


La raccomandazione neurale#
Intorno al 2016 il deep learning aveva già conquistato il riconoscimento delle immagini e stava conquistando il linguaggio, e la domanda era nell’aria: una rete neurale al posto del prodotto scalare farebbe meglio? Il prodotto scalare della sezione precedente è una regola di calcolo fissa, decisa a tavolino da chi ha scritto il modello, mentre una rete la regola se la cerca da sé. E può cercarla molto lontano: il capitolo sul Deep Learning racconta che una rete abbastanza grande sa approssimare, con la precisione che si vuole, quasi qualunque funzione, cioè quasi qualunque regola che da certi numeri in ingresso ricavi un numero in uscita. Il paper che diede forma alla domanda è Neural Collaborative Filtering [HLZ+17], e la risposta è più interessante di un semplice «sì»: è un piccolo caso di studio su cosa significa davvero «più potente» in machine learning.
Dal prodotto scalare alla rete#
Il Neural Collaborative Filtering (NCF) cambia un solo elemento della fattorizzazione. Restano gli embedding \(\mathbf{p}_u\) e \(\mathbf{q}_i\) di utenti e film; al posto del prodotto scalare c’è una rete neurale che riceve i due vettori, restituisce il punteggio e impara da sé come combinarli (Fig. 33.4).

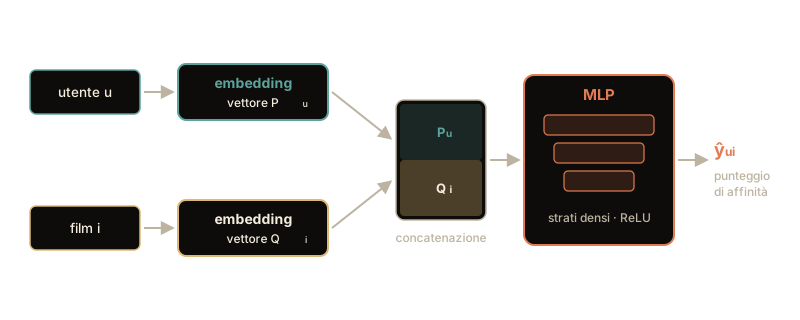
Fig. 33.4 L’architettura NCF: gli embedding dell’utente e del film vengono incollati uno sotto l’altro (concatenati) e passati a una piccola rete a più strati (un percettrone multistrato, in sigla MLP), che al posto del prodotto scalare produce il punteggio di affinità. Il disegno si ferma un passo prima della fine: nel modello quel punteggio passa ancora per una funzione che lo schiaccia fra zero e uno, la sigmoide, perché si legga come una probabilità.#
Nella fattorizzazione, il confronto tra la scheda dell’utente e quella del film è una regola fissa: si moltiplicano le voci corrispondenti e si somma (la manopola «commedia» dell’utente incontra solo la manopola «commedia» del film, mai le altre). È come giudicare una coppia sommando i punti in comune, voce per voce.
Il NCF cambia il giudice. Le due schede vengono incollate una sotto l’altra e consegnate a una piccola rete neurale, che durante l’addestramento impara da sola come leggerle insieme. In teoria può cogliere combinazioni che la somma voce per voce non vede (l’equivalente di «ama i documentari, ma solo se durano meno di un’ora»), perché nessuno le impone di trattare le voci a coppie.
Per trovarsi la regola da sé, però, il giudice nuovo ha bisogno di vedere tantissime coppie già giudicate, e ne ha viste pochissime: la tabella da cui impara è quasi tutta vuota.
Gli autori provano anche una terza strada, con due giudici al lavoro insieme: quello vecchio, che somma voce per voce, e quello nuovo, la rete, e alla fine si mettono d’accordo. Ma ciascuno dei due vuole le sue schede, così ogni utente e ogni film ne hanno due invece di una. Il confronto con la fattorizzazione di prima, che a ognuno dà una scheda sola della stessa lunghezza, non è più alla pari: questa versione ha il doppio dei numeri da imparare.
Con gli embedding \(\mathbf{p}_u, \mathbf{q}_i \in \mathbb{R}^k\) della sezione precedente, il NCF sostituisce il prodotto scalare con un percettrone multistrato applicato alla concatenazione:
dove \([\,\cdot\,;\,\cdot\,]\) è la concatenazione dei due vettori, \(f_{\theta}\) un MLP con attivazioni ReLU e \(\sigma\) la sigmoide, che schiaccia l’uscita in \((0,1)\): il modello è pensato per feedback implicito, e \(\hat{y}_{ui}\) si legge come probabilità di interazione. Si addestra con l’entropia incrociata binaria
dove \(\mathcal{Y}^+\) sono le interazioni osservate (\(y_{ui} = 1\)) e \(\mathcal{Y}^-\) coppie non osservate, pescate in modo uniforme a ogni iterazione e trattate come negative (\(y_{ui} = 0\)): negli esperimenti del paper quattro per ogni positiva. La valutazione è leave-one-out: per ogni utente l’ultima interazione va nel test e si mette in classifica contro 100 oggetti non visti presi a caso, con HR@10 e NDCG@10, su MovieLens 1M e Pinterest [HLZ+17]. Il protocollo conta, e il paragrafo sul misurare una classifica dice perché.
Il cappello indica sempre la predizione, ma la lettera sotto cambia con il compito, e qui si segue quella dei paper d’origine: \(\hat{r}_{ui}\) per un voto da prevedere (fattorizzazione), \(\hat{y}_{ui}\) per una probabilità di interazione (NCF), \(\hat{x}_{ui}\) per un punteggio di ranking (BPR), dove conta solo l’ordine e non il valore assoluto.
Il paper propone anche una variante che affianca i due mondi (NeuMF): un ramo GMF, \(\sigma\big(\mathbf{h}^\top (\mathbf{p}_u \odot \mathbf{q}_i)\big)\) con \(\odot\) il prodotto elemento per elemento, che ritrova esattamente la fattorizzazione con \(\mathbf{h} = \mathbf{1}\) e l’identità al posto di \(\sigma\); e un ramo MLP, ciascuno con la propria coppia di tabelle di embedding, fusi concatenando l’ultimo strato nascosto. Che le tabelle siano separate conta, ed è il paper stesso ad argomentarlo: condividerle costringerebbe i due rami alla stessa dimensione degli embedding, e gli autori scrivono che questo potrebbe limitare le prestazioni del modello fuso. La conseguenza da tenere a mente è che NeuMF ha il doppio dei parametri di embedding di una fattorizzazione a parità di \(k\), quindi il confronto fra i due non è a parità di capacità: cosa che rende il risultato di Rendle, fra poco, ancora più netto. In linea di principio l’MLP, per il teorema di approssimazione universale [Hor91] (nella versione di Leshno et al. [LLPS93], che copre attivazioni illimitate come la ReLU), può approssimare con precisione arbitraria, su un compatto, qualunque interazione continua tra i fattori; ma approssimare non è rappresentare esattamente, e se poi la impari davvero da dati sparsi è un’altra faccenda ancora.
Nel 2019 due ricercatori del Politecnico di Milano e un collega dell’università di Klagenfurt hanno provato a rifare i conti di diciotto metodi neurali per la raccomandazione, presentati alle conferenze principali [FDCJ19]. Solo sette si sono lasciati riprodurre con uno sforzo ragionevole, e sei di quei sette venivano spesso battuti da metodi molto più semplici: i vicini della sezione precedente, o cammini casuali sul grafo utenti-oggetti, che ricompare fra poco e che con le reti su grafo condivide il disegno ma non i parametri da imparare. Il settimo batteva quei metodi semplici, ma non riusciva a battere in modo costante un metodo lineare tarato con cura. Il lavoro ha vinto il premio per il miglior articolo lungo di RecSys 2019, la conferenza del settore, e ha spostato la domanda che si fa a un risultato nuovo: non «funziona?» ma «meglio di che cosa, tarato da chi?».
L’anno dopo Steffen Rendle e colleghi hanno rifatto la stessa operazione proprio sul NCF, sugli stessi banchi di prova del paper originale [RKZA20]. Hanno trovato due cose: che il vecchio prodotto scalare, tarato con cura, batte la rete; e che per un MLP imparare a riprodurre un prodotto scalare è sorprendentemente difficile, e richiede molta capacità e molti dati.
Il risultato non dice che le reti non servano: dice che la libertà in più ha un prezzo. Il prodotto scalare porta con sé un’ipotesi sul problema, che il punteggio sia una somma di prodotti fra componenti corrispondenti dei due embedding. Una rete al suo posto quell’ipotesi deve ricostruirla dai dati, e in una matrice quasi vuota i dati sono pochi: un’ipotesi azzeccata, data al modello in partenza, vale più di molti parametri in più. È il bias induttivo incontrato nella sezione sull’apprendimento multi-compito.
Il prodotto scalare ha anche un vantaggio di costo, che con la qualità non c’entra. Gli embedding degli oggetti non dipendono dall’utente, quindi si calcolano una volta, e per ogni utente basta cercare quelli con il prodotto scalare più alto, cosa che gli indici approssimati fanno senza scorrere tutto il catalogo. Una rete che riceve utente e oggetto insieme va invece valutata su ogni coppia: un milione di valutazioni per ogni persona che apre l’app, su un catalogo da un milione di titoli. Su cataloghi così è questo, più della qualità, a decidere se il sistema sta in piedi, e il conto preciso sta nel paragrafo sull’industria.
Tutto questo vale per il filtraggio collaborativo puro, cioè per modelli che vedono soltanto gli identificativi di utente e oggetto. Quando accanto alle interazioni ci sono altre informazioni (l’ora, il dispositivo, il prezzo, il genere, che nel gergo del mestiere si chiamano feature), una rete può usarle e un prodotto scalare fra due embedding no: per questo i modelli che ordinano i candidati nel secondo stadio dei sistemi industriali sono reti.
La matrice è un grafo#
C’è un secondo modo di andare oltre il prodotto scalare: dare al modello più dati da guardare. La matrice di interazione descrive per intero il grafo bipartito utenti-oggetti con cui si è chiuso il capitolo sulle reti neurali su grafo, un arco per ogni cella piena, e su quel grafo raccomandare vuol dire fare link prediction: prevedere gli archi che mancano. Letta così, la raccomandazione può propagare l’informazione lungo gli archi, oltre il singolo confronto fra due embedding.
La tabella utenti per film si può disegnare invece che tabulare. Metti tutti gli utenti in una colonna di pallini a sinistra, tutti i film in una colonna a destra, e tira una linea ogni volta che qualcuno ha visto qualcosa. I pallini sono i nodi e le linee gli archi, le parole del capitolo sulle reti neurali su grafo; qui continueremo a dire pallini e linee, che si vedono meglio. Non hai aggiunto né tolto niente: è lo stesso dato, disegnato. Ma adesso si vede una cosa che nella tabella era nascosta, e cioè che raccomandare vuol dire indovinare le linee che ancora non ci sono.
Vista così, la fattorizzazione guarda vicino: la scheda di ognuno riassume le linee che partono dal suo pallino, e per giudicare una coppia si confrontano quelle due schede. Non è poco (le schede sono proprio la mossa che permette di confrontare due persone senza film in comune) ma è un passo solo di distanza. Il metodo dei vicini della sezione precedente, letto sul disegno, fa tre passi: da te ai film che hai visto, da quei film alle persone che li hanno visti (i tuoi vicini), e da loro ai film che hanno visto e tu no. E poi? Perché fermarsi lì? Un film può interessarti perché piace a persone che a loro volta somigliano a chi somiglia a te, e per scoprire un legame così bisogna camminare più a lungo. Il grafo permette di raccogliere quel segnale lontano; la tabella no, perché lì i passi non si vedono.
Camminare così ha un nome, propagazione. Ogni pallino ha la sua scheda di numeri, e a ogni passo la sostituisce con una somma delle schede dei pallini a cui è collegato, ma non tutte allo stesso volume: chi è collegato a mezzo catalogo parla più piano, e un film visto da tutti conta poco per ognuno dei suoi spettatori. Dopo tre o quattro passi ogni scheda contiene anche notizie che vengono da lontano. E c’è un modello del 2020, LightGCN, famoso proprio perché non fa altro: niente rete neurale sopra, solo il camminare, ripetuto qualche volta e rimesso insieme alla fine, con le schede di partenza come unici numeri da imparare. È nato per sottrazione: i suoi autori hanno preso un modello a grafo che faceva di più e gli hanno tolto dei pezzi, scoprendo che così andava meglio del modello da cui erano partiti.
La matrice di interazione \(\mathbf{R} \in \{0,1\}^{n \times m}\), qui binaria e non più a stelle, dove \(n\) è il numero degli utenti e \(m\) quello degli oggetti (le stesse lettere della figura della sezione precedente), è la matrice di adiacenza di un grafo bipartito utente-oggetto, a meno di riscriverla in forma simmetrica:
Su un grafo si può propagare, ed è esattamente il message passing del capitolo sulle reti neurali su grafo. Nella forma più nuda, l’embedding di un utente al passo \(\ell+1\) è una somma pesata degli embedding degli oggetti con cui ha interagito, e viceversa:
Il peso è la stessa normalizzazione simmetrica dei gradi vista per la GCN (non una media: i coefficienti non sommano a uno), con una differenza da non scavalcare: la GCN del capitolo sui grafi normalizza \(\tilde{\mathbf{A}} = \mathbf{A} + \mathbf{I}\), cioè con i cappi, e qui la somma corre sui soli \(\mathcal{N}(u)\), senza cappio. Non è una svista: LightGCN scarta le self-connection per scelta dichiarata, mostrando che la combinazione finale degli strati (che include lo strato \(0\)) ne cattura già l’effetto. La lettura per il resto è la stessa: un utente che ha visto tutto, o un film visto da tutti, contano meno per singolo arco. Impilare \(L\) strati significa raccogliere segnale da \(L\) salti di distanza.
L’idea è nell’aria dal 2017, quando GC-MC formulò il completamento della matrice come convoluzione sul grafo bipartito [vdBKW17]. La tappa canonica è NGCF [WHW+19], che ricalca la GCN completa: trasformazione lineare, non linearità, propagazione. LightGCN toglie i primi due e tiene solo il terzo [HDW+20]. In forma matriciale la propagazione è
con \(\mathbf{D}\) la matrice diagonale dei gradi e \(\mathbf{E}^{(0)}\) la tabella degli embedding iniziali, una riga per nodo: per un utente è il \(\mathbf{p}_u\) della fattorizzazione, per un oggetto il \(\mathbf{q}_i\), ed è la sola cosa che si impara. Gli strati si combinano con pesi uniformi, \(\mathbf{e}_u = \sum_{\ell=0}^{L} \frac{1}{L+1} \mathbf{e}_u^{(\ell)}\), il punteggio è il prodotto scalare \(\mathbf{e}_u^\top \mathbf{e}_i\), e l’addestramento usa la perdita BPR, definita nel paragrafo su BPR. Un passaggio completo costa \(O(L\,|\mathcal{E}|\,k)\), con \(|\mathcal{E}|\) il numero di interazioni e \(k\) la dimensione degli embedding. Il limite è quello di ogni modello a propagazione, l’oversmoothing della sezione su GraphSAGE, GAT e applicazioni: con molti strati gli embedding finiscono per somigliarsi tutti, e il paper presenta la combinazione degli strati, che include lo strato \(0\), anche come rimedio. Costa molto meno di NGCF, e funziona meglio: circa il 16% di miglioramento relativo medio, a parità di protocollo sperimentale. È il termine di paragone da tenere a mente, perché è interno alla famiglia dei metodi a grafo: il paper non sta dicendo che LightGCN batte una fattorizzazione ben tarata, sta dicendo che togliere pezzi a NGCF lo migliora. Il punteggio, del resto, resta il prodotto scalare della sezione precedente: a cambiare sono gli embedding che vi entrano.
La morale somiglia a quella vista per il NCF, ma le due storie non pesano allo stesso modo come prova. La prima, il riesame del NCF, l’hanno fatta persone diverse da chi il metodo l’aveva proposto, ritarando con cura gli avversari e facendoli correre di nuovo. La seconda è il paper di LightGCN, cioè i suoi autori che riportano la propria vittoria su NGCF: è quello che fa chiunque pubblichi, ed è proprio per questo che da sola pesa meno. Le due vanno nella stessa direzione: NCF mette una rete al posto del prodotto scalare e non guadagna niente; LightGCN toglie la rete, tiene solo la propagazione, e batte il modello più complicato da cui è stato ricavato. Propagare sul grafo dà al modello un’ipotesi in più: chi ha interagito con cose simili alle tue è informativo anche a più di un salto di distanza. Che quest’ipotesi valga più di una fattorizzazione ben tarata, però, non lo dice nessuna delle due storie, e un riesame indipendente non lo conferma in generale. Anelli e colleghi hanno rifatto i conti di sei modelli a grafo e li hanno messi accanto a metodi classici ben tarati: su alcuni dataset i vicini sugli oggetti e i cammini casuali battono NGCF e LightGCN, su altri il primo posto resta a un modello a grafo, e l’esito dipende dalla struttura dei dati [AMP+23].
Il grafo permette anche una risposta parziale alla partenza a freddo, il limite contro cui la sezione precedente si era fermata. Nella matrice un film appena uscito è una colonna vuota, e da una colonna vuota non si estrae niente. In un grafo eterogeneo, con più tipi di nodi e di archi come i grafi di conoscenza del capitolo sulle reti su grafo, si aggiungono nodi per il regista, il genere, gli attori. Il film nuovo non ha ancora archi verso gli utenti, ma ne ha verso questi nodi, e la propagazione gli porta l’informazione dei film che li condividono: si presenta al sistema con un embedding sensato prima ancora che qualcuno lo guardi. È la strada dei modelli che uniscono in un solo grafo le interazioni e un grafo di conoscenza sugli oggetti, come KGAT [WHC+19], che nel paper ne misura il guadagno sugli utenti con poche interazioni. NGCF e LightGCN, che usano il solo grafo utente-oggetto, per un film senza archi non hanno nulla da propagare.
La lettura come link prediction rende disponibile tutto l’armamentario delle reti su grafo. Il caso più noto in produzione, PinSage [YHC+18], è raccontato nella sezione su GraphSAGE, GAT e applicazioni (lì il grafo bipartito è fatto di immagini e bacheche, ma il meccanismo è lo stesso), insieme al campionamento dei vicini che lo rende praticabile a scala web. Non è però la definizione del problema: un grafo di interazioni non ha un orologio, e i sistemi che girano davvero restano organizzati intorno al prodotto scalare fra due embedding.
Imparare a ordinare: BPR#
Con il feedback implicito cambia il compito. Quando non ci sono voti, ma solo la traccia di quello che uno ha guardato, non c’è nessun numero da prevedere. C’è l’elenco di ciò che hai guardato e l’oceano di ciò che non hai guardato; e quell’oceano, lo sappiamo dalla panoramica, non è un elenco di bocciature. La Bayesian Personalized Ranking (BPR) prende sul serio questa asimmetria: smette di prevedere valori e impara direttamente a ordinare [RFGST09]. Delle tre parole del nome quella che conta è l’ultima, ranking, che vuol dire mettere in fila. Personalized dice che la fila è diversa per ogni persona. Bayesian dice che il criterio è una stima di massimo a posteriori (MAP), con un prior gaussiano centrato in zero sui parametri, da cui discende un termine di regolarizzazione \(L_2\); la stessa lettura vale per la regolarizzazione della fattorizzazione, che a meno di costanti è anch’essa il logaritmo di un prior gaussiano cambiato di segno. Il nome si ferma lì: BPR non calcola una distribuzione a posteriori, ne cerca solo il massimo.
Sistemi la vetrina di una libreria per un cliente abituale. Non conosci i suoi voti, ma sai cosa ha comprato. La regola di BPR è tutta qui: ciò che ha scelto deve stare più in alto di ciò che ha ignorato. A ogni passo peschi una coppia (un libro che ha comprato, uno a caso tra i mille che non ha mai toccato) e controlli la tua vetrina: se il libro comprato sta già ben sopra, va bene così, quasi nessuna correzione; se sta sotto, sistemi la vetrina spostandolo su. Ripetuto milioni di volte, questo gioco di confronti a coppie produce una classifica personale senza che nessuno abbia mai dato un voto. Nota la finezza: non serve decidere quanto gli piace ogni libro; serve solo che l’ordine sia giusto.
E se il libro pescato a caso era proprio uno che gli sarebbe piaciuto, e che non ha comprato solo perché non l’ha mai visto? Succede, e per un istante lo stiamo spingendo giù per sbaglio. Il gioco regge lo stesso, per due motivi. Il primo è che su un catalogo grande capita di rado, e più il catalogo è grande più capita di rado (un libro che quel cliente ha già comprato non finisce mai fra gli ignorati, quello si riconosce; uno che gli sarebbe piaciuto e che non ha mai visto sì, e non c’è modo di accorgersene). Il secondo, che conta di più: ogni singolo confronto sposta la vetrina di pochissimo, quindi dopo milioni di confronti resta impressa la regolarità, non lo sbaglio di uno di essi. È il motivo per cui questo metodo vuole tantissimi confronti approssimativi e non pochi giudizi precisi.
E c’è un momento in cui il gioco smette di insegnare: a vetrina quasi a posto i libri pescati a caso stanno già tutti sotto, e da un confronto già vinto non si impara niente. Da lì in poi i confronti bisogna sceglierli, non pescarli.
Sia \(\hat{x}_{ui}\) il punteggio che un modello qualunque assegna alla coppia \((u,i)\): nel paper è una fattorizzazione ridotta al solo prodotto scalare, \(\hat{x}_{ui} = \mathbf{p}_u^\top \mathbf{q}_i\), senza nessuno dei termini additivi della sezione precedente. Due dei tre spariscono da sé, perché BPR confronta sempre due item dello stesso utente e nella differenza \(\mu\) e \(b_u\) si elidono. Il bias di item no: sopravvive come \(b_v - b_w\), e nel paper semplicemente non c’è. Un modo naturale di leggere quell’assenza (il paper non la discute) è che quel termine è la stessa quantità per tutti gli utenti, cioè la parte non personalizzata dell’ordinamento: la P di Personalized. Rimetterlo è legittimo e varie implementazioni lo fanno, al prezzo di una classifica che per un utente senza storia collassa su quella dei titoli più popolari, che è però anche il meglio che si possa fare quando di quell’utente non si sa nulla.
BPR costruisce triple \((u, v, w)\): un utente \(u\), un item \(v\) con cui ha interagito, un item \(w\) campionato tra quelli mai toccati. La loss chiede che \(v\) superi \(w\):
dove \(\sigma\) è la sigmoide e \(\theta\) raccoglie tutti i parametri del modello. La lettura probabilistica: \(\sigma(\hat{x}_{uv} - \hat{x}_{uw})\) è la probabilità, secondo il modello, che \(u\) preferisca \(v\) a \(w\); la loss è la log-verosimiglianza negativa di aver ordinato bene tutte le coppie, assunte indipendenti tra loro (senza questa ipotesi il prodotto delle sigmoidi non sarebbe una verosimiglianza), e \(\lambda\,\lVert\theta\rVert^2\) è, a meno di costanti, il logaritmo cambiato di segno del prior gaussiano della stima MAP. Conta solo la differenza dei punteggi, non il loro valore assoluto.
Il legame con le metriche è diretto. Per l’utente \(u\) l’AUC è la frazione di coppie (positivo, non osservato) messe nell’ordine giusto,
con \(\mathcal{P}_u\) gli oggetti con cui \(u\) ha interagito: BPR sostituisce l’indicatore, che non è derivabile, con \(\ln \sigma(\hat{x}_{uv} - \hat{x}_{uw})\), che lo è. Il gradiente di una tripla rispetto a un parametro \(\theta\) vale \(-\sigma\big(-(\hat{x}_{uv} - \hat{x}_{uw})\big)\, \partial(\hat{x}_{uv} - \hat{x}_{uw})/\partial\theta\): ogni coppia pesa quanto è ordinata male, quindi le coppie già ben ordinate con margine ampio contribuiscono quasi zero e quelle invertite spingono forte. I non osservati, però, non sono negativi veri: un oggetto mai visto può piacere, e BPR lo tratta come meno preferito senza poter sapere se lo è (è il problema dell’apprendimento positive-unlabeled), e si conta sul fatto che su un catalogo grande un \(w\) pescato a caso sia quasi sempre meno gradito. E BPR ottimizza l’ordine sull’intero catalogo, mentre le metriche del paragrafo sul misurare una classifica premiano solo le prime \(k\) posizioni. In pratica i negativi \(w\) si campionano a caso a ogni passo, con l’accortezza che, a modello maturo, i negativi «facili» non insegnano più nulla e il campionamento intelligente dei negativi difficili diventa metà del mestiere.

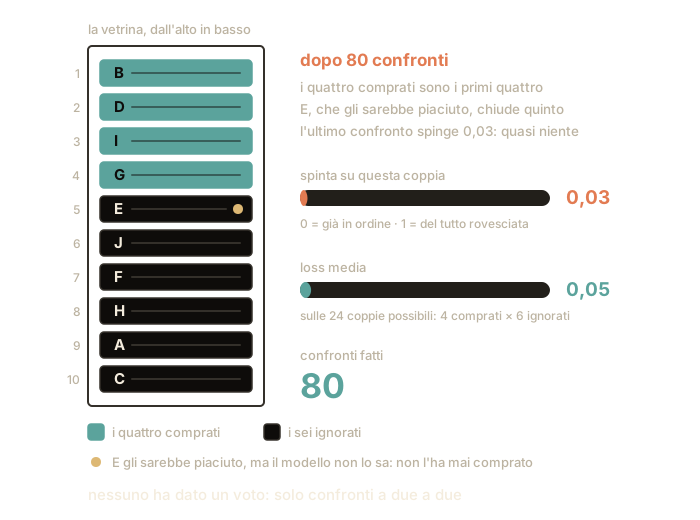
Fig. 33.5 Ottanta confronti a coppie su una vetrina di dieci libri; l’animazione mostra uno per uno i primi dieci, poi salta al risultato. Ogni confronto pesca un libro comprato e uno ignorato: se il comprato sta già sopra la spinta è quasi nulla e la vetrina resta ferma, se sta sotto risale di uno o più posti. A un certo punto l’ignorato pescato è il libro \(E\) del disegno, che a quel cliente sarebbe piaciuto davvero: scende di un posto per sbaglio, e al confronto dopo è già risalito. Alla fine i quattro comprati sono i primi quattro, e nessuno ha mai dato un voto.#
In PyTorch la loss di BPR è una riga, -F.logsigmoid(x_uv - x_uw).mean(),
ed è quella che muove la vetrina della Fig. 33.5. Il
programma completo, su un feedback implicito finto in cui ogni utente ha
guardato dieci film e due vengono nascosti per la valutazione, mette accanto a
BPR la classifica per popolarità della sezione precedente, e per tutti e due conta quanti dei titoli nascosti
finiscono fra i primi dieci della lista, che è la recall@10 del paragrafo sul
misurare una classifica.
import torch
import torch.nn.functional as F

torch.manual_seed(0)
n_utenti, n_film = 300, 200
P_vero, Q_vero = torch.randn(n_utenti, 4), torch.randn(n_film, 4)

# feedback implicito finto: ogni utente guarda i suoi 10 film preferiti
# (scelti con un po' di rumore), e due dei dieci, presi a caso, si nascondono
affinita = P_vero @ Q_vero.T + 0.5 * torch.randn(n_utenti, n_film)
visti = affinita.topk(10, dim=1).indices
visti = visti.gather(1, torch.rand(n_utenti, 10).argsort(dim=1))  # mescolati
nascosti, noti = visti[:, :2], visti[:, 2:]
noto = torch.zeros(n_utenti, n_film, dtype=torch.bool)
noto[torch.arange(n_utenti)[:, None], noti] = True

P = torch.nn.Parameter(0.1 * torch.randn(n_utenti, 8))
Q = torch.nn.Parameter(0.1 * torch.randn(n_film, 8))
ottim = torch.optim.Adam([P, Q], lr=0.02)
u = torch.arange(n_utenti).repeat_interleave(noti.shape[1])  # le coppie note
v = noti.reshape(-1)                                         # (u[j], v[j])

for epoca in range(200):
    w = torch.randint(0, n_film, v.shape)     # un negativo a caso per coppia
    ok = ~noto[u, w]                          # scarta i positivi pescati
    x_uv = (P[u[ok]] * Q[v[ok]]).sum(dim=1)
    x_uw = (P[u[ok]] * Q[w[ok]]).sum(dim=1)
    loss = -F.logsigmoid(x_uv - x_uw).mean()  # la loss di BPR
    ottim.zero_grad()
    loss.backward()
    ottim.step()
    if (epoca + 1) % 50 == 0:
        print(f"epoca {epoca + 1:3d} · loss BPR {loss.item():.3f}")

def recall_10(punteggi):
    punteggi = punteggi.masked_fill(noto, -float("inf"))  # esclusi i noti
    primi = punteggi.topk(10, dim=1).indices
    presi = (primi[:, :, None] == nascosti[:, None, :]).any(dim=1)
    return presi.float().mean().item()

with torch.no_grad():
    popolarita = noto.sum(dim=0).float().expand(n_utenti, -1)
    print(f"recall@10 · BPR {recall_10(P @ Q.T):.3f}"
          f" · solo i titoli popolari {recall_10(popolarita):.3f}")
epoca  50 · loss BPR 0.130
epoca 100 · loss BPR 0.055
epoca 150 · loss BPR 0.039
epoca 200 · loss BPR 0.025
recall@10 · BPR 0.738 · solo i titoli popolari 0.227
Senza un solo voto, BPR rimette fra i primi dieci quasi tre titoli nascosti su quattro, più di tre volte quelli che ritrova la classifica per popolarità, e nessuno gli ha mai detto quanto un film piaccia: solo quali film un utente ha scelto. La riga della loss, detta in italiano: guarda di quanto il libro comprato sta sopra a quello ignorato, e trasforma quel margine in una spinta. Se il comprato sta già molto sopra, la spinta è quasi zero e la vetrina non si muove; se sta sotto, la spinta cresce, e cresce tanto più quanto è sotto.
F.logsigmoid fa in un passaggio solo due conti, la sigmoide e il logaritmo
della sezione di analisi, perché
fatti separati in float32, il formato in cui PyTorch tiene i numeri, si
rompono quando il margine è molto negativo. Il confronto su tre margini, uno
disastroso, uno nullo e uno buono, con il valore della loss nella prima riga e
la sua derivata nella seconda:
import torch
import torch.nn.functional as F
margine = torch.tensor([-100.0, 0.0, 5.0], requires_grad=True)
a_mano = -torch.log(torch.sigmoid(margine))   # due conti separati
insieme = -F.logsigmoid(margine)              # un conto solo
print(a_mano.detach(), insieme.detach())
print(torch.autograd.grad(a_mano.sum(), margine)[0],
      torch.autograd.grad(insieme.sum(), margine)[0])
tensor([   inf, 0.6931, 0.0067]) tensor([1.0000e+02, 6.9315e-01, 6.7153e-03])
tensor([    nan, -0.5000, -0.0067]) tensor([-1.0000, -0.5000, -0.0067])
Il primo conto, la sigmoide, schiaccia il margine fra zero e uno, così si legge come una probabilità: «quanto il modello è convinto di aver messo i due libri nell’ordine giusto». Il secondo, il logaritmo col segno cambiato, trasforma quella probabilità in un errore: zero quando la probabilità è uno, sempre più grande quando la probabilità si avvicina a zero.
Fatti uno dopo l’altro, si inceppano. Se il libro comprato sta cento punti
sotto quello ignorato, la sigmoide dovrebbe dare un numero con quarantatré zeri
dopo la virgola. Per arrivarci, però, il calcolatore passa da un numero enorme,
di quarantaquattro cifre, che nel formato di PyTorch non ci sta: lo scrive come
infinito, e la sigmoide esce zero. Il logaritmo di zero è infinito, e la spinta
che dovrebbe correggere la vetrina esce nan, che sta per not a number: da
lì in poi l’addestramento è rovinato. Fatti insieme, i due conti si
semplificano prima di arrivare a quel numero minuscolo, e l’errore esce \(100\),
proprio il margine da cui si era partiti, con una spinta piena a correggerlo.
Per i margini normali, zero o cinque punti, le due strade danno lo stesso
numero.
Con \(z = \hat{x}_{uv} - \hat{x}_{uw}\) il termine della loss è
\(-\log\sigma(z) = \log(1 + e^{-z}) = \mathrm{softplus}(-z)\), e si può
calcolare come \(-\min(z, 0) + \log(1 + e^{-|z|})\), che non forma mai un
esponenziale maggiore di uno: per \(z \ll 0\) vale \(\approx -z\) (qui \(100\)), e la
derivata \(-\sigma(-z)\) resta fra \(-1\) e \(0\). A conti separati, in float32,
\(\sigma(z) = 1/(1 + e^{-z})\) diventa esattamente zero appena \(e^{-z}\) supera il
massimo rappresentabile, circa \(3{,}4 \cdot 10^{38}\), cioè per
\(z \lesssim -88{,}7\): il logaritmo dà \(-\infty\), la loss \(+\infty\), e la
derivata calcolata dalla catena, \(-\sigma'(z)/\sigma(z)\), è un \(0/0\) che esce
nan. Un solo nan nel gradiente basta a contaminare i parametri che
aggiorna, e da lì tutti gli altri.
Misurare una classifica#
Se il compito è mettere in ordine, anche il metro cambia: l’errore sul voto non è definito, perché i voti non ci sono. Le metriche più usate valutano i primi \(k\) suggerimenti (di solito \(k = 10\) o \(20\)), che sono la parte della lista che l’utente vede; l’AUC, che BPR approssima, guarda invece l’ordine dell’intero catalogo.
Prima di scegliere il metro, però, va deciso su che cosa si misura. Nessuno può dire se ti sarebbe piaciuto un titolo che non hai mai visto, quindi si procede per finta: si prende la storia di un utente, si nasconde una parte di ciò che ha davvero guardato, si addestra il modello su quel che resta, e poi si guarda quanti dei titoli nascosti il modello rimette in cima alla lista. I titoli nascosti fanno da riferimento: sono interazioni che sappiamo avvenute, e che il modello non ha visto perché le abbiamo tolte noi. Il riferimento è imperfetto, per le ragioni della panoramica: aver guardato un titolo non vuol dire averlo gradito, e un titolo buono che l’utente non ha mai incontrato, se il modello lo propone, conta come un errore.
I titoli nascosti sono 6, il sistema ne mostra 10, e 3 di quei 10 stanno fra i nascosti. La precision@10 (la chiocciola si legge «sui primi dieci») è la frazione di consigli azzeccati: \(3/10 = 0{,}3\). Il recall@10 misura invece quanti dei 6 nascosti ne ha ritrovati: \(3/6 = 0{,}5\). Le due metriche tirano in direzioni opposte: sparare consigli a raffica alza il recall e affonda la precision.
C’è però un dettaglio che entrambe ignorano: dove stanno i colpi azzeccati. Un successo al primo posto vale più di uno al decimo, perché al decimo posto forse non arrivi mai. La NDCG è la metrica che ne tiene conto: premia le classifiche che mettono i titoli giusti in cima, come un giornale che sceglie bene la prima pagina. In cifre: un titolo giusto vale \(1\) al primo posto, poi \(0{,}63\), \(0{,}50\), \(0{,}43\), \(0{,}39\), \(0{,}36\), \(0{,}33\) scendendo fino al settimo, e \(0{,}29\) al decimo. Non sono numeri a caso, e la regola si dice senza formule: si prende il numero del posto, gli si aggiunge uno, e si conta quante volte bisogna raddoppiare 1 per arrivarci; il titolo vale uno diviso quel conto. Per il primo posto si arriva a 2 con un raddoppio, e il titolo vale \(1\); per il terzo si arriva a 4 con due raddoppi, e vale metà; per il settimo, 8, con tre, e vale un terzo; per il quindicesimo, 16, con quattro, e vale un quarto. Sui posti in mezzo il conto dà numeri con la virgola: per il secondo posto si arriva a 3 con poco più di un raddoppio e mezzo, e il titolo vale \(0{,}63\). Lo sconto cala sempre più piano man mano che si scende: fra il primo e il secondo posto c’è più differenza (\(0{,}37\)) che fra il quinto e il decimo (\(0{,}10\)).
I punti si sommano e si dividono per il punteggio della classifica perfetta, quella che avrebbe messo i titoli giusti tutti in testa. Così il risultato sta fra \(0\) e \(1\) ed è confrontabile fra persone diverse, che altrimenti chi ha sei titoli nascosti raccoglierebbe più punti di chi ne ha due solo perché ne ha di più.
Finiamo l’esempio di prima. I 3 titoli azzeccati stiano ai posti 1, 4 e 7: valgono \(1 + 0{,}43 + 0{,}33 = 1{,}76\). La classifica perfetta avrebbe messo tutti e 6 i nascosti in cima, dal primo al sesto posto, cioè i sei sconti più alti, che sommano a \(3{,}3\). La NDCG@10 è \(1{,}76 / 3{,}3 = 0{,}53\).
E nascondere si può fare in più modi, che non sono equivalenti. Togliere un pezzo di storia a caso è comodo e imbroglia: il modello si addestra anche su cose successe dopo quelle su cui viene interrogato, e nella vita vera il futuro non è disponibile. Nascondere l’ultima cosa che ciascuno ha guardato è più onesto. Tagliare a una data è il più severo, e l’unico che somiglia alla situazione vera: fa comparire anche chi a quella data era appena arrivato, cioè proprio le persone su cui si sbaglia di più. Cambiando modo di nascondere, la classifica dei metodi può ribaltarsi.
E c’è una seconda decisione che nessuno dichiara: contro quanti titoli deve farsi largo quello nascosto. Batterne cento presi a caso è tutt’altra impresa che batterne un milione, e i due risultati si chiamano allo stesso modo. Contare su cento gonfia il punteggio, e non allo stesso modo per tutti: anche qui l’ordine fra due sistemi può rovesciarsi.
Detto \(\mathrm{Ril}_u\) l’insieme degli item rilevanti per \(u\) (nel test: le interazioni nascoste) e \(\mathrm{Top}_k(u)\) i primi \(k\) raccomandati, dove questo \(k\) è il taglio della lista e non i fattori latenti della sezione precedente:
Per pesare le posizioni si usa la Discounted Cumulative Gain:
dove \(\mathrm{rel}_j\) è la rilevanza dell’item in posizione \(j\) (binaria qui; per la rilevanza graduata la convenzione prevalente in information retrieval mette \(2^{\mathrm{rel}_j} - 1\) al numeratore, e le due forme coincidono solo nel caso binario) e \(\mathrm{IDCG@}k\) è la DCG della classifica ideale, che normalizza il punteggio tra utenti con numeri diversi di item rilevanti. Lo sconto logaritmico penalizza dolcemente: la posizione 2 vale \(1/\log_2 3 \approx 0{,}63\) della posizione 1. Quando il test ha un solo item rilevante per utente, che è il caso del protocollo leave-one-out con cui è valutato NCF, la recall@k degenera nella hit rate HR@k ed è con quel nome che la si trova nei paper; la metrica naturale diventa allora la MRR (mean reciprocal rank), \(\frac{1}{|\mathcal{U}|}\sum_u 1/\mathrm{rank}_u\), cioè la media dell’inverso della posizione in cui è finito l’unico item giusto.
Fra la precision e la NDCG sta la average precision della sezione sulle metriche, qui troncata al taglio \(k\):
cioè la somma delle precision misurate nelle posizioni in cui cade un item rilevante, divisa per quanti rilevanti potevano stare nei primi \(k\): un rilevante rimasto fuori conta come una precision nulla. Mediata sugli utenti diventa la MAP@\(k\). Premia anch’essa i successi in cima, con uno sconto implicito diverso da quello logaritmico della NDCG, e il denominatore cambia fra le implementazioni (\(|\mathrm{Ril}_u|\), \(\min(|\mathrm{Ril}_u|,k)\), o il numero di rilevanti trovati, che dà la media sulle sole posizioni colpite e non punisce chi ne trova pochi), quindi va dichiarato. Con un solo item rilevante la AP@\(k\) si riduce al reciproco del rango, \(1/\mathrm{rank}_u\) (zero se l’item è fuori dai primi \(k\)), e la NDCG@\(k\) a \(1/\log_2(\mathrm{rank}_u+1)\).
Tutte queste metriche si massimizzano, al contrario dell’RMSE della panoramica, che si minimizza; si mediano sugli utenti; e tutte ereditano il difetto della valutazione offline: misurano il recupero di interazioni passate, avvenute sotto l’esposizione del vecchio sistema, non il gradimento futuro.
Come si nasconde. «Nascondere una parte delle interazioni» lascia aperta una decisione che può cambiare l’ordine fra due metodi, e le opzioni in uso sono tre, con costi diversi. Split casuale sulle interazioni: comodo, ed è la scelta maggioritaria in letteratura, ma mette nell’addestramento interazioni successive a quelle di test, cioè addestra il modello su un futuro che al momento della predizione non esisteva [JSZL23]; è una fuga di informazione. Leave-one-out sull’ultima interazione di ciascun utente: rispetta la cronologia del singolo utente, non quella globale, perché il modello vede comunque il futuro degli altri. Taglio a un istante globale: l’unico che riproduce la situazione di produzione, ed è di gran lunga il più severo, perché fa emergere gli utenti che al momento della predizione non avevano ancora storia. La differenza non è di livello ma di ordine: passando da split casuale a temporale la graduatoria dei metodi può rovesciarsi, in buona parte proprio per via di quegli utenti freddi, e non c’è modo di prevedere in che verso.
Su quanti candidati. Seconda decisione tacita, e stessa morale. La precision, la recall e la NDCG, così definite, suppongono di ordinare l’intero catalogo non interagito, e ordinarlo tutto costa: molti lavori mettono in classifica l’item di test contro poche decine o centinaia di negativi campionati (è, alla lettera, il protocollo con cui sono prodotti i numeri di NCF: 100 negativi per utente). Le due quantità portano lo stesso nome e non sono confrontabili, perché battere cento concorrenti è molto più facile che batterne un milione. Il guaio peggiore però è un altro: il gonfiamento non è uguale per tutti i modelli, quindi la metrica campionata può invertire l’ordine fra due sistemi [KR20]. Il meccanismo si scrive in una riga. Se l’oggetto di test sta al posto \(\rho\) nella classifica di un catalogo di \(m\) oggetti e se ne campionano \(s\) negativi senza reimmissione, il numero \(X\) di negativi che gli stanno sopra è ipergeometrico, \(X \sim \mathrm{Ipergeom}(m - 1,\, \rho - 1,\, s)\), e l’hit rate campionata a \(k\) vale \(P(X \le k - 1)\), mentre quella esatta vale \(\mathbb{1}[\rho \le k]\). Krichene e Rendle mostrano che per questo la metrica campionata non è coerente con quella esatta, e ne propongono una correzione. Leggendo un Recall@10 in un paper, conviene sempre cercare prima su quanti candidati è stato calcolato.
Quanto gonfi il campionamento si vede su un catalogo da un milione di titoli con cento negativi, come nel protocollo di NCF: per un titolo di test che nella classifica completa sta a un dato posto, la probabilità di finire fra i primi dieci della lista campionata è
from scipy.stats import hypergeom

catalogo, negativi, k = 1_000_000, 100, 10
for posto in (10_000, 30_000, 100_000, 300_000):   # nel catalogo intero
    # dei negativi pescati, quanti stanno sopra: una variabile ipergeometrica
    sopra = hypergeom(catalogo - 1, posto - 1, negativi)
    p = sopra.cdf(k - 1)                            # al massimo k - 1 sopra
    print(f"posto vero {posto:>7}: fra i primi {k} su {negativi + 1}"
          f" con probabilita' {p:.3f}")
posto vero   10000: fra i primi 10 su 101 con probabilita' 1.000
posto vero   30000: fra i primi 10 su 101 con probabilita' 0.999
posto vero  100000: fra i primi 10 su 101 con probabilita' 0.451
posto vero  300000: fra i primi 10 su 101 con probabilita' 0.000
Un titolo al posto diecimila, lontanissimo dai primi dieci della classifica vera, nella lista campionata ci entra praticamente sempre, e uno al posto centomila quasi una volta su due. Sul catalogo intero tutti e quattro valgono zero.
La storia recente conta#
Un limite silenzioso di tutto ciò che abbiamo visto: la matrice dei voti non ha orologio. Per la fattorizzazione, il film visto ieri sera e quello di dieci anni fa pesano uguale. Ma chi ha appena comprato una tenda da campeggio è, per qualche giorno, una persona diversa: sacco a pelo e fornelletto sono consigli d’oro oggi e rumore tra un mese. La raccomandazione sequenziale tratta la storia di un utente, \(i_1, \dots, i_t\), come una frase da continuare, e stima \(P(i_{t+1} \mid i_1, \dots, i_t)\) sul catalogo come un modello del linguaggio stima la parola successiva. Gli strumenti sono quelli dei capitoli sul NLP e sui Transformer, e il settore ne ha seguito la stessa parabola: prima le reti ricorrenti, poi la self-attention. Al posto delle parole ci sono i titoli del catalogo.
Chi ti consiglia la prossima canzone guardando le ultime che hai ascoltato può farlo in tre modi. Il primo le ascolta una alla volta, nell’ordine, e tiene a mente un riassunto che aggiorna a ogni brano: arrivato all’ultimo, il riassunto dice che aria tira. Il secondo le ha davanti tutte insieme e, per indovinare la prossima, decide da sé quali delle precedenti contano di più, l’ultima o magari una di qualche giorno fa, senza mai sbirciare quelle che vengono dopo. Il terzo si allena in un altro modo: copre a caso qualche brano in mezzo alla fila e prova a indovinarlo guardando quelli prima e quelli dopo, come in un esercizio di parole mancanti.
Il terzo è arrivato per ultimo, e per un po’ è sembrato il migliore. Poi qualcuno ha rifatto le prove. Per ottenere i risultati annunciati bisognava allenarlo molto più a lungo di quanto dicessero le sue istruzioni; e il secondo, allenato a scegliere il brano giusto fra tutti quelli del catalogo invece che fra due soli, come faceva all’inizio, lo batteva.
GRU4Rec [HKBT16] usa una rete ricorrente a GRU sulle sessioni e la addestra con funzioni di costo di ranking a coppie, BPR e TOP1, contro oggetti campionati. SASRec [KM18] è un Transformer causale (ogni posizione vede solo le precedenti) addestrato a ogni posizione con l’entropia incrociata binaria fra l’oggetto successivo e un solo negativo campionato. BERT4Rec [SLW+19] è bidirezionale e si addestra con il compito cloze: maschera oggetti a caso nella sequenza e li prevede dal contesto sui due lati, con una softmax sull’intero catalogo. Che i modelli si susseguano in ordine di pubblicazione non vuol dire che si susseguano in ordine di qualità. BERT4Rec superava SASRec nei confronti del suo paper, ma Petrov e Macdonald ne riproducono i risultati con il codice originale solo addestrandolo fino a trenta volte più a lungo della configurazione predefinita [PM22]; e Klenitskiy e Vasilev mostrano che SASRec, addestrato con la stessa funzione di costo di BERT4Rec, lo supera in qualità e in velocità di addestramento [KV23]. Una parte del vantaggio attribuito all’architettura stava nella funzione di costo.
Come lo fa l’industria#
Resta da vedere che cosa succede davvero nell’attimo fra il momento in cui apri l’app e quello in cui compare la prima riga di suggerimenti. Nessuna piattaforma calcola un punteggio raffinato per milioni di titoli a ogni visita: i sistemi reali lavorano a due stadi, e li descrissero pubblicamente gli ingegneri di YouTube nel 2016 [CAS16].
Un concorso ha un milione di iscritti e una giuria di dieci persone. Nessuna giuria può ascoltare un milione di candidati: si fa una scrematura rapidissima e grossolana, che da un milione ne tiene qualche centinaio, e poi la giuria vera ascolta solo quelli. Chi consiglia i video fa la stessa cosa, e la fa da capo ogni volta che apri l’app, in una frazione di secondo.
Il primo tempo (nel gergo, il primo stadio) è la scrematura, e deve essere velocissima, quindi il lavoro grosso è già stato fatto la notte prima: per ogni titolo del catalogo la scheda di numeri è già lì, calcolata e messa in uno scaffale ordinato. Conta da che cosa è fatta, quella scheda: se la si ricava guardando il titolo (di che parla, chi l’ha girato) allora ce l’ha anche un film uscito stanotte; se invece è solo un numero cresciuto a forza di visioni, un film che nessuno ha ancora guardato resta senza. Quando arrivi tu, si calcola solo la tua scheda, tenendo conto anche di quello che hai guardato oggi, e poi si cerca sullo scaffale quali schede di titoli le somigliano di più. Questa ricerca è approssimata nel senso che non le guarda tutte: sullo scaffale le schede che si somigliano stanno vicine, e questo permette di scartare interi ripiani senza aprirli. Ogni tanto ci si perde per strada un titolo buono, e in cambio si va enormemente più veloci: è un baratto che conviene quasi sempre, e quello che si perde qui non lo recupera nessuno più avanti.
Il secondo tempo è la giuria: sulle poche centinaia di superstiti si può finalmente spendere del calcolo, e lì entra tutto ciò che il primo tempo non poteva guardare, cioè che ore sono, da che dispositivo stai guardando, quante volte quel titolo ti è già stato messo davanti senza che tu lo aprissi. È qui che si decide l’ordine di quello che vedi.
Il primo stadio, il retrieval, screma il catalogo da milioni a qualche centinaio di candidati con un modello volutamente semplice. Lo schema che si è imposto è la two-tower: due reti separate producono l’una l’embedding dell’utente, l’altra quello dell’item a partire dalle sue feature, e il punteggio è il loro prodotto scalare. La separazione è il punto: gli embedding degli item si precalcolano tutti offline, e a richiesta basta cercare, in modo approssimato, il massimo prodotto scalare fra quelli precalcolati: è il prodotto scalare della sezione precedente, riabilitato dall’efficienza. Con \(m\) oggetti ed embedding di dimensione \(k\), il punteggio esatto di tutto il catalogo costa \(O(mk)\) per richiesta, e un indice approssimato lo rende sublineare in \(m\); una rete che riceve utente e oggetto insieme, con \(c\) moltiplicazioni per coppia, costa \(O(mc)\) e non ammette indici, perché niente di ciò che calcola si può preparare senza conoscere l’utente. Un MLP \(128 \to 64 \to 32 \to 1\) fa \(128 \cdot 64 + 64 \cdot 32 + 32 = 10.272\) moltiplicazioni per coppia: su \(m = 10^7\) oggetti sono circa \(10^{11}\) per ogni richiesta, contro \(6{,}4 \cdot 10^8\) del prodotto scalare esatto con \(k = 64\). È l’argomento di costo di Rendle e colleghi [RKZA20]. Cercare il massimo prodotto scalare non è però cercare il vicino più prossimo, e le due cose coincidono solo se gli embedding degli item hanno tutti la stessa norma. Il divario si colma con una componente in più [BFGB+14]: con \(M = \max_i \lVert\mathbf{e}_i\rVert\), gli embedding estesi \(\tilde{\mathbf{e}}_i = \big(\sqrt{M^2 - \lVert\mathbf{e}_i\rVert^2},\, \mathbf{e}_i\big)\) e \(\tilde{\mathbf{e}}_u = (0,\, \mathbf{e}_u)\) danno \(\lVert\tilde{\mathbf{e}}_u - \tilde{\mathbf{e}}_i\rVert^2 = \lVert\mathbf{e}_u\rVert^2 + M^2 - 2\,\mathbf{e}_u^\top\mathbf{e}_i\), e il vicino più prossimo nello spazio esteso è l’oggetto con il prodotto scalare più alto. Gli indici approssimati (a grafo, a quantizzazione) lavorano su questo spazio, o su varianti costruite apposta. Il secondo stadio, il ranking, applica ai soli sopravvissuti un modello ricco quanto si vuole, con centinaia di feature di contesto (ora, dispositivo, storia recente).
Le attribuzioni vanno separate, perché la letteratura le confonde spesso. Covington et al. 2016 descrivono i due stadi e il recupero per prodotto scalare con vicini approssimati, e in quel paper il modello di candidate generation è una rete sola, sull’utente: i vettori dei video sono i pesi dello strato softmax di uscita, non l’uscita di una seconda torre. La two-tower propriamente detta, con una rete anche sul lato item e la correzione del bias di campionamento che la rende addestrabile su cataloghi enormi, si afferma negli anni successivi [YYH+19]. La differenza non è terminologica: una torre che legge le feature dell’item sa dare un embedding anche a un item mai visto, un peso appreso per identificativo no, ed è esattamente la partenza a freddo.
L’addestramento tratta il recupero come una classificazione sull’intero catalogo, \(P(i \mid u) = e^{s(u,i)} / \sum_{j \in \mathcal{I}} e^{s(u,j)}\), con \(s(u,i) = \mathbf{e}_u^\top \mathbf{e}_i\) il prodotto scalare fra le uscite delle due torri, e il denominatore, che somma su milioni di item, si approssima con gli altri item dello stesso batch usati come negativi. Quei negativi non sono uniformi: un item compare nei batch in proporzione a quanto è popolare, e la softmax campionata finisce per penalizzare proprio i titoli popolari. La correzione di Yi e colleghi sottrae al punteggio il logaritmo della probabilità di campionamento, \(s^{c}(u,j) = s(u,j) - \log p_j\), con \(p_j\) stimata in streaming dalla frequenza dell’item [YYH+19].
Il modello, poi, è solo una parte del sistema. Gli embedding degli oggetti vanno ricalcolati e l’indice ricostruito a ogni aggiornamento, e un indice vecchio di una settimana non contiene i titoli usciti nel frattempo né i gusti cambiati: consiglia benissimo la settimana scorsa.
Suggerire o pilotare?#
Resta la domanda che accompagna i sistemi di raccomandazione fin dalla matrice vuota: un sistema che decide cosa vedi, e impara da ciò che vedi, ti sta servendo o ti sta plasmando? Nel 2011 l’attivista Eli Pariser ha dato un nome alla paura [Par11]: filter bubble, la bolla in cui l’algoritmo, inseguendo i tuoi click, ti mostra sempre più di ciò che già pensi. Lo studio di Flaxman, Goel e Rao sul consumo di notizie online ha restituito un quadro meno netto, e per certi versi sorprendente [FGR16]. Non riguarda un sistema di raccomandazione addestrato sui click, ma i canali che ordinano gli articoli per chi legge, cioè i motori di ricerca e i social. Le domande che fa sono due, e conviene tenerle separate. La prima è quanto i lettori sono distanti fra loro: Flaxman e colleghi danno a ogni giornale un posto su una riga che va da sinistra a destra, a ogni lettore il posto medio dei giornali che legge, e trovano che chi arriva agli articoli dai motori di ricerca o dai social sta, in media, più lontano dagli altri lettori di chi va dritto sul sito del giornale. Su questa domanda la bolla c’è. La seconda è quanto spesso ciascuno incontra l’altra campana, e qui il risultato si rovescia: le stesse persone, proprio passando di lì, finiscono più spesso anche su articoli della parte politica che gradiscono meno.
Resta però vero il meccanismo da cui è nata la paura di Pariser, il feedback loop già incontrato: il modello impara da dati che il modello stesso ha filtrato, come discusso nella sezione Quando i dati cambiano.
Il punto critico non è la tecnica, è la metrica. Un sistema addestrato a massimizzare i minuti di visione imparerà, con perfetta onestà matematica, a mostrare tutto ciò che ci tiene incollati allo schermo: l’indignazione e il sensazionalismo compresi, se funzionano. Chi sceglie il metro su cui il sistema viene premiato (la funzione obiettivo, come si dice in gergo) sceglie, in ultima analisi, il comportamento che il sistema coltiverà nei suoi utenti: è qui che passa il confine tra suggerire e pilotare. Le contromisure esistono e sono concrete. Si può misurare, accanto a quanto il sistema ci azzecca, anche quanto la lista è varia e quanto spesso fa incontrare qualcosa di buono che non si stava cercando, e quest’ultima si chiama serendipità. Si possono mettere controlli espliciti nelle mani di chi il sistema lo usa. E da qualche anno c’è anche la legge: in Europa il Digital Services Act (all’articolo 38) impone alle piattaforme e ai motori di ricerca di dimensioni molto grandi di offrire, per ciascuno dei loro sistemi di raccomandazione, almeno un’opzione che non si basi sulla profilazione, cioè sulla ricostruzione dei gusti di ciascuno a partire da quello che ha fatto.
Nessuna di queste è una soluzione definitiva. Ma sapere che il consiglio nasce da un prodotto scalare fra vettori a cui nessuno ha dato un nome, che la lista è già stata scremata prima che tu arrivassi, e che il sistema insegue il metro su cui è stato premiato, è ciò che trasforma «me l’ha consigliato l’app» in una frase che si può discutere. Da questa parte dello schermo non si progetta niente, ma si può smettere di prendere la vetrina per il catalogo.
Da ricordare
Il NCF cambia il giudice: invece di confrontare le due schede voce per voce con una regola fissa, le incolla una sotto l’altra e lascia decidere a una piccola rete. In teoria vede combinazioni che la regola fissa non coglie; alla prova dei fatti il vecchio confronto, tarato con cura, resta un avversario durissimo: la libertà in più ha un prezzo, perché la rete deve imparare dai dati ciò che la regola fissa sa già. Il caso non è isolato: rifacendo i conti di diciotto metodi neurali, sette si sono lasciati riprodurre e sei di quei sette venivano spesso battuti da metodi molto più semplici.
La tabella dei voti si può disegnare: utenti da una parte, film dall’altra, una linea per ogni visione. Raccomandare vuol dire indovinare le linee che ancora non ci sono. Camminando sul disegno per più passi si raccoglie anche il segnale lontano, e LightGCN mostra che per farlo non serve una rete sopra: basta camminare. Che camminare batta una fattorizzazione ben tarata, però, dipende dai dati.
Quando non ci sono voti ma solo ciò che l’utente ha guardato, non si prevede un numero, si sistema una vetrina: ciò che ha scelto deve stare più in alto di un titolo preso a caso fra i mille che ha ignorato (BPR). Conta l’ordine, non quanto gli piace ogni titolo.
Una classifica si misura su quanti dei consigli mostrati sono azzeccati (precision), su quanti dei titoli buoni ha ritrovato (recall) e su quanto in alto li ha messi (NDCG). Ma prima ancora conta su che cosa si misura: si nasconde una parte di ciò che l’utente ha davvero guardato e si controlla se il modello la ritrova. Ribaltano la classifica dei metodi sia il modo di nascondere, sia il numero di titoli contro cui il nascosto deve farsi largo, ed è la parte più fragile del mestiere.
Quella tabella non ha un orologio: il film di ieri sera e quello di dieci anni fa pesano uguale, mentre chi ha appena comprato una tenda da campeggio è, per qualche giorno, una persona diversa. I modelli che guardano la storia in ordine la trattano come una frase da continuare, e il più recente non è per forza il migliore.
I sistemi veri lavorano in due tempi: un primo filtro rapido e grossolano che da milioni di titoli ne tiene qualche centinaio, poi un giudizio accurato sui soli superstiti.
Il metro che scegli plasma il sistema, e chi lo usa: premiato sui minuti di visione, imparerà tutto ciò che trattiene. Il confine tra suggerire e pilotare passa da lì.
Da ricordare
Il NCF sostituisce il prodotto scalare con un MLP sulla concatenazione degli embedding: più espressivo in teoria, ma un prodotto scalare ben tarato lo batte. Il prodotto scalare è un bias induttivo che l’MLP deve ricostruire dai dati, e impararlo richiede molta capacità e molti dati; in più ammette il recupero con indici approssimati, che una rete su utente e oggetto insieme non ammette. Che il fenomeno sia sistemico lo documenta un riesame di diciotto metodi neurali: dei sette riproducibili, sei venivano spesso battuti da euristiche semplici.
La matrice di interazione è il grafo bipartito utente-oggetto, e leggerla come link prediction (prevedere gli archi mancanti) è una riformulazione feconda, non la definizione del problema. Propagare sul grafo raccoglie segnale a più salti; LightGCN mostra che basta la propagazione, senza rete sopra, e il suo +16% è misurato su NGCF, non su una fattorizzazione ritarata. Contro metodi classici ben tarati, l’esito dipende dal dataset.
Con feedback implicito si impara a ordinare, non a prevedere voti: la loss BPR \(-\log\sigma(\hat{x}_{uv}-\hat{x}_{uw})\), un’approssimazione liscia dell’AUC per utente, chiede solo che l’item scelto superi quello ignorato, e tratta i non osservati come meno preferiti, non come negativi certi. In codice è
-F.logsigmoid(·): a conti separati, infloat32, \(\sigma(z)\) va a zero per \(z \lesssim -88{,}7\) e il gradiente escenan.Le classifiche si misurano con precision@k, recall@k e NDCG, che premia i successi in cima alla lista. Due decisioni tacite le governano: come si costruisce il test (casuale, leave-one-out, taglio temporale) e su quanti candidati si ordina (catalogo intero o negativi campionati). Entrambe possono invertire l’ordine fra due modelli: con cento negativi su un milione di oggetti, un titolo al posto diecimila entra nei primi dieci della lista campionata praticamente sempre.
La matrice di interazione non ha un asse dei tempi: la raccomandazione sequenziale prevede la prossima interazione come un modello di linguaggio prevede la parola dopo, e il settore ne ha ripercorso la parabola, dalle ricorrenti alla self-attention. L’ordine di pubblicazione non è un ordine di qualità: a parità di funzione di costo SASRec supera BERT4Rec.
I sistemi reali sono a due stadi: retrieval con vicini approssimati su embedding precalcolati, poi ranking fine sui candidati superstiti. I due stadi sono di Covington et al. 2016; la two-tower con una rete anche sul lato item, che è quella che dà un embedding a un item mai visto, viene dopo. Il massimo prodotto scalare si riporta al vicino più prossimo aggiungendo una componente agli embedding.
La metrica scelta plasma il comportamento del sistema, e degli utenti: il confine tra suggerire e pilotare passa dalla funzione obiettivo.
Il metro scelto plasma il sistema che si costruisce, e il modo di dividere i dati per misurare può ribaltare la graduatoria dei metodi: vale ben oltre le classifiche di film. Nella validazione delle serie temporali quella divisione smette di essere una scelta, perché i dati hanno un ordine nel tempo e misurare vuol dire non lasciare che il modello sbirci il futuro che gli si sta chiedendo di prevedere.