


Il filtraggio collaborativo#
C’è un algoritmo di raccomandazione che usiamo da sempre, e non richiede computer: chiedere all’amico giusto. Non a un amico qualunque: a quello con cui, film dopo film, ci siamo sempre trovati d’accordo. Se ha amato gli stessi film che ho amato io, e ne ha visto uno che io non conosco, il suo entusiasmo vale una previsione. Il filtraggio collaborativo è questa idea resa calcolabile: prevedere i gusti di una persona usando i giudizi delle persone che le somigliano. Il dettaglio sorprendente è ciò che ignora: il sistema non sa nulla dei film, né trama, né genere, né regista. Vede solo la tabella dei voti, e gli basta.
Il nome è del 1992, e nasce a Xerox PARC con Tapestry, un sistema che setacciava posta elettronica e newsgroup [GNOT92]. Per decidere cosa far passare guardava le reazioni che altri lettori avevano lasciato sui documenti, e quelle reazioni bisognava scriverle a mano. Due anni dopo GroupLens rese automatico il passaggio successivo, cioè trovare da solo i lettori con i gusti più vicini ai tuoi [RIS+94]. Le due parole dicono esattamente cosa succede. Collaborativo perché ognuno, mettendo un voto, senza saperlo aiuta degli sconosciuti che gli somigliano: nessuno collabora di proposito, eppure il lavoro è collettivo. Filtraggio perché di fronte a un catalogo enorme il mestiere è lasciar passare e non produrre: di centomila titoli te ne arrivano dieci, e il sistema è il setaccio.
La saggezza dei vicini#
La versione più diretta dell’idea si chiama filtraggio collaborativo a vicini (neighborhood-based), dove i «vicini» non sono quelli di casa ma gli utenti che hanno votato come te. E ha due versioni speculari, secondo da dove si comincia: dagli utenti simili, o dagli oggetti simili.

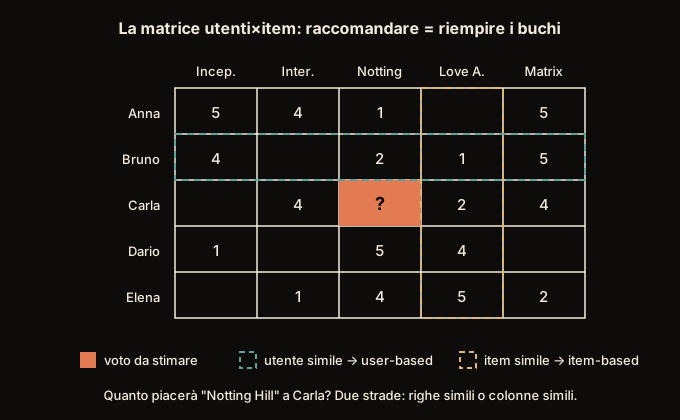
Fig. 33.2 Il compito, in una griglia: quanto piacerà Notting Hill a Carla? Prevedere una cella vuota significa guardare la riga di chi ha votato in modo simile sui film che entrambi hanno visto (nel disegno, la riga di Bruno), oppure la colonna dei film votati in modo simile dalle stesse persone (la colonna di Love Actually). Le due strade hanno un nome inglese ciascuna, user-based e item-based, e qui, seguendo la riga e la colonna che il disegno segna, portano alla stessa previsione, due stelle: il voto di Bruno a Notting Hill per la prima, quello di Carla a Love Actually per la seconda.#
La Fig. 33.2 indica un vicino, non il più simile. La misura di somiglianza più usata è la similarità del coseno della sezione di algebra lineare, calcolata sui soli film che i due hanno votato entrambi: con quella, Carla somiglia a Dario per \(1{,}00\), ad Anna per \(0{,}99\), a Bruno per \(0{,}96\) e a Elena per \(0{,}67\). Nella classifica dei più simili a Carla, Bruno è terzo. E Dario con Carla ha in comune un film solo, il che basta a farlo sembrare identico a lei. Il difetto si vede già su una griglia di venticinque caselle.
Il disegno non rende però la cosa più importante: lì le celle piene sono la maggioranza. In un catalogo vero ognuno ha visto una frazione minuscola dei titoli, quindi due persone qualsiasi hanno pochissimi film in comune su cui misurare la somiglianza. Quel vuoto è la difficoltà vera del mestiere, e da lì nasce il bisogno di riassumere ogni utente e ogni film in un vettore di pochi numeri, che è la mossa della fattorizzazione.
Da utente a utente. Per consigliare Notting Hill a Carla cerco i suoi «gemelli di gusto»: le persone che le hanno dato voti simili sui film che entrambi hanno visto. I film che uno dei due non ha visto restano fuori dal conto: una casella vuota dice «non l’ho visto», non «non mi è piaciuto».
Di gemelli ce n’è più d’uno e non li ascolto tutti: prendo i pochi più somiglianti fra quelli che il film l’hanno visto, e faccio la media dei loro voti, pesata in modo che i gemelli quasi perfetti contino più dei sosia approssimativi. Con pesi scelti per fare i conti tondi (sulla griglia della Fig. 33.2 verrebbero diversi), mettiamo che Bruno somigli a Carla con un peso di \(0{,}9\) e abbia dato 2, ed Elena molto meno, peso \(0{,}2\), e abbia dato 4. La previsione non è la media dei due voti, che sarebbe 3: è \((0{,}9 \cdot 2 + 0{,}2 \cdot 4) / (0{,}9 + 0{,}2) \approx 2{,}4\) (per la precisione \(2{,}36\)), cioè quasi il voto di Bruno.
Restano due ritocchi, e senza di quelli il conto sbaglia in modo prevedibile. Il primo riguarda chi ha pochi film in comune con Carla. Il conto della somiglianza guarda le proporzioni fra i voti più che i voti: chi ha dato 4 e 2 a due film e chi ha dato 2 e 1 risultano identici, perché per tutti e due il primo film vale il doppio del secondo. Con un film solo in comune non c’è nessuna proporzione da confrontare, e il conto risponde «identici» comunque, a chi ha dato 1 come a chi ha dato 5. Per questo il peso di un vicino si sconta in base a quanti film ha in comune con Carla: Dario, che ne ha uno solo, non può contare quanto chi ne ha cinquanta, e sotto una manciata conviene rispondere che non si sa.
Il secondo riguarda il metro. C’è chi dà 5 a tutto e chi non supera mai il 3, e un 2 da chi di media dà 4 è una stroncatura, un 3 da chi di media dà 2 è un elogio. Nella media allora non entrano i voti ma gli scarti di ciascuno dalla propria media, e il risultato si somma alla media di Carla. Bruno di media dà 3, e il suo 2 a Notting Hill è uno scarto di \(-1\); anche Elena di media dà 3, e il suo 4 vale \(+1\). Con i pesi di prima la media degli scarti fa \((0{,}9 \cdot (-1) + 0{,}2 \cdot 1) / (0{,}9 + 0{,}2) \approx -0{,}64\), e Carla, che di media dà \(3{,}3\), riceve una previsione di circa \(2{,}7\).
Da oggetto a oggetto. Si può ribaltare il punto di vista: invece di cercare utenti simili, cerco film simili; dove «simili» non significa stesso genere, ma «votati in modo simile dalle stesse persone». È il celebre «chi ha comprato questo ha comprato anche…» di Amazon: per stimare quanto ti piacerà un film, guardo i voti che tu hai dato ai film che gli somigliano. Questa variante ha un pregio pratico: i gusti delle persone cambiano, le somiglianze tra film sono più stabili e si possono calcolare in anticipo, una volta per tutte.
Ogni utente \(u\) è rappresentato dalla riga \(\mathbf{r}_u\) della matrice dei voti, un vettore con una componente per film (quasi tutte mancanti). La somiglianza fra due utenti è la similarità del coseno incontrata nella sezione di algebra lineare, ristretta all’insieme \(\mathcal{I}_{uv}\) dei film votati da entrambi:
Restringere a \(\mathcal{I}_{uv}\) ha ragioni strutturali. Sui vettori interi il coseno si può calcolare solo dopo aver deciso cosa mettere nelle componenti mancanti, e la scelta corrente per il coseno «pieno», imputare zero, mette il non visto sotto al peggiore dei voti possibili, che su una scala da 1 a 5 parte da 1: imputare zero è una decisione di modellazione, non una necessità.
Il voto previsto per l’utente \(u\) sul film \(i\) è la media dei voti dei vicini, pesata per la somiglianza:
dove \(\mathcal{N}_i(u)\) è il vicinato di \(u\), cioè i pochi utenti (tipicamente qualche decina) più simili a \(u\) fra quelli che hanno votato \(i\), e \(r_{vi}\) è il voto del vicino \(v\). Il vicinato non lo chiamiamo \(k\), come farebbe la tradizione dei \(k\) vicini più prossimi: quella lettera serve qui al numero di fattori latenti, che è tutt’altro conteggio.
C’è un guasto in agguato in questa formula, e non è quello che si direbbe. Con \(|\mathcal{I}_{uv}| = 0\) la similarità non è definita e i due utenti semplicemente non si vedono, cioè un falso negativo, sgradevole ma riconoscibile. Con \(|\mathcal{I}_{uv}| = 1\) la formula restituisce \(\mathrm{sim}(u,v) = 1\) sempre, qualunque siano i due voti: anche se uno ha dato 1 e l’altro 5, il numeratore e il denominatore coincidono. Il metodo fabbrica cioè un gemello perfetto, con peso massimo nella media, a partire da nessuna evidenza; e centrare i voti sposta il guasto di un passo invece di chiuderlo, perché su un film solo la correlazione di Pearson non è nemmeno definita, e su due vale \(\pm 1\) ogni volta che lo è.
Quanto spesso capiti lo dice un conto semplice. Due utenti con \(n_u\) e \(n_v\) voti sparsi a caso su \(m\) film ne hanno in comune, in media, \(n_u n_v / m\); la popolarità, che concentra i voti sugli stessi titoli, alza il conto. Su MovieLens 100K, con \(106\) voti a testa in media su \(1.682\) film, il conto uniforme dà quasi sette, e le coppie con uno o due film in comune sono una minoranza di quelle che ne hanno almeno uno. Sui voti finti del paragrafo sul modello in PyTorch, sedici a testa su duecento film, dà \(1{,}3\), e sono la grande maggioranza. A decidere è il numero di voti di ciascuno più che la densità, che nei due casi è simile. Nei cataloghi industriali, con qualche decina di interazioni per utente su milioni di oggetti, il conto uniforme scende molto sotto uno, e in quel conto una coppia che un oggetto in comune ce l’ha quasi sempre ne ha uno solo. Il correttivo standard è lo smorzamento per numerosità (shrinkage, nella forma di Koren [Kor08]; Herlocker e colleghi, col nome di significance weighting, usavano invece \(\min(|\mathcal{I}_{uv}|, 50)/50\) [HKBR99]): si moltiplica la similarità per \(\frac{|\mathcal{I}_{uv}|}{|\mathcal{I}_{uv}| + \beta}\), con \(\beta\) da tarare sui dati (in letteratura si va da qualche decina al centinaio), così una somiglianza vista su due film pesa una frazione di una vista su cinquanta; in alternativa si impone una soglia minima su \(|\mathcal{I}_{uv}|\) e sotto quella soglia si dichiara di non sapere.
Questa forma media voti grezzi, e i voti grezzi non sono confrontabili da persona a persona: c’è chi dà 5 a tutto e chi non supera mai il 3. Sottrarre a ciascuno la propria media è il correttivo standard, e si applica in due punti indipendenti, che conviene non confondere. Nella predizione si media lo scarto di ogni vicino dalla propria media, e il risultato si riporta sulla scala di \(u\):
Nella similarità, invece, centrare cambia la metrica, e le cambia il nome: se la media sottratta è calcolata sui soli film di \(\mathcal{I}_{uv}\) si ottiene esattamente la correlazione di Pearson; se è la media di tutti i voti dell’utente si ottiene il coseno centrato (mean-centered cosine), variante vicina ma distinta. Le due centrature sono ortogonali: si possono adottare entrambe, una sola, o nessuna. Qui si incontra una collisione di nomi che costa un pomeriggio. GroupLens calcolava medie e somme sui soli articoli votati da entrambi [RIS+94], cioè la Pearson vera; Breese, Heckerman e Kadie, che citano GroupLens come fonte della formula, sottraggono invece la media di tutti i voti dell’utente [BHK98], e buona parte della letteratura successiva chiama «correlazione di Pearson» anche la seconda variante. Lo stesso nome copre due formule diverse a seconda di chi lo scrive.
La variante item-based lavora sulle colonne della matrice [SKKR01]. Per la similarità fra due film Sarwar e colleghi trovano migliore il coseno aggiustato (adjusted cosine), che sottrae a ogni voto la media di chi l’ha dato, cioè la centratura sull’utente appena vista, applicata alle colonne:
dove \(\mathcal{U}_{ij}\) sono gli utenti che hanno votato sia \(i\) sia \(j\) e \(\bar{r}_u\) è la media di tutti i voti di \(u\). La previsione è la media dei voti di \(u\) sui film più simili a \(i\) fra quelli che ha votato, pesata per la similarità: \(\hat{r}_{ui} = \sum_{j \in \mathcal{N}_u(i)} \mathrm{sim}(i,j)\, r_{uj} \big/ \sum_{j \in \mathcal{N}_u(i)} \lvert \mathrm{sim}(i,j) \rvert\).
In produzione è spesso preferita, ed è la scelta con cui Amazon ha fatto girare il proprio motore [LSY03], e la ragione è di costo. La variante user-based deve confrontare \(u\) con tutti gli altri utenti a ogni richiesta, o tenere una matrice di similarità utente per utente che cambia a ogni voto. Le similarità fra oggetti sono più stabili nel tempo e si precalcolano offline: un utente con \(n_u\) voti contribuisce a \(O(n_u^2)\) coppie di film, per un totale di \(O(\sum_u n_u^2)\), e a richiesta resta solo da scorrere i vicini dei pochi film già votati dall’utente.
I vicini funzionano, e per anni hanno fatto girare i primi sistemi commerciali. Ma soffrono la sparsità in due modi. Due utenti con gusti simili e nessun film in comune hanno similarità non definita, e il metodo non li collega. Due utenti con un solo film in comune risultano identici qualunque voto abbiano dato, perché il coseno confronta direzioni e un vettore di una componente positiva punta sempre dalla stessa parte: \((4)\) e \((1)\) hanno similarità \(1\) come \((4, 2)\) e \((2, 1)\). Le due cause sono una sola: la similarità si calcola soltanto sui film votati da entrambi, e in una matrice quasi vuota sono pochi. Serve un modo di confrontare due utenti che non passi da lì.
Fattori latenti: la matrice compressa#
Invece di confrontare fra loro le righe e le colonne della matrice, la fattorizzazione di matrici (matrix factorization) parte da un’ipotesi: la matrice dei voti \(\mathbf{R}\) ha rango effettivo basso, cioè i gusti di tutti si spiegano con pochi tratti latenti. Si cercano allora due matrici strette, \(\mathbf{P}\) con una riga per utente e \(\mathbf{Q}\) con una riga per film, tutte e due con \(k\) colonne, il cui prodotto \(\mathbf{P}\mathbf{Q}^\top\) approssimi \(\mathbf{R}\) nelle celle note (Fig. 33.3). Come \(12 = 3 \times 4\) scompone un numero in due fattori, \(\mathbf{R} \approx \mathbf{P}\mathbf{Q}^\top\) scompone una matrice in due matrici più piccole. Le righe \(\mathbf{p}_u\) di \(\mathbf{P}\) e \(\mathbf{q}_i\) di \(\mathbf{Q}\) si chiamano vettori latenti, o embedding, e il voto previsto è il loro prodotto scalare. Al Netflix Prize questi modelli si dimostrarono superiori ai metodi a vicinato [KBV09].

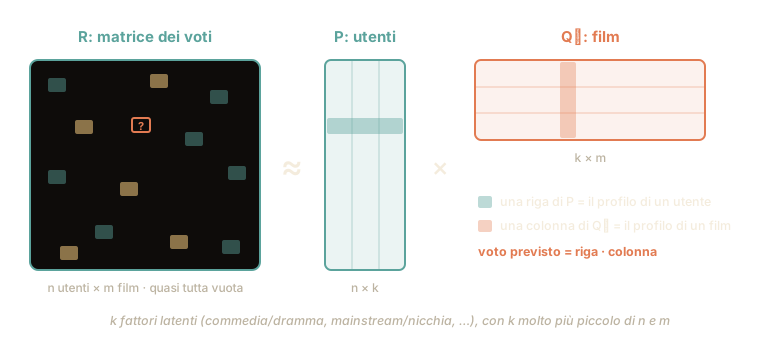
Fig. 33.3 La matrice dei voti \(\mathbf{R}\), \(n\) utenti per \(m\) film e quasi tutta vuota, è approssimata da \(\mathbf{P}\mathbf{Q}^\top\): \(\mathbf{P}\) ha una riga per utente, \(\mathbf{Q}\) una riga per film, tutte e due con \(k \ll \min(n, m)\) colonne, e la trasposta \(\mathbf{Q}^\top\) mette i film sulle colonne perché il prodotto combaci. Il voto previsto per \((u, i)\) è il prodotto scalare della riga \(u\) di \(\mathbf{P}\) e della colonna \(i\) di \(\mathbf{Q}^\top\); il modello completo aggiunge la media globale e due correzioni, una per utente e una per film.#
Ogni film si può descrivere con poche «manopole»: quanto è commedia e quanto dramma, quanto è mainstream e quanto di nicchia, quanto punta sull’azione. E ogni persona con le stesse manopole. La previsione diventa un confronto fra le due schede, voce per voce. Anna ha «commedia \(0{,}9\), azione \(0{,}1\)», un film ha «commedia \(0{,}8\), azione \(0{,}2\)»: l’affinità è \(0{,}9 \cdot 0{,}8 + 0{,}1 \cdot 0{,}2 = 0{,}74\). Con un film d’azione puro («commedia \(0{,}1\), azione \(0{,}9\)») verrebbe \(0{,}9 \cdot 0{,}1 + 0{,}1 \cdot 0{,}9 = 0{,}18\), e il primo è più di quattro volte il secondo.
L’affinità però non è ancora un voto in stelle. Ci si arriva dal voto medio del sito, corretto due volte: di quanto quella persona vota alto o basso rispetto a tutti, e di quanto quel film è apprezzato rispetto a tutti. Se sul sito si danno in media \(3{,}4\) stelle, Anna sta mezza stella sotto e il film quattro decimi sopra, la previsione è \(3{,}4 - 0{,}5 + 0{,}4 + 0{,}74 = 4{,}04\). Tolto di mezzo il facile, alle manopole resta l’incontro fra quella persona e quel film.
E qui questa strada batte quella dei gemelli di gusto: la scheda c’è anche per due persone senza un film in comune, e la tabella larga diecimila colonne diventa una scheda lunga venti.
Il colpo di scena è che le manopole non le sceglie nessuno. Nessun esperto etichetta i film: l’algoritmo riceve solo la tabella dei voti e cerca da sé i numeri da mettere nelle schede, in modo che i voti già dati tornino. E non sono numeri fra \(0\) e \(1\) come nell’esempio: vengono anche negativi, e una «commedia» negativa dice che quella persona la commedia la evita. I tratti che ne escono, che a guardarli dopo somigliano spesso a «commedia/dramma» o «mainstream/nicchia», sono per questo detti fattori latenti: nascosti nei dati, mai dichiarati da nessuno.
E le caselle vuote? Riempirle di zeri sarebbe un disastro: su una scala che parte da 1, uno zero direbbe «peggio del peggio», mentre una casella vuota dice «non lo so». L’algoritmo infatti non le guarda: cerca le manopole che fanno tornare i voti che ci sono, e sulle vuote dice il numero che ne viene fuori.
Resta il caso in cui nessuno mette stelle: su molti siti si sa soltanto che cosa uno ha aperto, e quante volte. Lì la casella vuota cambia mestiere: smette di dire «non lo so» e diventa l’unica cosa che somigli a un no, perché tutto il resto è un sì. Allora nessuna casella resta fuori dal conto, e ognuna riceve, oltre al suo sì o al suo no, un secondo numero: quanto ci si crede. Chi ha rivisto una serie dieci volte è un sì solido; chi non l’ha mai aperta è un no debolissimo, perché magari nessuno gliel’ha proposta.
A ogni utente \(u\) si associa un vettore \(\mathbf{p}_u \in \mathbb{R}^k\) e a ogni film \(i\) un vettore \(\mathbf{q}_i \in \mathbb{R}^k\), con \(k\) dell’ordine delle decine, contro le decine di migliaia di colonne della matrice originale. Il voto previsto è
dove \(\mu\) è la media globale dei voti, \(b_u\) il bias dell’utente (quanto vota sopra o sotto la media), \(b_i\) il bias del film (quanto è votato sopra o sotto la media), e il prodotto scalare \(\mathbf{p}_u^\top \mathbf{q}_i\) cattura l’interazione personale tra i gusti di \(u\) e i tratti di \(i\). I parametri si stimano minimizzando l’errore quadratico sui soli voti osservati \(\mathcal{K}\), con regolarizzazione \(L_2\):
dove \(\lambda\) governa il compromesso tra aderenza ai voti noti e semplicità dei fattori. Il vincolo «solo celle osservate» è ciò che distingue questo problema dalla SVD dell’algebra lineare. Su una matrice completa la migliore approssimazione di rango \(k\) in norma di Frobenius ha forma chiusa, la SVD troncata: è il teorema di Eckart e Young della sezione su ortogonalità e proiezioni. Con i buchi quella forma chiusa non c’è più: minimizzare l’errore sulle sole celle osservate è un’approssimazione di rango basso pesata (peso \(1\) sulle celle note, \(0\) sulle altre), non convessa e NP-difficile già per rango uno [GG11]: nella pratica ci si accontenta di un minimo locale. Riempire i buchi di zeri per tornare alla SVD vorrebbe dire dichiarare che ogni film non visto vale zero stelle. Nella fattorizzazione per feedback esplicito i buchi sono incognite, e restano fuori dalla somma; che nel gergo del Netflix Prize il metodo si chiami ancora «SVD» è un’eredità del nome slegata dalla matematica. Lo rese popolare Simon Funk, che l’11 dicembre 2006 descrisse in un post come addestrarlo con la discesa del gradiente sui soli voti noti, un fattore alla volta [Fun06].
Il «solo celle osservate» vale però per il feedback esplicito, e non è una proprietà generale della raccomandazione: sull’implicito il metodo canonico fa l’opposto. Hu, Koren e Volinsky osservano che concentrarsi sul solo feedback raccolto lascerebbe in mano soltanto esempi positivi, e che il segnale negativo, tale e quale, sta proprio nelle celle mancanti [HKV08]. Il loro modello introduce allora due quantità distinte, e per non far collidere le lettere chiamiamo \(\pi_{ui}\) la prima: una preferenza \(\pi_{ui} = \mathbb{1}[n_{ui} > 0]\), che vale \(1\) se un’interazione c’è stata, e una confidenza \(c_{ui} = 1 + \alpha\, n_{ui}\), che dice quanto crediamo a quella preferenza (chi ha guardato una serie dieci volte è un caso più solido di chi l’ha aperta una sera). Qui \(n_{ui}\) non è un voto ma il conteggio delle interazioni, che è tutto ciò che il feedback implicito lascia. Si minimizza
dove la somma corre su tutte le celle, osservate e no. È un cambio di regime radicale: i termini diventano miliardi, la discesa stocastica sulle triple non è più praticabile per questa loss, e i minimi quadrati alternati (ALS) smettono di essere un’alternativa di gusto. Fissati i \(\mathbf{q}_i\), ogni \(\mathbf{p}_u\) ha la soluzione chiusa \(\mathbf{p}_u = (\mathbf{Q}^\top \mathbf{C}^u \mathbf{Q} + \lambda \mathbf{I})^{-1} \mathbf{Q}^\top \mathbf{C}^u \boldsymbol{\pi}_u\), dove \(\mathbf{Q}\) ha i \(\mathbf{q}_i^\top\) per righe, \(\mathbf{C}^u = \mathrm{diag}(c_{u1}, \dots, c_{um})\) e \(\boldsymbol{\pi}_u\) è il vettore delle preferenze di \(u\). Il trucco che la rende praticabile è l’identità \(\mathbf{Q}^\top \mathbf{C}^u \mathbf{Q} = \mathbf{Q}^\top \mathbf{Q} + \mathbf{Q}^\top (\mathbf{C}^u - \mathbf{I}) \mathbf{Q}\): il primo termine è lo stesso per tutti gli utenti e si calcola una volta, in \(O(m k^2)\), e \(\mathbf{C}^u - \mathbf{I}\) è diversa da zero solo sulle \(n_u\) interazioni di \(u\), come \(\boldsymbol{\pi}_u\). Un utente costa quindi \(O(n_u k^2 + k^3)\) invece che \(O(m k^2)\), e un passaggio completo su utenti e oggetti \(O(k^2 |\mathcal{S}| + k^3 (n + m))\), con \(\mathcal{S}\) l’insieme delle interazioni: lineare nei dati, non nel numero delle celle. Qui \(\lambda\) non porta il peso \(n_u\) della versione per il caso esplicito. Il metodo si chiama iALS, ha quasi vent’anni ed è tutt’altro che un cimelio: ritarato con cura regge il confronto con i metodi più recenti sui banchi di prova su cui quei metodi erano stati presentati [RKZK22].
Per ottimizzare il caso esplicito resta la scelta fra due algoritmi. La discesa stocastica passa sulle triple \((u, i, r_{ui})\) una alla volta: calcolato l’errore \(e_{ui} = r_{ui} - \hat{r}_{ui}\), aggiorna \(b_u \leftarrow b_u + \eta\,(e_{ui} - \lambda b_u)\), \(b_i \leftarrow b_i + \eta\,(e_{ui} - \lambda b_i)\), \(\mathbf{p}_u \leftarrow \mathbf{p}_u + \eta\,(e_{ui}\,\mathbf{q}_i - \lambda\,\mathbf{p}_u)\) e \(\mathbf{q}_i \leftarrow \mathbf{q}_i + \eta\,(e_{ui}\,\mathbf{p}_u - \lambda\,\mathbf{q}_i)\), al costo di \(O(k)\) per voto [KBV09]. ALS risolve invece in forma chiusa alternando \(\mathbf{P}\) e \(\mathbf{Q}\): fissata \(\mathbf{Q}\), ogni \(\mathbf{p}_u\) è una regressione ridge sui film che \(u\) ha votato. Trascurando per brevità i bias, dette \(\mathbf{Q}_u\) la matrice delle righe \(\mathbf{q}_i^\top\) di quei film e \(\tilde{\mathbf{r}}_u\) il vettore dei voti corrispondenti,
dove \(n_u\) è il numero di voti dell’utente (da non confondere con il numero \(n\) degli utenti). Quel fattore \(n_u\) davanti a \(\lambda\) discende dall’aver scritto la penalità dentro la somma sulle coppie osservate, che penalizza ogni \(\mathbf{p}_u\) una volta per ogni suo voto, ed è la weighted-λ-regularization con cui Zhou e colleghi addestrarono l’ALS sui dati del Netflix Prize [ZWSP08]: la penalità cresce con i voti dell’utente, e la scelta di \(\lambda\) dipende meno da quanti voti ha ciascuno. Il costo è \(O(n_u k^2 + k^3)\) per utente, e ogni utente si risolve indipendentemente dagli altri. Il criterio non è di gusto: SGD è più semplice e più veloce sul dato sparso esplicito, ALS si parallelizza meglio e diventa obbligato quando ogni cella conta, come appunto sull’implicito. In nessuno dei due casi c’è la garanzia di arrivare a un minimo globale: il problema è convesso in \(\mathbf{P}\) e in \(\mathbf{Q}\) separatamente (che è precisamente ciò che rende sensato alternare) ma non nei due insieme, e dove si finisce dipende anche da dove si è partiti.
I fattori latenti non hanno un significato fissato in partenza. Il prodotto \(\mathbf{P}\mathbf{Q}^\top\) resta lo stesso se si sostituiscono \(\mathbf{P}\) con \(\mathbf{P}\mathbf{A}\) e \(\mathbf{Q}\) con \(\mathbf{Q}\mathbf{A}^{-\top}\), per ogni matrice invertibile \(\mathbf{A}\) di dimensioni \(k \times k\), perché \(\mathbf{P}\mathbf{A}\,(\mathbf{Q}\mathbf{A}^{-\top})^\top = \mathbf{P}\mathbf{A}\mathbf{A}^{-1}\mathbf{Q}^\top\); con la penalità \(L_2\) restano libere le rotazioni e le riflessioni. Ogni fattore è quindi definito solo a meno di una trasformazione, e nessuna coordinata si può chiamare «commedia» se non dopo averla confrontata con un’etichetta esterna. Per questo una raccomandazione fattorizzata si spiega con difficoltà, e le spiegazioni che si leggono davvero («perché hai visto X») vengono di solito dal lato oggetto-oggetto del filtraggio a vicini.
Il modello in PyTorch#
La palestra classica per questi modelli è MovieLens [HK15], una raccolta di voti veri messa insieme dal sito omonimo del gruppo GroupLens dell’Università del Minnesota, attivo dal 1997. La versione storica, MovieLens 100K, contiene 100.000 voti da 1 a 5 dati da 943 utenti a 1.682 film, con almeno 20 voti per utente: un fratello minore del dataset Netflix, da più di vent’anni banco di prova standard del settore.
Qui però i voti ce li inventiamo noi, così il codice gira all’istante senza scaricare niente. Hanno la stessa forma di quelli veri, cioè un elenco di terzetti (utente, film, voto), e per passare a MovieLens basterebbe leggere il suo file invece di generarli. Restano due differenze, e più avanti servono a spiegare i risultati. I nostri voti li calcola una formula, e vengono numeri con la virgola; quelli di MovieLens li hanno dati delle persone, in stelle intere. E la nostra tabella la faremo piena al 10% circa, cioè più fitta perfino di MovieLens 100K: là i 100.000 voti stanno in una tabella di \(943 \times 1.682\) celle, poco meno di un milione e seicentomila, e la riempiono al 6,3%. Fra i banchi di prova del settore, MovieLens 100K è già uno dei meno vuoti. Su un esempio piccolo come il nostro, con la sparsità vera non resterebbero abbastanza voti per addestrare il modello in trenta secondi.
Il modello è la traduzione letterale dell’idea appena vista.
nn.Embedding(n, k) è una matrice di parametri \(n \times k\) che restituisce la
riga dell’indice che riceve. Nel modello, P e Q contengono i vettori
latenti \(\mathbf{p}_u\) e \(\mathbf{q}_i\), b_u e b_i i bias (la tendenza di
ciascuno a votare, o a essere votato, sopra o sotto la media), e il forward
calcola il prodotto scalare come moltiplicazione elemento per elemento seguita
da una somma.
import torch
from torch import nn

class FattorizzazioneMatrici(nn.Module):
    def __init__(self, n_utenti, n_film, k=32):
        super().__init__()
        self.P = nn.Embedding(n_utenti, k)    # fattori latenti degli utenti
        self.Q = nn.Embedding(n_film, k)      # fattori latenti dei film
        self.b_u = nn.Embedding(n_utenti, 1)  # bias di utente
        self.b_i = nn.Embedding(n_film, 1)    # bias di film
        self.mu = nn.Parameter(torch.tensor(3.0))  # media globale
        nn.init.normal_(self.P.weight, std=0.05)   # si parte quasi dalla media
        nn.init.normal_(self.Q.weight, std=0.05)
        nn.init.zeros_(self.b_u.weight)
        nn.init.zeros_(self.b_i.weight)

    def forward(self, u, i):
        interazione = (self.P(u) * self.Q(i)).sum(dim=1)  # prodotto scalare
        return (self.mu + self.b_u(u).squeeze(1)
                + self.b_i(i).squeeze(1) + interazione)
I nostri voti finti nascono da fattori «veri» nascosti, che il modello non vede: vede solo i terzetti, come vedrebbe i voti di MovieLens.
from torch.utils.data import DataLoader, TensorDataset

torch.manual_seed(0)
n_utenti, n_film, k_vero = 300, 200, 4

P_vero = torch.randn(n_utenti, k_vero)   # gusti "veri", nascosti
Q_vero = torch.randn(n_film, k_vero)     # tratti "veri", nascosti

n_voti = 6_000        # 6.000 voti su 60.000 celle: matrice piena al 10% circa
u = torch.randint(0, n_utenti, (n_voti,))
i = torch.randint(0, n_film, (n_voti,))
affinita = (P_vero[u] * Q_vero[i]).sum(1)
voti = (3 + 1.2 * affinita / affinita.std()).clamp(1, 5)  # scala 1-5

# 80% per imparare, 20% messo da parte: su questi il modello non si addestra,
# e sono gli unici su cui il suo errore vorra' dire qualcosa
perm = torch.randperm(n_voti)
tr, te = perm[:4_800], perm[4_800:]
loader = DataLoader(TensorDataset(u[tr], i[tr], voti[tr]),
                    batch_size=256, shuffle=True)

celle = {*zip(u.tolist(), i.tolist())}
viste = {*zip(u[tr].tolist(), i[tr].tolist())}
ripetute = sum(c in viste for c in zip(u[te].tolist(), i[te].tolist()))
print(f"celle distinte: {len(celle)} su {n_voti} voti")
print(f"voti tenuti da parte su celle gia' viste: {ripetute} su {len(te)}")

# quanti film hanno in comune due utenti, sui voti di addestramento
votato = torch.zeros(n_utenti, n_film)
votato[u[tr], i[tr]] = 1
comuni = (votato @ votato.T).triu(1)    # una cella per ogni coppia di utenti
in_comune = comuni[comuni > 0]
n_coppie = n_utenti * (n_utenti - 1) // 2
print(f"coppie di utenti con almeno un film in comune: "
      f"{len(in_comune) / n_coppie:.0%}")
print(f"  e fra queste, con uno o due soltanto: "
      f"{(in_comune <= 2).float().mean():.0%}")
celle distinte: 5723 su 6000 voti
voti tenuti da parte su celle gia' viste: 91 su 1200
coppie di utenti con almeno un film in comune: 70%
  e fra queste, con uno o due soltanto: 83%
I voti si pescano a caso, quindi la stessa coppia (utente, film) può uscire due volte, e in effetti succede. Sono pochi e non spostano le conclusioni, ma quei 91 voti meritano un nome, perché è lo stesso che il paragrafo su come si misura una classifica, nella raccomandazione neurale, darà a un difetto molto diffuso: sono una fuga di informazione. Su quelle celle il modello non deve indovinare niente, gli basta ricordare, e l’errore che leggeremo fra poco è di quel tanto più basso del vero.
Il conto delle coppie torna invece ai vicini. Su questi voti, sedici a testa su duecento film, il 70% delle coppie di utenti ha almeno un film in comune, e di queste l’83% ne ha uno o due: è il regime in cui la similarità calcolata sui film in comune fabbrica utenti identici, ed è il motivo per cui qui si passa direttamente ai fattori latenti.
L’addestramento è un normale ciclo PyTorch. A ogni epoca (cioè a ogni giro completo sui voti) il modello prevede, calcola di quanto ha sbagliato, e l’ottimizzatore aggiorna i vettori latenti. La misura è l’errore quadratico medio, la MSE incontrata nella sezione sulle metriche. È lo stesso metro del Netflix Prize meno l’ultimo passaggio: l’RMSE è la radice quadrata della MSE che vedremo stampata. Una MSE di \(0{,}35\) vale quindi un errore di circa \(0{,}59\) stelle, perché \(\sqrt{0{,}35} \approx 0{,}59\).
Alla loss si aggiunge la regolarizzazione \(L_2\) della formula, che nel codice è
il weight_decay dell’ottimizzatore: a ogni passo tira i parametri verso lo
zero, e impedisce che crescano a dismisura pur di far tornare i voti già noti.
Qui vale \(10^{-4}\); quanto debba valere si decide dopo, guardando i numeri.
torch.manual_seed(0)                        # la partenza del modello, fissata
modello = FattorizzazioneMatrici(n_utenti, n_film, k=8)
ottim = torch.optim.Adam(modello.parameters(), lr=0.01, weight_decay=1e-4)
criterio = nn.MSELoss()

# il metro di paragone: prevedere per tutti la media dei voti di addestramento
banale = criterio(voti[tr].mean().expand_as(voti[te]), voti[te]).item()

for epoca in range(30):
    for batch_u, batch_i, batch_r in loader:
        pred = modello(batch_u, batch_i)
        loss = criterio(pred, batch_r)      # MSE sui soli voti osservati
        ottim.zero_grad()
        loss.backward()
        ottim.step()
    if (epoca + 1) % 10 == 0:
        with torch.no_grad():               # il modello a fine epoca
            visti = criterio(modello(u[tr], i[tr]), voti[tr]).item()
            fuori = criterio(modello(u[te], i[te]), voti[te]).item()
        print(f"epoca {epoca + 1:2d} · MSE visti {visti:.3f}"
              f" · MSE tenuti da parte {fuori:.3f} · banale {banale:.3f}")
epoca 10 · MSE visti 0.123 · MSE tenuti da parte 0.705 · banale 0.997
epoca 20 · MSE visti 0.034 · MSE tenuti da parte 0.481 · banale 0.997
epoca 30 · MSE visti 0.014 · MSE tenuti da parte 0.348 · banale 0.997
Sui voti di addestramento l’MSE scende a \(0{,}014\), praticamente zero, e da solo
il numero non dimostra niente. Il modello ha
\((300 + 200) \cdot 8 + 500 + 1 = 4.501\) parametri: un vettore di otto numeri
per ciascuno dei 300 utenti e dei 200 film (l’otto è la k=8 del codice, un
po’ più dei quattro fattori con cui i voti sono stati fabbricati, perché nella
vita vera quel numero non lo si conosce), un bias per ciascuno e la media
globale. I voti di addestramento sono \(4.800\): quasi un parametro per voto, e
con tanta libertà un errore basso su quei voti è ciò che ci si aspetta anche da
un modello che li ha soltanto memorizzati.
Il numero che conta è il secondo. Sui voti tenuti da parte, che il modello non ha mai visto, l’MSE si ferma a \(0{,}35\), circa un terzo dello \(0{,}997\) della previsione banale «a tutti il voto medio»: il modello ha imparato qualcosa di vero, anche se in stelle il vantaggio si assottiglia, \(0{,}59\) contro \(1{,}00\). Ma è venticinque volte l’errore sui voti di addestramento, e lo scarto fra i due misura quanto il modello ha memorizzato, cioè l’overfitting della sezione sulla validazione. Per questo il 20% dei voti viene messo da parte prima ancora di cominciare.
Con lo stesso metro si sceglie quanto deve valere weight_decay. Si rifà
l’addestramento da cinque partenze diverse (cinque semi per l’inizializzazione)
con quattro valori in Adam e due in AdamW, una variante di Adam che applica la
regolarizzazione in un altro punto del passo, e per ciascuno si guardano gli
intervalli degli errori sulle cinque partenze e la norma media dei vettori
\(\mathbf{p}_u\), che dice quanto la regolarizzazione li ha accorciati.
def addestra(ottimizzatore, lam, seme):
    torch.manual_seed(seme)
    m = FattorizzazioneMatrici(n_utenti, n_film, k=8)
    ott = ottimizzatore(m.parameters(), lr=0.01, weight_decay=lam)
    for _ in range(30):
        for bu, bi, br in loader:
            loss = criterio(m(bu, bi), br)
            ott.zero_grad()
            loss.backward()
            ott.step()
    with torch.no_grad():
        return (criterio(m(u[tr], i[tr]), voti[tr]).item(),
                criterio(m(u[te], i[te]), voti[te]).item(),
                m.P.weight.norm(dim=1).mean().item())

prove = [(torch.optim.Adam, 0), (torch.optim.Adam, 1e-4),
         (torch.optim.Adam, 1e-3), (torch.optim.Adam, 1e-2),
         (torch.optim.AdamW, 1e-4), (torch.optim.AdamW, 1e-1)]
print(f"{'':5}  {'weight_decay':>12}   {'MSE visti':11}  "
      f"{'MSE tenuti da parte':25}   norma di p_u")
for ottimizzatore, lam in prove:
    esiti = torch.tensor([addestra(ottimizzatore, lam, s) for s in range(5)])
    visti, fuori, norma = esiti.T
    print(f"{ottimizzatore.__name__:5}  {lam:>12g}   "
          f"{visti.min():.3f}-{visti.max():.3f}  "
          f"{fuori.min():.3f}-{fuori.max():.3f} (media {fuori.mean():.3f})"
          f"   {norma.mean():.2f}")
       weight_decay   MSE visti    MSE tenuti da parte         norma di p_u
Adam              0   0.010-0.016  0.396-0.545 (media 0.446)   1.36
Adam         0.0001   0.009-0.014  0.271-0.348 (media 0.315)   1.27
Adam          0.001   0.075-0.077  0.282-0.294 (media 0.289)   1.00
Adam           0.01   0.979-0.979  1.015-1.017 (media 1.016)   0.00
AdamW        0.0001   0.010-0.016  0.396-0.544 (media 0.446)   1.36
AdamW           0.1   0.011-0.015  0.294-0.365 (media 0.323)   1.29
La prima riga è il modello senza regolarizzazione, che sui voti tenuti da parte va da \(0{,}40\) a \(0{,}55\) secondo la partenza. Con \(10^{-4}\) l’errore di addestramento non cambia, ma quello sui voti nuovi scende fra \(0{,}27\) e \(0{,}35\): il peggiore dei cinque modelli regolarizzati batte il migliore dei cinque senza. A \(10^{-3}\) l’errore di addestramento sale a \(0{,}08\), mentre quello sui voti nuovi scende ancora un poco in media (\(0{,}289\) contro \(0{,}315\)) e soprattutto smette di dipendere dalla partenza. A \(10^{-2}\) i vettori latenti finiscono a zero (norma \(0{,}00\)) e il modello non personalizza più: restano la media e i bias, che stimati su sedici voti per utente e ventiquattro per film si portano dietro più rumore che informazione, e l’errore (\(1{,}016\)) supera quello della previsione banale. Il valore buono sta in mezzo, e si cerca sui dati.
Le righe di AdamW dicono un’altra cosa. Con \(10^{-4}\) AdamW dà praticamente gli stessi numeri del modello senza regolarizzazione, e per fargli fare quello che Adam fa con \(10^{-4}\) bisogna scrivergli \(10^{-1}\), mille volte tanto. Lo stesso numero in due ottimizzatori quasi uguali è una regolarizzazione diversa, e la ragione sta nel modo in cui la riga che gira si scosta dalla formula.
La regolarizzazione fa da freno: a ogni ritocco tira un po’ verso lo zero tutte le manopole delle schede. Così una manopola si allontana dallo zero solo se i voti la spingono più forte del freno, e il modello non può inventarsi numeri enormi per far tornare un voto isolato. Quanto stringerlo lo dicono i voti messi da parte: troppo lento, e il modello impara a memoria; troppo stretto, e le manopole restano tutte a zero, cioè il modello dà a ciascuno soltanto la media del sito con i suoi due ritocchi, e sbaglia più di chi desse a tutti il voto medio.
Nel codice, poi, il freno non è proprio quello della formula, per tre ragioni. Frena tutte le manopole a ogni ritocco, anche quelle delle persone e dei film che in quel momento non c’entrano. Frena perfino il numero che tiene la media dei voti del sito, che non andrebbe toccato: quello non inventa niente, constata un fatto. E con Adam la sua forza passa per l’ottimizzatore, che fa passi più o meno della stessa lunghezza qualunque sia la spinta che riceve, e quindi ingrandisce le spinte piccole. La spinta del freno è piccolissima, e Adam la ingrandisce come tutte le altre; AdamW la tiene fuori da quel conto. È per questo che lo stesso numero scritto nel codice frena mille volte di più in Adam che in AdamW.
La riga weight_decay si scosta dalla penalità della formula in tre punti.
Penalizza a ogni passo tutti i parametri, non i soli \(\mathbf{p}_u,
\mathbf{q}_i, b_u, b_i\) delle coppie del batch, mentre nella loss, dove la
penalità sta dentro la somma su \(\mathcal{K}\), ogni \(\mathbf{p}_u\) entra una
volta per ogni suo voto, cioè con peso \(\lambda n_u\). Tocca anche la media
globale \(\mu\), che il regolarizzatore della loss non include, e la attira verso
zero invece che verso la media dei voti. E in Adam il termine \(\lambda\theta\)
entra nel gradiente, \(g = \partial\mathcal{L}/\partial\theta + \lambda\theta\),
e l’aggiornamento \(\theta \leftarrow \theta - \eta\,\hat{m}/(\sqrt{\hat{v}} +
\varepsilon)\) lo divide per la radice del momento secondo, come racconta la
sezione sull’ottimizzazione: il decadimento effettivo vale
circa \(\eta\lambda/\sqrt{\hat{v}}\), diverso per ogni parametro e tanto più
forte quanto più piccoli sono i suoi gradienti. AdamW
[LH19] lo applica invece ai pesi, \(\theta \leftarrow
\theta(1 - \eta\lambda)\), fuori dalla normalizzazione. Con \(\eta = 0{,}01\) e
\(\lambda = 10^{-4}\) è un fattore \(1 - 10^{-6}\) per passo, e nei \(570\) passi
dell’addestramento (\(30\) epoche da \(19\) batch) i pesi cambiano di meno di un
millesimo: per questo AdamW a \(10^{-4}\) dà praticamente gli stessi numeri del
modello senza regolarizzazione. Che gli serva un \(\lambda\) mille volte più
grande per fare quello che Adam fa con \(10^{-4}\) dice l’ordine di grandezza di
\(\sqrt{\hat{v}}\) su questi gradienti, circa \(10^{-3}\). Chi vuole la formula
alla lettera scrive la penalità dentro la loss, sui soli parametri del batch e
senza \(\mu\); AdamW chiude il terzo scostamento e lascia i primi due.
Su MovieLens il procedimento è lo stesso, con due avvertenze. La prima è che i nostri voti finti nascono da un conto, e un conto è ripetibile: rifatto due volte dà sempre lo stesso voto. I voti veri no. La stessa persona, rivotando lo stesso film a distanza di mesi, non dà sempre le stesse stelle, e quell’oscillazione nessun modello può prevederla: su dati veri esiste quindi una soglia sotto la quale l’errore non scende, per quanto si affini il modello. Nel nostro esempio quella fonte di errore non c’è, e i numeri ne risentono. La seconda è quella già annunciata: la tabella vera è più vuota della nostra, e i dataset più grandi lo sono molto di più, quindi gli errori di MovieLens non sono questi.
Dove il collaborativo si ferma#
Due limiti, la partenza a freddo e il bias di popolarità, dipendono dal fatto che il filtraggio collaborativo usa soltanto la matrice delle interazioni. Si attenuano con informazione esterna alla matrice o con l’esplorazione, non con un modello migliore sugli stessi dati.
La partenza a freddo. Il nuovo iscritto è un perfetto sconosciuto: il libraio che consiglia in base agli acquisti passati, con chi non ha mai comprato nulla, è muto. Lo stesso vale per un film appena uscito: finché nessuno lo vota non somiglia a niente, e nessun sistema collaborativo può consigliarlo. Servirebbe sapere che film è, genere, attori, trama, ed è l’unica cosa che il collaborativo non guarda. È il problema della partenza a freddo (in inglese cold start, ed è il nome con cui lo si trova scritto quasi ovunque), e spiega perché le piattaforme ti tempestano di domande all’iscrizione («scegli tre titoli che ti piacciono»): stanno comprando a poco prezzo le prime celle della tua riga.
Finché quelle celle non ci sono, nella scheda di chi è appena arrivato non c’è niente che lo riguardi, e dal confronto non esce niente di personale: resta soltanto quanto quel film piace in generale, cioè una classifica identica per chiunque. Tanto vale sceglierla apposta, e mostrare i titoli che piacciono a tutti. Con un’avvertenza, che è la stessa di prima: un film con due voti entusiasti sembra amatissimo per la stessa ragione per cui due persone con un film solo in comune sembrano identiche, quindi quella classifica va fatta contando anche quante persone hanno votato.
La dittatura della popolarità. I film con moltissimi voti entrano nei conti di tutti, vengono consigliati spesso, e così raccolgono altri voti: i ricchi diventano più ricchi. Il capolavoro di nicchia con dodici voti entusiasti resta invisibile: proprio il titolo che il tuo amico cinefilo, lui sì, ti avrebbe messo in mano. Rimediare si può, forzando la lista a fare posto ai titoli poco visti, e si paga: qualche consiglio azzeccato in meno fra quelli che avresti guardato comunque. Quanto pagarne lo decide chi progetta.
E la popolarità ha un rovescio: consigliare a tutti i titoli più visti, senza sapere niente di nessuno, è un avversario che non sempre i sistemi sofisticati riescono a battere. Chi ne presenta uno nuovo e non lo mette accanto a quella lista salta la domanda più semplice.
Partenza a freddo. L’embedding di un utente o di un item senza interazioni non compare in nessun termine della somma, quindi niente lo determina: con l’SGD sulle sole triple resta all’inizializzazione, con ALS o con un decadimento dei pesi finisce a zero. In nessuno dei due casi il modello collaborativo puro ha un canale per informarlo. Le mitigazioni escono dal paradigma: modelli content-based o ibridi che inizializzano l’embedding dai metadati (genere, cast, descrizione, per gli item) o da questionari e dati demografici (per gli utenti), oppure strategie di esplorazione che mostrano l’oggetto nuovo a qualcuno per raccogliere interazioni mirate nei primi giorni di vita. Queste ultime sono il problema dei bandit a più braccia: UCB, il Thompson sampling e il bandit contestuale con cui Li e colleghi sceglievano le notizie da proporre [LCLS10]. Nell’attesa che una di queste faccia effetto, il ripiego standard è la classifica dei titoli più popolari, ed è meno rozzo di quanto suoni. Su un utente di cui non si sa nulla il termine \(\mathbf{p}_u^\top \mathbf{q}_i\) è rumore attorno allo zero, o esattamente zero se l’embedding ci è finito, e ciò che resta in piedi del modello è \(\mu + b_i\): un ordinamento per gradimento medio del titolo, uguale per tutti. Il sistema una classifica non personalizzata la sta già servendo, quindi tanto vale sceglierla apposta e sceglierla robusta, perché \(b_i\) stimato su una manciata di voti è esposto allo stesso guasto della similarità su due film in comune.
Bias di popolarità. La distribuzione delle interazioni è a coda lunga, e l’obiettivo di minimizzare l’errore medio concentra la capacità del modello sulla testa della distribuzione, dove stanno quasi tutti i termini della somma. Il feedback loop visto nella panoramica fa il resto: più esposizione, più interazioni, più esposizione. Le contromisure (ripesare le coppie per propensità inversa, penalizzare la popolarità nel punteggio, imporre quote di diversità nella lista finale) comprano equità nella coda pagando qualche punto di accuratezza in testa. È un compromesso da scegliere, non un difetto da correggere una volta per tutte.
La popolarità però non è solo una patologia. Raccomandare i titoli più popolari vuol dire ordinare gli oggetti per \(s(u, i) = \lvert\{v \in \mathcal{U} : (v, i) \in \mathcal{K}\}\rvert\), il numero di utenti che hanno interagito con \(i\): lo stesso punteggio per tutti, da cui si tolgono gli oggetti che \(u\) ha già visto. Senza personalizzazione e con zero parametri appresi, è una baseline difficile da battere in molti confronti (nel riesame di Ferrari Dacrema e colleghi, su un dataset batteva tutti i metodi in gara [FDCJ19]), ed è la prima riga da cercare in una tabella di confronto: il margine con cui un metodo la supera dice quanto vale davvero la personalizzazione, e senza quella riga non lo dice niente.
Nessuno dei due limiti si chiude restando dentro la matrice dei voti. La raccomandazione neurale comincia da una rete al posto del prodotto scalare, che non risolve nessuno dei due e serve a capire che cosa vale davvero il prodotto scalare; poi allarga i dati dalla matrice al grafo, che sulla partenza a freddo qualcosa dà.
Da ricordare
Il filtraggio collaborativo è «chiedere all’amico giusto» reso calcolabile: prevede i gusti di una persona dai giudizi di chi le somiglia (oppure dai voti che lei stessa ha dato a film votati in modo simile), guardando solo la tabella dei voti: né trama, né genere, né regista.
La fattorizzazione riassume ogni persona e ogni film in una scheda di poche manopole, e prevede il voto confrontando le due schede voce per voce, corretto da quanto quella persona vota alto in generale e da quanto quel film è apprezzato in generale. Le manopole non le sceglie nessuno: le trova l’algoritmo dai soli voti già dati (le celle vuote sono incognite, non zeri), con un freno che gli impedisce di imparare quei voti a memoria. Il freno va tarato sui voti messi da parte: troppo lento lascia imparare a memoria, troppo stretto spegne le manopole; e lo stesso numero scritto nel codice frena in modo molto diverso secondo l’ottimizzatore. Il «solo i voti già dati» però vale finché la gente vota: dove si sa soltanto che cosa uno ha aperto, il vuoto smette di essere un’incognita e diventa l’unico segnale negativo, con accanto quanto ci si crede.
In PyTorch sono due tabelle di schede e un confronto voce per voce: poche righe, la stessa idea che al Netflix Prize superò i vicini.
L’errore va guardato sui voti messi da parte, non su quelli con cui il modello si è addestrato: qui fa \(0{,}35\) sui voti messi da parte e \(0{,}014\) su quelli di addestramento, e solo lo \(0{,}35\) dice se ha imparato o se ha imparato a memoria.
Due limiti restano: di chi è appena arrivato non si sa nulla, e il libraio che consiglia in base agli acquisti passati è muto (partenza a freddo, e nell’attesa la cosa migliore da fare è mostrare i titoli che piacciono a tutti); i titoli già molto votati si consigliano da soli, e il capolavoro di nicchia con dodici voti entusiasti resta invisibile (dittatura della popolarità). La popolarità però fa due mestieri: è la patologia, ed è anche un avversario che non sempre i sistemi sofisticati riescono a battere.
Da ricordare
Il filtraggio collaborativo prevede i gusti di un utente dai giudizi degli utenti (o degli oggetti) simili, usando solo la matrice dei voti: nessuna informazione sui contenuti.
La fattorizzazione di matrici comprime la matrice in fattori latenti: \(\hat{r}_{ui} = \mu + b_u + b_i + \mathbf{p}_u^\top \mathbf{q}_i\), con loss MSE regolarizzata sui soli voti osservati. Il «solo osservati» vale per il feedback esplicito: sull’implicito il metodo canonico (iALS) somma su tutte le celle e le distingue con un peso di confidenza.
In PyTorch il modello è due
nn.Embeddinge un prodotto scalare: poche righe, la famiglia di modelli che al Netflix Prize superò i vicini. Con quasi un parametro per voto l’MSE di addestramento non misura la generalizzazione: qui \(0{,}014\) sui voti visti contro \(0{,}35\) su quelli tenuti da parte.La regolarizzazione \(L_2\) si tara sui voti tenuti da parte: con Adam e
weight_decay\(10^{-4}\) l’MSE scende in media da \(0{,}446\) a \(0{,}315\), a \(10^{-2}\) gli embedding vanno a zero e il modello smette di personalizzare. In Adam ilweight_decaypassa per la normalizzazione dei momenti e non coincide con la penalità della formula: AdamW, che lo applica ai pesi, a parità di numero frena circa mille volte meno.Limiti strutturali: partenza a freddo (cold start: senza interazioni il termine personalizzato è rumore e resta \(\mu + b_i\), cioè una classifica per gradimento medio uguale per tutti; tanto vale sceglierla apposta, e sceglierla robusta) e bias di popolarità (la coda lunga resta invisibile). La popolarità è insieme la patologia e una baseline che non tutti i metodi pubblicati battono, ed è la riga che dice quanto vale la personalizzazione.