


Quando le ipotesi sono infinite: la dimensione VC#
Le soglie su un segmento sono infinite, e l’esperimento delle mille soglie diceva che cento esempi bastano lo stesso. Il limite per le famiglie finite non può spiegarlo, perché le regole da contare sono infinite. Può spiegarlo un altro conto: al posto delle regole si contano le dicotomie, cioè i modi diversi in cui le regole dividono un insieme di punti fra le due classi (colorandoli, se si dà un colore a ciascuna classe). Due soglie che mettono gli stessi esempi dalla stessa parte, per quegli esempi, sono la stessa regola.
La misura che ne esce porta le iniziali di Vapnik e Chervonenkis [VC71], la cui storia sta nella sezione sulle SVM: la dimensione VC di una famiglia è il numero massimo di punti che la famiglia, se li si dispone nel modo più favorevole, riesce a dividere fra le due classi in tutti i modi possibili, cioè a frantumare.
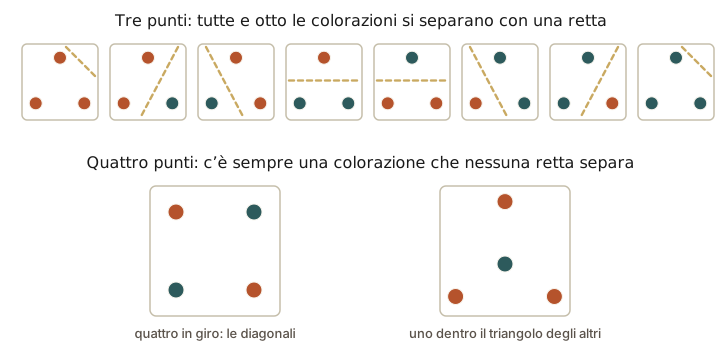
Fig. 5.2 Una retta divide tre punti non allineati in tutti gli otto modi possibili, e per questo si dice che li frantuma. Quattro punti invece non li frantuma mai: se stanno ai vertici di un quadrilatero le diagonali colorate uguali non si separano, se uno sta dentro il triangolo degli altri non lo si stacca da loro, e se stanno in fila basta alternare i colori.#
Frantumare un insieme di punti#
Su un foglio metti alcuni puntini dove vuoi. Un avversario li colora di rosso e di blu come vuole, e tu devi posare un righello in modo che i rossi stiano tutti da una parte e i blu dall’altra. Chi vince?
Con tre puntini non allineati vinci sempre (Fig. 5.2). Se hanno tutti lo stesso colore, posi il righello lontano; se uno ha un colore diverso dagli altri due, lo stacchi con un taglio; e le colorazioni possibili sono otto (due colori per ciascuno dei tre, \(2\cdot2\cdot2\)), tutte di uno di questi tipi. In fila no: rosso, blu, rosso non si separa con un righello, ed è per questo che i posti li scegli tu. Quando un righello riesce a separare un gruppo di puntini in tutti i modi in cui lo si può colorare, si dice che lo frantuma: la famiglia lo riduce in tutti i pezzi possibili.
Con quattro puntini, invece, l’avversario ha sempre una mossa vincente. Se i quattro stanno ai vertici di un quadrilatero, colora uguali quelli sulle diagonali, e nessun righello li separa; se uno sta dentro il triangolo degli altri tre, colora lui di un colore e gli altri dell’altro; se stanno in fila, alterna i colori come con tre. Il numero più grande di puntini che il righello frantuma è quindi tre, ed è la sua dimensione VC.
Altri attrezzi hanno altri numeri. Un paletto piantato su una strada, blu a sinistra e rosso a destra, che è poi una delle mille soglie con la strada al posto del segmento, frantuma un punto solo, perché con due punti la colorazione «rosso a sinistra, blu a destra» non gli riesce. Un tratto di strada dipinto di rosso, con il resto blu, ne frantuma due ma non tre (rosso, blu, rosso non si fa con un tratto solo). In una stanza, dove le direzioni sono tre, un foglio di cartone rigido al posto del righello ne frantuma quattro; in uno spazio di dieci direzioni, undici: sempre uno in più delle direzioni, come sul foglio, dove le direzioni sono due e i punti tre.
Viene da pensare che il numero conti le manopole di un attrezzo: il righello sul foglio ne ha tre (dove passa, quanto è inclinato, da che parte sta il rosso) e frantuma tre punti. Non è così. Una curva a onda con una manopola sola, quanto è fitta, colora in tutti i modi quanti punti si vuole, purché siano messi nei posti giusti, a distanze che si dimezzano a ogni punto: si dimostra che stringendo l’onda del giusto, una volta sola, la si fa passare sopra i rossi e sotto i blu, qualunque sia la colorazione. Una manopola, e nessun limite al numero di punti.
Per \(S=(x_1,\dots,x_m)\) e \(\mathcal{H}\subseteq\{-1,+1\}^{\mathcal{X}}\) siano \(\mathcal{H}_{|S}=\{(h(x_1),\dots,h(x_m)) : h\in\mathcal{H}\}\) le dicotomie che \(\mathcal{H}\) realizza su \(S\) e
la funzione di crescita. \(\mathcal{H}\) frantuma \(S\) se \(|\mathcal{H}_{|S}|=2^m\), e la dimensione VC è
infinita se il massimo non esiste. Per dimostrare che \(\mathrm{VCdim}(\mathcal{H})=d\) servono due mosse di segno opposto: esibire un insieme di \(d\) punti frantumato, e mostrare che nessun insieme di \(d+1\) punti lo è. Gli esempi standard [MRT18]: le soglie sulla retta, in un verso solo, hanno dimensione \(1\) (con i due versi \(2\)); gli intervalli \(2\), perché la dicotomia \((+,-,+)\) non si realizza (esempio 3.11); i semipiani di \(\mathbb{R}^2\) hanno dimensione \(3\), e per quattro punti i casi sono quelli della figura, a seconda che l’inviluppo convesso abbia quattro o tre vertici (se ne ha due i punti sono allineati, e i due in mezzo non si staccano da quelli agli estremi; esempio 3.12). In generale gli iperpiani di \(\mathbb{R}^n\), dove \(n\) è la dimensione dello spazio come nel resto del libro e \(d\) resta la dimensione VC, hanno dimensione \(n+1\). Il limite inferiore lo dà l’insieme formato dall’origine e dagli \(n\) vettori della base canonica, che gli iperpiani frantumano: per le etichette \(y_0,\dots,y_n\in\{\pm1\}\) bastano \(\mathbf{w}=(y_1,\dots,y_n)\) e \(b=y_0/2\). Il limite superiore viene dal teorema di Radon, secondo cui \(n+2\) punti di \(\mathbb{R}^n\) si ripartiscono sempre in due sottoinsiemi con inviluppi convessi che si intersecano, e due insiemi così non li separa nessun iperpiano (teorema 3.13).
Per gli iperpiani la dimensione coincide con il numero di parametri liberi, e la coincidenza è accidentale. La famiglia \(\{x\mapsto\mathrm{sgn}\sin(\omega x):\omega\in\mathbb{R}\}\) ha un parametro solo e dimensione VC infinita (esempio 3.16 ed esercizio 3.20): per ogni \(m\) i punti \(x_i=2^{-i}\) si frantumano, e per le etichette \(y_i\in\{\pm1\}\) basta \(\omega=\pi\big(1+\sum_{i=1}^{m}2^{i}(1-y_i)/2\big)\). La dimensione VC misura quello che la famiglia fa sui dati, non come è scritta.
Dal caso peggiore a un polinomio#
La dimensione VC serve perché mette un tetto al numero di dicotomie, e il tetto cambia natura: fino alla dimensione VC le dicotomie raddoppiano a ogni punto aggiunto, oltre crescono solo come una potenza fissa del numero di punti. È il risultato che rende la teoria utile, e ha un nome, il lemma di Sauer (un lemma è un teorema che serve a dimostrarne altri). Per le soglie, che frantumano un punto solo, la potenza è la prima: su cento esempi le dicotomie sono centouno invece di \(2^{100}\), e infinite soglie, davanti a quei cento esempi, valgono quanto una famiglia di centouno regole.
Dieci puntini sul foglio, senza tre allineati, si possono colorare in \(2^{10}=1024\) modi. Quanti di questi riesce a fare un righello? Contarli uno per uno si può, e sono \(92\): meno di uno su dieci, e vicino a cento, il quadrato di dieci. Con venti puntini le colorazioni sono più di un milione, e il righello ne fa \(382\), vicino a quattrocento. Il righello, cioè, si comporta come un attrezzo con un numero di mosse diverse che cresce come il quadrato dei punti, non come uno che ne raddoppia le possibilità a ogni punto nuovo.
Questo salva il conto dell’investigatore. Di righelli ce ne sono infiniti, ma davanti a venti indizi quelli che li colorano allo stesso modo sono, per quanto riguarda quegli indizi, lo stesso sospettato: i sospettati veri sono poche centinaia, non infiniti. E siccome crescono piano, alla lunga vincono i dimezzamenti: raddoppiando gli indizi i sospettati distinti si moltiplicano per quattro, mentre la probabilità che uno da scartare resti in lista si divide per più di quattro appena gli indizi sono una trentina (trenta indizi in più sono due dimezzamenti, cioè una divisione per quattro), e per sempre di più dopo.
Per contare il tetto non serve nemmeno conoscere l’attrezzo: basta la sua dimensione VC. Per un attrezzo che frantuma al più tre punti, su dieci punti le colorazioni possibili non superano \(1+10+45+120=176\), cioè i modi di scegliere nessuno, uno, due o tre punti fra dieci (\(45\) e \(120\) sono i conti della sezione su contare i casi). Il tetto ha questa forma perché a ogni colorazione diversa corrisponde un gruppetto di punti che l’attrezzo frantuma, e i gruppetti frantumati hanno al più tre punti. Sul paletto lo si vede a occhio. Con quattro puntini sulla strada le colorazioni sono cinque (tutti rossi, oppure blu fino al primo, al secondo, al terzo o al quarto), e i gruppetti che il paletto frantuma sono cinque anche loro, nessun punto oppure uno qualunque dei quattro: a «tutti rossi» va il gruppetto vuoto, a «blu fino al secondo» il secondo puntino, e così via. Il conto esatto per il righello dice \(92\), sotto il tetto come deve.
Da qui la regola pratica: gli esempi che servono crescono con la dimensione VC, come prima crescevano con il numero di raddoppi dei sospettati. Un attrezzo più potente sbaglia meno sugli esempi che ha visto e ne chiede di più perché ci si possa fidare, e scegliere l’attrezzo vuol dire scegliere dove stare fra le due cose. E non si scende sotto: nessun metodo, per quanto astuto, se la cava con meno esempi di una quantità proporzionale alla dimensione VC. Quando la dimensione VC è infinita, come per l’onda, nessun numero di esempi basta in tutti i casi, perché l’attrezzo riesce a colorare qualunque cosa e quindi non impara niente dai colori che ha visto.
Lemma di Sauer (Vapnik e Chervonenkis in una forma diversa, poi Sauer e Shelah, indipendentemente [Sau72, She72]; Mohri e colleghi, teorema 3.17 e corollario 3.18). Se \(\mathrm{VCdim}(\mathcal{H})=d\), per ogni \(m\)
La dimostrazione più corta passa per il lemma di Pajor: per ogni insieme \(S\) di \(m\) punti le dicotomie che \(\mathcal{H}\) realizza su \(S\) non sono più dei sottoinsiemi di \(S\) che \(\mathcal{H}\) frantuma, \(|\mathcal{H}_{|S}|\le|\{T\subseteq S:\ \mathcal{H}\text{ frantuma }T\}|\) (si dimostra per induzione su \(m\), togliendo un punto alla volta), e un sottoinsieme frantumato ha al più \(d\) elementi, quindi i sottoinsiemi sono al più \(\sum_{i\le d}\binom{m}{i}\). La forma chiusa viene, per \(m\ge d\), da \(\sum_{i\le d}\binom{m}{i}\le\sum_{i\le d}\binom{m}{i}(m/d)^{d-i} \le(m/d)^d(1+d/m)^m\le(em/d)^d\).
La funzione di crescita è quindi o esattamente \(2^m\) per ogni \(m\) (dimensione infinita) o maggiorata da un polinomio di grado \(d\): non esistono vie di mezzo. Per i semipiani del piano il teorema di Cover sulle dicotomie lineari [Cov65] dà il valore esatto per punti in posizione generale, \(\Pi(m)=m^2-m+2\), sotto il tetto di Sauer \(\sum_{i\le 3}\binom{m}{i}\).
Sostituendo \(\Pi_{\mathcal{H}}\) al posto di \(|\mathcal{H}|\) nel conto dell’unione si ottiene il bound VC (Mohri e colleghi, corollario 3.19): con probabilità almeno \(1-\delta\), per ogni \(h\in\mathcal{H}\),
La sostituzione non è immediata, perché \(R(h)\) dipende dall’intera distribuzione e non dalle sole dicotomie su \(S\). La via di Vapnik e Chervonenkis è la simmetrizzazione: si rimpiazza \(R(h)\) con il rischio empirico su un secondo campione fantasma, si riduce tutto alle dicotomie su \(2m\) punti e si applica l’unione a \(\Pi_{\mathcal{H}}(2m)\), con il risultato \(\sqrt{(8d\log\frac{2em}{d}+8\log\frac{4}{\delta})/m}\). Le costanti più strette del corollario 3.19 vengono da un’altra strada, il lemma di Massart applicato alla funzione di crescita, che è lo strumento della complessità di Rademacher; il tasso è lo stesso, \(O\big(\sqrt{d\log(m/d)/m}\big)\). Nel caso realizzabile, come per le famiglie finite, migliora a \(O\big(d\log(m/d)/m\big)\) [BEHW89].
Il bound è ottimo a meno del logaritmo. Il teorema fondamentale della teoria PAC, dimostrato da Blumer, Ehrenfeucht, Haussler e Warmuth [BEHW89], dice che una classe è PAC-apprendibile in modo indipendente dalla distribuzione se e solo se la sua dimensione VC è finita; e nel caso agnostico nessun algoritmo può garantire, per ogni distribuzione, uno scarto \(\varepsilon\) dal migliore di \(\mathcal{H}\) con meno di \(d/(320\,\varepsilon^2)\) esempi con confidenza superiore a \(63/64\) (Mohri e colleghi, teorema 3.23, per \(d>1\)). La costante è piccola e il bound superiore è largo, ma la dipendenza da \(d\) è quella giusta nei due versi.
Resta un compromesso, che Vapnik ha chiamato minimizzazione del rischio strutturale: una famiglia con \(d\) più grande abbassa \(\hat{R}_S\) e alza il termine di complessità, ed è la stessa tensione fra errore di approssimazione ed errore di stima vista con lo spazio delle ipotesi, questa volta con un numero accanto.
Il blocco conta le dicotomie che una retta produce su punti estratti a caso, provando tutte le rette che contano, e le confronta con la formula esatta che Thomas Cover ha dato per le rette nel 1965, \(m^2-m+2\) dicotomie su \(m\) punti senza tre allineati, e con il tetto di Sauer. Poi calcola, per le rette del piano e al crescere degli esempi, di quanto la garanzia della dimensione VC lascia che l’errore vero superi, al più, quello sugli esempi.
import numpy as np
from itertools import combinations
from math import comb, e, log, sqrt

rng = np.random.default_rng(1)

def colorazioni_di_rette(punti):
    """Le colorazioni che una retta produce sui punti, cercate tutte.
    Ogni colorazione realizzabile si ottiene, spostando appena la retta, da
    una retta che passa per due dei punti: si decide poi da che parte stanno
    quei due con una rotazione o una traslazione minuscola."""
    m = len(punti)
    trovate = {tuple([1] * m), tuple([0] * m)}
    for i, j in combinations(range(m), 2):
        d = punti[j] - punti[i]
        lato = np.sign((punti - punti[i]) @ np.array([-d[1], d[0]]))
        for a in (1, -1):
            for b in (1, -1):
                y = lato.copy()
                y[i], y[j] = a, b
                for verso in (1, -1):                    # e la retta capovolta
                    trovate.add(tuple(int(v > 0) for v in verso * y))
    return trovate

for m in (3, 4, 5, 10, 20):
    n = len(colorazioni_di_rette(rng.random((m, 2))))
    sauer = sum(comb(m, i) for i in range(4))           # dimensione VC d = 3
    print(f"m={m:>2}: tutte {2**m:>7}, con una retta {n:>3}"
          f" (m^2-m+2 = {m * m - m + 2}), tetto di Sauer {sauer:>4}")

# il bound di Mohri, corollario 3.19, per le rette del piano (d = 3), delta = 0,01
d, delta = 3, 0.01
for m in (100, 1_000, 10_000, 100_000):
    scarto = sqrt(2 * d * log(e * m / d) / m) + sqrt(log(1 / delta) / (2 * m))
    print(f"m={m:>6}: rischio vero al massimo rischio empirico + {scarto:.3f}")
m= 3: tutte       8, con una retta   8 (m^2-m+2 = 8), tetto di Sauer    8
m= 4: tutte      16, con una retta  14 (m^2-m+2 = 14), tetto di Sauer   15
m= 5: tutte      32, con una retta  22 (m^2-m+2 = 22), tetto di Sauer   26
m=10: tutte    1024, con una retta  92 (m^2-m+2 = 92), tetto di Sauer  176
m=20: tutte 1048576, con una retta 382 (m^2-m+2 = 382), tetto di Sauer 1351
m=   100: rischio vero al massimo rischio empirico + 0.672
m=  1000: rischio vero al massimo rischio empirico + 0.250
m= 10000: rischio vero al massimo rischio empirico + 0.089
m=100000: rischio vero al massimo rischio empirico + 0.031
Le prime righe fanno vedere il lemma di Sauer al lavoro: le dicotomie possibili raddoppiano a ogni punto, quelle di una retta crescono come il quadrato, e il conteggio fatto provando le rette coincide riga per riga con la formula di Cover. Le ultime dicono quanto costa la garanzia, che ha la forma di tutte quelle della teoria: l’errore vero sta sotto l’errore sugli esempi più uno scarto che cresce con la dimensione VC e cala con il numero degli esempi. Con cento esempi lo scarto promesso è \(0{,}67\), sessantasette punti percentuali, cioè quasi nessuna garanzia; con mille è un quarto; per scendere a tre punti percentuali ne servono centomila. Sono numeri larghi, perché la garanzia vale per qualunque distribuzione e quindi anche per la peggiore, e la distribuzione che si ha davanti di solito non è la peggiore.
Da ricordare
Una famiglia di regole infinita, davanti a un numero finito di esempi, si comporta come una finita: contano solo le colorazioni diverse che produce su quegli esempi.
La dimensione VC è il numero più grande di punti che la famiglia, con i punti messi dove le conviene, colora in tutti i modi: tre per un righello sul foglio, uno per un paletto su una strada. Non conta le manopole: un’onda con una manopola sola ce l’ha infinita.
Sopra la dimensione VC le colorazioni crescono piano, e gli esempi che servono crescono con lei; con dimensione infinita nessun numero di esempi basta in tutti i casi.
Da ricordare
\(\mathrm{VCdim}(\mathcal{H})\) è il massimo \(m\) con \(\Pi_{\mathcal{H}}(m)=2^m\); iperpiani in \(\mathbb{R}^n\): \(n+1\) (origine e base canonica, e Radon); \(\mathrm{sgn}\sin(\omega x)\): infinita con un parametro.
Lemma di Sauer: \(\Pi_{\mathcal{H}}(m)\le\sum_{i\le d}\binom{m}{i}\le(em/d)^d\); bound VC \(R(h)\le\hat{R}_S(h)+\sqrt{2d\log(em/d)/m}+\sqrt{\log(1/\delta)/(2m)}\).
PAC-apprendibile, in modo indipendente dalla distribuzione, se e solo se \(d<\infty\) (Blumer e colleghi, 1989); limite inferiore agnostico \(m=\Omega(d/\varepsilon^2)\).
La garanzia della dimensione VC ha un difetto che i numeri calcolati per le rette lasciano intuire: guarda la peggiore distribuzione possibile e i peggiori punti possibili, e non si accorge che i dati che si hanno davanti possono essere molto più benevoli. Una retta che separa due nuvole lontane, lasciando fra loro una strada larga, e una che passa rasente ai punti appartengono alla stessa famiglia, con la stessa dimensione VC, e la garanzia le tratta allo stesso modo. Per distinguerle serve una misura calcolata sui dati.