


Efficienza: il modello che si addestra e quello che si usa#
Molti insetti vivono due vite in un corpo solo. La larva è fatta per mangiare: lenta, molle, con un apparato digerente che occupa quasi tutto lo spazio disponibile. L’adulto è fatto per volare e riprodursi, ed è un animale completamente diverso. Nessuno dei due sarebbe capace di fare il mestiere dell’altro.
Con questa immagine si apre l’articolo sulla distillazione di Hinton, Vinyals e Dean, e la seconda frase è la tesi di tutto l’argomento:
Many insects have a larval form that is optimized for extracting energy and nutrients from the environment and a completely different adult form that is optimized for the very different requirements of traveling and reproduction. In large-scale machine learning, we typically use very similar models for the training stage and the deployment stage despite their very different requirements: […]
Hinton, Vinyals e Dean, Distilling the Knowledge in a Neural Network (2015) [HVD15]
Cioè: nell’apprendimento automatico su larga scala, per addestrare e per mettere in funzione usiamo di solito modelli molto simili, benché le due fasi abbiano esigenze molto diverse. Addestrare vuol dire macinare per settimane una montagna di dati, e costa tempo e denaro, ma nessuno sta aspettando una risposta. Rispondere vuol dire stare dentro la memoria di una macchina e restituire qualcosa mentre una persona guarda lo schermo. Larva e farfalla, e quasi sempre si spedisce la larva.
La domanda, allora, è come si costruisce la farfalla.
Il problema, in due numeri#
Prima dei rimedi viene il problema, e lo si misura con due numeri: quanti parametri ha il modello, \(P\), e quanti bit occupa ciascuno, \(b\). I parametri sono i pesi, i numeri che la rete ha imparato, e il conto d’apertura del parallelismo distribuito li ha già pesati in byte: quattro l’uno in precisione piena, due in mezza precisione.
I bit sono le cifre binarie con cui un calcolatore scrive tutto, e ogni bit in più raddoppia i valori diversi che si riescono a rappresentare. Con \(b\) bit sono \(2^b\): con due bit quattro, con quattro sedici, con otto duecentocinquantasei. Otto bit fanno un byte, quindi i pesi occupano \(P \cdot b / 8\) byte, e niente obbliga a fermarsi ai sedici bit della mezza precisione.
PARAMETRI = 7_000_000_000     # sette miliardi di parametri
SCHEDA_GB = 16                # la scheda grafica ha sedici gigabyte di memoria

print(f"{'formato':<9} {'bit':>4} {'peso':>10}   ci sta nella scheda?")
for nome, bit in (("float32", 32), ("float16", 16), ("int8", 8), ("int4", 4)):
    gb = PARAMETRI * bit / 8 / 1e9
    print(f"{nome:<9} {bit:>4} {gb:>7.1f} GB   {'sì' if gb < SCHEDA_GB else 'no'}")
formato    bit       peso   ci sta nella scheda?
float32     32    28.0 GB   no
float16     16    14.0 GB   sì
int8         8     7.0 GB   sì
int4         4     3.5 GB   sì
I formati portano il nome che hanno nel codice, float per la virgola mobile e
int per gli interi, seguito dai bit. Le due righe agli estremi descrivono lo
stesso modello, con gli stessi parametri, addestrato una volta sola. Nella prima
non ci sta; nell’ultima ci starebbe quattro volte e mezzo. (La colonna di
destra conta i soli pesi: per far girare davvero il modello serve dell’altro
spazio, e la riga a sedici bit, che lascia due gigabyte scarsi di margine,
nella pratica è più stretta di quanto sembri.) Fra le due non c’è nessun
addestramento in più: gli stessi parametri sono scritti con meno cifre, cioè
arrotondati.
Le tre leve#
Un modello troppo grande si può stringere in tre modi, e sono tre operazioni che agiscono su cose diverse, non la stessa idea vista da tre angoli: si possono usare tutte e tre insieme.
Meno bit per parametro. I parametri restano tutti, e resta la forma della rete: cambia solo quante cifre si tengono di ciascun numero. È la leva che abbiamo visto nel conto sui due numeri, si chiama quantizzazione, ed è quella che rende di più per quanto costa.
Meno parametri. La forma della rete resta quella, ma una parte dei suoi collegamenti viene messa a zero, e in linea di principio non servirebbe più né tenerli in memoria né moltiplicarli. Si chiama potatura, ed è la leva che promette di più e mantiene meno, per una ragione che riguarda il modo in cui i calcolatori fanno i conti.
Un modello più piccolo che impara dal grande. Qui non si stringe niente: si costruisce un secondo modello, piccolo dall’inizio, e gli si insegna a comportarsi come il primo. Si chiama distillazione, ed è l’unica delle tre in cui il modello finale è un oggetto nuovo.
Le tre si vedono meglio disegnate su una matrice di pesi \(\mathbf{W}\), la griglia di numeri che uno strato moltiplica per gli ingressi che gli arrivano (Fig. 9.1). Sulla stessa matrice si vede subito che le tre leve agiscono su cose diverse: una sui valori che ciascun elemento può assumere (le sfumature del disegno), una sugli elementi diversi da zero (le caselle piene), una sulla forma di \(\mathbf{W}\).

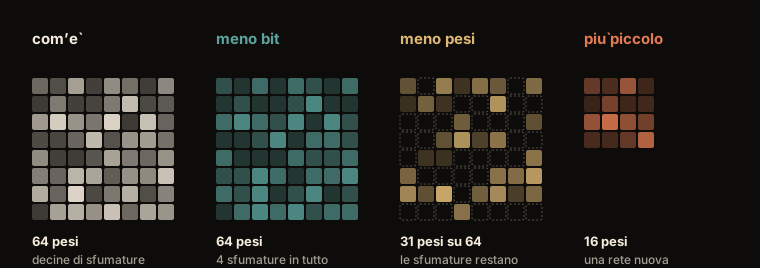
Fig. 9.1 Il primo riquadro è la matrice com’è; gli altri tre sono le tre leve, sulla stessa matrice. Togliere bit non cambia quante caselle ci sono, cambia quante sfumature diverse una casella può avere: qui il secondo riquadro ne ammette quattro, che sarebbero due bit per casella. Togliere pesi lascia le sfumature e svuota le caselle. Fare un modello più piccolo cambia la griglia.#
C’è poi una quarta strada per andare più veloci, di natura diversa: non tocca il modello, ma il modo in cui lo si fa lavorare mentre risponde. Tenere da parte i conti già fatti invece di rifarli, servire molte richieste insieme, far scrivere una bozza a un modello piccolo e farla controllare al grande: sono tecniche affrontate più avanti nella sezione sui grandi modelli linguistici e in quella su LLMOps, e la sezione su come far rispondere in fretta spiega perché stiano lì e non qui.
Tre piani, tre mestieri#
L’efficienza di un modello sta su tre piani, e ciascuno ha un mestiere suo.
Il capitolo sulla GPU spiega l’hardware: com’è fatta la memoria di una scheda, perché i byte che viaggiano contano più dei conti che si fanno, come si scrive un calcolo che la sfrutti. È il piano di sotto.
Il capitolo su MLOps spiega il servizio: come si mette un modello dietro a un indirizzo a cui altri programmi possano rivolgersi, che cosa si promette a chi lo usa, come si misura se sta rispettando la promessa. È il piano di sopra.
In mezzo sta il meccanismo: perché quattro bit bastino, che cosa si rompe quando non bastano, che cosa perde davvero uno studente che imita il maestro. Non come si mette in produzione, ma perché la cosa che si mette in produzione funziona.
Da ricordare
Addestrare e rispondere sono due mestieri diversi: il primo può durare settimane, perché nessuno aspetta una risposta; il secondo deve stare in una macchina e rispondere subito. Quasi sempre però si mette in produzione lo stesso identico modello che si è addestrato.
Il conto che spiega tutto: un modello da sette miliardi di parametri pesa 28 GB se ogni parametro si scrive con trentadue bit, e 3,5 GB se se ne usano quattro. È lo stesso modello, con i numeri scritti più corti, cioè arrotondati.
Le tre leve per stringerlo sono davvero tre cose diverse: meno bit per parametro (la quantizzazione), meno parametri (la potatura), oppure un modello nuovo e più piccolo che impara dal grande (la distillazione).
Qualcosa si paga sempre, e la parte utile di questo capitolo è quella: non che le tre leve esistano, ma che cosa costano.
Da ricordare
I pesi di un modello occupano \(P \cdot b / 8\) byte, con \(P\) il numero di parametri e \(b\) i bit per parametro: passare da \(b = 32\) a \(b = 4\) è un fattore otto a parità di \(P\). Non è tutta la memoria che serve, e il capitolo lo aggiunge man mano: la quantizzazione a gruppi si porta dietro le sue scale (il sei per cento in più a quattro bit con gruppi da sessantaquattro), e in servizio ci sono le attivazioni e la cache che cresce con la conversazione.
Le tre leve agiscono su fattori diversi dello stesso prodotto: la quantizzazione su \(b\), la potatura e la distillazione su \(P\). Le ultime due lo fanno però in modi diversi: la potatura svuota una matrice che resta della sua forma, la distillazione cambia la forma.
Sono componibili e si compongono davvero: un modello distillato si pota, e uno potato si quantizza, nell’ordine in cui le compone la prova sulla potatura. Quello che non è componibile è il budget di errore: ogni leva ne consuma un pezzo, e le perdite non si sommano in modo prevedibile.
Nella generazione, che produce un token per passo, il tempo di risposta è governato dai byte che si spostano più che dai conti che si fanno, ed è il modello roofline del capitolo sulla GPU: stringere il modello aiuta perché sono meno byte, e non basta, perché a un token per passo si resta legati alla banda comunque. La lettura del testo in ingresso elabora \(k\) token insieme, con intensità aritmetica \(k\) a sedici bit, e passa nel regime dominato dal calcolo solo quando \(k\) supera il ginocchio della macchina, nell’ordine delle centinaia.
La prima leva è quella che rende di più e si spiega peggio, perché la domanda che si porta dietro è scomoda: come fa un modello a funzionare quasi come prima se gli si tolgono ventotto bit su trentadue? Risponde la sezione Meno bit, e la risposta comincia da una cosa che facciamo tutti al supermercato.