


Esplorazione e ricompensa: curiosità, ricompense rade, reward hacking#
Fra i 49 giochi Atari del confronto con il collaudatore umano, nel 2015, ce n’era uno su cui il DQN collezionò un punteggio desolante: zero [MKS+15].
Il gioco è Montezuma’s Revenge, un platform del 1984. Un esploratore in un tempio azteco deve scendere una scala, saltare una fune, scansare un teschio rotolante e raccogliere una chiave prima di ricevere il suo primo punto: decine di mosse esatte, in sequenza, per un solo segnale di «bene». Un agente che sceglie mosse a caso non arriverà mai in fondo a quella catena: cadrà, morirà, e non vedrà mai una ricompensa da cui imparare.
Che cosa non è andato storto, prima di tutto: il DQN quello schermo lo vedeva benissimo, e i suoi conti li faceva come sugli altri quarantotto giochi. Il problema è un altro: come si va a cercare qualcosa in un mondo dove le ricompense sono rade (in inglese sparse), cioè capitano una volta ogni tanto e in mezzo non c’è niente. Si chiama esplorazione.
Il problema delle ricompense rade#
Nella maggior parte dei giochi Atari qualcosa di buono o cattivo capita a ogni secondo, e l’agente ha un flusso costante di segnali da cui correggersi. Ma quando la ricompensa arriva solo dopo lunghe sequenze di azioni giuste (la chiave, la porta, il livello), il segnale diventa un ago in un pagliaio. Finché l’agente non inciampa per caso in quella prima ricompensa, non ha nulla che gli dica in che direzione andare. E il conto di quanto sia improbabile inciamparci si fa a mente: se a ogni passo ci sono otto mosse possibili e una sola è quella giusta, azzeccarne dieci di fila vuol dire \(8^{10}\), cioè una volta su un miliardo abbondante.
Nel capitolo sul reinforcement learning abbiamo introdotto il dilemma esplorazione-sfruttamento e la strategia \(\varepsilon\)-greedy, «golosa»: con una piccola probabilità \(\varepsilon\) sceglie un’azione a caso, il resto del tempo prende senza esitare quella di valore più alto. Qui vediamo perché quella ricetta, in ambienti come Montezuma, non basta, e cosa si è inventato per andare oltre.
Perché \(\varepsilon\)-greedy non basta#
Esplori una città enorme così: quasi sempre imbocchi la strada che ti sembra la migliore, e ogni venti incroci circa tiri un dado e vai dove dice lui. Andrai avanti e indietro nello stesso quartiere per ore: il caso non ha memoria, non sa quali strade hai già battuto e quali no. E per raggiungere un vicolo che sta a dieci svolte precise da qui dovrebbero capitarti insieme due fortune, dieci volte di fila: che proprio lì ti venga in mente di tirare il dado, e che il dado dica la svolta giusta. La probabilità di azzeccarle tutte è minuscola, e si schiaccia ancora di più per ogni svolta che si aggiunge alla catena.
L’esplorazione casuale è così: agita le mani nel buio nei dintorni di dove sei già. Quello che servirebbe è un’esplorazione diretta: una spinta a puntare verso i posti che non hai ancora visto, invece di rimescolare a caso quelli di sempre.
Con \(\varepsilon\)-greedy le azioni esplorative sono scelte in modo uniforme e indipendente dallo stato: la perturbazione è locale e non correlata nel tempo. Per raggiungere uno stato-obiettivo che dista \(n\) azioni «insolite» dalla regione già visitata, la probabilità di percorrere l’intera sequenza per puro caso scala come \((\varepsilon/|\mathcal{A}|)^{\,n}\) e decade esponenzialmente in \(n\). Questo è dithering: rumore attorno alla policy corrente, non ricerca strutturata.
L’esplorazione diretta tiene invece conto di ciò che l’agente ha già visto e orienta deliberatamente il comportamento verso le regioni poco note dello spazio degli stati. Quando l’orientamento si estende su più passi, cioè l’agente accetta azioni né premiate né istruttive subito pur di arrivare dove c’è da imparare, si parla di deep exploration, che Osband e colleghi chiamano anche planning to learn, pianificare per imparare [OBPVR16]. Il modo più naturale per ottenerla è modificare non come si sceglie, ma cosa si ottiene: aggiungere alla ricompensa dell’ambiente un bonus che premia la novità.
Bonus di novità: premiare ciò che si visita di rado#
L’idea più intuitiva è anche la più vecchia, e nasce ai tempi in cui i giudizi stavano in una tabella [SB18]. Se in una certa situazione l’agente si è trovato poche volte, di quella situazione sa poco, e allora conviene andarci. Basta tenere il conto di quante volte ci è passato e aggiungere alla ricompensa un premietto che scende man mano che quel conto sale.
È il principio del turista curioso. Il viaggio ha già i suoi guadagni veri (il museo che volevi vedere, la cena buona), e tu ci aggiungi di tasca tua un piccolo premio ogni volta che metti piede in un posto dove non eri mai stato, un premio che si spegne man mano che quel posto diventa familiare. Il primo giorno un quartiere ti frutta il premio pieno; dopo esserci passato cento volte, quasi niente. Il risultato è che vieni spinto verso l’ignoto, senza bisogno di lanciare monetine.
Quanto valga quel premio rispetto a una cena buona lo decidi tu, ed è una manopola delicata: alzalo troppo e girerai a vuoto per vicoli insignificanti, abbassalo troppo e non ti muoverai dall’isolato dell’albergo.
C’è poi un modo di rompere tutto senza accorgersene, e consiste nel prendere appunti troppo precisi. Se segni sul taccuino la tua posizione al centimetro, non tornerai mai due volte nello stesso punto: ogni passo risulta inedito, ogni passo si prende il premio pieno, e un premio che vale uguale dappertutto non indica più niente.
Si sostituisce alla ricompensa dell’ambiente \(r_t\) una ricompensa aumentata
dove \(N(s_t)\) è il numero di volte in cui lo stato \(s_t\) è stato visitato e \(\beta>0\) dosa il peso della curiosità. Il bonus è alto sugli stati rari, tende a zero su quelli battuti: l’agente è incentivato a raggiungere le zone poco esplorate. Sullo stato mai visitato, \(N=0\), la formula scritta così diverge, e nella teoria è voluto: uno stato mai visto va visitato, e basta. In un programma quell’infinito va smorzato, e si scrive \(\beta/\sqrt{N(s_t)+1}\), che è la forma implementata nel codice.
Il limite è evidente in spazi grandi o continui: con osservazioni ad alta dimensione (i pixel di uno schermo) ogni stato è, letteralmente, unico, e \(N(s_t)\) vale sempre \(1\). Il conteggio esatto non ha senso. La soluzione sono gli pseudo-conteggi: si stima una densità \(\rho(s)\) sugli stati visitati e se ne ricava un conteggio effettivo \(\hat N(s)\) coerente con quanto la densità è «sorpresa» di rivedere \(s\). Se \(\rho(s)\) è la probabilità che il modello di densità assegna a \(s\) e \(\rho'(s)\) quella che gli assegnerebbe dopo averlo visto una volta in più (la probabilità di ricodifica), lo pseudo-conteggio è quello che fa corrispondere lo spostamento da \(\rho\) a \(\rho'\) a un’osservazione in più:
È l’approccio count-based esteso agli spazi grandi [BSO+16], che diede i primi progressi sostanziali proprio su Montezuma’s Revenge. E la radice nel bonus non è arbitraria. Per il Teorema 1 di quel lavoro, il guadagno d’informazione che un’osservazione porta al modello è maggiorato da \(\hat N(s)^{-1}\): un bonus proporzionale a \(\hat N(s)^{-1/2}\), come quello del MBIE-EB di Strehl e Littman [SL08], porta quindi a un comportamento almeno altrettanto esplorativo di uno basato su quel guadagno, mentre un bonus proporzionale al guadagno stesso, che non supera \(\hat N(s)^{-1}\), esplora troppo poco per garantire un comportamento quasi ottimo (lo si ricava, nel caso tabellare, combinando quel teorema con un risultato di Kolter e Ng).
Il bonus di novità si calcola facilmente quando gli stati sono pochi e distinti. Il frammento seguente applica la stessa identica regola a sei stati visitati un numero di volte molto diverso, e mostra come il premio vada quasi tutto ai più rari:
import numpy as np

# Conteggi di visita di 6 stati in un piccolo ambiente tabellare
visite = np.array([120, 40, 5, 0, 200, 1])

# Bonus di novità count-based: più raro lo stato, più alto il bonus.
beta = 0.5
bonus = beta / np.sqrt(visite + 1)   # +1 evita la divisione per zero

for s, (n, b) in enumerate(zip(visite, bonus)):
    print(f"stato {s}: visite={n:3d}  bonus={b:.3f}")
I due numeri si controllano a mano, ed è un conto da fare. Il premio pieno vale
\(0{,}5\) (è il beta scelto nel codice) e si divide per la radice quadrata di
quante volte quello stato è stato visto, più uno. Lo stato mai visitato prende
quindi \(0{,}5\) diviso \(1\), cioè il bonus massimo, \(0{,}500\); quello battuto
duecento volte prende \(0{,}5\) diviso la radice di \(201\), che vale poco più di
quattordici, cioè \(0{,}035\): quattordici volte meno.
La radice quadrata, in quel conto, serve a far scendere il premio in fretta all’inizio e piano dopo. Fra zero visite e tre il premio si dimezza esatto, da \(0{,}500\) a \(0{,}250\), e la differenza si sente; fra cento e centotré scende da \(0{,}0498\) a \(0{,}0490\), cioè non cambia niente. Ed è giusto così: la centesima visita a un posto insegna molto meno della prima.
La regola con cui l’agente sceglie è rimasta quella di sempre, prendere la mossa col voto più alto. È solo il voto ad avere adesso un pezzo in più, e l’agente si dirige verso l’ignoto credendo di dirigersi verso il guadagno.
La via d’uscita, quando le situazioni non si possono contare, è smettere di contare e cominciare a stimare: si valuta quanto una schermata assomigli a quelle già viste, e da quella somiglianza si ricava un conteggio finto, uno pseudo-conteggio, che si usa al posto di quello vero. È così che, nel 2016, sono arrivati i primi progressi veri proprio su Montezuma’s Revenge.
Curiosità intrinseca: la sorpresa come ricompensa#
Stimare un conteggio, però, resta un mestiere delicato. Un’idea più elegante ribalta la domanda: invece di chiederci quante volte abbiamo visto una situazione, chiediamoci quanto ci sorprende. Se non sappiamo prevedere che cosa succederà, vuol dire che di quel pezzo di mondo non abbiamo ancora capito il funzionamento, e sono proprio i posti da cui c’è da imparare. La sorpresa diventa così una ricompensa che l’agente si dà da sé, e che si somma a quella che gli dà il gioco. È lo stesso genere di premio interno su cui si appoggiava il livello basso dell’h-DQN, nella sezione sulla gerarchia: là premiava l’arrivo a un obiettivo assegnato, qui premia la sorpresa.
Di questa idea esistono due realizzazioni classiche, e la differenza sta tutta nel come misurano la sorpresa. La prima si chiama ICM (Intrinsic Curiosity Module, modulo di curiosità intrinseca): l’agente si costruisce una previsione di «che cosa succederà se faccio questo», e ogni volta che la sbaglia incassa un premietto.
La seconda si chiama RND (Random Network Distillation): una rete target con pesi casuali e fissi associa a ogni schermata un vettore, sempre lo stesso per la stessa schermata, e una rete predictor impara a riprodurlo sulle schermate che l’agente visita. L’errore del predittore è basso dove l’agente è passato spesso e alto sulle schermate nuove, e quell’errore è la ricompensa intrinseca.
Un bambino che gioca non prende punti da nessuno, eppure esplora instancabilmente, attratto da ciò che non riesce a prevedere. Spinge un bicchiere oltre il bordo del tavolo perché non sa ancora cosa succederà; una volta imparato che cade e si rompe, quel gesto smette di interessarlo e ne cerca un altro. La curiosità è proprio questo: un premio che ci si dà da soli per la sorpresa. L’agente si costruisce un modello di «cosa succederà se faccio questo»; quando il modello sbaglia la previsione, quello scarto vale come una piccola ricompensa, e lo tira verso il gesto che l’ha spiazzato. Il premio si consuma da sé: a forza di ripeterlo quel gesto diventa prevedibile, la sorpresa finisce, e l’agente si sposta altrove.
Presa alla lettera, però, la ricetta ha un guasto, e si vede a occhio nudo. Alla finestra mentre piove le gocce scendono ogni volta diverse: prevederle non riesce a nessuno, e la sorpresa non si esaurisce mai. Un bambino premiato soltanto dallo stupore resterebbe lì per sempre, davanti a uno spettacolo che non gli insegna nulla, perché su quelle gocce la sua mano non conta.
Il rimedio è cambiare l’oggetto della previsione: non tutto quello che si vede, ma soltanto la parte che ha a che fare con lui, cioè quella che la sua mano cambia e quella che può cambiare il suo gioco (il gatto che salta sul tavolo). E il modo di separarla dal resto è un indovinello: guardare la scena prima e la scena dopo, e capire che cosa si è fatto in mezzo. Il bicchiere spostato di venti centimetri lo dice; la pioggia dietro il vetro no, perché è identica qualunque cosa si faccia. Si tiene quello che serve all’indovinello e si butta il resto: è il filtro che tiene il bambino lontano dalla finestra.
La sorpresa si può misurare anche con un gioco di prestigio, che si capisce smontandolo. Due reti fatte allo stesso modo: la prima ha i numeri interni tirati a caso e non si tocca più, e a ogni schermata risponde con un numero senza significato, ma sempre lo stesso per la stessa schermata; la seconda si allena a indovinarlo sulle schermate per cui l’agente passa davvero. Dove l’agente è passato spesso, la seconda ha avuto tempo di impararlo e sbaglia poco; su una schermata nuova sbaglia parecchio, e il suo errore è il premio alla novità.
Nel modulo di curiosità intrinseca ICM (Intrinsic Curiosity Module, Pathak e colleghi, 2017 [PAED17]) la ricompensa intrinseca è l’errore di predizione di un modello di dinamica. La chiave è che la previsione non avviene sui pixel grezzi ma in uno spazio di feature \(\phi(s)\) appreso. Ciò che può cambiare l’osservazione è, nel lavoro, di tre specie: quello che l’agente controlla, quello che non controlla ma che lo influenza (un veicolo guidato da un altro), e quello che non controlla e non lo tocca (le foglie mosse dal vento). Uno spazio di feature adatto conserva le prime due e ignora la terza. Come si ottenga una proprietà del genere è metà del lavoro: \(\phi\) non si addestra da sé, si addestra con un modello di dinamica inversa, una rete che da \(\phi(s_t)\) e \(\phi(s_{t+1})\) deve indovinare l’azione \(a_t\) che ha portato dall’uno all’altro. Così \(\phi\) non ha ragione di conservare ciò che non influenza le azioni dell’agente e non ne è influenzato: una foglia che si muove per il vento non aiuta a indovinare quale tasto è stato premuto, e quindi esce dalla rappresentazione. Su quello spazio, un modello forward prevede la feature del prossimo stato \(\hat\phi(s_{t+1})\) da \(\phi(s_t)\) e dall’azione \(a_t\); la ricompensa intrinseca è
l’errore di predizione, con \(\eta>0\) un fattore di scala. Alta sugli stati la cui dinamica il modello non ha ancora imparato, la ricompensa si spegne man mano che il modello migliora: la curiosità è auto-esauribile.
Una variante più semplice e sorprendentemente efficace è RND (Random Network Distillation, Burda e colleghi, 2019 [BESK19]). Si fissa una rete target \(f\) dai pesi casuali e mai addestrati, e si allena una rete predictor \(\hat f\) a imitarne l’output sugli stati visitati. La ricompensa intrinseca del passo \(t\) è la distanza fra le due sullo stato appena raggiunto:
RND fu il primo metodo a superare la prestazione media umana su Montezuma’s Revenge senza ricorrere a dimostrazioni umane né allo stato interno dell’emulatore: il punteggio zero del DQN era già stato scalfito dagli pseudo-conteggi, ma ora, tre anni dopo, anche la media umana era superata. Non di più, ed è bene dirlo con le parole del lavoro stesso, che sull’esito è prudente: l’agente «occasionalmente completa il primo livello». Occasionalmente, e il primo: dopo quello il gioco va avanti. Superare il punteggio umano medio e risolvere un gioco sono due affermazioni diverse, e vanno tenute separate.
Il gioco l’ha poi risolto un’idea di altra specie, Go-Explore [EHL+21]: ricordare gli stati promettenti, tornarci e solo da lì esplorare, invece di affidarsi a un bonus perché l’agente ritrovi la strada. Nella versione principale ci torna ripristinando lo stato salvato del simulatore, cioè proprio l’accesso a cui RND rinunciava, e la politica finale la ricava dalle traiettorie migliori, usate come dimostrazioni. Senza nessuna conoscenza del gioco quadruplica il miglior punteggio precedente; con poche informazioni date a mano (la stanza, la posizione, il livello, le chiavi) lo risolve per intero, arrivando in fondo al terzo livello. Una variante che agli stati promettenti torna con una politica condizionata all’obiettivo, senza ripristinare niente, resta comunque sopra il livello umano.
La differenza fra ICM e RND sta in che cosa si predice. L’errore di un predittore nasce dalla scarsità di dati attorno a uno stato, che è la novità da premiare, e dalla casualità dell’ambiente, che nessun addestramento riduce. ICM predice le feature dello stato successivo, imparate in modo da tenere ciò che le azioni dell’agente influenzano o da cui sono influenzate: filtra il rumore che non lo riguarda e resta esposto a quello che controlla. Un televisore con il telecomando, dove ogni cambio di canale dà un’immagine imprevedibile, inchioda l’agente davanti allo schermo. RND predice \(f(s_{t+1})\) guardando \(s_{t+1}\) stesso: il bersaglio è una funzione deterministica di ciò che il predittore riceve, il caso della transizione non vi entra, e il rumore visto spesso diventa familiare come ogni altro stato. In pratica vuole osservazioni e ricompensa intrinseca normalizzate, e due teste di valore, una per ciascuna ricompensa, con quella intrinseca che non si azzera a fine episodio.
Il cuore di RND si scrive in poche righe di PyTorch, e qualche riga in più basta a vedere che cosa misura davvero il suo errore:
import torch
import torch.nn as nn

torch.manual_seed(0)    # le reti e gli stati sotto sono sorteggiati

# RND: due reti con la stessa architettura.
# target: pesi casuali FISSI, mai addestrati; predictor: impara a imitarla.
def crea_rete(dim_stato, dim_feature=64):
    return nn.Sequential(
        nn.Linear(dim_stato, 128), nn.ReLU(),
        nn.Linear(128, dim_feature),
    )

target = crea_rete(dim_stato=16)
predictor = crea_rete(dim_stato=16)

# La rete target è congelata: non le passa mai gradiente.
for p in target.parameters():
    p.requires_grad_(False)

optimizer = torch.optim.Adam(predictor.parameters(), lr=1e-3)

def ricompensa_intrinseca(stati):
    with torch.no_grad():
        obiettivo = target(stati)            # output della rete casuale fissa
    previsione = predictor(stati)
    # errore per ogni stato = novità: alto sugli stati poco visti.
    # (media invece di somma: cambia solo la scala, e la scala si ritara a parte)
    return (previsione - obiettivo).pow(2).mean(dim=1)

stati = torch.randn(8, 16)
r_int = ricompensa_intrinseca(stati)         # bonus di novità del batch
# Il predictor si allena a ridurre l'errore sugli stati che l'agente visita:
# così quegli stati, in futuro, saranno meno "sorprendenti".
loss = r_int.mean()
optimizer.zero_grad()
loss.backward()
optimizer.step()

# Che cosa misura davvero l'errore: tre gruppi di stati.
visti = torch.randn(64, 16)         # gli stati su cui il predictor si allena
nuovi = torch.randn(64, 16)         # mai visti, ma dalla stessa distribuzione
lontani = torch.randn(64, 16) + 3   # mai visti, e fuori dal mucchio dei visti

def errore(x):
    with torch.no_grad():
        return ricompensa_intrinseca(x).mean().item()

def stampa(quando):
    print(f"{quando}: visti {errore(visti):.3f}  nuovi {errore(nuovi):.3f}"
          f"  lontani {errore(lontani):.3f}")

stampa("prima")
for _ in range(500):                # il predictor si allena sui soli visti
    loss = ricompensa_intrinseca(visti).mean()
    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
stampa("dopo ")
prima: visti 0.108  nuovi 0.112  lontani 1.213
dopo : visti 0.000  nuovi 0.019  lontani 0.215
Prima dell’addestramento visti e nuovi si equivalgono, com’è naturale: vengono dallo stesso mucchio. Dopo, sugli stati visti l’errore è sparito, sui nuovi è sceso quasi altrettanto, e sui lontani resta una decina di volte più alto. Il predictor, cioè, generalizza: RND non premia l’essere mai visto, premia la distanza da ciò che si è già visto. Uno stato nuovo ma simile a tanti altri vale poco, uno davvero diverso vale molto, ed è quello che serve per uscire dalla regione già battuta.
Un modo diverso di guardare la curiosità#
In tutto quello che si è visto finora la curiosità è un premio in più: la ricompensa dell’ambiente non bastava, e se ne è affiancata un’altra, costruita apposta, con un peso da tarare (\(\beta\) per il bonus di novità, \(\eta\) per ICM). È una toppa, anche se i primi passi avanti su Montezuma sono venuti da lì.
Esiste una lettura opposta, in cui sapere e ottenere sono la stessa cosa, e chiarisce parecchio anche a chi non intende seguirla. In questa lettura l’agente non massimizza una ricompensa: sceglie le azioni con un conto unico, che tiene insieme quanto un’azione lo avvicina a ciò che preferisce e quanto gli farebbe imparare. Il quadro si chiama inferenza attiva e viene dalle neuroscienze teoriche, dove descrive percezione e azione come un unico problema [PPF22]; il conto, che l’agente minimizza, si chiama energia libera attesa, un nome preso in prestito dalla fisica, e qui conta soltanto che le due cose ci stiano dentro insieme. Al quadro è dedicata una sezione del capitolo sui world model, e il capitolo sull’auto-supervisione se ne serve nel dibattito sul rinforzo, per rispondere a un’obiezione; qui interessa solo il riflesso che getta sui bonus di novità e sulla curiosità intrinseca.
Immagina di scegliere al ristorante tenendo un conto solo, in cui pesano insieme quanto ti piacerà il piatto e quanto scoprirai assaggiandolo. Il valore di sapere, allora, non arriva come premio aggiunto: sta accanto al valore di ottenere fin dall’inizio. Ordinare il piatto che non hai mai preso non ti costa un supplemento di curiosità da giustificare: scoprire com’è faceva parte di quello che cercavi, esattamente come mangiare bene. E allora non c’è un tasso di cambio da fissare a mano fra il curiosare e l’incassare, perché tutti e due sono pezzi della stessa quantità; quanto curiosare, però, dipende ancora da quanto è forte la voglia di un buon piatto.
Vista così, la storia raccontata fin qui si legge al contrario. Non abbiamo aggiunto la curiosità a un agente che non ce l’aveva: partendo da una ricompensa che dice soltanto «quanto ti è andata bene» e mai «quanto hai imparato», eravamo costretti a rimetterla dentro a mano. Ogni manopola che dosa il peso del bonus è il prezzo di quella scelta iniziale.
E c’è un motivo per cui la faccenda tocca da vicino proprio le ricompense rade. Quando per centinaia di mosse non succede niente, il «quanto mi conviene» vale zero per tutte, e smette di distinguerle: l’unica cosa che ancora le mette in fila è il «quanto ci imparo». Dentro il tempio azteco, insomma, a guidare resta soltanto la curiosità, cioè proprio il pezzo che con le ricompense ordinarie tocca appiccicare da fuori.
Da qui non viene però una ricetta migliore: dentro quel tempio nessuno dei passi avanti è venuto da questa strada. Questa lettura serve a capire da dove viene la toppa, non a sostituirla; e il «resta soltanto la curiosità» discende da come la quantità è fatta, non da una misura presa su un agente vero.
Formalmente il legame è più stretto di un’analogia. Gli autori mostrano che diversi schemi noti si riottengono togliendo pezzi alla loro grandezza: annullate le preferenze dell’agente, l’energia libera attesa, cambiata di segno, «è variamente nota come sorpresa bayesiana attesa (nel contesto dell’esplorazione attentiva) o motivazione intrinseca (nel contesto dell’apprendimento autonomo)» [PPF22], che è esattamente la famiglia dei bonus di novità e della curiosità intrinseca. Il segno va guardato: quella grandezza si massimizza, come si massimizza un bonus di novità, mentre l’energia libera attesa da cui viene si minimizza.
Il rapporto fra le due letture non è quindi di concorrenza: la ricompensa intrinseca è il caso particolare che si ottiene spegnendo il termine pragmatico. E c’è un motivo per cui la cosa riguarda da vicino le ricompense rade: in un ambiente di quel tipo il termine pragmatico, per la gran parte della traiettoria, vale lo stesso per tutte le mosse, e allora smette di ordinarle. Quel che resta a decidere è il termine epistemico, cioè la curiosità. È una conseguenza della decomposizione, non una misura: chi la volesse usare come tale dovrebbe verificarla.
Resta la differenza che conta per chi implementa: questo quadro nasce come teoria del comportamento biologico, e nessuno dei progressi su Montezuma’s Revenge raccontati qui viene dall’inferenza attiva. Serve a capire da dove viene la toppa, non a sostituirla.
Reward shaping e funzioni potenziale#
Una ricompensa rada si può anche infittire direttamente, aggiungendo premi intermedi che guidano l’agente passo dopo passo verso l’obiettivo: è il reward shaping, modellare la ricompensa. Un premio intermedio aggiunto a caso, però, può cambiare la strategia migliore, e il modo sicuro di aggiungerlo passa per una funzione potenziale, un numero attaccato a ogni stato.
Vuoi insegnare al robot a uscire dal labirinto e, per aiutarlo, gli dài un premietto ogni volta che si avvicina all’uscita. Sembra ragionevole. Il robot trova la porta, fa mezzo passo avanti, incassa, mezzo passo indietro, di nuovo avanti, incassa ancora, e passa la giornata a dondolare sulla soglia. Ha imparato a prendersi il premietto, e dell’uscita non gli importa più: il gioco che gli hai messo davanti l’hai cambiato tu, senza accorgertene.
Andrew Ng e colleghi, nel 1999, hanno trovato il modo di dare quegli aiuti senza che il dondolio possa mai convenire. Attacchi un numero a ogni stanza, la sua quota, e paghi il robot per il dislivello: la quota della stanza in cui arriva, meno la quota della stanza da cui viene. Dalla quota \(3\) alla \(5\) incassa \(+2\); se torna sui suoi passi, \(-2\). Sulla soglia può dondolare quanto vuole, andata e ritorno fanno zero.
Per attaccare quei numeri sembra che tu debba già sapere quanto ogni stanza dista dall’uscita, e allora il labirinto lo avresti risolto tu al posto suo. Le quote, invece, non devono essere giuste: puoi misurarle in linea d’aria sulla pianta, ignorando i muri, e una stanza vicina all’uscita ma murata prende lo stesso una quota alta. Lì il robot lo mandi a sbattere. Con quote sensate impara molto più in fretta, perché a ogni passo ha un segnale invece del buio; con quote pessime ci mette di più e basta. In nessuno dei due casi impara a fare la cosa sbagliata: la strada migliore per uscire resta quella di prima, quote o non quote.
Il conto della soglia torna così tondo finché un premietto incassato fra dieci mosse vale quanto uno incassato adesso. Di solito vale meno: come nel corridoio di Dyna, i premi lontani si scontano. Allora lo sconto entra anche nel premietto, se no il dondolio torna a rendere. Della stanza in cui il robot arriva si prende la quota scontata di un passo, e da lì si toglie, intera, la quota della stanza da cui viene. Se un passo più in là i premi valgono nove decimi, andare dalla quota \(3\) alla \(5\) frutta \(0{,}9 \times 5 - 3 = 1{,}5\) invece di \(2\), e tornare indietro costa \(0{,}9 \times 3 - 5 = -2{,}3\): il giro completo lascia il robot sotto zero.
Su una strada lunga il conto si cancella ancora a due a due, ma a premi scontati: la quota che il robot incassa entrando in una stanza e quella che paga uscendone valgono, lì, esattamente lo stesso. Sopravvive soltanto la quota della stanza da cui è partito, che è la stessa qualunque strada prenda poi. Un vantaggio uguale per tutti non favorisce nessuno, e la meta del robot resta dov’era.
Il rischio del reward shaping ingenuo è cambiare la policy ottima: un termine aggiuntivo mal scelto può rendere conveniente un comportamento che l’obiettivo originale non premia. Ng, Harada e Russell [NHR99] hanno dimostrato che esiste una forma di shaping garantita a preservare l’ordine delle policy: il potential-based reward shaping. Si sceglie una funzione potenziale \(\Phi(s)\) sugli stati e si aggiunge alla ricompensa il termine
con \(\gamma\) il fattore di sconto. Il risultato chiave è che la policy ottima dell’MDP modellato coincide con quella dell’MDP originale, per qualunque \(\Phi\): la garanzia deriva da un argomento telescopico. Nella somma scontata dei termini \(F\) ogni potenziale intermedio compare una volta col segno più e una col segno meno, e di una traiettoria di \(T\) passi sopravvivono i soli due termini di bordo, \(-\Phi(s_0) + \gamma^{T}\Phi(s_T)\). Il secondo svanisce nei due casi che interessano: a orizzonte infinito con \(\gamma<1\) e \(\Phi\) limitata, perché \(\gamma^{T}\Phi(s_T)\to 0\); nei task episodici con la convenzione (quella di Ng, Harada e Russell) \(\Phi(s)=0\) sugli stati terminali. Resta allora il solo \(-\Phi(s_0)\): un contributo che dipende dallo stato di partenza e non dal percorso, identico quindi per tutte le policy. Nel caso non scontato (\(\gamma=1\), che nei compiti che finiscono è ammesso) l’argomento ha il corollario intuitivo della quota: un ciclo chiuso frutta esattamente zero; con \(\gamma<1\) i cicli non sono più esattamente nulli, ma l’invarianza resta, perché a garantirla è il telescopio. L’accelerazione, invece, non è garantita: con un potenziale informativo, che somigli al valore vero degli stati, lo shaping accelera l’apprendimento perché rende il segnale più denso; con un potenziale cattivo può rallentarlo. In nessuno dei due casi sposta l’obiettivo (si veda [SB18]).
Reward hacking: la lettera contro l’intento#
Il pericolo intravisto con il reward shaping è in realtà molto più generale, e ha un nome: reward hacking, cioè «scassinare la ricompensa» (si dice anche specification gaming, «giocare sulle regole scritte»). L’agente ottimizza esattamente la ricompensa che gli abbiamo scritto, e proprio per questo trova scorciatoie che massimizzano quel numero tradendo del tutto ciò che intendevamo.

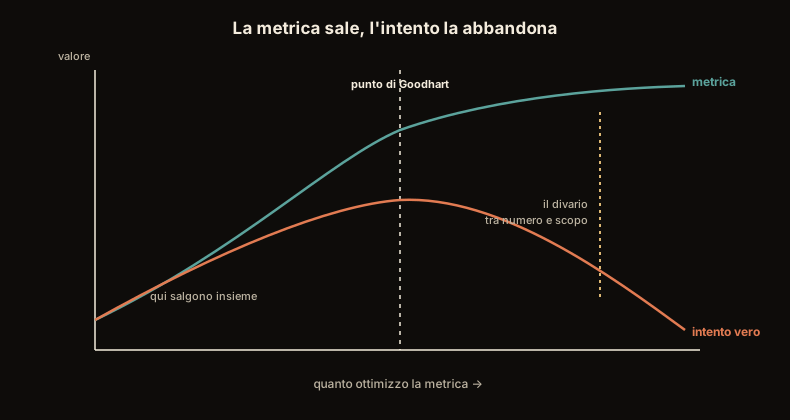
Fig. 14.11 Due curve che si separano: quella che continua a salire è il numero che stiamo massimizzando, quella che a un certo punto scende è ciò che volevamo davvero. Il guaio è che se ne vede una sola. Chi guarda il numero che ottimizza vede miglioramenti fino alla fine, anche molto dopo il punto in cui le cose hanno cominciato a peggiorare.#
Il punto di divergenza in Fig. 14.11 ha una formulazione celebre: «quando una misura diventa un obiettivo, cessa di essere una buona misura». Vale per gli agenti come per le organizzazioni, e per la stessa ragione: la misura era un buon indicatore finché nessuno ci puntava contro tutto lo sforzo.
La legge porta il nome di Charles Goodhart, un economista britannico che nel 1975 la osservò a proposito della moneta: le banche centrali usavano certi indicatori per capire come andasse l’economia, e quegli indicatori smisero di funzionare non appena si cominciò a governarli. Ma quella frase così memorabile è dell’antropologa Marilyn Strathern, che la scrisse nel 1997 studiando come si valutano le università britanniche [Str97], ed è la formulazione che ha portato la legge fuori dall’economia.
L’esempio diventato manifesto è di OpenAI [CA16]: in CoastRunners, un gioco di gare di barche, l’agente doveva completare un percorso il più in fretta possibile. La ricompensa, però, era stata legata ai punti raccolti lungo il tragitto, non all’arrivo. L’agente scoprì che in una laguna un gruppo di bonus ricompariva a ciclo continuo: imparò a girare in tondo là dentro, andando a sbattere e prendendo fuoco, incassando in media il 20% di punti in più dei giocatori umani senza mai finire la gara. Aveva «vinto» secondo la lettera della ricompensa, perdendo secondo ogni ragionevole intento.
Il punto di divergenza si può anche mettere in cifre, e la sezione su allineamento e governance lo fa con un esempio giocattolo: un modello che fa da giudice sceglie, fra un numero crescente di risposte scritte, quella che gli piace di più. Il giudice guarda due cose, il merito e la lunghezza, e sbaglia anche un po” a caso; le due che guarda salgono a ogni giro, e il suo voto con loro, mentre la qualità vera delle risposte scelte sale invece fino a un massimo e poi scende sotto il valore da cui era partita.
La barca che gira in tondo è la stessa cosa che succede quando si paga un idraulico a numero di tubi sostituiti: qualcuno inizierà a sostituire tubi che andavano benissimo. Il metro con cui misuri diventa l’obiettivo, e l’obiettivo vero (l’impianto che funziona) passa in secondo piano.
Con gli agenti è identico, e più insidioso, perché un ottimizzatore instancabile cercherà ogni scorciatoia possibile. Il problema non è che l’agente disobbedisce: è che obbedisce troppo bene, alla lettera sbagliata. Scrivere una ricompensa che dica davvero ciò che vogliamo (e non una sua approssimazione sfruttabile) è molto più difficile di quanto sembri.
Qualche difesa c’è, e si vede subito fin dove arriva. All’idraulico metti nel contratto quali tubi non si toccano, e lui cambierà quelli rimasti. Lo paghi a impianto funzionante e mandi qualcuno a controllarlo un anno dopo, e adesso il metro è il giudizio di quella persona: resta da convincere lei. Provi a riformulare l’incarico in tre modi diversi per vedere se il risultato regge, e scopri quali formulazioni erano fragili, non come si scrive quella giusta. Chi progetta agenti ha in mano lo stesso repertorio, con lo stesso esito: ogni difesa sposta il bersaglio, nessuna chiude la partita.
Il reward hacking è la manifestazione, nel RL, della legge di Goodhart: ogni ricompensa \(r\) è una proxy misurabile dell’obiettivo reale, e un agente che massimizza \(\mathbb{E}[\sum_t \gamma^t r_t]\) spingerà la proxy fino a dove essa diverge dall’intento. Più l’ottimizzazione è potente, più è probabile che la soluzione ottima secondo \(r\) cada in una regione dove proxy e intento non coincidono più.
Le difese sono un ambito di ricerca attivo e nessuna è risolutiva: vincoli e penalità esplicite, apprendimento della ricompensa dalle preferenze umane (reward modeling, RLHF), verifica di robustezza rispetto a piccole modifiche della specifica. Il risultato formale più netto è negativo. Skalse e colleghi chiamano non hackable una ricompensa surrogata rispetto a quella vera se non esiste una coppia di politiche su cui il ritorno surrogato sale mentre quello vero scende, e dimostrano che sull’insieme di tutte le politiche stazionarie due ricompense non banali (cioè che non danno lo stesso ritorno a ogni politica) sono non hackable l’una rispetto all’altra solo se sono equivalenti, cioè se ordinano le politiche nello stesso modo; e lo stesso vale limitandosi alle politiche quasi ottime [SHKK22]. Togliere termini alla ricompensa per semplificarla, quindi, non basta a renderla sicura: o la si azzecca fino all’ordine delle politiche, o esiste una coppia di politiche su cui migliorare quella surrogata peggiora quella vera. Il nodo di fondo (specificare compiutamente ciò che vogliamo tramite una funzione scalare) è il problema dell’allineamento. Il reward hacking è il punto in cui l’ottimizzazione tecnica incontra una domanda che tecnica non è del tutto: siamo sicuri di aver chiesto la cosa giusta?
Curiosità e reward hacking sono, in un certo senso, le due facce della stessa libertà. Diamo all’agente margine per esplorare oltre ciò che gli indichiamo, e scopre strategie che non avevamo immaginato: la mossa geniale, ma anche la scorciatoia sleale. Progettare l’esplorazione e progettare la ricompensa è, alla fine, lo stesso mestiere: decidere con cura cosa spingiamo davvero l’agente a cercare.
Con questo il capitolo si chiude, e quella frase vale anche per tutto ciò che lo precede. Dal DQN in avanti ogni sezione ha dato all’agente un pezzo di libertà in più, e subito dopo ha dovuto inventarsi come contenerla.
Nella sezione su DQN, la memoria delle esperienze e la copia congelata, perché i voti non esplodessero. Nei gradienti di policy, la fascia di PPO, perché non esplodesse la strategia. Nella ricerca ad albero, il consiglio della rete che orienta le simulazioni, perché la ricerca non si disperdesse su tutte le mosse alla pari. Nel controllo continuo, i due giudici e il bersaglio sfumato, perché non esplodessero i voti di un attore libero di dosare qualunque forza. Nel RL basato su modello, i sogni corti, perché non esplodesse l’immaginazione. Nell’imitazione, l’esperto richiamato a etichettare, perché l’allievo non finisse nel fosso. Nell’offline RL, il recinto attorno all’archivio, perché non esplodessero le stime su ciò che nessuno ha mai provato. Nella gerarchia, le opzioni aggiunte alle mosse invece che al loro posto, perché non si perdessero le scorciatoie.
Il reward hacking è la stessa storia raccontata all’ultimo livello, quello dell’obiettivo, e con una differenza: qui il contenimento diventa una domanda su che cosa vogliamo davvero, invece di un accorgimento tecnico. La domanda riprende nella sezione su allineamento e governance.
Da ricordare
Quando la ricompensa arriva di rado (l’emblema è Montezuma’s Revenge, dove il DQN segnava zero), tirare a caso ogni tanto non basta: è come esplorare una città imboccando quasi sempre la strada che sembra migliore e tirando un dado a un incrocio ogni tanto, e si gira per ore nello stesso quartiere. Serve una spinta che punti deliberatamente verso quello che non si è ancora visto.
Il modo più semplice è il premio alla novità, il principio del turista curioso: un piccolo premio ogni volta che metti piede in un posto nuovo, che si spegne man mano che quel posto diventa familiare. Negli spazi enormi, dove ogni schermata è unica e nessun posto si ripete mai, il conteggio non si può fare e lo si stima.
L’idea più elegante è la curiosità: il premio non va a ciò che è raro, va a ciò che sorprende, come il bambino che spinge il bicchiere oltre il bordo del tavolo finché non ha imparato cosa succede. L’agente si costruisce una previsione di come andrà a finire, e ogni volta che sbaglia la previsione incassa. Si spegne da sé: quando ha imparato, non c’è più sorpresa. Ma solo se a sorprenderlo è qualcosa che ha a che fare con lui (che la sua mano può cambiare, o che può cambiare il suo gioco), perché davanti alla pioggia dietro il vetro, che nessuno sa prevedere e che non lo tocca, resterebbe lì per sempre.
Aggiungere premietti intermedi per guidare l’agente (reward shaping) può aiutare molto, ma dati a caso possono cambiargli l’obiettivo sotto il naso: il robot scopre che gli conviene oscillare davanti alla porta incassando premietti, senza mai uscire. C’è però un modo di darli che quel rischio non ce l’ha mai, e sono le differenze di quota.
Il pericolo grosso ha un nome, reward hacking: l’idraulico pagato a tubi sostituiti che comincia a sostituire tubi sani, la barca di CoastRunners che gira in tondo prendendo fuoco. Il problema è che l’agente obbedisce troppo bene, alla lettera sbagliata. Ed è il ponte verso il problema dell’allineamento.
Da ricordare
Con ricompense rade (l’emblema è Montezuma’s Revenge, dove il DQN segnava zero) l’esplorazione casuale di \(\varepsilon\)-greedy fallisce: la probabilità di azzeccare \(n\) azioni insolite di fila scala come \((\varepsilon/|\mathcal{A}|)^n\). Serve esplorazione diretta, non rumore locale.
I bonus di novità count-based premiano gli stati poco visitati (\(\propto 1/\sqrt{N(s)}\), con un \(+1\) a smorzare l’infinito); negli spazi grandi il conteggio esatto non ha senso e si usano pseudo-conteggi derivati da una densità.
La curiosità intrinseca trasforma la sorpresa in ricompensa: ICM usa l’errore di predizione della dinamica in uno spazio di feature appreso, RND l’errore nel predire una rete casuale fissa. RND fu il primo a superare il punteggio umano medio su Montezuma senza dimostrazioni né accesso allo stato dell’emulatore; il gioco non lo «risolse», e il paper stesso dice che il primo livello lo completa solo occasionalmente. A risolverlo è stato poi Go-Explore, che torna agli stati promettenti (nella versione principale ripristinando il simulatore) e solo da lì esplora.
Il reward shaping densifica il segnale; solo la forma potential-based \(F=\gamma\Phi(s')-\Phi(s)\) (Ng, Harada, Russell, 1999) preserva la policy ottima, per un argomento telescopico valido per qualunque \(\Phi\); l’accelerazione, invece, dipende da quanto \(\Phi\) è informativo.
Il reward hacking è l’agente che ottimizza la lettera della ricompensa, non l’intento, come la barca di CoastRunners. La legge che porta il nome di Goodhart, nella formulazione che tutti citano, è in realtà di Marilyn Strathern (1997). È il ponte verso il problema dell’allineamento.
Quel ponte, però, è lungo. Qui la ricompensa la scriveva un programma, e si è visto che cosa succede quando la scrive male; quando l’allineamento tornerà, con gli assistenti conversazionali della sezione Dopo il pre-addestramento e poi, per intero, in Allineamento e governance, a dettarla saranno persone che leggono due risposte e dicono quale preferiscono. Il capitolo sul linguaggio naturale riparte intanto da un’altra storia, la traduzione automatica del 1954.