


Oltre il BPE: WordPiece, SentencePiece e i byte#
WordPiece: non il più frequente, il meno casuale#
Il criterio della frequenza ha un limite che si vede bene
nell’esempio svolto con le
cinque parole. BPE ha fuso per prima la coppia ss perché la s è una lettera
comunissima e le doppie italiane sono ovunque: la coppia è frequente
soprattutto perché i suoi pezzi lo sono. Ma «frequente» e «significativo» non
sono la stessa cosa. In quel corpus la a compare solo dopo la b: ba è
una coppia rara in assoluto (8 occorrenze contro 25), ma è una coppia che non
capita mai per caso.
Da qui il criterio alternativo di WordPiece, introdotto da Mike Schuster e
Kaisuke Nakajima nel 2012 per la ricerca vocale in giapponese e coreano
[SN12] e diventato noto anni dopo come il tokenizzatore
di BERT [DCLT19]. La struttura dell’algoritmo è identica a
quella di BPE: si parte dai caratteri e si fonde una coppia per volta fino a
riempire il vocabolario. Cambia solo quale coppia si sceglie: nel lavoro
originale quella che fa crescere di più la verosimiglianza del corpus, nella
ricostruzione che si è diffusa quella che sta insieme più di quanto farebbe
per caso, ed è questa seconda a preferire ba.
In un giornale, «di» seguito da «un» capita in continuazione e non vuol dire niente: capita perché entrambe sono parole comunissime. «Acqua» seguito da «minerale» è molto più raro in assoluto, eppure ogni volta che leggi «minerale» prima c’era «acqua». La seconda coppia dice qualcosa; la prima è rumore di fondo.
WordPiece, almeno nella versione che si insegna di solito, fa proprio questa distinzione. (È una ricostruzione fatta da chi l’ha studiato, perché la ricetta con cui Google ha addestrato BERT non è mai stata pubblicata.) Invece di chiedersi «quante volte questi due pezzi si trovano attaccati?», si chiede: «si trovano attaccati più di quanto capiterebbe per caso?». Il conto è semplice: si prende quante volte la coppia compare e la si divide per quanto sono comuni i due pezzi presi singolarmente. Un pezzo che è dappertutto viene penalizzato, e le sue coppie devono essere davvero frequenti per vincere.
Nel nostro corpus di cinque parole, con questo criterio, la prima fusione non è
più ss ma ba, e il conto si può rifare a mano con due divisioni. Nei 146
caratteri del corpus la s compare 50 volte e la coppia ss 25: il punteggio è
25 diviso (50 per 50), cioè 0,01. La b compare 11 volte, la a 8 e la coppia
ba 8: il punteggio è 8 diviso (11 per 8), cioè circa 0,09, nove volte tanto.
La s è talmente diffusa che le sue coppie non stupiscono nessuno, mentre la
a, che si presenta sempre e solo dopo la b, è una compagnia troppo fedele
per essere una coincidenza. BPE premia ciò che ricorre, WordPiece premia ciò
che sta insieme per una ragione.
Questa divisione, però, non guarda quanto lavoro farà la fusione. Torna al
giornale e mettiamo che «acqua» compaia 40 volte e «minerale» 12, sempre
preceduto da «acqua»: il punteggio della coppia è 12 diviso (40 per 12), cioè
0,025. Adesso prendi due parole che in tutto il giornale compaiono due volte
ciascuna, sempre una di seguito all’altra, come il nome e il cognome di un tale
che il giornale nomina in due righe e mai più: il punteggio è 2 diviso (2 per
2), cioè 0,5, venti volte tanto. Vincono loro, e incollarle accorcia il giornale
in due punti invece che in dodici. Il criterio misura quanto una coppia è
sorprendente, non quante volte tornerà utile, e giudica come se dovesse servire
una volta sola. Nel corpus delle cinque parole si vede già in piccolo: et, che
compare 5 volte, passa davanti a ro, che ne compare 14. Il criterio originale
di WordPiece quel lavoro lo contava, e sulle cinque parole avrebbe scelto
ancora ss: incollare le due s toglie dal corpus venticinque pezzi in un
colpo solo.
Il criterio del lavoro originale è: a ogni passo si aggiunge al vocabolario
l’unità ottenuta combinandone due esistenti che aumenta di più la
verosimiglianza dei dati sotto il modello di linguaggio. Nella forma in cui
l’algoritmo si è poi diffuso quel modello è un unigramma, cioè un modello
che assegna a una segmentazione \(x = (x_1, \dots, x_n)\) la probabilità
\(P(x) = \prod_{i=1}^{n} p(x_i)\) con \(p\) stimata per frequenza relativa. Sotto
questo modello il guadagno di log-verosimiglianza di una fusione si calcola
ricontando i simboli dopo averla fatta; quando la fusione consuma una piccola
parte delle occorrenze dei suoi pezzi vale circa
\(\mathrm{freq}(ab)\,\bigl(\mathrm{PMI}(a,b) - 1\bigr)\), con
\(\mathrm{PMI}(a,b)\) l’informazione mutua puntuale fra i due simboli in
logaritmo naturale, e pesa quindi anche quante volte la fusione si applica.
L’implementazione con cui Google ha addestrato il vocabolario di BERT non è mai
stata pubblicata, e il criterio che circola è una ricostruzione dalla
letteratura, proposta nel corso di Hugging Face sui tokenizzatori. La loro
libreria tokenizers non la usa: il suo addestratore WordPiece fonde per
frequenza, come BPE, e aggiunge soltanto il prefisso ## ai pezzi non iniziali.
La ricostruzione lascia cadere il peso e valuta il guadagno per occorrenza;
un’euristica ispirata alla verosimiglianza, più che una sua conseguenza:
dove \(\mathrm{freq}(a)\) è il numero di occorrenze del simbolo \(a\) nel corpus segmentato allo stato corrente e \(\mathrm{freq}(ab)\) quello della coppia adiacente. È una trasformazione monotona dell’informazione mutua puntuale (PMI): passando dalle frequenze assolute a quelle relative, il rapporto diventa \(\frac{p(ab)}{p(a)\,p(b)}\) a meno di un fattore che dipende solo dalla taglia del corpus, quindi costante entro un singolo passo e ininfluente sull’\(\arg\max\). Quel rapporto è l’esponenziale della PMI fra \(a\) e \(b\), che per definizione è il suo logaritmo, \(\mathrm{PMI}(a,b) = \log \frac{p(ab)}{p(a)\,p(b)}\): il rapporto vale \(1\) (e la PMI zero) quando i due simboli si incontrano esattamente come farebbero per caso, più di \(1\) quando si attirano.
Sul corpus giocattolo dell’esempio svolto, al primo passo (frequenze dei
simboli: s 50, o 44, t 14, r 14, b 11, a 8, e 5, su 146
caratteri):
coppia |
\(\mathrm{freq}(ab)\) |
\(\mathrm{freq}(a)\) |
\(\mathrm{freq}(b)\) |
punteggio |
|---|---|---|---|---|
|
8 |
11 |
8 |
0,0909 |
|
5 |
5 |
14 |
0,0714 |
|
7 |
14 |
14 |
0,0357 |
|
14 |
14 |
44 |
0,0227 |
|
25 |
50 |
50 |
0,0100 |
La coppia più frequente in assoluto, s s, scende all’ottavo posto su dodici;
vince b a, che ha un terzo delle occorrenze ma due componenti rari. Il
denominatore è esattamente il correttivo: penalizza le coppie che devono la
loro frequenza alla diffusione dei pezzi.
Il criterio originale, però, sulle stesse cinque parole non avrebbe scelto
ba. Lo si vede ricalcolando per ogni coppia il guadagno esatto di
log-verosimiglianza sotto l’unigramma, ricontando i simboli dopo la fusione,
accanto al punteggio per occorrenza:
import math
from collections import Counter

corpus = {"basso": 6, "bassotto": 2, "bosso": 3, "rosso": 9, "rossetto": 5}
parole = {p: tuple(p) for p in corpus}      # si parte dai caratteri


def conteggi(segmentate):
    """Occorrenze di ogni simbolo, pesate sulla frequenza delle parole."""
    c = Counter()
    for p, simboli in segmentate.items():
        for s in simboli:
            c[s] += corpus[p]
    return c


def log_verosimiglianza(segmentate):
    """Log-verosimiglianza sotto un unigramma a frequenze relative."""
    c = conteggi(segmentate)
    T = sum(c.values())
    return sum(n * math.log(n / T) for n in c.values())


def fondi(simboli, coppia):
    uniti, i = [], 0
    while i < len(simboli):
        if tuple(simboli[i:i + 2]) == coppia:
            uniti.append(simboli[i] + simboli[i + 1]); i += 2
        else:
            uniti.append(simboli[i]); i += 1
    return tuple(uniti)


def guadagno(coppia):
    """Di quanto cresce la log-verosimiglianza se si fonde la coppia."""
    dopo = {p: fondi(s, coppia) for p, s in parole.items()}
    return log_verosimiglianza(dopo) - log_verosimiglianza(parole)


c = conteggi(parole)
coppie = Counter()
for p, simboli in parole.items():
    for a, b in zip(simboli, simboli[1:]):
        coppie[(a, b)] += corpus[p]

print("coppia  freq  guadagno esatto  freq(ab)/(freq(a) freq(b))")
for (a, b), n in sorted(coppie.items(), key=lambda kv: -guadagno(kv[0])):
    print(f"{a + b:>6}  {n:>4}  {guadagno((a, b)):>15.2f}"
          f"  {n / (c[a] * c[b]):>26.4f}")
coppia  freq  guadagno esatto  freq(ab)/(freq(a) freq(b))
    ss    25            32.19                      0.0100
    ba     8            24.56                      0.0909
    ro    14            18.61                      0.0227
    tt     7            18.39                      0.0357
    et     5            12.66                      0.0714
    as     8             9.03                      0.0200
    se     5             5.53                      0.0200
    to     7            -0.89                      0.0114
    bo     3            -2.77                      0.0062
    ot     2            -3.31                      0.0032
    so    20            -5.65                      0.0091
    os    17            -8.88                      0.0077
Il guadagno esatto indica ancora ss, con \(32{,}19\) contro i \(24{,}56\) di
ba: fondere le due s toglie dal corpus un simbolo intero e accorcia il
testo di 25 pezzi, e la verosimiglianza ci guadagna più che con qualunque
coppia sorprendente. È la differenza fra pesare il guadagno per quante volte la
fusione si applica e valutarlo per occorrenza, approccio che sceglie ba.
L’approssimazione \(\mathrm{freq}(ab)\,(\mathrm{PMI} - 1)\) qui non aiuta,
perché vale quando la fusione consuma una piccola parte delle occorrenze dei
suoi pezzi, e la fusione di ss le consuma tutte.
Sul piano pratico, nell’implementazione resa popolare da BERT i pezzi non
iniziali portano il prefisso ##, così che bassetto possa uscire come
bass, ##etto e la ricomposizione sia priva di ambiguità (##etto non è lo
stesso token di etto a inizio parola: la distinzione fra prefissi e suffissi
è codificata nel vocabolario, non ricostruita a valle; il lavoro del 2012
otteneva lo stesso effetto con un marcatore di spazio attaccato alle unità).
BERT usa un vocabolario di circa \(30\,000\) token così costruiti. In fase di
codifica, inoltre, quella implementazione non replica una lista di fusioni ma
applica una scansione greedy del prefisso più lungo presente nel vocabolario:
differenza sottile che può produrre segmentazioni diverse da quelle che
l’applicazione di BPE darebbe a parità di vocabolario. Diverso è anche il
fallimento: se da un certo punto della parola nessun prefisso sta nel
vocabolario, l’implementazione di BERT restituisce [UNK] per la parola
intera, e non per il solo pezzo mancante.
SentencePiece e i byte: togliere gli ultimi presupposti#
BPE e WordPiece, così come li abbiamo descritti, danno per scontata una cosa: che il testo arrivi già diviso in parole. Entrambi partono da un dizionario parola \(\to\) frequenza, e quel dizionario qualcuno lo deve costruire, tagliando il testo sugli spazi e sulla punteggiatura. È un presupposto innocuo in italiano e in inglese, e falso in giapponese, in cinese e in thailandese, dove gli spazi fra le parole semplicemente non ci sono. In quelle lingue serve un segmentatore addestrato a parte, che diventa un pezzo in più da mantenere e una fonte in più di errori.
SentencePiece, presentato da Taku Kudo e John Richardson nel 2018 [KR18], toglie il presupposto nel modo più diretto possibile: non tratta il testo come una lista di parole, ma come un flusso grezzo di caratteri in cui lo spazio è un carattere come gli altri.
In una collana non ci sono vuoti, e «il gatto nero» ci entra così: al posto di
ogni spazio va una perlina segnaposto, ▁ (una barretta bassa, non un trattino
di sottolineatura), attaccata alla parola che comincia. Viene ▁il▁gatto▁nero,
una fila ininterrotta su cui BPE gira come prima. In giapponese, dove gli spazi
non ci sono, non cambia niente: la fila era già così.
Quando si scelgono le perline, però, la fila di solito si taglia lo stesso a
ogni barretta, e nessuna perlina nuova ne scavalca una: un pezzo come
▁sul▁muro nasce solo se lo si chiede. Dove barrette non ce ne sono, il pezzo
da guardare è la frase intera, e quanto può essere lunga una perlina lo si fissa
a parte.
Per riavere la frase basta riaccostare i pezzi e rimettere uno spazio dove c’è la barretta, senza regole su dove ci va e dove no (prima di gatto sì, prima della virgola no, dopo l’apostrofo nemmeno). La frase torna com’era, apostrofi e punteggiatura compresi. Torna, per la precisione, com’era dopo la pulizia che si fa prima di infilarla, quella che per esempio riduce a uno solo due spazi di fila: quella pulizia non si disfa, tutto il resto sì.
I pezzi si possono anche scegliere al rovescio di BPE, e se non si chiede altro
è così che si fa. Invece di partire dalle lettere e incollare, si parte da una
scatola troppo piena: dentro ci sono tutte le perline che nel testo ricorrono un
po’, molte più di quante ne servano. Ogni perlina ha un punteggio, e un modo di
infilare una parola vale il prodotto dei punteggi delle sue perline. Se gatt
vale 0,02 e ino 0,05, gattino infilata come gatt+ino vale 0,001; se
gat vale 0,01 e tino 0,02, infilata come gat+tino vale 0,0002, e il
primo modo vince. I punteggi si scoprono usando le perline: si infilano tutte le
frasi del testo in tutti i modi possibili, ciascuno pesato con il suo valore, si
conta quanto è servita ogni perlina, quei conti diventano i punteggi nuovi, e si
ricomincia finché non cambiano più.
Poi si toglie. Per ogni perlina si guarda quanto peggiorerebbero le collane del testo se mancasse, e a ogni giro si butta una parte di quelle di cui si sente meno la mancanza, tenendo sempre le perline di una lettera sola, perché senza di loro qualche collana non si infilerebbe più. Si rifà il giro finché nella scatola resta il numero di perline che ci si era prefissi.
Davanti a una parola nuova non si ripetono incollaggi: si cerca il modo di infilarla con il punteggio più alto. E siccome ogni modo ha il suo punteggio, in allenamento si può anche pescare a sorte fra i modi migliori, dando più biglietti a quelli col punteggio più alto, così che il modello veda la stessa parola infilata in modi diversi senza affezionarsi a uno solo. Quanti biglietti in più dare ai migliori lo regola una manopola: girata al massimo vince sempre il primo modo, girata al minimo tutti hanno le stesse possibilità.
Resta un buco. Le perline sono fatte delle lettere già viste, e le lettere del
mondo sono oltre centomila: nessun corpus le contiene tutte. Un ideogramma raro,
un simbolo matematico, un’emoji uscita ieri, e in mano resta un <UNK>, lo
stesso buco intravisto con rossellini.
Guarda una perlina più da vicino: anche quella che sembra una lettera è l’incastro di perline più piccole, e queste hanno un nome, byte. Ne esistono 256 tipi, tante quante le combinazioni di otto caselle da zero o uno con cui un computer scrive qualunque cosa: non 256 nei testi che si sono visti, 256 e basta, e non le ha scelte nessuno. Un ideogramma o un’emoji ne occupano più d’una, ma sempre di quelle. La scatola di partenza copre tutto per costruzione, e «sconosciuto» esce dal dizionario.
C’è un prezzo, e si paga sulla lunghezza della collana. Una lettera accentata sono due perline, un ideogramma tre, un’emoji quattro; se quelle sequenze non ricorrono abbastanza da meritarsi una perlina loro, vanno infilate una alla volta, e un solo ideogramma giapponese può costare più pezzi di un’intera parola inglese. Il conto arriva alle lingue che nel mucchio di testo di partenza c’erano poco.
SentencePiece è insieme un formato e una libreria, e va guardato su due piani: come tratta il testo in ingresso, e con quale algoritmo costruisce il vocabolario.
Il primo piano è la normalizzazione e la reversibilità. L’input è trattato come
una sequenza Unicode, passata per una normalizzazione (nella configurazione
predefinita la regola nmt_nfkc, cioè NFKC più alcune regole pensate per la
traduzione, e gli spazi ripetuti fusi in uno solo), in cui lo spazio è
rimpiazzato dal meta-simbolo ▁ (U+2581, LOWER ONE EIGHTH BLOCK) prefisso al
segmento che segue. La decodifica è la concatenazione dei token seguita dalla
sostituzione inversa, e vale l’identità
dove \(s\) è il testo grezzo e \(\mathrm{norm}\) la normalizzazione scelta. È la
proprietà che gli autori chiamano tokenizzazione lossless, e che nelle
pipeline basate su tokenizzatori dipendenti dalla lingua non è garantita,
perché la detokenizzazione è lì una collezione di regole ad hoc. Lo spazio,
però, resta un confine anche qui: con l’impostazione predefinita
(split_by_whitespace=True) l’addestramento divide il testo sugli spazi prima
di contare, e nessun pezzo attraversa un ▁; solo spegnendola compaiono pezzi
come ▁sul▁muro. Per le lingue senza spazi la «parola» diventa la frase
intera, e la lunghezza dei pezzi la limita max_sentencepiece_length.
Il secondo piano è l’algoritmo di costruzione del vocabolario. SentencePiece offre BPE, ma la sua scelta predefinita è il modello unigram [Kud18], che procede al contrario: si parte da un vocabolario candidato ampio \(V\) e lo si pota. A \(V\) fissato, il modello è lo stesso unigramma già incontrato con WordPiece, cioè assegna a una segmentazione \(x = (x_1,\dots,x_n)\) di una stringa la probabilità \(P(x) = \prod_{i=1}^{n} p(x_i)\), ma qui la verosimiglianza di una stringa \(s\) è la somma su tutte le segmentazioni possibili, \(P(s) = \sum_{x \in S(s)} P(x)\). Le \(p(x_i)\) si stimano con l’algoritmo EM (lo stesso delle misture gaussiane della sezione su riduzione e clustering: qui la variabile nascosta, quella che renderebbe facile la stima, è la segmentazione e non l’identità della componente); poi, per ogni token, si calcola quanto la verosimiglianza totale calerebbe rimuovendolo, e si tiene soltanto la frazione più utile (nel lavoro originale l’80%). I caratteri singoli non si tolgono mai: sono loro a garantire che ogni stringa del corpus resti segmentabile. Il vocabolario candidato di partenza è l’unione dei caratteri e delle sottostringhe più frequenti del corpus, estratte con un array dei suffissi, e va scelto ben più grande della taglia finale. Si itera fino alla taglia voluta. La segmentazione di una stringa nuova è quella di massima probabilità, trovata con Viterbi in tempo lineare nella lunghezza. Due proprietà distinguono unigram da BPE. È un modello probabilistico, quindi sa dire quanto una segmentazione è buona e campionarne di alternative: nella subword regularization [Kud18] si prendono le \(l\) segmentazioni migliori e se ne estrae una con probabilità proporzionale a \(P(x)^{\alpha}\), dove \(\alpha > 0\) regola quanto la scelta si concentra (con \(\alpha\) grande tende alla segmentazione di Viterbi, con \(\alpha\) piccolo si avvicina all’uniforme), e addestrare su segmentazioni diverse della stessa frase fa da regolarizzatore. E non dipende da un ordine di fusioni.
Una terza mossa, che SentencePiece non ha inventato ma che si combina con le
prime due, è il BPE a livello di byte, adottato da GPT-2
[RWC+19]: si applica BPE non ai caratteri Unicode (che sono
oltre centomila, un alfabeto di base già proibitivo) ma alla codifica UTF-8 del
testo. L’alfabeto di base ha allora esattamente \(|\Sigma| = 256\) elementi, e il
tasso di <UNK> è zero per costruzione, su qualunque input: testo, codice
sorgente, perfino dati binari. Il prezzo è che un carattere fuori ASCII
occupa da 2 a 4 byte, e se le sue sequenze non sono abbastanza frequenti da
meritare una fusione, un singolo ideogramma può costare più token di una parola
inglese intera. La
copertura universale non è gratis: si paga in lunghezza di sequenza, sempre
per le lingue meno rappresentate nel corpus di addestramento del
tokenizzatore. Il vocabolario di GPT-2 conta 50 257 voci: i 256 byte, 50 000
fusioni e un simbolo di fine testo. Prima di fondere, un’espressione regolare
separa lettere, cifre e punteggiatura, così che nessuna fusione attraversi due
categorie, con un’eccezione che gli autori dichiarano: lo spazio che precede una
parola le resta attaccato, ed è da lì che vengono i token con lo spazio in
testa. Anche le contrazioni inglesi ('s, 'll, 're) si staccano a parte.
SentencePiece toglie gli <unk> per un’altra strada, l’opzione byte_fallback,
spenta per default. Senza, i caratteri che coprono l’ultimo \(0{,}05\%\) del
corpus (character_coverage=0.9995) diventano <unk>; con l’opzione accesa si
scrivono con i loro byte, e il vocabolario resta a sotto-parole di carattere per
tutto il resto.
Quattro conseguenze che incontrerai davvero#
Fin qui la meccanica. Il tokenizzatore sembra un dettaglio della preparazione dei dati, ma le sue scelte arrivano fino a chi usa un modello di linguaggio: nei numeri, che si spezzano in modo irregolare; nel costo delle lingue diverse dall’inglese; negli spazi, che cambiano la sequenza in ingresso; e nel vocabolario, che una volta scelto non si cambia più.
Primo: i numeri si spezzano in modo irregolare, e l’aritmetica ne soffre.
Le fusioni si scelgono per frequenza, e le cifre non fanno eccezione. Le
sequenze numeriche comuni sul web (gli anni recenti, i numeri tondi, 100,
000, le cifre singole) si guadagnano un token tutto loro; quelle rare no.
Il guaio si vede con due numeri quasi uguali, e il tokenizzatore di GPT-2 ne ha un esempio pronto:
from transformers import AutoTokenizer

gpt2 = AutoTokenizer.from_pretrained("gpt2")       # il tokenizzatore di GPT-2

for numero in [" 2021", " 2022", " 2023", " 2024"]:
    pezzi = [gpt2.decode([i]) for i in gpt2.encode(numero)]
    print(f"{numero.strip()}: {pezzi}")
2021: [' 2021']
2022: [' 2022']
2023: [' 20', '23']
2024: [' 2024']
Quattro anni di fila, e il 2023 è l’unico a non avere un token suo: esce come
20 più 23. Due numeri della stessa lunghezza, tagliati in modo diverso, e
la cifra delle migliaia che nel primo caso sta dentro un pezzo unico e nel
secondo apre il pezzo 20. Adesso pensa a come si fa una somma in colonna a
scuola: si incolonnano le unità sotto le unità, le decine sotto le decine,
perché ogni cifra vale secondo il posto che occupa (è il valore posizionale).
Chiedere a un modello di sommare due numeri lunghi significa chiedergli di
incolonnare cifre che nella sua rappresentazione non sono incolonnate affatto,
perché è stato tagliato tutto secondo la frequenza e non secondo il posto. Non
spiega da solo tutti gli errori di calcolo dei modelli, ma il peso della
rappresentazione dei numeri è misurato: con i numeri spezzati in sottoparole un
modello non impara a sommare numeri di cinque cifre, e con le posizioni delle
cifre dichiarate arriva a sommarne di sessanta
[NJL21]; cambiare il verso in cui si raggruppano le
cifre sposta di parecchi punti l’aritmetica dei grandi modelli
[SS24]. Per questo vari tokenizzatori recenti forzano la
segmentazione delle cifre, una per una o a gruppi fissi di tre, per restituire
al modello una griglia regolare.
Secondo: l’italiano costa più token dell’inglese, a parità di significato.

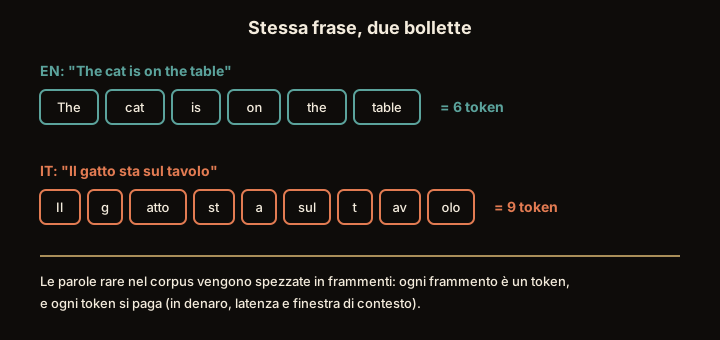
Fig. 15.9 Stessa frase, due conti diversi. Le parole italiane si frammentano perché il vocabolario è stato costruito su un corpus in prevalenza inglese, e i posti se li sono presi le sottostringhe inglesi.#
Come mostra la Fig. 15.9, il costo non è metaforico, e le due frasi della figura si possono ricontare con lo stesso tokenizzatore:
for frase in ["The cat is on the table", "Il gatto sta sul tavolo"]:
    pezzi = [gpt2.decode([i]) for i in gpt2.encode(frase)]
    print(f"{len(pezzi)} token: {pezzi}")
6 token: ['The', ' cat', ' is', ' on', ' the', ' table']
9 token: ['Il', ' g', 'atto', ' st', 'a', ' sul', ' t', 'av', 'olo']
La differenza nasce da due cause indipendenti che tirano nella stessa direzione.
La prima è la composizione del corpus. Se il testo su cui il tokenizzatore è stato addestrato è in prevalenza inglese, le fusioni che «pagano» sono quelle inglesi, e i posti nel vocabolario finiscono lì. Alle parole italiane restano i pezzi avanzati, presi in prestito da altre parole, e si frammentano.
La seconda è la morfologia. Una lingua flessiva come l’italiano moltiplica le forme: gatto, gatta, gatti, gatte, gattino, gattini sono sei parole distinte, ciascuna più rara dell’inglese cat, che sta al posto di quasi tutte. Più rara vuol dire meno probabile che si meriti un token suo.
E in che valuta si paga? In tre.
In denaro. I servizi che danno accesso a un modello di linguaggio (un programma che, dato un testo, scommette su come continua: è il tema di una sezione più avanti) fanno pagare un tanto a token. La stessa richiesta scritta in italiano costa dunque più della stessa richiesta in inglese, e di quanto dipende dal tokenizzatore: nella frase della figura, spezzata dal tokenizzatore di GPT-2, sono nove token contro sei, cioè la metà in più. Con tokenizzatori più recenti il rapporto scende, ma su testi tradotti in molte lingue Petrov e colleghi misurano differenze di lunghezza che arrivano a quindici volte [PLMTB23], e Ahia e colleghi ne ricavano che per molte lingue si paga di più per risposte peggiori [AKG+23].
In posti occupati. Un modello può tenere davanti agli occhi solo una certa quantità di testo per volta, misurata anch’essa in token: è la sua finestra di contesto. Un documento che in inglese ci sta, in italiano può non starci.
In lavoro. E qui il conto non è proporzionale, per via del costo quadratico dell’attenzione, che confronta ogni posizione con ogni altra: quel 50 per cento di token in più fa costare l’attenzione \(1{,}5^2 = 2{,}25\) volte tanto.
È una disparità che non nasce da una scelta contro l’italiano, ma dalla composizione di un corpus, e che si corregge solo addestrando il tokenizzatore su dati più bilanciati.
Terzo: uno spazio in più o in meno cambia i token. Nei tokenizzatori
moderni lo spazio è attaccato al token che lo segue, invece di fare da
separatore invisibile: ▁gatto e gatto sono due voci diverse del
vocabolario, con due posizioni diverse sulla mappa e due storie diverse alle
spalle. La prima è comunissima, perché quasi sempre gatto è preceduto da uno
spazio; la seconda è rara, perché ricorre solo dove gatto attacca senza
spazio davanti, cioè quasi mai.
Ne segue una cosa che sorprende chiunque non l’abbia mai sentita. Se il prompt finisce con uno spazio, quello spazio l’hai già speso tu, e al modello tocca continuare con un token senza barretta iniziale, cioè con la variante rara, quella su cui ha molta meno esperienza. Un solo carattere invisibile in coda alla richiesta, e la risposta può peggiorare senza che si capisca il perché. La fragilità non è del modello: gli hai dato in ingresso una sequenza diversa da quella che credevi.
Quarto: il vocabolario si fissa prima dell’addestramento e non si cambia dopo. Questa è la conseguenza più vincolante, e riguarda com’è fatto il modello per dentro. In ingresso c’è la matrice di embedding \(\mathbf{E} \in \mathbb{R}^{|V| \times d}\), con una riga per ogni token del vocabolario: la riga contiene i \(d\) numeri con cui quel pezzo di parola viene rappresentato. In uscita c’è la proiezione finale \(\mathbf{W}_{\text{out}} \in \mathbb{R}^{d \times |V|}\), con una colonna per ogni token, che dà a ciascun pezzo un punteggio per decidere quale scrivere; nei modelli a pesi condivisi è proprio \(\mathbf{E}^\top\). Aggiungere un token al vocabolario vuol dire allora aggiungere una riga e una colonna vuote a due tabelle che l’addestramento ha già riempito: numeri che nessun gradiente ha mai regolato, in mezzo a numeri regolati per mesi. E cambiare la segmentazione di un token esistente è peggio, perché tutto ciò che il modello ha imparato su quella riga si riferisce ormai a un’altra cosa. Il tokenizzatore è quindi parte del modello quanto i suoi pesi, si distribuisce insieme a essi, e se il dominio d’uso non era rappresentato nel corpus su cui è stato costruito (una lingua minore, la notazione chimica, un linguaggio di programmazione poco diffuso) quel testo resterà frammentato per tutta la vita del modello. Si può porre rimedio solo riaddestrando, o almeno estendendo il vocabolario e riadattando gli embedding nuovi: entrambe operazioni costose, ed è per questo che il tokenizzatore si sceglie all’inizio e con cura.
Un’idea che vale oltre il testo#
Un tokenizzatore costruisce un alfabeto discreto, cioè fatto di pezzi separati e contabili, come le lettere di un alfabeto e non come le sfumature di un colore: un insieme finito di simboli in cui qualunque testo in ingresso si possa scrivere e da cui qualunque testo in uscita si possa ricomporre. Per un modello autoregressivo, che scrive un pezzo per volta guardando quelli che ha già scritto, è l’alfabeto delle sue scommesse; per un encoder come BERT, che legge la frase intera, è l’alfabeto in cui legge. Il testo quell’alfabeto ce l’aveva già mezzo pronto (i caratteri) e il lavoro è stato scegliere i raggruppamenti giusti.
Altri segnali un alfabeto discreto non ce l’hanno. L’audio è un’onda continua, e per darlo a un modello autoregressivo bisogna prima ottenere dei simboli. Il metodo è la quantizzazione vettoriale: si costruisce un catalogo (codebook) di vettori campione, per esempio mille, si scorre la registrazione un pezzetto alla volta e a ogni pezzetto si assegna il numero del vettore del catalogo che gli somiglia di più [vdOVK17]. L’onda diventa così una sequenza di numeri fra uno e mille, cioè un testo in un alfabeto di mille lettere. Quando il catalogo e il modo di riassumere ogni pezzetto li impara una rete neurale, il sistema si chiama codec neurale, e il capitolo sull’audio gli dedica una sezione. Il problema è lo stesso della tokenizzazione del testo, la soluzione è diversa perché diversa è la materia prima.
E la domanda che resta aperta, in entrambi i casi, è se il testo e il suono debbano passare per dei simboli scelti prima dell’addestramento. Per il testo la strada senza tokenizzatore esiste già. ByT5 legge e scrive direttamente i byte con cui il testo è codificato (nella codifica standard, UTF-8) [XBC+22] e paga il conto previsto: sequenze in media circa quattro volte più lunghe di quelle a sotto-parole, da due volte e mezzo per il maltese a nove per il khmer. I modelli successivi accorciano il conto raggruppando i byte dentro la rete: in blocchi di lunghezza fissa (MEGABYTE [YSF+23]) oppure in blocchi che si allungano dove il byte successivo è facile da indovinare e si accorciano dove è incerto (il Byte Latent Transformer [PPR+24], che misura quell’incertezza con un piccolo modello addestrato a parte). Il taglio resta, ma non sta più in un vocabolario fissato prima: nel primo caso è una regola, nel secondo lo decide un modello, che però non si impara insieme al resto della rete, e gli autori lo indicano come direzione futura. Se il tokenizzatore resiste, la ragione è economica più che teorica: i simboli accorciano le sequenze, e la lunghezza delle sequenze è ciò che si paga.
Da ricordare
WordPiece cambia una cosa sola rispetto a BPE, quale coppia incollare. Nella versione che si insegna di solito non è la più frequente ma quella che sta insieme più di quanto ci si aspetterebbe per caso («acqua minerale» contro «di un»); il criterio originale guardava anche quante volte la fusione si applica.
SentencePiece tratta il testo come una collana ininterrotta di simboli, con lo spazio scritto come
▁: non c’è bisogno di tagliarlo prima in parole, e questo lo rende adatto anche a cinese e giapponese, dove gli spazi non ci sono; il testo si ricompone identico. Le perline si possono anche scegliere al rovescio, partendo da una scatola troppo piena e togliendo. Sotto i caratteri ci sono i byte, che sono 256 comunque vada: partendo da lì non resta fuori più niente, mai.Le conseguenze si toccano con mano: i numeri vengono spezzati secondo la frequenza e non secondo il posto delle cifre, e i conti ne soffrono; l’italiano costa più token dell’inglese, cioè più soldi e più posti occupati nella finestra di contesto; uno spazio di troppo in fondo a una richiesta cambia davvero la domanda; e il vocabolario, una volta scelto, non si cambia più, perché fa parte del modello quanto i numeri che ha imparato.
Da ricordare
WordPiece [SN12] ha la stessa struttura di BPE e sceglie la fusione che fa crescere di più la verosimiglianza; il criterio con cui Google ha addestrato BERT non è pubblico, e la ricostruzione che circola sceglie la coppia che massimizza \(\mathrm{freq}(ab)/(\mathrm{freq}(a)\,\mathrm{freq}(b))\), cioè ciò che ricorre più di quanto ci si aspetterebbe dal caso. Le due non coincidono: sul corpus dell’esempio il guadagno esatto sceglierebbe ancora
ss.SentencePiece [KR18] tratta il testo come flusso grezzo con lo spazio marcato da
▁: nessun bisogno di pre-segmentare in parole (il che lo rende usabile per cinese e giapponese, dove gli spazi fra le parole non esistono) e detokenizzazione esatta; il modello unigram, sua scelta predefinita, pota un vocabolario ampio con l’EM e permette di campionare le segmentazioni (subword regularization). A livello di carattere l’assenza di<UNK>dipende da quali caratteri stavano nel corpus; il livello dei byte la rende una proprietà per costruzione, perché i byte sono 256 e basta.Le conseguenze si vedono a valle: numeri segmentati in modo irregolare (e aritmetica fragile), lingue non inglesi che consumano più token e più contesto, spazi che cambiano la sequenza in ingresso, e un vocabolario congelato prima dell’addestramento, perché è parte del modello quanto i suoi pesi.
Con i token fissati e un vettore per ogni documento si può affrontare il compito più diffuso del NLP, dare un’etichetta a un testo, che è il tema di Insegnare a giudicare: classificare il testo.