


Equità e bias algoritmico#
Nel 2018 un’inchiesta di Reuters rivela che Amazon aveva accantonato in silenzio, all’inizio dell’anno precedente, uno strumento sperimentale di selezione del personale [Das18]. L’idea era seducente: addestrare un modello sui curriculum degli ultimi dieci anni perché imparasse a riconoscere i candidati «bravi», quelli che in passato erano stati assunti. Il modello imparò esattamente quello che l’obiettivo gli chiedeva. Poiché quei dieci anni di assunzioni erano stati dominati da uomini, il sistema dedusse che essere uomo fosse un buon segnale: penalizzava i curriculum che contenevano la parola «women’s», cioè «femminile», come nella riga «capitana della squadra di scacchi femminile», e declassava chi aveva studiato in due college per sole donne. Nessuno aveva scritto una regola contro le donne. La regola era stata appresa, letta nel passato dell’azienda e riproposta come profezia.
Bias, qui, vuol dire pregiudizio: quello della storia di Amazon, un trattamento sistematicamente peggiore riservato a un gruppo di persone.
La stessa parola ha già fatto altri due mestieri, e vanno tenuti distinti: non è il bias del neurone (il termine \(b\) che nel capitolo sulle reti neurali si somma ai pesi e sposta la soglia), e non è il bias del compromesso bias-varianza (l’errore sistematico di un modello troppo semplice, nella sezione su overfitting e validazione). Il secondo in particolare è vicino abbastanza da creare confusione, ma è un concetto diverso: un modello troppo semplice non per questo discrimina, e un modello che discrimina può essere complicato quanto si vuole.
Un modello non inventa il pregiudizio, lo eredita. Governarlo vuol dire prima capire da dove entra, poi misurarlo con precisione, con la tabella a quattro caselle del capitolo di Machine Learning compilata gruppo per gruppo. In fondo si incontra un risultato di impossibilità: alcune richieste di equità, ciascuna ragionevole, non possono valere tutte insieme.
Da dove entra il bias#
Il pregiudizio algoritmico non nasce dal codice, che è cieco e indifferente: nasce prima, nei dati, e nelle scelte con cui li abbiamo raccolti e poi etichettati, cioè con cui accanto a ogni esempio abbiamo scritto la risposta che il modello doveva imparare a dare («questo candidato era bravo», «questa persona ha commesso un reato»).

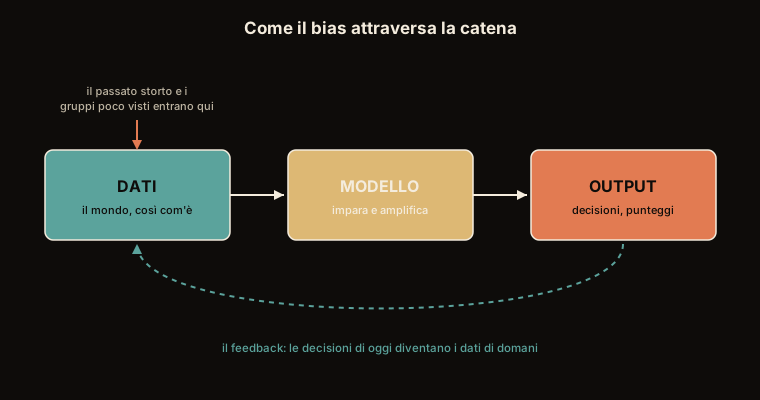
Fig. 38.1 Il bias non attraversa il modello e si ferma: torna indietro. Le decisioni di oggi diventano i dati di domani, e il giro seguente parte da una disparità un po’ più marcata.#
La freccia di ritorno in Fig. 38.1 è la ragione per cui il problema non si risolve una volta sola. Un sistema che seleziona candidati genera i dati sulle assunzioni future: se ha escluso un gruppo, il prossimo addestramento troverà davvero meno esempi di successo in quel gruppo, e ne diffiderà a ragion veduta. Sui dati avrà ragione; sulle persone no. Il pregiudizio si fabbrica le proprie prove. Gli studi su questo argomento (per esempio la rassegna di Mehrabi e colleghi [MMS+21]) distinguono alcune sorgenti ricorrenti.
Un apprendista impara il mestiere guardando solo le decisioni prese in passato dai suoi capi, e non chiede mai se fossero giuste. Erediterà la loro bravura, e anche le loro storture. Con i dati succede lo stesso, e le storture arrivano da quattro porte.
Il passato è ingiusto. Se per anni i prestiti sono andati soprattutto agli abitanti di certi quartieri, un modello addestrato su quello storico imparerà a dire di sì agli stessi e di no agli altri: non perché siano meno affidabili, ma perché storicamente hanno avuto meno occasioni.
Il campione non rappresenta tutti. Se le foto con cui si allena un riconoscitore di volti ritraggono in gran parte persone dalla pelle chiara, il sistema funzionerà peggio su tutti gli altri, che non ha quasi mai visto; e se sono così anche le foto con cui lo si prova, nessuno se ne accorge.
Le etichette sono distorte. Spesso la «risposta giusta» che diamo in pasto al modello non è la verità, ma una sua approssimazione imperfetta: «è stato arrestato» al posto di «ha commesso un reato», e l’arresto dipende anche da dove e chi la polizia controlla di più.
Il modello si morde la coda. Se un sistema manda più pattuglie in un quartiere, lì si registreranno più reati, il che convince il sistema a mandarcene ancora di più. Il pregiudizio si auto-conferma.
Due di queste porte si chiudono lavorando sulla raccolta: si fotografano più volti per il campione, e si smette di mandare le pattuglie soltanto dove le si è già mandate. Le altre due non si chiudono con altri dati dello stesso tipo. Mille prestiti in più dello stesso storico raccontano la stessa ingiustizia con qualche decimale in più; e «arrestato» scritto dove serviva «ha commesso un reato» resta la domanda sbagliata per quante risposte si raccolgano, finché non si trova un altro modo di misurare la cosa che interessa davvero.
Il riassunto sta in un adagio: bias in, bias out. Un modello impeccabile allenato su dati storti produce risultati storti.
Conviene distinguere le sorgenti, perché richiedono rimedi diversi. Le quattro voci che seguono vengono dal catalogo di Mehrabi e colleghi [MMS+21], che ne elenca molte di più, e Suresh e Guttag [SG21] le dispongono lungo il ciclo di vita del modello, dalla raccolta dei dati alla messa in uso.
Bias storico. I dati riflettono fedelmente un mondo già iniquo. Anche con campionamento perfetto ed etichette perfette, la regolarità che il modello apprende è la disuguaglianza. Nessuna quantità di dati aggiuntivi la corregge, perché quella disuguaglianza è il fenomeno, non un errore di misura.
Bias di rappresentazione (campionamento). La distribuzione dei dati di addestramento \(P_{\text{train}}\) differisce dalla popolazione bersaglio \(P_{\text{test}}\), e in particolare sotto-rappresenta alcuni gruppi. È il caso di Gender Shades, lo studio raccontato nell’apertura del capitolo: gli archivi più usati per valutare l’analisi dei volti hanno pochi volti scuri (nei due esaminati ha la pelle chiara il \(79{,}6\%\) e l’\(86{,}2\%\) dei soggetti), e sui sistemi commerciali, i cui dati di addestramento non sono dichiarati, l’errore è molto più alto su quel gruppo. Lo studio misura lo sbilanciamento della valutazione; che la disparità venga dal campione di addestramento è plausibile, non dimostrato.
Bias di misura (etichette). L’etichetta osservata è un proxy del costrutto d’interesse: si misura «arresto» per «reato», «voto del manager» per «rendimento». Se il proxy è più rumoroso o più severo per un gruppo, il bias entra dalle etichette prima ancora del modello.
Bias di feedback (loop). Le decisioni del modello alterano i dati futuri su cui il modello successivo verrà addestrato. La polizia predittiva è il caso documentato. Lum e Isaac [LI16] applicano un algoritmo di previsione ai reati di droga registrati a Oakland e trovano che manderebbe i controlli soprattutto nei quartieri poveri e non bianchi, colpendo i neri a un tasso circa doppio dei bianchi, benché l’uso di droga stimato sia simile nei due gruppi; Ensign e colleghi [EFN+18] mostrano come il ciclo si chiuda da sé: più controlli dove il modello prevede reati \(\Rightarrow\) più reati registrati lì \(\Rightarrow\) previsioni ancora più concentrate. Il segnale si auto-rinforza indipendentemente dal tasso reale.
La distinzione operativa è netta. Campionamento e feedback si attaccano intervenendo sulla raccolta: più esempi del gruppo scarso, e una raccolta che non dipenda dalle decisioni del modello. Il bias storico non si corregge con altri dati dello stesso tipo, perché la disuguaglianza è il fenomeno. Quello di misura si corregge soltanto cambiando la grandezza misurata, o modellandone la distorsione [FGSellC20]: serve una misura indipendente dall’etichetta distorta, e non sempre ce n’è una.
Una scheda tecnica per ogni dataset#
Le quattro sorgenti di bias si vedono solo se qualcuno ha scritto come i dati sono stati fatti. Timnit Gebru e colleghi [GMV+21] hanno proposto di accompagnare ogni dataset con una scheda tecnica (datasheet), come quella che nell’elettronica accompagna ogni componente, e Margaret Mitchell e colleghi [MWZ+19] la stessa cosa per i modelli, con le model card.
Ogni transistor venduto arriva con un foglio che dice a che cosa serve, come è stato collaudato, in quali condizioni funziona e in quali no. Un dataset, che decide il comportamento di un modello molto più di quanto un transistor decida quello di un circuito, di solito arriva con un nome e un indirizzo da cui scaricarlo.
La scheda tecnica di un dataset è una serie di domande a cui chi lo costruisce risponde per iscritto: perché è stato fatto e da chi; che cosa contiene, e chi ci manca o ci sta in pochi; come sono stati raccolti i dati e chi ha messo le etichette, e che cosa misurano davvero; per quali usi va bene e per quali no; chi lo distribuisce e chi lo aggiornerà. Ogni domanda guarda una delle porte: «chi ci sta in pochi» è la porta del campione, «che cosa misura l’etichetta» è quella della misura, «per quali usi no» mette per iscritto dove la storia che i dati si portano dietro farebbe danni (uno storico di assunzioni decise da capi di parte non va usato per scegliere chi assumere), «chi lo aggiornerà» tiene d’occhio l’anello che si richiude su sé stesso. Per un testo scritto o parlato si aggiunge in quale lingua o dialetto è, e chi l’ha detto, trascritto e scelto. E chi la legge decide con quelle risposte se il dataset fa al caso suo. Lo studio Gender Shades [BG18] trovò che due archivi molto usati per provare i sistemi di analisi dei volti avevano pochi volti scuri: è la risposta che la domanda su chi ci sta in pochi avrebbe messo in prima pagina.
Lo stesso vale per un modello: la sua scheda dice a che cosa serve e, soprattutto, quanto sbaglia gruppo per gruppo, non solo in media, perché una media alta può nascondere un gruppo su cui il modello tira a indovinare. Le schede però non aggiustano niente: rendono visibile. Non si possono compilare in automatico, perché il loro scopo è far riflettere chi le scrive; non garantiscono che i dati siano giusti; e costano tempo. Il regolamento europeo sull’intelligenza artificiale, l’AI Act, le ha rese in parte un obbligo: per i sistemi ad alto rischio chiede di documentare da dove vengono i dati e come sono stati preparati, e il testo italiano chiama quei documenti proprio «schede tecniche».
Il datasheet di Gebru e colleghi [GMV+21] è organizzato in sette gruppi di domande, uno per fase della vita del dataset: Motivation (scopo, autori, finanziatori), Composition (che cosa rappresentano le istanze, se il dataset identifica sottopopolazioni e con quale distribuzione, se contiene dati riservati), Collection Process (come è stato acquisito ogni dato, con quale campionamento, con quale revisione etica), Preprocessing, cleaning, labeling (e se il dato grezzo è stato conservato), Uses (usi già fatti e usi da evitare), Distribution e Maintenance. I destinatari sono due: chi crea il dataset, a cui la compilazione impone di riflettere su ipotesi e rischi, e chi lo usa, a cui dà gli elementi per decidere. Le quattro sorgenti di bias viste sopra, che non sono una categoria degli autori, si leggono sulle domande del datasheet: il bias di rappresentazione nella composizione, quello di misura nella raccolta e nell’etichettatura, quello storico negli usi da evitare, quello di feedback nella manutenzione. Gli autori escludono esplicitamente la compilazione automatica, avvertono che la scheda non è una soluzione completa ai danni e ai bias, e che ha un costo per chi la scrive. Le model card [MWZ+19] fanno lo stesso per i modelli (uso previsto, fattori, metriche, dati di valutazione e di addestramento, considerazioni etiche, avvertenze) e chiedono analisi quantitative disaggregate per i fattori rilevanti, per esempio età, genere e tipo di pelle nella scala di Fitzpatrick per i modelli di visione sulle persone; i data statement di Bender e Friedman [BF18] aggiungono per il linguaggio la varietà linguistica e chi ha parlato, annotato e curato i dati. Il regolamento europeo [EuropeanPaCouncil24] chiede per i sistemi ad alto rischio pratiche di governance dei dati che riguardano, fra l’altro, i processi di raccolta e l’origine dei dati e le operazioni di preparazione (articolo 10, paragrafo 2, lettere b e c), e nella documentazione tecnica (allegato IV, punto 2, lettera d) i requisiti sui dati «mediante schede tecniche»; il quadro complessivo sta nella sezione sulla governance.
Un esperimento minimo mostra perché una scheda di modello chiede i conti gruppo per gruppo. Costruisce dati in cui un gruppo, un decimo del totale, lega la risposta a un’altra colonna, addestra un solo modello su tutti e ne misura l’accuratezza in media e per gruppo, con il suo errore standard.
import numpy as np
from sklearn.linear_model import LogisticRegression

rng = np.random.default_rng(0)
n = 10000
gruppo = np.where(rng.random(n) < 0.1, "B", "A")        # B è un decimo dei dati
x = rng.normal(size=(n, 2))
# nel gruppo B la stessa risposta dipende da un'altra colonna
segnale = np.where(gruppo == "A", x[:, 0], x[:, 1])
y = (segnale + 0.5 * rng.normal(size=n) > 0).astype(int)
addestra, prova = np.arange(n) < n // 2, np.arange(n) >= n // 2

modello = LogisticRegression().fit(x[addestra], y[addestra])
giusto = modello.predict(x[prova]) == y[prova]
print("quote nel dataset:", {g: round(float(np.mean(gruppo == g)), 2) for g in ("A", "B")})
print(f"accuratezza complessiva {giusto.mean():.3f}")
for g in ("A", "B"):
    esiti = giusto[gruppo[prova] == g]
    errore_std = np.sqrt(esiti.mean() * (1 - esiti.mean()) / len(esiti))
    print(f"  gruppo {g}: {esiti.mean():.3f} su {len(esiti)} persone"
          f" (errore standard {errore_std:.3f})")
print("pesi del modello sulle due colonne:", modello.coef_[0].round(2))
quote nel dataset: {'A': 0.9, 'B': 0.1}
accuratezza complessiva 0.820
  gruppo A: 0.851 su 4494 persone (errore standard 0.005)
  gruppo B: 0.545 su 506 persone (errore standard 0.022)
pesi del modello sulle due colonne: [2.4  0.22]
In media il modello indovina l’82% delle volte, e sul gruppo grande l’85%; sul gruppo piccolo il 54,5%. Quel numero viene da 506 persone, e il suo errore standard, \(\sqrt{0{,}545 \cdot 0{,}455/506} \approx 0{,}022\), dice che l’accuratezza vera sta con buona probabilità fra \(0{,}50\) e \(0{,}59\): lontana dall’85%, appena sopra una moneta. L’ultima riga stampata dice perché: il modello ha dato quasi tutto il peso alla prima colonna, quella che decide la risposta nel gruppo grande, e quasi niente alla seconda, che la decide nel gruppo piccolo. La media assomiglia al gruppo grande perché è calcolata soprattutto sui suoi dati, e la quota nel dataset, la prima riga stampata, è la domanda sulla composizione della scheda tecnica: senza quella, e senza il conto per gruppo, il 54,5% non compare da nessuna parte.
Misurare l’equità guardando i gruppi#
Per parlare di equità con rigore serve un vocabolario, e quattro cose da tenere distinte: il gruppo a cui una persona appartiene, l’esito reale (quello che poi è successo davvero), la decisione del modello, e il punteggio da cui quella decisione si ricava fissando una soglia. Punteggio e decisione non sono la stessa cosa, e la differenza tornerà utile: il punteggio è un numero fra zero e uno, la decisione è il sì o il no che si ottiene tagliandolo a una certa altezza.
Su questi ingredienti si contano gli errori, con le due misure del capitolo di
Machine Learning. Le quattro caselle della tabella si chiamano VP, FP,
FN, VN (veri e falsi positivi, falsi e veri negativi). Il tasso di veri
positivi (TPR, dalle iniziali inglesi) è la quota dei casi positivi che il
modello riconosce, \(\text{TPR}=\text{VP}/(\text{VP}+\text{FN})\); il tasso di
falsi positivi (FPR) è la quota dei casi negativi che segnala per errore,
\(\text{FPR}=\text{FP}/(\text{FP}+\text{VN})\). I tassi sono frazioni, scritte
fra zero e uno: \(0{,}80\) sta per ottanta su cento. La differenza rispetto a
quel capitolo è una sola, ed è decisiva: qui i conti si fanno separatamente per
ciascun gruppo e poi si confrontano (Fig. 38.2).

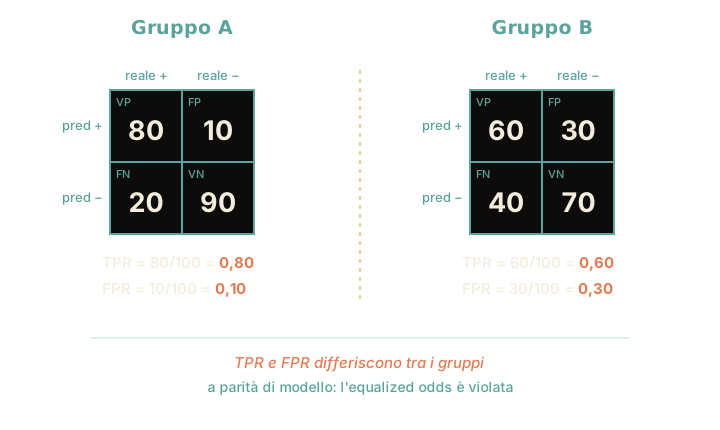
Fig. 38.2 Lo stesso modello, gli stessi conti, due gruppi. Nel Gruppo A, su cento persone a cui l’esito è poi capitato davvero il modello ne aveva individuate \(80\): \(80\) su \(100\), cioè \(0{,}80\). Nel Gruppo B solo \(60\), cioè \(0{,}60\). E i falsi allarmi sono \(10\) su \(100\) nel primo gruppo contro \(30\) su \(100\) nel secondo. Quando le due coppie di numeri non coincidono, il modello sbaglia in modo diverso a seconda del gruppo.#
«Sì» vuol dire che il modello ha detto la cosa che stavamo prevedendo, e quella cosa non è per forza bella. Nel prestito il «sì» è «te lo diamo»; nel software dei tribunali è «questa persona è ad alto rischio». E «l’esito è accaduto» vuol dire che è successo davvero quel che il modello prevedeva, buono o brutto che sia. Parole neutre, per un conto che si fa uguale nei due casi.
Ci sono tre modi diversi di chiedere «il modello è equo?», e portano a tre richieste distinte.
Stessa quota di sì, in gergo parità demografica. Il modello dice «sì» alla stessa percentuale di persone in ogni gruppo. Se approva il 40% degli uomini, deve approvare il 40% delle donne: a prescindere da tutto il resto. E il «a prescindere» va preso alla lettera: la richiesta resta soddisfatta anche scegliendo i migliori fra gli uomini e tirando a sorte fra le donne.
Stessi errori per tutti, in gergo equalized odds: i due tassi di errore del modello devono essere uguali nei due gruppi. Sono due condizioni in una: il modello deve prendere la stessa quota di persone a cui l’esito è poi capitato davvero, e dare la stessa quota di falsi allarmi su chi non c’entrava nulla. È la richiesta che la Fig. 38.2 mostra violata: stesso modello, due comportamenti. Chi teme soprattutto di lasciare indietro qualcuno può pretendere soltanto la prima delle due.
Stesso significato del punteggio, in gergo calibrazione. Il punteggio è una previsione di probabilità e non un voto. «70» non vuol dire «bravo sette su dieci», vuol dire «di persone come questa, secondo me, l’esito capita a settanta su cento». Calibrato vuol dire che quella promessa viene mantenuta, e mantenuta allo stesso modo per tutti: se fra gli uomini con punteggio 70 l’esito capita davvero al 70%, lo stesso deve valere fra le donne.
Sembrano tre modi di dire la stessa cosa. Non lo sono affatto, e metterle d’accordo è impossibile più spesso di quanto chiunque si aspetterebbe.
Fissiamo la notazione: \(A\) è l’attributo protetto che identifica il gruppo (per esempio \(A=a\) e \(A=b\)), \(Y \in \{0,1\}\) è l’esito reale, \(\hat{Y}\) è la decisione del modello e \(S \in [0,1]\) il punteggio da cui la decisione si ottiene fissando una soglia. Un criterio enunciato su \(S\) e lo stesso criterio enunciato su \(\hat{Y}\) sono affermazioni diverse, e la distinzione fra i due torna a ogni risultato di impossibilità.
Le definizioni di equità di gruppo si organizzano attorno a tre criteri statistici, nella terna di Barocas, Hardt e Narayanan [BHN23].
Parità demografica (independence, \(\hat{Y} \perp A\)): la quota di esiti positivi non dipende dal gruppo,
È il selection rate uguale fra i gruppi. Limite noto: ignora del tutto \(Y\), quindi è compatibile con l’assurdo di selezionare i candidati giusti in un gruppo e a caso nell’altro. È però il criterio più vicino alla pratica giuridica. Il rapporto fra le due quote di selezione, con il gruppo meno selezionato al numeratore, è il disparate impact ratio, e nelle assunzioni statunitensi la regola dei quattro quinti lo vuole non sotto \(0{,}8\): sotto quella soglia le agenzie federali lo considerano di norma indizio di impatto sfavorevole [EqualEOCaCSCaDoLaDoJustice78]. È un allarme e non una prova, e lo dicono le stesse linee guida, per cui una differenza su numeri piccoli e non significativa può non contare [BHN23].
Equalized odds (separation, \(\hat{Y} \perp A \mid Y\)), introdotta da Hardt, Price e Srebro [HPS16]: a parità di esito reale la predizione non dipende dal gruppo,
Per \(y=1\) questa è l’uguaglianza dei TPR, per \(y=0\) quella dei FPR: il modello deve avere lo stesso tasso di veri positivi e lo stesso tasso di falsi positivi in ogni gruppo. La Fig. 38.2 illustra una violazione: \(\text{TPR}_a=0{,}80 \neq \text{TPR}_b=0{,}60\) e \(\text{FPR}_a=0{,}10 \neq \text{FPR}_b=0{,}30\). La versione più debole equal opportunity impone la sola uguaglianza dei TPR (solo su \(y=1\)), appropriata quando il costo asimmetrico ricade su chi meritava l’esito positivo e viene mancato.
Calibrazione per gruppo: il punteggio è la probabilità dell’esito, e lo è in ogni gruppo,
Qui \(s\) è il valore del punteggio, e la condizione dice che «70» vuol dire settanta su cento di qua e di là. Il criterio della terna è un po’ più debole, la sufficiency (\(Y \perp A \mid S\)): chiede soltanto che uno stesso \(s\) significhi la stessa cosa in ogni gruppo, \(P(Y=1 \mid S=s,\, A=a) = P(Y=1 \mid S=s,\, A=b)\), senza pretendere che quella cosa sia \(s\). Un punteggio calibrato per gruppo è sufficiente; il contrario non vale, ma basta ritarare \(S\) con una stessa funzione per tutti i gruppi per passare dall’uno all’altro. La calibrazione è una proprietà di \(S\), non di \(\hat{Y}\): cambiare la soglia non la tocca. La usano due dei tre risultati di impossibilità che seguono, quelli di Kleinberg e di Pleiss; il primo, di Chouldechova, usa invece la quarta condizione.
Accanto va tenuta una quarta condizione, che le somiglia e non coincide: la parità del valore predittivo (predictive parity), che riguarda la decisione,
cioè l’uguaglianza fra i gruppi del valore predittivo positivo \(\text{VPP}=P(Y=1\mid\hat{Y}=1)\), che è la precision del capitolo di Machine Learning. È il criterio che Northpointe rivendicava a difesa di COMPAS [DMB16], ed è il perno dei risultati di impossibilità.
I risultati di impossibilità#
Arriviamo al nodo. Ai tre criteri visti finora se ne affianca un quarto, che somiglia moltissimo alla calibrazione e non è la stessa cosa: quando il modello dice sì, ci prende ugualmente spesso in ogni gruppo. In gergo si chiama parità del valore predittivo, e la differenza con la calibrazione è sottile e conta: la calibrazione riguarda il punteggio, il «70» che deve voler dire settanta su cento per tutti; questa riguarda il sì e il no che si ottengono tagliando quel punteggio a una certa altezza. È quest’ultima, non la calibrazione, quella che l’azienda di COMPAS rivendicava.
Questi criteri non entrano in conflitto per caso: alcuni sono matematicamente incompatibili ogni volta che i gruppi partono da tassi di base diversi, cioè ogni volta che l’esito, nei dati, è più frequente in un gruppo che nell’altro.
I risultati che lo dimostrano sono tre, e non sono tre versioni dello stesso. Quello di Chouldechova riguarda le decisioni sì o no: la parità del valore predittivo e quella dei due tassi d’errore. Quello di Kleinberg, Mullainathan e Raghavan riguarda i punteggi: la calibrazione e i punteggi medi ricevuti nei due gruppi. Quello di Pleiss e colleghi, fra i quali ci sono due degli autori del secondo, dice che cosa resta possibile: la calibrazione insieme alla parità di un solo tasso d’errore, contato sul punteggio e non sui sì e no, pagata in accuratezza. Scambiarli porta ad affermare il falso, per esempio che il caso COMPAS mostri un conflitto fra la calibrazione e la parità degli errori, mentre il teorema che lo spiega non nomina nemmeno la calibrazione. Cominciamo da quello, e prendiamoci lo spazio per vederlo succedere invece di annunciarlo.
Mettiamoci due gruppi veri e contiamo, perché è l’unico modo di vedere perché il muro c’è. In tutti e due l’esito che vogliamo prevedere capita a cinquanta persone; la differenza è che il Gruppo A è fatto di cento persone e il Gruppo B di duecento. Quindi nel Gruppo A l’esito riguarda una persona su due, nel Gruppo B una su quattro: sono i tassi di base diversi da cui parte tutto.
Pretendiamo due cose sensate, e per il momento otteniamole. La prima: che il modello prenda la stessa quota di persone a cui l’esito è poi capitato. Diciamo il settanta per cento, cioè 35 delle 50 in tutti e due i gruppi. La seconda: che quando dice sì ci prenda ugualmente spesso, sempre il settanta per cento.
A quel punto il numero dei falsi allarmi non lo scegliamo più noi. Perché 35 sì giusti siano il settanta per cento dei sì, i sì totali devono essere 50; e se i sì sono 50 e quelli giusti 35, i falsi allarmi sono 15. In tutti e due i gruppi, per forza, perché in tutti e due abbiamo preteso gli stessi due settanta per cento.
Quei 15 falsi allarmi sono lo stesso numero, ma non sono presi dallo stesso mucchio. Nel Gruppo A le persone a cui l’esito non è capitato sono 50, quindi 15 su 50: tre su dieci si prendono un’accusa ingiusta. Nel Gruppo B quelle stesse persone sono 150, quindi 15 su 150: uno su dieci. Tre volte più spesso, e nessuno l’ha voluto: il tre viene dal 50 contro 150, cioè da quante sono di qua e di là le persone che un falso allarme lo possono ricevere.
Il teorema di Chouldechova dice esattamente questo, in generale: quando i tassi di base sono diversi, tre parità non stanno insieme. Due le abbiamo appena pretese: che il sì valga lo stesso, e che il modello prenda la stessa quota di persone a cui l’esito è capitato, che è come pretendere che ne sfugga la stessa quota (se delle cinquanta ne prende trentacinque, le altre quindici gli sfuggono). La terza è quella saltata, la stessa quota di falsi allarmi (non lo stesso numero: il numero, come si è appena visto, coincide). Se ne assicuri due, la terza salta. È un vincolo dell’aritmetica, che né codice migliore né più dati possono togliere; ne restano fuori soltanto due casi limite, un modello che non dà mai un falso allarme e uno che non prende nessuna delle persone a cui l’esito capita.
E la richiesta rimasta fuori dal conto, dire sì alla stessa quota di persone in ogni gruppo, non si salva da sola. Se l’esito capita a una persona su due di qua e a una su quattro di là, l’unico modo di avere insieme la stessa quota di sì e gli stessi due tassi di errore è che il modello dica i suoi sì a caso, cioè che non serva a niente.
Ed è il cuore della disputa su COMPAS. L’inchiesta di ProPublica guardava i falsi allarmi e li trovava molto più alti fra gli imputati neri: la colonna dei 15 su 50. L’azienda guardava quanto spesso il suo «alto rischio» ci prendeva davvero e lo trovava uguale nei due gruppi: la riga del settanta per cento. Avevano ragione entrambe, ed è proprio questo il punto.
Teoremi di questa famiglia ce ne sono altri due. Quello di Kleinberg e colleghi guarda i punteggi invece dei sì, e si vede con gli stessi due gruppi. Se il punteggio è onesto, i conti tornano anche sommando: letti come probabilità («70» vale 0,7), i punteggi di un gruppo sommano in media al numero di persone che avranno l’esito, cioè a 50 nel Gruppo A e a 50 nel Gruppo B. Pretendiamo ora che chi l’esito lo avrà riceva in media lo stesso punteggio di qua e di là, diciamo 60: le cinquanta persone di ciascun gruppo, a 0,6 ciascuna, si prendono 30 di quei 50. I 20 che restano vanno a chi l’esito non lo avrà: nel Gruppo A sono 50 persone, e la loro media è 40; nel Gruppo B sono 150, e la media scende a circa 13. La terza pretesa, una media uguale nei due gruppi anche per chi l’esito non lo avrà, salta per forza, salvo che i gruppi partano dalla stessa frequenza o che il modello non sbagli mai.
L’ultimo, di Pleiss e colleghi, dice che cosa si salva. Un punteggio che resta onesto può avere pari una sola di quelle due medie (sono le persone che sfuggono e i falsi allarmi, contati sul punteggio), e mai gratis: nel gruppo in cui il modello sbaglia meno, a una parte delle persone scelta a sorte si dà il punteggio medio del gruppo invece del suo, cioè si butta via un pezzo di quello che il modello sa. Se invece a dover essere pari sono i sì e i no, il muro si sposta. Tagliando lo stesso punteggio onesto a un’altezza diversa nei due gruppi, a volte si riescono a pareggiare sia i falsi allarmi sia le persone sfuggite, e il punteggio resta onesto; a non tornare più pari, allora, è quanto spesso il sì ci prende, come vuole il conto di Chouldechova.
Primo teorema: Chouldechova (2017), parità del valore predittivo. La chiave è un’identità algebrica esatta che lega, all’interno di un gruppo, quattro grandezze: la prevalenza \(p = P(Y=1)\), il valore predittivo positivo \(\text{VPP}\) (la precision del capitolo di Machine Learning), il tasso di falsi negativi \(\text{FNR}=1-\text{TPR}\) e il tasso di falsi positivi [Cho17b]:
Qui \(p\) è la frazione reale di positivi nel gruppo, \(\text{VPP}=P(Y=1\mid\hat{Y}=1)\) è la probabilità che un positivo predetto sia davvero positivo, e \(\text{FNR}\) e \(\text{FPR}\) sono i due tassi di errore. L’identità si ricava contando i quattro pezzi della matrice di confusione. Con \(N\) persone nel gruppo i veri positivi sono \(\text{VP} = (1-\text{FNR})\,pN\) e i falsi positivi \(\text{FP} = \text{FPR}\,(1-p)\,N\); dalla definizione \(\text{VPP} = \text{VP}/(\text{VP}+\text{FP})\) segue \(\text{FP}/\text{VP} = (1-\text{VPP})/\text{VPP}\), cioè
e risolvendo per \(\text{FPR}\) si ottiene l’identità, valida per ogni classificatore che prenda almeno un positivo, con \(0 < p < 1\). La sua conseguenza è drastica: fissati \(\text{VPP}\) e \(\text{FNR}\) uguali fra due gruppi, se le prevalenze \(p_a \neq p_b\) differiscono, allora i \(\text{FPR}\) sono per forza diversi, fuori dai casi degeneri: \(\text{VPP}=1\), cioè nessun falso positivo da nessuna parte, dove il prodotto si annulla, oppure \(\text{FNR}=1\), cioè nessun positivo preso, dove \(\text{VPP}\) vale zero o non è definito e l’identità smette di valere.
Un esempio numerico lo rende palpabile. Siano due gruppi con prevalenze \(p_a=0{,}50\) e \(p_b=0{,}25\), e supponiamo un modello con lo stesso valore predittivo \(\text{VPP}=0{,}70\) e la stessa quota di positivi mancati \(\text{FNR}=0{,}30\) (dunque anche \(\text{TPR}=0{,}70\): perfino l’equal opportunity è rispettata). Applicando l’identità:
Stesso valore predittivo, stesso tasso di veri positivi, eppure il tasso di falsi positivi è tre volte più alto nel gruppo con prevalenza maggiore: \(0{,}30\) contro \(0{,}10\). È esattamente la forma del caso COMPAS [ALMK16]. In questo enunciato manca però un elemento: la calibrazione. Il teorema di Chouldechova parla di \(\text{VPP}\), che è una proprietà della decisione \(\hat{Y}\), non di \(S\).
Secondo teorema: Kleinberg, Mullainathan e Raghavan (2017), calibrazione. Il risultato gemello, indipendente e quasi simultaneo (i due preprint escono a un mese di distanza, nel settembre e nell’ottobre del 2016), riguarda i punteggi continui [KMR17]. Le tre condizioni in gioco sono la calibrazione e i due bilanciamenti di classe: che il punteggio medio ricevuto dai positivi sia lo stesso nei due gruppi, e che lo stesso valga per i negativi. Coesistono solo nei casi degeneri (prevalenze identiche o predizione perfetta). È un enunciato sui punteggi medi, non sui tassi della matrice di confusione: il bilanciamento della classe positiva non è l’uguaglianza dei TPR delle decisioni sì o no. Chiede che sia uguale fra i gruppi \(\mathbb{E}[S \mid Y=1, A=a]\), cioè \(1\) meno il tasso di falsi negativi generalizzato \(c_{\text{fn}} = \mathbb{E}[1-S \mid Y=1, A=a]\); quello della classe negativa chiede l’uguaglianza del tasso di falsi positivi generalizzato \(c_{\text{fp}} = \mathbb{E}[S \mid Y=0, A=a]\). Su un punteggio che vale solo \(0\) o \(1\) i due tassi generalizzati tornano quelli della matrice di confusione.
Terzo risultato: Pleiss e colleghi (2017), calibrazione più un solo vincolo d’errore. Con quei nomi il teorema precedente si rilegge così: calibrazione ed equalized odds generalizzato non stanno insieme, salvo prevalenze uguali o predittore perfetto. Pleiss e colleghi [PRW+17] (fra gli autori ci sono Kleinberg e Raghavan) lo riconoscono come risultato di Kleinberg e lo estendono: con prevalenze diverse, due vincoli di costo distinti qualsiasi, insieme alla calibrazione, impongono il predittore perfetto. La parte nuova è l’altra metà, quella costruttiva. Un vincolo alla volta, o i falsi negativi o i falsi positivi generalizzati, si ottiene conservando la calibrazione. Sia \(g_t(h)\) il costo d’errore generalizzato del classificatore \(h\) sul gruppo \(t\), e sia \(b\) il gruppo che sbaglia meno, \(g_a(h_a) \ge g_b(h_b)\). Il nuovo classificatore del gruppo \(b\) restituisce con probabilità \(\alpha\) la prevalenza \(p_b\) del gruppo (il predittore banale \(h^{p_b}\), che è calibrato e non informa) e altrimenti \(h_b(\mathbf{x})\); siccome il costo della mistura è lineare in \(\alpha\), i costi dei due gruppi coincidono per
E qualunque algoritmo che rispetti quel vincolo, dimostrano, non fa meglio di questa randomizzazione di una quota delle predizioni: il prezzo lo paga in accuratezza il gruppo avvantaggiato. Sull’ipotesi conviene essere precisi, perché non è quella che verrebbe da immaginare: non si chiede affatto che il classificatore sia uno solo, dato che nel loro impianto ce n’è già uno per gruppo, e il rimedio che propongono ne fabbrica un terzo. Si chiede che il classificatore di cui si pareggiano gli errori sia esso stesso calibrato, e che quegli errori siano generalizzati, cioè medie del punteggio che quel classificatore restituisce e non conteggi di decisioni binarie.
Che peso abbiano quelle ipotesi si vede lasciandole cadere: l’incompatibilità sparisce. Si prendano due gruppi con un punteggio calibrato per costruzione in entrambi (l’etichetta estratta con probabilità pari al punteggio, quindi \(P(Y=1\mid S=s, A=a)=s\) esattamente) e punteggi distribuiti come due Beta, \(\text{Beta}(3;\,3)\) e \(\text{Beta}(2{,}7;\,3{,}3)\), la cui media (che qui è la prevalenza) vale \(0{,}50\) e \(0{,}45\). Con una soglia per gruppo, \(0{,}584\) e \(0{,}537\), si ottiene \(\text{TPR}=0{,}489\) e \(\text{FPR}=0{,}202\) in tutti e due, cioè equalized odds pieno, con la calibrazione intatta perché le soglie non toccano \(S\). A divergere è il valore predittivo, \(0{,}708\) contro \(0{,}664\): esattamente come impone l’identità di Chouldechova. Non è una smentita di Pleiss, e capire perché è la parte che insegna. Calibrato, qui, è il punteggio \(S\); il classificatore di cui abbiamo pareggiato gli errori è il sì o no che si ottiene tagliandolo, e quello calibrato non è, perché quando dice sì ci prende nel \(70{,}8\%\) dei casi in un gruppo e nel \(66{,}4\%\) nell’altro, mentre un sì o no calibrato dovrebbe prenderci sempre, cioè essere perfetto. L’ipotesi non è caduta: l’abbiamo aggirata cambiando oggetto, e il prezzo si vede subito nel valore predittivo. Il post-processing di Hardt, Price e Srebro vive proprio in questo spiraglio.
Quei numeri si rifanno in forma chiusa, senza bisogno di simulare: per \(S \sim \text{Beta}(\alpha,\beta)\) la massa di punteggio sopra la soglia vale
dove \(t\) è la soglia e \(\mathbb{1}\{\cdot\}\) vale \(1\) quando la condizione è vera e \(0\) altrimenti. Da lì il TPR si ottiene dividendo quella massa per la prevalenza \(p\); il FPR sottraendola da \(P(S \ge t)\) e dividendo per \(1-p\); il VPP dividendola per \(P(S \ge t)\).
E la terna dei criteri statistici. Per independence, separation e sufficiency il risultato è più severo, come riassumono Barocas, Hardt e Narayanan [BHN23]: sono incompatibili già a due a due, fuori dai casi degeneri. Independence e separation coesistono solo se \(A \perp Y\) oppure \(\hat{Y} \perp Y\); independence e sufficiency solo se \(A \perp Y\); separation e sufficiency solo se \(A \perp Y\) o la predizione è perfetta. Qui però le tre condizioni sono enunciate sullo stesso predittore: è la ragione per cui il controesempio con le due Beta non le contraddice, dato che lì la calibrazione riguarda \(S\) e l’equalized odds riguarda un \(\hat{Y}\) ottenuto con due soglie.
Quel che i teoremi non dicono: i tassi di base sono misure#
Tutti e tre i risultati partono dallo stesso presupposto, ed è il punto in cui il ragionamento fatto finora rischia di dare una mano proprio a ciò che ha appena denunciato. Il conflitto si accende quando i tassi di base differiscono. Ma «tasso di base» è la frequenza di un esito così come lo abbiamo misurato, e non un dato di natura: è esattamente la grandezza che il bias di misura, quello delle etichette storte, può distorcere. In COMPAS il tasso di base non è la frequenza dei reati: è la frequenza dei riarresti. Se gli arresti dipendono anche da dove passano le pattuglie, allora la difesa «il nostro punteggio è affidabile allo stesso modo rispetto a quel tasso di base» è una difesa rispetto a un numero che porta dentro il problema che si voleva misurare.
Questo non rende falso nessuno dei tre teoremi: sono catene di uguaglianze, e restano vere qualunque sia l’esito che si è deciso di misurare. Cambia però cosa se ne può concludere. Il teorema dice che, dati quei numeri, non si possono avere tutte le garanzie; non dice che quei numeri siano i numeri giusti, e non dice quale garanzia tenere. Fermarsi a «tanto è una scelta di valori» è vero e insufficiente, perché lascia credere che almeno le premesse del conflitto siano solide. Una di esse non lo è.
È la domanda che viene naturale e che di solito non si trova scritta: e se i due gruppi hanno tassi di base diversi perché il mondo è ingiusto, il teorema che cosa dimostra?
Dimostra esattamente quello che dice, né più né meno: che con quei numeri lì non puoi avere tutte le garanzie insieme. Non dice che quei numeri fotografino la realtà. Prendi due quartieri in cui succedono esattamente gli stessi reati, dieci per uno. Nel primo passano molte pattuglie e ne vengono registrati nove; nel secondo ne passano poche e ne vengono registrati cinque. I reati sono gli stessi, i due «tassi di base» no: nove contro cinque. Il teorema continua a valere, e continua a costringerti a scegliere; ma il divario che lo fa scattare l’ha prodotto il metro, non il mondo.
La conseguenza pratica è che ci sono due domande, non una. La prima è «quale garanzia di equità pretendo?», ed è la domanda che il teorema mette sul tavolo. La seconda viene prima e si dimentica quasi sempre: «l’esito che sto prevedendo è davvero quello che mi interessa, o è solo quello che qualcuno ha registrato?». Un capitolo che facesse solo la prima insegnerebbe a scegliere bene dentro un problema mal posto.
L’osservazione viene da dentro la letteratura, ed è di Chouldechova stessa. Fogliato, G’Sell e Chouldechova [FGSellC20] studiano la valutazione dell’equità quando l’etichetta osservata è una versione rumorosa e sistematicamente distorta di quella d’interesse, ed è precisamente il caso dell’arresto usato come proxy del reato. La conclusione è che anche piccole distorsioni nell’etichetta osservata possono rovesciare le conclusioni di un’analisi condotta su di essa.
Il meccanismo si vede con una costruzione minima. Si prendano due gruppi con tasso di base vero identico e una sola differenza, la probabilità che il fatto venga rilevato (\(0{,}90\) nel primo, \(0{,}50\) nel secondo). Il punteggio resta calibrato per costruzione sull’etichetta osservata in entrambi. Le prevalenze vere coincidono; le prevalenze osservate no, e a quel punto il teorema, che legge la riga «arresto», dichiara inevitabile un divario che è interamente prodotto dalla misura.
Da cui una regola di lettura per tutta la sezione: ogni volta che si scrive \(P(Y=1)\) conviene ricordarsi che \(Y\) è un dato raccolto da qualcuno, in un posto, con un criterio. La formalizzazione è onesta a patto di non far passare \(Y\) per il fenomeno invece che per la sua registrazione.
Attenuare il bias: tre punti di intervento#
Se una cura definitiva non esiste, restano comunque leve per ridurre il divario, e si distinguono per il momento in cui agiscono. Prima dell’addestramento si può intervenire sui dati; durante, sull’obiettivo di addestramento, a cui si aggiunge un termine che penalizza le disparità; dopo, sulle decisioni già prodotte.
In una gara di corsa un gruppo parte più indietro. Puoi intervenire in tre momenti. Prima della gara, sistemando la linea di partenza: correggi i dati, dando più peso a certi esempi e meno ad altri (uno conta come due, un altro come mezzo), oppure raccogliendone altri. I pesi si scelgono in modo che, contando con i pesi, la quota di chi ce l’ha fatta sia la stessa in ogni gruppo: a quel punto sapere a quale gruppo appartiene una persona non dice più niente su come le è andata, e la linea sistemata vale per tutte le gare che verranno. Durante la gara, cambiando le regole: al modello si chiede di sbagliare il meno possibile, e gli si aggiunge una penale ogni volta che sbaglia più su un gruppo che sull’altro, come un giudice che toglie punti a chi taglia la strada; quanti punti togliere lo decidiamo noi, ed è la manopola con cui si sceglie quanta accuratezza spendere. Dopo la gara, spostando il traguardo: il modello resta com’è, ma il punteggio oltre il quale si dice sì viene fissato più in alto per un gruppo e più in basso per l’altro, finché i due tassi di errore coincidono.
Nessuno dei tre è gratis. Riequilibrare i dati può abbassare l’accuratezza per tutti. Spostare il traguardo pareggia gli errori senza toccare il punteggio, che resta onesto com’era; a pagare è il «sì», che dopo vale di più in un gruppo che nell’altro. Ed è delicato per una ragione che si sente subito: vuol dire trattare due persone in modo diverso proprio in base al gruppo, che è la cosa da cui eravamo partiti. C’è chi lo considera l’unico rimedio serio e chi una discriminazione a sua volta, e la discussione è aperta anche fra i giuristi.
Pre-processing. Si trasforma il dataset prima dell’addestramento. Nel reweighting di Kamiran e Calders [KC12] ogni esempio con gruppo \(a\) ed esito \(y\) riceve il peso \(w(a,y) = P(A=a)\,P(Y=y)\,/\,P(A=a,\,Y=y)\), con le probabilità stimate come frequenze sul campione: sotto quei pesi la distribuzione congiunta si fattorizza, cioè \(Y\) diventa indipendente da \(A\), e l’effetto sperato a valle è un classificatore più vicino alla parità demografica. In alternativa si ricampionano i gruppi sotto-rappresentati, o si apprende una rappresentazione da cui l’attributo protetto non si ricostruisca. Vantaggio: agnostico al modello a valle. Limite: togliere le feature che fanno da proxy dell’attributo di rado basta, perché il gruppo si indovina dalla loro combinazione.
In-processing. Si modifica l’obiettivo di addestramento aggiungendo un vincolo o un termine di regolarizzazione di equità, per esempio minimizzare \(\mathcal{L}_{\text{pred}} + \lambda\,\mathcal{L}_{\text{fair}}\) dove \(\mathcal{L}_{\text{fair}}\) penalizza il divario di TPR/FPR fra i gruppi e \(\lambda\) regola il compromesso equità-accuratezza. I tassi contano decisioni binarie e non sono derivabili, quindi in pratica si penalizza un surrogato continuo, per esempio il divario fra i punteggi medi dei gruppi sui soli positivi. Rientrano qui l’adversarial debiasing, in cui un avversario prova a indovinare \(A\) dall’uscita del modello (e, per l’equalized odds, anche dall’esito vero) e il modello impara a impedirglielo [ZLM18], e le riduzioni di Agarwal e colleghi, che risolvono il problema vincolato come una sequenza di classificazioni pesate [ABDudik+18].
Post-processing. Si lascia intatto il modello e si aggiustano le soglie: Hardt, Price e Srebro [HPS16] mostrano come derivare soglie per-gruppo (eventualmente randomizzate) che raggiungono l’equalized odds a partire da un qualsiasi punteggio già addestrato (una costruzione geometrica sulle curve ROC dei due gruppi).
I risultati di impossibilità restano sullo sfondo, e il post-processing è il posto in cui si vede meglio che cosa comprano davvero queste tecniche. Le soglie per gruppo raggiungono l’equalized odds senza toccare il punteggio, quindi senza toccarne la calibrazione; ciò che non possono fare è tenere fermo anche il valore predittivo, che si separa fra i gruppi non appena le prevalenze differiscono. Nessuna delle tre leve annulla il conflitto: sposta quale criterio privilegiare, e quel «quale» non è una scelta tecnica.
Equità individuale#
Le definizioni viste finora guardano ai gruppi in media. Una famiglia alternativa sposta l’obiettivo sul singolo: due persone che si somigliano devono ricevere lo stesso trattamento, e poco importa da quale gruppo vengano. È la strada aperta da Cynthia Dwork e colleghi [DHP+12] con un titolo che è già una tesi, fairness through awareness, «equità attraverso la consapevolezza»: contro la fairness through unawareness, l’idea diffusa che per non discriminare basti togliere dagli input l’attributo protetto. Non basta, perché altre caratteristiche fanno da proxy e il gruppo si ricostruisce dalla loro combinazione, come nel caso Amazon, dove il nome di un college per sole donne bastava a rivelare il genere.
L’idea è intuitiva: due persone simili devono ricevere esiti simili. Se due candidati hanno percorso, competenze ed esperienza quasi identici, il modello non può approvarne uno e bocciare l’altro solo perché appartengono a gruppi diversi. E la pretesa cresce con la somiglianza: due candidati lontanissimi possono ricevere esiti lontanissimi, due che distano un soffio devono ricevere esiti che distano un soffio, e il modello non ha il diritto di allontanarli più di quanto li allontani il metro con cui li misuriamo. È un principio di coerenza, non di media: non dice «tratta bene i gruppi», dice «non fare distinzioni ingiustificate fra individui vicini».
Il problema è tutto in quella parola, simili. Simili rispetto a cosa? Due curriculum possono sembrare vicini per titoli di studio e lontani per esperienza: chi decide il metro? Definire la somiglianza «giusta» è difficile quanto il problema di equità di partenza, e spesso nasconde, dentro il metro, le stesse distorsioni che volevamo eliminare.
Formalmente, dato un metro di distanza fra individui \(d(\mathbf{x}_i, \mathbf{x}_j)\) e una distanza fra distribuzioni di esito \(D\), il classificatore (che a ogni individuo associa una distribuzione sugli esiti) deve essere Lipschitz [DHP+12]:
dove \(M(\mathbf{x})\) è la distribuzione di esito assegnata a \(\mathbf{x}\) e \(D\) è per esempio la distanza di variazione totale fra distribuzioni. In parole: individui vicini secondo \(d\) ricevono esiti vicini secondo \(D\); il modello non può «strappare» a piacere due punti che il metro dichiara simili. È una garanzia sul singolo, più fine dell’equità di gruppo, e le due si toccano: un \(M\) Lipschitz rispetta la parità demografica fra due gruppi a meno di un termine (lemma 3.1 del lavoro) che con la variazione totale è limitato dalla distanza di trasporto, l’Earthmover, fra le distribuzioni dei due gruppi misurata con \(d\) (teorema 3.3). Gruppi vicini secondo \(d\) ricevono quote simili senza che lo si imponga; gruppi lontani possono riceverne di molto diverse. Ma l’equità individuale sposta l’intera difficoltà su \(d\): la metrica di somiglianza specifica del compito è assunta data, mentre in pratica sceglierla è precisamente il giudizio di valore che si voleva rendere oggettivo. Per questo l’equità individuale è teoricamente elegante ma di rado applicabile tale e quale.
Il conflitto, coi numeri#
Chiudiamo il cerchio con un esperimento riproducibile. Inventiamo due gruppi di persone e diamo a ciascuna un punteggio di rischio onesto per costruzione: se il punteggio dice \(0{,}7\), l’esito accade davvero sette volte su dieci, in entrambi i gruppi allo stesso modo (è la calibrazione di prima). L’unica differenza è che l’esito è complessivamente più frequente in un gruppo che nell’altro: i tassi di base diversi da cui parte il teorema. Poi applichiamo la stessa soglia a tutti e contiamo gli errori gruppo per gruppo.
Il punteggio fa da dado truccato: se una persona ha punteggio \(0{,}7\), tiriamo un dado che dice sì sette volte su dieci, e quello che esce diventa il suo esito reale. Il dado funziona nello stesso modo per tutti; a cambiare fra i due gruppi è soltanto quanti punteggi alti girano.
L’etichetta reale è estratta con probabilità pari al punteggio, \(P(Y=1\mid S=s)=s\), identica nei due gruppi: il punteggio è calibrato per costruzione. A differire è la sola distribuzione marginale di \(S\) (due Beta di media \(0{,}50\) e \(0{,}33\)), e con essa la prevalenza \(p=\mathbb{E}[S]\).
Il programma sorteggia i due gruppi e poi stampa, riga per riga, gli errori che il modello fa in ciascuno. Sono quei numeri, e non il programma, quelli di cui parla il commento.
import numpy as np

rng = np.random.default_rng(0)

def genera_gruppo(n, alpha, beta):
    # Il punteggio è calibrato per costruzione: P(Y=1 | S=s) = s
    s = rng.beta(alpha, beta, size=n)          # punteggio in [0,1]
    y = (rng.random(n) < s).astype(int)        # etichetta vera: 1 con probabilità s
    return s, y

# I due numeri decidono quanti punteggi alti girano nel gruppo: piu' il primo
# supera il secondo, piu' il gruppo e' spostato verso i punteggi alti.
# Gruppo A: rischio di base più alto; Gruppo B: più basso
sA, yA = genera_gruppo(20000, 3.0, 3.0)        # media score ~0,50
sB, yB = genera_gruppo(20000, 2.0, 4.0)        # media score ~0,33

soglia = 0.5

def tassi(s, y, t):
    yhat = (s >= t).astype(int)
    sel = yhat.mean()                # selection rate: quota di sì
    tpr = yhat[y == 1].mean()        # veri positivi / positivi reali
    fpr = yhat[y == 0].mean()        # falsi positivi / negativi reali
    ppv = y[yhat == 1].mean()        # valore predittivo positivo (precision)
    return sel, tpr, fpr, ppv

for nome, s, y in [("A", sA, yA), ("B", sB, yB)]:
    sel, tpr, fpr, ppv = tassi(s, y, soglia)
    print(f"Gruppo {nome}: base={y.mean():.3f}  selection={sel:.3f}  "
          f"TPR={tpr:.3f}  FPR={fpr:.3f}  VPP={ppv:.3f}")

# Calibrazione per gruppo: in ogni fascia di punteggio, quante volte
# l'esito e' accaduto davvero. Se il punteggio non mente, i due numeri
# di una stessa fascia coincidono, e coincidono col punteggio medio.
bins = np.linspace(0, 1, 6)
print("\nCalibrazione (fascia di punteggio -> quante volte l'esito e' accaduto):")
for nome, s, y in [("A", sA, yA), ("B", sB, yB)]:
    idx = np.clip(np.digitize(s, bins) - 1, 0, len(bins) - 2)
    riga = [f"[{bins[b]:.1f},{bins[b+1]:.1f})->{y[idx == b].mean():.2f}"
            for b in range(len(bins) - 1)]
    print(f"  Gruppo {nome}:", "  ".join(riga))

# Seconda prova: una soglia diversa per ciascun gruppo. Le due soglie non
# hanno niente di magico: si fanno scorrere finche' i due tassi di errore
# non coincidono, ed e' cosi' che sono stati trovati 0,72 e 0,57.
# Il punteggio non viene toccato, quindi resta calibrato.
print("\nCon una soglia per gruppo (0,72 per A e 0,57 per B):")
for nome, s, y, t in [("A", sA, yA, 0.72), ("B", sB, yB, 0.57)]:
    sel, tpr, fpr, ppv = tassi(s, y, t)
    print(f"  Gruppo {nome}: TPR={tpr:.3f}  FPR={fpr:.3f}  VPP={ppv:.3f}")
Gruppo A: base=0.500  selection=0.502  TPR=0.658  FPR=0.346  VPP=0.656
Gruppo B: base=0.329  selection=0.188  TPR=0.348  FPR=0.110  VPP=0.607

Calibrazione (fascia di punteggio -> quante volte l'esito e' accaduto):
  Gruppo A: [0.0,0.2)->0.16  [0.2,0.4)->0.31  [0.4,0.6)->0.50  [0.6,0.8)->0.69  [0.8,1.0)->0.85
  Gruppo B: [0.0,0.2)->0.13  [0.2,0.4)->0.29  [0.4,0.6)->0.48  [0.6,0.8)->0.67  [0.8,1.0)->0.81

Con una soglia per gruppo (0,72 per A e 0,57 per B):
  Gruppo A: TPR=0.215  FPR=0.056  VPP=0.795
  Gruppo B: TPR=0.219  FPR=0.055  VPP=0.660
Le colonne dicono, per ciascun gruppo, quanto è frequente davvero l’esito
(base) e a quante persone il modello dice sì (selection). TPR e VPP
hanno lo stesso numeratore, i veri positivi, e denominatori diversi:
\(\text{TPR}=\text{VP}/(\text{VP}+\text{FN})\) conta quanti dei positivi reali
il modello trova, \(\text{VPP}=\text{VP}/(\text{VP}+\text{FP})\) (il valore
predittivo positivo) quanto vale un suo sì, e su quella differenza poggia il
teorema. In mezzo c’è il FPR, la quota di falsi allarmi fra i negativi
reali. Con ventimila persone per gruppo, le differenze in gioco sono molto più
grandi del rumore del sorteggio.
Le due righe della calibrazione si leggono così: [0.0,0.2)->0.16 vuol dire
che alle persone con punteggio fra zero e zero virgola due l’esito è poi
capitato nel \(16\%\) dei casi. Sono essenzialmente identiche: in ogni
fascia di punteggio la frazione è pressoché la stessa nei due gruppi, e
coincide con la media dei punteggi delle persone che stanno in quella fascia
(non con il centro della fascia: nella prima, che va da zero a zero virgola
due, le persone si addensano verso l’alto, ed è per questo che si legge
\(0{,}16\) e non \(0{,}10\)). La calibrazione per gruppo è rispettata. Restano
briciole di
differenza fra i due gruppi, tutte nello stesso verso, e non sono un difetto:
dentro una stessa fascia il Gruppo B ha più punteggi appoggiati al bordo basso,
e la media di quella fascia lo segue. È la fascia a essere larga, non il
punteggio a mentire. Eppure, con la soglia unica, la
quota di falsi allarmi è tre volte più alta nel Gruppo A (\(0{,}346\) contro
\(0{,}110\)) e diverge nettamente anche il TPR (\(0{,}658\) contro \(0{,}348\)):
saltano tutte e due le parità degli errori, cioè l’equalized odds, quella dei
falsi allarmi e quella dei casi presi.
Attenzione però a non trarne la conclusione sbagliata, che è quella che si legge più spesso. Non è che quei tassi non si possano allineare: le ultime righe stampate, quelle con una soglia diversa per gruppo, fanno esattamente questo, e li allineano bene (\(0{,}215\) contro \(0{,}219\) e \(0{,}056\) contro \(0{,}055\)), senza toccare il punteggio e senza toccare le frequenze di base, che restano \(0{,}50\) e \(0{,}33\). Quel che si sposta, e che con la soglia unica passava inosservato, è il valore predittivo: \(0{,}795\) nel Gruppo A contro \(0{,}660\) nel Gruppo B. Cioè: quando il modello dice sì, ci prende molto più spesso in un gruppo che nell’altro.
È il teorema, nella sua forma esatta: tre garanzie, al più due alla volta. Un esperimento non dimostra un’impossibilità (un esempio non è una prova), ma questo mostra la forma del vincolo, e mostra soprattutto che la scelta è una scelta vera: si può decidere di pareggiare gli errori accettando che il «sì» valga meno in un gruppo, oppure di pareggiare l’affidabilità del sì accettando tassi di errore diversi. Quello che non esiste è la scelta che le tiene entrambe.
E qui il cerchio si chiude sull’inchiesta da cui era partito il capitolo, ma
con una precisazione che i numeri della simulazione impongono. Nella disputa
vera su COMPAS le due parti guardavano due colonne diverse della stessa
tabella, e
nessuna delle due mentiva. Nella nostra simulazione a soglia unica, invece,
nemmeno la colonna dell’azienda è pari: il VPP vale \(0{,}656\) e \(0{,}607\),
vicini ma non uguali. Per vedere la disputa nella sua forma pura bisogna
guardare le righe con le due soglie, quelle in cui gli errori sono
davvero pareggiati e la differenza si sposta tutta sul valore del «sì»:
\(0{,}795\) contro \(0{,}660\). È lì che le due parti hanno ragione entrambe.
Una differenza però resta. Qui la frequenza dell’esito nei due gruppi l’abbiamo decisa noi; su persone vere qualcuno deve andarla a contare, e la conta come può.
La configurazione a soglia unica riproduce la struttura del caso COMPAS [ALMK16]: divario nei tassi di errore con punteggio calibrato. Quella a due soglie riproduce il post-processing di Hardt, Price e Srebro [HPS16], e mostra il prezzo che si paga a valle, la separazione del VPP, che è il criterio rivendicato da Northpointe [DMB16]. Resta il caveat sui tassi di base come grandezze misurate, e vale anche qui: nella simulazione sono noti per costruzione, mentre su dati veri sono stimati da etichette che possono essere a loro volta distorte.
Nessuna metrica è «quella giusta»#
Se c’è una lezione da portare via, è questa: la domanda «questo modello è equo?» è mal posta finché non specifichiamo secondo quale criterio. Parità demografica, equalized odds, calibrazione ed equità individuale sono definizioni diverse e in tensione, e non approssimazioni successive di un’unica verità nascosta: ciascuna è sensata in certi contesti e inaccettabile in altri. In un esame di massa per una malattia grave conta non mancare i malati, e allora si pretende lo stesso tasso di veri positivi; nella concessione di un mutuo conta che un punteggio significhi lo stesso per tutti, e allora si pretende la calibrazione. Sono due risposte diverse alla stessa domanda, e sono diverse perché diverso è ciò che costa di più sbagliare.
Quel che la statistica può fare lo fa fino in fondo: elenca le opzioni, quantifica cosa costa ciascuna, smaschera quelle che si escludono a vicenda. Poi si ferma, e la scelta va fatta in chiaro da qualcuno che se ne assume la responsabilità, invece che finire dentro una riga di codice che non legge nessuno.
Da ricordare
Qui bias vuol dire pregiudizio: non è il numero dentro il neurone né l’errore di un modello troppo semplice, che nel libro portano lo stesso nome.
Il pregiudizio non nasce nel codice, entra prima, da quattro porte: il passato è ingiusto; di qualche gruppo ci sono pochi esempi; quello che è scritto nei dati non è la cosa che credevamo («arrestato» al posto di «ha commesso un reato»); e il modello si morde la coda, perché le sue decisioni di oggi diventano i dati di domani.
Le porte si vedono solo se qualcuno scrive come i dati sono stati fatti: la scheda tecnica di un dataset risponde per iscritto a chi l’ha fatto e perché, chi c’è e chi manca, come sono state messe le etichette, per quali usi va bene. Quella di un modello dice quanto sbaglia gruppo per gruppo, perché una media alta può nascondere un gruppo piccolo su cui tira a indovinare.
Per misurarlo si usa la tabella a quattro caselle del capitolo di Machine Learning, compilata un gruppo alla volta, e si confrontano due numeri: quanti dei casi veri il modello prende, e quanti falsi allarmi dà.
Ci sono più idee di equità, tutte ragionevoli: stessa quota di sì per tutti; stessi errori per tutti; stesso significato del punteggio, che non è un voto ma una previsione di probabilità; e che quando il modello dice sì ci prenda ugualmente spesso in ogni gruppo. Quando l’esito è più frequente in un gruppo che nell’altro, non si possono avere tutte insieme, e il muro è preciso: fra l’affidabilità del sì, il tasso di falsi allarmi e la quota di persone che sfuggono se ne ottengono al più due alla volta, mai tre.
Il conto che lo mostra si fa a mano, ed è quello dei due gruppi da cento e duecento persone. Se pretendi di prendere la stessa quota di persone a cui l’esito è poi capitato e di avere la stessa affidabilità quando dici sì, i falsi allarmi ti vengono 15 in tutti e due i gruppi: stesso numero, ma da una parte sono 15 innocenti su 50 e dall’altra 15 su 150. Il tasso di falsi allarmi è tre volte più alto, e non l’hai scelto tu.
E quella frequenza è un numero misurato da qualcuno, non un dato di natura: se è la frequenza degli arresti invece che dei reati, il conto che ti costringe a scegliere è stato fatto su una misura storta.
Si può attenuare, non risolvere, e si può farlo in tre momenti: prima della gara (sistemando i dati), durante (cambiando le regole dell’addestramento) o dopo (usando una soglia diversa per gruppo).
Quale garanzia pretendere è una decisione e non un calcolo, e va presa alla luce del sole.
Da ricordare
Il bias non nasce nel codice ma a monte, nei dati: passato iniquo, campione non rappresentativo, etichette-proxy distorte e feedback loop che si auto-conferma. Bias in, bias out [MMS+21].
Datasheet [GMV+21] e model card [MWZ+19] documentano dataset e modelli per fasi (motivazione, composizione, raccolta, etichettatura, usi, distribuzione, manutenzione) e con analisi disaggregate per gruppo; non correggono il bias, lo rendono ispezionabile. L’AI Act chiede per l’alto rischio la documentazione di origine e preparazione dei dati.
L’equità di gruppo si misura riusando la matrice di confusione del capitolo di Machine Learning, ma separatamente per gruppo. Tre criteri: parità demografica (stessa quota di sì), equalized odds (stessi TPR e FPR) [HPS16], calibrazione (il punteggio è la probabilità dell’esito in ogni gruppo, proprietà di \(S\) e non di \(\hat{Y}\)).
Tre risultati di impossibilità distinti, da non confondere: Chouldechova [Cho17b], parità del valore predittivo più i due tassi d’errore, al più due su tre; Kleinberg, Mullainathan e Raghavan [KMR17], calibrazione più i due bilanciamenti di classe (punteggi medi, non tassi); Pleiss e colleghi [PRW+17], calibrazione più equalized odds, ma con un solo vincolo d’errore alla volta e sotto l’ipotesi che il classificatore di cui si pareggiano gli errori sia esso stesso calibrato. Il primo dei tre è il nodo del caso COMPAS [ALMK16], dove ProPublica e Northpointe [DMB16] avevano ragione entrambe.
I tassi di base che accendono il conflitto sono grandezze misurate: su COMPAS sono riarresti, non reati, e il bias di misura le tocca [FGSellC20]. Il teorema resta vero; quel che non è dato è che le sue premesse siano neutrali.
Si può attenuare, non risolvere, intervenendo in pre-processing (riequilibrio dei dati), in-processing (vincoli/regolarizzazione di equità) o post-processing (soglie per gruppo: raggiungono l’equalized odds lasciando intatta la calibrazione, al prezzo di separare il VPP).
L’equità individuale [DHP+12] chiede esiti simili per individui simili, ma sposta la difficoltà sul definire «simile».
Nessuna metrica è «quella giusta»: scegliere il criterio di equità è una decisione di valore, non un calcolo.
L’equità chiede che cosa il modello fa alle persone su cui decide. La sezione su privacy e robustezza cambia domanda: che cosa il modello conserva e lascia trapelare delle persone su cui è stato addestrato, e che cosa un avversario gli fa fare con un input costruito apposta.