


Far funzionare le reti profonde#
Per molto tempo una rete con tanti strati è stata più un’idea che una pratica. Negli anni Novanta e nei primi anni Duemila impilare più livelli spesso peggiorava le cose: la loss (il numero che misura quanto la rete sbaglia) non scendeva, l’addestramento si arenava dopo poche passate sui dati. Non era solo questione di potenza di calcolo. Mancavano gli accorgimenti che rendono stabile l’apprendimento quando la rete è profonda.
Sono arrivati fra il 2010 e il 2015, e sono una manciata: inizializzazioni più accorte, la batch normalization [IS15], il dropout [SHK+14], gli ottimizzatori adattivi come Adam [KB15]. Insieme hanno trasformato le reti profonde da promessa fragile a strumento affidabile.
Non rispondono tutti alla stessa domanda. Alcuni servono a far arrivare un gradiente utilizzabile dall’uscita fino ai primi strati: l’inizializzazione, la scelta dell’attivazione, la batch normalization. Altri decidono come muoversi una volta che il gradiente c’è: gli ottimizzatori e il ritmo con cui cambia il passo. Altri ancora impediscono alla rete di imparare troppo bene gli esempi che ha davanti: il dropout, il weight decay, il bersaglio ammorbidito. Vanno presi in fila, prima il problema e poi i rimedi, e in fondo c’è un fenomeno, il grokking, che mostra che cosa può succedere quando l’addestramento continua ben oltre il punto in cui sembra finito.
Quando il gradiente svanisce (o esplode)#
Una rete impara per correzioni: risponde, si vede dire di quanto ha sbagliato e aggiusta i propri pesi. La correzione si legge nel gradiente della loss, \(\nabla_\theta\mathcal{L}\), che ha una componente per peso: dice di quanto la loss cresce se quel peso cresce di poco. Ogni peso si sposta nel verso opposto, di un passo proporzionale al tasso di apprendimento \(\eta\). A calcolare il gradiente è la retropropagazione (backpropagation): parte dall’uscita della rete e risale verso l’ingresso, uno strato alla volta.
A ogni passo indietro il gradiente viene moltiplicato per i pesi dello strato e per le derivate delle attivazioni. La derivata dell’attivazione dice di quanto cambia l’uscita di un neurone per una piccola variazione del suo ingresso, e dove l’attivazione è quasi piatta vale poco: muovere l’ingresso non cambia quasi niente. Ed è qui che nasce il guaio: moltiplicare tante volte per numeri piccoli.

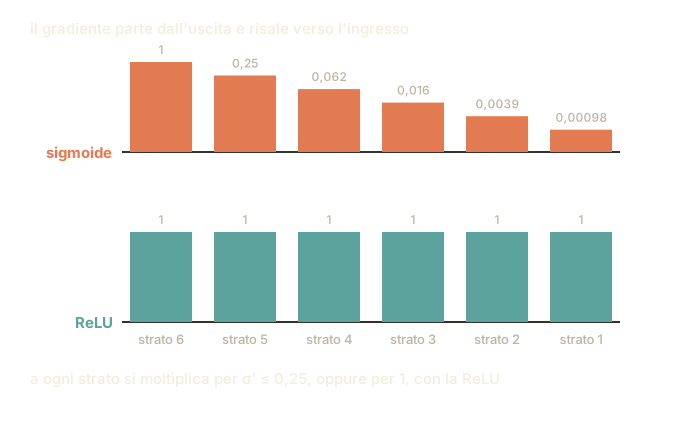
Fig. 10.7 Quanta parte del gradiente sopravvive al passaggio di ogni strato, con due attivazioni diverse: la sigmoide, la curva a S che schiaccia qualunque numero dentro l’intervallo fra 0 e 1, e la ReLU, che lascia passare i positivi come sono e azzera i negativi. Con la sigmoide ogni strato lo moltiplica per un numero che non supera mai \(0{,}25\), cioè lo divide almeno per quattro: dal sesto strato al primo, che sono cinque passaggi, resta un millesimo scarso di quello di partenza (\(0{,}25^5 = 0{,}00098\), l’ultima barra). Con la ReLU quel numero vale \(1\) dove il neurone è acceso, cioè dove il numero che gli entra è positivo, e il prodotto non si consuma. (Le barre sono disegnate in scala logaritmica: la lunghezza cresce di un tratto uguale ogni volta che il valore si moltiplica per dieci, e il disegno ne copre quattro di questi tratti. In scala normale le ultime barre non si vedrebbero, che poi è il punto.)#
I numeri della Fig. 10.7 sono il caso migliore per la sigmoide: \(0{,}25\) è il massimo della sua derivata, e lo raggiunge in un punto solo, quello in cui il numero che entra nel neurone vale zero. Altrove è molto più piccolo, e il crollo è più rapido.
Verrebbe da concludere che con la ReLU il problema sia chiuso, e non lo è. Le derivate sono solo metà della storia: a ogni passo indietro il gradiente viene moltiplicato anche per i pesi dello strato, e quelli, all’inizio, non li ha ancora sistemati nessuno. Questo rende cruciale la scelta successiva: la scala dei pesi prima del primo passo.
Un foglio scritto a matita, fotocopiato. Poi si fotocopia la fotocopia, e poi la fotocopia di quella. A ogni giro il grigio sbiadisce. Se a ogni passaggio ne resta un decimo, dopo dieci copie di quello che c’era scritto è rimasto un decimo di miliardesimo: un foglio bianco.
È ciò che succede al gradiente, il segnale di correzione che dall’uscita della rete deve tornare fino ai primi strati: attraversando molti livelli si assottiglia fino a sparire. Gli strati vicini all’ingresso non ricevono quasi nessuna indicazione su come cambiare, e di fatto smettono di imparare. Il difetto opposto è pari e contrario: se ogni passaggio ingrandisce invece di sbiadire, dopo poche copie il segnale esplode in numeri enormi e l’addestramento va in tilt.
Quanto grigio sopravvive a un passaggio dipende da com’è fatto il neurone che lo lascia passare, e cambiare quello è il primo rimedio. La curva a S non ne restituisce mai più di un quarto, nemmeno nel suo punto migliore: cinque passaggi e si è già sotto il millesimo. La ReLU, che lascia passare i positivi come sono, lo restituisce tutto dove il neurone è acceso, e lì il grigio non si consuma. Contro il difetto opposto la mossa è un’altra: si fissa un tetto, e il segnale che lo supera viene riportato lì prima di proseguire.
Il gradiente rispetto ai pesi di uno strato profondo è un prodotto di molti fattori. Chiamiamo \(\mathbf{z}_k\) gli ingressi dei neuroni dello strato \(k\) prima dell’attivazione, e \(\boldsymbol{\delta}_k = \partial\mathcal{L}/\partial \mathbf{z}_k\) il gradiente della loss rispetto a quegli ingressi. La retropropagazione è la ricorsione \(\boldsymbol{\delta}_{k-1} = \operatorname{diag}\!\big(g'(\mathbf{z}_{k-1})\big)\,\mathbf{W}_k^\top \boldsymbol{\delta}_k\), e svolgendola dalla cima fino allo strato \(\ell\) in una rete di \(L\) strati si ottiene
dove \(\mathbf{W}_k\) è la matrice dei pesi dello strato \(k\) e \(g'(\mathbf{z}_{k-1})\) la derivata della funzione di attivazione \(g\) calcolata negli ingressi dello strato precedente (la lettera è quella del capitolo sulle reti neurali; la sigmoide, che ne è un caso particolare, si nomina sempre per esteso). Il prodotto è ordinato: i fattori vanno scritti da sinistra a destra per \(k\) crescente e non si possono scambiare, perché il prodotto di matrici non commuta. Siccome la norma di un prodotto non supera il prodotto delle norme, se le norme spettrali dei fattori restano sotto \(1\) il prodotto tende a \(0\) esponenzialmente in \(L\) (vanishing gradient): è una condizione sufficiente. Che qualche norma superi \(1\) è invece necessario perché il gradiente diverga (exploding gradient), ma non basta, perché conta anche come i fattori si allineano [PMB13].
La sigmoide aggrava il primo caso: la sua derivata non supera \(0{,}25\) in
nessun punto, quindi il solo fattore di attivazione riduce il gradiente di
almeno quattro volte a ogni strato. Rimedi complementari: attivazioni non
saturanti come la ReLU (\(g'=1\) per input positivi); il gradient clipping
contro l’esplosione, che quando la norma del gradiente supera una soglia
fissata lo riscala fino a quella soglia, cambiandone la lunghezza e non la
direzione [PMB13] (in PyTorch
torch.nn.utils.clip_grad_norm_); e una scelta accurata della scala iniziale
dei pesi.
Partire col piede giusto: l’inizializzazione#
Se il gradiente svanisce o esplode a seconda di quanti fattori piccoli lo hanno moltiplicato, il punto di partenza conta, e conta tanto di più quanto più la rete è profonda. Le due ricette con cui si sceglie la scala iniziale dei pesi, Xavier e He, e il fatto che il default di PyTorch non sia nessuna delle due, li ha già nominati il capitolo su PyTorch; qui se ne vede la ragione.
Attenzione a una parola che da qui in avanti cambia mestiere. «Attivazione» indica due cose diverse: la funzione che ogni neurone applica al proprio risultato (la ReLU, la sigmoide) e i numeri che escono da uno strato dopo che quella funzione è stata applicata. «La derivata dell’attivazione» è la prima cosa; «normalizzare le attivazioni» sono i secondi. Il contesto basta a distinguerle.

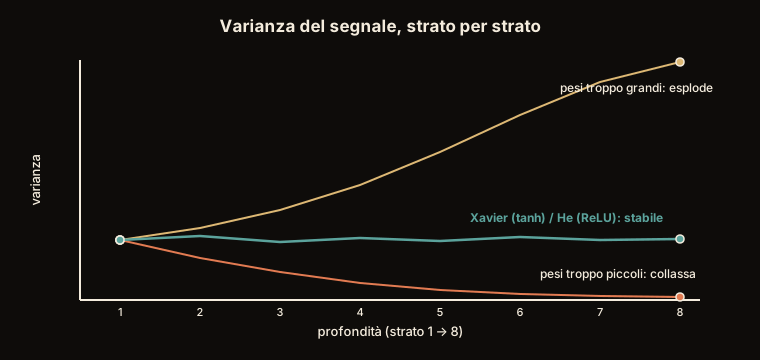
Fig. 10.8 Tre inizializzazioni, tre destini, e nessun addestramento ancora avvenuto. In verticale c’è la varianza del segnale, cioè quanto sono sparpagliati i numeri che escono da uno strato: grande vuol dire valori forti e distanti fra loro, vicina a zero vuol dire valori tutti appiccicati, cioè un segnale ormai spento. La curva piatta è l’obiettivo: quell’ampiezza deve attraversare la rete senza gonfiarsi né spegnersi, e ci riesce la scala calibrata sull’attivazione, Xavier per la tanh e He per la ReLU.#
Il fatto che le tre curve di Fig. 10.8 divergano prima del primo aggiornamento è ciò che rende l’inizializzazione un problema a sé: con la scala sbagliata, in una rete profonda, il gradiente è già svanito o esploso al primo passo, prima che l’addestramento possa correggere qualcosa.
Cento persone in una stanza, e ognuna ripete ad alta voce quello che sente dalla stanza prima; dall’ultima torna indietro un grido: giusto, o sbagliato. Il volume deve restare quello che è: se ogni stanza alza un poco, in fondo si urla; se abbassa un poco, in fondo c’è silenzio. Quel volume, cioè quanto i numeri di uno strato sono forti e sparpagliati, si chiama varianza.
Chi ne ascolta cento e le ripete tutte insieme ne rimanda fuori cento sovrapposte, e cento voci fanno cento volte il volume di una. Perché dalla sua bocca esca il volume di una voce sola, ognuna gli deve arrivare attenuata a un centesimo: è il volume che si mette in partenza a ciascuna, uno diviso il numero di voci che arrivano.
Da lì partono le due ricette collaudate. Glorot (o Xavier, dal nome di battesimo dell’autore) nota che nella fila si viaggia in due versi: il messaggio scende, il grido di correzione risale. Tenerlo fermo all’andata vuol dire sbagliarlo al ritorno, e allora si divide per la media fra le voci che uno ascolta e quelle a cui parla. Vale nella stanza in cui tutte le voci ripartono, nessuna esclusa: è il caso della tanh, la curva a S della sigmoide spostata fra \(-1\) e \(+1\).
Kaiming He ha in mente una stanza dove metà delle voci non riparte, che è quello che fa la ReLU: sotto zero zittisce tutto. Delle cento ne ripartono cinquanta, quindi chi parla si regola su cinquanta e comincia al doppio del volume. Di quanti lo ascoltino non si occupa.
Uno strato creato in PyTorch senza dire niente non segue nessuna delle due: la stanza parte con un volume sei volte più basso di He, e nessuno parte in silenzio. Il bias è il numero fisso che ogni neurone somma a quello che ha sentito, dovrebbe valere zero all’inizio, perché non c’è ancora ragione di preferire un verso, e PyTorch lo sorteggia come i pesi.
Il divario si sente presto, e cresce con la fila. Con cinque stanze, il grido che torna alla prima con i pesi di PyTorch è già mille volte più fioco che con quelli alla He. Con quaranta, alla He vale ancora quasi mezzo; con i pesi di PyTorch comincia con diciassette zeri dopo la virgola, decine di milioni di miliardi di volte più fioco. A sessanta gli zeri dopo la virgola sono venticinque: un grido che nessuno sentirebbe. E se arriva ancora qualcosa, lo si deve anche al brusio di quei bias sorteggiati, che ogni stanza aggiunge comunque, anche senza sentire niente: è la sola cosa che tiene vivo il messaggio mentre i pesi lo spengono. Il volume di partenza lo sceglie chi costruisce la rete, prima che faccia un solo passo.
L’obiettivo è preservare la varianza delle attivazioni (e dei gradienti) da uno strato all’altro, e il conto si fa in due righe sotto tre ipotesi: pesi indipendenti, a media nulla e indipendenti dagli ingressi; pre-attivazioni simmetriche attorno a zero; bias nulli. Per la pre-attivazione di un’unità, \(z = \sum_{j=1}^{n_{\text{in}}} w_j h_j\), l’indipendenza dà
Con la ReLU e la pre-attivazione dello strato prima, \(z'\), simmetrica attorno a zero, \(\mathbb{E}[h^2] = \mathbb{E}[\max(0,z')^2] = \tfrac{1}{2}\operatorname{Var}(z')\), quindi la varianza resta costante di strato in strato se e solo se \(n_{\text{in}}\operatorname{Var}(w)/2 = 1\). Con un’attivazione che vicino a zero è l’identità, come la tanh, il fattore \(\tfrac{1}{2}\) sparisce e la condizione diventa \(n_{\text{in}}\operatorname{Var}(w) = 1\); la stessa richiesta sui gradienti, che all’indietro attraversano la matrice trasposta, dà \(n_{\text{out}}\operatorname{Var}(w) = 1\). L’inizializzazione di Glorot [GB10] fa la media fra le due richieste e campiona i pesi con varianza
adatta ad attivazioni simmetriche attorno a zero (tanh). Per la ReLU, che azzera metà degli ingressi, He [HZRS15] raddoppia la scala usando solo il fan-in:
In entrambi i casi \(w\) si estrae da una normale (o da una uniforme con supporto equivalente) e i bias si pongono a \(0\). La regola pratica: He con ReLU e varianti, Glorot con tanh. Con la sigmoide il conto non regge, perché non è simmetrica attorno a zero (in zero vale \(1/2\)), e Glorot e Bengio stessi la sconsigliano nelle reti profonde inizializzate a caso, perché spinge in saturazione gli ultimi strati nascosti [GB10].
Quello che queste due ricette non sono è il comportamento predefinito di
PyTorch, ed è un equivoco che costa poco credere e parecchio pagare.
nn.Linear e nn.Conv2d inizializzano i pesi con
kaiming_uniform_(a=math.sqrt(5)), che nonostante il nome produce varianza
cioè un sesto di He. Su nn.Linear(100, 100) fa
\(1/300 \approx 3{,}3\times10^{-3}\), contro i \(2/100 = 2{,}00\times10^{-2}\) di
He. E i bias non sono nulli: escono da una uniforme
\(\pm 1/\sqrt{n_{\text{in}}}\), la stessa scala dei pesi.
Su una pila di blocchi Linear(100, 100) + ReLU la differenza si misura, e
cresce con la profondità. Il protocollo, perché la misura si possa rifare:
ingresso \(64\times100\) da una normale standard, loss l’errore quadratico medio
dell’uscita contro zero, si legge la norma del gradiente sui pesi del primo
strato, mediana su cinque semi. I bias seguono ciascuno la propria ricetta:
azzerati con He e con Glorot, come le due prescrivono, e lasciati come li mette
PyTorch nel caso del default, che è appunto quel che si ottiene senza toccare
niente; la riga default, bias 0 li azzera anche lì, per vedere quanto
contano. La norma si calcola in float64, e la ragione si vede a sessanta
blocchi. Il conto sta in un blocco:
import statistics
import torch
from torch import nn

torch.set_num_threads(1)

def norma_primo_strato(ricetta, blocchi, seme):
    torch.manual_seed(seme)
    strati = []
    for _ in range(blocchi):
        lineare = nn.Linear(100, 100)
        if ricetta == "He":
            nn.init.kaiming_normal_(lineare.weight, nonlinearity="relu")
            nn.init.zeros_(lineare.bias)
        elif ricetta == "Glorot":
            nn.init.xavier_normal_(lineare.weight)
            nn.init.zeros_(lineare.bias)
        elif ricetta == "default, bias 0":
            nn.init.zeros_(lineare.bias)
        strati += [lineare, nn.ReLU()]
    rete = nn.Sequential(*strati)
    (rete(torch.randn(64, 100)) ** 2).mean().backward()
    # norma in float64: in float32 i quadrati di numeri cosi' piccoli si perdono
    return rete[0].weight.grad.double().norm().item()

for blocchi in (5, 10, 40, 60):
    for ricetta in ("He", "Glorot", "default", "default, bias 0"):
        norme = [norma_primo_strato(ricetta, blocchi, s) for s in range(5)]
        mediana = statistics.median(norme)
        print(f"{blocchi:2d} blocchi, {ricetta:<15} mediana {mediana:.1e}"
              f"   (da {min(norme):.1e} a {max(norme):.1e})")
 5 blocchi, He              mediana 4.6e-01   (da 4.3e-01 a 6.7e-01)
 5 blocchi, Glorot          mediana 2.0e-02   (da 1.9e-02 a 3.0e-02)
 5 blocchi, default         mediana 4.2e-04   (da 3.3e-04 a 4.6e-04)
 5 blocchi, default, bias 0 mediana 1.9e-04   (da 1.5e-04 a 2.0e-04)
10 blocchi, He              mediana 5.4e-01   (da 4.5e-01 a 7.8e-01)
10 blocchi, Glorot          mediana 7.5e-04   (da 6.2e-04 a 1.1e-03)
10 blocchi, default         mediana 3.7e-06   (da 3.0e-06 a 5.8e-06)
10 blocchi, default, bias 0 mediana 3.2e-08   (da 2.4e-08 a 3.6e-08)
40 blocchi, He              mediana 4.7e-01   (da 8.2e-02 a 9.7e-01)
40 blocchi, Glorot          mediana 6.1e-13   (da 1.1e-13 a 1.3e-12)
40 blocchi, default         mediana 9.6e-18   (da 2.2e-18 a 1.5e-17)
40 blocchi, default, bias 0 mediana 1.0e-31   (da 1.3e-32 a 3.4e-31)
60 blocchi, He              mediana 1.7e-01   (da 4.6e-02 a 1.2e+00)
60 blocchi, Glorot          mediana 2.1e-19   (da 5.7e-20 a 1.4e-18)
60 blocchi, default         mediana 9.4e-26   (da 2.2e-26 a 1.7e-25)
60 blocchi, default, bias 0 mediana 0.0e+00   (da 0.0e+00 a 0.0e+00)
A quaranta blocchi la mediana vale \(4{,}7\times10^{-1}\) inizializzando alla He, \(6{,}1\times10^{-13}\) alla Glorot e \(9{,}6\times10^{-18}\) con il default di PyTorch: più di sedici ordini di grandezza fra la prima e l’ultima, e l’addestramento non è ancora cominciato. La dispersione fra semi è ampia (con He il singolo seme va da \(8{,}2\times10^{-2}\) a \(9{,}7\times10^{-1}\)), il divario fra le tre no. E il divario c’è già con pochi strati: a cinque blocchi il default arriva al primo strato con un gradiente mille volte più piccolo di He (\(4{,}2\times10^{-4}\) contro \(4{,}6\times10^{-1}\)), a dieci più di centomila volte (\(3{,}7\times10^{-6}\) contro \(5{,}4\times10^{-1}\)). Con la discesa del gradiente semplice, che non riscala niente, l’aggiornamento del primo strato rallenta dello stesso fattore.
I bias del default contano: azzerandoli, a quaranta blocchi la norma scende da
\(9{,}6\times10^{-18}\) a \(1{,}0\times10^{-31}\). Sono loro a tenere viva l’uscita
mentre i pesi la spengono, e dall’uscita riparte il gradiente. A sessanta
blocchi il default scende a \(9{,}4\times10^{-26}\), un numero che float32 sa
ancora scrivere (il più piccolo valore normale è circa \(10^{-38}\)). La norma
calcolata in float32, però, lo perde: eleva al quadrato le componenti,
dell’ordine di \(10^{-27}\), e \(10^{-54}\) è sotto anche il più piccolo numero che
float32 sappia scrivere (circa \(1{,}4\times10^{-45}\)), quindi la somma dei
quadrati fa zero e la norma pure, con un gradiente che zero non è. È la ragione
per cui il blocco calcola la norma in float64. Lo zero di default, bias 0 a
sessanta blocchi, invece, è vero: senza il brusio dei bias l’uscita della rete
è dell’ordine di \(10^{-23}\), il gradiente che ne riparte è più piccolo ancora,
e il loro prodotto, che è il gradiente sui pesi, scende sotto quella soglia già
mentre lo si calcola. Che la questione sia nota a chi scrive le librerie lo
dicono le librerie stesse: la ResNet di torchvision non si fida del default e
reinizializza ogni convoluzione con nn.init.kaiming_normal_(m.weight, mode="fan_out", nonlinearity="relu").
Normalizzare mentre si impara: la batch normalization#
Una buona inizializzazione vale all’inizio; dopo qualche aggiornamento la scala delle attivazioni di ogni strato cambia di nuovo. La batch normalization [IS15] normalizza le attivazioni di ogni strato con la media e la varianza calcolate sul gruppo di esempi in corso, e permette di addestrare reti profonde con un passo più lungo e con meno attenzione all’inizializzazione.

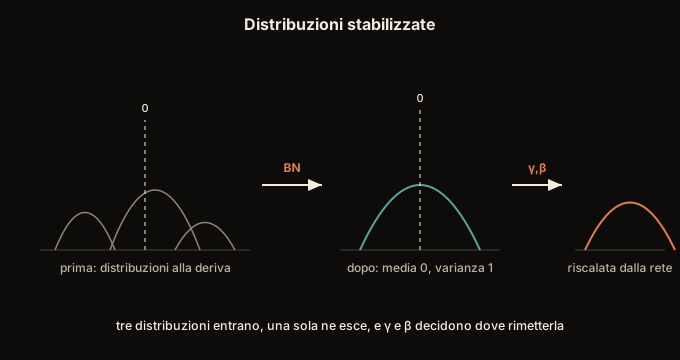
Fig. 10.9 Da tre distribuzioni che vagano a una sola. Una distribuzione è la gobba che si ottiene segnando quanti numeri cadono in ciascun punto: alta dove i numeri si addensano, bassa dove sono rari, e spostata a destra o a sinistra a seconda di dove sta il grosso. Nel riquadro di mezzo le tre curve, che differivano solo per posizione e larghezza, coincidono, e per questo se ne disegna una: la normalizzazione fissa la media e la varianza, non la forma. Il terzo riquadro è la coda dell’operazione: due parametri, \(\gamma\) (gamma) e \(\beta\) (beta), restituiscono alla rete la libertà che la normalizzazione le ha appena tolto, il primo riallargando o restringendo i numeri, il secondo spostandoli in su o in giù.#
La coda di Fig. 10.9 è la parte che spesso si salta e che invece conta. Normalizzare e basta imporrebbe a ogni strato un’ampiezza decisa da noi; \(\gamma\) e \(\beta\) sono due numeri che la rete impara come tutti gli altri, e le permettono di riallargare e spostare il risultato se le conviene, invece di subire la scala che abbiamo scelto noi.
Le reti non si addestrano un esempio alla volta: si prende un gruppetto di esempi, di solito da qualche decina a qualche centinaio, si guarda quanto la rete sbaglia su tutti insieme e si fa un’unica correzione. Quel gruppetto si chiama mini-batch, o batch per brevità, ed è l’unità di misura dell’addestramento.
La batch normalization fa questo: a ogni strato prende i numeri che escono, li ricentra perché abbiano media zero e li riscala perché abbiano ampiezza uno, e media e ampiezza le misura sul mini-batch corrente. Con tre numeri soli, 2, 4 e 6, la media è 4, e tolta la media restano \(-2\), 0 e 2. L’ampiezza è la deviazione standard, la radice della media dei quadrati di quegli scarti: \(\sqrt{8/3}\), circa 1,63. Divisi per quella, i tre numeri diventano circa \(-1{,}22\), 0 e \(1{,}22\). È come rimettere in scala i numeri a ogni passo, così che nessuno strato debba adattarsi a ingressi che cambiano scala di continuo. In pratica accelera molto l’addestramento, permette un passo di correzione più aggressivo e ha un lieve effetto di regolarizzazione (cioè frena l’imparare a memoria), perché ogni gruppetto ha statistiche un po’ diverse dal precedente e quella variabilità fa da rumore utile.
Quando la rete smette di allenarsi e va a lavorare, però, il gruppetto non c’è più: le domande arrivano una alla volta, e una media calcolata su un esempio solo non vuol dire niente. Per questo, mentre si allena, la rete si tiene da parte una media e un’ampiezza che aggiorna a ogni passo, pesando un poco il gruppetto appena visto e molto tutti quelli di prima. A lavoro finito usa quelle, sempre le stesse, e la risposta a una domanda non dipende più da chi le capita accanto nel gruppo.
Sul mini-batch \(\mathcal{B}\) si calcolano media \(\mu_{\mathcal{B}}\) e varianza \(\sigma_{\mathcal{B}}^2\), si normalizza e si riscala con due parametri appresi \(\gamma\) (scala) e \(\beta\) (shift):
Il termine \(\epsilon\) evita la divisione per zero.
Su che cosa si calcolino quelle statistiche è la domanda che decide quanti
parametri ha lo strato, e la risposta dipende dal tipo di dato. In una rete
densa la coppia \((\gamma,\beta)\) è per unità. In una rete convoluzionale
sarebbe assurdo trattare i pixel come feature diverse, visto che la mappa è
prodotta dallo stesso filtro in ogni punto: media e varianza si calcolano
per canale, su tutte le posizioni e tutti gli esempi del batch insieme (gli
assi \((N,H,W)\)), e la coppia \((\gamma,\beta)\) è una per canale. Per questo
nn.BatchNorm2d(16) ha \(32\) parametri appresi e non \(2\,C\,H\,W\): sedici
\(\gamma\) e sedici \(\beta\), e la risoluzione delle mappe non c’entra.
Su che cosa restituiscano \(\gamma\) e \(\beta\) conviene essere precisi, perché la formula promette meno di come viene raccontata di solito. Rispetto alle statistiche fisse usate in inferenza, sì: con \(\gamma=\sqrt{\sigma^2+ \epsilon}\) e \(\beta=\mu\) lo strato torna esattamente l’identità. Lotto per lotto no: \((\gamma,\beta)\) sono due costanti apprese, mentre \((\mu_{\mathcal{B}},\sigma_{\mathcal{B}})\) cambiano a ogni batch, e nessuna coppia di costanti può annullare una normalizzazione che si muove.
In inferenza infatti le statistiche del batch non si usano: al loro posto va
una media mobile esponenziale aggiornata durante l’addestramento,
\(\hat{\mu} \leftarrow (1-m)\,\hat{\mu} + m\,\mu_{\mathcal{B}}\), non la media di
tutto ciò che si è visto. Attenzione al nome del parametro: il momentum di
nn.BatchNorm2d (default \(0{,}1\)) è il peso del dato nuovo, cioè
l’opposto del \(\beta_1\) di Adam, dove \(0{,}9\) è il peso della storia.
Quale delle due statistiche si usa lo decide lo stato del modulo: dopo
model.train() lo strato normalizza con
\((\mu_{\mathcal{B}}, \sigma^2_{\mathcal{B}})\) e aggiorna le medie mobili, dopo
model.eval() usa le medie mobili e non le tocca più. Dimenticare eval() in
valutazione fa dipendere la predizione di un esempio dagli altri del batch, ed è
il guasto più frequente di questo strato. In addestramento PyTorch normalizza
con la varianza distorta, divisa per il numero di valori che entrano nella stima
(\(|\mathcal{B}|\) in una rete densa, \(N\,H\,W\) per canale in una convoluzionale),
e aggiorna la media mobile con quella corretta, divisa per quel numero meno uno.
E il gradiente attraversa anche \(\mu_{\mathcal{B}}\) e \(\sigma_{\mathcal{B}}\),
che dipendono da tutti gli esempi del batch: ogni esempio riceve un gradiente
che dipende dagli altri, e con batch di pochi esempi le stime sono così rumorose
che lo strato peggiora l’addestramento. È la ragione per cui altrove si
normalizza sul singolo esempio, come fa la layer normalization dei Transformer.
Perché la batch normalization funzioni così bene non lo sa ancora nessuno con certezza. Quello che fa è fuori discussione: sottrae la media, divide per la deviazione standard e lascia alla rete due parametri, \(\gamma\) e \(\beta\), per ripristinare scala e posizione. Il perché è un’altra storia. Ioffe e Szegedy la introdussero per ridurre l’internal covariate shift, il cambiare della distribuzione degli ingressi di uno strato mentre gli strati prima di lui si aggiornano. Santurkar e colleghi [STIM18] hanno mostrato che la riduzione dello shift non spiega il beneficio: iniettando apposta rumore dopo la normalizzazione, con media e varianza che cambiano a ogni passo, la distribuzione si sposta più di prima, e l’addestramento resta rapido quasi quanto con la batch normalization pulita. La spiegazione che hanno proposto, una superficie della loss più liscia e quindi più facile da percorrere, è a sua volta un’ipotesi.
È un motivo per diffidare delle spiegazioni troppo pulite, non per rinunciare alla tecnica: nel deep learning capita spesso che una tecnica sia solidissima in pratica e ancora senza una teoria che regga.
Spegnere neuroni a caso: il dropout#
La batch normalization frena un po’ l’imparare a memoria, come effetto collaterale. Il dropout lo fa per scelta esplicita, ed è uno dei modi più semplici per combattere l’overfitting, cioè il caso in cui la rete impara a memoria gli esempi che le sono stati mostrati e su quelli nuovi sbaglia.

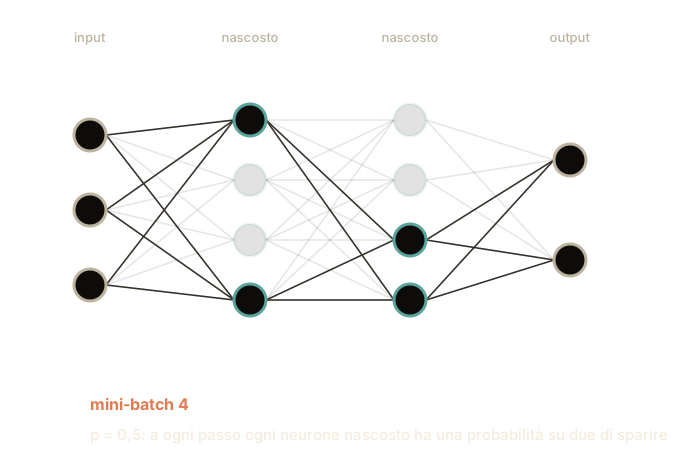
Fig. 10.10 Quattro mini-batch consecutivi con \(p = 0{,}5\): ogni volta la rete che viene davvero addestrata è un’altra. Ogni neurone nascosto se la gioca a testa o croce per conto proprio, quindi il numero di quelli spenti cambia da un passo all’altro. Input e output non si spengono mai.#
Durante l’addestramento, a ogni passo, spegniamo a caso una frazione dei neuroni. La rete non può più affidarsi a un singolo neurone «specialista»: deve distribuire la conoscenza, perché quel neurone potrebbe non esserci al prossimo giro. È come allenare ogni volta una squadra leggermente diversa: il risultato è un modello più robusto, che generalizza meglio su dati nuovi. Quando poi la rete lavora sul serio, cioè quando risponde invece di allenarsi (si dice a inferenza), tutti i neuroni tornano attivi.
Verrebbe da chiedersi se a quel punto i numeri non raddoppino, visto che raddoppiano i neuroni che li producono. Non succede, perché il conto è già stato pareggiato prima: durante l’allenamento, quando metà dei neuroni è spenta, i sopravvissuti vengono raddoppiati sul posto, così la somma che esce ha la taglia giusta fin da subito. A rete piena non resta niente da aggiustare.
Spegnere neuroni a caso e batch normalization non vanno d’accordo sullo stesso strato, e la ragione sta proprio nelle taglie. La seconda misura media e ampiezza su una rete a cui manca ogni volta metà dei neuroni, e quel continuo accendersi e spegnersi allarga i numeri di suo. Il giorno in cui la rete lavora ci sono tutti, quel rimescolio sparisce, e i numeri arrivano più stretti di come erano stati misurati, mentre la scala messa da parte è rimasta quella larga. La rete risponde peggio di quanto farebbe con una tecnica sola, e per questo di solito se ne sceglie una.
Con probabilità di spegnimento \(p\), la convenzione di nn.Dropout(p) in
PyTorch, si applica alle attivazioni una maschera binaria
\(\mathbf{m} \sim \text{Bernoulli}(1-p)\):
dove \(\odot\) è il prodotto elemento per elemento. Il fattore \(1/(1-p)\) (inverted dropout) mantiene invariato il valore atteso di ciascuna attivazione, e a inferenza si usa direttamente la rete piena senza riscalature. Attenzione a cosa questo garantisce: l’uscita della rete piena non è la media dell’ensemble di sotto-reti, perché attraversare una non-linearità non conserva il valore atteso. Ne è un’approssimazione (della media geometrica delle distribuzioni predette), esatta solo per modelli senza unità nascoste non lineari e per il resto giustificata dalla sola evidenza empirica, che però è schiacciante. Valori tipici: \(p \in [0{,}2,\ 0{,}5]\).
Perché regolarizzi si vede in chiuso su un modello lineare con perdita quadratica. Con \(\tilde{\mathbf{x}} = (\mathbf{m}\odot\mathbf{x})/(1-p)\) ogni componente ha media \(x_j\) e varianza \(x_j^2\,p/(1-p)\), maschere indipendenti, quindi
cioè, in media, la perdita senza dropout più una penalità \(L_2\) in cui ogni peso paga in proporzione al quadrato del suo ingresso: una regolarizzazione che si adatta ai dati [SHK+14]. La stessa varianza spiega perché non si combina bene con una batch normalization messa dopo, sullo stesso strato. Per un’attivazione \(h\) a media nulla, \(\tilde h\) ha varianza \(\operatorname{Var}(h)/(1-p)\) in addestramento e \(\operatorname{Var}(h)\) in inferenza, e le statistiche che la normalizzazione accumula in addestramento sovrastimano la varianza di inferenza di un fattore \(1/(1-p)\), il doppio con \(p = 0{,}5\). È lo spostamento di varianza (variance shift) che Li e colleghi indicano come causa del disaccordo [LCHY19], e il motivo per cui sullo stesso strato si sceglie spesso l’una o l’altro.
Il dropout si descrive spesso come un ensemble implicito, cioè come una squadra di reti al posto di una sola, e la ragione è nel conto delle reti possibili. I neuroni che si possono spegnere sono quelli nascosti, cioè quelli in mezzo, che non ricevono i dati e non danno la risposta finale: se sono \(n\), le combinazioni possibili di acceso e spento sono \(2^n\), che già con dieci neuroni fa 1024 reti diverse e con venti più di un milione. Ogni passo di addestramento ne allena una presa a caso. Quelle reti però non hanno pesi propri: sono tutte ritagliate dallo stesso insieme di pesi, e un peso aggiornato per la sotto-rete di un passo ha lo stesso valore nuovo in tutte quelle che lo contengono. Non si allenano una alla volta: si allenano tutte, un pezzetto per volta.
Bersagli meno netti: il label smoothing#
Il dropout agisce sulla rete; il label smoothing («etichette lisciate») agisce sul bersaglio, cioè sulle risposte giuste con cui la rete viene corretta.
In classificazione l’etichetta di un esempio è un vettore one-hot: un uno sulla classe vera e zero sulle altre (gatto 1, lince 0, cane 0, camion 0, sedia 0). La rete risponde invece con una softmax, che dai punteggi grezzi dell’ultimo strato fa probabilità, e le probabilità della softmax stanno tutte strettamente fra zero e uno: nessun valore finito dei punteggi la porta a uno sulla classe vera e a zero sulle altre. Con il bersaglio one-hot, quindi, la loss non ha un minimo che dei punteggi finiti possano raggiungere.
Il professore di scienze fa un gioco. Mostra la foto di un animale, e ciascuno, invece di scrivere una risposta sola, deve spartire dieci gettoni fra le cinque risposte in elenco: gatto, lince, cane, camion, sedia. Più gettoni sulla risposta giusta, più punti.
I gettoni però non si posano a mano. Accanto a ogni risposta si scrive un numero, e i gettoni si spartiscono seguendo quei numeri: chi ha il numero più alto prende la fetta più grossa. È il gioco della softmax, che dei punteggi grezzi fa percentuali, e la sua regola ha una proprietà che qui conta più di tutte: per quanto in basso si scriva un numero, la fetta rimpicciolisce e non si annulla. Tacere non è previsto: le cinque risposte hanno tutte il loro numero.
Il regolamento dice che la risposta perfetta sono dieci gettoni sul gatto e zero su tutto il resto, e lì sta il guaio: quello zero non si può ottenere. Per darlo al camion bisognerebbe scrivergli accanto un numero più basso di qualunque numero, e un numero così non c’è. Si può soltanto scrivere accanto al gatto un numero sempre più alto e vedere la briciola del camion rimpicciolire senza sparire. E un numero più alto c’è sempre: chi prende alla lettera quel regolamento non ha mai finito.
E allora perché cambiare il regolamento? Per due ragioni, e la voglia di finire non è fra quelle. La prima: chi passa i suoi turni a rialzare il numero accanto a una risposta che sa già non sta imparando niente di nuovo, sta imparando a memoria quelle foto lì. La seconda: chi si dà il \(99{,}99\%\) su ogni foglio ha smesso di dire quanto è sicuro, e quanto è sicuro è la cosa che decide se fidarsi della risposta o far guardare la foto a una persona.
E chi scrive numeri enormi si rende difficile cambiarli. La correzione che il professore segna è la differenza fra la fetta uscita e quella che si voleva, cioè fra due percentuali: quando il numero del gatto sta già dodici sopra quello degli altri, una correzione così piccola non lo sposta quasi più.
Con \(K\) classi, l’etichetta di un esempio è la distribuzione degenere \(q(k) = \delta_{k,y}\), che vale 1 sulla classe vera \(y\) e 0 altrove, e la loss è l’entropia incrociata
dove \(\mathbf{z} \in \mathbb{R}^K\) sono i logit dell’ultimo strato e \(p(k)\) la probabilità che il modello assegna alla classe \(k\) (questo \(p\) è la distribuzione predetta, e non ha niente a che vedere con la \(p\) scalare del dropout, che era la probabilità di spegnimento). Il minimo si tocca per \(p(y) = 1\), e nessun \(\mathbf{z}\) finito lo realizza: avvicinarvisi richiede \(z_y - z_k \to \infty\) per ogni \(k \ne y\). Il gradiente rispetto ai logit vale \(\partial H / \partial z_k = p(k) - q(k)\) e resta diverso da zero comunque a lungo si vada avanti, quindi i logit continuano a crescere e con loro i pesi che li producono. Vale però in un regime preciso, quello in cui la rete riesce davvero a separare gli esempi di addestramento: se gli stessi ingressi compaiono con etichette diverse, il bersaglio che la rete vede in aggregato finisce dentro la simplex e il distacco converge da sé, senza bisogno di nessun ammorbidimento. Quel gradiente, poi, è limitato in modulo da 1, e su distacchi già enormi le correzioni disponibili diventano minuscole rispetto al distacco: è così che Szegedy e colleghi leggono la perdita di adattabilità di un modello troppo sicuro. Il weight decay mette un prezzo sulla crescita dei pesi; il label smoothing toglie invece la ragione di crescere.
Il rimedio è cambiare il bersaglio: invece di pretendere tutta la massa sulla classe giusta, se ne cede una frazione fissa a tutte le altre.
Basta una riga del regolamento. Al posto di «dieci sul gatto», il bersaglio diventa: nove gettoni sul gatto, e il decimo spartito in parti uguali fra tutte e cinque le risposte, gatto compreso. Fa nove gettoni e due decimi al gatto, due decimi a ciascuna delle altre quattro.
Sembra uno sconto e invece è una richiesta in più. La vecchia, «metti i gettoni sul gatto», adesso pesa nove decimi; e accanto ne compare una nuova, «non lasciare nessuna risposta completamente a secco», che pesa il decimo restante e tira nella direzione opposta. Il lavoro lo fa quel tiro contrario.
Adesso il traguardo esiste, e si può calcolare prima di cominciare. Al gatto tocca prendersi nove gettoni e due decimi contro i due decimi di ciascun altro, cioè quarantasei volte tanto. E la regola dei gettoni è fatta così: alzare di uno il numero scritto accanto a una risposta le moltiplica la fetta, rispetto a ciascuna delle altre, sempre per lo stesso fattore, \(2{,}7\) circa. Per moltiplicarla per quarantasei ci vogliono quindi poco meno di quattro punti di distacco, cioè di differenza fra il numero del gatto e quello degli altri; il valore esatto è \(3{,}83\). Arrivati lì si smette di alzare, perché alzare ancora abbasserebbe il voto invece di alzarlo: il gioco ha un punto in cui si vince, e ci si può arrivare.
Il prezzo si legge nella stessa riga che ha portato il guadagno. Quel decimo di gettone si spartisce in parti uguali: alla lince tanto quanto al camion. Ma la lince era quasi giusta e il camion era assurdo, e il bersaglio nuovo cancella quel «quasi». Finché si tratta di indovinare l’animale non manca niente. Comincia a mancare quando qualcuno impara dai fogli di un compagno più bravo e non dal foglio delle soluzioni: è la distillazione, quella del maestro che scrive «7, ma per un soffio», e lì il «quasi» era proprio la cosa che si voleva passare.
E il guadagno non è garantito. Con il regolamento nuovo la classe qualche volta prende voti migliori e qualche volta no, e nessuno sa dire quando: il bersaglio morbido si adotta perché raramente fa danno, più che perché si sappia quando aiuti.
Szegedy e colleghi [SVI+16], lavorando su Inception-v2, sostituiscono il bersaglio con una miscela fra \(q\) e una distribuzione fissa \(u\), indipendente dall’esempio, governata da un parametro \(\epsilon\):
dove \(\epsilon\) è la frazione di massa ceduta (\(0{,}1\) nell’articolo, con \(K =
1000\)) e \(u\) è l’uniforme su tutte le \(K\) classi, quella vera compresa.
Attenzione alla lettera: questo \(\epsilon\) vale un decimo ed è una frazione di
probabilità, mentre l’\(\epsilon\) della batch normalization e quello degli
ottimizzatori adattivi sono numeri minuscoli che evitano una divisione per
zero. In PyTorch i primi due si chiamano eps, il terzo label_smoothing; la
lettera \(\epsilon\) resta perché è quella dell’articolo di Szegedy e colleghi,
con cui il parametro si cerca in letteratura. Il bersaglio sulla classe
corretta è quindi \(1-\epsilon+\epsilon/K\), e non \(1-\epsilon\): la differenza è
piccola ma le due convenzioni circolano entrambe.
L’entropia incrociata contro il nuovo bersaglio si spezza in due termini:
cioè la loss di prima più una penalità che misura quanto \(p\) si allontani dall’uniforme, con peso relativo \(\epsilon/(1-\epsilon)\). E siccome \(H(u,p) = D_{\mathrm{KL}}(u \,\|\, p) + H(u)\) con \(H(u)\) costante, quella penalità è una divergenza di Kullback-Leibler a meno di un termine che dei parametri non dipende.
Il guadagno è che l’ottimo diventa raggiungibile. Minimizzando \(H(q', p)\) rispetto a \(p\) su tutte le distribuzioni (il vincolo \(\sum_k p(k) = 1\) serve: senza, l’entropia incrociata non ha minimo) si trova \(p^\star = q'\) per la disuguaglianza di Gibbs, quindi un distacco fra logit finito e calcolabile in anticipo:
Con \(K = 5\) e \(\epsilon = 0{,}1\) fa \(\log 46 \approx 3{,}83\); con \(K = 1000\) e lo stesso \(\epsilon\), \(\log 9001 \approx 9{,}10\). C’è un punto in cui il modello si ferma. Il conto vale per un esempio con i logit liberi. In una rete i logit li producono parametri condivisi fra tutti gli esempi, e quello che Müller e colleghi osservano è come la rete ci si avvicina: le rappresentazioni del penultimo strato si raccolgono in gruppi compatti, uno per classe, ciascuno vicino al vettore di pesi della propria classe nell’ultimo strato e alla stessa distanza da quelli delle altre.
Il punto di rottura sta nella scelta di \(u\) uniforme, che dichiara tutte le classi sbagliate sbagliate allo stesso modo. Müller, Kornblith e Hinton [MullerKH19] misurano due effetti, e li tengono separati. Il primo: le rappresentazioni del penultimo strato si stringono in gruppi compatti per classe, e da quel collasso sparisce dai logit l’informazione su quanto una classe somigli a un’altra; una rete così addestrata fa quindi da cattiva maestra nella distillazione, dove quello che passa all’allievo è la graduatoria intera e non la sola risposta giusta (il loro esperimento è sulle immagini: per la traduzione dichiarano di non sapere quale delle due scelte convenga). Il secondo effetto va nella direzione opposta: le probabilità dichiarate si avvicinano alle frequenze con cui il modello ci prende davvero. Gli autori lo presentano come sorprendente proprio alla luce del collasso, e non come una sua conseguenza.
E l’uniforme non è obbligatoria: l’articolo di Szegedy propone come \(u\) la distribuzione a priori delle classi, e ripiega sull’uniforme solo negli esperimenti. Chi ha capito il punto di rottura ha già in mano la direzione in cui ripararlo.
In PyTorch è un argomento della loss, nn.CrossEntropyLoss(label_smoothing=0.1),
e la convenzione implementata è quella di Szegedy, con \(\epsilon\) spartito su
tutte le \(K\) classi.
Una riserva sull’insieme, che i due articoli scrivono e vale ripetere. Il guadagno in accuratezza è piccolo e non costante: su alcuni compiti Müller e colleghi non ne misurano affatto, e resta un accorgimento che si adotta perché raramente danneggia, più che perché si sappia quando aiuti. Il titolo del loro articolo è una domanda, e nell’abstract il verdetto è che il label smoothing «è ancora poco capito». Il conto sul distacco fra logit spiega perché l’addestramento smetta di correre, non perché la rete generalizzi meglio: sono due domande diverse, e la seconda resta aperta come quella sulla batch normalization.
Quel distacco si può guardare crescere. Bastano cinque punteggi grezzi liberi, senza nessuna rete attorno, corretti un poco per volta verso i due bersagli, quello netto e quello morbido. La correzione è il gradiente della loss rispetto ai punteggi, la probabilità che esce meno quella che si voleva, \(p - q\).
import math

import numpy as np

K, eps, passo = 5, 0.1, 0.5

netto = np.zeros(K)
netto[0] = 1.0                   # gatto sì, tutto il resto no
morbido = np.full(K, eps / K)
morbido[0] += 1 - eps            # nove e due decimi al gatto, due decimi agli altri

def softmax(z):
    e = np.exp(z - z.max())
    return e / e.sum()

def scendi(q, tappe):
    """Discesa del gradiente sui soli punteggi grezzi: la correzione vale p - q."""
    z = np.zeros(K)
    for t in range(1, max(tappe) + 1):
        z -= passo * (softmax(z) - q)
        if t in tappe:
            p = softmax(z)
            yield t, z[0] - z[1], p[0]

tappe = (10**3, 10**4, 10**5)
for (t, dn, pn), (_, dm, pm) in zip(scendi(netto, tappe), scendi(morbido, tappe)):
    print(f"{t:>6} passi | netto: distacco {dn:5.2f}, al gatto il {pn:8.4%}"
          f" | morbido: distacco {dm:4.2f}, al gatto il {pm:.4%}")

print("distacco previsto per il morbido:",
      round(math.log((K * (1 - eps) + eps) / eps), 2))
  1000 passi | netto: distacco  7.82, al gatto il 99.8388% | morbido: distacco 3.83, al gatto il 92.0000%
 10000 passi | netto: distacco 10.13, al gatto il 99.9840% | morbido: distacco 3.83, al gatto il 92.0000%
100000 passi | netto: distacco 12.43, al gatto il 99.9984% | morbido: distacco 3.83, al gatto il 92.0000%
distacco previsto per il morbido: 3.83
Con il bersaglio netto il distacco fa \(7{,}82\), poi \(10{,}13\), poi \(12{,}43\): ogni volta che i passi si moltiplicano per dieci ne guadagna circa \(2{,}3\), e non accenna a fermarsi: per aggiungerne altri due e tre decimi servono dieci volte i passi fatti finora, sempre, per quanto lontano si sia arrivati. Con quello morbido si posa su \(3{,}83\) già alla prima misura e ci resta: è \(\log 46\), il logaritmo del rapporto fra la probabilità che il bersaglio morbido chiede per la classe vera, \(0{,}92\), e quella che chiede per ciascuna delle altre, \(0{,}02\); e la percentuale stampata, \(92{,}0000\%\), è proprio quel \(0{,}92\). La differenza fra i due comportamenti non sta nella risposta scelta, che è la stessa: sta nei numeri che la rete dichiara accanto alla risposta, e nel fatto che uno dei due addestramenti sa quando ha finito.
Scendere bene: gli optimizer moderni#
Tutti questi accorgimenti stabilizzano il gradiente; resta da decidere come muoversi una volta che lo si è ricevuto.
Per ogni possibile scelta dei pesi si può disegnare quanto la rete sbaglia con quei pesi: ne viene fuori un paesaggio, con alture dove sbaglia molto e conche dove sbaglia poco. Addestrare vuol dire camminare in quel paesaggio cercando il fondo di una conca, e il gradiente è la pendenza sotto i piedi: punta in salita, e si scende nel verso opposto. È il panorama della loss, e la rete ci si muove al buio: della pendenza nel punto in cui si trova sa tutto, del resto del paesaggio niente.
Gli algoritmi che decidono come fare il passo si chiamano ottimizzatori, o optimizer. La discesa del gradiente pura fa un passo proporzionale alla pendenza e basta, e in una valle stretta e allungata la pendenza più forte punta verso la parete di fronte: chi la segue attraversa, risale dall’altra parte, e lungo il fondovalle avanza pochissimo. Il rimedio, un po’ di inerzia, si chiama momentum (Fig. 10.11).

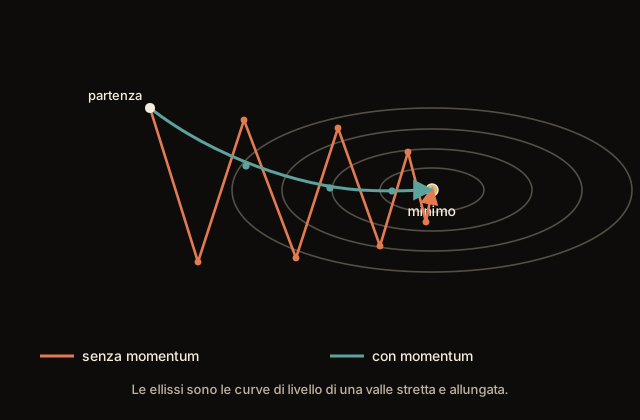
Fig. 10.11 In una valle stretta la discesa del gradiente senza momentum (terracotta) oscilla tra le pareti ripide. Il momentum (teal) accumula velocità lungo la direzione utile e smorza le oscillazioni, arrivando più dritto al minimo.#
Il momentum è una pallina che rotola in una valle: accumula velocità nella direzione giusta e si lascia dietro i rimbalzi laterali. Un’altra famiglia di ottimizzatori cambia invece la lunghezza del passo, e la cambia per ciascun numero della rete. Il primo è Adagrad: dà a ogni parametro (i pesi, più i bias: tutti i numeri che la rete regola) un passo su misura, più corto dove il terreno è ripido e più lungo dove è piatto. Per farlo tiene il conto di tutta la strada già percorsa, parametro per parametro: quelli corretti di continuo rallentano, quelli toccati di rado conservano passi generosi.
Toccati di rado capita più spesso di quanto sembri. Quando una rete lavora su un testo, per esempio, ogni parola del vocabolario viene trasformata in una fila di numeri, e quei numeri sono parametri come gli altri: la rete li aggiusta solo quando quella parola compare. Se compare in una pagina su mille, riceve una correzione una volta su mille, ed è ragionevole che quando arriva sia grande. Il difetto di Adagrad è che quel conto non si azzera mai: passo dopo passo la falcata si accorcia, finché la discesa semplicemente si ferma. RMSProp rimedia guardando solo al passato recente invece che all’intera storia, così il passo non muore mai del tutto. Adam mette insieme le due strade, il passo su misura di RMSProp e l’inerzia del momentum, e per questo è oggi la scelta predefinita in gran parte delle reti.
Con momentum si accumula una media mobile dei gradienti \(\mathbf{g}_t\) (che sono vettori, una componente per parametro, e come tali vanno in grassetto; \(\theta\) resta tondo, come tutte le greche dei parametri):
con \(\eta\) il learning rate, cioè la lunghezza del passo, e tipicamente \(\beta = 0{,}9\).[1] Adagrad [DHS11] normalizza per la scala di ciascun parametro sommando i quadrati di tutti i gradienti visti finora:
dove le operazioni sono elemento per elemento: ogni parametro riceve un learning rate effettivo \(\eta/(\sqrt{\mathbf{s}_t}+\epsilon)\) tutto suo. La normalizzazione premia le feature sparse (i parametri aggiornati di rado conservano passi ampi) ma \(\mathbf{s}_t\) cresce monotonicamente, quindi il passo effettivo tende a zero e prima o poi l’addestramento si arena. RMSProp [TH12] rimedia sostituendo la somma con una media mobile esponenziale, che dimentica il passato remoto:
dove \(\rho \in (0,1)\) è il coefficiente della media mobile: quanto più è
vicino a uno, tanto più lungo è il passato che \(\mathbf{s}_t\) tiene in conto,
e tanto più lentamente il passo si riadatta. La formulazione originale usa
\(0{,}9\); torch.optim.RMSprop chiama questo coefficiente alpha e lo lascia
a \(0{,}99\).
Sulla stessa idea, Adadelta [Zei12] accumula una media mobile anche degli aggiornamenti, eliminando di fatto la scelta di \(\eta\). Adam unisce momentum e passo adattivo con due medie mobili elemento per elemento,
che partono da \(\mathbf{v}_0 = \mathbf{s}_0 = \mathbf{0}\), e quella partenza le tira verso il basso. Svolgendo la ricorrenza, \(\mathbf{s}_t = (1-\beta_2)\sum_{\tau=1}^{t}\beta_2^{\,t-\tau}\,\mathbf{g}_\tau\odot\mathbf{g}_\tau\), e se i gradienti hanno momento secondo costante si ottiene \(\mathbb{E}[\mathbf{s}_t] = (1-\beta_2^{\,t})\,\mathbb{E}[\mathbf{g}\odot\mathbf{g}]\), e lo stesso per \(\mathbf{v}_t\) con \(\beta_1\). Da qui la correzione del bias, \(\hat{\mathbf{v}}_t = \mathbf{v}_t/(1-\beta_1^t)\) e \(\hat{\mathbf{s}}_t = \mathbf{s}_t/(1-\beta_2^t)\), che conta per centinaia di passi: senza, con i default e un gradiente costante, il rapporto \(\mathbf{v}_t/\sqrt{\mathbf{s}_t}\) vale \((1-\beta_1^t)/\sqrt{1-\beta_2^t}\) volte il segno del gradiente, cioè \(0{,}1/\sqrt{0{,}001} \approx 3{,}16\) al primo passo, circa \(6{,}6\) attorno al dodicesimo e ancora \(1{,}26\) al millesimo: passi più lunghi del dovuto proprio quando le stime sono peggiori, e per tutto il tempo che serve a \(\beta_2\). L’aggiornamento è:
I default \(\beta_1=0{,}9\), \(\beta_2=0{,}999\), \(\epsilon=10^{-8}\) funzionano in un’enorme varietà di casi.[2]
C’è un punto in cui gli ottimizzatori incontrano la lotta contro l’overfitting:
il parametro weight_decay di torch.optim, che serve a tenere i pesi
piccoli. L’idea è che una rete costretta a lavorare con numeri modesti non può
affidarsi a pochi valori enormi per imparare a memoria. Il nome però promette
una cosa e il codice ne fa un’altra: un equivoco da cui nasce lo stesso AdamW.
Tenere piccoli i pesi si può fare in due modi, che sembrano lo stesso e non lo sono. Il primo è aggiungere al conto dell’errore una multa proporzionale a quanto i pesi sono grandi: la rete, cercando di pagare meno multa, li tiene bassi da sé. Il secondo è più diretto: a ogni passo si accorciano un pochino tutti i pesi, e basta.
Con la discesa più spoglia che ci sia, quella senza inerzia, i due modi finiscono per fare la stessa cosa. Basta però aggiungere l’inerzia (il momentum, la pallina che rotola) e non è più vero: la multa entra nella spinta accumulata e continua a farsi sentire nei passi successivi, invece di esaurirsi in quello in cui è stata data. E l’inerzia c’è quasi sempre.
La differenza si vede con un peso solo. Prendi un peso che vale \(1\), mettilo in un punto dove il terreno è perfettamente piatto (così l’unica cosa che lo muove è la multa) e fagli fare quaranta passi, con una multa che ogni volta gli toglie mezzo centesimo. Senza inerzia i due modi lo lasciano tutti e due dove lo lascia il conto a mano, \(0{,}995\) moltiplicato per sé stesso quaranta volte: \(0{,}818\), identici come promesso. Con l’inerzia il secondo modo resta a \(0{,}818\), perché l’accorciamento non passa dalla pallina. Il primo, invece, porta il peso a \(0{,}061\), tredici volte più in basso: ogni multa entra nella spinta, la spinta se la porta dietro, e i passi successivi tolgono ciascuno più del loro mezzo centesimo. Nessuno ha cambiato l’importo della multa: è cambiato solo che adesso si accumula.
Con Adam la differenza è di un altro tipo ancora, perché Adam ridimensiona ogni correzione in base a quanto quel peso è stato corretto di recente, e insieme alla correzione ridimensiona anche la multa. Risultato: la multa arriva forte su certi pesi e debole su altri, e non perché qualcuno l’abbia deciso. AdamW tiene le due cose separate, accorcia i pesi per conto suo senza passare dal ridimensionamento di Adam, ed è per questo che è diventato la scelta abituale.
Il parametro weight_decay di torch.optim (in SGD come in Adam) non
implementa il decadimento dei pesi: somma al gradiente il termine
\(\lambda\theta\), cioè la regolarizzazione L2 (una penalità nella loss
proporzionale al quadrato dei pesi). A gradiente nullo l’aggiornamento diventa
\(\theta \leftarrow \theta(1-\eta\lambda)\): il peso si accorcia, ma la
sforbiciata passa dal learning rate.
Questa forma coincide con il decadimento vero solo nel caso più spoglio, la discesa senza momentum. Basta accendere il momentum e le due divergono, perché il termine \(\lambda\theta\) entra nel buffer della velocità e si accumula come farebbe un gradiente qualunque: la penalità non agisce più una volta per passo, ma con la coda di tutti i passi precedenti.
Il conto si fa con un parametro solo che parte da \(\theta_0 = 1\) e gradiente identicamente nullo, così a muovere il peso resta la sola penalità: \(\eta = 0{,}1\), \(\lambda = 0{,}05\), quaranta passi.
import torch

def dopo_40_passi(momentum, weight_decay=0.0, a_mano=False):
    p = torch.nn.Parameter(torch.tensor([1.0]))
    opt = torch.optim.SGD([p], lr=0.1, momentum=momentum, weight_decay=weight_decay)
    for _ in range(40):
        opt.zero_grad(); p.grad = torch.zeros_like(p)   # gradiente nullo
        opt.step()
        if a_mano:                # il decadimento vero, fuori dall'ottimizzatore
            with torch.no_grad(): p.mul_(1 - 0.1 * 0.05)    # 1 - eta*lambda
    return p.item()

print(f"weight_decay, senza momentum: {dopo_40_passi(0.0, weight_decay=0.05):.4f}")
print(f"a mano,       senza momentum: {dopo_40_passi(0.0, a_mano=True):.4f}")
print(f"a mano,       momentum 0,9:   {dopo_40_passi(0.9, a_mano=True):.4f}")
print(f"weight_decay, momentum 0,9:   {dopo_40_passi(0.9, weight_decay=0.05):.4f}")
weight_decay, senza momentum: 0.8183
a mano,       senza momentum: 0.8183
a mano,       momentum 0,9:   0.8183
weight_decay, momentum 0,9:   0.0606
Senza momentum le due strade lasciano lo stesso identico \(0{,}8183\), che è
esattamente \((1-\eta\lambda)^{40}\). Col momentum il decadimento a mano non
cambia di una cifra, mentre weight_decay porta il peso a \(0{,}0606\):
tredici volte e mezzo più piccolo, senza che nessuno abbia toccato
\(\lambda\). È una differenza che conta, perché l’SGD che si usa davvero è quello
con il momentum.
Con i passi adattivi di Adam la questione cambia natura, e non nel senso che il decadimento si indebolisce: il termine \(\lambda\theta\) finisce dentro la normalizzazione, quindi i parametri con gradienti tipicamente grandi vengono regolarizzati meno e quelli con gradienti piccoli di più. Il difetto è la disomogeneità, non la debolezza. AdamW [LH19] lo disaccoppia dall’aggiornamento adattivo, applicandolo direttamente ai pesi.
Su da che cosa lo disaccoppi conviene essere precisi, perché la frase che
gira è più forte del paper. Nell’Algoritmo 2 il decadimento è \(\theta
\leftarrow \theta(1-\eta_t\lambda)\), dove \(\eta_t\) è il moltiplicatore dello
schedule e non il learning rate \(\alpha\): è da \(\alpha\) che il decadimento
viene sganciato, non da ogni fattore esterno. torch.optim.AdamW esegue
param.mul_(1 - lr * weight_decay), cioè lo stesso identico fattore dell’L2 di
SGD. Il conto, con \(\eta=0{,}5\), \(\lambda=0{,}1\) e gradiente nullo:
import torch

for Opt in (torch.optim.SGD, torch.optim.AdamW, torch.optim.Adam):
    p = torch.nn.Parameter(torch.tensor([1.0]))
    opt = Opt([p], lr=0.5, weight_decay=0.1)
    opt.zero_grad(); p.grad = torch.zeros_like(p); opt.step()
    print(f"{Opt.__name__:5s} dopo un passo: {p.item():.2f}")
SGD   dopo un passo: 0.95
AdamW dopo un passo: 0.95
Adam  dopo un passo: 0.50
Un passo porta il peso allo stesso \(0{,}95\) con SGD e con AdamW, e a
\(0{,}50\) con Adam. È quello che AdamW corregge: non la scala del decadimento,
ma il fatto che passi dal ridimensionamento adattivo.
AdamW è oggi la scelta abituale per addestrare i Transformer, la famiglia di
reti di cui parla il capitolo che porta il loro nome, e in PyTorch si usa esattamente come Adam:
optim.AdamW(model.parameters(), lr=1e-3, weight_decay=0.01).
Regolare il passo nel tempo#
Un ultimo dettaglio spesso decisivo: il learning rate \(\eta\), cioè la lunghezza del passo con cui si correggono i pesi, non deve restare costante.

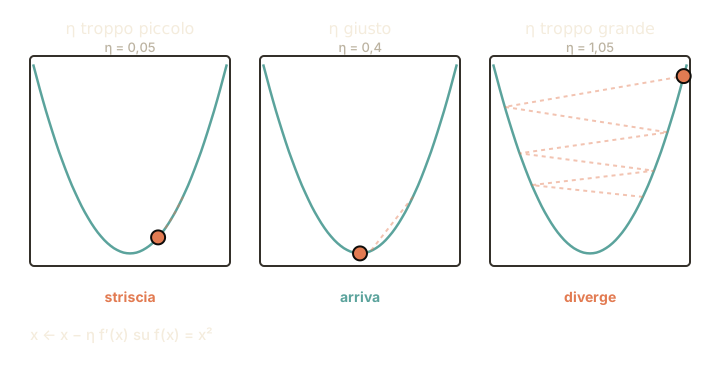
Fig. 10.12 Sei passi di discesa lungo la parabola \(f(x)=x^2\), sempre a partire dallo stesso punto, con tre lunghezze di passo diverse. Nelle scritte, la lettera greca \(\eta\) («eta») è la lunghezza del passo e \(f'(x)\) è la pendenza del terreno nel punto in cui ci si trova. Il passo governa tutto: troppo corto e non si arriva, troppo lungo e si scappa.#
Il terzo pannello non è una licenza grafica: dietro c’è un conto esatto, e sta in una riga. Sulla parabola del disegno, \(f(x) = x^2\), la pendenza nel punto \(x\) vale \(2x\), il doppio della distanza dal minimo. Il passo toglie a \(x\) la pendenza moltiplicata per \(\eta\), cioè \(2\eta x\), e quello che resta è \(x(1-2\eta)\): ogni passo moltiplica la distanza dal minimo per \(1-2\eta\). Con \(\eta = 0{,}4\) quel fattore vale \(0{,}2\): a ogni passo la distanza si riduce a un quinto, e in sei passi non resta quasi niente. Con \(\eta = 1{,}05\) vale \(-1{,}1\), e il segno meno dice solo che si finisce dall’altra parte del minimo; quello che conta è che in valore assoluto sia maggiore di uno, perché vuol dire che a ogni passo si atterra più lontano di dove si era partiti. Oltre una certa lunghezza il passo non rallenta la discesa, la fa scappare.
Quella lunghezza dipende da quanto la conca è ripida e stretta, e le conche non sono tutte uguali. Camminando, la rete passa da un tratto di paesaggio a un altro, e il passo tarato sul primo è quello sbagliato sul secondo, e non perché il paesaggio si muova: se ne sta attraversando un pezzo nuovo.
All’inizio conviene un passo grande: la rete è lontana da qualunque soluzione decente e serve coprire strada. Alla fine conviene piccolo, perché la direzione che la rete segue a ogni passo è calcolata su un gruppetto di esempi e non su tutti, e quindi trema un poco. Con passi lunghi quel tremito la porta a scavalcare il punto in cui voleva fermarsi, una volta di qua e una di là, come chi infila la chiave nella toppa con la mano che trema e la muove dieci centimetri per volta; accorciando i movimenti, il tremito conta sempre meno.
La ricetta che regola il passo mentre l’addestramento procede si chiama schedule (è l’inglese per «programma»). Ce ne sono diverse e si assomigliano tutte: ridurre il passo un po’ a ogni passata sui dati, dimezzarlo a scalini ogni tot, oppure farlo scendere lungo una curva morbida che parte quasi piatta, cala in fretta a metà strada e si riappiattisce alla fine (quella curva è il coseno, ed è la scelta più comune oggi).
Su \(f(x)=x^2\) l’aggiornamento è \(x \leftarrow x(1-2\eta)\), quindi \(x_k = x_0\,(1-2\eta)^k\): si converge se e solo se \(|1-2\eta| < 1\), cioè \(0 < \eta < 1\). Il terzo pannello usa \(\eta = 1{,}05\): fattore \(-1{,}1\), e ogni passo scavalca il minimo più lontano del precedente. Su una funzione qualunque la soglia dipende dalla curvatura: se il gradiente è \(L\)-lipschitziano, il lemma di discesa garantisce che un passo fisso \(\eta < 2/L\) abbassa la loss a ogni iterazione, e sulla parabola \(L = 2\), quindi \(2/L = 1\) è la soglia appena trovata (la derivazione sta nella sezione sulla discesa del gradiente). Uno schedule insegue questa soglia mentre la curvatura cambia. C’è poi una seconda ragione per ridurre il passo, che con il gradiente esatto non esisterebbe: con gradienti stocastici, calcolati su un mini-batch, a passo costante le iterate non si fermano sul minimo ma continuano a oscillargli attorno, in un intorno la cui ampiezza cresce con \(\eta\). Per questo un passo grande all’inizio esplora in fretta, e verso la fine va accorciato. Le condizioni classiche sono quelle di Robbins e Monro, \(\sum_t\eta_t=\infty\) e \(\sum_t\eta_t^2<\infty\), e il decadimento inverso \(\eta_t = \eta_0/(1+\kappa t)\), dove \(\kappa\) regola quanto in fretta cala, le soddisfa; in pratica si usano anche i gradini e l’andamento a coseno.
In PyTorch gli scheduler vivono accanto all’ottimizzatore e si aggiornano dentro il ciclo di addestramento. Ce n’è un quarto tipo, oltre ai tre appena elencati: invece di seguire una curva decisa in partenza, tiene d’occhio l’errore su un gruppo di esempi messi da parte apposta (la validazione, che serve a misurare la rete su dati che non ha usato per imparare) e dimezza il passo quando quell’errore smette di scendere.
from torch import nn, optim

criterion = nn.CrossEntropyLoss()
optimizer = optim.Adam(model.parameters(), lr=1e-3)   # passo iniziale

# dimezza il learning rate quando la loss di validazione smette di scendere
scheduler = optim.lr_scheduler.ReduceLROnPlateau(optimizer,
                                                 factor=0.5, patience=3)

for epoca in range(50):        # un'«epoca» è una passata su tutti i dati
    addestra_una_epoca(model, train_loader, criterion, optimizer)
    loss_val = valuta(model, val_loader, criterion)   # loss di validazione
    scheduler.step(loss_val)                          # decide se ridurre il passo
C’è però un pezzo dello schedule che non sta alla fine ma all’inizio, e che si incontra in ogni ricetta di addestramento moderna: il warmup. Invece di partire subito da \(\eta_0\), si sale da (quasi) zero fino a \(\eta_0\) nell’arco delle prime centinaia o migliaia di passi, e solo dopo comincia il decadimento.
Sembra un capriccio, e ha una ragione precisa. Gli ottimizzatori moderni non usano il gradiente grezzo: lo confrontano con una media di quelli visti finora, per capire quanto quel gradiente sia affidabile e quanto grande fare il passo. All’inizio quella media è fatta di due o tre numeri, quindi è rumorosa, e la stima può risultare sballata di parecchio.
Il guaio è che i primi passi sono anche i più pericolosi: la rete è ancora disordinata, e un passo troppo lungo in una direzione sbagliata può portarla in una regione da cui non si riprende: i neuroni finiti tutti nel tratto piatto della propria curva, dove non reagiscono più a niente, oppure i pesi diventati enormi. Partire piano è un modo di non prendere decisioni importanti mentre si è ignoranti: si fanno passetti finché le statistiche non si assestano, e poi si va.
Una ragione sola però non basta a spiegarlo. Il warmup fa bene anche a chi il passo su misura non ce l’ha, cioè alla pallina che si limita a rotolare con la sua inerzia: lì di stime da aspettare non ce n’è nessuna, e il vantaggio si vede lo stesso. Che cosa esattamente ripari è ancora in discussione, mentre che convenga farlo non lo discute nessuno.
Adam normalizza il gradiente per la radice della stima del secondo momento, \(\hat{\mathbf{s}}_t\) nella notazione adottata per gli ottimizzatori (Kingma e Ba, e con loro buona parte della letteratura, chiamano \(\mathbf{m}_t\) il primo momento e \(\mathbf{v}_t\) il secondo). Nei primi passi quella stima è calcolata su pochissimi campioni ed è ad alta varianza, quindi il rapporto \(\hat{\mathbf{v}}_t/\sqrt{\hat{\mathbf{s}}_t}\) può assumere valori molto più grandi del previsto: il passo effettivo è enormemente più variabile di \(\eta\). La correzione del bias di Adam sistema la media ma non la varianza della stima: è la diagnosi proposta da Liu e colleghi [LJH+20], che leggono il warmup come un riduttore di varianza nella fase iniziale. Non è l’ultima parola. Ma e Yarats [MY21] la contestano e riconducono il fenomeno alla dimensione del passo, e il fatto che il warmup serva anche a SGD con momentum, che di stime adattive non ne ha, dice che di una spiegazione sola non si tratta.
Si somma a due fattori che agiscono nella stessa direzione. Con batch grandi il learning rate viene scalato verso l’alto (la regola lineare di [GDollarG+17]), e quel valore alto è proprio ciò che all’inizio si vuole evitare. E nei Transformer post-LN la norma è dopo il blocco residuo, il che produce gradienti molto grandi negli strati alti a inizio addestramento [XYH+20]; è il motivo per cui la ricetta originale prevedeva warmup obbligatorio, e per cui l’adozione del pre-LN lo ha reso meno critico ma non inutile.
La forma standard è lineare crescente per \(T_w\) passi e poi coseno decrescente:
dove \(t\) è il passo di addestramento, \(T\) il numero totale di passi previsti, \(T_w\) la durata del warmup, \(\eta_0\) il learning rate di picco (quello che si tocca esattamente alla fine del warmup) ed \(\eta_{\min}\) il valore su cui il coseno si appoggia a fine corsa, spesso zero. Le due righe si saldano senza scalini: in \(t = T_w\) la prima dà \(\eta_0\) e la seconda pure, perché \(\cos 0 = 1\); in \(t = T\) resta \(\eta_{\min}\), perché \(\cos \pi = -1\). Ed è quella che si trova, con nomi diversi, in quasi ogni configurazione di addestramento su larga scala.
Quando la generalizzazione arriva tardi: il grokking#
Il weight decay è comparso fin qui come un freno: tiene piccoli i pesi, e la rete impara un po’ meno a memoria. C’è però un regime in cui fa una cosa più interessante, e per vederla bisogna ignorare la regola che consiglia di fermarsi quando la validazione smette di migliorare.
Power e colleghi [PBE+22] addestrano reti piccole su compiti di aritmetica modulare, cioè somme fatte a orologio su un numero primo di ore. L’errore di addestramento va a zero presto, come previsto: la rete ha memorizzato le somme che le hanno mostrato. Quello che succede dopo è che, per moltissimi passi, l’accuratezza sulle somme mai viste resta a livello di sorteggio. Poi, molto oltre il punto in cui chiunque avrebbe spento l’addestramento, sale di colpo fino a sbagliare quasi niente. Il fenomeno ha preso il nome di grokking, da to grok, il verbo che Robert Heinlein inventò nel 1961 per un romanzo di fantascienza e che vuol dire capire una cosa fino in fondo, d’intuito. La spiegazione meccanica è arrivata dopo [NCL+23].
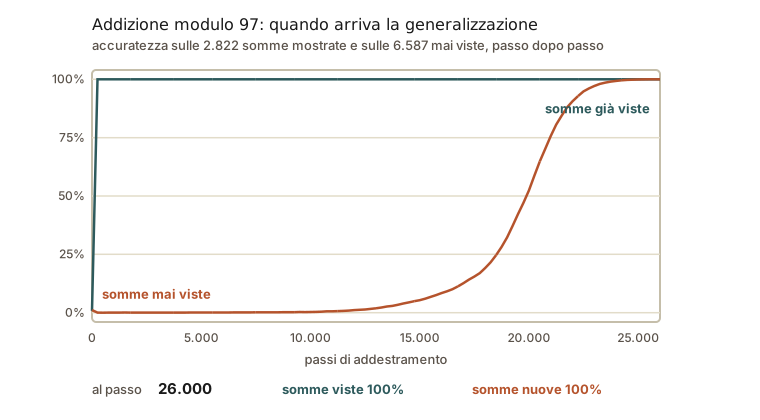
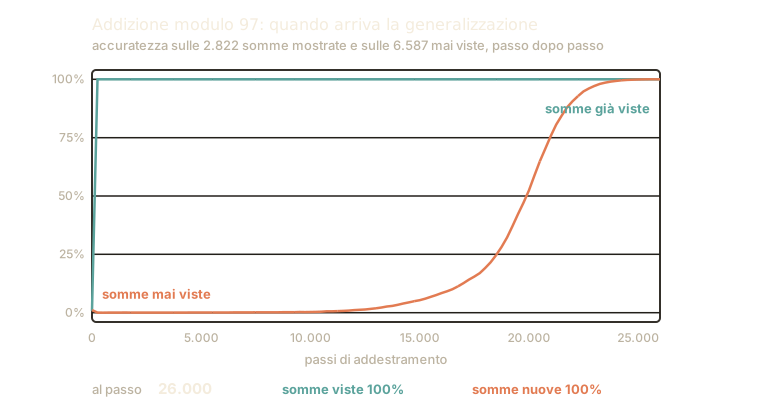
Fig. 10.13 Ventiseimila passi di addestramento su una rete piccola, che deve sommare numeri su un orologio a novantasette ore. Le somme che le hanno mostrato le sa tutte dopo poche centinaia di passi; su quelle che non ha mai visto sta sotto il tiro a indovinare per quasi dodicimila passi, e solo allora comincia a salire. Chi avesse spento l’addestramento a metà avrebbe concluso che non c’era altro da imparare.#
Il tratto piatto di Fig. 10.13 è la parte che sorprende, ed è anche la sola parte in cui le due curve, guardate da fuori, non dicono niente di quello che sta succedendo dentro.
Immagina qualcuno a cui si chiede di sommare le ore su un orologio strano, che invece di dodici ore ne ha novantasette. Gli si mostrano un po” di somme già fatte, e lui deve imparare a rispondere anche su quelle che non ha visto.
Comincia nel modo più naturale: si scrive un bigliettino con le risposte che gli hanno mostrato. Funziona benissimo su quelle e non serve a niente su tutte le altre, ed è esattamente quello che si vede da fuori, con le domande già viste tutte giuste e le altre quasi tutte sbagliate.
Intanto, però, sotto sotto sta cominciando a vedere il quadrante: che sommare su quell’orologio vuol dire far girare la lancetta, e che dove si ferma non dipende da quanti giri ha fatto. Non se ne accorge nessuno, perché finché il bigliettino c’è è il bigliettino a rispondere, e le risposte da fuori sono le stesse. Chi potesse guardargli in testa vedrebbe il quadrante farsi nitido un pezzo alla volta, senza nessun salto.
Un quadrante solo, però, non gli basterebbe. Due risposte vicine ci finiscono quasi nello stesso punto, e a occhio non le distingue. Gliene servono alcuni, con lancette che girano a velocità diverse: una che fa un giro mentre le ore vanno da zero a novantasei, una che ne fa due, una che ne fa tre. Due risposte che sul primo quadrante cadono vicine, sul secondo o sul terzo cadono lontane.
E qui entra la multa. La regola in vigore dice che ogni appunto tenuto costa, e costa in proporzione a quanto è ingombrante. Il bigliettino è enorme, migliaia di righe una per somma; la regola sta in una frase. Finché la regola era incompleta il bigliettino serviva e la multa si pagava; appena la regola regge da sola, tenerlo diventa una spesa senza ritorno, e lui lo butta.
Da fuori quello è il momento in cui «di colpo ha capito». In realtà aveva già capito da un pezzo, e quello che è successo di colpo è la buttata via del bigliettino. E si vede che cosa affretta l’intero episodio: se tenere appunti costa, prima o poi il bigliettino conviene buttarlo; se è gratis può restare lì molto più a lungo, e il quadrante ci mette molto di più a venire allo scoperto. La multa non è indispensabile (la curva più famosa di questo fenomeno è stata ottenuta senza, lasciando correre l’addestramento per un milione di passi), ma è la cosa che anticipa di più il momento.
Da qui la cosa che conta per chi addestra. Mandarlo a casa il giorno in cui il bigliettino era completo, perché tanto da fuori non migliorava più, sarebbe stato il momento peggiore possibile per farlo. Con l’avvertenza che regge tutto il resto: l’orologio a novantasette ore è un esercizio costruito apposta, con una regola esatta là sotto da trovare, e non tutti i problemi ne hanno una.
L’addestramento si divide in tre fasi, e la seconda è invisibile da fuori perché non sposta nessuna delle due curve. La memorizzazione porta la loss di addestramento a zero con un circuito che mappa le coppie viste sulle loro risposte. La formazione del circuito costruisce, in parallelo e gradualmente, un meccanismo che generalizza: sui compiti di addizione modulare la rete calcola una trasformata di Fourier discreta e usa le identità trigonometriche per trasformare la somma in una rotazione sul cerchio. La pulizia rimuove le componenti memorizzanti, e nel loro impianto è il weight decay a guidarla, perché il circuito completo risolve il compito con una norma dei pesi più bassa di quella del circuito che memorizza.
Ne segue la conclusione del lavoro di Nanda e colleghi: la transizione che si osserva coincide con la sparizione del circuito che memorizza, mentre quello che generalizza era già lì da tempo, e cresceva. Sotto una curva che salta esistono misure di progresso continue, ricavate aprendo il modello, che salgono regolarmente per tutta la fase invisibile.
Per chi addestra la conseguenza pratica è precisa, e va presa con la sua portata. L’arresto anticipato decide quando fermarsi guardando una curva di validazione, quindi in questo regime deciderebbe di fermarsi esattamente durante la fase in cui il meccanismo si sta formando, cioè nel punto peggiore possibile. Questo non manda in pensione l’arresto anticipato, che resta la scelta giusta quasi ovunque: dice che la sua ipotesi implicita, cioè che una validazione ferma significhi che non c’è altro da imparare, è un’ipotesi e non un teorema. Vale anche l’avvertenza sul perimetro: il fenomeno è documentato soprattutto su dataset algoritmici piccoli e generati a tavolino, dove il compito ha una struttura esatta da scoprire. Su dati veri è stato indotto, non osservato per caso: Liu, Michaud e Tegmark lo ottengono su immagini (MNIST), recensioni di film e molecole riducendo il campione e ingrandendo la scala dei pesi iniziali, lo trovano meno marcato che sui compiti algoritmici, e lo attribuiscono a un disaccordo fra il paesaggio della loss di addestramento e quello di prova in funzione della norma dei pesi [LMT23].
Di quel che succede a curve ferme si può controllare a mano il pezzo aritmetico, cioè che una manciata di frequenze basti a scrivere la tavola dell’addizione modulare. Una frequenza \(k\) è un quadrante su cui la lancetta fa \(k\) giri mentre le ore vanno da zero a \(p - 1\), con \(p = 97\) il numero di ore. Per ogni coppia di addendi \(a, b\) e ogni risposta possibile \(c\), il conto guarda su ciascun quadrante quanto la lancetta di \(a + b\) cade vicino a quella di \(c\): il coseno di quell’angolo vale \(1\) quando le due coincidono e scende quando si allontanano. Sommando i quadranti si ottiene il punteggio \(s(c) = \sum_k \cos\!\big(2\pi k (a+b-c)/p\big)\), e il conto guarda due cose: se il punteggio più alto cade sulla risposta giusta per tutte le coppie, e di quanto stacca la seconda.
import numpy as np

p = 97                       # le somme si fanno a orologio, su 97 ore
tavola = np.arange(p)[:, None] + np.arange(p)[None, :]      # a + b
vero = tavola % p

coppie = p * p
viste = int(0.3 * coppie)    # se ne mostra il 30% e si chiede il resto
print(f"coppie in tutto: {coppie}, viste: {viste}, mai viste: {coppie - viste}")
print(f"tirando a caso si indovina una volta su {p}: {100 / p:.2f}%")

def punteggi(frequenze):
    "s(c) = somma su k di cos(2 pi k (a + b - c) / p)"
    diff = (tavola[:, :, None] - np.arange(p)[None, None, :]) % p
    return sum(np.cos(2 * np.pi * k * diff / p) for k in frequenze)

for frequenze in ([1], [1, 2, 3, 4, 5]):
    s = punteggi(frequenze)
    ordinati = np.sort(s, axis=2)
    print(f"frequenze usate: {len(frequenze)}  ->  "
          f"{(s.argmax(axis=2) == vero).sum()}/{coppie} somme esatte, "
          f"margine minimo {(ordinati[..., -1] - ordinati[..., -2]).min():.4f}")
coppie in tutto: 9409, viste: 2822, mai viste: 6587
tirando a caso si indovina una volta su 97: 1.03%
frequenze usate: 1  ->  9409/9409 somme esatte, margine minimo 0.0021
frequenze usate: 5  ->  9409/9409 somme esatte, margine minimo 0.1147
Le \(6587\) coppie mai viste sono la misura di che cosa vuol dire generalizzare qui: una tabella delle sole coppie viste, per quanto completa, su quelle risponde all’\(1{,}03\%\), cioè come un dado a novantasette facce. E il margine dice perché una frequenza sola non basterebbe. Una sola frequenza fa già tutte e \(9409\) le somme giuste, ma stacca la risposta sbagliata più vicina di \(0{,}0021\): un margine che qualunque rumore si mangia. Con cinque il margine sale a \(0{,}1147\), più di cinquanta volte tanto, e il meccanismo diventa qualcosa su cui si può contare. Non dice però che cinque bastino: il margine continua a salire aggiungendone ancora.
Rimesse in fila, le tecniche tornano ai loro mestieri. L’inizializzazione, la scelta dell’attivazione e la batch normalization fanno arrivare un gradiente utilizzabile fino ai primi strati; gli ottimizzatori e il ritmo del passo decidono come muoversi nel panorama della loss; il dropout, il weight decay e il bersaglio ammorbidito impediscono alla rete di imparare troppo bene quello che ha davanti, e compaiono accanto agli altri perché in pratica si montano nello stesso punto, dentro lo stesso ciclo di addestramento. Il grokking, che tecnica non è, chiude la fila per una ragione: mostra il weight decay al lavoro su una scala di tempi che nessuna delle altre lascia sospettare, e ricorda che le due curve che si guardano per decidere quando fermarsi non dicono tutto quello che la rete sta facendo.
Da ricordare
Il gradiente, il segnale di correzione che torna indietro, si assottiglia o esplode, perché attraversando gli strati viene moltiplicato tante volte: se ogni strato lo riduce di quattro volte, dopo cinque strati ne resta un millesimo.
Partire con i pesi della scala giusta (e non è quella che la libreria mette da sé, che già con pochi strati fa arrivare ai primi un grido mille volte più fioco, e con tanti lo spegne), rimettere in scala i numeri a ogni strato (batch normalization) e spegnere neuroni a caso (dropout) sono i tre accorgimenti che rendono l’addestramento stabile e la rete meno incline a imparare a memoria.
Il foglio delle risposte si può ammorbidire (label smoothing): invece di «tutto al gatto, zero al resto», nove decimi al gatto e il decimo restante spartito in parti uguali fra tutte le risposte (con cinque risposte, il \(92\%\) al gatto e il \(2\%\) a ciascun’altra). Con il bersaglio netto la rete alza i propri numeri per sempre, perché lo zero non lo può scrivere; con quello morbido c’è un punto in cui si ferma. Il prezzo: la briciola è uguale per tutti, e si perde che la lince era quasi giusta e il camion no. Che, su un esempio solo, smetta di alzare i numeri è dimostrato; che la rete impari meglio si misura ogni tanto, e nessuno sa perché.
Adam è il punto di partenza sensato: mette insieme l’inerzia della pallina che rotola e un passo su misura per ogni peso. AdamW se si vogliono anche tenere piccoli i pesi.
La lunghezza del passo non resta la stessa per tutto l’addestramento: prima sale da quasi zero (è il warmup: passetti piccoli finché la rete è ancora disordinata; che convenga non lo discute nessuno, che cosa ripari esattamente sì), poi cala man mano che ci si avvicina, di solito lungo la curva del coseno.
La multa sui pesi grandi sa fare più che tenere i numeri piccoli. Su certi compiti di aritmetica la rete prima impara a memoria, poi trova la regola vera senza che da fuori si veda niente, e alla fine butta via la parte imparata a memoria perché tenerla costa: quello è il momento in cui sembra che «abbia capito di colpo». Succede molto dopo il punto in cui chiunque avrebbe spento l’addestramento.
Da ricordare
I gradienti svaniscono o esplodono perché la backpropagation moltiplica tanti fattori, uno per strato: con norme spettrali sotto uno il prodotto svanisce, e perché esploda serve almeno una norma sopra uno. Profondità, attivazioni saturanti e pesi della scala sbagliata sono i colpevoli.
Inizializzazione giusta (He per ReLU, Glorot per tanh) e scelta a mano, perché il default di PyTorch è un sesto di He e i suoi bias non sono nulli; batch normalization, che in una CNN normalizza per canale, e dropout rendono l’addestramento stabile e generalizzabile; perché la batch normalization funzioni è però ancora una questione aperta.
Il label smoothing sostituisce il bersaglio \(\delta_{k,y}\) con \((1-\epsilon)\delta_{k,y} + \epsilon/K\), cioè aggiunge alla loss una penalità verso l’uniforme, di peso relativo \(\epsilon/(1-\epsilon)\) rispetto alla loss di prima. Su un esempio con logit liberi l’ottimo diventa raggiungibile, con distacco \(\log\big((K(1-\epsilon)+\epsilon)/\epsilon\big)\). In cambio l’uniforme appiattisce le somiglianze fra classi, e sulle immagini un modello così addestrato distilla peggio. Che con i logit liberi l’addestramento si fermi è dimostrato; che una rete generalizzi meglio è misurato e non spiegato.
Adam (momentum + passo adattivo) è il punto di partenza sensato, AdamW se si usa il weight decay (che in
torch.optimè una penalità L2, la quale coincide col decadimento vero solo per l’SGD senza momentum); un learning rate schedule che decade nel tempo rifinisce la convergenza.Lo schedule comincia però salendo: il warmup porta il learning rate da quasi zero a \(\eta_0\) nei primi passi, i più fragili. La diagnosi più citata è la varianza altissima del passo effettivo di Adam, i cui momenti all’inizio sono stimati su pochissimi campioni; è però contestata, e il warmup giova anche a SGD con momentum, che di stime adattive non ne ha. Poi si decade, di norma a coseno.
Il grokking divide l’addestramento in memorizzazione, formazione del circuito e pulizia, e solo la terza si vede nelle curve: il weight decay la anticipa (non è indispensabile, ma la rende molto più rapida), perché il circuito che generalizza ha norma dei pesi più bassa di quello che memorizza. Ne segue che l’ipotesi implicita dell’arresto anticipato, cioè che una validazione ferma voglia dire che non c’è altro da imparare, è un’ipotesi. Documentato su dataset algoritmici piccoli; su dati veri è stato indotto, meno marcato, con un campione ridotto e pesi iniziali più grandi.
Fin qui si è visto come far funzionare una rete profonda. Resta da vedere quali reti, con questi stessi accorgimenti, hanno davvero vinto, e in che ordine: è la storia delle architetture che hanno fatto la storia.