


Modelli a energia#
L’8 ottobre 2024 l’Accademia reale svedese delle scienze annuncia il premio Nobel per la fisica: va a John Hopfield e Geoffrey Hinton «per scoperte e invenzioni fondamentali che rendono possibile l’apprendimento automatico con reti neurali artificiali». La notizia lascia interdetti parecchi addetti ai lavori (lo stesso Hinton, raggiunto al telefono in un albergo della California, si dice sbalordito) e per giorni rimbalza la stessa domanda: che cosa c’entra la fisica? Hopfield e Hinton non hanno scoperto particelle né misurato onde gravitazionali: hanno costruito reti neurali.
La risposta della giuria è seria, ed è la porta d’ingresso dei modelli a energia. Le reti premiate hanno la stessa struttura matematica di un modello fisico, quello con cui i fisici descrivono una calamita e che porta il nome di Ernst Ising: a ogni configurazione dei loro neuroni, cioè a ogni modo in cui possono essere accesi e spenti, è associato un numero, e quel numero si chiama energia.
Conviene fermarsi subito su quella parola, perché è una parola presa in prestito. Qui «energia» non è la corrente che accende una lampadina né le calorie di un piatto di pasta: non è una sostanza che la rete possiede e consuma. È un voto, un numero che il modello dà a ogni risposta possibile: basso se la risposta è sensata, alto se è assurda. Poteva chiamarsi punteggio, o stranezza, o altezza. Si chiama energia per due motivi: la formula che lo calcola è, lettera per lettera, quella del modello di Ising (da dove esca lo racconta la prima sezione), e quella parola porta con sé un’immagine comoda, le risposte buone come il fondo di una valle.
Le parole che arrivano dalla fisica sono quattro, e ciascuna si scioglie dove compare. La prima è quella appena sciolta, energia; le altre sono temperatura, partizione e spin, e arrivano in quest’ordine.
Che le risposte buone stiano in basso è una convenzione, la stessa della fisica, e si poteva scegliere il verso opposto. È però una convenzione comoda, perché nella rete di Hopfield ogni aggiornamento lascia l’energia dov’è o la abbassa: ricordare significa allora scendere in un minimo, e imparare significa modificare i pesi in modo che i minimi cadano sui dati, cioè scavare valli nei punti dove vogliamo che la rete vada a finire. Dalla macchina di Boltzmann in poi la discesa resta soltanto la tendenza media di una dinamica che ogni tanto risale.
Quarant’anni dopo quelle reti, il linguaggio dell’energia non è un pezzo da museo. È quello in cui è scritta la proposta di Yann LeCun per l’AI che verrà; descrive, a meno di una riparametrizzazione, l’addestramento dei modelli di diffusione; e permette di confrontare due risposte senza calcolare la costante che trasformerebbe i punteggi in probabilità, che è proprio il conto che nei modelli probabilistici costa.
Quella rinuncia è il seguito diretto della verosimiglianza esatta, che per avere probabilità esatte paga in vincoli sulla forma della rete. Qui si prende la strada opposta: si rinuncia in partenza a normalizzare, cioè a imporre che le probabilità di tutte le configurazioni sommino a uno, e si tiene l’energia così com’è.
Un numero al posto di una probabilità#

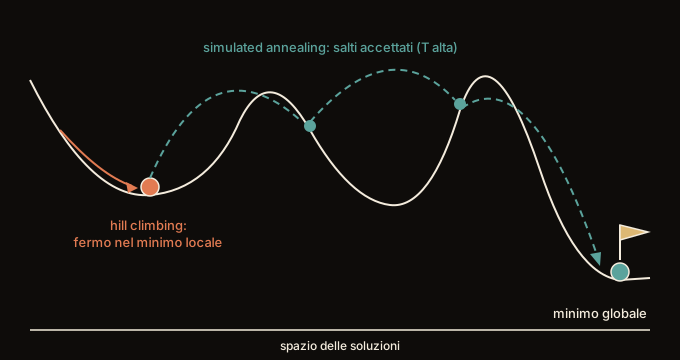
Fig. 29.1 Il paesaggio che dà il nome al capitolo: in basso le risposte sensate, in alto quelle assurde, e in orizzontale (nel disegno, «spazio delle soluzioni») tutte le risposte possibili messe in fila. La pallina di sinistra si limita a scendere, e si ferma nella prima conca che trova; quella tratteggiata ogni tanto accetta di risalire, e così cambia valle. Sono due mosse per due problemi diversi, e il capitolo le incontra in quest’ordine.#
Le due mosse della Fig. 29.1 sono quelle della ricerca locale, già incontrate nella sezione sulla ricerca senza un modello del mondo. La prima è la salita (hill climbing), che accetta soltanto le mosse che migliorano; qui le risposte buone stanno in basso, quindi la salita scende, e il nome le è rimasto addosso. La seconda è la ricottura simulata (simulated annealing), che accetta anche una mossa che alza l’energia di \(\Delta E > 0\), con probabilità \(e^{-\Delta E / T}\), e abbassa \(T\) col passare del tempo [KGV83]: finché \(T\) è alta la pallina esce anche dalle conche in cui si era infilata per sbaglio. Il nome viene dal fabbro, che scalda un pezzo di metallo e lo lascia raffreddare adagio invece di buttarlo nell’acqua, perché raffreddando piano gli atomi hanno il tempo di sistemarsi bene. È la mossa su cui sono costruite le macchine di Boltzmann.
Ed ecco la seconda parola presa in prestito dalla fisica, quella che nel disegno è la «T»: temperatura. Non c’è niente di caldo e nessun termometro: \(T > 0\) è il parametro che decide quanto spesso si accetta una mossa che alza l’energia. Per \(T \to 0\) si scende soltanto; per \(T\) grande quasi ogni mossa passa, e la pallina salta dappertutto. La sezione sulle macchine di Boltzmann le fa fare un mestiere in più: trasformare le altezze del paesaggio in probabilità.
Quella seconda mossa, la scossa che accetta di far risalire, anticipa una differenza di mentalità che attraversa quasi tutto il capitolo. Un classificatore o un regressore ottimizzano: cercano la risposta migliore e si fermano lì. La prima rete che incontreremo, quella di Hopfield, fa lo stesso. Ma dalla macchina di Boltzmann in poi i modelli a energia campionano, cioè producono una risposta alla volta, e la pescano in modo che a lungo andare le risposte buone escano spesso, quelle mediocri ogni tanto e quelle assurde quasi mai: è la frequenza che il paesaggio prescrive. Per riuscirci accettano di peggiorare per un tratto, perché è l’unico modo di uscire da una valle e vederne un’altra. Non è una novità assoluta: i modelli autoregressivi, i flussi e i modelli di diffusione campionano anche loro, e quelli di diffusione lo fanno con una mossa parente stretta di quella che si incontra qui.
Un modello probabilistico assegna a ogni configurazione \(\mathbf{x}\) una probabilità \(p(\mathbf{x}) \ge 0\), e le probabilità di tutte le configurazioni devono sommare a uno (integrare a uno, se le configurazioni sono continue): per valutarne una sola bisogna quindi tener conto di tutte le altre. Un modello a energia rinuncia a questo vincolo. Assegna a ogni configurazione (un’immagine, una frase, uno stato della rete) un’energia, e chiede soltanto che quelle sensate stiano in basso e le altre in alto.
Passa un dito su una carta geografica in rilievo e senti le valli e le cime. Ogni punto di quella carta è una risposta possibile alla tua domanda: una faccia, una frase, il fotogramma che verrà. L’altezza del punto è la sua energia, e dice quanto la risposta è insensata: le risposte buone stanno nelle valli, quelle assurde in cima ai monti. Rispondere significa lasciar rotolare una pallina e guardare dove si ferma, e mettere le risposte buone in basso serve proprio a questo: nei punti bassi la pallina ci va da sola, mentre in cima a un monte non ci sta ferma nessuno, quindi le risposte non bisogna cercarle. Imparare significa scavare il paesaggio finché le valli non stanno nei punti giusti.
Le percentuali, dalla carta, si ricavano. Scuotila e lascia girare la pallina per un’ora: quanto forte scuoti è la temperatura, e con scossoni forti la pallina salta dappertutto, con scossoni deboli resta nei fondovalle. Tocca un po’ tutti i punti, ma in quelli bassi si trattiene molto più a lungo che in cima, e quel «molto più a lungo» è una percentuale. Altezze e frequenze dicono la stessa cosa in due lingue. La traduzione, però, si paga. Se ti chiedessi «quante probabilità ci sono che dietro l’angolo ci sia un gatto?» e volessi una percentuale onesta, dovrei aver messo in conto tutto quello che un gatto non è: cani, biciclette, cassonetti, qualunque cosa esista. È il prezzo del cento per cento: per dire «70%» su una cosa devi aver pesato tutte le altre, e una carta grande così, disegnata come capita, nessuno riesce a misurarla tutta. Ci si riesce solo se la carta è stata disegnata apposta perché il conto torni da sé, e quel disegno obbligato ha i suoi costi.
Se invece ti chiedo soltanto «gatto o cassonetto, quale delle due torna di più?», ti basta confrontare due altezze sulla carta. Il paesaggio non ti obbliga mai a fare il giro del mondo per rispondere a una domanda locale.
Un modello a energia (energy-based model, EBM) è una funzione scalare \(E_\theta(\mathbf{x})\) (o \(E_\theta(\mathbf{x}, y)\) quando le variabili osservate \(\mathbf{x}\) e quelle da predire \(y\) vanno distinte) con parametri \(\theta\): bassa dove i dati sono plausibili, alta altrove. L’inferenza è un’ottimizzazione,
dove \(\hat{y}\) è la risposta predetta e \(\mathcal{Y}\) l’insieme delle risposte ammissibili: nessuna somma su \(\mathcal{Y}\), solo una ricerca del minimo.
Il legame con la probabilità esiste, ed è la distribuzione di Boltzmann–Gibbs:
dove \(Z(\theta)\) è la funzione di partizione, l’integrale (o la somma, nel caso discreto) su tutto lo spazio delle configurazioni. Ogni energia per cui quell’integrale è finito definisce una densità, e ogni densità strettamente positiva si riscrive come energia, \(E_\theta(\mathbf{x}) = -\log p_\theta(\mathbf{x}) + \text{cost.}\): le due descrizioni sono equivalenti sulla carta. Non lo sono nei conti. \(Z(\theta)\) è esplicita quando la struttura lo permette: in una gaussiana; in un modello autoregressivo o in un flusso, che sono normalizzati per costruzione (è il prezzo in vincoli della verosimiglianza esatta); in una rete binaria abbastanza piccola da sommarne tutti i \(2^N\) stati. Per un’energia scelta senza vincoli sull’architettura, su un \(\mathbf{x}\) ad alta dimensione come un’immagine, nessuno la sa calcolare, e «modello a energia» in senso stretto designa proprio questo caso. Metà del capitolo è dedicata a ciò che si può fare senza \(Z(\theta)\), e all’osservazione, tutt’altro che ovvia, che moltissimi compiti non ne hanno mai avuto bisogno.
Lo stesso oggetto sotto quattro nomi#
Lo stesso oggetto continua a riaffiorare sotto nomi diversi, e finché lo si incontra un pezzo per volta non lo si riconosce.
I modelli di diffusione imparano, per ogni livello di rumore, la pendenza di un paesaggio: è il punteggio (score) del capitolo sulla diffusione, e generare vuol dire attraversare quella successione di paesaggi, dal più liscio al più dettagliato. Le architetture che il capitolo sui world model chiama JEPA (Joint-Embedding Predictive Architecture), cioè i modelli che per prevedere come va il mondo ne confrontano due riassunti invece di ridisegnarlo pixel per pixel, sono energie mai trasformate in probabilità: giudicano quanto stiano bene insieme un pezzo di mondo osservato e uno da predire. Le reti di Hopfield «moderne» richiamano un ricordo con lo stesso conto con cui un Transformer decide a quali parole guardare [RSchaflL+21]. E LeCun chiude da anni le sue conferenze con quattro cose a cui il campo dovrebbe rinunciare, fra le quali il modello probabilistico, da sostituire con i modelli a energia; l’argomento disteso sta nel documento di posizione del 2022 [LeC22].
Diffusione, JEPA, Hopfield moderne, il programma di LeCun: sembrano quattro argomenti distinti, e hanno in comune un punteggio da minimizzare invece di normalizzare (per la diffusione con una riserva, che la sezione sulla funzione di partizione rende precisa). La sezione sui paesaggi di oggi li riprende uno per uno.
Dal paesaggio all’energia#
Si comincia da dove l’idea è nata: la memoria associativa di Hopfield [Hop82], venticinque neuroni che ricostruiscono un ricordo rovinato rotolando in fondo a una valle, con il codice per vederlo accadere. Poi la macchina di Boltzmann [AHS85], che aggiunge temperatura e neuroni nascosti, trasforma il paesaggio in percentuali e proprio per questo incontra il muro contro cui va a sbattere metà del capitolo: per dire che una risposta vale il 30% bisogna aver pesato tutte le altre, cioè aver misurato il paesaggio intero.
Quel conto porta un nome che spaventa più di quel che vale, ed è la terza parola presa in prestito: si chiama funzione di partizione. «Partizione» qui non ha niente a che vedere con il dividere un insieme in parti né con le partizioni di un disco fisso: il conto dice come il cento per cento si ripartisce fra tutte le configurazioni possibili, e il nome viene da lì. La lettera con cui i libri lo indicano è \(Z\), che in italiano non è l’iniziale di niente: arriva dal tedesco Zustandssumme, «somma su tutti gli stati», che è esattamente quello che quel conto fa.
Da ricordare
Un modello a energia è una carta geografica in rilievo di tutte le risposte possibili: ogni risposta ha la sua altezza, bassa se è sensata e alta se è assurda. Rispondere significa lasciar rotolare una pallina e guardare in che valle si ferma; imparare significa scavare le valli nei punti giusti.
Altezze e percentuali dicono la stessa cosa in due lingue, ma la traduzione costa cara, perché per dire onestamente «70% gatto» bisogna aver pesato tutto quello che gatto non è. Il paesaggio non lo chiede mai: per sapere quale di due risposte torna di più bastano due altezze messe a confronto. Quel conto di tutto il resto del mondo, che su una carta disegnata come capita nessuno riesce a fare, si chiama funzione di partizione, ed è l’ostacolo contro cui si scontra metà del capitolo.
Il premio Nobel per la fisica del 2024 a Hopfield e Hinton ha ricordato a tutti che questo modo di ragionare non se n’è mai andato: i generatori di immagini a diffusione partono dal rumore e seguono la pendenza di una fila di paesaggi, e le reti di Hopfield di oggi richiamano un ricordo con lo stesso conto con cui i modelli di linguaggio decidono a quali parole guardare.
Nelle prossime pagine, cinque: la memoria che si ripara da sola, le reti che imparano scaldandosi e raffreddandosi, i modi di girare intorno al conto impossibile, il giudizio a coppie («questa risposta sta bene con questa domanda?») e i paesaggi che si usano oggi.
Da ricordare
Un modello a energia assegna un numero a ogni configurazione (basso se plausibile, alto se no) e risponde cercando il minimo: \(\hat{y} = \arg\min_y E_\theta(\mathbf{x}, y)\). Niente probabilità da far sommare a uno.
Energia e probabilità sono legate dalla distribuzione di Boltzmann–Gibbs, \(p_\theta(\mathbf{x}) = e^{-E_\theta(\mathbf{x})}/Z(\theta)\). Il ponte si paga con la funzione di partizione \(Z(\theta)\), intrattabile in alta dimensione quando l’energia non ha vincoli sull’architettura: è il personaggio contro cui si scontra metà del capitolo.
Il premio Nobel per la fisica 2024 a Hopfield e Hinton ha riportato alla luce un filone che non se n’era mai andato: lo score della diffusione è \(-\nabla_{\mathbf{x}} E_t\), una pendenza per ogni livello di rumore; la JEPA è un’energia non normalizzata; l’aggiornamento delle Hopfield moderne è la scaled dot-product attention, a meno della proiezione dei value.
Nel resto del capitolo: memoria associativa, macchine di Boltzmann e contrastive divergence, i modi di aggirare \(Z\), la cornice dell’energy-based learning e i modelli a energia di oggi.