


I grandi modelli linguistici#
Nel 1951 Claude Shannon pubblicò uno degli esperimenti più casalinghi della storia dell’informatica [Sha51]: copriva una riga di un testo e chiedeva a una persona di indovinare, lettera dopo lettera, come continuava. Il risultato, contando i tentativi necessari, è più sorprendente di quanto sembri. Senza sapere niente del contesto, indovinare una lettera dell’alfabeto inglese è come scegliere fra ventisei possibilità: un’incertezza che, nell’unità con cui la si misura (il bit, cioè il numero di domande sì o no che servirebbero a risolverla), vale poco meno di cinque. Sapendo quel che c’è scritto prima, quell’incertezza scende a circa uno: una domanda sola, cioè quanto un testa-o-croce. Il contesto, insomma, toglie da solo i quattro quinti dell’incertezza. L’abbiamo raccontato nella sezione sulla teoria dell’informazione, a proposito dell’entropia. Settant’anni dopo, GPT-3 [BMR+20] gioca esattamente lo stesso gioco: indovinare come continua un testo. Niente di più. La scommessa è la stessa; è cambiata la scala. Un adolescente di tredici anni, secondo le stime usate dalla ricerca sull’acquisizione del linguaggio, è stato esposto a meno di 100 milioni di parole, quasi tutte ascoltate [WCM+23]; GPT-3 in addestramento ne ha viste circa 300 miliardi contate in token, cioè nei pezzi in cui il testo viene spezzato, che per l’inglese corrispondono a poco più di 200 miliardi di parole: più di duemila volte tanto.
Il terreno è già preparato. Nella sezione sulle famiglie di modelli la famiglia GPT è quella dei Transformer decoder-only, addestrati a predire il token successivo; e GPT-3, arrivato a quella scala, sapeva eseguire un compito nuovo solo perché glielo si descriveva nel prompt, magari con due o tre esempi svolti: è la capacità few-shot. Fra il gioco di Shannon e GPT-3 c’è un gradino intermedio da nominare, GPT-2 [RWC+19], 1,5 miliardi di parametri addestrati nel 2019 su pagine web segnalate dagli utenti di Reddit, con un titolo che era già un programma: Language Models are Unsupervised Multitask Learners, cioè i modelli di linguaggio imparano da soli a svolgere molti compiti. Restano da spiegare da dove vengono i dati, perché «più grande» funziona in modo così prevedibile da meritarsi delle leggi, come si sceglie in pratica il token da scrivere e quale accorgimento di ingegneria rende la generazione sostenibile.
Il pretraining su scala web: i dati#
Il pre-addestramento (pretraining) è la prima di due fasi: il modello impara la lingua e una parte delle conoscenze sul mondo, e solo dopo, con il post-training, impara a svolgere compiti. Trecento miliardi di token non stanno in nessuna enciclopedia, e il grosso può venire solo dal web, che però mescola testo di qualità, spam, pagine duplicate e testo generato da macchine: va filtrato, deduplicato e ripesato prima dell’addestramento, e questa preparazione è una parte rilevante del lavoro di chi costruisce un grande modello.
Una lingua straniera si può imparare con un solo tipo di esercizio: frasi da completare. Nessuna grammatica, nessun insegnante, nessuna correzione a penna rossa: solo miliardi di esercizi di completamento, ricavati coprendo a turno ogni parola di frasi vere. «Il gatto nero salta sul ___»: provi, sbagli, aggiusti, scopri la parola e passi a coprire quella dopo. Il voto che conta è quanto si sbaglia in media su una parola: il totale degli sbagli, con miliardi di parole, direbbe soltanto che le parole erano tante. Con abbastanza esercizi, per completare bene devi assorbire ortografia, grammatica, modi di dire, e perfino nozioni sul mondo: non puoi completare «la capitale della Francia è ___» senza sapere di Parigi. Il bello è che gli esercizi si fabbricano da soli: qualunque testo esistente è già un esercizio con la soluzione inclusa. Serve però una biblioteca sterminata e pulita: se la soffitta è piena di doppioni, l’allievo impara a memoria invece di imparare la lingua; se è piena di spazzatura, impara la spazzatura. Per questo, prima di studiare, si butta via moltissimo: pagine duplicate, testo generato da macchine, contenuti di bassa qualità. A decidere che cosa buttare non c’è nessuno che legge: c’è un giudice automatico, a cui sono stati mostrati due o tre scaffali scelti bene, e che tiene le pagine somiglianti a quelli. E quello che resta non pesa tutto uguale: del mucchio raccolto dal web si legge una parte, mentre gli scaffali migliori si ripassano più volte, così contano nello studio più di quanto la loro mole direbbe.
La materia prima tipica è Common Crawl, un’istantanea periodica e liberamente scaricabile del web, che va però raffinata: filtri di qualità (per GPT-3, un classificatore addestrato a distinguere le pagine simili a corpora di riferimento dal resto del crawl), deduplicazione fuzzy (i duplicati gonfiano la memorizzazione e falsano la valutazione) e rimozione di contenuti indesiderati. Il dataset di GPT-3 [BMR+20] è una miscela pesata a mano, e il peso non segue la dimensione: il Common Crawl filtrato dà il 60% dei token visti in addestramento; le fonti ritenute migliori, e più piccole, vengono ripassate più volte (WebText2 quasi tre, Wikipedia più di tre) e pesano il 22% e il 3%. Nel mezzo due corpora di libri, 8% ciascuno (le quote della tabella sommano a 101 per arrotondamento). Il testo è segmentato in sub-word con BPE, come visto nella sezione sui tokenizzatori [SHB16].
L’unica supervisione è il testo stesso: si minimizza la cross-entropia sul token successivo,
dove \(x_t\) è il token in posizione \(t\), \(p_\theta\) è la distribuzione prodotta
dal Transformer con parametri \(\theta\) (softmax sull’intero vocabolario) e la
somma corre sugli \(n\) token del corpus, che però è spezzato in sequenze
indipendenti: il condizionamento si ferma alla finestra di contesto, e dentro
ciascuna sequenza riparte da capo. Quando servirà la loss per token, cioè la
stessa quantità divisa per \(n\), la scriveremo \(\bar{\mathcal{L}} =
\mathcal{L}/n\): la distinzione conta, perché più avanti la perplessità si
calcola mettendo all’esponente proprio quella, e chi confonde le due ottiene la
perplessità elevata alla potenza \(n\). È la stessa nn.CrossEntropyLoss dei
capitoli precedenti, applicata a un problema di classificazione con decine di
migliaia di classi (le parole possibili) ripetuto miliardi di volte; e quella
che restituisce di suo è \(\bar{\mathcal{L}}\), perché la sua riduzione
predefinita è la media. Nessuna etichetta umana: per questo si parla di
apprendimento auto-supervisionato. Sui rischi di corpora così raccolti (bias,
contenuti tossici, opacità) il dibattito è aperto e acceso
[BGMMS21].
Quell’idea, che qualunque testo esistente sia già un esercizio con la soluzione inclusa, è l’apprendimento auto-supervisionato, e non riguarda soltanto il linguaggio. È lo stesso meccanismo con cui il capitolo sulla visione ha fatto imparare a rappresentare le immagini senza etichette, e con cui più avanti si riconoscerà il parlato senza trascrizioni e si allineeranno le immagini alle loro didascalie. Il capitolo sull’auto-supervisione lo tratta per intero, e discute perché regga tanti problemi: a ogni token il modello riceve una correzione, un segnale molto più fitto di un’etichetta per fotografia o di un «hai vinto» a fine partita.
La ricetta a tre ingredienti: le leggi di scala#
Perché proprio grandi modelli? È una regolarità che qualcuno ha misurato.
Un modello di linguaggio ha un solo compito, indovinare la parola dopo, e su quel compito si può dargli un voto preciso: gli si fa leggere del testo che non ha mai visto e si guarda quanta probabilità aveva assegnato alle parole che poi sono comparse davvero. Se ne dava tanta, ha indovinato bene; se ne dava poca, male. Quel numero, che va verso il basso quando il modello impara, è l’errore (in gergo la loss), e quando si tratterà di dare un voto a un modello finito lo ritroveremo sotto un altro nome, la perplessità.
Tra il 2020 e il 2022 due lavori hanno misurato, con la pazienza di centinaia di addestramenti, come cambia quell’errore al crescere delle risorse, e hanno trovato curve così regolari da chiamarle leggi di scala.
La ricetta di un modello di linguaggio ha tre ingredienti: la taglia del modello, la quantità di testo su cui studia, e il calcolo (quante ore di computer può bruciare). La taglia si misura in parametri, cioè i numeri interni che l’addestramento sposta un’inezia alla volta: «un modello da sette miliardi» vuol dire sette miliardi di parametri. La scoperta del 2020 [KMH+20] è che aumentando gli ingredienti tutti insieme l’errore cala in modo prevedibile: niente salti misteriosi, una curva liscia, come una ricetta che riesce sempre un po’ meglio se si raddoppia ogni ingrediente. Prevedibile è la parola che conta: si prova la ricetta in piccolo, si guarda di quanto migliora a ogni raddoppio, e si sa già come verrà quella grande prima di infornarla. Il guadagno però è lento: ogni raddoppio del calcolo lima l’errore di poco più del tre per cento. E la ricetta perfetta non arriva mai: sotto un certo punto non si scende comunque, perché una quota dell’incertezza appartiene alla lingua stessa, e nessuna quantità di parametri la toglie di mezzo. La seconda scoperta, del 2022 [HBM+22], è che gli ingredienti vanno bilanciati: è inutile fare una torta con dieci uova e un cucchiaio di farina. La regola pratica emersa è circa 20 pezzi di testo per ogni parametro del modello, contati in quei pezzi in cui il testo viene spezzato, i token, non in parole: per un modello da sette miliardi di parametri vuol dire centoquaranta miliardi di token da leggere. Molti modelli dell’epoca erano enormi ma avevano studiato troppo poco, e la dimostrazione ha un nome, perché è un modello costruito apposta: si chiama Chinchilla, ha quattro volte meno parametri del suo rivale diretto (Gopher), ha letto quasi cinque volte più testo a parità di ore di calcolo, e lo batte. Da allora «più grande» non basta più: conta il rapporto fra modello e dati. Venti pezzi per parametro, però, è la proporzione che costa meno da addestrare: chi il modello lo deve poi usare moltissimo ne fa uno più piccolo e gli fa leggere molto di più, perché ogni risposta di un modello piccolo costa meno.
Kaplan e colleghi [KMH+20] osservano che la loss di test per token, cioè la \(\bar{\mathcal{L}}\) di poco fa, segue leggi di potenza in ciascuna delle tre risorse, quando le altre due non fanno da collo di bottiglia:
dove \(N\) è il numero di parametri (esclusi gli embedding), \(D\) il numero di token di addestramento, \(C_{\min}\) il calcolo speso in modo ottimo fra modello e dati (che è la grandezza per cui gli autori raccomandano di fare previsioni: la curva a batch size fissato ha un esponente suo, \(\approx 0{,}057\)), \(N_c\), \(D_c\) e \(C_c\) costanti di normalizzazione, e gli esponenti misurati valgono \(\alpha_N \approx 0{,}076\), \(\alpha_D \approx 0{,}095\), \(\alpha_C^{\min} \approx 0{,}050\). Esponenti piccoli: raddoppiare il calcolo, speso bene, riduce la loss di circa il 3,4% (\(2^{-0{,}050} \approx 0{,}966\)), poco, ma con sorprendente affidabilità su molti ordini di grandezza, il che permette di estrapolare: si può stimare la loss di un modello da miliardi di parametri addestrando modelli da milioni. Un’avvertenza sulla forma: scritte così le tre leggi mandano la loss a zero su scale arbitrariamente grandi, il che è falso. Valgono dentro il regime misurato, e la forma completa che si usa per estrapolare davvero somma un termine costante irriducibile, l’entropia del linguaggio stesso, che nessuna quantità di parametri toglie di mezzo, ed è la forma che Hoffmann e colleghi adottano.
Hoffmann e colleghi [HBM+22] correggono la conclusione operativa di Kaplan (che suggeriva di privilegiare \(N\)): rifacendo le misure trovano che, a budget di calcolo \(C\) fissato, il minimo della loss si ottiene scalando all’incirca \(N_{\mathrm{opt}} \propto C^{0{,}5}\) e \(D_{\mathrm{opt}} \propto C^{0{,}5}\) (modello e dati crescono insieme, in proporzione) con un rapporto quasi costante \(D/N \approx 20\) token per parametro. La verifica empirica è Chinchilla: 70 miliardi di parametri addestrati su 1.400 miliardi di token che, a parità di calcolo, superano Gopher (280 miliardi di parametri, circa 300 miliardi di token). Col senno del 2022, GPT-3 era fortemente sotto-addestrato. Il conto passa per il costo di un addestramento, \(C \approx 6ND\) operazioni in virgola mobile: due per parametro e per token nel passaggio in avanti, quattro nella retropropagazione. Con \(D = 20N\) viene \(C \approx 120N^2\), quindi \(N_{\text{opt}} \approx \sqrt{C/120}\). Il conto si rifà in poche righe:
# il conto di Hoffmann e colleghi: C = 6 N D, e all'ottimo D = 20 N
N, D = 175e9, 300e9                    # GPT-3: parametri e token
C = 6 * N * D
N_opt = (C / 120) ** 0.5               # da C = 6 N (20 N) = 120 N^2
print(f"calcolo di GPT-3: {C:.2e} operazioni")
print(f"all'ottimo: {N_opt/1e9:.0f} miliardi di parametri, "
      f"{20 * N_opt/1e9:.0f} miliardi di token")
print(f"token per 175 miliardi di parametri: {20 * N/1e9:.0f} miliardi")
print(f"Llama 3 8B su 15 000 miliardi di token: {15e12/8e9:.0f} per parametro")
calcolo di GPT-3: 3.15e+23 operazioni
all'ottimo: 51 miliardi di parametri, 1025 miliardi di token
token per 175 miliardi di parametri: 3500 miliardi
Llama 3 8B su 15 000 miliardi di token: 1875 per parametro
Il calcolo di GPT-3, \(3{,}15\cdot10^{23}\) operazioni, sarebbe stato speso al meglio su circa 51 miliardi di parametri e poco più di mille miliardi di token; tenuti fissi i 175 miliardi, la regola ne chiederebbe 3.500. Kaplan prescriveva invece \(N_{\text{opt}} \propto C^{0{,}73}\). Hoffmann e colleghi attribuivano la differenza al programma del learning rate, che Kaplan teneva uguale per tutti i modelli; Porian e colleghi [PWJ+24] hanno poi riprodotto la legge di Kaplan e ne hanno trovato altre tre cause: il calcolo dell’ultimo strato, che Kaplan non contava, la durata del riscaldamento e una regolazione dell’ottimizzatore che dipende dalla scala. Corretti questi tre punti i due risultati coincidono, e un decadimento accurato del learning rate non risulta essenziale.
Hoffmann adatta la forma \(\bar{\mathcal{L}}(N,D) = E + A/N^{a} + B/D^{b}\), con \(E \approx 1{,}69\) il termine irriducibile, \(A\) e \(B\) due costanti di adattamento e \(a \approx 0{,}34\), \(b \approx 0{,}28\). Sono i valori arrotondati dell’articolo, e Besiroglu e colleghi [BEBY24], ricostruendo i dati dai grafici, trovano che quei valori non descrivono bene i dati: il loro adattamento dà \(E \approx 1{,}82\), \(a \approx 0{,}35\), \(b \approx 0{,}37\), quindi \(N_{\text{opt}} \propto C^{0{,}51}\) e un rapporto ottimo vicino a venti token per parametro. La regola del mezzo regge, i valori arrotondati no. E il rapporto 20 minimizza il costo dell’addestramento, non quello dell’uso: chi prevede di servire molte richieste addestra di proposito un modello più piccolo su molti più token. La famiglia Llama 3 lo fa anche con i modelli più piccoli [GDJ+24], e quello da 8 miliardi di parametri ha letto circa 15 000 miliardi di token, quasi 1.900 per parametro.

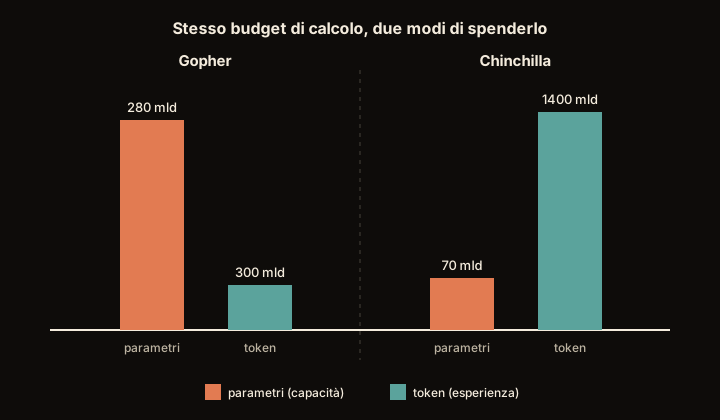
Fig. 16.12 Lo stesso budget, due modi di spenderlo. Chinchilla è quattro volte più piccolo di Gopher e ha letto quasi cinque volte di più: a parità di calcolo, vince Chinchilla.#
Il confronto di Fig. 16.12 è il motivo per cui «quanti parametri ha?» ha smesso di essere una domanda sensata da sola. Un numero di parametri dice quanta capacità c’è, non quanta ne è stata riempita, e due modelli con lo stesso cartellino possono aver letto quantità di testo incomparabili.
Una parola di prudenza: le leggi di scala descrivono come cala la loss di test dentro il regime in cui sono state misurate, cioè che il modello sbaglierà un po’ meno a indovinare la parola dopo, non che a una certa taglia gli spunterà una certa abilità. Che le abilità spuntino davvero all’improvviso è una faccenda controversa.
Generare: l’arte di scegliere la parola dopo#
Un modello addestrato non sceglie una parola: distribuisce probabilità su tutte quelle possibili. Per scrivere, però, bisogna sceglierne una davvero, poi un’altra, poi un’altra ancora, e il modo in cui la si sceglie cambia moltissimo il testo che ne esce.
I due modi classici li abbiamo già visti nella sezione sulla traduzione con le reti. Il primo è prendere ogni volta la parola più probabile e tirare dritto (si chiama greedy, cioè ingorda). Il secondo è meno miope: invece di impegnarsi subito, si portano avanti in parallelo le \(k\) continuazioni più promettenti, si vede come proseguono, e solo alla fine si tiene la migliore delle \(k\) (è la beam search, «ricerca a fascio»). Le quantità che seguono, come \(k\), \(T\) e \(p\), sono iperparametri della decodifica: li sceglie chi usa il modello, e non si imparano.
Per la traduzione questi due modi funzionano; per la generazione libera (scrivere un racconto, rispondere a una domanda aperta) falliscono in un modo curioso, documentato da Holtzman e colleghi [HBD+20]. Il testo che massimizza la probabilità è noioso, ripetitivo, e finisce spesso incastrato a girare in tondo («Il gatto nero salta sul muro. Il gatto nero salta sul muro. Il gatto nero…»). Gli stessi autori sono andati a controllare come è fatto il testo scritto da noi: hanno preso pagine di prosa umana e hanno chiesto al modello, parola per parola, quanto le riteneva probabili. Il risultato è che noi non scriviamo la sequenza più probabile, mai: le nostre frasi sono punteggiate di scelte a media e bassa probabilità, ed è quello che le rende vive. Per scrivere come noi, allora, il modello deve rischiare: non scegliere sempre il massimo, ma campionare, cioè tirare un dado truccato secondo le sue probabilità. E il trucco del dado si può regolare.

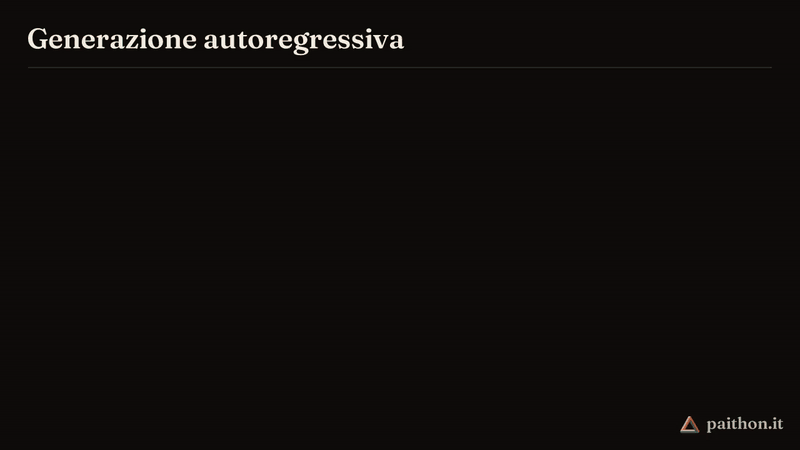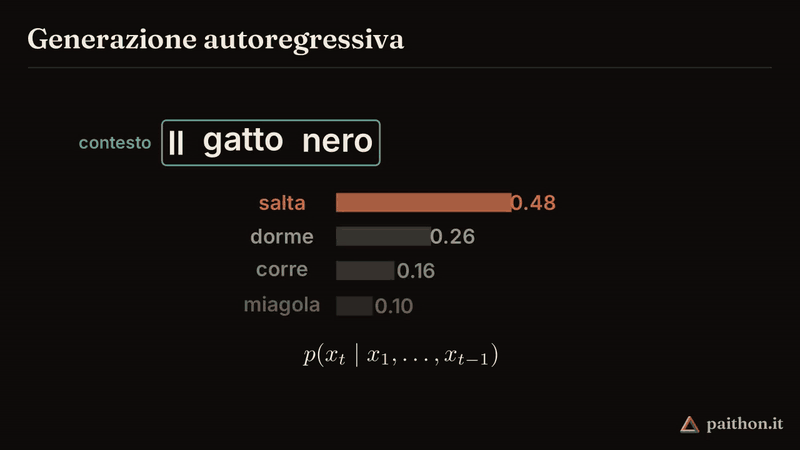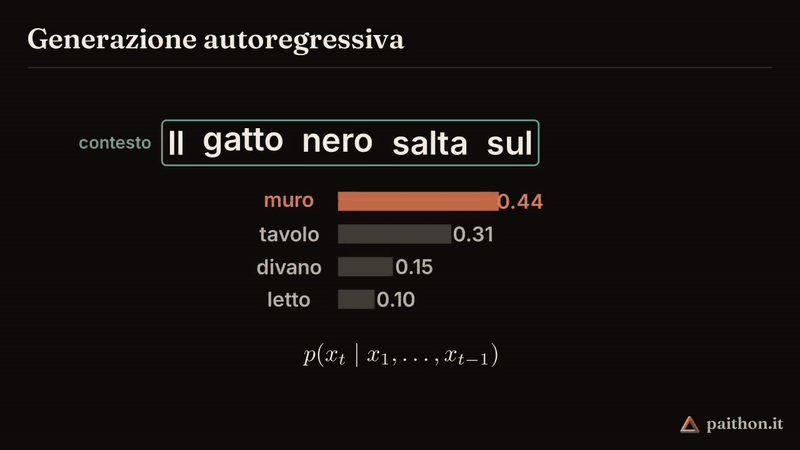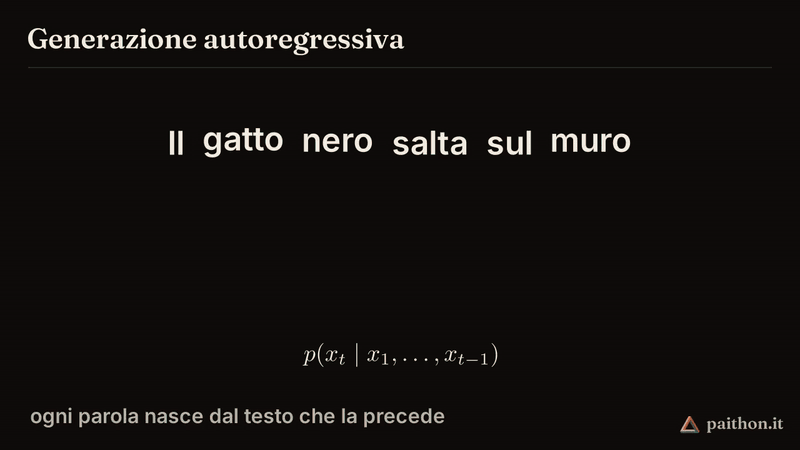
Fig. 16.13 Il ciclo della generazione: leggi tutto quello che c’è scritto finora, ottieni una probabilità per ogni parola possibile, scegline una, riattaccala in fondo e ricomincia da capo.#
Nella Fig. 16.13 la scelta cade ogni volta sul candidato più probabile: è la decodifica greedy, quella che produce i loop appena descritti. Gli iperparametri che seguono servono a non far vincere sempre la barra più lunga.
Tre manopole, tutte con la stessa filosofia: quanta sorpresa vogliamo?
La temperatura regola quanto è truccato il dado. Riprendiamo il gioco: «Il gatto nero salta sul…» con quattro esiti; muro (probabile), tetto, divano, pigiama (assurdo). A temperatura bassa il dado è truccatissimo: esce «muro» quasi sempre, il testo è prudente e un po’ monotono. A temperatura 1 il dado rispetta le probabilità del modello. A temperatura alta il dado si «stempera» verso l’equità: ogni tanto esce «pigiama», e il testo si fa creativo fino allo sproposito. Bassa = affidabile e prevedibile; alta = vivace e rischiosa. Il nome viene dalla fisica, non dal caldo: nelle formule che descrivono un gas compare esattamente la stessa manopola, e alzarla vuol dire far muovere le particelle più a caso. Qui non si scalda niente; è la formula a essere la stessa.
Top-k e top-p tolgono dal mazzo le carte peggiori prima di pescare. Con il top-k tieni solo le \(k\) carte migliori: con \(k=2\), nel nostro gioco, pesca solo tra «muro» e «tetto»; «pigiama» non può proprio uscire. Il difetto: \(k\) è fisso, ma a volte le carte buone sono due, a volte venti. Il top-p è più furbo: tieni le carte migliori finché, sommando le loro probabilità, copri (diciamo) il 90% del totale; a volte bastano due carte, a volte ne servono dieci, il mazzo si adatta da solo alla situazione. È il metodo proposto proprio nell’articolo del «caso curioso», con il nome di nucleus sampling: si pesca solo dal nucleo buono del mazzo, e la coda di parole strampalate (che una per una vale poco, ma sommata pesa) sparisce.
Le tre manopole si usano insieme, e in quest’ordine: prima si decide quanto truccare il dado, poi si tolgono le carte dal mazzo, e solo alla fine si pesca.
Il modello produce per ogni token del vocabolario un punteggio grezzo (il logit \(z_i\)); la softmax con temperatura \(T\) lo converte in probabilità:
dove \(|\mathcal{V}|\) è la dimensione del vocabolario (il calligrafico distingue l’insieme delle parole possibili dalla matrice \(\mathbf{V}\) dei value), e \(T > 0\) scala i logit prima della normalizzazione: per \(T \to 0\) la distribuzione collassa sul massimo (si torna alla scelta greedy), per \(T \to \infty\) tende all’uniforme. Esempio numerico completo con quattro parole e logit \(\mathbf{z} = (2{,}0;\; 1{,}0;\; 0{,}0;\; -2{,}0)\):
parola |
\(z_i\) |
\(T=0{,}5\) |
\(T=1\) |
\(T=2\) |
|---|---|---|---|---|
muro |
\(2{,}0\) |
\(0{,}867\) |
\(0{,}657\) |
\(0{,}474\) |
tetto |
\(1{,}0\) |
\(0{,}117\) |
\(0{,}242\) |
\(0{,}287\) |
divano |
\(0{,}0\) |
\(0{,}016\) |
\(0{,}089\) |
\(0{,}174\) |
pigiama |
\(-2{,}0\) |
\(0{,}000\) |
\(0{,}012\) |
\(0{,}064\) |
A \(T=0{,}5\) «muro» passa da 0,657 a 0,867 e «pigiama» praticamente scompare; a \(T=2\) la distribuzione si appiattisce e «pigiama» sale a 0,064: un errore ogni sedici parole, in media.
Il top-k limita il campionamento ai \(k\) token con probabilità maggiore, rinormalizzando: con \(k=2\) restano muro e tetto con \(0{,}657/0{,}899 \approx 0{,}731\) e \(0{,}242/0{,}899 \approx 0{,}269\). Il top-p (nucleus sampling [HBD+20]) sceglie invece il più piccolo insieme di token (il nucleo) la cui probabilità cumulata raggiunge la soglia \(p\):
ordinando per probabilità decrescente. Con \(p=0{,}9\) e \(T=1\): la cumulata fa \(0{,}657 \to 0{,}899 \to 0{,}988\); siccome \(0{,}899 < 0{,}9\), serve anche «divano», e il nucleo è {muro, tetto, divano}, rinormalizzato a \((0{,}665;\; 0{,}245;\; 0{,}090)\). A differenza di \(k\), la taglia del nucleo si adatta alla forma della distribuzione: pochi candidati quando il modello è sicuro, molti quando è incerto. Holtzman e colleghi mostrano che è la strategia che meglio riproduce le statistiche del testo umano nella generazione di testi lunghi. Le tre operazioni si compongono: prima la temperatura, poi i tagli top-k e top-p, infine il campionamento.

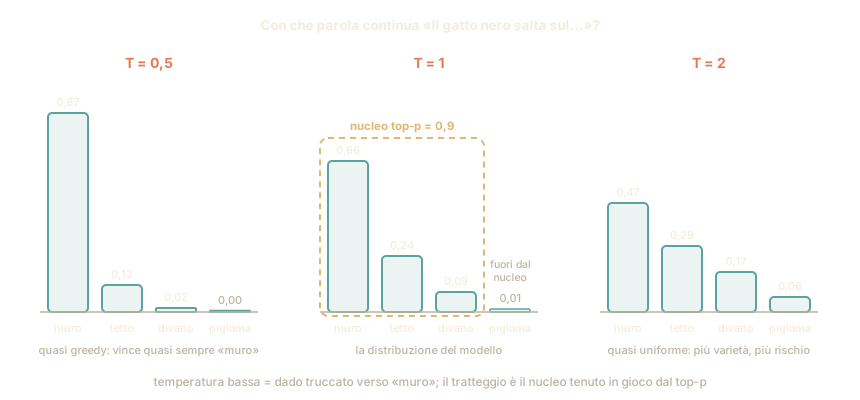
Fig. 16.14 Le stesse probabilità a tre temperature: più la temperatura è bassa, più il dado è truccato verso «muro»; il riquadro tratteggiato racchiude le parole che restano nel mazzo con il taglio top-p.#
In Fig. 16.14 si vede il compromesso a colpo d’occhio: la temperatura decide quanto la distribuzione è appuntita, il top-p dove tagliare la coda. In pratica si usano insieme (temperature attorno a 0,7–0,8 e \(p\) attorno a 0,9 sono punti di partenza comuni) e la scelta dipende dal compito: per una risposta fattuale conviene un dado truccato, per una poesia un dado più libero.
La KV cache#
C’è un dettaglio pratico che a prima vista sembra un disastro. La generazione è autoregressiva: come visto nella sezione sulla struttura del Transformer, il token prodotto rientra come input e si ricomincia. Ma allora, per ogni nuovo token, il Transformer dovrebbe rileggere tutta la sequenza, e i conti dell’attenzione sul prefisso sarebbero sempre gli stessi, rifatti da capo a ogni passo. Nessun sistema reale lavora così: tutti usano la KV cache, che la sezione sull’attenzione in pratica ha descritto come struttura dati. Il nome dice già tutto, una volta sciolto: K e V sono la key e il value dell’attenzione, i vettori che ogni posizione offre come chiave e come valore; cache è la memoria in cui si conserva quello che è già stato calcolato.
È il taccuino della sezione sull’attenzione in pratica, uno per ogni piano e per ogni lettore: per ogni parola letta ci restano scritte l’etichetta con cui si fa trovare e l’informazione che consegna, e per una parola nuova il modello scrive soltanto le sue due righe, consultando le vecchie senza rifarle. Il risultato è identico a quello che verrebbe rileggendo tutto, perché nessuna parola può guardare avanti: quello che succede a pagina trecento non cambia quello che si era annotato a pagina dodici. Il risparmio è enorme, la differenza fra girare pagina e rileggere il libro da capo a ogni pagina. Il prezzo è lo spazio: il taccuino si allunga a ogni parola, mezzo megabyte a parola per un modello da sette miliardi, e per conversazioni molto lunghe arriva a pesare quanto il modello stesso.
Anche col taccuino, però, resta una fatica che non si può togliere: per ogni parola scritta il modello ripassa tutti i suoi parametri, miliardi di numeri, e li deve rileggere dalla memoria ogni volta. Consultare il taccuino, al confronto, costa poco, e resta la parte minore finché il testo davanti non diventa lunghissimo: oltre qualche decina di migliaia di parole è il taccuino a pesare di più.
La KV cache evita di ricalcolare chiavi e valori del prefisso: il costo di un passo scende, per strato, da \(O(t^2 d + t\,d^2)\) a \(O(t\,d + d^2)\), e quello dell’intera generazione di \(n\) token da \(O(n^3 d + n^2 d^2)\) a \(O(n^2 d + n\,d^2)\), come ricava la sezione sull’attenzione in pratica; per il modello intero si moltiplica per gli \(n_{\text{strati}}\) strati.
I due termini vanno tenuti distinti, perché è facile portarsi via la morale sbagliata. Il termine in \(t\,d\) è quello dell’attenzione ed è ineliminabile, come nel confronto con le RNN; il termine in \(d^2\) è quello delle matrici dense (proiezioni e feed-forward), e domina finché il contesto è più corto di qualche decina di migliaia di token. Per un modello da 7 miliardi di parametri, con le forme di Llama 2 7B (\(n_{\text{strati}} = 32\), \(d = d_{\text{model}} = 4096\), feed-forward SwiGLU con \(d_{\text{ff}} = 11\,008\), vocabolario di \(32\,000\) token), il conto mette due operazioni per parametro delle matrici dense e \(4\,t\,d\) per strato per l’attenzione su \(t\) token di contesto:
# le forme di un modello da sette miliardi (quelle di Llama 2 7B)
n_strati, d, d_ff, vocab = 32, 4096, 11008, 32000

per_strato = 4 * d * d + 3 * d * d_ff         # proiezioni e FFN SwiGLU
parametri = n_strati * per_strato + 2 * vocab * d   # embedding e uscita
densi = n_strati * per_strato + vocab * d     # l'embedding non fa conti
print(f"parametri: {parametri/1e9:.2f} miliardi")

# per token: 2 operazioni per parametro denso, e 4 t d per strato
# di attenzione (Q K^T e A V) su t token di contesto
flop_densi = 2 * densi
for t in (1024, 4096, 32768, 131072):
    flop_att = 4 * t * d * n_strati
    quota = flop_att / (flop_att + flop_densi)
    print(f"contesto {t:>6}: attenzione {quota:6.1%}")
print(f"pareggio a {flop_densi/(4 * d * n_strati):.0f} token")

# a una richiesta per volta si rileggono tutti i pesi, 2 byte l'uno
print(f"operazioni per byte di pesi letti: {flop_densi/(2 * parametri):.2f}")
parametri: 6.74 miliardi
contesto   1024: attenzione   3.9%
contesto   4096: attenzione  14.0%
contesto  32768: attenzione  56.5%
contesto 131072: attenzione  83.9%
pareggio a 25204 token
operazioni per byte di pesi letti: 0.98
A 1.024 token di contesto l’attenzione vale il 4% del calcolo per token, a 4.096 il 14%; i due termini si pareggiano attorno ai 25.000 token, e oltre quella soglia il calcolo per token è fatto soprattutto di attenzione, l’84% a 131.072. Il tempo, però, a una richiesta per volta lo decide un’altra cosa: a ogni token vanno riletti dalla memoria tutti i pesi, due byte per parametro a 16 bit, per circa due operazioni per parametro, cioè un’operazione per byte letto, molto sotto il ginocchio del modello roofline, che per una scheda grafica moderna in mezza precisione sta oltre le centocinquanta. Generare testo, a una richiesta per volta, è quindi un lavoro limitato dalla memoria più che dall’aritmetica, come dirà anche la sezione sui modelli a esperti: il collo di bottiglia è leggere i pesi a ogni parola, non confrontare la parola con quelle prima.
Il conto della memoria è quello della tabella della sezione sull’attenzione in pratica: con una testa di chiave e valore per ogni testa di query sono \(2\,n_{\text{strati}}\,d_{\text{model}}\) numeri per token, mezzo megabyte a 16 bit per il modello da sette miliardi, e una finestra di 4.096 token occupa circa 2 GB per ogni sequenza nel batch, da sommare ai ~14 GB dei pesi. Con meno teste di chiave e valore la voce scende (con GQA a otto gruppi, a un quarto), ed è per questo che MQA, GQA e MLA sono diventate standard nei modelli recenti. Lo stesso conto spiega un’asimmetria che si nota usando i servizi commerciali: elaborare il prompt (il prefill, parallelo) e generare i token (la decodifica, sequenziale e affamata di memoria) hanno costi molto diversi.
Programmare con le parole: prompt e in-context learning#
Abbiamo visto, fra le famiglie di modelli, la scoperta di GPT-3: descrivere un compito nel prompt, con due o tre esempi già svolti, basta spesso a farlo eseguire [BMR+20].

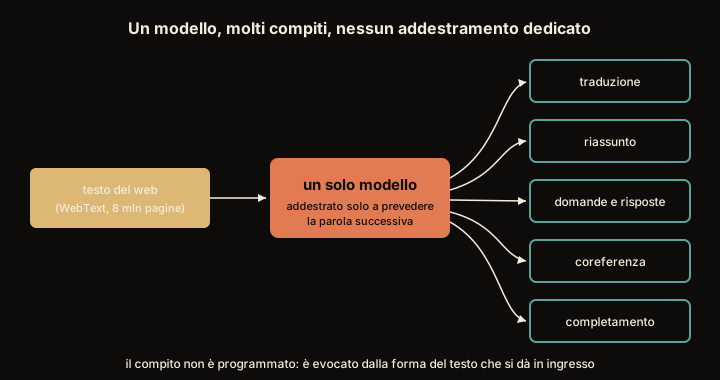
Fig. 16.15 Un solo obiettivo, molti compiti. Nessuno ha insegnato a questo modello a riassumere o a tradurre; GPT-2 ci riesce soltanto in modo grezzo (nel riassunto di articoli di giornale, di poco meglio di tre frasi prese a caso), ma ci riesce senza aver visto un solo esempio del compito.#
L’osservazione di Fig. 16.15 precede GPT-3 e ne spiega la premessa. Se il corpus è abbastanza vasto, contiene esempi impliciti di molti compiti linguistici, e un modello che prevede bene il testo può imparare in parte a svolgerli: è la congettura degli autori di GPT-2, che i loro risultati sostengono solo in parte (55 di F1 sulle domande di CoQA, 5 di BLEU nella traduzione dall’inglese al francese, un riassunto che batte di poco tre frasi scelte a caso). GPT-3 la riprende con un modello più di cento volte più grande e con gli esempi nel prompt. Il fatto resta strano. Fin qui, «adattare un modello» ha significato addestrarlo, cioè mostrargli esempi, misurare quanto sbaglia e spostargli i numeri interni un’inezia alla volta, per giorni. Qui no: il compito viene descritto in italiano (o in inglese), e il modello, completando il testo nel modo più probabile, di fatto lo esegue. Il prompt è diventato un’interfaccia di programmazione in linguaggio naturale: si «programma» il modello scrivendo, e l’in-context learning (imparare dal contesto della singola richiesta) non era un obiettivo di progetto: nessuna loss lo chiede, e migliora con la scala, anche se i suoi meccanismi di base, le teste di induzione che ricopiano il seguito di uno schema già comparso nel contesto, si formano già in modelli piccolissimi [OEN+22].
L’onestà impone però di dire che questa «programmazione» è fragile. L’ordine degli esempi nel prompt può portare l’accuratezza da vicino allo stato dell’arte fino al livello del caso [LBM+22]; il solo formato della richiesta (separatori, maiuscole, spazi) la sposta fino a 76 punti su un modello da 13 miliardi di parametri [SCTS24]; e le etichette degli esempi contano meno di quanto ci si aspetterebbe, tanto che sostituirle a caso cambia poco [MLH+22]. Una frase d’istruzione che funziona con un modello può fallire con un altro. Non c’è un manuale del linguaggio di programmazione, perché non è un linguaggio di programmazione. Sotto non c’è nessuno che esegue un ordine: c’è una macchina che, dato tutto quello che ha davanti, calcola quanto è probabile ogni possibile continuazione, e ne sceglie una. Se cambi quello che ha davanti, cambiano le probabilità; l’istruzione è un pezzo di contesto come tutti gli altri e non un comando, e il confine tra «istruire» e «suggestionare» è sottile. Il prompt engineering (l’artigianato di formulare richieste che funzionano) è utile, ma va preso per quello che è: una collezione di euristiche su un sistema che nessuno, finora, sa programmare con garanzie.
Misurare un gigante#
Come si valuta un modello del genere? La misura più naturale è la stessa cosa che il modello sta imparando a fare: quanto resta indeciso sulla parola successiva. Si chiama perplessità, ed è l’esponenziale della loss media per token, cioè il numero di scelte equiprobabili fra cui il modello si troverebbe, in media, a ogni passo. Perplessità 1 vuol dire che sa sempre esattamente che cosa viene dopo; più è alta, più è indeciso, e quindi più è bassa, meglio è. È un altro modo di scrivere l’errore di cui parlavano le leggi di scala, cioè esattamente la cosa che il pretraining fa scendere, e resta il termometro più affidabile della qualità come modello di linguaggio.
Il dado è tutto quello che serve. Se un modello ha perplessità 20 su un certo testo, vuol dire che, in media, a ogni parola si trova nella condizione di uno che deve indovinare fra venti possibilità equiprobabili. Un modello migliore scende a dieci, uno molto migliore a cinque, e nessuno arriverà mai a uno, perché il linguaggio ha una sua imprevedibilità di fondo che nessun modello può togliere: quella che Shannon misurava coprendo una riga di testo e chiedendo a una persona di indovinare come andava avanti.
L’avvertenza è che il numero non si confronta fra testi diversi. La perplessità su una raccolta di leggi e quella su un romanzo non si possono mettere sulla stessa riga, perché le leggi sono scritte in modo molto più prevedibile: confrontare due modelli ha senso solo sullo stesso testo e spezzato allo stesso modo. L’unica alternativa per sfuggire alla scelta dei pezzi è contare l’indecisione lettera per lettera, che non dipende da come il testo viene diviso.
In formula, con la stessa definizione della sezione sulla teoria dell’informazione e di quella sui modelli n-gram, la perplessità è \(2^H\), dove \(H\) è la cross-entropia media per token espressa in bit. La parola «bit» è il punto in cui si sbaglia: la cross-entropia del pretraining si scrive col logaritmo naturale, quindi la loss per token \(\bar{\mathcal{L}}\) è in nat e non in bit. Per passare dagli uni agli altri si moltiplica per \(\log_2 e = 1{,}4427\), cioè \(H = \bar{\mathcal{L}}/\ln 2\), e la perplessità si scrive allora più comodamente \(e^{\bar{\mathcal{L}}}\). Chi invece mette \(\bar{\mathcal{L}}\) tale e quale all’esponente di 2 sta usando un esponente più piccolo del dovuto di quel fattore, e ottiene la perplessità vera elevata a \(\ln 2 = 0{,}693\): su una perplessità di 20 ne stampa 8. Il valore dipende poi dal corpus e da come il testo è stato spezzato in token, quindi due modelli si confrontano così solo sullo stesso testo e con la stessa segmentazione. Con tokenizzatori diversi si normalizza per i byte invece che per i token, e si usano i bit per byte,
dove \(n_{\text{token}}\) e \(n_{\text{byte}}\) sono i token e i byte dello stesso testo: il numeratore è la cross-entropia dell’intero testo, in nat, e dividerla per i byte invece che per i token dà una misura che si confronta anche fra modelli che spezzano il testo in modo diverso.
Ma nemmeno la perplessità dice quasi nulla di ciò che interessa a chi il modello lo usa: sa rispondere a domande di diritto? Sa tradurre? Per questo si affiancano batterie di test standardizzati, i benchmark: il più citato è stato a lungo MMLU (Massive Multitask Language Understanding) [HBB+21], cinquantasette materie di domande a scelta multipla, dal diritto alla fisica.
I benchmark vanno però letti con un sospetto specifico: la contaminazione dei dati di test.

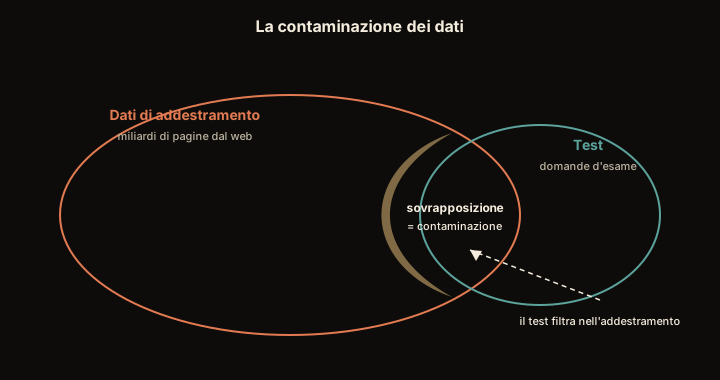
Fig. 16.16 La zona di sovrapposizione è il problema. Non serve malafede perché si formi: basta che il benchmark sia pubblico e il corpus sia il web.#
Come si vede in Fig. 16.16, la contaminazione non è un imbroglio ma una conseguenza quasi inevitabile del modo in cui si raccolgono i dati. Ed è per questo che è difficile da escludere: per dimostrare che una domanda non è nel corpus bisognerebbe poterlo ispezionare tutto, e chi pubblica un punteggio quasi mai pubblica anche i dati. Se il modello ha studiato l’intero web, è probabile che abbia già visto le domande del test, che quindi misura la memoria, non la competenza. Il rischio è concreto: gli stessi autori di GPT-3 dedicano al problema un’analisi accurata, e ammettono che, per un bug nella procedura di pulizia, parte delle sovrapposizioni tra corpus e benchmark non era stata rimossa [BMR+20]. Da allora il problema è solo cresciuto: ogni benchmark pubblicato sul web è, per il modello successivo, potenziale materiale di studio. Quando leggi «il modello X supera il modello Y di due punti», la domanda giusta è: su dati che nessuno dei due aveva mai visto? Una trattazione sistematica della perplessità, della decodifica e della valutazione dei grandi modelli linguistici sta nel manuale di Jurafsky e Martin [JM26], nel capitolo sui modelli a n-grammi e nelle parti dedicate ai grandi modelli.
Le abilità emergenti, e il dubbio che siano un miraggio#
Su certi compiti (aritmetica a più cifre, ragionamento a più passi) i modelli piccoli vanno a zero, e poi, superata una certa scala, la prestazione salta all’improvviso. Non migliora gradualmente: appare. Da qui il nome abilità emergenti, e l’idea inquietante che ingrandendo un modello si ottengano capacità non previste.

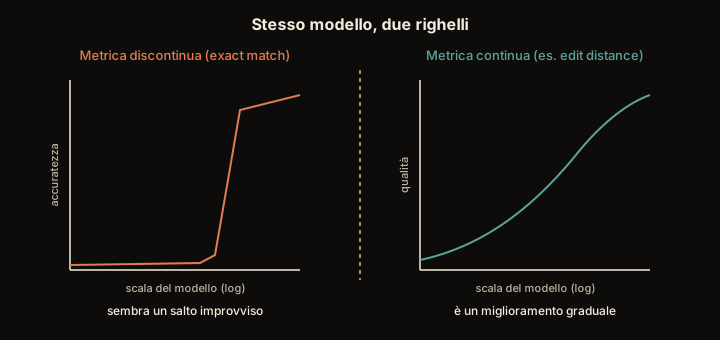
Fig. 16.17 Lo stesso modello, due righelli. Il gradino di sinistra sta nel modo di dare i voti, non nei dati: quel modo assegna zero a una risposta quasi giusta finché non diventa esatta.#
I due grafici di Fig. 16.17 sono lo stesso modello, misurato in due modi diversi, e la differenza fra loro è il cuore della questione.
L’obiezione arrivata dopo mostra che l’errore stava nel modo di misurare.
Molti di quei compiti sono valutati tutto-o-niente: la risposta a \(134 \times 27\) è giusta solo se tutte le cifre sono giuste. Con una metrica del genere, un modello che passa dallo sbagliare tre cifre allo sbagliarne una prende zero in entrambi i casi: poi azzecca l’ultima e prende uno. Il salto è nella pagella, non nel modello.
Se si misura la stessa identica prestazione con un metro graduale (quante cifre sono corrette, o la probabilità assegnata alla risposta giusta), la curva diventa liscia e prevedibile. Il miglioramento c’era ed era continuo: la metrica lo nascondeva.
In molti casi, non in tutti. Che gran parte di quelle curve a scalino sia un effetto del righello è ormai ben argomentato; che ingrandire un modello non gli cambi mai niente di qualitativo è un’affermazione più forte, e nessuno l’ha dimostrata. Il dibattito è aperto, e conviene tenerlo aperto anche quando la spiegazione furba fa comodo.
La morale vale ben oltre gli LLM: una metrica discontinua trasforma un progresso graduale in un miracolo apparente.
Le abilità emergenti sono state documentate da Wei e colleghi [WTB+22]; la critica del miraggio è di Schaeffer, Miranda e Koyejo [SMK23].
L’argomento è preciso. Se l’errore per token cala regolarmente con la scala (come predicono le leggi di scala), l’accuratezza su una risposta di \(n\) token valutata in modo esatto vale circa \(p_{\text{tok}}^{\,n}\), dove \(p_{\text{tok}}\) è la probabilità di azzeccare un singolo token e il conto suppone che gli errori sui token siano indipendenti l’uno dall’altro. Una funzione del genere resta schiacciata vicino a zero e poi si impenna: la discontinuità è prodotta dalla non linearità della metrica, non dal modello. Sostituendo l’accuratezza esatta con la distanza di edit, o con la log-verosimiglianza della risposta corretta, in molti casi l’emergenza svanisce.
Il dibattito non è chiuso, e conviene tenere distinte due affermazioni. Che gran parte delle curve «a salto» siano artefatti di misura è ormai ben argomentato. Che nessun cambiamento qualitativo avvenga con la scala è un’affermazione più forte e non dimostrata: fenomeni come l’in-context learning restano difficili da ridurre a un miglioramento puramente continuo.
La ricaduta pratica è però univoca, e riguarda chiunque valuti un modello: usare metriche continue quando si studia un andamento, e diffidare di qualunque grafico in cui una capacità «appare». La prima domanda da farsi è come è stata misurata.
In pratica: campionare con PyTorch#
Temperatura, top-k e top-p stanno in una funzione di venti righe. Non c’è nessun modello scaricato: i punteggi grezzi (i logit, cioè i punteggi che il modello assegna a ogni token del vocabolario prima di trasformarli in probabilità) sono scritti a mano, così resta in vista solo il meccanismo. Le operazioni sono quelle di prima, nell’ordine: la temperatura divide i logit, top-k e top-p tolgono i token fuori dal taglio, e infine si campiona.
import torch

def sample_next(logits, temperature=1.0, top_k=None, top_p=None):
    """Sceglie il prossimo token dai logits (tensore di forma [V])."""
    if temperature == 0:                       # caso limite: scelta greedy
        return int(torch.argmax(logits))

    logits = logits / temperature              # 1) temperatura

    if top_k is not None:                      # 2) top-k: solo i k migliori
        soglia = torch.topk(logits, top_k).values[-1]
        logits = logits.masked_fill(logits < soglia, float("-inf"))

    if top_p is not None:                      # 3) top-p: il nucleo
        ordinati, indici = torch.sort(logits, descending=True)
        probs_ord = torch.softmax(ordinati, dim=-1)
        cumulate = torch.cumsum(probs_ord, dim=-1)
        # fuori dal nucleo i token oltre la soglia (il migliore resta sempre)
        fuori = (cumulate - probs_ord) >= top_p
        ordinati[fuori] = float("-inf")
        logits = torch.full_like(logits, float("-inf")).scatter(0, indici, ordinati)

    probs = torch.softmax(logits, dim=-1)      # 4) di nuovo una distribuzione
    return int(torch.multinomial(probs, num_samples=1))

# --- l'esempio numerico del testo: muro, tetto, divano, pigiama ---
logits = torch.tensor([2.0, 1.0, 0.0, -2.0])
for T in (0.5, 1.0, 2.0):
    print(f"T={T}:", torch.softmax(logits / T, dim=-1).round(decimals=3))
T=0.5: tensor([0.8670, 0.1170, 0.0160, 0.0000])
T=1.0: tensor([0.6570, 0.2420, 0.0890, 0.0120])
T=2.0: tensor([0.4740, 0.2870, 0.1740, 0.0640])
Sono i numeri della tabella: a \(T = 0{,}5\) la distribuzione si concentra su «muro», a \(T = 2\) si appiattisce. E un mini-ciclo di generazione, con un «modello» giocattolo al posto di un vero Transformer: la struttura del loop è identica a quella reale.
import torch

torch.manual_seed(0)

vocab = ["il", "gatto", "nero", "salta", "sul", "muro",
         "tetto", "divano", "e", "poi", "dorme", "."]

def modello_giocattolo(sequenza):
    # un vero LLM restituirebbe qui i logits dell'ultima posizione;
    # noi generiamo logits riproducibili a partire dall'ultimo token
    g = torch.Generator().manual_seed(sequenza[-1])
    return torch.randn(len(vocab), generator=g)

sequenza = [vocab.index("il")]
for _ in range(8):
    logits = modello_giocattolo(sequenza)   # in un LLM vero: forward + KV cache
    prossimo = sample_next(logits, temperature=0.8, top_p=0.9)
    sequenza.append(prossimo)

print(" ".join(vocab[i] for i in sequenza))
# testo sgrammaticato, ovviamente: il "modello" è un generatore casuale.
# Ma il ciclo (forward, campiona, appendi, ripeti) è quello vero.
Sostituendo modello_giocattolo con un Transformer addestrato si ottiene il
ciclo di generazione di un modello linguistico, a parte la KV cache,
l’elaborazione di più richieste insieme e i criteri per fermarsi.
C’è però un ultimo tassello. Il modello che esce dal pretraining è un completatore, non un assistente: alla domanda «Qual è la capitale della Francia?» può rispondere «Qual è la capitale della Spagna? Qual è la capitale dell’Italia?», perché nel web le liste di domande abbondano, e completare la lista è probabile. Trasformare il completatore in un interlocutore che risponde, segue istruzioni e rifiuta le richieste dannose richiede una seconda fase di addestramento, con ricette proprie: è il post-training, e ha una sezione tutta sua.
Da ricordare
Un grande modello linguistico gioca il gioco di Shannon su scala industriale: coprire a turno ogni parola di una frase vera e provare a indovinarla, miliardi di volte, su una biblioteca raccolta dal web e ripulita. Nessuno gli corregge i compiti: la soluzione era già nel testo.
Più parametri, più testo da leggere e più ore di calcolo danno un modello migliore, e in modo prevedibile. Non all’infinito, però: sotto un certo punto non si scende, perché una quota dell’incertezza appartiene alla lingua stessa. Gli ingredienti, poi, vanno bilanciati, e la regola pratica è una ventina di pezzi di testo per ogni parametro, se si vuole spendere il meno possibile per addestrarlo; chi poi deve usare il modello moltissimo ne fa uno più piccolo e gli fa leggere di più. «Quanto è grande?», da sola, ha smesso di essere una domanda sensata.
Per scrivere, il modello non prende sempre la parola più probabile: verrebbe un testo noioso, che si incarta a ripetere sé stesso. Tira un dado, e tre manopole decidono quanto quel dado è truccato (la temperatura) e quante carte restano nel mazzo da cui pescare (il top-k e il top-p).
Il taccuino della KV cache evita di rileggere tutto da capo a ogni parola: gli appunti già presi restano in memoria. Si risparmia tempo e si paga in spazio, ed è uno dei motivi per cui le conversazioni lunghe costano.
Il prompt è un modo di programmare scrivendo: potente e fragile insieme. E i punteggi dei test vanno letti sapendo che un modello che ha studiato tutto il web potrebbe aver già visto le domande.
Quello che esce da tutto questo è un completatore di testo, non un assistente: per quello serve una seconda fase, il post-training.
Da ricordare
Un LLM gioca il gioco di Shannon su scala industriale: cross-entropia sul token successivo come unica supervisione, su corpora web filtrati e deduplicati (GPT-3: ~300 miliardi di token, 60% da Common Crawl).
Leggi di scala: la loss cala come una legge di potenza in parametri, dati e calcolo [KMH+20], dentro il regime misurato e sopra un termine irriducibile; il bilanciamento che minimizza il costo di addestramento è circa 20 token per parametro [HBM+22], e chi prevede di servire molte richieste addestra di proposito un modello più piccolo su più token. Sulle «capacità emergenti» il dibattito è aperto: prudenza.
Massimizzare la probabilità degenera in ripetizioni [HBD+20]: si campiona con temperatura (che scala i logit), top-k (i \(k\) token più probabili) e top-p (il nucleo che copre probabilità cumulata \(p\)).
La KV cache conserva key e value già calcolati: niente ricalcoli, ma memoria che cresce col contesto (~0,5 MB per token in un modello da 7 miliardi di parametri con una testa di chiave e valore per ogni testa di query, un quarto con GQA a otto gruppi); ecco perché i contesti lunghi costano. Oltre qualche decina di migliaia di token di contesto (circa \(6\,d_{\text{model}}\)), poi, il calcolo per token è fatto soprattutto di attenzione.
Il prompt è programmazione in linguaggio naturale: potente e fragile insieme. I benchmark vanno letti col sospetto della contaminazione dei dati di test.
Il pretraining produce un completatore, non un assistente: per quello serve il post-training.
Prima del post-training, però, un’idea architetturale che la scala rende interessante. Crescere conviene, ma per scrivere una sola parola il modello la moltiplica, piano dopo piano, per tutti i suoi parametri, e più i parametri sono tanti più ogni parola costa. A meno di far passare ogni parola solo per una parte dei parametri, che è l’idea della sezione sui modelli a esperti.