


La forchetta che non c’era#
Apparecchia mezzo tavolo: un piatto, un coltello alla sua destra, un bicchiere. Fotografa e chiedi a un modello che vede e parla che cosa c’è sul tavolo. È probabile che nella risposta compaia anche una forchetta, magari «a sinistra del piatto», con la stessa calma con cui il modello ha nominato il bicchiere. La forchetta non c’è, e non c’è mai stata.
Il primo istinto è chiamarlo un errore di percezione, come una macchia sul sensore o un riflesso scambiato per un oggetto. Il più delle volte è una lettura fuorviante, e fermarsi lì porta a cercare la soluzione nel posto sbagliato. Il modello non ha visto male: ha scritto bene. Nelle didascalie del mondo, accanto a un piatto e a un coltello, una forchetta c’è spesso, e chi è addestrato a continuare frasi plausibili la scrive perché la frase, senza, sarebbe meno plausibile.
Quello che il modello si aspetta di leggere prima di guardare la fotografia è il priore linguistico: la distribuzione sulle parole successive condizionata soltanto al testo già scritto, \(p_\theta(y_t \mid y_{<t})\), «priore» perché viene prima dell’immagine e indipendentemente da essa. Perché vinca così spesso sull’evidenza visiva, come si misura e che cosa lo contiene sono le tre domande che seguono.
Un errore che non nasce solo negli occhi#
L’apertura del capitolo ha già dato un nome al fenomeno, allucinazione visiva, e ne ha mostrato la radice principale: la perdita che l’addestramento fa scendere premia chi indovina le parole, e chi indovina bene impara a fare a meno di guardare. La forma precisa dell’argomento dice anche dove si può intervenire.
La tastiera del telefono, dopo «a domani e buona», propone «serata». Non sa che cosa stai per dire: sa come vanno a finire le frasi, e sbaglia così di rado che smettiamo di accorgercene. Un modello che descrive una fotografia fa esattamente quel mestiere, con una differenza sola: fra i suggerimenti che gli arrivano c’è anche l’immagine. L’immagine però è un suggerimento, non un padrone; se è sfocata, se l’angolo del tavolo è tagliato fuori, se la forchetta ci starebbe benissimo, il suggerimento debole perde e vince l’abitudine, quella che chi studia questi modelli chiama priore linguistico.
Facciamo un conto ipotetico, per capire quanto sia conveniente l’abitudine. Mettiamo che su cento fotografie in cui compare un coltello, in ottanta ci sia anche una forchetta. Un modello che non guarda affatto e risponde sempre «sì, c’è la forchetta» ne azzecca ottanta su cento. Per battere quel punteggio guardando davvero bisogna fare meglio dell’ottanta per cento, e nessuno gliel’ha chiesto: l’addestramento premia la risposta media giusta, e la risposta media giusta si ottiene anche a occhi chiusi. Guardare non è vietato, è semplicemente facoltativo.
E l’abitudine parte avvantaggiata. Le frasi la tastiera le macina da anni; la telecamera gliel’hanno attaccata ieri, e il filo fra le due è nuovo di zecca, per cui all’inizio, con ogni probabilità, non guardare costa poco. Poi c’è il materiale su cui ha imparato. Molte descrizioni delle fotografie le ha scritte un altro programma, che aveva davanti due righe di didascalia e non la foto; lì, dove leggeva «tavola apparecchiata», ha messo piatto, coltello e forchetta. Quella forchetta era lì prima di ogni domanda.
Un modello con connettore [LLWL23] ottimizza la cross-entropia autoregressiva \(\mathcal{L}(\theta) = -\sum_t \log p_\theta\big(y_t \mid y_{<t}, E(\mathbf{I})\big)\), dove \(y_t\) è il token al passo \(t\), \(\mathbf{I}\) l’immagine ed \(E\) l’encoder visivo con il suo connettore. Il termine dentro il logaritmo si scompone in modo istruttivo:
dove il primo addendo è ciò che il modello direbbe a occhi chiusi. L’identità è algebrica e vale sempre; le etichette dei due addendi chiedono un’ipotesi in più. La rete interrogata senza immagine non calcola il marginale vero \(\mathbb{E}_{\mathbf{I}}\big[p_\theta(y_t \mid y_{<t}, E(\mathbf{I}))\big]\): è un altro percorso di calcolo, mai addestrato a marginalizzare. Nella misura in cui lo approssima, il primo addendo stima il priore linguistico e il secondo la mutua informazione puntuale fra il token e l’immagine, dato il prefisso. Per predittori ottimi la riduzione della perdita che il condizionamento sull’immagine produce è esattamente la mutua informazione condizionata \(\mathcal{I}(Y_t; \mathbf{I} \mid Y_{<t})\), dove le maiuscole sono i token visti come variabili aleatorie: dove la didascalia è già prevedibile dal solo testo, quella quantità è piccola, e con essa il gradiente che spinge il percorso visivo a servire a qualcosa.
Il punto di partenza dell’ottimizzazione può aggravare lo sbilanciamento. Il priore arriva già formato da un pre-addestramento testuale enormemente più lungo, mentre il connettore è inizializzato a caso e vale, come si è visto, qualche milione di parametri contro i miliardi del modello di linguaggio. Una ragione plausibile, da verificare caso per caso, è che a pre-addestramento testuale concluso la perdita sia già bassa senza l’immagine, e che il segnale che spinge il percorso visivo a servire a qualcosa resti debole dove la didascalia è prevedibile dal solo testo. (A connettore inizializzato a caso, del resto, l’immagine entra come rumore, ed è per questo che il primo tempo dell’addestramento muove il connettore soltanto.)
C’è infine un contributo che nasce nei dati stessi. I corpora di istruzione visiva generati da un modello di solo testo a partire da didascalie e riquadri (la ricetta discussa in Innestare gli occhi) contengono affermazioni che il generatore non poteva verificare, in una quota che si misura: nei 158 000 esempi del primo LLaVA, secondo l’analisi automatica di HalluciDoctor, il 28% delle frasi nomina un oggetto che nell’immagine non c’è [YLW+24]. Il bersaglio della massima verosimiglianza è già popolato di forchette inventate.
La radice è quella delle allucinazioni testuali, le «risposte fluenti e sbagliate» che la sezione sulle famiglie di modelli ha già riconosciuto come conseguenza dell’obiettivo, e che la sezione LLMOps metterà fra le cose da sorvegliare in un modello in servizio. Con un’aggravante e un’attenuante. L’aggravante è che qui una fonte di verità c’era, allegata alla richiesta, e il modello l’ha ignorata. L’attenuante, se così si può chiamare, è che proprio perché quella fonte esiste il fenomeno è misurabile: su una domanda di storia bisogna andare a controllare i libri, su una fotografia la risposta giusta è nella fotografia.
Il guaio di correggere un tema#
Misurabile in linea di principio, però, non vuol dire facile. Chiedi a un modello «descrivi questa immagine», ottieni sei righe, e prova a dare un voto. Quale parola è sbagliata? Se il testo dice «un tavolo apparecchiato con piatto, coltello e forchetta, pronto per il pranzo», l’errore è una parola su dodici, ma per accorgersene bisogna prima decidere quali parole sono affermazioni sul mondo e poi verificarle una a una.
La via classica è del 2018 e si chiama CHAIR [RHB+18], le iniziali di Caption Hallucination Assessment with Image Relevance, cioè una misura di quanto le didascalie allucinano rispetto a ciò che l’immagine contiene. Si fissa un elenco chiuso di categorie di oggetti e si cercano quelle parole nel testo generato, con una tabella di sinonimi e di plurali. Poi si contano due rapporti. Il primo guarda gli oggetti, uno per uno (la \(i\) sta per instance): fra tutti quelli nominati, quanti non c’erano, \(\mathrm{CHAIR}_i = \lvert\{\text{oggetti nominati e assenti}\}\rvert / \lvert\{\text{oggetti nominati}\}\rvert\). Il secondo guarda le descrizioni (la \(s\) sta per sentence): fra tutte, quante nominano almeno un oggetto che non c’era, \(\mathrm{CHAIR}_s = \lvert\{\text{descrizioni con almeno un oggetto assente}\}\rvert / \lvert\{\text{descrizioni}\}\rvert\). «Assente» vuol dire fuori dall’elenco di quel che c’è nella fotografia, scritto a mano da chi le ha preparate (nel lavoro originale, le 80 categorie di COCO). Se un modello scrive dieci descrizioni che nominano in tutto quaranta oggetti, e quattro di questi non ci sono, sparsi in tre descrizioni, il primo rapporto vale \(4/40 = 0{,}10\) e il secondo \(3/10 = 0{,}30\). Il secondo di solito è il più severo, perché basta una forchetta a bocciare tutta la descrizione; non sempre, perché una descrizione che inventa tre oggetti pesa tre volte nel primo e una volta sola nel secondo. Funziona, è stata la prima misura del campo, ed è il capostipite della famiglia che guarda quel che il modello scrive di sua iniziativa invece di interrogarlo. Porta però con sé quattro fragilità che non si possono togliere.
La prima: vede solo gli oggetti dell’elenco, quindi un colore sbagliato, un conteggio sbagliato, una relazione spaziale rovesciata sono invisibili. La seconda: dipende dalla completezza delle annotazioni, e un oggetto che c’è davvero ma che nessuno ha annotato viene contato come allucinazione. La terza: cercare parole dentro un testo libero è un metodo approssimativo, che va bene in media e sbaglia sui casi atipici, perché inciampa sulle negazioni («non c’è nessuna forchetta» contiene la parola «forchetta») e sui riferimenti generici. E la quarta: il punteggio dipende da cose che con l’immagine non c’entrano, cioè da come è formulata la richiesta e da quanto è lunga la descrizione che ne esce, perché più si scrive più si rischia di sbagliare. È l’obiezione che muovono gli autori di POPE [LDZ+23], e che li ha portati a cambiare strada.
Il risultato è una misura che si muove per ragioni che con l’immagine non c’entrano. Chiedi al modello una descrizione più lunga e il punteggio peggiora; cambia il modo di chiedere e cambia di nuovo, senza che il modello sia cambiato di una virgola. È la cosa peggiore che si possa avere in mano quando si vuole stabilire se un fenomeno esista. La via d’uscita non è un analizzatore migliore. È cambiare la domanda.
Una domanda con due sole risposte#
L’impostazione che ha reso il problema trattabile è quella di POPE [LDZ+23] (le iniziali di Polling-based Object Probing Evaluation, cioè una valutazione che tasta gli oggetti a forza di domande): non si chiede più al modello di descrivere, gli si chiede «c’è una forchetta in questa immagine?» e si accetta solo sì o no. La risposta è una parola sola, la verità sta nell’elenco di quel che c’è, e nessun giudice deve interpretare niente. È la ragione per cui il protocollo esiste. L’alternativa sarebbe mettere a correggere un secondo modello di linguaggio (il modello giudice, l’LLM-as-a-judge di cui parlerà la sezione su LLMOps), e un secondo modello si porta dietro i propri difetti proprio là dove si vuole misurarne uno.
Il cuore del metodo, però, sta in come si scelgono gli oggetti assenti, più che nel formato binario. Chiedere «c’è una zebra?» davanti a una cucina non misura niente.
Un esame si fa facile o difficile decidendo che cosa chiedere. Qui si risponde soltanto sì o no, e la difficoltà sta tutta nell’oggetto assente su cui si interroga. I modi sono tre.
Il primo: peschi un oggetto a caso dall’elenco delle categorie. «C’è una zebra?» davanti a un tavolo apparecchiato è una domanda regalata: nessuna abitudine spinge verso il sì.
Il secondo: peschi gli oggetti che nelle fotografie compaiono più spesso in assoluto. «C’è una persona?» è già più insidiosa, perché nelle immagini raccolte dal web una persona c’è quasi sempre, e il modello lo ha imparato.
Il terzo, il più cattivo: peschi l’oggetto che va di solito insieme a quelli che ci sono davvero. Davanti al piatto e al coltello, «c’è una forchetta?». Qui l’abitudine spinge con tutta la sua forza, ed è esattamente la spinta che vogliamo misurare.
La cosa importante viene alla fine: non si guarda un punteggio, se ne guardano tre, e si guarda quanto scendono passando dalla domanda regalata a quella cattiva. Quella discesa non racconta quanto il modello sia bravo. Racconta a quale abitudine si sta appoggiando.
Sia \(\mathcal{O}\) l’insieme delle categorie annotate nel corpus e \(\mathcal{O}(\mathbf{I}) \subseteq \mathcal{O}\) quelle presenti nell’immagine \(\mathbf{I}\). Le domande positive si estraggono da \(\mathcal{O}(\mathbf{I})\), quelle negative da \(\mathcal{O} \setminus \mathcal{O}(\mathbf{I})\) secondo tre distribuzioni:
dove \(\hat{p}(o)\) è la frequenza marginale della categoria \(o\) nel corpus e \(\hat{p}(o \mid o')\) la sua frequenza condizionata alla presenza di \(o'\); nelle ultime due si prendono i primi \(k\) candidati in ordine di punteggio anziché campionare, con \(k\) pari al numero di domande negative che tocca all’immagine. Le tre condizioni mettono alla prova separatamente due priori diversi, quello marginale e quello condizionato alla co-occorrenza, più un controllo. Il divario fra le accuratezze nelle tre condizioni è una stima di quanto ciascun priore stia guidando la risposta.
Tre proprietà del disegno lo rendono una misura e non un sondaggio. L’insieme è bilanciato, metà domande con risposta sì e metà con risposta no, così che entrambe le strategie degeneri si collochino al livello del caso in accuratezza. La risposta è un token, quindi il confronto con la verità è esatto e riproducibile. E accanto alle metriche si riporta la quota di sì, \(\hat{\rho} = \frac{1}{n}\sum_{i} \mathbb{1}[\hat{y}_i = \text{sì}]\), che è il vero strumento diagnostico: un \(\hat{\rho}\) lontano da \(0{,}5\) dice che il modello non sta rispondendo alla domanda, sta esprimendo una disposizione.
Accanto ai punteggi delle tre condizioni serve sempre un altro numero, la quota di sì: su tutte le domande fatte, quante volte il modello ha risposto «sì». Perché non sia un ornamento si vede facendo i conti su un test bilanciato di tremila domande, millecinquecento su oggetti presenti e millecinquecento su oggetti assenti.
import numpy as np

# Un test bilanciato: 1500 domande su oggetti presenti, 1500 su oggetti assenti.
verita = np.array([1] * 1500 + [0] * 1500)      # 1 = l'oggetto c'e' davvero


def pagella(risposte):
    """(accuratezza, F1, quota di si') di un modello su questo test."""
    vp = ((risposte == 1) & (verita == 1)).sum()   # dice si', e c'e'
    fp = ((risposte == 1) & (verita == 0)).sum()   # dice si', e non c'e'
    fn = ((risposte == 0) & (verita == 1)).sum()   # dice no, e invece c'e'
    precision = vp / (vp + fp)
    recall = vp / (vp + fn)
    f1 = 2 * precision * recall / (precision + recall)
    accuratezza = (risposte == verita).mean()
    return (round(float(accuratezza), 3), round(float(f1), 3),
            round(float((risposte == 1).mean()), 3))


def guarda_davvero(a):
    """Modello che risponde correttamente a una frazione a di ciascuna classe."""
    giuste = round(1500 * a)
    return np.concatenate([
        np.array([1] * giuste + [0] * (1500 - giuste)),      # sui presenti
        np.array([0] * giuste + [1] * (1500 - giuste)),      # sugli assenti
    ])


print("dice sempre si':      ", pagella(np.ones(3000, dtype=int)))
print("guarda, sbaglia molto:", pagella(guarda_davvero(0.60)))
print("guarda bene:          ", pagella(guarda_davvero(0.90)))
dice sempre si':       (0.5, 0.667, 1.0)
guarda, sbaglia molto: (0.6, 0.6, 0.5)
guarda bene:           (0.9, 0.9, 0.5)
Il primo modello risponde sempre «sì»: non guarda mai, e sbaglia una domanda su due, perché azzecca tutte le millecinquecento domande sugli oggetti che ci sono e sbaglia tutte le millecinquecento su quelli che non ci sono. E succede davvero: nel protocollo originale, con gli assenti scelti a caso, LLaVA e MultiModal-GPT rispondevano «sì» nel \(98{,}8\%\) e nel \(99{,}9\%\) dei casi, con un’accuratezza vicina a \(0{,}5\) e una F1 vicina a \(0{,}667\) [LDZ+23]. L’accuratezza, su un test bilanciato, mette i modelli nell’ordine giusto (\(0{,}5\) contro \(0{,}6\)); eppure la F1, il punteggio con cui di solito si riassumono queste prove, premia chi dice sempre sì, perché ignora le risposte «no» corrette. È la F1 delle metriche di classificazione, fatta di due numeri che qui tirano in direzioni opposte. La recall è la quota di oggetti presenti che il modello ha riconosciuto: chi dice sempre «sì» non se ne lascia sfuggire nemmeno uno, quindi prende il massimo, \(1\). La precision è la quota di volte in cui, avendo detto «sì», aveva ragione: qui una su due, cioè \(0{,}5\). La F1 non è la loro media normale, che darebbe \(0{,}75\): è la media che tira verso il più piccolo, il doppio del prodotto diviso la somma, \(2 \cdot 1 \cdot 0{,}5 / (1 + 0{,}5) = 0{,}667\). Un modello che guarda davvero ma sbaglia due volte su cinque, sia sulle domande a cui va risposto sì sia su quelle a cui va risposto no, si ferma a \(0{,}60\): meno.
Un modello che dell’immagine non ha usato un pixel, a leggere la sola F1, si metterebbe in classifica sopra a chi guarda davvero e sbaglia due volte su cinque. La quota di sì scioglie l’equivoco in un colpo: \(1{,}0\) contro \(0{,}5\), e il primo dei due non sta rispondendo, sta ripetendo sempre la stessa cosa.
Il protocollo ha tre limiti. Il primo: si misura l’esistenza degli oggetti, e nient’altro; un colore sbagliato, un conteggio sbagliato, una relazione rovesciata restano invisibili. Il secondo: poiché la misura è pubblica e la strategia per migliorarla è nota, un modello istruito a dire «no» più spesso guadagna punti senza aver guadagnato un grammo di vista, e la quota di sì lo smaschera soltanto se chi legge se la va a guardare. È la legge di Goodhart, quella per cui una misura, appena diventa un obiettivo, smette di misurare ciò che misurava, e vale qui come altrove.
Il terzo è il più facile da dimenticare, perché riguarda il confine fra le due misure e non i loro difetti. Domandare non è far descrivere: qui si misura se il modello acconsente a un oggetto che non c’è, non se lo nomina scrivendo di sua iniziativa. Sono due grandezze diverse, non due letture della stessa, e la seconda è precisamente quella con cui la sezione si è aperta, il tavolo con la forchetta. Un modello può rispondere «no, non c’è nessuna forchetta» a chi glielo chiede e continuare a metterla in tutte le sue descrizioni: per accorgersene serve ancora una misura sul testo generato, con tutta la sua rumorosità. Le due si leggono insieme, e nessuna delle due sostituisce l’altra.
Chi controlla il controllore#
C’è un piano superiore della stessa domanda, e non porlo sarebbe disonesto. Abbiamo chiesto: il modello ha davvero guardato? E abbiamo risposto con un protocollo di misura. Ma anche il protocollo può rispondere senza aver guardato.
Di un compito in classe gira da mesi la fotocopia con le soluzioni: i voti alti non dicono più chi ha studiato, dicono chi ha visto la fotocopia. In questo campo è successo, ed è documentato. Le prove con cui si misurano questi sistemi sono pubbliche, stanno sul web, e sul web questi sistemi si addestrano: domande e risposte finiscono nel materiale di studio insieme a tutto il resto.
C’è anche un secondo difetto, più banale e forse peggiore: molte domande si possono indovinare senza guardare la fotografia. Queste prove, a differenza delle domande a cui si risponde sì o no, sono a crocette, e la risposta sta spesso nella domanda stessa, nelle alternative proposte accanto («che animale c’è nella foto? a) un cane, b) una sedia, c) un tavolo, d) una nuvola») o in cose che chiunque sa del mondo.
Per fortuna il controllo che li scopre tutti e due è il più semplice che si possa immaginare: rifare l’esame togliendo l’immagine. Quello che il modello porta a casa a occhi chiusi è quello che non ha imparato guardando. E per sapere quale dei due difetti si ha davanti, quel voto si mette accanto a quello di un compagno che ha letto gli stessi libri e non ha mai fatto il corso con le fotografie: se il modello bendato batte quel compagno, la fotocopia è girata anche a lui. Chi pubblica un punteggio senza aver riportato anche quello sta chiedendo di essere creduto sulla parola.
Il fenomeno è stato quantificato da chi ha costruito MMStar [CLD+24], ed è di ampiezza tale da rendere non interpretabili molti punteggi pubblicati. I due meccanismi sono distinti. Il primo è la risolvibilità dal solo testo: un modello di solo linguaggio fra i più forti, interrogato senza ricevere alcuna immagine, batte la scelta casuale di oltre venti punti in media su sei benchmark generalisti, perché la risposta si ricava dalla domanda, dalle opzioni o dalla conoscenza del mondo che il modello ha già. Il secondo è la fuga di dati: un modello ottiene \(43{,}6\%\) su un benchmark multimodale senza immagini, cioè \(17{,}9\) punti sopra il proprio modello di linguaggio di base valutato senza esempi, un indizio di memorizzazione più che di deduzione; con due esempi nel prompt lo scarto scende a \(8{,}5\), e la stima della fuga dipende quindi dal protocollo. Da qui le due misure che gli autori propongono, il guadagno multimodale (quanto si perde togliendo l’immagine) e la fuga multimodale (quanto il sistema completo, interrogato anche lui senza immagini, supera il proprio modello di linguaggio di base: se lo supera, il di più viene dai dati di addestramento multimodali, non dal guardare).
Il caso è aggravante proprio per un protocollo come quello appena descritto, che poggia sulle annotazioni di un corpus fotografico pubblico, cioè su un corpus che sta nella miscela di addestramento di quasi ogni sistema di cui si vuole misurare l’allucinazione. Qui serve cautela: che quel corpus sia nella miscela è noto, che questo gonfi i punteggi è un rischio documentato altrove e non una misura pubblicata su questo protocollo. Il rimedio resta comunque quello, e costa una riesecuzione: riportare il punteggio a immagine tolta accanto a quello ordinario. È la stessa mossa che fra poco troveremo fra i rimedi in decodifica (confrontare la risposta a occhi aperti con quella a occhi chiusi), portata dalla generazione alla valutazione.
Il difetto viene da più a monte#
Fin qui abbiamo trattato il priore linguistico come un concorrente troppo forte. Ma c’è un secondo pezzo del meccanismo, e sta prima: a volte l’informazione che avrebbe permesso di rispondere non è arrivata affatto.
Due gemelli sono identici, se non per un neo piccolissimo sulla guancia di uno dei due. Chi li guarda da lontano li vede uguali: il neo c’è, e da vicino si vedrebbe, ma è così piccolo che chi guarda non ci fa caso, e nessuno gli ha mai detto che proprio lì stava la differenza. Se poi gli chiedi «quale dei due è Marco?», dovrà tirare a indovinare, e tirerà a indovinare secondo l’abitudine, perché non ha altro.
Lo sguardo da lontano, qui, è l’encoder della prima sezione, quello addestrato sulle didascalie del web. Si possono trovare, e si sono trovate, coppie di fotografie che una persona distingue in mezzo secondo (un animale girato a destra e lo stesso girato a sinistra, una scarpa allacciata e la stessa slacciata) e che quell’encoder vede quasi identiche: somiglianza sopra \(0{,}95\), su una scala che arriva a \(1\). Un secondo osservatore, addestrato sulle sole immagini e senza aver mai visto una didascalia, mette le stesse due foto sotto \(0{,}6\): per lui sono due cose diverse. La differenza non sta nella fotografia, sta in chi la guarda, e non è sfortuna: chi ha imparato dalle didascalie tiene quello che le didascalie nominano, e il verso in cui è girato un animale le didascalie non lo dicono quasi mai. (Coppie così non capitano per caso: i ricercatori le hanno pescate apposta, tenendo solo quelle in cui il primo osservatore diceva «quasi uguali» e il secondo «diverse».)
Ed ecco il punto che chiude il cerchio: quando l’encoder distingue troppo poco, il modello di linguaggio non risponde «non lo so». Riempie il buco con quello che di solito è vero. Il punto cieco non produce silenzio, produce allucinazione.
Il lavoro di Tong e colleghi [TLZ+24] costruisce coppie cieche in modo operativo: due immagini \(\mathbf{I}_1, \mathbf{I}_2\) tali che
dove \(E_{\text{CLIP}}\) è la torre visiva di un modello contrastivo [RKH+21], \(E_{\text{SSL}}\) un encoder auto-supervisionato di sola visione, e i vettori sono normalizzati, così che il prodotto scalare sia un coseno. La seconda condizione garantisce che la differenza esista nei pixel; la prima, che sia scomparsa nell’embedding. Da queste coppie si ricavano domande a cui una persona risponde quasi sempre correttamente, e gli errori si raggruppano in nove famiglie ricorrenti: orientamento e direzione, presenza di un dettaglio, stato e condizione di un oggetto, quantità e conteggio, posizione e relazione spaziale, colore e aspetto, caratteristiche fisiche e strutturali, testo scritto, punto di vista e prospettiva.
Perché a valle non si recuperi si adduce di solito un argomento informazionale, che da solo non basta. Il decoder vede soltanto \(\mathbf{Z} = E(\mathbf{I})\), quindi la catena \(\mathbf{I} \to \mathbf{Z} \to Y\) è markoviana e per qualunque risposta \(Y\) vale la disuguaglianza dell’elaborazione dei dati, \(\mathcal{I}(Y; \mathbf{I}) \le \mathcal{I}(\mathbf{Z}; \mathbf{I})\), dove \(\mathcal{I}\) è la mutua informazione: addestrando ciò che viene dopo non si aggiunge informazione sull’immagine. Vero, e qui inoffensivo. L’encoder è una funzione deterministica e le due immagini della coppia hanno coseno \(0{,}95\), cioè embedding distinti. (Una precisazione sull’oggetto: il coseno \(0{,}95\) è misurato sull’embedding globale dell’immagine, mentre un modello con connettore riceve la griglia delle feature di patch del penultimo strato, che di solito differiscono di più; il legame fra le due cose è empirico, perché gli stessi modelli sbagliano sulle domande costruite da quelle coppie.) Finché \(E\) è iniettivo, \(\mathcal{I}(\mathbf{Z}; \mathbf{I}) = H(\mathbf{I})\), con \(H\) l’entropia dell’immagine (finita, perché i pixel sono già quantizzati), e un limite pari a tutta l’informazione disponibile non vieta niente a nessuno. La disuguaglianza morderebbe se l’encoder mandasse le due immagini nello stesso punto, che non è ciò che il lavoro citato osserva.
Il limite vero è di margine, non di informazione, ed è più istruttivo. La differenza fra le due immagini sopravvive nell’embedding, ma lungo una direzione di norma ridotta (con vettori unitari e coseno \(0{,}95\) la distanza è \(\sqrt{2(1 - 0{,}95)} \approx 0{,}32\), e la soglia è un minimo: molte coppie sono più vicine), che nulla, in addestramento, ha mai chiesto al decoder di leggere. Se \(g\) è il decoder ed è lipschitziano di costante \(L\), allora \(\lVert g(\mathbf{z}_1) - g(\mathbf{z}_2) \rVert \le L \lVert \mathbf{z}_1 - \mathbf{z}_2 \rVert\): con \(\mathbf{z}_1 \approx \mathbf{z}_2\) le due risposte partono costrette a somigliarsi, mentre le risposte corrette sono opposte. Non è una dimostrazione di impossibilità, perché \(L\) non viene maggiorato e per una rete profonda è enorme; è la constatazione che quella distinzione la troverebbe solo chi la cercasse, e che il modello non la cerca, mentre il priore linguistico lo spinge a rompere il pareggio in un altro modo. Chi volesse l’affermazione informazionale in senso forte deve introdurre del rumore, che nei sistemi veri c’è (quantizzazione, precisione ridotta, augmentation in addestramento): allora \(\mathcal{I}(\mathbf{Z}; \mathbf{I})\) cala davvero e la disuguaglianza torna a mordere. In tutti i casi, punto cieco a monte e allucinazione a valle sono un difetto e la sua manifestazione.
È lo stesso limite della prima sezione, visto dall’altro lato. Là, dal lato del testo, il gioco dell’abbinamento chiedeva solo di distinguere la didascalia vera da quelle di altre fotografie prese a caso, e per vincerlo bastava riconoscere gli oggetti: da qui il comportamento a sacchetto di parole, che tratta la frase come un mucchio di parole senza ordine. Qui, dal lato dell’immagine, vale la conseguenza speculare: se un tratto della fotografia non serve mai a fare quella scelta, buttarlo via non costa niente, e l’addestramento, che non ha motivo di conservare un tratto da cui la perdita non dipende, lo butta. Il verso in cui è girato un animale, quanti oggetti ci sono, un particolare minuto sono precisamente i tratti da cui la didascalia di un’altra fotografia non dipende mai. È un solo difetto, visto dai due lati.
Il rimedio a monte è coerente con la diagnosi: se un encoder addestrato sulle didascalie perde ciò che le didascalie non nominano, gli si affianca un secondo encoder addestrato sulle sole immagini e si uniscono le due descrizioni. Il come cambia il conto e il risultato. Si possono combinare i due vettori di ogni tessera sommandoli o concatenandoli, e la sequenza resta lunga uguale: nelle prove di Tong e colleghi la fusione fa salire il punteggio sulle coppie cieche (da \(5{,}5\) a \(18{,}7\) con tre parti su quattro di encoder di sola visione), ma fa scendere la capacità di seguire le istruzioni da \(81{,}8\) a \(75{,}8\). Oppure si mettono in fila i token dei due encoder, alternandoli e tenendo l’ordine delle tessere, il che conserva le istruzioni e porta il punteggio a \(16{,}7\), al prezzo di \(512\) token invece di \(256\) [TLZ+24], cioè del costo di contesto che la sezione Il costo del dettaglio ha calcolato. In tutti i casi restano due encoder da far girare invece di uno, e il problema si sposta invece di sparire.
Rimedi, e nessuna cura#
Le contromisure che hanno un senso meccanico si distribuiscono su tre punti della catena: l’addestramento, il momento in cui la risposta si scrive, la risposta già scritta. Sull’addestramento si agisce in più modi (ancorando la risposta alle coordinate, ripulendo i dati di istruzione [YLW+24], ottimizzando le preferenze fra risposte con e senza oggetti inventati); qui se ne segue uno per punto, e con il secondo encoder, che lavora ancora più a monte, i punti diventano quattro. Fig. 19.6 li mette sulla stessa catena da cui il difetto viene.
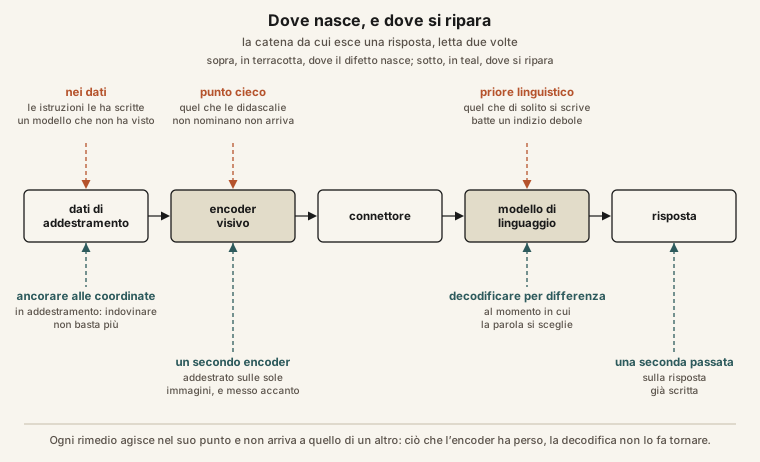
Fig. 19.6 La stessa catena letta due volte. Sopra i tre posti in cui il difetto nasce, sotto i quattro in cui si può intervenire. Leggerla serve soprattutto a non sbagliare rimedio: una distinzione che l’encoder ha già buttato via non la riporta indietro nessuna correzione fatta più a valle.#
Ancorare la risposta a ciò che si vede. Invece di chiedere al modello che cosa c’è, gli si chiede anche dove: il nome dell’oggetto accompagnato dalle quattro coordinate del riquadro che lo contiene, scritte nella stessa risposta. I quattro numeri sono le coordinate di due angoli opposti del rettangolo, l’alto a sinistra e il basso a destra, misurate in frazioni di immagine: zero a un bordo, uno al bordo opposto. I due lavori di riferimento li scrivono in modi opposti. Kosmos-2 [PWD+23] divide l’immagine in una griglia e dà a ogni cella un simbolo nuovo, aggiunto all’elenco da cui il modello pesca, così che un riquadro si scrive con due simboli, la cella dell’angolo in alto a sinistra e quella dell’angolo in basso a destra: è il gesto del mosaicista con il suo catalogo, applicato alla posizione. Shikra [CZZ+23] scrive invece le coordinate come numeri decimali dentro la frase, come li scriverebbe una persona.
Per il nostro problema la differenza conta poco: «una forchetta» l’abitudine della lingua te la regala, «una forchetta in \(0{,}42\), \(0{,}31\), \(0{,}55\), \(0{,}60\)» no, perché quei quattro numeri dall’abitudine non si ricavano, o se ne ricava pochissimo. In uscita, l’effetto è che l’affermazione diventa verificabile: chi legge può andare a guardare quel rettangolo. In addestramento l’effetto è più profondo, e riguarda il gradiente, cioè il segnale che corregge i pesi: sbagliare le coordinate costa, e per un oggetto piccolo e sparso come una forchetta indovinarle per abitudine non si può, quindi la perdita scende in modo apprezzabile solo passando per l’immagine. Per un oggetto grande e quasi sempre nello stesso posto, come un tavolo, una parte delle coordinate si indovina già dal priore.
Decodificare per differenza. Il secondo rimedio non tocca i pesi: cambia come si sceglie il token.
Il trucco è fare la stessa domanda due volte: la prima guardando la fotografia, la seconda guardando la stessa fotografia rovinata di proposito, coperta di disturbo finché non ci si distingue quasi più niente. Poi si tiene solo la differenza. Per brevità diremo «a occhi aperti» e «a occhi chiusi», ma nel secondo caso gli occhi restano socchiusi e non chiusi del tutto, perché l’immagine c’è ancora, solo che è illeggibile. (Qualcuno la toglie del tutto, ed è la variante più radicale dello stesso gesto.)
Se «forchetta» risulta probabile in entrambi i casi, quella parola non viene dalla foto: viene dall’abitudine, e allora la si penalizza. Se «coltello» è probabile solo a occhi aperti, quella parola l’ha vista davvero, e la si premia. In pratica si parte dal giudizio a occhi aperti e gli si toglie una dose di quello che il modello direbbe comunque: quanto è grande la dose lo decide una manopola.
Una precauzione serve, altrimenti il trucco si rivolta: sottraendo senza freni si finisce per premiare parole assurde, che a occhi chiusi erano improbabilissime e a occhi aperti solo un po’ meno. Il rimedio è restringere la scelta in partenza alle parole che a occhi aperti valgono almeno un decimo della più probabile: dentro quel gruppo ristretto si confronta, fuori non si guarda. E il conto da pagare è semplice: due letture invece di una, quindi il doppio del tempo per ogni parola scritta.
Restano due modi di farsi male. Se si spinge forte sulla sottrazione sparisce anche la forchetta delle tavole in cui la forchetta c’è davvero, e si è barattato un errore con un altro. E se l’encoder, guardando da lontano, le due cose non le aveva separate, chiedere due volte non le separa: la differenza rimescola le parole in classifica, non aggiunge un pixel.
Detti \(\ell_\theta\) i logit del modello, \(\mathbf{x}\) il prompt testuale, \(\mathbf{I}\) l’immagine e \(\mathbf{I}'\) la stessa immagine degradata (nel lavoro citato con il rumore gaussiano del processo diretto di diffusione, aggiunto finché la scena non è più riconoscibile; varianti successive contrastano invece con l’assenza dell’immagine), la decodifica contrastiva visiva [LZC+24] sceglie il token successivo secondo
ristretto all’insieme dei candidati plausibili
dove \(\alpha \ge 0\) regola la forza della correzione e \(\beta \in (0,1)\) (in pratica intorno a \(0{,}1\)) è la soglia di plausibilità che impedisce alla sottrazione di promuovere token del tutto improbabili. La differenza dei due logit è, a meno delle costanti di normalizzazione, proprio il contributo visivo isolato nella scomposizione della perdita: si sta decodificando sulla log-probabilità a occhi aperti corretta da \(\alpha\) volte una stima della mutua informazione puntuale, \(\ell_\theta(y_t \mid \cdot, \mathbf{I}) + \alpha\,\big[\ell_\theta(y_t \mid \cdot, \mathbf{I}) - \ell_\theta(y_t \mid \cdot, \mathbf{I}')\big]\), che si riduce alla sola mutua informazione soltanto al limite \(\alpha \to \infty\), con la stessa approssimazione di allora, resa qui ancora più larga quando \(\mathbf{I}'\) è un’immagine degradata e non l’assenza dell’immagine.
I limiti seguono dalla stessa lettura. È una toppa in decodifica: non aggiunge informazione, ridistribuisce quella che c’è. Nel lavoro originale, su LLaVA-1.5 e sulle immagini di COCO, l’accuratezza su POPE sale di circa quattro punti e mezzo con gli assenti scelti a caso (\(83{,}3 \to 87{,}7\)), di tre e mezzo con quelli frequenti e di meno di due con quelli che co-occorrono (\(79{,}0 \to 80{,}9\)): il guadagno è minimo proprio dove il priore è più forte. Se la distinzione che serve è già scomparsa in \(E(\mathbf{I})\), contrastare con \(E(\mathbf{I}')\) non la fa ricomparire: la correzione sposta massa di probabilità fra token, non restituisce una dimensione che l’encoder ha collassato. E con \(\alpha\) grande si penalizza tutto ciò che è al contempo vero e atteso, cioè anche la forchetta nelle foto in cui la forchetta c’è: si scambia un tipo di errore con l’altro.
Fig. 19.7 mostra il meccanismo su un vocabolario giocattolo di sei parole.

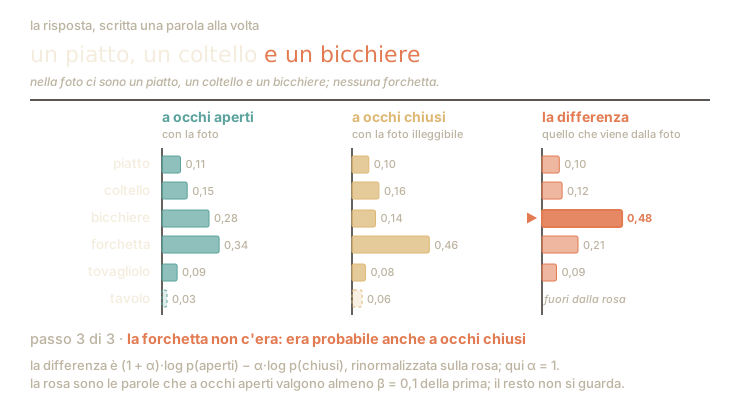
Fig. 19.7 Il rimedio visto nel tempo: a ogni parola due letture, una sottrazione e una scelta. Al terzo passo «forchetta» guida tutte e due le letture, ed è proprio questo a condannarla: quello che il modello direbbe comunque non viene dall’immagine. In fondo al disegno, la formula del rimedio: il logaritmo della probabilità a occhi aperti, rafforzato, meno quello a occhi chiusi. I numeri sono un esempio giocattolo: qui si sottrae per intero quel che il modello direbbe a occhi chiusi, e si guardano solo le parole che a occhi aperti valgono almeno un decimo della prima (la «rosa» del disegno).#
Una seconda passata. Il terzo rimedio prende la risposta già scritta, la scompone in affermazioni elementari («c’è un piatto», «c’è una forchetta», «la forchetta è a sinistra del piatto») e verifica ciascuna con l’immagine in mano, riscrivendo o togliendo quelle che non passano [YFZ+23]. Per gli oggetti le domande di verifica sono quelle di POPE allargate al conteggio («c’è una forchetta? quante?»), e risponde un rilevatore di oggetti, un programma addestrato a trovare e incorniciare gli oggetti in una foto; per gli attributi sono aperte («di che colore è?»), e risponde un modello addestrato a rispondere a domande sulle immagini. Il protocollo di valutazione diventa così un componente del sistema. Il costo è il tempo di risposta (la latenza), che cresce con il numero di affermazioni da controllare; e il difetto è più insidioso, perché se a verificare è un modello della stessa famiglia, si porta dietro lo stesso priore, e può confermare con entusiasmo l’errore che avrebbe dovuto smascherare. Il rimedio funziona nella misura in cui il secondo controllo è indipendente dal primo: un rilevatore di oggetti, un programma che li ritaglia sapendo riconoscere anche categorie che non erano nel suo elenco, oppure una persona.
Nessuno dei rimedi elimina il fenomeno, perché il fenomeno è la conseguenza di come i modelli si addestrano. Finché la funzione di costo premia la continuazione plausibile e l’immagine è soltanto uno dei dati da cui la risposta dipende, il priore resta la strada più economica verso una perdita bassa. I rimedi spostano il punto di equilibrio, rendono le affermazioni controllabili, rendono più caro dire ciò che si direbbe comunque, mettono un secondo paio di occhi. Riducono, non curano. È la domanda che tornerà nella sezione su privacy e robustezza, posta qui a un sistema che vede: quanto è fragile, davvero, una volta messo nel mondo. E un sistema che comanda una mano la rende meno accademica.
Dalla percezione all’azione#
Se un sistema sa mappare pixel e istruzioni in parole, niente gli impedisce di mappare pixel e istruzioni in azioni, a una condizione: che le azioni si possano scrivere. E scriverle si può, con il gesto già fatto due volte, per i pezzi d’immagine e per le coordinate dei riquadri: si taglia una grandezza continua in gradini e si dà un nome a ogni gradino.
Un braccio robotico riceve sette numeri: di quanto spostare la mano nelle tre direzioni dello spazio, di quanto ruotarla nei tre versi, quanto stringere la pinza. Sono numeri continui, e un modello che scrive parole sa soltanto scegliere una voce da un elenco. Allora si taglia ciascun numero in 256 gradini, come le tacche di un righello, e si dà a ogni gradino un nome preso in prestito dal vocabolario, fra le parole che non si usano quasi mai.
Da quel momento «sposta la mano di un centimetro in avanti» è una parola, e produrre un movimento è la stessa identica operazione che produrre una frase: scegliere sette parole di fila. Si riusano i pezzi di prima, l’encoder che guarda, il connettore che traduce, il modello che scrive; cambia soltanto che cosa c’è scritto nell’elenco finale. E mentre impara a muoversi continua a leggere fotografie e frasi come faceva prima, per cui può eseguire un ordine che in nessuna dimostrazione ha mai visto: che cosa sia una banana non gliel’ha insegnato il robot.
Il prezzo si legge sul righello. Quanto farlo lungo lo dicono le dimostrazioni raccolte, buttando via l’uno per cento più esagerato a ciascun capo: un solo strattone finito lì per sbaglio stirerebbe il righello e allontanerebbe le tacche per tutti. Se la mano si può spostare al massimo di cinque centimetri per volta, in avanti o all’indietro, il righello è lungo dieci centimetri: i 256 gradini se li dividono, e distano meno di quattro decimi di millimetro l’uno dall’altro. Il braccio esegue sempre il gradino più vicino a quel che gli è stato detto, quindi sbaglia al massimo di mezzo gradino: due decimi di millimetro, che vanno benissimo per afferrare una tazza e molto meno per infilare un ago.
Sia \(\mathbf{a} \in \mathbb{R}^{7}\) l’azione (tre componenti di traslazione, tre di rotazione, una per l’apertura della pinza), a cui si aggiunge un indicatore binario di fine episodio. Ogni componente \(j\) viene discretizzata in \(B = 256\) gradini uniformi fra \(a_j^{\min}\) e \(a_j^{\max}\), e l’indice del gradino diventa un token: se il vocabolario ha già un simbolo per ogni intero fino a mille lo si riusa così com’è, altrimenti si sovrascrivono le 256 voci meno frequenti. La politica è allora
dove \(k_1\) è il token dell’indicatore \(e\) di fine episodio (RT-2 lo mette per primo, e l’ordine conta, perché ogni token è condizionato ai precedenti), \(k_2, \dots, k_8\) sono i token dei gradini delle sette componenti, \(\mathbf{I}\) l’osservazione ed \(\mathbf{x}\) l’istruzione in lingua naturale. È la fattorizzazione autoregressiva dei grandi modelli linguistici, vista nella pagina sui grandi modelli linguistici, applicata a una sequenza lunga otto, con la stessa cross-entropia come perdita. È l’impostazione di RT-2 [BBC+23], che addestra il modello in co-fine-tuning su una miscela di traiettorie robotiche e di dati visione-linguaggio del web: le traiettorie insegnano a muoversi, il resto della miscela impedisce al modello di dimenticare quel che sapeva, ed è la ragione per cui un’istruzione mai comparsa in nessuna dimostrazione può comunque essere eseguita, dato che il significato delle parole viene da altrove. OpenVLA [KPK+24] riprende la discretizzazione di RT-2 in una versione aperta e più piccola, con sette token per azione e senza indicatore di fine, addestrata soltanto su traiettorie robotiche (970 000 dimostrazioni, nessun dato del web nell’ottimizzazione: se aggiungerli aiuti, gli autori lo lasciano come domanda aperta), con due accorgimenti da isolare. Gli estremi \(a_j^{\min}\) e \(a_j^{\max}\) non sono il minimo e il massimo osservati ma i quantili all’1% e al 99% delle azioni di addestramento, perché un solo campione anomalo allargherebbe la scala e sprecherebbe i gradini. E l’encoder visivo concatena per canali le feature di un modello contrastivo e di uno auto-supervisionato di sola visione, una scelta della stessa famiglia del rimedio dei due encoder affiancati: gli autori la motivano con il ragionamento spaziale, e trovano che fare il fine-tuning dell’encoder visivo, invece di congelarlo, sia cruciale per il dettaglio fine.
La discretizzazione sta in poche righe, e il codice serve soprattutto a rendere visibile che cosa il braccio esegua davvero, che quasi mai è esattamente l’azione richiesta: è il centro del gradino più vicino.
import numpy as np

np.set_printoptions(precision=4, suppress=True)

# Sette gradi di liberta': 3 di traslazione (metri), 3 di rotazione (radianti),
# 1 per l'apertura della pinza. Gli estremi sono i quantili all'1% e al 99%
# delle dimostrazioni, non il minimo e il massimo.
basso = np.array([-0.05, -0.05, -0.05, -0.20, -0.20, -0.20, 0.0])
alto  = np.array([ 0.05,  0.05,  0.05,  0.20,  0.20,  0.20, 1.0])

N_BIN = 256           # i gradini del righello
PRIMO = 32000 - 256   # gli ultimi 256 identificativi di un vocabolario da 32.000


def in_token(a):
    """Da un'azione continua a sette identificativi di token."""
    frazione = (np.clip(a, basso, alto) - basso) / (alto - basso)   # in [0, 1]
    return PRIMO + np.minimum((frazione * N_BIN).astype(int), N_BIN - 1)


def in_azione(token):
    """E ritorno: il centro del gradino, l'unica cosa che il braccio esegue."""
    frazione = (token - PRIMO + 0.5) / N_BIN
    return basso + frazione * (alto - basso)


a = np.array([0.012, -0.004, 0.021, 0.05, -0.11, 0.0, 1.0])
print(in_token(a))                    # i sette identificativi
print(in_azione(in_token(a)))         # l'azione che il braccio esegue davvero
print((alto - basso) / (2 * N_BIN))   # mezzo gradino: l'errore massimo
[31902 31861 31925 31904 31801 31872 31999]
[ 0.0119 -0.0041  0.0209  0.0508 -0.1102  0.0008  0.998 ]
[0.0002 0.0002 0.0002 0.0008 0.0008 0.0008 0.002 ]
L’ultima riga è l’errore massimo dell’arrotondamento a gradini, che è mezzo gradino: due decimi di millimetro sulla traslazione, meno di un millesimo di radiante sulla rotazione, cioè meno di un ventesimo di grado. È un limite noto e accettabile. I difetti che non si liquidano con un numero sono altri tre, e stanno tutti fra il video di una dimostrazione e un impianto che lavora.
Il primo è la frequenza. Nel lavoro che nel 2023 ha introdotto questa ricetta [BBC+23] un modello da decine di miliardi di parametri, servito da un gruppo di acceleratori remoti, emetteva fra uno e tre comandi al secondo e, sceso a qualche miliardo, circa cinque; un controllore classico ne emette decine o centinaia. Finché il compito è afferrare e spostare va bene, per un movimento che deve reagire in fretta no. La dimensione del modello però non è tutto: OpenVLA, con sette miliardi di parametri, gira a circa sei comandi al secondo su una sola scheda grafica, e lavori successivi hanno moltiplicato i comandi al secondo a parità di modello, generando più azioni insieme a blocchi (26 volte il ritmo di prima, nel 2025 [KFL25]), oppure cambiando il modo di trasformare le azioni in token, perché la discretizzazione uniforme, gradino per gradino e istante per istante, regge male i movimenti fini ad alta frequenza [PSI+25]. Altri ancora hanno abbandonato i token di azione per un’uscita continua, generata con il flow matching, e comandano fino a cinquanta volte al secondo [BBD+25].
Il secondo è come si sbaglia. Una parola sbagliata si rilegge, e il peggio che capita è che qualcuno la creda. Un movimento sbagliato è già avvenuto, ha spostato un oggetto vero e magari lo ha rotto; non esiste un pulsante «rigenera». Un impianto industriale ragiona in tassi di guasto che si contano in parti per milione, mentre i sistemi di questa famiglia riportano, sui compiti provati, tassi di successo che nel lavoro su OpenVLA, nel 2024, restano di norma sotto il \(90\%\).
Il terzo sono i dati. Le traiettorie non si raccolgono dal web: ognuna richiede un robot vero e una persona che lo guida, e la scala che si raggiunge è lontanissima dai miliardi di token del testo. E qui la generalizzazione cambia natura. Cambiare robot cambia la relazione fra il comando e il movimento, e la regola con cui il modello decide che cosa fare (la sua politica) non si trasferisce come si trasferisce un prompt. È un problema vicino al sim-to-real, lo scarto fra simulazione e mondo fisico, ma distinto: qui la differenza è fra due robot veri, e nessuna quantità di didascalie la colma. È anche la ragione per cui il capitolo sui world model, cioè i modelli che si costruiscono una copia mentale del mondo, è il vicino di casa naturale di un robot che impara: provare in quella copia costa meno che provare sul robot vero.
Resta il fatto che il meccanismo è di una economia notevole. Non c’è un’architettura per l’azione: c’è la stessa macchina di tutto il capitolo, con un vocabolario un po’ più largo. E c’è, insieme, il motivo per cui l’azione sta in coda all’allucinazione e non altrove: un sistema che allucina una forchetta scrive una parola di troppo, lo stesso sistema che comanda una mano allucina un movimento.
Quattro mosse, e una diffidenza#
Sotto la sua pipa Magritte aveva scritto che quella non era una pipa, e chi guardava il quadro capiva al volo il salto fra il disegno, la cosa e la parola. Per una macchina quel salto dipende da dove si incontrano i due flussi. Allineare due spazi senza fonderli, cioè mandare le foto e le frasi sulla stessa mappa, dà un modello che cerca e non parla; e uno spazio allineato non è uno spazio che capisce. Innestare un occhio su un modello che sa già parlare dà un modello che conversa, e fra i modelli aperti si è diffusa la saldatura più povera, perché comprimere significa scegliere prima di conoscere la domanda. Fondere all’ingresso, in un vocabolario solo, dà un modello che produce, al prezzo di un pre-addestramento da rifare o da estendere a lungo e di un arrotondamento a catalogo che perde parte dell’informazione. Pagare il dettaglio è il conto che presenta la risoluzione, dove ogni pixel in più si trasforma in posto occupato nella sequenza.
E infine diffidare, che non è una quinta tecnica ma la disposizione da tenere davanti alle altre quattro: chiedersi non soltanto dove i due flussi si sono incontrati, ma se si sono incontrati davvero, o se il modello sta parlando di una fotografia che non ha guardato.
Da ricordare
La forchetta che non c’era viene dall’abitudine della lingua che vince sulla fotografia, e si chiama allucinazione visiva. Nelle didascalie del mondo, accanto a un piatto e a un coltello, una forchetta c’è spesso, e chi è addestrato a scrivere frasi plausibili la scrive. Guardare resta facoltativo.
Dare un voto a sei righe di descrizione è rumoroso: bisogna decidere quali parole sono affermazioni sul mondo e poi controllarle una a una. La via che funziona è cambiare la domanda: si chiede «c’è una forchetta?» e si accetta solo sì o no.
Le domande difficili sono quelle sull’oggetto che di solito accompagna quelli presenti, non quelle a caso («c’è una zebra?»). Non si guarda un punteggio: se ne guardano tre e si guarda quanto scendono, perché quella discesa misura l’abitudine e non la bravura.
Il voto va letto insieme a quante volte il modello ha detto sì: chi dice sempre sì sbaglia una domanda su due e ottiene comunque, nel voto che si usa di solito, un punteggio migliore di chi guarda davvero e sbaglia due volte su cinque. E succede davvero: alcuni modelli veri dicevano sì quasi sempre.
Una parte del guaio viene da prima, da chi guarda: esistono coppie di fotografie che una persona distingue in un istante e che l’encoder vede quasi uguali, come due gemelli visti da lontano. La differenza c’è ancora, come il neo, ma è così piccola che nessuno ha mai insegnato al modello a cercarla; e lui, invece di dire «non lo so», riempie il buco con l’abitudine.
Tre rimedi a valle, nessuna cura: farsi dire anche dove (le coordinate l’abitudine non le regala, o quasi), chiedere due volte e tenere la differenza fra occhi aperti e occhi chiusi, far ricontrollare la risposta da qualcuno di indipendente; e a monte un secondo encoder che guarda da vicino. Riducono, non eliminano.
Gli stessi pezzi comandano un braccio: si taglia ogni comando in 256 gradini come le tacche di un righello e ogni gradino diventa una parola, così muoversi è scrivere. Restano il passo del righello, i pochi comandi al secondo (che modi più furbi di generare le azioni stanno già moltiplicando), i dati che nessuno regala sul web, e il fatto che una mossa sbagliata è già avvenuta.
Da ricordare
L’allucinazione visiva non è soltanto un errore di percezione: la perdita si scompone in un priore linguistico più un contributo visivo, e dove la didascalia è già prevedibile dal testo il gradiente che spinge a guardare è debole. Guardare resta facoltativo, e i dati di istruzione generati possono già contenere oggetti inventati.
Le due misure sono costrutti diversi, non due letture della stessa grandezza. CHAIR [RHB+18] conta gli oggetti allucinati in una descrizione libera (generativo, rumoroso, sensibile all’istruzione e alla lunghezza); POPE [LDZ+23] misura a che cosa il modello acconsente su domande binarie, con gli assenti scelti a caso, per frequenza o per co-occorrenza: il divario fra le tre condizioni misura il priore, non la bravura. Si leggono insieme.
Il test va bilanciato e letto con la quota di sì: un modello che risponde sempre «sì» non guarda mai e ottiene comunque una F1 di \(0{,}667\), più di un modello che guarda davvero e sbaglia due volte su cinque (\(0{,}60\)), mentre l’accuratezza li ordina nel modo giusto. Nel protocollo originale LLaVA diceva sì nel \(98{,}8\%\) dei casi.
Anche il benchmark può rispondere senza aver guardato: molte domande sono risolvibili dal solo testo e i test pubblici finiscono nei corpora di addestramento [CLD+24], anche se la stima della fuga dipende dal protocollo. Il controllo che costa meno di tutti è rieseguire la prova a immagine tolta e riportare il divario.
Una parte del difetto è a monte: esistono coppie di immagini con embedding contrastivi quasi identici (coseno oltre \(0{,}95\)) che un encoder di sola visione separa nettamente [TLZ+24]. La differenza sopravvive, ma con un margine così sottile che nulla, in addestramento, ha insegnato al decoder a leggerlo: il modello rompe il pareggio con il priore. È il limite composizionale della prima sezione [RKH+21] visto dal lato dell’immagine.
Tre rimedi a valle, nessuna cura: ancorare la risposta alle coordinate (che il priore indovina poco, tranne per gli oggetti grandi e fissi), decodificare per differenza fra la distribuzione con l’immagine e quella con l’immagine degradata (trattenuta da una soglia di plausibilità, e con guadagni minimi proprio dove il priore è più forte), una seconda passata di verifica (utile solo se indipendente); a monte, un secondo encoder di sola visione, a un prezzo in token o in capacità di seguire le istruzioni. Riducono, non eliminano.
Discretizzando i comandi di un robot in 256 gradini per grado di libertà, l’azione diventa una sequenza di token e tutta la macchina del capitolo si riusa [BBC+23], [KPK+24]. Restano il passo di quantizzazione, la frequenza di controllo (pochi hertz nei primi modelli, molti di più generando le azioni a blocchi o in forma continua), i dati che non si raccolgono dal web, e un modello di errore in cui la mossa sbagliata è già avvenuta.
L’azione si può scrivere, e chi scrive azioni sbaglia come sbaglia chi scrive parole, cioè con sicurezza e senza accorgersene. Quello che qui nessuno fa è il resto del mestiere: decidere quando è il momento di agire, mettere in fila le mosse di un lavoro lungo, tenere il conto di che cosa si è già provato. Comincia da lì il capitolo sugli agenti.