


Dalla softmax alla ricorrenza#
Le reti ricorrenti che i Transformer hanno sostituito non pagavano nessuno dei due conti dell’attenzione, né il lavoro che cresce come \(O(n^2)\) nel numero \(n\) dei token né la KV cache che si allunga a ogni token generato: leggevano in sequenza, a costo lineare, con uno stato di dimensione fissa. Le si era abbandonate per un difetto altrettanto grave, la sequenzialità: ogni passo aspetta il precedente, e le GPU, fatte per eseguire molti conti insieme, durante l’addestramento restano in gran parte ferme. La domanda è se si possano avere le due cose: il parallelismo dei Transformer quando il modello impara, e il costo fisso per token delle reti ricorrenti quando scrive. La risposta parte da un’osservazione algebrica elementare sulla somiglianza fra query e chiave, un raccoglimento a fattor comune.
Il trucco del kernel: una somiglianza che si scompone#
L’ostacolo sta nella softmax, e più precisamente nel suo esponenziale. Per calcolare l’attenzione si misura quanto ogni parola somiglia a ogni altra, con il punteggio \(\mathbf{q}_i^\top\mathbf{k}_j\) fra la query dell’una e la chiave dell’altra, e la softmax ne prende l’esponenziale prima di normalizzare: ne esce una tabella con una riga e una colonna per ciascuna parola, mille parole e un milione di caselle. A imporre la tabella è la forma di quella somiglianza. La funzione \(\exp(\mathbf{q}_i^\top\mathbf{k}_j)\) non si scompone in un fattore che dipende soltanto dalla query e in uno che dipende soltanto dalla chiave, quindi ogni casella va calcolata per la propria coppia. La normalizzazione, cioè la divisione per la somma della riga che trasforma i punteggi in pesi, non c’entra: la si conserva anche senza tabella, con un secondo accumulatore.
La via d’uscita è cambiare la misura di somiglianza: ne serve una che si scomponga in un fattore dipendente solo dalla query e in uno dipendente solo dalla chiave, \(\phi(\mathbf{q})^\top\phi(\mathbf{k})\). Una misura così si chiama kernel, come nelle SVM, cioè una funzione che dà un numero per ogni coppia di vettori; con il filtro delle reti convoluzionali e con il programma che gira sulla GPU ha in comune soltanto il nome. Con un kernel che si scompone il prodotto fra matrici si può ri-associare, e il numero di operazioni scende da \(O(n^2 d)\) a \(O(n d^2)\), con \(d\) la dimensione di query e chiavi.
Mille persone in una sala, una per ogni parola della frase, e ognuna ha qualcosa da dire alle altre. Farle parlare tutte con tutte sono \(499\,500\) conversazioni, contando una volta sola ogni coppia; la tabella per segnarle ha un milione di caselle, perché ogni persona ha la sua riga e la sua colonna, sé stessa compresa. Il costo esplode perché quanto io do retta a te nasce dall’incontro fra me e te: quel numero non esiste finché non ci siamo visti.
Cambiamo la regola. All’ingresso ognuno riceve due cartellini con un numero ciascuno, uno da mostrare quando ascolta e uno da mostrare quando parla, e da lì in poi quanto io do retta a te è il numero del mio cartellino d’ascolto per quello del tuo cartellino da oratore. Il peso si spezza in due, un pezzo mio e uno tuo, e per conoscerlo non serve più incontrarsi.
Anna, Bruno e Carla hanno da dire tre numeri: \(2\), \(5\) e \(3\). Davide li ascolta, e con la vecchia regola doveva incontrarli uno per uno; dagli incontri uscivano tre pesi diversi, poniamo \(1\), \(6\) e \(8\), e il suo totale era \(1\times 2 + 6\times 5 + 8\times 3\): tre conversazioni, tre caselle della tabella grande. Con i cartellini, invece, Anna e Bruno parlano con il cartellino \(1\), Carla con il \(3\), e Davide ascolta con il \(3\): i suoi pesi sono \(3\), \(3\) e \(9\), e il totale è \(3\times 2 + 3\times 5 + 9\times 3 = 48\). Lo stesso \(48\) si ottiene in un altro ordine. Chi parla moltiplica prima quello che ha da dire per il proprio cartellino da oratore (Anna e Bruno consegnano \(2\) e \(5\), Carla \(3\times 3 = 9\)), e Davide moltiplica la somma per il suo cartellino d’ascolto: \(3\times(2+5+9) = 3\times 16 = 48\). È il raccoglimento a fattor comune di seconda media. E quel \(16\) non dipende da chi ascolta: chi ascolta col cartellino \(7\) farà \(7\times 16\), chi col \(4\) farà \(4\times 16\).
Allora il \(16\) si calcola una volta sola. All’ingresso c’è un registro, che è lo stato di taglia fissa: chi entra ci somma il proprio contributo, sempre nelle stesse caselle, e chi vuole farsi un’idea non gira più per la sala, legge il totale e lo moltiplica per il proprio cartellino d’ascolto. Le persone restano mille, il registro è uno solo, e lo si aggiorna una volta per ciascuna: mille aggiornamenti invece di mezzo milione di conversazioni. Scrivere sul registro costa quante sono le sue caselle, ma quel costo resta lo stesso man mano che la sala si riempie: raddoppia la gente e raddoppiano gli aggiornamenti, mentre le conversazioni diventerebbero quattro volte tante.
I numeri sui cartellini possono essere piccolissimi, mai negativi: se no chi entra toglierebbe dal registro quello che gli altri ci hanno scritto, invece di aggiungercisi. E c’è un secondo conto da tenere. I pesi di Davide (\(3\), \(3\) e \(9\)) devono diventare le fette di una torta, che messe insieme fanno la torta intera, come faceva la softmax: per questo accanto al registro sta un secondo foglio, più corto, dove chi entra somma soltanto il proprio cartellino da oratore, \(1 + 1 + 3 = 5\). Davide moltiplica anche quello per il suo \(3\), trova \(15\), che è il totale dei suoi pesi, e divide: \(48 / 15 = 3{,}2\). Quello che esce è una media pesata di ciò che i tre avevano da dire (\(2\), \(5\) e \(3\)), e non una somma che si gonfia man mano che entra gente. Se il cartellino d’ascolto di Davide valesse zero, anche il secondo foglio moltiplicato per lui darebbe zero, e per zero non si può dividere: è lì che il meccanismo si pianta. E a zero ci si arriva anche senza volerlo: un cartellino piccolissimo, scritto con le poche cifre che la macchina tiene, diventa zero.
Un modo di misurare la somiglianza che si spezza così, un pezzo per chi ascolta e uno per chi parla, in matematica si chiama kernel, la stessa parola delle SVM, dove dice quanto due punti si somigliano. Il trucco però va al rovescio: là il kernel serviva a non costruire mai lo spazio sollevato, qui i cartellini si scrivono davvero.
Nell’attenzione dei Transformer [VSP+17] l’uscita (non normalizzata) per la query \(i\) è una somma dei value pesati dalla somiglianza esponenziale \(\exp(\mathbf{q}_i^\top \mathbf{k}_j)\), con il fattore di scala \(1/\sqrt{d}\) assorbito in query e chiavi. Il guaio è che quell’esponenziale non si spezza: non esiste una fattorizzazione esatta a dimensione finita in un prodotto di una funzione della sola \(\mathbf{q}_i\) per una funzione della sola \(\mathbf{k}_j\). Lo si vede riscrivendolo come
cioè, a meno di due fattori che dipendono ciascuno da un solo argomento, il kernel gaussiano delle SVM con \(\gamma = 1/2\), la cui feature map ha infinite componenti. In pratica la si può solo approssimare con un numero finito di componenti: è la strada delle random features del Performer [CLD+21]. Restando esatti, quindi, l’esponenziale va valutato per ogni coppia \((i,j)\): la matrice \(n \times n\). La normalizzazione della softmax, invece, non obbliga a niente: è una somma per riga, che si può accumulare a parte e applicare in fondo.
L’idea di Katharopoulos e colleghi [KVPF20] è sostituire la somiglianza con una che si spezza, cioè un prodotto scalare fra versioni trasformate di query e key:
dove \(\phi\) è una feature map applicata a ciascun vettore, riga per riga sulle matrici di query e chiavi. In generale è una \(\phi: \mathbb{R}^d \to \mathbb{R}^C\), che può cambiare dimensione: \(C\) è la dimensione dello spazio di feature ed è un parametro libero (il Performer, per dire, ne sceglie 256 di random features), e da essa dipende la taglia della memoria. Il nome trucco del kernel va letto al rovescio rispetto alla SVM: là il kernel trick evita di costruire \(\phi\), perché \(k(\mathbf{x},\mathbf{z}) = \phi(\mathbf{x})^\top\phi(\mathbf{z})\) si calcola direttamente sulle coordinate originali; qui il kernel esatto è proprio ciò che impedisce di riordinare il conto, e la \(\phi\) esplicita, di dimensione finita, si costruisce e si calcola davvero. Con questa scelta l’uscita per la query \(i\) diventa
dove i passaggi sono tre: il prodotto scalare è simmetrico, quindi \(\phi(\mathbf{q}_i)^\top \phi(\mathbf{k}_j) = \phi(\mathbf{k}_j)^\top \phi(\mathbf{q}_i)\); uno scalare si può spostare a destra del vettore \(\mathbf{v}_j\); e a quel punto è l’associatività del prodotto a permettere di raccogliere \(\phi(\mathbf{q}_i)\) fuori dalla somma su \(j\), che si stacca dalla query e si condensa in un’unica matrice \(\mathbf{S} = \sum_j \mathbf{v}_j\, \phi(\mathbf{k}_j)^\top \in \mathbb{R}^{d_v\times C}\) (lo stato, una memoria chiave→valore). Qui \(\mathbf{q}_i, \mathbf{k}_j, \mathbf{v}_j\) sono i vettori query, key e value del token e \(d_v\) è la dimensione del value. Da qui in avanti, per semplicità, assumiamo key, query e value della stessa dimensione \(d\) e una \(\phi\) che non cambia dimensione (\(C = d\)), così che lo stato sia una \(d \times d\): è il caso della feature map che sceglieremo fra poco, ma non il caso generale.
Le due strade hanno costi diversissimi. Calcolare tutti i prodotti \(\phi(\mathbf{q}_i)^\top \phi(\mathbf{k}_j)\) è la matrice \(n \times n\), costo \(O(n^2 d)\); costruire \(\mathbf{S}\) una volta e applicarla a ogni query costa \(O(n d^2)\): una matrice \(d \times d\) al posto di una \(n \times n\). Quando \(n \gg d\) (sequenze lunghe), la seconda vince nettamente, ed è il passaggio da \(O(n^2 d)\) a \(O(n d^2)\), cioè da quadratico a lineare nella lunghezza (lo stesso \(O(n d^2)\) delle ricorrenti che avevamo incontrato nel confronto fra Transformer e RNN). In forma matriciale compatta, per tutte le query insieme, è l’identità
la stessa \(\text{softmax}(\mathbf{Q}\mathbf{K}^\top)\mathbf{V}\) del capitolo sui Transformer con \(\phi(\mathbf{Q})\,\phi(\mathbf{K})^\top\) al posto dell’esponenziale dei punteggi e senza normalizzazione: senza l’esponenziale il prodotto si può ri-associare, e si calcola prima \(\phi(\mathbf{K})^\top \mathbf{V}\), la matrice piccola. Una nota sulla convenzione: qui i token stanno sulle righe di \(\mathbf{Q}\), \(\mathbf{K}\) e \(\mathbf{V}\), quindi la matrice piccola \(\phi(\mathbf{K})^\top \mathbf{V}\) è \(d \times d_v\), cioè \(\mathbf{S}^\top\) e non \(\mathbf{S}\).
Resta da scegliere \(\phi\). Serve una feature map che dia somiglianze positive (perché i pesi si comportino come quelli di una media), e Katharopoulos et al. propongono la più semplice che funzioni:
applicata componente per componente e sempre maggiore di zero. Lo è in
aritmetica esatta: per \(x<0\) vale \(\exp(x)\), ma il calcolo passa da \(-1 +
\exp(x)\), e in float32 quella somma arrotonda a \(-1\) appena \(\exp(x)\) scende
sotto \(2^{-25}\), cioè da \(x = -25\ln 2 \approx -17{,}33\) in giù. Da lì \(\phi\) è
zero esatto, e un denominatore che si azzera è il modo tipico in cui questa
implementazione si rompe. La softmax aveva anche un denominatore che
normalizzava i pesi: lo si conserva come un secondo accumulatore \(\mathbf{z} =
\sum_j \phi(\mathbf{k}_j)\), e la lettura normalizzata diventa \(\mathbf{o}_i =
\mathbf{S}\,\phi(\mathbf{q}_i) \,/\, \big(\mathbf{z}^\top
\phi(\mathbf{q}_i)\big)\).
L’attenzione lineare è una RNN#
Fin qui le parole erano tutte disponibili insieme. Nella generazione vale una condizione in più: ogni token vede soltanto quelli che lo precedono, e l’attenzione si dice causale. Allora non c’è più un’unica matrice \(\mathbf{S}\), calcolata alla fine, ma una successione \(\mathbf{S}_t\), in cui ogni token aggiunge il proprio contributo a quanto accumulato dai precedenti, e le dimensioni restano quelle. Uno stato che si aggiorna così, un passo alla volta e a partire da com’era al passo prima, è una ricorrenza: il nome delle reti che i Transformer avevano mandato in pensione.
A una riunione lunga si prendono appunti in due modi.
Il primo è la KV cache dei Transformer: ogni volta che qualcuno parla, aggiungi uno scontrino alla pila. Non butti via niente, e questo è comodo (hai tutto) ma la pila cresce, e a fine giornata occupa mezzo tavolo. Ogni parola nuova ne aggiunge un’altra.
Il secondo è un foglio-registro di dimensione fissa. Non aggiungi scontrini: aggiorni le stesse caselle. Quando qualcuno parla, sommi il suo contributo a ciò che c’è già scritto, e il foglio resta un foglio: sempre lo stesso, che tu sia alla decima o alla decimillesima parola. Per rispondere a una domanda leggi il foglio, non rovisti nella pila. Il foglio, però, non ricorda chi ha parlato per primo: \(2 + 5\) fa \(7\) come \(5 + 2\), e l’ordine degli interventi resta soltanto se qualcuno l’ha scritto dentro quello che dice.
L’attenzione lineare tiene esattamente questo foglio. Ecco perché la memoria non cresce: qualunque sia la lunghezza del testo, il foglio (negli articoli si chiama stato) ha sempre le stesse dimensioni. È il ritorno, sotto mentite spoglie, della vecchia idea delle reti ricorrenti.
Basta riscrivere \(\mathbf{S}\) come somma cumulativa fino al passo \(t\):
e la lettura al passo \(t\) usa lo stato corrente:
Qui \(\mathbf{S}_t \in \mathbb{R}^{d\times d}\) è lo stato, una memoria chiave→valore che a ogni passo incassa il prodotto esterno \(\mathbf{v}_t\, \phi(\mathbf{k}_t)^\top\) (scrivi il value \(\mathbf{v}_t\) sotto l’etichetta \(\phi(\mathbf{k}_t)\)); \(\mathbf{z}_t\) è il normalizzatore che accumula le key trasformate; \(\mathbf{o}_t\) è l’uscita. Leggere con \(\phi(\mathbf{q}_t)\) significa \(\mathbf{S}_t \phi(\mathbf{q}_t) = \sum_{i\le t} \big(\phi(\mathbf{k}_i)^\top\phi(\mathbf{q}_t)\big)\, \mathbf{v}_i\): la query ripesca dai value in proporzione a quanto la sua etichetta somiglia a ciascuna key già scritta.
Il normalizzatore \(\mathbf{z}_t\) di Katharopoulos fa della lettura una media pesata, di cui \(\mathbf{z}_t^\top \phi(\mathbf{q}_t)\) è il denominatore, ed è per lui che serve la positività di \(\phi\): con pesi positivi il denominatore non cambia segno e non si annulla. I lavori successivi lo abbandonano. Schlag e colleghi lo giudicano instabile, perché è una somma di termini positivi che cresce a ogni passo, e normalizzano invece per somma le chiavi e le query trasformate [SIS21]; le architetture più recenti eliminano il denominatore e mettono una normalizzazione sull’uscita. Senza denominatore la positività non serve più: la lettura \(\mathbf{S}_t\,\phi(\mathbf{q}_t)\) è una combinazione lineare dei value, con pesi \(\phi(\mathbf{k}_i)^\top\phi(\mathbf{q}_t)\) che possono avere segno, e la scala la riporta la normalizzazione in uscita. È la scelta di RetNet e di GLA, che pongono \(\phi\) uguale all’identità [SDH+23, YWS+24], ed è quella delle formule da qui in avanti: \(\phi\) assorbita nelle proiezioni che producono query e chiavi, e nessun \(\mathbf{z}_t\).
Guardiamo bene questa ricorrenza. È esattamente una RNN, ma con due differenze rispetto alle celle dei modelli di sequenza. La prima: lo stato non è un vettore \(\mathbf{h}_t\) ma una matrice \(\mathbf{S}_t\) (una memoria molto più capiente). La seconda, decisiva: la transizione di stato è lineare, anzi è l’identità (\(\mathbf{S}_{t-1}\) passa intatto, gli si somma soltanto un termine nuovo). Non c’è nessuna \(\tanh\) o non-linearità sullo stato, come invece in \(\mathbf{h}_t = \tanh(\mathbf{W}_{hh} \mathbf{h}_{t-1} + \dots)\). L’aggiornamento costa \(O(d^2)\) per token e la memoria è costante: la matrice \(d \times d\) non cambia dimensione, sia al decimo sia al milionesimo token.
È il senso, volutamente ironico, del titolo del paper di Katharopoulos et al., Transformers are RNNs [KVPF20]: sotto una certa scelta della somiglianza, un Transformer è una rete ricorrente; solo che se n’era dimenticato.
Una conseguenza dell’accumulo puro: come l’attenzione senza codifiche posizionali, lo stato \(\mathbf{S}_t=\sum_{i\le t}\mathbf{v}_i\,\phi(\mathbf{k}_i)^\top\) non dipende dall’ordine dei token passati, perché la somma è commutativa. L’ordine entra solo se è già scritto nei vettori \(\mathbf{q}\) e \(\mathbf{k}\) (con una codifica posizionale, o con una convoluzione corta sui token vicini) oppure se lo introduce la transizione, con un decadimento che fa pesare di più i token recenti: per questo RetNet ha un decadimento, RWKV il token-shift e DeltaNet una convoluzione corta dopo le proiezioni [YWZ+24].

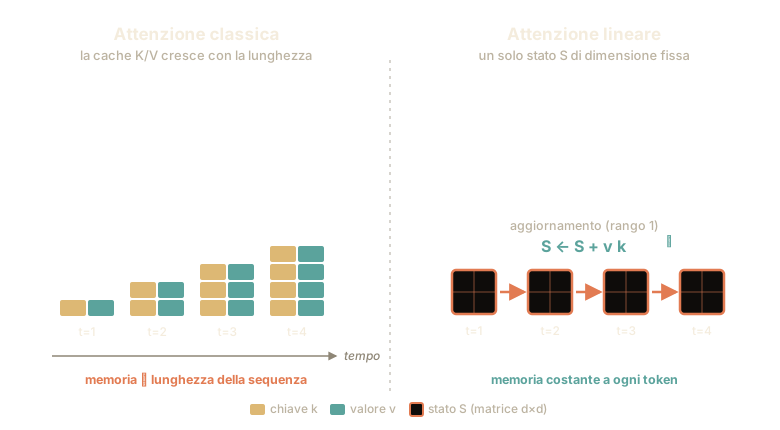
Fig. 17.2 Due modi di ricordare. A sinistra la memoria dei Transformer, che cresce di una coppia etichetta-informazione a ogni parola. A destra l’attenzione lineare: un’unica tabella di numeri, sempre della stessa taglia, in cui ogni parola somma la propria informazione sotto la propria etichetta, e che si rilegge facendole una domanda.#
Come mostra Fig. 17.2, i due schemi conservano il passato in modi opposti: la KV cache tiene tutte le coppie chiave-valore e paga con una memoria che cresce; lo stato le comprime in una matrice di taglia fissa, e la compressione perde informazione.
Addestrare in parallelo, generare in ricorrenza#
Finora lo stato si è riempito un token alla volta. Quando il testo è già tutto disponibile, come in addestramento, lo stesso risultato si ottiene anche in parallelo, ripartendo il lavoro fra molte unità di calcolo: in aritmetica esatta le due forme calcolano la stessa funzione, e in precisione finita differiscono per un arrotondamento. Questa doppia scrittura, parallela e ricorrente, è la proprietà che interessa in tutta la famiglia, e ritorna, con altri strumenti, nel capitolo sugli State Space Model, i modelli che descrivono una sequenza come un sistema che evolve nel tempo.

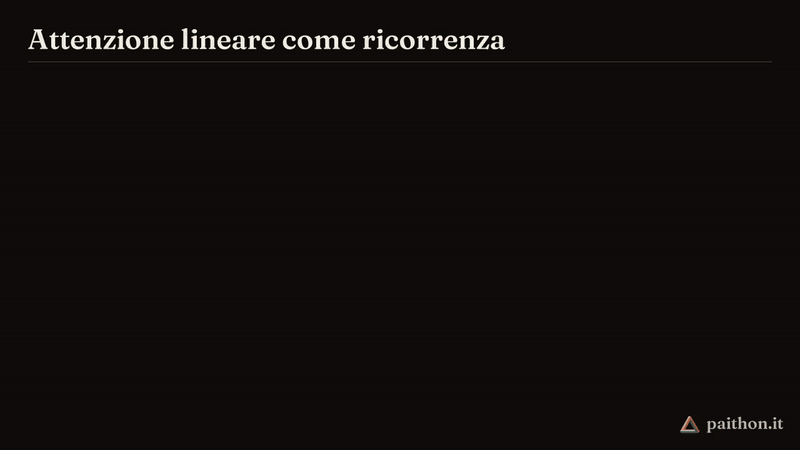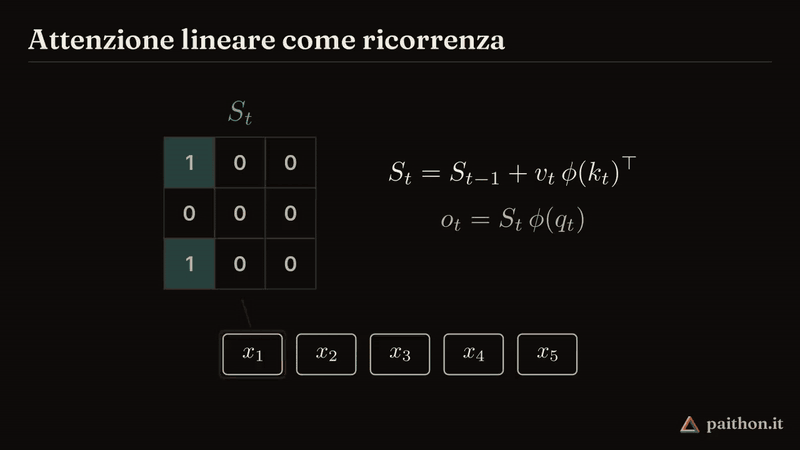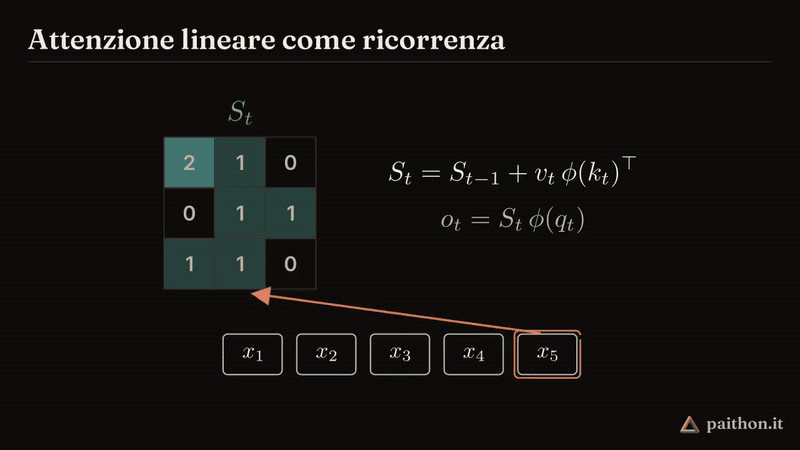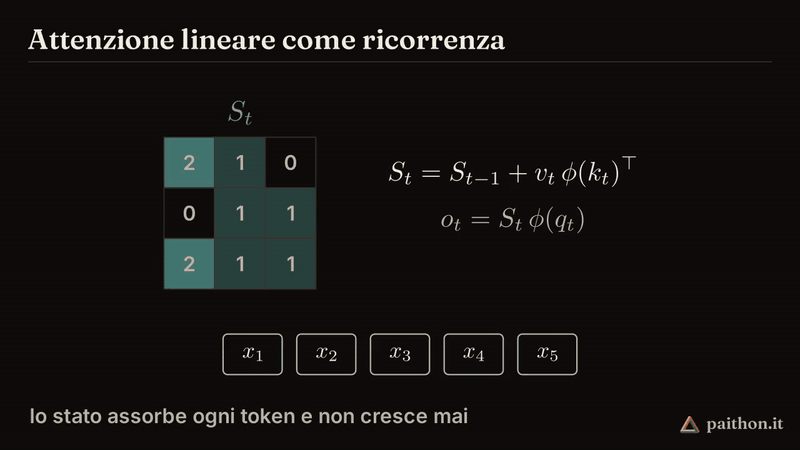
Fig. 17.3 La memoria che si aggiorna parola per parola: a ogni passo i numeri nelle caselle cambiano, perché ci si somma sopra il contributo della parola appena letta, ma le caselle restano quelle. Alla quinta parola la tabella è grande esattamente come alla prima.#
La Fig. 17.3 mostra la parte economica del patto: la memoria non cresce. Mostra però anche il prezzo: in ogni casella si sommano i contributi di token diversi, e alla rilettura si separano di nuovo soltanto se le loro chiavi sono quasi perpendicolari fra loro (ortogonali); altrimenti si mescolano, ed è il limite dell’accumulo.
Studiare un libro che hai già tutto in mano è un mestiere; raccontare a voce una storia che stai inventando adesso è un altro.
Nel primo caso (è l’addestramento, quando il modello impara) il testo esiste già per intero: puoi aprirlo a metà, dare un capitolo a testa a dieci persone e finire in un decimo del tempo. È la forma «tutta insieme», quella che tiene occupata tutta la scheda grafica.
Nel secondo caso (è la generazione, quando il modello scrive) procedi parola per parola, perché il seguito non esiste ancora: lo stai inventando. Qui l’unica cosa che ti porti dietro è il foglio-registro, che aggiorni a ogni parola e che non cresce mai.
Le due forme danno lo stesso risultato, e lo si controlla con i tre della sala, che lasciano nel registro \(2\), \(5\) e \(9\). Una parola alla volta, il registro passa da \(2\) a \(2 + 5 = 7\) e poi a \(7 + 9 = 16\), e dopo ogni ingresso c’è un totale da leggere: \(2\), \(7\) e \(16\). Tutto insieme, ogni posto calcola il suo totale per conto proprio, sommando i contributi di chi è entrato prima di lui: il primo trova \(2\), il secondo \(2 + 5 = 7\), il terzo \(2 + 5 + 9 = 16\). Stessi numeri, e nessuno ha aspettato nessuno. Si usa allora ciascuna forma dove conviene: il modello si allena con quella che sfrutta tutte le unità di calcolo insieme, e scrive con quella che occupa sempre la stessa memoria. La KV cache dei Transformer, al contrario, obbliga a trascinare una pila che si allunga a ogni parola generata.
La forma tutta insieme, fatta così, ha però un costo nascosto. Il terzo posto somma tre contributi, il millesimo ne somma mille, e in tutto sono di nuovo circa mezzo milione di somme: la tabella grande di prima, tagliata a triangolo perché ognuno guarda soltanto chi è venuto prima. Il registro risparmiava la tabella quando bastava un totale solo, letto alla fine; qui ogni parola vuole il registro com’era al momento del suo ingresso, e i totali da leggere sono tanti quante le parole.
C’è una seconda strada, e sembra risolvere tutto: costruire davvero quei registri intermedi, uno per parola, e dare a ognuna delle dieci persone quello da cui comincia il suo capitolo, così nessuno aspetta nessuno. I conti da fare restano proporzionali alla lunghezza, ma con un testo di ottomila parole i fogli da scrivere, tenere da parte e rileggere sono ottomila invece di uno, e il tempo che se ne va a spostarli si mangia il guadagno di lavorare in dieci.
La strada che si prende davvero sta in mezzo, e si lavora a blocchi: si taglia il testo in pezzi, e dentro ogni pezzo si fa tutto insieme, dove la tabella è piccola perché le parole sono poche; poi il registro passa da un pezzo al successivo. In fila vanno i pezzi, che sono pochi e grossi; il grosso del lavoro, quello dentro ai pezzi, resta in parallelo. Il risultato non cambia, e i blocchi torneranno in tutti i modelli che seguono.
E un’avvertenza sulle promesse: meno conti non vuol dire subito più veloce. Su un testo corto un’attenzione dei Transformer scritta con cura vince ancora, perché è stata limata per anni, e il conto proporzionale la batte solo se è scritto con la stessa cura; il guadagno si raccoglie quando il testo si allunga, ed è lì che il conto proporzionale stacca quello a valanga.
In addestramento si usa la forma parallela, ma il suo costo dipende da come la si scrive. La strada più diretta è il prodotto fra matrici mascherato dalla causalità, \(\operatorname{tril}\big(\phi(\mathbf{Q})\phi(\mathbf{K})^\top\big)\mathbf{V}\), dove \(\operatorname{tril}\) tiene il triangolo inferiore, diagonale compresa, e azzera il resto. Qui la maschera moltiplica: la maschera additiva dei Transformer, con \(-\infty\) sui collegamenti vietati, funziona solo perché la softmax trasforma \(-\infty\) in un peso nullo, e senza softmax un \(-\infty\) romperebbe la somma invece di toglierne un termine. La forma mascherata è parallela esattamente come un Transformer, ma la maschera impedisce di ri-associare il prodotto e si torna a pagare \(O(n^2 d)\). L’alternativa è srotolare la somma cumulativa \(\mathbf{S}_t = \sum_{i\le t} \mathbf{v}_i\,\phi(\mathbf{k}_i)^\top\) come prefix sum (una somma progressiva): l’operazione è associativa, quindi si calcola con uno scan parallelo a costo \(O(n d^2)\), lineare. L’ostacolo qui non è il numero di operazioni ma la memoria: uno scan pretende di materializzare tutti gli \(n\) stati intermedi \(d \times d\), cioè \(O(n d^2)\) di memoria contro gli \(O(d^2)\) della forma ricorrente, e il traffico da e verso la memoria della GPU vanifica il guadagno del parallelismo (con \(n = 8192\) e \(d = 64\) per testa sono più di 33 milioni di valori per testa e per strato, contro i 4096 dello stato). Nessuna delle due forme dà insieme le due cose. Katharopoulos e colleghi addestrano con la forma ricorrente, scritta come kernel per GPU sequenziale nel tempo ma parallelo su tutto il resto. Riscrivono inoltre il gradiente come somma cumulativa, così da non conservare nessuno stato intermedio. La conciliazione usata in seguito è il calcolo a blocchi (chunkwise), proposto da Hua e colleghi nel 2022 [HDLL22]: parallelo dentro ogni blocco, ricorrente fra un blocco e l’altro, con costo \(O(nBd + nd^2)\) per blocchi di ampiezza \(B\), cioè lineare in \(n\). I due addendi di un blocco, \(B^2 d\) per la parte parallela e \(B d^2\) per leggere e aggiornare lo stato, si equivalgono a \(B \approx d\), dove il totale è \(O(n d^2)\) come nella forma ricorrente; blocchi più grandi aumentano il lavoro dentro il blocco e diminuiscono i passi in sequenza, che sono \(n/B\). Nelle misure di GLA il blocco è di 64 token, con teste di dimensione 64 [YWS+24]. Lo formalizzano RetNet e DeltaNet, nella sezione sulle architetture lineari e in quella sulla scrittura nella memoria.
«Lineare», però, non vuol dire subito più veloce. L’attenzione softmax ha implementazioni molto curate nel traffico di memoria, e il punto di pareggio dipende dall’implementazione. In addestramento, l’algoritmo a blocchi di GLA, che cura quel traffico, supera FlashAttention-2 già su sequenze di 1000 token, mentre la stessa forma a blocchi scritta senza curarlo è nettamente più lenta [YWS+24]; l’algoritmo a blocchi di Mamba-2 (detto SSD) pareggia FlashAttention-2 intorno ai 2000 token e la supera di sei volte a 16 000 [DG24]. Per questo buona parte del lavoro su queste architetture è lavoro di implementazione, più che di formule.
In inferenza autoregressiva si usa la forma ricorrente: si aggiorna \(\mathbf{S}_t\) sul posto e si legge \(\mathbf{o}_t\), con costo \(O(d^2)\) per token e memoria \(O(d^2)\) costante. Nessuna KV cache che si allunga: lo stato è sempre la stessa matrice \(d \times d\). In un Transformer la cache cresce di una coppia \((\mathbf{k}_t, \mathbf{v}_t)\) per token e per strato, e il costo di generare l’\(n\)-esimo token sale con la lunghezza del prefisso; qui resta piatto. Per testa, lo stato occupa \(d^2\) numeri e la KV cache \(2nd\): a memoria la ricorrenza conviene da \(n > d/2\) (32 token con \(d = 64\)), a lavoro per token (\(O(d^2)\) contro \(O(nd)\)) da \(n > d\). Con chiavi e valori condivisi fra più teste (GQA, MLA) la cache è più piccola e il pareggio si sposta in avanti. Per un modello intero il gruppo di MiniMax colloca il pareggio teorico a qualche migliaio di token, e avverte che in produzione restano da risolvere la precisione con cui si conserva lo stato e il riuso dei prefissi già calcolati [MiniMax25a].
Da questo contrasto nasce la cifra più citata di Katharopoulos e colleghi: fino a circa 4000 volte più veloce nella generazione. È misurata generando immagini CIFAR-10 pixel per pixel (\(n = 3072\)) e confrontando le immagini al secondo con un Transformer softmax che a ogni pixel ricalcola l’intero prefisso, cioè senza KV cache. Contro lo stesso Transformer con la cache, che gli autori misurano in appendice, il vantaggio è di circa 56 volte su CIFAR-10 e di 19 su MNIST (\(n = 784\)); a un’immagine per volta su GPU scende a 1,14 volte su CIFAR-10 (61,3 secondi contro 70,4) [KVPF20]. La memoria costante rende la generazione più economica, ma di quanto dipende dal termine di paragone: dei 4000, un fattore 80 lo dà già la sola cache aggiunta al Transformer softmax (da 0,004 a 0,32 immagini al secondo su CIFAR-10).
Il passo con cui il modello genera un token sta in poche righe, e la cosa che
conta si legge a colpo d’occhio: S, lo stato \(\mathbf{S}_t\), entra ed esce
dalla funzione sempre della stessa taglia, e in tutto il codice non c’è
nessuna lista che si allunga.
import torch
import torch.nn.functional as F

phi = lambda x: F.elu(x) + 1.0   # feature map: sempre positiva

def genera_passo(S, z, q_t, k_t, v_t):
    """Un passo di attenzione lineare, forma ricorrente.
    S: stato d x d (fisso)   z: normalizzatore d   q_t, k_t, v_t: vettori d."""
    pk = phi(k_t)
    S = S + torch.outer(v_t, pk)          # scrivi: S += v_t phi(k_t)^T
    z = z + pk                            # aggiorna il normalizzatore
    pq = phi(q_t)
    o_t = (S @ pq) / (z @ pq)             # leggi: o_t = S phi(q_t) / (z . phi(q_t))
    return o_t, S, z
La memoria occupata da S non dipende da quanti token sono già stati
generati: è il cuore del vantaggio. Accanto a S viaggia z, il
normalizzatore \(\mathbf{z}_t\), cioè il totale dei pesi per cui si divide la
lettura; è un vettore, anche lui di taglia fissa.
Il limite dell’accumulo#
L’aggiornamento \(\mathbf{S}_t = \mathbf{S}_{t-1} + \mathbf{v}_t\,\phi(\mathbf{k}_t)^\top\) è puramente additivo: non cancella e non corregge nulla di ciò che è già scritto. Ogni token lascia il proprio contributo, sommato a quelli dei precedenti, e il contributo resta per sempre, perché la transizione è l’identità. Una memoria di capacità finita, a forza di somme, si satura.
Un foglio-registro su cui continui a sommare senza mai cancellare niente, prima o poi diventa illeggibile: le scritte si sovrappongono, e quando cerchi un’informazione precisa ti ritrovi un pasticcio di tracce che si confondono.
Se due parole diverse hanno etichette simili, i loro contributi si mescolano, e rileggendo non capisci più bene quale informazione appartenesse a quale etichetta. Il disturbo non comincia di colpo a una certa soglia: comincia subito, piano, e cresce con quante cose hai scritto.
E il foglio si riempie molto prima di quanto lascino sperare le sue caselle, perché un’informazione non occupa una casella: quando la scrivi si spalma su tutto il foglio, e la successiva si spalma sopra di lei. Prendi un foglio piccolo, trentadue righe per trentadue colonne (nei modelli veri il lato va da sessantaquattro a duecentocinquantasei): di caselle ne ha più di mille, ma le etichette che riesce a tenere separate sono trentadue, cioè il suo lato. La ragione sta nelle etichette. Ognuna è una fila di trentadue numeri, cioè una direzione, e due etichette non si pestano i piedi solo se le loro direzioni sono del tutto perpendicolari, come i tre spigoli che si incontrano in un angolo della stanza. Nella stanza di direzioni così ce ne sono tre; con file di trentadue numeri ce ne stanno trentadue, e non una di più. Le altre caselle non fanno posto a etichette nuove: servono a scrivere, accanto a ciascuna delle trentadue, un’informazione di trentadue numeri.
E trentadue è già il caso migliore, quello che nella pratica non capita: le etichette non le sceglie nessuno apposta distinte, le assegna il modello, e due parole qualunque finiscono per somigliarsi un po’. Infatti già a otto informazioni la risposta torna sbagliata di circa metà del suo valore, e a trentadue lo sbaglio è grande quanto la risposta. Da lì in poi ritrovare il dettaglio giusto («di che colore era il cappotto citato venti pagine fa?») è impossibile. L’attenzione dei Transformer, quella che tiene tutti gli scontrini, quel dettaglio ce l’ha ancora; il registro riassuntivo può averlo perso.
E la domanda ovvia (perché non prendersi un foglio più grande?) ha una risposta altrettanto ovvia: si può, ed è una delle manopole di chi progetta il modello, ma si paga. Un foglio più largo vuol dire più caselle da aggiornare e da rileggere a ogni parola, quindi più conti e più memoria: allargandolo abbastanza si torna a spendere quanto un Transformer, e il vantaggio che eravamo venuti a cercare svanisce. Il gioco, da qui in avanti, è un altro: tenere il foglio piccolo e imparare a scriverci meglio.
Il limite è di capacità, ed è una conseguenza della dimensione finita. Lo stato \(\mathbf{S}\) è una matrice \(d \times d\): in uno spazio di dimensione \(d\) non esistono più di \(d\) vettori mutuamente ortogonali. È la capacità delle memorie associative lineari, di cui \(\mathbf{S} = \sum_j \mathbf{v}_j\,\phi(\mathbf{k}_j)^\top\) è la regola di covarianza. Le reti di Hopfield moderne, la cui regola di aggiornamento coincide con l’attenzione softmax, hanno invece una capacità che cresce in modo esponenziale con \(d\), perché conservano i ricordi uno per uno invece di sommarli, come fa la KV cache (il confronto sta nel capitolo sui modelli a energia, in Paesaggi di oggi). Se le key \(\phi(\mathbf{k}_1), \dots\) fossero esattamente ortogonali e di norma uno, leggere con \(\phi(\mathbf{q})\) recupererebbe il value giusto pulito fino a \(d\) associazioni; ma le key le produce una proiezione lineare, non un’ortogonalizzazione, e con chiavi casuali il crosstalk (le briciole degli altri value che il retrieval raccoglie insieme a quello cercato) non compare a una soglia: cresce da subito come \(\sqrt{N/d}\) con il numero \(N\) di associazioni scritte. A \(N \approx d\) l’interferenza vale ormai quanto il valore cercato. In \(d=32\), con chiavi gaussiane riportate a norma unitaria e value gaussiani, l’errore relativo medio del richiamo (media su tutte le chiavi scritte e su duemila estrazioni) è \(0{,}99\) a \(N=d\) e \(0{,}46\) a \(N=d/4\), in accordo con l’andamento atteso \(\sqrt{(N-1)/d}\) (\(0{,}98\) a \(N=d\)), cioè \(\sqrt{N/d}\) a meno del contributo della chiave che si sta interrogando; la stessa misura con value di norma unitaria, nella sezione sui limiti degli State Space Model, dà \(0{,}98\), e il centesimo di scarto viene dal modo di stimarla. Il richiamo pulito vuole quindi \(N\) ben minore di \(d\), non \(N \le d\). Ed essendo la transizione l’identità, non c’è modo di dimenticare: una scrittura spuria fatta all’inizio resta a disturbare per sempre. La capacità finita è una delle ragioni per cui l’attenzione lineare pura resta indietro rispetto all’attenzione softmax sui compiti di richiamo preciso: quanto si richiama cresce con la dimensione dello stato [AEZ+24]. Un’altra, indipendente dalla capacità, è che i pesi dell’attenzione lineare sono meno concentrati di quelli della softmax, che può dare quasi tutto il peso a poche chiavi [ZBKRe24].
Il conto si rifà in poche righe: si riempie una memoria \(32\times32\) con \(N\) associazioni, la si rilegge con le stesse chiavi con cui è stata scritta, e si guarda di quanto la risposta si discosta dal valore giusto.
import numpy as np

def errore_richiamo(N, d=32, prove=2000, seme=0):
    # errore relativo medio nel rileggere N associazioni da una memoria d x d
    rng = np.random.default_rng(seme)
    errori = []
    for _ in range(prove):
        K = rng.standard_normal((N, d))
        K /= np.linalg.norm(K, axis=1, keepdims=True)  # chiavi a norma unitaria
        V = rng.standard_normal((N, d))
        S = V.T @ K                                    # la memoria dopo N scritture
        letto = (S @ K.T).T                            # rileggo con le stesse chiavi
        errori.append((np.linalg.norm(letto - V, axis=1)
                       / np.linalg.norm(V, axis=1)).mean())
    return float(np.mean(errori))

for N in (8, 16, 32):
    print(f"N={N:2d}  errore relativo medio = {errore_richiamo(N):.2f}"
          f"   (andamento atteso ~{np.sqrt((N - 1) / 32):.2f})")
N= 8  errore relativo medio = 0.46   (andamento atteso ~0.47)
N=16  errore relativo medio = 0.68   (andamento atteso ~0.68)
N=32  errore relativo medio = 0.99   (andamento atteso ~0.98)
I rimedi che conservano la taglia fissa dello stato sono due: un gate di dimenticanza (in italiano un cancello, come nelle LSTM), che fa sbiadire ciò che è scritto da tempo, e la delta rule (regola delta), che prima di scrivere interroga lo stato con la chiave e vi annota soltanto la differenza fra il valore che ne ricava e quello giusto. Li sviluppa scrivere meglio nella memoria.
Da ricordare
Far parlare ogni parola con tutte le altre è un’esplosione di conversazioni: mille parole sono quasi mezzo milione di scambi. Sostituire quel confronto a due a due con un registro riassuntivo, che ciascuno aggiorna una volta sola, porta il conto a mille aggiornamenti, ciascuno grande quanto il registro e sempre uguale a sé: da esplosivo a proporzionale alla lunghezza del testo, ed è esattamente ciò che si intende per costo lineare.
Il registro è un foglio di dimensione fissa: ogni parola ci scrive la propria informazione sotto la propria etichetta, e per rispondere a una domanda lo si rilegge, invece di rovistare nella pila degli scontrini.
Quando ogni parola guarda soltanto quelle venute prima, come quando il modello scrive, quel foglio letto parola per parola è il riassunto di una vecchia rete ricorrente: si aggiorna sommando, costa sempre lo stesso a ogni parola e non cresce mai, che si sia alla decima o alla milionesima. È l’ironia del titolo Transformers are RNNs (Katharopoulos e colleghi, 2020).
Stesso risultato, due modi di ottenerlo: tutto insieme quando il testo c’è già (studiare un libro che si ha in mano, cioè addestrare, e in pratica si fa a blocchi) e una parola alla volta quando il testo si sta inventando (raccontarlo a voce, cioè generare), senza la pila che si allunga. La stessa doppia natura tornerà con gli State Space Model.
Il difetto del registro: somma e basta, non cancella e non corregge. Le scritte si sovrappongono un po’ fin dalla prima riga, e il foglio si riempie molto prima di quanto lascino sperare le sue caselle, perché ogni informazione si spalma su tutto il foglio: uno da trentadue righe per trentadue colonne ne ha più di mille, ma tiene separate al più trentadue etichette, quante il suo lato, e già a otto informazioni la risposta torna sbagliata di circa metà del suo valore, e a trentadue lo sbaglio è grande quanto la risposta. Prendere un foglio più grande si può, ma costa conti e memoria a ogni parola, e a quel punto tanto vale un Transformer.
I due rimedi: un modo per sbiadire ciò che è vecchio e un modo per correggere invece di sommare alla cieca.
Da ricordare
L’attenzione softmax costa \(O(n^2 d)\) perché la somiglianza esponenziale \(\exp(\mathbf{q}^\top\mathbf{k})\) non si fattorizza in dimensione finita (la normalizzazione non c’entra); sostituirla con una somiglianza \(\text{sim}(\mathbf{q},\mathbf{k})=\phi(\mathbf{q})^\top\phi(\mathbf{k})\) e ri-associare il prodotto porta il costo a \(O(n d^2)\), cioè lineare nella lunghezza.
Il calcolo si condensa in uno stato-matrice \(\mathbf{S} = \sum_j \mathbf{v}_j\,\phi(\mathbf{k}_j)^\top\) di dimensione fissa \(d \times d\): una memoria chiave→valore che si legge con \(\mathbf{S}\,\phi(\mathbf{q})\).
In forma causale è una ricorrenza, \(\mathbf{S}_t = \mathbf{S}_{t-1} + \mathbf{v}_t\,\phi(\mathbf{k}_t)^\top\): cioè una RNN a stato matriciale con transizione lineare (l’identità), aggiornamento \(O(d^2)\) per token e memoria costante; da cui l’ironia di Transformers are RNNs (Katharopoulos et al., 2020).
Stessa funzione, due forme: parallela per addestrare (in pratica a blocchi, con costo \(O(nBd + nd^2)\)), ricorrente per generare a memoria costante, senza la KV cache che invece cresce. La stessa dualità tornerà per gli State Space Model. Lineare non vuol dire però subito più veloce: il pareggio con un’attenzione softmax ben scritta dipende dall’implementazione (in addestramento, da circa mille token per l’algoritmo a blocchi di GLA a circa duemila per quello di Mamba-2), e il «4000 volte» di Katharopoulos è misurato contro un Transformer senza KV cache.
Il difetto dell’accumulo puro: non dimentica e non corregge. Con chiavi casuali l’interferenza (crosstalk) cresce come \(\sqrt{N/d}\) fin da subito e a \(N \approx d\) pareggia il segnale: il richiamo pulito vuole \(N\) ben minore di \(d\).
I due rimedi: un gate che dimentica e una delta rule che corregge invece di sommare.