


Mettersi d’accordo: dire, votare, diffidare#
Il sindaco che dice «vi dichiaro marito e moglie» non riferisce di un matrimonio, lo celebra. L’osservazione sembra ovvia appena qualcuno la pronuncia, e a farla fu il filosofo del linguaggio John Langshaw Austin, in un ciclo di lezioni tenuto a Harvard nel 1955 e uscito in volume solo dopo la sua morte, con un titolo che è già una tesi: How to Do Things with Words, come fare cose con le parole. Certe frasi descrivono il mondo, e di esse ha senso chiedersi se siano vere o false: «piove». Altre non descrivono niente, lo cambiano. «Prometto di venire domani» sfugge al vero e al falso: è un impegno che un istante prima non esisteva. Austin chiamò queste frasi enunciati performativi, e da lì è nata la teoria degli atti linguistici, il capitolo della pragmatica (la parte della linguistica che studia l’uso delle parole) che si occupa di ciò che le parole fanno oltre a ciò che dicono.
La teoria serve a chi progetta protocolli fra agenti. Quando due agenti si scambiano un messaggio, la domanda «che cosa c’è scritto» è la meno interessante; quella che conta è «che cosa fa questo messaggio»: apre un impegno, ne chiude uno, chiede, propone, rifiuta. Subito dopo arriva la seconda domanda, quella che con un agente solo non si pone: quando le risposte non coincidono, chi decide? Le risposte che il campo ha dato vanno dal messaggio che dichiara il proprio tipo fino al voto di maggioranza, e il voto poggia su un’ipotesi, l’indipendenza degli errori, che fra copie dello stesso modello quasi mai vale.
Atti linguistici e performative#
Cominciamo dalla forma. In un sistema multi-agente il testo che passa da un partecipante all’altro è un atto comunicativo, e come ogni atto ha un tipo: informare, chiedere, impegnarsi, rifiutare.

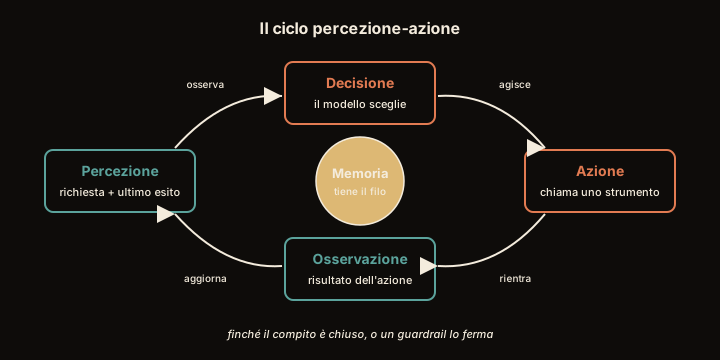
Fig. 22.3 Il ciclo del singolo agente, prima di metterne insieme molti: percezione, decisione, azione e osservazione dell’effetto, con al centro la memoria che porta lo stato da un giro al successivo. Ogni partecipante a un protocollo è uno di questi cicli: i messaggi entrano dalla percezione ed escono dall’azione.#
Prima di guardare i messaggi conviene rimettersi davanti il singolo agente della sezione sul ciclo dell’agente, disegnato in Fig. 22.3: è l’unità di misura di tutto quello che segue. Ogni partecipante a un protocollo è uno di questi anelli, e i messaggi che si scambiano entrano dalla stazione «percezione» ed escono da quella «azione»: parlare, per un agente, è agire.
Al frigorifero sono attaccati tre biglietti. Sul primo c’è scritto «il latte è finito». Sul secondo «compra il latte». Sul terzo «il latte lo prendo io tornando». Parlano tutti e tre della stessa cosa, con quasi le stesse parole, ma fanno tre mestieri diversi: il primo dà una notizia, il secondo scarica un compito su chi legge, il terzo se lo prende chi ha scritto.
La differenza si vede domani mattina, quando il latte manca ancora. Col primo biglietto non ha sbagliato nessuno: era solo un’informazione. Col secondo hai sbagliato tu. Col terzo ha sbagliato chi l’ha scritto. Stesso argomento, tre responsabilità diverse, e a stabilirlo non è l’argomento ma il tipo di biglietto. Tenerlo scritto sul biglietto, invece di lasciarlo indovinare a chi legge, è l’unica cosa che permette a fine giornata di dire se qualcuno ha mancato a qualcosa.
Ci sono anche due modi diversi di sbagliare. «Il latte è finito» scritto mentre in frigo c’è un litro pieno è semplicemente falso. «Compra il latte» attaccato al frigorifero di un vicino non ha niente di falso, e però non vale: quel vicino non ti doveva la spesa, e domani nessuno può rimproverargli niente. Il biglietto falso lo smaschera chi apre il frigorifero; quello che non vale lo vede chi guarda a quale frigorifero è appeso.
Austin distingue tre livelli in ogni enunciato: l’atto locutorio (dire qualcosa di sensato), quello illocutorio (ciò che si compie nel dirlo: promettere, ordinare, asserire) e quello perlocutorio (l’effetto ottenuto col dirlo: convincere, spaventare). Il livello che ci serve è il secondo. John Searle lo formalizza scomponendo ogni enunciato in due coordinate indipendenti, \(F(P)\): la forza illocutoria \(F\) e il contenuto proposizionale \(P\). «Chiudi la porta» e «prometto di chiudere la porta» condividono \(P\) e differiscono per \(F\), e non c’è modo di ricavare \(F\) da \(P\): sono assi ortogonali.
Searle raggruppa poi le forze in cinque classi: assertivi (impegnano chi parla sulla verità di \(P\)), direttivi (tentano di far fare qualcosa a chi ascolta), commissivi (impegnano chi parla a un’azione futura), espressivi e dichiarazioni (che modificano il mondo per il solo fatto di essere pronunciate da chi ne ha l’autorità). Le condizioni che Austin chiamava di felicità [Aus62] Searle le sistema in regole di quattro specie [Sea69]: sul contenuto proposizionale (una promessa riguarda un atto futuro di chi parla), preparatorie (chi riceve preferisce che l’atto sia fatto, e non è ovvio che sarebbe fatto comunque; per un ordine, chi lo dà ha autorità su chi lo riceve), di sincerità (chi promette intende farlo) ed essenziale (dire la frase conta come assumersi l’obbligo). Un ordine dato a chi non è tenuto a obbedire viola una condizione preparatoria, ed è nullo anche se non contiene niente di falso. Ed è proprio la distinzione fra «falso» e «nullo» che serve a un sistema distribuito: un contenuto sbagliato è un problema di merito, un atto mal formato è un problema di protocollo, e si diagnosticano in modi diversi. Austin stesso, nelle ultime lezioni, abbandona la contrapposizione fra enunciati performativi e constativi (quelli che descrivono): ogni enunciato ha una forza illocutoria, anche «piove».
Negli anni Novanta la ricerca sugli agenti trasforma questa analisi in una
regola di scrittura. Ogni messaggio fra agenti deve portare in cima, scritto a
chiare lettere, che cosa quel messaggio fa: si chiama performativa, ed è il
nome tecnico di quello che sui biglietti del frigorifero era il tipo di
biglietto. È una casella obbligatoria, da riempire scegliendo in un elenco
finito, accanto a mittente, destinatario, contenuto, a quale conversazione il
messaggio appartiene e a quale messaggio risponde. Le due proposte che hanno
fatto scuola sono KQML, sviluppato da Tim Finin e colleghi in un programma
di ricerca finanziato dalla DARPA [FFMM94], e FIPA-ACL, lo
standard della Foundation for Intelligent Physical Agents, un consorzio nato nel
1996; il suo catalogo di atti comunicativi conta ventidue voci
[FoundationfIPAgents02], e i nomi dicono già tutto: inform («ti informo che»),
request («ti chiedo di»), agree («va bene, lo faccio»), refuse («no»),
failure («ci ho provato e non ci sono riuscito»), not-understood («non ho
capito che cosa vuoi»), e altre sedici sulla stessa falsariga.
Perché conta oggi, che gli agenti sono modelli di linguaggio e la prosa libera gli riesce benissimo? Perché la prosa libera non si verifica. Se un agente scrive «ci penso io, più tardi», nessun programma può stabilire se ha accettato un incarico o se sta rimandando; e a lavoro finito nessuno può far dire a una macchina se quella richiesta ha avuto risposta, se quell’impegno è stato onorato, se quella proposta è stata accettata o ignorata. La stessa idea torna negli standard di oggi per gli agenti linguistici, quelli che la sezione sul ciclo dell’agente ha già presentato: MCP per il dialogo fra un agente e i suoi strumenti, e A2A, annunciato da Google nell’aprile 2025 [SJVS25], per quello fra agenti. Danno ai messaggi un tipo e uno schema, e questo li rende controllabili nella forma; non garantisce però che gli agenti si capiscano, perché gli errori di disallineamento osservati da Cemri e colleghi compaiono anche fra agenti dello stesso framework, che si scrivono in linguaggio naturale [CPY+25].
Scrivere il tipo sul messaggio cambia la natura della conversazione: da testo da interpretare diventa una sequenza di mosse previste. In ogni momento ciascuno scambio si trova in uno di pochi stati dichiarati («ho chiesto e aspetto», «ha accettato e non ha ancora consegnato», «chiuso»), e da uno stato all’altro si passa solo con le performative lecite, e solo se a farle è chi ne ha titolo. In informatica un oggetto fatto così si chiama macchina a stati finiti, e si può registrare, rigiocare dall’inizio e controllare mossa per mossa.
Nel programma, un pianificatore apre tre conversazioni, che nel codice si chiamano fili: chiede i dati a un ricercatore, una stima a un analista, un controllo a un revisore. Il programma rilegge i messaggi in ordine, come si rileggerebbero i biglietti del frigorifero a fine giornata, e dice di ogni filo come è finito.
from dataclasses import dataclass


@dataclass
class Messaggio:
    """La performativa dice che cosa il messaggio *fa*, non di che cosa parla."""
    performativa: str   # richiedi, accetta, rifiuta, informa, fallisci
    mittente: str
    destinatario: str
    filo: str           # a quale conversazione appartiene
    contenuto: str


# La macchina a stati del protocollo: da ogni stato, quali performative sono
# lecite e in quale stato portano.
TRANSIZIONI = {
    "aperto":    {"richiedi": "in attesa"},
    "in attesa": {"accetta": "impegnato", "rifiuta": "chiuso"},
    "impegnato": {"informa": "chiuso", "fallisci": "chiuso"},
    "chiuso":    {},
}

# Gli stati in cui la conversazione non e' finita: sono i conti aperti.
IN_SOSPESO = {"in attesa": "<- richiesta senza risposta",
              "impegnato": "<- impegno non onorato"}


def ripercorri(traccia):
    """Rilegge la traccia e restituisce lo stato finale di ogni filo.
    Solleva un errore alla prima mossa che il protocollo non prevede, o che
    arriva da chi non ha titolo per farla."""
    stati, parti = {}, {}
    for m in traccia:
        stato = stati.get(m.filo, "aperto")
        lecite = TRANSIZIONI[stato]
        if m.performativa not in lecite:
            raise ValueError(
                f"filo {m.filo}: '{m.performativa}' non e' lecita nello stato "
                f"'{stato}' (attese: {sorted(lecite) or 'nessuna'})")
        if m.performativa == "richiedi":
            parti[m.filo] = (m.mittente, m.destinatario)   # chi chiede, a chi
        elif (m.destinatario, m.mittente) != parti[m.filo]:
            raise ValueError(
                f"filo {m.filo}: risponde {m.mittente}, ma la richiesta "
                f"era per {parti[m.filo][1]}")
        stati[m.filo] = lecite[m.performativa]
    return stati


traccia = [
    Messaggio("richiedi", "pianificatore", "ricercatore", "f1", "trova i dati"),
    Messaggio("accetta",  "ricercatore", "pianificatore", "f1", "procedo"),
    Messaggio("richiedi", "pianificatore", "analista", "f2", "stima il trend"),
    Messaggio("informa",  "ricercatore", "pianificatore", "f1", "ecco la tabella"),
    Messaggio("accetta",  "analista", "pianificatore", "f2", "procedo"),
    Messaggio("richiedi", "pianificatore", "revisore", "f3", "controlla la stima"),
    Messaggio("rifiuta",  "revisore", "pianificatore", "f3", "mi manca la tabella"),
]

for filo, stato in sorted(ripercorri(traccia).items()):
    print(f"{filo}: {stato:10s} {IN_SOSPESO.get(stato, '')}".rstrip())

# Due mosse fuori protocollo, intercettate subito: una risposta su un filo gia'
# chiuso, e una consegna fatta da chi l'impegno non l'aveva preso.
fuori = [
    Messaggio("informa", "revisore", "pianificatore", "f3", "controllo fatto"),
    Messaggio("informa", "ricercatore", "pianificatore", "f2", "ecco la stima"),
]
for m in fuori:
    try:
        ripercorri(traccia + [m])
    except ValueError as errore:
        print("violazione:", errore)
f1: chiuso
f2: impegnato  <- impegno non onorato
f3: chiuso
violazione: filo f3: 'informa' non e' lecita nello stato 'chiuso' (attese: nessuna)
violazione: filo f2: risponde ricercatore, ma la richiesta era per analista
Una quarantina di righe di macchina a stati, senza una sola chiamata a un modello, e il sistema segnala fatti che una rilettura della trascrizione non rende evidenti. L’analista ha promesso una stima e non l’ha mai consegnata: è un impegno pendente, il biglietto «il latte lo prendo io» con il frigorifero ancora vuoto. Il revisore ha provato a rispondere su un filo che aveva già chiuso rifiutando, e il ricercatore a consegnare una stima che nessuno gli aveva chiesto: sono violazioni di protocollo, mosse che il protocollo non prevede o che fa chi non ne ha titolo, come il biglietto attaccato al frigorifero del vicino. Sono guasti diversi: a un impegno pendente si rimedia con un sollecito, o decidendo di aspettare al massimo tanto e poi dare per perso chi non ha risposto; a una violazione scartando il messaggio. Il disallineamento fra agenti, che la sezione sul costo del coordinamento elencava fra le tre famiglie di fallimento [CPY+25], si manifesta spesso così, sotto una conversazione perfettamente cortese, e il tipo di messaggio è il primo strumento che lo rende visibile.
È lo stesso baratto che la sezione sul ciclo dell’agente fa quando impone al modello di chiamare gli strumenti con argomenti in un formato fisso invece che in prosa: si restringe quello che può scrivere, e in cambio si ottiene la possibilità di controllarlo a macchina. Quello che cambia qui è la scala. Il cancello di verifica descritto nella sezione sul costo del coordinamento, quel controllo esterno che o passa o non passa, giudica una risposta per volta; un protocollo giudica l’intera conversazione. Non «questa risposta è ben formata», ma «questo scambio, dal primo messaggio all’ultimo, è una partita legale».
Uno dei primi protocolli di questo tipo ha più di quarant’anni, ed è lo stesso Contract Net di Reid G. Smith [Smi80] che la sezione sulle topologie ha incontrato come mercato. Là interessava chi prende il lavoro; qui interessa la forma dello scambio. Bando, offerta, assegnazione e rapporto finale sono quattro messaggi con il tipo scritto sopra, in una sequenza fissa, e dopo l’assegnazione esiste un oggetto che prima non c’era: un contratto, con un responsabile e una scadenza. È la stessa idea dei biglietti sul frigorifero, portata su scala di sistema: dopo l’assegnazione la domanda «questo compito ha un titolare?» ha una risposta che il programma sa dare da sé, senza rileggere niente, e il rapporto finale dice se il titolare l’ha svolto. La stessa sequenza torna ogni volta che si chiede a più agenti se sono in grado di svolgere un compito prima di affidarlo.
Aggregare i giudizi: il conto di Condorcet#
Dai messaggi passiamo alle decisioni. Se più agenti hanno risposto e le risposte differiscono, la strada più ovvia è contare: vince la maggioranza. Ed è una strada con alle spalle il teorema più antico della materia. Nel 1785 Nicolas de Condorcet, matematico e politico, pubblica un saggio sull’applicazione del calcolo delle probabilità alle decisioni prese a maggioranza di voti. La domanda era se una giuria numerosa giudichi meglio di un singolo giudice. La risposta è sì, ma a due condizioni, e sono le condizioni a interessarci. La prima è che ciascun giurato, da solo, ci prenda più della metà delle volte. La seconda è che i giurati sbaglino in modo indipendente, cioè che non sbaglino tutti sulle stesse domande. La seconda è quella che nei sistemi di agenti salta sempre.
Nella pagina d’apertura del capitolo tre colleghi che ci prendono sette volte su dieci arrivavano, votando, al 78%, senza che si vedesse come. Ecco il conto: due sole risposte possibili, mille domande, e tutti i casi possibili messi in fila.
Che ci prendano tutte e tre capita sette volte su dieci, per sette su dieci, per sette su dieci: sette per sette per sette fa trecentoquarantatré, quindi trecentoquarantatré domande su mille. Moltiplicare così ha senso finché le tre persone non sbagliano tutte sulle stesse domande.
Che ne azzecchino due su tre capita in tre modi diversi, a seconda di chi dei tre sbaglia, e ciascun modo vale sette per sette per tre, cioè centoquarantasette su mille: in tutto quattrocentoquarantuno.
Che ne azzecchi una sola: ancora tre modi, ciascuno da sette per tre per tre, cioè sessantatré, in tutto centottantanove. E che sbaglino tutte e tre: tre per tre per tre fa ventisette. I quattro numeri messi insieme fanno mille, come devono.
La maggioranza ha ragione nei primi due casi, quando ci prendono in tre o in due: trecentoquarantatré più quattrocentoquarantuno fa settecentottantaquattro su mille. Il gruppo azzecca quasi otto volte su dieci mentre ciascuno, da solo, ne azzecca sette. Il guadagno viene da un fatto elementare: perché il gruppo sbagli servono almeno due errori insieme, e due errori insieme sono più rari di uno.
Con cinque persone servirebbero tre errori insieme, e il gruppo sale a ottantaquattro volte su cento; con nove ne servirebbero cinque, e si arriva a novanta. Sono lo stesso identico conto con più casi da elencare, e a quel punto conviene farli elencare a un programma.
E attenzione al verso, perché è la prima delle due condizioni. Se ciascuno ci prende meno della metà delle volte il conto si ribalta: con tre persone che azzeccano quattro volte su dieci il gruppo scende a trentacinque su cento, e con nove a ventisette. Più si è, peggio si fa. Il voto non aggiunge competenza, amplifica quella che c’è: sopra la metà spinge verso la risposta giusta, sotto la metà verso quella sbagliata.
È il teorema della giuria di Condorcet. Con \(n\) votanti che decidono in modo indipendente fra due alternative, ciascuno corretto con probabilità \(p\), e regola di maggioranza semplice, la probabilità che il verdetto collettivo sia corretto è
dove \(\binom{n}{k}\) conta i modi in cui \(k\) votanti su \(n\) possono essere quelli corretti, \(p^k(1-p)^{n-k}\) è la probabilità di ciascuno di quei modi e l’estremo inferiore della somma è la più piccola maggioranza stretta (per \(n\) dispari, \((n+1)/2\); si prende \(n\) dispari proprio per non dover arbitrare i pareggi).
L’ipotesi delle due sole alternative pesa sul seguito: le risposte di un agente non sono binarie, e con molte alternative la formula smette di dare l’accuratezza della maggioranza e ne diventa un limite inferiore, perché i voti sbagliati si disperdono invece di sommarsi su un’unica risposta falsa. E si sposta anche la soglia. Con voto di pluralità e voti indipendenti, se ciascuno sceglie la risposta giusta con probabilità \(p\) e la più probabile fra le sbagliate con probabilità \(q\), la pluralità tende alla verità per \(n \to \infty\) non appena \(p > q\), anche con \(p < 1/2\) [LG01]: una risposta giusta al 40% batte dieci risposte sbagliate al 6% ciascuna. La dicotomia con la soglia a \(1/2\) che segue è quella del caso binario.
Il teorema ha due parti: per \(p > 1/2\) la successione \(P_n\), letta sui valori dispari di \(n\), è crescente e tende a \(1\); per \(p < 1/2\) è decrescente e tende a \(0\). Il voto amplifica la tendenza di fondo, qualunque essa sia: sopra la soglia converge alla verità, sotto la soglia converge all’errore, e la soglia è esattamente il tirare a caso.
Con \(p = 0{,}7\): \(P_3 = 0{,}784\), \(P_5 = 0{,}837\), \(P_9 = 0{,}901\), \(P_{21} = 0{,}974\). La convergenza è reale ma lenta, con rendimenti decrescenti marcati: i primi due votanti aggiunti comprano otto punti (\(0{,}700 \to 0{,}784\)), i dodici che portano da nove a ventuno ne comprano sette (\(0{,}901 \to 0{,}974\)). Questa curva va confrontata con il costo, che la sezione sul costo del coordinamento ha mostrato crescere come il quadrato quando tutti leggono tutto: il voto è il caso migliore per il multi-agente proprio perché i votanti non si parlano, e quindi il costo resta lineare in \(n\).
L’indipendenza si può indebolire, e la letteratura lo ha fatto in due modi. Ladha mostra che il teorema regge anche con voti correlati, purché la correlazione media fra i voti resti abbastanza piccola rispetto alla competenza dei votanti [Lad92]. Dietrich e Spiekermann riformulano l’ipotesi come indipendenza condizionata al problema, cioè alla domanda e alle cause comuni che agiscono su tutti i votanti, e mostrano che in quel caso, se i problemi si dividono in facili e difficili, la maggioranza non tende a \(1\) ma alla probabilità che il problema sia facile [DS13]. Il modello a trappole, che arriva fra poco, è il caso più semplice di questo risultato, con le trappole al posto dei problemi difficili.
L’ipotesi che non regge#
Qui arriva il punto della sezione. Il teorema di Condorcet ha un’ipotesi, l’indipendenza, e nei sistemi multi-agente costruiti oggi quell’ipotesi è quasi sempre falsa. Lo misurano Kim e colleghi su più di trecentocinquanta modelli: sulle domande di una delle classifiche pubbliche che esaminano, quando due modelli sbagliano entrambi danno la stessa risposta sbagliata circa sei volte su dieci (a caso, fra le risposte sbagliate disponibili, accadrebbe una volta su tre), e gli errori sono molto correlati proprio fra i modelli più grandi e più accurati, anche di architetture e fornitori diversi [KGPG25].
Dieci copie dello stesso modello, con lo stesso foglio di istruzioni, davanti alla stessa domanda, valgono molto meno di dieci votanti indipendenti. È una conseguenza di come sono fatte. I pesi del modello, cioè i numeri che l’addestramento ha aggiustato una volta per tutte, sono fissi, e l’unica cosa che varia da una risposta all’altra è il campionamento: parola per parola, il modello non prende sempre la più probabile, ma ogni tanto ne pesca una vicina, e quanto spesso lo faccia lo regola la temperatura. Portata a zero, il caso si spegne e dieci copie restituiscono (quasi) la stessa risposta, cioè un parere fotocopiato dieci volte. Alzandola si cambia il percorso lungo il quale la risposta si forma, non la macchina che la forma: restano identici i pesi, i dati su cui il modello si è addestrato e le lacune che quei dati hanno lasciato. Un errore sistematico vive esattamente lì (una formula memorizzata male, un’ambiguità letta sempre nello stesso verso, un fatto che nei testi di addestramento compare solo nella versione sbagliata) e non è il tipo di errore che quel pescare parole vicine possa disperdere: non è un singolo agente a sbagliare, sbagliano tutti, e sbagliano allo stesso modo. La maggioranza, in quel caso, non corregge niente: certifica.
È anche una previsione che si può mettere alla prova in mezz’ora, e conviene farlo prima di fidarsi di un voto. Su un insieme di domande con la risposta nota si conta, per ogni coppia di agenti, quanto spesso sbagliano insieme, e lo si confronta con il prodotto delle due frequenze di errore, che è quanto sbaglierebbero insieme se fossero indipendenti. Se la frequenza congiunta supera di molto il prodotto, gli errori sono correlati e la formula di Condorcet non si applica. (Contare soltanto quanto spesso gli agenti concordano sulle domande sbagliate non basta: con due sole risposte possibili, due agenti che sbagliano danno per forza la stessa risposta sbagliata.)
Mettiamo dei numeri, con la descrizione più semplice che tenga dentro il fenomeno. Una parte delle domande sono trappole: contengono proprio la cosa che manda fuori strada quel modello, e su quelle sbagliano tutti gli agenti insieme. Sulle altre gli errori sono indipendenti, come vuole Condorcet.
Diciamo che una domanda su cinque è una trappola, e che sulle altre quattro ogni agente ci prende sette volte su otto. Sono numeri scelti apposta perché il singolo agente, sul totale delle domande, resti corretto le solite sette volte su dieci: quattro quinti per sette ottavi fa esattamente sette decimi, quindi uguale a prima, indistinguibile da fuori se guardi un agente alla volta.
Al voto, però, le cose cambiano, anche se con tre agenti quasi non si vede: si passa da settantotto volte su cento a settantasette. Il conto è in due pezzi. Sulle venti trappole su cento la maggioranza sbaglia sempre. Sulle altre ottanta ciascuno ci prende sette volte su otto, e il conto dei casi fatto per Condorcet, rifatto con sette ottavi al posto di sette decimi, dà una maggioranza giusta novantasei volte su cento: novantasei per cento di ottanta fa settantasette. Con nove agenti, dove Condorcet prometteva novanta, ci si ferma a ottanta. E la cosa da guardare è che oltre non si va: con ventuno agenti si fa ottanta, con novantanove ancora ottanta. Il tetto lo fissa la quota di domande-trappola: restano le altre quattro domande su cinque, cioè l’ottanta per cento, e nessun numero di partecipanti supera quella soglia, perché su quel quinto di domande stanno sbagliando tutti insieme.
C’è di peggio, ed è la parte che dovrebbe far paura. Sulle trappole i nove agenti non sbagliano un po’ ciascuno per conto suo: rispondono la stessa cosa sbagliata, all’unanimità. Chi usa l’accordo come misura di fiducia (nove su nove, andiamo tranquilli) sta leggendo il segnale più forte proprio nel momento in cui è più falso.
Il conto si fa su cento domande. Venti di quelle cento sono trappole, e lì tutti e nove rispondono la stessa cosa sbagliata: venti unanimità, tutte sbagliate. Delle altre ottanta, quante sono quelle in cui tutti e nove ci prendono? Ciascuno ci prende sette volte su otto, e perché ci prendano tutti e nove insieme bisogna moltiplicare fra loro nove sette-ottavi, cosa che una calcolatrice fa in un secondo e dà poco più di trenta volte su cento: ventiquattro domande sulle ottanta. In tutto quarantaquattro unanimità, di cui venti sbagliate. Quasi una su due.
Sia \(\lambda\) la probabilità che una domanda appartenga alla regione di errore sistematico, dove il voto degenera perché tutti gli agenti producono la stessa risposta errata, e \(p_0\) la probabilità di correttezza individuale sulle domande restanti, dove gli errori sono indipendenti. La probabilità marginale di correttezza del singolo agente è \(p = (1-\lambda)\,p_0\), e quella del voto di maggioranza vale
dove il fattore \(1-\lambda\) non dipende da \(n\) e mette un tetto che nessun numero di votanti supera. Con \(\lambda = 0{,}2\) e \(p_0 = 0{,}875\) si ha \(p = 0{,}7\), identica al caso indipendente, ma il tetto è \(0{,}8\) contro l’\(1\) di Condorcet.
La versione generale del fenomeno si legge sulla varianza. Per \(n\) votanti scambiabili, ciascuno con varianza \(\sigma^2\) e correlazione a coppie \(\rho\), la varianza della media vale \(\sigma^2\,[1 + (n-1)\rho]/n\), che per \(n\) grande tende a \(\sigma^2\rho\) invece che a zero. Il numero efficace di votanti è quindi
dove \(\rho\) è la correlazione fra i giudizi di due votanti qualsiasi. Con \(\rho = 0{,}5\), mille agenti valgono due votanti indipendenti; con \(\rho = 0{,}2\) ne valgono cinque. Il numero va preso per quello che è, un ordine di grandezza: il conto è esatto per la varianza della media, mentre l’accuratezza della maggioranza su voti binari non è determinata dalla sola correlazione a coppie (due meccanismi di correlazione con la stessa \(\rho\) possono dare curve \(P_n\) diverse, e il modello a trappole è appunto un meccanismo particolare). Il messaggio qualitativo però non cambia: la curva si appiattisce. È la stessa aritmetica che governa gli ensemble nella sezione sugli alberi e gli ensemble, dove il guadagno del bagging viene dalla decorrelazione e non dal numero di alberi. La conseguenza per chi progetta è una sola: finché \(\rho\) non si misura, il numero di agenti che si pagano dice poco sul numero di giudizi indipendenti che si ottengono, e la curva reale sta sotto quella di Condorcet.
Peggiora se si guarda l’unanimità. Nel modello a trappole, con \(n = 9\), la probabilità che tutti concordino è \(\lambda + (1-\lambda)p_0^9 = 0{,}441\): il primo addendo sono le trappole, il secondo il caso in cui, fuori dalle trappole, tutti e nove abbiano ragione (si trascura la coincidenza di nove errori indipendenti, che su risposte non binarie ha probabilità irrisoria). La probabilità che una risposta unanime sia sbagliata è dunque \(\lambda / 0{,}441 = 0{,}454\). L’accordo, usato come stima della confidenza, è un cattivo stimatore in modo asimmetrico: è alto quando l’errore è sistematico, cioè proprio nei casi in cui servirebbe un allarme.
Il codice che produce questi numeri sta in una trentina di righe e non ha bisogno di nulla oltre la libreria standard.
from math import comb


def maggioranza(n, p):
    """Probabilita' che piu' della meta' di n votanti indipendenti sia corretta."""
    return sum(comb(n, k) * p**k * (1 - p) ** (n - k)
               for k in range(n // 2 + 1, n + 1))


def maggioranza_correlata(n, p0, lam):
    """Con probabilita' lam la domanda e' una trappola e sbagliano tutti insieme;
    altrimenti ciascuno e' corretto in modo indipendente con probabilita' p0."""
    return (1 - lam) * maggioranza(n, p0)


lam, p0 = 0.2, 0.875   # cosi' il singolo agente resta corretto il 70% delle volte

print("  n   indipendenti   correlati")
for n in (1, 3, 5, 9, 21, 99):
    print(f"{n:3d}       {maggioranza(n, 0.7):.3f}         "
          f"{maggioranza_correlata(n, p0, lam):.3f}")

# Nove agenti che rispondono all'unisono: quanto vale quell'unanimita'?
concordi_giusti = (1 - lam) * p0**9
concordi_sbagliati = lam           # sulle trappole sbagliano tutti allo stesso modo
unanimi = concordi_giusti + concordi_sbagliati
print(f"\nP(unanimita' su 9) = {unanimi:.3f}, "
      f"di cui sbagliate {concordi_sbagliati / unanimi:.1%}")
  n   indipendenti   correlati
  1       0.700         0.700
  3       0.784         0.766
  5       0.837         0.787
  9       0.901         0.798
 21       0.974         0.800
 99       1.000         0.800

P(unanimita' su 9) = 0.441, di cui sbagliate 45.4%
Riassunto in una riga: fra agenti che sbagliano insieme il voto alza la correttezza solo fino a un tetto (\(1-\lambda\), qui \(0{,}80\) invece di \(1\)), e alza la sicurezza con cui la risposta viene data molto più della correttezza. Ed è un esito pericoloso: un sistema che sbaglia e dà segno di essere incerto si può ancora recuperare, mentre uno che sbaglia esibendo nove firme in calce no.
L’indipendenza, però, non è tutto o niente: un po’ se ne può comprare, e ogni modo di comprarla ha il suo prezzo. Si può alzare la manopola della temperatura, perché le risposte prendano strade diverse. Si può chiedere esplicitamente modi di ragionare diversi: risolvi per stima, poi per calcolo esatto, poi partendo dal risultato e tornando indietro. Si può cambiare il modo in cui la domanda è posta, riformulandola o rimescolando l’ordine delle opzioni, che è anche il modo di scoprire quanto la risposta dipendeva dalla formulazione. E si può, quando è possibile, cambiare modello: è l’intervento che allontana di più gli errori gli uni dagli altri, perché cambia la macchina e non solo la strada che percorre, anche se modelli diversi e accurati sbagliano spesso sulle stesse domande [KGPG25]; ed è anche il più caro da gestire.
È esattamente il meccanismo della self-consistency [WWS+23], che la sezione sul prompt engineering ha descritto come voto di maggioranza fra catene di ragionamento campionate, e dove era già comparsa la stessa riserva: il voto protegge dagli errori che cambiano da una catena all’altra, non da quello che la domanda induce in tutte allo stesso modo. Il modello a trappole la mette in numeri. Funziona, e funziona per la ragione appena messa in conto: variare il modo di generare rende gli errori un po’ meno simili fra loro. Conviene insistere su quel «un po’». Quei percorsi escono tutti dallo stesso modello, quindi la somiglianza si abbassa ma non arriva a zero, il tetto resta dov’era, e il guadagno reale è sempre inferiore a quello che il conto di Condorcet promette.
Ne discende la cosa pratica da fare, che è una sola e costa una serata. Invece di scegliere il numero di agenti a intuito, si prova con tre, con cinque, con nove, con ventuno, e ogni volta si misura quanto ci prende il gruppo. All’inizio i numeri salgono; a un certo punto smettono, e da lì in poi aggiungere agenti non compra più niente. Il punto in cui smettono di salire è il tetto, ed è misurato invece che sperato. Va misurato con cura, però, perché le differenze vicino al tetto sono piccole: nel modello a trappole fra cinque e ventuno agenti c’è poco più di un punto. Su \(m\) domande l’accuratezza di un gruppo che ci prende l’80% ha un errore standard di \(\sqrt{0{,}8 \cdot 0{,}2/m} = 0{,}4/\sqrt{m}\), cioè quasi due punti con cinquecento domande; servono quindi molte domande, le stesse per tutti i gruppi, e il tetto è il punto oltre il quale le differenze non superano più quell’incertezza.
Dibattere invece di votare#
Se contare le teste non basta, si può cambiare gioco: invece di aggregare risposte, farle scontrare. Nel dibattito due agenti rispondono alla stessa domanda, si contestano a vicenda a turno, e un terzo (un umano, o un altro modello) dichiara chi dei due ha dato l’informazione più vera e più utile. L’idea la propongono nel 2018 Geoffrey Irving, Paul Christiano e Dario Amodei [ICA18], non come un prodotto ma come una linea di ricerca su un problema aperto: come si fa a controllare un sistema che su una certa questione ne sa più di chi lo controlla. Niente, nelle regole, obbliga i due a sostenere risposte diverse, e se coincidono non c’è niente da dibattere; per questo negli esperimenti i ruoli si assegnano in anticipo, e uno sostiene una risposta mentre l’altro la contesta.
Il meccanismo interessante è lo squilibrio fra inventare e controllare. Comporre un cruciverba richiede giorni; verificare che una griglia compilata sia giusta richiede minuti, e non serve saperlo comporre. Il cruciverba è però il caso facile: lì basterebbe farsi dare la griglia e controllarla, e due agenti non servirebbero. Il dibattito nasce per il gradino sopra, quello in cui nemmeno la griglia compilata è alla portata del giudice. Quello che i turni comprano è la riduzione di scala. A ogni turno chi afferma scompone la propria tesi, chi contesta indica la parte che ritiene falsa, e il giro dopo si ricomincia lì dentro: alla fine il giudice non ha davanti la griglia, ha una casella sola (Fig. 22.4).
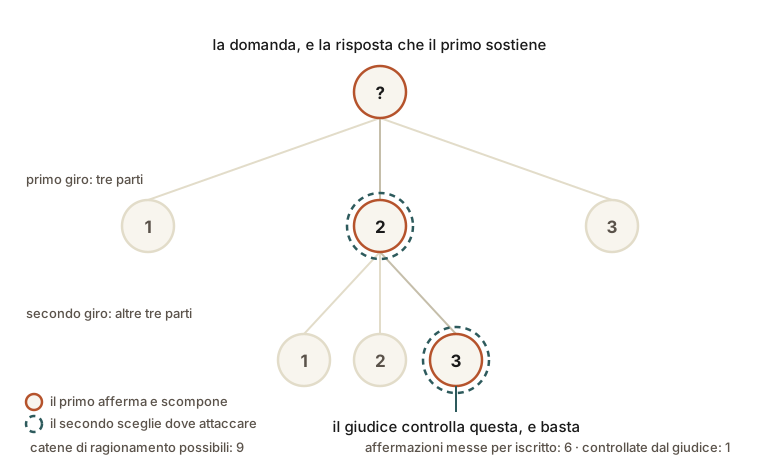
Fig. 22.4 Il dibattito non percorre l’albero delle affermazioni: ne apre un ramo per volta. Il ramo lo sceglie il contendente che vuole vincere, mai il giudice: per vincere gli conviene indicare il punto dove crede ci sia la falla.#
In un processo il giudice non ha svolto le indagini, non ha visitato la scena, non ha interrogato i testimoni: da solo non arriverebbe mai alla verità. Eppure decide, e il sistema funziona perché il suo compito è più piccolo: accorgersi di quando un ragionamento non sta in piedi. Ci sono due parti che hanno interesse opposto, e ciascuna ha tutte le ragioni per mettere in evidenza la falla dell’altra.
Ecco il punto che rende il meccanismo forte: se uno dei due mente, all’altro conviene puntare il dito esattamente sul punto della bugia. Non deve conoscere tutta la verità per farlo, e ci riesce per una ragione precisa: è bravo quanto chi mente, ha davanti la stessa ricostruzione, e gli basta trovare un anello che non regge. Se lasciasse passare proprio quello, perderebbe: per questo contesta l’anello che gli sembra più debole.
E il processo non si esaurisce in un’udienza. Chi ha parlato per primo, messo sotto accusa su un punto, quel punto lo spiega più minutamente; l’altro guarda la spiegazione e di nuovo indica il pezzo che non gli torna; e si va avanti così, restringendo ogni volta. Alla fine il disaccordo si è stretto a un dettaglio solo, e controllare un dettaglio è alla portata di chiunque, anche di chi non avrebbe saputo ricostruire l’intera storia. Il giudice non deve essere più bravo dei dibattenti: deve solo saper valutare l’ultimo passaggio contestato. Quante udienze servano lo decide il caso: più è intricato, più giri ci vogliono per arrivare a quel dettaglio.
E qui sta anche il limite, che è bene guardare in faccia. Tutto regge finché il giudice distingue un argomento sbagliato da uno valido. Se si lascia convincere dal più sicuro di sé, dal più fluente, da chi usa le parole difficili, allora il dibattito non premia chi ha ragione: premia chi è più persuasivo, che è una qualità diversa e a volte opposta.
Il guaio peggiore però non riguarda il giudice. Se accusa e difesa hanno studiato sugli stessi libri e credono tutte e due alla stessa cosa falsa, quella cosa in aula non la nomina nessuno: non viene contestata, il giudice non la sente mai, e il verdetto si gioca su tutto il resto. Ed è il caso normale, non quello raro: due contendenti presi dallo stesso modello hanno studiato sugli stessi libri per forza. Il processo porta alla luce i disaccordi che ci sono; quelli che non ci sono non li inventa.
Il dibattito si formalizza come un gioco a somma zero a due giocatori: dati una domanda e un limite di lunghezza degli interventi, i due agenti si alternano e alla fine un giudice, con risorse di calcolo limitate, dichiara chi ha dato l’informazione più vera e utile. L’addestramento che gli autori propongono è per self-play sullo stesso gioco, con la stessa struttura del self-play dietro AlphaGo, nella sezione sulla ricerca ad albero Monte Carlo, e che Imparare insieme riprende per esteso.
L’argomento teorico che gli autori portano è un’analogia con la teoria della complessità, e chiarisce esattamente che cosa il dibattito compri [ICA18]. Un giudice che valuta direttamente una risposta esibita da un solo agente può decidere, con gioco ottimale, le domande in NP: quelle per cui esiste un certificato breve, verificabile in tempo polinomiale. Il gioco del dibattito, con due agenti in competizione, arriva a PSPACE, che contiene NP e tutta la gerarchia polinomiale, perché l’alternanza fra i due giocatori corrisponde all’alternanza dei quantificatori di una formula booleana quantificata, ed è quella corrispondenza (la PSPACE-completezza di TQBF) a reggere il risultato. Le ipotesi però contano, e sono tre: i dibattenti hanno potenza di calcolo illimitata, e il dibattente onesto deve poterla usare tutta, perché per vincere è costretto a simulare per intero un calcolo esponenziale; il giudice è polinomiale ma scelto in funzione del problema; e il numero di turni cresce con il problema, perché a \(n\) turni fissati la classe raggiunta è \(\Sigma_n^P\), un gradino della gerarchia polinomiale per ogni turno. Il guadagno non viene dal fatto che i dibattenti siano più bravi, ma dal fatto che il giudice non deve esaminare l’intero albero degli argomenti: gli basta seguire il ramo che i due, con interessi opposti, hanno scelto di contestare.
Tre avvertenze, e sono sostanziali. La prima: il risultato vale con gioco ottimale e giudice affidabile, cioè capace di valutare correttamente l’ultimo passaggio conteso. Un giudice sensibile alla posizione dell’intervento, alla sua lunghezza o alla somiglianza con il proprio stile rompe l’ipotesi, e il gioco premia la persuasione invece della verità. Sono esattamente i tre bias dell’LLM-as-a-judge (position, verbosity e self-enhancement) che la sezione su LLMOps riprende con i numeri: i primi due misurati, il terzo osservato senza poter essere dimostrato. La seconda riguarda proprio questo capitolo: due dibattenti istanziati dallo stesso modello ereditano la correlazione appena descritta. Se entrambi condividono lo stesso errore sistematico, nessuno dei due lo contesta, l’errore non entra mai nel dibattito e il giudice non ha nulla su cui esercitare la propria verifica. Il dibattito rende ispezionabile il disaccordo che c’è, non crea quello che manca.
La terza avvertenza è la più grave, perché non riguarda il giudice né la somiglianza fra i due: attacca l’asimmetria stessa da cui tutto discende. Chi mente può scomporre la propria tesi in moltissimi pezzi sapendo che uno è falso senza sapere quale, e a quel punto smascherarlo costa all’onesto un lavoro computazionalmente intrattabile, mentre a lui l’imbroglio non è costato quasi niente. È il problema degli argomenti offuscati (obfuscated arguments), che Beth Barnes descrive nel 2020 a partire da esperimenti di dibattito [Bar20], e sotto di esso non è più vero che mentire sia più difficile che confutare una menzogna. I protocolli successivi nascono per aggirarlo: il doubly-efficient debate toglie l’ipotesi che l’onesto debba simulare un calcolo esponenziale [BCIP23], e la variante prover-estimator, di cui Irving è coautore, arriva a garantire la vittoria dell’onesto con uno sforzo paragonabile a quello dell’avversario, ma solo sotto ipotesi di stabilità [BCIP+25].
Quando qualcuno mente: i generali bizantini#
Resta il caso duro, e ha un teorema che dice esattamente quanto è duro. Nel 1982 Leslie Lamport, Robert Shostak e Marshall Pease pubblicano un articolo destinato a diventare un classico dei sistemi distribuiti [LSP82]. La storiella è nota: alcune divisioni assediano una città, i generali comunicano solo con messaggeri, devono decidere insieme se attaccare o ritirarsi, e alcuni di loro sono traditori che possono dire cose diverse a interlocutori diversi. Il nome ha una piccola storia editoriale che Lamport ha raccontato lui stesso: la prima versione parlava di generali albanesi, scelti perché l’Albania di allora era un paese chiuso e sembrava improbabile che qualcuno protestasse; fu un collega, Jack Goldberg, a fargli notare che di albanesi ce n’è anche fuori dall’Albania, e allora si ripiegò su un impero abbastanza estinto da non offendersi.
Facciamo il caso più piccolo: tre generali, di cui uno traditore, e messaggi solo a voce. Uno comanda e gli altri due eseguono.
Prendi il punto di vista di un generale leale che riceve «attacca» dal comandante. Chiede conferma al collega e quello risponde: «a me ha detto ritirati». Adesso il nostro generale sa che uno dei due mente, ma non ha alcun modo di sapere quale: le due storie sono perfettamente simmetriche. Potrebbe essere il comandante che ha dato ordini diversi ai due ufficiali sotto di lui (i luogotenenti), oppure il collega che riferisce il falso. Dall’interno, le due situazioni sono indistinguibili, perché sono fatte esattamente degli stessi messaggi.
E il «a voce» conta, perché è l’unica cosa che rende il bugiardo impunibile: se i messaggi fossero firmati in modo non falsificabile, il nostro generale mostrerebbe al collega il foglio con la firma del comandante, e chi ha mentito salterebbe fuori in un colpo. Restiamo dunque a voce, che è il caso duro.
Il caso dei tre è il mattone di un risultato più generale, che qui non dimostriamo: con soli messaggi a voce non basta che gli onesti siano la maggioranza, devono essere più di due terzi. Il che vuol dire che i bugiardi possono essere meno di un terzo, cioè che per sopportarne uno bisogna essere almeno in quattro (uno su quattro è meno di un terzo, uno su tre no); per due bugiardi almeno in sette, per tre almeno in dieci. Ogni bugiardo in più costa tre partecipanti. E non è che non si sia ancora trovato l’algoritmo giusto: è dimostrato che non esiste.
E con quattro, che cosa cambia? Che ciascuno, prima di decidere, chiede a tutti gli altri che cosa hanno sentito, mette insieme le risposte e prende quella che compare più volte. Guarda i due casi. Se a mentire è il comandante, i tre luogotenenti leali si scambiano le tre versioni che hanno ricevuto e si ritrovano in mano tutti e tre lo stesso identico mucchietto: da un mucchietto uguale tirano fuori la stessa conclusione, qualunque essa sia, e attaccare tutti insieme o ritirarsi tutti insieme era proprio l’obiettivo. Se invece a mentire è un luogotenente, i due leali hanno l’ordine vero due volte (ricevuto dal comandante e confermato l’un l’altro) e la bugia una volta sola: vince l’ordine vero. Con tre partecipanti quel mucchietto è di due sole risposte, una per parte, e non c’è modo di far comparire qualcosa due volte: è tutta lì la differenza.
C’è però un secondo muro, e sta prima di questo. Finora abbiamo dato per buona una cosa che sembra ovvia e non lo è: che ci si accorga quando un generale non risponde. Ma come fai ad accorgertene? Aspetti. E se dopo un’ora non è arrivato niente non sai se il messaggero è morto o se è solo in ritardo: da dove sei tu, un compagno fermo e un compagno lento sono la stessa identica cosa. Nel 1985 tre informatici hanno dimostrato che senza un tempo massimo garantito per consegnare un messaggio basta che uno solo dei partecipanti possa fermarsi, senza mentire e senza fare niente di male, perché nessuna procedura fissata in anticipo possa garantire che gli altri si mettano d’accordo [FLP85]. Ecco perché i sistemi veri, prima ancora di preoccuparsi dei bugiardi, comprano un orologio: decidono di aspettare al massimo tanto e di considerare morto chi non ha risposto entro quel tanto, sapendo benissimo che ogni tanto dichiareranno morto qualcuno che era soltanto lento. È il prezzo, e si paga volentieri.
Formalmente, un comandante deve trasmettere un ordine a \(n-1\) luogotenenti in modo che valgano due condizioni: tutti i luogotenenti leali eseguono lo stesso ordine, e se il comandante è leale ogni luogotenente leale esegue proprio l’ordine impartito. Con messaggi orali (consegna garantita, mittente identificabile, assenza di messaggio rilevabile, ma nessuna firma) il risultato di Lamport, Shostak e Pease è di impossibilità: nessuna soluzione esiste se i partecipanti sono \(n \le 3f\), dove \(f\) è il numero di partecipanti che possono comportarsi in modo arbitrario. Serve dunque
e la condizione è anche sufficiente: l’algoritmo \(\mathrm{OM}(f)\) degli autori risolve il problema con \(n \ge 3f+1\) in \(f+1\) giri di messaggi, al prezzo di un numero di messaggi che cresce come \(O(n^{f+1})\), perché a ogni giro ciascun luogotenente rigira a tutti gli altri quello che ha appena sentito. Cambiando ipotesi cambia il limite: con messaggi firmati, cioè con firme non falsificabili e verificabili da chiunque, il vincolo dei due terzi cade e l’algoritmo \(\mathrm{SM}(f)\) risolve il problema con qualunque numero \(f\) di traditori; sotto \(n = f+2\) i generali leali sono al più uno, e il problema non ha più niente da chiedere.
Delle tre ipotesi orali conviene però fermarsi sulla terza, perché è un’ipotesi sul tempo, travestita da dettaglio tecnico. Sono gli autori stessi a scioglierla, quando passano ai sistemi reali. L’assenza di un messaggio si può rilevare in un modo solo, cioè constatando che non è arrivato entro un tempo prefissato, e questo richiede che esista un tempo massimo entro il quale un messaggio viene prodotto e consegnato. Quella terza ipotesi, che nell’articolo porta il nome A3, è alla lettera l’ipotesi di sincronia.
Tolta quella, il quadro cambia di natura, e per una ragione che con i traditori non c’entra niente. Il risultato di Fischer, Lynch e Paterson del 1985 [FLP85] dice che in un sistema asincrono, dove non esiste alcun limite noto ai ritardi di consegna né alla velocità relativa dei processi, nessun protocollo deterministico risolve il consenso se anche un solo processo può guastarsi, e guastarsi nel modo più mite immaginabile: fermandosi. Nessuna malizia, nessun messaggio contraddittorio, nessuna coalizione di traditori. Un processo che tace, e basta. La ragione, in una riga, è che in un sistema asincrono un processo fermo e un processo lento sono indistinguibili: chi aspetta non può sapere se sta aspettando invano, e un protocollo che decida comunque si lascia portare a decidere male da un ritardo abbastanza sfortunato.
I due risultati sono due muri in modelli diversi, e non si ordinano l’uno sull’altro. FLP vale nel modello più debole, quello asincrono, e chiede soltanto che un processo possa fermarsi; \(3f+1\) vale anche nel modello sincrono, ma per guasti arbitrari. La soglia dei due terzi è quindi ciò che si paga dopo aver comprato l’ipotesi che FLP nega, cioè un limite ai tempi. Le monete con cui la si compra sono tre, e sono tutte e tre in uso. La sincronia parziale, cioè i timeout: si scommette su un tempo massimo, e si accetta di sbagliare quando la scommessa salta. La randomizzazione, che rinuncia alla terminazione certa e si tiene quella con probabilità \(1\) [BO83]. E i rilevatori di guasti, cioè un oracolo esterno, necessariamente fallibile, che dichiara chi è morto [CT96]. Paxos [Lam98] e Raft [OO14], i due algoritmi con cui si tengono coerenti le basi di dati replicate, comprano la prima: la coerenza la garantiscono sempre, decidere entro un tempo dato no, e quando la rete si comporta male smettono di avanzare invece di sbagliare. Tollerano però processi che si fermano, non processi che mentono, e per questo bastano \(n \ge 2f+1\) repliche: due maggioranze qualsiasi hanno sempre un membro in comune. Il caso bizantino in sincronia parziale richiede di nuovo \(n \ge 3f+1\), e qui le firme non lo abbassano, perché con ritardi senza limite noto un leale non distingue un traditore da un compagno lento [DLS88]; il suo algoritmo classico è PBFT di Castro e Liskov [CL99]. La soglia \(n \ge f+2\) dei messaggi firmati è, insomma, un risultato sincrono.
È un punto di metodo che vale ben oltre i generali: un risultato di impossibilità non dice «impossibile», dice «impossibile sotto queste ipotesi», e il lavoro dell’ingegnere è capire quale ipotesi si può comprare. Qui le ipotesi da comprare sono due, a due prezzi diversi: la sincronia si paga in latenza e in falsi allarmi, la lealtà dei partecipanti si paga in partecipanti, tre volte tanti quanti sono i bugiardi che si vogliono tollerare.
Che cosa c’entra un teorema sui protocolli di consenso con l’intelligenza artificiale? C’entra perché parte da una distinzione che qui serve tale e quale. Un partecipante guasto smette di rispondere: se ne accorge chiunque, basta aspettare un po’ e dichiararlo morto, e la cura è avere qualcuno di riserva (se uno tace, chiedi a un altro). Un partecipante bizantino, cioè bugiardo, risponde: risponde in tempo, risponde in modo perfettamente plausibile, e dice il falso. Nessuna attesa lo smaschera, perché dal punto di vista del protocollo si sta comportando benissimo.
Un modello di linguaggio che si inventa una cosa e la dice con sicurezza è, in questa classificazione, un partecipante bizantino. Non si blocca, non restituisce un errore, non abbassa il tono: produce una citazione inesistente con lo stesso garbo con cui produce quelle vere. Ecco la ragione tecnica per cui la ridondanza ingenua non basta: con \(n \ge 3f+1\) partecipanti si tollerano \(f\) bugiardi, ma solo se mentono ciascuno per conto suo, mentre copie dello stesso modello sbagliano insieme, sulla stessa domanda e nello stesso verso (sono gli errori correlati della sezione sul voto). Le architetture multi-agente costruite sull’idea «se sono in tanti, qualcuno se ne accorgerà» contano su un’indipendenza che non hanno. Lo stesso terreno lo riprende la sezione su privacy e robustezza, dove robusto vuol dire comportarsi in modo prevedibile quando qualcosa (o qualcuno) prova a farti sbagliare.
Va detto con onestà fin dove arriva l’analogia. Il teorema descrive un avversario che sceglie la strategia peggiore possibile e può mettersi d’accordo con gli altri traditori: un modello che sbaglia non è malevolo in quel senso, e la soglia dei due terzi non si trasferisce come formula ai sistemi di agenti, che non hanno traditori coordinati da tollerare. Quello che si trasferisce, e conta parecchio, è la classificazione dei guasti e la sua conseguenza di progetto: contro un partecipante che mente con garbo, l’unica difesa è un riscontro esterno che non passi per la sua parola. Uno strumento che misura, una fonte che si può andare a leggere, un programma di prova che o passa o non passa: è il cancello di verifica della sezione sul costo del coordinamento, qui nella veste di antidoto alla menzogna. E vale, sempre, l’avvertenza che la stessa sezione dava sui fallimenti reali: un verificatore che non ha modo di controllare davvero non aggiunge informazione, aggiunge una firma [CPY+25].
Rendere visibile il disaccordo#
C’è una cosa che il teorema dei generali bizantini garantisce e una che non garantisce, e la distinzione chiude la sezione. Garantisce l’accordo: i partecipanti leali decidono tutti lo stesso valore. Non garantisce la verità: se il comandante leale ordina una ritirata sbagliata, il protocollo farà ritirare tutti, ordinatamente e all’unanimità. Consenso e correttezza sono due proprietà diverse, e confonderle è il modo più elegante di costruire un sistema che sbaglia in modo coordinato.
Vale per tutti i meccanismi visti qui. Scrivere il tipo sul messaggio rende controllabile se un agente ha risposto e se ha mantenuto un impegno, senza renderlo più capace. Il voto amplifica la competenza che c’è, nel bene e nel male, e fino al tetto che gli errori comuni gli impongono. Il dibattito rende esaminabile quello che i due contendenti hanno scelto di contestare, e quello soltanto. Tutti questi protocolli rendono osservabile il disaccordo fra gli agenti; per renderli affidabili serve, in più, un riscontro esterno.
Ed è già molto, purché si progetti per quello. In pratica significa tre cose.
Registrare i voti, non solo il vincitore. Cinque a quattro e nove a zero hanno lo stesso esito e valgono in modo diversissimo, e chi tiene solo l’esito butta via proprio l’informazione che gli servirebbe.
Trattare il disaccordo come un segnale da mandare da qualche parte, a un giudice, a un altro strumento o a una persona, invece che come rumore da appiattire.
Diffidare dell’unanimità almeno quanto del conflitto. In un gruppo di agenti costruiti tutti allo stesso modo il consenso perfetto è più spesso la firma di un errore condiviso che la prova di una risposta giusta.
Un sistema in cui il disaccordo emerge ed è ispezionabile è migliore di uno che converge in silenzio sulla risposta sbagliata.
Da ricordare
Un messaggio fra agenti ha un contenuto e, separato da quello, quello che fa: dare una notizia, chiedere qualcosa, prendersi un impegno, rifiutare. Sono i tre biglietti sul frigorifero, che dicono quasi la stessa cosa e assegnano tre responsabilità diverse. Scriverlo sul biglietto invece di lasciarlo indovinare permette a un programma di dire, a fine giornata, se una richiesta ha avuto risposta e se un impegno è stato onorato, e se a rispondere è stato chi ne aveva titolo. Uno dei primi protocolli di questo tipo è il Contract Net [Smi80], cioè bando, offerta, assegnazione e rapporto finale.
Condorcet: se tre persone ci prendono sette volte su dieci ciascuna e decidono a maggioranza, il gruppo ci prende quasi otto volte su dieci, e con nove il novanta per cento. Ma se le risposte possibili sono due e ciascuna ci prende meno della metà delle volte, votare peggiora le cose. Il voto non aggiunge competenza: amplifica quella che c’è, nel bene e nel male.
Fra agenti identici l’ipotesi crolla. Dieci copie dello stesso modello con le stesse istruzioni valgono molto meno di dieci votanti indipendenti: sulle domande che mandano fuori strada quel modello sbagliano tutte insieme e allo stesso modo, e su quelle il voto non corregge, certifica. Il voto alza ancora la correttezza, ma solo fino a un tetto (con una domanda su cinque fatta di trappole, l’ottanta per cento), e alza molto di più la sicurezza con cui la risposta viene data: su nove agenti concordi, quasi una unanimità su due è sbagliata.
Un po’ di indipendenza si compra: far generare le risposte in modo meno prevedibile, chiedere strade di ragionamento diverse, riformulare la domanda, cambiare modello. È il motivo per cui la self-consistency [WWS+23] funziona; il guadagno però resta sempre sotto a quello promesso, e il modo di scoprire quanti agenti servono è provare con tre, cinque, nove, ventuno, sulle stesse domande e su molte, e guardare quando i risultati smettono di salire.
Il dibattito [ICA18] restringe invece di aggregare: a ogni turno chi afferma scompone e chi contesta indica il pezzo che ritiene falso, finché il disaccordo sta in un dettaglio solo. Il giudice non deve essere più bravo dei due contendenti, deve solo saper valutare quel dettaglio. Regge finché il giudice distingue un argomento sbagliato da uno valido, e due contendenti nati dallo stesso modello si portano dietro gli stessi punti ciechi: il dibattito rende visibile il disaccordo che c’è, non crea quello che manca. E chi mente ha una scappatoia: scomporre in tanti pezzi da rendere la caccia all’errore più cara della bugia [BCIP+25].
I generali bizantini [LSP82]: se qualcuno può dire cose diverse a persone diverse, per tollerare un bugiardo servono almeno quattro partecipanti, per due sette, per tre dieci, ed è dimostrato che con meno non si può. (È un teorema su traditori che possono anche mettersi d’accordo fra loro, quindi il conto non si trasferisce così com’è a una squadra di agenti; quello che si trasferisce è la distinzione fra il guasto e il bugiardo.) Un agente guasto tace e lo si becca aspettando; uno bugiardo risponde in tempo, con garbo, e dice il falso, come un modello che produce una citazione inesistente con la stessa disinvoltura di quelle vere. Contro di lui aggiungere copie non serve a niente: serve un riscontro esterno, cioè qualcosa che si possa controllare senza passare dalla sua parola.
E prima ancora dei bugiardi c’è il tempo. Se nessuno garantisce entro quanto un messaggio arriva, un partecipante fermo e uno lento sono la stessa cosa vista da fuori, e basta che uno solo possa fermarsi perché nessuna procedura decisa in anticipo garantisca l’accordo [FLP85]. I sistemi veri comprano un orologio: aspetto al massimo tanto, e chi non risponde lo do per morto, sapendo che ogni tanto sbaglierò.
E il consenso garantisce l’accordo, mai la verità: un gruppo può ritirarsi tutto insieme, ordinatamente, dalla parte sbagliata.
Da ricordare
Un messaggio fra agenti ha un contenuto e una forza illocutoria (che cosa fa: chiedere, informare, impegnarsi, rifiutare). KQML e FIPA-ACL l’hanno resa un campo obbligatorio, e tipizzare i messaggi trasforma la conversazione in una macchina a stati ispezionabile: si può verificare a macchina se una richiesta ha avuto risposta, se un impegno è stato onorato e se a fare la mossa è stato chi ne aveva titolo (una condizione preparatoria di Searle). Il Contract Net [Smi80] (annuncio → offerta → assegnazione → rapporto) è uno dei primi protocolli di questo tipo; oggi la stessa idea torna in MCP e A2A, che tipizzano i messaggi senza eliminare il disallineamento [CPY+25].
Il teorema di Condorcet: con \(n\) votanti indipendenti corretti con probabilità \(p > 1/2\), la maggioranza tende alla verità (\(p = 0{,}7\): \(P_3 = 0{,}784\), \(P_9 = 0{,}901\)). Sotto \(1/2\) (con due alternative) converge all’errore: il voto amplifica la tendenza di fondo. Con voti correlati regge finché la correlazione media è piccola [Lad92]; con indipendenza solo condizionata al problema la maggioranza tende alla probabilità che il problema sia facile, non a \(1\) [DS13].
L’ipotesi crolla fra agenti identici, e la correlazione degli errori si misura anche fra modelli diversi [KGPG25]. Dieci istanze dello stesso modello, a pesi fissi, differiscono solo per il campionamento: con una frazione \(\lambda\) di errori sistematici il voto ha un tetto \(1-\lambda\) (\(0{,}80\) contro l’\(1\) promesso), e con correlazione \(\rho\) il numero efficace di votanti si ferma, come ordine di grandezza, a \(1/\rho\). Il voto alza la correttezza fino a quel tetto e la confidenza molto di più: su nove agenti concordi, il 45% delle unanimità è sbagliato. Che i voti siano indipendenti si controlla confrontando la frequenza degli errori congiunti con il prodotto delle frequenze, e il tetto si cerca con molte domande, le stesse per tutti (\(\mathrm{SE} = \sqrt{p(1-p)/m}\)).
Un po’ di indipendenza si compra: campionare a temperatura, imporre percorsi di ragionamento diversi, riformulare la domanda, cambiare modello. È il motivo per cui la self-consistency [WWS+23] funziona, ma decorrela solo parzialmente: il guadagno reale è sempre minore di quello che Condorcet promette.
Il dibattito [ICA18] riduce la questione a un ramo solo dell’albero degli argomenti: con gioco ottimale, dibattenti illimitati e giudice polinomiale scelto in funzione del problema si passa da NP a PSPACE, e a turni fissati a \(\Sigma_n^P\). Ma regge solo se il giudice riconosce un argomento fallace, due dibattenti dello stesso modello ereditano la stessa correlazione, e l’asimmetria stessa cade sugli argomenti offuscati [Bar20], dove smascherare costa all’onesto più che mentire al disonesto [BCIP23, BCIP+25].
I generali bizantini [LSP82]: con soli messaggi orali servono \(n \ge 3f+1\) partecipanti per tollerarne \(f\) che mentono (con firme, e solo in un sistema sincrono, il vincolo cade, e il problema ha senso da \(n = f+2\) in su). Un agente guasto tace e lo becca un timeout; uno bizantino risponde in modo plausibile e falso, come un LLM che allucina con sicurezza: contro di lui la ridondanza serve solo se i bugiardi sono pochi e indipendenti, e copie dello stesso modello non lo sono; serve un riscontro esterno.
Accanto a quel risultato ce n’è un altro, in un modello diverso. L’ipotesi A3 di Lamport, «l’assenza di un messaggio è rilevabile», è l’ipotesi di sincronia travestita; toltala, FLP [FLP85] dice che in un sistema asincrono nessun protocollo deterministico risolve il consenso se anche un solo processo può fermarsi, perché un processo fermo e uno lento sono indistinguibili. I due muri non si ordinano: la soglia \(3f+1\) è ciò che si paga dopo aver comprato la sincronia; le monete sono timeout, randomizzazione [BO83] e rilevatori di guasti [CT96], e Paxos [Lam98] e Raft [OO14] comprano la prima.
E il consenso garantisce l’accordo, mai la verità.
Protocolli, voti e dibattiti sono regole di interazione scritte da un progettista, che decide in anticipo chi parla, con quali messaggi e chi decide. Resta da vedere se gli agenti possano arrivare a coordinarsi da soli, imparando, e a quali condizioni: è l’argomento della sezione su imparare insieme.