


Deep Q-Network (DQN)#
Il risultato del 2013 su Breakout veniva da un programma solo, provato su sette videogiochi Atari, da Pong a Space Invaders: per tentativi, in tre di quei sette (Breakout, Enduro e Pong) arrivava a superare un umano esperto [MKS+13]. Due anni dopo il risultato finì sulla copertina di Nature [MKS+15]. Quel programma si chiama Deep Q-Network, DQN.
Il Q-learning impara una funzione \(Q(s,a)\) che stima quanto è conveniente, nel lungo periodo, compiere l’azione \(a\) trovandosi nello stato \(s\), e la tiene in una tabella: una riga per ogni stato, una colonna per ogni azione. Funziona con pochi stati. Con le schermate di un videogioco no, e il conto lo ha fatto l’apertura del capitolo: già i fotogrammi ridotti a \(84\times84\) punti in grigio sono un numero di quasi diciassettemila cifre, e a una tabella così non basterebbe l’universo. Al suo posto serve una funzione che generalizzi, cioè che dia valori simili a stati simili anche quando non li ha mai visti.
Dalla tabella alla rete#
La mossa di DQN è tanto semplice quanto radicale: buttiamo via la tabella e mettiamo al suo posto una rete neurale.
Uno schedario, un cartellino per ogni possibile schermata di gioco, e su ciascun cartellino quanto vale ciascuna mossa: è la tabella di prima, e compilarlo, si è visto, non si può. Al posto dello schedario si mette allora un esperto che guarda la schermata e dice il valore di tutte le mosse insieme, in un colpo solo, senza passarle in rassegna una per volta. E lo fa anche per schermate che non ha mai visto prima, perché ha imparato a riconoscere le somiglianze. Quell’esperto è la rete neurale.
Dentro la rete ci sono dei numeri, nella rete di DQN più di un milione e mezzo, che decidono come una schermata si trasforma in un voto: si chiamano pesi, e sono le uniche cose che cambiano mentre la rete impara. Addestrare la rete vuol dire ritoccarli, un pochino alla volta, finché i voti non diventano sensati.
Approssimiamo la funzione azione-valore ottima con una rete parametrizzata da \(\theta\):
La rete prende in ingresso lo stato \(s\) (i pixel) e restituisce in uscita un vettore con un valore \(Q\) per ciascuna azione ammissibile: non serve una passata per azione. È un function approximator: generalizza a stati mai visti, sfruttando la struttura condivisa delle immagini invece di memorizzare ogni caso singolarmente.
Lo stato entra da un lato, una rete convoluzionale ne estrae le caratteristiche visive, e dall’altro lato escono i valori delle azioni (Fig. 14.3).

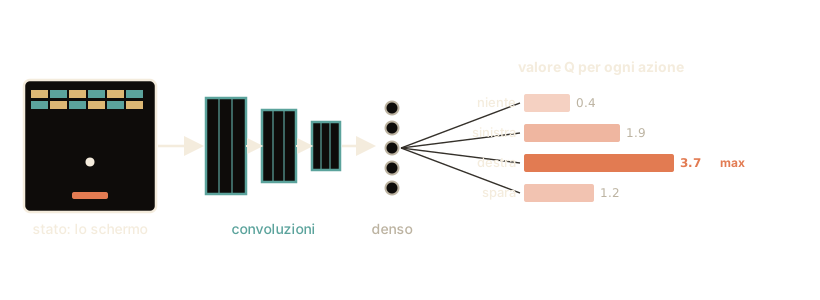
Fig. 14.3 Lo schema di DQN. Lo schermo di gioco attraversa gli strati convoluzionali e uno strato denso; l’uscita è un valore \(Q\) per ogni azione, cioè un voto per ogni mossa. L’agente sceglie l’azione con il valore più alto.#
Perché poteva divergere: la triade fatale#
Mettere una rete al posto della tabella non era, di per sé, un’idea nuova. TD-Gammon lo faceva dal 1992, con una rete addestrata a suon di partite di backgammon giocate contro se stessa; nella versione descritta tre anni dopo giocava quasi come i più forti campioni del mondo [Tes95]. Eppure il Q-learning con una rete era noto per la sua instabilità: i valori stimati potevano crescere senza fermarsi, invece di assestarsi. Funzionava in casi particolari, e il replay delle esperienze che ritroveremo fra poco è di Long-Ji Lin, del 1992 [Lin92]; con aggiornamenti a lotti funzionava anche il Neural Fitted Q-iteration di Martin Riedmiller [Rie05]. In modo affidabile, su problemi grandi e partendo dai pixel, no.
Fra TD-Gammon e il Q-learning c’è una differenza sola, e torna in tutto il capitolo. TD-Gammon aggiornava i valori della policy che stava giocando: apprendimento on-policy. Il Q-learning gioca in un modo e impara un altro. Ogni tanto, apposta, sceglie un’azione a caso per esplorare, ma il bersaglio verso cui corregge la stima non usa il valore di quell’azione: usa quello della migliore fra le azioni disponibili nella situazione successiva. La policy che raccoglie i dati (\(\varepsilon\)-greedy) e quella di cui si stimano i valori (greedy) sono quindi due policy diverse, e si parla di apprendimento off-policy. È comodo, perché permette di imparare da qualunque partita: anche da una giocata male, anche da una giocata da altri molto tempo prima.
E l’instabilità non veniva dalla sfortuna, né da un passo di apprendimento tarato male (il learning rate: di quanto si spostano i pesi a ogni correzione). Prima dei due trucchi che hanno reso il metodo praticabile, serve capire da che cosa lo abbiano salvato: un risultato preciso e sorprendentemente pulito.
Al cabinato c’è un tale col taccuino: guarda giocare e per ogni schermata segna quanto promette bene. Ha tre abitudini.
Non tiene un foglio per ogni schermata, giudica a somiglianza: ci rimette in precisione sulla singola, e in cambio ha un voto anche per quelle che non ha mai visto. È l’approssimazione.
Non aspetta la fine della partita. Una mossa gli frutta \(1\) punto, valuta \(7\) la schermata in cui si ritrova, e scrive subito i due numeri messi insieme, il secondo contato per nove decimi: \(7{,}3\), ed è il bersaglio verso cui correggerà il voto di partenza. Aggiustare un voto con un altro voto si chiama bootstrapping, e separa le differenze temporali del capitolo precedente, il TD, dai metodi Monte Carlo, che aspettano il fischio finale per tirare le somme.
Guarda partite giocate a casaccio e scrive i voti come se al posto di quel giocatore ci fosse un campione: si gioca da esploratore e si prendono appunti da campione. È l’off-policy.
Ognuna di queste abitudini, da sola, è utile, e anche a coppie il taccuino si può tenere in ordine. Tutte e tre insieme aprono la porta a un guaio: i voti possono crescere senza fermarsi. Non succede per forza, e ci sono taccuini più complicati, costruiti apposta, che lo evitano; ma il pericolo c’è, e Richard Sutton e Andrew Barto, che hanno scritto il manuale classico della materia, la chiamano triade fatale.
Per vederla non serve un gioco difficile, serve il contrario. Il più facile del mondo lo costruì Baird, e da lui si chiama controesempio di Baird: sette schermate, e non si guadagna mai un punto. Zero dappertutto è la risposta giusta, e il taccuino potrebbe scriverla alla perfezione: basterebbe mettere a zero la manciata di numeri con cui calcola i voti. Quei numeri, invece di posarsi sullo zero, crescono e non smettono più. Se il metodo sbaglia il problema più semplice del mondo, il guasto non è nel problema.
Il tale ritocca il voto di una schermata, e per somiglianza si spostano da sé anche le vicine: di solito è il suo vantaggio. Ma il bersaglio da cui era partito è il voto di una vicina, uno di quelli che ha appena mosso. Ogni ritocco sposta il bersaglio che l’aveva deciso, e il ritocco seguente insegue un bersaglio già spostato: i voti si rimpallano fra loro.
Di solito quel rimpallo si spegne da sé, e il motivo sta in quanto spesso il tale vede ciascuna schermata. Se le partite che guarda sono giocate come le giocherebbe lui, le schermate frequenti gli passano davanti spesso e quelle rare di rado, nelle proporzioni in cui contano davvero; e sono le frequenti a decidere come va a finire, così il rimpallo si smorza. Che vada così l’hanno dimostrato nel 1997 due studiosi, John Tsitsiklis e Benjamin Van Roy, ma solo per il taccuino più semplice, quello in cui il voto di una schermata è una somma di pezzi, uno per ogni cosa che si vede (tanto per la pallina lì, tanto per la racchetta là). Con una rete a molti strati non c’è riuscito nessuno, e si conoscono casi in cui i voti scappano anche così.
La terza abitudine toglie proprio questa protezione. Le partite del tale sono giocate in un altro modo, e certe schermate gli passano davanti molto più spesso di quanto capiterebbero nel suo gioco, altre quasi mai. Corregge con forza dove non serve, il rimpallo non si smorza più, e i voti salgono invece di posarsi.
La triade fatale [SB18] è la coesistenza di:
approssimazione di funzione, cioè una rappresentazione parametrica che generalizza fra stati invece di trattarli come voci indipendenti;
bootstrapping, cioè bersagli che contengono stime correnti (TD, programmazione dinamica) invece dei soli ritorni osservati;
addestramento off-policy, cioè una distribuzione degli aggiornamenti diversa da quella indotta dalla policy che si sta valutando.
Con due soli dei tre l’instabilità si può evitare. Con tutti e tre il pericolo c’è, e la divergenza si osserva già nel caso della sola predizione, senza controllo né miglioramento della policy. Non dipende nemmeno dall’incertezza sull’ambiente: si manifesta identica nella programmazione dinamica, dove il modello è noto per intero. Pericolo, però, e non condanna: i metodi Gradient-TD, che scendono lungo il gradiente dell’errore di Bellman proiettato al prezzo di un secondo vettore di parametri con il suo passo, e gli Emphatic-TD, che ripesano gli aggiornamenti, combinano tutti e tre gli elementi con garanzie di convergenza nel caso dell’approssimazione lineare [SB18].
Il controesempio di Baird lo esibisce in forma minima: sette stati, due azioni, ricompensa sempre nulla, \(\gamma = 0{,}99\), e una policy di comportamento che visita gli stati in modo uniforme mentre la policy bersaglio ne concentra tutta la massa su uno solo. La funzione valore vera è identicamente zero ed è esattamente rappresentabile dai parametri disponibili; il TD semi-gradiente, ciononostante, fa divergere i pesi. Il fattore decisivo è la distribuzione degli aggiornamenti: uniforme sugli stati, mentre la policy bersaglio li visiterebbe in proporzioni tutte diverse. Non basta osservare che l’aggiornamento semi-gradiente non è il gradiente di nessuna funzione obiettivo (si deriva rispetto alla stima ma non rispetto al bersaglio, che pure dipende dai parametri): lo stesso aggiornamento, con approssimatore lineare e sotto la distribuzione on-policy, converge, come dimostrarono Tsitsiklis e Van Roy nel 1997 [TVR97]. Ed è a quel caso, lineare e on-policy, che si fermano le garanzie di convergenza note: con approssimatori non lineari come le reti si conoscono controesempi di divergenza perfino on-policy.
Sutton e Barto passano poi in rassegna i tre elementi chiedendosi a quale si possa rinunciare, ed è la lettura più utile per chi progetta. All’approssimazione no: senza, non si scala. Al bootstrapping si può, usando Monte Carlo, e si paga in efficienza computazionale (bisogna conservare tutto fino alla fine dell’episodio) e in efficienza di dati. All’off-policy si può, sostituendo il Q-learning con Sarsa, e si perde la possibilità di imparare da un archivio di esperienze altrui, che è però proprio la premessa del replay buffer.
Due accorgimenti per non far esplodere l’addestramento#
DQN non rinuncia a nessuno dei tre elementi della triade: li tiene tutti e tre, e ne rende praticabile la convivenza con i due accorgimenti che seguono.
Experience replay#
Un agente che impara sui fotogrammi nell’ordine in cui li vive è come uno studente che rilegge cento volte la stessa pagina di seguito: fotogrammi consecutivi si somigliano troppo e la rete finisce per «fissarsi». La memoria di replay è un grande quaderno degli appunti: ogni esperienza vissuta viene annotata e, per allenarsi, l’agente pesca a caso vecchie esperienze dal quaderno. Così mescola situazioni lontane nel tempo e impara in modo più equilibrato, e riutilizza ogni esperienza molte volte, non una sola.
Ogni transizione \((s, a, r, s')\) viene salvata in un buffer \(\mathcal{D}\) (tipicamente un milione di transizioni). L’aggiornamento dei pesi avviene su minibatch campionati uniformemente da \(\mathcal{D}\), e non sull’ultima transizione. Questo rompe la correlazione temporale tra campioni consecutivi (che violerebbe l’ipotesi di indipendenza della discesa del gradiente stocastica) e aumenta enormemente l’efficienza nell’uso dei dati, riutilizzando ogni transizione in molti aggiornamenti.
Rete-target#
C’è un secondo problema: la rete deve inseguire un bersaglio che lei stessa sposta a ogni passo, come cercare di colpire la propria ombra. La soluzione è tenere due copie della rete: una che impara di continuo e una «congelata» che fornisce il bersaglio e viene aggiornata solo ogni tanto. Il bersaglio resta fermo abbastanza a lungo perché la rete che apprende riesca a raggiungerlo.
Si mantiene una rete-target con parametri \(\theta^{-}\), copia periodica dei \(\theta\) ogni \(C\) passi. Quella dei \(\theta\) è la rete che sceglie le mosse e si aggiorna a ogni passo, e per contrasto si chiama rete online: è lei che si allena minimizzando l’errore quadratico sull’equazione di Bellman:
Qui \(r\) è la ricompensa immediata, \(\gamma\in[0,1)\) il fattore di sconto, \(d\in\{0,1\}\) vale \(1\) quando \(s'\) è terminale (e allora del futuro non resta niente), e il termine \(y = r + \gamma\,(1-d)\max_{a'} Q(s', a'; \theta^{-})\) è il bersaglio, calcolato con i pesi congelati \(\theta^{-}\). Congelarli attenua il feedback instabile in cui il bersaglio si muove insieme alla stima: con le parole del lavoro, divergenza e oscillazioni diventano molto meno probabili.
Due dettagli del lavoro su Nature [MKS+15] cambiano questa perdita. Nel gradiente l’errore \(\delta = y - Q(s,a;\theta)\) è tosato in \([-1,1]\), il che equivale alla perdita di Huber, quadratica per \(|\delta| \le 1\) e lineare oltre: un bersaglio sballato di cento spinge quanto uno sballato di uno. E le ricompense sono tosate a \(-1\), \(0\), \(+1\), perché lo stesso passo valga su giochi con scale di punteggio diversissime, al prezzo di non distinguere più un bottino piccolo da uno grande. Completano la ricetta un \(\varepsilon\) portato da \(1\) a \(0{,}1\) nel primo milione di fotogrammi e ogni azione ripetuta per quattro fotogrammi. Nel lavoro, quindi, un «fotogramma» è un passo dell’agente: i \(50\) milioni dell’addestramento sono \(200\) milioni di fotogrammi dell’emulatore, circa \(38\) giorni di gioco a sessanta al secondo.
Sono due modi di rompere lo stesso legame, quello che tiene attaccate fra loro cose che si susseguono nel tempo. La memoria di replay lo spezza fra un’esperienza e la successiva, pescando a caso invece che nell’ordine in cui le cose sono state vissute; la rete-target lo spezza fra la stima e il bersaglio che la guida, tenendo fermo il secondo mentre la prima si muove (Fig. 14.4).

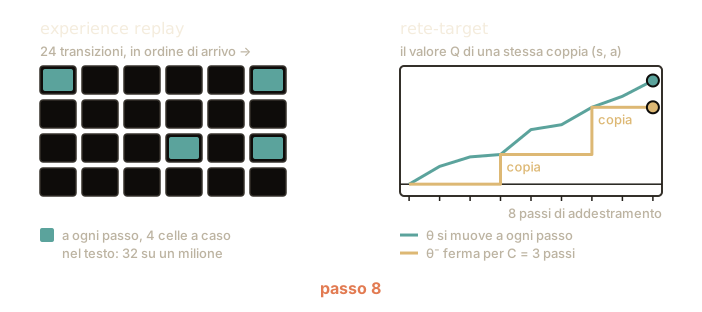
Fig. 14.4 I due accorgimenti al lavoro sullo stesso addestramento. A sinistra la memoria di replay: le esperienze entrano in ordine, e la manciata su cui si studia (il minibatch) le pesca a caso. A destra lo stesso valore \(Q\) calcolato dalla rete che impara, che si muove a ogni passo, e dalla copia congelata, che resta ferma per un numero fisso di passi (nel disegno tre) e poi scatta a raggiungerla. La figura è in scala ridotta: in un addestramento vero le esperienze in memoria sono un milione e quelle pescate a ogni giro sono trentadue.#
Si vede anche quale dei tre elementi della triade ciascuno dei due attenua, e la risposta è meno simmetrica di quanto sembri. La rete-target attenua il bootstrapping, cioè il correggere una stima guardandone un’altra: quell’altra adesso sta ferma per un po’ e si fa raggiungere. La memoria di replay non ne attenua nessuno, e stabilizza per un’altra via: spezza il legame fra un’esperienza e la successiva, che non è uno dei tre elementi. Sull’off-policy, semmai, tira dall’altra parte, perché pescare da un milione di ricordi vuol dire allenarsi su partite giocate da versioni vecchie della policy, più lontane da quella di adesso. Anzi, la memoria di replay l’apprendimento off-policy lo presuppone: senza un bersaglio che valuti una policy diversa da quella che ha raccolto i dati, un ricordo vecchio non si potrebbe riusare affatto. Il primo elemento, la rete al posto della tabella, resta intatto: è quello per cui si è fatto tutto il resto.
La rete, in PyTorch, si costruisce in poche righe. Un paio di numeri prima di
leggerla. I fotogrammi arrivano ridotti a \(84\times84\) punti in scala di grigi
e impilati a quattro a quattro, perché da una sola immagine ferma non si
capisce dove stia andando la pallina. I tre strati convoluzionali usano filtri
\(8\times8\) con stride \(4\), \(4\times4\) con stride \(2\) e \(3\times3\) con stride
\(1\), senza bordo aggiunto, e un filtro \(k\times k\) con stride \(s\) porta un lato
di \(n\) punti a \(\lfloor (n-k)/s\rfloor + 1\), come nella
sezione sulle reti convoluzionali:
il lato passa da \(84\) a \(20\), poi a \(9\), poi a \(7\). Restano \(7\times7\)
posizioni per ciascuno dei \(64\) filtri dell’ultimo strato, i rivelatori che la
rete ha imparato (uno reagisce ai bordi verticali, un altro alla pallina, e
così via), e da lì esce il 64 * 7 * 7 del primo strato denso, quello in cui
ogni numero in entrata parla con ogni numero in uscita.
from torch import nn

def crea_q_network(n_azioni):
    # ingresso (4, 84, 84): 4 fotogrammi impilati (per cogliere il movimento)
    return nn.Sequential(
        nn.Conv2d(4, 32, kernel_size=8, stride=4),
        nn.ReLU(),
        nn.Conv2d(32, 64, kernel_size=4, stride=2),
        nn.ReLU(),
        nn.Conv2d(64, 64, kernel_size=3, stride=1),
        nn.ReLU(),
        nn.Flatten(),
        nn.Linear(64 * 7 * 7, 512),
        nn.ReLU(),
        nn.Linear(512, n_azioni),  # un valore Q per azione, nessuna attivazione
    )

rete_q = crea_q_network(n_azioni=4)            # Breakout ha quattro azioni
print(f"pesi da imparare: {sum(p.numel() for p in rete_q.parameters())}")
pesi da imparare: 1686180
Il bersaglio si calcola con la rete-target, e quando la partita finisce lì (uno stato terminale: nessun seguito, quindi nessun premio futuro da aggiungere) si tiene la sola ricompensa:
import torch

# minibatch: 32 esperienze pescate a caso dalla memoria di replay
s, a, r, s_next, fine = replay.campiona(batch=32)

with torch.no_grad():                              # il bersaglio non si corregge
    # il voto migliore nella situazione seguente, secondo la COPIA CONGELATA
    q_next = target_net(s_next).max(dim=1).values
# gamma (fra 0 e 1) dice quanto conta il futuro rispetto al presente
bersaglio = r + gamma * q_next * (1 - fine)        # se finisce qui, resta solo r
Atari: giocare partendo dai pixel#
Il dettaglio storicamente rilevante è cosa vede la rete: nient’altro che l’immagine, cioè i quattro fotogrammi impilati. Nessuna informazione sulle regole, e nessuna misura scelta e calcolata a mano da un programmatore (in gergo, nessuna feature: niente «distanza fra pallina e racchetta», niente «numero di mattoni rimasti»). E da un gioco all’altro non cambiava niente: i 49 titoli del confronto con il collaudatore umano raccontato in apertura di capitolo li ha imparati lo stesso algoritmo, con le stesse manopole di regolazione (gli iperparametri: quelli che si decidono prima e non si imparano), scelte una volta per tutte con qualche prova su cinque di quei giochi. Era la prima volta che un singolo sistema imparava una gamma così ampia di compiti partendo da input sensoriali grezzi.
Il difetto che il massimo si porta dietro#
Nel bersaglio di DQN c’è un’operazione che sembra innocua e non lo è: prendere il valore più alto. Capire perché l’operazione gonfi le stime serve due volte: il fenomeno è controintuitivo (prendere il massimo è proprio quello che si vuole fare), e lo stesso difetto con la stessa cura torneranno, identici, nella sezione sul controllo continuo.
Otto mosse da cui scegliere, e per ciascuna un voto approssimativo: giusto in media, ma sporcato ogni volta da un errore in più o in meno. Tu prendi sempre il voto più alto. Ora, il voto più alto degli otto è di solito quello della mossa a cui l’errore ha dato la spinta verso l’alto più grande, non quello della mossa davvero migliore. Fra otto misure sbagliate a caso, la più alta è quasi sempre una misura fortunata.
Prendere il massimo di stime rumorose, insomma, non restituisce il massimo dei valori veri: restituisce qualcosa di sistematicamente più grande. Il conto si può anche fare. Le otto mosse valgono tutte esattamente \(5\), e ogni voto sbaglia di una quantità qualsiasi fra \(-1\) e \(+1\), in su come in giù, senza preferenze. Fra otto errori pescati così, il più grande sta quasi sempre vicino al bordo alto, e di quanto lo dice un ragionamento da righello. Otto punti buttati a caso su un segmento lo tagliano, in media, in nove pezzi uguali, e il più alto lascia sopra di sé un pezzo solo, un nono del segmento. Qui il segmento va da \(-1\) a \(+1\) ed è lungo \(2\): il più alto degli otto errori sta in media a \(2/9\) dal bordo, cioè a \(1 - 2/9 = 7/9\), circa \(+0{,}78\), invece che a \(0\). È la formula \((8-1)/(8+1)\). Quindi il voto più alto degli otto, in media, non vale \(5\): vale \(5{,}78\).
Quanto si gonfia dipende da due cose: da quante sono le mosse fra cui si sceglie, e da quanto sono sballati i voti. Con due mosse sole, e gli stessi errori di prima, la gonfiatura scende a \(1/3\); con otto mosse ma errori larghi il doppio, tutto raddoppia e sale a \(1{,}56\). E il guaio è che il voto gonfiato diventa il bersaglio dell’aggiornamento successivo, quindi la gonfiatura non resta dov’era: si tramanda.
Il rimedio si chiama Double DQN, e divide in due un lavoro che prima faceva una rete sola. Prima: la stessa rete decide qual è la mossa migliore e dice quanto vale. Dopo: la rete che sta imparando dice quale mossa, e la copia congelata dice quanto vale quella mossa lì. Che i due ruoli stiano su reti diverse è tutta la sostanza: l’errore che ha fatto sembrare buona quella mossa non è lo stesso errore che poi ne misura il valore, così la fortuna non viene contata due volte. E non si assegnano a caso: a dire quanto vale deve essere la copia congelata, altrimenti si perde il bersaglio fermo che serviva a non far esplodere l’addestramento.
Attenua, però, non guarisce. Le due reti non sono estranee fra loro: una è la copia dell’altra di qualche passo prima, e quella parentela lascia passare buona parte della gonfiatura. E quando le mosse non valgono davvero tutte uguale, il correttivo tende a esagerare dalla parte opposta: i voti escono un filo bassi invece che alti.
La causa non è che le singole stime siano distorte, perché non lo sono: è l’incontro fra il rumore e la convessità del massimo, che la disuguaglianza di Jensen mette in conto. Per stime \(\hat Q\) non distorte,
e il divario cresce con il numero di azioni e con la varianza dell’errore: la disuguaglianza è stretta ogni volta che il rumore può cambiare quale azione risulti la migliore, e con stime esatte si ridurrebbe a un’uguaglianza. Basta quindi un errore di stima a media nulla perché il bersaglio sia sistematicamente gonfio, e il bootstrapping lo propaga all’indietro.
Il caso più semplice si calcola per intero. Se gli \(m\) valori veri sono uguali e gli errori \(\epsilon_a\) sono indipendenti e uniformi in \([-1,1]\), il loro massimo ha funzione di ripartizione \(F(x) = \big((x+1)/2\big)^m\) su \([-1,1]\), e quindi
che vale \(1/3\) con due azioni e \(7/9 \approx 0{,}78\) con otto, e raddoppia se gli errori sono larghi il doppio. È il Teorema 2 di van Hasselt e colleghi, dimostrato nell’appendice della versione estesa del lavoro [vHGS16]: la sovrastima cresce con il numero di azioni anche a errori fissati.
Il Double DQN [vHGS16] disaccoppia i due ruoli. Il bersaglio di DQN usa \(\theta^{-}\) sia per scegliere sia per valutare; quello di Double DQN fa scegliere alla rete online \(\theta\) e valutare alla rete target \(\theta^{-}\):
Da confrontare con \(y = r + \gamma \max_{a'} Q(s',a';\theta^{-})\): la differenza
sta tutta in quali parametri compaiono dentro l’\(\arg\max\), e nel codice del
bersaglio di DQN cambia soltanto il calcolo di q_next:
with torch.no_grad():
    # la rete online sceglie l'azione, la rete target ne dice il valore
    a_star = online_net(s_next).argmax(dim=1, keepdim=True)
    q_next = target_net(s_next).gather(1, a_star).squeeze(1)
bersaglio = r + gamma * q_next * (1 - fine)
L’ordine dei due ruoli non è però scambiabile a piacere: far scegliere a \(\theta^{-}\) e valutare a \(\theta\) conserverebbe il disaccoppiamento, e quindi una parte della correzione, ma rimetterebbe i pesi in aggiornamento dentro il bersaglio, buttando via il congelamento che era servito a stabilizzarlo.
Gli autori sono prudenti sul risultato, ed è giusto esserlo con loro: l’algoritmo «riduce le sovrastime osservate», non le elimina. Il disaccoppiamento annullerebbe il bias solo con due stimatori indipendenti, e qui il secondo non lo è: la rete target è una copia ritardata del primo, scelta perché è il candidato che c’era già, e il paper stesso avverte che il disaccoppiamento non è completo. Resta inoltre che il correttivo non è neutro: quando i valori veri delle azioni non sono tutti uguali, lo stimatore doppio tende a sostituire la sovrastima con una lieve sottostima.
Il conto delle otto mosse si rifà pescando gli errori a caso, un milione di volte per ciascun caso, e facendo la media del massimo:
import numpy as np

rng = np.random.default_rng(0)
for mosse, ampiezza in ((8, 1), (2, 1), (8, 2)):
    # valori veri tutti uguali: cio' che il massimo trova in piu' e' errore
    errori = rng.uniform(-ampiezza, ampiezza, size=(1_000_000, mosse))
    gonfiatura = errori.max(axis=1).mean()
    formula = ampiezza * (mosse - 1) / (mosse + 1)
    print(f"{mosse} mosse, errori fra -{ampiezza} e +{ampiezza}: "
          f"il massimo gonfia di {gonfiatura:.2f} (formula {formula:.2f})")
8 mosse, errori fra -1 e +1: il massimo gonfia di 0.78 (formula 0.78)
2 mosse, errori fra -1 e +1: il massimo gonfia di 0.33 (formula 0.33)
8 mosse, errori fra -2 e +2: il massimo gonfia di 1.56 (formula 1.56)
Ripassare ciò che sorprende, e giudicare la situazione prima delle mosse#
Sul telaio di DQN la ricerca ha montato una famiglia intera di migliorie. Due sono entrate nella pratica quasi quanto il Double DQN, e portano un’idea ciascuna: una cambia che cosa si ripassa, l’altra come si scompone il voto.
Il quaderno degli appunti di prima si ripassa pescando a caso, e a caso vuol dire che un’esperienza banale vale quanto una sorprendente. Uno studente vero non fa così: ripassa più spesso le pagine dove l’ultimo compito è andato peggio. È il replay con priorità: ogni esperienza porta un segnalibro grande quanto l’errore che la rete ci ha fatto sopra l’ultima volta, e la pesca premia i segnalibri grandi. Quanto li premi è una manopola: portata a zero, si torna alla pesca a caso di prima. Le esperienze appena vissute entrano col segnalibro al massimo, così nessuna finisce nel dimenticatoio prima di un primo ripasso. Il prezzo c’è: chi ripassa quasi soltanto le pagine dove sbaglia si fa un’idea storta del libro intero, e il rimedio è contare i ripassi pescati apposta un po’ meno di quelli che sarebbero usciti a caso.
L’altra idea spezza il voto in due domande: quanto è buona la situazione, e quanto aggiunge ciascuna mossa. Su un rettilineo vuoto guidare bene non dipende dalla piccola correzione che dai al volante: conta che il rettilineo è tranquillo, e lo sarà per chiunque. La rete a due rami impara le due cose separatamente e le rimette insieme alla fine, sommandole. Sommare, però, lascia una libertà di troppo: «la strada vale 10 e la sterzata non aggiunge niente» e «la strada vale 7 e la sterzata aggiunge 3» fanno lo stesso voto, e niente dice quale delle due divisioni sia quella buona. Serve un patto, e glielo si impone: i contributi delle mosse devono compensarsi fra loro, tanto in su quanto in giù, e quello che avanza è il giudizio sulla situazione. Con i due rami separati, quel giudizio si affina a ogni passaggio, anche quando sulle singole mosse non c’è niente da imparare. Così è già pronto quando arriva la curva in cui le mosse tornano a contare.
Il prioritized experience replay [SQAS16] sostituisce il campionamento uniforme dal buffer con
dove \(\delta_i\) è l’ultimo errore TD misurato sulla transizione \(i\), \(\epsilon\) è una costante piccola che impedisce a un errore sceso a zero di escludere per sempre quella transizione, e \(\alpha \ge 0\) dosa quanto la priorità morde (\(\alpha = 0\) riporta all’uniforme); le transizioni nuove entrano con priorità massima. Il campionamento non uniforme distorce però la distribuzione degli aggiornamenti, e la correzione è un peso di importance sampling \(w_i = \big(N\, P(i)\big)^{-\beta}\), dove \(N\) è il numero di transizioni in memoria; il peso si normalizza sul massimo del minibatch, e \(\beta\) viene portato verso \(1\) nel corso dell’addestramento, quando la correzione conta di più.
La dueling network [WSH+16] spezza la testa della rete in due rami, il valore dello stato \(V(s)\) e il vantaggio delle azioni \(A(s,a)\), e li ricompone in
dove \(|\mathcal{A}|\) è il numero di azioni e la sottrazione della media rende identificabile la scomposizione: senza, una costante potrebbe passare da \(V\) ad \(A\) lasciando \(Q\) identica. Il guadagno è che ogni aggiornamento allena \(V\), qualunque azione contenga il minibatch: negli stati in cui le azioni più o meno si equivalgono, e in molti giochi sono tanti, la rete impara comunque qualcosa che servirà altrove.
Con il Double DQN e altre tre migliorie (i ritorni a più passi, la stima di un’intera distribuzione di ritorni al posto della media, l’esplorazione tramite rumore nei pesi), questi due pezzi confluiscono in Rainbow [HMvH+18]; l’ablazione di quel lavoro indica il replay con priorità e i ritorni a più passi come i componenti la cui rimozione costa di più all’insieme.
I limiti#
Molti confini di questo approccio hanno guidato la ricerca successiva: oltre alla sovrastima del massimo, che il Double DQN attenua e basta, ne restano tre principali.
Fame di dati. La versione di Nature usa \(50\) milioni di passi dell’agente per gioco, circa \(38\) giorni di gioco ininterrotto; il collaudatore umano con cui è confrontata si era allenato circa due ore per gioco.
Le mosse devono essere poche e distinte (in gergo discrete, cioè contabili una per una, come le voci di un menu). Prendere il valore più alto vuol dire scorrerle tutte: va bene per un joystick a poche direzioni, non per uno sterzo o un braccio robotico, dove la mossa è una quantità da dosare e le possibilità sono infinite. Da lì nascono gli algoritmi attore-critico (actor-critic), dove uno propone la mossa e l’altro la giudica, che incontreremo nel gradiente di policy e nel controllo continuo.
Ricompense rade. In certi giochi il punteggio arriva solo dopo lunghe sequenze di mosse esatte, e lì DQN sostanzialmente fallisce: senza segnale, non c’è nulla da inseguire. Il caso più celebre, Montezuma’s Revenge, apre la sezione sull’esplorazione.
Da ricordare
DQN butta via lo schedario che aveva un cartellino per ogni schermata e ci mette una rete neurale: guarda i pixel e dice a colpo d’occhio quanto vale ciascuna mossa, anche su schermate mai viste prima.
Per anni un’idea così è stata instabile, e per una ragione precisa, la triade fatale: una rete al posto della tabella, stime aggiornate a partire da altre stime, e una strategia imparata mentre se ne gioca un’altra. Due qualunque dei tre si possono tenere insieme senza danni; tutti e tre insieme aprono la porta al guaio, e i valori possono crescere senza fermarsi. Non succede per forza (DQN li tiene tutti e tre), ma il pericolo c’è: il controesempio di Baird lo mostra su sette stati in cui non si guadagna mai nulla e la risposta giusta («tutto vale zero») il sistema saprebbe rappresentarla alla perfezione, e i numeri crescono lo stesso.
Due accorgimenti lo rendono stabile: il quaderno degli appunti, che si chiama memoria di replay (ogni esperienza viene annotata e ripescata a caso, così l’agente mescola situazioni lontane invece di rileggere cento volte la stessa pagina) e la copia congelata della rete, che tiene fermo il bersaglio abbastanza a lungo perché lo si possa raggiungere. Nessuno dei tre ingredienti sparisce: la copia congelata addolcisce il bootstrapping (correggere una stima guardandone un’altra), mentre il quaderno toglie un guaio che nella triade non c’era, cioè proprio quel rileggere la stessa pagina; sull’off-policy, semmai, tira dall’altra parte, perché i ricordi vengono da partite giocate in un altro modo e più vecchie.
Prendere sempre il voto più alto gonfia i voti: fra tante stime sporcate da un errore, la più alta è quasi sempre una stima fortunata, non la mossa migliore. Il Double DQN attenua il difetto facendo dire quale mossa alla rete che impara e quanto vale alla copia congelata; non lo elimina, perché le due reti sono parenti strette.
Due migliorie con un’idea ciascuna: si ripassa più spesso ciò che ha sorpreso (contando un po’ meno i ripassi pescati apposta, per non farsi un’idea storta), e si giudica la situazione separatamente dalle mosse, così si impara anche dove le mosse non contano.
Il risultato storico del 2015: un solo programma, con le stesse manopole di regolazione, arriva al livello di un collaudatore umano professionista su molti giochi Atari partendo dai soli pixel. Restano i limiti: servono quantità enormi di partite, le mosse devono essere poche e distinte, e dove il punteggio arriva di rado l’agente resta senza nulla da inseguire.
Da ricordare
DQN sostituisce la tabella \(Q\) con una rete neurale \(Q(s,a;\theta)\) che mappa i pixel dello stato ai valori delle azioni.
Era instabile per una ragione precisa, la triade fatale: approssimazione, bootstrapping e off-policy insieme possono far esplodere i valori. Con due soli dei tre l’instabilità si può evitare; con tutti e tre il pericolo c’è, e il controesempio di Baird lo mostra su sette stati con ricompense tutte nulle, dove la soluzione esatta è rappresentabile e i pesi divergono lo stesso. Non è una condanna: Gradient-TD ed Emphatic-TD li combinano con garanzie nel caso lineare.
Due accorgimenti lo rendono stabile: l’experience replay (memoria di transizioni campionate a caso) e la rete-target (bersaglio congelato). Nessuno dei tre ingredienti sparisce, e uno solo viene attenuato: la rete-target smorza il bootstrapping; il replay decorrela i campioni, e l’off-policy lo presuppone invece di attenuarlo.
Il \(\max\) nel bersaglio sovrastima perché il rumore incontra una funzione convessa, non perché le stime siano distorte (Jensen; stretta solo se il rumore può cambiare quale azione risulta la migliore, non su tutte le stime aleatorie): \(\mathbb{E}[\max_a \hat Q] \ge \max_a \mathbb{E}[\hat Q]\). Il Double DQN fa scegliere l’azione a \(\theta\) e valutarla a \(\theta^{-}\): riduce il bias, non lo annulla, perché i due stimatori non sono indipendenti.
Il prioritized replay campiona con \(P(i)\propto(|\delta_i|+\epsilon)^{\alpha}\) e corregge il bias con pesi di importance sampling; la dueling network ricompone \(Q = V + (A - \bar A)\) e allena \(V\) a ogni aggiornamento. Con Double DQN e altre tre migliorie confluiscono in Rainbow.
Il risultato storico (Mnih et al., 2015): livello umano su molti giochi Atari partendo dai soli pixel. Restano limiti di efficienza, azioni discrete e ricompense rade.