


Componenti e modelli classici: da ARIMA a Holt-Winters#
Nel 1970 George Box e Gwilym Jenkins misero in appendice al loro libro una tabella di numeri che sarebbe diventata la «cavia» di generazioni di statistici: i passeggeri mensili delle linee aeree internazionali dal 1949 al 1960 [BJRL15]. A guardarla, quella serie racconta tre storie sovrapposte. Una crescita costante, perché era il decennio del boom dei voli: ogni anno si vola più dell’anno prima. Un respiro stagionale: ogni estate un picco, ogni inverno un avvallamento, puntuali come le stagioni che li causano. E, sopra a tutto, un tremolio irregolare che nessuna regola spiega. Box e Jenkins notarono anche un dettaglio decisivo: le oscillazioni estive non erano sempre alte uguali, ma crescevano insieme al livello dei voli. È da qui che parte ogni modello classico di serie temporale: imparare a leggere quelle tre storie separatamente prima di provare a prevederle.
Scomporre una serie: trend, stagionalità, residuo#
La prima mossa, più vecchia dei calcolatori, è la decomposizione: separare una serie nei suoi ingredienti. Ce ne sono tre, e la Fig. 34.2 li mostra impilati sotto la serie di partenza, sullo stesso asse del tempo.

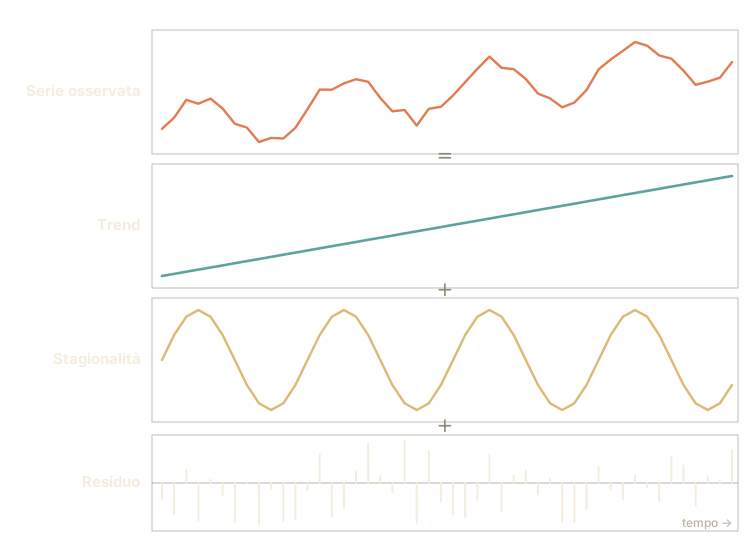
Fig. 34.2 La serie osservata (in alto) come somma di tre parti: una tendenza di fondo (in inglese trend, ed è il nome che si usa anche in italiano), una stagionalità che si ripete a intervalli regolari e un residuo irregolare, che oscilla attorno allo zero. I tre pannelli in basso sono disegnati ciascuno alla propria scala, per far vedere la forma di ognuno: nella serie in alto l’onda della stagione è alta circa tre volte e mezzo le barrette del residuo.#
Dentro la bolletta della luce ci sono tre cose diverse. C’è una parte fissa, il canone, che cambia poco e semmai cresce piano di anno in anno: è il trend, la direzione di fondo. C’è una parte stagionale: d’estate il condizionatore, d’inverno le luci accese di più (un su e giù che torna uguale ogni anno). E poi c’è l’imprevisto: il mese che sei stato in ferie e hai consumato meno, l’amico ospite che ha lasciato tutto acceso; piccoli scarti che non seguono nessuna regola. È il residuo.
Scomporre una serie vuol dire fare esattamente questo: guardare la bolletta e dire «di questi 90 euro, 60 sono il canone di base, 25 sono la stagione calda, e 5 sono capitati così». Una volta separati i tre pezzi, ciascuno diventa più facile da capire e da prevedere: il canone lo estrapoli, la stagione la ripeti, e sull’imprevisto puoi solo dire quanto è grande di solito.
Separarli è un lavoro da medie. Il canone di un mese si trova facendo la media di un anno intero centrato su quel mese: il mese stesso, i sei prima e i sei dopo. Sono tredici mesi, uno di troppo, perché il primo e l’ultimo sono lo stesso mese dell’anno a dodici mesi di distanza (il luglio scorso e il luglio prossimo, per la bolletta di gennaio); per questo contano metà ciascuno, e ogni mese dell’anno entra nella media una volta sola. Dentro una media così la stagione sparisce da sé: la stagione è proprio quanto ciascun mese sta sopra o sotto la media del suo anno, e sull’anno intero il condizionatore d’estate e le luci d’inverno si compensano con i mesi in cui si spende meno. L’imprevisto, che non segue regole, su tredici mesi si compensa in buona parte. Tolto il canone resta la stagione più l’imprevisto, e la stagione si riconosce perché è la parte che torna uguale ogni anno: se ne fa la media su tutti i gennai, poi su tutti i febbrai, e così via. Quello che avanza dopo aver tolto anche quella è l’imprevisto.
Si assume che la serie osservata \(x_t\) sia composta da tre componenti latenti: un trend-ciclo \(T_t\), una stagionalità \(S_t\) di periodo \(m\) (12 per dati mensili, 4 per trimestrali) e un residuo \(R_t\). Attenzione alla lettera: questa \(T\) con il pedice è il trend, mentre la \(T\) senza pedice, che compare fra poco e in tutto il capitolo, è l’ultimo istante osservato. Le due forme canoniche sono il modello additivo e quello moltiplicativo:
Nell’additivo l’ampiezza della stagionalità è costante in valore assoluto: l’estate aggiunge sempre lo stesso numero di unità, qualunque sia il livello. Nel moltiplicativo l’ampiezza è proporzionale al livello: l’estate aggiunge una percentuale, quindi cresce con la serie (proprio come i passeggeri delle linee aeree). Un modello moltiplicativo si linearizza prendendo il logaritmo, \(\log x_t = \log T_t + \log S_t + \log R_t\), che riporta al caso additivo.
Attenzione al ritorno, perché è il passo che si dimentica: se si modella \(\log x_t\) e poi si esponenzia la previsione, quello che si ottiene è la mediana di \(x_{T+h}\), non la media, perché l’esponenziale non commuta col valore atteso (\(\mathbb{E}[e^X] = e^{\mu+\sigma^2/2}\) per una gaussiana). Con \(\sigma = 0{,}3\) la differenza è del \(4{,}4\%\) verso il basso, e il fattore di correzione vale \(e^{\sigma^2/2}\). Non è sempre un errore: se si punta alla mediana (ed è il caso se si giudica col MAE, o con la pinball loss al quantile \(0{,}5\) della sezione seguente) esponenziare e basta è esattamente giusto; se serve la media, perché si sommano le previsioni di più prodotti o perché si giudica con l’RMSE, la correzione va applicata [HA21].
Nella classical decomposition \(T_t\) si stima con una media mobile centrata; con \(m\) pari serve la media \(2\times m\), che per \(m=12\) è
tredici termini con gli estremi a metà peso, così che ogni mese dell’anno pesi uguale e la stagionalità si annulli. Poi \(S_t\) è la media, mese per mese, di \(x_t - \hat{T}_t\), ricentrata a somma zero, e \(R_t\) il resto. I limiti sono due: il trend manca per \(m/2\) punti a ciascun estremo, cioè proprio dove servirebbe prevedere, e la stagionalità è imposta identica ogni anno. STL (Seasonal-Trend decomposition using Loess) [CCMT90] li scioglie entrambi: alterna una regressione locale sulle sottoserie dello stesso mese, che dà una stagionalità libera di evolvere lentamente, e una sulla serie destagionalizzata, che dà il trend; un ciclo esterno assegna pesi bassi ai punti anomali, così che un picco isolato non deformi le componenti [HA21]. È additiva: una stagionalità moltiplicativa si decompone sul logaritmo.
Le tre parti si possono rimettere insieme in due modi, e la differenza conta. O la stagione aggiunge sempre la stessa cifra, d’estate tanti euro in più e sempre quelli, che il giro d’affari sia grande o piccolo: è la forma additiva. Oppure la stagione moltiplica, cioè aggiunge una percentuale, e allora cresce insieme al resto: è la forma moltiplicativa, ed è quella dei passeggeri delle linee aeree di Box e Jenkins, dove i picchi estivi si alzavano man mano che si volava di più. Fig. 34.3 mette le due a confronto, e aggiunge il terzo disegno che le riconcilia.
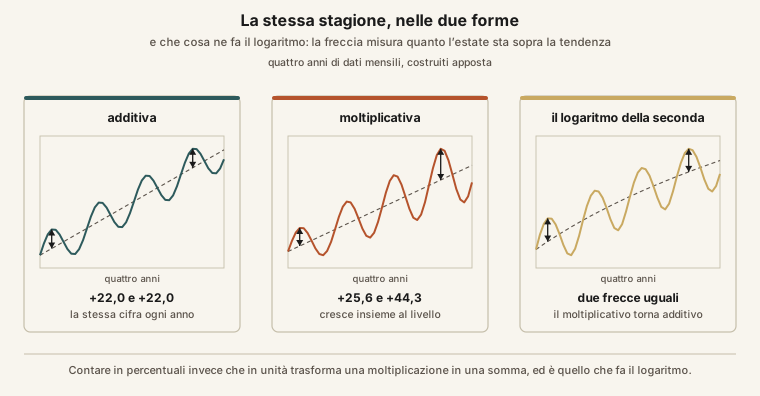
Fig. 34.3 La freccia misura quanto il picco estivo sta sopra la tendenza, nel primo anno e nell’ultimo. Additiva, le due misure coincidono; moltiplicativa, la seconda vale \(1{,}7\) volte la prima; sul logaritmo della stessa serie tornano di nuovo uguali.#
Un esempio minuscolo rende concreta la differenza. Prendiamo le vendite di gelato di una gelateria in quattro trimestri (in migliaia di euro):
Con un anno solo di dati la direzione di fondo non si vede ancora (servirebbero più anni per dire se sale o scende): quello che si può stimare è il livello attorno a cui l’anno ruota, cioè la media dei quattro trimestri, che scriviamo \(\bar{x}\) (la barra sopra una lettera vuol dire «media di»):
La stagionalità additiva, che qui chiamiamo \(S^{\text{add}}\) (le tre letterine in alto sono solo un’etichetta per distinguerla dalla prossima, non un esponente), è ciò che ogni trimestre aggiunge o toglie rispetto a quel livello. I quattro numeri stanno fra parentesi tutti insieme perché sono una lista ordinata, un valore per trimestre:
Questi scarti sommano a zero: sono scarti dalla media, e per definizione di media quello che sta sopra pareggia esattamente quello che sta sotto. La stagionalità moltiplicativa è invece il rapporto rispetto al livello:
fattori che hanno media \(1\) invece di sommare a zero, e il conto si controlla subito: \(0{,}44+1{,}00+1{,}78+0{,}78 = 4\), diviso quattro fa \(1\). La lettura è diversa: l’additivo dice «d’estate si vendono 35 mila euro in più del solito»; il moltiplicativo dice «d’estate si vende il 78% in più» (moltiplicare per \(1{,}78\) e aggiungere il \(78\%\) sono la stessa operazione: \(1\) è quello che c’era già, \(0{,}78\) è quello che si aggiunge). Se l’anno prossimo la gelateria raddoppia il giro d’affari, e il livello passa da 45 a 90, il modello additivo continuerebbe a dire +35 mila, sottostimando l’estate; quello moltiplicativo continua a dire +78%, che su un livello di 90 vuol dire +70 mila, cioè uno scarto raddoppiato. Il residuo è ciò che resta dopo aver tolto il livello e la stagione: se questa estate avesse fruttato \(82\), mentre il livello (\(45\)) e lo scarto estivo (\(+35\)) restano quelli stimati sugli anni scorsi, il residuo di quel trimestre sarebbe \(82 - (45 + 35) = 2\).
Le due forme sono poi la stessa scomposizione misurata su due scale, e a passare dall’una all’altra basta cambiare unità: contare in percentuali invece che in euro trasforma una moltiplicazione in una somma, ed è esattamente quello che fa il logaritmo: in base dieci il logaritmo di 10 è 1, di 100 è 2, di 1000 è 3, cioè ogni volta che si moltiplica per dieci il logaritmo aggiunge uno. Portata sui logaritmi, la stagione della gelateria smette di moltiplicare per \(1{,}78\) e torna ad aggiungere sempre la stessa cifra. È la strada che Box e Jenkins presero sui passeggeri aerei, ed è il motivo per cui i modelli che lavorano su somme se la cavano anche con una stagione che moltiplica: basta portarli sulla scala dove quella stagione aggiunge.
Stazionarietà e differenziazione#
L’apertura del capitolo ha presentato la stazionarietà con l’immagine del fiume stabile. Detta per esteso: una serie è stazionaria quando il valore attorno a cui balla, l’ampiezza con cui balla e il modo in cui due giorni si somigliano restano gli stessi lungo tutta la serie. L’ultimo punto è quello che conta, e va detto con precisione: due istanti si somigliano in base a quanto distano fra loro, non a quando cadono nel calendario.[1]
Perché proprio il terzo? I primi due riguardano dove sta la serie e quanto si agita, cose che si vedono a occhio e si aggiustano in fretta. Il terzo riguarda la memoria, cioè proprio quello da cui una previsione si tira fuori. Se il legame fra un giorno e il successivo è uno a gennaio e un altro a luglio, non c’è nessuna regola da imparare: ce ne sono due, e il modello ne troverà una terza che non vale né qui né lì.
Quasi tutti i modelli classici la pretendono, per una ragione precisa. Stimano pochi parametri (la frazione con cui ieri pesa su oggi, l’ampiezza tipica degli scossoni) su tutta la serie, e li usano invariati per prevedere. Se la media, l’ampiezza delle oscillazioni o il legame fra un giorno e il successivo cambiano nel tempo, un solo insieme di parametri descrive bene un tratto della serie e male un altro: la stazionarietà è la condizione che rende sensato stimarli una volta sola. Per questo si toglie alla serie ciò che la rende non stazionaria, tendenza e stagionalità, e si modella quello che resta, che balla sempre allo stesso modo.
Lo strumento più famoso è la differenziazione: sostituire ogni valore con la sua variazione rispetto al precedente,
L’operatore \(\nabla\) (si legge «nabla») sottrae a ogni valore quello che lo precede. La stessa lettera indica altrove il gradiente, e qui non c’entra, nemmeno quando più avanti porta un pedice.
Sulla serie \(100, 110, 120, 130\), che cresce di \(10\) a ogni passo, la differenziata è \(10, 10, 10\): la salita è sparita, resta una costante. Il meccanismo si vede benissimo, ed è per questo che l’esempio è utile. Su una serie liscia come quella, però, il meccanismo è tutto quello che si vede: le serie vere hanno degli scossoni, e sono gli scossoni a decidere se differenziare sia la mossa giusta o quella sbagliata.
Una serie che ha una tendenza ce l’ha di uno di due tipi, e i due chiedono due cure diverse. Una tendenza è deterministica (la parola vuol dire che la regola è scritta una volta per tutte, e il caso non la tocca) quando la scossa si riassorbe: la serie sbanda e il passo dopo è di nuovo dove la regola la voleva, come se non fosse successo niente. Una tendenza è invece stocastica (la parola vuol dire «governata dal caso») quando la scossa entra nel livello e ci resta: da lì in poi la serie cammina più in alto o più in basso di dove sarebbe andata, per sempre, come il prezzo di un’azione in borsa che dopo un crollo riparte da dove è arrivato e non da dove sarebbe dovuto essere.
A distinguerle non è la salita, ed è l’errore da non fare: anche una serie che cammina alla cieca può avere una spinta di fondo che la porta su, e in media seguire una retta. Quello che cambia è che cosa succede a una scossa, e Fig. 34.4 lo fa vedere sulla stessa scossa, data alle due serie nello stesso istante.
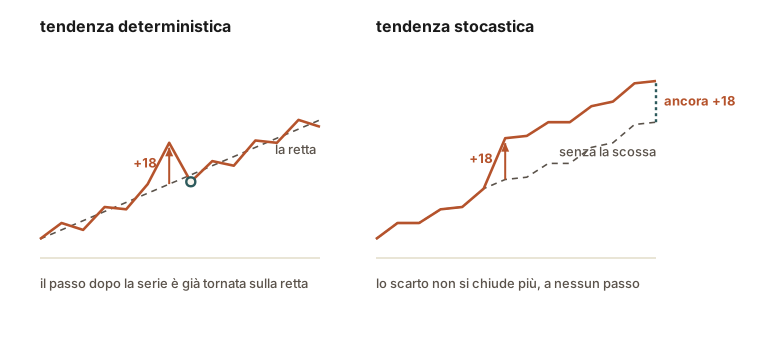
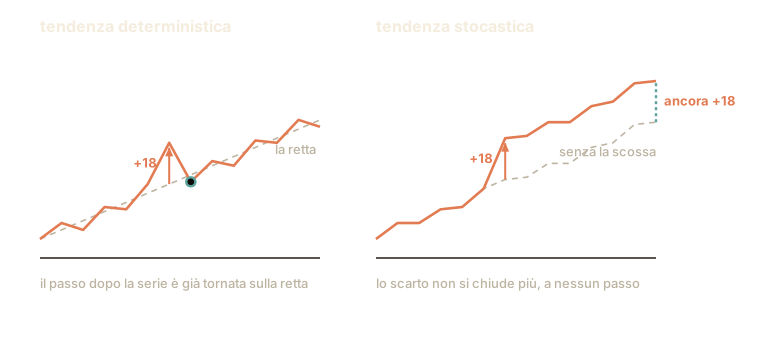
Fig. 34.4 Le due serie partono uguali, salgono con la stessa spinta e ricevono le stesse scosse. A sinistra la scossa si somma alla retta, quindi il passo dopo è già sparita; a destra si somma al valore precedente, cioè al livello, e da lì in poi la serie corre diciotto sopra il cammino che avrebbe fatto senza. Salgono tutte e due, e a separarle è che cosa resta di una scossa, non la pendenza.#
Il camminare alla cieca ha un nome, e conviene saperlo perché è quello che si trova nei manuali e nel codice: la passeggiata aleatoria (random walk), cioè il processo \(x_t = x_{t-1} + \varepsilon_t\), dove ogni valore è il precedente più una scossa e nient’altro. Per riconoscerla si differenzia e si guarda che cosa resta. Si prende la serie differenziata (le differenze fra un valore e quello prima si chiamano differenze prime, perché la mossa si può ripetere) e le si chiede due cose: che sia stazionaria, e che nessun giorno somigli più a quello prima di quanto somigli a uno qualunque, cioè che sia rimasto puro rumore. Alla prima domanda rispondono i test ADF e KPSS, alla seconda il test di Ljung-Box, e la procedura di Box e Jenkins, fra poco, li mette in fila. Se la serie differenziata passa tutte e due le prove, quello che resta dopo aver tolto il livello non ha più niente dentro, e la serie era una passeggiata aleatoria.
Sapere di averne una davanti serve soprattutto a non farsi ingannare da un grafico. La previsione a un passo di una passeggiata aleatoria è, per costruzione, l’ultimo valore osservato: disegnata sopra la serie vera, la curva prevista la ricalca con un giorno di ritardo, e sembra bravissima. Non ha imparato niente, e la prova sta nel fatto che quella previsione è la più semplice delle linee di base, «ripeti l’ultimo valore», che la sezione sulla validazione chiamerà naive. Su una serie del genere l’unica previsione onesta a orizzonte lungo è una retta che parte dall’ultimo valore osservato, piatta se la serie non ha una spinta di fondo e inclinata di quella spinta se ce l’ha. Attorno, una banda d’incertezza che si allarga come la radice di quanti passi si guarda avanti: le scosse future sono indipendenti, e fra scosse indipendenti a sommarsi sono le varianze, quindi dopo \(h\) passi la varianza è \(h\) volte quella di un passo, e la larghezza della banda, che va come la deviazione standard, cresce come \(\sqrt{h}\).
La differenziazione è la cura della tendenza stocastica, e sulla strada dei modelli ARIMA non ha sostituti. Sulla deterministica fa invece un danno, e il danno si vede a mano, senza far girare niente.
Prendi una serie che è davvero una retta più uno scossone casuale al giorno, \(x_t = a + bt + \varepsilon_t\): il valore di oggi è il punto della retta di oggi, più lo scossone di oggi. Adesso sottrai il valore di ieri:
Della retta resta solo la salita \(b\), sempre uguale (quei \(10\) dell’esempio di prima), e accanto a quella resta lo scossone di oggi meno quello di ieri.
Guarda cosa è appena successo a un singolo scossone, mettiamo quello di ieri. Ieri era il «più» del conto di ieri; oggi è il «meno» del conto di oggi. Lo stesso numero, in due giorni consecutivi, una volta con un segno e una volta con l’altro. Se ieri è stato grosso, ieri ha spinto in alto e oggi spinge in basso, e così per ogni scossone: nella serie differenziata a un valore alto ne segue regolarmente uno basso. Quella è una regolarità, e nella serie di partenza non c’era: l’abbiamo fabbricata noi differenziando. Un modello che la guardi si metterà a spiegarla.
L’altra cura si chiama detrendizzazione: si tira la retta che segue la
salita e si tengono, di ogni punto, gli scarti da quella retta. È precisamente
ciò che faceva il codice dell’introduzione al capitolo con polyfit e
polyval. Il conto le mette a confronto tutte e due su venti serie fatte
allo stesso modo, trecento punti ciascuna, una retta con sopra uno scossone al
giorno.
import numpy as np

def somiglianza(v):
    """Quanto un valore somiglia al precedente: un numero fra -1 e +1."""
    v = v - v.mean()
    return float(v[1:] @ v[:-1] / (v @ v))

t = np.arange(300)
dopo_diff, dopo_retta, rapporti = [], [], []
for seme in range(20):
    rng = np.random.default_rng(seme)
    # Scossoni senza memoria propria, su una retta: e' il primo dei due casi.
    scossoni = rng.normal(0, 1, 300)
    serie = 0.5 * t + scossoni
    retta = np.polyval(np.polyfit(t, serie, 1), t)
    differenziata = np.diff(serie)
    dopo_diff.append(somiglianza(differenziata))
    dopo_retta.append(somiglianza(serie - retta))
    rapporti.append(differenziata.var() / scossoni.var())

for cura, v in (("differenziata", dopo_diff), ("tolta la retta", dopo_retta)):
    v = np.array(v)
    print(f"somiglianza fra giorni vicini, {cura:14s} {v.mean():+.2f}"
          f"   (le venti serie da {v.min():+.2f} a {v.max():+.2f})")
print(f"scarti al quadrato della differenziata, in volte quelli"
      f" degli scossoni   {np.mean(rapporti):.2f}")
somiglianza fra giorni vicini, differenziata  -0.50   (le venti serie da -0.59 a -0.41)
somiglianza fra giorni vicini, tolta la retta -0.01   (le venti serie da -0.17 a +0.13)
scarti al quadrato della differenziata, in volte quelli degli scossoni   2.02
La prima riga è l’effetto appena descritto, messo in cifre. Quella misura sta fra \(-1\) e \(+1\), dove \(+1\) vuol dire che i due giorni si muovono sempre insieme, \(0\) che non c’entrano niente l’uno con l’altro e \(-1\) che uno sale ogni volta che l’altro scende: mezzo punto sotto zero è quindi molto. La seconda riga dice che togliendo la retta, invece, non resta niente. La terza dice che gli scarti della differenziata, elevati al quadrato e mediati (cioè la varianza), sono il doppio di quelli degli scossoni che c’erano dentro, perché ogni giorno adesso se ne porta dentro due invece di uno. Il conto si fa a mano: il quadrato di \(\varepsilon_t - \varepsilon_{t-1}\) è \(\varepsilon_t^2 - 2\,\varepsilon_t\varepsilon_{t-1} + \varepsilon_{t-1}^2\); in media il primo e l’ultimo pezzo valgono una varianza ciascuno, e il doppio prodotto vale zero, perché due scossoni indipendenti hanno lo stesso segno tanto spesso quanto segno opposto. Il \(2\) è esatto sulle varianze del processo; sulle venti serie misurate è il \(2{,}02\) della terza riga.
E il \(2\) spiega anche il \(-0{,}50\) della prima. Due giorni consecutivi della differenziata hanno in comune un solo scossone, quello che nell’uno entra col più e nell’altro col meno: la loro covarianza vale quindi meno una varianza, e divisa per la varianza di un giorno, che di varianze ne contiene due, dà esattamente \(-1/2\).
E c’è un’ipotesi, senza la quale il \(-0{,}50\) non è quel numero: che intorno alla retta ci sia rumore senza memoria propria, cioè che uno scossone non tiri l’altro. Se invece gli scossoni si somigliano già fra loro, differenziare ne cancella una parte e il numero sale verso lo zero.
Le due operazioni non sono intercambiabili: ciascuna guasta il caso che l’altra risolve.
Per la stagionalità si usa la differenziazione stagionale \(\nabla_m x_t = x_t - x_{t-m}\), dove \(m\) è la lunghezza del ciclo (12 per dati mensili, 7 per dati giornalieri con un ritmo settimanale): sottrae il valore dello stesso periodo del ciclo precedente, mese contro stesso mese dell’anno prima. Prima di modellare si differenzia quanto basta a stabilizzare la serie, e non di più: differenziare una volta di troppo è un errore vero e ha un nome, sovradifferenziazione. È lo stesso guasto di poco fa, e la ragione è la stessa: quando non c’era più niente da togliere, sottrarre il giorno prima non toglie una salita, sparpaglia solo ogni scossone su due giorni.
E adesso la domanda pratica: come si fa a vedere quanta memoria è rimasta dentro una serie, e di che tipo? Con due grafici a barre che sono il pane quotidiano dell’analista di serie temporali, l’ACF e la PACF.
Ricopia la serie su un foglio trasparente e fai scivolare la copia indietro di un giorno: quanto si somigliano, le due? Poi di due giorni, poi di tre. La risposta, passo per passo, è la funzione di autocorrelazione (ACF): un grafico a barre che dice quanto oggi assomiglia a ieri, all’altro ieri, e così via. Se le barre restano alte a lungo, la serie ha una memoria lunga.
C’è però un inganno. Se oggi somiglia a ieri e ieri somigliava all’altro ieri, allora oggi somiglierà all’altro ieri di rimbalzo, anche senza un legame diretto. La PACF (autocorrelazione parziale) toglie questo effetto a catena: misura quanto oggi dipende dal valore di tre giorni fa una volta scontato ciò che passa attraverso ieri e l’altro ieri. È la differenza fra «il nonno somiglia al nipote» e «il nonno somiglia al nipote al netto del padre».
Si guardano in coppia, perché nessuno dei due da solo dice tutto, e insieme dicono una cosa in più: il punto in cui le barre si schiacciano di colpo segna fin dove arriva la memoria. Schiacciarsi vuol dire rientrare nella fascia sottile attorno allo zero dove cadono le barre di una serie che memoria non ne ha; e una barra sola che sporge non è la firma di niente, perché su venti barre capita più spesso che no che una sporga per caso.
Di memorie, fra poco, ne incontreremo due. Una è la memoria dei valori: oggi è caldo perché ieri era caldo, e il caldo rientra piano verso il normale. L’altra è la memoria delle sorprese: una gita che svuota la gelateria si fa sentire ancora l’indomani, e poi più niente, qualunque cifra sia finita nel registro. Ciascuna lascia la firma su un grafico diverso: se a schiacciarsi di colpo è la PACF, la serie si ricorda i valori passati; se è l’ACF, si ricorda le sorprese passate. Con una riserva: sulle serie vere le due firme si sovrappongono, e questo modo di leggerle funziona molto meno di quanto i manuali lascino sperare.
L’autocorrelazione a ritardo \(k\) è
dove \(\gamma(k)\) è l’autocovarianza; la sequenza \(\{\rho_k\}\) è l’ACF. La PACF \(\phi_{kk}\) è invece la correlazione fra \(x_t\) e \(x_{t-k}\) dopo aver rimosso la dipendenza lineare dai ritardi intermedi \(x_{t-1},\dots,x_{t-k+1}\); coincide con l’ultimo coefficiente della regressione di \(x_t\) su quei \(k\) ritardi. Le due funzioni sono la bussola dell’identificazione di Box-Jenkins, perché hanno firme complementari: un processo AR(\(p\)) ha PACF che si annulla dopo il ritardo \(p\) e ACF che decade gradualmente; un processo MA(\(q\)) ha ACF che si annulla dopo il ritardo \(q\) e PACF che decade. Leggere dove le barre «cadono nel rumore» suggerisce gli ordini \(p\) e \(q\) da provare [BJRL15]. Vale però sui processi puri: quando le due memorie convivono, cioè su un ARMA, nessuna delle due funzioni si annulla e la lettura non decide niente, ed è la ragione per cui in pratica gli ordini si scelgono stimando una griglia di modelli invece che guardando un grafico.
«Nel rumore» ha una definizione precisa: dentro la banda \(\pm z_{1-\alpha/2}/\sqrt{n}\), cioè \(\pm 1{,}96/\sqrt{n}\) al 95%, che è l’intervallo in cui cadrebbe un’autocorrelazione campionaria se il processo fosse rumore bianco (\(n\) è il numero di osservazioni). L’ipotesi non è «se quella vera fosse zero», ed è una differenza che morde proprio dove l’identificazione manda a guardare: su un MA(\(q\)), oltre il ritardo \(q\) la varianza campionaria è \(\big(1 + 2\sum_{j=1}^{q}\rho_j^2\big)/n\), cioè più larga, e chi usa la banda stretta vede uscire barre che non escono e sovrastima l’ordine (la banda giusta è quella di Bartlett, e le librerie la offrono). Va letta anche sapendo che è una banda puntuale, valida un ritardo per volta: su venti ritardi di rumore bianco puro, la probabilità che almeno una barra esca dalla banda per puro caso supera il 50%. Una barra fuori non è la firma di niente, ed è esattamente la ragione per cui il test di Ljung-Box, più avanti, giudica tutte le autocorrelazioni insieme invece che una per una.
Le due firme, sui due casi da manuale, stanno nella Fig. 34.5.
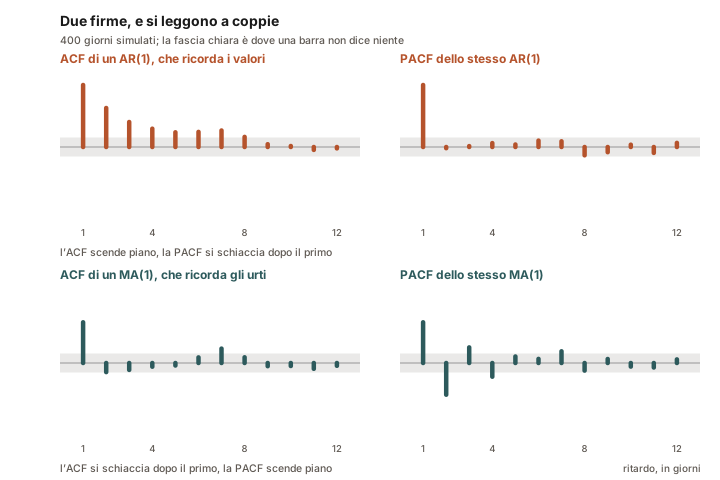
Fig. 34.5 Quattrocento giorni simulati da una regola nota, e le due firme scambiate: chi si ricorda i valori passati schiaccia la PACF, chi si ricorda gli urti passati schiaccia l’ACF. La fascia chiara è dove una barra non dice niente, e in basso a sinistra una barra ci esce comunque, al settimo ritardo, dove non c’è niente da ricordare: è la ragione per cui si guarda la forma dell’insieme e non la singola barra.#
Autoregressione: AR(\(p\))#
Il modello più naturale per una serie con memoria dice: il prossimo valore è una combinazione dei valori appena passati, più una spinta casuale.
Domani la temperatura sarà simile a quella di oggi, con una correzione. Se oggi fa più caldo della media di stagione, è probabile che anche domani sia sopra la media, ma un po’ meno: il caldo «rientra» piano verso il normale. Un modello autoregressivo cattura proprio questo: prende gli ultimi valori, li pesa, li somma, e aggiunge un pizzico di imprevedibile per il resto. «Auto-regressivo» vuol dire che la serie fa da predittore a sé stessa: guarda il proprio passato, non variabili esterne.
Il numero di passati che guarda è l’ordine, ed è la lettera \(p\) che compare fra parentesi nel nome del modello: AR(\(p\)) vuol dire soltanto «autoregressivo che guarda indietro di \(p\) giorni». Un AR(1) guarda solo ieri; un AR(2) guarda ieri e l’altro ieri. Più passati includi, più la memoria del modello si allunga, ma anche più parametri devi stimare da una serie che è pur sempre lunga un tanto.
Un processo autoregressivo di ordine \(p\), AR(\(p\)), è definito da
dove \(\phi_1,\dots,\phi_p\) sono i coefficienti autoregressivi, \(c\) una costante e \(\varepsilon_t\) è rumore bianco: una sequenza a media nulla, varianza \(\sigma^2\) costante e incorrelata nel tempo. La parte prevedibile è \(c + \sum_{i=1}^p \phi_i x_{t-i}\), e per chiamarla valore atteso condizionato al passato serve un’ipotesi più forte della sola incorrelazione, cioè che la scossa di oggi non sia prevedibile da ciò che è successo prima; con la sola incorrelazione quella quantità è la migliore previsione lineare, che è meno.
La condizione sui coefficienti riguarda il polinomio autoregressivo \(\phi(z) = 1 - \phi_1 z - \dots - \phi_p z^p\), e chiede che le sue radici stiano fuori dal cerchio unitario. Così scritta dà la stazionarietà e la causalità, cioè il fatto che il processo si possa scrivere in funzione delle sole scosse passate, che è poi ciò che serve per prevedere; per la sola stazionarietà basterebbe che nessuna radice cada sul cerchio. Attenzione alla convenzione, perché è la sede di un inciampo classico: chi scrive il polinomio nell’altra forma, \(z^p - \phi_1 z^{p-1} - \dots - \phi_p\), chiede le radici dentro il cerchio, e sta dicendo la stessa identica cosa. Per l’AR(1) tutto questo si riduce alla condizione \(|\phi_1| < 1\). In quel caso la media di lungo periodo è \(\mu = c/(1-\phi_1)\) e la serie vi ritorna dopo ogni scossa.
Vediamolo con i numeri su un AR(1). La regola dice: il valore di domani è una quota fissa più una frazione del valore di oggi, più una scossa casuale. In simboli, \(x_t = c + \phi\,x_{t-1} + \varepsilon_t\), dove \(c\) è la quota fissa, \(\phi\) la frazione e \(\varepsilon_t\) la scossa. Prendiamo \(c = 4\) e \(\phi = 0{,}6\), cioè: di quello che c’era ieri ne resta il 60%, e ogni giorno se ne aggiungono 4.
Dove finisce una serie fatta così, se la si lascia andare? In un valore che non si muove più, cioè quello per cui «il 60% di sé stesso più 4» ridà sé stesso. Chiamiamolo \(\mu\), la lettera con cui in statistica si indica una media. La condizione si scrive \(\mu = 0{,}6\,\mu + 4\), cioè \(0{,}4\,\mu = 4\), quindi \(\mu = 10\). È la media di lungo periodo, e in generale vale \(c/(1-\phi)\).
Partiamo da un valore alto, \(x_0 = 20\), e seguiamo la parte prevedibile (mettendo a zero il rumore, \(\varepsilon_t = 0\)):
La serie scivola \(20 \to 16 \to 13{,}6 \to 12{,}16\), avvicinandosi a \(10\) a ogni passo: è il rientro verso la media (in inglese mean reversion). Succede finché la frazione \(\phi\) sta fra \(-1\) e \(+1\), che è quello che dice la scrittura \(|\phi| < 1\): le due sbarrette vogliono dire «guarda il numero senza il segno». Se valesse esattamente \(1\), ogni giorno ricomincerebbe da dove era arrivato e la serie non tornerebbe mai indietro: è la tendenza stocastica di poco fa. Oltre \(1\) è un caso diverso ancora, e più violento: ogni scossa viene moltiplicata a ogni passo, la serie parte per la tangente e non c’è differenziazione che la riporti a posto. Il rumore, nella realtà, scompiglia continuamente la discesa, ma la spinta di fondo resta sempre quella verso \(\mu\).
Da AR ad ARIMA: media mobile, integrazione, stagionalità#
L’AR è metà della storia. L’altra metà guarda non ai valori passati, ma agli urti passati: è il modello a media mobile, sigla MA. Attenzione, perché «media mobile» in questo campo indica due cose diverse. La prima, la più comune, è il modo più semplice di lisciare un grafico: si sostituisce ogni valore con la media dei suoi vicini, e così il tremolio si attenua e si vede il fondo. È anche la via più corta per tirar fuori la tendenza di una serie, ed è per questo che il nome ricorre in giro. La seconda è questa, il modello MA, ed è una media degli imprevisti e non dei valori. Sono due mestieri diversi con lo stesso nome, e d’ora in avanti «media mobile», da sola, indica il modello.
Una gita scolastica svuota la gelateria; uno sciopero blocca i voli. L’effetto di un urto imprevisto non si esaurisce il giorno stesso: si fa sentire ancora domani, un po’ meno dopodomani, e poi svanisce. Un modello a media mobile dice proprio questo: l’incasso di oggi è il livello normale, più la sorpresa di oggi, più l’eco delle sorprese degli ultimi giorni. Quanto pesa l’eco di ciascun giorno passato è un numero che si legge dai dati, non una regola fissa.
Le sorprese però nessuno le misura: nel registro della gelateria ci sono gli incassi, e la sorpresa di ieri si ricava all’indietro, per differenza fra quello che ci si aspettava e quello che è arrivato. Il conto all’indietro funziona finché l’eco di una sorpresa pesa meno della sorpresa stessa: allora un errore nel ricostruire la sorpresa di un giorno, il giorno dopo, conta di meno, e col passare dei giorni si spegne. Se invece l’eco pesa più della sorpresa, ogni errore si ingrandisce a ogni giorno, e presto le sorprese ricostruite non hanno più niente a che vedere con quelle vere: il modello è scritto bene, ma senza le sorprese non prevede niente.
Chiedi alla gelateria l’incasso di domani e di dopodomani: l’eco delle sorprese di ieri e di oggi c’è ancora, e il modello la usa. Delle sorprese che devono ancora succedere non sa niente, e non prova a indovinarle: le mette a zero, perché in media non spostano né in su né in giù. Chiedi allora l’incasso di venerdì prossimo. Di eco non ne resta più nemmeno una, restano solo le sorprese future messe a zero, e la risposta è il giorno normale, lo stesso numero per tutti i giorni che seguono. Sul grafico esce una linea piatta, all’altezza del livello medio degli incassi che il modello ha stimato sul registro: da venerdì in poi risponde quello che chiunque avrebbe risposto guardando la media. Il modello non si è rotto. Ha finito la memoria, e la memoria dura quanti giorni gli si è detto di farla durare.
Chi a venerdì ci vuole arrivare glielo chiede due giorni per volta, e appena gli incassi veri arrivano glieli rimette sotto, così ogni volta riparte da qualcosa che è successo davvero. Funziona per chi prevede la settimana giorno per giorno, mentre i giorni passano; a chi oggi deve consegnare la previsione di venerdì non serve, perché mercoledì non è ancora successo.
Le due memorie si possono usare insieme, quella dei valori (l’AR appena visto) e quella degli urti (il MA), e insieme la linea piatta non c’è più: la memoria dei valori non finisce di colpo, si spegne piano, e la previsione si avvicina al giorno normale senza mai arrivarci.
Le serie vere, poi, quasi mai stanno ferme attorno a un valore, e allora prima si raddrizza la serie e poi si modella ciò che resta. Raddrizzare vuol dire il trucco già incontrato per le serie che camminano alla cieca: sostituire ogni valore con la variazione rispetto al giorno prima. (Quando invece la tendenza è deterministica, la retta si toglie prima, fuori dal modello.) Il tutto insieme si chiama ARIMA, il modello di punta di Box e Jenkins, e la sigla mette in fila i tre pezzi: AR la memoria dei valori, I (integrated) il raddrizzamento, MA la memoria degli urti. Dietro ci sono tre conteggi (quanti valori passati guardare, quante volte raddrizzare la serie, per quanti giorni far durare l’eco degli urti), che i manuali scrivono in quest’ordine fra parentesi, ARIMA(\(p,d,q\)). Se c’è anche una stagionalità, si rifà lo stesso gioco sul calendario, e dicembre si confronta con lo scorso dicembre: è la variante SARIMA, dove la S sta per seasonal, stagionale. Di calendari, però, ne segue uno solo: una gelateria che ha insieme il ciclo della settimana e quello dell’anno, il sabato e l’estate, con un SARIMA ne tiene uno e lascia fuori l’altro.
Il modello a media mobile MA(\(q\)) è
dove \(\varepsilon_{t-i}\) sono le scosse casuali dei passi precedenti e \(\theta_1,\dots,\theta_q\) i loro pesi: un urto di oggi non si esaurisce subito, ma continua a farsi sentire per \(q\) passi prima di svanire.
Come per l’AR c’è una condizione sui coefficienti, ma serve a un’altra cosa. Si chiama invertibilità e chiede che le radici di \(1 + \theta_1 z + \dots + \theta_q z^q\) stiano fuori dal cerchio unitario (\(|\theta_1| < 1\) per l’MA(1)). Non serve per la stazionarietà, che un MA ha comunque, essendo una somma finita di scosse a varianza costante. Serve per due ragioni concrete. La prima: senza di essa il modello non è identificato, perché \(\theta\) e \(1/\theta\) danno la stessa autocorrelazione (\(\rho_1 = \theta/(1+\theta^2)\) vale \(0{,}40\) tanto per \(\theta = 0{,}5\) quanto per \(\theta = 2\)), quindi la stessa ACF, quindi due processi che i due grafici di poco fa non sanno distinguere. La seconda: solo con essa le scosse passate \(\varepsilon_{t-i}\), che nessuno osserva, si possono ricostruire dai dati, cioè solo con essa il modello si può usare per prevedere. Una spia utile: quando una serie è stata sovradifferenziata, il \(\theta\) stimato finisce inchiodato a \(-1\) o quasi, cioè proprio sul bordo di questa regione.
Ricostruire le scosse passate serve a prevedere, e da qui viene un limite dell’MA(\(q\)) che si incontra al primo uso. La previsione a orizzonte \(h\) è la migliore previsione lineare di \(x_{T+h}\) dato tutto il passato fino all’ultimo istante osservato, che chiamiamo \(T\) (attenzione: è un’altra cosa dal trend-ciclo \(T_t\) della scomposizione di apertura, e qui \(T\) è un indice e non una componente). Le scosse ancora da venire non sono correlate con niente di osservato e portano zero, quelle già viste restano, e quel che avanza è
dove \(\mu\) è il livello medio attorno a cui la serie oscilla. La somma parte da \(i = h\) perché solo per \(i \geq h\) l’istante \(T+h-i\) cade a \(T\) o prima, cioè solo quelle scosse si sono già viste; e finisce a \(i = q\) perché oltre \(q\) il modello non ha più pesi da dare. Appena \(h > q\) i due estremi si incrociano, la somma è vuota, e la previsione vale \(\mu\) per tutti gli orizzonti successivi: una retta orizzontale, che coincide (a meno di come si stima \(\mu\)) con il rispondere sempre il livello medio della serie. Un MA(2) interrogato su cinquanta passi ne dà due sensati e quarantotto piatti, e quei quarantotto dicono soltanto che il modello ha esaurito la memoria che gli si è data.
Il rimedio è chiedergli non più di \(q\) passi per volta, e vale quando i dati arrivano prima della previsione successiva: la seconda coppia si chiede quando le osservazioni vere della prima sono ormai in mano, e l’orizzonte torna ogni volta a uno. È lo stesso gesto con cui la sezione sulla validazione farà scorrere la finestra per misurare un modello, usato qui per prevedere. Chi invece deve consegnare oggi i cinquanta passi di domani non ha rimedi: con un MA(\(q\)) quell’orizzonte resta scoperto, ed è un’informazione sul modello, non un dettaglio operativo.
E la regola vale per l’MA puro, non per quello che viene adesso: in un ARMA(\(p,q\)) causale, oltre \(q\) passi la parte autoregressiva continua a lavorare, e la previsione tende a \(\mu\) per via geometrica senza arrivarci mai. Con una differenziazione (\(d = 1\)) la previsione di lungo periodo tende a un valore costante, e a una retta inclinata se al modello si aggiunge una costante o se si differenzia due volte [HA21]. Chi porta dentro l’ARIMA la regola della linea piatta se la ritrova falsa.
Mettendo insieme le due idee si ottiene l’ARMA(\(p,q\)), che spiega il valore odierno con \(p\) valori passati e \(q\) errori passati. Ma l’ARMA vive solo su serie stazionarie, e le serie vere quasi mai lo sono. La soluzione di Box e Jenkins è incorporare la differenziazione nel modello stesso: nasce l’ARIMA(\(p,d,q\)) [BJRL15]. Le tre lettere:
AR(\(p\)), l’ordine autoregressivo, quanti valori passati;
I(\(d\)), integrated, quante volte si differenzia la serie per renderla stazionaria (\(d=1\) basta per una passeggiata aleatoria, con o senza deriva; \(d=2\) serve quando a camminare a caso è anche la pendenza);
MA(\(q\)), l’ordine a media mobile, quanti errori passati.
In pratica si differenzia la serie \(d\) volte, si adatta un ARMA(\(p,q\)) al risultato, e si «re-integra» sommando all’indietro per tornare alla scala originale. La differenziazione è la cura per una tendenza che cammina a caso; se la tendenza è deterministica, una retta nel tempo, si stima la retta (o si mette \(t\) fra i regressori) e l’ARMA si adatta ai residui. I parametri \((c, \phi_i, \theta_j, \sigma^2)\) si stimano per massima verosimiglianza gaussiana. Per un AR puro, condizionando ai primi \(p\) valori, la stima coincide con i minimi quadrati (quelli della regressione con cui, più avanti, si stima a mano un AR(1)); con una parte MA la verosimiglianza non è più quadratica nei \(\theta_j\), si calcola con il filtro di Kalman, che il capitolo incontra più avanti, e va massimizzata per via numerica. L’ottimizzatore può fermarsi prima di arrivare a convergenza, e l’AIC di una stima non giunta a convergenza non è confrontabile con quello degli altri modelli. Quando la serie ha una stagionalità marcata, si aggiunge un secondo blocco di termini che agiscono al ritardo stagionale \(m\): è il SARIMA(\(p,d,q\))(\(P,D,Q\))\(_m\), dove le lettere maiuscole \(P,D,Q\) sono gli ordini AR, di differenziazione e MA stagionali, e \(m\) è la lunghezza del ciclo. Su una serie mensile con trend e stagionalità annuale il punto di partenza canonico ha un nome e una storia: è il SARIMA\((0,1,1)(0,1,1)_{12}\) sul logaritmo, che Box e Jenkins montarono proprio sui passeggeri aerei del 1949-60, e che da allora si chiama modello airline. Sono quattro pezzi già visti uno per uno: il logaritmo per le oscillazioni che crescono col livello, la differenza fra un mese e il precedente per la salita di fondo, quella fra un mese e lo stesso mese dell’anno prima per il ciclo, e un solo termine di memoria degli urti su ciascuna delle due scale. Partire da lì, e aggiungere termini solo se servono, costa meno che partire da un modello pieno e toglierli. Il SARIMA, però, di periodi ne conosce uno solo: su dati giornalieri con due stagionalità sovrapposte, la settimana e l’anno, si passa a una regressione sui termini di Fourier, che la sezione seguente mette fra le feature, con un ARIMA sugli errori, oppure ai modelli additivi come Prophet [HA21].
In pratica: dopo due passi un MA(2) smette di prevedere#
La linea piatta si può vedere, e senza aspettare che capiti su dati veri: si genera una serie da un MA(2) di cui si conoscono i pesi, si stima il modello, e gli si chiedono sei passi. Poi si confrontano tre modi di coprire quaranta passi: tutto in un colpo solo, due passi per volta, e la linea di base che risponde sempre il livello medio. Le serie sono dodici, perché un rapporto misurato una volta sola non è un rapporto, e il confronto si fa serie per serie, così che a decidere sia la differenza dentro ciascuna e non il caso che ha reso quelle dodici più o meno agitate.
import numpy as np
from statsmodels.tsa.arima_process import ArmaProcess
from statsmodels.tsa.arima.model import ARIMA

# Un MA(2) con eco marcata: l'urto di oggi si sente per due passi, poi basta.
processo = ArmaProcess(ar=np.r_[1], ma=np.r_[1, 0.9, 0.7])

rng = np.random.default_rng(0)
serie = processo.generate_sample(nsample=300, distrvs=rng.standard_normal)
stimato = ARIMA(serie, order=(0, 0, 2)).fit()
media = stimato.params[stimato.param_names.index("const")]

print(f"livello medio stimato: {media:+.3f}")
for h, y in enumerate(stimato.forecast(steps=6), start=1):
    print(f"   h = {h}   previsione = {y:+.3f}   "
          f"scarto dal livello medio = {abs(y - media):.0e}")

# Tre modi di coprire quaranta passi, sulle stesse dodici serie.
colpo, piatta, finestra = [], [], []
for seme in range(12):
    rng = np.random.default_rng(seme)
    s = processo.generate_sample(nsample=340, distrvs=rng.standard_normal)
    passato, futuro = s[:300], s[300:]
    fit = ARIMA(passato, order=(0, 0, 2)).fit()
    mu = fit.params[fit.param_names.index("const")]
    colpo.append(np.mean((futuro - fit.forecast(steps=len(futuro))) ** 2))
    piatta.append(np.mean((futuro - mu) ** 2))            # la linea di base
    stato, pezzi = fit, []
    for i in range(0, len(futuro), 2):                    # due passi per volta
        pezzi.extend(stato.forecast(steps=2))
        stato = stato.append(futuro[i:i + 2], refit=False)  # rientrano i veri
    finestra.append(np.mean((futuro - np.array(pezzi)) ** 2))

colpo, piatta, finestra = map(np.array, (colpo, piatta, finestra))
print("\nerrore quadratico medio su 40 passi, 12 serie:")
for etichetta, v in (("tutto in un colpo solo", colpo),
                     ("sempre il livello medio", piatta),
                     ("due passi per volta", finestra)):
    print(f"   {etichetta:24s} {v.mean():.2f}")
v = 1 + 0.9 ** 2 + 0.7 ** 2                 # varianza del processo
guadagno = ((v - 1) + (v - (1 + 0.9 ** 2))) / 40
print(f"   (a parametri noti i due passi utili valgono {guadagno:.3f} su 40)")
print("\nscarto appaiato rispetto alla linea piatta (negativo = meglio):")
for nome, misura in (("tutto in un colpo solo", colpo),
                     ("due passi per volta", finestra)):
    d = misura - piatta
    print(f"   {nome:24s} {d.mean():+.2f} +/- "
          f"{d.std(ddof=1) / np.sqrt(len(d)):.2f}"
          f"   meglio in {int((d < 0).sum())} serie su 12")
livello medio stimato: -0.092
   h = 1   previsione = -0.150   scarto dal livello medio = 6e-02
   h = 2   previsione = +0.544   scarto dal livello medio = 6e-01
   h = 3   previsione = -0.092   scarto dal livello medio = 0e+00
   h = 4   previsione = -0.092   scarto dal livello medio = 0e+00
   h = 5   previsione = -0.092   scarto dal livello medio = 0e+00
   h = 6   previsione = -0.092   scarto dal livello medio = 0e+00

errore quadratico medio su 40 passi, 12 serie:
   tutto in un colpo solo   2.45
   sempre il livello medio  2.49
   due passi per volta      1.49
   (a parametri noti i due passi utili valgono 0.045 su 40)

scarto appaiato rispetto alla linea piatta (negativo = meglio):
   tutto in un colpo solo   -0.04 +/- 0.01   meglio in 10 serie su 12
   due passi per volta      -0.99 +/- 0.18   meglio in 12 serie su 12
Il primo gruppo di righe è il modello stimato su una serie sola. I primi due passi hanno una previsione loro; dal terzo in poi la previsione coincide con il livello medio stimato, e lo scarto stampato è zero. È la linea piatta.
Il secondo gruppo confronta i tre modi di coprire quaranta passi sulle dodici serie. Il costo è l’errore quadratico medio (MSE), la media dei quadrati degli errori: il quadrato rende uguali l’errore per eccesso e quello per difetto, e pesa di più quelli grandi. Più basso è meglio, e il numero si legge solo per confronto con un altro. Chiedere all’MA(2) tutti e quaranta i passi in un colpo solo costa \(2{,}45\); rispondere sempre il livello medio, cioè non usare affatto il modello, costa \(2{,}49\). La differenza è minima, e la riga fra parentesi dice da dove viene: sono i due passi utili su quaranta, che a parametri noti valgono \(0{,}045\). Chi consegna quaranta passi di previsione da un MA(2) sta consegnando, per il novantacinque per cento, la linea di base. Chiederli due per volta, rimettendo sotto i valori veri man mano che arrivano, cambia registro: \(1{,}49\), due quinti in meno.
Il terzo gruppo dice se queste differenze sono vere o fortuna. Per ogni serie
si sottrae l’errore della linea piatta da quello del modello (è lo scarto
appaiato: negativo vuol dire che il modello ha fatto meglio) e se ne fa la
media sulle dodici serie; il numero dopo il +/- è l’errore standard di quella
media, cioè di quanto ballerebbe rifacendo la prova con altre dodici serie. Uno
scarto conta solo se è più grande del suo margine. Quello del colpo solo,
\(-0{,}04\) contro un margine di \(0{,}01\), è piccolo ma sistematico (più basso in
dieci serie su dodici); quello dei due passi per volta, \(-0{,}99\) contro
\(0{,}18\), è grosso e sistematico (più basso in tutte e dodici). Nessuno dei due
si sarebbe potuto chiamare così guardando una serie sola.
Scegliere l’ordine, e poi verificare i residui#
Sappiamo che cos’è un ARIMA, e sappiamo che i tre conteggi fra parentesi si scrivono \(p\) (quanti valori passati), \(d\) (quante volte si raddrizza la serie) e \(q\) (per quanti giorni dura l’eco degli urti). Resta la domanda pratica, che è quella che si pone chiunque abbia una serie davanti: quali numeri ci metto dentro, e come faccio a sapere se il modello che ne esce va bene? La risposta è una procedura in tre tempi, e vale per tutti i modelli di questa famiglia, dal più piccolo al SARIMA più carico di lettere.
Primo tempo: raddrizzare la serie. Si toglie la retta se una retta c’è, oppure si sostituisce ogni valore con la variazione rispetto al giorno prima se la serie cammina alla cieca. Per decidere se la serie è già a posto ci sono due esami, che si chiamano ADF e KPSS e vanno letti insieme. Partono da sospetti opposti: l’ADF parte dal sospetto che la serie non sia a posto e chiede alla serie di smentirlo, il KPSS parte dal sospetto contrario. Quindi lo stesso responso, nei due, vuol dire cose opposte, e il modo di leggerli è guardare se concordano. Da qui esce già uno dei tre conteggi, quello di mezzo, che dice quante volte si è raddrizzata la serie.
Secondo tempo: scegliere gli altri due. La ricetta dei manuali dice di leggere i due grafici a barre, l’ACF e la PACF, e dedurli da lì. Funziona sui casi da libro di testo, e sulle serie vere quasi mai: quando ci sono insieme la memoria dei valori e quella degli urti, entrambi i grafici scendono lentamente e non si legge niente.
Allora si fa la cosa onesta: si provano tutte le combinazioni entro un limite ragionevole. Sono una manciata di modelli e il computer li stima tutti in qualche secondo. Poi si sceglie con un criterio che tiene conto di due cose insieme: quanto bene il modello spiega i dati, e quanti numeri ha dovuto inventarsi per riuscirci. Il secondo pezzo conta quanto il primo: aggiungere numeri migliora sempre l’aderenza ai dati che si hanno sotto gli occhi, quindi senza una penalità si finirebbe per scegliere ogni volta il modello più grosso, che è il modo classico di imparare a memoria invece che imparare la regola.
Terzo tempo: guardare quello che resta. Fatta la scelta non si è finito, e questo è il passo che quasi tutti saltano, che è poi l’unico che dice se il modello è utile. Un modello buono ha spremuto dalla serie tutta la regolarità che c’era, quindi ciò che avanza, la differenza fra previsto e osservato, deve essere indistinguibile dal caso. Se in quello che avanza si vede ancora una regolarità, vuol dire che il modello se l’è lasciata sfuggire, e va cambiato. E se non si vede niente si è imparato meno di quanto sembri: vuol dire che con questi dati nessuna regolarità è saltata fuori, non che non ce ne siano.
Il modello sbagliato lo si riconosce dai suoi errori, non dalle sue previsioni. Le previsioni sembrano sempre plausibili; gli errori, se guardati, confessano.
La procedura è quella di Box e Jenkins nella forma che si usa oggi, in tre tempi.
1. Rendere stazionaria la serie. Si testa, si toglie il necessario, si fissa \(d\) (e \(D\) per la parte stagionale). Sovradifferenziare è un errore reale e riconoscibile: introduce autocorrelazione negativa artificiale al ritardo 1 e gonfia la varianza. Quando ciò che resta era rumore bianco il conto è esatto: \(\nabla\varepsilon_t = \varepsilon_t - \varepsilon_{t-1}\) è un MA(1) con \(\theta = -1\), quindi \(\rho_1 = \theta/(1+\theta^2) = -0{,}5\) e la varianza raddoppia. Si vede anche dal \(\theta\) stimato, che finisce proprio lì, sul bordo della regione di invertibilità.
Sui test conviene spendere quattro righe, perché sono due e vanno usati insieme. L’ADF (Dickey-Fuller aumentato, dal test di Dickey e Fuller del 1979 [DF79], che Said e Dickey estesero nel 1984 alle serie con una parte a media mobile di ordine ignoto [SD84]) ha per ipotesi nulla «c’è una radice unitaria», quindi un \(p\)-value basso dice stazionaria; il KPSS (Kwiatkowski, Phillips, Schmidt e Shin, 1992 [KPSS92]) ha per ipotesi nulla «la serie è stazionaria», quindi un \(p\)-value basso dice non stazionaria. Il KPSS ha dunque lo stesso verso del Ljung-Box del passo 3 (si spera di non rifiutare), l’ADF ha il verso contrario, e portare la regola dell’uno sull’altro è l’errore più facile del capitolo. Usarli in coppia dà quattro esiti e non due: concordi in un senso, concordi nell’altro, e i due casi in cui non concordano, che sono i più informativi, perché dicono che con questi dati la domanda non si decide e conviene guardare il grafico.
Il verdetto dipende anche dai termini deterministici che si mettono nella regressione ausiliaria del test. Si riprendano le venti serie di prova di poco fa, una retta più rumore: di radici unitarie non ne hanno nessuna.
import numpy as np
from statsmodels.tsa.stattools import adfuller

t = np.arange(300)
solo_costante, con_trend = [], []
for seme in range(20):
    rng = np.random.default_rng(seme)
    serie = 0.5 * t + rng.normal(0, 1, 300)      # le stesse venti di prima
    solo_costante.append(adfuller(serie, regression="c")[1])
    con_trend.append(adfuller(serie, regression="ct")[1])
print(f"ADF con la sola costante:  p medio {np.mean(solo_costante):.2f}, "
      f"il più basso {min(solo_costante):.2f}")
print(f"ADF con costante e trend:  p medio {np.mean(con_trend):.0e}, "
      f"il più alto {max(con_trend):.0e}")
ADF con la sola costante:  p medio 0.96, il più basso 0.88
ADF con costante e trend:  p medio 2e-10, il più alto 3e-09
Con la sola costante l’ADF non rifiuta mai, e chi segue la ricetta alla lettera differenzia, cioè sovradifferenzia. Mettendo il trend nella specificazione, le stesse serie danno il verdetto opposto, con un \(p\) praticamente nullo. Lo stesso vale per il KPSS, che a seconda della specificazione ha per ipotesi nulla la stazionarietà attorno a una costante oppure attorno a un trend: di entrambi i test va saputo quale delle due domande si è posta. I test non hanno difetti: stanno rispondendo a domande diverse.
2. Scegliere gli ordini con un criterio di informazione. Si stimano tutte le combinazioni di \((p,q)\) entro una griglia e si prende quella che minimizza l’AIC, il criterio di Akaike del 1974 [Aka74]:
dove \(\hat{L}\) è la verosimiglianza massimizzata e \(k\) il numero di parametri. Il primo termine penalizza la complessità, il secondo premia l’aderenza: è lo stesso compromesso bias-varianza del capitolo sul Machine Learning, espresso in valuta di verosimiglianza invece che di errore su un set di validazione. Il BIC di Schwarz [Sch78] (\(k\ln n - 2\ln\hat L\), con \(n\) il numero di osservazioni) penalizza di più al crescere delle osservazioni e tende a scegliere modelli più piccoli.
Due dettagli cambiano il numero. Il primo: in \(k\) entra anche la varianza
dell’innovazione, non solo i \(\phi\), i \(\theta\) e la costante; statsmodels la
conta (per un ARMA(1,1) con costante \(k=4\)), e chi rifà il conto a mano con
\(k=3\) sbaglia di due unità, cioè esattamente la soglia sotto la quale l’AIC non
distingue niente. Il secondo: il \(2k\) è una correzione asintotica, e in campione
corto va sostituita con la versione corretta per il campione finito (esatta per
la regressione lineare gaussiana, approssimata per gli ARIMA), l’AICc
\(= \mathrm{AIC} + \frac{2k(k+1)}{n-k-1}\), che il manuale di Hyndman e
Athanasopoulos raccomanda sugli ARIMA e che le loro librerie usano di default
[HA21]. Con seicento osservazioni e quei quattro
parametri la differenza è di sette centesimi; con quaranta, e sei parametri,
supera le due unità e cambia la scelta.
Una nota che vale più della formula: l’AIC è una quantità relativa. Il suo valore assoluto non significa nulla, contano solo le differenze \(\Delta_i = \mathrm{AIC}_i - \mathrm{AIC}_{\min}\), e la convenzione d’uso ha una lettura precisa: \(e^{-\Delta_i/2}\) è la verosimiglianza relativa del modello \(i\) rispetto al migliore, quindi a \(\Delta = 2\) vale \(0{,}37\) e il modello resta del tutto plausibile, a \(\Delta = 10\) vale \(0{,}007\) e non lo è più [BA04]. Differenze sotto le due unità non bastano a preferire un modello all’altro.
E contano solo fra modelli stimati sugli stessi dati. È la clausola che rende l’AIC un criterio invece che un numero, ed è la ragione per cui \(d\) si fissa al passo 1 e non si mette nella griglia: differenziare cambia i dati su cui la verosimiglianza è calcolata (una serie differenziata una volta ha un’osservazione in meno), e due AIC così non si possono sottrarre. Vale identico per le trasformazioni: l’AIC di un modello su \(\log x_t\) e quello di un modello su \(x_t\) non vivono nella stessa scala, e la differenza fra i due è dominata dal cambio di variabile, non dal modello. Su una serie positiva il confronto grezzo è dominato dal termine jacobiano \(2\sum_t \log x_t\), che nasce dal cambio di variabile e va rimesso al suo posto prima di sottrarre i due AIC. Per duecento punti che crescono in proporzione costante da un centinaio a circa settecento vale circa \(2\,230\) (su una crescita in proporzione costante la media dei logaritmi è quella dei due estremi: \(2 \cdot 200 \cdot \tfrac12(\log 100 + \log 700)\)), cioè più di mille volte la soglia delle due unità, e dipende solo da quanto sono grandi i numeri della serie, non da come si comportano. Tolto quel termine, il vantaggio del logaritmo, se c’è, torna della grandezza di una differenza fra modelli: il confronto grezzo stava misurando l’unità di misura.
3. Verificare i residui. Se il modello ha catturato la struttura, i residui \(\hat\varepsilon_t = x_t - \hat x_t\) devono essere rumore bianco: media nulla, varianza costante, nessuna autocorrelazione. Due strumenti, uno qualitativo e uno quantitativo.
Il Q-Q plot confronta i quantili empirici dei residui con quelli di una normale: se stanno su una retta, la distribuzione è normale come si assume. È veloce e resta un giudizio a occhio.
Il test di Ljung-Box è quantitativo e testa congiuntamente le prime \(\ell\) autocorrelazioni dei residui:
con \(n\) il numero di osservazioni, \(\ell\) il numero di ritardi esaminati (è la notazione di Hyndman e Athanasopoulos; il livello \(\ell_t\) del lisciamento esponenziale, più avanti, porta un pedice ed è un’altra cosa) e \(\hat\rho_k\) l’autocorrelazione campionaria al ritardo \(k\). Sotto l’ipotesi nulla di assenza di autocorrelazione, \(Q\) si distribuisce asintoticamente come una \(\chi^2\): è un’approssimazione per \(n\) grande, e regge se i ritardi esaminati sono pochi rispetto alle osservazioni. Quanti: la regola d’uso è \(\ell = 10\) su una serie senza stagionalità e \(\ell = 2m\) su una che ce l’ha, comunque non oltre \(n/5\), e comunque più di \(p+q\), altrimenti i gradi di libertà con cui il test si legge diventano zero o negativi [HA21].
Con quanti gradi di libertà, però, cambia tutto. Applicato ai residui di un ARMA stimato, il test va calcolato con \(\ell - (p+q)\) gradi di libertà e non con \(\ell\) [HA21]: i parametri già spesi per far aderire il modello ai dati non contano come prove d’innocenza. Ometterlo è la scorciatoia più diffusa della materia (le librerie lasciano fare, perché il parametro va passato a mano) ed è sempre ottimista: gonfia il \(p\)-value, cioè fa sembrare adeguati modelli che lo sono meno. Sull’ARMA scelto con seicento osservazioni la differenza fra le due letture è fra \(0{,}71\) e \(0{,}51\).
Attenzione anche al verso, perché è controintuitivo: qui si spera di non rifiutare. Un \(p\)-value alto significa «non c’è evidenza di struttura residua», cioè il modello va bene; un \(p\)-value basso significa che qualcosa è rimasto fuori. È il verso opposto a quello dell’ADF del passo 1.
Non rifiutare l’ipotesi nulla non prova che i residui siano rumore bianco: prova solo che il test, con quei dati, non ha trovato prove del contrario. È la stessa asimmetria di ogni test d’ipotesi, e la ragione per cui la diagnostica non sostituisce la validazione su dati futuri, che il capitolo affronta nella sezione seguente.
Il ciclo, in una riga: stima, seleziona, verifica, e se in quello che resta si vede ancora una regolarità torna indietro. È la stessa disciplina che nel Machine Learning tiene separati i dati su cui il modello impara da quelli su cui lo si esamina, applicata qui a un oggetto diverso.
Le due cose hanno un nome, e conviene averlo prima di vederle all’opera. Il criterio che sceglie fra i modelli si chiama AIC: più è basso, meglio è. Ma è un numero che vale solo per differenza, e la differenza va guardata con una soglia in testa: fra due modelli che distano meno di due unità l’AIC non indica una preferenza che valga la pena difendere. Quel due è una convenzione della materia, non una legge di natura, e ha un senso preciso: a due unità di distanza il modello peggiore conserva più di un terzo della plausibilità del migliore [BA04].
Il test che guarda quello che resta si chiama Ljung-Box, dai due statistici che lo misero a punto nel 1978 [LB78], e risponde a una domanda sola: negli errori del modello si vede ancora una regolarità, o sembrano capitati a caso? Un mucchio di numeri senza nessuna regolarità dentro si chiama rumore bianco, ed è il complimento più alto che si possa fare agli errori di un modello: vuol dire che tutto ciò che si poteva spremere è stato spremuto.
La risposta del test è un numero fra \(0\) e \(1\), il \(p\)-value della sezione su probabilità e statistica: la probabilità che errori senza nessuna regolarità ne mostrino, per puro caso, una almeno così marcata. Va letto al contrario di quanto verrebbe naturale: alto vuol dire che negli errori non c’è evidenza di regolarità, e il modello va bene finché non si trova di meglio; vicino a zero vuol dire che una regolarità c’è, e il modello se l’è lasciata fuori. La soglia d’uso è \(0{,}05\), per convenzione.
In pratica: l’AIC sceglie, Ljung-Box giudica#
Si può vedere l’intera procedura su una serie di cui conosciamo la risposta, perché la generiamo noi. La generiamo da un ARMA(2,1): un ARIMA senza il raddrizzamento (la I di mezzo), perché la serie che ci fabbrichiamo è già stabile e non c’è niente da raddrizzare. Guarda due valori passati e un urto passato.
import warnings
import numpy as np
from statsmodels.tsa.arima_process import ArmaProcess
from statsmodels.tsa.arima.model import ARIMA
from statsmodels.stats.diagnostic import acorr_ljungbox
from statsmodels.tools.sm_exceptions import ConvergenceWarning

# Gli avvisi sui valori di partenza qui non interessano; quelli di mancata
# convergenza sì, perché l'AIC di una stima non convergita non è affidabile.
warnings.simplefilter("ignore")

# Una serie generata da un ARMA(2,1) NOTO: la risposta giusta la sappiamo.
processo = ArmaProcess(ar=np.r_[1, -0.6, -0.25], ma=np.r_[1, 0.4])

def scegli(serie):
    """Stima tutte le combinazioni fino a ordine 3 e le ordina per AIC;
    restituisce anche quelle la cui stima non è arrivata a convergenza."""
    esiti, non_convergenti = [], []
    for p in range(4):
        for q in range(4):
            # d è fissato al passo 1 e NON entra nella griglia: differenziare
            # cambia i dati, e due AIC su dati diversi non si sottraggono
            with warnings.catch_warnings(record=True) as avvisi:
                warnings.simplefilter("always", ConvergenceWarning)
                aic = ARIMA(serie, order=(p, 0, q)).fit().aic
            if any(issubclass(a.category, ConvergenceWarning) for a in avvisi):
                non_convergenti.append(f"ARMA({p},{q})")
            esiti.append((aic, p, q))
    return sorted(esiti), non_convergenti

def ljung_box(residui, p, q, lags=10):
    """p-value di Ljung-Box sui residui di un ARMA(p,q) stimato.
    I gradi di libertà sono lags - (p+q): i parametri già spesi per
    adattare il modello non contano come prove d'innocenza."""
    esito = acorr_ljungbox(residui, lags=[lags], model_df=p + q, return_df=True)
    return esito["lb_pvalue"].iloc[0]

for n in (600, 2000):
    rng = np.random.default_rng(0)
    serie = processo.generate_sample(nsample=n, distrvs=rng.standard_normal)
    classifica, non_convergenti = scegli(serie)
    posto = [i for i, (_, p, q) in enumerate(classifica) if (p, q) == (2, 1)][0]
    print(f"\ncon {n} osservazioni (il vero modello è ARMA(2,1)):")
    for i, (aic, p, q) in enumerate(classifica[:3]):
        print(f"   ARMA({p},{q})   AIC = {aic:8.1f}   (+{aic - classifica[0][0]:.1f})")
    aic, p, q = classifica[posto]
    print(f"   il VERO ARMA(2,1) è {posto + 1}° a +{aic - classifica[0][0]:.1f}")
    print(f"   stime non arrivate a convergenza: "
          f"{', '.join(non_convergenti) or 'nessuna'}")

    p, q = classifica[0][1], classifica[0][2]
    residui = ARIMA(serie, order=(p, 0, q)).fit().resid
    pv = ljung_box(residui, p, q)
    voto = "nessuna evidenza di struttura" if pv > 0.05 else "resta struttura"
    print(f"   Ljung-Box sul modello scelto: p = {pv:.3f}  ->  {voto}")
    print(f"   (senza togliere i {p + q} gradi già spesi: p = "
          f"{ljung_box(residui, 0, 0):.3f})")

# e su un modello deliberatamente troppo povero? (nessun parametro: model_df=0)
pv = ljung_box(ARIMA(serie, order=(0, 0, 0)).fit().resid, 0, 0)
print(f"\nLjung-Box su un modello vuoto (0,0,0): p = {pv:.1e}  ->  resta struttura")
con 600 osservazioni (il vero modello è ARMA(2,1)):
   ARMA(1,1)   AIC =   1707.9   (+0.0)
   ARMA(2,0)   AIC =   1708.3   (+0.4)
   ARMA(3,0)   AIC =   1709.4   (+1.5)
   il VERO ARMA(2,1) è 5° a +1.8
   stime non arrivate a convergenza: ARMA(3,3)
   Ljung-Box sul modello scelto: p = 0.514  ->  nessuna evidenza di struttura
   (senza togliere i 2 gradi già spesi: p = 0.706)

con 2000 osservazioni (il vero modello è ARMA(2,1)):
   ARMA(2,1)   AIC =   5687.9   (+0.0)
   ARMA(1,2)   AIC =   5688.4   (+0.6)
   ARMA(3,2)   AIC =   5688.8   (+1.0)
   il VERO ARMA(2,1) è 1° a +0.0
   stime non arrivate a convergenza: nessuna
   Ljung-Box sul modello scelto: p = 0.407  ->  nessuna evidenza di struttura
   (senza togliere i 3 gradi già spesi: p = 0.705)

Ljung-Box su un modello vuoto (0,0,0): p = 0.0e+00  ->  resta struttura
Il risultato è più istruttivo di quello che ci si aspetterebbe.
Con 600 osservazioni l’AIC sbaglia: sceglie un ARMA(1,1) invece del vero ARMA(2,1). Ma guarda i margini. Il secondo classificato è a \(+0{,}4\) dal primo, il terzo a \(+1{,}5\), e il vero ARMA(2,1) arriva quinto a \(+1{,}8\): dal primo all’ultimo di questi, tutti stanno dentro le due unità sotto le quali, come si è appena detto, l’AIC non indica una preferenza. L’AIC non ha scartato il modello vero, l’ha messo nella stessa nuvola d’indifferenza degli altri, il che con seicento osservazioni è la verità. Delle sedici stime, una non è arrivata a convergenza, l’ARMA(3,3): il suo AIC non è affidabile, e qui non cambia niente solo perché sta lontano dalla testa della classifica.
Il Ljung-Box sul modello scelto dà \(p = 0{,}514\): il test, su questi dati, non trova evidenza di struttura residua. Che non è la stessa cosa che dimostrare l’assenza, come si è avvertito poco fa, ma è tutto quello che una diagnostica può dare. (Senza togliere i gradi già spesi per stimare il modello, il \(p\) sale a \(0{,}706\): è la lettura ottimista che le librerie lasciano fare, e che fa sembrare il modello più adeguato di quanto sia.) Il modello «sbagliato» va benissimo, ed è la lezione centrale: l’obiettivo non è indovinare il modello vero (che sulle serie reali non esiste), ma trovarne uno che non lasci struttura fuori.
Con 2000 osservazioni l’AIC trova l’ordine giusto, e il secondo classificato è ancora lì a \(+0{,}6\). Verrebbe da concludere che basti avere più dati, e sarebbe una conclusione affrettata, perché quello è un colpo riuscito, uno solo. Lo stesso esperimento si rilancia allora venti volte, cambiando ogni volta soltanto il seme, il numero da cui parte il generatore di numeri casuali e che decide quale, fra le infinite serie che quel modello può produrre, esce davvero.
# pt-lento: 640 stime ARIMA, un paio di minuti su CPU
for n in (600, 2000):
    esatti, p_minimo = 0, 1.0
    for seme in range(20):
        rng = np.random.default_rng(seme)
        serie = processo.generate_sample(nsample=n, distrvs=rng.standard_normal)
        classifica, _ = scegli(serie)
        p, q = classifica[0][1], classifica[0][2]
        esatti += (p, q) == (2, 1)
        residui = ARIMA(serie, order=(p, 0, q)).fit().resid
        p_minimo = min(p_minimo, ljung_box(residui, p, q))
    print(f"n = {n}: ordine esatto in {esatti} serie su 20, "
          f"p di Ljung-Box mai sotto {p_minimo:.3f}")
n = 600: ordine esatto in 1 serie su 20, p di Ljung-Box mai sotto 0.127
n = 2000: ordine esatto in 5 serie su 20, p di Ljung-Box mai sotto 0.175
Più dati aiutano, quindi, e si vede: l’ordine esatto esce una volta su venti con seicento osservazioni e cinque volte su venti con duemila. Ma non bastano affatto, perché anche con duemila osservazioni l’AIC manca il modello vero tre volte su quattro.
L’AIC fa il suo mestiere: è fatto per scegliere il modello che prevede meglio, non per indovinare quello che ha generato i dati, e quando due modelli spiegano i dati quasi ugualmente bene i due obiettivi non coincidono. A puntare sull’identificazione è semmai il BIC, un parente stretto che penalizza i parametri tanto più severamente quante più osservazioni ci sono. La lezione che invece tiene su tutti i semi e a tutte e due le numerosità è un’altra: il Ljung-Box sul modello scelto non rifiuta mai, e il \(p\)-value più basso nei quaranta esperimenti è \(0{,}13\).
Sul modello vuoto, infine, il \(p\)-value crolla a zero. «Vuoto» vuol dire letteralmente questo: un ARMA(\(0,0\)) non guarda nessun valore passato e nessun urto passato, dice soltanto che la serie balla a caso attorno alla propria media. Su una serie che una memoria invece ce l’ha, quello che avanza è tutta la memoria, e il test la vede benissimo: è esattamente il suo mestiere.
Un’ultima avvertenza, che la sezione seguente riprende quando costruisce il backtesting: anche scegliere \(p\) e \(q\) è un modo di usare i dati. Qui le sedici combinazioni sono state provate su tutta la serie, dal primo giorno all’ultimo. Se adesso misurassimo quanto sbaglia il modello scelto su quegli stessi giorni, il numero verrebbe più bello del vero, perché il modello è stato scelto avendo già visto anche i giorni che avrebbero dovuto fargli da esame.
Con l’AIC il danno è piccolo, perché l’AIC non promette di dire quanto il modello sbaglierà su giorni nuovi: dichiara solo quanto aderisce a quelli che ha già visto, penalità compresa. Diventa grave quando a scegliere è l’errore misurato su un pezzo di serie tenuto da parte, che è il meccanismo costruito nella sezione seguente: lì la scelta va fatta dentro quel meccanismo, non prima.
Il mondo entra nella serie: SARIMAX e VAR#
Fin qui la serie ha spiegato sé stessa con il proprio passato. Ma il gelataio sa che le vendite dipendono dal meteo, e il negoziante che dipendono dalle promozioni. Come entrano, quelle informazioni?
Le strade sono due, e rispondono a due situazioni diverse.
La prima: hai una serie da prevedere e altre informazioni che la influenzano ma che non ti interessa prevedere (la temperatura, i giorni di festa, il prezzo di listino). Quelle si chiamano variabili esogene, cioè «che vengono da fuori», e si aggiungono al modello come contributi che si sommano a quello che la serie già spiega da sola. La sigla diventa SARIMAX, e la X finale sta proprio per quelle variabili esterne.
C’è una trappola che si scopre sempre troppo tardi. Per prevedere le vendite di domani con il meteo, ti serve il meteo di domani, che non hai. Quindi o è una cosa che si conosce in anticipo per costruzione (il calendario, i giorni di chiusura, una promozione già decisa), oppure va prevista a sua volta, e allora nella previsione finale entrano due errori invece di uno. Le variabili esogene che aiutano davvero sono quasi sempre quelle del primo tipo.
La seconda strada: hai più serie che si influenzano a vicenda e vuoi prevederle tutte insieme (il reddito e i consumi, la domanda e il prezzo). Qui non c’è una principale e delle comparse: ognuna dipende dal proprio passato e da quello delle altre. È il modello VAR, e la V sta per «vettoriale», che qui vuol dire solo che al posto di un numero per volta il modello tratta una fila di numeri per volta, una casella per ciascuna serie.
Il VAR conviene a una condizione: che quelle serie si aiutino davvero a prevedersi. Se non lo fanno il modello resta lecito, e una cosa continua a darla, cioè quanto le serie possono sbagliare insieme; quello che non compra sono previsioni migliori, e quei parametri, che crescono col quadrato del numero di serie, li paghi lo stesso.
Esiste un test per verificarlo, e prende il nome dall’economista Clive Granger, che lo propose nel 1969 [Gra69]. Il nome, però, è la cosa più sbagliata che ha: si dice «causalità di Granger», e non dice affatto che una serie fa succedere l’altra. Dice solo che il suo passato aiuta a indovinarla. Se il gelato e i condizionatori salgono insieme d’estate, ciascuno dei due «prevede» l’altro benissimo, ma a farli salire è il caldo, che non è né l’uno né l’altro. È un’affermazione sui dati, non sul mondo, e chi la porta fuori da qui come se fosse una prova di causa fa un errore che è costato mezzo secolo di equivoci.
SARIMAX aggiunge al SARIMA una componente di regressione su \(r\) variabili esogene \(\mathbf{z}_t\):
dove \(\eta_t\) segue un SARIMA(\(p,d,q\))(\(P,D,Q\))\(_m\). Si legge bene così: una regressione ordinaria il cui errore non è indipendente ma ha esso stesso una struttura temporale, il che è precisamente la ragione per cui una regressione lineare ordinaria su dati temporali dà coefficienti con errori standard sbagliati (di solito troppo piccoli, e i test troppo ottimisti).
Il vincolo operativo da tenere a mente: per una previsione a orizzonte \(h\) servono i valori \(\mathbf{z}_{T+1},\dots,\mathbf{z}_{T+h}\). O sono noti per costruzione (calendario, festività, promozioni pianificate), o vanno previsti, e la loro incertezza si propaga a quella finale senza che gli intervalli standard ne tengano conto.
Il modello VAR(\(p\)) tratta invece \(N\) serie come un vettore \(\mathbf{x}_t \in \mathbb{R}^N\) (nel capitolo \(N\) è sempre il numero di serie osservate insieme, e \(n\) resta il numero di osservazioni di una serie; la lettera \(d\) è già impegnata per l’ordine di differenziazione):
con \(\mathbf{A}_i\) matrici \(N \times N\). La condizione di stazionarietà è la sorella multivariata di quella dell’AR: le radici di \(\det(\mathbf{I} - \mathbf{A}_1 z - \dots - \mathbf{A}_p z^p)\) devono stare fuori dal cerchio unitario. Il numero di parametri cresce come \(pN^2\) (più le \(N\) intercette e le \(N(N+1)/2\) della covarianza delle innovazioni), il che spiega perché il VAR sia praticabile su poche serie e diventi subito ingestibile su molte.
Il test di causalità di Granger verifica se i ritardi di una serie migliorano significativamente la previsione di un’altra rispetto ai soli ritardi di quest’ultima: è un test \(F\) fra due regressioni annidate, l’ipotesi nulla è che i coefficienti aggiuntivi siano tutti nulli, e richiede serie stazionarie. Il verso è quello dell’ADF del passo 1, non quello del KPSS: si spera di rifiutare, perché rifiutare vuol dire che i ritardi dell’altra serie servono. Un \(p\)-value basso dice quindi «Granger-causa», un \(p\) alto dice che il VAR non compra niente. Va fatto in entrambe le direzioni, perché è asimmetrico. E va letto sapendo che il verdetto dipende da che cos’altro c’è nella regressione: una Granger-causalità fra due serie può sparire appena se ne aggiunge una terza, ed è il caso più frequente sui dati veri. Dipende anche dal numero di ritardi che si è scelto.
Un chiarimento su cosa il test non è: non è un test di validità del VAR. Un VAR le cui matrici \(\mathbf{A}_i\) risultano (blocco-)diagonali è un modello perfettamente ben specificato, che si riduce a tanti AR univariati e che continua ad aggiungere qualcosa rispetto a stimarli separatamente ogni volta che le innovazioni \(\boldsymbol{\varepsilon}_t\) sono correlate contemporaneamente (per gli intervalli congiunti, e per le funzioni di risposta d’impulso). Il test di Granger è un test di esclusione su un blocco di coefficienti: risponde a «i ritardi incrociati servono?», non a «il VAR è lecito?».
E qui va detto forte, perché il nome ha prodotto mezzo secolo di equivoci: la causalità di Granger non è causalità. È precedenza predittiva, e soltanto quella. Due serie guidate da una terza causa comune non osservata si «Granger-causano» a vicenda allegramente; e una causa vera che agisce più in fretta del passo di campionamento non viene rilevata affatto. Il test dice «il passato di \(A\) aiuta a prevedere \(B\)», che è un’affermazione sui dati, non sul mondo. La scala della causalità di Judea Pearl, quella della sezione su probabilità e statistica, serve esattamente a tenere separate queste due cose: il gradino su cui vive un test di Granger è il primo, quello delle associazioni fra dati osservati.
Lisciamento esponenziale: da SES a Holt-Winters#
La famiglia ARIMA dichiara la memoria della serie a voce alta: tanti valori passati, tanti urti passati, un coefficiente per ciascuno. C’è una seconda famiglia, altrettanto classica, che non dichiara niente e ottiene lo stesso effetto con molto meno: il lisciamento esponenziale (exponential smoothing). Al posto dei coefficienti ha una media, e la fa su tutto il passato in una volta sola.
Per indovinare le vendite di domani potresti fare la media di tutti i giorni passati. Ma il mese scorso conta davvero quanto ieri? No. Il lisciamento esponenziale fa una media pesata, in cui ieri pesa molto, l’altro ieri un po’ meno, la settimana scorsa ancora meno, e così via a scendere. A ogni passo indietro il peso si riduce di una stessa frazione, come un ricordo che sbiadisce sempre allo stesso ritmo: nitido ieri, sfocato la settimana scorsa, quasi niente un anno fa.
Il conto non chiede di tenere il registro di tutti i giorni passati: basta un numero, la stima di ieri, che ogni sera si sposta un poco verso quello che è appena successo. Quanto poco lo decide una manopola. Girata tutta da un lato, il metodo insegue ogni sussulto e dimentica in fretta; tutta dall’altro, è lento a cambiare idea. Messa a 30 su 100, la manopola dà a oggi un peso di 30, e a ogni passo indietro il settanta per cento del precedente: 21, poi quasi 15, e così a scendere.
La versione base tiene conto solo del livello (dove sta la serie ora). Ma se la serie sale con costanza, ti serve anche una stima di quanto sale: aggiungi il trend. E se ha un respiro stagionale, aggiungi anche quello. Sono i tre gradini: livello, poi livello + trend, poi livello + trend + stagionalità. Con tutti e tre, il metodo si chiama Holt-Winters, dai nomi dei due che lo misero a punto fra il 1957 e il 1960: Charles Holt per il livello e la tendenza, Peter Winters per la stagione. E se la tendenza va prolungata lontano, conviene smorzarla: nessuna crescita dura per sempre, e una salita che si spegne piano sbaglia di meno di una che tira dritto per anni.
Il lisciamento esponenziale semplice (SES) tiene solo il livello \(\ell_t\) e lo aggiorna a ogni passo come media pesata fra l’osservazione nuova e la stima vecchia:
con \(\alpha \in (0,1)\) il fattore di lisciamento. Srotolando la ricorsione fino all’inizio della serie, \(\ell_t = \alpha \sum_{j=0}^{t-1} (1-\alpha)^j x_{t-j} + (1-\alpha)^t \ell_0\): i pesi \(\alpha(1-\alpha)^j\) decadono esponenzialmente e, per \(t\) grande (quando il peso residuo dell’inizializzazione \(\ell_0\) è ormai trascurabile), la loro somma tende a \(1\). Con \(\alpha = 0{,}3\) valgono \(0{,}30,\ 0{,}21,\ 0{,}147,\ \dots\)
Il metodo di Holt aggiunge una componente di trend \(b_t\):
con previsione a \(h\) passi \(\hat{x}_{t+h} = \ell_t + h\,b_t\). Holt-Winters aggiunge infine la stagionalità \(s_t\) di periodo \(m\) (forma additiva):
dove \(k = \lfloor (h-1)/m \rfloor\): l’indice stagionale ricicla sempre l’ultimo ciclo stimato, così anche oltre un periodo intero (\(h > m\)) la previsione non riferisce mai stagioni non ancora osservate. I tre fattori \(\alpha,\beta,\gamma\) stanno fra \(0\) e \(1\), con il vincolo in più \(\gamma \le 1-\alpha\) che questa parametrizzazione porta con sé, e regolano quanto in fretta livello, trend e stagionalità si adeguano ai dati nuovi (qui \(\gamma\) è un fattore di lisciamento, non l’autocovarianza \(\gamma(k)\) dell’ACF di poco fa: è la notazione consolidata di questa famiglia, e le due cose non hanno niente a che vedere). È la forma a componenti di Hyndman e Athanasopoulos, dove questo \(\beta\) si scrive \(\beta^*\): nella loro forma a correzione d’errore il pendio si aggiorna con \(\alpha\beta^*\), e chi confronta i valori stimati da due librerie deve sapere quale dei due sta leggendo.
Questi metodi hanno una veste moderna nei modelli ETS (Error, Trend, Seasonal) in forma spazio-stato, che aggiungono un’interpretazione probabilistica e intervalli di previsione. Le tre componenti si combinano: errore additivo o moltiplicativo; trend assente, additivo o additivo smorzato; stagionalità assente, additiva o moltiplicativa. Fra le combinazioni si sceglie con l’AICc [HA21]. Il trend smorzato esiste perché un trend lineare prolungato su orizzonti lunghi tende a sovrastimare. Con un fattore di smorzamento \(0<\kappa<1\) (in letteratura si scrive \(\phi\), che qui è già il coefficiente dell’AR) la previsione diventa \(\hat{x}_{t+h} = \ell_t + (\kappa + \kappa^2 + \dots + \kappa^h)\,b_t\), la pendenza si spegne, e la previsione converge a \(\ell_t + b_t\,\kappa/(1-\kappa)\) [GM85].
Il lisciamento esponenziale semplice, infine, è un ARIMA travestito. Dall’aggiornamento scritto come \(\ell_t = \ell_{t-1} + \alpha e_t\), con \(e_t = x_t - \ell_{t-1}\) l’errore a un passo, si ricava \(x_t - x_{t-1} = e_t - (1-\alpha)\,e_{t-1}\): una media mobile di ordine uno sulla serie differenziata, cioè un ARIMA(0,1,1) con \(\theta = \alpha - 1\) [HA21]. Per \(\alpha \to 1\) il \(\theta\) va a zero e resta la passeggiata aleatoria; per \(\alpha \to 0\) va a \(-1\), che è la firma della sovradifferenziazione: un lisciamento quasi fermo dice che la serie è rumore attorno a un livello fisso, e che differenziarla era di troppo.
Lo stato che non si vede: il filtro di Kalman#
Nel lisciamento esponenziale la manopola \(\alpha\) è stata finora una scelta di gusto: più grande, e la stima insegue ogni sussulto; più piccola, e reagisce in ritardo. Il filtro di Kalman la ricava invece da due incertezze dichiarate: quanto si muove la grandezza che si vuole conoscere, e quanto sbaglia lo strumento che la misura. Viene dall’ingegneria dei sistemi di controllo, e poggia sul modello a spazio di stato della sezione sui sistemi dinamici: lo stato, una manciata di variabili che non si osservano, evolve nel tempo, e la misura ne dà un’immagine rumorosa. Rudolf Kálmán pubblicò la ricetta per aggiornare la stima dello stato a ogni misura nuova nel 1960 [Kal60]; il ciclo su cui poggia (prevedere lo stato, guardare la misura, correggere) l’avevano già scritto l’astronomo danese Thorvald Thiele nel 1880 e, alla fine degli anni Cinquanta, Ruslan Stratonovich e Peter Swerling [RN20], e il nome è rimasto a Kálmán perché è la sua versione che l’ingegneria ha adottato. Il lisciamento esponenziale ne è un caso particolare, e la sua manopola, vista da lì, smette di essere una questione di gusto.
Il magazzino di un ricambista tiene ottomila articoli, e per ciascuno ci sono due numeri che dicono quanti pezzi ci sono. Il primo lo dà il gestionale, cioè il programma che registra i movimenti: ieri erano quaranta, oggi ne sono usciti sei ed è arrivato un bancale da dieci, quindi oggi sono quarantaquattro. Il secondo lo dà il magazziniere che, ogni tanto, va allo scaffale e li conta. Il conto dà quarantuno. Quei pezzi che ci sono davvero, e che nessuno dei due numeri conosce, sono lo stato.
Nessuno dei due è la verità. Il gestionale non registra le rotture, i resi messi a posto male, il pezzo preso di fretta senza scrivere niente; e quegli errori si accumulano, perché ogni giorno che passa senza un controllo se ne aggiunge un altro. Il magazziniere, dal canto suo, conta in fretta scaffali alti, e sbaglia di uno o due, ma sbaglia soltanto oggi: il suo errore non si porta dietro quello di ieri.
Che cosa scrivere, allora, sulla scheda dell’articolo? Prendere il conto e buttare il gestionale è sprecare tutto quello che si sapeva; tenere il gestionale e ignorare il conto è ostinazione. Ci si muove in mezzo, e di quanto lo decide il confronto fra i due margini di errore. Se il magazziniere è preciso e il gestionale è vecchio di tre settimane, ci si sposta quasi tutto sul conto; se il conto è stato fatto di corsa e il gestionale è stato aggiornato ieri, ci si sposta appena. La proporzione con cui ci si sposta ha un nome preso dall’ingegneria, guadagno, e si ricava dai due margini: si fa il quadrato di ciascuno, perché è così che due errori indipendenti si mettono insieme (si sommano i quadrati, come i cateti di un triangolo rettangolo), e si guarda quanto pesa il quadrato del gestionale sul totale. Con un margine di tre pezzi per il gestionale e di uno per il conteggio: nove e uno, cioè nove parti su dieci in tutto, guadagno nove decimi. La sorpresa, cioè i quarantuno contati meno i quarantaquattro previsti, vale meno tre, e nove decimi di meno tre fanno meno due virgola sette: sulla scheda va quarantuno virgola tre. Come conteggio di pezzi un numero con la virgola non esiste; come stima sì.
Se i due margini sono dichiarati onestamente, quella proporzione è la sola che rende lo sbaglio più piccolo possibile sul lungo periodo: in una singola giornata spostarsi un po’ di più o un po’ di meno può risultare più fortunato, ma su mille giornate nessun’altra proporzione fa meglio.
Fatto questo, c’è un secondo numero da aggiornare: il margine di quello che si è appena scritto. Dopo un conteggio si sa di più di prima, quindi il margine si stringe, e nell’esempio passa da tre pezzi a circa uno; più era preciso il conteggio, più si stringe. Poi ricomincia il giro: si prevede il giorno dopo, e nel prevedere il margine si allarga di nuovo, perché è passato un altro giorno di rotture non registrate. Il ciclo è sempre lo stesso, tre mosse: prevedi, guarda, correggi in proporzione a quanto ti fidi. Per questo si chiama filtro: lascia passare quello che nella misura è informazione e trattiene quello che è rumore.
Su un articolo lento, di quelli che stanno fermi sullo scaffale per mesi, il gestionale non ha movimenti da registrare, quindi la previsione è semplicemente «oggi come ieri»; e se i due margini restano gli stessi giorno dopo giorno, il guadagno smette di cambiare e si assesta su un valore fisso. La regola diventa: la stima nuova è un pezzetto del conto di oggi più tutto il resto della stima di ieri. Che è, parola per parola, il lisciamento esponenziale, e la sua manopola la decide il confronto fra quanto si muove la cosa che si vuole conoscere e quanto sbaglia lo strumento che la guarda. Serve però che qualche rottura non registrata continui a capitare. Se non ne capitasse nessuna, il margine non si riallargherebbe mai, ogni conteggio peserebbe meno di quello prima (la metà, un terzo, un quarto), e la scheda finirebbe per segnare la media di tutti i conteggi fatti: un’altra cosa dal lisciamento esponenziale.
Quello che conta, nel dosaggio, è quale dei due margini è più grande. Raddoppiali tutti e due e sulla scheda finisce lo stesso numero di prima: cambia solo la forchetta che le si scrive accanto. Sbagliare il confronto, invece, si paga, e in due modi opposti. Se il magazziniere lo si crede più preciso di quanto sia, la scheda viene riscritta a ogni conteggio e insegue i suoi errori; se lo si crede meno preciso, lo si smette di ascoltare, e la scheda si allontana dal magazzino senza che nessuno se ne accorga. Dalla scheda non si vede; si vede dal registro delle sorprese. Con due margini onesti le sorprese vengono grandi più o meno quanto quei margini promettevano, e non sistematicamente più piccole o più grandi; e non vanno a strisce, tante in su di fila e poi tante in giù.
Tutto questo regge se la previsione si fa sommando (ieri più gli arrivi meno le uscite) e se gli errori sono sparsi attorno allo zero, cioè se sbagliano tanto in eccesso quanto in difetto. Se qualcuno si porta via i pezzi, gli errori sbagliano sempre nello stesso verso, e nessun dosaggio fra i due numeri lo aggiusta: quello è un modello sbagliato, e va cambiato il modello. E c’è un secondo modo di uscire di strada: il bancale di stamattina o è arrivato o non è arrivato, quindi i pezzi sono quaranta oppure cinquanta, e scrivere quarantacinque con un margine largo è una bugia comoda, perché quarantacinque non è mai stato possibile. Lì si cambia arnese: si tengono tante schede in parallelo, una per ipotesi, e a ogni conteggio si dà più peso a quelle che ci avevano preso, buttando via le peggiori e duplicando le migliori. È il filtro a particelle, e il suo prezzo sono le schede: ne servono tante di più quante più grandezze si seguono insieme.
Il modello a livello locale è il più piccolo modello in spazio di stato che serva a qualcosa: uno stato scalare che cammina a caso, e una misura rumorosa di quello stato,
con \(w_t\) ed \(e_t\) indipendenti fra loro, nel tempo e dallo stato iniziale (alla più debole delle due garanzie che seguono basta che siano incorrelati). Il livello \(\ell_t\) è la stessa grandezza che il lisciamento esponenziale stima, e \(x_t\) la serie osservata.
Il filtro di Kalman mantiene due numeri, la stima corrente \(\hat{\ell}_{t}\) e la sua varianza \(V_t\), e li aggiorna in due tempi. La predizione porta avanti lo stato e allarga l’incertezza,
la correzione usa la misura appena arrivata, con il guadagno
La quantità \(x_t - \hat{\ell}_{t|t-1}\) è l’innovazione, cioè la parte della misura che il modello non aveva previsto, e \(K_t \in (0,1)\) dice quanta parte di quella sorpresa entra nella stima. Il guadagno è grande quando l’incertezza sulla previsione supera quella della misura, e piccolo nel caso opposto: è un rapporto fra i gradi di fiducia, non una costante da tarare.
La garanzia è forte e va enunciata per intero. Sotto linearità e rumore gaussiano, \(\hat{\ell}_t\) è la media della distribuzione a posteriori dello stato date tutte le osservazioni fino a \(t\), quindi è lo stimatore a minimo errore quadratico medio, e \(V_t\) è la sua varianza esatta. Senza gaussianità la ricorsione resta il migliore fra gli stimatori lineari non distorti, e a quella seconda garanzia bastano media nulla, varianze note e incorrelazione: è meno, ma non è poco.
Con \(\sigma_\ell^2>0\) e \(\sigma_x^2\) costanti la ricorsione su \(V\) converge. Componendo correzione e predizione si ha \(V_{t+1|t} = V_{t|t-1}\sigma_x^2/(V_{t|t-1}+\sigma_x^2) + \sigma_\ell^2\); dividendo per \(\sigma_x^2\), e posti \(r = \sigma_\ell^2/\sigma_x^2\) (il rapporto segnale-rumore, che è il nome con cui compare anche nel codice, e non ha niente a che vedere con le \(r\) variabili esogene del SARIMAX) e \(v = V_{t|t-1}/\sigma_x^2\), l’iterazione diventa \(v \mapsto v/(v+1) + r\), che ha derivata \(1/(v+1)^2 < 1\): è una contrazione, quindi il punto fisso esiste, è unico ed è attrattivo. La condizione \(v = v/(v+1) + r\) dà \(v^2 - rv - r = 0\), la cui sola radice positiva (e \(v\) è un rapporto di varianze) è
E la ricorsione a regime, sostituendo, è \(\hat{\ell}_t = K_\infty x_t + (1-K_\infty)\hat{\ell}_{t-1}\), cioè il lisciamento esponenziale semplice con \(\alpha = K_\infty\). La corrispondenza si inverte in una riga, \(r = K_\infty^2/(1-K_\infty)\), ed è una biiezione fra \((0,\infty)\) e \((0,1)\): a ogni fattore di lisciamento ammissibile corrisponde uno e un solo rapporto segnale-rumore, e viceversa. Sceglierlo equivale quindi a dichiarare un’ipotesi sul fenomeno invece che a tentare un numero, ed è per questo che i modelli in forma spazio-stato danno, oltre alle stesse previsioni puntuali, anche gli intervalli e un criterio d’informazione per scegliere fra modelli [HA21].
Con \(\sigma_\ell^2 = 0\) la convergenza si perde: il guadagno scende come \(1/t\), la stima diventa la media campionaria dell’intera serie, e non è più un lisciamento esponenziale.
La generalizzazione è meccanica. Un ingresso noto entra nell’evoluzione,
\(\ell_t = \ell_{t-1} + u_t + w_t\) (gli arrivi e le uscite registrati), e
sposta soltanto la predizione: varianze e guadagno restano gli stessi. Lo stato
diventa un vettore (livello e pendenza, oppure livello e dodici indici
stagionali), la sua evoluzione una matrice, e la misura una combinazione
lineare delle sue componenti; varianze e
guadagno diventano matrici, e l’unica divisione della formula scalare diventa
l’inversione di una matrice, di lato pari al numero di grandezze osservate
insieme. È in quella forma che statsmodels stima un ARIMA, la cui classe
eredita per intero dall’impianto in spazio di stato: la verosimiglianza si
scrive come prodotto delle densità delle innovazioni, e il filtro la calcola in
una passata. (I modelli ETS della stessa libreria seguono invece la forma a
innovazioni di Hyndman, dove i fattori di lisciamento sono direttamente i
parametri e il filtro non serve.)
I punti di rottura sono tre. Il primo è la linearità: se lo stato evolve o si osserva in modo non lineare, si linearizza attorno alla stima corrente (filtro esteso) o si propagano pochi punti scelti (filtro unscented), e tutti e due possono divergere quando la non linearità è forte. Il secondo sono la gaussianità e l’unimodalità: il filtro riassume la posteriore con media e varianza, quindi un problema in cui le ipotesi plausibili sono due lontane fra loro non ci sta dentro. Lì si usa il filtro a particelle [GSS93], che rappresenta la posteriore con un campione pesato: ogni particella si propaga secondo il modello, il suo peso viene moltiplicato per la verosimiglianza della misura, e si normalizzano i pesi e si ricampiona, per non ritrovarsi con un peso solo diverso da zero. Non chiede né linearità né gaussianità, e il suo prezzo è il numero di particelle, che per tenere l’errore sotto controllo deve crescere molto in fretta con la dimensione dello stato: per questo è il metodo di elezione su stati piccoli e non su stati grandi. Il terzo punto di rottura sono le due varianze: \(\sigma_\ell^2\) e \(\sigma_x^2\) non si osservano ma si stimano, e conviene distinguere che cosa dipenda da che cosa. Le stime dipendono solo dal loro rapporto, quindi scalarle entrambe dello stesso fattore non le cambia; gli intervalli invece sì. Sbagliare il rapporto degrada il filtro nei due versi. La diagnostica giusta non guarda le stime ma le innovazioni, che sotto il modello corretto sono bianche e di varianza \(V_{t|t-1} + \sigma_x^2\): un test di Ljung-Box sulle innovazioni normalizzate è lo stesso controllo sui residui già visto per ARIMA.
Il filtro sta in dieci righe, e la cosa da guardare mentre gira è la proporzione con cui la sorpresa entra nella stima: parte da uno, perché all’inizio non si sa niente e la prima misura vale come verità, e scende fino ad assestarsi.
import numpy as np

rng = np.random.default_rng(0)
passi = 300
var_livello, var_misura = 0.05, 1.0        # quanto si muove, quanto sbaglia
livello = np.cumsum(rng.normal(0, np.sqrt(var_livello), passi))
misura = livello + rng.normal(0, np.sqrt(var_misura), passi)

def filtro(x, var_l, var_x, V0=1e6):
    """Predici, guarda, correggi: una passata sola sui dati."""
    stima, V, storia, guadagni = 0.0, V0, [], []
    for xt in x:
        V = V + var_l                      # predico: l'incertezza cresce
        K = V / (V + var_x)                # quanto credo alla misura nuova
        stima = stima + K * (xt - stima)   # correggo, in proporzione a K
        V = (1 - K) * V                    # e l'incertezza scende
        storia.append(stima)
        guadagni.append(K)
    return np.array(storia), np.array(guadagni)

stima, K = filtro(misura, var_livello, var_misura)
print(np.round(K[:6], 4))     # il guadagno dei primi sei passi
print(round(K[-1], 6))        # e quello dell'ultimo

# a regime il guadagno e' l'alfa del lisciamento esponenziale
r = var_livello / var_misura
v = (r + np.sqrt(r * r + 4 * r)) / 2
alfa = v / (v + 1)
print(round(alfa, 6))

ses = np.empty(passi)
ses[0] = misura[0]
for t in range(1, passi):
    ses[t] = alfa * misura[t] + (1 - alfa) * ses[t - 1]
print(round(np.abs(stima[100:] - ses[100:]).max(), 10),   # la distanza massima
      round((1 - alfa) ** 100, 10))                       # e 0,8 alla cento

# quanto serve: errore quadratico medio contro il livello vero, e il valore
# che la teoria prevede a regime, cioe' la radice di (1 - alfa) * v
rmse = lambda a: float(np.sqrt(np.mean((a - livello) ** 2)))
print(round(rmse(misura), 4), round(rmse(stima), 4),      # misura, filtro
      round(np.sqrt((1 - alfa) * v), 4))                  # e teoria a regime

# e i due modi di sbagliare le due larghezze dichiarate, di 25 volte e di 1000
for fattore in (25, 1000):
    print(fattore,
          round(rmse(filtro(misura, var_livello, var_misura / fattore)[0]), 4),
          round(rmse(filtro(misura, var_livello, var_misura * fattore)[0]), 4))
[1.     0.5122 0.3599 0.2907 0.2541 0.2332]
0.2
0.2
2e-10 2e-10
0.9752 0.4171 0.4472
25 0.6608 0.6819
1000 0.9551 1.1446
La proporzione parte da \(1\), scende in fretta (\(0{,}51\), \(0{,}36\), \(0{,}29\), \(0{,}25\), \(0{,}23\)) e continua a scendere fino ad assestarsi su \(0{,}2\), che è esattamente il valore che si ricava dalle due larghezze dichiarate. Da lì in poi il filtro e il lisciamento esponenziale con la manopola su venti centesimi producono le stesse stime: dal centesimo passo in poi la differenza non supera \(0{,}0000000002\), e il numero stampato accanto, \(0{,}8\) elevato a cento, è dello stesso ordine non per caso. Le due ricorsioni partono da punti diversi, e la distanza fra loro si riduce di un fattore \(0{,}8\) a ogni passo: è la memoria dell’inizio che si esaurisce, non l’arrotondamento del calcolatore. Sul valore vero, che qui si conosce perché è stato generato apposta, lo scarto quadratico medio della misura grezza è \(0{,}9752\) e quello del filtro \(0{,}4171\), contro un valore teorico a regime di \(0{,}4472\): meno della metà, senza guardare nemmeno un dato futuro.
Le ultime due righe sono i due modi di sbagliare le larghezze. Dichiarando la misura venticinque volte più precisa di quanto sia l’errore sale a \(0{,}6608\), perché il filtro insegue il rumore; dichiarandola venticinque volte meno precisa sale a \(0{,}6819\), perché smette di ascoltarla. A venticinque volte i due errori costano quasi uguale, e su un’altra serie l’ordine fra i due si può invertire; in tutti e due i casi si perde quasi metà del guadagno, e si resta comunque sotto lo \(0{,}9752\) della misura grezza. A sbagliare di mille i due versi si separano: il filtro sordo supera la misura grezza (\(1{,}1446\) contro \(0{,}9752\)), mentre l’altro resta appena sotto (\(0{,}9551\)). Il sordo è anche il più insidioso dei due, perché produce una curva liscia e convincente che si allontana dalla realtà con calma.
La stessa ricetta vale ben oltre il lisciamento esponenziale, ed è la ragione per cui sta in mezzo ai modelli classici. Scritto in forma di spazio di stato, anche un ARIMA ha uno stato nascosto e una misura rumorosa: il filtro passa una volta sui dati, calcola dalle innovazioni quanto quel modello è d’accordo con la serie osservata (la sua verosimiglianza), e da lì si cercano i coefficienti. È così che le librerie stimano un ARIMA. E la forma a spazio di stato, con il filtro o, per i modelli ETS, senza, è anche ciò che dà a questi modelli, oltre alla previsione puntuale, la forbice attorno a essa.
Quando i classici bastano (o battono il deep learning)#
Le competizioni M di Spyros Makridakis, quelle dell’apertura del capitolo, misurano da quarant’anni come se la cavano i metodi statistici semplici (ARIMA, Holt-Winters e le loro medie) contro metodi più complessi, e per molti anni li hanno visti vincere; nella M4 del 2018 vinse un ibrido, che di quei metodi conservava un pezzo. La quinta edizione, la M5 del 2020, ha spostato il quadro in un punto preciso. Le serie erano quarantaduemila, le vendite giornaliere dei negozi Walmart, organizzate a piramide: il singolo prodotto in un negozio, poi il reparto, il negozio, lo stato, e ogni livello è la somma di quelli sotto (per questo si dicono serie gerarchiche). E arrivavano con prezzi e calendario accanto. I primi classificati erano alberi potenziati, cioè gli ensemble di alberi decisionali della sezione sui metodi ensemble, ciascuno addestrato su tutte le serie insieme invece che su una per volta (un modello globale, come si dice), e distanziavano nettamente le linee di base statistiche [MSA22]. Quando le serie sono tante, collegate e ricche di informazioni esterne, un modello globale ha da cui imparare ciò che un modello per serie non vede.
Le ragioni per cui i classici restano così difficili da battere sono tre. La robustezza: un modello con pochi parametri ha poco spazio per rincorrere il rumore, e rincorrere il rumore è il modo migliore di sbagliare sul futuro, perché il rumore di domani non è quello di ieri. Quel poco che impara, allora, ha buone probabilità di valere anche sui giorni che non ha visto, e questo vale pure quando la serie è corta o disturbata. La frugalità di dati: gran parte delle serie reali (le vendite mensili di un prodotto, i pazienti di un reparto) hanno poche decine o centinaia di osservazioni, troppo poche per addestrare una rete affamata di dati, più che sufficienti per un ARIMA. E l’interpretabilità. La frazione con cui il passato pesa sul futuro, la componente stagionale, la forbice dentro cui il modello dichiara che cadrà il valore vero (il filo rosso dell’introduzione al capitolo): sono oggetti che un analista legge, discute e difende davanti a chi deve decidere. I parametri di una rete neurale sono milioni, e presi uno per uno non hanno un significato che si possa difendere. La regola pratica che ne discende attraversa tutto il forecasting serio: un modello classico è la linea di base onesta. Prima si batte quella, poi si passa al deep learning.
In pratica: stimare un AR(1) ai minimi quadrati#
Stimare un AR(1) non richiede librerie sofisticate: è una regressione lineare di \(x_t\) sul suo ritardo \(x_{t-1}\) ai minimi quadrati, la retta che passa più vicino a tutte le coppie (valore di ieri, valore di oggi) nel senso della sezione sull’apprendimento supervisionato. Generiamo una serie dal modello con una frazione \(\phi\) nota, verifichiamo di saperla recuperare e facciamo una previsione a un passo, tutto in NumPy.
import numpy as np

rng = np.random.default_rng(42)

# --- genera una serie dal modello AR(1): x_t = c + phi * x_{t-1} + rumore ---
phi_vero, c_vero, sigma = 0.6, 4.0, 1.0
n = 500
x = np.zeros(n)
x[0] = c_vero / (1 - phi_vero)                 # parte dalla media di lungo periodo (10)
for t in range(1, n):
    x[t] = c_vero + phi_vero * x[t - 1] + rng.normal(0, sigma)

# --- stima ai minimi quadrati: regredisci x_t su [1, x_{t-1}] ---
y = x[1:]                                       # bersaglio: x_t
Xmat = np.column_stack([np.ones(n - 1), x[:-1]])  # colonne: costante e x_{t-1}
beta, *_ = np.linalg.lstsq(Xmat, y, rcond=None)   # risolve i minimi quadrati
c_hat, phi_hat = beta

print(f"phi vero = {phi_vero:.2f}   phi stimato = {phi_hat:.3f}")
print(f"c vero   = {c_vero:.2f}   c stimato   = {c_hat:.3f}")

# --- previsione one-step dopo l'ultima osservazione ---
x_next = c_hat + phi_hat * x[-1]
print(f"ultima osservazione x_T = {x[-1]:.3f}")
print(f"previsione   x_(T+1)    = {x_next:.3f}")
phi vero = 0.60   phi stimato = 0.635
c vero   = 4.00   c stimato   = 3.636
ultima osservazione x_T = 7.363
previsione   x_(T+1)    = 8.315
Il \(\phi\) stimato cade a \(0{,}635\) e la costante a \(3{,}636\), uno un po’ alto e l’altra un po’ bassa, e i due scarti vanno insieme: frazione e quota fissa entrano tutte e due nella media di lungo periodo \(c/(1-\phi)\), ed è quella che con cinquecento osservazioni i minimi quadrati ricostruiscono bene: i numeri stimati danno \(3{,}636/(1-0{,}635) = 9{,}96\), contro il \(10\) vero. La previsione a un passo è semplicemente la formula del modello applicata all’ultimo valore osservato. Da qui si può ripetere il conto in avanti per prevedere più giorni (quanto lontano si guarda si chiama orizzonte). Si cade però in un guaio: dal secondo giorno in poi il conto non parte più da un valore osservato, parte da una previsione, cioè da un numero che può già essere sbagliato, e quello sbaglio si trascina fino in fondo. La sezione seguente lo riprende per esteso.
Una stima sola, però, dice che cosa è capitato questa volta, non come si comporta il metodo. Per saperlo si ripete la stessa stima ventimila volte, su ventimila serie generate dalla stessa regola, lunghe cinquecento punti e poi cinquanta, e si guarda dove cade in media \(\hat\phi\) e quanto si sparpaglia.
for n_oss in (500, 50):
    rng = np.random.default_rng(0)
    prove = 20_000
    s = np.empty((prove, n_oss))                   # una serie per riga
    s[:, 0] = c_vero / (1 - phi_vero)
    for t in range(1, n_oss):
        s[:, t] = c_vero + phi_vero * s[:, t - 1] + rng.normal(0, sigma, prove)
    ieri, oggi = s[:, :-1], s[:, 1:]           # la regressione di prima
    ieri_c = ieri - ieri.mean(1, keepdims=True)
    oggi_c = oggi - oggi.mean(1, keepdims=True)
    phi_hat = (ieri_c * oggi_c).sum(1) / (ieri_c ** 2).sum(1)
    scarto = phi_hat.mean() - phi_vero
    formula = -(1 + 3 * phi_vero) / n_oss
    print(f"{n_oss:3d} osservazioni: distorsione {scarto:+.4f}, "
          f"formula {formula:+.4f}, errore standard {phi_hat.std():.3f}")
500 osservazioni: distorsione -0.0052, formula -0.0056, errore standard 0.036
 50 osservazioni: distorsione -0.0580, formula -0.0560, errore standard 0.124
In media la stima cade sotto il valore vero, e ci cade tanto più quanto la serie è corta: di sei millesimi con cinquecento osservazioni, di sei centesimi con cinquanta. Accanto c’è la formula classica che lo prevede, \(-(1+3\phi)/n\), e l’errore standard, cioè di quanto la stima si sparpaglia attorno alla propria media.
Due cose, per non prendere il risultato per più di quel che è.
La prima riguarda il metodo. Tirare una retta in mezzo a punti che vengono da giorni diversi è delicato, perché quei punti non sono indipendenti fra loro: si tengono per mano. E il guaio che ne verrebbe è questo: la retta viene fuori sensata, ma il conto che dice quanto ci si può fidare di quella retta assume punti indipendenti, e allora dichiara una precisione che non c’è.
Qui il guaio non si presenta. In un AR(1) fatto come si deve, gli scarti fra il valore vero e quello che la retta prevede sono le scosse casuali del modello, e le scosse casuali fra loro per mano non si tengono. Si presenterebbe se in quegli scarti restasse ancora una regolarità, ed è per questo che guardarli è il passo che non si salta.
La seconda riguarda la stima che, ripetuta ventimila volte, cade in media sotto il valore vero. Il colpevole è il modo stesso di fare il conto, e la ragione principale è questa. Il livello attorno a cui la serie balla non lo conosce nessuno, e lo si stima con la media degli stessi giorni. Se per caso in quei giorni la serie è stata quasi sempre sopra il livello vero, la media stimata viene più alta del vero. Misurati da lì, i giorni alti sembrano meno alti di quanto fossero, e gli scarti escono più corti di quelli veri. Una somiglianza misurata su scarti accorciati esce più debole, e la retta viene un filo più piatta di quella vera.
C’è anche una ragione più piccola, che resterebbe pure se il livello lo si conoscesse: il valore di ieri, quello che facciamo da guida, porta già dentro la scossa di ieri, quindi guida ed errore non sono estranei come una regressione ordinaria pretende. Con cinquecento osservazioni le due insieme non si vedono; con cinquanta tolgono un decimo al valore vero. Molte serie reali sono corte, e chi legge quel numero deve saperlo.
Due precisazioni, perché il numero è giusto ma il metodo ha un limite che va detto proprio nel regime in cui vive gran parte delle serie reali.
La prima: l’avvertimento sul SARIMAX («una regressione lineare ordinaria su dati temporali dà coefficienti con errori standard sbagliati») qui non morde, perché in un AR(1) ben specificato l’errore è rumore bianco per costruzione, ed è quando l’errore ha struttura che gli errori standard ordinari diventano inaffidabili.
La seconda: regredire su un valore ritardato della stessa serie non è una regressione ordinaria fino in fondo, perché il regressore non è indipendente dall’errore passato, cioè viene meno l’esogeneità stretta. La stima resta consistente, ma in campione finito è distorta verso lo zero, di circa \((1+3\phi)/n\) quando la media va stimata insieme a \(\phi\). Di questi, circa \(2\phi/n\) vengono dalla dipendenza fra regressore ed errore, e resterebbero anche a media nota; il resto, \((1+\phi)/n\), viene dal dover stimare la media sugli stessi dati, e con \(\phi = 0{,}6\) è la parte più grossa. Con cinquecento osservazioni la formula dà sei millesimi, con cinquanta sei centesimi, cioè il 10% del valore vero, e la prova ripetuta misura \(-0{,}005\) e \(-0{,}058\).
La distorsione non supera l’errore standard, che a cinquanta osservazioni resta il doppio (\(0{,}12\)). Tuttavia l’errore standard, a forza di ripetere la misura, si media via, e la distorsione no, perché punta sempre dalla stessa parte: passando da cinquecento a cinquanta osservazioni cresce da meno di un sesto dell’errore standard a quasi la metà.
Con questo abbiamo la cassetta degli attrezzi classica: decomposizione per capire, ARIMA e Holt-Winters per prevedere, ACF e PACF per diagnosticare. La sezione successiva affronta la domanda che finora abbiamo aggirato, cioè come si valida un modello di serie temporale senza barare col futuro. E poi come si trasformano le serie in colonne di una tabella, per darle in pasto ai modelli tabellari già incontrati nel capitolo sul Machine Learning.
Da ricordare
Scomporre una serie vuol dire leggerla come la bolletta della luce: il canone di fondo (il trend), la stagione che torna ogni anno (la stagionalità) e l’imprevisto (il residuo). La stagione può aggiungere sempre la stessa cifra (caso additivo) oppure una percentuale, che cresce insieme al giro d’affari (caso moltiplicativo): in gelateria, «d’estate 35 mila euro in più» contro «d’estate il \(78\%\) in più». Il logaritmo porta il secondo caso nel primo.
Quasi tutti i modelli classici vogliono una serie stazionaria, che balli sempre allo stesso modo. Le strade per arrivarci sono due, e a sceglierle è che cosa resta di una scossa: se si riassorbe si toglie la retta, se entra nel livello e ci resta si guarda la variazione da un giorno all’altro. Sbagliare strada si paga: differenziare dove bastava togliere la retta fabbrica una regolarità che non c’era, e togliere la retta dove serviva differenziare lascia la serie storta com’era. I due esami che aiutano a scegliere, ADF e KPSS, partono da sospetti opposti e si leggono insieme.
Le memorie sono due: quella dei valori passati (l’autoregressione: domani somiglia a oggi, con un rientro verso la media) e quella delle sorprese passate (la media mobile: lo sciopero si fa sentire ancora domani). ARIMA le usa insieme su una serie raddrizzata, SARIMA rifà lo stesso gioco sul calendario [BJRL15]. La memoria delle sorprese dura quanto le si dice, e finita quella la previsione diventa una linea piatta, a meno di rimettergli sotto i dati veri man mano che arrivano; dove c’è anche la memoria dei valori, la previsione si spegne piano invece.
Gli ordini del modello si indovinano dai grafici ACF e PACF solo sui casi da manuale: si provano tutte le combinazioni e si sceglie con l’AIC, che pesa insieme quanto il modello spiega e quanti parametri ha speso, e sotto le due unità di differenza non preferisce nessuno. Poi si guarda quello che resta: se negli errori c’è ancora una regolarità, il modello se l’è lasciata sfuggire.
Le informazioni esterne entrano in un SARIMAX, purché se ne conosca il valore futuro; se più serie si influenzano a vicenda, in un VAR. La «causalità di Granger» dice che il passato di una serie aiuta a indovinarne un’altra, non che la faccia succedere: gelato e condizionatori si prevedono a vicenda, ma a farli salire è il caldo.
Il lisciamento esponenziale è una media in cui il passato sbiadisce a ritmo costante; con livello, tendenza e stagione si chiama Holt-Winters.
Il filtro di Kalman prevede, guarda la misura e corregge in proporzione a quanto si fida dell’una e dell’altra; su una grandezza che si sposta a caso diventa il lisciamento esponenziale, di cui spiega la manopola. Si sbaglia dichiarando lo strumento più o meno preciso di quanto sia, e ce se ne accorge dalle sorprese, che con margini onesti vengono grandi quanto promesso. Regge finché gli errori sbagliano tanto in eccesso quanto in difetto e le ipotesi plausibili non sono due lontane fra loro.
I classici sono robusti, si accontentano di poche osservazioni e si spiegano a chi deve decidere: nelle competizioni M restano una linea di base durissima da battere, anche se dove le serie sono tante, collegate e ricche di informazioni esterne la M5 l’hanno vinta modelli globali appresi. Prima si supera la linea di base, poi si passa al deep learning [HA21].
Da ricordare
La decomposizione separa una serie in trend, stagionalità e residuo, in forma additiva (\(x_t = T_t + S_t + R_t\), oscillazioni di ampiezza costante) o moltiplicativa (\(x_t = T_t \times S_t \times R_t\), ampiezza proporzionale al livello, linearizzabile col logaritmo, purché al ritorno si ricordi che esponenziare dà la mediana e non la media).
Quasi tutti i modelli classici richiedono la stazionarietà, e lo strumento dipende dal tipo di non stazionarietà: differenziare (\(\nabla x_t = x_t - x_{t-1}\)) contro un trend stocastico, detrendizzare contro un trend deterministico, e ciascuna guasta il caso che l’altra risolve: differenziare un trend deterministico sovradifferenzia, e lascia \(\rho_1 = -0{,}5\), varianza doppia e \(\theta\) inchiodato sul bordo dell’invertibilità; detrendizzare una radice unitaria la lascia dov’era, cioè non stazionaria. Si testa con ADF e KPSS, che hanno ipotesi nulle opposte. ACF e PACF diagnosticano gli ordini sui processi puri: la PACF si annulla dopo il ritardo \(p\) di un AR, l’ACF dopo il ritardo \(q\) di un MA, e «annullarsi» vuol dire cadere dentro \(\pm 1{,}96/\sqrt{n}\), che è una banda puntuale; su un ARMA non si annulla nessuna delle due, e gli ordini si scelgono con una griglia.
AR(\(p\)) spiega il valore con i \(p\) passati; MA(\(q\)) con i \(q\) errori passati; ARIMA(\(p,d,q\)) unisce i due sulla serie differenziata \(d\) volte, e SARIMA aggiunge i termini stagionali al ritardo \(m\) [BJRL15].
Un MA(\(q\)) non prevede oltre \(q\) passi: per \(h > q\) la somma \(\sum_{i=h}^{q}\theta_i\varepsilon_{T+h-i}\) è vuota e la previsione vale \(\mu\), cioè una retta piatta al livello medio. Il rimedio, chiedere al più \(q\) passi per volta rimettendo sotto le osservazioni vere, vale solo se i dati arrivano prima della previsione successiva; altrimenti quell’orizzonte resta scoperto. La regola è dell’MA puro: in un ARMA causale la parte autoregressiva fa convergere la previsione a \(\mu\) per via geometrica, senza linea piatta.
La procedura è in tre tempi: stazionarizzare (fissando \(d\)), scegliere \((p,q)\) minimizzando l’AIC \(= 2k - 2\ln\hat L\) su una griglia (sotto \(\Delta = 2\) nessuna preferenza, e una stima non convergita ha un AIC inaffidabile), verificare che i residui siano rumore bianco con il Q-Q plot e il test di Ljung-Box, calcolato con \(\ell - (p+q)\) gradi di libertà: ometterlo gonfia sempre il \(p\)-value. Attenzione al verso del test: qui si spera di non rifiutare (il contrario dell’ADF), e l’AIC è una quantità relativa e confrontabile solo a parità di dati, il che è la ragione per cui \(d\) e le trasformazioni non entrano nella griglia.
SARIMAX aggiunge variabili esogene (una regressione il cui errore ha a sua volta struttura temporale), al prezzo di doverne conoscere i valori futuri. VAR(\(p\)) modella \(N\) serie insieme, con \(pN^2\) parametri: se i ritardi incrociati non aiutano, il modello resta lecito (e con innovazioni correlate contemporaneamente aggiunge ancora qualcosa), ma quei parametri si pagano lo stesso. Che i ritardi incrociati servano lo dice il test di Granger, che è un test di esclusione su quei coefficienti, non di validità del modello, e che misura precedenza predittiva, non causalità.
Il lisciamento esponenziale pesa il passato con pesi che decadono esponenzialmente: SES (solo livello), Holt (livello + trend), Holt-Winters (livello + trend + stagionalità), e nella forma ETS anche il trend smorzato per gli orizzonti lunghi. Il SES è un ARIMA(0,1,1) con \(\theta = \alpha - 1\).
Il filtro di Kalman alterna predizione (\(V_{t|t-1} = V_{t-1} + \sigma_\ell^2\)) e correzione con guadagno \(K_t = V_{t|t-1}/(V_{t|t-1}+\sigma_x^2)\): è la media a posteriori esatta sotto linearità e gaussianità, e il migliore stimatore lineare non distorto senza. Sul modello a livello locale il guadagno converge e la ricorsione diventa il SES con \(\alpha = K_\infty\), in corrispondenza biunivoca con il rapporto \(\sigma_\ell^2/\sigma_x^2\). Cade sulla non linearità (filtro esteso o unscented), sulla posteriore multimodale (filtro a particelle, il cui costo cresce in fretta con la dimensione dello stato) e sul rapporto fra le due varianze mal stimato, che si diagnostica dalle innovazioni.
I modelli classici sono robusti, frugali di dati e interpretabili: nelle competizioni M restano una linea di base durissima da battere, anche se nella M5, su serie gerarchiche collegate e ricche di covariate, hanno vinto modelli globali appresi (alberi potenziati). Prima si supera la linea di base, poi si passa al deep learning [HA21].