


Modelli di Diffusione#
Versa una goccia d’inchiostro in un bicchiere d’acqua e guarda. Prima un filamento scuro, poi volute sempre più sottili, e in pochi minuti l’acqua è tutta di un azzurro pallido e uniforme. Succede da solo, ogni volta, senza che nessuno mescoli. Il contrario non lo ha mai visto nessuno: l’inchiostro che spontaneamente si ritira dalle volute e si riconcentra in goccia. La fisica ha un nome per questa asimmetria (è il secondo principio della termodinamica) e un verdetto onesto: disfare è facile; rifare non è vietato, è solo così improbabile che non basterebbe l’età dell’universo per vederlo accadere per caso.
Ed è esattamente qui che si nasconde il trucco. Nel 2015 Jascha Sohl-Dickstein e colleghi, tra Stanford e Berkeley, pubblicano un paper dal titolo che sembra uscito da un dipartimento di fisica: Deep Unsupervised Learning using Nonequilibrium Thermodynamics [SDWMG15]. L’ispirazione viene davvero dalla termodinamica di non equilibrio, e l’idea è di un’eleganza spudorata: se distruggere è facile e costruire da zero non lo sa fare nessuno, filmiamo la distruzione e insegniamo a una rete a proiettare il film al contrario. Prendi una fotografia e aggiungile del rumore, cioè numeri sorteggiati a caso che si sommano ai colori veri e li sporcano di puntini: un pizzico alla volta, finché non resta che pulviscolo. Questo è il verso facile, la goccia che si disperde. Poi addestra una rete a percorrere la pellicola all’indietro, un fotogramma per volta. Se impara bene, potrà partire da rumore puro, sorteggiato di nuovo e mai visto prima, e riavvolgerla fino a un’immagine che non è mai esistita. Non è la stessa foto che torna indietro: il sorteggio di partenza è diverso ogni volta, e da un pulviscolo diverso esce un’immagine diversa.
Due parole sul vocabolario. «Rumore» è il termine tecnico, ed è quello che compare nelle formule; raccontando la cosa a parole diremo anche disturbo, pulviscolo o sporco, ma è sempre lui, e sempre la stessa quantità. E già che ci siamo: si chiamano modelli di diffusione proprio per la goccia d’inchiostro, perché il verso facile è quello che la diffonde nell’acqua.
Il film proiettato al contrario#
Un modello di diffusione vive quindi di due processi, uno l’inverso dell’altro. L’andata non si impara: è una ricetta fissa che a ogni passo sbiadisce un pochino la fotografia e le getta sopra un pizzico di rumore casuale (due gesti, non uno, e nella prossima sezione si vedrà perché servono tutti e due). Il ritorno è l’unica cosa che si apprende, ed è una domanda sola: guardando un fotogramma sporco, quanto rumore c’è qui sopra?
Su quella domanda conviene essere precisi subito. Alla rete non si chiede il pizzico dell’ultimo passo, ma tutto il rumore che la ricetta ha steso dalla fotografia pulita fino al livello di rovina \(t\), quello che nelle formule si chiama \(\boldsymbol{\epsilon}\). Non è la differenza fra il fotogramma e l’originale, perché nel frattempo anche la fotografia è sbiadita: è la parte del fotogramma che dalla fotografia non viene. La risposta ha la forma dell’immagine, un valore per punto, ed è una mappa del rumore, non un’immagine. Come si passi da quella mappa a un’immagine è una faccenda a parte, meno intuitiva di quanto sembri, ed è il centro della sezione su come funziona la diffusione.
Prendi una fotografia e rovinala in mille passi: al passo 10 si nota appena una grana fine, al passo 500 le forme si indovinano a fatica, al passo 1.000 è rumore puro, come un televisore senza segnale. Questo è il verso facile: lo fa un dado, non serve intelligenza. Mille passi e non tre, perché ciascuno sia minuscolo: una foto ridotta a pulviscolo in un colpo solo non la rimette a posto nessuno, mentre fra due fotogrammi vicini c’è pochissima strada da rifare.
Ora la parte furba. Non chiediamo alla rete l’impossibile («da questo pulviscolo tira fuori una foto») ma una cosa umile: «ecco il fotogramma 500: dimmi quanto sporco c’è qui sopra, punto per punto». È il mestiere di un restauratore paziente, che non ridipinge il quadro ma sa dire dov’è lo sporco e quanto è spesso. Di fotogrammi così ne serve una montagna per allenarla, da ogni foto dell’archivio e da ogni livello di rovina, e nessuno li prepara rovinando la foto cinquecento volte di seguito: la dose di sporco che spetta al passo 500 si sa calcolare in anticipo e si stende in un gesto solo. La risposta esatta la conosciamo sempre: lo sporco l’abbiamo messo noi.
Per generare un’immagine nuova si parte dalla fine: si sorteggia del pulviscolo nuovo (dado alla mano, come per rovinare la foto, solo che qui sotto non c’è nessuna foto) e si ripete mille volte il giro di domanda e risposta, dal passo 1.000 al passo 1. A ogni passo emerge qualcosa (una massa scura, una sagoma, un gatto) e all’ultimo fotogramma c’è un’immagine che non esisteva da nessuna parte: la rete ha imparato che aspetto ha il mondo.
Verrebbe da immaginare che a ogni giro si sollevi un velo di sporco, e che dopo mille veli il quadro sia pulito. Non è così: a ogni giro se ne toglie pochissimo, e se ne getta sopra dell’altro, sorteggiato di nuovo. L’immagine emerge lo stesso, e una delle due ragioni è che quel poco che si toglie è mirato (ogni giro spinge il quadro un pochino più verso una figura sensata), quello che si getta è sorteggiato, e mille spintine tutte concordi si sommano mentre mille spintoni a casaccio si disfano fra loro. La seconda ragione richiede i numeri, e ce li prendiamo nella sezione su come funziona la diffusione.
Il processo diretto, l’andata, è una catena di Markov che corrompe il dato \(\mathbf{x}_0\) in \(T\) passi (in DDPM, \(T = 1000\)):
dove \(\mathbf{x}_t\) è il dato al passo \(t\), \(\beta_t\) una piccola varianza fissata da uno schedule crescente e \(\mathbf{I}\) l’identità: a ogni passo si attenua un po’ il segnale e si inietta rumore gaussiano. La catena ammette una scorciatoia in forma chiusa:
dove \(\bar{\alpha}_t = \prod_{s=1}^{t}(1-\beta_s)\), la cui radice \(\sqrt{\bar{\alpha}_t}\) è la frazione di segnale originale sopravvissuta al passo \(t\): si campiona \(\mathbf{x}_t\) direttamente da \(\mathbf{x}_0\), senza percorrere la catena; per \(t \to T\), \(\bar{\alpha}_t \to 0\) e \(\mathbf{x}_T\) è rumore puro.
Il risultato che rende tutto possibile viene dall’analisi dei processi di diffusione: se i passi \(\beta_t\) sono piccoli, anche il processo inverso \(q(\mathbf{x}_{t-1} \mid \mathbf{x}_t)\) è approssimativamente gaussiano. Non viene dal deep learning e lo precede di decenni: lo si deve a William Feller, che lo pubblica nel 1949 [Fel49]; Sohl-Dickstein e colleghi lo riprendono e ci costruiscono sopra il modello [SDWMG15]. Il risultato vale nel limite \(\beta_t \to 0\), e va letto per quello che dice: è gaussiana la forma dell’inverso, la stessa dell’andata, mentre la sua media e la sua covarianza dipendono dalla distribuzione dei dati, che non si conosce. È questa dipendenza che va appresa. Ha quindi senso modellare il processo inverso, il ritorno, con una gaussiana parametrizzata da una rete, \(p_\theta(\mathbf{x}_{t-1} \mid \mathbf{x}_t)\), con parametri appresi \(\theta\). Il contributo di DDPM [HJA20] è una parametrizzazione che riduce ogni cosa a una regressione: la rete \(\boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t)\) predice il rumore \(\boldsymbol{\epsilon}\) della scorciatoia in forma chiusa, cioè quello accumulato da \(\mathbf{x}_0\) a \(\mathbf{x}_t\) e non l’incremento del solo passo \(t\), con la loss
dove l’attesa è su un dato reale \(\mathbf{x}_0\), un rumore \(\boldsymbol{\epsilon}\) e un passo \(t\) estratti a caso: un errore quadratico medio. La derivazione completa, dal limite variazionale a questa forma, è il tema della prossima sezione.
Una parabola in tre atti#
Le idee, in questo mestiere, raramente vincono al primo colpo, e questa ci ha messo sette anni. Il paper del 2015 dimostra che il meccanismo funziona (Fig. 27.1 ne è lo schema), ma su immagini piccole e con una qualità che non impensierisce nessuno: sono gli anni in cui le GAN, nate l’anno prima, si prendono la scena, e la diffusione resta per cinque anni una curiosità da addetti ai lavori.

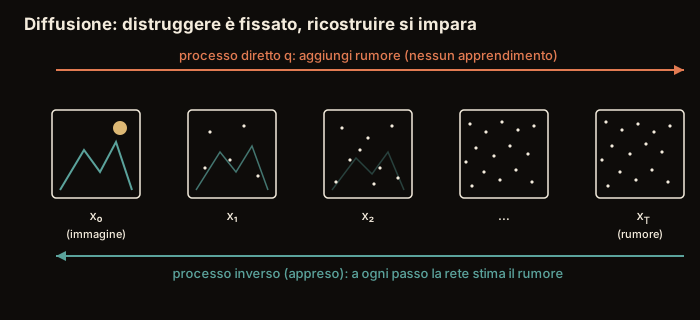
Fig. 27.1 L’idea di fondo, quella del 2015. I riquadri disegnati sono cinque, ma i tre puntini stanno per le centinaia che non ci stanno nel foglio: è il punto della figura, tanti passi piccoli invece di pochi grandi. Ogni passo chiede alla rete un compito facile, e la difficoltà si distribuisce sull’intera catena.#
La figura rende evidente anche il conto da pagare, un vincolo che tornerà di continuo. Se la generazione è una catena di centinaia di passi, ogni passo vuole la sua risposta dalla rete: per una immagine bisogna interrogarla centinaia di volte, non una. Da qui in avanti questa operazione (passare alla rete un fotogramma rumoroso con il suo livello di rovina, e leggerne la risposta) si chiama sempre allo stesso modo, una valutazione della rete (in inglese si contano le NFE, number of function evaluations), e se ne conterà il numero.
Il secondo atto è del 2020. Jonathan Ho, Ajay Jain e Pieter Abbeel, a Berkeley, ripuliscono la formulazione e la battezzano DDPM, Denoising Diffusion Probabilistic Models [HJA20]. L’addestramento si riduce a «indovina il rumore», e la rete che lo indovina è presa in prestito dalla visione artificiale: si chiama U-Net e la incontreremo per esteso nella prossima sezione. Per la prima volta le immagini prodotte reggono il confronto con le migliori GAN, e non a occhio: c’è un metro apposta, il FID (Fréchet Inception Distance, definito nel capitolo sulle GAN), che confronta il mucchio delle immagini generate con il mucchio di quelle vere e dice quanto i due si somigliano. Più è basso, meglio è.
Il terzo atto arriva un anno dopo, e il titolo dice tutto: Diffusion Models Beat GANs on Image Synthesis [DN21]. La diffusione supera le GAN migliori in due modi, nella qualità delle singole immagini e nella varietà di quelle che sa produrre: una GAN può affezionarsi a un pugno di soggetti e ripetere sempre quelli, ed è il difetto raccontato per esteso in GAN.
Poi c’è l’epilogo che non è più storia della ricerca ma storia e basta: il 2022. Nel giro di pochi mesi OpenAI presenta DALL·E 2 (aprile), Google risponde con Imagen (maggio, annunciato ma non accessibile al pubblico), Midjourney apre la beta a tutti (luglio) e soprattutto, in agosto, arriva Stable Diffusion: nato dai latent diffusion models (modelli che diffondono non l’immagine ma una sua versione compressa) del gruppo di Björn Ommer a Monaco di Baviera [RBL+22] e rilasciato con i pesi aperti: i pesi sono i milioni di numeri che una rete si ritrova dentro dopo l’addestramento, cioè tutto quello che ha imparato, e rilasciarli vuol dire mettere in rete un file che chiunque può scaricare e far girare a casa propria. Per la prima volta si può scrivere «un gatto nero che salta sul muro, in stile acquerello» e vedere l’immagine materializzarsi sul proprio computer, non nel data center di qualcun altro. La generazione di immagini smette di essere una demo e diventa un fenomeno pubblico, con il suo seguito di entusiasmo, cause legali sui dati di addestramento e domande aperte sul lavoro creativo.
Il falsario e il restauratore#

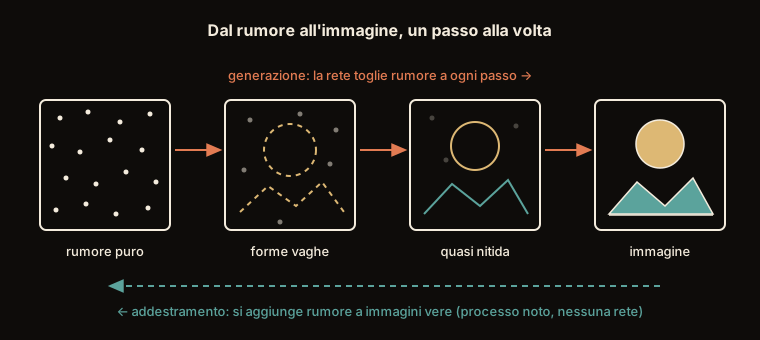
Fig. 27.2 Le due frecce del capitolo, lette questa volta nel verso della generazione: i riquadri vanno dal rumore al nitido, e in alto sta la freccia che toglie il rumore, l’unica cosa che una rete deve imparare. Quella in basso, che il rumore lo aggiunge, è una ricetta fissa e si può calcolare.#
L’asimmetria di Fig. 27.2 è la ragione per cui il metodo funziona. Poiché l’andata è nota, da ogni singola fotografia si possono fabbricare gratis quanti esempi di allenamento si vuole: si sceglie un livello di rovina fra i mille, si sorteggia il rumore, lo si stende sopra, e si ha una domanda («quanto rumore c’è qui sopra?») di cui si conosce già la risposta. Il sorteggio è diverso ogni volta, quindi la stessa fotografia allo stesso livello non dà mai due volte lo stesso esercizio, e gli esercizi non finiscono mai. Il ritorno diventa così un problema come quelli del capitolo sul machine learning: domande di cui si conosce già la risposta giusta, tante quante ne servono.
Il capitolo sulle GAN si è chiuso, nella sezione sulle loro evoluzioni, con il passaggio di testimone del 2021 raccontato dal lato di chi lo cede: i due guasti del duello. Dal lato di chi lo riceve, lo stesso passaggio ha un meccanismo preciso, e anche un conto da pagare.
La GAN è un duello: un falsario e un esperto d’arte che si allenano ostacolandosi a vicenda. Quando funziona è spettacolare, ma tenere in equilibrio due avversari è un mestiere da domatori: se uno dei due prende il sopravvento l’allenamento si incarta, e il falsario può scoprire un solo quadro che inganna sempre l’esperto e mettersi a rifare quello per sempre (il mode collapse del capitolo scorso, la fine della varietà).
Il modello di diffusione, invece, è un artigiano solitario con un compito umile: guarda il quadro sporco e dimmi dov’è lo sporco, mille volte. Niente avversario, niente equilibri delicati: imparare è come studiare da un libro di esercizi con le soluzioni in fondo, perché la risposta giusta la conosciamo sempre. E siccome deve saper rispondere su ogni foto dell’archivio, non può rifugiarsi in un unico quadro vincente: la varietà viene di serie, e quando si perde è per altre strade, come la manopola che decide quanto il disegno debba obbedire a una richiesta scritta.
Il conto da pagare è la lentezza. Il falsario, una volta allenato, dipinge in una pennellata sola: una domanda alla rete, un’immagine. Il restauratore deve ripetere il suo giro di domanda e risposta centinaia o migliaia di volte per una sola immagine: la stabilità si paga in tempo d’attesa, e accorciare quel tempo è diventato un filone di ricerca a sé.
Il confronto si gioca su tre assi.
Stabilità. L’addestramento GAN cerca l’equilibrio di un gioco minimax \(\min_G \max_D V(D,G)\): una dinamica a due giocatori che può oscillare, divergere o collassare, come visto nel capitolo precedente. La diffusione minimizza una singola loss di regressione, \(\mathcal{L} = \mathbb{E}\lVert\boldsymbol{\epsilon} - \boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t)\rVert^2\): un obiettivo stazionario che si minimizza con la discesa del gradiente come qualunque problema supervisionato, senza equilibri da inseguire.
Diversità. Il minimo della loss quadratica è la media condizionata \(\mathbb{E}[\boldsymbol{\epsilon} \mid \mathbf{x}_t]\) (la dimostrazione sta nella sezione sulla loss), che è definita per ogni esempio del dataset a ogni livello di rumore: il bersaglio dell’addestramento è l’intera distribuzione, modi compresi. Il mode collapse nasce dalla struttura del gioco avversario, dove il generatore è premiato se inganna \(D\) e può riuscirci anche con un solo modo. Nella regressione sul rumore non c’è un avversario da ingannare, e un modo trascurato resta un errore che la loss fa pagare in proporzione alla sua massa. L’argomento vale per il minimo: una rete finita lo approssima, e la varietà si può perdere per altre vie, la guida forte della sezione sulla guida e la memorizzazione di singoli esempi di addestramento [CHN+23]. Dhariwal e Nichol [DN21] misurano, oltre alla qualità, anche la copertura della distribuzione dei dati, con il richiamo. (Attenzione a non appoggiare questo argomento al limite variazionale: la loss che si usa davvero non è un bound, come mostra la sezione su come funziona la diffusione. Regge da sé.)
Costo di campionamento. Una GAN genera con una valutazione della rete; un DDPM ne richiede \(T\) (mille, in origine), perché il campionamento percorre l’intera catena inversa. È il rovescio della medaglia, e ha aperto un filone di ricerca sui campionatori accelerati (a partire da DDIM, che riduce i passi a poche decine) che incontreremo più avanti nel capitolo.
Nessun vincitore assoluto, dunque, e conviene dirlo con i meccanismi invece che con una classifica, perché i meccanismi non invecchiano: una GAN genera con una sola valutazione della rete, un DDPM con molte, e la diffusione paga in tempo ciò che guadagna in stabilità dell’addestramento e in copertura della varietà. Da lì in poi, buona parte del lavoro sulla diffusione è servito ad accorciare quel conto, e nel farlo ha spesso rimesso in gioco un discriminatore, che è il nome tecnico dell’esperto d’arte del capitolo precedente: il duello è rientrato come attrezzo di servizio dentro una macchina che di suo non ne ha bisogno, invece di sparire. L’impianto dei generatori di immagini arrivati al pubblico dal 2022 in poi, però, è questo e non quello, ed è la ragione per cui da qui in avanti lo smonteremo pezzo per pezzo.
Dal rumore all’immagine#
Tre tappe portanti. Prima come funziona davvero: i due processi di DDPM [HJA20] visti da vicino, come si dà un voto alla rete quando sbaglia la sua risposta, che rete sia (una vecchia conoscenza della visione artificiale) e tutto il meccanismo in miniatura, funzionante, in poche righe di Python. Poi il salto di scala: come si può far lavorare la rete non sulla fotografia ma su una sua versione compressa decine di volte, che è il segreto per cui Stable Diffusion [RBL+22] gira su un computer di casa, e come si fa a ordinargli che cosa disegnare scrivendolo a parole. Infine l’incontro con i Transformer [VSP+17], quelli del capitolo che porta il loro nome: si può buttare via la rete di visione e mettere al suo posto uno di loro [PX23]? La risposta è sì, e ha cambiato il modo in cui questi modelli si costruiscono. Ha aperto anche una porta che non ci aspettavamo: la stessa ricetta, applicata a blocchi di fotogrammi invece che a fotografie singole, genera video, ed è da lì che arrivano i filmati generati a partire da una frase.
Attorno a queste tre stanno le pagine che le reggono e ne tirano le conseguenze. Prima del salto di scala vengono il limite continuo, che dei mille passi fa una sola equazione differenziale (una regola che dice come l’immagine cambia istante per istante), e il flow matching, che il percorso lo sceglie invece di ereditarlo dal modo in cui si è deciso di rovinare le immagini. Dopo i Transformer vengono i campionatori (le procedure che percorrono il ritorno) che portano i passi a qualche decina, i generatori che li portano a uno, la guida con cui si decide quanto il risultato debba obbedire alla richiesta, e infine la stessa ricetta applicata a uno stato fatto di simboli invece che di numeri, cioè al testo.
Da ricordare
Un modello di diffusione impara a proiettare al contrario il film di una rovina: l’andata (aggiungere un pizzico di disturbo mille volte, finché non resta che pulviscolo) è una ricetta fissa che sa eseguire un dado; il ritorno è l’unica cosa che si apprende, e quello che si impara è una domanda sola, «quanto disturbo c’è qui sopra?», dove il disturbo da misurare è tutto quello accumulato dalla foto pulita in poi, non il pizzico dell’ultimo passo. L’idea viene da un’osservazione di fisica: disfare è facile, rifare per caso è così improbabile da non accadere mai.
DDPM rende l’addestramento facile perché non chiede il capolavoro ma una cosa umile: «dimmi quanto disturbo ho steso su questa foto». La risposta esatta la conosciamo sempre, visto che il disturbo l’abbiamo messo noi: è come studiare su un libro di esercizi con le soluzioni in fondo.
Nel 2021 un lavoro di riferimento misura che la diffusione batte le GAN migliori in qualità e in varietà dei risultati; nel 2022, con DALL·E 2, Imagen, Midjourney e soprattutto Stable Diffusion, scaricabile da chiunque, diventa un fenomeno di massa.
Rispetto alle GAN: niente duello fra falsario ed esperto, quindi niente allenamenti che si incartano; e la varietà, se si perde, si perde per una guida troppo forte (la manopola che decide quanto il disegno obbedisca alla richiesta), non per un rifugio in un unico quadro vincente. Il conto si paga in attesa: il falsario dipinge in una pennellata sola, il restauratore ripete il suo giro centinaia di volte. È un baratto e non una classifica: tempo in cambio di stabilità e varietà.
Da ricordare
Un modello di diffusione impara a invertire una degradazione: l’andata (aggiungere rumore in tanti piccoli passi) è fissa e banale, il ritorno è l’unica cosa che si apprende, ed è la stima del rumore presente, non la sua rimozione. L’idea nasce dalla termodinamica di non equilibrio [SDWMG15]; il risultato che la sostiene (per passi piccoli l’inverso è approssimativamente gaussiano) è di Feller [Fel49].
DDPM [HJA20] riduce l’addestramento a una regressione, predire il rumore iniettato, loss \(\mathbb{E}\lVert\boldsymbol{\epsilon} - \boldsymbol{\epsilon}_\theta(\mathbf{x}_t,t)\rVert^2\), stabile come un problema supervisionato.
Nel 2021 la diffusione supera le GAN in qualità e copertura dei modi [DN21]; nel 2022, con DALL·E 2, Imagen, Midjourney e Stable Diffusion, rilasciato con i pesi aperti [RBL+22], diventa un fenomeno pubblico.
Rispetto alle GAN: niente duello, niente mode collapse da gioco avversario (la varietà si perde, se si perde, per la guida forte o per la memorizzazione), addestramento stabile, ma il campionamento costa molti passi di rete invece di uno.