


Dove la fisica aiuta e dove no#
Un neurochirurgo studia un aneurisma: una sacca gonfiata sulla parete di un’arteria del cervello, che se cede uccide. La domanda che conta è quanto preme il sangue contro quella parete, perché la pressione è fra le cose che decidono se e quando si romperà. Ma la pressione dentro un vaso non si misura senza infilarci un tubicino, il catetere: un gesto invasivo, rischioso, che sull’arteria malata raramente è proponibile.
Quello che si riesce ad avere, invece, è un filmato. Nel sangue si inietta una sostanza che le macchine sanno vedere (si chiama tracciante), poi la si segue con la risonanza magnetica, che di immagini ne fa una dopo l’altra: il risultato è un film in cui si vede, punto per punto e istante per istante, quanto tracciante c’è. Solo quello: dove sta la macchia. Non quanto va veloce il sangue, non quanto preme. È la domanda della molla nella scatola chiusa, portata dentro un’arteria: misurare quello che si può, e ricavare il resto dalla legge.
Nel 2020 Maziar Raissi, Alireza Yazdani e George Karniadakis pubblicano su Science un metodo, Hidden Fluid Mechanics, che ricostruisce velocità e pressione a partire dalle sole immagini del tracciante [RYK20]. Alla rete si danno le immagini (nell’articolo sono simulate al calcolatore, e portano solo il tracciante: nessun sensore di pressione da nessuna parte) e le si impone di rispettare tre leggi: l’equazione che dice come il tracciante viene trasportato e si sparge, le equazioni di Navier–Stokes, che descrivono il moto di un fluido, e l’incomprimibilità. La rete, per essere coerente con quelle leggi e con il filmato, è costretta a ricostruire i campi che nel filmato non ci sono: velocità e, soprattutto, pressione. (Un campo, qui, è semplicemente una grandezza che ha un valore in ogni punto dello spazio e in ogni istante: la velocità del sangue in quel punto, la pressione in quel punto.)
Il risultato sembra un gioco di prestigio, e smette di sembrarlo appena si guarda che cosa dicono quelle leggi. Sono una catena di due anelli.
Il primo anello lega il filmato alla velocità. Il tracciante non si muove da solo: se ne sta lì e va dove lo porta il sangue, come una macchia di colore in un fiume. Quindi il modo in cui la macchia si allunga e si sposta dice molto della corrente che l’ha spostata così. Non tutto, però: dove il colore è uniforme, una corrente vale l’altra, perché spostare acqua colorata in acqua dello stesso colore non lascia traccia. La velocità non si vede nel filmato, ma dove la macchia ha dei bordi il filmato la restringe moltissimo.
Il secondo anello lega la velocità alla pressione, e la cosa che dice è quella che tutti conosciamo senza chiamarla così: un fluido viene spinto verso i punti dove la pressione è più bassa. Lascia andare l’imboccatura di un palloncino gonfio e l’aria schizza fuori, perché dentro la pressione è alta e fuori è più bassa; e più è ripido quel dislivello, più forte è la spinta. Adesso la stessa frase si legge all’incontrario. Sapere la velocità in ogni punto e in ogni istante vuol dire sapere anche come sta cambiando, cioè quanto il sangue accelera: è la mossa della molla, dove dalla curva ricavavamo pendenza e curvatura. Ma se il sangue accelera, qualcosa lo sta spingendo. E a spingerlo è il dislivello di pressione. Quindi, saputa l’accelerazione, il dislivello non è più libero: la legge lo ha già deciso.
Resta fuori una cosa sola. Il sangue, come l’acqua, è incomprimibile: per quanto lo schiacci, il suo volume non cambia. In un fluido così la pressione non compare mai da sola nelle leggi, compare sempre come dislivello fra un punto e il vicino. Il che vuol dire che si ricava di quanto la pressione cambia da un punto all’altro, non a che livello stia: la ricostruzione può dire «qui la pressione è più alta di cinque millimetri di mercurio che là» senza saper dire se qui vale 105 o 205. Per fissare il livello servirebbe una misura vera, presa da qualche parte, ed è proprio quella che dentro l’arteria malata non si può prendere.
La rete restituisce in ogni punto \((\mathbf{x}, t)\) la concentrazione \(c\), la velocità \(\mathbf{u}\) e la pressione \(p\). Si osserva solo \(c\), e la loss somma lo scarto sulle osservazioni e i residui delle tre equazioni, scritte in forma adimensionale come nell’articolo, con il numero di Péclet \(\mathrm{Pe}\) e il numero di Reynolds \(\mathrm{Re}\) noti:
La prima lega il tracciante alla velocità, la seconda la velocità alla pressione, la terza è l’incomprimibilità. Il tracciante vincola \(\mathbf{u}\) solo attraverso \(\mathbf{u}\cdot\nabla c\), quindi nulla dice della velocità dove \(\nabla c = \mathbf{0}\) o lungo le isolinee di \(c\): gli autori avvertono che senza condizioni al contorno l’unicità del campo di velocità non è garantita, e scelgono domini di addestramento in cui il gradiente di concentrazione normale al bordo è sufficiente. La pressione compare solo come \(\nabla p\), e in un fluido incomprimibile fa da moltiplicatore di Lagrange del vincolo \(\nabla\cdot\mathbf{u} = 0\): due pressioni che differiscono per una costante danno la stessa loss, e la ricostruzione la identifica a meno di una costante additiva.
Restano i dislivelli di pressione, ed è comunque moltissimo: da lì, e dal modo in cui il sangue scorre rasente alla parete, si capisce dove la parete è sollecitata di più. Su una simulazione di aneurisma intracranico il metodo ricostruisce la pressione senza che nessuna misura di pressione gli sia mai stata data. Che il flusso dell’esperimento fosse simulato al calcolatore è insieme la condizione della prova e la sua debolezza, e gli autori la mettono fra i propri limiti: solo con dati fabbricati la risposta vera si conosce e si può controllare se la ricostruzione sia corretta, ma quei dati sono più puliti di qualunque risonanza.
Leggere il non misurabile a partire dal misurabile è la vera ragione per studiare le PINN, molto più che rifare quello che i solutori classici fanno già benissimo (il conto a passettini dell’apertura del capitolo, quello che avanza su una fitta rete di puntini).
Il problema inverso#
Diretto e inverso li abbiamo già incontrati: il caffè ricostruito da una legge nota, e la rigidezza della molla ricavata da venticinque misure. Resta da vedere perché l’inverso, che sembra la stessa strada fatta al contrario, sia tanto più difficile, e perché il risultato sull’aneurisma sia speciale.
Dalla ricetta alla torta si va senza sorprese: chi conosce dosi, forno e minuti sa dire prima di aprire lo sportello quanto sarà gonfia e quanto dorata. All’indietro no. Chi assaggia una torta e prova a indovinare le dosi ha in mano una fetta sola, magari con il bordo un po’ bruciato, e tante ricette diverse danno torte che al palato si somigliano: la risposta può non essere una sola. E basta sbagliare di poco l’assaggio perché la dose che se ne ricava sbagli di molto: un pizzico di sale che non avevi sentito, e ti convinci che il lievito fosse il doppio.
Eppure è quasi sempre la domanda che interessa davvero, come la pressione sulla parete dal filmato del tracciante. La PINN affronta l’inverso con naturalezza: la dose ignota diventa un numero in più che l’addestramento regola insieme ai pesi, finché fisica e osservazioni non vanno d’accordo.
Indovinare le dosi da un assaggio, del resto, non l’ha inventato la rete. Al calcolatore lo si fa da decenni con altri metodi, spesso spendendo meno. Della PINN conta che il modo di procedere resta lo stesso, qualunque assaggio capiti in mano.
Nel problema diretto l’equazione e i suoi dati al contorno sono noti e si cerca la soluzione \(u\): è tipicamente ben posto nel senso di Hadamard (esistenza, unicità, dipendenza continua dai dati). Nel problema inverso parte della soluzione è osservata (spesso su pochi punti e con rumore) e l’incognita è un ingrediente dell’equazione stessa: un coefficiente, un termine sorgente, una condizione al contorno. Questi problemi sono notoriamente mal posti: l’unicità può cadere, e piccole perturbazioni dei dati ne producono di enormi sulla stima.
La PINN non cambia impianto tra i due casi. Nel diretto minimizza \(\mathcal{L}(\theta)\) sui soli parametri di rete \(\theta\); nell’inverso promuove il parametro fisico ignoto (chiamiamolo \(\alpha\)) a variabile addestrabile e minimizza congiuntamente
dove il residuo fisico dentro \(\mathcal{L}\) dipende ora anche da \(\alpha\), il cui gradiente arriva dalla stessa passata di backpropagation che aggiorna i pesi: soluzione e parametro si stimano nello stesso ciclo di discesa.
Una scorciatoia retorica diffusa consiste nel dipingere i metodi classici mentre provano un valore, risolvono tutto, confrontano e riprovano. Non è così che si fa, e non lo è da quarant’anni: il metodo dello stato aggiunto ottiene il gradiente della funzione di scarto rispetto a tutti i parametri incogniti al costo di una o due risoluzioni del problema diretto, indipendentemente da quanti siano quei parametri, e poi scende con un quasi-Newton [Ple06]. Anche lì c’è un solo problema di ottimizzazione, non un anello annidato. La differenza vera è che lo stato aggiunto richiede di derivare e scrivere, per quella specifica equazione, sia il solutore diretto sia quello aggiunto, mentre la PINN monta un unico problema non vincolato in \((\theta, \alpha)\) e assorbe misure sparse, rumorose e di natura eterogenea senza cambiare impianto. È un vantaggio di uniformità e di costo di implementazione, non di complessità algoritmica.
E non è nemmeno un vantaggio della rete. La stessa formulazione (residuo discreto più dati, minimizzati insieme al parametro incognito) si può montare su un campo discretizzato su griglia anziché su una rete neurale, ed è quello che fanno Karnakov, Litvinov e Koumoutsakos con ODIL, riportando su problemi di riferimento un costo computazionale da due a cinque ordini di grandezza inferiore a quello delle PINN: due o tre nell’inferenza di una conducibilità, che è il caso inverso, cinque su un problema a valori iniziali risolto con Newton, e su una CPU sola [KLK24]. Il problema inverso resta il terreno migliore per le PINN, ma «migliore per le PINN» non vuol dire «senza rivali».
In codice si fa come nella legge dentro la loss, e non importa quale sia il numero della fisica che manca. Là era la rigidezza di una molla, qui prendiamo la diffusività di un materiale, cioè quanto in fretta il calore ci si propaga dentro: in tutti e due i casi quel numero diventa un parametro come i pesi e finisce nella lista di quelli che l’addestramento aggiorna.
# Il parametro fisico ignoto (qui la diffusivita', cioe' quanto in fretta
# il calore si propaga nel materiale) diventa un parametro addestrabile,
# indistinguibile da un peso qualsiasi della rete. `rete` e' la candidata
# soluzione della PINN della molla.
alpha = torch.nn.Parameter(torch.tensor(0.5))          # valore iniziale di comodo
ottimizzatore = torch.optim.Adam(                      # ottimizzato insieme ai pesi
    list(rete.parameters()) + [alpha], lr=1e-3
)

# Stare nella lista non basta: alpha si muove solo se compare nel conto da
# cui il gradiente parte, cioe' dentro il residuo.
residuo = u_t - alpha * u_xx
Cosa sanno fare, per davvero#
Al di là dell’aneurisma, il filone ha prodotto applicazioni concrete. I casi in cui le PINN portano un vantaggio reale vanno tenuti separati da quelli dove sono ancora una promessa da verificare.
Fluidodinamica ed emodinamica, cioè il moto dei fluidi in generale e del sangue in particolare. È il territorio d’elezione, quello di Hidden Fluid Mechanics: ricostruire velocità e pressione punto per punto a partire da immagini di un tracciante, con Navier–Stokes imposta come penalità [RYK20]; nel lavoro fondativo, però, le immagini sono simulate e pulite, e la prova su misure cliniche rumorose resta da fare. Il valore non è la velocità di calcolo (un solutore maturo è più rapido) ma la capacità di tenere conto di misure reali tutte insieme, che in gergo si dice assimilarle, e di ricavare da lì ciò che quelle misure non contengono.
Identificazione di parametri nei materiali. Da poche misure di deformazione o di temperatura, stimare grandezze nascoste trattandole come incognite dell’equazione: quanto un materiale si piega sotto carico (il modulo elastico), quanto si lascia attraversare dal calore (la conducibilità), quanto si lascia attraversare da un fluido (la permeabilità). Funziona quando il modello fisico è quello giusto; se l’equazione imposta è quella sbagliata, la stima esce sbagliata ma con l’aria di essere giusta, coerente con tutto il resto, e non c’è niente che lo segnali.
Geofisica e sismica. Risalire alla struttura del sottosuolo dai sismogrammi (i tracciati registrati in superficie dai rilevatori di vibrazioni) è un inverso da manuale, e ci si è provato anche con le PINN. Resta un campo di ricerca attivo più che una tecnologia consolidata: quello stesso problema ha già i suoi metodi classici, che in inglese si chiamano full-waveform inversion (simulano le onde in un modello del sottosuolo e lo correggono finché i sismogrammi calcolati coincidono con quelli registrati), e sono maturi e difficili da battere.
Clima e meteo. I grandi modelli meteorologici neurali che negli ultimi anni hanno fatto notizia non sono PINN. GraphCast, una rete a grafo, prevede dieci giorni su tutto il pianeta in meno di un minuto [LSGW+23], e FourCastNet una settimana in meno di due secondi [PSH+22], ma nella loss di nessuno dei due c’è un’equazione: hanno imparato a prevedere guardando decenni di mappe del tempo passato. (Esistono anche modelli ibridi, che affiancano un risolutore della dinamica dell’atmosfera a componenti apprese [KYL+24].) Quelle mappe non sono l’archivio grezzo delle misure, che è pieno di buchi e cambia strumento ogni pochi anni: sono il risultato di un lavoro lungo, in cui tutte le osservazioni disponibili vengono rimesse insieme dai centri meteorologici e rese omogenee, così che ogni punto del pianeta e ogni ora abbiano il loro valore. Si chiamano dati di rianalisi. Da lì i modelli imparano la dinamica dall’osservazione, non dalla fisica imposta. Ci torneremo fra qualche pagina, in fondo a questa stessa sezione, perché sono la porta verso l’idea più interessante di tutte.
I limiti, detti con franchezza#
Sarebbe disonesto fermarsi qui. Le PINN hanno modi di fallire ben documentati, e conoscerli è parte del mestiere. Il lavoro di riferimento è di Aditi Krishnapriyan e colleghi, e mostra una cosa scomoda: una PINN può fallire anche su equazioni semplici [KGZ+21]. Non perché la rete sia troppo povera per disegnare quella curva, che la saprebbe disegnare benissimo. Il guasto è più subdolo: la curva giusta esiste ed è a portata della rete, ma la strada per arrivarci, quella che l’addestramento percorre abbassando il punteggio un passo alla volta, diventa quasi impraticabile.
Il primo motivo è lo squilibrio fra i termini della loss, che spingono la rete in direzioni diverse.
Nella loss della PINN i termini sono almeno due, e su un’equazione che vive nello spazio e nel tempo sono tre o quattro: la fisica, il punto di partenza, i bordi, e le misure quando ci sono. È un tiro alla fune: da una parte della corda tira la fisica, dall’altra tutto quello che si sa già. E c’è una manopola per ogni termine, che decide quanto è forte quella squadra: è quel 100 che sulla molla moltiplicava il termine della partenza.
Se la giri troppo da una parte, la fisica vince e la rete produce una curva liscia che però ignora le misure; se la giri troppo dall’altra, la rete si incolla alle misure sporche e se ne infischia della legge. La soluzione buona sta dove le due forze si bilanciano, e trovare quel punto è un’arte: nessuna formula dà il valore giusto, e si procede provando, oppure lasciando che sia l’addestramento a ristimarlo guardando quanto strattona ciascuna squadra, o quanto in fretta ciascuna avanza. Sulla molla l’abbiamo fatto, e su dieci ripartenze la manopola su 1 e quella su 100 hanno sbagliato strada lo stesso numero di volte, cinque; il solo modo di saperlo era che lì la risposta la conoscevamo.
Quella manopola, però, non la si può affidare all’addestramento come la rigidezza della molla nel problema inverso. L’addestramento sposta ogni suo numero nel verso che abbassa il punteggio, e per la manopola il verso più rapido è girarla a zero: zittire una delle due squadre fa scendere il totale subito, senza risolvere niente. Chi prende il voto, insomma, non può decidere come si dà il voto. Si può invece affidarla a un arbitro che lavora contro la rete: a ogni giro alza il peso dei punti dove la rete sbaglia di più, mentre la rete cerca di sbagliare di meno. Uno spinge il punteggio in su, l’altra in giù, e si fermano dove nessun punto resta trascurato.
Nelle formule scritte da altri quella manopola porta per nome la lettera greca «lambda», e la si trova davanti all’una o all’altra squadra: a contare è il rapporto fra le due forze.
Poi c’è un guaio che nessuna posizione della manopola sistema. La squadra della fisica non guarda dove passa la curva, ma quanto si piega; e una curva si piega tanto più quanto più in fretta cambia direzione, non quanto è alta: un’increspatura minuscola, se è stretta, piega moltissimo. Basta quindi un ritocco invisibile perché quella squadra strattoni con tutt’altra forza, e con un avversario così non c’è passo che vada bene: si avanza al rallentatore, o non si avanza affatto. Un rimedio che funziona è cominciare da una versione mite della legge e indurirla poco alla volta: per una sostanza trascinata da una corrente, si parte da una corrente lenta, che la rete impara senza fatica, e si alza la velocità a piccoli passi mentre la curva si sistema.
La loss composita \(\mathcal{L}(\theta) = \mathcal{L}_{\text{fisica}} + \sum_i \lambda_i\,\mathcal{L}_i\), con \(i\) che scorre sui termini di dati (misure, condizioni iniziali, condizioni al contorno), è un’ottimizzazione multi-obiettivo camuffata da obiettivo singolo. I gradienti dei termini possono puntare in direzioni discordi: minimizzarne uno peggiora l’altro, e i coefficienti \(\lambda_i\) ne stabiliscono il compromesso. Dove stia il coefficiente è convenzione (nella loss dell’apertura del capitolo moltiplicava la fisica, sulla molla le sole condizioni iniziali), e a contare è il rapporto fra i termini. Una formula chiusa per i \(\lambda_i\) non c’è: o li si cerca provando, o li si fa ristimare durante l’addestramento dalle statistiche dei gradienti, che è la proposta di Wang, Teng e Perdikaris [WTP21]. A ogni passo calcolano, per ciascun termine di dati \(\mathcal{L}_i\),
dove il massimo e la media (la barra) sono presi sulle componenti del gradiente rispetto ai pesi e \(\rho = 0{,}9\) (nel lavoro originale è \(\alpha\), che in questa pagina è il parametro fisico ignoto): i termini di dati, che sono quelli da rialzare, vengono portati alla scala del termine di fisica. Costa una backward in più per termine. Un’altra strada, dello stesso gruppo, dà a ogni termine, fisica compresa, un peso inversamente proporzionale alla traccia del suo blocco del nucleo tangente neurale, \(\lambda_i = \mathrm{Tr}(\mathbf{K}) / \mathrm{Tr}(\mathbf{K}_{ii})\) [WYP22]. Qui \(\mathbf{K}\) ha elementi \(K_{ab} = \langle \nabla_\theta f_a, \nabla_\theta f_b \rangle\), dove le \(f_a\) sono gli scarti nei singoli punti di tutti i termini (di bordo e interni), e \(\mathbf{K}_{ii}\) è il blocco dei punti del termine \(i\). Nel regime di rete larga gli scarti evolvono sotto il flusso del gradiente come \(\dot{\mathbf{f}} = -\mathbf{K}\,\mathbf{f}\), e la media degli autovalori del blocco, \(\mathrm{Tr}(\mathbf{K}_{ii})/n_i\), è la velocità media con cui converge il termine \(i\): il peso riequilibra queste velocità. Un’altra ancora dà un peso a ogni singolo punto e lo fa girare all’addestramento, ma in salita, come un problema di punto di sella in cui la rete minimizza e i pesi massimizzano, così che i punti dove il residuo resta alto contino sempre di più (le self-adaptive PINN [MBN23]). Peggio: il termine fisico contiene operatori differenziali di ordine alto (derivate seconde, a volte quarte) che rendono il problema mal condizionato, nel senso preciso dei richiami di analisi numerica, e la discesa rallenta o si blocca. De Ryck e colleghi individuano la radice del guasto non nell’ottimizzatore ma in un operatore preciso, che mette insieme il quadrato hermitiano dell’operatore della PDE e il nucleo tangente del modello: se quello è mal condizionato l’addestramento è lento o impraticabile [DRBMdBezenac24]. Nel regime in cui la rete si comporta come un modello lineare quell’operatore ha lo stesso numero di condizionamento dell’Hessiano della loss, ed è da questa lettura che gli autori ricavano il precondizionamento che propongono.
Krishnapriyan e colleghi guardano la stessa cosa da un altro lato e puntano il dito sulla regolarizzazione soft, cioè sull’imporre la PDE come penalità anziché come vincolo esatto: è quella, mostrano, a deformare il paesaggio, e fra i guai che porta c’è proprio un problema peggio condizionato [KGZ+21]. I rimedi che propongono sono due, e valgono fino a uno o due ordini di grandezza sull’errore: la curriculum regularization, cioè partire da una versione addolcita dell’equazione e irrigidirla gradualmente, e una decomposizione sequenziale nel tempo.
Il secondo motivo è che una rete densa impara in fretta le componenti della soluzione a bassa frequenza, gli andamenti larghi e lenti, e molto più lentamente quelle ad alta frequenza, cioè quelle che cambiano molte volte su una distanza breve (la parola viene dai suoni, dove alto di frequenza vuol dire acuto). Il fenomeno si chiama spectral bias.
È il modo di lavorare di un pittore che parte dalle grandi campiture di colore (il cielo, il prato) e solo alla fine, con pazienza, aggiunge i dettagli minuti: le foglie, i riflessi. Una rete fa lo stesso da sola: cattura in fretta la forma d’insieme, aggiunge i particolari fini con enorme lentezza. Per molti problemi va benissimo. Ma certe soluzioni fisiche sono fatte di increspature rapide: l’aria attorno a un aereo supersonico, che cambia di colpo nello spazio di pochi centimetri; l’acqua di un fiume in piena, tutta vortici piccoli; il bordo fra due masse d’aria che avanza, dove la temperatura cambia tutta nello spazio di pochi chilometri. Lì la rete arranca proprio dove servirebbe precisa, e le mancano esattamente i dettagli che contano.
Su un bordo tagliato col coltello succede qualcosa di peggio. Il voto che dice al pittore se rispetta la regola si dà guardando di quanto cambia il colore da un punto a quello accanto, e su un taglio netto il colore salta di colpo: lì quel «di quanto cambia» non ha un valore, e il voto non vuol dire niente. La lentezza non c’entra più. Serve un voto di un altro tipo, che invece di chiedere conto a ogni punto guardi una macchia intera a cavallo del bordo, quanto colore c’è da una parte e quanto dall’altra: quella domanda ha una risposta anche quando il bordo è netto.
E c’è un terzo guaio, che non somiglia a nessuno dei due: il quadro lunghissimo, una giornata intera dipinta su una parete, con l’alba a sinistra e la notte a destra, così che camminare lungo la parete è come far passare le ore. Nessuno obbliga il pittore a partire da sinistra e ad andare in ordine: ritocca un pezzo qua e uno là, ogni tratto guardato da vicino sta in piedi, ma l’alba che gli avevano dato non arriva mai in fondo alla parete. Viene fuori una giornata piatta e senza ore, che passa tutti i controlli da vicino ed è sbagliata guardata intera. È quello che è successo alla molla con il seme 7: dopo il primo tuffo la rete si è stesa sullo zero, in regola in ogni punto controllato, e le oscillazioni che dovevano venire dopo non sono mai arrivate. Il rimedio è obbligare il pittore all’ordine: un tratto conta nel voto solo quando quelli alla sua sinistra sono già a posto.
È lo spectral bias già incontrato nella sezione sul rendering neurale: la velocità con cui una rete densa apprende una componente di Fourier decresce con la frequenza [RBA+19], e altrove porta il nome di frequency principle [XZL+20]. Per una PINN è un problema strutturale, perché molte soluzioni interessanti (fronti ripidi, strati limite, regimi turbolenti) vivono proprio nelle alte frequenze. Si mitiga con gli stessi accorgimenti di là, Fourier features in ingresso, attivazioni periodiche, riscalamenti.
Va però tenuto distinto da un altro terreno ostile con cui viene spesso confuso, quello delle PDE stiff. La rigidezza è un rapporto fra autovalori dell’operatore, e la componente «veloce» di un sistema stiff è tipicamente un modo fortemente smorzato, cioè un decadimento rapido, non un’oscillazione rapida: esaurito il transitorio, la soluzione di un problema stiff è liscia e a bassa frequenza, ed è precisamente per questo che i metodi impliciti possono farci passi enormi. Si costruisce senza fatica un problema la cui rigidezza cresce di cinque ordini di grandezza mentre il contenuto in frequenza della soluzione non si muove di un millimetro. Alle PINN i problemi stiff danno comunque filo da torcere, ma per la ragione vista poco sopra, non per lo spectral bias. Wang, Teng e Perdikaris misurano una rigidezza diversa da quella dell’equazione: quella del flusso del gradiente nello spazio dei parametri, cioè dell’equazione \(\dot\theta = -\nabla_\theta\mathcal{L}\) di cui la discesa del gradiente è il passo di Eulero esplicito, stabile solo per \(\eta < 2/\mu_{\max}\), con \(\mu_{\max}\) il massimo autovalore dell’hessiana. La trovano dominata dal residuo della PDE, e ne fanno discendere lo squilibrio fra i rami della loss; che legame ci sia fra la rigidezza di un’equazione e quella del flusso della sua PINN lo lasciano come domanda aperta [WTP21]. De Ryck e colleghi riconducono la difficoltà al condizionamento dell’operatore [DRBMdBezenac24]. Quel che lo spectral bias spiega davvero sono i fronti ripidi e gli strati limite, che sono localmente ad alta frequenza, e fra questi il transitorio iniziale di un problema stiff.
C’è poi un caso che lo spectral bias non copre affatto, ed è il più duro: quando la soluzione ha una discontinuità vera, come l’urto di una legge di conservazione non viscosa. Lì l’equazione in forma forte non ha nessuna soluzione classica, perché la soluzione vera sull’urto non è derivabile; la rete, che è liscia per costruzione, un residuo lo calcola lo stesso, e il guaio è tutto qui. Non è che impari piano, è che il problema che sta minimizzando non è quello giusto. La strada, in quel caso, è riscrivere il vincolo in forma debole: invece di chiedere \(\mathcal{N}[u_\theta] = 0\) punto per punto, si chiede che il residuo sia ortogonale a una famiglia di funzioni test, \(\int_\Omega \mathcal{N}[u_\theta]\,\varphi\,\mathrm{d}\mathbf{x} = 0\), e un’integrazione per parti sposta le derivate da \(u_\theta\) a \(\varphi\), così che sull’urto la soluzione non vada più derivata. Per l’equazione di Poisson \(-\Delta u = q\) con \(u = 0\) sul bordo, per esempio, la forma debole chiede \(\int_\Omega \nabla u_\theta\cdot\nabla\varphi\,\mathrm{d}\mathbf{x} = \int_\Omega q\,\varphi\,\mathrm{d}\mathbf{x}\) per ogni \(\varphi\) nulla sul bordo: di \(u_\theta\) compare solo la derivata prima, e la loss somma i quadrati degli scarti di questa identità su una famiglia finita di funzioni test. Sono le variational PINN di Kharazmi, Zhang e Karniadakis [KZK19], che nella versione hp prendono come funzioni test dei polinomi a tratti su una suddivisione del dominio, come negli elementi finiti [KZK21]; e per le leggi di conservazione le weak PINN di De Ryck, Mishra e Molinaro [DRMM24], che impongono in forma debole le disuguaglianze di entropia, con funzioni test anch’esse reti, in un problema di punto di sella. Parente stretto, ma solo per i problemi che derivano da un principio variazionale, è il Deep Ritz di E e Yu [EY18]: per l’equazione di Poisson \(-\Delta u = q\) la loss non è un residuo ma l’energia \(\int_\Omega \big(\tfrac{1}{2}|\nabla u_\theta|^2 - q\,u_\theta\big)\mathrm{d}\mathbf{x}\), il cui minimo fra le funzioni nulle sul bordo è la soluzione, e l’ordine delle derivate richieste scende da due a uno. Senza il vincolo al bordo l’energia non ha minimo (con \(\int_\Omega q \neq 0\) una costante la manda a \(-\infty\)), ed E e Yu lo impongono con una penalità, \(\beta \int_{\partial\Omega} u_\theta^2\,\mathrm{d}s\), cioè in forma soft, come le PINN.
Sugli orizzonti temporali lunghi agisce invece un guasto tutto suo, da tenere distinto dallo spectral bias: è un meccanismo indipendente. Non è nemmeno un accumulo di errore passo dopo passo (quella è la malattia degli integratori sequenziali, e qui di passi non ce ne sono: l’ottimizzazione è globale nel tempo). È che la loss, sommando residui su punti sparsi in tutto il dominio, non impone alcun ordine causale: nulla obbliga la rete a sistemare prima l’inizio dell’intervallo e poi il resto, e l’informazione delle condizioni iniziali non viene propagata in avanti nel tempo. Il residuo può così restare piccolo mentre la rete collassa su una dinamica banale, plausibile punto per punto e sbagliata nel complesso. Lo correggono la decomposizione sequenziale nel tempo di Krishnapriyan et al., vista poco sopra, che addestra una finestra temporale per volta, e i pesi causali di Wang, Sankaran e Perdikaris [WSP24], che dentro un’unica ottimizzazione, e calcolati a gradiente fermo, fanno contare il residuo di un istante solo quando quelli che lo precedono sono già piccoli.
L’ordine causale ha anche un rimedio che si vede (Fig. 35.5): pesare il residuo di ogni istante con quanto bene sono già risolti gli istanti prima.
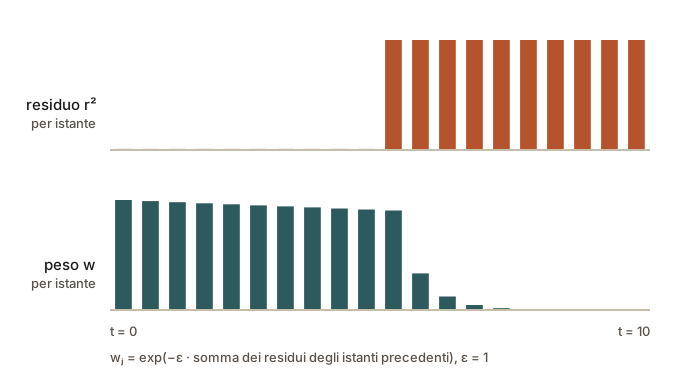
Fig. 35.5 I pesi causali su un residuo di esempio. In alto il residuo, piccolo negli istanti già risolti e grande dopo il fronte; in basso i pesi calcolati con la formula di Wang, Sankaran e Perdikaris, accesi fino al fronte e spenti poco oltre. Man mano che il fronte avanza, i pesi si accendono un istante dopo l’altro.#
E poi c’è il confronto onesto con i solutori classici, da ripetere senza sconti. Prendiamo un problema standard: equazione nota, forma regolare, nessun dato sperimentale da tenere insieme alla legge. Lì il conto a passettini visto in apertura di capitolo, fatto bene, è più rapido di ordini di grandezza ed è più preciso: nei confronti sistematici con gli elementi finiti le PINN non lo battono né nel tempo per arrivare alla soluzione né nell’accuratezza [GKLSchonlieb24]. Ne esistono due versioni mature, e conviene avere i nomi: le differenze finite mettono i puntini in righe e colonne regolari, gli elementi finiti ritagliano la regione in tanti triangoli (o tetraedri, nello spazio) e sanno quindi seguire una forma qualsiasi.
E il conto a passettini porta in dote qualcosa che a una rete addestrata manca del tutto: si dimostra, sotto ipotesi che si sanno controllare prima di partire, che infittendo i puntini l’errore scende, e pure di quanto. Una PINN che impiega minuti dove un solutore maturo impiega millisecondi, e che ogni tanto fallisce senza preavviso, è un passo indietro. Il vantaggio delle PINN, quando c’è, sta in tre casi: quando misure e leggi vanno usate insieme per rispondere alla stessa domanda; quando la risposta dipende da così tante grandezze che i puntini da mettere sarebbero più di quanti un calcolatore ne possa tenere; e quando il problema è inverso.
Oltre le PINN: imparare il mestiere, non il compito#
C’è un limite più profondo di tutti quelli visti finora, e superarlo apre la direzione più promettente. Una PINN risolve un problema, e uno soltanto: è come se, per ogni caffè che parte da una temperatura diversa, si dovesse rifare tutta la fatica dal principio.
Quando l’addestramento finisce, infatti, restano fissati per sempre cinque ingredienti, e li si capisce tutti e cinque con la sbarra di ferro del capitolo. Dov’è la sbarra, quanto è lunga e per quanto tempo la si guarda: è la regione in cui si cerca la soluzione, il dominio. Com’era calda prima che tutto cominciasse: è la condizione iniziale. Che cosa le si tiene attaccato ai due capi, una fiamma da una parte e un blocco di ghiaccio dall’altra: sono le condizioni al contorno. Che cosa la scalda dall’interno, per esempio una resistenza elettrica infilata dentro che la percorre tutta: è la sorgente, e dove non scalda niente vale zero, che è pur sempre un valore deciso prima. E di che materiale è fatta, cioè quanto in fretta il calore ci corre dentro: sono i coefficienti dell’equazione. Cambia uno solo dei cinque, sposta la fiamma o passa dal ferro al rame, e si riaddestra da capo.
Messi sul disegno, Fig. 35.6, quattro dei cinque smettono di essere un elenco e diventano posti.
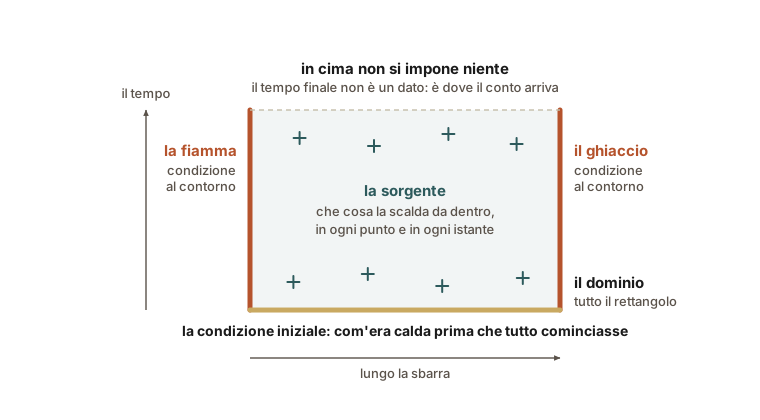
Fig. 35.6 Il rettangolo è il dominio: la sbarra da un capo all’altro, e il tempo per cui la si guarda. La condizione iniziale sta sul lato di sotto, le condizioni al contorno sui due fianchi, la sorgente dappertutto dentro. In cima non c’è niente, e non è una dimenticanza: il tempo finale non è un dato del problema ma il punto in cui il conto arriva. I coefficienti non hanno un lato perché non stanno sul bordo: stanno nell’equazione che vale in ogni punto del rettangolo.#
Chi ha risolto un problema di fisica sa la risposta a quel problema; chi ha imparato il metodo risolve anche quelli che non ha mai visto, purché somiglino a quelli su cui si è esercitato, e senza rifare la fatica ogni volta.
C’è una famiglia di reti che impara il metodo. Invece di imparare la soluzione di un problema, imparano il procedimento che porta dalla domanda alla risposta: dammi una temperatura di partenza qualsiasi, un materiale che lascia passare il calore più o meno in fretta, e ti restituisco subito la curva, senza riaddestrare niente. È un’approssimazione, buona ma non esatta, e arriva in un istante. Hai imparato il mestiere, non il singolo compito, ed è riusabile all’infinito.
Il mestiere ha i suoi confini, come li ha quello di una persona. Chi si è allenato sulle sbarre di ferro che si scaldano non sa per questo come si raffredda una stanza, e la rete portata fuori dal suo terreno risponde lo stesso, con la stessa sicurezza, e risponde male. Per i problemi in cui piccoli cambiamenti della domanda portano piccoli cambiamenti della risposta, si dimostra che una rete abbastanza grande da imparare quel mestiere esiste; quanto grande debba essere, la dimostrazione non lo dice.
Quelle reti si chiamano operatori neurali, dove «operatore» è il nome che i matematici danno appunto a un procedimento che prende una cosa intera e ne restituisce un’altra intera.
Un operatore neurale approssima una mappa \(\mathcal{G}: \mathcal{A} \to \mathcal{U}\) tra spazi di funzioni: l’ingresso non è un vettore ma una funzione intera (il campo delle condizioni iniziali, dei coefficienti, della sorgente) e l’uscita è la funzione soluzione. Due architetture hanno segnato il campo. Il DeepONet di Lu, Jin, Pang, Zhang e Karniadakis poggia sul teorema di approssimazione universale degli operatori, dimostrato da Tianping Chen e Hong Chen nel 1995 per operatori continui su un compatto di funzioni, e come tutti i teoremi di quella famiglia dice che una rete abbastanza grande esiste, non quanto debba essere grande [CC95]: una rete branch codifica la funzione d’ingresso campionata su un insieme di sensori, una rete trunk codifica il punto di query, e il loro prodotto scalare dà il valore della soluzione lì [LJP+21]. In formule, con \(m\) sensori fissi \(\mathbf{x}_1, \dots, \mathbf{x}_m\), \(\mathcal{G}(a)(\mathbf{y}) \approx \sum_{k=1}^{p} b_k\big(a(\mathbf{x}_1), \dots, a(\mathbf{x}_m)\big)\,\tau_k(\mathbf{y})\), dove le \(b_k\) sono le uscite della rete branch e le \(\tau_k\) quelle della rete trunk (il preprint è del 2019, la rivista del 2021). Il Fourier Neural Operator di Li, Kovachki e colleghi parametrizza il nucleo integrale direttamente nello spazio di Fourier [LKA+21]: ogni strato trasforma, tiene le sole frequenze basse e le ripesa con parametri appresi, antitrasforma. Le alte frequenze non sono perdute per sempre, altrimenti il filtro sarebbe un passa-basso e basta: a rigenerarle sono le nonlinearità fra uno strato e l’altro, mentre la trasformazione lineare che scorre accanto al ramo spettrale porta avanti quello che il taglio lascia fuori. Uno strato è \(v_{\ell+1}(\mathbf{x}) = \sigma\big(\mathbf{W}_\ell\,v_\ell(\mathbf{x}) + \mathcal{F}^{-1}\big(\mathbf{R}_\ell \cdot \mathcal{F}v_\ell\big)(\mathbf{x})\big)\), con \(\mathcal{F}\) la trasformata di Fourier, \(\mathbf{R}_\ell\) un tensore di pesi complessi che agisce sui soli \(k_{\max}\) modi più bassi, \(\mathbf{W}_\ell\) un’applicazione lineare punto per punto e \(\sigma\) l’attivazione (preprint del 2020, conferenza ICLR del 2021). Il risultato è invariante alla risoluzione (addestri su una griglia, valuti su un’altra) e su Navier–Stokes il riassunto dell’articolo dichiara un’inferenza fino a circa tre ordini di grandezza più rapida dei solutori tradizionali; il cronometro nel corpo, sul confronto con il pseudospettrale, dà 440 volte.
Quella cifra però va presa con le stesse pinze che si usano qui sulle PINN. Il confronto non è a parità di accuratezza: il solutore pseudospettrale è quello che ha generato i dati di addestramento, e nella tabella dell’accuratezza dello stesso articolo l’errore relativo dell’operatore alle due viscosità più basse che provano sta fra l’8% e il 19%, a seconda di quanti esempi gli si danno da studiare. Sui tempi, rifatti da altri, si tornerà fra qualche pagina; qui conta il conto d’insieme della rassegna di McGreivy e Hakim, che dà la misura del problema: fra gli articoli che dichiarano di battere un metodo numerico classico, ne trova 60 su 76 che si confrontano con una baseline debole [MH24]. Gli operatori neurali restano la direzione più interessante di tutte; i loro numeri di targa vanno letti come si leggono tutti gli altri.
Ed eccoci al meteo. I modelli neurali di previsione globale, quelli che danno dieci giorni di tempo su tutto il pianeta in meno di un minuto, là dove i centri di calcolo tradizionali integrano le equazioni per ore su un supercomputer, sono costruiti nello stesso spirito: reti che hanno imparato il metodo, cioè come l’atmosfera passa da uno stato al successivo, invece della singola risposta. Le architetture variano. GraphCast è una rete a grafo su una maglia che avvolge la sfera [LSGW+23]; FourCastNet discende dal Fourier Neural Operator [PSH+22], che lavora scomponendo in onde quel che vede: come un accordo si scompone nelle note che lo formano, una mappa di temperature si scompone in ondulazioni, quelle larghe e lente e quelle piccole e fitte, e la rete lavora su quelle invece che sui singoli punti. Nessuno dei due ha una legge fisica nella loss: quello che li fa funzionare è aver imparato dai dati il procedimento. E la qualità regge il confronto: rispetto al miglior sistema deterministico operativo, GraphCast fa meglio sul 90% dei 1380 bersagli di verifica su cui gli autori lo misurano.
Un risultato così va maneggiato con prudenza, e non solo perché restano aperte questioni serie: gli eventi estremi, che sono rari e quindi mal rappresentati in quello che il modello ha studiato; la tenuta quando si spinge la previsione lontano nel tempo; e il fatto che, non avendo nessuna legge dentro, un modello del genere può restituire uno stato dell’atmosfera che la fisica non ammetterebbe.
Poi c’è una prudenza diversa, che riguarda i numeri di targa, ed è una lezione che vale ben oltre il meteo. Restiamo sul Fourier Neural Operator, ma questa volta non sui modelli meteo: sul problema di prova su cui quella famiglia si è fatta conoscere, un fluido in due dimensioni. Nel riassunto dell’articolo che lo propone si legge «fino a tre ordini di grandezza più rapido dei solutori tradizionali», cioè mille volte; qualche pagina dopo, nello stesso articolo, il cronometro dice quattrocentoquaranta. E in quel confronto il metodo classico stava lavorando molto più fine, cioè stava dando una risposta più precisa. Quando altri sono andati a rifarlo a parità di precisione, chiedendo cioè ai due la stessa accuratezza e poi cronometrando, il vantaggio è sceso a sette volte [MH24], e per giunta con la rete su una scheda grafica contro un portatile. Sette volte è ancora un bel guadagno. Ma fra sette e mille c’è la differenza fra un miglioramento e una rivoluzione, e conviene sapere quale dei due si sta comprando.
Congedo: far collaborare conoscenza e dati#
Le PINN valgono, alla fine, più come simbolo che come tecnica, e il simbolo è questo: non chiedono di scegliere fra la conoscenza umana e i dati. Per secoli la scienza ha scritto leggi e le ha risolte al calcolatore; nel decennio abbondante che va dalla svolta del deep learning, attorno al 2012, a oggi, il machine learning ha spesso fatto l’opposto, lasciando che la struttura venisse dai dati, con vincoli leggeri come le simmetrie delle convoluzioni e dei grafi, e senza le leggi della fisica. Le PINN indicano una terza strada: mettere la legge scritta a mano e il dato misurato nella stessa funzione di costo (l’altro nome della loss), e lasciare che si correggano a vicenda. La fisica riempie i vuoti che i dati non coprono; i dati piegano la fisica dove il modello è incompleto.
Gli operatori neurali spostano l’idea su un altro piano, imparare il procedimento invece del singolo problema, ma di norma lo imparano dai soli dati, come i modelli meteo. La legge rientra nella loss solo in varianti costruite apposta, come gli operatori neurali informati dalla fisica [LZK+24] e le DeepONet informate dalla fisica [WWP21], che sommano il residuo dell’equazione allo scarto sugli esempi, o lo usano al posto degli esempi quando mancano.
Da ricordare
Il caso in cui le PINN sono più naturali è il problema inverso: misurare quello che si può misurare e far tirare fuori alla legge quello che non si può, come la pressione dentro un vaso sanguigno a partire dal filmato di un tracciante iniettato nel sangue [RYK20]. Funziona perché le leggi della fisica legano fra loro le grandezze: chi ne conosce una ovunque, dell’altra sa già qualcosa. Non tutto, però: dove la macchia è uniforme il filmato non dice niente della corrente, e della pressione si ricavano i dislivelli, non il livello.
Dove sono più promettenti: ricostruire il flusso del sangue e dei fluidi da immagini (finora su dati simulati) e stimare le proprietà nascoste di un materiale. Sulla struttura del sottosuolo dalle onde dei terremoti si sta ancora provando, e i metodi vecchi per ora tengono. I grandi modelli che prevedono il tempo di tutto il pianeta in un minuto scarso, invece, non sono PINN: non hanno nessuna legge dentro il punteggio, hanno solo imparato da decenni di mappe del tempo passato.
Limiti, senza sconti [KGZ+21]: il metodo fallisce anche su problemi facili; la manopola che bilancia le due squadre del tiro alla fune va cercata provando, o fatta ristimare durante l’addestramento guardando quanto strattona ciascuna squadra, e resta un guaio che nessuna posizione della manopola sistema, perché la squadra della fisica strattona a ogni passo (si rimedia partendo da una legge addolcita, da irrigidire poco alla volta); la rete impara in fretta le forme d’insieme e arranca sui dettagli fini (il pittore che lascia le foglie per ultime), e su un bordo netto serve un voto dato su una macchia intera; sulle durate lunghe va obbligata all’ordine, dall’inizio alla fine. E soprattutto, come si è visto sulla molla, un punteggio basso non vuol dire risposta giusta.
Sui problemi ordinari il conto a passettini di sempre vince quasi sempre, in velocità, in precisione e in garanzie. Le PINN si affiancano, non sostituiscono.
Il passo successivo sono reti che imparano il metodo invece del singolo compito: una volta addestrate rispondono a qualunque situazione simile senza rifare la fatica, con una risposta approssimata ma buona, ed è il motivo per cui certe previsioni meteo escono in secondi anziché in ore. Di solito imparano il metodo dai soli esempi, senza la legge nel punteggio. Fuori dal terreno su cui si sono allenate, però, rispondono lo stesso, con la stessa sicurezza, e sbagliano.
I confronti di velocità che si leggono in giro vanno però verificati, e la storia più istruttiva non riguarda il meteo ma il problema di prova su cui quella famiglia si è fatta conoscere: dichiarato mille volte più rapido del metodo classico, rifacendo la corsa a parità di precisione è risultato sette volte più rapido [MH24].
Da ricordare
Il problema inverso è il caso in cui l’impianto delle PINN è più naturale: stimare grandezze non misurabili (la pressione in un aneurisma) da ciò che si misura, imponendo la fisica come vincolo [RYK20], purché i dati le identifichino (la velocità dove \(\nabla c \neq \mathbf{0}\), la pressione a meno di una costante). Il parametro ignoto diventa una variabile addestrabile, stimata insieme alla soluzione. Il vantaggio sui classici è di uniformità, non di complessità: lo stato aggiunto dà il gradiente in due risoluzioni [Ple06], e sui propri problemi di riferimento ODIL costa da due a cinque ordini di grandezza meno della PINN [KLK24].
Dove le PINN hanno dimostrazioni solide: ricostruzione di campi di flusso da immagini di un tracciante (finora su dati simulati) e stima di parametri di materiali da poche misure. In geofisica sono ancora ricerca, e l’inversione di forma d’onda classica resta difficile da battere. I grandi modelli meteo neurali sono appresi dai dati di rianalisi, senza fisica nella loss, e non sono PINN.
Limiti onesti [KGZ+21]: le PINN falliscono anche su PDE semplici; la loss multi-obiettivo va bilanciata, provando o ristimando i coefficienti dalle statistiche dei gradienti o dal nucleo tangente; lo spectral bias frena fronti ripidi e strati limite; le PDE stiff sono ostili per il condizionamento, non per lo spectral bias [DRBMdBezenac24], e il flusso del gradiente di una PINN è rigido di suo, con i gradienti dei termini squilibrati [WTP21]; sugli orizzonti lunghi manca l’ordine causale, e residuo piccolo non implica soluzione corretta (lo si è misurato sulla molla della legge dentro la loss). Sui problemi standard i solutori classici vincono quasi sempre in velocità, accuratezza e garanzie [GKLSchonlieb24].
Gli operatori neurali imparano il mestiere, non il compito: la mappa condizioni → soluzione, riusabile senza riaddestrare (DeepONet [LJP+21] e Fourier Neural Operator [LKA+21]), di norma dai soli dati; la fisica entra nella loss solo in varianti come PINO e DeepONet informate dalla fisica. Gli speedup dichiarati vanno però verificati a parità di accuratezza: il 1000× del FNO diventa 440× nel corpo del paper e 7× in replica indipendente [MH24].
La direzione indicata dalle PINN non sostituisce la conoscenza umana con i dati: li fa collaborare nella stessa funzione di costo.
Grafi, cataloghi di prodotti da consigliare, serie storiche, equazioni della fisica: la stessa matematica si è piegata ogni volta alla struttura di un dominio, e con le PINN a quella di una legge. Da qui la domanda cambia. Il capitolo su MLOps non chiede più che cosa un modello riesca a imparare, ma che cosa gli succede il giorno dopo, quando smette di essere un esperimento e diventa un servizio che qualcuno usa davvero; dopo vengono il perché delle sue decisioni e ciò che dobbiamo a chi le subisce.