


Davanti ai modelli: limitare, ritentare, instradare#
Una centrale di commutazione della rete interurbana AT&T, a New York, il
pomeriggio del 15 gennaio 1990 ebbe un guasto e fece quello per cui era stata
progettata: si fermò qualche secondo, si rimise in ordine e, tornata in
servizio, lo annunciò alle centrali vicine. Quel messaggio fece cadere le
centrali che lo ricevevano. Un aggiornamento installato a dicembre aveva
lasciato nel programma un’istruzione fuori posto (un break del linguaggio C,
che fa uscire da un blocco di codice prima del tempo), e una centrale che
riceveva due messaggi a pochi millisecondi l’uno dall’altro si corrompeva i
dati, se ne accorgeva e si riavviava; tornando in servizio, lo annunciava alle
vicine. Le 114 centrali telefoniche della rete si passarono il riavvio per
circa nove ore, e in quelle ore quasi metà delle chiamate interurbane della
compagnia non passò.
Il difetto stava nel codice che serviva a riprendersi dai guasti. Il meccanismo pensato per contenere un problema locale è diventato il mezzo con cui il problema ha fatto il giro della rete, ed è la specie di guasto da cui un gateway deve difendersi.
Un’applicazione che usa modelli linguistici raramente parla con un modello solo, e quasi mai direttamente. In mezzo c’è un gateway, una porta unica da cui passano tutte le chiamate, e dietro stanno i modelli: repliche proprie, servizi di terzi raggiunti via rete. Il gateway fa quattro mestieri. Decide chi passa e quanto, decide che cosa fare quando un modello non risponde, sceglie a quale modello mandare ciascuna richiesta, e registra che cosa succede. Il limite, i ritentativi e il ripiego su un altro modello sono meccanismi di difesa e di recupero, e il caso di AT&T dice perché vanno progettati con cura: quando sbagliano, sbagliano moltiplicando.
Chi passa, e quanto#
Un servizio con capacità finita deve difendersi da chi chiede troppo, anche in buona fede, come un programma che per un errore ripete la stessa chiamata senza fermarsi. Il limite di frequenza (rate limit) fissa quanto ciascuno può chiedere, e per un modello linguistico si scrive in due unità, richieste al minuto e token al minuto, perché una richiesta da dieci token e una da centomila non costano lo stesso.
All’ingresso di un museo c’è un distributore che stampa un biglietto ogni sei secondi e ne tiene al massimo cinquanta in pila. Chi arriva prende dalla pila tanti biglietti quanti ne servono al suo gruppo; se la pila non basta, aspetta che la macchina ne stampi altri.
Succedono due cose insieme, ed è per questo che il meccanismo funziona. Nel lungo periodo non entra più di un visitatore ogni sei secondi, perché più in fretta la macchina non stampa. Ma se il museo è rimasto tranquillo per un po’ la pila è piena, e una scolaresca di cinquanta ragazzi entra tutta insieme senza aspettare: le raffiche sono permesse, purché siano state pagate prima da un po’ di calma. L’altezza della pila decide quanto può essere grande una raffica, il ritmo della stampa quanto si entra in media, e le due cose si regolano separatamente.
Con i modelli i biglietti sono token, e c’è una complicazione: quanti ne consumerà una richiesta si sa solo per metà. Il testo in entrata si conta prima di spedirlo; la risposta no, perché non è ancora stata scritta. Allora si prendono dalla pila i biglietti per la risposta più lunga permessa, e a risposta finita si restituiscono quelli avanzati. È prudente, e ha un costo: chi dichiara di voler scrivere risposte lunghissime tiene fermi biglietti che non userà, e chi viene dopo trova la pila più bassa del necessario.
Resta da decidere di chi sono i biglietti. Con un distributore solo per tutti, una scuola da cinquecento ragazzi svuota la pila e le famiglie restano fuori: il posto se lo prende chi chiede di più. Per questo ogni gruppo ha il suo distributore, con la sua pila, e chi esagera svuota soltanto la propria.
Il distributore conta gli ingressi, e non sa quanto i visitatori si fermino dentro: una scolaresca che resta tre ore occupa le sale più di cento turisti di passaggio. Per questo molti musei mettono un secondo tetto, sulle persone presenti nello stesso momento. Chi esce libera un posto, e quando le sale si svuotano piano si entra più piano anche alla porta, senza che nessuno debba ritoccare il distributore.
Il token bucket è definito da una capienza \(b\) e da un tasso di ricarica \(r\). Lo stato è il livello \(s \in [0, b]\), che cresce con \(\dot s = r\) finché non raggiunge \(b\); una richiesta di costo \(\kappa\) è ammessa se \(s \ge \kappa\), e allora \(s \leftarrow s - \kappa\). Ne segue la garanzia che ne ha fatto il meccanismo standard del controllo di traffico: su qualunque intervallo di durata \(\Delta t\) il costo ammesso non supera \(b + r\,\Delta t\). Il tasso medio è limitato da \(r\), la raffica da \(b\), e le due grandezze si scelgono indipendentemente. Un contatore a finestra fissa non lo permette: con finestre da un minuto, sessanta secondi a cavallo del confine fra due finestre possono far passare il doppio del limite.
Per un modello linguistico il costo di una richiesta è \(\kappa = N_{\text{in}} + N_{\text{out}}\) token, con \(N_{\text{in}}\) noto all’arrivo e \(N_{\text{out}}\) noto solo alla fine. Il gateway preleva \(N_{\text{in}} + N_{\text{max}}\), con \(N_{\text{max}}\) il tetto dichiarato della risposta, e restituisce \(N_{\text{max}} - N_{\text{out}}\) al termine. La restituzione indebolisce la garanzia. Il limite \(b + r\,\Delta t\) vale sui prelievi netti, cioè al netto di quanto restituito; sul costo reale delle richieste ammesse nell’intervallo vale con un termine in più, gli avanzi delle prenotazioni ancora aperte all’inizio, che appena restituiti possono rientrare sotto forma di altre richieste. Il tasso medio resta limitato da \(r\). Il prelievo del maggiorante ha poi un costo suo, una sottoutilizzazione pari ai token riservati e non usati, tanto più grande quanto più \(N_{\text{max}}\) è largo rispetto alle risposte reali; e una richiesta con \(N_{\text{in}} + N_{\text{max}} > b\) non entra mai, quindi la capienza si dimensiona sul contesto più lungo che si vuole servire. Si applicano di solito due secchi in serie, uno sulle richieste e uno sui token, per cliente e per modello. Chi viene respinto riceve un codice che lo dice (in HTTP il 429, too many requests) e l’indicazione di quando riprovare.
Il secchio per cliente realizza l’isolamento. Senza, la capacità condivisa si ripartisce in proporzione a quanto ciascuno chiede, cioè premia chi chiede di più, e un cliente in errore che manda richieste senza sosta degrada il servizio di tutti gli altri.
Il tasso però non basta, perché con un LLM una richiesta lunga occupa il servente molto più di una breve. Si aggiunge allora un limite \(L_{\max}\) sulle richieste in volo. Per la legge di Little, la stessa che in Quante repliche accendere dà il bersaglio dell’autoscaler, il tasso medio ammesso è \(L_{\max}/W\), con \(W\) la permanenza media: quando il servente rallenta, \(W\) cresce e il limite ammette meno richieste da sé. Quelle oltre il limite si respingono subito (load shedding) invece di accodarle, così che la coda non cresca proprio quando la capacità manca.
Quando un modello non risponde#
Il secondo mestiere è il più delicato. Un modello può non rispondere per molte ragioni (una replica caduta, un fornitore sovraccarico, una rete che perde pacchetti), e la reazione istintiva, riprovare, ripara un guasto isolato e aggrava un guasto da sovraccarico, a meno che qualcuno non ne limiti il numero. La differenza sta tutta in come i tentativi si sommano.
Il lunedì alle otto lo studio del medico apre le prenotazioni, e le prende con la segreteria telefonica: si lascia un messaggio, e l’impiegata richiama i pazienti uno alla volta, nell’ordine in cui hanno chiamato. Chi non viene richiamato entro un quarto d’ora pensa che il messaggio sia andato perso e ne lascia un altro. Riprovare, di per sé, funziona: se un messaggio si è perso davvero, il secondo arriva.
Ma alle otto chiama mezzo quartiere, e l’impiegata non riesce a richiamare tutti entro un quarto d’ora. Allora quasi tutti lasciano un secondo messaggio, poi un terzo, e i messaggi smettono di essere quelli dei pazienti: sono i pazienti moltiplicati per i tentativi di ciascuno. L’impiegata richiama in ordine, e passa la mattina a richiamare messaggi vecchi, di gente che intanto ne ha lasciati altri due o che si è stufata ed è andata altrove. Alle nove i pazienti nuovi quasi non chiamano più, e la segreteria è ancora piena: la ressa si mantiene da sola, alimentata dai messaggi ripetuti.
Le difese stanno in parte da chi chiama e in parte dallo studio. Chi chiama può aspettare prima di riprovare, e aspettare ogni volta di più: un quarto d’ora, poi mezz’ora, poi un’ora. E non tutti lo stesso minuto, o alle otto e un quarto richiamano tutti insieme e si ricomincia: ciascuno aggiunge un po’ di caso alla sua attesa. La segreteria può mettere un tetto ai messaggi ripetuti, e se superano uno ogni dieci messaggi nuovi smette di registrarli, perché oltre quel punto ripetere non aiuta nessuno. Quando è piena da troppo tempo può rispondere con un avviso che chiude subito, «prenotazioni sospese fino alle dieci», senza registrare niente; alle dieci lascia passare un messaggio solo, e se l’impiegata ce la fa riapre, se no rimette l’avviso.
L’ultimo rimedio è dell’impiegata. Richiamare un messaggio che il paziente ha già ripetuto, o di chi è andato altrove, è lavoro per nessuno. Se ogni messaggio portasse scritta l’ora oltre la quale non vale più, lei salterebbe quelli scaduti, e la pila si svuoterebbe in fretta.
Sia \(p\) la probabilità che un tentativo fallisca, per errore o per scadenza del timeout, e \(k\) il numero massimo di ritentativi. Se i tentativi falliscono in modo indipendente, il numero atteso di tentativi per richiesta è
che vale circa 1 per \(p\) piccolo e tende a \(k + 1\) per \(p \to 1\), e il carico offerto al servente è \(A\lambda\). Per un guasto isolato, con \(p\) piccolo e indipendente dal carico, il ritentativo è quasi gratuito e recupera quasi tutte le richieste. In un guasto da sovraccarico \(p\) dipende invece dal carico stesso: più tentativi allungano la coda, la coda fa scadere più tentativi, i tentativi scaduti ne generano altri. È una retroazione positiva, che con \(k = 3\) moltiplica per quattro il carico proprio quando la capacità manca, e può tenere il sistema in sovraccarico anche dopo che la causa scatenante è sparita. È un guasto metastabile [BACZ21]: allo stesso carico nominale il sistema ha due equilibri, e un’eccitazione transitoria lo sposta dal buono al cattivo. Il servente lavora a pieno, e quasi tutto il suo lavoro va a tentativi che il cliente ha già abbandonato: goodput prossimo a zero con il throughput al massimo.
Le difese agiscono sui termini di \(A\) e sull’anello. L’attesa esponenziale fra
i tentativi, con una componente casuale (backoff con jitter: prima del
ritentativo \(i \ge 1\) si attende un tempo uniforme in \([0, \min(t_{\max}, t_0
2^{i-1})]\), con \(t_0\) l’attesa di base e \(t_{\max}\) il tetto), diluisce nel
tempo il carico dei ritentativi e ne decorrela gli istanti: senza la parte
casuale, i clienti falliti insieme ritentano insieme e ricreano il picco a ogni
scadenza. È il full jitter. Nel confronto di Brooker, le tre varianti con una
componente casuale battono tutte quella che ne è priva. Fra loro, quella che
tiene fissa metà dell’attesa (l’equal jitter) è la peggiore, mentre fra il
full jitter e il decorrelated jitter, che allarga l’intervallo a partire
dall’attesa precedente, la scelta resta aperta [Bro15]. Se
il servente ha risposto 429 indicando quando riprovare (l’intestazione
Retry-After), quell’indicazione viene prima del backoff. Un budget di
ritentativi, per esempio non più del 10% delle richieste nuove applicato con un
token bucket, impone \(A \le 1{,}1\) qualunque sia \(p\), e rompe l’anello; lo si
tiene per destinazione e per cliente, perché un budget unico lascerebbe a un
solo cliente in errore la possibilità di consumarlo tutto. Il circuit
breaker [Nyg07] osserva il tasso di errore verso una
destinazione: sopra una soglia passa allo stato aperto e fa fallire subito
ogni chiamata senza inoltrarla, dopo un intervallo ne lascia passare una sola
(stato semiaperto), e torna chiuso se va a buon fine. Toglie carico a chi è
già in difficoltà, e restituisce l’errore in millisecondi invece che allo
scadere di un timeout. L’ultima difesa sta dal lato del servente: se ogni
richiesta porta con sé la propria scadenza e il servente scarta senza eseguirle
quelle già scadute (la propagazione della scadenza), sparisce il lavoro speso
per nessuno, che è il combustibile della metastabilità.
Per un modello generativo il timeout si scrive sul TTFT e sulla pausa massima fra token, non sulla durata totale: una risposta lunga è lenta per costruzione, e un timeout sul totale la interromperebbe regolarmente, trasformando una risposta sana in un ritentativo che rifà il prefill da capo. E una chiamata che genera testo non si può ritentare in modo trasparente dopo che i primi token sono già arrivati all’utente: il ritentativo va fatto prima del primo token, o bisogna saper riprendere lo stream. E ritentare una richiesta che il servente stava già generando fa pagare due volte: il lavoro del primo tentativo, e presso un fornitore anche i suoi token, è speso per nessuno.
La differenza fra un ritentativo che salva e uno che affonda si vede su dieci secondi di guasto. Un modello smaltisce 100 tentativi al secondo e ne riceve 80 nuovi; ogni cliente aspetta due secondi, poi lascia perdere e, a seconda della politica, ritenta. Dal trentesimo al quarantesimo secondo il modello non risponde a nessuno. Il modello lavora dalla testa della fila e non sa chi ha smesso di aspettare, tranne nell’ultima politica.
from collections import deque

CAPACITA = 100.0        # tentativi al secondo che il modello smaltisce
ARRIVI = 80.0           # richieste nuove al secondo
PAZIENZA = 2.0          # dopo due secondi senza risposta il cliente lascia perdere
PASSO = 0.1             # la simulazione avanza a decimi di secondo
GUASTO = (30.0, 40.0)   # dieci secondi in cui il modello non risponde a nessuno

def simula(nome, ritenta=0, budget=0.0, scarta_scadute=False):
    coda = deque()      # gruppi di tentativi: [partiti alle, quanti, tentativo, abbandonati]
    utili = [0.0] * 340 # risposte arrivate a qualcuno che aspettava ancora, per secondo
    scorta = budget * ARRIVI * 10       # il secchio dei ritentativi: dieci secondi di scorta
    for k in range(3400):
        ora = k * PASSO
        coda.append([ora, ARRIVI * PASSO, 0, False])
        scorta = min(scorta + budget * ARRIVI * PASSO, budget * ARRIVI * 10)
        # chi aspetta da troppo lascia perdere e, se può, ritenta subito
        nuovi = []
        for g in coda:
            if not g[3] and ora - g[0] > PAZIENZA:
                g[3] = True
                if g[2] < ritenta:
                    quanti = g[1] if budget == 0 else min(g[1], scorta)
                    scorta -= quanti if budget else 0.0
                    if quanti > 0:
                        nuovi.append([ora, quanti, g[2] + 1, False])
        coda.extend(nuovi)
        # il modello lavora dalla testa della fila, e non sa chi ha lasciato perdere
        lavoro = 0.0 if GUASTO[0] <= ora < GUASTO[1] else CAPACITA * PASSO
        while lavoro > 1e-9 and coda:
            g = coda[0]
            if scarta_scadute and g[3]:
                coda.popleft()          # la scadenza viaggia con la richiesta: si butta
                continue
            fatto = min(g[1], lavoro)
            lavoro -= fatto
            g[1] -= fatto
            if not g[3]:
                utili[int(ora)] += fatto
            if g[1] <= 1e-9:
                coda.popleft()
    finestra = lambda a, b: sum(utili[a:b]) / (b - a)
    print(f"{nome:<32}{finestra(0, 30):7.1f}{finestra(40, 70):7.1f}"
          f"{finestra(70, 130):8.1f}{finestra(280, 340):8.1f}{sum(g[1] for g in coda):9.0f}")

print(f"{'politica':<32}{'prima':>7}{'0-30s':>7}{'30-90s':>8}{'4-5min':>8}{'in fila':>9}")
simula("non ritenta")
simula("ritenta, fino a 3 volte", ritenta=3)
simula("ritenta, budget del 10%", ritenta=3, budget=0.1)
simula("ritenta, scadute scartate", ritenta=3, scarta_scadute=True)
politica                          prima  0-30s  30-90s  4-5min  in fila
non ritenta                        80.0    0.0    80.3    80.0        0
ritenta, fino a 3 volte            80.0    0.0     0.0     0.0    68192
ritenta, budget del 10%            80.0    0.0    38.4    80.0        0
ritenta, scadute scartate          80.0   89.5    80.0    80.0        0
Le colonne sono le risposte utili al secondo, cioè arrivate a qualcuno che le aspettava ancora: prima del guasto, nei trenta secondi dopo, fra trenta e novanta secondi dopo, e fra quattro e cinque minuti dopo. L’ultima è quanto resta in fila quando la simulazione si ferma.
Senza ritentativi il servizio si riprende da solo. A guasto finito in fila ci sono ottocento tentativi che, quando il modello li raggiunge, nessuno aspetta più, e il modello li smaltisce con un margine di venti al secondo (cento contro ottanta). Finché la fila vale più di due secondi d’attesa, cioè per una trentina di secondi, lavora a vuoto: ogni risposta arriva a qualcuno che se n’è già andato. Poi le risposte utili tornano a ottanta. Con tre ritentativi il servizio non si riprende più (Fig. 36.18). Ogni richiesta che trova la fila lunga scade, e scadendo ne genera un’altra, fino a quattro tentativi: 320 al secondo contro una capacità di 100. La fila cresce senza fine (68.192 tentativi quando la simulazione si ferma), il modello lavora al massimo e le risposte utili sono zero, con il guasto finito da cinque minuti. È lo stato che si chiama metastabile: la causa è sparita, ma il sistema resta bloccato in una condizione che si alimenta da sola, e ci resta finché qualcuno non spegne i ritentativi o non taglia il traffico. Ed era esposto molto prima degli ottanta al secondo: con tre ritentativi basta che le richieste nuove superino le 25 al secondo perché un guasto abbastanza lungo porti i tentativi oltre la capacità, 25 per quattro tentativi, cioè 100.
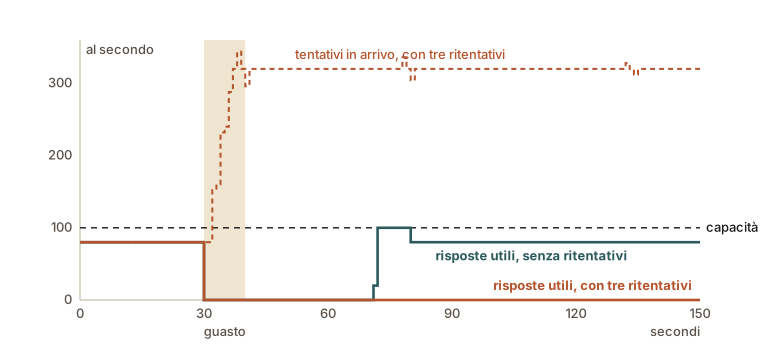
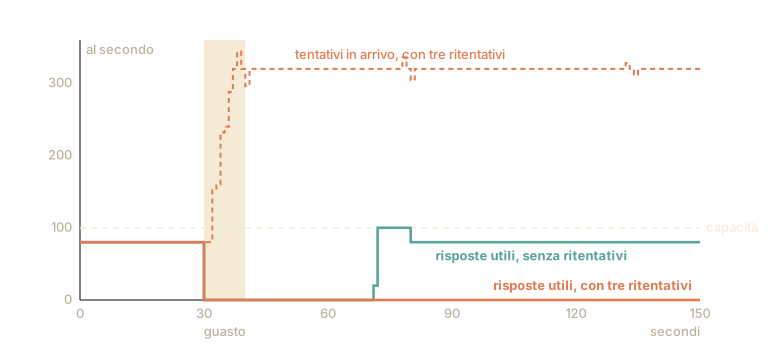
Fig. 36.18 Lo stesso guasto di dieci secondi, due politiche. Senza ritentativi il modello smaltisce la fila di chi non aspetta più e torna a servire; con tre ritentativi ogni richiesta scaduta ne genera un’altra, i tentativi in arrivo restano oltre il triplo della capacità e le risposte utili a zero, a guasto finito da un pezzo.#
Il tetto del 10% ai ritentativi (in gergo il budget) spezza il circolo: i ritentativi sono in media otto al secondo, dopo una prima raffica grande quanto la scorta, il carico resta sotto la capacità, e la fila si svuota. Si svuota più piano che senza ritentativi (38,4 risposte utili al secondo fra trenta e novanta secondi, contro 80,3), perché anche i ritentativi permessi aggiungono lavoro. Il vantaggio di ritentare comunque un poco si vede quando un tentativo fallisce per caso e non per la ressa, un evento che la simulazione non contempla: lì il secondo tentativo passa quasi sempre, mentre senza ritentativi quella risposta andrebbe persa. L’attesa che cresce e l’avviso che chiude subito non sono nella simulazione; agiscono sugli stessi numeri, diluendo i ritentativi nel tempo o togliendoli del tutto. Scartare i tentativi scaduti fa meglio di tutto il resto. Il modello non spende un istante per chi non aspetta più, i ritentativi trovano la fila corta, e nei trenta secondi dopo il guasto le risposte utili sono 89,5 al secondo, più delle ottanta richieste nuove che arrivano: oltre a loro il modello serve, con il suo margine di venti al secondo, anche i ritentativi di chi era rimasto senza risposta durante il guasto e aspetta ancora.
A quale modello#
Il terzo mestiere nasce dal fatto che i modelli non costano uguale e non sanno le stesse cose. Mandare tutto al modello più grande è la scelta sicura e la più cara, mandare tutto al più piccolo la più economica e la più rischiosa. Fra le due c’è l’instradamento (routing), che decide richiesta per richiesta chi deve rispondere. Accanto c’è un mestiere che gli somiglia e che non va confuso, il ripiego (fallback): dove andare quando chi doveva rispondere non risponde.
Al pronto soccorso chi entra non va subito dal medico. Prima passa dal triage, un infermiere che in due minuti guarda, chiede e assegna un colore, e il colore decide dove si va: i casi semplici all’ambulatorio veloce, dove un medico generico li sbriga in fretta, i casi seri dallo specialista, che costa di più e ha meno tempo. Il triage costa poco, ma decide prima di sapere, da pochi segni, e ogni tanto sbaglia: il codice verde che nascondeva un infarto, il codice rosso per un attacco di panico.
Si può fare anche un’altra cosa, che somiglia al triage e funziona al rovescio. Tutti passano prima dall’ambulatorio veloce, e il medico generico prova a risolvere; se capisce che il caso lo supera, manda il paziente dallo specialista. La decisione arriva dopo una visita, quindi è più informata, e lo specialista vede solo i casi difficili. Il prezzo è che chi arriva allo specialista ha pagato due visite e ha aspettato due volte. Se il generico costa un decimo dello specialista e risolve otto casi su dieci, cento pazienti costano cento visite dal generico, che valgono quanto dieci dallo specialista, più le venti visite dallo specialista di chi non è stato risolto: trenta in tutto, meno di un terzo delle cento che servirebbero mandando tutti da lui. Conviene finché il generico sa riconoscere i casi che non sa risolvere; uno che si crede bravo e non manda mai nessuno costa poco e sbaglia molto.
Poi c’è il caso in cui lo specialista non c’è. Il turno salta, il reparto chiude, e il paziente va mandato in un altro ospedale. Qui il criterio smette di essere la difficoltà del caso e diventa la disponibilità. E l’altro ospedale ha i suoi protocolli, i suoi moduli, le sue abitudini: il paziente sarà curato, ma non allo stesso modo. Se nessuno ha mai provato a mandarcene uno, il giorno che serve si scopre che il numero di telefono del reparto era sbagliato. L’altro ospedale, che di colpo riceve anche i pazienti del primo, rischia di chiudere a sua volta. E se i due dipendevano dallo stesso centralino, quando il centralino si ferma si fermano insieme.
Siano \(m_1, \dots, m_J\) modelli ordinati per costo crescente, \(c_1 < \dots < c_J\). Un router è una funzione \(\pi(x)\) che sceglie il modello prima di interrogarne alcuno, dai soli tratti della richiesta. RouteLLM [OAW+25] ne addestra per il caso di due modelli, uno forte e uno debole, stimando da dati di preferenza umana la probabilità che la risposta del forte venga preferita, e instradando al forte quando la stima supera una soglia; al variare della soglia si percorre una curva costo-qualità. Il guadagno dipende molto dal compito. Nella tabella degli autori, con GPT-4 come modello forte e Mixtral 8x7B come debole, si fissa il punto in cui il router recupera metà del divario di qualità fra i due e si contano le chiamate al forte che servono per arrivarci, contro quelle di un instradamento casuale: su MT Bench sono 3,66 volte meno, e lì si resta al 95% della qualità del forte; su MMLU 1,41 volte meno, al 92%; su GSM8K 1,49 volte meno, all’87%. Una cascata interroga invece i modelli in ordine e si ferma al primo la cui risposta supera un criterio di accettazione \(g(x, \hat{y}) \ge \tau_j\) sulla risposta \(\hat{y}\), stimato da un punteggiatore addestrato; FrugalGPT [CZZ24b] ne apprende insieme l’ordine e le soglie sotto un vincolo di budget. Se \(u_j\) è la probabilità che la risposta di \(m_j\) venga accettata, dato che le precedenti non lo sono state, il costo atteso è
e la latenza si compone allo stesso modo: la cascata paga sempre \(c_1\), e a chi viene inoltrato fa pagare tutte le chiamate precedenti. Conviene quando \(u_1\) è alto e il punteggiatore ha pochi falsi positivi, cioè accetta di rado risposte sbagliate, che sono l’errore che la cascata non recupera. Con due modelli, e trascurando il costo del punteggiatore, la cascata costa meno che mandare tutto al secondo se \(c_1 + (1-u_1)c_2 < c_2\), cioè se \(u_1 > c_1/c_2\).
Il fallback risponde alla disponibilità, e non alla difficoltà: è una lista ordinata di destinazioni equivalenti, percorsa quando la prima fallisce o supera il timeout, di solito dietro un circuit breaker, così che una destinazione aperta venga saltata senza aspettarne la scadenza. Tre avvertenze lo separano da un ritentativo qualsiasi. Due modelli non sono intercambiabili: tokenizzatore, lunghezza massima del contesto, formato delle chiamate agli strumenti e comportamento sullo stesso prompt cambiano, quindi il ripiego va valutato con lo stesso protocollo del primario (la valutazione di LLMOps). Il ripiego scarica sulla riserva il traffico del primario nel momento in cui questo cade, e una riserva dimensionata per il proprio traffico normale cade a sua volta: è la stessa amplificazione dei ritentativi, un livello più su. E le destinazioni devono guastarsi in modo indipendente, senza condividere la regione di calcolo, il fornitore o la dipendenza comune che le farebbe cadere insieme.
Vedere dove va il tempo#
Tutto questo si governa solo se si vede. Le metriche aggregate di Sorvegliare un modello vivo dicono che la p99 del TTFT è salita; non dicono dove è andato il tempo. Per saperlo serve la traccia distribuita di ogni richiesta, il suo percorso cronometrato tratto per tratto.
Un pacco spedito ieri non è ancora arrivato. Il tempo medio di consegna del corriere, due giorni, non dice niente su questo pacco; il tracciamento sì. Ogni volta che il pacco passa da un posto qualcuno lo scansiona, e il sito mostra la fila delle scansioni con l’ora: ritirato alle nove, al centro di smistamento alle undici, al deposito della città alle sei di sera, e da lì più niente per ventiquattr’ore. Il ritardo ha un indirizzo, il deposito.
Con una risposta di un modello si fa lo stesso. Ogni tratto del percorso segna quando comincia e quando finisce: il passaggio dalla porta d’ingresso, l’attesa per il limite di frequenza, la scelta del modello, la fila sulla replica, la lettura del prompt, la scrittura della risposta. Alcuni tratti ne contengono altri, come un deposito diviso in reparti: se per rispondere il modello va a cercare dei documenti, quella ricerca è un tratto dentro il tratto. L’attesa della prima parola, che nel cruscotto è un numero solo, nel tracciamento diventa la somma delle sue attese, e quella cresciuta si vede.
Ogni scansione porta anche un’etichetta, e qui l’etichetta dice quale modello ha risposto, quanti token sono entrati e usciti, se gli appunti dell’inizio erano già pronti, e soprattutto se la richiesta era un secondo tentativo. Senza quell’ultima riga, sul cruscotto una ressa di messaggi ripetuti sembra traffico vero.
Tracciare tutto rallenterebbe il servizio e riempirebbe i dischi, e allora si traccia solo una parte dei pacchi. Chi decide quali seguire alla partenza, prima di sapere com’è andata, perde quasi sempre i pochi pacchi in ritardo; chi decide a consegna finita può tenere sempre quelli lenti o finiti male, che sono quelli da cui si impara. E il contenuto del pacco non si fotografa: il testo delle domande e delle risposte può contenere i dati di chi scrive, e si registra solo dove le regole lo consentono.
Una traccia è un albero di span. Ciascuno ha un identificativo, il riferimento allo span genitore, un istante d’inizio, uno di fine e un insieme di attributi; tutti gli span di una richiesta condividono l’identificativo di traccia, che si propaga da un servizio all’altro insieme alla chiamata (per esempio in un’intestazione HTTP). Lo schema si è affermato con Dapper [SBB+10], e le due scelte che l’hanno reso sostenibile alla scala di Google valgono ancora: strumentare poche librerie comuni invece di ogni applicazione, e campionare. Per una chiamata a un modello generativo il cammino critico degli span scompone il TTFT in
più gli span figli (recuperi di documenti, chiamate a strumenti) che precedono il primo token, con \(t_{\text{rete}}\) i due tratti di rete, l’andata della richiesta e il ritorno del primo token al cliente. È il TTFT visto dal cliente, come in Misurare un servizio; la somma \(t_{\text{coda}} + t_{\text{prefill}}\) è il tratto che la replica misura da sé, il TTFT lato servente. Il TPOT è la durata dello span di decode divisa per \(N_{\text{out}} - 1\). La p99 aggregata dice che uno dei termini è cresciuto; la traccia dice quale.
Il campionamento in testa (head-based), deciso all’ingresso con probabilità fissa come in Dapper, costa poco ma perde quasi tutte le richieste rare; quello in coda (tail-based), deciso a traccia completa, trattiene tutte le lente e tutte quelle in errore, al prezzo di tenere in memoria gli span finché la richiesta non finisce. Gli attributi propri di un LLM sono il modello e la sua versione, \(N_{\text{in}}\) e \(N_{\text{out}}\), i token trovati nella cache del prefisso, l’indice del tentativo e l’eventuale destinazione di ripiego: senza gli ultimi due, una tempesta di ritentativi appare nelle metriche come un aumento del traffico offerto, e la diagnosi va nel verso sbagliato. Il testo di prompt e risposte può contenere dati personali, e si registra solo dove le regole sulla loro protezione lo consentono, di solito ridotto o cifrato.
Provare a rompere#
Le difese viste fin qui hanno un difetto in comune: entrano in funzione solo
quando qualcosa va storto, cioè di rado, e il codice che gira di rado è il meno
collaudato del sistema. Era il caso di AT&T, dove il break sbagliato stava
proprio nel percorso di recupero. Il modo più affidabile di sapere se un ripiego
funziona è farlo scattare, in condizioni controllate.
Una scuola non aspetta un incendio per scoprire se l’uscita di sicurezza si apre. Un paio di volte l’anno suona l’allarme per finta, e tutti escono. Prima di cominciare si stabilisce che cosa vuol dire che è andata bene (tutti in cortile entro tre minuti, nessuno dimenticato in bagno), e a esercitazione finita si confronta quello che è successo con quella promessa. Se il tempo è stato rispettato, la scuola ha una prova in più che il piano regge; se no, ha trovato il difetto in un giorno tranquillo invece che durante un incendio.
L’esercitazione si fa con la scuola vera, in orario di lezione, con i ragazzi veri: provata di sabato a scuola vuota direbbe che le porte si aprono, non che trecento persone ci passano in tre minuti. Ma il guasto finto tocca pochi: si fa trovare chiusa una scala a una classe sola, mentre tutte le altre escono come sempre, così la ressa nei corridoi è quella vera e, se qualcosa va storto, il problema resta confinato. C’è anche un modo di fermare tutto se va storto davvero. E si cambia l’evento, perché gli incendi non scelgono il momento comodo: un anno l’allarme suona mentre la scala principale è chiusa per lavori, un altro durante la ricreazione. Poi la si ripete, perché la scuola cambia (un’aula nuova, un corridoio chiuso) e il piano che reggeva l’anno scorso può non reggere più.
Con un servizio che risponde attraverso dei modelli si fa lo stesso. Si spegne apposta una replica, si fa rispondere piano un fornitore, si fa dire a un modello «troppe richieste», e lo si fa per una piccola parte delle richieste vere, mentre tutte le altre passano come sempre. Poi si guarda se i ripieghi scattano, se il limite di frequenza protegge, se i ritentativi restano dentro il loro tetto. La promessa con cui confrontare quello che succede è quella di sempre: la quota di richieste servite bene.
L’ingegneria del caos [BBdR+16] tratta la resilienza come un’ipotesi da falsificare con esperimenti controllati, e la riassume in quattro principi formulati sull’esperienza di Netflix. Si definisce uno stato stazionario come un’uscita misurabile del sistema che indica il funzionamento normale (a Netflix gli avvii di streaming al secondo; qui il goodput, o la conformità agli SLO su TTFT e ITL), e si ipotizza che resti tale sia nel gruppo di controllo sia in quello sperimentale. Si introducono variabili che riproducono eventi reali: la caduta di una replica, la latenza di una dipendenza, risposte 429 o 5xx da un fornitore, la revoca di un’istanza prerilasciabile, la perdita di una zona. Si eseguono gli esperimenti in produzione, perché solo lì il carico ha la sua distribuzione vera. E li si automatizza perché girino con continuità, dato che il sistema cambia e la confidenza guadagnata ieri invecchia. L’ipotesi è falsificata se lo stato stazionario differisce fra i due gruppi. Per contenere il rischio l’articolo limita l’esperimento a una piccola percentuale degli utenti; la pratica successiva ne ha fatto un principio, il raggio d’impatto minimo, con un arresto automatico legato allo stato stazionario.
Per un servizio che usa modelli, gli esperimenti che rendono di più sono quelli sui percorsi di recupero, perché sono quelli che il traffico normale non esercita mai: il circuit breaker si apre davvero sopra la soglia, il ripiego regge il traffico del primario oltre al proprio, il budget dei ritentativi tiene quando il primario restituisce solo errori, la revoca di un’istanza prerilasciabile non fa perdere le richieste in corso. I guasti metastabili spiegano perché serva la scala vera: la retroazione che li sostiene dipende dall’intensità del carico, e una prova in piccolo può non innescarla mai.
Un gateway, quindi, lascia il modello com’è e gli costruisce intorno le
condizioni per restare raggiungibile quando le cose vanno male. Limita chi
chiede troppo, ritenta senza moltiplicare, instrada a chi costa meno quando
basta, ripiega su una riserva provata, e registra abbastanza da capire che
cosa è successo. E ognuno di questi meccanismi va provato rompendo di proposito
le cose, perché è proprio il codice che gira solo nei giorni cattivi a
nascondere il break fuori posto.
Da ricordare
Il limite di frequenza è il distributore del museo: stampa biglietti a ritmo fisso e ne tiene una pila, così si entra in media al ritmo della stampa e si possono fare raffiche grandi quanto la pila. Con i modelli i biglietti sono token: si prendono per la risposta più lunga permessa e si restituiscono quelli avanzati. Un distributore per cliente, perché chi esagera svuoti solo la sua pila, e un tetto alle persone presenti, che rallenta gli ingressi da sé quando le sale si svuotano piano.
Ripetere un messaggio funziona quando il primo si è perso per caso; quando non si viene richiamati perché chiamano tutti, i messaggi ripetuti moltiplicano il lavoro e la ressa si mantiene da sola anche dopo che la causa è passata. Le difese sono aspettare sempre di più e ognuno un po’ a caso, un tetto ai messaggi ripetuti, l’avviso che chiude subito, e saltare i messaggi scaduti invece di richiamare chi non aspetta più.
Nella simulazione, dieci secondi di guasto con tre ritentativi lasciano il servizio a zero risposte utili cinque minuti dopo; con un tetto del 10% ai ritentativi si riprende, anche se più piano che senza ritentativi, e scartando i tentativi scaduti si riprende più in fretta di tutti.
Scegliere il modello prima di interrogarlo è il triage: costa poco e ogni tanto sbaglia. Provare prima il piccolo e passare al grande solo se serve è l’ambulatorio veloce che manda dallo specialista solo i casi che lo superano: decide meglio, e chi ci passa paga due visite. Il ripiego su un altro modello è un altro ospedale: ha i suoi protocolli, va provato prima, deve reggere anche i pazienti del primo e non deve dipendere dallo stesso centralino.
Per capire dove va il tempo di una risposta serve la sua traccia, il percorso cronometrato tratto per tratto come il tracciamento di un pacco, e non solo le medie del cruscotto; e ogni tratto dice se la richiesta era un secondo tentativo.
I meccanismi che servono nei giorni cattivi si provano rompendo le cose apposta, come un’esercitazione antincendio: con la scuola vera, facendo trovare il guasto a pochi mentre tutti gli altri escono come sempre, e confrontando il risultato con la promessa.
Da ricordare
Il token bucket di capienza \(b\) e ricarica \(r\) ammette al più \(b + r\,\Delta t\) di prelievi netti in ogni intervallo \(\Delta t\). Per un LLM il costo è \(N_{\text{in}} + N_{\text{out}}\): si preleva il maggiorante \(N_{\text{in}} + N_{\text{max}}\) e si restituisce l’avanzo, e sul costo reale il limite si allarga degli avanzi delle prenotazioni aperte. Secchi per cliente e per modello, su richieste e su token, danno l’isolamento; un limite \(L_{\max}\) sulle richieste in volo ammette in media \(L_{\max}/W\) richieste al secondo, e si stringe da sé quando il servente rallenta.
Con probabilità di fallimento \(p\) e \(k\) ritentativi i tentativi per richiesta sono \(A = (1-p^{k+1})/(1-p)\), che tende a \(k+1\) nel sovraccarico: la retroazione può rendere il guasto metastabile [BACZ21]. Difese: backoff esponenziale con jitter, budget di ritentativi (\(A \le 1{,}1\) con il 10%), circuit breaker [Nyg07], propagazione della scadenza. Il timeout di un modello generativo si scrive sul TTFT e sulla pausa fra token.
Il router sceglie prima di interrogare [OAW+25]; la cascata interroga in ordine e accetta con un punteggiatore [CZZ24b], con \(\mathbb{E}[C] = c_1 + (1-u_1)c_2 + \cdots\). Il fallback risponde alla disponibilità: va valutato come il primario, dimensionato per il traffico che eredita e indipendente nei guasti.
La traccia distribuita [SBB+10] scompone il TTFT nelle sue attese; per un LLM gli span portano modello, versione, token, colpi di cache e provenienza da ripiego o ritentativo.
L’ingegneria del caos [BBdR+16] falsifica un’ipotesi sullo stato stazionario (goodput, conformità agli SLO) introducendo eventi reali in produzione, su una piccola parte degli utenti e in modo continuo; rende di più sui percorsi di recupero, che il traffico normale non esercita.
Tutto il lavoro di mettere un modello davanti a molte persone, dalle repliche ai gateway, si misura alla fine in schede accese e in ore di calcolo. Quelle ore hanno anche un conto che non si paga in euro, e che quasi nessuno dichiara: Il conto in energia.