


Ricerca e pianificazione: l’albero dei futuri#
Una cassa di ingranaggi e contatti elettrici, in una sala di Parigi, nel 1914, gioca a scacchi da sola davanti al pubblico. Dentro non c’è nessuno, a differenza del famoso Turco, l’automa che più di un secolo prima aveva girato l’Europa con un giocatore in carne e ossa nascosto nel mobile. L’ha costruita due anni prima l’ingegnere spagnolo Leonardo Torres Quevedo, e riconosce da sé dove sono i pezzi, muove i propri e non ha bisogno di nessuno che le dica che cosa fare.
Gioca una situazione sola, e non è l’inizio della partita ma la sua coda, quella che negli scacchi si chiama finale: da una parte re e torre, dall’altra il re avversario e nient’altro. Ma lo gioca contro chiunque, da qualunque posizione, e lo scacco matto (il re avversario attaccato, senza nessun modo di sottrarsi) lo dà sempre. Non lo dà in fretta: ci mette più mosse del necessario, a volte più delle cinquanta senza catture oltre le quali il regolamento permette di chiedere la patta, cioè il pareggio; la macchina il regolamento non lo conosce, e al matto arriva lo stesso. Il modo in cui ci riesce è quello che ci interessa: non pensa avanti. Non immagina le mosse dell’avversario, non prova continuazioni, non valuta niente. Guarda dove sono i tre pezzi e applica una regola fissa, scritta a mano dentro gli ingranaggi, del tipo «se il re nemico sta in questa fascia, porta la torre una riga più in là». Quella regola esiste perché re e torre contro re è un problema abbastanza piccolo da avere una ricetta: qualcuno l’ha trovata, l’ha scritta, e la macchina la esegue.
Per la partita intera, di ricetta non ce n’è. Nessuno sa scrivere una regola che, guardando una posizione qualunque di scacchi, dica quale mossa fare. E allora bisogna fare l’altra cosa, quella che fa un giocatore umano davanti alla scacchiera: immaginare. Se muovo qui lui risponde là, e allora io potrei… Immaginare in modo ordinato è una delle idee fondanti dell’intelligenza artificiale, e ha un nome asciutto: ricerca. Un programma che cerca lavora senza bersaglio: non ha esempi da imitare, non impara niente, e tutta la sua forza sta nel guardare avanti fra le mosse possibili.
Guardata dal lato di quello che restituisce, cioè una sequenza di mosse da eseguire poi nell’ordine, la stessa faccenda si chiama pianificazione. I pianificatori in senso stretto descrivono il problema in un linguaggio apposito, con i fatti che valgono in uno stato e le condizioni e gli effetti di ogni azione; il motore che hanno sotto, però, è la stessa ricerca.
Gli stati, le mosse, e l’albero che ne esce#
Per immaginare in modo ordinato serve poco, e serve la stessa cosa per gli scacchi, per il navigatore satellitare e per quel rompicapo di plastica in cui si fanno scivolare delle tessere numerate dentro una cornice.
Serve dire in che situazione ci si trova, e quella descrizione si chiama stato: la posizione di tutti i pezzi sulla scacchiera, l’incrocio in cui ci si trova, la disposizione delle tessere. Serve dire che cosa si può fare, cioè quali mosse sono ammesse in quello stato e in quale stato portano. E serve sapere quando si è arrivati, cioè riconoscere lo stato di fine.
Da qui l’oggetto che nasce è sempre lo stesso. Dallo stato di partenza si dipartono tante linee quante sono le mosse possibili; da ciascuno degli stati che ne escono, altrettante; e così via. È un albero, la stessa forma degli alberi decisionali, e ogni punto che ci sta dentro è un nodo: uno stato, raggiunto per un cammino preciso. È un albero capovolto rispetto a quelli veri: la radice sta in cima, e in fondo, alla punta di ogni ramo, ci sono le foglie, i nodi da cui non si va più avanti (negli scacchi, le partite finite). Ogni cammino dalla radice a una foglia è un futuro possibile.
Prendi il rompicapo con le tessere numerate che scorrono in una cornice, quello in cui c’è una casella vuota e bisogna rimettere i numeri in ordine facendo scivolare una tessera per volta nel buco.
Lo stato è come stanno adesso le tessere. Le mosse sono le tessere che in questo momento confinano con la casella vuota, e sono due, tre o quattro a seconda di dove il buco si trova. Ogni mossa si può scrivere come una regola con un prima e un dopo: se il buco sta accanto al 7, il 7 ci può scivolare dentro, e dopo il buco sta dove stava il 7. Lo stato di fine è i numeri in ordine.
Adesso disegna, su un foglio e senza toccare il rompicapo: come restano le tessere dopo una mossa lo sai in anticipo, senza farla, e lo sai per tutte le mosse che vuoi. In cima metti la situazione di partenza. Sotto, un riquadro per ciascuna mossa che puoi fare: mettiamo che siano tre, e che restino tre a ogni riga. La riga dopo ne ha nove, quella dopo ancora ventisette, la quarta ottantuno. Dopo quattro righe hai disegnato centoventi riquadri e non sei arrivato da nessuna parte: la soluzione, per un rompicapo mescolato bene, sta una ventina di mosse più in basso.
E parecchi di quei riquadri sono lo stesso rompicapo disegnato due volte. Fai scivolare il 7 nel buco, poi rimettilo dov’era: le tessere stanno come stavano. Sul foglio però sono due riquadri lontani fra loro, e sotto a ciascuno ricominci da capo a disegnare tutto quello che viene dopo. Le situazioni davvero diverse in cui il rompicapo può trovarsi sono tante, ma sono un numero fisso. I riquadri sul foglio no: ogni situazione ne prende uno per ogni strada che ci arriva, e di strade se ne possono inventare quante si vuole.
Quel disegno è l’albero, e non lo si costruisce mai tutto. Se ne costruisce un pezzetto, si guarda, si decide da che parte continuare.
Un problema di ricerca è definito da cinque componenti: lo spazio degli stati \(\mathcal{S}\); lo stato iniziale \(s_0 \in \mathcal{S}\); l’insieme delle azioni ammesse \(\mathcal{A}(s)\) per ogni stato; una funzione di transizione \(\mathrm{ris}(s, a)\) che dice in quale stato si finisce; e un test di arrivo, che nei giochi si chiama test di terminazione. Se le azioni hanno costi diversi si aggiunge \(c(s, a, s')\), il costo del passo. Una soluzione è una sequenza di azioni che porta da \(s_0\) a uno stato che passa il test; il suo costo è la somma dei costi dei passi, e \(C^*\) indica il costo minimo fra tutte le soluzioni.
Qui gli stati sono atomici: l’algoritmo li genera e li confronta, ma non ne guarda la struttura. La pianificazione in senso stretto li descrive invece in forma fattorizzata: uno stato è l’insieme dei fatti che vi sono veri, e un’azione ha precondizioni, i fatti che devono valere per eseguirla, ed effetti, i fatti che aggiunge e quelli che toglie; il linguaggio di riferimento si chiama PDDL. Da quella descrizione il pianificatore ricava da solo stime indipendenti dal dominio, per esempio contando i passi di un problema in cui le precondizioni si ignorano [RN20], ma la ricerca che le usa è la stessa.
Dalla definizione di problema discende l’albero di ricerca, che non va confuso con lo spazio degli stati. Lo spazio degli stati è un grafo: uno stesso stato si può raggiungere per strade diverse, e la stessa posizione può ripresentarsi (la cosa ha un nome, trasposizione, e la sezione sui giochi ci torna). L’albero di ricerca è invece l’oggetto che l’algoritmo srotola: un suo nodo contiene uno stato, il nodo da cui viene e il costo \(g(n)\) del cammino fin lì, e due nodi diversi possono contenere lo stesso stato, uno per ogni cammino che ci arriva; se nello spazio ci sono cicli, l’albero è infinito. Anche il grafo cresce in modo esponenziale con la dimensione del problema: il rompicapo delle otto tessere ha 181.440 stati raggiungibili, quello delle quindici più di diecimila miliardi. L’albero lo supera di tanto quanto sono numerose le strade verso uno stesso stato.
Le due misure che governano tutto sono il fattore di ramificazione \(b\), cioè quante mosse ci sono in media in uno stato, e la profondità, che conviene distinguere in due: \(d\) è quella a cui sta la soluzione, \(m\) quella massima dell’albero. Un albero completo fino a profondità \(d\) ha circa \(b^d\) nodi: il costo non si somma di livello in livello, si moltiplica.
Perché l’albero esplode, e perché è il problema#
I numeri, qui, fanno la differenza fra un problema difficile e un problema che non si affronta affatto.
Negli scacchi, in una posizione tipica, le mosse legali sono circa trentacinque, e una partita dura in media un’ottantina di mosse contando quelle di tutti e due i giocatori. L’albero completo di una partita ha quindi qualcosa come trentacinque elevato a ottanta nodi [RN20]. Il conto delle cifre si fa in due righe, e accanto ci sta quello degli atomi dell’universo osservabile, che si stimano attorno a un 1 seguito da ottanta zeri.
albero = 35 ** 80   # trentacinque mosse a posizione, per ottanta mosse
atomi = 10 ** 80    # la stima degli atomi dell'universo osservabile
cifre_albero, cifre_atomi = len(str(albero)), len(str(atomi))
print(f"35^80 ha {cifre_albero} cifre e comincia con {str(albero)[0]}")
print(f"10^80 ne ha {cifre_atomi}: {cifre_albero - cifre_atomi} in meno")
35^80 ha 124 cifre e comincia con 3
10^80 ne ha 81: 43 in meno
Un 3 seguito da altre centoventitré cifre non è «tanto». È un numero che non ha riscontro fisico: se ogni atomo dell’universo fosse un calcolatore che esamina una posizione al secondo dal Big Bang a oggi, l’albero degli scacchi non sarebbe stato sfiorato.
Il problema, allora, è guardare pochissimo di quell’albero e decidere bene lo stesso. Le strade sono due. La prima è guardare nel posto giusto, e per farlo serve una stima di quanto manca alla fine, quella che si chiama euristica. La seconda è smettere di guardare dove non serve, e per farlo basta accorgersi che un ramo è già peggio di uno che si conosce, cioè potarlo.

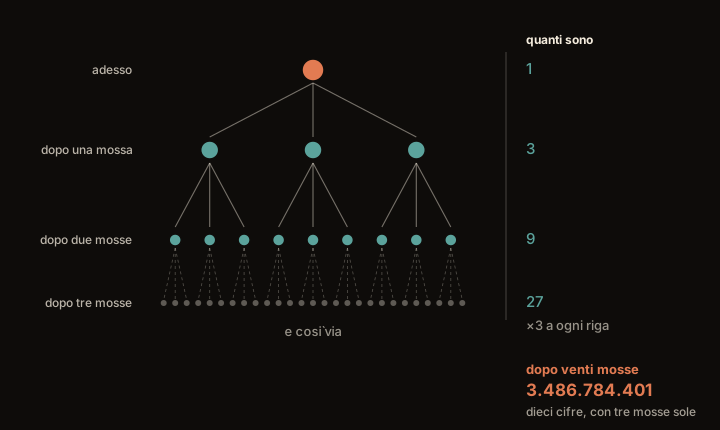
Fig. 12.1 Tre mosse per stato sono poche, e bastano. Il numero a destra non aumenta di tre a ogni riga: si moltiplica per tre, e dopo venti righe è un numero con dieci cifre. Con le trentacinque mosse degli scacchi e ottanta righe, le cifre diventano centoventiquattro.#
Il numero di destra in Fig. 12.1 è il motivo per cui nessun algoritmo di ricerca costruisce l’albero intero, salvo dove il gioco è abbastanza piccolo da permetterselo, come il tris: si sceglie quale pezzetto costruire.
Che cosa si sa del mondo#
Da qui in avanti una macchina non si limita a riconoscere quello che ha davanti: decide che cosa fare. Quello che può fare dipende da quanto sa del mondo e da quanto il mondo è grande, ed è la stessa domanda che separa la ricerca dal reinforcement learning, l’apprendimento per rinforzo.
Il mondo è noto, ed è piccolo. Si sa dove porta ogni mossa e quanto paga, e questo sapere ha un nome, il modello del mondo. Allora si possono passare in rassegna tutti gli stati e calcolare per ciascuno il suo valore, cioè quanto ci si può aspettare di guadagnare da lì in avanti giocando bene: se il mondo è un labirinto, si segna accanto a ogni casella quanto conviene trovarcisi. È la programmazione dinamica, e il reinforcement learning comincia da qui, nella sezione su MDP e funzioni valore.
Il mondo è noto, ed è enorme. Gli stati sono più di quanti se ne possano passare in rassegna, e allora si guarda in avanti dallo stato in cui ci si trova, lungo pochi rami scelti bene. Dove il fondo si raggiunge, come nel rompicapo delle tessere, ne esce il piano intero; dove non si raggiunge, come negli scacchi, ne esce la mossa da fare adesso, e alla mossa dopo si ricomincia. È il campo della ricerca in avanti.
Il mondo non è noto. Nessuno dice dove porta una mossa né quanto paga, e bisogna provare e vedere come va. È il reinforcement learning senza modello, quello dei metodi Monte Carlo e delle differenze temporali, a cui il capitolo sul reinforcement learning arriva dopo il caso a modello noto.
Dall’albero dei futuri alle sue potature#
La strada comincia da un mondo senza avversari, dove l’unico nemico è la dimensione: si cerca a tentoni, si misura quanto costa, e si introduce quello che cambia di più le proporzioni, una stima di quanto manca alla fine. Ne esce un algoritmo del 1968, A* (si legge «a stella»), con la condizione precisa che la stima deve rispettare perché non faccia sbagliare strada. È ancora oggi alla base della ricerca di percorsi, dai videogiochi ai navigatori, che lo affiancano a calcoli fatti in anticipo.
Poi dall’altra parte del tavolo si siede un avversario. Ne escono il modo di ragionare sui giochi a due, che si chiama minimax, la potatura che permette di ignorare interi rami senza guardarli, e il difetto di ogni ricerca che si ferma a una profondità fissa e lì deve giudicare la posizione a occhio, l’effetto orizzonte: il disastro che sta un passo oltre l’ultima mossa guardata. In fondo c’è un gioco di fiammiferi, il Nim, in cui quel difetto non esiste, perché chi vince si legge dalla posizione senza guardare avanti.
Alla fine si mettono in chiaro le ipotesi che la ricerca ha dato per scontate, e si tolgono una per volta: ognuna, mancando, porta a un metodo diverso, e la più grossa porta al capitolo sul reinforcement learning.
Da ricordare
La macchina di Torres Quevedo, che nel 1914 giocava a scacchi da sola, non pensava affatto: seguiva una regola scritta a mano, e poteva farlo perché il finale che giocava era abbastanza piccolo da avere una regola.
Per i problemi che una regola non ce l’hanno bisogna immaginare i futuri: da dove sono adesso, che cosa succede se faccio questa mossa, e poi quella, e poi quell’altra. I futuri immaginati formano un albero, in cui la stessa situazione ricompare in tanti punti diversi, uno per ogni strada che ci arriva.
L’albero esplode, e non per poco: guardando un passo più avanti il numero di futuri non aumenta di un po’, si moltiplica. Per gli scacchi si arriva a un numero di centoventiquattro cifre, cioè più di quaranta cifre in più di quante ne servano per contare gli atomi dell’universo.
Quindi l’albero, salvo nei giochi piccoli come il tris, non si costruisce mai tutto: si sceglie il pezzetto da costruire, guardando nel posto giusto con una stima di quanto manca (l’euristica) e smettendo di guardare dove non serve (la potatura).
Da ricordare
Un problema di ricerca è (stati, stato iniziale, azioni, transizione, test di arrivo), più eventualmente i costi; una soluzione porta dallo stato iniziale a uno che passa il test, e \(C^*\) è il costo minimo. Da lì discende l’albero di ricerca, quello che l’algoritmo srotola, i cui nodi sono stati raggiunti per un cammino preciso. Va distinto dal grafo dello spazio degli stati, che cresce già in modo esponenziale con la dimensione del problema: l’albero lo supera di quanto sono numerose le strade verso uno stesso stato.
Le due grandezze che governano il costo sono il fattore di ramificazione \(b\) e la profondità: un albero completo fino a \(d\) ha \(O(b^d)\) nodi. Per gli scacchi \(b \approx 35\) e una partita dura in media ottanta mosse dei due giocatori insieme, cioè \(35^{80} \approx 3 \cdot 10^{123}\), un numero di centoventiquattro cifre [RN20].
La ricerca è pianificazione a modello noto: si assume di poter interrogare la funzione di transizione quante volte si vuole, a costo nullo. È l’ipotesi che il capitolo sul reinforcement learning toglierà.
Rispetto alla programmazione dinamica di quel capitolo, che calcola il valore di tutti gli stati, qui si guarda in avanti dal solo stato corrente. Dove il fondo si raggiunge, come nel rompicapo, ne esce il piano intero; dove non si raggiunge, come nei giochi, ne esce la sola mossa da fare adesso, e il lavoro si rifà da capo alla mossa dopo.
Il pezzetto più piccolo che valga la pena costruire è quello che comincia adesso, ed è il problema del navigatore: trovare la strada più corta in un mondo che, mentre si cerca, sta fermo.