



Ortogonalità e proiezioni: la risposta migliore quando non ce n’è una esatta#
Dall’osservatorio di Palermo, nella prima notte dell’Ottocento, Giuseppe Piazzi punta il telescopio verso il Toro e nota un puntino che nelle carte non c’è. Lo segue fino all’11 febbraio, e in quelle poche settimane lo misura una ventina di volte, quasi sempre con le due coordinate che fissano un punto sulla volta celeste. Poi Piazzi si ammala, e l’astro (lo chiamerà Cerere) si avvicina al Sole fino a perdersi nel suo chiarore. Per ritrovarlo bisogna prevedere dove riemergerà, e per prevederlo bisogna ricavarne l’orbita da un arco di pochi gradi.
Un’orbita si descrive con sei numeri, e tre posizioni complete danno sei coordinate, quante ne servono. Il ventiquattrenne Carl Friedrich Gauss, nell’autunno del 1801, trova un modo di calcolare un’orbita da tre sole osservazioni, quelle del 2 e del 22 gennaio e dell’11 febbraio. Con tutte le misure, però, il problema è sovradeterminato: una ventina di posizioni danno quaranta equazioni circa per sei incognite, e nessuna orbita passa esattamente per tutti i punti osservati, perché ogni misura porta con sé il suo errore.
Gauss ritocca allora l’orbita finché gli scarti restano piccoli e non mostrano più alcuna regolarità. Nella nota in cui riassume il metodo, pubblicata solo nel 1809, riduce il ritocco a un sistema lineare in sei correzioni, e aggiunge che i valori più adatti si potrebbero trovare con una regola di calcolo, ma che «un certo tatto» guida con altrettanta sicurezza [Gau74]. Il 7 dicembre Franz Xaver von Zach, a Gotha, annota fra le stelline del campo proprio Cerere, anche se ne sarà certo solo il 31; la notte del primo gennaio 1802 la ritrova Wilhelm Olbers a Brema. Stava a meno di mezzo grado dal punto previsto.
In quella nota la regola non compare, e il metodo che si imporrà pochi anni dopo cambia la domanda: se nessuna orbita azzera gli scarti, si prende quella che rende minima la somma dei loro quadrati.
È il metodo dei minimi quadrati, pubblicato da Adrien-Marie Legendre nel 1805 e da Gauss nel 1809. Ha una forma geometrica semplice, che nelle due derivazioni originali non compare in primo piano: il minimo è un’ombra.
Perpendicolare: due direzioni che non si intralciano#
Il prodotto scalare \(\mathbf{u}^\top\mathbf{v}\), introdotto nella sezione sull’algebra lineare, misura quanto due vettori sono allineati; il caso in cui vale zero ha un nome, l’ortogonalità.
Se il prodotto scalare di due liste di numeri fa zero, le due frecce corrispondenti sono perpendicolari. Il nome tecnico è ortogonali, dal greco per «ad angolo retto»: spostarsi lungo una delle due non ti sposta di un millimetro lungo l’altra.
Ad esempio, sul foglio la freccia \((3, 0)\) punta a destra e la freccia \((0, 5)\) punta in alto, e il loro prodotto scalare fa \(3\cdot 0 + 0\cdot 5 = 0\). In altre parole, quanto vai a est e quanto vai a nord sono due calcoli separati, e ciascuno si fa senza guardare l’altro.
Si è tentati di concludere, sbagliando, che due grandezze misurate lungo direzioni perpendicolari non abbiano niente da dirsi. Prendi quattro punti sulla carta, \((-2,4)\), \((-1,1)\), \((1,1)\) e \((2,4)\). La colonna delle posizioni verso est (\(-2\), \(-1\), \(1\), \(2\)) è perpendicolare a quella delle posizioni verso nord (\(4\), \(1\), \(1\), \(4\)): il prodotto scalare fa \(-8-1+1+8=0\), e infatti la retta che meglio lega il nord all’est è piatta, non sale e non scende. Eppure il nord è deciso per intero dall’est, perché ne è il quadrato. Perpendicolare vuol dire che le due grandezze non vanno d’accordo in linea retta, non che fra loro non ci sia nessun legame.
Quando in un gruppo le direzioni sono tutte perpendicolari a due a due, e lunghe uno, il gruppo si dice ortonormale e diventa comodissimo, perché ogni direzione si interroga separatamente. In particolare, per sapere quanto di una certa direzione c’è dentro un vettore basta fare il prodotto scalare con quella direzione, senza sapere niente delle altre: gli assi di una carta stradale funzionano così, «quanto a est» si legge senza guardare «quanto a nord».
Con direzioni oblique il gioco si rompe. Se due assi formano un angolo di trenta gradi, chiedere «quanto ce n’è del primo?» dà una risposta che dipende da quanto ce n’è del secondo, e per districarli tocca risolvere un sistema. Ecco perché, quando si può scegliere, si scelgono assi perpendicolari, che fanno risparmiare quel sistema.
Un secondo motivo, meno ovvio, pesa di più quando a calcolare è una macchina. Girare la carta stradale, tenendo i due assi perpendicolari fra loro, non cambia nessuna distanza e nessun angolo: le città restano lontane quanto prima, e cambiano solo le loro coordinate. In generale, un cambio di assi perpendicolari non ingrandisce e non schiaccia nulla, quindi non amplifica gli errori di arrotondamento; per questo le librerie costruiscono con trasformazioni di questo tipo (rotazioni e riflessioni) i loro algoritmi di calcolo con le matrici.
Due vettori \(\mathbf{u},\mathbf{v}\in\mathbb{R}^n\) sono ortogonali se \(\mathbf{u}^\top\mathbf{v}=0\). Un insieme \(\{\mathbf{q}_1,\dots,\mathbf{q}_k\}\) è ortonormale se
dove \(\delta_{ij}\) è il simbolo di Kronecker. Un insieme ortonormale è sempre linearmente indipendente, poiché, prendendo il prodotto scalare di una combinazione nulla con \(\mathbf{q}_i\), resta \(c_i = 0\).
L’ortogonalità è una proprietà di vettori fissati. Per due variabili aleatorie centrate l’analogo è \(\mathbb{E}[XY]=0\), cioè covarianza nulla, e la sezione su probabilità e statistica mostra che non implica l’indipendenza: ad esempio, \(X\) simmetrica attorno a zero, con momento terzo finito, e \(Y=X^2\) sono incorrelate e legate da una funzione.
La comodità operativa sta tutta in una formula. Se \(\{\mathbf{q}_i\}\) è una base ortonormale di un sottospazio e \(\mathbf{v}\) appartiene a quel sottospazio, allora
cioè i coefficienti si leggono con un prodotto scalare ciascuno, invece di risolvere un sistema. Con una base qualunque \(\{\mathbf{a}_i\}\) i coefficienti sono la soluzione di \(\mathbf{A}\mathbf{c}=\mathbf{v}\), e costano \(\Theta(nk^2)\) contro i \(\Theta(nk)\) della formula precedente (per \(\mathbf{v}\in\mathbb{R}^n\)).
Una matrice quadrata \(\mathbf{Q}\) le cui colonne sono ortonormali si dice ortogonale e soddisfa \(\mathbf{Q}^\top\mathbf{Q}=\mathbf{I}\), quindi \(\mathbf{Q}^{-1}=\mathbf{Q}^\top\); in altri termini, l’inversa si ottiene trasponendo, senza calcoli. Le trasformazioni ortogonali conservano prodotti scalari, lunghezze e angoli (\(\lVert\mathbf{Q}\mathbf{x}\rVert_2 = \lVert\mathbf{x}\rVert_2\)), cioè sono rotazioni e riflessioni.
Sono anche perfettamente condizionate. Indicato con \(\kappa_2(\mathbf{A})=\sigma_{\max}/\sigma_{\min}\) il numero di condizionamento (il rapporto fra il massimo e il minimo allungamento), per una matrice ortogonale tutti i valori singolari valgono uno, e quindi \(\kappa_2(\mathbf{Q})=1\). Per questo le librerie costruiscono la QR e la SVD con matrici ortogonali.
Proiezione su una direzione: l’ombra di un vettore#
Nella sezione sui sistemi lineari una trasformazione proiettava lungo raggi paralleli qualsiasi. Se i raggi sono perpendicolari al sottospazio su cui si proietta, si ha la proiezione ortogonale: manda un vettore nel punto del sottospazio che gli è più vicino. Per una retta, è l’ombra che darebbe un sole a picco.
Tieni una matita obliqua sopra un tavolo, con il sole a picco. L’ombra sul tavolo è più corta della matita e sta tutta sul tavolo: è la parte della matita che il tavolo «vede». La parte che sparisce è quella verticale, perpendicolare al tavolo.
In generale, ogni vettore si spacca in modo unico in un pezzo che sta nella direzione scelta e in uno che le è perpendicolare, e i due pezzi non si parlano. Il primo si chiama proiezione, il secondo scarto (o residuo).
Usi già questo principio tutti i giorni senza saperlo. Hai misurato cinque volte la stessa cosa, e devi riassumere i cinque numeri in uno solo. La lista delle cinque misure è un vettore in uno spazio a cinque dimensioni; i vettori «tutte e cinque le misure uguali fra loro» formano una direzione sola, quella di \((1,1,1,1,1)\). Il numero unico che rappresenta meglio le cinque misure è il punto di quella direzione più vicino alla lista vera, cioè la sua ombra.
Il calcolo dà la media aritmetica; in altri termini, la media è l’ombra delle misure sulla direzione in cui sono tutte uguali. Lo scarto, la parte che l’ombra non registra, è la lista delle differenze fra ciascuna misura e la media, ed essendo perpendicolare a \((1,1,1,1,1)\) ha somma zero. Per questo gli scarti dalla media si compensano sempre, un fatto che di solito si impara come una curiosità e che qui diventa geometria.
Ne segue anche che la lunghezza al quadrato dello scarto è la somma dei quadrati delle differenze dalla media, la quantità che in statistica si chiama devianza (divisa per il numero di misure è la varianza). Media e devianza, che sembrano due nozioni separate, dicono l’una dove cade l’ombra e l’altra di quanto i dati ne sporgono.
Sia \(\mathbf{a}\neq\mathbf{0}\). La proiezione ortogonale di \(\mathbf{b}\) sulla retta generata da \(\mathbf{a}\) è
dove il coefficiente \(c=(\mathbf{a}^\top\mathbf{b})/(\mathbf{a}^\top\mathbf{a})\) si ricava imponendo che il residuo \(\mathbf{r}=\mathbf{b}-c\,\mathbf{a}\) sia ortogonale ad \(\mathbf{a}\):
La decomposizione \(\mathbf{b}=\operatorname{proj}_{\mathbf{a}}(\mathbf{b}) + \mathbf{r}\) è unica, e i due addendi sono ortogonali, quindi vale il teorema di Pitagora: \(\lVert\mathbf{b}\rVert^2 = \lVert\operatorname{proj}_{\mathbf{a}}(\mathbf{b})\rVert^2 + \lVert\mathbf{r}\rVert^2\).
In particolare, con \(\mathbf{a}=\mathbf{1}=(1,\dots,1)^\top\in\mathbb{R}^n\) si ottiene
cioè la media campionaria, e il residuo \(\mathbf{y}-\bar{y}\mathbf{1}\) ha per costruzione somma nulla. La sua norma al quadrato è \(\sum_i (y_i-\bar{y})^2 = n\,\hat{\sigma}^2\), con \(\hat{\sigma}^2\) la varianza calcolata dividendo per \(n\). La media è quindi il coefficiente della proiezione lungo \(\mathbf{1}\), e la varianza è la norma al quadrato del residuo divisa per \(n\). La sezione su probabilità e statistica le ritroverà per la via probabilistica, e i due calcoli danno gli stessi numeri.
import numpy as np

# cinque misure della stessa grandezza, in metri
y = np.array([2.03, 1.98, 2.05, 1.99, 2.00])
uno = np.ones(5)

c = (uno @ y) / (uno @ uno)      # la proiezione su (1,1,1,1,1)
print(c, y.mean())               # -> 2.01 2.01

r = y - c * uno                       # lo scarto, perpendicolare a uno
print(round(r.sum(), 12), round(uno @ r, 12))   # -> 0.0 0.0
print(round(r @ r, 10), round(5 * y.var(), 10))  # -> 0.0034 0.0034
I due arrotondamenti a dodici cifre servono perché la somma degli scarti non viene esattamente zero ma un numero dell’ordine di \(10^{-16}\), cioè il gradino più piccolo che la macchina sa scrivere accanto a \(2\), come spiega la sezione di analisi numerica.
Proiettare su un piano, e perché quella è la risposta migliore#
Una direzione sola basta di rado. Il caso che interessa è quello in cui le direzioni disponibili sono parecchie, e tutte le loro combinazioni formano un sottospazio, che nel linguaggio della sezione sui sistemi lineari è l’immagine di una matrice.


Fig. 3.6 Il vettore dei dati \(\mathbf{b}\) sporge fuori dal piano delle combinazioni possibili, e nessuna combinazione delle colonne lo raggiunge. Il punto del piano più vicino è la sua proiezione \(\mathbf{p}\), poiché qualunque altro punto del piano forma con \(\mathbf{b}\) l’ipotenusa di un triangolo rettangolo, e quindi dista di più.#
Torniamo al colorificio della sezione sui sistemi lineari, con una differenza: il colore del cliente non si può fare. I barattoli disponibili producono un repertorio di tinte, e quella richiesta ne sta fuori. Mandare via il cliente sarebbe scortese; la cosa sensata è scegliere, fra tutte le tinte che si possono preparare, quella che gli somiglia di più.
Fig. 3.6 disegna la scena. Il piano è il repertorio, la freccia che sporge è il colore chiesto, e la sua ombra a picco sul piano è la risposta. Che l’ombra sia il punto più vicino, e non un altro punto del piano, si vede con il teorema di Pitagora. Infatti, per un punto qualsiasi del repertorio diverso dall’ombra, la distanza dal colore chiesto è l’ipotenusa di un triangolo rettangolo che ha per cateto la distanza minima, ed è quindi più lunga.
Ne segue una regola pratica. Quando la soluzione migliore è stata trovata, l’errore che resta è perpendicolare a tutto ciò che si poteva fare. Se non lo fosse, l’errore avrebbe una componente lungo una direzione disponibile, e spostandosi un po” in quella direzione si farebbe meglio, segno che non si era ancora al minimo. Errore perpendicolare e minimo raggiunto sono quindi la stessa condizione.
La stessa geometria ha altre due conseguenze. La prima è che rifare l’ombra di un’ombra non cambia niente, perché l’ombra sta già distesa sul piano e la sua ombra è sé stessa.
La seconda riguarda una scelta finora implicita. Sommare i quadrati degli scarti, invece dei loro valori assoluti, è una decisione con una conseguenza: un errore doppio pesa quattro volte, quindi un solo dato molto sbagliato tira la risposta verso di sé molto più di dieci dati sbagliati di poco. In compenso i quadrati danno l’ombra, cioè una risposta con una formula chiusa e una geometria limpida, mentre i valori assoluti non hanno né l’una né l’altra.
In questo modo il problema dell’orbita di Cerere si chiude, rifatto con la regola dei quadrati. Finché i ritocchi sono piccoli, le orbite che si ottengono ritoccando quella di partenza stanno su un piano; le misure di Piazzi sono la freccia che sporge, e l’orbita migliore è la sua ombra: quella che lascia uno scarto perpendicolare a tutti i ritocchi possibili, cioè uno scarto che nessun ritocco può ridurre.
Sia \(\mathbf{A}\in\mathbb{R}^{m\times n}\) con \(m>n\) e \(\mathbf{b}\in\mathbb{R}^m\). Il sistema \(\mathbf{A}\mathbf{x}=\mathbf{b}\) è in generale incompatibile, e si sostituisce il problema di minimo
Teorema della proiezione. Il minimo si raggiunge quando il residuo \(\mathbf{r}=\mathbf{b}-\mathbf{A}\hat{\mathbf{x}}\) è ortogonale a \(\operatorname{im}(\mathbf{A})\), cioè a tutte le colonne insieme: \(\mathbf{A}^\top\mathbf{r}=\mathbf{0}\).
La condizione è sufficiente. Infatti, se \(\mathbf{r}\perp\operatorname{im}(\mathbf{A})\), per ogni \(\mathbf{x}\) vale \(\mathbf{A}\mathbf{x}-\mathbf{b}=\mathbf{A}(\mathbf{x}-\hat{\mathbf{x}})-\mathbf{r}\) con i due addendi ortogonali, quindi \(\lVert\mathbf{A}\mathbf{x}-\mathbf{b}\rVert_2^2=\lVert\mathbf{A}(\mathbf{x}-\hat{\mathbf{x}})\rVert_2^2+\lVert\mathbf{r}\rVert_2^2\ge\lVert\mathbf{r}\rVert_2^2\), con uguaglianza se e solo se \(\mathbf{A}\mathbf{x}=\mathbf{A}\hat{\mathbf{x}}\). Il minimo è dunque raggiunto, e il vettore \(\mathbf{A}\hat{\mathbf{x}}\) è unico.
La condizione è anche necessaria. La derivata di \(\lVert\mathbf{A}\mathbf{x}-\mathbf{b}\rVert_2^2\) in \(\hat{\mathbf{x}}\) lungo \(\mathbf{A}^\top\mathbf{r}\) vale \(-2\lVert\mathbf{A}^\top\mathbf{r}\rVert_2^2\), negativa se \(\mathbf{A}^\top\mathbf{r}\neq\mathbf{0}\), e allora un piccolo passo in quella direzione riduce l’errore. Sviluppando la condizione si ottengono le equazioni normali
e se \(\mathbf{A}\) ha rango pieno per colonne, \(\mathbf{A}^\top\mathbf{A}\) è invertibile e la soluzione è unica: \(\hat{\mathbf{x}} = (\mathbf{A}^\top\mathbf{A})^{-1}\mathbf{A}^\top\mathbf{b}\). La proiezione stessa si scrive \(\mathbf{p}=\mathbf{P}\mathbf{b}\) con
matrice che soddisfa \(\mathbf{P}^2=\mathbf{P}\) (proiettare due volte è come proiettare una volta) e \(\mathbf{P}^\top=\mathbf{P}\), le due proprietà che caratterizzano i proiettori ortogonali.
La stessa condizione si ricava anche per via analitica, annullando il gradiente di \(\lVert\mathbf{A}\mathbf{x}-\mathbf{b}\rVert^2\), e le due strade coincidono, poiché la condizione \(\nabla_{\mathbf{x}}\lVert\mathbf{A}\mathbf{x}-\mathbf{b}\rVert^2 = 2\mathbf{A}^\top(\mathbf{A}\mathbf{x}-\mathbf{b}) = \mathbf{0}\) dà letteralmente l’ortogonalità del residuo. Il gradiente arriva nella sezione su analisi e ottimizzazione; l’identità fra «gradiente nullo» e «residuo perpendicolare a tutto ciò che è raggiungibile» è una delle corrispondenze più usate.
Perché i quadrati? Con errori gaussiani indipendenti a varianza costante sono la stima di massima verosimiglianza (la sezione su da dove viene la loss lo ricava), e con errori incorrelati a media nulla e varianza costante danno lo stimatore lineare non distorto di varianza minima (teorema di Gauss-Markov).
Se il rango non è pieno, la soluzione di minimo esiste ancora ma non è unica:
le soluzioni differiscono per elementi di \(\ker(\mathbf{A})\), e la convenzione
è scegliere quella di norma minima (ciò che restituisce numpy.linalg.lstsq).
Il minimo dei quadrati è però una scelta, non un obbligo: minimizzare la somma dei valori assoluti stima una mediana condizionata invece di una media, ed è meno sensibile ai valori anomali, come spiega la stessa sezione su da dove viene la loss.
Nel problema di Cerere le equazioni non sono lineari nei sei elementi dell’orbita. Si linearizza quindi attorno all’orbita di partenza, si risolve ai minimi quadrati il sistema lineare per le correzioni e si ripete con l’orbita corretta. Il procedimento prende il nome di metodo di Gauss–Newton.
Con questa lettura la regressione lineare, la retta che meglio lega una grandezza a un’altra, smette di essere una formula da ricordare.
Consideriamo, ad esempio, cinque appartamenti di cui si conoscono i metri quadri e il prezzo. Ogni retta è una combinazione di due colonne, quella tutta di uni (che dà l’intercetta, il punto di partenza della retta) e quella dei metri quadri (che dà la pendenza), e la migliore si trova risolvendo le equazioni normali \(\mathbf{A}^\top\mathbf{A}\hat{\mathbf{x}}=\mathbf{A}^\top\mathbf{b}\), cioè la perpendicolarità del residuo scritta come sistema.
import numpy as np
mq     = np.array([55., 70., 85., 100., 120.])
prezzo = np.array([148., 182., 210., 250., 290.])   # migliaia di euro

# due colonne: la costante e i metri quadri. Le loro combinazioni sono
# tutte e sole le rette del piano (mq, prezzo).
A = np.column_stack([np.ones(5), mq])

coef = np.linalg.solve(A.T @ A, A.T @ prezzo)       # equazioni normali
print(np.round(coef, 4))                            # -> [26.9339  2.1984]

residuo = prezzo - A @ coef
print(np.round(A.T @ residuo, 10))   # perpendicolare alle colonne -> [0. 0.]
print(np.round(residuo, 3))          # -> [ 0.152  1.175 -3.802  3.222 -0.747]
La retta trovata dice che un appartamento parte da circa ventisettemila euro e ne guadagna circa duemiladuecento per metro quadro. La verifica che conta è il prodotto \(\mathbf{A}^\top\mathbf{r}\). Il residuo, moltiplicato per le due colonne, dà zero in tutte e due le direzioni, e quello zero dice che nessuna modifica dei due coefficienti potrebbe ridurre l’errore.
Rendere perpendicolari le colonne: Gram-Schmidt e QR#
Le equazioni normali sono la formula con cui si capisce il problema. Per calcolare si preferisce di norma un’altra strada, perché elevano al quadrato il numero di condizionamento di \(\mathbf{A}\).
Il problema è quello degli assi obliqui, portato all’estremo. Se due colonne puntano quasi nella stessa direzione (i metri quadri e il numero di stanze di un appartamento, che crescono insieme), distinguere il contributo dell’una da quello dell’altra diventa un esercizio di equilibrismo. Basta infatti uno spostamento minimo dei dati perché le due dosi cambino tantissimo pur dando quasi lo stesso risultato.
C’è un numero che misura questo equilibrismo, il numero di condizionamento, e più è grande più i conti sono delicati. Le equazioni normali, però, non lavorano sulla tabella dei dati ma su un’altra, ottenuta moltiplicandola per sé stessa con righe e colonne scambiate (la sua trasposta), e in quel passaggio il numero viene elevato al quadrato, per cui un problema un po” delicato diventa molto delicato, e uno molto delicato diventa impossibile. Sull’esempio degli appartamenti si passa da circa trecentocinquanta a più di centoventimila.
Il rimedio è doppio. La prima parte è una precauzione senza spesa: togliere a ogni colonna di dati la propria media, e se serve dividerla per la propria scala. La colonna tutta di uni, quella che dà il punto di partenza della retta, si lascia stare, perché centrata diventerebbe tutta di zeri; le altre sì, e in questo esempio ce n’è una sola. La colonna dei metri quadri vale attorno a ottanta, quella degli uni vale uno, e già solo questa sproporzione fa danni: centrare i metri quadri porta il numero da trecentocinquanta a ventitré.
La seconda parte è più profonda e consiste nel raddrizzare le colonne prima di usarle. Si prende la prima direzione così com’è; alla seconda si toglie la sua ombra sulla prima, e quel che resta è perpendicolare alla prima; alla terza si tolgono le ombre sulle prime due, e così via. Alla fine si hanno direzioni perpendicolari che descrivono lo stesso repertorio di prima, e su assi perpendicolari l’equilibrismo sparisce.
Questo procedimento porta il nome di Gram e Schmidt. Il suo risultato, scritto come prodotto di una matrice a colonne perpendicolari per una a scaletta, si chiama scomposizione QR, e le librerie serie la calcolano con un altro procedimento, meno soggetto agli errori.
Il procedimento di Gram-Schmidt trasforma una base \(\{\mathbf{a}_1,\dots,\mathbf{a}_n\}\) in una base ortonormale \(\{\mathbf{q}_1,\dots,\mathbf{q}_n\}\) dello stesso sottospazio:
dove la sommatoria toglie ad \(\mathbf{a}_k\) le sue proiezioni su tutte le direzioni già ortonormalizzate. Raccogliendo i coefficienti si ottiene la scomposizione QR
con \(\mathbf{Q}\in\mathbb{R}^{m\times n}\) a colonne ortonormali e \(\mathbf{R}\in\mathbb{R}^{n\times n}\) triangolare superiore. Sostituendo nelle equazioni normali, \(\mathbf{Q}^\top\mathbf{Q}=\mathbf{I}\) fa collassare tutto in
un sistema triangolare che si risolve per sostituzione all’indietro in \(\Theta(n^2)\).
Il costo dominante è quindi la fattorizzazione: circa \(2mn^2-\tfrac23 n^3\) operazioni con le riflessioni di Householder, contro circa \(mn^2+\tfrac13 n^3\) delle equazioni normali risolte con la fattorizzazione di Cholesky [GVL13]; per \(m\gg n\) la QR costa il doppio, e in cambio non eleva al quadrato il condizionamento. La SVD costa di più, e rivela il rango.
Il motivo per preferire la QR sta nel condizionamento. Per una matrice a rango pieno per colonne
perché i valori singolari di \(\mathbf{A}^\top\mathbf{A}\) sono i quadrati di quelli di \(\mathbf{A}\). Formare esplicitamente il prodotto raddoppia quindi le cifre perse, mentre la via QR lavora su \(\mathbf{A}\) e ha condizionamento \(\kappa_2(\mathbf{R})=\kappa_2(\mathbf{A})\); l’errore sulla soluzione cresce come \(\kappa_2(\mathbf{A})\) quando il residuo è piccolo e come \(\kappa_2(\mathbf{A})^2\tan\theta\), con \(\theta\) l’angolo fra \(\mathbf{b}\) e l’immagine di \(\mathbf{A}\), quando non lo è [Hig02]. La sezione di analisi numerica spiega che cosa quella grandezza misura e perché le cifre si perdono.
In pratica, numpy.linalg.lstsq non forma mai
\(\mathbf{A}^\top\mathbf{A}\), e usa la decomposizione ai valori singolari, che è
ancora più cauta. Si noti che il condizionamento di \(\mathbf{A}\) dipende anche
dalle unità di misura: scalare le colonne a norma unitaria è quasi ottimo fra
le scalature diagonali
(per il teorema di van der Sluis, \(\kappa_2\) resta entro un fattore \(\sqrt n\)
dal minimo), e centrare le colonne dei dati riparametrizza l’intercetta senza
cambiare le predizioni.
Il Gram-Schmidt nella forma data (detto classico) perde l’ortogonalità in aritmetica finita in proporzione a \(\kappa_2(\mathbf{A})^2\varepsilon\), con \(\varepsilon\) la precisione di macchina; la variante modificata, che sottrae una proiezione per volta aggiornando ogni volta il vettore, è algebricamente identica e perde in proporzione a \(\kappa_2(\mathbf{A})\varepsilon\); le riflessioni di Householder, usate dalle librerie, conservano l’ortogonalità a meno di un multiplo di \(\varepsilon\) [Hig02].
import numpy as np
# continua dal blocco precedente (mq, prezzo, A)
# lo stesso conto per tre strade, e il prezzo delle equazioni normali
Q, R = np.linalg.qr(A)
print(np.round(np.linalg.solve(R, Q.T @ prezzo), 4))    # -> [26.9339  2.1984]
print(np.round(np.linalg.lstsq(A, prezzo, rcond=None)[0], 4))  # idem

print(round(np.linalg.cond(A), 1))            # il condizionamento di A
print(round(np.linalg.cond(A.T @ A), 1))      # e quello di A^T A, il suo quadrato

# centrare la colonna dei metri quadri costa una riga e cambia tutto
A_centrata = np.column_stack([np.ones(5), mq - mq.mean()])
print(round(np.linalg.cond(A_centrata), 3))

# e scalare le colonne a norma uno, prima e dopo averle centrate
norma_uno = lambda M: M / np.linalg.norm(M, axis=0)
print(round(np.linalg.cond(norma_uno(A)), 1),
      round(np.linalg.cond(norma_uno(A_centrata)), 1))
[26.9339  2.1984]
[26.9339  2.1984]
348.9
121756.6
22.672
7.7 1.0
Le tre strade danno la stessa retta. Il condizionamento di \(\mathbf{A}\) vale \(348{,}9\) e nelle equazioni normali diventa più di centoventimila; centrare i metri quadri lo porta a \(22{,}7\), scalare le colonne a norma uno a \(7{,}7\), e le due cose insieme a \(1\), perché le due colonne centrate sono ortogonali.
Tenere le prime direzioni, e sapere quanto si perde#
Nel 1936 Carl Eckart e Gale Young pubblicano su Psychometrika, una rivista di misurazione psicologica, un teorema che a loro serviva per l’analisi fattoriale, il metodo con cui gli psicologi riassumono i punteggi di molti test in pochi fattori [EY36]. Oggi questo teorema è alla base della riduzione delle dimensioni, del modo in cui si decide quante direzioni di una tabella contano davvero, e di ogni stima di quanto si perde comprimendo. Erhard Schmidt lo aveva dimostrato ventinove anni prima, in tedesco e per le equazioni integrali [Sch07b], e per questo il teorema porta anche il suo nome.
Il teorema dice che, quando di una tabella si può tenere solo un pezzo, esiste un pezzo migliore di tutti gli altri; e dice, prima ancora di costruirlo, quanto si sbaglia a tenere quello.
Il problema è quello lasciato aperto dalla sezione sui sistemi lineari, dove una matrice di rango basso si riscriveva come il passaggio attraverso un collo di bottiglia di poche dimensioni. Nei dati veri il collo di bottiglia esatto non c’è quasi mai: c’è una matrice in cui poche direzioni contano molto e le altre quasi niente. Data \(\mathbf{A}\) di rango \(r\) e un intero \(k<r\), ci chiediamo quindi qual è la matrice \(\mathbf{B}\) di rango al più \(k\) più vicina ad \(\mathbf{A}\), e a che distanza sta.
La risposta passa per la decomposizione ai valori singolari, che scrive \(\mathbf{A}=\sum_i\sigma_i\mathbf{u}_i\mathbf{v}_i^\top\), somma di matrici di rango uno pesate dai valori singolari \(\sigma_i\). La matrice più vicina tiene i primi \(k\) termini, quelli con i valori singolari maggiori, e scarta gli altri. Non è ovvio che sia così, poiché le matrici di rango \(k\) sono infinite, e nulla garantisce a priori che la più vicina ad \(\mathbf{A}\) si ottenga troncando questa somma. L’errore, poi, si legge nei valori singolari scartati: \(\sqrt{\sum_{i>k}\sigma_i^2}\) in norma di Frobenius, \(\sigma_{k+1}\) in norma spettrale.
Il colorificio ha allargato il catalogo: sul cartoncino ci sono quaranta tinte, e ognuna è una ricetta scritta sui dodici barattoli del magazzino. È una tabella con una riga per tinta e una colonna per barattolo.
Sullo scaffale del laboratorio, però, ci stanno due barattoli soli. Il titolare non sceglie due dei dodici, che sarebbe una scelta povera: fa preparare due premiscele, ciascuna con la sua dose fissa di tutti e dodici, e d’ora in poi ogni tinta del catalogo si otterrà dosando solo quelle due. Nessuna delle quaranta verrà più esatta, e il titolare vuole sapere due cose: quali premiscele, e quanto sbaglieranno le tinte.
Il procedimento ricava le premiscele e ne consegna cinque, tante quante sono le direzioni indipendenti del catalogo, in ordine di importanza. Ognuna porta un’etichetta con il suo peso, un numero da leggere che non ha niente a che vedere con i pesi che si regolano in una rete. Il peso misura due cose insieme: quanta parte del catalogo quella premiscela spiega, e di quanto ogni litro versato sposta il colore. Le etichette dicono \(10\), \(6\), \(2\), \(0{,}5\) e \(0{,}2\): un litro della prima muove le tinte cinquanta volte più di un litro dell’ultima.
Il titolare mette sullo scaffale le prime due e rimanda indietro le altre tre; nessun’altra coppia, comunque mescolata, avvicinerebbe il catalogo più di questa. Quanto sbaglierà lo legge prima di aprire un barattolo, sulle etichette rimandate indietro, che dicono \(2\), \(0{,}5\) e \(0{,}2\): le eleva al quadrato (\(4\), \(0{,}25\) e \(0{,}04\)), le somma e prende la radice, come nel teorema di Pitagora con più di due lati. Vengono \(2{,}07\).
Lo stesso calcolo su tutte e cinque le etichette dà la grandezza dell’intero catalogo, \(11{,}84\), e il rapporto fra i due dice che con due barattoli invece di cinque si sbaglia del diciassette e mezzo per cento. Anche la tinta più sfortunata ha un tetto: nessuna sbaglia più dell’etichetta più alta fra quelle rimandate indietro, cioè più di \(2\).
Il garzone che per fretta tiene la prima e la terza rimanda indietro il \(6\), lo \(0{,}5\) e lo \(0{,}2\), quindi Pitagora dà poco più di \(6\) e lo sbaglio quasi triplica. Sullo sbaglio complessivo l’ordine delle etichette lascia in sospeso un caso solo, due etichette con lo stesso numero: allora nessuno decide quale delle due premiscele tenere, e vanno bene tutte e due.
Quel catalogo, però, era fatto apposta per essere compresso. Se le cinque etichette dicessero tutte \(3\), ad esempio, rimandarne indietro tre lascerebbe uno sbaglio di più del settantasette per cento, e la risposta onesta al titolare sarebbe che gli servono cinque barattoli.
L’altro limite è più insidioso, perché il calcolo riesce lo stesso e il risultato non serve. Il procedimento rende piccolo lo sbaglio di tutto il catalogo, e va bene finché le tinte contano uguale. Se però una è il colore del marchio di un cliente e deve venire perfetta, la coppia migliore è un’altra, e il procedimento non la trova. Lo stesso succede quando del catalogo si conosce solo un pezzo, con delle caselle lasciate in bianco, perché le etichette andrebbero calcolate su qualcosa che non si ha.
Sia \(\mathbf{A}\in\mathbb{R}^{m\times n}\) di rango \(r\), con decomposizione ai valori singolari \(\mathbf{A} = \mathbf{U}\boldsymbol{\Sigma}\mathbf{V}^\top\). Scrivendo \(\mathbf{u}_i\) e \(\mathbf{v}_i\) per le colonne di \(\mathbf{U}\) e \(\mathbf{V}\), cioè per i vettori singolari sinistri e destri (ortonormali, perché le due matrici sono ortogonali), la stessa decomposizione si legge come somma di \(r\) termini di rango uno,
ed è questa la scrittura che serve qui. Per \(k<r\) si chiami troncamento di rango \(k\) la somma parziale \(\mathbf{A}_k = \sum_{i\le k} \sigma_i\,\mathbf{u}_i\mathbf{v}_i^\top\), che ha rango esattamente \(k\) perché \(\mathbf{A}_k\mathbf{v}_j = \sigma_j\mathbf{u}_j\) per \(j\le k\), cioè la sua immagine contiene \(k\) vettori indipendenti.
Teorema di Schmidt-Eckart-Young-Mirsky. Per ogni \(\mathbf{B}\) con \(\operatorname{rank}(\mathbf{B})\le k\),
dove \(\lVert\cdot\rVert_F\) è la norma di Frobenius (la radice della somma dei quadrati di tutti gli elementi) e \(\lVert\cdot\rVert_2\) la norma spettrale, cioè l’allungamento massimo. Eckart e Young dimostrano il caso di Frobenius [EY36]; Mirsky, nel 1960, mostra che lo stesso \(\mathbf{A}_k\) minimizza qualunque norma invariante per trasformazioni ortogonali [Mir60], cioè che il troncamento non è una risposta legata a un modo particolare di misurare l’errore.
L’unicità invece dipende dalla norma, e le due non vanno confuse. In norma di Frobenius il minimo è unico se e solo se \(\sigma_k > \sigma_{k+1}\): a valori singolari pari il sottospazio da tenere non è determinato. In norma spettrale i minimi sono quasi sempre infiniti, perché conta solo il residuo più grande. Ad esempio, per \(\mathbf{A} = \operatorname{diag}(2,1)\) e \(k=1\) ogni \(\mathbf{B} = \operatorname{diag}(c,0)\) con \(c\in[1,3]\) ha rango uno e lascia \(\lVert\mathbf{A}-\mathbf{B}\rVert_2 = 1 = \sigma_2\), mentre in Frobenius solo \(c=2\) è ottimo.
Per la norma spettrale la dimostrazione è un conteggio di dimensioni, e mostra da dove venga \(\sigma_{k+1}\). Se \(\operatorname{rank}(\mathbf{B})\le k\) allora \(\dim\ker(\mathbf{B})\ge n-k\); lo span di \(\mathbf{v}_1,\dots,\mathbf{v}_{k+1}\) ha dimensione \(k+1\); poiché \((n-k)+(k+1)>n\), la formula di Grassmann (\(\dim(U\cap W)\ge\dim U+\dim W-n\)) dà un’intersezione non banale, e ne prendiamo un vettore unitario \(\mathbf{w}\). Allora \((\mathbf{A}-\mathbf{B}) \mathbf{w} = \mathbf{A}\mathbf{w}\), e siccome \(\mathbf{w}\) appartiene allo span dei primi \(k+1\) vettori singolari destri, che sono ortonormali, per l’identità di Parseval \(\sum_{i\le k+1}(\mathbf{v}_i^\top\mathbf{w})^2 = \lVert\mathbf{w}\rVert_2^2 = 1\), e quindi
D’altra parte, \(\lVert\mathbf{A}-\mathbf{B}\rVert_2 \ge \lVert(\mathbf{A}-\mathbf{B}) \mathbf{w}\rVert_2\) per definizione di norma spettrale; pertanto nessuna matrice di rango \(k\) scende sotto \(\sigma_{k+1}\), e il troncamento raggiunge proprio questo valore.
Ne discende anche un controllo riga per riga, utile quando le righe sono i casi di una tabella: la riga \(j\)-esima di \(\mathbf{A}-\mathbf{A}_k\) ha norma \(\lVert(\mathbf{A}-\mathbf{A}_k)^\top\mathbf{e}_j\rVert_2 \le \lVert\mathbf{A}-\mathbf{A}_k\rVert_2 = \sigma_{k+1}\), dove \(\mathbf{e}_j\) è il vettore che vale uno nella posizione \(j\) e zero altrove.
Da qui discendono tre fatti che tornano di continuo. La PCA è il troncamento della decomposizione della matrice dei dati centrata per colonne. I vettori singolari destri di \(\mathbf{X}\) sono gli autovettori di \(\mathbf{X}^\top\mathbf{X}\), cioè della covarianza campionaria a meno di un fattore costante (che non cambia gli autovettori); la strada spettrale e quella dei valori singolari danno quindi gli stessi assi, e la sezione sulla riduzione di dimensionalità percorre la prima. Senza il centraggio si ottiene invece il migliore sottospazio passante per l’origine, che in generale è un altro.
Il rango numerico è lo stesso troncamento letto al contrario: azzerare i \(\sigma_i\) sotto una soglia \(\tau\) significa sostituire \(\mathbf{A}\) con il troncamento che dista da essa meno di \(\tau\) in norma spettrale (in Frobenius la distanza è \(\sqrt{\sum_{i>k}\sigma_i^2}\) e può superare \(\tau\) quanto si vuole).
Infine, un collo di bottiglia lineare addestrato su un errore quadratico ha in \(\mathbf{A}_k\) il proprio ottimo globale. La forma della superficie attorno a quell’ottimo è un fatto in più, e si deve a Baldi e Hornik [BH89]. Il loro risultato poggia su due ipotesi, la covarianza di rango pieno e i suoi autovalori tutti distinti. Gli autori le danno per poco restrittive, e nel 1989 lo erano. Su quella superficie non ci sono minimi locali spuri, perché ogni altro punto critico è una sella, cioè un punto da cui si scende in una direzione e si sale in un’altra.
La soluzione è determinata solo a meno di un cambio di base nello spazio compresso di mezzo, il latente, \(\mathbf{W}_2 = \mathbf{V}_k\mathbf{C}\) e \(\mathbf{W}_1 = \mathbf{C}^{-1}\mathbf{V}_k^\top\) con \(\mathbf{C}\) invertibile qualunque. Un autoencoder lineare ritrova quindi il sottospazio della PCA e non i suoi assi.
Non ne segue che la discesa del gradiente raggiunga l’ottimo, e gli autori lo scrivono: una superficie senza minimi locali lascia comunque il modo di incagliarsi in una sella. Aggiungono però che in pratica non capita quasi mai, perché la direzione calcolata su pochi campioni non è il gradiente vero. Si noti che oggi l’ipotesi del rango pieno cade spesso: ogni volta che i casi sono meno delle caratteristiche, e anche quando i casi bastano ma le direzioni vere sono poche, come in una matrice di quaranta righe e dodici colonne che ha cinque valori singolari non nulli.
Il troncamento ha due limiti precisi. Se lo spettro non decade il teorema resta vero e diventa inutile: con tutti i \(\sigma_i\) uguali l’errore relativo del troncamento è \(\sqrt{(r-k)/r}\), cioè quasi tutto. Inoltre il teorema vale per la norma di Frobenius su tutte le celle; se la somma corre su un sottoinsieme di celle (le sole osservate) o pesa le celle in modo diverso, il minimo smette di essere il troncamento e il problema perde la soluzione in forma chiusa. È la ragione per cui la fattorizzazione delle matrici di valutazioni si stima per discesa del gradiente invece che con una decomposizione, come racconta la sezione sul filtraggio collaborativo.
Per mettere alla prova il teorema costruiamo una matrice di cui si conoscono in anticipo i valori singolari, e verifichiamo che l’errore del troncamento cada dove previsto.
import numpy as np
rng = np.random.default_rng(0)

# quaranta tinte, dodici pigmenti, cinque premiscele di peso deciso
pesi = np.array([10.0, 6.0, 2.0, 0.5, 0.2])
U0, _ = np.linalg.qr(rng.normal(size=(40, 5)))
V0, _ = np.linalg.qr(rng.normal(size=(12, 5)))
C = U0 @ np.diag(pesi) @ V0.T

U, s, Vt = np.linalg.svd(C, full_matrices=False)
# il segno dei vettori singolari dipende dalla libreria: lo si fissa (la
# componente più grande di ogni u_i positiva), così i sorteggi sono gli stessi
segni = np.sign(U[np.abs(U).argmax(axis=0), np.arange(U.shape[1])])
U, Vt = U * segni, Vt * segni[:, None]
print(np.round(s[:6], 6))            # -> [10.  6.  2.  0.5 0.2 0. ]

k = 2
C_k = (U[:, :k] * s[:k]) @ Vt[:k]
print(round(np.linalg.norm(C - C_k, 'fro'), 4),
      round(np.sqrt((s[k:] ** 2).sum()), 4))          # -> 2.0712 2.0712
print(round(np.linalg.norm(C - C_k, 2), 4), round(s[k], 4))   # -> 2.0 2.0
print(round(np.linalg.norm(C - C_k, axis=1).max(), 4))        # -> 0.8463
print(round(np.linalg.norm(C, 'fro'), 4))                     # -> 11.8444

# tenere la prima e la terza invece delle prime due
sel = [0, 2]
print(round(np.linalg.norm(C - (U[:, sel] * s[sel]) @ Vt[sel], 'fro'), 4))

# duemila vicine di rango 2, sempre più vicine: nessuna sotto 2.0712
B0, D0 = U[:, :k] * s[:k], Vt[:k]
for eps in (0.05, 0.01, 0.001):
    print(eps, round(min(np.linalg.norm(
        C - (B0 + eps * rng.normal(size=B0.shape))
          @ (D0 + eps * rng.normal(size=D0.shape)), 'fro')
        for _ in range(2000)), 4))

# lo stesso troncamento su uno spettro piatto
Z = U0 @ np.diag(np.full(5, 3.0)) @ V0.T
Uz, sz, Vtz = np.linalg.svd(Z, full_matrices=False)
Z_k = (Uz[:, :k] * sz[:k]) @ Vtz[:k]
print(round(np.linalg.norm(Z - Z_k, 'fro') / np.linalg.norm(Z, 'fro'), 4),
      round(np.linalg.norm(C - C_k, 'fro') / np.linalg.norm(C, 'fro'), 4))
[10.   6.   2.   0.5  0.2  0. ]
2.0712 2.0712
2.0 2.0
0.8463
11.8444
6.0241
0.05 2.3676
0.01 2.0836
0.001 2.0714
0.7746 0.1749
L’errore complessivo coincide con la radice della somma dei quadrati dei valori singolari scartati, e quello sulla riga peggiore sta sotto \(\sigma_{k+1}\). Tenere la prima e la terza direzione invece delle prime due lo triplica quasi, e nessuna delle duemila alternative vicine scende sotto il minimo: più si avvicinano alla coppia migliore, più il loro errore si stringe verso quello.
Con i valori singolari tutti uguali, invece, due direzioni su cinque perdono il \(77{,}5\%\) della matrice contro il \(17{,}5\%\) dello spettro decrescente: lì non c’è niente da comprimere.
Quando le soluzioni ugualmente buone sono più di una#
Finora il minimo dei quadrati aveva una soluzione sola. C’è però un caso in cui ne ha infinite, e capita ogni volta che le colonne di \(\mathbf{A}\) sono linearmente dipendenti: ad esempio, una grandezza misurata due volte in unità diverse, un totale registrato accanto ai suoi addendi, una variabile indicatrice per ogni categoria più l’intercetta. Nei dati veri è frequente, e ancora più frequente è la sua versione approssimata. Un metodo che davanti a infinite risposte si ferma non serve a niente; ne serve uno che ne scelga una e dica quale.
Che cosa si risponde a un cliente quando le ricette che vanno bene sono più di una? Al bancone succede per un difetto di magazzino: due dei barattoli sono in realtà lo stesso colore, comprati da due fornitori diversi. Allora le dosi che danno la miscela migliore non sono più una sola. Un litro dal primo e niente dal secondo, niente dal primo e un litro dal secondo, mezzo e mezzo, tre quarti e un quarto: viene sempre la stessa tinta, e lo stesso identico scarto dal colore chiesto.
Fra risposte che valgono uguale bisogna sceglierne una, e il bancone suggerisce la regola: si spalma invece di concentrare. Si sommano i quadrati delle dosi e si tiene la ricetta che dà il totale più piccolo. Ad esempio, mezzo e mezzo dà \(0{,}25 + 0{,}25\), cioè \(0{,}50\); il litro secco dà \(1\), il doppio. Sono gli stessi quadrati che danno l’ombra, e penalizzano chi esagera in un punto solo. È una convenzione, e nessuno vieta al titolare di preferirne un’altra, ma le librerie di calcolo che usiamo restituiscono questa senza dichiararlo.
Il modo di ottenerla è quello del catalogo, letto al contrario. Là ogni premiscela aveva un peso, che diceva quanto un litro di quella premiscela sposta il colore; qui si parte dallo spostamento che serve e si cerca il litro, quindi si divide per il peso invece di moltiplicare. Una premiscela pesante sposta molto, e ne bastano poche gocce; una leggera ne vuole litri. In particolare, una premiscela di peso zero non sposta niente: qualunque dose se ne metta il colore non cambia, e la si lascia fuori dalla ricetta. Se i barattoli sono tutti diversi la ricetta buona è una sola, e la procedura restituisce quella.
Una seconda strada mostra che la regola non è arbitraria. Si chiede al calcolo di non esagerare con le dosi, mettendo una penale sui litri usati, e poi si allenta la penale un po” alla volta: la ricetta si avvicina a quella spalmata e, alleggerendo ancora, la raggiunge.
Il vantaggio della regola si vede quando i due barattoli sono quasi uguali e non del tutto. In senso stretto la ricetta migliore torna allora a essere una sola, e prescrive decine di migliaia di litri dal primo barattolo e, dal secondo, una dose negativa: vernice da togliere, un’operazione che in bottega non esiste.
La differenza fra i due barattoli è più piccola dell’imprecisione con cui li si è misurati, e il calcolo risponde a una domanda che nessuno ha posto. Occorre quindi dichiararlo: si fissa una soglia sotto la quale due barattoli si considerano lo stesso barattolo, e la ricetta torna quella di bottega. È lo stesso metodo del catalogo, cioè buttare via le premiscele di peso trascurabile.
Data \(\mathbf{A} = \mathbf{U}\boldsymbol{\Sigma}\mathbf{V}^\top\), la pseudoinversa di Moore-Penrose è
dove \(\boldsymbol{\Sigma}^{+}\) si ottiene trasponendo \(\boldsymbol{\Sigma}\) e sostituendo ogni \(\sigma_i>0\) con \(1/\sigma_i\), lasciando a zero gli altri. Penrose la caratterizza nel 1955 come l’unica matrice che soddisfa quattro identità [Pen55]: \(\mathbf{A}\mathbf{A}^{+}\mathbf{A} = \mathbf{A}\), \(\mathbf{A}^{+}\mathbf{A}\mathbf{A}^{+} = \mathbf{A}^{+}\), e la simmetria dei due prodotti \(\mathbf{A}\mathbf{A}^{+}\) e \(\mathbf{A}^{+}\mathbf{A}\), che sono i proiettori ortogonali sull’immagine di \(\mathbf{A}\) e sul complemento ortogonale del suo nucleo. Se \(\mathbf{A}\) è invertibile allora \(\mathbf{A}^{+}=\mathbf{A}^{-1}\); se ha rango pieno per colonne allora \(\mathbf{A}^{+} = (\mathbf{A}^\top\mathbf{A})^{-1}\mathbf{A}^\top\), cioè la formula delle equazioni normali.
Nei minimi quadrati il vettore \(\hat{\mathbf{x}} = \mathbf{A}^{+}\mathbf{b}\) è, fra tutti i minimizzatori di \(\lVert\mathbf{A}\mathbf{x}-\mathbf{b}\rVert_2\), quello di norma \(\lVert\mathbf{x}\rVert_2\) minima. Le due situazioni si leggono insieme: con più righe che colonne il minimo dell’errore in generale non vale zero (vale zero solo se \(\mathbf{b}\) sta nell’immagine) e la pseudoinversa dà la proiezione; con un nucleo non banale i minimizzatori formano \(\hat{\mathbf{x}}+\ker(\mathbf{A})\) e la pseudoinversa sceglie il rappresentante ortogonale al nucleo.
La pseudoinversa è legata anche alla regolarizzazione:
Il termine \(\lambda\mathbf{I}\) è la penalità ridge, che limita la grandezza dei coefficienti e che la sezione su overfitting e validazione tratta per esteso. Farla svanire porta alla soluzione di norma minima, il che dà alla pseudoinversa una lettura statistica, quella di limite di un modello regolarizzato invece che di ripiego algebrico.
L’applicazione \(\mathbf{A}\mapsto\mathbf{A}^{+}\) non è continua dove il rango cambia. Se un valore singolare vale \(\varepsilon\) invece di zero il suo reciproco vale \(1/\varepsilon\), e la soluzione di norma minima esplode; il limite per \(\varepsilon\to 0\) di quelle soluzioni non è la soluzione della matrice di rango carente.
Per questo tutte le implementazioni troncano. numpy.linalg.pinv, ad
esempio, azzera i \(\sigma_i\) sotto rcond volte \(\sigma_{\max}\),
cioè calcola la pseudoinversa di un troncamento \(\mathbf{A}_k\) invece che di
\(\mathbf{A}\). Il legame con il teorema di Schmidt-Eckart-Young-Mirsky è
letterale: la sola pseudoinversa numericamente sensata è quella di un
troncamento. Il nome del parametro dichiara la scelta, perché rcond è il
reciproco del condizionamento che si accetta; fissarlo a \(10^{-4}\), per
esempio, vuol dire scartare ogni direzione il cui valore singolare sta sotto
\(10^{-4}\sigma_{\max}\), cioè per cui \(\sigma_{\max}/\sigma_i>10^{4}\).
Per avere un sistema con infinite risposte ugualmente buone basta aggiungere all’esempio degli appartamenti una colonna che ne ripete un’altra, il numero di stanze contato come un venticinquesimo dei metri quadri.
import numpy as np
# continua dal blocco precedente (mq, prezzo, A)
A2 = np.column_stack([np.ones(5), mq, mq / 25.0])
print(np.linalg.matrix_rank(A2))                      # -> 2, non 3

x = np.linalg.pinv(A2) @ prezzo
print(np.round(x, 4), round(np.linalg.norm(x), 4))
# -> [26.9339  2.1949  0.0878] 27.0233

alt = x + 200.0 * np.array([0.0, 1 / 25.0, -1.0])     # nel nucleo di A2
print(round(np.linalg.norm(A2 @ x - prezzo), 5),
      round(np.linalg.norm(A2 @ alt - prezzo), 5),
      round(np.linalg.norm(alt), 4))      # -> 5.17627 5.17627 201.9759

for lam in (1.0, 1e-2, 1e-4, 1e-6):                   # il limite ridge
    xl = np.linalg.solve(A2.T @ A2 + lam * np.eye(3), A2.T @ prezzo)
    print(lam, round(np.linalg.norm(xl - x), 6))
# -> 1.0 20.310268 | 0.01 0.803555 | 0.0001 0.00828 | 1e-06 8.3e-05

# la colonna quasi doppione, che il rango numerico non vede più
A3 = A2.copy()
A3[:, 2] += 1e-6 * np.array([1., -1., 1., -1., 1.])
print(np.linalg.matrix_rank(A3))                      # -> 3
print(np.round(np.linalg.pinv(A3) @ prezzo, 1))
# -> [ 2.7100000e+01  7.3378800e+04 -1.8344156e+06]
print(np.round(np.linalg.pinv(A3, rcond=1e-4) @ prezzo, 4))
# -> [26.9339  2.1949  0.0878]
I due vettori x e alt lasciano lo stesso errore, \(5{,}17627\) tutti e due, e
la misura che li distingue, la radice della somma dei quadrati dei coefficienti,
vale \(27{,}02\) per il primo e \(201{,}98\) per il secondo; la pseudoinversa
restituisce il primo. La penalità ridge arriva alla stessa soluzione per
un’altra via, e la distanza dalla soluzione parsimoniosa scende da \(20{,}31\) a
\(8{,}3\cdot 10^{-5}\) mentre la penalità si alleggerisce di sei ordini di
grandezza.
La matrice A3, invece, differisce dalla precedente per un milionesimo, ma
viene contata come se le sue tre colonne portassero informazioni distinte, e
la soluzione più parsimoniosa passa a coefficienti dell’ordine del milione.
Dichiarando una soglia si torna, a meno di due milionesimi, a quella di prima.
Per questo lstsq accetta un rcond; il valore predefinito è comunque una
soglia, scelta da chi ha scritto la libreria e non da chi la usa.
In molte dimensioni quasi tutto è perpendicolare#
C’è un fatto sull’ortogonalità che nello spazio di tutti i giorni non si vede, e da cui dipende l’ipotesi con cui si spiegano le rappresentazioni interne dei modelli, cioè le liste di numeri con cui una rete descrive quello che ha davanti.
Sul foglio, due frecce con direzioni scelte a caso sono quasi allineate (o quasi opposte) molto più spesso che quasi perpendicolari. Salendo di dimensione la faccenda cambia, e cambia in fretta. In uno spazio a mille dimensioni due direzioni prese a caso sono quasi sempre quasi perpendicolari. Il loro prodotto scalare, misurato su vettori di lunghezza uno, si aggira infatti intorno a due centesimi e mezzo, mentre nello spazio a tre dimensioni si aggira intorno a mezzo.
La ragione si intuisce contando le occasioni di essere diversi. Per puntare nella stessa direzione, due frecce devono andare d’accordo su tutte le coordinate contemporaneamente; con mille coordinate scelte a caso, che vadano d’accordo su tutte è un colpo di fortuna astronomico, e la somma dei mille contributi (metà positivi, metà negativi) si compensa quasi perfettamente.
La conseguenza pratica cambia il modo di pensare agli spazi grandi. In mille dimensioni si possono sistemare molte più di mille direzioni tutte quasi perpendicolari fra loro; in altre parole, rinunciando alla perpendicolarità esatta e accontentandosi di «quasi», la capienza esplode. È l’ipotesi con cui si spiega come una rete possa tenere in uno spazio di poche migliaia di dimensioni molti più concetti: a ciascuno toccherebbe una lista di numeri sua, cioè una direzione sua, e finché le direzioni restano quasi perpendicolari i concetti si confonderebbero poco. La sezione sull’interpretabilità meccanicistica racconta che cosa succede quando invece si disturbano.
Il rovescio della medaglia è il punto in cui questa materia inganna di più: l’intuizione costruita su tre dimensioni sbaglia in modo sistematico, e non di poco. Cose che nel piano sembrano rare (due direzioni quasi perpendicolari) là dentro sono la norma, e cose che nel piano sembrano normali (due direzioni quasi allineate) là dentro non capitano mai per caso. Quando un ragionamento su uno spazio grande poggia su un disegno fatto sul foglio, conviene rifarlo con i numeri.
Siano \(\mathbf{u},\mathbf{v}\) due vettori unitari indipendenti e uniformi sulla sfera \(S^{d-1}\). Il loro coseno \(\mathbf{u}^\top\mathbf{v}\) ha media nulla e varianza \(1/d\), quindi la sua deviazione standard è \(1/\sqrt{d}\); per \(d\) grande il valore atteso del modulo è asintotico a \(\sqrt{2/(\pi d)}\approx 0{,}8/\sqrt{d}\), mentre in tre dimensioni vale esattamente \(1/2\). La concentrazione è esponenziale: per ogni \(\varepsilon>0\)
e da questa stima, con l’unione sulle coppie, segue che si possono collocare \(N\) direzioni con coseni tutti sotto \(\varepsilon\) finché \(N \lesssim e^{d\varepsilon^2/4}\), cioè un numero esponenziale nella dimensione. La stessa stima sta alla base del lemma di Johnson-Lindenstrauss sulle proiezioni casuali che quasi conservano le distanze.
Le conseguenze per il deep learning sono due, e vanno tenute insieme. La prima è che uno spazio di rappresentazione a \(d\) dimensioni ospita molte più di \(d\) feature distinguibili, purché si accetti una sovrapposizione piccola; si tratta dell’ipotesi della sovrapposizione, che la sezione sull’interpretabilità meccanicistica discute per esteso.
La seconda è un avvertimento sulla geometria dell’alta dimensione: l’intuizione tridimensionale sbaglia sistematicamente, e le quantità che sembrano tipiche (distanze, angoli, volumi vicino alla superficie) si concentrano attorno a valori che nel piano non si osservano mai.
import numpy as np
rng = np.random.default_rng(0)

for d in (3, 100, 1000):
    V = rng.normal(size=(3000, d))
    V /= np.linalg.norm(V, axis=1, keepdims=True)   # sulla sfera unitaria
    G = V @ V.T
    np.fill_diagonal(G, 0.0)                        # via i coseni di un
                                                    # vettore con sé stesso
    print(d, round(abs(G).mean(), 4), round(abs(G).max(), 3),
          round(1 / np.sqrt(d), 4))
# -> 3    0.4998 1.0   0.5774
# -> 100  0.0799 0.477 0.1
# -> 1000 0.0252 0.166 0.0316
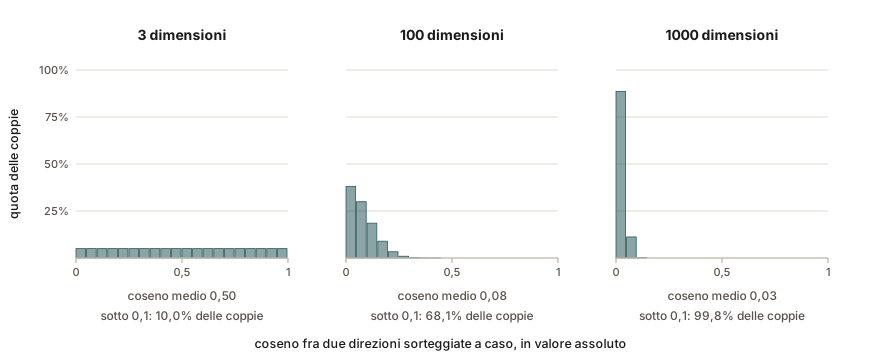
Fig. 3.7 Il coseno fra due direzioni estratte a caso, misurato su tremila direzioni per ogni spazio e diviso in venti fasce. In tre dimensioni le fasce sono tutte ugualmente piene, cioè fra due direzioni può capitare qualunque angolo; in mille ne resta piena una sola, appoggiata allo zero, e il 99,8% delle coppie sta sotto un decimo.#
La media da sola non distingue una distribuzione che si è spostata da una che si è stretta, e Fig. 3.7 fa vedere che è la seconda. Consideriamo tremila direzioni estratte a caso in mille dimensioni, cioè tre volte più direzioni che dimensioni. Fra i quattro milioni e mezzo di coppie possibili, la più allineata di tutte ha coseno \(0{,}166\), che corrisponde a un angolo di poco più di ottanta gradi. Le stesse tremila direzioni in tre dimensioni danno invece coseno massimo \(1{,}0\), poiché là dentro non c’è posto e due finiscono per sovrapporsi.
La stessa capienza rende plausibile un’operazione che a prima vista sembra sconsiderata: sommare due informazioni diverse dentro gli stessi numeri invece di tenerle in caselle separate. Se i due vettori puntano in direzioni quasi perpendicolari la somma li contiene tutti e due, e ciascuno disturba l’altro di poco (in mille dimensioni, di quei due centesimi e mezzo), quindi una rete può imparare a tenerli distinti. Ad esempio, il Transformer somma all’embedding di una parola la codifica della sua posizione, come racconta la sezione sull’architettura del Transformer; gli autori lo motivano con la dimensione (i due vettori hanno lo stesso numero di componenti, \(d_{\text{model}}\), e quindi si possono sommare) [VSP+17], non con la perpendicolarità.
In pratica, con NumPy#
import numpy as np

A = np.column_stack([np.ones(5), np.array([55., 70., 85., 100., 120.])])
b = np.array([148., 182., 210., 250., 290.])

np.linalg.lstsq(A, b, rcond=None)[0]   # la via consigliata: minimi quadrati
np.linalg.qr(A)                        # Q ortonormale, R triangolare
np.linalg.cond(A)                      # quanto il problema è delicato

P = A @ np.linalg.inv(A.T @ A) @ A.T   # il proiettore, da guardare non da usare
np.allclose(P @ P, P)                  # proiettare due volte -> True

np.linalg.svd(A, full_matrices=False)  # U, valori singolari, V trasposta
np.linalg.pinv(A)                      # la pseudoinversa, troncata a rcond
Il proiettore costruito per esteso vale come esercizio e mai come codice di
produzione, poiché costa \(\Theta(m^2 n)\), e l’inversa che compare nella sua
formula è quella di \(\mathbf{A}^\top\mathbf{A}\), il passaggio che eleva al
quadrato il condizionamento. Nelle applicazioni si usa lstsq, e se serve la
proiezione la si ottiene come A @ coefficienti.
Da ricordare
Due direzioni sono perpendicolari quando il loro prodotto scalare fa zero, e allora spostarsi lungo una non ti sposta di un millimetro lungo l’altra: il che non vuol dire che le due grandezze misurate lungo di esse non abbiano niente da dirsi. Con direzioni perpendicolari e lunghe uno ogni coefficiente si legge con un prodotto scalare, senza risolvere nessun sistema.
La proiezione è l’ombra a picco: ogni vettore si spacca in modo unico nella parte che sta nella direzione scelta più la parte perpendicolare. La media aritmetica è l’ombra delle misure sulla direzione in cui sono tutte uguali, e questo spiega perché gli scarti dalla media si compensano.
Quando il colore chiesto non si può fare, si prende quello più vicino fra quelli possibili, cioè l’ombra. Il segno di aver finito è che l’errore rimasto è perpendicolare a tutto ciò che si poteva fare: se non lo fosse, spostandosi si migliorerebbe ancora.
Colonne quasi allineate rendono i conti equilibristici, e la formula più immediata peggiora le cose elevando al quadrato quella delicatezza. Le due cure sono centrare le colonne dei dati, non quella delle costanti (una riga di codice), e raddrizzarle togliendo a ciascuna l’ombra sulle precedenti, che è quello che fanno Gram-Schmidt e la scomposizione QR.
Quando di una tabella si può tenere solo un pezzo, il pezzo migliore si ottiene ordinando le direzioni per importanza e tenendo le prime: nessun’altra scelta le si avvicina di più. Lo sbaglio si conosce prima, perché sta scritto nei pesi scartati: quadrato di ciascuno, somma, radice. Vale anche caso per caso, perché nessuna riga sbaglia più del peso più grosso fra quelli buttati. Se i pesi sono tutti simili non c’è niente da guadagnare, e se alcune caselle mancano il calcolo non vale più.
Quando le ricette ugualmente buone sono più di una, si tiene quella che spalma le dosi invece di concentrarle, cioè quella con la somma dei quadrati più piccola. Due direzioni quasi identiche vanno contate come una sola, sotto una soglia che qualcuno deve dichiarare.
In uno spazio con tante dimensioni due direzioni a caso sono quasi sempre quasi perpendicolari, e ce ne stanno molte più di quante siano le dimensioni. È l’ipotesi con cui si spiega come un modello possa dare una direzione propria a un numero enorme di concetti.
Da ricordare
\(\mathbf{u}^\top\mathbf{v}=0\) definisce l’ortogonalità; una base ortonormale dà i coefficienti come prodotti scalari, e una matrice ortogonale soddisfa \(\mathbf{Q}^{-1}=\mathbf{Q}^\top\), conserva le norme e ha \(\kappa_2=1\).
\(\operatorname{proj}_{\mathbf{a}}(\mathbf{b}) = \frac{\mathbf{a}^\top\mathbf{b}}{\mathbf{a}^\top\mathbf{a}}\mathbf{a}\); con \(\mathbf{a}=\mathbf{1}\) si ottiene la media campionaria, e la norma al quadrato del residuo è \(n\) volte la varianza.
Teorema della proiezione: \(\hat{\mathbf{x}}\) minimizza \(\lVert\mathbf{A}\mathbf{x}-\mathbf{b}\rVert_2\) se e solo se \(\mathbf{A}^\top(\mathbf{b}-\mathbf{A}\hat{\mathbf{x}})=\mathbf{0}\), da cui le equazioni normali \(\mathbf{A}^\top\mathbf{A}\hat{\mathbf{x}} = \mathbf{A}^\top\mathbf{b}\) e il proiettore \(\mathbf{P}=\mathbf{A}(\mathbf{A}^\top\mathbf{A})^{-1}\mathbf{A}^\top\), con \(\mathbf{P}^2=\mathbf{P}=\mathbf{P}^\top\). La stessa condizione è l’annullamento del gradiente.
Gram-Schmidt ortonormalizza togliendo a ogni colonna le proiezioni sulle precedenti e dà \(\mathbf{A}=\mathbf{Q}\mathbf{R}\); si preferisce alle equazioni normali perché \(\kappa_2(\mathbf{A}^\top\mathbf{A})=\kappa_2(\mathbf{A})^2\). Usare la variante modificata, o meglio Householder.
Schmidt-Eckart-Young-Mirsky: fra le matrici di rango \(\le k\), il troncamento \(\mathbf{A}_k=\sum_{i\le k}\sigma_i\mathbf{u}_i\mathbf{v}_i^\top\) minimizza ogni norma invariante per trasformazioni ortogonali, con \(\lVert\mathbf{A}-\mathbf{A}_k\rVert_F=\sqrt{\sum_{i>k}\sigma_i^2}\) e \(\lVert\mathbf{A}-\mathbf{A}_k\rVert_2=\sigma_{k+1}\). In Frobenius il minimo è unico se e solo se \(\sigma_k>\sigma_{k+1}\); in norma spettrale i minimi sono in genere infiniti. Diventa inutile se lo spettro non decade, e cade se la norma è pesata o ristretta alle celle osservate.
La pseudoinversa \(\mathbf{A}^{+}=\mathbf{V}\boldsymbol{\Sigma}^{+}\mathbf{U}^\top\) dà il minimizzatore di \(\lVert\mathbf{A}\mathbf{x}-\mathbf{b}\rVert_2\) di norma minima, coincide con \((\mathbf{A}^\top\mathbf{A})^{-1}\mathbf{A}^\top\) a rango pieno per colonne ed è il limite della penalità ridge per \(\lambda\to 0^{+}\). Non è continua dove il rango cambia: da qui il troncamento a
rcond.Su \(S^{d-1}\) il coseno fra due direzioni casuali ha deviazione standard \(1/\sqrt{d}\) e code sub-gaussiane, quindi in \(\mathbb{R}^d\) si collocano esponenzialmente molte direzioni quasi ortogonali: è la base della sovrapposizione e delle proiezioni casuali.
Le proiezioni hanno risolto il caso in cui i vincoli sono troppi, e la pseudoinversa quello in cui sono troppo pochi, due casi che la sezione sui sistemi lineari aveva descritto soltanto; i valori singolari, ordinati, hanno detto che cosa tenere quando non si può tenere tutto. Resta da vedere come una trasformazione lineare cambia le aree e i volumi, e lo dice un numero solo, il determinante, che misura quanto una trasformazione gonfia o comprime lo spazio su cui lavora.