



Harness engineering: tutto ciò che non è il modello#
«Costruisci un clone di claude.ai.» La richiesta stava in una riga; il lavoro
che chiedeva, un sito per conversare con un modello, con le sue pagine, i suoi
pulsanti e l’archivio delle conversazioni, non sarebbe mai entrato in una sola
finestra di contesto, il testo che un modello riesce a leggere in una volta. In
Anthropic l’hanno affidata a un agente di programmazione: un modello di punta
(Justin Young, che ha raccontato l’esperimento nel novembre 2025, cita Claude
Opus 4.5) dentro un ciclo che gli permetteva di leggere e scrivere i file del
progetto, lanciare comandi e ripartire quando la finestra era piena, passando
alla sessione successiva un riassunto di quello che era successo. Young elenca
che cosa è andato storto [You25].
L’agente ha provato a fare tutto in un colpo: ha esaurito la finestra a metà di una funzionalità e ha lasciato alla sessione successiva un lavoro iniziato, senza una riga che dicesse fin dove era arrivato. Più avanti una sessione nuova, ripartita da zero, si è guardata intorno, ha visto che molto era già stato fatto, e ha dichiarato il progetto concluso. Altre volte l’agente ha segnato come finite delle funzionalità che aveva controllato soltanto a pezzi, con i test del codice o con una richiesta diretta al server, senza mai usarle come le userebbe una persona davanti allo schermo. E ha chiuso delle sessioni lasciando l’applicazione rotta, così che la sessione successiva spendeva il suo tempo a capire che cosa fosse successo e a rimetterla in piedi.
Il riassunto non bastava: lo scriveva il modello di getto, quando la finestra era piena, decidendo da sé che cosa tenere, e non sempre consegnava alla sessione successiva istruzioni chiare.
La soluzione ha lasciato il modello com’era e ha cambiato quello che c’era attorno, compreso uno strumento in più per provare l’applicazione dentro un browser, come farebbe un utente. Una prima sessione dell’agente, con un compito diverso da tutte le altre e un prompt scritto apposta, ha preparato il terreno: un comando per avviare l’applicazione, un elenco di oltre duecento funzionalità da realizzare, tutte segnate come non ancora riuscite, un file in cui ogni sessione annota che cosa ha fatto, e una prima versione del progetto salvata nella sua storia.
Da lì in poi ogni sessione ha seguito la stessa routine: rileggere dove si era arrivati, scegliere una sola funzionalità fra quelle mancanti, lavorarci, provarla da utente, salvare il lavoro con una descrizione e aggiornare il file delle annotazioni. Young non riporta un clone finito né un numero: riporta che le sessioni smettevano di dover indovinare che cosa fosse successo, e che gli strumenti per provare l’applicazione da utente hanno migliorato nettamente i risultati.
Quell’insieme di file, comandi, controlli e abitudini che circonda il modello si chiama harness. In inglese la parola indica i finimenti del cavallo, ciò che collega la forza dell’animale al carro e permette di guidarla; e da decenni, nel gergo di chi collauda il software, un test harness è l’impianto che fa girare un programma sotto prova e ne raccoglie gli esiti. Detto di un agente, l’harness è tutto ciò che, nel sistema costruito attorno a un modello, non è il modello.
Il loop engineering chiudeva l’elenco dei suoi componenti (la sveglia che fa partire il ciclo, la copia dei file su cui ogni iterazione lavora, i file in cui il ciclo tiene memoria) chiamandoli scaffolding, la struttura attorno al modello. L’harness engineering, invece, prende sul serio quella struttura: ne fa un oggetto di progetto, da misurare componente per componente, e porta al centro la domanda che la memoria esterna del ciclo aveva appena toccato, cioè che cosa resta, e in che forma, quando la finestra si svuota.
Un compito lungo, per un agente, si spezza in sessioni, e ogni sessione comincia con una finestra vuota. Quello che sopravvive è soltanto ciò che è stato scritto fuori: nei file del progetto, nella cartella che git custodisce con la storia di tutte le sue versioni (il repository), nei controlli che qualcuno ha preparato.
In questo capitolo i guasti di Young danno l’ordine al percorso. Contro la sessione che non sa dove si era arrivati c’è il repository come memoria; contro il lavoro fatto tutto in un colpo, la preparazione del primo turno e la sua lista delle funzionalità; contro la sessione che lascia il progetto in disordine, il passaggio di consegne; contro la vittoria dichiarata e il «fatto» senza prova, il collaudo. Uno dei rimedi di Young era uno strumento in più, e gli strumenti hanno un progetto loro: che cosa l’agente può chiedere, che cosa gli torna indietro, fin dove arriva un errore.
Restano poi le cose che nessun guasto singolo mostra: che cosa succede a un sistema che lavora quando nessuno guarda, quanto costa e quanto dura un compito, cioè il suo conto, come si disegna un lavoro che ha bisogno di più di un ciclo, una mappa di passi collegati da frecce che si chiama grafo, e che cosa succede quando a scrivere e a provare l’harness è un altro programma, che lo riscrive.
Che cosa c’è attorno al modello#
Un harness si lascia dividere per funzione in cinque sottosistemi. Le
istruzioni sono i file che il modello legge all’inizio di ogni sessione (il
più comune si chiama AGENTS.md, in alcuni agenti CLAUDE.md). Gli
strumenti sono le operazioni che il modello può chiedere al programma che
lo ospita di eseguire, con le regole che dicono quali può chiedere da solo e
quali solo con un permesso. L’ambiente è lo spazio di lavoro in cui le
azioni hanno effetto: la macchina, il progetto con le librerie da cui dipende,
l’applicazione avviata; spesso si ricostruisce a ogni sessione, e allora a
sopravvivere è la ricetta scritta per ricostruirlo. Lo stato è ciò che si
scrive apposta per la sessione dopo: un file di avanzamento, l’elenco delle
funzionalità, la storia delle versioni. La verifica è l’insieme dei
controlli che decidono se una cosa è fatta.
A tenerli insieme c’è il ciclo, che il loop engineering ha già progettato: è lui che a ogni passo monta il contesto, passa le richieste del modello agli strumenti e ne raccoglie gli esiti.
L’anatomia di un agente divideva un agente in quattro parti (modello, strumenti, ciclo di controllo, memoria), con l’ambiente attorno: era la fotografia di un agente mentre lavora. I cinque sottosistemi tagliano lungo un altro asse, perché guardano anche quello che esiste quando nessun agente sta girando. La memoria a lungo termine dell’anatomia qui è lo stato; quella a breve, la finestra, non è un sottosistema ma il foglio su cui il ciclo scrive a ogni passo; istruzioni e verifica sono le due parti che l’anatomia non nominava.
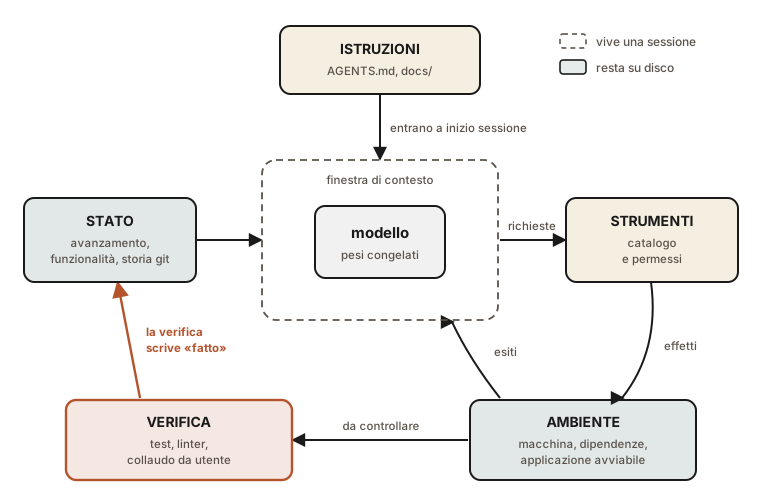
Fig. 22.1 L’anatomia di un harness. Il tratteggio segna ciò che dura una sessione, la finestra di contesto; il modello che la legge e i cinque riquadri pieni restano quando la sessione finisce, ed è da loro che la sessione dopo riparte.#
Nella Fig. 22.1 si leggono già i guasti dell’esperimento. Le frecce che entrano nella finestra sono quelle che la prossima sessione riceve: se le istruzioni sono confuse o lo stato non dice dove si era arrivati, il modello riparte da un’ipotesi.
La freccia che va dalla verifica allo stato è quella che dovrebbe scrivere «fatto». Nell’harness di Young quel segno lo metteva l’agente stesso, ma soltanto dopo aver provato la funzionalità da utente: a tenere lontana la vittoria dichiarata era l’obbligo della prova, non chi scriveva il segno. Fare scrivere il segno a un controllo che non è il modello, come chiede il cancello del loop engineering, è la versione più robusta della stessa idea.
Torna nella bottega dove ogni mattina siede al banco un artigiano senza un ricordo di ieri: ha le mani dell’artigiano di ieri, non la sua memoria. L’artigiano è il modello. Tutto il resto della bottega è l’harness, e lo riconosci da una cosa: la sera, quando l’artigiano se ne va, rimane lì.
Rimane il cartello accanto alla porta, che il nuovo arrivato legge prima di toccare qualunque cosa: che cosa si fabbrica qui, dove sta che cosa, le tre regole da non violare mai. Sono le istruzioni. Rimangono gli attrezzi sulla parete, ciascuno al suo gancio, e accanto un foglio con quelli che un apprendista può prendere da solo e quelli per cui deve chiedere: gli strumenti, con i loro permessi. Rimangono il banco, il legno in magazzino, la corrente che arriva alle macchine: l’ambiente, il posto dove il lavoro succede davvero.
Rimangono il registro e il foglio dell’ordine, con le voci già fatte spuntate: lo stato. E rimane la dima, la sagoma su cui ogni pezzo va appoggiato prima di dirsi finito: la verifica. A tenere insieme tutto c’è il capobottega, che ogni mattina mette davanti all’artigiano il cartello e la pagina giusta del registro, gli passa gli attrezzi che chiede e a ogni pezzo finito lo prova sulla dima.
Metti lo stesso artigiano in due botteghe. Nella prima il cartello non c’è, gli attrezzi stanno in un mucchio, il registro è vuoto e nessuno controlla: lavora con le stesse mani, e a sera hai tre pezzi cominciati e nessuno finito. Nella seconda consegna il pezzo giusto. Le mani erano le stesse, è cambiata la bottega.
Attento però a come fai il confronto. Lo hanno fatto davvero: lo stesso modello ha lavorato venti minuti in una bottega spoglia e sei ore in una attrezzata, e la seconda ha consegnato un gioco che funzionava, la prima no. Ma la seconda aveva avuto diciotto volte il tempo e più di venti volte la spesa, e quindi non sai quanto del risultato sia merito della bottega e quanto del tempo e dei soldi.
La bottega non insegna a intagliare. Se l’artigiano non sa usare lo scalpello, nessun cartello glielo insegna; la dima può solo scartare i pezzi storti e farli rifare, che è già molto, ma costa.
E quando assumi artigiani più bravi, qualche precauzione smette di servire: la prova sulla dima, che si faceva a ogni pezzo, diventa una prova sola a fine lavoro. A volte, invece, con artigiani nuovi ne serve una che prima non ti era venuta in mente. Ogni cosa appesa al muro racconta che cosa si pensava che l’artigiano non sapesse fare da solo; quando l’artigiano cambia, conviene riguardarla.
Sia \(\theta\) il vettore dei pesi, congelato, e \(x\) il compito. Un sistema ad agente è la coppia \((\theta, H)\), e l’harness \(H\) comprende tutto il resto: le istruzioni \(I\), il catalogo degli strumenti \(\mathcal{T}\) con le sue regole di permesso, la ricetta dell’ambiente (da cui si ricostruisce lo stato iniziale \(E_{k,1}\) di ogni sessione), lo stato persistente iniziale \(M_0\), i controlli di verifica \(V\), e il codice del ciclo che li collega. Nella sessione \(k\), al passo \(t\), il ciclo monta il contesto, campiona un’azione e la esegue se è permessa:
dove \(a_{k,1:t-1}\) e \(o_{k,1:t-1}\) sono le azioni e le osservazioni già raccolte nella sessione: un’azione vietata non resta senza esito, il rifiuto torna nel contesto. Il permesso si giudica sulla chiamata (lo strumento con i suoi argomenti), non sul solo strumento. Se la finestra si riempie, è \(\mathrm{monta}\) a comprimere la cronologia in un riassunto, la compattazione.
La politica del sistema è dunque \(\pi_{\theta,H}(a \mid x, M_k, \text{storia}) = P_\theta(a \mid \mathrm{monta}(\dots))\), composta con il filtro dei permessi: la stessa distribuzione del modello, condizionata da ciò che \(H\) le mette davanti.
A fine sessione lo stato si aggiorna con le modifiche \(D_k\) che superano la verifica, \(M_{k+1} = \mathrm{scrivi}(M_k, D_k)\) con \(V(D_k) = 1\). \(V\) può essere un predicato deterministico (una suite di test, un controllo dei tipi) oppure un giudice che è a sua volta una chiamata a un modello; nel secondo caso sbaglia nei due versi, e la sua precisione va misurata come quella di qualunque classificatore.
Il contesto \(C\) muore con la sessione; \(I\), \(\mathcal{T}\), \(V\), \(M\) e la ricetta dell’ambiente sopravvivono. Nei tre cerchi il ciclo calcola \((C_{t+1}, M_{t+1}) = g(C_t, M_t, o_t)\) passo per passo; qui le scale sono due, il passo dentro la sessione e la sessione dentro il compito, e l’harness comprende il codice che calcola \(g\) e gli oggetti su cui lavora, compresi quelli che attraversano le sessioni.
Ne segue che un banco di prova misura sempre una coppia. La sezione sulle architetture degli agenti riporta l’esperimento in una direzione: lo stesso ciclo minimo, con \(H\) fissato a grandi linee (le misure usano versioni diverse dello stesso agente minimo) e \(\theta\) che cambia, andava nel 2025 dal 9% al 74% delle correzioni riuscite su cinquecento segnalazioni ripulite di SWE-bench, con la riserva sulla contaminazione che quella sezione discute.
L’esperimento inverso, \(\theta\) fissato e \(H\) che cambia, è il terreno dell’harness engineering, ed è più difficile da fare pulito di quanto sembri. Ad esempio, Rajasekaran riporta lo stesso modello e lo stesso prompt in un’esecuzione singola da 20 minuti e circa 9 dollari, il cui gioco non funzionava, e in un harness a tre agenti da 6 ore e circa 200 dollari, il cui gioco funzionava [Raj26]; ma insieme all’harness cambiano la spesa (di più di venti volte) e il tempo (di diciotto), la prova è una sola, e il giudizio «funzionava» è dell’autore. Dice che il compito, con quell’harness, è riuscito; non quanto dell’esito si debba a \(H\) e quanto al budget.
C’è poi una ragione più profonda per cui i due fattori non si separano del tutto: i fornitori addestrano i propri modelli sugli strumenti del proprio harness, e un confronto a \(H\) fissato favorisce il modello addestrato per quell’\(H\).
\(H\) non aggiunge capacità a \(\theta\): le aggiunge al sistema. Nessuna istruzione insegna al modello ciò che non sa, ma un controllo con la possibilità di rifare alza il tasso di successo di qualunque modello che riesca con una probabilità fra zero e uno. Ogni componente di \(H\) codifica un’ipotesi su che cosa il modello non sa fare da solo, e il suo valore dipende da \(\theta\).
Rajasekaran ne dà due casi: il valutatore separato, che vale il suo costo finché il compito sta oltre ciò che il modello fa in modo affidabile da solo e che con un modello più recente ha ridotto a un solo controllo a fine lavoro; e il ripartire da capo con una finestra nuova, indispensabile con Claude Sonnet 4.5 (fine settembre 2025) e tolto con Claude Opus 4.5, che di suo non chiudeva più il lavoro in fretta all’avvicinarsi del limite della finestra. In nessuno dei due casi c’è un’ablazione misurata: c’è un cambio di modello, e un componente tolto perché non serviva più.
Quando l’agente sbaglia, che cosa manca#
Alla fine dell’agosto 2025 una piccola squadra di OpenAI ha aperto un repository vuoto con una regola sola: nessuna riga di codice scritta a mano. Cinque mesi dopo il progetto contava circa un milione di righe, scritte tutte da un agente, Codex: il codice dell’applicazione, i test, la configurazione dei controlli automatici, la documentazione. Le richieste di modifica aperte e integrate erano circa millecinquecento, e a guidare il lavoro c’erano tre ingegneri, poi diventati sette. Ryan Lopopolo, che lo ha raccontato nel febbraio 2026, scrive che all’inizio si andava più piano del previsto, e non perché il modello non ne fosse capace: l’ambiente era descritto troppo poco, e all’agente mancavano gli strumenti e la struttura per avvicinarsi a un obiettivo grande [Lop26].
Quando qualcosa falliva, la riparazione non era quasi mai chiedergli di impegnarsi di più. Era chiedersi quale capacità gli mancasse, e come fargliela vedere (un documento, uno strumento, un messaggio d’errore che spiega che cosa fare) e insieme renderla impossibile da ignorare (un controllo che ferma il lavoro quando la regola non è rispettata). È il resoconto di un progetto interno, e Lopopolo stesso avverte che la capacità dell’agente di portare a termine da solo una funzionalità dipende dalla struttura di quel repository, e non va data per generalizzabile senza un investimento simile.
Questo è il gesto diagnostico dell’harness engineering. Un fallimento si attribuisce a uno dei cinque sottosistemi (l’istruzione che mancava, lo strumento che non c’era, l’ambiente che non partiva, lo stato che non diceva dove si era arrivati, il controllo che non ha fermato l’errore), si ripara lì, e si riprova. Cambiare modello resta un’ipotesi, ma viene dopo le altre, perché è la sola che non dice niente su che cosa mancasse; ci si arriva quando nessuna riparazione dell’harness basta.
Il gesto ha un rovescio, che si dimentica più spesso: ogni componente aggiunto costa (testo da leggere a ogni sessione, cioè token, poi tempo e cose da tenere aggiornate), e un harness cresciuto per accumulo va potato con lo stesso metodo con cui è cresciuto, togliendo un componente e guardando che cosa succede.
Un pezzo esce storto. Tu, che della bottega sei il proprietario, non cominci cambiando artigiano: ti chiedi che cosa mancasse. Le istruzioni del cartello erano poco chiare? Mancava lo scalpello giusto? Il banco ballava? Nessuno aveva scritto da nessuna parte che quel legno si scheggia? Nessuno ha provato il pezzo sulla dima? Ripari quella cosa, e fai rifare il pezzo. Cambi artigiano solo quando hai riparato tutto e il pezzo continua a uscire storto.
Poi c’è la domanda contraria: la prova sulla dima serve ancora, o è solo tempo perso? Per saperlo la salti per due settimane su metà dei lavori e conti i pezzi sbagliati nelle due metà. Tre trappole ti aspettano. Se in ogni metà hai fatto cinque pezzi e uno è venuto storto, non hai imparato niente: con così pochi pezzi può essere il caso, e ne servono centinaia.
Se poi i controlli sono due, la dima al banco e un’occhiata del capobottega prima della consegna, togliendone uno alla volta non vedi niente, perché l’altro ripara; toglili insieme e i pezzi storti escono. Prova uno alla volta e concluderai che nessuno dei due serve, cioè la cosa sbagliata; se si coprono a vicenda, ne tieni uno, il meno costoso. E se in quelle due settimane sono arrivati solo lavori facili, la dima non aveva niente da fermare: non sai che cosa succede nei giorni difficili.
Anche il cartello si mette alla prova così. Se è lungo come un manuale e l’artigiano lo legge tutto ogni mattina, costa mezz’ora al giorno; e l’artigiano lo segue alla lettera, anche le righe che non servono, e perde tempo a fare quello che dicono. Se togliendo metà delle righe i pezzi vengono uguali, in quella bottega quelle righe erano solo un costo. Ma guarda perché: se ripetevano quello che sta già scritto nel manuale dentro il cassetto, in una bottega senza manuale sarebbero servite eccome. Quando assumi artigiani più bravi, le prove si rifanno da capo.
Sia \(s(\theta, H)\) il tasso di successo vero della coppia su una batteria fissata di compiti \(\mathcal{B}\), cioè la media sui compiti della probabilità di successo, e \(\hat{s}\) la sua stima con \(n\) esecuzioni per compito. Il valore marginale di un componente \(h \in H\) è
dove togliere \(h\) vuol dire sostituirlo con il suo elemento neutro (istruzioni vuote, un controllo che approva sempre, un catalogo ridotto), e l’ablazione lo stima togliendo un componente alla volta. Le cautele che ne limitano la portata sono più d’una.
Stima e appaiamento. \(\hat{s}\) è una proporzione su esecuzioni stocastiche, e \(\Delta\hat{s}_h\) una differenza di due proporzioni. Su campioni indipendenti la sua varianza è la somma delle due, cioè l’ampiezza dell’intervallo cresce di \(\sqrt{2}\) e il numero di esecuzioni per lo stesso margine raddoppia rispetto al tasso singolo che la valutazione degli agenti dimensiona con l’intervallo di Wilson. Sulla stessa batteria però il confronto è appaiato, e va trattato come tale (il test di McNemar sui compiti discordanti, o un bootstrap per compito); e le esecuzioni ripetute dello stesso compito non sono indipendenti, quindi la numerosità che conta è \(|\mathcal{B}|\), non \(n\).
Interazioni. \(\Delta s\) non è additivo. Se due componenti \(h_1, h_2\) intercettano lo stesso difetto, \(\Delta s_{h_1} \approx \Delta s_{h_2} \approx 0\) mentre \(s(\theta, H) - s(\theta, H \setminus \{h_1, h_2\})\) può essere grande: l’ablazione a un componente per volta dichiara superfluo ciò che è soltanto coperto.
Copertura. \(\Delta s_h\) dipende da \(\mathcal{B}\). Un componente che difende da un guasto assente nella batteria riceve \(\Delta s_h \approx 0\), e resta indispensabile dove quel guasto c’è.
Adattamento alla batteria. Il gesto diagnostico legge i fallimenti e ripara: se lo si fa sulla stessa \(\mathcal{B}\) su cui poi si misura, \(s\) e \(\Delta s\) sono ottimisti, come l’errore di addestramento di un modello. Serve una batteria tenuta da parte; e un’ablazione su molti componenti moltiplica i confronti, con il rischio di trovare per caso un effetto che non c’è.
L’ablazione misura quindi un valore marginale su \(\mathcal{B}\), non il collo di bottiglia: per trovare quello serve l’attribuzione dei fallimenti alle loro cause, sulle tracce delle esecuzioni fallite, che a sua volta è un giudizio fallibile.
Ogni componente ha anche un costo, e \(\Delta s_h\) (una differenza di probabilità) non si confronta con un costo in token o in tempo senza un cambio di unità: la grandezza giusta è il costo per compito risolto, \(c(H)/s(H)\).
Il caso misurato più istruttivo riguarda proprio le istruzioni. Gloaguen e colleghi hanno confrontato quattro agenti di programmazione con e senza un file di contesto del repository [GMundlerSMuller+26]. I file scritti da un modello hanno cambiato la quota di problemi risolti di \(-0{,}5\) e \(-2\) punti percentuali nei due insiemi di prova, differenze non distinguibili dallo zero, e hanno alzato il costo d’inferenza del 20% e del 23%; quelli scritti dagli sviluppatori l’hanno alzata di \(2{,}4\) punti in media, anch’essi senza significatività, con un costo fino al 19% più alto. Su quella misura il costo per problema risolto sale in tutti e tre i casi.
Ma lo stesso lavoro mostra le cautele di sopra all’opera. Togliendo dal repository ogni altra documentazione, i file generati da un modello hanno migliorato il successo di \(2{,}7\) punti in media: erano ridondanti con la documentazione che c’era già, cioè l’effetto quasi nullo era un’interazione, non un’inutilità. E l’effetto dei file degli sviluppatori cambia segno da un modello all’altro, da circa \(-3\) a circa \(+8\) punti: \(\Delta s_h\) è funzione di \(\theta\), e ogni cambio di modello riapre il conto.
Sull’efficienza, un’altra misura trova invece che il file accorcia i tempi; la sezione sul repository come memoria mette i due risultati uno accanto all’altro.
Rajasekaran riassume la disciplina in una convinzione personale, non in una misura: al migliorare dei modelli lo spazio delle combinazioni interessanti di un harness non si restringe, si sposta [Raj26].
Detto così, l’harness potrebbe sembrare un altro nome del ciclo, e in parte lo è: il capobottega del loop engineering teneva già un registro e controllava il pezzo finito. L’harness engineering sposta lo sguardo dal capobottega agli oggetti che maneggia, il cartello, il registro, la dima, il banco, e li tratta come componenti da progettare e da misurare uno per uno.
Si guastano però in modi diversi: un ciclo con un buon controllo finale e un limite ai tentativi, lanciato in un repository che non dice dove si era arrivati, rifà ogni volta da capo la stessa esplorazione, e la paga ogni volta in token.
Da ricordare
L’harness è tutto ciò che sta attorno al modello: il cartello con le istruzioni, gli attrezzi con i loro permessi, il banco dove si lavora, il registro con quello che è stato fatto, la dima che dice se un pezzo è finito. Il modello è l’artigiano che ogni mattina arriva senza ricordi; la bottega resta.
Un lavoro lungo si spezza in sessioni, e ogni sessione riparte con la memoria vuota: sopravvive soltanto quello che è stato scritto fuori, nei file del progetto e nella sua storia.
Lo stesso modello in due harness diversi fa due lavori diversi. Ma per confrontarli onestamente bisogna dare a tutti e due lo stesso tempo e la stessa spesa.
Quando l’agente sbaglia, la prima domanda è che cosa gli mancava (un’istruzione, uno strumento, un ambiente che parte, il segno di dove si era arrivati, un controllo). Si cambia modello quando nessuna riparazione basta.
Ogni componente dell’harness costa, e racconta che cosa si pensava che il modello non sapesse fare. Si prova a toglierlo, su molti lavori e anche su quelli difficili, togliendo insieme i controlli che si coprono a vicenda, e si rifà la prova quando il modello cambia.
Da ricordare
Un sistema ad agente è una coppia \((\theta, H)\): l’harness \(H\) è tutto ciò che non è pesi, cioè istruzioni, catalogo con i permessi, ricetta dell’ambiente, stato persistente, verifica, e il ciclo che calcola \(g\) su due scale, il passo e la sessione. Il contesto muore con la sessione; il resto sopravvive, ed è da lì che la sessione dopo riparte.
La politica eseguita è \(\pi_{\theta,H}\): un banco di prova misura sempre una coppia, e i due fattori non si separano del tutto. I confronti a \(\theta\) fissato e \(H\) variabile vanno fatti a budget uguale, o confondono l’harness con il tempo e la spesa.
\(H\) non aggiunge capacità a \(\theta\), le aggiunge al sistema; ogni componente codifica un’ipotesi su che cosa il modello non sa fare da solo, e il suo valore cambia con \(\theta\) [Raj26].
Il gesto diagnostico attribuisce un fallimento a un sottosistema e lo ripara lì [Lop26]. L’ablazione stima \(\Delta s_h = s(\theta, H) - s(\theta, H \setminus \{h\})\) su una batteria fissata, con confronti appaiati, attenta alle interazioni fra componenti ridondanti, alla copertura della batteria e all’adattamento su di essa. Misura un valore marginale, non il collo di bottiglia.
Il bilancio si fa sul costo per compito risolto. I file di contesto non hanno cambiato in modo significativo il successo e hanno alzato il costo fino al 23%, ma erano ridondanti con la documentazione esistente, e il loro effetto cambia segno con il modello [GMundlerSMuller+26].