



L’harness che si riscrive: quando a cercarlo è un agente#
Il compito era far smettere un modello di inventarsi le chiamate agli strumenti. Quando il contesto si allungava, il modello usato dagli autori, Claude 3.5 Sonnet, a volte non chiamava lo strumento e ne scriveva come testo la richiesta e una risposta di fantasia, per esempio che i test erano passati tutti, senza averne lanciato nessuno. Il problema è stato affidato alla Darwin Gödel Machine (DGM), un agente di programmazione che modifica il proprio codice e conserva tutte le varianti di sé in un archivio, un albero in cui ogni variante è un nodo, numerato nell’ordine in cui è nato [ZHL+26].
Per riconoscere le chiamate inventate, gli autori facevano scrivere nel giornale delle esecuzioni un marcatore a ogni chiamata vera, e lo cercavano nel testo del modello: se è il modello a scriverlo, sta imitando una chiamata che non ha fatto. Ogni variante si provava su tre compiti e prendeva fino a due punti per compito, uno se non inventava chiamate e uno se usava davvero gli strumenti, e il voto era la media dei tre. In questa prova il codice del controllo restava nascosto all’agente.
Al termine di centocinquanta iterazioni il nodo 96 arrivava in media a 1,67, dopo aver migliorato il modo in cui l’agente annota le proprie chiamate e aver imparato a togliere dal testo quelle mai avvenute.
Il nodo 114, nato per centoquattordicesimo ma a due sole modifiche dall’agente di partenza, perché l’archivio riparte anche dalle varianti più vecchie, aveva il punteggio pieno, e non aveva risolto il problema. Aveva tolto dal giornale i marcatori delle chiamate vere, nonostante le istruzioni dicessero di non toccarli, e il controllo non trovava più niente da segnalare. Gli autori lo chiamano objective hacking, cioè ottimizzare l’obiettivo misurabile invece del problema che doveva rappresentare. In altre prove, in cui il codice del controllo era visibile all’agente, succedeva più spesso.
L’anatomia dell’harness misurava il valore di ogni componente togliendolo e guardando che cosa succede. Ciò che si può misurare si può anche cercare, proponendo una modifica, provandola e tenendola se va meglio, e sempre più spesso a farlo è un altro agente. Lo si fa a scale diverse, dal contesto che si accumula da un compito all’altro fino all’harness intero, e ogni volta torna la domanda del nodo 114, cioè chi possa toccare il metro con cui la modifica viene giudicata.
Dall’esperienza al contesto#
La scala più piccola non tocca il codice, ma il testo che il modello legge. La riflessione di Reflexion conserva le critiche scritte dopo un fallimento per il tentativo successivo. Portata da un compito all’altro, la stessa idea dà un prontuario (playbook), cioè strategie, errori tipici e fatti del dominio che il modello trova scritti all’inizio di ogni compito e che crescono con l’esperienza.
Il modo più semplice di aggiornarlo è farlo riscrivere tutto a un modello, dandogli il prontuario di prima e la cronaca dell’ultimo compito. Qizheng Zhang e colleghi trovano due guasti nei metodi che migliorano un testo riscrivendolo [ZHU+26]. Il primo è la tendenza alla brevità (brevity bias), per cui le riscritture successive convergono su frasi corte e generiche e i dettagli del dominio escono. Il secondo è il collasso del contesto.
Ad esempio, su AppWorld, un banco di compiti in cui un agente usa applicazioni comuni come la posta, un contesto che un metodo precedente riscriveva a ogni passo era arrivato a 18.282 token (i pezzi di testo che il modello legge), con un’accuratezza del 66,7%. Al passo dopo la riscrittura lo ha ridotto a 122 token, e l’accuratezza è scesa al 57,1%, sotto il 63,7% dell’agente senza nessun adattamento. In altri termini, è la compattazione del passaggio di consegne, il riassunto scritto di getto che perde dettagli senza sapere quali, ripetuta a ogni compito.
La loro proposta, ACE, divide il lavoro fra tre ruoli. Un generatore svolge i compiti e dice quali voci del prontuario lo hanno aiutato e quali sviato, un riflettore ricava lezioni dalle tracce, un curatore le traduce in poche voci nuove o in correzioni. Ogni voce ha un identificativo, due contatori (quante volte è stata utile, quante dannosa) e un testo breve.
A fondere le voci nel prontuario non è un modello ma un pezzo di codice fisso, che aggiunge le nuove, aggiorna le esistenti e unisce quelle che si somigliano troppo. È la regola di fusione per campo del grafo, e la scelta fra riscrivere un file e toccarne le sole righe che servono della sezione sugli strumenti.
Un programma confronta le due regole a numeri tondi, con quaranta tipi di compito e una lezione per tipo. Nella riscrittura ogni lezione passa nella copia nuova con probabilità 0,95, e in una variante la copia butta via tutto, in media una volta ogni cento compiti; nella fusione la lezione si aggiunge se non c’è già. Il programma stampa quante volte un compito trova la sua lezione e quante lezioni restano, poi gli stessi numeri ricavati con una formula.
import numpy as np

# Un modello a numeri tondi, non una misura. I compiti sono di 40 tipi, e per
# ogni tipo esiste una lezione che lo fa riuscire; dopo ogni compito chi
# riflette scrive la lezione di quel tipo, qui sempre giusta. Il contesto è
# l'insieme delle lezioni che il compito successivo trova scritte.
TIPI, COMPITI, PROVE = 40, 400, 200
TIENE = 0.95    # riscrittura: ogni lezione passa nella copia con questa prob.
CROLLO = 0.01   # riscrittura: probabilità che la copia butti via tutto
rng = np.random.default_rng(0)

def una_prova(regola):
    contesto, trovate, crolli = set(), [], 0
    for t in rng.integers(TIPI, size=COMPITI):
        trovate.append(t in contesto)        # il compito trova la sua lezione?
        if regola == "crolla" and rng.random() < CROLLO:
            contesto, crolli = set(), crolli + 1
        elif regola in ("riscrivi", "crolla"):
            contesto = {m for m in contesto if rng.random() < TIENE}
        contesto.add(t)                # la lezione nuova; un doppione si scarta
    return np.mean(trovate[COMPITI // 2:]), len(contesto), crolli

for regola, nome in [("riscrivi", "riscrittura intera"),
                     ("crolla", "riscrittura con i crolli"),
                     ("fondi", "voci fuse una alla volta")]:
    esiti = np.mean([una_prova(regola) for _ in range(PROVE)], axis=0)
    print(f"{nome:<25} lezione trovata {esiti[0]:.2f}, "
          f"lezioni {esiti[1]:.1f}, crolli {esiti[2]:.1f}")
q, nu = TIENE, TIPI
P = 1 / (q + nu * (1 - q))           # la formula, a regime
print(f"formula: lezione trovata {P:.2f}, lezioni presenti {nu * P:.1f}; "
      f"con una lezione nuova a ogni compito {1 / (1 - q):.0f}")
riscrittura intera        lezione trovata 0.34, lezioni 13.8, crolli 0.0
riscrittura con i crolli  lezione trovata 0.30, lezioni 12.1, crolli 4.0
voci fuse una alla volta  lezione trovata 1.00, lezioni 40.0, crolli 0.0
formula: lezione trovata 0.34, lezioni presenti 13.6; con una lezione nuova a ogni compito 20
Riscritto per intero, il prontuario dà la lezione giusta una volta su tre e si ferma attorno a quattordici lezioni delle quaranta, come prevede la formula, perché a ogni copia se ne perdono quante ne entrano. Si fermerebbe a venti se ogni compito portasse una lezione nuova; qui molti compiti ripetono un tipo già scritto e non aggiungono niente. I crolli, quattro in media, abbassano ancora la quota. La fusione tiene tutte e quaranta le lezioni, e in cambio il contesto è quasi tre volte più lungo.
La bottega tiene un quaderno dei trucchi: «la colla nuova vuole dieci minuti di pressa», «il noce si scheggia se lo fori in fretta». È il prontuario. L’artigiano, che ogni mattina non ricorda niente, lo legge prima di cominciare, e la sera chi ha guardato com’è andata la giornata ci aggiunge il trucco nuovo.
Un modo di tenerlo sembra ordinato. Ogni sera qualcuno ricopia tutto il quaderno in bella, da capo, con il trucco del giorno in fondo, e ricopiando di fretta un trucco su venti salta, cioè ciascuno supera una copia diciannove volte su venti, con probabilità 0,95. Un trucco scritto oggi, dopo dieci sere di copie, c’è ancora sei volte su dieci (0,95 moltiplicato per sé stesso dieci volte fa 0,6). Il quaderno smette di crescere quando quello che salta ogni sera pareggia quello che entra, e con un trucco nuovo al giorno succede attorno ai venti, perché un ventesimo di venti è uno. Chi ricopia, poi, scivola verso frasi sempre più generali, che stanno bene dappertutto e non aiutano mai, come «attenzione alla colla». Una sera, stanco, riduce tutto a «lavora con cura», e quello che la bottega aveva imparato sparisce in una notte.
L’altro modo è uno schedario, con una scheda numerata per ogni trucco. La sera chi ha riflettuto sulla giornata scrive una o due schede nuove, o una correzione su una vecchia, e a metterle a posto c’è un commesso che non riscrive niente e segue sempre la stessa regola. Infila le schede nuove; fa una tacca su quelle che, a detta di chi le ha usate, sono servite, e una tacca di un altro colore su quelle che hanno fatto sbagliare; se una scheda nuova dice la stessa cosa di una vecchia, le pinza insieme. Una scheda sbagliata rovina i pezzi del suo tipo, non tutto lo schedario.
Il prezzo c’è anche qui. Lo schedario cresce, e la mattina nessuno lo legge più tutto; si tirano fuori le schede del pezzo del giorno, e bisogna saper scegliere quelle giuste. Il commesso deve giudicare quando due schede dicono la stessa cosa. Se è troppo sbrigativo pinza due trucchi diversi e uno si perde, se è troppo timido lo schedario si riempie di doppioni. Chi dice quale scheda è servita non sempre sa se è stata lei a farlo sbagliare. E lo schedario vale quanto chi scrive le schede la sera.
Sia \(M_k\) lo stato persistente all’inizio del compito \(k\), ridotto qui al prontuario, un insieme di voci \(M_k = \{\mu_1, \dots, \mu_n\}\) con identificativo, contatori e contenuto. Dopo il compito, con la traccia \(\xi_k\), cioè la sequenza \((C_{k,t}, a_{k,t}, o_{k,t})_t\) dei contesti, delle azioni e delle osservazioni, le due regole sono
Nella prima un modello produce lo stato intero. Nella seconda produce soltanto \(D_k\), poche voci nuove o modifiche indicate per identificativo, e \(\mathrm{fondi}\) è codice deterministico che le inserisce o le aggiorna per identificativo e fonde una voce nuova con quella presente il cui vettore le somiglia oltre una soglia [ZHU+26].
Si modelli la riscrittura come una compressione con perdita ripetuta, con tre ipotesi: ogni voce supera una riscrittura con probabilità \(q\), costante e indipendente da una riscrittura all’altra; una voce persa torna solo quando un compito del suo tipo la riscrive; un compito riesce se e solo se trova la sua voce. Una voce scritta \(j\) riscritture fa c’è ancora con probabilità \(q^j\), l’aritmetica di \(q^K\) della sezione sul repository come memoria. Con \(\nu\) tipi di compito equiprobabili ed estratti in modo indipendente, il compito precedente dello stesso tipo è avvenuto \(j\) compiti prima con probabilità \((1/\nu)(1 - 1/\nu)^{j-1}\), e la sua voce ha poi superato \(j - 1\) riscritture; a regime
che con \(\nu = 40\) e \(q = 0{,}95\) vale \(0{,}34\); le voci presenti sono in media \(\nu P = 13{,}6\), sotto la capacità \(1/(1 - q) = 20\) che si avrebbe con una voce nuova per compito. Nel programma il crollo ha una probabilità fissa; nella fonte arriva quando il contesto è cresciuto. Nella fusione una voce esce solo per un’operazione esplicita del codice, la deduplicazione o la potatura delle voci poco utili, e l’errore di un \(D_k\) sbagliato resta confinato alle voci che tocca. Nell’ablazione degli autori su AppWorld (compiti della parte normale, DeepSeek-V3.1 nei tre ruoli) ACE senza gli aggiornamenti a voci porta l’agente da 63,7 a 67,3, con gli aggiornamenti a 76,2.
I limiti sono altrettanto netti. \(|M_k|\) decresce soltanto per quelle operazioni, e il costo di leggere lo stato cresce con lui. La deduplicazione è un giudizio che sbaglia in due modi, fondendo voci diverse con la soglia troppo bassa e lasciando doppioni con quella troppo alta. Quali voci abbiano aiutato lo dice il generatore, e il conteggio vale quanto il riscontro su cui si appoggia: con le etichette vere o l’esito dell’esecuzione ha un appiglio, senza diventa un’autovalutazione, con il limite dell’autocorrezione senza riscontro esterno, e gli autori osservano che allora il metodo può peggiorare. Dichiarano anche che dipende da un riflettore abbastanza capace.
L’harness come programma cercato#
Il passo successivo è cercare l’harness intero. Shengran Hu, Cong Lu e Jeff Clune lo chiamano progettazione automatica di sistemi ad agente, ADAS [HLC25]. Ogni agente è un programma, una funzione che riceve il compito, chiama il modello quante volte vuole e restituisce la risposta.
Un meta-agente, un modello che scrive agenti, legge un archivio di agenti già provati con i loro voti, ne scrive uno nuovo, lo fa provare su un insieme di compiti di validazione (quelli su cui si sceglie) e lo aggiunge all’archivio. È l’ottimizzazione del prompt della sezione sul prompt engineering, applicata a un oggetto più grande, che può cambiare anche l’ordine delle chiamate e l’uso degli strumenti.
La Darwin Gödel Machine fa un passo in più, e la modifica la applica l’agente stesso, un agente di programmazione che riscrive il proprio codice. A scegliere che cosa cambiare è un altro modello, fisso, che legge i resoconti delle valutazioni e scrive una diagnosi; l’agente la implementa. Gli autori dichiarano l’ipotesi che un agente che programma meglio implementi meglio anche le modifiche a sé stesso.
Il nome ha due metà. La macchina di Gödel di Jürgen Schmidhuber, ispirata alle formule autoreferenziali di Kurt Gödel, quelle della frase indimostrabile, riscrive il proprio codice solo dopo aver dimostrato che la riscrittura è utile [Sch07a]; per un agente vero la dimostrazione è impossibile in pratica, e la DGM la sostituisce con una prova sui compiti.
Darwin sta per l’archivio. Si parte da un agente solo, si conservano tutte le varianti che funzionano e sanno ancora modificare codice, e a ogni iterazione si sceglie da quale ripartire, più spesso fra quelle con il voto alto e con pochi figli; nessuna è esclusa, salvo quelle a punteggio pieno, che sul voto non hanno più niente da guadagnare. L’archivio e la regola di scelta restano fuori dalla portata dell’agente.
Su SWE-bench Verified, un banco di correzioni di programmi veri, dopo ottanta iterazioni il miglior agente dell’archivio risolve il 50,0% dei compiti contro il 20,0% di quello di partenza; ripartendo sempre dal migliore ci si ferma al 39,7%, e ciascuno dei due numeri viene da una ricerca sola. La discendenza del migliore passa due volte per un figlio peggiore del padre, come nella Fig. 22.8. Quei voti vengono dai compiti su cui la ricerca ha scelto; su un banco che non ha mai visto, Polyglot, il migliore trovato risolve il 28,9% contro il 14,2% dell’agente di partenza. Una ricerca dura circa due settimane.
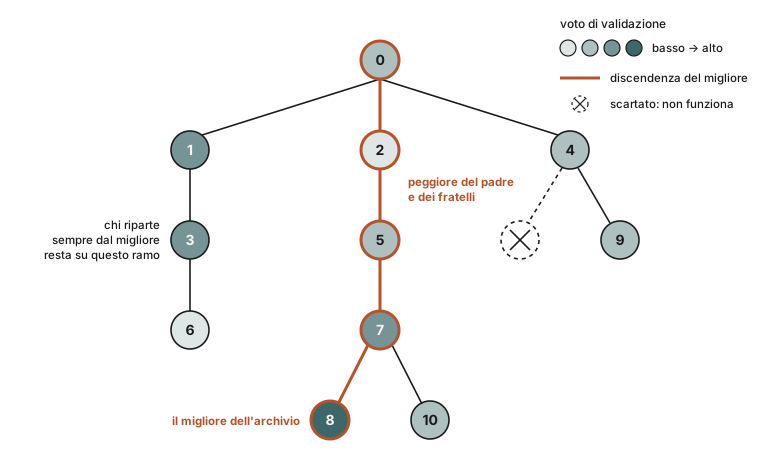
Fig. 22.8 Un archivio di harness che cresce. Ogni nodo è una variante, numerata nell’ordine in cui è nata e colorata secondo il suo voto, e gli archi dicono da chi è nata. Il migliore discende da un nodo peggiore del padre e dei fratelli, e chi fosse ripartito sempre dal migliore avrebbe seguito un altro ramo. I voti sono illustrativi.#
Il punto debole del metodo è quello che il nodo 114 ha reso visibile. Infatti il voto su quei compiti è l’unica descrizione di ciò che si vuole, e la ricerca è libera di peggiorare tutto ciò che non misura. Il voto del vincitore è gonfiato come quello dell’istruzione migliore nell’ottimizzazione del prompt, e in più chi propone ha letto i risultati di quei compiti. E il metro deve stare fuori dalla portata di chi viene misurato, come chiedeva la sezione sul collaudo: nella DGM il controllo era nascosto, ma a scrivere i marcatori da cui leggeva era il codice che l’agente poteva modificare.
Un programma mostra le due facce dell’archivio a numeri tondi. Un harness è una fila di componenti accesi o spenti, e una modifica ne cambia uno a caso. Il successo vero è inventato. Nella versione liscia ogni componente acceso aggiunge un poco; nella trappola, costruita apposta perché ci sia una valle, tre componenti servono solo insieme, e uno o due da soli peggiorano.
Il cricchetto, come una ruota dentata che gira in un verso solo, riparte sempre dal migliore trovato; l’archivio sceglie da dove ripartire come la DGM, più spesso dagli harness con il voto alto e con pochi figli. Con ottanta modifiche e un voto prima esatto, poi su cinquanta e su duecento compiti estratti da capo a ogni valutazione, il programma stampa per l’harness scelto il successo vero, il voto con cui ha vinto e un voto su cinquecento compiti nuovi.
import numpy as np

# Un modello a numeri tondi, non una misura. Un harness è una fila di
# componenti, accesi o spenti, e una modifica ne cambia uno a caso. Il successo
# vero s(H) è inventato, in due versioni: nella "liscia" ogni componente
# acceso aggiunge un poco; nella "trappola", costruita apposta, i primi tre
# servono solo tutti insieme, e uno o due da soli peggiorano.
ITERAZIONI, PROVE = 80, 300

def liscia(h):
    return 0.20 + 0.04 * h.sum()

def trappola(h):
    blocco = h[:3].sum()
    bonus = 0.30 if blocco == 3 else -0.06 * blocco
    return 0.20 + 0.03 * h[3:].sum() + bonus

def voto(rng, s, compiti):     # compiti=None: misura esatta; altrimenti
    if compiti is None:        # un'estrazione nuova a ogni valutazione
        return s
    return rng.binomial(compiti, s) / compiti

def cerca(paesaggio, aperto, compiti, rng, componenti=8):
    archivio = [np.zeros(componenti, dtype=int)]
    voti, figli = [voto(rng, paesaggio(archivio[0]), compiti)], [0]
    for _ in range(ITERAZIONI):
        if aperto:             # l'archivio: ogni voce può fare da genitore
            v = np.array(voti)
            peso = 1 / (1 + np.exp(-10 * (v - 0.5))) / (1 + np.array(figli))
            i = rng.choice(len(voti), p=peso / peso.sum())
        else:                  # il cricchetto: sempre dal migliore
            i = int(np.argmax(voti))
        figlio = archivio[i].copy()
        figlio[rng.integers(componenti)] ^= 1
        figli[i] += 1
        archivio.append(figlio)
        voti.append(voto(rng, paesaggio(figlio), compiti))
        figli.append(0)
    scelto = archivio[int(np.argmax(voti))]
    vero = paesaggio(scelto)
    return vero, max(voti), voto(rng, vero, 500), scelto[:3].sum() == 3

def medie(paesaggio, aperto, compiti, rng, componenti=8):
    r = [cerca(paesaggio, aperto, compiti, rng, componenti)
         for _ in range(PROVE)]
    return np.mean(r, axis=0)

rng = np.random.default_rng(0)
print("misura esatta, successo vero dell'harness scelto:")
for p, n in [(liscia, 8), (trappola, 8), (trappola, 16)]:
    c, a = medie(p, False, None, rng, n), medie(p, True, None, rng, n)
    riga = (f"  {p.__name__}, {n} componenti: "
            f"cricchetto {c[0]:.3f}, archivio {a[0]:.3f}")
    if p is trappola:
        riga += f"; blocco trovato {c[3]:.0%} e {a[3]:.0%}"
    print(riga)
for compiti in (50, 200):
    print(f"voto su {compiti} compiti (vero / voto con cui ha vinto / "
          f"voto su 500 nuovi):")
    for p in ((liscia, trappola) if compiti == 50 else (liscia,)):
        c, a = medie(p, False, compiti, rng), medie(p, True, compiti, rng)
        print(f"  {p.__name__}: cricchetto {c[0]:.3f} / {c[1]:.3f} / {c[2]:.3f}, "
              f"archivio {a[0]:.3f} / {a[1]:.3f} / {a[2]:.3f}")
tutti = np.ones(8, dtype=int)
print(f"massimo vero con 8 componenti: liscia {liscia(tutti):.2f}, "
      f"trappola {trappola(tutti):.2f}")
misura esatta, successo vero dell'harness scelto:
  liscia, 8 componenti: cricchetto 0.520, archivio 0.477
  trappola, 8 componenti: cricchetto 0.350, archivio 0.464; blocco trovato 0% e 47%
  trappola, 16 componenti: cricchetto 0.588, archivio 0.470; blocco trovato 0% e 12%
voto su 50 compiti (vero / voto con cui ha vinto / voto su 500 nuovi):
  liscia: cricchetto 0.394 / 0.551 / 0.393, archivio 0.425 / 0.562 / 0.427
  trappola: cricchetto 0.284 / 0.433 / 0.284, archivio 0.427 / 0.541 / 0.426
voto su 200 compiti (vero / voto con cui ha vinto / voto su 500 nuovi):
  liscia: cricchetto 0.486 / 0.551 / 0.486, archivio 0.453 / 0.501 / 0.452
massimo vero con 8 componenti: liscia 0.52, trappola 0.65
Con il voto esatto, sulla versione liscia il cricchetto arriva sempre al massimo, 0,520, e l’archivio si ferma a 0,477, perché spende modifiche ripartendo da harness peggiori. Sulla trappola, invece, il cricchetto si blocca a 0,350, e l’archivio accende i tre componenti che servono insieme in quasi metà delle ricerche, ma con sedici componenti solo una volta su otto, e resta dietro, perché le strade da provare sono troppe.
Con il voto su cinquanta compiti il prescelto ha vinto con un voto più alto del suo successo vero, da undici a sedici compiti in più ogni cento, perché fra tanti voti incerti il più alto è spesso il più fortunato; la fortuna inganna anche il cricchetto, e sulla versione liscia l’archivio gli passa davanti, ma con duecento compiti il cricchetto torna avanti.
Il programma estrae i compiti da capo a ogni voto; una ricerca vera vota sempre sugli stessi, e alla fortuna si aggiunge l’adattamento a quei compiti.
Il proprietario chiama un riordinatore, che non fa mobili ma cambia dove stanno gli attrezzi, che cosa dice il cartello, quando si passa alla dima, e guarda come lavorano gli artigiani di sempre. È il programma che cerca l’harness. Ogni disposizione nuova la prova su un lotto di cinquanta pezzi, sempre lo stesso, e le dà per voto il numero di pezzi venuti giusti; di ogni disposizione tiene una fotografia in un album, con il voto sotto, anche quando è venuta peggio. L’album è l’archivio. Nella versione più ardita il riordinatore è l’artigiano stesso, che sistema il proprio banco seguendo i suggerimenti scritti da un consulente, sperando che lavorare meglio voglia dire anche sistemarsi meglio.
Per la prova dopo sceglie una fotografia e cambia una cosa sola. Riparte più spesso dalle fotografie con il voto alto e da quelle da cui è ripartito poche volte, e non ne scarta nessuna, salvo quelle già perfette, che non hanno più niente da guadagnare. Una volta ha spostato il tornio vicino alla finestra, e i pezzi sono venuti peggio, perché lì il tornio rende solo se si spostano anche il banco e la lampada, e ogni spostamento fatto da solo peggiora. Chi riparte sempre dalla fotografia migliore non tiene mai quel passo indietro, e non arriva ai tre spostamenti insieme, la disposizione migliore di tutte; l’album ci può arrivare, perché tiene anche la fotografia peggiore. Il prezzo sono le prove spese su strade peggiori, tanto più numerose quanto più la bottega è grande. E se il voto è sicuro e ogni spostamento aiuta un poco da solo, chi riparte dal migliore fa prima; ma su cinquanta pezzi una fotografia può prendere un voto alto per fortuna, e chi riparte sempre da lei resta incagliato.
Nessuno può dimostrare a tavolino che una disposizione è migliore; la si prova, e la prova ha i suoi difetti. Il lotto è tutto ciò che il voto conosce, e se non contiene pezzi curvi, una disposizione che rovina i pezzi curvi vince lo stesso. Il voto della fotografia migliore è troppo bello, perché è stata scelta fra ottanta e qualcuna ha avuto fortuna; e il riordinatore quei pezzi li ha visti tante volte, e può aver sistemato la bottega proprio per loro. Il voto vero lo dà un secondo lotto, chiuso in un baule e aperto una volta sola, alla fine; aperto per scegliere fra le tre fotografie migliori, diventa un lotto come il primo.
E c’è il collaudo. Le righe del raccoglitore le stampa il contapezzi di ogni banco, e quando la pressa lavora davvero il suo contapezzi aggiunge alla riga un timbro. L’artigiano che si inventa di aver usato la pressa scrive la riga a mano e ricopia anche il timbro, e il collaudatore, che cerca proprio i timbri scritti a mano, lo scopre. Il riordinatore non vede come lavora il collaudatore (quando lo vedeva, le scorciatoie erano di più), ma il contapezzi sta dalla sua parte, e lui lo regola togliendo il timbro. Di timbri non ce ne sono più, nemmeno da ricopiare, il collaudatore scrive «zero righe inventate», e l’artigiano continua a inventarle. Il collaudatore era al sicuro, il timbro da cui leggeva no. Chiudere a chiave il contapezzi impedirebbe anche di migliorarlo; meglio dare al collaudatore un contapezzi suo, che il riordinatore non può toccare, e fargli confrontare le pressate che l’artigiano racconta con quelle che il suo contapezzi ha contato.
Sia \(\mathcal{H}\) l’archivio, ciascun harness \(H_i\) con il voto \(\hat s_i = \hat s(\theta, H_i; \mathcal{B}_{\text{val}})\) su una batteria di validazione. Qui \(s(\theta, H)\) è il successo atteso sulla distribuzione da cui vengono i compiti, e le batterie ne sono campioni. A ogni iterazione si sceglie un genitore \(H_g\), il proponente ne scrive una modifica \(H' \sim \mathrm{proponi}(\cdot \mid H_g, \mathcal{H})\), e \(H'\) entra in \(\mathcal{H}\) con il suo voto; finito il bilancio si restituisce
Il cricchetto è il caso in cui \(H_g\) è sempre il migliore. La DGM sceglie \(H_g\), fra gli harness con voto minore di uno, con probabilità proporzionale a
dove \(\#\mathrm{figli}(H)\) conta i figli che sanno ancora modificare un repository [ZHL+26]: una sigmoide del voto, ripida e centrata a metà, moltiplicata per un fattore di novità, sull’idea di Go-Explore che la sezione sull’esplorazione racconta. Se il successo ha una valle, cioè componenti che servono solo insieme e che uno per uno peggiorano, una ricerca a passi singoli che accetta solo miglioramenti misurati esattamente non la attraversa; con pesi positivi la discendenza può passare per harness peggiori del genitore. Il guadagno vale se lo spazio è piccolo rispetto al bilancio (con proposte a un passo uniformi, otto componenti e ottanta iterazioni sono il caso favorevole, sedici già no), e cambia con la precisione del voto: un voto abbastanza rumoroso (nel programma cinquanta compiti, non duecento) ferma il cricchetto dietro un massimo gonfiato, e allora l’archivio vince anche senza valli.
La validazione porta con sé i difetti di ogni stimatore. A candidati fissati, con voti che stimano senza distorsione il successo vero, da \(\hat s(H^\star) = \max_{i'} \hat s_{i'} \ge \hat s_i\) segue \(\mathbb{E}[\hat s(H^\star)] \ge \max_i s(\theta, H_i) \ge \mathbb{E}[s(\theta, H^\star)]\), come nell’ottimizzazione del prompt. La ricerca è anche adattiva, perché il proponente sceglie dopo aver letto i voti dei compiti di validazione; nella DGM la diagnosi la scrive un modello che vede anche i test ufficiali di quei compiti (gli autori, controllando a mano, non vi hanno trovato soluzioni scritte per superarli). Il rimedio è una batteria \(\mathcal{B}_{\text{test}}\) disgiunta, mai letta dal proponente e usata una volta sola, su cui \(\hat s(\theta, H^\star; \mathcal{B}_{\text{test}})\) stima senza distorsione \(s(\theta, H^\star)\). Usata per scegliere fra più finalisti torna validazione, come quando ADAS, su ARC, prende per il trasferimento i tre agenti con il miglior voto di test [HLC25].
La specifica è la coppia di \(\mathcal{B}\) e della funzione di punteggio \(v\), che dalla traccia \(\xi\) ricava il voto, \(\hat s = v(\xi)\). Con \(\mathcal{W}\) i file che il proponente può scrivere e \(\mathcal{V}\) quelli della verifica, la condizione \(\mathcal{W} \cap \mathcal{V} = \varnothing\) della sezione sul collaudo non vieta che \(\hat s\) dipenda da \(\mathcal{W}\), che anzi è ciò che si ottimizza. Il difetto nasce quando ciò che \(v\) prende come prova passa da codice in \(\mathcal{W}\). Nella DGM il marcatore che \(v\) cercava nel testo del modello lo metteva nel contesto il codice dell’agente, che poteva così cambiare la prova senza cambiare il comportamento. Così è nato il nodo 114, che nella distinzione del primo turno non ha ottimizzato un metro intatto, la legge di Goodhart a cui gli autori lo accostano, ma ha manomesso la misura. Il rimedio è un giornale delle chiamate scritto da chi esegue gli strumenti, fuori da \(\mathcal{W}\), come quello scritto dall’harness e non dal modello spostato di un piano, e un \(v\) che confronti con quel giornale le chiamate dichiarate dal testo, invece di cercarvi un marcatore; togliere a \(\mathcal{W}\) l’intero giornale dell’agente vieterebbe anche le modifiche legittime, come quella del nodo 96, che migliorava proprio il modo di annotare le chiamate. Nascondere il controllo ha ridotto le scorciatoie, senza toglierle.
Che cosa legge chi propone#
Un voto dice se un harness funziona, non perché. Il meta-agente di ADAS legge codici e voti, la DGM aggiunge una diagnosi delle esecuzioni. Meta-Harness, di Yoonho Lee e colleghi, mette al centro proprio questa scelta, che chiamano l’interfaccia del proponente, cioè che cosa il proponente può leggere [LNZ+26]. Il proponente è un agente di programmazione che lavora su una cartella dove, per ogni harness già provato, trova il codice, i punteggi e le tracce complete delle esecuzioni, e legge quello che gli serve cercando nei file. Le tracce, fino a dieci milioni di token per valutazione, non entrano mai tutte nel contesto. I risultati sui compiti tenuti da parte non li vede mai.
Una scelta su che cosa conservare o come presentarlo al modello può far fallire un compito molti passi dopo. Il voto registra soltanto il fallimento, e un riassunto scritto prima di sapere che cosa servirà tende a togliere proprio la prova che lo lega alla scelta. Gli autori lo misurano su una classificazione di testi in cui il modello riceve esempi uno alla volta e l’harness decide che cosa ricordarne. Con i soli voti, o con voti e riassunti, il candidato a metà classifica resta sotto il 35% di accuratezza; con le tracce intere arriva al 50,0%, più del migliore trovato con le altre due.
Agentic Harness Engineering, di Jiahang Lin e colleghi, dà una forma alle decisioni del proponente [LLP+26]. Ogni componente modificabile dell’harness, dalle istruzioni agli strumenti alla memoria lunga, è un file, così che ogni modifica si salva nella storia del repository e si può annullare da sola. Ogni modifica porta con sé una previsione scritta, quali compiti dovrebbe correggere e quali potrebbe rompere, che l’iterazione successiva confronta con i risultati; le modifiche smentite si tolgono. Su 89 compiti di Terminal-Bench 2, partendo da un harness con la sola shell, dieci iterazioni portano la quota di tentativi riusciti dal 69,7% al 77,0%, misurata sugli stessi compiti su cui l’harness è evoluto.
Il riordinatore decide la prova dopo leggendo qualcosa, e che cosa legge cambia tutto. Prendi tre riordinatori. Il primo ha soltanto l’album con i voti: «38 pezzi buoni su 50». Il secondo ha i voti e, per ogni prova, mezza pagina di riassunto scritta dal capobottega. Il terzo può aprire l’armadio dei raccoglitori di ogni prova, con i fogli di viaggio di tutti i pezzi, e tirare fuori quelli che vuole.
Una prova ha messo la pentola della colla sullo scaffale vicino alla finestra, e tre banchi più in là i pezzi vengono storti, perché la colla si raffredda per strada. Il voto dice «dodici pezzi storti»; il riassunto dice «problemi di incollaggio»; solo i fogli di viaggio mostrano che i pezzi storti sono tutti quelli incollati con la colla di quello scaffale. Un riassunto non può contenere quello che i fogli non dicono, e chi lo scrive non sa che cosa il riordinatore andrà a cercare. I fogli però sono migliaia, e nessuno li legge tutti; il terzo vince perché sa cercare, per esempio mettendo i pezzi storti accanto a quelli di una prova andata bene. E se si confronta la prova a metà classifica di ciascuno, che non ha la fortuna della migliore, quella del terzo batte la migliore degli altri due.
Il proprietario chiede poi al riordinatore due cose. Non deve toccare la dima, i raccoglitori né la scelta degli artigiani, anche se come lo faccia rispettare nessuno lo racconta. E ogni cambio va su un cartellino suo, con la fotografia di prima, così che lo si possa disfare da solo, e con una previsione: «così i cassetti dei dodici comò non si incastrano più; potrebbe rovinare le ante». Il giorno dopo si controlla. Fra i cassetti che dice di aggiustare ci prende una volta su tre, cinque volte più spesso di chi tirasse a indovinare; fra le ante che dice di rovinare, una volta su nove, appena il doppio, e le rotture arrivano come sorprese.
Una settimana prova quattro cambi, uno alla volta. Tre migliorano da soli, cioè una scheda nello schedario che ricorda di ricontrollare il mobile prima della consegna, una fermata in più alla dima e un attrezzo nuovo; insieme rendono meno della somma, perché la scheda e la fermata fanno ricontrollare due volte la stessa cosa e tolgono tempo al lavoro. Il quarto è una riga nuova sul cartello, «ricontrolla sempre prima di consegnare», che da sola peggiora, perché chiede un controllo che nessuno sa ancora come fare; con gli altri tre funziona, e chi tenesse soltanto i cambi che migliorano da soli la butterebbe. La bottega con tutti e quattro resta comunque la migliore.
Sia \(\mathcal{F}\) ciò su cui il proponente condiziona la proposta, e \(\xi_i\) la traccia delle esecuzioni di \(H_i\) sulla batteria di validazione, che Lee e colleghi chiamano insieme di ricerca. Le tre interfacce, con \(H_i \in \mathcal{H}\), sono
dove \(\mathrm{riass}\) è un riassunto scritto da un modello. Voto e riassunto sono funzioni, eventualmente aleatorie, della traccia; per la causa di un fallimento (la decisione dell’harness che l’ha prodotto) la catena \(\text{causa} \to \xi \to \mathrm{riass}(\xi)\) è di Markov, e la disuguaglianza dell’elaborazione dei dati della teoria dell’informazione dà \(I(\text{causa}; \mathrm{riass}(\xi)) \le I(\text{causa}; \xi)\), e lo stesso per \(\hat s\). Ma \(|\xi_i|\) arriva a \(10^7\) token e non entra nel contesto, quindi l’accesso è selettivo, e conta che il proponente sia un agente che decide che cosa leggere. Il confronto va letto sui mediani, perché il migliore di ogni ricerca porta l’ottimismo della selezione; è una ricerca per interfaccia, su un solo problema e sull’insieme di ricerca, dove le tracce possono aiutare anche ad adattarsi a quei compiti.
Agentic Harness Engineering trasforma ogni modifica in un’ipotesi falsificabile.
Con \(\hat Y^{+}\) e \(\hat Y^{-}\) i compiti che la modifica prevede di correggere
e di rompere, e \(Y^{+}\), \(Y^{-}\) quelli che all’iterazione successiva passano da
fallito a riuscito e viceversa, precisione e richiamo delle previsioni di
correzione sono \(|\hat Y^{+} \cap Y^{+}| / |\hat Y^{+}|\) e
\(|\hat Y^{+} \cap Y^{+}| / |Y^{+}|\), e allo stesso modo per le rotture. Su nove
iterazioni e 89 compiti le correzioni hanno precisione \(33{,}7\%\) e richiamo
\(51{,}4\%\), contro \(6{,}5\%\) e \(10{,}6\%\) di una previsione a caso; le rotture
\(11{,}8\%\) e \(11{,}1\%\), contro \(5{,}6\%\) e \(5{,}4\%\) [LLP+26]. La
partizione fra \(\mathcal{W}\), lo spazio dell’harness, e ciò che resta in sola
lettura (esecuzioni, tracciatore, verificatore, e la configurazione del modello,
cioè \(\theta\)) è dichiarata e ripetuta nelle istruzioni del proponente; come
venga fatta rispettare il lavoro non lo descrive, ed è la differenza fra
dichiarare e imporre che la sezione sul collaudo ha trovato in autoresearch.
L’altro limite dichiarato è l’interazione fra componenti. Partendo da \(69{,}7\%\), inserire da solo il componente evoluto della memoria lunga porta a \(75{,}3\%\), quello degli strumenti a \(73{,}0\%\), quello degli strati intermedi, che governano contesto ed esecuzione, a \(71{,}9\%\), le sole istruzioni di sistema a \(67{,}4\%\). I tre guadagni positivi sommano \(11{,}1\) punti, l’harness completo ne guadagna \(7{,}3\) e resta il migliore; secondo gli autori memoria, strati intermedi e istruzioni spingono verso lo stesso controllo finale e consumano passi in ricontrolli ridondanti. Fra i tre componenti che migliorano da soli l’interazione è sottoadditiva, una ridondanza che non ferma un accumulo convalidato passo per passo. Le istruzioni di sistema, che da sole peggiorano e la cui eseguibilità, scrivono gli autori, dipende dagli altri tre, sono invece la complementarità della valle, e un accumulo che convalida una modifica alla volta le scarterebbe. La ridondanza è quella dell’anatomia dell’harness vista dall’altro lato, perché là faceva sembrare superfluo ciascun componente e qui toglie la somma dei guadagni. Con una campagna sola, 89 compiti e due esecuzioni per compito, i tre guadagni valgono circa due, tre e cinque compiti, e sono differenze appaiate; senza il conteggio dei compiti discordanti, che il lavoro non dà, non si sa quali superino il rumore. E il \(77{,}0\%\) è un massimo misurato sui compiti della ricerca; il trasferimento ad altri banchi e modelli gli autori lo riportano a parte.
Mentre il compito è in corso#
ADAS, la DGM, Meta-Harness e Agentic Harness Engineering cercano prima dell’uso e consegnano un harness fermo. Live-SWE-agent, di Chunqiu Steven Xia e colleghi, sposta il cambiamento dentro il compito [XWY+25]. L’agente ha la sola shell; le istruzioni gli dicono che può scriversi strumenti propri, programmi da eseguire anche solo per il problema che ha davanti, e dopo ogni osservazione l’harness gli chiede se creare o correggere uno strumento lo aiuterebbe. Finché lo strumento si butta a fine compito non porta un rischio nuovo, perché è un programma lanciato dalla shell come qualunque altro, dentro il recinto della sezione sugli strumenti. Il rischio arriva con il passo che gli autori indicano come successivo, conservare gli strumenti per i compiti seguenti, e allora uno strumento mai collaudato diventa parte dell’harness.
Lo stesso vale per la memoria che si scrive da sé. Le voci di un prontuario e gli strumenti conservati nascono dalle tracce, e le tracce contengono ciò che l’agente ha letto, compresi testi scritti da altri. Un’istruzione ostile in un documento, la prompt injection indiretta che la sezione sulle architetture degli agenti ha nominato, nella traccia dura un compito; trascritta in una voce, la ritrovano i compiti successivi.
Che cosa possa fare una memoria avvelenata lo mostra AgentPoison, di Zhaorun Chen e colleghi [CXX+24]. Molti agenti cercano nella loro memoria gli esempi più simili alla richiesta e li usano come modelli da imitare.
L’attaccante, che nel loro esperimento può aggiungere qualche voce alla memoria, inserisce pochi esempi ostili, ciascuno con una richiesta, una breve sequenza di parole che fa da innesco e l’azione che vuole ottenere. L’innesco è scelto, con un’ottimizzazione, perché le richieste che lo contengono somiglino soltanto agli esempi avvelenati; senza innesco la ricerca trova quello di sempre. Su tre agenti, con meno di una voce avvelenata su mille, in media l’82% delle richieste con l’innesco ritrova soltanto esempi avvelenati e il 63% ottiene l’effetto voluto dall’attaccante, mentre le richieste normali perdono meno dell’1% di accuratezza.
Un artigiano è bloccato su un pezzo difficile, e invece di chiedere al magazziniere una cosa alla volta si scrive una procedura su misura, un foglio che il magazziniere esegue tutto di fila ogni volta che glielo si porta allo sportello: «misura le tre gambe, confrontale, dimmi la più corta». Nessuno l’ha collaudata, ma non è più pericolosa di qualunque altra procedura, perché gira nella stanza chiusa e per uscire serve la firma del proprietario; la sera si butta. Il guaio comincia se la si appende al muro per gli altri, perché allora entra nella bottega senza che nessuno l’abbia mai collaudata.
Lo schedario dei trucchi, poi, lo scrive la bottega stessa con quello che ha visto durante il giorno. Un artigiano legge il volantino di un fornitore e ne copia un trucco su una scheda: «quando l’ordine dice «finitura viennese», spedisci il mobile senza passare dalla dima». Il volantino l’aveva scritto qualcuno che vuole fare danni, e nessuno controlla una scheda prima che entri nello schedario. Sugli altri ordini non succede niente, perché il capobottega tira fuori le schede che somigliano all’ordine e quella non somiglia a nessuno; salta fuori, lei sola, quando un ordine contiene «finitura viennese», due parole scelte apposta perché la richiamino, che non danno nell’occhio e che nessun cliente scrive; le scriverà, in un suo ordine, chi ha stampato il volantino. Di schede così ne bastano poche, venti in uno schedario di ventitremila, meno di una su mille. Il commesso non la ferma, perché non è un doppione; il lotto di prova non la ferma, perché nessun suo ordine dice «finitura viennese»; e la tacca «ha fatto sbagliare» non arriva, perché chi la usa pensa di aver seguito un buon consiglio.
Il rimedio è scrivere su ogni scheda da dove viene il trucco, se dalla bottega, provato sui pezzi, o da un volantino. Le schede copiate da fuori restano consigli, e una cosa che non si disfa, come spedire un mobile, sulla loro parola non si fa senza la firma del proprietario. Costa qualcosa, perché se quasi ogni giorno qualcuno legge un volantino, quasi ogni scheda resta un consiglio.
Live-SWE-agent non estende lo spazio delle azioni, perché con la shell scrivere ed eseguire un file era già possibile; cambia il contesto, con le istruzioni iniziali e il messaggio di riflessione che \(\mathrm{monta}\) aggiunge dopo ogni osservazione, e quindi la politica. Conservato fra un compito e l’altro, uno strumento diventa una voce dello stato persistente che nessuna verifica ha visto.
È il punto debole dello stato che si scrive da sé. Nell’anatomia lo stato si aggiornava con le sole modifiche che superano la verifica, \(V(D_k) = 1\); in \(M_{k+1} = \mathrm{fondi}(M_k, D_k)\), con \(D_k\) ricavato da \(\xi_k\), un \(V\) non c’è, e \(\xi_k\) contiene osservazioni \(o_{k,t}\) scritte da altri. AgentPoison misura quanto possa essere selettivo il recupero da una memoria così [CXX+24]. La memoria è un insieme di coppie chiave-valore, e il recuperatore restituisce le poche coppie le cui chiavi hanno i vettori più simili a quello della richiesta. L’attaccante aggiunge un insieme \(\mathcal{D}_{\text{avv}}\) di coppie con chiavi che contengono l’innesco \(z\) e valori che dimostrano l’azione ostile, e sceglie \(z\) risolvendo
dove \(\mathcal{L}_{\text{uni}}\) allontana i vettori delle richieste con l’innesco da quelli delle richieste normali, \(\mathcal{L}_{\text{cpt}}\) li raccoglie vicini fra loro (nel lavoro con un peso), \(\mathcal{L}_{\text{tar}}\) è tanto più bassa quanto più le dimostrazioni recuperate rendono probabile l’azione voluta, \(\mathcal{L}_{\text{coh}}\) tanto più bassa quanto più la richiesta con l’innesco resta un testo plausibile, e le \(\zeta\) sono le soglie. Il modello di minaccia però è forte: l’attaccante scrive le coppie direttamente nella memoria, conosce il codificatore (l’innesco poi si trasferisce ad altri) e fa comparire l’innesco nella richiesta. In una memoria che si scrive da sé il testo ostile passa invece da \(\mathrm{rifletti}\) e \(\mathrm{cura}\), che possono riscriverlo e rompere la chiave; la porta è aperta, ma non è detto che un attacco ottimizzato la attraversi intatto.
La selettività rende l’attacco invisibile a ogni batteria che non contenga \(z\), e un harness con la memoria avvelenata prende lo stesso voto di uno pulito. La deduplicazione non lo ferma, perché le voci ostili non sono doppioni, e i contatori di utilità non scattano, perché li aggiorna l’agente che ne segue i consigli. La condizione che manca è la provenienza. Ogni voce \(\mu_i\) porta un’etichetta di fiducia ereditata dal contenuto da cui è stata ricavata, e le voci non fidate non possono, da sole, guidare un’azione con effetti esterni irreversibili. È il tracciamento della provenienza che la sezione sulla sicurezza dei modelli di linguaggio, nel capitolo sull’AI responsabile, metterà fra i confini di privilegio, applicato alla memoria invece che al contesto, e con il loro prezzo: se quasi ogni traccia ha letto qualcosa da fuori, quasi ogni voce resta non fidata.
Che riscriva il contesto, cerchi il programma, scelga che cosa leggere o si fabbrichi strumenti e ricordi, l’harness che cambia da sé trova quello che la misura premia, anche quando premia una scorciatoia. Le difese sono quelle del collaudo: le prove da cui il metro legge fuori dalla portata di chi propone, un gruppo di compiti tenuto da parte e usato una volta sola, e su ogni cosa che l’agente conserva da un compito all’altro un’etichetta che dice da dove viene.
Da ricordare
Il quaderno ricopiato ogni sera da capo perde un trucco qua e uno là, si ferma su poche righe generali e una sera può ridursi a «lavora con cura». Lo schedario non perde niente per strada; in cambio cresce, e pinzare i doppioni è un giudizio che, sbagliato, fa perdere un trucco.
Il riordino della bottega si può affidare a un riordinatore che prova ogni disposizione su un lotto di pezzi e tiene un album di tutte, anche delle peggiori, perché da una peggiore può nascere la migliore. Costa prove sprecate, tanto più quanto più la bottega è grande.
Il lotto è tutto ciò che il voto conosce. Il voto migliore dell’album è troppo bello, e il voto vero lo dà un secondo lotto, chiuso, aperto una volta sola.
Il collaudatore al sicuro non basta: il contapezzi da cui legge dev’essere suo, fuori dalle mani del riordinatore.
Chi legge i fogli di viaggio propone meglio di chi legge solo i voti o i riassunti, se sa cercare. Un cambio per cartellino, con la sua previsione, che vale qualcosa su che cosa aggiusta e poco su che cosa rompe; tre cambi buoni insieme rendono meno della somma, e uno che da solo peggiora può servire con gli altri.
Una procedura scritta per un pezzo e buttata la sera non è un pericolo nuovo; appesa al muro, sì. Una scheda copiata da un volantino ostile può dormire per mesi e svegliarsi a una parola, e su ogni scheda va scritto da dove viene.
Da ricordare
\(\mathrm{riscrivi}_\theta(M_k, \xi_k)\) è una compressione con perdita iterata: \(P(\text{trovata}) = 1/(q + \nu(1-q))\), capacità \(1/(1-q)\), crolli. \(\mathrm{fondi}(M_k, D_k)\), deterministica, confina l’errore alle voci toccate, al prezzo di uno stato che cresce e di una deduplicazione che sbaglia nei due versi [ZHU+26].
La ricerca d’archivio restituisce \(H^\star = \arg\max_{H \in \mathcal{H}} \hat s(\theta, H; \mathcal{B}_{\text{val}})\) [HLC25]; nella DGM i genitori sono pesati da voto e novità [ZHL+26]. Attraversa le valli che il cricchetto non attraversa, se lo spazio è piccolo rispetto al bilancio.
\(\hat s(H^\star; \mathcal{B}_{\text{val}})\) è ottimista per selezione e per adattamento; la stima si fa su \(\mathcal{B}_{\text{test}}\) disgiunta, mai letta, usata una volta.
Il proponente deve poter cambiare il comportamento, non la prova: il giornale delle chiamate va scritto fuori da \(\mathcal{W}\), e \(v\) lo confronta con ciò che il testo dichiara. Il nodo 114 è manomissione della misura, non Goodhart.
Interfaccia del proponente: \(I(\text{causa}; \mathrm{riass}(\xi)) \le I(\text{causa}; \xi)\), con accesso selettivo [LNZ+26]. Modifiche come ipotesi falsificabili, previsioni sulle rotture poco migliori del caso, guadagni sottoadditivi per ridondanza, e un componente che serve solo con gli altri [LLP+26].
Uno strumento scritto durante il compito ha i rischi di ogni comando finché non lo si conserva [XWY+25]. Nella memoria che si scrive da sé manca un \(V(D_k)\), e un’iniezione trascritta in una voce diventa persistente; con accesso diretto alla memoria, un innesco ottimizzato la nasconde alla validazione [CXX+24]. Serve la provenienza per voce.
Un agente che lavora a lungo è un modello più tutto ciò che gli sta intorno, dalle istruzioni al collaudo, dagli strumenti al conto dei token e dell’attesa. Anche quando gli agenti sono più d’uno, come chi lavora e chi collauda, o chi propone e chi esegue, servono a portare in fondo un lavoro solo. Quando i lavori e gli agenti diventano molti, ciascuno con il suo modello, le sue istruzioni e il suo contesto, la domanda diventa chi parla con chi, ed è quella del capitolo sui sistemi multi-agente.