



Servire un agente: richieste che aspettano#
Una calcolatrice risponde in meno di un millesimo di secondo; una persona che legge la risposta di un modello e scrive la domanda successiva può metterci più di un minuto. In mezzo stanno una ricerca su Wikipedia, che torna in media in meno di un secondo, e una mossa in una casa simulata, che ne chiede un decimo.
Reyna Abhyankar, Zijian He e i loro colleghi dell’Università della California a San Diego hanno studiato che cosa succede, durante quelle attese, al server, il programma che fa girare il modello e risponde alle richieste. Hanno considerato sei modi in cui una generazione si interrompe per aspettare qualcosa da fuori: la calcolatrice in un problema di aritmetica, le ricerche su Wikipedia, la casa simulata di ALFWorld, la conversazione con una persona, un modello che genera immagini e uno che legge il testo ad alta voce [AHS+24].
I server di allora, compreso vLLM, quello di LLMOps, trattavano l’interruzione come la fine della richiesta. Scartavano la KV cache, gli appunti che il modello tiene su ciò che ha già letto, e al ritorno dello strumento ricevevano una richiesta nuova da rileggere dall’inizio. Sul carico misto delle sei interruzioni, fra il 37 e il 40% del tempo di calcolo del modello se ne andava a ricostruire contesti già calcolati.
Le alternative ovvie, però, sprecavano in altri modi. Conservando la cache durante l’attesa, quasi metà della memoria della scheda restava occupata da richieste ferme, e così per più del 60% del tempo; spostandola nella memoria del computer in cui la scheda è montata (l’host), con trasferimenti che bloccano il calcolo, più di un quarto del tempo passava ad aspettarli. Il lavoro, presentato nel 2024 alla conferenza ICML con il nome di InferCept, partiva da questi tre sprechi, nessuno dei quali va bene sempre.
Il continuous batching di LLMOps e le misure di Misurare un servizio guardano le richieste una per una. Quelle di un agente, invece, dipendono l’una dall’altra, si allungano a ogni passo e, fra una e l’altra, aspettano.
Un programma, molte chiamate#
Il ciclo dell’agente, visto dal motore che serve il modello (il server), è una successione di richieste. Alla chiamata \(j\) il modello riceve un contesto di \(L_j\) token, ne genera \(o_j\) (un ragionamento e una richiesta di strumento) e si ferma; l’harness esegue lo strumento, che impiega \(t_j\) secondi e restituisce \(r_j\) token; la chiamata dopo legge \(L_{j+1} = L_j + o_j + r_j\) token (ad esempio, con 1.000 di contesto, 50 generati e 200 di risultato, 1.250).
Le chiamate dipendono l’una dall’altra, perché la \(j + 1\) non esiste finché la \(j\) non è finita e lo strumento non ha risposto. Il contesto cresce, e finché l’harness non lo riscrive (una compattazione, un esito vecchio sostituito da una riga) ogni chiamata contiene la precedente come prefisso.
Inoltre i buchi fra una chiamata e l’altra cambiano di ordini di grandezza. Ad esempio, su cento esecuzioni di un agente che corregge difetti veri di programmi (la raccolta SWE-bench), Hanchen Li e colleghi contano in media 10,9 iterazioni del ciclo per compito e strumenti che durano in media 925 millisecondi, con una deviazione standard (lo scarto tipico dalla media) di 3.550 millisecondi, quasi quattro volte la media, segno che qualche chiamata dura moltissimo [LHM+25].
L’insieme delle chiamate di un agente su un compito, con le dipendenze fra loro, si chiama programma: una catena di chiamate e di interruzioni, o un grafo quando l’agente lancia più chiamate in parallelo [LSC+25]. Il motore vede soltanto richieste, e non ha un modo sicuro di sapere che due di esse appartengono allo stesso programma. Due sistemi pensati per servire agenti, Autellix e Continuum (il lavoro di Li e colleghi), glielo fanno sapere nel modo più semplice: il cliente apre una sessione, o dichiara un identificativo di programma, e lo attacca a ogni chiamata. Il motore può allora decidere che cosa fare della KV cache di un programma fermo su uno strumento, a quale programma dare la precedenza, su quale replica (copia del modello) mandare la chiamata che torna. Il conto di un compito guardava le stesse chiamate dal lato di chi le paga; per chi tiene accese le schede, invece, conta la memoria.
Mentre lo strumento lavora#
Quando una chiamata finisce con una richiesta di strumento, la sua KV cache servirà di nuovo quando lo strumento risponde, e intanto non serve a nessuno. Si può conservarla nella memoria della scheda (preserve), scartarla e ricostruirla al ritorno rileggendo tutto il contesto in un colpo solo (discard), oppure spostarla nella memoria dell’host e riportarla indietro (swap). Le ultime due sono le strade con cui vLLM, in Quando la memoria finisce, riprende una sequenza sospesa per mancanza di memoria; ma lì la durata dell’attesa la decideva lo scheduler (chi sceglie chi lavora), qui uno strumento.
InferCept confronta le tre strade con un’unità sola, la memoria della scheda che resta inutilizzata moltiplicata per il tempo in cui lo resta, in gigabyte-secondi (GB·s). Un gigabyte fermo per due secondi e due fermi per un secondo sono lo stesso spreco, perché quella memoria avrebbe potuto tenere altre richieste nel mazzo. Il conto vale quando qualche richiesta aspetta posto; se nessuno aspetta, conservare non costa. Mentre la scheda ricostruisce una cache, o la copia con un trasferimento che blocca il calcolo, restano ferme anche le altre richieste del mazzo, e la loro memoria si spreca come quella della richiesta.
Per vederlo, un calcolo a numeri tondi misura questo spreco per una richiesta di 2.000 token in pausa per quattro durate diverse. Il modello ha sette miliardi di parametri, le altre richieste tengono trenta gigabyte di cache, e l’attenzione è multi-testa piena (MHA) oppure GQA, la variante di L’attenzione in pratica che qui tiene un quarto degli appunti per token. Infine cerca la soglia oltre la quale conservare smette di convenire.
# Un conto a numeri tondi, non una misura: lo spreco di memoria per tempo di
# una richiesta ferma ad aspettare uno strumento, con le tre strade, quando
# altre richieste aspettano posto (senza coda, conservare non costa niente).
N_P = 7e9          # parametri del modello
P_EFF = 5e14       # FLOP al secondo che la scheda tiene in prefill
B_HOST = 25e9      # byte al secondo fra la memoria dell'host e la scheda
ALTRI = 30e9       # byte di KV cache delle altre richieste in corso
KIB = 1024

def sprechi(n, t, m_kv):
    """GB·s sprecati da n token di contesto fermi per t secondi."""
    propria = n * m_kv                    # i byte della sua KV cache
    t_ric = 2 * N_P * n / P_EFF           # un prefill per ricostruirla
    t_viaggio = propria / B_HOST          # un passaggio fra host e scheda
    conserva = t * propria
    scarta = t_ric * (propria + ALTRI)    # gli altri aspettano il ricalcolo
    sposta = 2 * t_viaggio * (propria + ALTRI)   # uscita e rientro
    return conserva / 1e9, scarta / 1e9, sposta / 1e9

n = 2000
for nome, m_kv in [("MHA", 512 * KIB), ("GQA", 128 * KIB)]:
    print(f"{nome}: {n * m_kv / 1e9:.2f} GB di cache, ricalcolo "
          f"{2 * N_P * n / P_EFF * 1000:.0f} ms, viaggio "
          f"{n * m_kv / B_HOST * 1000:.1f} ms")
    for t in [0.01, 0.5, 5, 30]:
        c, s, p = sprechi(n, t, m_kv)
        scelta = min([(c, "conserva"), (s, "scarta"), (p, "sposta")])[1]
        print(f"  pausa {t:>5} s  conserva {c:6.3f}  scarta {s:4.2f}  "
              f"sposta {p:4.2f} GB·s: {scelta}")
    _, s, p = sprechi(n, 0.0, m_kv)
    print(f"  soglia {min(s, p) / (n * m_kv / 1e9):.2f} s")
MHA: 1.05 GB di cache, ricalcolo 56 ms, viaggio 41.9 ms
  pausa  0.01 s  conserva  0.010  scarta 1.74  sposta 2.60 GB·s: conserva
  pausa   0.5 s  conserva  0.524  scarta 1.74  sposta 2.60 GB·s: conserva
  pausa     5 s  conserva  5.243  scarta 1.74  sposta 2.60 GB·s: scarta
  pausa    30 s  conserva 31.457  scarta 1.74  sposta 2.60 GB·s: scarta
  soglia 1.66 s
GQA: 0.26 GB di cache, ricalcolo 56 ms, viaggio 10.5 ms
  pausa  0.01 s  conserva  0.003  scarta 1.69  sposta 0.63 GB·s: conserva
  pausa   0.5 s  conserva  0.131  scarta 1.69  sposta 0.63 GB·s: conserva
  pausa     5 s  conserva  1.311  scarta 1.69  sposta 0.63 GB·s: sposta
  pausa    30 s  conserva  7.864  scarta 1.69  sposta 0.63 GB·s: sposta
  soglia 2.42 s
Con l’attenzione multi-testa piena la cache pesa 1,05 GB e ricostruirla costa 56 millisecondi di prefill. Lo spreco dello scarto viene quasi tutto dai trenta gigabyte delle altre richieste, ferme per quei 56 millisecondi, e i suoi 1,74 GB·s battono la conservazione oltre 1,66 secondi, la soglia in cui i due sprechi si pareggiano (1,74 GB·s divisi per 1,05 GB). Quanto al trasferimento, due viaggi da 41,9 millisecondi costano più di un ricalcolo da 56, e il trasferimento non vince mai (2,60 contro 1,74 GB·s).
Con la GQA, invece, la cache pesa un quarto, i viaggi durano 10,5 millisecondi, e oltre 2,42 secondi conviene spostare (0,63 GB·s) e non scartare (1,69). In pratica, calcolatrice, Wikipedia e casa simulata stanno sotto la soglia di questo calcolo; una persona che risponde mezzo minuto dopo sta ben sopra. La Fig. 37.19 segue la memoria della scheda durante una pausa di cinque secondi, una strada per corsia.
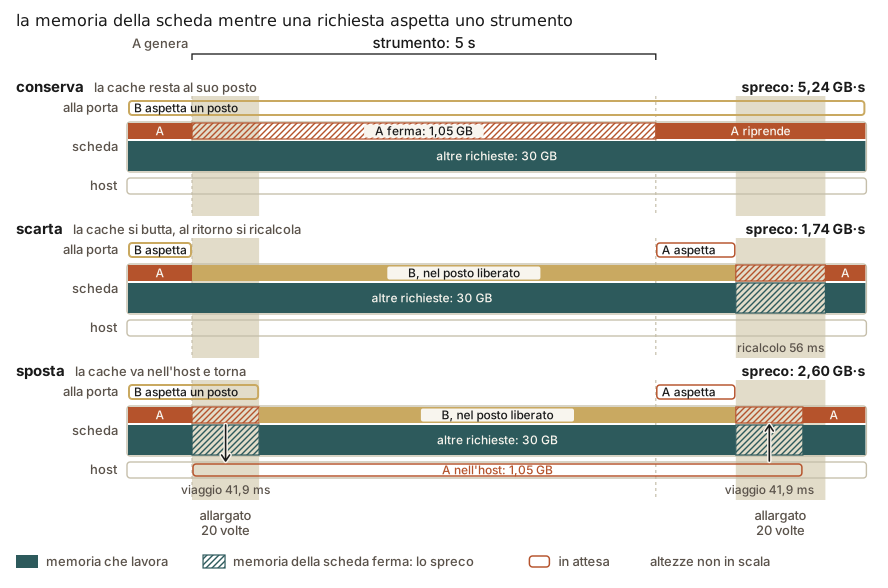
Fig. 37.19 La memoria della scheda mentre una richiesta da 2.000 token aspetta uno strumento per cinque secondi: la cache che resta ferma, la cache scartata che al ritorno ferma il mazzo per il ricalcolo, la cache che scende nella memoria dell’host e risale. Il tratteggio è lo spreco di memoria per tempo; ricalcolo e viaggi, che durano decine di millisecondi, sono allargati per vederli.#
Torna nella sala del maître di LLMOps. Le sedie sono la memoria della scheda, ogni comitiva è una richiesta, e il cameriere a ogni giro porta una portata a tutti i tavoli pronti. Stasera alla porta c’è la fila. A metà cena una comitiva di quattro esce a fare una telefonata e aspetta che le rispondano (è lo strumento che lavora); quanto starà fuori non lo sa nessuno. Sul tavolo resta la cena fin lì, i bicchieri dei vini già serviti, i piatti già passati, ed è guardando quella tavola che il cameriere saprà da dove riprendere. Quella tavola è la KV cache.
Il maître conta il danno in sedie-minuto. Se lascia il tavolo com’è, quattro sedie restano ferme per tutta la telefonata mentre la fila aspetta, e cinque minuti fanno venti sedie-minuto. Se sparecchia, la fila entra, ma al ritorno il cameriere deve riapparecchiare. Lo fa dalla comanda, che resta (è il testo della conversazione), e rimette tutto in un colpo, molto più in fretta della cena; intanto però il giro si ferma per tutta la sala. Ad esempio, con altre centosedici sedie occupate e un minuto di lavoro, sono le quattro della comitiva più le centosedici ferme per un minuto, centoventi sedie-minuto, quante ne costa tenere il tavolo senza nessuno seduto per mezz’ora. Per una telefonata più corta il maître lascia il tavolo, per una più lunga sparecchia. Tutto vale perché alla porta c’è la fila. Se nessuno aspettasse, il tavolo lasciato non toglierebbe posto a nessuno, e sparecchiare sarebbe solo fatica.
Il maître può anche caricare la tavola su un carrello e parcheggiarlo nel magazzino accanto, la memoria dell’host, dove c’è posto ma si passa da una porta stretta; se a spingerlo è il cameriere, il giro si ferma all’uscita e al rientro. È la scelta del copista di Misurare un servizio fra rifare gli appunti e portarli in archivio, e si decide allo stesso modo. Riapparecchiare costa uguale in ogni locale, perché si fa dalla comanda, come il copista rifaceva gli appunti dalle righe dell’atto; il carrello invece pesa quanto la tavola. Dove ogni portata lascia quattro bicchieri, come le quattro righe di appunti del copista, fa prima riapparecchiare; dove ne lascia uno, per le telefonate lunghe vince il carrello.
La durata della telefonata il maître la sa per quelle che conosce; per le altre guarda l’orologio, e più la comitiva resta fuori, più si convince che starà fuori a lungo. Quella sera due aiuti gli cambiano il conto. Il commis, l’aiutante di sala, spinge il carrello mentre il cameriere gira, così il carrello non ferma più nessuno, ma porta un viaggio solo per giro, e il maître gli affida i tavoli che con le altre strade costerebbero di più. Gli altri li riapparecchia il cameriere con le mani che il giro gli lascia libere, perché a ogni tavolo porta un piatto solo; sparecchiare, che ora rallenta appena il giro, conviene già con telefonate più brevi. Quando la comitiva rientra, il maître la fa sedere prima dei clienti arrivati dopo di lei.
Siano \(L\) i token di contesto della richiesta interrotta, \(m_{\text{kv}}\) i byte di KV cache per token, \(t_{\text{s}}\) la durata dell’interruzione (la \(t_j\) di prima), \(M_{\text{altri}}\) i byte di cache delle altre richieste in corso, \(\Delta(n)\) il tempo che \(n\) token di ricalcolo aggiungono a un’iterazione e \(t_{\text{sw}}(L) = L\,m_{\text{kv}}/B_{\text{host}}\) la durata di un trasferimento fra scheda e host in un verso. InferCept assegna a ogni strada uno spreco \(S\) in memoria per tempo [AHS+24]
Nello scarto il primo termine è la memoria della richiesta mentre la si ricostruisce, il secondo quella delle richieste in corso, ferme per il tempo aggiunto; nello spostamento gli stessi termini valgono per un trasferimento sincrono, all’uscita e al rientro. Le tre formule suppongono la memoria contesa, con richieste in attesa di posto (senza coda \(S_{\text{cons}} = 0\)); con una cache dei prefissi, scartare vuol dire lasciare i blocchi sfrattabili. Con il prefill compute-bound, \(\Delta(L) \approx 2N_pL/P_{\text{eff}}\), dove i parametri \(N_p\), i FLOP al secondo in prefill \(P_{\text{eff}}\) e la banda \(B_{\text{host}}\) sono quelli di Quando la memoria finisce, conservare conviene finché \(t_{\text{s}} < t^*\), con
In regime saturo la soglia è lineare in \(L\), con un’intercetta proporzionale al carico espresso in token, \(M_{\text{altri}}/m_{\text{kv}}\), che sulla scheda piena domina. Il rapporto fra i due argomenti del minimo è quello fra ricalcolo e trasferimento contato sui due versi, 0,67 per l’attenzione piena e 2,7 per la GQA con i numeri di quel paragrafo, e cresce con \(N_p/m_{\text{kv}}\); con un modello da settanta miliardi di parametri a GQA gli autori trovano infatti conservare e spostare migliori dello scarto.
Il conto suppone la durata nota, il ricalcolo in un’iterazione sola e il trasferimento sincrono, e InferCept allenta le tre ipotesi. La durata, per gli strumenti profilati, è quella misurata in anticipo; per quelli molto variabili o non profilati la si stima con il tempo trascorso, \(\hat{t}_{\text{s}} = t_{\text{ora}} - t_{\text{chiamata}}\), che cresce con l’attesa e con lei lo spreco previsto della conservazione (sul carico misto, il 93% delle prestazioni di un oracolo con le durate esatte). Il ricalcolo si spezza in \(q\) pezzi grandi quanto \(n_{\text{sat}}\) meno la dimensione del mazzo in corso, dove \(n_{\text{sat}}\), misurato in anticipo, è il numero di token di query oltre il quale l’iterazione si allunga senza che il throughput cresca,
Il primo termine si dimezza perché la memoria ricostruita cresce pezzo dopo pezzo (se le \(q\) iterazioni del ricalcolo durano insieme circa quanto il ricalcolo intero, \(\Delta(L)\)); il secondo resta piccolo, perché sotto la saturazione ogni pezzo usa calcolo che il decode lasciava inutilizzato. Il trasferimento si fa in pipeline per strato e a pezzi, al più \(n_{\text{sw}}\) token per iterazione, con \(t_{\text{sw}}(n_{\text{sw}})\) pari alla durata dell’iterazione; dentro quel bilancio non ferma nessuno, e nelle misure sparisce il 96% dello spreco del trasferimento sincrono. Infine si decide per richiesta. Il bilancio di uscita va alle richieste in ordine di \(S = \min(S_{\text{cons}}, S'_{\text{scar}})\) decrescente, le altre si conservano o si scartano secondo il minimo, e al rientro si servono in ordine d’arrivo originale.
InferCept, quando la durata dello strumento è nota da misure fatte in anticipo e la decisione è di conservare, tiene la cache finché la chiamata successiva non arriva, e gli autori di Continuum vi trovano due lacune [LHM+25]. Una richiesta sfrattata, quando lo strumento risponde, non riparte subito nemmeno con la cache già pronta nell’host, perché aspetta che le richieste entrate al suo posto liberino memoria, e quell’attesa si ripete a ogni iterazione del programma.
La seconda lacuna è che le durate di uno stesso strumento sono molto disuguali (nelle loro tracce il 10% più lento delle chiamate a uno strumento che scarica pagine web fa il 52,5% del tempo passato in quello strumento), quindi una cache conservata per uno strumento che sfora la previsione tiene ferma la memoria per un tempo che nessuno aveva messo in conto. Continuum fissa la cache per un tempo di vita, una durata massima dopo la quale se ne va da sola, e a distinguerlo è come la sceglie, dalle durate già viste di quello strumento e dall’attesa al rientro.
In un altro ristorante il maître fa diversamente. Tiene un quaderno con quanto sono durate, sera dopo sera, le telefonate di ogni tipo (quelle della centrale dei taxi quasi sempre meno di quattro minuti, quelle di famiglia da cinque minuti a un’ora), e a ogni comitiva che esce promette il tavolo per un certo numero di minuti. Allo scadere, se non è tornata, sparecchia comunque, e una telefonata che non finisce più gli costa al massimo quei minuti.
Per scegliere i minuti mette su un piatto della bilancia le sedie tenute per tutto il tempo promesso, un conto prudente, perché se la comitiva torna prima le sedie le usa lei. Sull’altro mette quello che si risparmia se la comitiva torna in tempo, la tavola da non rifare e l’attesa al rientro. Chi ha perso il tavolo, tornando, anche se passa primo nella fila deve aspettare che si liberi un posto, e i posti li hanno presi altri, che non si alzano prima di aver finito; a ogni telefonata succede di nuovo. Ad esempio, il tavolo ha quattro sedie, e la comitiva che torna in tempo fa risparmiare quaranta sedie-minuto. Se nove telefonate su dieci di quel tipo finiscono entro quattro minuti, promettere quattro minuti costa sedici sedie-minuto e ne fa risparmiare in media trentasei, venti guadagnate; promettere un’ora le copre tutte, ma costa duecentoquaranta sedie-minuto per risparmiarne quaranta. Il maître promette quattro minuti.
L’attesa al rientro pesa a seconda del locale. Dove tutti prendono lo stesso menù, chi rientra dopo molte portate è vicino al dolce, e farlo sedere subito lo fa finire e liberare presto il posto; dove le portate già mangiate non dicono niente su quante ne mancano, farlo passare avanti non accorcia niente, e resta solo la tavola da non rifare. Chi rientra in tempo si risiede senza fila, e fra quelli in fila il maître fa entrare prima chi è arrivato prima al ristorante. Una sera i tavoli occupati e quelli promessi riempiono la sala, e alla porta non entra più nessuno: il maître libera il tavolo promesso alla comitiva arrivata per ultima.
Si consideri una richiesta che si interrompe con una chiamata allo strumento \(f\), e siano \(\mathrm{Mem}\) la memoria della sua cache, \(\bar{M}\) la memoria media delle richieste attive e \(u = \mathrm{Mem}/\bar{M}\) il numero di richieste medie che la cache tiene fuori. Continuum misura costi e benefici in tempo di completamento sommato sui programmi e suppone, come InferCept, che in coda ci sia sempre chi aspetta quel posto. Fissare la cache per un tempo di vita \(T\) costa \(u\,T\), cioè \(T\) di ritardo per ciascuna delle \(u\) richieste escluse; con una durata \(X\) dello strumento il costo atteso sarebbe \(u\,\mathbb{E}[\min(X, T)]\), e \(u\,T\) ne è un maggiorante prudente, che accorcia il tempo di vita scelto. Il beneficio, se la chiamata successiva arriva entro \(T\), è
con \(t_{\text{rip}}\) il tempo per ricostruire la cache (prefill o ricarica dall’host), che ritarda le \(u\) richieste escluse, e \(\bar{w}\) la media mobile dell’attesa in coda delle richieste sfrattate, un’attesa del programma stesso che gli autori scalano con la stessa taglia. Il fattore \(\zeta = -\mathrm{Corr}(k, J - k)\) (la \(\eta\) del lavoro originale) misura quanto il carico abbia memoria, con \(J\) le chiamate di un programma e \(k\) quelle già servite. Vale 1 se tutti i programmi hanno lo stesso numero di chiamate, e allora chi ha fatto più iterazioni è più vicino alla fine e tenerlo in ordine approssima il servire per primo il lavoro più corto; vale 0 se il numero di chiamate è geometrico, e dell’attesa evitata non resta niente. Il tempo di vita massimizza il beneficio atteso netto,
con \(\mathcal{S}_f\) le durate già osservate per lo strumento \(f\) (l’intervallo fra la fine di una chiamata e l’arrivo della successiva dello stesso programma); \(u\) si semplifica, e il massimo si cerca fra le durate osservate, zero compreso. Allo scadere la cache si libera, se la chiamata successiva non è già in coda. La coda d’attesa ordina prima le richieste sospese per mancanza di memoria, poi quelle con la cache ancora fissata, poi per ordine d’arrivo del programma; e quando la memoria è tutta fissata e nessuna richiesta entra, si libera la cache del programma arrivato per ultimo.
Chi servire prima#
Lo scheduler di un motore decide a ogni iterazione chi entra nel mazzo, e la regola di partenza di vLLM è l’ordine d’arrivo delle richieste (FCFS, first come, first served). Per un agente conta il tempo del programma intero, dalla prima chiamata all’ultima, e l’ordine d’arrivo delle richieste lo ignora. Ogni chiamata nuova di un programma lungo entra in coda come una richiesta qualunque, e un programma corto che fa anche lui più di una chiamata se la ritrova davanti a ogni chiamata sua. Autellix lo chiama blocco in testa alla coda a livello di programma (head-of-line blocking, chi sta davanti nella fila ferma tutti quelli dietro), lo stesso effetto che in Misurare un servizio un prompt lunghissimo aveva sulle risposte in corso [LSC+25].
Le soluzioni proposte guardano al programma e si dividono in due famiglie. Autellix dà la precedenza al programma che ha ricevuto meno servizio fino a quel momento; Continuum, e già InferCept per le richieste che rientrano, rispettano l’ordine d’arrivo del programma invece di quello della chiamata.
Una simulazione a numeri tondi mette alla prova tre regole, l’ordine d’arrivo delle chiamate, il minor servizio ricevuto dal programma (la regola di Autellix, chiamata PLAS) e l’ordine d’arrivo dei programmi, su due carichi. Nel primo, con lunghezze molto disuguali, quattro programmi su cinque fanno quasi sempre una o due chiamate e uno ne fa una ventina in media; nel secondo tutti ne fanno sette.
Il motore ha quattro posti nel mazzo e lavora all’85% circa; il tempo si conta in passi, e a ogni passo ogni posto fa un’unità di lavoro. Tutto si estrae a caso all’arrivo di ogni programma, così che le tre regole servono lo stesso carico. Si stampano i passi che impiegano in media tutti i programmi e, nel primo carico, i corti (al più due chiamate) e i lunghi (almeno venti).
import random

# Un conto a numeri tondi, non una misura. A ogni passo il motore fa avanzare
# di un'unità di lavoro fino a POSTI chiamate pronte, scelte da una regola.
# Un programma è una fila di chiamate; fra una chiamata e la successiva
# aspetta uno strumento per 1-6 passi. Tutto si sorteggia all'arrivo del
# programma, così le tre regole servono lo stesso carico.
POSTI, PASSI = 4, 60_000

def simula(chiamate, arrivi, regola, seme=0):
    rng = random.Random(seme)
    arrivo, pronto, servito, lavori, pause = {}, {}, {}, {}, {}
    tot, fatte, durata = {}, {}, {}
    prossimo, p, lavoro = rng.expovariate(arrivi), 0, 0
    for t in range(PASSI):
        while prossimo <= t:                      # arriva un programma
            n = chiamate(rng)
            arrivo[p], pronto[p], servito[p] = t, t, 0
            tot[p], fatte[p] = n, 0
            lavori[p] = [1 + int(rng.expovariate(1 / 3)) for _ in range(n)]
            pause[p] = [rng.randint(1, 6) for _ in range(n - 1)]
            p, prossimo = p + 1, prossimo + rng.expovariate(arrivi)
        chiave = {"FCFS per chiamata": lambda q: (pronto[q], q),
                  "PLAS": lambda q: (servito[q], q),
                  "FCFS per programma": lambda q: (arrivo[q], q)}[regola]
        attivi = [q for q in pronto if pronto[q] <= t]
        for q in sorted(attivi, key=chiave)[:POSTI]:
            servito[q] += 1
            lavori[q][fatte[q]] -= 1
            lavoro += 1
            if lavori[q][fatte[q]] == 0:          # la chiamata è finita
                fatte[q] += 1
                if fatte[q] == tot[q]:
                    durata[q] = t + 1 - arrivo[q]
                    del pronto[q]
                else:                             # ora lavora lo strumento
                    pronto[q] = t + 1 + pause[q][fatte[q] - 1]
    dopo = [q for q in durata if arrivo[q] > PASSI // 10]   # senza l'avvio
    media = lambda xs: sum(xs) / len(xs) if xs else 0.0
    return (lavoro / (POSTI * PASSI), media([durata[q] for q in dopo]),
            media([durata[q] for q in dopo if tot[q] <= 2]),
            media([durata[q] for q in dopo if tot[q] >= 20]))

def disuguali(rng):       # quattro programmi su cinque corti, uno lunghissimo
    m = 2 if rng.random() < 0.8 else 20
    return 1 + int(rng.expovariate(1 / (m - 1)))

def tutti_uguali(rng):    # sette chiamate per tutti
    return 7

for nome, chiamate, arrivi in [("disuguali", disuguali, 0.186),
                               ("tutti uguali", tutti_uguali, 0.138)]:
    print(nome)
    for regola in ["FCFS per chiamata", "PLAS", "FCFS per programma"]:
        uso, tutti, corti, lunghi = simula(chiamate, arrivi, regola)
        riga = f"  {regola:<19} occupato {uso:.0%}  tutti {tutti:5.1f}"
        if nome == "disuguali":
            riga += f"  corti {corti:5.1f}  lunghi {lunghi:6.1f}"
        print(riga)
disuguali
  FCFS per chiamata   occupato 84%  tutti  47.1  corti   9.6  lunghi  361.7
  PLAS                occupato 84%  tutti  44.8  corti   5.5  lunghi  419.9
  FCFS per programma  occupato 84%  tutti  65.2  corti  37.1  lunghi  295.0
tutti uguali
  FCFS per chiamata   occupato 86%  tutti  78.6
  PLAS                occupato 86%  tutti 100.6
  FCFS per programma  occupato 86%  tutti  67.4
Con lunghezze così disuguali PLAS chiude i programmi corti in 5,5 passi, contro i 9,6 dell’ordine d’arrivo delle chiamate e i 37,1 dell’ordine d’arrivo dei programmi, e abbassa anche la durata media di tutti, 44,8 passi contro 47,1 e 65,2. Il prezzo lo pagano i lunghi, che passano da 361,7 e 295,0 a 419,9 passi. Con sette chiamate per tutti, invece, la stessa regola diventa la peggiore, 100,6 passi in media contro 78,6 e 67,4.
A un cliente importa quando finisce la sua cena, non quanto è arrivato in fretta ogni piatto. In sala ci sono tavolate che restano tutta la sera e ordinano una portata dopo l’altra, e clienti di passaggio che prendono uno o due piatti. Se il maître fa passare le comande in ordine d’arrivo, la tavolata che mangia da due ore ordina l’ottava portata un attimo prima che tu ordini il primo dei tuoi due piatti, e tu aspetti dietro di lei; mentre mangi, lei ordina la nona, e quando ordini il secondo aspetti di nuovo.
L’ideale sarebbe servire prima chi ha meno da mangiare ancora, ma il maître non sa quante portate ordinerà ciascuno. Sa però quanto ciascuno ha già mangiato, e serve prima chi ha mangiato meno. Dove quasi tutti prendono uno o due piatti e pochi restano tutta la sera, chi ha già mangiato molto è quasi certamente uno di quei pochi e ne ha ancora per molto, quindi servire prima chi ha mangiato meno vuol dire, quasi sempre, servire prima chi ha meno da mangiare. Nella simulazione chi prende uno o due piatti finisce in circa metà del tempo che gli serve con le comande in ordine d’arrivo, e anche la cena media di tutti si accorcia.
In un locale a menù fisso, dove tutti mangiano sette portate, la regola si rovescia. Chi ha già mangiato molto è vicino al dolce, e farlo aspettare tiene occupato il suo tavolo più a lungo; lì conviene servire in ordine d’arrivo al ristorante, così che chi è entrato prima finisca prima e liberi il posto.
Nel ristorante dei piatti singoli, però, la tavolata che resta tutta la sera finisce sempre in fondo, perché arrivano di continuo clienti nuovi. Quando il maître si accorge che ha aspettato troppo rispetto a quanto è stata servita, la porta in testa. E per non far correre il cameriere da un tavolo all’altro a ogni boccone non stila una classifica esatta. Mette le comande in poche fasce secondo il cliente (appena arrivato, a metà, di lunga sosta), serve in ordine dentro ciascuna, e una comanda che chiede troppo tempo passa nella fascia sotto.
Una tavolata grande, a volte, si divide in gruppetti che ordinano per conto loro, e se ne va solo quando ha finito il gruppetto con più portate. Il maître conta allora la fila di portate più lunga che un gruppetto abbia già mangiato, perché è quella a decidere quando la tavolata se ne va, e serve tutti i gruppetti con quella, così nessuno resta indietro. Tutto questo il maître lo fa leggendo il numero del tavolo sulle comande. Una sera una tavolata detta appena seduta l’intero menù, e le portate partono una dopo l’altra senza che nessuno le chieda; ma deve sapere già tutto quello che ordinerà.
L’obiettivo è il tempo medio di risposta dei programmi. Su un server solo, la regola che serve per primo il lavoro residuo più corto (SRPT) lo minimizza, ma richiede di conoscere il residuo, che un motore non conosce [LSC+25]. Fra le regole che non usano la lunghezza del lavoro il riferimento è il servizio al lavoro che ne ha ricevuto meno (least attained service, LAS). In una coda GI/GI/1 (arrivi e durate indipendenti, di distribuzioni qualunque, un server), se le lunghezze hanno tasso di guasto decrescente (la densità in \(x\) divisa per la probabilità di superare \(x\); è la classe DFR, che comprende alcune delle distribuzioni a coda pesante più note), LAS rende la lunghezza della coda stocasticamente minima, a ogni istante, fra le regole che non conoscono il servizio residuo; con tasso crescente (IFR) l’ordine si rovescia, e vincono le regole che non interrompono, come FCFS. È un risultato di Righter e Shanthikumar, riportato nella rassegna di Nuyens [Nuy04]; in regime stazionario, per la legge di Little di Servire un modello, la coda minima porta con sé il tempo medio minimo. L’intuizione è la vita residua media, \(\mathbb{E}[X - a \mid X > a]\), che per una distribuzione DFR cresce con il servizio già ricevuto \(a\).
PLAS (program-level attained service) applica LAS ai programmi, assegnando alla chiamata \(c_j\) la priorità
con la somma sulle chiamate già completate dello stesso programma e \(d_i\) il tempo di esecuzione di \(c_i\) (più alto il valore, più bassa la priorità). ATLAS (adaptive thread-level attained service), per un programma che si dirama, usa il cammino critico, la catena più lunga di chiamate dipendenti,
con \(\mathcal{P}(c_j)\) le chiamate genitrici. In pratica Autellix tiene un solo numero per programma, il più lungo cammino critico osservato, che tutte le sue chiamate ereditano, e i rami avanzano insieme. Le priorità continue possono degenerare in un turno a rotazione (un poco a testa) con molti cambi di contesto e trasferimenti di cache, e Autellix le discretizza in \(K\) code, ciascuna su un intervallo di valori di \(p\), con FCFS dentro la coda e un quanto di tempo scaduto il quale la chiamata scende alla coda sotto. Contro la fame dei programmi lunghi una chiamata sale alla prima coda quando \((w_{\text{prog}} + w_c)/(d_{\text{prog}} + d_c) \ge \beta\), con \(w\) le attese e \(d\) i servizi di programma e chiamata; \(\beta\) regola lo scambio fra tempo medio ed equità.
Né PLAS né la simulazione stanno nelle ipotesi del teorema. Hanno più posti nel mazzo e il programma assente dal motore mentre lavora lo strumento; PLAS misura per giunta il servizio in tempo effettivo, che dipende da chi altro è nel mazzo, e la simulazione conta nel servizio anche la chiamata in corso. Ma la simulazione ne ritrova il verso. Con il numero di chiamate tratto da una miscela di due geometriche il lavoro di un programma è una miscela di geometriche, DFR, e PLAS abbassa la media di tutti perché i corti guadagnano più di quanto i lunghi perdano; con sette chiamate per tutti è una somma di sette geometriche, IFR, e PLAS diventa la regola peggiore. Continuum sceglie l’ordine d’arrivo del programma perché nelle sue tracce i programmi vicini alla fine hanno meno lavoro residuo (\(\zeta > 0\)), e la scelta fra le due famiglie è una stima della forma della distribuzione delle lunghezze, da rifare quando il carico cambia.
Un programma può anche dichiarare la propria struttura. In Parrot i segnaposto
di ingresso e di uscita nel prompt, le variabili semantiche, collegano una
chiamata all’altra, e dai collegamenti il servizio ricava il grafo delle
dipendenze, avvia la chiamata successiva senza ripassare dal cliente e deduce
dall’obiettivo dichiarato sull’uscita finale come servire le intermedie
[LHZ+24]. Il frontend di SGLang, quando il programma si dirama
(fork), manda prima il prefisso comune, che entra in cache prima dei rami
[ZYX+24]. Un grafo dichiarato descrive bene una pipeline fissa e
male un agente che sceglie il passo dopo leggendo lo strumento, ed è
l’obiezione di Continuum a Parrot.
Quale replica#
Quando una replica non basta, le richieste si dividono fra più copie dello stesso modello, quante ne servono secondo Quante repliche accendere. L’instradamento di Davanti ai modelli sceglieva fra modelli diversi; fra repliche dello stesso modello a distinguerle è che cosa hanno in memoria, perché ognuna tiene la sua cache dei prefissi, gli inizi di richiesta che ha già letto. Un bilanciatore del carico classico la ignora. Il turno a rotazione (round robin) manda le richieste alle repliche in ordine ciclico, l’altra regola comune le manda alla replica con meno richieste in corso.
Ad esempio, nelle misure di Autellix, fra chiamate dello stesso programma la quota di token in ingresso già presenti in cache resta sopra il 90% a ogni lunghezza dell’ingresso, mentre fra programmi diversi cala rapidamente con la lunghezza, perché in comune hanno soltanto l’istruzione di sistema, le righe che dicono al modello come comportarsi [LSC+25]. Mandare la richiesta alla replica che ha in cache il prefisso più lungo è l’instradamento consapevole della cache, che in Quando la memoria finisce andava pesato contro il carico di chi riceve. Senza quel peso, un prefisso molto richiesto attira sulla stessa replica tutto il traffico che lo condivide.
Il ristorante ha più sale uguali, le repliche, e all’ingresso un secondo maître decide in quale far sedere chi arriva. In ogni sala la tavola della casa, pane e carta dei vini, è apparecchiata allo stesso modo (è l’istruzione di sistema), e chi entra per un piatto veloce trova quasi tutto pronto dovunque. La comitiva che rientra dal telefono alla decima portata no, perché la sua tavola sta in una sala sola. Se il maître manda la gente a turno, o nella sala meno affollata, le sale si riempiono alla pari, ma la comitiva finisce spesso dove non c’è niente di suo, e la tavola va rifatta da capo.
Allora il maître guarda, per ogni cliente, quanta parte della sua tavola è già pronta in ciascuna sala. Una sera arriva un uomo per il menù della festa, servito su una tavola lunga da preparare e già allestita nella sala verde. Lì è pronto più di metà di quello che gli serve, e ci va. Una coppia che non trova pronta più di metà da nessuna parte va nella sala meno carica, e il maître la riconosce dal lavoro fatto lì negli ultimi minuti, dalle tavole da sparecchiare per farle posto (che pesano di più se molti le usano) e dalla tavola da preparare. Se però in una sala quasi tutti sono a metà cena, il cameriere lì ha le mani libere, e la coppia ci va senza bisogno di fare il conto.
Verso le nove arriva un pullman per il menù della festa. La sala verde si riempie mentre le altre restano mezze vuote, e il maître se ne accorge quando la fila c’è già, perché il carico lo legge dagli ultimi minuti. Allora manda i prossimi clienti della festa nella sala gialla, che per servirli prepara la tavola lunga anche lei. Se nemmeno così la fila davanti alla verde cala, fa allestire la tavola della festa in anticipo in un’altra sala ancora e divide fra le sale i clienti di quel menù. Nella sala verde, intanto, il cameriere serve più spesso chi trova la tavola già pronta, ma ogni tanto anche chi ha tutto da preparare, così nessuno resta fuori.
In un altro ristorante il maître all’ingresso fa più semplice. Chi arriva per un piatto veloce va nella sala con meno clienti; la comitiva con la cena a metà torna sempre nella sua sala, anche quando è piena e deve aspettare un po” davanti alla porta, perché rifarle la tavola altrove costerebbe di più.
Si consideri una richiesta con un prompt di \(L\) token, e per la replica \(g\) siano \(L^{\text{hit}}_{g}\) i token che trovano nella sua cache e \(L^{\text{miss}}_{g} = L - L^{\text{hit}}_{g}\) quelli da calcolare. Preble tiene un albero dei prefissi globale, che per ogni nodo registra le repliche che lo hanno in cache e quante richieste lo hanno condiviso in una finestra recente di durata \(H\) (tre minuti di default), e decide con la regola E2, sfruttamento ed esplorazione [SHA+25]. Se sul prefisso più lungo trovato \(L^{\text{miss}} < L^{\text{hit}}\), cioè se la parte in cache supera metà del prompt, la richiesta sfrutta, e va alla replica che ha il nodo più lungo del cammino (fra più candidate, a quella di costo minimo). Altrimenti esplora, e va alla replica che minimizza
dove \(\mathcal{W}_g\) sono le richieste servite dalla replica nella finestra, \(L^{\text{miss}}_{x,g}\) i token che la richiesta \(x\) non vi ha trovato in cache, \(t_{\text{pre}}\) e \(t_{\text{dec}}\) i tempi di prefill e di decode stimati con regressioni misurate in anticipo, \(\bar{o}_g\) la lunghezza media delle uscite nella finestra, \(\mathcal{E}_g\) i nodi da sfrattare per far posto, \(\ell_v\) la lunghezza del nodo \(v\) e \(\nu_v\) la quota di richieste della finestra che lo condividono. Prima del confronto, una richiesta da esplorare, quasi tutta prefill, va alla replica dove il decode prevale oltre una soglia, perché lì il calcolo è sottoutilizzato.
Dopo l’assegnazione il carico si corregge. Se la replica più carica supera la più scarica oltre un fattore fissato, le richieste future che sfrutterebbero la prima vanno alla seconda finché il divario non rientra; se l’attesa media in coda per un prefisso raddoppia nella finestra, il prefisso si replica e il suo sottoalbero si divide per carico. Dentro la replica le richieste in attesa stanno in un numero fisso di gruppi per quota di prompt in cache, e ogni gruppo riceve una quota dei posti che cresce con quella in cache, perché servire sempre per prima la richiesta con più prefisso in cache, come fa l’ordinamento per affinità di prefisso di SGLang, affamerebbe le altre.
Autellix usa una regola più semplice, che segue dalla sua misura. Una richiesta di al più 2.048 token, che trova comunque in cache l’istruzione di sistema su qualunque replica (la quota di colpi è almeno del 75%), va alla replica meno usata; una più lunga va alla replica del suo programma, scelta come la meno usata alla prima chiamata lunga [LSC+25]. È un’affinità di sessione limitata alle richieste per cui la località vale più dello squilibrio. Le due regole si rompono in punti diversi. Preble legge il carico su una finestra passata, e una raffica improvvisa su un prefisso caldo lo trova in ritardo, il caso che ribilanciamento e replica correggono. Autellix lega le richieste lunghe alla replica del programma qualunque sia il suo carico, e accetta in cambio qualche attesa in coda; le corte non le lega, perché legate lascerebbero i programmi grandi e paralleli a dominare una replica.
Le decisioni del motore si contendono la stessa risorsa, la memoria e il calcolo della scheda, e la misurano in monete diverse, memoria per tempo in InferCept, tempo di completamento dei programmi in Continuum e in Autellix, tempo di calcolo nella scelta della replica. Ognuna si rompe in un punto suo, la durata dello strumento che nessuno sa prevedere, quanto sono disuguali le lunghezze dei programmi, il prefisso che troppi vogliono nello stesso posto.
Da ricordare
Un agente manda una cena intera, una portata dopo l’altra, e fra una e l’altra la comitiva esce a telefonare. Il maître sa che le portate sono della stessa cena solo se sulla comanda c’è il numero del tavolo.
Mentre la comitiva è al telefono, il tavolo si può lasciare, sparecchiare o caricare su un carrello, e il danno si conta in sedie-minuto. Lasciarlo costa per tutta la telefonata, sparecchiare ferma il giro della sala mentre si riapparecchia, il carrello lo ferma all’uscita e al rientro. Il conto vale perché alla porta c’è la fila.
Per le telefonate brevi conviene lasciare il tavolo, per le lunghe no; il confine si sposta con quanto è piena la sala e con quanti bicchieri lascia ogni portata.
Si può anche promettere il tavolo per un numero fisso di minuti, scelto dalle durate già viste di quelle telefonate e da quanto si risparmia, contando anche l’attesa che la comitiva farebbe al ritorno. Allo scadere si sparecchia comunque.
Chi servire prima: chi ha mangiato meno, se quasi tutti prendono uno o due piatti e pochi restano tutta la sera; chi è entrato prima, se tutti hanno lo stesso menù. Nel primo caso le tavolate lunghe pagano, e serve un correttivo per chi aspetta da troppo.
Fra più sale, mandare il cliente dove la sua tavola è già pronta conviene finché quella sala non trabocca. Se è pronta più di metà della tavola si va lì, altrimenti nella sala meno carica.
Da ricordare
Un agente è un programma di chiamate dipendenti, con un contesto che cresce (\(L_{j+1} = L_j + o_j + r_j\) finché l’harness non lo riscrive) e interruzioni di durata variabile; il motore lo riconosce con certezza solo da un identificativo di sessione o di programma.
InferCept misura lo spreco in memoria per tempo, \(S_{\text{cons}} = t_{\text{s}} L m_{\text{kv}}\), \(S_{\text{scar}} = \Delta(L)(L m_{\text{kv}} + M_{\text{altri}})\), \(S_{\text{spos}} = 2 t_{\text{sw}}(L)(L m_{\text{kv}} + M_{\text{altri}})\), con la memoria contesa (senza coda conservare non costa). In regime saturo la soglia di conservazione cresce con il carico e dipende da \(m_{\text{kv}}\). Stima le durate non profilate con il tempo trascorso, ricalcola a pezzi nella capacità libera, trasferisce in pipeline e sceglie per richiesta [AHS+24].
Continuum fissa la cache per un tempo di vita \(T^* = \arg\max_T F_f(T)(t_{\text{rip}} + \zeta \bar{w}) - T\), che mette nel beneficio anche l’attesa al rientro e limita la perdita quando la durata dello strumento sorprende; il costo \(uT\) è prudente [LHM+25].
PLAS dà la precedenza al programma con meno servizio ricevuto, ATLAS al cammino critico più corto, con code discrete e un correttivo contro la fame [LSC+25]. Su un server solo, fra le regole che non conoscono il lavoro residuo, LAS rende minima la coda, e il tempo medio, quando le lunghezze sono DFR; con lunghezze IFR vincono, nella stessa classe, le regole che non interrompono [Nuy04]. PLAS è fuori da quelle ipotesi, e la simulazione ne ritrova il verso.
Fra repliche, E2 sfrutta la cache se i token trovati superano quelli mancanti, altrimenti esplora minimizzando carico recente, sfratti e prefill; ribilanciamento e replica dei prefissi caldi correggono gli squilibri [SHA+25].
Ogni decisione del motore si paga in secondi di scheda, la memoria tenuta ferma, i prefill rifatti, i trasferimenti fra scheda e host, le repliche accese per un prefisso troppo richiesto. Quei secondi sono anche joule, e il conto in energia li segue fino alla corrente che li alimenta e all’anidride carbonica che lasciano.