



Il repository come memoria: istruzioni e fonte di verità#
Un ingegnere arriva il lunedì in una squadra che lavora da mesi allo stesso progetto. Ha davanti il codice, e nient’altro. Non c’era alla riunione in cui si è deciso di non usare una certa libreria, non ha letto la conversazione in cui si è stabilito che ogni modifica passa da una certa batteria di test, non sa che il database di prova si azzera ogni notte. Un buon collega lo accompagna per una settimana, e alla fine della settimana l’ingegnere sa. Un agente quella settimana non ce l’ha: ogni sessione, per lui, è il primo lunedì.
Ryan Lopopolo, che ha raccontato il progetto di OpenAI scritto da cima a fondo da un agente, lo dice dal punto di vista dell’agente: ciò a cui non può accedere nel contesto mentre lavora, di fatto, non esiste [Lop26]. Le decisioni prese in un documento condiviso, in una chat, nella testa di qualcuno, per lui non ci sono, esattamente come non ci sarebbero per una persona entrata in squadra tre mesi dopo; ci sono il codice e i file di testo del repository, con la loro storia. Il repository diventa allora la fonte di verità del progetto, e tutto ciò che serve a lavorarci (che cosa si sta costruendo, come è organizzato, come si avvia, come si controlla, a che punto si è) ci va scritto dentro.
Ciò che l’agente non vede non esiste#
Un agente che lavora su un progetto riceve informazione da tre canali: le istruzioni che il ciclo gli monta davanti all’inizio della sessione, i file che legge con i suoi strumenti, e gli esiti dei comandi che lancia. A questi si aggiunge ciò che il modello sa già dall’addestramento, che basta per le scelte che ogni programmatore farebbe e non serve a niente per le abitudini di quel progetto. Tutto il resto dovrà ricostruirlo, cioè indovinarlo, e indovinarlo di nuovo a ogni sessione, perché la finestra della sessione prima è sparita.
Ne viene una prova che costa cinque minuti e dice molto: la prova della
sessione nuova. Si apre una sessione che non sa niente e le si chiede di
rispondere, guardando soltanto il repository, a cinque domande: che cos’è
questo sistema, come è organizzato, come si avvia, come si controlla che
funzioni, a che punto è il lavoro. A ciascuna risponde di solito un oggetto
preciso, nello stesso ordine: il file d’istruzioni e il file di presentazione
(il README), un documento che descrive come le parti del programma stanno
insieme (l’architettura), uno script che prepara e avvia l’ambiente, i comandi
dei test, il file di avanzamento con la storia delle versioni. Una domanda
senza risposta è un punto in cui ogni sessione tirerà a indovinare, e non
sempre allo stesso modo.
Il martedì passi in bottega e dici a voce all’artigiano di turno che quel legno di noce si scheggia, e che va tagliato nell’altro verso. L’artigiano ringrazia, taglia bene, e la sera se ne va. Il mercoledì al banco siede l’artigiano del mercoledì, con le mani di quello di martedì e non la sua memoria: quella frase non l’ha mai sentita, e per lui non esiste. Esiste soltanto ciò che trova scritto in bottega, sul cartello, sul registro, nelle schede dei cassetti, più quello che ogni falegname sa da sé. La frase detta a voce è morta con la giornata di martedì.
Il nuovo arrivato, entrando, cerca cinque cose. Che cosa si fabbrica qui. Dove sta che cosa. Come si accendono le macchine. Come si controlla un pezzo. Fin dove è arrivato il lavoro di ieri. Se una delle cinque non è scritta da nessuna parte, la indovina; e il giorno dopo un altro artigiano la indovinerà di nuovo.
Indovinare la stessa cosa ogni mattina costa più di quanto sembri. Poniamo che nessuno abbia scritto quale colla si usa, e che ogni artigiano, guardando i barattoli, scelga quella giusta nove volte su dieci. Che in dieci mattine di fila tutti scelgano quella giusta ha probabilità 0,9 alla decima: 0,9 × 0,9 fa 0,81, per 0,9 ancora fa 0,73, poi 0,66, e così via fino a circa 0,35 alla decima mattina. Tutte giuste, quindi, solo 35 volte su 100: quasi due volte su tre, in quelle dieci mattine, almeno un giorno qualcuno incolla diverso, e a fine lavoro i pezzi non tengono insieme.
Il conto ha due correzioni, e vanno tutte e due nella stessa direzione: scrivi quello che è tuo. Per le cose che ogni falegname sa (la sega si tiene così) il nuovo arrivato sbaglia di rado, e scriverle non serve; per le abitudini di questa bottega, che nessuno indovinerebbe, sbaglia quasi sempre. E gli artigiani si copiano: se un giorno qualcuno usa la colla sbagliata e i pezzi restano lì, l’artigiano di domani vede quei pezzi e fa lo stesso. Copiare aiuta a essere coerenti, e aiuta altrettanto a ripetere un errore. Una riga sul cartello, «colla vinilica, mai quella a caldo», porta quel 35 vicino a cento, finché il cartello viene letto e dice il vero.
Nella notazione dell’anatomia dell’harness, la sessione \(k\)
decide su ciò che il ciclo le monta nel contesto \(C_{k,t}\): istruzioni,
catalogo degli strumenti, stato persistente, compito, e le azioni e le
osservazioni della sessione stessa; i documenti di docs/ vi entrano come
osservazioni, quando l’agente li apre. Si divida la conoscenza del progetto
\(\mathcal{K}\) in \(\mathcal{K}_{\text{repo}}\), ciò che il ciclo può portare in
\(C_{k,t}\), e \(\mathcal{K}_{\text{fuori}}\). La politica \(\pi_{\theta,H}\) non
dipende da \(\mathcal{K}_{\text{fuori}}\): una decisione \(d \in
\mathcal{K}_{\text{fuori}}\) non viene ignorata, viene ricampionata. Ogni
sessione ne costruisce una versione \(\hat{d}_k\) da ciò che vede e da ciò che il
modello sa già, perché anche i pesi \(\theta\) sono un canale.
Se le \(\hat{d}_k\) sono indipendenti con \(P(\hat{d}_k = d) = q\), la probabilità che \(K\) sessioni restino tutte fedeli alla decisione originale è
con \(0{,}9^{10} \approx 0{,}35\): è l’aritmetica della moltiplicazione degli errori che il loop engineering applica ai passi di un’iterazione, spostata dai passi alle sessioni. Due ipotesi del calcolo vanno discusse. L’indipendenza: una sessione che legge il codice scritto dalle precedenti tende a imitarne le scelte. Con sessioni scambiabili e positivamente correlate, scrivendo \(Q\) per la probabilità di fedeltà comune a tutte le sessioni (aleatoria, di media \(q\)), la probabilità di restare fedeli è \(\mathbb{E}[Q^K] \ge (\mathbb{E}[Q])^K = q^K\) per la disuguaglianza di Jensen, quindi \(q^K\) è un limite inferiore; ma la stessa correlazione alza la probabilità che tutte sbaglino allo stesso modo, una volta che una scelta sbagliata è entrata nel codice. L’imitazione non migliora \(q\), concentra l’errore. Il \(q\) costante: in realtà \(q\) dipende da \(d\). Per le scelte convenzionali, che il modello ricava dal pre-addestramento e dal codice, è vicino a uno; per quelle idiosincratiche, le pratiche non standard del progetto, può essere vicino a zero, e per loro \(q^K\) crolla. Sono le decisioni da scrivere.
Scrivere \(d\) in \(\mathcal{K}_{\text{repo}}\) porta \(q\) vicino a uno a tre condizioni: che il documento venga caricato quando serve, che venga seguito, e che resti vero. Il calcolo, d’altra parte, non contiene i meccanismi che recuperano un errore prima che entri nella storia, la verifica e la revisione. Ne segue anche il ruolo della prova della sessione nuova: verifica una condizione necessaria (le cinque risposte stanno in \(\mathcal{K}_{\text{repo}}\) e si raggiungono a basso costo), non una sufficiente, perché un documento può esserci e mentire, ed è il caso peggiore, poiché l’agente lo segue. Tenere quella conoscenza nel repository, e non in un sistema accanto, ha infine una ragione di versione: una decisione e il codice che la applica cambiano nello stesso commit, e la storia dice quale versione della regola valeva per quale versione del codice.
Un indice, non un manuale#
Il primo oggetto che un agente legge è il file d’istruzioni: un file di
testo nella cartella principale del repository, che il ciclo mette nel contesto
all’inizio di ogni sessione. Il nome più diffuso è AGENTS.md, una convenzione
adottata da più programmi; alcuni usano il proprio, come CLAUDE.md. Spesso i
file sono più d’uno e si sommano: uno personale, valido per tutti i progetti di
chi lavora; uno del progetto; e uno per sottocartella, caricato quando l’agente
lavora lì. Le regole più specifiche arrivano dopo quelle generali, e di solito,
quando si contraddicono, vale la più specifica. Nella sezione sul context engineering il file compariva di
passaggio, fra le regole di progetto; qui diventa la porta di tutto il
repository.
La tentazione, a ogni errore dell’agente, è aggiungere una riga a quel file, e il file cresce fino a diventare un manuale. La squadra di Lopopolo ha provato la strada del file unico e grande, e racconta come fallisce. Il contesto è una risorsa scarsa, e un file enorme toglie spazio al compito, al codice e ai documenti che servono davvero, così l’agente o perde un vincolo importante o comincia a inseguire quelli sbagliati. Troppe indicazioni smettono di indicare: quando tutto è «importante», niente lo è, e l’agente finisce per attaccarsi alla regola che ha sotto gli occhi invece di cercare quella che serve. Il manuale invecchia subito, diventa un accumulo di regole scadute di cui l’agente non sa quali valgano ancora, e le persone smettono di aggiornarlo. E non si presta ai controlli meccanici (che cosa copre, se è aggiornato, chi ne risponde, se i rimandi tengono): è un blocco di prosa [Lop26].
A questo si aggiunge l’effetto di posizione che la sezione sul context engineering discute: misurato sul recupero di informazioni, con modelli del 2023, un modello usa peggio ciò che sta a metà di un testo lungo [LLH+24]. Sulle regole di un file d’istruzioni l’effetto non è stato misurato, e il file sta comunque in testa al contesto; ma una regola sepolta alla riga cinquecento di un file di mille è il caso su cui non conviene scommettere.
La riparazione è trattare il file come un indice e non come un manuale. Nel
repository di Lopopolo AGENTS.md è lungo un centinaio di righe e fa
soprattutto da mappa, con i rimandi alle fonti di verità più profonde; il resto
vive in una cartella docs/ organizzata, con i documenti sull’architettura e
sul progetto, i piani di lavoro in corso e conclusi con le decisioni prese, le
specifiche del prodotto e i riferimenti. Un indice di questo tipo dice che cos’è
il progetto, quali comandi lo avviano e lo controllano, quali poche regole non
si violano mai, e dove guardare per tutto il resto, come nella
Fig. 22.2. Conviene che descriva i documenti, cioè ciò che
dal codice non si ricava, più che il codice stesso, che l’agente sa esplorare da
sé.
L’agente parte da un punto d’ingresso piccolo e stabile, e impara dove guardare dopo: è quella che nel disegno delle interfacce si chiama divulgazione progressiva (progressive disclosure), mostrare subito il poco che serve a tutti, e il resto quando serve. È una pratica raccontata da chi l’ha adottata, non un risultato misurato contro un gruppo di confronto, e le misure del 2026 ne mostrano i limiti.
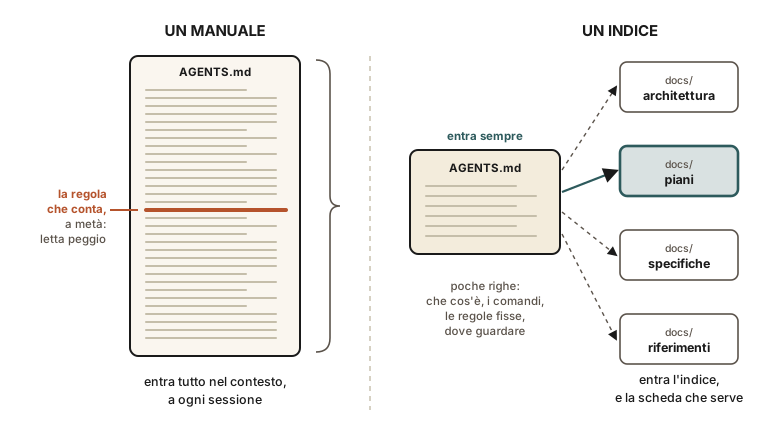
Fig. 22.2 Due modi di dare le istruzioni a un agente. A sinistra il manuale: entra tutto nel contesto a ogni sessione, e la regola importante finisce a metà. A destra l’indice: entra sempre, è corto, e manda alla sola scheda che il compito chiede.#
All’ingresso della bottega c’è un cartello di una pagina. Dice che cosa si fabbrica, come si accendono le macchine, come si controlla un pezzo, le tre regole che non si violano mai; e per tutto il resto, quale cassetto aprire. Ogni cassetto ha un’etichetta chiara («incastri», «vernici», «ordini in corso») e dentro le sue schede. L’artigiano del mattino legge il cartello e apre soltanto il cassetto del lavoro di oggi, che sono tre pagine. Quattro pagine in tutto, e il banco resta libero per il disegno del pezzo.
Nella bottega accanto, invece del cartello, c’è un raccoglitore di sessanta pagine, e la regola è leggerlo tutto ogni mattina. Sessanta pagine sono una mattina persa, e aperte sul banco non lasciano posto al disegno. La regola che conta davvero sta a pagina trenta, proprio in mezzo, e lì l’occhio scivola: di una lettura lunga si ricordano meglio l’inizio e la fine. Metà delle pagine sono sottolineate in rosso, e quando tutto è sottolineato niente spicca. E dentro ci sono regole di tre anni fa, quando la bottega usava un’altra vernice: l’artigiano non sa che sono scadute, e le segue.
Il cartello ha un punto debole suo, e conviene saperlo. Funziona solo se le etichette dei cassetti sono chiare. Un cassetto con scritto «varie» non lo apre nessuno, e la regola che ci sta dentro, per quell’artigiano, è come se non fosse scritta. Al contrario, un’etichetta troppo vaga fa aprire il cassetto anche quando non serve, e la mattina si allunga. Per le regole che non si possono mancare, quindi, il cassetto non basta: vanno sul cartello stesso, in alto. Nel file di un agente l’etichetta del cassetto è la riga che, accanto al nome di ogni documento, dice che cosa contiene e quando aprirlo.
Si modelli il caricamento. Sia \(L_0\) la lunghezza in token dell’indice e \(L_1,
\dots, L_m\) quelle dei documenti di docs/. Un file monolitico porta nel
contesto, a ogni sessione, \(L_0 + \sum_j L_j\) token. Con la divulgazione
progressiva entra sempre l’indice, e il documento \(j\) quando l’agente lo apre.
Se \(p_j\) è la probabilità che il compito richieda \(j\), \(r_j\) quella che
l’agente lo apra quando serve (il richiamo dell’instradamento) e \(f_j\) quella
che lo apra quando non serve, la probabilità effettiva di caricarlo è
\(\tilde{p}_j = r_j p_j + f_j (1 - p_j)\), e
Il risparmio rispetto al monolite è \(\sum_j (1 - \tilde{p}_j) L_j\) per sessione. Si noti che la formula, presa da sola, premia proprio il guasto da temere: se l’instradamento peggiora, \(r_j\) scende, \(\mathbb{E}[L]\) scende con lui, e il «risparmio» sale. Il calcolo completo ha un termine di perdita: con \(C_j\) il danno atteso di una regola mancata e \(c_g\) il costo di una chiamata a uno strumento per aprire un documento, l’indice conviene se
Le regole il cui mancato caricamento costa troppo (\(C_j\) grande: una scrittura irreversibile, un vincolo di sicurezza) restano nell’indice stesso, dove la probabilità di caricamento è uno, e preferibilmente in testa. Quanto alla scala, un file d’istruzioni lungo vale qualche migliaio di token, mentre una singola esecuzione di un agente di programmazione ne legge in ingresso dell’ordine delle centinaia di migliaia (nel lavoro di Lulla e colleghi la mediana è di circa 117.000 token, in gran parte riletti dalla cache): il risparmio in token, da solo, è modesto. Gli argomenti forti per l’indice sono gli altri tre di Lopopolo, cioè l’attenzione che il manuale disperde, il suo invecchiare e il fatto che non si lascia controllare; l’ultimo è la proprietà su cui si regge la parte sul tenere vera la memoria.
Che cosa dicono le misure#
Le prime misure sul valore dei file d’istruzioni sono arrivate nel 2026. Tutte e due guardano agenti che risolvono una richiesta alla volta, non lavori di molte sessioni, e usano modelli del 2025; dicono comunque una cosa più scomoda e più utile di «scrivilo bene».
Gloaguen e colleghi hanno messo quattro agenti di programmazione davanti a compiti presi da progetti esistenti, in tre condizioni: senza file d’istruzioni (loro lo chiamano file di contesto), con un file scritto da un modello, e, nei progetti che lo avevano, con quello scritto dagli sviluppatori [GMundlerSMuller+26]. I file scritti da un modello hanno cambiato di poco la quota di compiti riusciti, mezzo punto e due punti percentuali in meno nei due gruppi di prova: differenze così piccole che potrebbero essere dovute al caso. Il costo di ogni esecuzione, cioè quanto si paga per il lavoro del modello, è invece salito in media del 20% e del 23%, e questo aumento non è dovuto al caso.
Quelli scritti dagli sviluppatori hanno alzato la quota di 2,4 punti in media, anche questi troppo pochi per escludere il caso, e il costo in media del 19%, con grandi differenze da un agente all’altro; in compenso hanno fatto meglio dei file scritti da un modello, ed è l’unica differenza di successo dello studio che il caso non spiega. Gli agenti seguivano le istruzioni, e proprio per questo facevano più passi, in particolare più test e più esplorazione. Le panoramiche del progetto, la parte che quasi tutte le guide raccomandano, non aiutavano.
Due risultati spostano la lettura. Dove dal progetto si toglieva ogni altra documentazione, il file scritto da un modello migliorava il successo di 2,7 punti in media, nel gruppo di prova in cui la prova è stata fatta: il file serve quando non c’è altro da leggere. E la lunghezza del file, fra le poche decine e le circa duemila parole dei file dello studio, non appariva legata al successo: in quei dati i file lunghi non facevano sbagliare di più. La ragione per tenerlo corto sta altrove, nel fatto che ogni riga si paga a ogni sessione e prima o poi invecchia, e che un indice si controlla e un manuale no.
Lulla e colleghi hanno guardato a un’altra cosa, il tempo: un solo agente di programmazione su 124 modifiche piccole prese da dieci progetti, ogni compito eseguito una volta con il file e una senza [LMG+26]. Con il file il tempo tipico (la mediana, cioè il valore che sta a metà della fila) è sceso da 98,6 a 70,3 secondi, e il testo prodotto dal modello da 2.925 a 2.440 token, mentre quello letto non è cambiato; se le modifiche fossero corrette non era fra le cose misurate. Le due misure guardano cose diverse, il successo e la spesa su compiti più grandi da una parte, il tempo su modifiche piccole dall’altra, e non si contraddicono: nessuna delle due dice che il file aiuti sempre.
Messe insieme, non dicono di non scrivere il file. Dicono che il file è un componente come gli altri, con un costo che si paga a ogni sessione e un beneficio che non è garantito: va scritto con le cose che l’agente non può ricavare da sé (i comandi, le pratiche non standard, le regole che non si violano), va tenuto lontano dalle descrizioni che il codice dà già, e va provato sui compiti veri prima di crederci.
Tenere vera la memoria#
Un indice corto ha un vantaggio che il manuale non ha: si può controllare. Nel repository di Lopopolo dei controlli automatici verificano che la base di conoscenza sia aggiornata, collegata e strutturata come previsto, e un agente che parte a cadenza fissa cerca i documenti che non descrivono più il comportamento reale del codice e propone le correzioni [Lop26]. Una regola dell’indice, poi, regge meglio se porta con sé perché esiste, quando si applica e quando smette di valere: senza il perché nessuno osa toglierla, senza il quando la si legge anche dove non c’entra, senza la scadenza diventa una delle regole morte di cui l’agente non sa niente.
Il controllo più semplice si scrive in poche righe. Lavora su un repository finto, tenuto in un dizionario (percorso → contenuto), e cerca tre guasti tipici di un indice: un documento citato che non esiste più, un documento che l’indice non cita mai, e un comando citato che il progetto non ha.
import re

# Un repository finto: percorso -> contenuto. L'indice cita i documenti e i
# comandi fra apici inversi, come si fa di solito in Markdown.
repo = {
    "AGENTS.md": (
        "# Negozio online\n"
        "Avvio: `make dev`. Controllo: `make check`, poi `make lint`.\n"
        "Mai scrivere sul database di produzione.\n"
        "- dove va il codice nuovo: `docs/architettura.md`\n"
        "- prima di toccare il checkout: `docs/pagamenti.md`\n"
        "- a inizio sessione: `docs/piani/carrello.md`\n"
    ),
    "docs/architettura.md": "Tre strati: dati, servizi, interfaccia.",
    "docs/piani/carrello.md": "Fatto: aggiunta al carrello. Manca: sconti.",
    "docs/sicurezza.md": "Le chiavi dei pagamenti non vanno mai nei file.",
    "Makefile": "dev:\n\tpython app.py\ncheck:\n\tpytest\n",
}

indice = repo["AGENTS.md"]
citati = set(re.findall(r"`(docs/[^`]+)`", indice))
documenti = {p for p in repo if p.startswith("docs/")}
comandi = set(re.findall(r"`make (\w+)`", indice))
bersagli = set(re.findall(r"^(\w+):", repo["Makefile"], re.M))

problemi = {
    "documenti citati ma assenti": sorted(citati - set(repo)),
    "documenti mai citati": sorted(documenti - citati),
    "comandi citati ma assenti": sorted(comandi - bersagli),
}
print("righe dell'indice:", len(indice.splitlines()))
for nome, elenco in problemi.items():
    print(f"{nome}: {elenco}")
print("cancello:", "chiuso" if any(problemi.values()) else "aperto")
righe dell'indice: 6
documenti citati ma assenti: ['docs/pagamenti.md']
documenti mai citati: ['docs/sicurezza.md']
comandi citati ma assenti: ['lint']
cancello: chiuso
L’indice è di sei righe, quindi corto, e ha tre guasti. Il primo è il più grave: l’indice manda l’agente a leggere le regole dei pagamenti prima di toccare il checkout, e quel documento non c’è più; l’agente lo cerca, non lo trova, e procede senza. Il secondo è una regola viva, le chiavi dei pagamenti fuori dai file, che l’indice non cita: l’agente potrebbe sempre trovarla elencando i file, ma la troverà di rado, e proprio nella sessione che non sapeva di doverla cercare. Il terzo è un comando che l’indice raccomanda e che non esiste, cioè un’istruzione che fallirà a ogni sessione. Qui «citato» vuol dire citato dall’indice; con più indici annidati si seguirebbe la catena dei rimandi.
Il programma stampa soltanto; in un controllo automatico vero uscirebbe con un codice d’errore, e quel codice, lanciato a ogni modifica insieme ai test, è ciò che la ferma: un cancello come quelli del loop engineering. Il cancello però ha un limite preciso. Controlla che i documenti esistano e si raggiungano, non che dicano il vero: che un documento descriva ancora il codice lo può dire solo chi lo rilegge, una persona o un agente incaricato di farlo, che a sua volta può sbagliare.
Da ricordare
Per un agente esiste soltanto ciò che trova scritto nel progetto, più quello che ogni programmatore sa già. Una decisione presa a voce o in una chat viene indovinata di nuovo a ogni sessione: se ogni sessione indovina giusto nove volte su dieci, in dieci sessioni sono tutte giuste solo 35 volte su 100.
Vanno scritte soprattutto le abitudini del progetto, quelle che nessuno indovinerebbe; e gli errori, una volta entrati nel lavoro, vengono copiati. Scriverle funziona finché lo scritto viene letto e resta vero.
La prova della sessione nuova: guardando solo il progetto, si deve sapere che cos’è, com’è organizzato, come si avvia, come si controlla, a che punto è il lavoro.
Il file d’istruzioni (
AGENTS.md) va fatto come il cartello all’ingresso, non come un raccoglitore: poche righe, le regole che non si violano, e per il resto quale cassetto aprire, con etichette chiare.Le misure del 2026 non dicono di non scrivere questi file: dicono che costano (più passi, più spesa), che a volte fanno fare prima e che non sempre aiutano a riuscire. Servono soprattutto per ciò che l’agente non può capire da solo, si tengono corti perché ogni riga si paga e invecchia, e vanno provati sui lavori veri.
Un indice corto si controlla a macchina (ogni documento citato esiste, ogni documento è citato, ogni comando esiste), ma il controllo non sa se ciò che è scritto è ancora vero: quello va riletto.
Da ricordare
La politica non dipende da \(\mathcal{K}_{\text{fuori}}\): una decisione non scritta viene ricampionata, e con sessioni indipendenti la fedeltà decade come \(q^K\). Con sessioni positivamente correlate \(q^K\) è un limite inferiore, ma l’imitazione concentra anche l’errore; e \(q\) dipende da \(d\), vicino a zero proprio per le pratiche non standard.
La prova della sessione nuova verifica che le cinque risposte siano nel repository: condizione necessaria, non sufficiente, perché un documento può mentire [Lop26].
Indice contro monolite: \(\mathbb{E}[L] = L_0 + \sum_j \tilde{p}_j L_j\) con \(\tilde{p}_j = r_j p_j + f_j(1 - p_j)\); il conto va chiuso con la perdita attesa delle regole mancate, e le regole con \(C_j\) alto restano nell’indice. In token il risparmio è modesto: contano attenzione, invecchiamento, controllabilità.
Le misure (una richiesta alla volta, modelli del 2025): file generati da un modello senza effetto significativo sul successo e con il 20-23% di costo in più; file degli sviluppatori +2,4 punti non significativi, costo medio +19%, meglio dei generati; utili dove manca altra documentazione [GMundlerSMuller+26]. Sul tempo, mediana da 98,6 a 70,3 secondi e token prodotti da 2.925 a 2.440, correttezza non misurata [LMG+26].
La base di conoscenza si mantiene con controlli meccanici (riferimenti esistenti, documenti citati, comandi esistenti) lanciati come un cancello; la verità di un documento resta fuori dalla loro portata.