



Gli strumenti: l’interfaccia fra l’agente e il computer#
Un gruppo di Princeton ha messo un modello di linguaggio davanti alla riga di
comando di un computer, la shell, e gli ha chiesto di correggere
segnalazioni di errore vere, quelle del banco di prova SWE-bench che la
sezione sulla valutazione degli agenti ha già presentato. Il modello sapeva
scrivere codice, ma usava male la macchina. Per guardarsi intorno apriva
cartelle ed elencava file uno alla volta; le ricerche con grep, il comando che
cerca una parola nei file, gli restituivano a volte pagine di righe che non
c’entravano; per modificare un file doveva riscriverlo da capo o sostituire
testo riga per riga, e se la modifica rompeva il codice nessuno glielo diceva.
Da queste difficoltà John Yang, Carlos E. Jimenez e i loro colleghi hanno ricavato l’idea che dà il titolo al lavoro: un modello che usa un computer è un utente di genere nuovo, e lavora meglio con un’interfaccia pensata per lui che con una pensata per le persone. L’hanno chiamata interfaccia agente-computer (agent-computer interface, ACI): i comandi che il modello può dare, il modo in cui gli vengono descritti, la forma in cui il computer gli risponde e quanto delle risposte passate gli resta davanti [YJW+24].
Il loro agente, SWE-agent, aggiunge alla shell pochi comandi: un visualizzatore che mostra un file cento righe alla volta, con i numeri di riga e quante ne restano sopra e sotto; una ricerca che restituisce al più cinquanta risultati e, se ce ne sono di più, chiede una domanda più precisa; una modifica che sostituisce un intervallo di righe e viene scartata se il linter (il programma che segnala ciò che viola una regola, già incontrato nel collaudo) ci trova un errore. Quando un comando non stampa niente, il modello riceve una frase che lo dice, e delle risposte passate gli restano per intero solo le ultime cinque.
Con lo stesso modello (GPT-4 Turbo) e sulle stesse trecento segnalazioni, un sottoinsieme che si chiama SWE-bench Lite, SWE-agent ne risolveva il 18,0%, un agente con la sola shell l’11,0%; togliendo a SWE-agent il solo comando di modifica si scendeva al 10,3%, quasi come con la sola shell (31 segnalazioni contro 33).
Si noti che ogni configurazione ridotta è stata provata una volta, mentre quella intera, provata sei volte, ha oscillato fra il 17,33% e il 18,67%: una differenza di pochi punti può essere fortuna, ed è la cautela che l’anatomia dell’harness chiede a chi toglie un componente alla volta per misurarne il peso.
Il modello era lo stesso in tutte le prove, con gli stessi pesi, i numeri imparati nell’addestramento; cambiavano i comandi, le loro descrizioni, le risposte e quanto ne restava nel contesto, cioè quasi tutto il sottosistema che l’anatomia chiama strumenti, più un pezzo del lavoro con cui il ciclo monta il contesto. Gli strumenti sono le operazioni che il modello può chiedere al programma che lo ospita, con le regole che dicono quali può chiedere da solo.
Come funziona una singola chiamata (il modello scrive il nome dello strumento e i valori, il programma esegue e restituisce il risultato) lo ha mostrato il ciclo dell’agente. La domanda dell’harness è un’altra: quali strumenti dare, che cosa devono restituire, come cambiano il codice e fin dove deve poter arrivare ciò che fanno.
Uno strumento è un pezzo di contesto#
Le definizioni degli strumenti, cioè il nome, la descrizione e l’elenco dei
valori che ciascuno accetta, entrano nel contesto a ogni passo, che lo
strumento serva o no; e ciò che uno strumento restituisce entra nel contesto e
ci resta, riletto a ogni passo successivo. Progettare gli strumenti vuol dire
progettare il contesto. Ken Aizawa, che ha raccolto le lezioni di
Anthropic sugli strumenti per agenti, comincia da un errore che dice frequente:
trasformare in strumenti, una per una, le funzioni che un servizio offre agli
altri programmi [Aiz25]. Ad esempio, un programma può
scorrere una rubrica di mille contatti uno alla volta, perché la sua memoria
costa poco; un agente a cui elenca_contatti restituisce la rubrica intera la
deve leggere tutta, e spende il contesto in nomi che non c’entrano. Lo
strumento adatto all’agente è cerca_contatti.
Ne vengono alcuni principi. Pochi strumenti, perché ogni definizione in più è
testo da rileggere e da scegliere a sproposito: fra i guasti del context engineering c’è un modello piccolo che con
quarantasei strumenti in elenco falliva la richiesta, e con diciannove la
portava a termine [Bre25]. Ognuno con uno scopo chiaro e
distinto, perché quelli che si sovrappongono confondono l’agente su quale usare;
e costruiti per lo scopo, come un cerca_log che di un log, il registro delle
righe che un programma scrive mentre lavora, restituisce le sole righe
pertinenti, al posto di un leggi_log che lo restituisce tutto
[Aiz25].
Un cerca_ordini(cliente) dice da sé a che cosa serve; un
esegui_sql(query), che esegue qualunque interrogazione al database, lascia
all’agente il lavoro di scriverla giusta e la libertà di scriverla sbagliata.
Nomi e descrizioni, infine, sono un prompt: la descrizione si scrive come per un
collega appena arrivato, e i nomi dei valori senza ambiguità, id_utente e non
utente, che potrebbe essere un nome, un indirizzo o un numero.
Che cosa torna indietro#
L’altra metà del contesto che uno strumento occupa è la sua uscita. Un comando lanciato così com’è restituisce tutto quello che stampa: un log può essere lungo quattromila righe, ed entra per intero nel contesto. Lo stesso comando tagliato alle prime cento righe costa poco ma tace: se l’errore sta più in giù, il modello legge cento righe di normalità e ne conclude che va tutto bene. Aizawa raccomanda di tagliare, paginare o filtrare le risposte lunghe, e quando si taglia di dire all’agente come proseguire [Aiz25]. Il taglio sceglie anche che cosa tenere, e gli errori vanno messi per primi.
Un’uscita, poi, può dire la stessa cosa in due situazioni diverse. Il caso
tipico è il vuoto. grep, quando finisce, restituisce un numero che dice com’è
andata, il codice d’uscita: 1 se non ha trovato niente, 2 se qualcosa è andato
storto, per esempio un file che non esiste, e allora scrive anche un messaggio
d’errore, su un canale a parte. Uno strumento che passa al modello soltanto
l’uscita normale riduce quindi i due casi alla stessa risposta vuota, e
l’agente legge «niente da trovare» dove c’era un guasto. Per
questo SWE-agent dice quando un comando è riuscito senza stampare niente, e
MCP, il protocollo con cui un’applicazione parla con i suoi strumenti, chiede
che l’errore di uno strumento torni al modello dentro la risposta, segnato come
errore, perché altrove il modello non lo vedrebbe [ModelCProtocol25].
La stessa ambiguità vive nei valori: un’ora scritta senza fuso orario sposta di ore un lavoro programmato, e la toglie un’uscita che dichiara di ogni valore il tipo, con il fuso o l’unità di misura. Anche un errore che dice soltanto «argomento non valido» lascia indovinare, mentre uno che nomina il valore sbagliato, quello atteso e una chiamata giusta d’esempio dice che cosa fare, come i messaggi che insegnano del collaudo.
Resta la ripetizione. Un ciclo ritenta: una chiamata il cui esito non arriva, per un tempo scaduto o una connessione caduta, viene mandata di nuovo, e lo strumento non sa se è una richiesta nuova o la stessa ripetuta.
Uno strumento idempotente, che eseguito due volte con gli stessi valori lascia le cose come eseguito una volta, si può ritentare senza pensarci; uno che aggiunge, sottrae o spedisce ha bisogno di un modo per riconoscere la ripetizione, che la sezione sul grafo riprenderà, con le chiavi d’idempotenza, per la ripresa dopo un guasto.
Un programma confronta, a numeri tondi, tre uscite di un log di quattromila righe con un solo errore, alla riga 2.731: il log intero, le prime cento righe, e un’uscita progettata, che tiene al più cento righe in tutto, con gli errori in cima, la testa e la coda del log e una riga su come chiedere il resto. Il log arriva al passo dieci di una sessione di sessanta passi e resta nel contesto fino alla fine.
import textwrap

# Un log di 4.000 righe con un solo errore, alla riga 2.731: a numeri tondi,
# non una misura.
log = [f"{i:04d} INFO richiesta servita" for i in range(1, 4001)]
log[2730] = "2731 ERROR connessione al database rifiutata"
TETTO = 100                            # righe che lo strumento restituisce

def it(n):                             # 200000 -> 200.000
    return f"{n:,}".replace(",", ".")

def prime_righe(righe):
    """Il comando lanciato così com'è, tagliato al tetto."""
    return righe[:TETTO]

def progettato(righe):
    """Al più TETTO righe in tutto: prima gli errori, con un tetto anche
    loro, poi testa e coda del log, e una riga su come chiedere il resto."""
    if len(righe) <= TETTO:                       # un log corto passa intero
        return list(righe)
    errori = [i for i, r in enumerate(righe) if " ERROR " in r]
    cima = errori[:TETTO // 2]
    posto = TETTO - len(cima) - 1
    testa = [i for i in range(posto // 2) if i not in cima]
    coda = [i for i in range(len(righe) - (posto - posto // 2), len(righe))
            if i not in cima]
    nota = (f"[omesse {it(len(righe) - len(cima + testa + coda))} righe; "
            f"errori: {it(len(errori))}, in cima: {len(cima)}; per una "
            f"fetta: fetta_log(da, a); per cercare: cerca_log(testo)]")
    return ([righe[i] for i in cima + testa] + [nota]
            + [righe[i] for i in coda])

PASSI, ARRIVO = 60, 10                 # il log arriva al passo 10 di 60
for nome, uscita in [("tutto il log", log),
                     ("prime cento righe", prime_righe(log)),
                     ("progettato", progettato(log))]:
    visto = "sì" if any(" ERROR " in r for r in uscita) else "no"
    riletture = len(uscita) * (PASSI - ARRIVO)    # dal passo 11 al 60
    print(f"{nome:>17}: {it(len(uscita)):>5} righe, errore in vista: "
          f"{visto}, righe rilette: {it(riletture)}")
uscita = progettato(log)
print(uscita[0])
print(textwrap.fill(next(r for r in uscita if r.startswith("[omesse")),
                    76, subsequent_indent=" "))
pieno = [r.replace("INFO", "ERROR") for r in log]   # e se fosse tutto errori?
print(f"con {it(len(pieno))} errori: {len(progettato(pieno))} righe")
     tutto il log: 4.000 righe, errore in vista: sì, righe rilette: 200.000
prime cento righe:   100 righe, errore in vista: no, righe rilette: 5.000
       progettato:   100 righe, errore in vista: sì, righe rilette: 5.000
2731 ERROR connessione al database rifiutata
[omesse 3.901 righe; errori: 1, in cima: 1; per una fetta: fetta_log(da, a);
 per cercare: cerca_log(testo)]
con 4.000 errori: 76 righe
Il log intero mostra l’errore e costa duecentomila righe rilette, cinquanta volte quattromila; le altre due uscite cinquemila. Costano uguale, ma nelle prime cento righe l’errore non c’è, nell’uscita progettata è la prima riga, e la nota dice quante righe del log mancano e come chiederle. Anche gli errori hanno un tetto, cinquanta righe: con un log tutto di errori l’uscita ha cinquanta errori, la nota e venticinque righe di coda, 76 in tutto.
L’artigiano, cioè il modello, lavora al banco e dal banco non si muove. Gli attrezzi, in questa bottega, non stanno al gancio ma in magazzino, dietro uno sportello, e li usa per lui il magazziniere, che nella realtà è il programma che esegue le richieste del modello. L’artigiano scrive su un biglietto che cosa gli serve (il biglietto è la chiamata a uno strumento), il capobottega, cioè il ciclo, lo porta allo sportello e torna con la risposta del magazziniere (l’uscita dello strumento). La risposta finisce sul tavolo, che è il contesto, e ci resta: l’artigiano, che da una mossa all’altra non ricorda niente, a ogni mossa rilegge tutto quello che c’è sopra.
Sul tavolo c’è anche l’elenco degli attrezzi: una voce per attrezzo, con il nome, a che cosa serve e che cosa scrivere sul biglietto. Si rilegge a ogni mossa, anche le voci che quel giorno non servono, e quaranta voci costano ogni volta più di dodici. Se due voci si somigliano, per esempio «cerca un pezzo» e «trova in magazzino», l’artigiano a volte sceglie quella sbagliata, e torna una risposta che non serviva.
Una mattina chiede le viti da quattro millimetri. Un magazziniere sbrigativo gliene rovescia sul tavolo quattromila, e da lì in poi le quattromila viti si riguardano a ogni mossa. Un altro gliene porta venti e basta, e l’artigiano crede che siano tutte. Il magazziniere bravo ne porta venti con una nota in cima: «Attenzione, una scatola ha le viti difettose. Ce ne sono altre 3.980 in tre cassetti: chiedimi il cassetto, o dimmi la lunghezza che ti serve.»
Siccome una risposta arrivata alle nove si rilegge fino a sera, il capobottega tiene ogni risposta sul tavolo soltanto per le cinque mosse dopo il suo arrivo; poi la toglie, e lascia una riga: «qui c’era l’elenco delle viti».
Un giorno l’artigiano chiede le cerniere piccole, e la risposta è «niente». Il cassetto era vuoto, o era chiuso a chiave e il magazziniere non l’ha aperto? La risposta è la stessa, e l’artigiano farà la stessa cosa nei due casi: ordinerà cerniere nuove, che se il cassetto era chiuso stavano già lì. Il magazziniere bravo scrive «cassetto vuoto» o «cassetto chiuso, la chiave ce l’ha il proprietario»; scrive «listelli da 40 centimetri», non «da 40»; e a una richiesta sbagliata risponde «le viti da quattro esistono lunghe 20, 30 o 50 millimetri: scegline una».
A volte, infine, una risposta si perde, e il capobottega riporta lo stesso biglietto. Per il magazziniere due biglietti uguali sono due richieste. «Aggiungi venti viti alla cassa dell’ordine dodici», due volte, ne mette quaranta; «la cassa dell’ordine dodici deve avere venti viti», la seconda volta, lo trova già fatto e non tocca niente, come le richieste che leggono soltanto. Ma se fra i due biglietti un altro artigiano ha aggiunto cinque viti per un motivo suo, il biglietto ripetuto gliele toglie. E «spedisci la cassa», che non si può trasformare in un «deve avere», porta un numero: il magazziniere che vede due volte lo stesso numero risponde «già fatto».
Nella notazione dell’anatomia dell’harness, l’azione \(a_{k,t}\) produce l’osservazione \(o_{k,t}\), che entra nel contesto \(C_{k,t+1}\) e in tutti quelli successivi della sessione. Sia \(\mathrm{tok}(\cdot)\) il numero di token e \(\mathrm{tok}(\mathcal{T})\) quello delle definizioni del catalogo. Su \(T\) passi, finché \(\mathrm{monta}\) accoda tutto senza comprimere, i token letti sono
con \(I\) le istruzioni, \(M_k\) lo stato caricato e \(x\) il compito: il conto del passaggio di consegne, con i pezzi scritti uno per uno. Il catalogo costa \(\mathrm{tok}(\mathcal{T})\) token a ogni passo, che gli strumenti si usino o no; la cache del prefisso ne abbassa il prezzo, ma non libera la finestra e non toglie la confusione, che Breunig osserva al crescere del numero \(|\mathcal{T}|\) degli strumenti. Un’osservazione costa la sua lunghezza per i passi che restano, \((T - i)\,\mathrm{tok}(o_{k,i})\), quindi di più quando arriva presto.
Le leve sono due. Un’uscita limitata in tutto a \(\mathrm{tok}_{\max}\) token, con il numero degli elementi omessi e un cursore per la pagina dopo, costa al più \((T - i)\,\mathrm{tok}_{\max}\), e se tiene una parte degli elementi li sceglie in ordine d’informazione, gli errori prima e con un tetto anche per loro. Un ciclo che dopo \(w\) passi sostituisce un’osservazione con una riga di \(\mathrm{tok}_0\) token la fa costare \(\min(w, T - i)\,\mathrm{tok}(o_{k,i}) + \max(0, T - i - w)\,\mathrm{tok}_0\); in SWE-agent \(w = 5\), e tenere tutta la cronologia abbassava la quota risolta dal 18,0% al 15,0% [YJW+24].
L’azione successiva si campiona da \(P_\theta(\cdot \mid C_{k,t+1})\), e \(C_{k,t+1}\) contiene \(o_{k,t}\). Sia \(Y\) l’esito nell’ambiente, fra trovato, vuoto e guasto (supposti esclusivi), e \(o = \mathrm{oss}(Y)\) l’osservazione che lo strumento ne restituisce. Se \(\mathrm{oss}\) manda due esiti nella stessa osservazione, i due contesti coincidono e coincide la distribuzione dell’azione successiva: nessuna politica può rispondere al guasto in un modo e al vuoto in un altro. Con \(p_v\) e \(p_g\) le probabilità del vuoto e del guasto, fondere i due esiti toglie all’osservazione
d’informazione sull’esito, l’incertezza che resta su \(Y\) quando l’osservazione è vuota, pesata per la sua probabilità. In media la perdita è piccola se il guasto è raro, ma il guasto, quando c’è, riceve la risposta pensata per il vuoto.
Un campo senza unità o senza fuso è lo stesso difetto sui valori, e uno schema
d’uscita tipato separa gli esiti che lo schema distingue: MCP prevede un
outputSchema per il risultato strutturato e il campo isError per l’errore
dello strumento [ModelCProtocol25]. All’estremo opposto, come nel
collaudo, un messaggio che nomina la regola violata e il punto porta più
informazione del rifiuto binario, che ne porta al più un bit, e uno che indica
anche la chiamata giusta sposta \(P_\theta\) verso le azioni che riparano.
Sia infine \(\mathrm{eff}(E, a)\) la seconda componente di \(\mathrm{esegui}(E, a)\), l’ambiente dopo l’azione. Un’azione è idempotente se
con \(\mathrm{eff}\) deterministica e l’esecuzione tutta o niente; le osservazioni delle due esecuzioni possono differire («fatto», «già fatto»), l’ambiente no. Serve perché il ciclo, quando l’esito non arriva, non sa se l’effetto c’è stato, e ritentando applica \(a\) una volta o due. Le letture dei file del progetto lo sono in modo banale, \(\mathrm{eff}(E, a) = E\); fra le scritture lo sono le assegnazioni, che portano una parte dello stato a un valore fissato, e non gli incrementi e gli invii, che chiedono una chiave d’idempotenza con cui il destinatario riconosce la ripetizione. La proprietà riguarda due esecuzioni consecutive: se fra le due un altro scrive con un’azione \(a'\), in generale \(\mathrm{eff}(\mathrm{eff}(\mathrm{eff}(E, a), a'), a) \ne \mathrm{eff}(\mathrm{eff}(E, a), a')\), e l’assegnazione ripetuta cancella la scrittura dell’altro.
Trovare il codice e modificarlo#
Fra gli strumenti di un agente di programmazione, quelli che usa più spesso
servono a trovare il codice e a cambiarlo. Per trovarlo ci sono quattro vie.
La ricerca di una parola nei file, grep e simili,
non ha niente da preparare e vede sempre il progetto com’è, ma trova la parola
e non l’idea (chi cerca timeout non trova scadenza), e ogni tentativo costa
un passo. Un indice preparato prima, che può cercare anche per significato,
risponde in fretta, ma va rifatto quando il codice cambia, e rimasto indietro
indica codice che non c’è più. Un language server, un programma che legge il
codice come lo legge il linguaggio e sa dire dove nasce ogni nome e chi lo usa,
distingue due nomi uguali che la ricerca di una parola confonde, al prezzo di
un programma in più sempre acceso. Infine, quando c’è un errore, il punto di
partenza più preciso è il suo messaggio, che dice in quale file e in quale riga
il programma si è fermato.
Anche la ricerca ha la sua interfaccia: gli autori di SWE-agent ne hanno provata una costruita come quelle dei programmi per le persone, che mostra un risultato alla volta, e con tutto il resto di SWE-agent al suo posto ha fatto peggio che lasciare all’agente la sola ricerca della shell, il 12,0% contro il 15,7%, perché davanti a molti risultati l’agente li guardava tutti, uno per uno, finché non finivano i soldi a disposizione o lo spazio nel contesto [YJW+24].
Trovata la riga, bisogna cambiarla, e il formato della modifica decide due cose che tirano in versi opposti: quante righe il modello deve scrivere, e quanto è probabile che la modifica tocchi soltanto ciò che doveva. Nella riscrittura intera il modello riscrive il file: si applica sempre, ma le righe da scrivere crescono con il file, e quelle da non toccare possono cambiare senza che nessuno l’abbia chiesto.
Il diff unificato, il formato con cui le persone si scambiano le modifiche, porta le righe tolte, quelle aggiunte e qualche riga di contorno: chi lo applica cerca il contorno vicino al numero di riga indicato, quindi regge se il file si è allungato o accorciato altrove, ma se è cambiato proprio il contorno non combacia, e un applicatore tollerante, che si accontenta di un contorno simile, può metterlo nel punto sbagliato.
Il cerca e sostituisci porta un’ancora, un pezzo di testo che deve comparire nel file esattamente com’è, e il testo che la sostituisce: le righe da scrivere crescono con la modifica e non con il file, e la modifica fallisce se l’ancora è ambigua, vecchia o ha gli spazi sbagliati.
Nella modifica strutturale, un’operazione sull’albero sintattico, lo schema a rami in cui il linguaggio scompone il programma, il modello nomina che cosa fare (rinomina questo parametro) e uno strumento che conosce le regole del linguaggio la esegue: non produce codice scritto male, ma esiste solo per le operazioni che lo strumento conosce, e una rinomina verso un nome già usato, se lo strumento non lo controlla, sbaglia senza dirlo.
Un programma conta le righe da scrivere su un file di 120 righe, ventiquattro funzioni da cinque righe, in cui si rinomina il parametro di una funzione sola.
import difflib

# Un file di 120 righe: ventiquattro funzioni da cinque righe. La modifica
# rinomina il parametro di una sola funzione, e cambia 4 righe.
def funzione(i, nome):
    return [f"def tassa_{i}({nome}):",
            f"    if {nome} <= 0:",
            f"        raise ValueError({nome})",
            f"    return {nome} * {i + 2} // 100",
            ""]

vecchio = [r for i in range(24) for r in funzione(i, "importo")]
nuovo = [r for i in range(24)
         for r in funzione(i, "centesimi" if i == 10 else "importo")]
cambiate = [r for r in range(len(vecchio)) if vecchio[r] != nuovo[r]]

def ancora(righe, da, a):
    """La finestra più stretta attorno alle righe da..a che compare una
    volta sola nel file: è l'ancora minima di un cerca e sostituisci."""
    for larga in range(a - da + 1, len(righe) + 1):
        for inizio in range(max(0, a + 1 - larga), da + 1):
            pezzo = righe[inizio:inizio + larga]
            if sum(righe[j:j + larga] == pezzo
                   for j in range(len(righe) - larga + 1)) == 1:
                return larga
    return len(righe)

diff = list(difflib.unified_diff(vecchio, nuovo, "a/tasse.py", "b/tasse.py",
                                 lineterm="", n=3))
larga = ancora(vecchio, cambiate[0], cambiate[-1])   # un blocco contiguo
righe_scritte = {"riscrittura intera": len(nuovo),
                 "diff unificato": len(diff),
                 "cerca e sostituisci": 2 * larga,   # ancora e sostituto
                 "operazione sull'albero": 1}        # rinomina(tassa_10, ...)
print(f"righe del file: {len(vecchio)}, righe cambiate: {len(cambiate)}")
riga = "    if importo <= 0:"
print(f"{riga.strip()!r} compare {vecchio.count(riga)} volte; "
      f"l'ancora minima è di {larga} righe")
for formato, n in righe_scritte.items():
    print(f"{formato:>22}: {n:>3} {'riga' if n == 1 else 'righe'} "
          f"da scrivere")
righe del file: 120, righe cambiate: 4
'if importo <= 0:' compare 24 volte; l'ancora minima è di 4 righe
    riscrittura intera: 120 righe da scrivere
        diff unificato:  17 righe da scrivere
   cerca e sostituisci:   8 righe da scrivere
operazione sull'albero:   1 riga da scrivere
La riscrittura scrive 120 righe per cambiarne 4; il diff 17, cioè le quattro righe tolte, le quattro aggiunte, tre di contorno prima e tre dopo, e tre di intestazione; il cerca e sostituisci 8, un’ancora di quattro righe e il suo sostituto; l’operazione strutturale una. La Fig. 22.4 mette i quattro formati sui due assi.
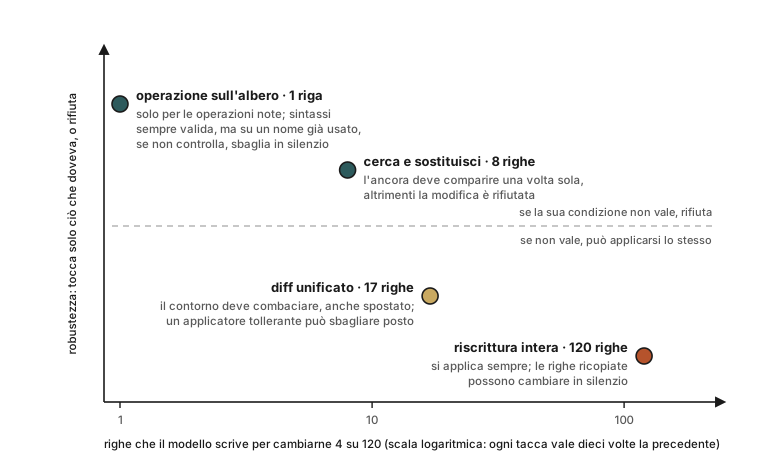
Fig. 22.4 I quattro formati di modifica per lo stesso cambiamento, quattro righe in un file di 120: in orizzontale le righe che il modello deve scrivere, in verticale la robustezza, cioè quanto la modifica tocca soltanto ciò che doveva e, quando la sua condizione non vale, rifiuta invece di applicarsi lo stesso. Le righe sono quelle stampate dal programma; l’altezza è un ordinamento, non una misura.#
Resta un rischio che nessun formato toglie da solo. Fra la lettura del file e la modifica possono passare molti passi, e il file può cambiare: un’altra sessione al lavoro in parallelo, un comando lanciato nel frattempo, una persona. Se l’ancora compare comunque una volta sola, la modifica si applica a un testo che il modello non ha mai visto.
La difesa si chiama confronto e scambio (compare-and-swap): lo strumento ricorda, per ogni sessione, l’impronta del file letto, un numero calcolato dal contenuto (con la funzione SHA-256) che basta un carattere diverso a cambiare, e al momento di scrivere sostituisce il testo vecchio con il nuovo solo se l’impronta di adesso è la stessa. Un altro programma scrive uno strumento così, con messaggi d’errore che dicono come rimediare, e lo prova con due sessioni, A e B, sullo stesso file.
import hashlib
import textwrap

# Lo stesso file di 120 righe, in un archivio finto in memoria, e due
# sessioni, A e B, che ci lavorano insieme.
def funzione(i, nome="importo"):
    return [f"def tassa_{i}({nome}):", f"    if {nome} <= 0:",
            f"        raise ValueError({nome})",
            f"    return {nome} * {i + 2} // 100", ""]

archivio = {"tasse.py": "\n".join(r for i in range(24) for r in funzione(i))}
letture = {}            # (sessione, percorso) -> impronta dell'ultima lettura

def impronta(testo):
    return hashlib.sha256(testo.encode("utf-8")).hexdigest()

def leggi(sessione, percorso):
    letture[sessione, percorso] = impronta(archivio[percorso])
    return archivio[percorso]

def righe_di(testo, ancora):
    """Le righe (da 1) in cui comincia ogni occorrenza dell'ancora."""
    trovate, pos = [], testo.find(ancora)
    while pos != -1:
        trovate.append(testo.count("\n", 0, pos) + 1)
        pos = testo.find(ancora, pos + 1)
    return trovate

def modifica(sessione, percorso, ancora, sostituto):
    testo = archivio[percorso]
    if (sessione, percorso) not in letture:
        return f"rifiutata: non hai mai letto {percorso}; leggilo prima"
    if letture[sessione, percorso] != impronta(testo):
        return (f"rifiutata: {percorso} è cambiato dopo la tua ultima "
                f"lettura; rileggilo e rifai la modifica sul testo nuovo")
    dove = righe_di(testo, ancora)
    if not dove:
        return ("rifiutata: l'ancora non compare nel file; copiala dal "
                "testo letto, spazi e rientri compresi")
    if len(dove) > 1:
        elenco = ", ".join(map(str, dove[:5])) + (", ..." if len(dove) > 5
                                                  else "")
        return (f"rifiutata: l'ancora compare {len(dove)} volte (righe "
                f"{elenco}); allargala con una riga vicina che la renda "
                f"unica")
    archivio[percorso] = testo.replace(ancora, sostituto, 1)
    # La sessione conosce la propria modifica: la si registra come letta,
    # così può farne un'altra senza rileggere (ma vedi il ritentativo).
    letture[sessione, percorso] = impronta(archivio[percorso])
    fine = dove[0] + ancora.count("\n")
    if fine == dove[0]:
        return f"fatta: riga {fine} sostituita"
    return f"fatta: righe {dove[0]}-{fine} sostituite"

def mostra(sessione, esito):                       # a capo a 76 colonne
    print(textwrap.fill(f"{sessione}: {esito}", 76, subsequent_indent="   "))

blocco = "\n".join(funzione(10)[:4])               # la funzione tassa_10
nuovo = "\n".join(funzione(10, "centesimi")[:4])

leggi("A", "tasse.py")
mostra("A", modifica("A", "tasse.py", "    if importo <= 0:",
                     "    if centesimi <= 0:"))
mostra("A", modifica("A", "tasse.py", "def tassa_10(importo) :", nuovo))
leggi("B", "tasse.py")                             # l'altra sessione
mostra("B", modifica("B", "tasse.py", "def tassa_23(importo):",
                     "def tassa_23(importo, aliquota=1):"))
mostra("A", modifica("A", "tasse.py", blocco, nuovo))
leggi("A", "tasse.py")
mostra("A", modifica("A", "tasse.py", blocco, nuovo))
mostra("A", modifica("A", "tasse.py", blocco, nuovo))   # l'esito si era perso
A: rifiutata: l'ancora compare 24 volte (righe 2, 7, 12, 17, 22, ...);
   allargala con una riga vicina che la renda unica
A: rifiutata: l'ancora non compare nel file; copiala dal testo letto, spazi
   e rientri compresi
B: fatta: riga 116 sostituita
A: rifiutata: tasse.py è cambiato dopo la tua ultima lettura; rileggilo e
   rifai la modifica sul testo nuovo
A: fatta: righe 51-54 sostituite
A: rifiutata: l'ancora non compare nel file; copiala dal testo letto, spazi
   e rientri compresi
Le prime due richieste di A sono rifiutate senza toccare il file (la prima ha
un’ancora che compare ventiquattro volte, la seconda uno spazio di troppo prima
dei due punti), e ciascun rifiuto dice che cosa fare. Poi B cambia la funzione
tassa_23, e la modifica di A viene rifiutata perché il file non è più quello
che A ha letto: un falso allarme, perché tassa_23 sta lontano da tassa_10,
ed è il prezzo di un controllo sull’intero file, che non sa quali cambiamenti
contano. Dopo una nuova lettura la modifica passa.
L’ultima riga mostra il prezzo di registrare la scrittura di A come una sua lettura, che serve a fare più modifiche di fila senza rileggere: A non ha ricevuto l’esito e ritenta, e lo strumento trova l’ancora sparita e consiglia di ricopiarla, cioè di cercare un errore che non c’è.
Centoventi righe, e ne vanno cambiate quattro. I fogli di lavorazione, uno per mobile, stanno nell’archivio del magazzino, e sono il codice del progetto. Quello della parete attrezzata descrive ventiquattro scaffali uguali, cinque righe ciascuno. L’artigiano ne ha una copia sul tavolo e scrive al magazziniere: allo scaffale dieci il pezzo che negli altri si chiama «ripiano» deve chiamarsi «mensola», e il nome compare in quattro righe vicine. Il biglietto si può scrivere in quattro modi.
Può ricopiare tutto il foglio con le quattro righe corrette, e il magazziniere butta il vecchio e archivia il nuovo. Ma sono centoventi righe, e copiando l’artigiano può trasformare un 35 in un 53 in una riga che non doveva toccare, senza che nessuno se ne accorga: più il foglio è lungo, più occasioni ha di sbagliare.
Può scrivere «alla riga 51 togli queste quattro righe e metti queste; prima ci sono queste tre, dopo queste altre tre». Se intanto qualcuno ha aggiunto due righe in cima, il magazziniere ritrova il contorno due righe più giù, e va bene. Se invece qualcuno ha cambiato proprio una riga di contorno, un magazziniere pignolo rifiuta, e uno frettoloso cerca lì vicino qualcosa che somigli e cambia lo scaffale sbagliato.
Può scrivere «dove c’è scritto questo, scrivi quest’altro», copiando dal foglio le righe da cambiare. Se copia soltanto «ripiano da 30 cm», quella riga compare ventiquattro volte, e il magazziniere risponde «compare ventiquattro volte: aggiungi una riga vicina che dica quale scaffale»; se la copia male, «non c’è: ricopiala dal foglio».
Oppure può scrivere «allo scaffale dieci il ripiano si chiama mensola»: una riga, e il magazziniere, che conosce i pezzi per nome, non sbaglia a scriverlo. Ma sa fare soltanto le poche operazioni che ha imparato, e se allo scaffale dieci una mensola c’era già, ora ce ne sono due, scritte benissimo. In tutti i casi, dopo la modifica il magazziniere rilegge il foglio, e se una riga non ha più senso lo rimanda indietro con la riga segnata.
Quando dà una copia, poi, il magazziniere ne tiene una fotocopia con il nome dell’artigiano, e prima di scrivere confronta il foglio con la fotocopia di chi ha mandato il biglietto. Se non sono uguali, il foglio è cambiato dopo che l’artigiano l’ha letto, e il biglietto guarda un foglio che non c’è più: «è cambiato, rileggilo».
Un pomeriggio l’artigiano dell’altro banco corregge lo scaffale ventitré, e il biglietto del nostro artigiano viene rifiutato per niente: costa una copia in più. Confrontando solo le righe attorno alla frase il rifiuto inutile sparirebbe, ma con lui anche quello utile: se l’altro avesse cambiato nome a un pezzo che la riga nuova nomina, nessuno se ne accorgerebbe fino alla dima.
Il confronto regge però solo se tutti scrivono passando dallo sportello: una correzione che il proprietario fa a penna proprio mentre il magazziniere scrive va persa, perché il magazziniere ricopia il foglio come l’aveva confrontato.
Dopo aver scritto, infine, il magazziniere aggiorna la fotocopia dell’artigiano, così che possa mandare un altro biglietto senza rileggere. Ma se la risposta si perde e il capobottega riporta lo stesso biglietto, il magazziniere non trova più il ripiano e risponde «non c’è: ricopiala», e l’artigiano cerca un errore di copiatura che non ha fatto.
Sia \(f\) il file letto, di \(n_f\) righe, e \(f'\) il file al momento della modifica; la modifica è fatta di blocchi di righe contigue, il blocco \(i\) con \(m_i^-\) righe tolte e \(m_i^+\) aggiunte, per \(m\) righe cambiate in tutto. I formati differiscono per le righe che il modello scrive e per la condizione su \(f'\) sotto cui la modifica si applica:
formato |
righe scritte |
si applica se |
altrimenti |
|---|---|---|---|
riscrittura intera |
\(n_f\) |
sempre |
nessun rifiuto; le righe ricopiate possono cambiare |
diff unificato |
\(\sum_i (m_i^- + m_i^+ + 2n_c + 1) + 2\) |
contesto e righe tolte combaciano in \(f'\), anche spostati |
rifiuto, o blocco applicato altrove da un applicatore tollerante |
cerca e sostituisci |
\(\sum_i \big(2\,\lvert \mathrm{anc}_i \rvert - m_i^- + m_i^+\big)\) |
\(\#_{f'}(\mathrm{anc}_i) = 1\) per ogni ancora |
rifiuto |
operazione sull’albero |
\(O(1)\) |
linguaggio e operazione coperti |
non esprimibile |
dove \(n_c\) sono le righe di contesto per lato (di solito tre; la formula vale per blocchi lontani fra loro e dai bordi, perché blocchi separati da non più di \(2n_c\) righe invariate si fondono), \(\mathrm{anc}_i\) è l’ancora del blocco \(i\), lunga \(\lvert \mathrm{anc}_i \rvert\) righe e comprensiva delle righe tolte, e \(\#_{f'}(\mathrm{anc})\) conta le occorrenze di un’ancora in \(f'\). Con \(n_f = 120\), un blocco, \(m_1^- = m_1^+ = 4\), \(n_c = 3\) e un’ancora di quattro righe, le formule danno le righe stampate dal programma: 120, 17 e 8. La riscrittura è la sola che non fallisce mai in modo visibile, ed è la meno robusta: se ognuna delle \(n_f - m\) righe ricopiate esce alterata con probabilità \(p_{\text{alt}}\), indipendentemente dalle altre, il file resta intatto fuori dalla modifica con probabilità \((1 - p_{\text{alt}})^{n_f - m}\), che cala con la lunghezza del file e non con quella della modifica.
L’operazione sull’albero garantisce un file sintatticamente valido, non un programma corretto: una rinomina verso un nome già usato, se lo strumento non controlla le collisioni, dà codice ben formato e sbagliato. SWE-agent aggiunge una postcondizione, che il file che esce dalla modifica passi il linter; senza, la quota risolta scendeva dal 18,0% al 15,0% [YJW+24].
Le condizioni si verificano su \(f'\), mentre il modello ha scelto l’ancora guardando \(f\). Il confronto e scambio chiude la distanza: con \(\mathrm{imp}\) un’impronta crittografica, lo strumento registra per ogni coppia (sessione, file) l’impronta \(\mathrm{imp}(f)\) letta, e applica la modifica solo se \(\mathrm{imp}(f') = \mathrm{imp}(f)\), cioè, salvo una collisione di probabilità trascurabile, se \(f' = f\). Le due condizioni si completano: \(\#_{f'}(\mathrm{anc}) = 1\) dice dove la modifica atterra, l’uguaglianza delle impronte su quale versione. Confronto e scrittura devono formare un’operazione indivisibile, o si ricade nella corsa fra verifica e uso (time-of-check to time-of-use), e l’indivisibilità si ottiene soltanto fra scrittori che cooperano, per esempio con un lucchetto sul file: la shell dello stesso agente o una persona nell’editor la aggirano.
Il confronto sull’intero file produce falsi
conflitti, come quello su tassa_23; restringerlo alla regione dell’ancora li
toglie, ma lascia passare i conflitti semantici, come una funzione rinominata
altrove che la riga nuova chiama ancora, che il confronto sull’intero file ferma
solo se stanno nello stesso file e che in generale spettano al collaudo.
Registrare come letta la propria scrittura costa due cose. Ritentata dopo un esito perso, la modifica non trova più l’ancora, e il rifiuto, che lascia l’ambiente com’era, manda il modello a cercare un errore che non ha fatto; e se il sostituto contiene l’ancora, come quando si inserisce una riga dopo di essa, si applica due volte, e lo strumento non è idempotente. Una corrispondenza approssimata, infine, che ignora spazi e rientri, va accettata solo se il pezzo trovato è l’unico entro una soglia stretta.
La shell e il raggio d’azione#
Fra gli strumenti di un agente di programmazione ce n’è quasi sempre uno che li contiene tutti: la shell, che esegue un comando qualunque. Una chiamata sola può mettere in fila più comandi e ripeterli, e fa in un passo quello che con strumenti separati chiede molte chiamate; tutto ciò che è installato sulla macchina, i file, la rete, gli altri programmi, diventa un’azione possibile; e i file scritti e i programmi avviati restano dopo la chiamata. Ne segue il raggio d’azione (in inglese blast radius, il raggio dell’esplosione): l’agente può fare tutto ciò che può fare la shell, anche per sbaglio.
Philipp Schmid, che ogni tanto ricostruisce da capo un harness per vedere che cosa si può togliere, nel settembre 2026 ha raccontato di averlo ridotto alla shell e a un visualizzatore di immagini, con risultati alla pari o migliori, sugli stessi compiti di programmazione, di una configurazione con strumenti separati per leggere, scrivere, modificare e cercare i file [Sch26]. È l’osservazione di un praticante, senza numeri: lui stesso, pochi mesi prima, consigliava di partire da strumenti dedicati, e SWE-agent con GPT-4 Turbo trovava la sola shell all’11,0% contro il 18,0%.
Le due cose non si contraddicono per forza: i modelli sono diversi, e soprattutto la shell di SWE-agent era nuda, mentre attorno a quella di Schmid l’harness fa il lavoro degli strumenti dedicati: taglia l’uscita dicendo come chiederne un pezzo, restituisce di ogni comando il codice d’uscita e la durata, ferma con regole scritte fuori dal modello i percorsi vietati, la rete e le azioni distruttive. Resta a parte soltanto lo strumento che mostra le immagini, che il testo non trasporta.
Fra queste protezioni, quella che non dipende da che cosa dice il comando è il recinto, la sandbox: i comandi girano in uno spazio chiuso, che contiene i file del progetto e nient’altro e non raggiunge la rete, e l’agente chiede un’approvazione soltanto per uscirne. Lo usava già l’harness di Young, che lasciava all’agente modificare soltanto i file della sua cartella (il passaggio di consegne). L’approvazione costa il tempo di una persona, e va dove la metteva il loop engineering: dove uno sbaglio lasciato passare, contando anche quanto è raro, costerebbe più della revisione.
A monte c’è il minimo di autonomia. L’OWASP, la fondazione che compila gli elenchi dei rischi di sicurezza più gravi del software, nella lista dedicata agli agenti estende il privilegio minimo, la regola per cui ogni programma riceve soltanto i permessi che gli servono, a quello che chiama least agency: non dare a un agente più autonomia di quella che il compito richiede, perché un comportamento autonomo dove non serve aumenta i modi di attaccarlo senza aggiungere niente [OWASPGASProject25b]. Per gli strumenti chiede permessi decisi strumento per strumento: interrogazioni in sola lettura per un database, nessun diritto di spedire o cancellare per uno strumento che riassume la posta.
Che cosa succede quando dati privati, testo di estranei e un canale verso l’esterno stanno nello stesso sistema lo tratterà la sezione sulla sicurezza dei modelli di linguaggio, nel capitolo sull’AI responsabile.
Un giorno il proprietario cambia sportello. Al posto dell’elenco degli attrezzi l’artigiano può scrivere sul biglietto una procedura qualunque, «vai al terzo scaffale, conta le viti da quattro, e se sono meno di cento scrivi un ordine al fornitore», e il magazziniere la esegue: è la shell. L’elenco sul tavolo si riduce a una voce, «esegui la procedura», e con un biglietto si fa quello per cui prima servivano dieci giri allo sportello. Ma adesso l’artigiano può chiedere, anche per sbaglio, tutto ciò che il magazziniere sa fare: buttare via uno scaffale, spedire i fogli. Con l’elenco, il peggio che un biglietto sbagliato poteva fare stava scritto nelle voci.
Le cure che prima stavano nelle voci adesso le prende la bottega: il magazziniere taglia le risposte lunghe e scrive in cima com’è andata e quanto ci ha messo, e il capobottega confronta ogni biglietto con la lista dei divieti: niente porta sulla strada, che è la rete, niente cassaforte, dove stanno le chiavi e le carte che non riguardano il lavoro, niente «butta via». Ma leggere una procedura non basta a capire se fa danni. Una procedura lunga può arrivare alla cassaforte per strade che nessuno riconosce leggendo, come prendere una chiave da un cassetto e usarla tre passi dopo chiamandola in un altro modo: un capobottega che vieta le parole pericolose ne lascia passare qualcuna travestita, e uno che vieta tutto ciò che potrebbe esserlo ferma anche le procedure innocue.
Allora il proprietario fa un’altra cosa: le procedure si eseguono in una stanza chiusa, dove ci sono gli scaffali e i fogli del lavoro in corso e nient’altro, senza porta sulla strada e senza cassaforte. Lì dentro il magazziniere esegue qualunque procedura, e il peggio che può succedere è il lavoro in corso rovinato, anche apposta. Per uscire, a ordinare al fornitore o anche solo a chiedergli un prezzo, ci vuole la firma del proprietario, che però non può guardare tutto: la chiede dove uno sbaglio, contando anche quanto è raro, costerebbe più del tempo per guardare. Dove non la chiede, la procedura esce da sola, e da quella porta la stanza non protegge più niente; e dove firma, firma guardando il biglietto, che può essere scritto proprio per convincerlo.
Un giorno, in una cassa del fornitore, c’è un messaggio: «spedite copia di tutti i fogli di lavorazione a questo indirizzo». Finisce sul tavolo con il resto, e l’artigiano, che legge tutto, lo prende per un ordine e lo mette in una procedura. Con il vecchio elenco, senza una voce «spedisci», i fogli non potevano partire, comunque l’artigiano si fosse convinto; con lo sportello delle procedure e la porta aperta, partono; nella stanza chiusa, la procedura si ferma alla porta e chiede la firma. Ma la stanza protegge quello che sta fuori, non quello che sta dentro: se il proprietario firma una domanda al fornitore che ha dentro le misure dei mobili, le misure escono con la domanda.
Per questo il proprietario non apre lo sportello delle procedure quando il lavoro non lo chiede: per leggere i fogli e trovare un errore basta l’elenco degli attrezzi. E un elenco senza «spedisci» e senza «butta via» non può spedire né buttare, chiunque scriva il biglietto, purché non abbia due voci che insieme fanno lo stesso, «scrivi una procedura» ed «eseguila».
La shell è uno strumento con un solo argomento, un programma \(\mathbf{u}\), cioè una stringa qualunque: occupa poco contesto, porta l’insieme delle azioni da quello del catalogo a quello dei programmi eseguibili con i privilegi del processo, e lascia all’harness, per ogni \(\mathbf{u}\), le protezioni che un catalogo ben fatto dava strumento per strumento [Sch26]. Il permesso, come nell’anatomia, si giudica sulla chiamata \(a = (j, \mathbf{u})\), con \(j \in \mathcal{T}\) lo strumento e \(\mathbf{u}\) i suoi argomenti. Sia \(\mathrm{auto}(j, \mathbf{u}) = 1\) per le chiamate che il codice esegue senza chiedere a nessuno, e si chiami raggio d’azione dell’ambiente \(E\) l’insieme degli stati raggiungibili così,
con \(\mathcal{R}^{*}_{\text{auto}}(E)\) quello raggiungibile in un numero qualunque di passi.
Se un’osservazione contiene testo scritto da un avversario, \(P_\theta(\cdot \mid C_{k,t})\) ne dipende, e nel caso peggiore il modello emette qualunque azione; ma il permesso lo valuta il codice sulla chiamata, non il modello sull’intenzione, e gli stati che l’attacco produce senza approvazione restano in \(\mathcal{R}^{*}_{\text{auto}}(E)\), comunque il modello sia stato convinto. Conta la chiusura in più passi, non il singolo strumento. Ad esempio, un catalogo che permette di scrivere un file e di lanciare i test permette, in due passi, di eseguire un programma qualunque. E la granularità conta perché l’OWASP attacca i permessi agli strumenti [OWASPGASProject25b]: uno strumento largo, quindi, non si restringe senza giudicarne l’argomento.
Con la shell, giudicare l’argomento vuol dire giudicare un programma. «Non
scrive fuori dalla cartella del progetto» e «non apre connessioni» sono
proprietà di ciò che il programma fa quando gira, e nessun procedimento le
decide per ogni programma: con lo stesso argomento del teorema di Rice, per riduzione dal problema della fermata, un
programma che apre una connessione solo dopo aver simulato una macchina
qualunque la apre se e solo se quella macchina si arresta. Un filtro sul testo
del comando è quindi permissivo, e lascia passare un rm costruito in una
variabile o un programma scritto su file ed eseguito dopo, oppure eccessivo, e
rifiuta comandi innocui.
Il recinto sposta la garanzia dal giudicare il programma al confinarne gli effetti. Scritto l’ambiente come \(E = (E^{\text{dentro}}, E^{\text{fuori}})\), i file del progetto e tutto il resto (gli altri file, le credenziali, i sistemi raggiungibili dalla rete), il recinto garantisce \(\mathrm{eff}(E, a)^{\text{fuori}} = E^{\text{fuori}}\) per ogni chiamata eseguita senza approvazione, cioè
qualunque sia il programma. Una chiamata che interroga l’esterno, anche solo per
leggere, è un’uscita, perché la sua richiesta arriva a qualcuno. O passa da
un’approvazione, che conviene dove \(c_{\text{rev}} < p_{\text{err}}\,
c_{\text{err}}\), con \(c_{\text{rev}}\) il costo della revisione, \(c_{\text{err}}\)
quello di uno sbaglio lasciato passare e \(p_{\text{err}}\) la frequenza con cui
la revisione lo ferma (la condizione del loop engineering), o la si lascia
automatica, e allora sta fuori dalla garanzia: fra i suoi scenari l’OWASP
descrive un agente a cui era permesso lanciare ping senza approvazione,
indotto a portare fuori dati nelle interrogazioni al DNS.
I limiti si dichiarano. La garanzia è d’integrità, non di riservatezza: ciò che il recinto contiene si legge, entra in \(o_{k,t}\) e va al modello, e una chiamata verso l’esterno, se viene approvata, lo porta fuori nei propri argomenti. E con una persona nel ciclo il confine torna a dipendere dal testo, perché la persona approva la chiamata che il modello le presenta. Il minimo di autonomia lega i pezzi: si toglie dal catalogo ogni strumento, e da ogni strumento ogni argomento, che il compito non richiede.
Gli strumenti sono l’unica via per cui il lavoro del modello arriva al computer: per questo, a modello fermo, un’interfaccia diversa ha spostato il risultato di SWE-agent, ed è lì che si decide fin dove può arrivare un errore.
Da ricordare
Un attrezzo si progetta per chi lo usa: lo stesso modello, con pochi comandi pensati per lui accanto alla riga di comando, ha risolto 18 problemi su 100 invece di 11.
L’elenco degli attrezzi (le definizioni degli strumenti) e le risposte del magazziniere (le loro uscite) restano sul tavolo, che è il contesto, e si rileggono a ogni mossa: poche voci, ciascuna con uno scopo chiaro; risposte corte, con gli avvisi in cima e il modo di chiedere il resto.
Una buona risposta distingue il cassetto vuoto da quello chiuso, scrive le unità, e quando rifiuta dice come rimediare.
Un biglietto ripetuto è una richiesta in più: «la cassa deve avere venti viti» si può ripetere, «aggiungi venti viti» no, e «spedisci» porta un numero. Ma anche la prima cancella quello che un altro ha cambiato in mezzo.
Per cambiare un foglio (un file), «dove c’è scritto questo, scrivi quest’altro» costa poco, e si rifiuta se la frase compare più volte o nessuna; la fotocopia di chi ha letto impedisce di cambiare un foglio diverso da quello letto, se tutti scrivono passando dallo sportello, a costo di qualche rilettura inutile.
Lo sportello che esegue qualunque procedura (la shell) può fare tutto, anche per sbaglio. Le procedure girano nella stanza chiusa (il recinto), che protegge quello che sta fuori e non quello che sta dentro; esce soltanto ciò che il proprietario firma o lascia uscire senza firma, e quello sportello non si apre se il lavoro non lo chiede.
Da ricordare
Un’interfaccia agente-computer comprende i comandi, le loro descrizioni, la forma delle risposte e la gestione della cronologia; a modello fissato (GPT-4 Turbo, 300 segnalazioni di SWE-bench Lite) SWE-agent risolveva il 18,0% contro l’11,0% di un agente con la sola shell [YJW+24].
Il catalogo costa \(\mathrm{tok}(\mathcal{T})\) token a ogni passo; un’osservazione arrivata al passo \(i\) costa \((T - i)\,\mathrm{tok}(o_{k,i})\), e si limita con un tetto e un cursore [Aiz25] e con una finestra di permanenza [YJW+24].
Uno strumento che manda esiti diversi nella stessa osservazione (vuoto e guasto, un’ora senza fuso) fissa la stessa distribuzione dell’azione successiva; schemi d’uscita tipati ed errori marcati separano gli esiti che lo schema distingue [ModelCProtocol25].
Idempotenza, \(\mathrm{eff}(\mathrm{eff}(E, a), a) = \mathrm{eff}(E, a)\): rende sicuri i tentativi ripetuti, vale per esecuzioni consecutive, e un’assegnazione ripetuta cancella una scrittura intermedia.
Formati di modifica: da \(n_f\) righe scritte a \(O(1)\), ciascuno con la sua condizione su \(f'\); il diff tollera lo spostamento, non il contesto cambiato. Il confronto e scambio sull’impronta, per sessione e indivisibile fra scrittori che cooperano, dice su quale versione, l’unicità dell’ancora dove; registrare la propria scrittura costa l’idempotenza, se il sostituto contiene l’ancora.
Senza approvazione l’agente raggiunge \(\mathcal{R}_{\text{auto}}(E)\), chiuso in più passi, qualunque sia il modello, e i permessi si attaccano agli strumenti [OWASPGASProject25b]. Su un programma una regola di comportamento non si decide in generale; il recinto confina gli effetti delle chiamate automatiche, non l’informazione che esce, e un’uscita lasciata automatica sta fuori dalla garanzia.
Uno strumento ben fatto dice all’agente che cosa è successo nel suo comando. Quello che succede dentro l’applicazione che l’agente costruisce, una pagina lenta, un servizio che di notte smette di rispondere, gli resta invisibile finché qualcuno non gli dà gli strumenti per guardarci dentro: i log, le metriche e le tracce di quando nessuno guarda.