


Le architetture lineari: RetNet, RWKV, xLSTM#
La somiglianza che si scompone, il gate e la delta rule sono meccanismi. RetNet, RWKV e xLSTM, apparse fra il 2023 e il 2025, li montano in architetture complete, addestrate come modelli linguistici per fare concorrenza al Transformer sul suo terreno, la previsione della parola successiva su testi lunghi. Si guardano insieme perché illustrano tre scelte diverse sullo stesso schema: in RetNet, nata fra un laboratorio industriale e un’università, un decadimento fisso e una forma a blocchi per i contesti lunghi; in RWKV, cresciuta come progetto aperto di comunità, uno stato che diventa una matrice e poi la delta rule; in xLSTM, la riedizione della LSTM fatta da uno dei suoi inventori, il gating esponenziale e una cella a memoria matriciale che si addestra in parallelo.
Sotto la carrozzeria, però, il motore è quasi sempre lo stesso, quello di scrivere meglio nella memoria: una memoria di taglia fissa, aggiornata una volta per token, che si riempie in parallelo mentre il modello impara, sfruttando tutte le unità di calcolo della scheda grafica come fa un Transformer, e si rilegge un token alla volta mentre il modello scrive, a costo sempre uguale, come faceva una vecchia rete ricorrente. A cambiare, da un’architettura all’altra, è soprattutto la transizione di stato (il fattore che decide come la memoria di ieri sopravvive a oggi), insieme all’ingegneria che la rende addestrabile su larga scala. Fa eccezione la cella sLSTM di xLSTM, la cui ricorrenza non è lineare.
RetNet: la retention e le sue tre forme#
La prima architettura arriva da Microsoft Research e Tsinghua nel luglio 2023, con Sun e colleghi [SDH+23]. Il nome del meccanismo è retention, «ritenzione», e da lì viene il nome della rete; il suo gesto è tra i più semplici possibili: al posto della softmax si mette un decadimento esponenziale fisso, un fattore \(\gamma\) fra zero e uno che a ogni token di distanza moltiplica ancora una volta il peso del passato. Nella forma parallela, quella con cui si addestra, le coppie di token continuano a confrontarsi come nell’attenzione, con il punteggio \(\mathbf{q}_i^\top\mathbf{k}_j\), ma il punteggio non passa per la softmax: è moltiplicato per \(\gamma^{\,i-j}\), che dipende dalla distanza e mai dal contenuto, e sbiadisce allo stesso modo una data e un intercalare.
Il punto interessante di RetNet non è tanto il meccanismo quanto il fatto che lo stesso calcolo ammette tre forme equivalenti: tre modi di ottenere esattamente lo stesso risultato, ciascuno conveniente in una situazione diversa (Fig. 17.5).
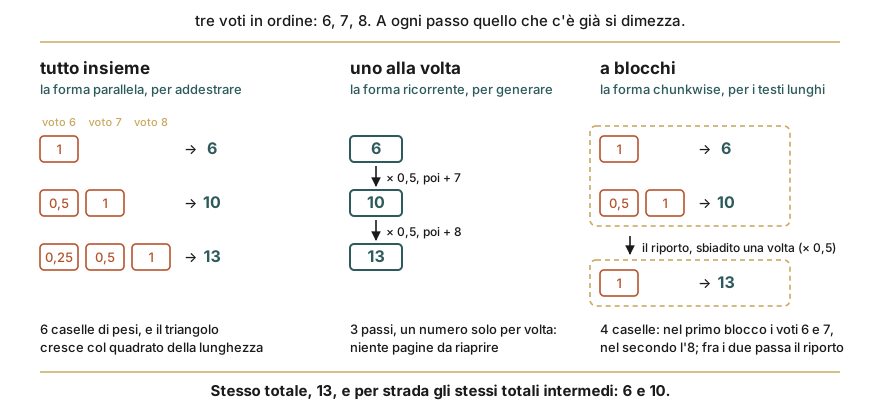
Fig. 17.5 Le tre forme della retention sugli stessi tre voti, con quello che c’è già che si dimezza a ogni passo. Tutte e tre arrivano a 13, e per strada danno gli stessi totali intermedi, 6 e 10: a cambiare è la forma del lavoro. A sinistra il triangolo ha una casella per ogni coppia di momenti, quindi cresce con il quadrato della lunghezza; al centro resta un numero solo per volta; a destra il triangolo torna, ma soltanto dentro un blocco, e da un blocco all’altro passa il riporto.#
Un professore tira le somme a giugno, e le interrogazioni di maggio pesano più di quelle di ottobre. Ogni interrogazione porta due cose, il voto e la materia; se oggi si parla di storia, l’interrogazione di storia conta più di quella di ginnastica, e su questo RetNet non cambia niente. Cambia il peso della distanza, che guarda quanto tempo è passato e basta.
I conti si possono chiudere in tre modi, e il totale è sempre lo stesso. Un totale solo, però, al professore non basta: ne vuole uno dopo ogni interrogazione, com’era messo lo studente a ottobre, a novembre, a dicembre.
Tutto insieme, il professore apre le pagine dell’anno sul tavolo e riempie una tabella con una riga per ogni momento dell’anno e una colonna per ogni voto, scrivendo in ogni casella il peso che quel voto ha in quel momento. Con un foglio di calcolo che macina moltiplicazioni in parallelo è la strada più rapida finché le pagine ci stanno sul tavolo, ed è quella con cui si addestra. Il prezzo è la tabella: raddoppiando la lunghezza dell’anno le sue caselle quadruplicano, ed è di nuovo la tabella grande da cui l’attenzione lineare era scappata.
Uno alla volta, tiene un numero solo a matita in fondo alla pagina. Finita un’interrogazione, sbiadisce un po’ il numero vecchio e ci somma il voto nuovo. Non riapre nessuna pagina, e ogni interrogazione gli costa gli stessi due gesti, che sia la prima o la centesima. È la strada dei voti in diretta, uno oggi e uno domani, cioè del modello che scrive una parola per volta.
A blocchi, chiude un mese per volta sul tavolo e passa il totale al mese dopo sbiadendolo, come il numero a matita. Serve perché su un anno intero le altre due hanno ciascuna il suo prezzo: la prima paga la tabella, e la seconda va per forza in fila, perché nessuna interrogazione si chiude prima di quella di ieri e mille aiutanti resterebbero a guardare. Dentro un mese si lavora con le pagine aperte, quindi i totali intermedi si prendono lì e la tabella del mese resta piccola, perché il mese è corto; da un mese all’altro passa un numero solo. Si tiene la fretta senza pagare la tabella, ed è così che reggono i testi lunghissimi.
Che il totale non cambi si controlla con tre numeri. Tre voti in ordine, \(6\), \(7\) e \(8\), e a ogni passo quello che c’è già si dimezza.
Tutto insieme: una riga di tabella per ogni momento. L’ultima dà \(0{,}25\times 6 + 0{,}5\times 7 + 8 = 13\), e le due sopra danno i totali di ottobre e novembre, \(6\) e \(0{,}5\times 6 + 7 = 10\).
Uno alla volta: parto da \(6\); arriva il \(7\) e faccio \(0{,}5\times 6 + 7 = 10\); arriva l’\(8\) e faccio \(0{,}5\times 10 + 8 = 13\). Gli stessi tre totali, ma tenendo in mano un numero solo per volta.
A blocchi, con blocchi da due: dentro il primo blocco lavoro con le pagine aperte, quindi i due totali escono in un colpo solo e senza che il secondo debba aspettare il primo, \(6\) e \(7 + 0{,}5\times 6 = 10\); poi il blocco successivo riparte da quel \(10\) e ci attacca il terzo, \(0{,}5\times 10 + 8 = 13\).
Tredici tutte e tre le volte.
E di numeri a matita il professore ne tiene parecchi affiancati, ognuno con un ritmo di sbiadimento suo. In uno il passato si dimezza a ogni interrogazione, e contano quasi soltanto le ultime due; in un altro sbiadisce così piano che settembre pesa ancora a giugno. Messi in fila dicono come sta lo studente adesso e come è andato l’anno, e il modello li legge tutti insieme.
Lo stato \(\mathbf{S}_t \in \mathbb{R}^{d\times d}\) è una memoria «chiave \(\to\) valore», \(\mathbf{q}_t, \mathbf{k}_t, \mathbf{v}_t\) sono query, chiave e valore del token \(t\). Le tre forme della retention sono:
Parallela (addestramento). Come nell’attenzione, ma senza softmax:
dove \(\mathbf{Q}, \mathbf{K}, \mathbf{V}\) sono le matrici di query, chiavi e valori, \(\odot\) è il prodotto elemento per elemento e \(\mathbf{D}\) è una maschera causale con decadimento: sostituisce la softmax con un peso \(\gamma^{\,i-j}\) per ogni coppia di posizioni \((i,j)\), che dipende solo dalla distanza \(i-j\) e svanisce in modo esponenziale (\(0 < \gamma < 1\)). I pesi non sommano a uno: le sole normalizzazioni sono quelle descritte sotto, la normalizzazione di gruppo e le tre riscalature. Costa \(O(n^2 d)\) come l’attenzione, ma tutte le posizioni si calcolano insieme.
Questa è la forma essenziale. Il paper vi affianca due cose che non cambiano il discorso ma è onesto nominare: una rotazione di fase (xPos) che convive con il decadimento e fa da codifica posizionale relativa (il decadimento completo è allora un numero complesso: il modulo \(\gamma\) dimentica, la fase \(\theta\) codifica la posizione), e tre riscalature dei punteggi che servono a tenere i conti in un intervallo numerico sicuro. Non modificano l’uscita perché ogni testa passa poi per una normalizzazione di gruppo, che è cieca a un fattore comune: gli autori dichiarano che il risultato non cambia, e l’equivalenza fra le tre forme è esatta anche senza.
Ricorrente (inferenza, costo costante nella lunghezza: \(O(d^2)\) per token, come per l’attenzione lineare). La stessa funzione, srotolata come una RNN a stato matriciale:
dove \(\gamma\) è il fattore di decadimento e \(\mathbf{v}_t \mathbf{k}_t^\top\) è la nuova coppia scritta in memoria. Ogni token costa un aggiornamento a memoria fissa: niente cache che cresce.
Chunkwise (contesto lungo). Si spezza la sequenza in blocchi di \(B\) token; per il blocco \(c\), con \(\mathbf{Q}_c, \mathbf{K}_c, \mathbf{V}_c \in \mathbb{R}^{B\times d}\) le sue righe e \(\mathbf{S}_{c-1}\) lo stato alla fine del blocco precedente,
dove \(\mathbf{D}\) è la maschera con decadimento della forma parallela ristretta al blocco (\(B \times B\)), \(\boldsymbol{\Xi} = \operatorname{Diag}(\gamma^{1}, \dots, \gamma^{B})\) sbiadisce lo stato ereditato secondo la posizione nel blocco e \(\mathbf{Z} = \operatorname{Diag}(\gamma^{B-1}, \dots, \gamma^{0})\) sbiadisce ogni scrittura secondo quanto manca alla fine del blocco. Il primo addendo è la forma parallela dentro il blocco, il secondo la lettura dello stato ereditato, la seconda equazione la ricorrenza fra blocchi. Un blocco costa \(O(B^2 d)\) per la parte parallela e \(O(B d^2)\) per lettura e aggiornamento dello stato, in tutto \(O(nBd + nd^2)\): lineare in \(n\), con ogni conto scritto come prodotto di matrici. \(B = 1\) ridà la ricorrenza pura, \(B = n\) la forma parallela.
Un dettaglio dà a RetNet la sua firma: la retention è multi-scala. Ogni testa usa un \(\gamma\) diverso (chi vicino a \(1\) ricorda a lungo, chi più piccolo dimentica in fretta), così che l’insieme delle teste copra orizzonti temporali di durata diversa, dal contesto immediato a quello lontano.
RetNet è il primo dei tre gradini dello sbiadimento descritti in scrivere meglio nella memoria: il ritmo con cui la memoria decade è deciso in fase di progetto, uguale per ogni token e per ogni componente dello stato. È la forma più grossolana di oblio: efficace e a costo nullo, ma cieca al contenuto. Gli altri due gradini quella cecità la tolgono: Mamba-2, che il ritmo lo ricalcola a ogni token guardando che cosa sta leggendo, e GLA (gated linear attention), che oltre a ricalcolarlo lo differenzia canale per canale. Sono i tre modi di decidere quanto dimenticare, dal più rigido al più libero.
RWKV: reinventare le RNN#
La seconda architettura non esce da un laboratorio ma da una comunità. RWKV è un progetto aperto guidato da Bo Peng, sviluppato in pubblico da una comunità di ricercatori indipendenti. Il suo obiettivo dichiarato è nel titolo del primo articolo: «Reinventing RNNs for the Transformer Era», reinventare le reti ricorrenti per l’epoca dei Transformer [PAA+23].
Un blocco RWKV alterna, come un Transformer, due sottostrati. Il time-mixing, «mescolamento nel tempo», mescola l’informazione fra i token con una memoria che si aggiorna token per token, e fa il mestiere che nel Transformer fa l’attenzione. Il channel-mixing opera su ogni token per conto suo, rimescolandone i canali (le posizioni della fila di numeri che lo rappresenta), e fa il mestiere della rete feed-forward. Entrambi cominciano con un token-shift: l’ingresso è una miscela, canale per canale e con pesi appresi, fra il token corrente e il precedente, \(\mathbf{x}'_t = \boldsymbol{\mu}\odot\mathbf{x}_t + (1-\boldsymbol{\mu})\odot\mathbf{x}_{t-1}\). Costa pochissimo, qualche vettore di pesi, e dà alla rete un accesso diretto al passo appena trascorso.
Perché servano tutti e due si vede togliendoli. Senza il mescolamento fra le parole la frase resterebbe un elenco di parole che non si parlano; senza quello che rimescola i numeri di una parola sola il modello saprebbe chi parla con chi ma capirebbe poco di ciascuno. Si alternano per tutta l’altezza della rete, ed è la stessa divisione del lavoro dei Transformer. Dei due, quello che ci riguarda è il mescolamento fra le parole, perché è lì che sta la memoria di taglia fissa.
Il nome, poi, è la lista dei quattro ingredienti del mescolamento fra le parole: Receptance, Weight, Key, Value. Le ultime tre le conosciamo (il peso che sbiadisce, l’etichetta, l’informazione); la receptance è un rubinetto d’uscita, che decide quanta parte di ciò che la memoria risponde viene effettivamente lasciata passare al resto della rete.
Il peso che sbiadisce si vede all’opera tornando ai voti dello studente. Il peso di un voto ha due fattori. Il primo è la distanza: il voto di ieri conta pieno, quello di prima ancora la metà. Il secondo è l’importanza, che il voto si porta dietro dal giorno in cui è stato preso e che non cambia più: un compito in classe conta più di un’interrogazione di recupero. Rispetto al professore di RetNet manca una cosa, la domanda di oggi: là ogni voto si rileggeva alla luce della materia di cui si parla adesso, qui nessuna materia del giorno decide quale voto conti di più. E ce ne sono due in più. RWKV divide la somma per il totale dei pesi, così che quello che esce sia una media, cioè ancora un voto e non un mucchio che cresce con gli anni. E al voto di oggi non applica lo sbiadimento, che infatti parte da ieri: gli dà un peso deciso a parte, mettiamo il doppio di quello che tocca a ieri, così che il presente non finisca trattato come una cosa vecchia. Con i voti \(6\), \(7\) e \(8\), tutti della stessa importanza, i pesi diventano allora \(0{,}5\), \(1\) e \(2\): la somma pesata fa \(0{,}5\times 6 + 1\times 7 + 2\times 8 = 26\), i pesi messi insieme fanno \(3{,}5\), e il risultato è \(26\) diviso \(3{,}5\), cioè circa \(7{,}43\). Un voto, appunto: senza quella divisione resterebbe \(26\), che non vuol dire niente.
Un’ultima cosa, perché il seguito ci conta sopra: RWKV è una famiglia che ha cambiato pelle più volte, e le versioni si chiamano col loro numero. Quelle che ci riguardano sono quattro. RWKV-4 (2023), la prima descritta in un articolo, non tiene ancora un foglio a righe e colonne, ma una fila di numeri che sbiadiscono con ritmi decisi una volta per tutte. RWKV-5 (2024) sostituisce quella fila con il foglio che conosciamo. RWKV-6 quei ritmi li ricalcola a ogni parola, zona per zona, come GLA. RWKV-7 (2025), prima di scrivere, corregge quello che c’è già, come faceva la rubrica di Mario, e in più ha una libertà che lì non c’era: la correzione può andare oltre la misura, e allora la voce vecchia non si limita a sparire ma si ribalta dall’altra parte, come il \(7\) che con l’etichetta calcata col pennarello diventava \(13\). Là era un guaio; qui, dosato, è un attrezzo, perché con quel ribaltamento la memoria riesce a tenere il conto di una situazione che cambia di continuo, come chi ha la palla dopo venti passaggi, dove ogni passaggio non aggiunge un’informazione ma sostituisce quella di prima. Nei modelli che gli autori hanno rilasciato il ribaltamento è permesso solo in parte, per tenere stabile l’addestramento, e le garanzie dimostrate valgono per la versione che lo permette per intero.
Nella versione del primo articolo, la RWKV-4, il cuore del time-mixing è l’operatore WKV, una forma di attenzione lineare con decadimento. Per un singolo canale:
dove \(k_i\) e \(v_i\) sono chiave e valore alla posizione \(i\), \(w \ge 0\) è il decadimento del canale (il peso di un token svanisce come \(e^{-(t-1-i)w}\) al crescere della distanza, e il caso limite \(w = 0\) è il canale che non dimentica) e \(u\) è un bonus riservato al token corrente, che lo esenta dal decadimento così che il presente non venga penalizzato quanto il passato. Numeratore e denominatore sono la classica media pesata: il denominatore è il normalizzatore, la somma dei pesi. Tenerne uno avvicina RWKV-4 a Katharopoulos e lo separa dalla famiglia senza normalizzatore di GLA e DeltaNet; ma quello di Katharopoulos dipende dalla query, e questo no. In RWKV-4 il decadimento \(w\) è appreso ma fisso (uno per canale, non dipende dall’input): la transizione di stato è dunque un decadimento diagonale data-indipendente.
Un dettaglio che conta: in RWKV-4 lo stato è un vettore per canale e la scrittura è elemento per elemento, non un prodotto esterno. Nella formula non compare nessuna query, e infatti non c’è: la receptance \(r\) è un gate d’uscita, non un termine di affinità. Il prodotto esterno arriva con la v5.
L’architettura è poi evoluta in due tappe. RWKV-5/6, nome in codice Eagle e Finch [PGA+24], promuove lo stato da vettore a matrice, una per testa, come \(\mathbf{S}_t\) nelle formule di RetNet, e rende il decadimento data-dipendente: in Finch, cioè RWKV-6, il fattore di oblio è generato dall’input, cioè la stessa scelta della GLA, alla quale gli autori dichiarano di essere arrivati per conto proprio e nello stesso periodo. RWKV-7, nome in codice Goose [P+25], compie il salto più netto: adotta una delta rule generalizzata, con l’evoluzione di stato (trasposta nella convenzione \(\mathbf{S} = \sum_i \mathbf{v}_i\mathbf{k}_i^\top\))
dove \(\mathbf{w}_t\) è un decadimento vettoriale, un valore per canale (l’erede del gate diagonale di Finch): qui moltiplica lo stato, quindi si legge al rovescio del \(w\) della v4, e vicino a \(1\) conserva mentre vicino a \(0\) dimentica. Poi \(\hat{\boldsymbol{\kappa}}_t\) è una chiave di rimozione normalizzata e disaccoppiata dalla chiave di scrittura \(\tilde{\mathbf{k}}_t\), e \(\mathbf{a}_t\) è un tasso di apprendimento appreso in contesto, anch’esso canale per canale. La transizione di stato è dunque un decadimento diagonale più una correzione di rango uno, e quella riga la tabella unificante non ce l’ha: il Gated DeltaNet della tabella sbiadisce con uno scalare, mentre qui il fattore è un vettore, un valore per canale. RWKV-7 tiene cioè il gating per canale della GLA e ci aggiunge la correzione, invece di scambiare l’uno con l’altra, ed è la differenza che gli autori sottolineano contro i lavori precedenti.
La capacità nuova, però, non viene dal gate per canale, e nemmeno dalla sola correzione di rango uno, che DeltaNet ha già: viene dal segno degli autovalori. In DeltaNet, con chiavi di norma unitaria, \(\mathbf{I} - \beta_t \mathbf{k}_t\mathbf{k}_t^\top\) è una Householder generalizzata con \(\beta_t \in (0,1)\): un autovalore vale \(1-\beta_t \in (0,1)\), gli altri \(1\), e uno negativo non compare mai (la riflessione vera, con autovalore \(-1\), si avrebbe solo a \(\beta_t = 2\)). Grazzi e colleghi dimostrano che una ricorrenza lineare a precisione finita, le cui transizioni hanno solo autovalori positivi, non risolve nemmeno la parità, e che con autovalori in \([-1,1]\) la risolve [GSZ+25]. In RWKV-7 la transizione è
con \(c = 1\) nei modelli rilasciati: ha tutti gli autovalori in \((-1,1)\) e al più uno negativo. Quei modelli, però, limitano il decadimento a \(\mathbf{w}_t \in (e^{-e^{-1/2}}, 1) \approx (0{,}545;\, 1)\) per la stabilità dell’addestramento, e con quel limite l’autovalore negativo non scende sotto \(e^{-e^{-1/2}} - 1 \approx -0{,}455\). È il segno meno a permettere allo stato di tenere il conto invece di limitarsi a sbiadire.
È questo che dà a RWKV-7 una capacità di state tracking, cioè di seguire lo stato di un automa a stati finiti mentre legge i simboli (la parità di una sequenza di bit, o la composizione di permutazioni), che le versioni precedenti non avevano. Gli autori dimostrano che un solo strato basta per un problema \(\mathsf{NC}^1\)-completo, tenere il conto degli scambi fra cinque elementi, e quattro strati bastano a riconoscere qualunque linguaggio regolare, cioè qualunque insieme di stringhe che un automa a stati finiti sa riconoscere (sono i linguaggi delle espressioni regolari), pur mantenendo l’addestramento parallelo [P+25]. Le loro costruzioni, però, usano \(c = 2\) e \(\mathbf{w}_t = \mathbf{1}\), dove lo scambio di due componenti dello stato ha autovalore \(-1\), e si estendono a \(c = 1\) dimezzando \(\mathbf{w}_t\): valgono per l’architettura senza il limite sul decadimento, e non per i modelli rilasciati. Sotto la congettura \(\mathsf{TC}^0 \neq \mathsf{NC}^1\) (\(\mathsf{NC}^1\) è la classe dei circuiti di profondità logaritmica con porte a due ingressi), ciò eccede quanto può fare un Transformer a profondità fissa, a precisione logaritmica nella lunghezza e senza passi intermedi generati: in quelle ipotesi calcola solo funzioni in \(\mathsf{TC}^0\), i circuiti di profondità costante e dimensione polinomiale con porte di soglia a ventaglio illimitato [MS23]. Lo stesso limite vale per gli SSM con transizione diagonale, come Mamba [MPS24], ed è per questo che la transizione non diagonale di RWKV-7 conta. Con precisione arbitraria e passi di decodifica illimitati il quadro cambia, come racconta la sezione sulle tendenze e i limiti dei Transformer.
RWKV ha poi una storia sua, in un campo dominato dai grandi laboratori. RWKV-4 è stata addestrata fino a 14 miliardi di parametri, ed era la più grande rete ricorrente densa (che usa tutti i propri parametri a ogni token) mai addestrata quando è uscito l’articolo, nel 2023 [PAA+23]. L’articolo su RWKV-7 rilascia sette modelli a pesi aperti, cioè scaricabili e riusabili da chiunque, fino a 2,9 miliardi di parametri, sotto licenza Apache 2.0 [P+25]. Un’architettura competitiva, dunque, può nascere fuori dai recinti industriali; le macchine su cui addestrare i modelli le hanno però messe due aziende, come i ringraziamenti dell’articolo dichiarano.
xLSTM: il ritorno di Hochreiter#
La terza architettura ha il sapore di un ritorno. La LSTM dei modelli di sequenza [HS97] è una cella che tiene una memoria e la governa con alcuni cancelli, i gate. Negli anni Novanta risolse un problema che sembrava senza uscita, quello di una rete ricorrente che su una sequenza lunga smetteva semplicemente di imparare (il gradiente che svanisce), e dal 2013 al 2017 circa è stata, insieme alla GRU, l’architettura di riferimento per le sequenze.
All’inizio i gate erano due: uno per far entrare l’informazione (input), uno per farla uscire (output). Il terzo, quello che lascia sbiadire la memoria vecchia (forget), arriva nel 2000 con Gers, Schmidhuber e Cummins [GSC00], ed è la forma a tre gate che oggi tutti chiamano LSTM.
Nel 2024 uno dei suoi due inventori, Sepp Hochreiter, torna sulla propria creatura e la aggiorna per l’era dei Transformer. Il risultato è xLSTM, di Beck e colleghi, presentato a NeurIPS 2024 [BPoppelS+24].
La domanda di partenza è schietta: che cosa mancava alla LSTM per reggere il confronto? Tre cose, secondo gli autori. Un modo di rivedere le decisioni di memoria in modo più netto, cioè cancelli che si possono aprire senza un tetto, invece di fermarsi sempre un po’ prima del tutto aperto (nei paper si chiama gating esponenziale). Una memoria più capiente, perché in una cella sola l’informazione va compressa in un numero: da qui il passaggio da una cella con un solo posto a una cella a griglia (da scalare a matriciale). E la possibilità di riempirla tutta insieme, che nella vecchia LSTM non c’era, perché i collegamenti da stato a stato costringono a procedere in fila. xLSTM offre due tipi di blocco, che rispondono a queste esigenze.
La vecchia LSTM tiene bottega con un unico scaffale, e per ogni articolo che arriva il magazziniere fissa tre quote, ciascuna fra zero e uno: quanta parte della roba vecchia tenere, quanta parte dell’articolo nuovo far entrare, quanto mostrare al cliente di quello che c’è dentro. Uno vuol dire tutto, e più di tutto non si può. Arriva un articolo che conta più dei mille precedenti messi insieme, e per farlo entrare il magazziniere ha soltanto quel gesto: la quota d’ingresso era già quasi a uno, lui la porta a uno, e all’articolo tocca appena un po’ di spazio in più degli altri.
Nella bottega sLSTM, la prima delle due nuove, lo scaffale resta uno e cambiano le quote: quella d’ingresso non ha più un tetto, può valere dieci, cento, mille, e l’articolo che conta più di tutti si prende lo spazio che merita. Quello che stava sullo scaffale fino a ieri finisce sommerso sotto quello di oggi.
Quel tetto tolto si paga in due modi. Con quote così grandi i numeri che il magazziniere segna crescono in fretta, e diventano troppo grandi perché il calcolatore li sappia scrivere: dieci articoli che entrano ciascuno con quota mille fanno già un uno seguito da trenta zeri. La contromisura è segnare tutto in rapporto alla quota più grande ancora in gioco, come chi, invece di scrivere cifre enormi, scrive «metà della più grande», «un decimo della più grande»: i rapporti restano gli stessi, e i numeri da scrivere restano piccoli. Poi c’è la risposta al cliente. Il magazziniere prende il mucchio che ha accumulato sullo scaffale e lo divide per quanta roba ci ha fatto entrare, come si fa con la media dei voti, e quella media è quello che consegna. Così la risposta resta della taglia di un articolo anche dopo mille articoli e con quote altissime.
Nella bottega mLSTM, la seconda e quella che conterà di più, lo scaffale lascia il posto a un archivio a griglia, ed è di nuovo la rubrica di Mario: un numero fisso di caselle, non un cassetto per ogni etichetta. Chi arriva chiede l’informazione di un’etichetta invece di guardare un ripiano solo, e si sente rispondere un miscuglio in cui pesa soprattutto quello che sta scritto sotto l’etichetta più somigliante. Quanto sbiadire la roba vecchia, poi, il magazziniere lo decide articolo per articolo, guardando quello che ha in mano in quel momento, come faceva Mamba-2.
E la bottega mLSTM guadagna una cosa che con la capienza non c’entra. Le quote dipendono solo dall’articolo che si ha in mano, e nessuno ha bisogno di sapere com’è messo l’archivio adesso: nessun addetto aspetta che il collega abbia finito, e mille addetti sistemano mille articoli contemporaneamente. Nella bottega sLSTM non si può. Lì, per fissare le quote, il magazziniere guarda com’è ridotto lo scaffale in quel momento, e finché non ha sistemato l’articolo di oggi non sa come regolarsi con quello di domani: si va in fila, uno dietro l’altro, come nella bottega della vecchia LSTM. Le due botteghe nuove, insieme, sono la LSTM di trent’anni fa rifatta con la memoria e i muscoli di oggi.
sLSTM (memoria scalare) conserva la struttura classica ma introduce il gating esponenziale. Qui ogni cella tiene un numero solo, e le formule si leggono per una cella alla volta: la memoria e il suo normalizzatore evolvono come
dove \(z_t\) è l’input candidato, \(f_t, o_t\) i gate di forget e output e \(i_t = \exp(\tilde{\imath}_t)\) è il gate di input reso esponenziale, con \(\tilde{\imath}_t\) la sua pre-attivazione, cioè quello che la rete calcola prima di passarlo per l’esponenziale. Il denominatore \(n_t\) è un normalizzatore che accumula i gate di input, così che la lettura \(c_t/n_t\) resti una media ben scalata. La sLSTM ha una memory mixing fra le celle di una stessa testa, e non fra teste diverse: è per questo che i suoi parametri ricorrenti sono \(d^2/N_h\) invece di \(d^2\), con \(N_h\) il numero di teste. Proprio quel mescolamento (i collegamenti da stato a stato) la rende, per costruzione, ricorrente non parallelizzabile: si valuta con un kernel sequenziale, che gli autori hanno però ottimizzato scrivendolo direttamente in CUDA.
mLSTM (memoria matriciale) è la variante pensata per le GPU. Lo stato diventa una matrice, e qui porta il nome che ha nelle LSTM, \(\mathbf{C}_t\) come cell: è lo stesso \(\mathbf{S}_t\) delle formule di prima. Vive in \(\mathbb{R}^{d\times d}\) e si aggiorna con una regola di covarianza, un prodotto esterno, esattamente come nell’attenzione lineare:
dove \(\mathbf{q}_t, \mathbf{k}_t, \mathbf{v}_t\) sono query, chiave e valore, \(f_t\) e \(i_t\) i gate di forget e input, \(\mathbf{n}_t\) il normalizzatore che accumula le chiavi pesate dai gate e \(\mathbf{h}_t\) l’uscita della cella. Attenzione a \(\mathbf{o}_t\): nelle LSTM è il nome del gate d’uscita, ed è quello che vale qui, non l’uscita della lettura, che nella retention si scriveva \(\mathbf{o}_t = \mathbf{S}_t \mathbf{q}_t\). Senza memory mixing, la mLSTM è completamente parallelizzabile: di fatto è un’attenzione lineare con gate e gating esponenziale, in cui la transizione di stato è il decadimento scalare \(f_t\) moltiplicato per l’identità. È quindi la riga «Mamba-2 / RetNet» della tabella unificante (con \(f_t\) data-dipendente, come in Mamba-2), non quella di GLA, che ha un gate per canale; con in più un fattore di scrittura \(i_t\), che nella riga della tabella vale uno.
Resta un problema numerico. Un gate esponenziale \(i_t = \exp(\tilde{\imath}_t)\) può esplodere. La cura è uno stabilizzatore in scala logaritmica, uno stato
che tiene il logaritmo del peso più grande fra quelli con cui le scritture ancora in memoria contano, e viene sottratto prima di esponenziare: è il classico trucco log-sum-exp. Perché il risultato resti davvero identico, però, va riscalato anche il fondo del denominatore, che diventa \(\max\big(|\mathbf{n}_t^\top \mathbf{q}_t|,\, e^{-m_t}\big)\): è la forma stabilizzata che gli autori danno in appendice [BPoppelS+24], e la ragione è aritmetica. Sottrarre \(m_t\) riscala di \(e^{-m_t}\) tanto \(\mathbf{C}_t\) quanto \(\mathbf{n}_t\); se anche la soglia porta lo stesso fattore, esso si semplifica e le due scritture coincidono per costruzione, mentre la soglia fissa \(1\) non si riscala con il resto e, appena il massimo entra in gioco, l’uscita è un’altra. Lo stabilizzatore, invece, non è un’aggiunta della mLSTM: gli autori lo introducono per la sLSTM e qui lo riusano tale e quale. Quello che nella sLSTM non si pone è il secondo passaggio, la riscalatura della soglia, perché lì la lettura è il rapporto puro \(c_t/n_t\) e il fattore si semplifica da sé.
La mLSTM, cioè la cella con la memoria a griglia, si è rivelata quella di maggior peso pratico. Nel 2025 lo stesso gruppo presenta xLSTM-7B [BPoppelL+25], un modello da 7 miliardi di parametri costruito su sole celle mLSTM e addestrato su 2,3 mila miliardi di token: a quella taglia va alla pari con i modelli confrontabili, mantenendo l’inferenza a memoria costante che una ricorrenza porta con sé.
Lo stesso scheletro#
Tre architetture, tre storie (un laboratorio industriale insieme a un’università, una comunità aperta, il ritorno di un pioniere) e tre insiemi di scelte ingegneristiche, sullo schema delle ricorrenze lineari: una memoria di taglia fissa che si riempie in parallelo mentre il modello impara e si rilegge un token alla volta, a costo sempre uguale, quando scrive. Vale per RetNet, per RWKV dalla versione 5 in poi e per la cella mLSTM; fa eccezione la sLSTM, i cui collegamenti da stato a stato la rendono non lineare e addestrabile solo in sequenza.
A distinguerle è soprattutto il modo in cui la memoria di ieri sopravvive a oggi, cioè il gradino che occupano nella tabella delle ricorrenze di scrivere meglio nella memoria. RetNet la sbiadisce con un ritmo deciso una volta per tutte. La mLSTM di xLSTM la sbiadisce con un ritmo che ricalcola a ogni token, cioè sta sul gradino di Mamba-2. RWKV ha percorso tutta la scala in due anni: dai ritmi fissi di RWKV-4 (2023) a quelli ricalcolati a ogni token, canale per canale, di RWKV-6 (2024), che è il gradino di GLA, fino a RWKV-7 (2025), che prima di scrivere cancella la voce che sta per riscrivere, cioè corregge invece di sommare alla cieca. RWKV-5, in mezzo, su questa scala non fa gradino: cambia la forma della memoria, non il ritmo con cui sbiadisce.
Che due modelli stiano sullo stesso gradino non vuol dire che siano lo stesso modello: vuol dire che scelgono lo stesso modo di far sopravvivere la memoria, e poi si distinguono per tutto il resto (come si aprono i cancelli, che cosa si mette attorno alla memoria, come si scrive il codice che gira sulla scheda grafica). Nomi, sigle e comunità diverse raccontano, in fondo, la stessa storia.
Una precisazione, perché le storie tutte-uguali sono sospette e questa ha un’eccezione onesta. La prima versione di RWKV, la v4, non tiene una tabella di etichette e informazioni come le altre: tiene una fila di numeri, uno per canale, che sbiadiscono ciascuno per conto proprio. È attenzione lineare anche quella, e la storia dello sbiadimento vale identica, ma il foglio a righe e colonne, quello che risponde alle domande per etichetta, in RWKV arriva con la versione 5.
Con i nomi tecnici: la transizione di stato è un decadimento scalare data-indipendente in RetNet (\(\gamma \mathbf{I}\)), uno scalare data-dipendente con gating esponenziale nella mLSTM di xLSTM, e in RWKV passa dal decadimento diagonale fisso della v4 a quello data-dipendente della v6 fino al decadimento diagonale con correzione di rango uno della v7. Attenzione a non leggerlo come il gradino che, nella famiglia di Yang, separa la GLA dal Gated DeltaNet: quello scambia il decadimento per canale con uno scalare mentre aggiunge la correzione, la v7 invece conserva il decadimento per canale.
Una riserva sull’affermazione «tutte tengono una memoria che si scrive per prodotto esterno»: vale da RWKV-5 in poi (oltre che per RetNet e per la mLSTM), non per RWKV-4, il cui stato è un vettore per canale aggiornato elemento per elemento e la cui formula, come si è visto, non contiene nessuna query. Nella tassonomia dei paper è la differenza fra stato piccolo e stato grande, ed è proprio il salto che compie Eagle.
Gli State Space Model (S4, Mamba e i loro discendenti) arrivano allo stesso posto da un’altra strada, senza passare dall’attenzione: la matematica con cui si descrive un sistema che evolve nel tempo (un pendolo, un circuito), scritta prima con il tempo che scorre di continuo e poi ridotta a passi, uno per token. Il punto d’arrivo coincide: anche un SSM è una ricorrenza lineare a stato fisso con le sue due forme, parallela e ricorrente. E Mamba-2, che si può scrivere tanto come stato che si aggiorna quanto come attenzione (gli autori chiamano dualità questa doppia scrittura), mostra che per i modelli a decadimento scalare, quelli che sbiadiscono tutta la memoria con un solo fattore, le due famiglie sono proprio la stessa cosa [DG24].
Alla fine del 2025 nessuna di queste architetture aveva «ucciso» il Transformer. Lo stato di dimensione fissa, che è la loro forza in efficienza, è anche il loro limite: quando serve ritrovare un dettaglio preciso in un contesto molto lungo, l’attenzione piena, che conserva ogni token, resta superiore. Nei paper quel compito si chiama recall associativo, e lo si misura con banchi di prova sintetici come MQAR [AET+23] e con compiti di estrazione di informazioni da testi veri [AEZ+24]. È da qui che nascono gli ibridi, che alternano pochi strati di attenzione piena a molti strati lineari, ed è la forma in cui gli strati lineari sono entrati nei grandi modelli del 2025: un blocco di attenzione softmax ogni sette di attenzione lineare in MiniMax-01, a gennaio [MiniMax25b]; uno ogni tre blocchi Gated DeltaNet in Qwen3-Next, a settembre [QwenTeam25]; lo stesso rapporto in Kimi Linear, a ottobre, con una Gated DeltaNet a gate per canale [KimiTeam25]. L’esito non era scontato nemmeno allora: a ottobre lo stesso gruppo di MiniMax è tornato all’attenzione piena con M2, scrivendo che in un sistema di produzione l’attenzione efficiente doveva ancora fare strada prima di batterla [MiniMax25a]. Questi limiti, e il modo in cui gli ibridi li affrontano, si capiscono meglio dopo aver visto anche l’altra metà della famiglia, e li riprende la sezione sui limiti e sugli ibridi del capitolo sugli State Space Model.
Da ricordare
RetNet [SDH+23] toglie la softmax e pesa ogni parola passata con un fattore che sbiadisce con la distanza, sempre lo stesso: le parole si confrontano ancora, ma quanto il passato conti dipende solo da quanto è lontano. È la somma pesata dei voti di uno studente, con le interrogazioni recenti che pesano più delle vecchie, e si può fare nei tre modi che danno lo stesso risultato: tutto insieme (per addestrare in fretta), uno alla volta tenendo un totale corrente (per generare, a costo fisso per parola), a blocchi (per i testi lunghissimi).
Quel ritmo di sbiadimento, però, è deciso a priori e uguale per ogni parola: la forma più grossolana di oblio, cieca al contenuto, all’opposto dello sbiadimento di Mamba-2 e di GLA, che si regola da sé parola per parola e zona per zona della memoria. Di ritmi, però, ne tiene parecchi affiancati, chi svelto e chi lentissimo, così che l’insieme copra insieme il passato vicino e quello lontano.
RWKV [PAA+23], progetto aperto di comunità, alterna due blocchi: uno mescola l’informazione fra le parole (il mestiere dell’attenzione), l’altro rimescola fra loro i numeri con cui è scritta una singola parola. Come le altre, si addestra guardando tutto il testo insieme e in uso procede una parola alla volta, tenendo una memoria di taglia fissa.
Le sue versioni salgono gli stessi gradini dello sbiadimento: prima un ritmo fissato una volta per tutte (RWKV-4, 2023), poi deciso parola per parola e zona per zona (RWKV-6, 2024 [PGA+24]), infine una versione che, prima di scrivere, corregge quello che c’è già e può correggere oltre la misura, ribaltando la voce vecchia (RWKV-7, 2025 [P+25]). È quel ribaltamento a farle tenere il conto di una situazione che cambia, e nei modelli rilasciati è permesso solo in parte.
xLSTM [BPoppelS+24] riapre la bottega della vecchia LSTM di Hochreiter [HS97], il magazziniere con un solo scaffale e tre quote fra zero e uno. Toglie il tetto alla quota d’ingresso (tenuta a bada da un accorgimento di calcolo perché i numeri non esplodano) e apre due botteghe: la sLSTM, con l’unico scaffale, che sistema un articolo per volta e in fila, e la mLSTM, con un archivio a griglia, che ne sistema mille insieme. Un modello da sette miliardi di parametri costruito solo sulla seconda [BPoppelL+25] va, a quella taglia, alla pari con i modelli confrontabili.
Il filo comune: RetNet, RWKV e la mLSTM di xLSTM, con GLA, DeltaNet e Gated DeltaNet, tengono una memoria di taglia fissa aggiornata parola per parola, e a distinguerli è soprattutto il modo in cui la memoria di ieri sopravvive a oggi (la sLSTM fa eccezione, perché va in fila). Gli State Space Model arrivano allo stesso motore da un’altra strada.
Da ricordare
RetNet [SDH+23] sostituisce la softmax con un decadimento esponenziale fisso \(\gamma\) e offre lo stesso calcolo in tre forme equivalenti: parallela (addestramento, \(O(n^2 d)\)), ricorrente \(\mathbf{S}_t = \gamma \mathbf{S}_{t-1} + \mathbf{v}_t \mathbf{k}_t^\top\) (inferenza a costo costante nella lunghezza, \(O(d^2)\) per token), chunkwise (contesto lungo, lineare in \(n\)). È multi-scala: ogni testa usa un \(\gamma\) diverso.
Il decadimento di RetNet è scalare, deciso una volta per tutte e uguale per ogni parola: la forma più grossolana di oblio, all’opposto dei gate appresi di Mamba-2 e GLA.
RWKV [PAA+23], progetto aperto di comunità, alterna time-mixing (attention-like) e channel-mixing (FFN-like) con token-shift, \(\mathbf{x}'_t = \boldsymbol{\mu}\odot\mathbf{x}_t + (1-\boldsymbol{\mu})\odot\mathbf{x}_{t-1}\): si addestra come un Transformer, si usa come una RNN a stato costante.
L’evoluzione di RWKV va dall’operatore WKV a decadimento fisso (v4) allo stato matriciale della v5 (Eagle) e al decadimento data-dipendente della v6 (Finch) [PGA+24] fino alla delta rule generalizzata di v7 Goose [P+25], la cui transizione ammette un autovalore negativo. Lo state tracking e il riconoscimento dei linguaggi regolari sono dimostrati per l’architettura con \(c = 2\) (o con il decadimento non limitato), non per i modelli rilasciati, che con \(c = 1\) e \(\mathbf{w}_t > e^{-e^{-1/2}}\) fermano l’autovalore negativo sopra \(-0{,}455\).
xLSTM [BPoppelS+24] aggiorna la LSTM di Hochreiter [HS97] con gating esponenziale (stabilizzato in scala log) e due celle: sLSTM (memoria scalare, non parallelizzabile) e mLSTM (memoria matriciale \(\mathbf{C}_t = f_t \mathbf{C}_{t-1} + i_t \mathbf{v}_t \mathbf{k}_t^\top\), parallelizzabile, di fatto un’attenzione lineare con decadimento scalare data-dipendente, cioè la riga di Mamba-2 e RetNet). xLSTM-7B [BPoppelL+25] la porta alla scala dei grandi modelli.
Il filo comune: RetNet, RWKV (dalla v5) e la cella mLSTM di xLSTM, con GLA e DeltaNet, sono la stessa RNN lineare a stato fisso; cambia soprattutto la transizione di stato, e in pochi casi il termine di scrittura. La sLSTM, non lineare, fa eccezione. Gli State Space Model arrivano allo stesso punto da un’altra strada, e Mamba-2 dimostra che sulla riga del decadimento scalare sono lo stesso modello.
Dalle tre architetture resta uno schema: una memoria di taglia fissa aggiornata parola per parola, che i modelli trattano in modi diversi soprattutto nel far sopravvivere la memoria di ieri. Il notebook lo mette alla prova con un calcolo, mostrando che la forma parallela e quella ricorrente producono le stesse uscite; poi gli State Space Model arrivano allo stesso schema, una ricorrenza lineare a stato fisso con le sue due forme, da un’altra strada, quella dei sistemi dinamici, senza passare dall’attenzione.