


Mondi in miniatura: imparare sognando#
L’esperimento del 2018 che l’apertura del capitolo ha nominato di passaggio, e che la sezione sul reinforcement learning basato su modello aveva già messo sul tavolo, sembra uscito da un racconto più che da un laboratorio di machine learning. Qui lo si smonta pezzo per pezzo. David Ha e Jürgen Schmidhuber prendono un livello di Doom (lo storico sparatutto) in cui bisogna schivare palle di fuoco, e ci allenano un agente che, durante l’allenamento, il gioco vero non lo tocca mai. L’ordine delle cose è questo: prima si raccolgono migliaia di partite giocate premendo i tasti a caso; da quelle partite due reti neurali si costruiscono una copia compressa e approssimativa del gioco; e l’agente si allena esclusivamente dentro quella copia, nel proprio «sogno», l’hanno chiamato proprio così. Riportato nel gioco autentico, schiva le palle di fuoco ben oltre la soglia che definisce il livello «risolto» [HS18].
L’articolo ha un titolo di due parole, World Models (presentato a NeurIPS 2018 come Recurrent World Models Facilitate Policy Evolution), e contiene anche un secondo esperimento, su un gioco di guida in cui il sogno non c’entra: è il più comodo per guardare dentro la macchina, e lo si segue per primo. Un world model, in tutti e due i casi, è una copia interna, compressa e appresa, dell’ambiente: dentro, provare un’azione costa poco e sbagliare non ha conseguenze. Dopo la ricetta viene la sua discendenza, fino ai Dreamer e ai diamanti di Minecraft, e in fondo i tre moduli in PyTorch.
Tre lettere per un pilota: V, M e C#
La ricetta ha tre ingredienti dai nomi minimalisti: V come visione, M come memoria, C come controller. V comprime ogni fotogramma in un piccolo codice, che è una lista corta di numeri e niente di più. M impara come quel codice evolve in risposta alle azioni, ed è una rete ricorrente (in sigla RNN): una rete che legge un passo alla volta portandosi dietro un riassunto di tutto quel che ha già visto, e quel riassunto si chiama \(\mathbf{h}\). La variante di rete ricorrente che Ha e Schmidhuber adoperano si chiama LSTM, ed è quella che sa tenersi stretto un ricordo per molti passi invece di lasciarlo sbiadire. C, che dei tre è di gran lunga il più piccolo, legge codice e memoria e decide.
I numeri che seguono sono quelli del gioco di guida, CarRacing-v0: una pista vista dall’alto, generata a caso a ogni partita, su cui il pilota C si allena nel gioco vero. Lì lo schema è il primo sistema dichiarato in grado di risolvere il compito: 906 punti di media su 100 piste, contro la soglia di 900 che arriva insieme all’ambiente e che tutti adoperano, così che i risultati si possano confrontare. «Risolto», accanto a un numero, vuol dire soltanto «sopra la soglia fissata dall’ambiente», e il numero va letto insieme alla soglia e a come la si misura. L’esperimento del sogno è l’altro, lo sparatutto, con taglie diverse che vanno dette insieme ai suoi numeri.
La Fig. 31.1 mostra il giro completo, con \(\mathbf{h}\) e LSTM scritti al loro posto: l’azione di C torna all’ambiente, che produce il fotogramma successivo. E mostra l’anello tratteggiato che rende speciale l’architettura: M può alimentare se stesso, sostituendosi all’ambiente. È il circuito del sogno.

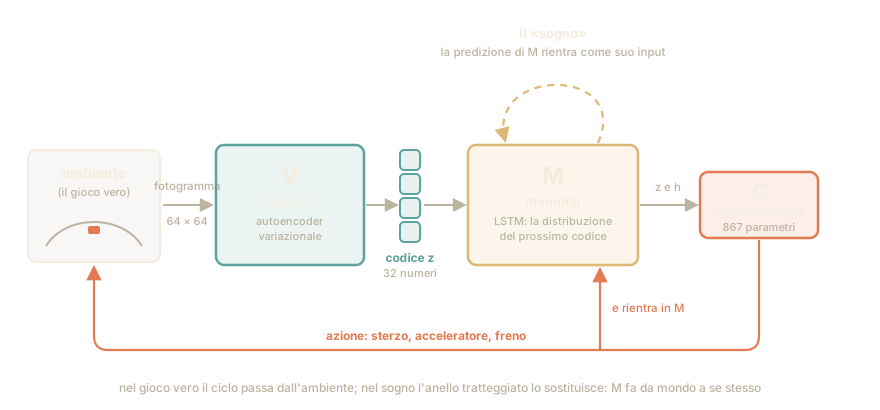
Fig. 31.1 I tre moduli di Ha e Schmidhuber: nel gioco vero il ciclo passa dall’ambiente; nel sogno l’anello tratteggiato lo sostituisce. L’azione fa due strade: torna all’ambiente e rientra in M, ed è quella diramazione a rendere il modello utile per decidere.#
V come Visione: il mondo in trentadue numeri#
Un fotogramma di CarRacing, ridotto a \(64 \times 64\) pixel, sono 4.096 puntini; ma ogni puntino è colorato, e per dire un colore servono tre numeri (quanto rosso, quanto verde, quanto blu), quindi il fotogramma sono \(64 \times 64 \times 3 = 12\,288\) numeri. Troppi, e quasi tutti ridondanti: alla guida non servono i singoli fili d’erba, serve sapere dove curva la strada e dove sta l’auto. V è un encoder addestrato a comprimere ogni fotogramma in un codice di 32 numeri, 384 volte meno dei 12.288 di partenza; il suo nome tecnico è autoencoder variazionale, in sigla VAE, ed è la macchina che la sezione sull’ELBO e la riparametrizzazione deriva per intero [KW14]. Il codice è il vettore \(\mathbf{z} \in \mathbb{R}^{32}\), il riassunto di quel che si vede adesso. Per fare questo mestiere V si porta dietro circa 4,3 milioni di parametri (il conto comprende anche il decoder che serve ad addestrarlo): è di gran lunga il più pesante dei tre moduli.
Descrivi la schermata di gioco a un amico al telefono. Non gli detti i 4.096 puntini uno per uno, ciascuno con i suoi tre numeri di colore: dici «curva a sinistra, auto al centro, erba sui bordi» (poche informazioni, quelle giuste). Il VAE fa lo stesso, ma nessuno gli ha suggerito quali informazioni tenere: le ha scelte da solo, perché il suo allenamento è un gioco di andata e ritorno (comprimi il fotogramma in 32 numeri, poi prova a ridisegnarlo dal solo riassunto). Se il disegno somiglia all’originale, il riassunto conteneva l’essenziale; se non somiglia, quei 32 numeri vanno usati meglio. Come al telefono: se dalla tua descrizione l’amico disegna una scena quasi uguale, la descrizione era buona.
Nell’andata e ritorno c’è una seconda regola. Chi guarda lo schermo non detta una frase sola: detta una frase con il suo margine («più o meno curva a sinistra»), e ogni volta ne pesca una un po’ diversa dentro quel margine. La stessa schermata una volta diventa «curva a sinistra», un’altra «piega a sinistra», e l’amico deve saper disegnare una scena sensata da tutte e due. Una parte del voto, poi, punisce chi stringe il margine fino a una frase sola, e chi si allontana dal modo di parlare di tutti: senza quella penalità chi riassume imparerebbe a dettare sempre la stessa frase precisa, e l’amico imparerebbe a disegnare soltanto quella. Perché questa fatica? Perché fra poco le frasi non le detterà più chi guarda lo schermo: se le inventerà M, che lo schermo non lo vede mai, e le sue frasi non saranno mai precise parola per parola. Se l’amico sapesse disegnare soltanto una manciata di frasi imparate a memoria, davanti a una frase inventata poserebbe la matita, e il sogno finirebbe lì.
L’encoder del VAE mappa il fotogramma \(\mathbf{x} \in \mathbb{R}^{64 \times 64 \times 3}\) in una distribuzione gaussiana sullo spazio latente:
dove \(\boldsymbol{\mu}_\phi(\mathbf{x})\) e \(\boldsymbol{\sigma}_\phi(\mathbf{x})\) sono media e deviazione standard prodotte da una pila di convoluzioni con parametri \(\phi\), \(\mathbf{z} \in \mathbb{R}^{32}\) è il codice latente e la seconda uguaglianza è il trucco della riparametrizzazione, che rende campionabile e derivabile il passaggio. L’addestramento massimizza l’ELBO,
dove \(p_\theta\) è il decoder con parametri \(\theta\); con un decoder gaussiano a varianza fissa \(\sigma_x^2\) il primo termine vale, a meno di una costante, \(-\lVert \mathbf{x} - \hat{\mathbf{x}} \rVert^2 / (2\sigma_x^2)\), con \(\hat{\mathbf{x}}\) la ricostruzione, e nel paper è infatti la distanza \(L_2\) fra immagine e ricostruzione. Il secondo termine tiene ogni \(q_\phi(\mathbf{z} \mid \mathbf{x})\) vicina alla prior, cioè impedisce alle varianze di stringersi a zero e alle medie di allontanarsi. La derivazione è nella sezione sull’ELBO. Ed è la stessa forma, verosimiglianza meno KL, che torna nella loss del modello di Dreamer.

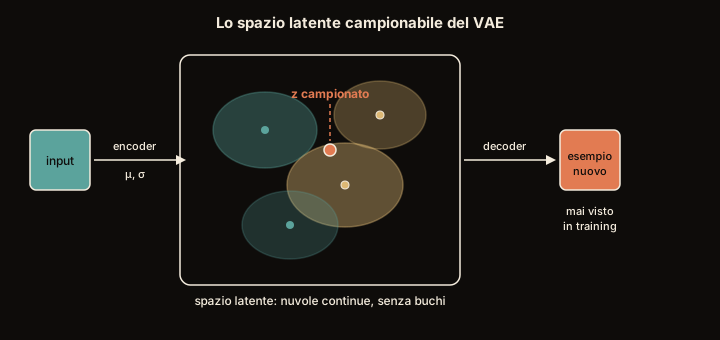
Fig. 31.2 Perché le nuvole si sovrappongono. Codificando ogni fotogramma in una distribuzione invece che in un punto, lo spazio resta pieno: anche i punti mai visti decodificano in qualcosa di sensato.#
La proprietà mostrata in Fig. 31.2 è ciò che rende V utilizzabile da M. Se il latente avesse buchi, la ricorrenza che immagina il codice successivo finirebbe presto in una zona che nessun fotogramma vero ha mai occupato, dove la dinamica di M non è stata stimata da niente, e il sogno si spezzerebbe dopo pochi passi. Nel paper V viene addestrato per primo, in modo non supervisionato, su fotogrammi raccolti da una policy casuale; il decoder serve solo in addestramento. Su CarRacing V pesa circa 4,3 milioni di parametri.
M come Memoria: la fisica del gioco in una RNN#
Un fotogramma compresso è una fotografia, non un film: non dice cosa succederà. Il secondo modulo impara la dinamica: dato il codice di adesso e l’azione scelta, quale sarà il codice di poi? M è una LSTM, la rete ricorrente con i gate (i cancelli che decidono cosa ricordare e cosa dimenticare) incontrata nella sezione sui modelli di sequenza [HS97]. Solo che qui la «frase» da proseguire non è fatta di parole ma di codici \(\mathbf{z}\): M vive nel piccolo mondo dei 32 numeri, senza mai toccare i pixel, perciò è veloce ed economica. Il riassunto che si porta dietro di passo in passo è una fila di 256 numeri, ed è la \(\mathbf{h}\) del disegno (una LSTM in realtà ne porta due, e il secondo lo racconta una nota); in tutto a M bastano poco più di 400.000 parametri, meno di un decimo di quelli di V.
Un’amica ha giocato mille partite. Le descrivi la situazione in una frase («sono a metà curva, sto accelerando») e lei ti dice come prosegue: «esci largo verso l’erba». Non le serve vedere lo schermo: le basta il riassunto, perché la fisica del gioco ce l’ha in testa. E la domanda che le fai non è mai «come va a finire»: è «come va a finire se accelero», e con «se freno» ti risponde un’altra cosa. Senza quel pezzo la sua risposta sarebbe la stessa qualunque cosa tu faccia, e non servirebbe a decidere niente. Una sfumatura conta: l’amica onesta non risponde con una certezza ma con un ventaglio, «quasi sempre esci largo; ogni tanto la tieni». M è costruita così: per ogni situazione prevede le diverse continuazioni possibili, ciascuna con la sua probabilità, come le previsioni del tempo che dicono «pioggia al 70%» invece di giurare sul sole. E non sceglie fra due o tre finali già pronti: la descrizione è fatta di trentadue numeri, e su ciascuno di quelli, preso da solo, apre un ventaglio a cinque alternative; i finali che ne escono, prendendo un’alternativa per ogni numero, sono più di quanti se ne possano contare. Il futuro di un gioco (e del mondo) non è mai scritto del tutto, e un modello che finge di saperlo mente.
M è una MDN-RNN: una LSTM (256 unità nascoste su CarRacing) la cui testa di uscita è una mixture density network, l’idea proposta da Christopher Bishop nel 1994 per far predire a una rete un’intera distribuzione anziché un valore. Conviene scrivere la ricorrenza per esteso, perché è lì che entra l’azione:
dove \(\mathbf{h}_t\) è lo stato nascosto della LSTM prima del passo \(t\) (il
riassunto di tutto ciò che è successo fino a \(t-1\) compreso), \([\mathbf{z}_t ;
\mathbf{a}_t]\) è la concatenazione del codice corrente e dell’azione scelta
(\(\mathbf{a}_t \in \mathbb{R}^3\) nel gioco di guida: sterzo, acceleratore,
freno), e \(\mathbf{h}_{t+1}\) è il nuovo stato nascosto, funzione deterministica
dei tre argomenti che stanno a destra della barra verticale. È da
\(\mathbf{h}_{t+1}\), e solo da lì, che escono i parametri della miscela: se
l’azione non entrasse nella ricorrenza, M predirebbe lo stesso futuro qualunque
cosa l’agente faccia, e sarebbe inutile proprio per la cosa a cui serve,
immaginare le conseguenze di una scelta. La convenzione sui pedici è la stessa
del controller, dove \(\mathbf{a}_t\) si sceglie leggendo \(\mathbf{z}_t\) e
\(\mathbf{h}_t\): \(\mathbf{h}_t\) esiste prima che l’azione sia decisa. Nello
scheletro in PyTorch la riga nn.LSTM(dim_z + dim_a, dim_h) monta esattamente
questa ricorrenza.
Quanto al resto, \(z_{t+1,i}\) è la \(i\)-esima delle 32 componenti del prossimo codice: ognuna ha la propria miscela di \(K = 5\) gaussiane, con pesi \(\pi_{k,i}\) (una softmax, sommano a 1) e con \(\mu_{k,i}\), \(\sigma_{k,i}\) a darne centro e incertezza. La fattorizzazione nel prodotto dice che le scelte di componente sono indipendenti dimensione per dimensione: il modello non pesa cinque «versioni del futuro» preconfezionate, ne può comporre \(5^{32}\) combinando le alternative di ogni componente. È anche una rinuncia, e gli autori la dichiarano: fra una componente e l’altra del prossimo codice non c’è nessuna correlazione modellata, quindi le trentadue scelte possono cadere in modo incoerente fra loro.
L’addestramento minimizza la log-verosimiglianza negativa dei codici osservati nelle partite raccolte,
con la forzatura dell’insegnante (teacher forcing): a ogni passo l’ingresso \(\mathbf{z}_t\) è quello della partita registrata, non quello che M ha predetto. E non è la media dell’encoder ma un campione nuovo da \(q_\phi(\mathbf{z} \mid \mathbf{x}_t)\) a ogni batch, così che M non si adatti a una sola realizzazione del codice. Su Doom M predice anche la probabilità che l’episodio finisca (l’agente muore), e nel sogno la partita si chiude quando quella probabilità supera il 50%. Su CarRacing M pesa in tutto poco più di 400.000 parametri, e la miscela è ciò su cui agirà la temperatura del sogno, che regola quanto il «mondo interno» sia capriccioso.
C come Controller: il pilota minimalista#
Dopo un encoder da milioni di parametri e una memoria da centinaia di migliaia, il modulo che decide è il più piccolo dei tre. C mette in fila i 32 numeri del codice visivo e i 256 della memoria, 288 in tutto, e ne fa una trasformazione affine: per ciascuno dei tre comandi (sterzo, acceleratore, freno) una somma pesata dei 288 numeri più una costante, cioè \(288 \times 3 + 3 = 867\) parametri. È la tesi dell’articolo: se V e M hanno estratto la struttura utile del mondo, per agire basta una policy lineare.
Quanto contino il codice e la memoria lo dicono gli autori togliendo pezzi uno alla volta (in gergo, un’ablazione), sempre su CarRacing. Ogni risultato è la media del punteggio su cento piste, e il numero dopo il ± è la deviazione standard, cioè quanto il punteggio cambia da una pista all’altra. Un C lineare che legge il solo codice visivo arriva a \(632 \pm 251\); dandogli più capacità, cioè uno strato nascosto fra ingresso e uscita, sale a \(788 \pm 141\); lasciandolo lineare e dandogli invece la memoria di M arriva a \(906 \pm 21\). Capacità in più nel controllore compra qualcosa, il modello compra molto di più, e rende anche il pilota più regolare.
Al banco di un fonico c’è una fila di manopole, ciascuna che alza o abbassa un ingresso, e in uscita tre soli comandi. Gli ingressi, qui, sono i 288 numeri che descrivono la situazione (che cosa si vede adesso, che cosa si ricorda di prima), ogni manopola dice quanto ciascuno di quei numeri deve contare, e i tre comandi in uscita sono sterzo, acceleratore e freno. Imparare a guidare, per C, vuol dire soltanto trovare la posizione giusta di 867 manopole: pochissimo, se si pensa che una sola immagine del gioco è fatta di 12.288 numeri. Ed è proprio questo il punto dell’esperimento: la parte difficile (capire come funziona il mondo) l’hanno già sbrigata V e M, e a chi deve muovere i pedali resta un lavoro da riflesso.
Il metodo di addestramento abituale delle reti, quello che dopo ogni errore ritocca ogni peso di un soffio nella direzione che conviene (in gergo si chiama seguire il gradiente), qui non si può nemmeno usare: nessuno dice al pilota se una singola sterzata è stata buona, il voto arriva tutto insieme a fine gara. Con 867 manopole si può fare a meno del gradiente, e basta un metodo alla Darwin: si provano 64 piloti presi un po’ a caso, si tengono quelli che hanno guidato meglio, si fa una nuova generazione somigliante a loro, e si ricomincia. Ci vuole pazienza, e benzina vera: qui i piloti corrono nel gioco autentico, non in un sogno, sedici gare ciascuno per ogni generazione, e nell’articolo le generazioni sono 1.800. Fanno quasi due milioni di gare, e alla fine si guida.
La forma esatta è una moltiplicazione di matrice:
dove \([\mathbf{z}_t ; \mathbf{h}_t]\) è la concatenazione del codice visivo e dello stato della memoria (\(32 + 256 = 288\) numeri), \(\mathbf{W}_c\) è una matrice \(3 \times 288\) e \(\mathbf{b}_c\) un vettore di tre bias, uno per azione: sterzo, acceleratore, freno. Totale: \(288 \times 3 + 3 = 867\) parametri. La tangente iperbolica non aggiunge capacità (schiaccia soltanto le uscite in \([-1, 1]\); acceleratore e freno vengono poi riportati in \([0, 1]\)), quindi la policy è a tutti gli effetti lineare. Un controllore così piccolo si può addestrare senza gradiente: gli autori usano CMA-ES, una strategia evolutiva che a ogni generazione fa «gareggiare» 64 varianti del controllore, ne stima media e covarianza e ricampiona da lì la generazione successiva. Con 867 parametri da scegliere l’evoluzione è sufficiente, ed è anche la strada più naturale, visto che il segnale su cui giudicare un pilota (il punteggio) arriva solo a fine episodio. Non è però economica: ogni candidato si valuta su 16 episodi, e le generazioni sono 1800, cioè \(64 \times 16 \times 1800 = 1\,843\,200\) episodi nell’ambiente vero per addestrare il solo C su CarRacing, oltre ai 10.000 rollout casuali su cui si sono addestrati V e M. Il guadagno di questo esperimento è la separazione fra rappresentazione e policy, e il punteggio; l’efficienza campionaria, che è la promessa di un modello del mondo, si misura solo dove C si allena nel sogno.
Allenarsi nel sogno#
Finora M ha fornito a C il proprio stato \(\mathbf{h}\), il riassunto di quel che era successo prima. L’anello tratteggiato della Fig. 31.1 fa un’altra cosa: il codice \(\mathbf{z}_{t+1}\) predetto da M non viene confrontato con il fotogramma vero, ma rientra in M come ingresso del passo successivo. Il modello si racconta il gioco da solo, un passo dopo l’altro: niente più ambiente, niente pixel, solo codici che generano codici. Ha e Schmidhuber lo chiamano dream, sogno, e l’esperimento è tutto qui: C viene addestrato soltanto dentro il sogno e poi trasferito, senza ritocchi, nel gioco vero.
Sulla parola conviene fermarsi un secondo, perché si porta dietro qualcosa che qui non c’entra. Un sogno vero è sconclusionato, e da un sogno ci si aspetta che sbagli; questo invece è una simulazione, e la si vuole fedele: quando si scolla dal gioco vero è un guasto e non un tratto pittoresco, ed è il guasto di cui parla il resto della sezione. Per il resto la parola calza: il gioco è staccato, si procede a occhi chiusi, e quel che si vede se lo sta inventando chi lo guarda.
Un cambio di scena, però, va dichiarato. I numeri dati finora (32 numeri di codice, 256 di memoria, 867 parametri di controller) sono quelli di CarRacing, e su CarRacing gli autori fanno evolvere il controller nell’ambiente vero. L’unico esperimento allenato davvero dentro il sogno è l’altro, lo sparatutto. Il suo nome per esteso è Take Cover, uno degli scenari di VizDoom (la versione di Doom attrezzata per la ricerca), e Take Cover è il nome con cui lo chiameremo d’ora in avanti. Lì lo stesso schema usa un codice da 64 numeri, una memoria da 512 numeri e un controller da 1088 parametri: la ricetta è la stessa, le taglie no.[1]
È il pilota che la sera prima della gara ripassa il circuito a occhi chiusi, lo stesso che nella sezione sul reinforcement learning basato su modello si allenava nel sogno di Dreamer. Il ripasso costa zero benzina e zero incidenti. E se il gioco vero è staccato, chi tiene il punteggio? Il sogno stesso. Nello sparatutto il punteggio è quanto sopravvivi, e M, oltre al riassunto del momento dopo, prevede anche se sei stato colpito: quando decide che l’hai presa, la partita sognata finisce e il punteggio è la sua durata. Ma c’è un tallone d’Achille: se nella tua testa una curva è più dolce che in pista, impari una traiettoria che domani ti manda nella ghiaia. E lo scarto non resta dov’è: ogni curva ripassata storta sposta anche il punto da cui parte quella dopo, così più a lungo il ripasso va avanti, meno il circuito immaginato somiglia a quello vero. La velocità con cui succede dipende dal circuito: lo sparatutto è semplice, e lì il ripasso poteva durare una partita intera; sui giochi più ricchi i Dreamer, più avanti, lo terranno corto. All’agente di Ha e Schmidhuber successe qualcosa di più subdolo: dentro il sogno scoprì dei trucchi. Trovò modi di muoversi per cui le palle di fuoco, mentre stavano per formarsi, svanivano. Stava barando al proprio sogno, sfruttandone i difetti, come uno studente che si prepara all’esame inventandosi da solo domande facili. Punteggi splendidi nel mondo immaginato, figuraccia in quello vero. (Un secondo guasto c’era e non era colpa sua: con il sogno troppo docile i mostri non sparavano affatto, qualunque cosa l’agente facesse, perché M si era ridotto a raccontare sempre la stessa storia.)
Il rimedio è rendere il sogno più capriccioso del gioco vero, e si fa girando una manopola sola. Si chiama temperatura, per un’immagine presa dalla fisica: più una cosa è calda, più le sue particelle si agitano a caso. M non annuncia una continuazione unica ma un ventaglio di continuazioni con le loro probabilità: alzando la temperatura escono più spesso quelle improbabili. Il sogno diventa dispettoso, e un trucco che ha funzionato una volta la volta dopo non funziona più. Alzarla troppo, però, non conviene: un sogno completamente sregolato non somiglia più a niente, e lì dentro non si impara nulla. Il punto giusto della manopola lo si scova provando, e nello sparatutto cadeva dove il sogno era diventato più capriccioso del gioco vero: là l’agente sopravvisse in media più a lungo nella realtà che nella propria testa, 1092 punti contro 918.
Resta un limite, e sta in come il sogno è nato: M l’ha imparato guardando partite giocate premendo i tasti a casaccio. Il pilota è cresciuto dentro la copia di un gioco che nessun bravo giocatore ha mai giocato, e nel sogno non può esserci quello che in quelle partite non è mai successo. Per questi due giochi bastava; per uno più ricco gli autori propongono un giro che si ripete. Il pilota va a correre sul serio, le partite nuove (fatte meglio, quindi con situazioni che il caso non avrebbe mai prodotto) servono a rifare il sogno, e nel sogno rifatto il pilota si riallena; poi si ricomincia.
Un rollout nel modello è la catena
dove la terza uguaglianza è la ricorrenza di M scritta poco fa, qui senza più nessun fotogramma a rifornirla: il codice che entra al passo dopo è quello che M ha appena inventato. Il campionamento dalla miscela avviene a temperatura \(\tau\), un parametro che agisce in due punti: divide i logit da cui esce la softmax dei pesi \(\pi_{k,i}\) e riscala le varianze \(\sigma_{k,i}^2\). Gonfia l’incertezza per \(\tau > 1\) e la spegne per \(\tau \to 0\), dove M diventa quasi una LSTM deterministica e collassa su una sola modalità. Il problema strutturale è che C viene ottimizzato contro M, non contro l’ambiente: ogni errore sistematico del modello diventa una risorsa da sfruttare, e la ricerca di policy trova politiche avversarie al proprio stesso mondo interno; nel paper, movimenti che «estinguono» le palle di fuoco mentre si formano. Va tenuto distinto il guasto che a \(\tau = 0{,}10\) gli autori descrivono a parte, i mostri che non sparano mai qualunque cosa l’agente faccia: quello va attribuito al mode collapse di M, non a una politica avversaria. Con \(\tau\) basso il sogno è docile e l’inganno prospera: a \(\tau = 0{,}10\) l’agente totalizza \(2086 \pm 140\) nel proprio sogno e \(193 \pm 58\) nell’ambiente vero, che è il modo più netto di dire «transfer disastroso».
Alzare \(\tau\) è il rimedio, ma fino a un certo punto, e la tabella di Take Cover dice dove (punteggi su 100 rollout, media e deviazione standard; un episodio dura al più 2100 passi, e la soglia di risoluzione è 750):
\(\tau\) |
nel sogno |
nell’ambiente vero |
|---|---|---|
0,10 |
\(2086 \pm 140\) |
\(193 \pm 58\) |
0,50 |
\(2060 \pm 277\) |
\(196 \pm 50\) |
1,00 |
\(1145 \pm 690\) |
\(868 \pm 511\) |
1,15 |
\(918 \pm 546\) |
\(1092 \pm 556\) |
1,30 |
\(732 \pm 269\) |
\(753 \pm 139\) |
La curva non è monotona: ha un massimo a \(\tau = 1{,}15\), dove l’agente va meglio nella realtà che nella propria immaginazione e supera largamente la soglia di risoluzione (750); a 1,30 ricade a tre punti sopra quella soglia, ma con una deviazione standard molto più stretta (139 contro 556). L’agente ha imparato comunque: è meno bravo, e più regolare. Gli autori lo dicono con parole loro: alzare \(\tau\) rende più difficile a C trovare politiche avversarie, ma alzarla troppo rende l’ambiente virtuale troppo difficile perché l’agente impari alcunché, e quindi è un iperparametro da tarare. Nel paper non c’è alcun criterio per sceglierlo a priori, né la pretesa che 1,15 valga altrove.
Resta da dire da dove viene il sogno, perché è il vincolo che decide tutto. V e M non nascono dal nulla: sono addestrati su rollout raccolti nell’ambiente vero da una policy casuale. Su Take Cover quella policy totalizza \(210 \pm 108\), contro i 1092 dell’agente finale: il modello del mondo dentro cui cresce il pilota è stato imparato guardando qualcuno che gioca malissimo. Gli autori dichiarano che questo basta perché i due compiti sono semplici, e per ambienti più ricchi prescrivono una procedura iterativa, in cui l’agente torna a raccogliere dati veri e il modello viene riaddestrato. Il limite, quindi, è che cosa la policy di raccolta ha avuto occasione di vedere, e non solo quanto M sia preciso. E il disallineamento fra \(P_\tau\) e la vera dinamica non si annulla: gli errori si compongono lungo il rollout, con la velocità che dipende da quanto la dinamica amplifica le perturbazioni. Su Take Cover il sogno dura quanto un episodio, fino a 2100 passi, e il pilota cresciuto lì dentro funziona lo stesso nel gioco vero: il compito è semplice, come dicono gli autori, e il rumore di M è alzato apposta. Negli ambienti più ricchi la linea Dreamer lo contiene con rollout di una quindicina di passi, che ripartono da stati visitati davvero.
Che gli errori si accumulino è una di quelle cose che si leggono e si accettano senza vederle. Fig. 31.3 la mette in scena sul mondo più piccolo che si possa immaginare: un’altalena che qualcuno continua a spingere. Va avanti e indietro, a ogni passaggio perde un po’ di slancio per l’attrito e ne riceve un po’ dalla spinta, e nella finestra disegnata la spinta vince: l’ampiezza cresce. Il modello che se la immagina sbaglia una cosa sola: quanta parte dello slancio sopravvive a ogni passaggio, 0,9973 invece di 0,97. Detto così è il 2,8 per cento in più. Detto dalla parte dell’attrito, però, l’errore è grosso: il modello crede che a ogni passaggio se ne perda lo 0,27 per cento invece del 3, cioè ne vede meno di un decimo. E l’altalena è spinta quasi al ritmo a cui oscillerebbe da sola, che è proprio il caso in cui un attrito sbagliato pesa di più.

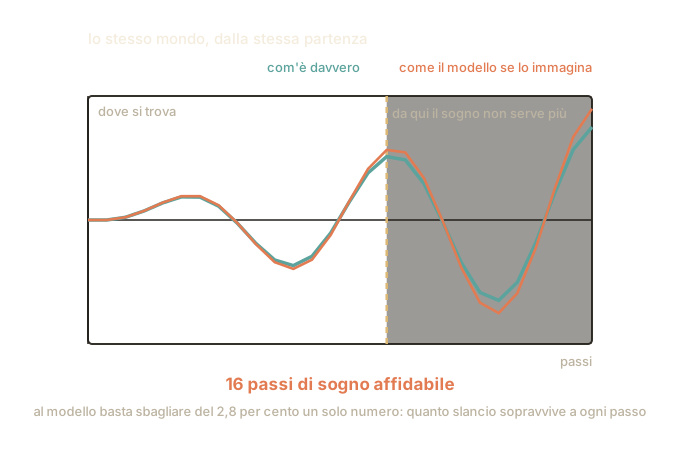
Fig. 31.3 La stessa spinta iniziale, due altalene quasi identiche: una vera e una immaginata. Per sedici passi il sogno è una fotocopia della realtà; poi si stacca. La fascia ombreggiata, a destra della riga tratteggiata, comincia dove lo scarto peggiore fin lì ha superato quello che si era deciso di tollerare: da lì in avanti il sogno non è più roba su cui allenare nessuno.#
La dinamica della figura sta in due righe, e un conto di poche righe ne ricava i numeri che contano:
import math

def altalena(a, passi=28):
    """La posizione passo per passo; a è la parte di slancio che sopravvive."""
    x, v, posizioni = 0.0, 0.0, []
    for t in range(passi):
        posizioni.append(x)
        # richiamo verso il centro, attrito, spinta periodica
        v += -0.35 * x - (1 - a) * v + 0.30 * math.sin(0.55 * t)
        x += v
    return posizioni

vera, sognata = altalena(0.97), altalena(0.9973)
scarto = [abs(p - q) for p, q in zip(vera, sognata)]
record = [max(scarto[:t + 1]) for t in range(len(scarto))]  # il peggiore fin lì

def passi_affidabili(tolleranza):
    return next(t for t, r in enumerate(record) if r > tolleranza)

# senza spinta e con a = 0.97, gli autovalori della dinamica hanno angolo
# arccos((a + 0.65) / (2 radice di a)): è il ritmo a cui l'altalena va da sola
ritmo = math.acos((0.97 + 0.65) / (2 * math.sqrt(0.97)))
n = passi_affidabili(0.25)
print(f"slancio che sopravvive: {100 * (0.9973 / 0.97 - 1):.1f}% in più; "
      f"attrito visto dal modello: {(1 - 0.9973) / (1 - 0.97):.2f} del vero")
print(f"ritmo proprio: {ritmo:.2f} radianti per passo, "
      f"ritmo della spinta: 0.55")
print(f"scarto al passo 17: {scarto[17]:.2f}, al passo 19: {scarto[19]:.2f}")
print(f"passi affidabili: {n} con tolleranza 0.25, "
      f"{passi_affidabili(0.50)} con 0.50")
print(f"escursione nei primi {n} passi: {max(vera[:n]) - min(vera[:n]):.2f}, "
      f"su tutti i {len(vera)}: {max(vera) - min(vera):.2f}")
slancio che sopravvive: 2.8% in più; attrito visto dal modello: 0.09 del vero
ritmo proprio: 0.61 radianti per passo, ritmo della spinta: 0.55
scarto al passo 17: 0.43, al passo 19: 0.06
passi affidabili: 16 con tolleranza 0.25, 21 con 0.50
escursione nei primi 16 passi: 5.38, su tutti i 28: 10.07
Tre cose conviene notare in Fig. 31.3, e nessuna delle tre si vede in un fotogramma.
La prima è che l’inizio è identico. Chi guardasse solo i primi passi concluderebbe che il modello è ottimo, ed è esattamente il modo in cui un modello del mondo viene di solito valutato: lo si fa partire da una situazione vera, gli si chiede che cosa succede subito dopo, si misura l’errore e si riparte da un’altra situazione vera. Un modello promosso a pieni voti da questa prova può essere bocciato appena lo si lascia andare da solo per venti passi, ed è quello che qui succede. Per questo un modello del mondo si giudica anche lasciandolo andare da solo per molti passi, o dal risultato di chi ci si allena dentro.
La seconda va guardata con attenzione, perché sembra dire il contrario. La distanza fra le due altalene, misurata passo per passo, a tratti si richiude: al passo 17 vale 0,43 e al 19 è scesa a 0,06, perché oscillando le due altalene ogni tanto si ritrovano per caso dalla stessa parte. Quello che non torna più indietro è il record, cioè il peggiore scarto visto fin lì, ed è l’unica misura onesta di un sogno: un modello che al passo 19 sembra tornato buono ha già sbagliato di 0,43, e tutti i passi seguenti partono da lì.
La terza è che il numero di passi affidabili non dipende solo dal modello: dipende da quanto scarto si è disposti a tollerare. Qui la tolleranza è 0,25, e per avere un metro basta guardare quanto si muove l’altalena: nei sedici passi buoni va su e giù di 5,38 unità, quindi si accetta uno scarto pari a meno di un ventesimo del movimento.[2] È una scelta, e cambiandola cambia la risposta: chi accetta il doppio, 0,50, si tiene ventuno passi invece di sedici. Chi non dichiara la tolleranza non sta dichiarando neanche l’orizzonte, cioè fino a che punto conviene dare retta al sogno.
C’è poi una cosa che la figura non può mostrare, ed è bene non dedurla da qui. Quanto in fretta lo scarto si apra non è una legge universale: dipende da quanto il sistema amplifica gli scossoni che riceve, e un’altalena spinta quasi al proprio ritmo li amplifica parecchio. La sezione sul reinforcement learning basato su modello lo scrive per bene, e mostra che su una dinamica abbastanza mite lo scarto, invece di esplodere, si assesta.
Dai sogni ai diamanti: la linea Dreamer#
World Models era una dimostrazione su due videogiochi. Trasformarla in un metodo generale è stato in buona parte il lavoro di Danijar Hafner e colleghi. Dreamer (2020) impara i comportamenti senza quasi mai uscire dal proprio modello: le partite su cui si allena sono tutte immaginate, e sono immaginate nello spazio dei codici, non in quello dei pixel. Una catena di passi generati uno dall’altro è un rollout, ed è esattamente il sogno di poco fa; la parola vale anche per le partite vere, quando si raccolgono una mossa alla volta. A imparare da quei rollout sono due reti che si danno il cambio, e le abbiamo incontrate nella sezione sul gradiente di policy: l’attore, che sceglie la mossa, e il critico, che stima quanto vale la situazione in cui l’attore si è cacciato, così che l’attore sappia subito se ha fatto bene invece di dover aspettare la fine della partita.
DreamerV2 (ICLR 2021) è il primo agente a raggiungere il livello umano sui 55 giochi Atari del banco di prova imparando i comportamenti soltanto dentro un modello del mondo addestrato a parte [HLNB21]. «Livello umano», lì, è una misura aggregata: si normalizza il punteggio di ogni gioco (0 per chi preme tasti a caso, 1 per un giocatore professionista) e la mediana sui 55 giochi supera 1. Il DQN, sei anni prima, era arrivato al livello di un collaudatore umano professionista su 49 giochi, con più del 75% del suo punteggio in 29 di essi [MKS+15], ma provando nel gioco vero; e MuZero (arXiv 2019, Nature 2020) si costruiva un modello di tutt’altro genere, buono per cercare la mossa al momento di agire e non per generare quel che si vedrà.
DreamerV3, pubblicato su Nature nel 2025 [HPBL25], affronta più di 150 compiti (robot simulati, Atari, navigazione 3D) con la stessa identica configurazione, senza ritocchi per dominio. Il risultato simbolo è Minecraft: applicato così com’è, è il primo algoritmo a raccogliere diamanti partendo da zero, senza dimostrazioni umane e senza un curriculum, cioè senza che nessuno gli abbia messo davanti gli esercizi in fila, dal facile al difficile. Il diamante sta in fondo a una catena di dodici tappe (il tronco, le assi, il banco da lavoro, i picconi di legno e di pietra, il ferro da fondere, il piccone di ferro, e così via), e l’ambiente premia ciascuna tappa la prima volta che la si raggiunge: premi rari, ma non uno solo in fondo. Le condizioni vanno dette insieme al risultato. L’ambiente è costruito dagli autori sopra MineRL, con le azioni scelte da un menu e partite di al più mezz’ora; in cento milioni di passi tutti e dieci gli agenti addestrati trovano almeno un diamante, ma a fine addestramento il diamante arriva nello 0,4% delle partite. È comunque il tipo di compito su cui, come mostra la sezione sull’esplorazione e la ricompensa con Montezuma’s Revenge, il DQN si arena.
I world model rispondono così, con un approccio model-based, alla fame di esperienza dei metodi model-free: ogni interazione vera con l’ambiente (un campione, nel lessico del rinforzo) migliora il modello oltre ai valori, e il modello genera poi altre esperienze al solo costo del calcolo.
Ogni esperienza vera, per il DQN [MKS+15], serve solo ad aggiustare di un soffio le valutazioni, come uno studente che di un’intera lezione trattiene una riga. Un world model spreme la stessa esperienza molto di più: ogni partita vera migliora la copia interna del gioco, e dentro la copia ci si allena quanto si vuole, al solo costo dell’elettricità. L’idea, in piccolo, la conosciamo già: è Dyna, l’architettura della sezione sul reinforcement learning basato su modello con cui Richard Sutton nel 1990 faceva alternare a un agente mosse vere e mosse «ripassate» in un modellino imparato del labirinto [Sut90]: un antenato a caselle dei sogni di Dreamer.
C’è un prezzo, però: quel che si impara nella copia vale quanto la copia. Se il modellino mette un muro dove il labirinto vero ha un corridoio, l’agente impara benissimo a schivare un muro che non esiste. E dove le partite vere costano poco, giocarle davvero resta competitivo: fra chi sogna e chi prova, la partita è ancora aperta.
Un metodo model-free come il DQN stima direttamente valori o policy dall’esperienza; un metodo model-based impara anche un modello della dinamica \(p(s_{t+1} \mid s_t, a_t)\) e lo usa per generare transizioni sintetiche. Dyna [Sut90] è lo schema capostipite: gli aggiornamenti di \(Q\) attingono sia da transizioni reali sia da transizioni simulate dal modello appreso, mescolando apprendimento e pianificazione. I Dreamer ne sono l’erede profondo, e il modello che adoperano non è farina del loro sacco: l’RSSM (il modello ricorrente a spazio di stati) lo introduce PlaNet [HLF+19], un anno prima, per pianificare dentro il latente. Il modello ha una memoria deterministica \(\mathbf{h}_t = f_\phi(\mathbf{h}_{t-1}, \mathbf{z}_{t-1}, a_{t-1})\), un codice stocastico \(\mathbf{z}_t \sim q_\phi(\mathbf{z}_t \mid \mathbf{h}_t, \mathbf{x}_t)\) che guarda il fotogramma e un predittore \(\hat{\mathbf{z}}_t \sim p_\phi(\hat{\mathbf{z}}_t \mid \mathbf{h}_t)\) che lo indovina senza guardarlo, ed è quello che gira nel sogno; teste separate predicono osservazione, ricompensa e continuazione \(c_t\) dell’episodio. La loss del modello è una variante dell’ELBO sequenziale,
con \(\mathcal{L}_{\text{pred}} = -\ln p_\phi(\mathbf{x}_t \mid \mathbf{z}_t, \mathbf{h}_t) - \ln p_\phi(r_t \mid \mathbf{z}_t, \mathbf{h}_t) - \ln p_\phi(c_t \mid \mathbf{z}_t, \mathbf{h}_t)\) per le tre teste, e il KL fra \(q_\phi\) e \(p_\phi\) spezzato in due termini con lo stop-gradient \(\mathrm{sg}\) su lati opposti: \(\mathcal{L}_{\text{dyn}} = \max\big(1, D_{\mathrm{KL}}[\mathrm{sg}(q_\phi) \,\|\, p_\phi]\big)\) addestra il predittore, e \(\mathcal{L}_{\text{rep}} = \max\big(1, D_{\mathrm{KL}}[q_\phi \,\|\, \mathrm{sg}(p_\phi)]\big)\) chiede all’encoder di farsi prevedere. I pesi sono \(\beta_{\text{pred}} = \beta_{\text{dyn}} = 1\) e \(\beta_{\text{rep}} = 0{,}1\), e la soglia di un nat (free bits) azzera il gradiente dei due KL quando sono già piccoli, così che il latente non si riduca a una dinamica banale. Attore e critico si addestrano dentro rollout immaginati di una quindicina di passi (\(H = 15\)), per contenere l’accumulo degli errori del modello. Il critico \(p_\psi\) minimizza \(-\sum_t \ln p_\psi(R^\lambda_t \mid \mathbf{s}_t)\) sul \(\lambda\)-ritorno \(R^\lambda_t = r_t + \gamma c_t\big[(1-\lambda)\, v(\mathbf{s}_{t+1}) + \lambda R^\lambda_{t+1}\big]\), con \(R^\lambda_T = v(\mathbf{s}_T)\), \(\mathbf{s}_t = (\mathbf{h}_t, \mathbf{z}_t)\), \(\gamma = 0{,}997\) e \(\lambda = 0{,}95\), che mescola la ricompensa sognata con il valore stimato oltre l’orizzonte. L’attore \(\pi_\theta\) massimizza
con \(S\) l’ampiezza fra i percentili 5 e 95 dei ritorni (stimata con una media mobile) e \(H\) l’entropia della policy. È REINFORCE su tutte le azioni: la prima versione retropropagava il ritorno attraverso la dinamica, mentre DreamerV2 [HLNB21] usava REINFORCE sulle sole azioni discrete. Gli stessi iperparametri reggono su domini diversi grazie a un insieme di tecniche di robustezza, quattro delle quali gli autori misurano togliendole una alla volta: il bilanciamento dei due KL con i free bits, che pesa più di tutte; osservazioni vettoriali passate per \(\mathrm{symlog}(x) = \mathrm{sign}(x)\ln(|x|+1)\); ricompense e valori predetti come distribuzione categoriale su intervalli spaziati in modo esponenziale, con il bersaglio spartito fra i due intervalli adiacenti (codifica two-hot); la normalizzazione dei ritorni per \(\max(1, S)\). A queste si aggiunge l’1% di distribuzione uniforme mescolato a ogni categoriale, perché nessuna diventi deterministica [HPBL25]. Su Minecraft l’agente riceve anche un vettore con il massimo raggiunto da ciascun oggetto dell’inventario, che gli dice quali tappe ha già superato, e la rottura dei blocchi segue la regola di un lavoro precedente, perché una policy che sorteggia le mosse farebbe fatica a tenere premuto un tasto a lungo. Quanto ai costi di calcolo, contro le 720 GPU per nove giorni di VPT (che usava dati umani), a DreamerV3 basta una sola GPU per lo stesso tempo. Il guadagno è l’efficienza campionaria; il tetto è la qualità del modello: la policy è buona quanto il sogno in cui è cresciuta, e su dinamiche caotiche o eventi rari i modelli restano il punto debole. Il confronto con i metodi model-free, competitivi quando i campioni costano poco, è tutt’altro che chiuso.
Una nota di prospettiva: «world model» è anche il nome che si dà ai grandi modelli generativi di video, promossi a simulatori del mondo fisico. La parentela concettuale c’è, e la prova richiesta è la stessa raccontata qui: reggere un intero addestramento al proprio interno, cioè farvi crescere un agente che poi, riportato fuori, funzioni davvero. Qualche lavoro comincia a mostrarla. Yang e colleghi allenano una policy dentro un simulatore video appreso e la portano su un robot vero senza altri ritocchi [YDG+24]. E la linea Dreamer, nel settembre 2025, ha fatto il passo che chiude il cerchio con i generatori di video: Dreamer 4 si costruisce un modello del mondo a trasformatore abbastanza veloce da girare in tempo reale su una scheda grafica, lo impara da 2.500 ore di partite a Minecraft giocate da persone, e allena la strategia soltanto lì dentro, senza mai toccare il gioco durante l’addestramento [HYL25]. È il primo agente a ottenere diamanti in quel modo: in partite di un’ora, guidato da una sequenza di compiti intermedi, ci riesce nello 0,7% dei casi. In un esperimento a parte, lo stesso modello impara come le azioni muovono il mondo anche da poco materiale: con i comandi registrati per sole 100 ore su 2.500 arriva a più dell’80% della precisione che ottiene con tutti, e il resto lo ricava dai video senza comandi, che è la logica dei simulatori video come Genie. È un videogioco e non un robot, e quanto lontano arrivi questa strada è una domanda aperta, non un risultato acquisito.
I tre moduli in PyTorch#
Chiudiamo con lo scheletro di V, M e C: poche righe, con le dimensioni di ogni pacchetto di numeri scritte nei commenti. Manca tutta la parte di addestramento: i tre moduli qui nascono con i pesi a caso e non imparano niente. Quello che il codice mostra è il percorso dei dati, cioè chi passa che cosa a chi, ed è quello vero.
import torch
from torch import nn

class EncoderVAE(nn.Module):
    """V: comprime un fotogramma 3x64x64 in un codice z di 32 numeri."""
    def __init__(self, dim_z=32):
        super().__init__()
        self.conv = nn.Sequential(
            nn.Conv2d(3, 32, 4, stride=2), nn.ReLU(),    # -> (32, 31, 31)
            nn.Conv2d(32, 64, 4, stride=2), nn.ReLU(),   # -> (64, 14, 14)
            nn.Conv2d(64, 128, 4, stride=2), nn.ReLU(),  # -> (128, 6, 6)
            nn.Conv2d(128, 256, 4, stride=2), nn.ReLU(), # -> (256, 2, 2)
            nn.Flatten(),                                # -> 1024
        )
        self.mu = nn.Linear(1024, dim_z)       # media del codice
        self.logvar = nn.Linear(1024, dim_z)   # log-varianza del codice

    def forward(self, x):                      # x: (B, 3, 64, 64)
        h = self.conv(x)                       # (B, 1024)
        mu, logvar = self.mu(h), self.logvar(h)
        eps = torch.randn_like(mu)             # riparametrizzazione
        return mu + torch.exp(0.5 * logvar) * eps   # z: (B, 32)

class ModelloRNN(nn.Module):
    """M: dato il codice e l'azione, predice il codice del passo dopo.
    (Versione deterministica; il paper usa una miscela di gaussiane.)"""
    def __init__(self, dim_z=32, dim_a=3, dim_h=256):
        super().__init__()
        self.lstm = nn.LSTM(dim_z + dim_a, dim_h, batch_first=True)
        self.testa = nn.Linear(dim_h, dim_z)   # media del prossimo z

    def forward(self, z, a, stato=None):       # z: (B, T, 32), a: (B, T, 3)
        ingresso = torch.cat([z, a], dim=-1)   # (B, T, 35)
        h, stato = self.lstm(ingresso, stato)  # h: (B, T, 256)
        return self.testa(h), stato            # z predetto: (B, T, 32)

class Controller(nn.Module):
    """C: policy lineare da codice e memoria all'azione."""
    def __init__(self, dim_z=32, dim_h=256, dim_a=3):
        super().__init__()
        self.lineare = nn.Linear(dim_z + dim_h, dim_a)   # 288*3+3 = 867

    def forward(self, z, h):                   # z: (B, 32), h: (B, 256)
        # azioni in [-1, 1]; gas e freno andrebbero poi riportati in [0, 1]
        return torch.tanh(self.lineare(torch.cat([z, h], dim=-1)))
E questo è il circuito del sogno: dieci passi interamente nello spazio dei codici, con M che fa da ambiente a se stesso. Le azioni qui sono casuali; nell’addestramento vero le sceglierebbe C, e il punteggio sognato guiderebbe l’evoluzione dei suoi pochi parametri (867 con le taglie di CarRacing usate in questo scheletro, 1088 su Take Cover, che è il gioco in cui il sogno è stato davvero adoperato per allenare).
Lo scheletro ha due limiti, e conviene saperli prima di provarci. Il primo: questo M predice un codice solo e non un ventaglio di continuazioni possibili, quindi la temperatura qui non c’è, perché non ci sono probabilità da rimescolare. Il secondo: con i pesi a caso il sogno dimentica subito da dove è partito, e cambiare il fotogramma di partenza, che è la prima cosa che viene in mente di provare, non produce nessun effetto visibile.
V, M, C = EncoderVAE(), ModelloRNN(), Controller()
for nome, rete in (("V, solo l'encoder", V), ("M, senza la miscela", M),
                   ("C", C)):
    print(f"{nome}: {sum(p.numel() for p in rete.parameters())} parametri")

x = torch.rand(1, 3, 64, 64)     # un fotogramma finto: batch 1, RGB, 64x64
z = V(x).unsqueeze(1)            # (1, 1, 32): il codice, come sequenza di 1 passo
stato = None                     # memoria (h, c) della LSTM, vuota all'inizio

for t in range(10):              # dieci passi di sogno: nessun ambiente
    a = torch.rand(1, 1, 3) * 2 - 1        # azione casuale in [-1, 1]
    z, stato = M(z, a, stato)              # il codice sognato: (1, 1, 32)

# il controller legge codice e memoria e restituisce i tre comandi
h = stato[0].squeeze(0)          # stato nascosto della LSTM: (1, 256)
comandi = C(z.squeeze(1), h)     # (1, 3): sterzo, acceleratore, freno
V, solo l'encoder: 755744 parametri
M, senza la miscela: 308256 parametri
C: 867 parametri
Il pilota è minuscolo, ed è proprio quello del paper. Gli altri due no, e per una ragione dichiarata: di V qui c’è solo l’encoder, mentre i 4,3 milioni del paper comprendono il decoder, e M non ha la testa a miscela, che nel paper lo porta a 422.368 parametri.
Il secondo limite si misura in poche righe. Si parte da cinque fotogrammi diversi invece che da uno, si danno a tutti e cinque le stesse identiche azioni, e si guarda quanto restano distanti fra loro i cinque codici sognati e i cinque comandi finali; e lo si rifà con quaranta inizializzazioni diverse, perché la risposta dipende dai pesi con cui si parte.
import statistics

@torch.no_grad()
def quanto_dimentica(seme):
    """Cinque partenze diverse, le stesse azioni: quanto restano distanti?"""
    torch.manual_seed(seme)
    V, M, C = EncoderVAE(), ModelloRNN(), Controller()
    z = V(torch.rand(5, 3, 64, 64)).unsqueeze(1)          # (5, 1, 32)
    prima = torch.cdist(z[:, 0], z[:, 0]).max()           # distanza massima
    stato = None
    for t in range(10):
        a = (torch.rand(1, 1, 3) * 2 - 1).expand(5, 1, 3)  # la stessa per tutti
        z, stato = M(z, a, stato)
    dopo = torch.cdist(z[:, 0], z[:, 0]).max()
    comandi = C(z[:, 0], stato[0][0])                     # (5, 3)
    divario = (comandi.max(dim=0).values - comandi.min(dim=0).values).max()
    return (prima / dopo).item(), divario.item()

prove = [quanto_dimentica(seme) for seme in range(40)]
fattori = [f for f, _ in prove]
basso, alto, mezzo = (round(v, -2) for v in          # alle centinaia
                      (min(fattori), max(fattori), statistics.median(fattori)))
print(f"distanza fra i codici, dopo dieci passi: divisa per {basso:.0f}"
      f"-{alto:.0f}, mediana {mezzo:.0f}")
print(f"comandi finali: mai più lontani di {max(d for _, d in prove):.4f}")
distanza fra i codici, dopo dieci passi: divisa per 2600-4900, mediana 3300
comandi finali: mai più lontani di 0.0014
Dieci passi di sogno bastano a dividere per qualche migliaio la distanza fra cinque partenze diverse, e i comandi finali coincidono fino al millesimo e mezzo: una ricorrenza con i pesi a caso non ricorda da dove è partita. È il contrario di quello che fa un M addestrato, la cui memoria serve proprio a portarsi dietro il passato.
Da ricordare
Un world model è una copia interna del mondo, imparata e ridotta all’osso: pensare e sbagliare lì dentro non costa quasi niente.
La ricetta di Ha e Schmidhuber (2018) è fatta di tre pezzi. V guarda e riassume: da un’immagine di 12.288 numeri ne tira fuori 32. M ricorda e prevede: dato il riassunto di adesso e la mossa scelta dice come potrebbe continuare, e non con una certezza ma con un ventaglio di possibilità. C decide, ed è ridicolmente piccolo: 867 manopole nel gioco di guida, 1088 nello sparatutto. La tesi dell’articolo è tutta qui: se i primi due hanno capito il mondo, al terzo basta un riflesso.
Il sogno è quel che succede quando si stacca il gioco e si lascia che M si racconti la partita da solo, un passo dopo l’altro. Il rischio è lo studente che si prepara all’esame inventandosi domande facili: l’agente scopre i difetti del proprio sogno e ci sguazza (certi suoi movimenti spegnevano le palle di fuoco mentre si formavano). Il rimedio è rendere il sogno più capriccioso del mondo vero, ma con misura: troppo capriccioso, e lì dentro non si impara più niente.
Allenato così e riportato nel gioco vero senza alcun ritocco, l’agente di Doom se la cava meglio della soglia che definisce il livello superato.
I Dreamer, negli anni successivi, portano l’idea a maturità. DreamerV3 (Nature, 2025) impara più di 150 compiti diversi con le stesse impostazioni, e in Minecraft arriva a scavare diamanti senza che nessuno gli abbia mai mostrato come si fa, anche se a fine addestramento ci riesce in quattro partite su mille. Dreamer 4 (2025) ci arriva allenandosi soltanto dentro un modello imparato da partite registrate, senza mai giocare.
Il guadagno è l’esperienza risparmiata: chi ha un modello si allena gratis nella propria testa, chi non ce l’ha deve provare tutto per davvero (nel gioco di guida, dove il pilota correva sul serio, sono servite quasi due milioni di gare). Il limite è sempre lo stesso: una strategia è buona quanto il sogno in cui è cresciuta, e un sogno è buono quanto le partite che gli sono state date da guardare.
Da ricordare
Un world model è una copia interna, compressa e imparata, dell’ambiente: pensare e sbagliare lì dentro costa quasi nulla.
La ricetta di Ha e Schmidhuber (2018): V, un VAE che comprime il fotogramma in 32 numeri; M, una MDN-RNN che, ingerito \([\mathbf{z}_t ; \mathbf{a}_t]\), predice la distribuzione del prossimo codice; C, una policy lineare. L’intelligenza sta nel modello, non nel controllore.
Le taglie cambiano con il gioco, e conta sapere quale: su CarRacing (\(\mathbf{z}\) a 32 numeri, LSTM a 256 unità, C a 867 parametri) il controller è evoluto nell’ambiente vero; l’esperimento addestrato solo nel sogno è VizDoom: Take Cover, con \(\mathbf{z}\) a 64, LSTM a 512 e C a 1088 parametri.
Il sogno è un rollout in cui M alimenta se stesso; ma V e M sono stati imparati su rollout raccolti nel mondo vero da una policy casuale, e gli autori dichiarano che basta perché i compiti sono semplici: per ambienti più ricchi prescrivono una raccolta iterativa. Su Take Cover il sogno dura un episodio intero (fino a 2100 passi); i Dreamer lo tengono a 15 passi.
Rischio del sogno: sfruttarne i difetti (le palle di fuoco spente mentre si formano; i mostri che non sparano a \(\tau\) bassa sono invece mode collapse di M, non una politica trovata da C). Rimedio: tarare la temperatura \(\tau\) verso l’alto, non alzarla e basta. Su Take Cover l’ottimo è \(\tau = 1{,}15\) (1092 nel mondo vero contro 868 a \(\tau = 1\)), e già a 1,30 si ricade a 753, tre punti sopra la soglia di risoluzione.
La linea Dreamer porta l’idea a maturità: DreamerV3 (Nature, 2025) impara nell’immaginazione latente su rollout brevi (una quindicina di passi), usa gli stessi iperparametri su più di 150 compiti e trova i diamanti in Minecraft senza dimostrazioni umane, con dodici tappe premiate e il diamante nello 0,4% delle partite a fine addestramento. Dreamer 4 (2025) li ottiene da dati registrati, allenando la policy soltanto nel modello.
È la risposta model-based alla fame di campioni del DQN, con un antenato preciso: Dyna di Sutton (1990). Ma l’efficienza vale dove la policy cresce nel sogno: su CarRacing C costa circa 1,8 milioni di episodi veri. Il limite resta la qualità del modello, e prima ancora la copertura dei dati su cui l’ha imparata.