


Reti convoluzionali (CNN)#
Per un computer una fotografia è una tabella di numeri: uno per ogni pixel, o tre se la foto è a colori. Prendi la foto di un gatto e spostala di dieci pixel a destra: per te è ancora un gatto; per la tabella, invece, quasi nessun numero è rimasto dov’era, e una rete fatta come quelle del capitolo sulle reti neurali si ritrova davanti un ingresso completamente nuovo. È il caso della rete con cui il capitolo su PyTorch riconosceva le cifre scritte a mano: srotolava la griglia di 28 per 28 pixel in una fila di 784 numeri e la passava a strati densi, e per quella fila una cifra spostata di due pixel è un’altra fila.
Questo scarto tra come noi vediamo un’immagine e come la vede una rete neurale ordinaria è il problema che le reti convoluzionali (Convolutional Neural Networks, CNN) sono nate per risolvere. L’idea affonda le radici negli stessi esperimenti di Hubel e Wiesel sulla corteccia del gatto: prende forma nel Neocognitron di Fukushima [Fuk80], una rete a strati che imita proprio quella catena di rivelatori, e arriva a maturazione nella LeNet-5 di Yann LeCun e colleghi (1998) [LBBH98], il riconoscitore di cifre scritte a mano di un sistema che leggeva gli assegni bancari.
Perché uno strato denso non basta#
Il pezzo che abbiamo già è lo strato in cui ogni neurone riceve tutti i numeri che escono dallo strato di sotto: con quello erano fatte tutte le reti del capitolo sulle reti neurali, e si chiama strato denso (fully-connected). Sulle immagini funziona male, e tanto peggio quanti più pixel ci sono, per due ragioni: il numero di pesi da imparare cresce con i pixel fino a diventare ingestibile, e lo strato tratta la stessa forma come due cose diverse a seconda di dove si trova nell’immagine.
Uno strato denso collega ogni pixel a ogni neurone. Sembra generoso, ma è uno spreco. Una foto a colori di 256×256 pixel non sono 65.536 numeri ma il triplo: ogni pixel ne porta tre, uno per il rosso, uno per il verde e uno per il blu, e \(256 \times 256 \times 3\) fa 196.608, quasi 200.000. Uno strato denso con 1000 neuroni ha un peso per ogni coppia (numero in ingresso, neurone): \(196.608 \times 1000\), cioè quasi 200 milioni di pesi da imparare, solo per il primo strato. Troppi. Con tanti numeri da regolare, la rete ha modo di imparare a memoria le foto che le mostri invece di quello che hanno in comune: sulle foto già viste va benissimo, sulla prima foto nuova sbanda.
E c’è un problema più profondo. Se la rete impara a riconoscere un occhio quando compare in alto a sinistra, non sa nulla dello stesso occhio in basso a destra: per lei sono due cose diverse, perché occupano posizioni (e quindi pesi) diversi. Manca l’idea che un motivo è lo stesso ovunque appaia.
Uno strato fully-connected su un input \(\mathbf{x}\in\mathbb{R}^{D}\) con \(h\) unità richiede \(h\cdot D\) pesi. Per un’immagine RGB \(256\times256\) si ha \(D = 256\cdot256\cdot3 \approx 1{,}97\times10^{5}\): con \(h=1000\) servono circa \(2\times10^{8}\) parametri, un invito all’overfitting.
Soprattutto, lo strato denso non è equivariante alla traslazione: un pattern spostato di un vettore \(\boldsymbol{\Delta}\) attiva pesi diversi, perché l’indice della componente cambia. Le CNN recuperano l’equivarianza grazie alla sola condivisione dei pesi: sposti l’input, e l’attivazione si sposta con lui. L’equivarianza vale all’interno, con due riserve: la cornice di zeri la rompe sul bordo, dove il motivo perde i contributi che cadono fuori; inoltre, con un passo maggiore di uno sopravvivono solo gli spostamenti multipli del passo. L’altro vincolo, la connettività locale, dà i pochi parametri e non l’equivarianza: uno strato locally connected, che guarda una finestra piccola ma con pesi diversi in ogni posizione, equivariante non è. Attenzione a non chiamarla invarianza, che è un’altra proprietà (la risposta non cambia affatto) e la convoluzione non la dà: semmai la porta la testa della rete, con il global average pooling di Network in Network, che incontreremo in Architetture storiche.
La convoluzione: un filtro che scorre#
Il cuore della rete è la convoluzione: un piccolo filtro (o kernel), tipicamente \(3\times3\), che scivola su tutta l’immagine. In ogni posizione sovrappone il filtro alla porzione di immagine sottostante, moltiplica valore per valore e somma il tutto in un numero, che è il prodotto scalare fra la porzione e il filtro. Quel numero è alto dove la porzione ha la forma del motivo che il filtro codifica: un bordo verticale, una macchia di colore, una trama.
I nove numeri di cui un filtro \(3\times3\) è fatto non li scrive nessuno a mano: sono pesi come tutti gli altri della rete, e li fissa l’addestramento.

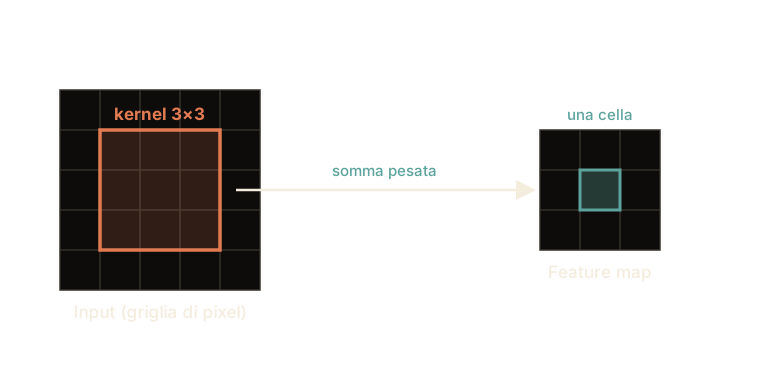
Fig. 10.2 Il filtro (o kernel) di \(3\times3\) copre nove caselle dell’immagine per volta: i nove valori vengono moltiplicati ciascuno per il proprio peso e poi sommati, e il totale diventa una casella della mappa dei risultati, la feature map. Facendo scorrere la finestra si riempie l’intera mappa.#
Come mostra Fig. 10.2, il filtro guarda solo una finestra per volta, ma quella stessa finestra visita ogni angolo dell’immagine.
Uno stampino traforato con nove caselle scorre su una pagina a quadretti. In ogni punto guardi i nove quadretti che si affacciano dai buchi, moltiplichi ciascuno per il numero scritto sul suo buco e sommi: viene un totale solo, e quello scrivi su un foglio nuovo. I nove numeri dello stampino sono la ricetta, e sono quelli che la rete impara: all’inizio sono presi a caso e non trovano niente, e a forza di esempi diventano un cercatore di bordi o di macchie. Lo stampino, in altre parole, è una domanda che la rete impara a formulare da sé.
Il punto è che lo stampino non cambia mai mentre scorre: la ricetta è la stessa in tutti i punti della pagina. Se è brava a trovare un bordo, lo trova ovunque nell’immagine, in alto come in basso. E ogni totale finisce sul foglio nuovo nel punto corrispondente: sposta il bordo di due quadretti e si sposta di due quadretti anche il segno che lo segnala. È questo il trucco che mancava allo strato denso.
In due dimensioni, con input \(I\) e kernel \(K\), l’operazione (tecnicamente una cross-correlazione, come da convenzione nelle librerie di deep learning) è
Qui \(S(i,j)\) è il valore in posizione \((i,j)\) della mappa di uscita, mentre \(m,n\) scorrono sulle celle del kernel. Il punto da vedere è che \(K\) non dipende da \((i,j)\): è lo stesso filtro in ogni posizione, ed è da lì, e solo da lì, che viene l’equivarianza. La dimostrazione è una riga. Sia \(T_{\boldsymbol{\Delta}}\) la traslazione di \(\boldsymbol{\Delta} = (\Delta_1, \Delta_2)\), \((T_{\boldsymbol{\Delta}} I)(i,j) = I(i-\Delta_1,\, j-\Delta_2)\); allora
cioè filtrare l’immagine traslata dà la mappa traslata. Il passaggio usa che \(K\) sia lo stesso in \((i,j)\) e in \((i-\Delta_1, j-\Delta_2)\), e che la somma corra su tutto il piano: su un’immagine finita vale lontano dal bordo, e con uno stride \(s\) solo per spostamenti multipli di \(s\). La convoluzione in senso stretto, \(\sum_m\sum_n I(i-m,\,j-n)\,K(m,n)\), differisce dalla cross-correlazione solo per il kernel ribaltato, e siccome \(K\) si impara la differenza non ha conseguenze. Con più canali in ingresso (es. RGB), \(F\) filtri, un bias per filtro e una funzione di attivazione \(g\) (di solito la ReLU), la stessa formula si riscrive con gli indici:
I simboli: \(f\) indicizza i filtri e quindi le mappe che escono, \(c\) i canali d’ingresso, \(K_{f,c,m,n}\) è il peso del filtro \(f\) per canale \(c\) e posizione \((m,n)\), \(a_{f,i,j}\) l’attivazione risultante. Il kernel ha dunque quattro indici, e il numero \(C\) dei canali d’ingresso di uno strato è l’\(F\) dello strato sotto: ogni filtro legge tutte le mappe che arrivano, non una.

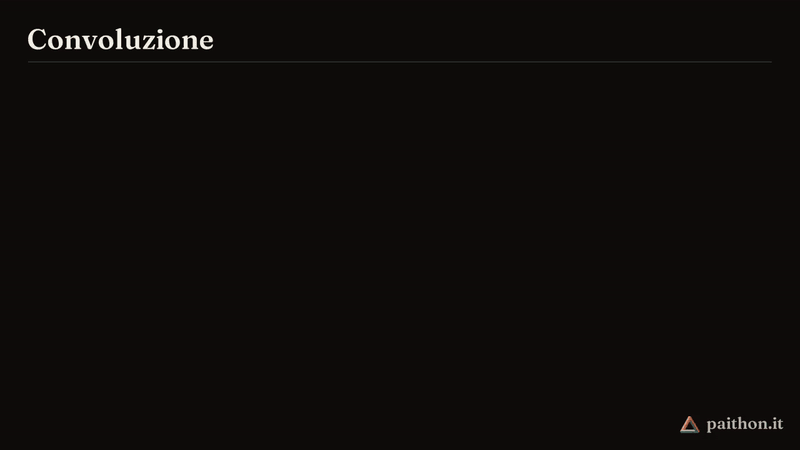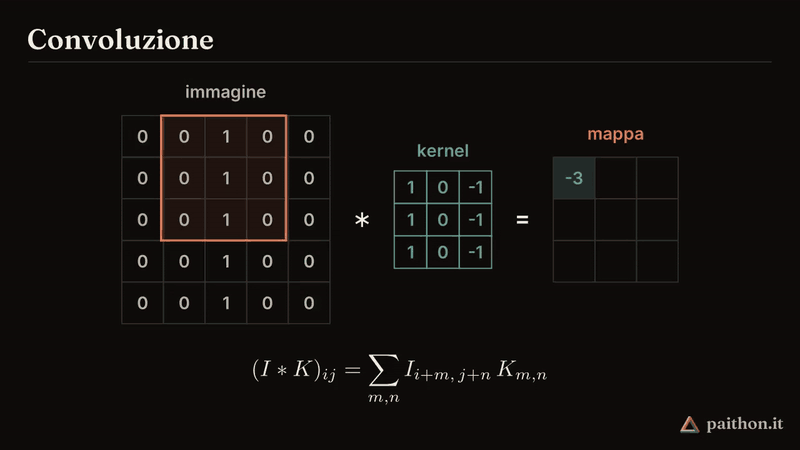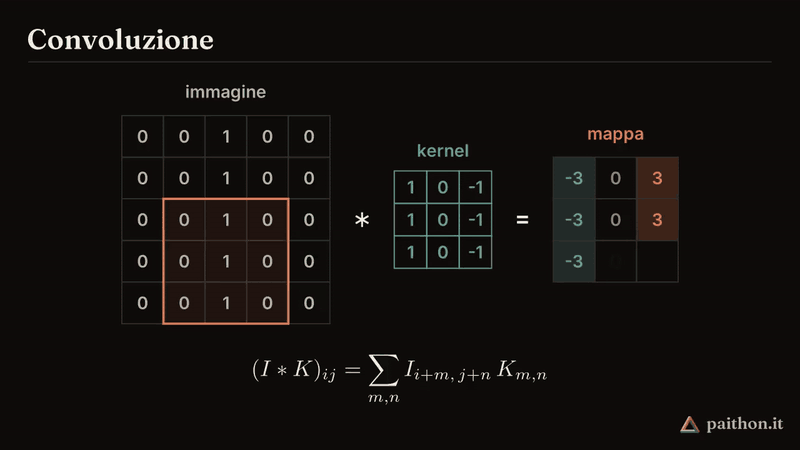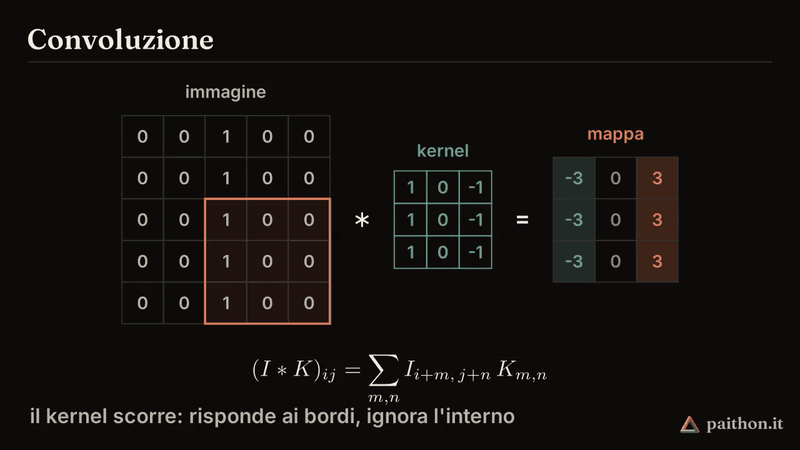
Fig. 10.3 La stessa operazione in movimento, con un filtro che cerca bordi verticali e un’immagine con una barra verticale spessa un pixel. Sotto i tre riquadri, la regola scritta in simboli, che dice questo: moltiplica i nove valori sotto la finestra per i nove pesi del filtro, e somma tutto.#
I conti della Fig. 10.3 si rifanno a mano. Il filtro è fatto di tre righe uguali, ciascuna con i pesi \(1\), \(0\), \(-1\); la barra vale \(1\) e lo sfondo \(0\). Quando la barra finisce sotto la colonna destra del filtro, ogni riga contribuisce \(-1\) e le tre righe insieme danno \(-3\); quando finisce sotto la colonna sinistra, \(+3\); quando è al centro, il peso che la moltiplica è \(0\) e le altre due colonne vedono solo sfondo. Il filtro non misura quanto la barra è chiara: misura il contrasto fra il lato sinistro e il lato destro della propria finestra, e il segno dice da che parte sta il chiaro. È già un abbozzo di ciò che i primi strati di una CNN imparano da soli.
Campi recettivi locali e pesi condivisi#
Due principi rendono tutto ciò possibile, e tornano dappertutto. Il primo è il campo recettivo locale: ogni casella della mappa dei risultati (che è poi un neurone come quelli del capitolo sulle reti neurali, solo con pochissimi ingressi) guarda una finestra piccola, non l’immagine intera. Il secondo è la condivisione dei pesi: lo stesso filtro si usa in ogni posizione, quindi i pochi numeri che lo compongono vengono riutilizzati migliaia di volte.
Un filtro \(3\times3\) su un’immagine a colori guarda nove caselle, e di ogni casella i tre numeri del colore: \(3\times3\times3 = 27\) pesi.
Più un ultimo numero, sempre lo stesso, che si somma al risultato in ogni posizione. Alza o abbassa in blocco l’intera mappa, e serve a regolare quanto forte debba essere la somiglianza prima che il filtro dica «l’ho trovato»: se vale \(-2\), una somiglianza da 1 non basta più a produrre un risultato positivo. Si chiama bias, e fa \(27+1 = 28\) numeri da imparare per filtro.
Uno stampino solo trova un motivo solo, quindi se ne usano tanti, tutti della stessa forma e con dentro numeri diversi: chi ha imparato i bordi verticali, chi le macchie chiare, chi una trama. Con 32 stampini sono \(28 \times 32 = 896\) pesi, meno di mille, contro i milioni dello strato denso. Con così pochi numeri da regolare resta molto meno spazio per imparare le foto a memoria. E restano 896 anche su una foto con quattro volte i pixel: lo stampino non si allarga, fa solo più giri, mentre lo strato denso avrebbe preteso quattro volte i pesi.
Da 32 stampini escono 32 fogli, ed è qui che si vede come si impilano gli strati. Lo stampino del secondo strato non scorre su un foglio solo: scorre su tutti e 32 insieme, e di ogni casella legge i 32 numeri, come quello del primo leggeva i tre del colore. Per questo trova cose che il primo non poteva trovare: mette insieme un bordo verticale e uno orizzontale, e quello che ne esce è un angolo.
E la ragione per cui la rete impara cosa cercare e non dove non è che i pesi siano pochi: è che lo stampino non cambia mai mentre scorre. I pesi pochi sono un altro guadagno, e viene dalla finestra piccola.
Un layer convoluzionale con \(F\) filtri, kernel \(k\times k\) e \(C\) canali in ingresso ha \(F\,(k^2 C + 1)\) parametri, e nel conto la risoluzione dell’immagine non compare: su una foto con quattro volte i pixel il lavoro da fare quadruplica, i pesi da imparare restano quelli. Attenzione a non trasportare il risparmio dai parametri ai conti: le moltiplicazioni sono \(o^2 F k^2 C\) con \(o\) il lato della mappa d’uscita, e in questo conto la risoluzione compare in pieno. Il crollo di cinque ordini di grandezza è sui pesi; sul calcolo il vantaggio è molto più modesto, ed è per questo che le CNN restano care da addestrare. Il conto spiega anche il ritmo con cui le reti profonde crescono: dimezzare \(o\) raddoppiando sia \(F\) sia \(C\) lo lascia invariato, \((o/2)^2\,(2F)\,k^2\,(2C) = o^2 F k^2 C\), e ogni blocco costa quanto il precedente. È la condivisione dei pesi (parameter sharing) che impone l’equivarianza traslazionale come prior strutturale, riducendo drasticamente lo spazio delle ipotesi e quindi il rischio di overfitting.
L’uscita di un filtro è una feature map: una mappa che segna, punto per punto, dove nell’immagine è presente il motivo cercato. Uno strato convoluzionale produce una pila di feature map, una per filtro, e lo strato dopo le riceve come canali d’ingresso, nello stesso modo in cui il primo riceve i tre colori di una foto. I primi strati imparano motivi elementari (bordi, angoli), i più profondi li combinano in parti sempre più astratte (occhi, ruote, volti).
Quella pila decide anche la forma di un filtro: Fig. 10.4 lo disegna come un mazzo di griglie, alto quanto le mappe che gli arrivano.
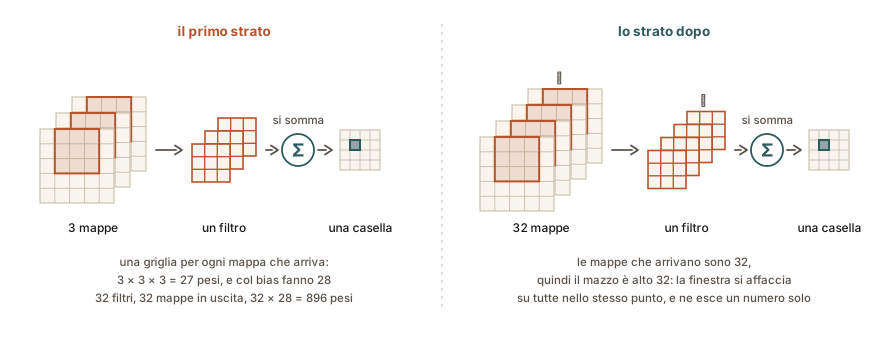
Fig. 10.4 Lo stesso gesto, a due strati diversi. La finestra si affaccia su tutte le mappe che arrivano, nello stesso punto di ognuna, e i prodotti si sommano tutti insieme in un numero solo: quindi un filtro è un mazzo di griglie alto quanto le mappe che arrivano, tre al primo strato e trentadue al secondo.#
Il pooling: mappe più piccole, e cosa si guadagna#
Nelle architetture classiche, dopo la convoluzione si applica quasi sempre il pooling, che rimpicciolisce le feature map riassumendo ogni zona in un numero solo (molte reti recenti le rimpiccioliscono invece con una convoluzione che avanza di due pixel per volta). Il più comune è il max pooling, che di ogni finestra (di solito \(2\times2\)) conserva il massimo: su un quadratino che contiene \(1\), \(7\), \(3\) e \(2\), esce \(7\), e gli altri tre numeri si perdono. L’altro modo è tenere la media, e la variante che fa la media di una mappa intera invece che di una finestra torna nella sezione Architetture storiche.
Il max pooling è come chiedere, per ogni quadratino \(2\times2\): «il motivo qui intorno c’è, sì o no?», tenendo solo la risposta più forte. Non c’è nessun peso da imparare: la regola è una sola, «tieni il più grande». Dimezza larghezza e altezza, quindi tutto quello che viene dopo lavora su un quarto dei numeri. E ogni casella rimasta ne riassume quattro, così il filtro dello strato successivo, pur restando di nove caselle, arriva a coprire una fetta di immagine larga il doppio. Sono questi i guadagni sicuri.
Ce n’è un altro, ma più piccolo di come lo si racconta di solito. Se il motivo si sposta di un pixel e resta dentro lo stesso quadratino, il massimo di quel quadratino non cambia, e dopo il pooling la mappa è identica: lo spostamento è stato assorbito. Se invece scavalca il confine fra due quadratini, cambia eccome. Su una mappa piena di valori diversi uno spostamento di un solo pixel altera quasi sempre il risultato. Sfumare un poco la mappa prima di riassumerla, così che un valore forte si spanda anche sui vicini, fa assorbire una parte degli spostamenti che scavalcano il confine.
È un baratto, non un regalo: si guadagnano leggerezza e un po’ di tolleranza, si perde precisione su dove le cose stanno.
Per una regione \(\mathcal{R}_{i,j}\) della feature map,
Non ha parametri da apprendere. Sottocampionando, allarga il campo recettivo dei layer successivi; e in cambio dell’equivarianza esatta, che con finestre prese a passo 2 sopravvive solo per gli spostamenti pari, offre una modesta tolleranza alle traslazioni di un pixel. Modesta è la parola giusta: su un picco isolato spostato di un pixel la mappa risultante resta identica circa una volta su due, su feature map dense di valori diversi praticamente mai. La causa ha un nome, aliasing: sottocampionare senza prima togliere le frequenze alte con un filtro passa-basso ignora il teorema del campionamento, e una traslazione di un pixel può cambiare l’uscita di molto. Vale per il max pooling, per il pooling medio e per la convoluzione a passo due, e filtrare prima di sottocampionare restituisce parte della tolleranza [Zha19]. È un baratto e non un’aggiunta gratuita.
La tolleranza agli spostamenti si misura, e il risultato è più magro di come viene raccontata di solito. Si prende una mappa, la si legge due volte sfalsata di un pixel, e si conta quante volte il pooling restituisce esattamente la stessa cosa.
import torch
from torch.nn.functional import max_pool2d

def dopo_lo_spostamento(mappa):
    """La stessa mappa letta due volte, sfalsata di un pixel, dopo il pooling."""
    return max_pool2d(mappa[..., :-1], 2), max_pool2d(mappa[..., 1:], 2)

lato = 16
uguali = 0
for riga in range(lato):                 # un picco isolato, una posizione per volta
    for colonna in range(lato):
        m = torch.zeros(1, 1, lato, lato + 1)
        m[0, 0, riga, colonna] = 1.0
        a, b = dopo_lo_spostamento(m)
        uguali += int(torch.equal(a, b))
print(f"picco isolato: identica {uguali} volte su {lato * lato}")

g = torch.Generator().manual_seed(0)     # una mappa fitta di valori tutti diversi
uguali = sum(int(torch.equal(*dopo_lo_spostamento(
                 torch.rand(1, 1, lato, lato + 1, generator=g))))
             for _ in range(200))
print(f"mappa densa:   identica {uguali} volte su 200")
picco isolato: identica 128 volte su 256
mappa densa:   identica 0 volte su 200
Metà delle volte su un picco isolato, mai su una mappa piena: il picco sopravvive quando lo spostamento non gli fa scavalcare il confine fra due quadratini, e su una mappa fitta basta che una finestra cambi il proprio massimo perché la mappa risultante sia un’altra.
L’architettura tipica#
Lo schema classico alterna blocchi conv → ReLU → pool, ripetuti alcune volte, e chiude con uno o più strati densi che trasformano le feature astratte in una decisione, cioè nella classe dell’immagine: gatto, cane, tazza da caffè.
La ReLU sta in mezzo, fra il filtro e il pooling, ed è lei a rendere davvero diversi due strati impilati. Una convoluzione è fatta di moltiplicazioni e somme, e applicarne una al risultato di un’altra, senza niente in mezzo, darebbe ancora moltiplicazioni e somme: una convoluzione sola, un po’ più larga. È il piegare i numeri (buttare via i negativi) a far sì che il secondo strato veda qualcosa che il primo non poteva produrre da solo.
Due manopole governano poi lo scorrimento del filtro: lo stride, di quanti pixel salta la finestra a ogni passo, e il padding, la cornice di zeri aggiunta ai bordi per non perdere i pixel di frontiera. Insieme alla larghezza della finestra, e alla dilatazione quando c’è, decidono quanto viene grande la mappa che esce.
Quanto viene grande la mappa che esce? Se la finestra avanza di un pixel per volta (stride 1) e all’immagine si aggiunge attorno una cornice spessa uno (padding 1), un filtro \(3\times3\) restituisce una mappa grande esattamente quanto l’immagine di partenza: da \(28\times28\) pixel escono \(28\times28\) risultati. Senza quella cornice ne uscirebbero \(26\times26\), e il conto si fa a mente: la finestra è larga 3, può cominciare dal primo pixel e deve finire entro il ventottesimo, quindi le posizioni buone sono \(28 - 3 + 1 = 26\), una in meno su ciascun lato, due in tutto. Se invece si tiene la cornice e si porta il passo a 2, la finestra salta una posizione ogni volta e la mappa esce dimezzata, \(14\times14\).
Col passo a 2 il conto non sempre torna in pieno, e allora tocca scegliere. Su una striscia larga 61 quadretti, una finestra da 2 come quella del pooling, che avanza di 2, ne copre 60 e ne lascia fuori uno: o si butta via l’ultima colonna, e i risultati sono 30, oppure la si tiene con la finestra mezza fuori dal foglio, e sono 31. Due persone che scelgono in modo diverso si ritrovano con mappe di dimensione diversa, convinte di aver costruito la stessa rete.
C’è anche il modo di allargare la finestra senza aggiungere caselle: le nove caselle che legge si distanziano, una ogni due quadretti invece che attaccate. Legge sempre nove numeri, ma la fetta che copre è larga cinque quadretti invece di tre, e con la solita cornice da uno la mappa esce \(26\times26\) invece di \(28\times28\): guarda più lontano e mangia più bordo. Si chiama dilatazione.
La dimensione di uscita lungo un asse è
dove \(n\) è la dimensione d’ingresso, \(k\) quella del kernel, \(p\) il padding
(uguale sui due lati: dove non lo è, il \(2p\) va letto come
\(p_{\text{sx}} + p_{\text{dx}}\)), \(s\) lo stride e \(\lfloor \cdot \rfloor\) la
parte intera inferiore. Un esempio con i
numeri di una rete che lavora su immagini \(28\times28\): ingresso \(n=28\), kernel
\(k=3\), padding \(p=1\), stride \(s=1\), e
\(o = \lfloor(28 + 2 - 3)/1\rfloor + 1 = 28\), la risoluzione non cambia. Con
padding="same" si sceglie appunto \(p\) affinché \(o=n\): vale a stride 1, e con
uno stride maggiore PyTorch non prova a indovinare, solleva un errore
(TensorFlow invece prende \(o = \lceil n/s \rceil\), che è un’altra
convenzione).
Due precisazioni, perché la formula così com’è nasconde altrettante ipotesi.
La prima: a stride 1 la parte intera non serve, perché dividere per uno dà
sempre un intero. Conta da stride 2 in su, dove le posizioni in cui la finestra
sporgerebbe dal bordo semplicemente non si contano. Qui occorre ricordare che
arrotondare per difetto è una convenzione, non l’unica possibile:
nn.MaxPool2d(..., ceil_mode=True) arrotonda per eccesso, tenendo anche
l’ultima finestra incompleta. Con \(n=61\) e \(k=s=2\) la prima dà \(30\) e la
seconda \(31\), e due reti che si credono uguali si ritrovano con mappe di
dimensione diversa.
La seconda: la formula assume dilatazione 1, cioè un filtro i cui pesi guardano pixel adiacenti. Con dilatazione \(d\) i pesi si distanziano fra loro e il filtro copre \(d(k-1)+1\) pixel invece di \(k\), quindi
Con \(n=28\), \(k=3\), \(p=1\), \(s=1\) e \(d=2\) l’uscita è \(26\), non \(28\): un \(3\times3\) dilatato di due è largo cinque pixel e mangia i bordi come una \(5\times5\).
In PyTorch l’intera architettura sta in poche righe:
import torch
from torch import nn

model = nn.Sequential(
    # blocco 1: 32 filtri 3x3, mappe grandi come l'input
    nn.Conv2d(1, 32, 3, padding="same"), nn.ReLU(),
    nn.MaxPool2d(2),
    # blocco 2: più filtri man mano che le mappe rimpiccioliscono.
    # Il primo numero è 32: ogni filtro di questo strato legge tutte
    # e 32 le mappe che escono dal blocco di sopra.
    nn.Conv2d(32, 64, 3, padding="same"), nn.ReLU(),
    nn.MaxPool2d(2),
    nn.Flatten(),                  # srotola la pila in una fila di numeri
    nn.Linear(64 * 7 * 7, 10),     # 10 classi (logit)
)

# quattro immagini in scala di grigi da 28x28: (immagini, canali, righe, colonne)
x = torch.zeros(4, 1, 28, 28)
for strato in model:
    x = strato(x)
    print(f"{strato.__class__.__name__:10s} -> {tuple(x.shape)}")
Conv2d     -> (4, 32, 28, 28)
ReLU       -> (4, 32, 28, 28)
MaxPool2d  -> (4, 32, 14, 14)
Conv2d     -> (4, 64, 14, 14)
ReLU       -> (4, 64, 14, 14)
MaxPool2d  -> (4, 64, 7, 7)
Flatten    -> (4, 3136)
Linear     -> (4, 10)
Nota il ritmo ricorrente: le mappe si restringono (28 → 14 → 7), mentre il numero di filtri cresce (32 → 64). È uno scambio: la rete rinuncia a sapere dove le cose stanno con precisione, e in cambio si porta dietro più tipi diversi di cose trovate, finché le poche posizioni rimaste bastano allo strato denso per decidere. E ha anche una ragione di costo. Le moltiplicazioni di uno strato crescono con l’area della mappa che esce, con il numero dei filtri e con quello dei canali che arrivano: nelle reti più profonde, dove a ogni dimezzamento del lato raddoppiano sia i filtri sia i canali, l’area si divide per quattro e il resto si moltiplica per quattro, e ogni blocco costa quanto il precedente.
Un dettaglio tutto di PyTorch: nn.Flatten() srotola la pila di mappe in
un’unica fila di numeri, e lo strato denso finale, che in PyTorch si chiama
nn.Linear, vuole sapere esattamente quanti ne riceve (qui
\(64 \cdot 7 \cdot 7 = 3136\), la penultima riga dell’uscita). Quel conto resta
a chi progetta la rete, a meno di usare nn.LazyLinear, che ricava il numero
degli ingressi dalla prima chiamata.
Lo stesso conto con meno moltiplicazioni#
Il numero di moltiplicazioni di una convoluzione \(3\times3\) sembra fissato: nove per ogni casella della mappa, per ogni filtro e per ogni canale. Per i filtri piccoli, però, le librerie che eseguono le convoluzioni su una GPU possono usare l’algoritmo di Winograd, che dà lo stesso risultato con meno moltiplicazioni e qualche somma in più (lo stesso identico, se i conti si facessero senza arrotondare). L’idea viene dagli algoritmi di filtraggio minimo che Shmuel Winograd descrisse nel 1980 [Win80], e alle reti convoluzionali la portarono Andrew Lavin e Scott Gray nel 2016 [LG16].
Basta una riga sola per vedere il trucco. Lo stampino di tre caselle, su una striscia di quattro quadretti, trova posto in due punti, e il conto normale costa sei moltiplicazioni, tre per posizione. Con i quadretti \(1, 2, 3, 4\) e i pesi \(1, 2, 3\) escono \(1 + 4 + 9 = 14\) e \(2 + 6 + 12 = 20\).
Si può fare con quattro, una per quadretto della striscia, e con meno non si può. Prima si preparano quattro miscele dello stampino: il primo peso da solo, \(1\); metà della somma dei tre, \((1 + 2 + 3)/2 = 3\); metà della stessa somma col secondo peso tolto invece che aggiunto, \((1 - 2 + 3)/2 = 1\); e l’ultimo peso da solo, \(3\). Poi quattro miscele della striscia, fatte di sole somme e differenze: il primo quadretto meno il terzo, il secondo più il terzo, il terzo meno il secondo, il secondo meno il quarto, cioè \(-2, 5, 1, -2\). Ora le moltiplicazioni: ogni miscela della striscia per la sua miscela dello stampino, quattro in tutto, e vengono \(-2, 15, 1, -6\). Infine si ricompone, di nuovo con somme e differenze: il primo risultato è la somma dei primi tre prodotti, \(-2 + 15 + 1 = 14\), il secondo è il secondo prodotto meno il terzo meno il quarto, \(15 - 1 - (-6) = 20\). E torna con qualunque striscia e qualunque stampino. Il trucco sta nei quadretti che le due posizioni hanno in comune, il secondo e il terzo: il conto normale li moltiplica due volte, una per posizione, mentre le miscele li sommano e li sottraggono prima di moltiplicare, e così bastano quattro moltiplicazioni in tutto, una per quadretto della striscia.
Contate tutte, però, le operazioni sono aumentate: prima sei moltiplicazioni e quattro somme, adesso quattro e otto. Il guadagno arriva in una rete vera, dove le miscele si preparano una volta e servono molte volte. Quelle di uno stampino si fanno una volta sola, divisioni comprese, perché lo stampino non cambia mentre scorre. Quelle di un pezzo d’immagine servono a tutti gli stampini che ci passano sopra, uno per ogni foglio che esce. E l’ultimo passo, la ricomposizione che dai quattro prodotti tira fuori 14 e 20, si può rimandare: uno stampino del secondo strato legge insieme i 32 fogli usciti dallo strato prima, e invece di ricomporre 32 volte si sommano prima i prodotti, foglio per foglio e posto per posto, e si ricompone una volta sola il totale. Alla fine restano da pagare quasi soltanto le moltiplicazioni, che nei chip costano più delle somme.
Sull’immagine il gioco si fa lungo le righe e lungo le colonne: un pezzo di quattro quadretti per quattro dà i quattro risultati di un quadratino di due per due, e invece di nove moltiplicazioni per ciascuno dei quattro, trentasei in tutto, ne bastano sedici, di nuovo una per quadretto del pezzo; con pezzi più grandi il risparmio cresce ancora.
Il prezzo è la precisione. Un calcolatore tiene di ogni numero un numero fisso di cifre e arrotonda il resto. Con le nostre metà i conti tornano esatti, ma le miscele dei pezzi più grandi (quattro risultati di fila, che con uno stampino da tre vogliono sei quadretti) usano numeri come \(8\) e un ventiquattresimo, e quando le cifre sono poche un arrotondamento di un millesimo su una miscela moltiplicata per \(8\) torna nel risultato come otto millesimi. Per questo i pezzi restano piccoli, e anche perché le miscele di un pezzo grande costano tante somme da mangiarsi il risparmio. E il trucco vuole uno stampino piccolo che avanza di un quadretto alla volta: se salta di due, le posizioni vicine hanno meno quadretti in comune. Passi lunghi e stampini grandi si spezzano prima in pezzi di quel tipo, oppure si usa un altro trucco, pensato per gli stampini grandi, che scompone immagine e stampino in onde.
Sia \(F(m, r)\) il calcolo di \(m\) uscite consecutive di un filtro a \(r\) coefficienti (il \(k\) del conto delle dimensioni: \(r\) è la lettera di Lavin e Gray), che in modo diretto costa \(mr\) moltiplicazioni. Winograd mostrò che ne bastano \(m + r - 1\), una per ciascun valore d’ingresso che le \(m\) uscite leggono, e che non si può fare con meno [Win80]. La costruzione passa dalla moltiplicazione di polinomi. L’algoritmo di Toom e Cook moltiplica un polinomio di grado \(m - 1\) per il filtro, letto come polinomio di grado \(r - 1\): li valuta in \(m + r - 1\) punti, moltiplica i valori e torna ai coefficienti per interpolazione. \(F(m, r)\) è la trasposta di quel conto [LG16], e i ruoli si scambiano: il filtro si valuta nei punti (\(\mathbf{G}\)), l’ingresso passa per la trasposta dell’interpolazione (\(\mathbf{B}^\top\)) e l’uscita per la trasposta della valutazione (\(\mathbf{A}^\top\)), a meno di un fattore costante per ciascun punto, che si può spostare da una matrice all’altra. Per \(F(2,3)\) i punti sono \(0\), \(1\), \(-1\) e \(\infty\). In forma matriciale, con \(\mathbf{d} \in \mathbb{R}^{4}\) il pezzo d’ingresso, \(\mathbf{g} \in \mathbb{R}^{3}\) il filtro e \(\mathbf{y} \in \mathbb{R}^{2}\) le due uscite,
dove \(\odot\) è il prodotto elemento per elemento, l’unico punto in cui si moltiplicano fra loro dati e pesi: le trasformazioni moltiplicano soltanto per costanti note (\(\tfrac12\), e per tessere più grandi \(4\), \(-5\), \(8\)), ed è di quel prodotto fra dato e peso che parla il teorema. In due dimensioni lo schema si annida: con \(\mathbf{K}\) il filtro \(r\times r\) e \(\mathbf{D}\) il pezzo d’ingresso \((m+r-1)\times(m+r-1)\), la tessera d’uscita \(m\times m\) è \(\mathbf{Y} = \mathbf{A}^\top\big[(\mathbf{G}\mathbf{K}\mathbf{G}^\top) \odot (\mathbf{B}^\top\mathbf{D}\mathbf{B})\big]\mathbf{A}\), e \(F(m\times m, r\times r)\) costa \((m + r - 1)^2\) moltiplicazioni invece di \(m^2 r^2\): \(16\) contro \(36\) per \(F(2\times2, 3\times3)\), un fattore \(2{,}25\), e \(36\) contro \(144\) per \(F(4\times4, 3\times3)\), un fattore \(4\).
Il guadagno sopravvive ai canali perché le trasformazioni si ammortizzano. Con \(\mathbf{U}_{f,c} = \mathbf{G}\mathbf{K}_{f,c}\mathbf{G}^\top\), calcolata una volta per filtro, e \(\mathbf{V}_{c,p} = \mathbf{B}^\top\mathbf{D}_{c,p}\mathbf{B}\), calcolata una volta per tessera \(p\) e canale e condivisa da tutti i filtri, la somma sui canali si fa nel dominio trasformato, \(\mathbf{Y}_{f,p} = \mathbf{A}^\top\big[\sum_c \mathbf{U}_{f,c}\odot\mathbf{V}_{c,p}\big]\mathbf{A}\), e la trasformazione all’indietro si paga una volta per filtro e tessera. Per ciascuna delle \((m+r-1)^2\) posizioni \(\xi\) della tessera trasformata la somma \(\sum_c U^{(\xi)}_{f,c} V^{(\xi)}_{c,p}\) è un prodotto fra una matrice \(F\times C\) e una \(C\times P\) (qui \(F\), senza argomenti, è il numero di filtri, come nel conto dei parametri, e \(P\) il numero di tessere di tutte le immagini del batch; la \(p\) che le numera non è il padding): la convoluzione diventa \((m+r-1)^2\) moltiplicazioni fra matrici indipendenti [LG16], cioè il GEMM che una GPU sa fare meglio di ogni altra cosa.
I limiti vengono dalla costruzione stessa. La precisione: per \(F(4,3)\) i punti di interpolazione diventano \(0, \pm1, \pm2, \infty\), nelle matrici compaiono \(8\) e \(1/24\), e l’errore di arrotondamento delle trasformazioni cresce con \(m\), tanto più quando i numeri hanno poche cifre. Il costo: le somme e i prodotti per costante delle trasformazioni crescono col quadrato della tessera, e per tessere grandi si mangiano il risparmio sulle moltiplicazioni [LG16]. Per queste due ragioni le tessere restano piccole. Il passo: la costruzione presuppone uscite consecutive, cioè stride \(1\), perché il risparmio viene proprio dal fatto che le finestre di due uscite vicine si sovrappongono per \(r - 1\) valori; uno stride \(s > 1\) si riconduce al caso base separando ingresso e filtro per resto dell’indice modulo \(s\), in convoluzioni a stride \(1\) con filtri più corti, e il risparmio si assottiglia [HZZ+20]. La taglia del filtro: con \(r = 1\) non c’è niente da risparmiare, perché \(m + r - 1 = mr\), e per filtri grandi le tessere trasformate diventano grandi e mal condizionate: conviene spezzare il filtro in pezzi piccoli, allo stesso modo, o passare alla convoluzione via trasformata di Fourier [MHL14].
La Fig. 10.5 rifà in quattro tempi il conto della striscia.
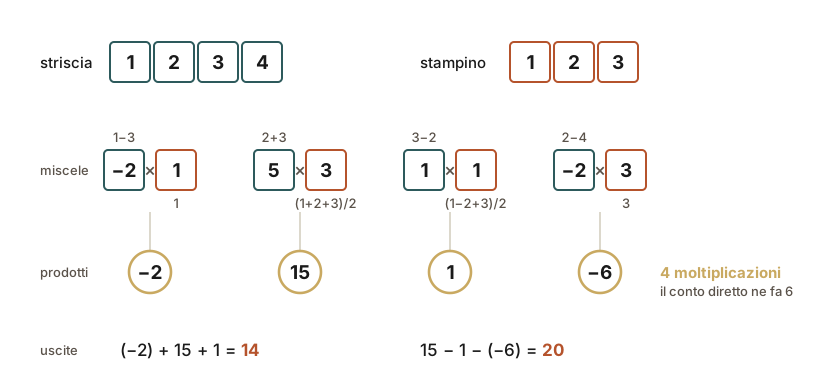
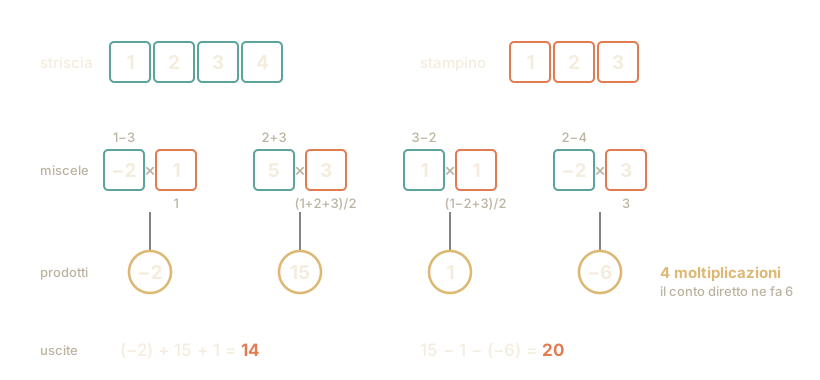
Fig. 10.5 Due uscite di un filtro da tre pesi su una striscia di quattro valori. Le miscele del filtro si preparano una volta sola, quelle della striscia sono fatte di sole somme e differenze, e le moltiplicazioni sono quattro; la ricomposizione dà \(14\) e \(20\), come il conto diretto con sei moltiplicazioni.#
Il blocco rifà prima i conti della striscia. Poi applica un filtro \(3\times3\)
a un’immagine di \(64\) canali in quattro modi: due diretti, che differiscono
solo per l’ordine in cui sommano i prodotti, e due alla Winograd, a pezzi (le
tessere) di quattro e di sei valori per lato. Il primo dei due si scrive
\(F(2\times2, 3\times3)\), che si legge «uscite a quadratini di due per due,
filtro di tre per tre», il secondo \(F(4\times4, 3\times3)\). Di ciascun modo
misura l’errore: tutti i conti, dati, trasformazioni (le miscele della
figura) e somme, si fanno prima con numeri a 32 bit e poi a 16 (float32 e
float16, cioè con circa sette e circa tre cifre significative), e il
risultato si confronta con lo stesso conto fatto a 64 bit. L’errore è relativo:
lo scarto più grande diviso per il valore più grande.
L’ordine delle somme conta, perché in virgola mobile l’addizione non è associativa. A 16 bit, oltre \(2048\) i numeri si susseguono di due in due, quindi \(2048 + 1 + 1\) fatto da sinistra resta \(2048\) (\(2049\) non si può scrivere, e l’arrotondamento lo riporta a \(2048\)), mentre \(1 + 1 + 2048\) fa \(2050\). Per questo il blocco somma in un ordine fissato, un’operazione elemento per elemento alla volta, e gli arrotondamenti sono gli stessi su qualunque processore.
import numpy as np

# F(2,3): due uscite di un filtro da tre pesi con quattro moltiplicazioni
BT2 = np.array([[1, 0, -1, 0], [0, 1, 1, 0], [0, -1, 1, 0], [0, 1, 0, -1]])
G2 = np.array([[1, 0, 0], [1/2, 1/2, 1/2], [1/2, -1/2, 1/2], [0, 0, 1]])
AT2 = np.array([[1, 1, 1, 0], [0, 1, -1, -1]])
# F(4,3): quattro uscite con sei moltiplicazioni (le matrici di Lavin e Gray)
BT4 = np.array([[4, 0, -5, 0, 1, 0], [0, -4, -4, 1, 1, 0], [0, 4, -4, -1, 1, 0],
                [0, -2, -1, 2, 1, 0], [0, 2, -1, -2, 1, 0], [0, 4, 0, -5, 0, 1]])
G4 = np.array([[1/4, 0, 0], [-1/6, -1/6, -1/6], [-1/6, 1/6, -1/6],
               [1/24, 1/12, 1/6], [1/24, -1/12, 1/6], [0, 0, 1]])
AT4 = np.array([[1, 1, 1, 1, 1, 0], [0, 1, -1, 2, -2, 0],
                [0, 1, 1, 4, 4, 0], [0, 1, -1, 8, -8, 1]])

d, g = np.array([1., 2, 3, 4]), np.array([1., 2, 3])
print("diretta :", [float(d[i:i + 3] @ g) for i in range(2)], "con 6 moltiplicazioni")
print("Winograd:", [float(v) for v in AT2 @ ((G2 @ g) * (BT2 @ d))], "con 4 moltiplicazioni")
h = np.float16  # a 16 bit, oltre 2048 i numeri vanno di due in due
print("a 16 bit: 2048 + 1 + 1 =", float(h(2048) + h(1) + h(1)),
      "  1 + 1 + 2048 =", float(h(1) + h(1) + h(2048)))

# Da qui in poi solo operazioni elemento per elemento, in un ordine fissato:
# gli errori di arrotondamento non dipendono dal processore che fa i conti.
def per(M, X):
    """M @ X lungo il penultimo asse di X, sommando nell'ordine degli indici."""
    righe = []
    for i in range(M.shape[0]):
        somma = M[i, 0] * X[..., 0, :]
        for j in range(1, M.shape[1]):
            somma = somma + M[i, j] * X[..., j, :]
        righe.append(somma)
    return np.stack(righe, axis=-2)

def trasforma(M, X):                                  # M X M^T sugli ultimi due assi
    return np.swapaxes(per(M, np.swapaxes(per(M, X), -1, -2)), -1, -2)

def diretta(img, filt, tipo, per_canale=False):
    """Nove prodotti per canale; di default li somma tutti in una catena sola,
    con per_canale=True somma prima i nove di ogni canale e poi i canali."""
    img, filt = img.astype(tipo), filt.astype(tipo)
    C, H, W = img.shape
    uscita = np.zeros((H - 2, W - 2), tipo)
    for c in range(C):
        parziale = np.zeros((H - 2, W - 2), tipo) if per_canale else uscita
        for a in range(3):
            for b in range(3):
                parziale = parziale + img[c, a:a + H - 2, b:b + W - 2] * filt[c, a, b]
        uscita = uscita + parziale if per_canale else parziale
    return uscita

def winograd(img, filt, BT, G, AT, tipo):
    """Convoluzione 3x3 a tessere m x m: filtro e tessere trasformati, prodotto
    elemento per elemento sommato sui canali, trasformazione all'indietro."""
    BT, G, AT = BT.astype(tipo), G.astype(tipo), AT.astype(tipo)
    img, filt = img.astype(tipo), filt.astype(tipo)
    C, H, W = img.shape
    m, t = AT.shape[0], BT.shape[0]
    n = (H - 2) // m                                   # tessere per lato
    tessere = np.stack([np.stack([img[:, i * m:i * m + t, j * m:j * m + t]
                                  for j in range(n)], axis=1) for i in range(n)], axis=1)
    U = trasforma(G, filt)                             # una volta per filtro
    V = trasforma(BT, tessere)                         # una volta per tessera
    somma = U[0][None, None] * V[0]
    for c in range(1, C):                              # la somma sui canali
        somma = somma + U[c][None, None] * V[c]
    Y = trasforma(AT, somma)                           # n x n tessere di m x m uscite
    return Y.transpose(0, 2, 1, 3).reshape(n * m, n * m)

rng = np.random.default_rng(0)
img, filt = rng.normal(size=(64, 26, 26)), rng.normal(size=(64, 3, 3))  # 64 canali
esatta = diretta(img, filt, np.float64)
print(f"\n{'':14}{'moltipl. per uscita':>21}{'errore float32':>16}{'errore float16':>16}")
for nome, per_uscita, calcolo in [
        ("diretta", 9, lambda tipo: diretta(img, filt, tipo)),
        ("per canale", 9, lambda tipo: diretta(img, filt, tipo, per_canale=True)),
        ("F(2x2, 3x3)", 16 / 4, lambda tipo: winograd(img, filt, BT2, G2, AT2, tipo)),
        ("F(4x4, 3x3)", 36 / 16, lambda tipo: winograd(img, filt, BT4, G4, AT4, tipo))]:
    errori = [np.abs(calcolo(tipo) - esatta).max() / np.abs(esatta).max()
              for tipo in (np.float32, np.float16)]
    print(f"{nome:14}{per_uscita:21.2f}{errori[0]:16.1e}{errori[1]:16.1e}")
diretta : [14.0, 20.0] con 6 moltiplicazioni
Winograd: [14.0, 20.0] con 4 moltiplicazioni
a 16 bit: 2048 + 1 + 1 = 2048.0   1 + 1 + 2048 = 2050.0

                moltipl. per uscita  errore float32  errore float16
diretta                        9.00         6.4e-07         6.2e-03
per canale                     9.00         2.4e-07         1.9e-03
F(2x2, 3x3)                    4.00         3.2e-07         2.5e-03
F(4x4, 3x3)                    2.25         2.9e-06         2.9e-02
Nella tabella 6.4e-07 si legge \(6{,}4\cdot10^{-7}\), cioè \(6{,}4\) diviso dieci
milioni, e 2.9e-02 è quasi il \(3\,\%\). Le moltiplicazioni per casella scendono
da \(9\) a \(4\) e a \(2{,}25\), e l’errore segue la taglia della tessera: in
float32 come in float16, \(F(4\times4, 3\times3)\) sbaglia circa dieci volte
più di \(F(2\times2, 3\times3)\).
Le due dirette, invece, dicono una cosa sull’ordine delle somme. Quella che
somma tutti i \(576\) prodotti (\(64\) canali per \(9\) pesi) in una catena sola
sbaglia più di \(F(2\times2, 3\times3)\), come nelle misure di Lavin e Gray in
float32; sommando prima i nove prodotti di ogni canale e poi i \(64\) canali,
la stessa convoluzione diretta torna la più precisa della tabella, di poco
davanti a \(F(2\times2, 3\times3)\). Le somme sono \(575\) in tutti e due i casi,
ma nella catena unica il primo prodotto le attraversa tutte, mentre sommando
per canale ne attraversa al più \(8 + 63 = 71\), e ogni somma aggiunge il suo
arrotondamento. È la stessa ragione per cui la precisione mista tiene gli ingressi a 16 bit e l’accumulo, cioè il
totale che raccoglie i prodotti uno dopo l’altro, a 32 bit.
Il prezzo di Winograd, quindi, dipende da dove si arrotonda. Se a 16 bit sono anche le trasformazioni, come nel blocco, le tessere grandi sbagliano di più; Lavin e Gray, con i soli dati a 16 bit e i conti a 32 bit, trovano invece tutti gli algoritmi alla pari, perché lì a dominare è l’arrotondamento dei dati, e le trasformazioni non lo peggiorano [LG16].
Lo stesso conto con meno spostamenti#
Winograd toglie moltiplicazioni. Su un chip costruito per le reti, però, la voce di spesa più grossa è spostare i numeri, che costa più energia che moltiplicarli, come si è visto per gli array sistolici. Là un elemento di calcolo tiene fermo un peso o un totale, e per un prodotto fra matrici basta. Una convoluzione offre più riuso di così: lo stesso peso serve in tutte le posizioni dell’immagine, lo stesso pixel sta sotto più posizioni del filtro, e la stessa casella d’uscita raccoglie prodotti da più righe del filtro e da più canali. Eyeriss, un chip costruito apposta per le reti convoluzionali da Chen, Emer e Sze [CES16], sfrutta questi riusi tutti insieme con un modo di far scorrere i dati che i suoi autori chiamano row stationary, «a riga ferma»: ogni elemento di calcolo tiene ferma una riga del filtro, come in Fig. 10.6.
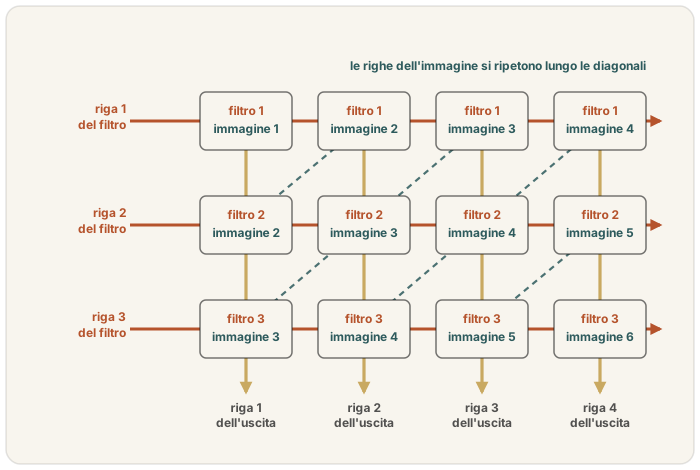
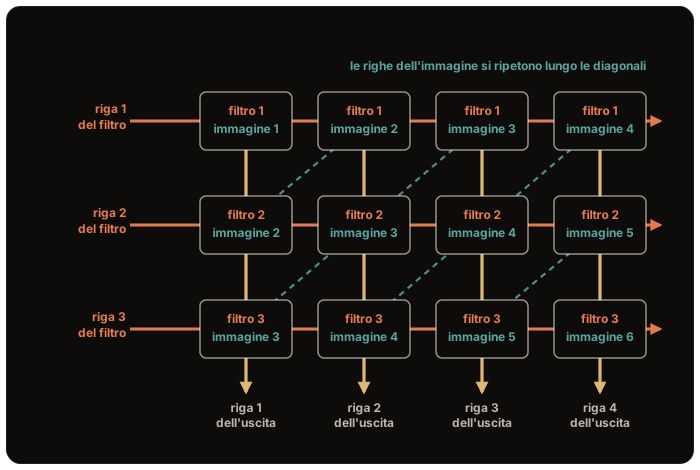
Fig. 10.6 Il flusso row stationary con un filtro di tre righe e una mappa d’uscita di quattro righe: ogni elemento tiene la riga del filtro della propria fila e riceve una riga dell’immagine, scalata di uno da una colonna all’altra. Le righe del filtro scorrono lungo la propria fila, quelle dell’immagine si ripetono lungo le diagonali, le somme parziali scendono per colonna, e in fondo esce una riga della mappa d’uscita.#
Lo stampino di tre righe si smonta nelle sue righe, e la pagina a quadretti nelle sue. Una riga di stampino che scorre su una riga di pagina è il conto della striscia di poco fa: una fila di totali, uno per posizione. E una riga intera del foglio dei risultati è la somma di tre di queste file: la prima riga dello stampino sulla prima riga della pagina, la seconda sulla seconda, la terza sulla terza.
Nel capannone con i banchi a scacchiera degli array sistolici si dà allora a ogni banco una riga dello stampino, e il banco la tiene per tutto il turno: nella prima fila di banchi tutti hanno la prima riga, nella seconda fila la seconda, nella terza la terza. A ogni banco arriva anche una riga della pagina, scalata di uno da una colonna all’altra, così che i tre banchi di una colonna vedano tre righe consecutive; i loro tre fogli, sommati mentre scendono, fanno una riga del risultato, e la colonna accanto fa quella dopo. Se le pagine sono tante, o gli stampini più d’uno, lo stesso banco tiene a portata di mano più righe, di pagine o di stampini diversi, e le alterna.
Così ogni numero lavora molte volte senza tornare in magazzino: la riga di stampino serve tutta la sua fila, la riga di pagina tutti i banchi di una diagonale, e i totali si completano passando al banco di sotto. Ed è la distanza a fare il conto della luce: nelle misure di chi ha progettato il chip, prendere un numero dal magazzino costa quanto duecento moltiplicazioni, dal tavolo comune del chip quanto sei, dal banco accanto quanto due, da sopra il proprio banco quanto una.
Il prezzo è che il capannone va ridisegnato per ogni strato. Uno stampino più alto della colonna, o più righe di risultato che colonne di banchi, vanno divisi in turni; la rete che porta la stessa riga a più banchi insieme va costruita apposta; e lo spazio per tenere le righe sul banco occupa chip che non moltiplica.
Siano \(R\) le righe del filtro ed \(E\) quelle della mappa d’uscita (i nomi di Chen, Emer e Sze). Con passo unitario, per un canale e un filtro, la riga \(e\) dell’uscita è
dove \(\mathbf{k}_r\) è la riga \(r\) del filtro, \(\mathbf{x}_h\) la riga \(h\) della mappa d’ingresso e \(\star\) la correlazione in una dimensione, che dà una riga d’uscita in cui ogni valore somma tanti prodotti quante sono le colonne del filtro. Il set logico di elementi ha \(R\) righe ed \(E\) colonne: l’elemento \((r, e)\) tiene \(\mathbf{k}_r\) nel proprio register file, riceve \(\mathbf{x}_{r+e-1}\) e produce il termine \(r\) della somma, che scende nella colonna. Le righe del filtro si riusano in orizzontale, quelle d’ingresso in diagonale (\(r + e\) costante), le somme parziali si accumulano in verticale: è il riuso che il lavoro chiama convolutional reuse. Gli altri due, filter reuse (lo stesso filtro su più immagini del lotto) e ifmap reuse (la stessa mappa sotto più filtri), si ottengono intrecciando nel register file righe di immagini, filtri e canali diversi.
Il criterio è energetico. Con i costi per accesso di un processo a 65 nm, normalizzati a una moltiplicazione-accumulo (register file 1, rete fra elementi 2, buffer globale 6, DRAM 200), il flusso minimizza l’energia complessiva del movimento dei dati, invece di tenere fermo un solo tipo di dato come weight stationary e output stationary, o nessuno come no local reuse. Sugli strati convoluzionali di AlexNet, a parità di area e di numero di elementi, questo flusso risulta da \(1{,}4\) a \(2{,}5\) volte più efficiente degli altri, e almeno \(1{,}3\) volte sugli strati densi, con lotti di almeno sedici immagini. Il chip [CKES17] ha 168 elementi in una matrice \(12 \times 14\) e 108 kB di buffer globale; adatta il set logico alla matrice fisica spezzandolo quando è troppo grande e replicandolo quando è piccolo, e la sua rete porta la stessa riga a più elementi in multicast. I limiti sono la mappatura, che va ricalcolata per ogni forma di strato, e l’area dei register file e della rete, che non moltiplica.
Il blocco scompone una convoluzione con un filtro \(3 \times 3\) su un’immagine \(6 \times 6\) nelle convoluzioni fra righe, la ricompone per colonne come fa la matrice di elementi, e conta chi usa che cosa.
import numpy as np

rng = np.random.default_rng(0)
R, H = 3, 6                                 # filtro R x R, immagine H x H
filtro = rng.integers(-2, 3, (R, R))
immagine = rng.integers(0, 5, (H, H))
E = H - R + 1                               # righe (e colonne) della mappa d'uscita

def riga_per_riga(riga_filtro, riga_immagine):
    """Convoluzione 1D: la riga del filtro scorre sulla riga dell'immagine."""
    return np.array([riga_filtro @ riga_immagine[x:x + R] for x in range(E)])

# il banco (i, j), contando da zero, tiene la riga i del filtro e riceve la riga
# i + j dell'immagine;
# la colonna j somma i suoi R risultati e dà la riga j dell'uscita
banchi = {(i, j): riga_per_riga(filtro[i], immagine[i + j]) for i in range(R) for j in range(E)}
uscita = np.array([sum(banchi[i, j] for i in range(R)) for j in range(E)])

diretta = np.array([[(filtro * immagine[y:y + R, x:x + R]).sum() for x in range(E)]
                    for y in range(E)])
print("uguale alla convoluzione diretta:", np.array_equal(uscita, diretta))

# chi usa che cosa: ogni riga del filtro, ogni riga dell'immagine, ogni riga dell'uscita
usi_filtro = [sum(1 for (i, j) in banchi if i == r) for r in range(R)]
usi_immagine = [sum(1 for (i, j) in banchi if i + j == h) for h in range(H)]
print(f"{R} x {E} banchi; ogni riga del filtro serve {usi_filtro} banchi,"
      f" le righe dell'immagine {usi_immagine}, ogni riga d'uscita somma {R} banchi")
moltiplicazioni = E * E * R * R
print(f"{moltiplicazioni} moltiplicazioni; letture se ogni numero arriva a ogni conto:"
      f" {2 * moltiplicazioni}, se ognuno arriva una volta sola: {R * R + H * H}")
uguale alla convoluzione diretta: True
3 x 4 banchi; ogni riga del filtro serve [4, 4, 4] banchi, le righe dell'immagine [1, 2, 3, 3, 2, 1], ogni riga d'uscita somma 3 banchi
144 moltiplicazioni; letture se ogni numero arriva a ogni conto: 288, se ognuno arriva una volta sola: 45
La ricomposizione dà esattamente la convoluzione diretta. Ogni riga del filtro serve i quattro elementi della sua fila, e ogni riga dell’immagine da uno a tre, quante sono le posizioni del filtro che la coprono. Se ogni numero arriva dal buffer una volta sola, e la rete lo porta in multicast a tutti gli elementi che lo usano, le 144 moltiplicazioni leggono 45 numeri invece di 288; il conto guarda solo pesi e ingressi, perché i totali parziali nel flusso scendono di elemento in elemento dentro la colonna.
Da ricordare
Uno strato denso sull’immagine intera ha troppi pesi da imparare: con foto a colori da 256 per 256 e mille neuroni sono quasi 200 milioni, e solo per il primo strato. E per di più non ha nessuna idea che un motivo sia lo stesso ovunque appaia.
La convoluzione fa scorrere sull’immagine un filtro piccolo e scrive su un foglio nuovo, punto per punto, quanto quel motivo c’è: quel foglio si chiama feature map.
Pochi pesi, riusati in ogni punto: la rete impara cosa cercare, non dove. Se il motivo si sposta, si sposta con lui anche il segnale che lo indica.
Quanto viene grande la mappa che esce lo decidono la larghezza della finestra, di quanto salta a ogni passo (lo stride), la cornice attorno all’immagine (il padding) e, quando c’è, la dilatazione. Col passo a 1 e la cornice da uno, un filtro \(3\times3\) lascia la mappa grande quanto l’immagine; col passo a 2 la dimezza, e quando il conto non torna in pieno due persone che scelgono in modo diverso si ritrovano con mappe diverse.
Il max pooling tiene, di ogni quadratino, solo il valore più forte: rimpicciolisce le mappe e dà un po’ di tolleranza agli spostamenti minimi, in cambio della precisione su dove le cose stanno. L’architettura tipica alterna convoluzione e pooling, e chiude con gli strati densi che decidono la classe.
Lo stesso conto si può fare con meno moltiplicazioni (l’algoritmo di Winograd): mescolando prima lo stampino e il pezzo d’immagine, due risultati di uno stampino da tre costano quattro moltiplicazioni invece di sei. Si paga in precisione, e vale per stampini piccoli che avanzano di un quadretto.
E con meno spostamenti: un chip che dà a ogni banco una riga dello stampino fa lavorare ogni numero molte volte prima di rimandarlo in magazzino, dove prenderlo costa quanto duecento moltiplicazioni. Il prezzo è che il capannone va ridisegnato per ogni strato.
Da ricordare
Gli strati densi scalano male sulle immagini: i parametri crescono con i pixel, e lo strato non è equivariante alla traslazione.
La convoluzione fa scorrere un piccolo kernel che evidenzia un motivo ovunque compaia; l’uscita è una feature map.
Campo recettivo locale = pochi parametri; pesi condivisi = risposta equivariante, cioè il motivo riconosciuto ovunque compaia, con l’attivazione che si sposta insieme a lui. L’invarianza è un’altra proprietà, e arriva semmai dalla testa della rete (pooling globale), non dalla convoluzione.
La dimensione d’uscita è \(o = \lfloor (n + 2p - k)/s \rfloor + 1\), e con dilatazione \(d\) il kernel copre \(d(k-1)+1\) pixel invece di \(k\). La parte intera è una convenzione e non l’unica possibile (
ceil_mode=Truearrotonda per eccesso): a \(n=61\), \(k=s=2\) le due scelte danno 30 e 31.Il max pooling riduce la risoluzione e baratta l’equivarianza esatta con una tolleranza modesta ai piccoli spostamenti (su un picco isolato la mappa resta identica metà delle volte, su una mappa fitta di valori diversi mai); l’architettura tipica alterna conv e pool e chiude con strati densi.
L’algoritmo di Winograd calcola \(F(m, r)\) con \(m + r - 1\) moltiplicazioni invece di \(mr\), e \(F(m\times m, 3\times3)\) con \((m+2)^2\) invece di \(9m^2\) (\(2{,}25\) volte meno per \(m = 2\), \(4\) per \(m = 4\)); nel dominio trasformato la somma sui canali diventa un GEMM per posizione. L’errore e il costo delle trasformazioni crescono con \(m\); la costruzione vale a stride \(1\) e per filtri piccoli, e il resto va prima spezzato in convoluzioni di quel tipo.
Il flusso row stationary di Eyeriss scompone la convoluzione in correlazioni fra righe: riga del filtro ferma nel register file, righe d’ingresso in diagonale, somme parziali in verticale; minimizza l’energia del movimento dei dati sulla gerarchia DRAM (200), buffer (6), rete (2), register file (1); la mappatura va però ricalcolata per ogni forma di strato.
I due vincoli della convoluzione, una finestra sola per ogni neurone e lo stesso filtro in ogni posizione, stanno dentro l’architettura invece di essere sperati dall’addestramento: si pagano in flessibilità, e in cambio per imparare servono molti meno esempi. Restano due domande, di mestiere diverso: come si fa a far imparare davvero una rete profonda, il tema di Far funzionare le reti profonde, e quali reti hanno vinto con questi pezzi, che racconta Le architetture che hanno fatto la storia.