


Teoria dell’informazione: misurare la sorpresa#
Nel luglio del 1948, sul Bell System Technical Journal, un ingegnere trentaduenne dei Bell Labs di nome Claude Shannon pubblica A Mathematical Theory of Communication [Sha48]. L’articolo definisce la quantità di informazione di un messaggio a partire dalla probabilità della sorgente che lo produce, e ne fissa l’unità di misura, il bit: contrazione di binary digit, parola che Shannon attribuisce al collega John Tukey e che proprio in quell’articolo compare a stampa per la prima volta.
Nello stesso articolo la grandezza centrale della teoria prende il nome che ha ancora oggi, entropia, lo stesso della termodinamica: è il nome dell’aneddoto raccontato nell’apertura del capitolo, quello che von Neumann avrebbe suggerito a Shannon. Dall’entropia e dalla divergenza di Kullback e Leibler (1951) si ricava la cross-entropy, la funzione di errore con cui si addestra la maggior parte dei classificatori, cioè dei modelli che scelgono fra alternative (gatto o cane, spam o no).
La sorpresa di un evento#
Il punto di partenza di Shannon è un’osservazione quasi banale: un messaggio porta tanta più informazione quanto più è improbabile.
Il telegiornale non apre mai con «domani il sole sorgerà»: è certo, quindi non è una notizia. Apre con la nevicata a Palermo, proprio perché è rara. L’informazione è sorpresa: un evento scontato ne porta poca, un evento raro ne porta molta.
Shannon trasformò l’intuizione in un numero, e il gioco delle venti domande fa vedere come. Uno pensa a un oggetto, l’altro può chiedere solo cose con risposta sì o no. Chi gioca bene sceglie domande che dimezzano ogni volta le possibilità rimaste, e in venti mosse arriva a distinguere più di un milione di oggetti, perché \(2^{20} \approx 1{,}05\) milioni. Chi gioca male («è un carciofo?», «è un trapano?») non esaurisce nemmeno il contenuto di un cassetto. Una domanda ben posta è l’unità di misura della sorpresa, e si chiama bit.
Il bit è l’esponente del due. Due alternative fanno \(1\) bit perché \(2^1 = 2\); quattro ne fanno \(2\) perché \(2^2 = 4\); otto ne fanno \(3\). L’esito di una moneta equa (testa o croce, 50 e 50) vale quindi esattamente 1 bit: una domanda secca, e la risposta è trovata.
Due monete lanciate insieme danno quattro esiti, cioè due domande: le possibilità si moltiplicano, le domande si sommano. Un bit di sorpresa più un bit di sorpresa fanno due bit, e questo vale per qualunque coppia di eventi che non si influenzano a vicenda.
Un dado onesto ha sei facce, e sei sta in mezzo fra quattro e otto: fra \(2\) e \(3\) bit. Il numero esatto è l’esponente che elevando \(2\) dà \(6\), cioè circa \(2{,}585\). Un esponente con la virgola sembra non avere senso (moltiplicare il due per sé stesso due volte e mezza?), e invece ne ha uno preciso: l’elevamento a potenza si estende agli esponenti con la virgola in modo che continui a valere la regola di sempre, cioè che sommando gli esponenti si moltiplichino i risultati. Con quella regola \(2^{0{,}5}\) deve essere il numero che moltiplicato per sé stesso dà \(2\), cioè \(\sqrt 2 \approx 1{,}41\), e \(2^{2{,}585}\) è il numero fra \(2^2 = 4\) e \(2^3 = 8\) che fa proprio \(6\).
Attenzione però a che cosa promette quel \(2{,}585\). Le domande si contano intere, quindi su un tiro solo la strategia migliore ne consuma in media due e due terzi, un po’ più di quel numero: due facce si isolano con due domande, le altre quattro con tre, e \((2+2+3+3+3+3)/6 = 16/6\). Il resto si recupera facendo domande su più tiri insieme. Due tiri hanno trentasei esiti, e con le domande giuste sulla coppia ventotto esiti si isolano con cinque domande e otto con sei: in media \(188/36 \approx 5{,}22\) domande, cioè \(2{,}61\) per tiro. Allungando la partita la media per tiro scende ancora, fino a \(2{,}585\), e sotto non va. Sono i «2,6 bit» del dado: non il costo di una partita, ma il fondo a cui si arriva allungandola.
Con una moneta sbilanciata il conto è lo stesso, con un’avvertenza: al posto del numero di alternative si mette uno diviso la probabilità. Una moneta truccata dà testa \(9\) volte su \(10\). La testa è «un’alternativa su \(1/0{,}9 = 1{,}11\)», cioè quasi nessuna domanda, \(0{,}15\) bit, e ce lo aspettavamo. La croce è «una su \(1/0{,}1 = 10\)», cioè quanto un dado a dieci facce, e vale \(3{,}32\) bit: rara, e perciò molto informativa.
Quei due esponenti li dà una calcolatrice, e si controllano andando nel verso facile, cioè elevando il due. Se \(0{,}15\) è giusto, \(2^{0{,}15}\) deve fare \(1{,}11\), e infatti fa \(1{,}11\). Se \(3{,}32\) è giusto, \(2^{3{,}32}\) deve fare \(10\): sta fra \(2^3 = 8\) e \(2^4 = 16\), e viene \(9{,}99\).
L’autoinformazione (o sorpresa) di un esito \(x\) con probabilità \(p(x)\) è
dove il segno meno rende la quantità positiva (i logaritmi di numeri fra \(0\) e \(1\) sono negativi) e la base \(2\) fissa l’unità di misura in bit. La forma logaritmica è obbligata: è l’unica forma continua (a meno della base) che rende la sorpresa additiva per eventi indipendenti; se \(p(x,y)=p(x)\,p(y)\), allora \(I(x,y)=I(x)+I(y)\), perché il logaritmo trasforma i prodotti in somme. L’aggettivo serve: l’equazione funzionale \(f(pq)=f(p)+f(q)\) ha anche soluzioni patologiche, che però si costruiscono solo rinunciando a ogni regolarità (continuità, monotonia o misurabilità).
Esempi: moneta equa, \(I=-\log_2 0{,}5 = 1\) bit; una faccia del dado, \(I=-\log_2 \tfrac{1}{6} \approx 2{,}585\) bit; testa con la moneta truccata, \(I=-\log_2 0{,}9 \approx 0{,}152\) bit; croce con la stessa moneta, \(I=-\log_2 0{,}1 \approx 3{,}322\) bit. Con il logaritmo naturale al posto di \(\log_2\) l’unità si chiama nat: è la convenzione usata dalle loss di PyTorch.
L’entropia: la sorpresa media#
Un singolo esito ha una sorpresa; una sorgente di esiti (una moneta, un dado, una lingua) ha una sorpresa media. È l’entropia: quanto ci aspettiamo di essere sorpresi, in media, a ogni estrazione (Fig. 3.26).

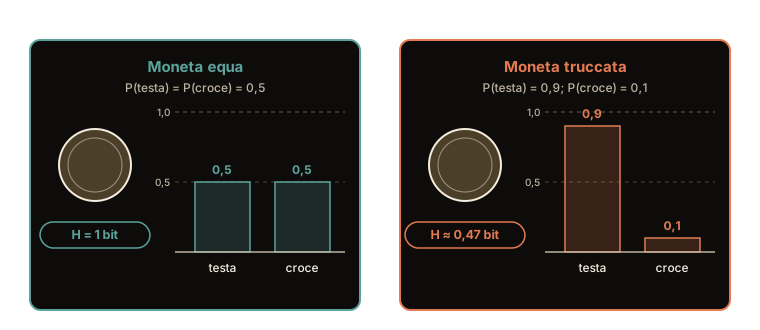
Fig. 3.26 Due monete identiche all’aspetto, entropie diverse: l’equa produce in media 1 bit di sorpresa per lancio, la truccata meno della metà. (La lettera \(H\) che compare nel disegno è il simbolo con cui si indica l’entropia, così come \(\pi\) indica il pi greco: «\(H = 1\) bit» si legge «l’entropia di questa moneta è di un bit».)#
Riprendiamo la moneta truccata: testa 9 volte su 10. Nove lanci su dieci la sorpresa è quasi nulla (0,15 bit), una volta su dieci è grande (3,32 bit). La media pesata fa \(0{,}9 \times 0{,}15 + 0{,}1 \times 3{,}32 \approx 0{,}47\) bit per lancio: meno della metà del bit pieno della moneta equa. Ha senso: una moneta prevedibile ci sorprende poco, e infatti «produce» poca informazione.
La regola generale: l’entropia è massima quando tutto è ugualmente possibile (massima incertezza: 1 bit per la moneta equa, circa 2,6 bit per il dado onesto) e scende verso zero man mano che un esito diventa dominante. Una moneta con due teste ha entropia zero: nessuna sorpresa, mai.
Per una distribuzione discreta \(p=(p_1,\dots,p_n)\), l’entropia è il valore atteso dell’autoinformazione:
dove i termini con \(p_i=0\) valgono \(0\) per convenzione (coerente col limite \(p\log p \to 0\)). Verifiche: moneta equa, \(H = -(0{,}5\log_2 0{,}5 + 0{,}5\log_2 0{,}5) = 1\) bit; moneta truccata con \(p=0{,}9\), \(H \approx 0{,}9\cdot 0{,}152 + 0{,}1\cdot 3{,}322 \approx 0{,}469\) bit; dado equo, \(H = \log_2 6 \approx 2{,}585\) bit.
Due proprietà strutturali: \(H(p)\ge 0\), con uguaglianza solo per distribuzioni degeneri (un esito certo); e \(H(p)\le \log_2 n\), con uguaglianza solo per la distribuzione uniforme. L’entropia è quindi una misura di incertezza: nulla quando l’esito è scritto, massima quando le \(n\) alternative sono equiprobabili.
Entrambe valgono nel discreto, e nel continuo la prima cade. L’analogo per una densità, l’entropia differenziale \(h(f) = -\int f\log_2 f\), può essere negativo appena la densità si concentra: \(h(\mathcal{N}(0,1)) = +2{,}05\) bit, ma \(h(\mathcal{N}(0,\,0{,}1^2)) = -1{,}27\). La divergenza KL, invece, resta \(\ge 0\) in entrambi i casi, ed è una delle ragioni per cui è lei l’oggetto su cui si costruisce.
Confrontare distribuzioni: cross-entropia e divergenza KL#
Nel machine learning le distribuzioni in gioco sono due. La prima, \(p\), è la distribuzione vera dei dati, quanto spesso nel mondo esce ciascuna risposta: con la moneta truccata la conosciamo, perché l’abbiamo truccata noi; con le foto di gatti no. La seconda, \(q\), è quella che il modello assegna, e differisce da \(p\) finché il modello non ha imparato (e in generale anche dopo). Serve una misura di quanto \(q\) si discosta da \(p\).

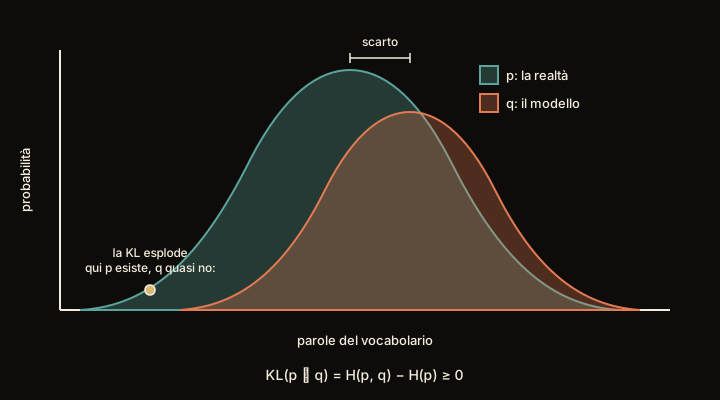
Fig. 3.27 Le due curve e il fatto che non combaciano. La cross-entropia misura il costo totale di descrivere \(p\) usando \(q\); la divergenza KL misura solo il sovrapprezzo, cioè quanto si paga in più rispetto a conoscere \(p\), ed è la sottrazione scritta in fondo al disegno (dove \(H(p,q)\) è la cross-entropia, \(H(p)\) la sorpresa media della realtà, e la doppia stanghetta si legge «rispetto a»). Due avvertenze sul resto. Lo spazio bianco fra le due curve è un promemoria visivo e non la misura esatta dello scarto. Il punto segnato sulla coda di sinistra è invece il caso che costa di più, quello in cui la realtà ogni tanto produce una parola a cui il modello aveva assegnato una probabilità quasi nulla: essere colti di sorpresa lì è la cosa più cara che possa capitare, ed è per questo che la scritta accanto dice che il conto «esplode».#
Il codice Morse assegna il segnale più corto (un punto) alla E, che in inglese è la lettera più frequente: le scorciatoie migliori vanno alle cose più comuni, così i messaggi restano brevi. Se telegrafi in italiano usando il Morse tarato sull’inglese, l’alfabeto funziona ancora, ma le frequenze sono diverse: ogni tanto un carattere per noi comunissimo si porta dietro un codice lungo. In media, sprechi.
La cross-entropia è la lunghezza media dei tuoi messaggi quando usi il codice pensato per la lingua sbagliata: le lettere arrivano secondo la realtà (\(p\)), le scorciatoie sono ottimizzate per la convinzione del modello (\(q\)). La divergenza di Kullback–Leibler è lo spreco puro: i bit pagati in più rispetto al codice giusto. È zero solo se \(q\) indovina esattamente \(p\), e non è simmetrica: sbagliare codice in un verso non costa quanto sbagliarlo nell’altro.
La cross-entropia fra la distribuzione vera \(p\) e quella del modello \(q\) è
cioè la sorpresa media che proviamo usando le probabilità sbagliate \(q\) mentre gli esiti escono secondo \(p\). La divergenza di Kullback–Leibler [KL51] è l’eccesso rispetto al minimo possibile:
dove la disuguaglianza (di Gibbs) vale sempre, con uguaglianza se e solo se \(p=q\). La prova è la disuguaglianza di Jensen applicata al logaritmo, che è concavo. Sommando sui soli \(i\) con \(p_i>0\),
La stessa riga, con \(q\) uniforme su \(n\) esiti, dà \(D_{KL}(p\,\|\,u)=\log_2 n-H(p)\ge 0\), cioè il tetto \(H(p)\le\log_2 n\). E dice anche dove la divergenza smette di essere finita: se per qualche esito \(p_i>0\) e \(q_i=0\), il termine \(p_i\log_2(p_i/q_i)\) vale \(+\infty\). Un modello che dà probabilità zero a un esito che accade paga una sorpresa infinita. Esempio con le nostre monete: se la realtà è la moneta truccata (\(p = (0{,}9;\, 0{,}1)\)) e il modello la crede equa, \(H(p,q)=1\) bit e \(D_{KL} = 1 - 0{,}469 \approx 0{,}531\) bit. Nel verso opposto (realtà equa, modello convinto del trucco) \(H(p,q) \approx 1{,}737\) bit e \(D_{KL} \approx 0{,}737\) bit. I due valori differiscono: la KL è asimmetrica, \(D_{KL}(p\,\|\,q) \ne D_{KL}(q\,\|\,p)\) in generale, e non soddisfa la disuguaglianza triangolare. Non è una distanza in senso matematico, per quanto la si usi come misura di dissimilarità.
Il legame con il codice è un teorema. Per la disuguaglianza di Kraft esiste un codice prefisso con lunghezze \(\ell_i\) se e solo se \(\sum_i 2^{-\ell_i}\le 1\). Scegliendo \(\ell_i=\lceil-\log_2 q_i\rceil\) la condizione è soddisfatta, e se gli esiti escono secondo \(p\) la lunghezza media sta fra \(H(p,q)\) e \(H(p,q)+1\) bit. Con \(q=p\) è il teorema della codifica di sorgente di Shannon, \(H(p)\le\mathbb{E}[\ell]<H(p)+1\) per il codice migliore; con \(q\ne p\) il sovrapprezzo rispetto al codice giusto è \(D_{KL}(p\,\|\,q)\), a meno di quel bit di arrotondamento, che si diluisce codificando i simboli a blocchi. \(H(p,q)\) è quindi, a meno di quel bit, la lunghezza media dei messaggi scritti con il codice tarato sulla distribuzione sbagliata.
La cross-entropia e la divergenza KL, le due misure di Fig. 3.27, differiscono per \(H(p)\), l’entropia della distribuzione vera, che non dipende dal modello: minimizzare l’una o l’altra rispetto ai parametri dà quindi lo stesso modello. La cross-entropia ha in più un vantaggio pratico: \(H(p,q)=\mathbb{E}_{x\sim p}[-\log q(x)]\) si stima dai campioni, con \(-\frac1N\sum_{j=1}^{N}\log q(x_j)\) sugli \(N\) esempi \(x_j\) estratti da \(p\), senza mai scrivere \(p\): ogni foto etichettata «gatto» è un esito della realtà, e la media della sorpresa del modello sugli esiti fa entrare \(p\) nel conto da sé. La divergenza KL contiene invece \(H(p)\), che dai soli esempi non si calcola direttamente. Di solito si hanno gli esempi e non la legge che li ha prodotti.
Il ponte con l’apprendimento#
Da qui viene la cross-entropia come funzione di perdita.
Quando una rete neurale impara a classificare, a ogni esempio le si fa una sola domanda: quanto ti sorprende la risposta giusta? Se il modello dava al gatto il 90% di probabilità e l’immagine era davvero un gatto, la sorpresa è piccola e la correzione minima; se gli dava il 2%, la sorpresa è enorme e la correzione energica. Addestrare significa girare le manopole dei parametri per rendere la risposta giusta sempre meno sorprendente. La «punizione» media è esattamente la cross-entropia dell’analogia del Morse: il modello smette di sprecare quando il suo codice (le sue probabilità) combacia con la realtà.
Smettere di sprecare, però, non vuol dire arrivare a costo zero: anche col codice giusto i telegrammi hanno una lunghezza. Se una foto sfocata può essere gatto o cane, nessuna manopola rende certa la risposta; quella sorpresa che resta è l’incertezza dei dati stessi, e la paga anche il modello perfetto. La stessa manovra ha infine un terzo nome: scegliere i parametri sotto i quali gli esempi raccolti risultano i più plausibili. Sorprendersi poco della risposta giusta e trovare plausibile quello che è successo sono la stessa regolazione delle manopole, vista da due lati.
Minimizzare la cross-entropia rispetto ai parametri \(\theta\) del modello equivale a minimizzare la divergenza KL, perché
e \(H(p)\) non dipende da \(\theta\): il minimo teorico della loss non è zero ma l’entropia dei dati, la loro incertezza irriducibile.
Attenzione però a quale \(p\), perché lo stesso simbolo (qui come dappertutto) copre due cose diverse. Se \(p\) è la distribuzione condizionata vera del processo che genera i dati, il pavimento è la sua entropia media sugli ingressi, \(\mathbb{E}_{\mathbf{x}}\big[H(p(\cdot\mid\mathbf{x}))\big]\), positiva appena l’etichetta non è una funzione deterministica dell’ingresso (la foto sfocata), e nessun modello scende sotto. Se invece \(p\) è il bersaglio empirico di un singolo esempio, cioè «questa immagine è un gatto» con probabilità \(1\) e tutto il resto a zero, allora \(H(p) = 0\) e il pavimento è zero. Le due affermazioni convivono, e spiegano una cosa che si osserva addestrando. Anche la loss di validazione si calcola su bersagli certi, un’etichetta per esempio; ma su esempi nuovi la sua media tende a \(\mathbb{E}_{\mathbf{x}}\big[H(p(\cdot\mid\mathbf{x}))+D_{KL}\big(p(\cdot\mid\mathbf{x})\,\|\,q_\theta(\cdot\mid\mathbf{x})\big)\big]\), il pavimento vero più l’errore del modello (in bit: la loss delle librerie usa il logaritmo naturale, e misura le stesse quantità in nat, cioè moltiplicate per \(\ln 2\)). Sul training set, invece, un modello abbastanza ricco può dare probabilità quasi \(1\) proprio all’etichetta che ogni esempio ha ricevuto, rumore compreso: la loss scende quasi a zero perché il modello ha memorizzato quelle estrazioni, non perché il processo sia diventato certo.
Inoltre, sulla distribuzione empirica del training set la cross-entropia
coincide con la log-verosimiglianza negativa media: minimizzarla è la stima
di massima verosimiglianza della sezione su probabilità e statistica. Le tre prospettive (minimizzare la
cross-entropia, avvicinare \(q_\theta\) a \(p\) nel senso della KL, massimizzare la
verosimiglianza) sono la stessa operazione. È ciò che fa nn.CrossEntropyLoss:
la loss di un esempio è \(\ell=-\log \hat{y}_c\) (dove \(\hat{y}_c\) è la
probabilità che il modello assegna alla classe corretta \(c\)), e \(\mathcal{L}\) è
la sua media sugli esempi. Che questa funzione di perdita esca da una
distribuzione categorica sull’uscita, e non sia una scelta a sé, lo mostra la
sezione Da dove viene la loss.
Due variabili: entropia condizionata e informazione mutua#
Fin qui una variabile alla volta. Nel machine learning le variabili sono almeno due, l’ingresso \(X\) e l’etichetta \(Y\), e interessa quanto conoscere la prima riduca, in media, l’incertezza sulla seconda. L’entropia condizionata \(H(Y\mid X)\) è l’incertezza che resta su \(Y\) dopo aver osservato \(X\), mediata sui valori di \(X\); la differenza fra prima e dopo,
è l’informazione mutua. Ricompare con altri nomi: è l’information gain con cui un albero di decisione sceglie la domanda, è la base dell’NMI (normalized mutual information) che confronta due raggruppamenti, ed è la quantità a cui l’apprendimento auto-supervisionato lega la propria perdita InfoNCE.
Un amico tira un dado e, prima di mostrarlo, ti dice soltanto «è uscito un numero pari». Prima della frase le facce possibili erano sei, cioè circa \(2{,}585\) bit di incertezza; dopo sono tre, \(2\), \(4\) e \(6\), e restano circa \(1{,}585\) bit. La frase dell’amico valeva esattamente la differenza, un bit: è l’informazione mutua fra «pari o dispari» e la faccia del dado.
Le domande si possono anche mettere in fila. Per scoprire la faccia si chiede prima se è pari (un bit), poi quale delle tre rimaste (un bit e mezzo abbondante): in tutto \(2{,}585\), come prima. L’incertezza su tutte e due le cose insieme è quella sulla prima più quella che resta sulla seconda, una volta saputa la prima. E il conto si può rovesciare: chi vede la faccia sa anche se è pari, quindi sapere la faccia toglie tutta l’incertezza sulla parità, che era proprio un bit. Quanto l’una dice dell’altra non dipende da quale si guarda per prima.
Se invece l’amico ti dice che tempo fa a Roma, non ti dice niente del dado: dopo la frase le facce sono ancora sei, e l’informazione mutua è zero. Succede sempre così quando le due cose non hanno niente a che fare l’una con l’altra, e solo allora.
Il punto di rottura sta in una parola sola, «in media». Un esame per una malattia che colpisce una persona su cento: prima dell’esame il dubbio è minimo, quasi certamente sei sano (circa \(0{,}08\) bit). Se l’esame risulta positivo, la probabilità di essere malato sale a una su sei, e il dubbio cresce otto volte, a \(0{,}65\) bit: quella notizia ti ha confuso le idee invece di schiarirle. Ma un positivo capita di rado, e un negativo, che capita quasi sempre, lo riduce quasi a zero. Contando tutte e due le risposte con la loro frequenza, l’esame dimezza l’incertezza: dopo restano \(0{,}04\) bit. Una singola notizia può aumentare il dubbio; una fonte di notizie, in media, non lo aumenta mai.
E le notizie non si moltiplicano passando di bocca in bocca. Se l’amico riferisce la sua frase a un terzo, e il terzo la riferisce a te, del dado puoi sapere al massimo quel bit, e spesso meno, se per strada la frase si storpia: nessun passaparola aggiunge sul dado qualcosa che la prima frase non dicesse.
Per due variabili discrete con distribuzione congiunta \(p(x,y)\), l’entropia congiunta è \(H(X,Y)=-\sum_{x,y}p(x,y)\log_2 p(x,y)\) e l’entropia condizionata è la media delle entropie delle condizionate,
Da \(p(x,y)=p(x)\,p(y\mid x)\) segue la regola della catena \(H(X,Y)=H(X)+H(Y\mid X)\), e scrivendola nei due versi \(I(X;Y)=H(Y)-H(Y\mid X)=H(X)-H(X\mid Y)=H(X)+H(Y)-H(X,Y)\): l’informazione mutua è simmetrica. Sul dado, con \(X\) la parità e \(Y\) la faccia, \(H(Y)=\log_2 6\), \(H(Y\mid X)=\log_2 3\), \(H(X\mid Y)=0\), e da tutti e due i lati \(I=1\) bit.
L’informazione mutua è una divergenza KL fra la congiunta e il prodotto delle marginali,
quindi per la disuguaglianza di Gibbs è non negativa, e nulla se e solo se \(X\) e \(Y\) sono indipendenti. Ne segue \(H(Y\mid X)\le H(Y)\): condizionare non aumenta l’entropia in media. Per un singolo valore invece \(H(Y\mid X=x)>H(Y)\) è possibile, e l’esame lo mostra: con \(Y\) lo stato di salute e \(X\) l’esito dell’esame, prevalenza \(0{,}01\), sensibilità \(0{,}99\) e falsi positivi al \(5\%\), \(H(Y)\approx 0{,}081\) bit, \(H(Y\mid X=+)\approx 0{,}650\), \(H(Y\mid X)\approx 0{,}040\) e \(I(X;Y)\approx 0{,}041\) bit. Allo stesso modo la quantità dentro il valore atteso, l’informazione mutua puntuale \(\operatorname{pmi}(x,y)=\log_2\frac{p(x,y)}{p(x)\,p(y)}\), può essere negativa, mentre la sua media non lo è mai [CT06].
Due proprietà reggono gli usi successivi. La disuguaglianza dell’elaborazione dei dati: se \(X\to Y\to Z\) è una catena di Markov (come un dato, la sua rappresentazione e una funzione di quella rappresentazione), allora \(I(X;Z)\le I(X;Y)\), e nessuna elaborazione di \(Y\) crea informazione su \(X\) che \(Y\) non avesse. E la stima: su variabili continue e ad alta dimensione l’informazione mutua non si calcola, si maggiora o si minora con stimatori variazionali, e l’InfoNCE dell’auto-supervisione ne dà un minorante che non supera \(\log N\), con \(N\) il numero di esempi a confronto.
import numpy as np

def H(p):
    p = np.asarray(p, dtype=float).ravel()
    p = p[p > 0]
    return float(-(p * np.log2(p)).sum())

def info_mutua(congiunta):
    """I(X;Y) = H(X) + H(Y) - H(X,Y), dalla tabella della congiunta."""
    c = np.asarray(congiunta, dtype=float)
    return H(c.sum(axis=1)) + H(c.sum(axis=0)) - H(c)

# il dado: righe = pari/dispari, colonne = facce 1..6
dado = np.zeros((2, 6))
for faccia in range(1, 7):
    dado[faccia % 2, faccia - 1] = 1 / 6
print(round(info_mutua(dado), 4))                   # -> 1.0

# l'esame: righe = sano/malato, colonne = negativo/positivo
prev, sens, fp = 0.01, 0.99, 0.05
esame = np.array([[(1 - prev) * (1 - fp), (1 - prev) * fp],
                  [prev * (1 - sens),     prev * sens]])
print(round(H(esame.sum(axis=1)), 4), round(info_mutua(esame), 4))
# -> 0.0808 0.0407
positivo = esame[:, 1] / esame[:, 1].sum()      # P(Y | X = +)
negativo = esame[:, 0] / esame[:, 0].sum()      # P(Y | X = -)
print(round(H(positivo), 4), round(H(negativo), 4),
      round(H(esame.sum(axis=1)) - info_mutua(esame), 4))
# -> 0.65 0.0016 0.0401
La perplessità: quante facce ha il dado#
Dall’entropia si ricava una misura più parlante, cara a chi costruisce modelli di linguaggio.

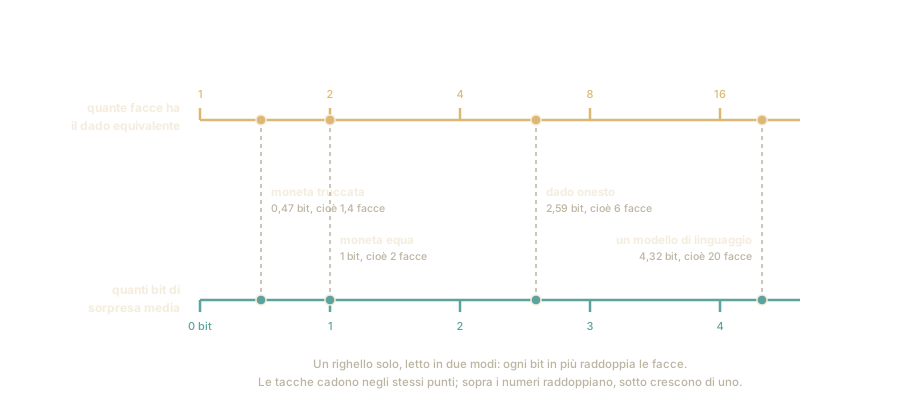
Fig. 3.28 Un righello solo, con due scritte diverse sui due bordi. La perplessità non aggiunge niente all’entropia: la dice in facce invece che in bit, e le facce raddoppiano dove i bit crescono di uno.#
La perplessità è l’esponenziale dell’entropia: riporta l’incertezza al numero di alternative equiprobabili che darebbero la stessa entropia. Per la moneta equa \(2^1 = 2\) facce, per quella truccata \(2^{0{,}47} \approx 1{,}4\), e in Fig. 3.28 sono lo stesso punto letto sui due bordi. Un valore non intero ha un senso preciso: \(2^{0{,}47}\approx1{,}4\), poco meno di \(2^{0{,}5}\approx1{,}41\), vuol dire meno di due alternative effettive.
Dire «entropia 2,585 bit» non è intuitivo; dire «è incerto come un dado a sei facce» sì. La perplessità fa proprio questa traduzione: riconverte l’entropia nel numero di alternative ugualmente probabili che darebbero la stessa incertezza. Moneta equa: perplessità 2. Dado onesto: 6. La moneta truccata: circa 1,4 (quasi nessun dubbio, poco più di un’alternativa secca). Quando leggerai che un modello di linguaggio «ha perplessità 20», ora sai cosa significa: a ogni parola è incerto come se tirasse un dado a 20 facce. Meno facce, modello più sicuro: è un numero da far scendere, e sotto \(1\) (nessun dubbio) non può andare.
La perplessità di una distribuzione è
l’esponenziale dell’entropia nella stessa base del logaritmo. Per la distribuzione uniforme su \(n\) esiti, \(\mathrm{PP} = 2^{\log_2 n} = n\): il numero di alternative, appunto. Per le nostre sorgenti: \(2^{1}=2\) (moneta equa), \(2^{\log_2 6}=6\) (dado), \(2^{0{,}469}\approx 1{,}38\) (moneta truccata). Un modello \(q\) valutato su un testo \(w_1,\dots,w_T\) ha perplessità \(\mathrm{PP}=2^{H(p,q)}\), con \(H(p,q)\approx-\frac1T\sum_{t=1}^{T}\log_2 q(w_t\mid w_{<t})\), cioè \(\mathrm{PP}=\big(\prod_{t}q(w_t\mid w_{<t})\big)^{-1/T}\): la media geometrica degli inversi delle probabilità assegnate alle parole che sono davvero occorse. Si minimizza, e il suo pavimento è \(1\) (probabilità \(1\) a ogni parola occorsa). Nei modelli di linguaggio si usa la perplessità per parola: la riprende, numeri alla mano, la sezione sui modelli n-gram.
Il limite della compressione#
La conseguenza più concreta del lavoro di Shannon è che l’entropia fissa il
limite alla compressione. Comprimere un file, come fanno zip e gzip, vuol
dire riscriverlo più corto in modo da poterlo ricostruire identico. Shannon
dimostrò che nessun codice senza perdita può avere, in media, una lunghezza per
simbolo inferiore all’entropia per simbolo (entropy rate) della sorgente
che produce il messaggio,
cioè la sorpresa media di un simbolo dato tutto ciò che lo precede. Se i simboli sono indipendenti, \(h\) coincide con la \(H\) di un simbolo solo; se c’è memoria, \(h\) è più piccola, e l’entropia calcolata sulle sole frequenze dei simboli (quella di ordine zero) sovrastima il limite. Una lingua ha memoria: dopo una «q» arriva quasi sempre una «u», dopo «il gatto ne» le continuazioni plausibili sono poche.
La differenza si tocca con mano su una sorgente con memoria costruita apposta,
dove si sa in partenza dove la memoria sta. Si estraggono a caso ventimila
parole da un elenco di sei e si mettono una dietro l’altra. La sorgente vera
produce \(\log_2 6 \approx 2{,}6\) bit ogni volta che sceglie una parola, e
siccome le parole sono lunghe in media poco più di cinque caratteri, ne produce
meno di mezzo bit per carattere. Contando invece soltanto quanto è frequente
ciascuna lettera, senza accorgersi che le lettere arrivano in gruppi
obbligati, la sorpresa media sale a \(3{,}36\) bit a carattere. Passato lo stesso
testo a gzip, il compressore più ordinario che ci sia, il file esce a circa
\(0{,}8\) bit a carattere, cioè a un quarto di quel presunto limite
invalicabile. Non ha violato nessun teorema, sta sfruttando la ridondanza fra
un carattere e il successivo che quel conto ignorava; e resta comunque sopra il
mezzo bit della sorgente vera, perché un compressore generico quella struttura
la indovina, non la conosce.
L’entropia per simbolo dell’inglese scritto Shannon la stimò nel 1951 in circa un bit per lettera [Sha51], e va confrontata con i quasi \(5\) bit che darebbero ventisei lettere equiprobabili tenendo conto solo di quante sono. Uno zip morde bene un testo perché quella ridondanza c’è tutta; non morde più niente su un file già compresso, dove è già stata spremuta via.
Un compressore assegna codici corti ai simboli frequenti; un modello che predice il simbolo successivo dà probabilità più precise, condizionate a ciò che è appena stato letto. Con la codifica aritmetica un modello \(q\) scrive un testo \(x_1\dots x_T\) in circa \(-\sum_{t=1}^{T}\log_2 q(x_t\mid x_{<t})\) bit, cioè \(T\) volte la sua cross-entropia per simbolo: dove il modello indovina, la sorpresa è quasi zero e non c’è quasi niente da scrivere. Predire bene e comprimere bene sono lo stesso problema, e la perdita con cui si addestra un modello linguistico è, a meno della base del logaritmo, la lunghezza media per simbolo del testo compresso con lui.
In pratica, con NumPy#
import numpy as np

def entropia(p):
    p = np.asarray(p, dtype=float)
    p = p[p > 0]                        # convenzione: 0·log 0 = 0
    return -(p * np.log2(p)).sum()

equa     = [0.5, 0.5]
truccata = [0.9, 0.1]
dado     = np.full(6, 1/6)

print(entropia(equa))                   # 1.0
print(entropia(truccata))               # ~0.4690
print(entropia(dado))                   # ~2.5850

def cross_entropia(p, q):
    p, q = np.asarray(p, dtype=float), np.asarray(q, dtype=float)
    m = p > 0
    return -(p[m] * np.log2(q[m])).sum()

# la realtà è truccata, il modello crede la moneta equa
H_pq = cross_entropia(truccata, equa)   # 1.0
kl   = H_pq - entropia(truccata)        # ~0.5310: lo "spreco" in bit
print(H_pq, kl)

# perplessità: 2^H, il numero di alternative equiprobabili
print(2**entropia(equa), 2**entropia(dado))   # 2.0  6.0
E il conto della compressione, sulla sorgente con memoria: le lettere arrivano in gruppi obbligati, e chi conta solo quanto è frequente ciascuna non se ne accorge.
import gzip

rng = np.random.default_rng(0)
parole = ["gatto ", "cane ", "topo ", "riso ", "muro ", "tetto "]
testo = "".join(rng.choice(parole) for _ in range(20_000))

# sorpresa media contando SOLO quanto è frequente ciascun carattere
_, conteggi = np.unique(list(testo), return_counts=True)
h_zero = entropia(conteggi / conteggi.sum())

# quanto ci mette davvero un compressore ordinario, in bit per carattere
compresso = gzip.compress(testo.encode(), 9)
gzip_per_carattere = 8 * len(compresso) / len(testo)

print(f"{h_zero:.2f}  {gzip_per_carattere:.2f}")
3.36 0.80
Da ricordare
L’informazione è sorpresa: una notizia scontata (domani sorge il sole) non informa, una rara sì. Si misura in bit, e un bit è una domanda ben posta, con risposta sì o no.
L’entropia è la sorpresa media di una sorgente: 1 bit a lancio per la moneta equa, circa 0,47 per quella truccata che dà testa nove volte su dieci, circa 2,585 per il dado a sei facce. Massima quando tutti gli esiti sono ugualmente possibili, nulla quando l’esito è già deciso in partenza.
La cross-entropia è quanto costa scrivere i messaggi con il codice sbagliato (il Morse tarato sull’inglese, usato per l’italiano); i bit pagati in più rispetto al codice giusto, cioè lo spreco puro, sono la divergenza di Kullback–Leibler: mai negativa, zero solo se il modello indovina la realtà, e diversa a seconda del verso in cui si sbaglia (perciò non è una distanza).
Addestrare un classificatore rendendo la risposta giusta sempre meno sorprendente, avvicinare le credenze del modello alla realtà e scegliere i parametri che rendono i dati più plausibili sono tre nomi per la stessa operazione.
L’informazione mutua è quanto una cosa dice di un’altra: l’incertezza di prima meno quella che resta dopo averla saputa (un bit, per «è pari» sul dado). È la stessa nei due versi, è zero solo fra cose che non hanno niente a che fare l’una con l’altra, e in media una notizia non aumenta mai il dubbio, anche se una notizia singola può farlo.
La perplessità traduce l’entropia in facce del dado: quante alternative ugualmente probabili darebbero la stessa incertezza (2 per la moneta equa, 6 per il dado). Meno facce, meno incertezza: è un numero da far scendere, e sotto \(1\) non va. La ritroveremo nei modelli di linguaggio.
Comprimere senza perdere niente ha un limite, ed è l’entropia per simbolo della sorgente: quanta sorpresa porta in media ogni pezzo di messaggio, tenuto conto di tutto quello che lo precede. È molto meno di quanto direbbero le sole frequenze delle lettere, ed è la ragione per cui uno zip su un testo fa meglio di quel conto ingenuo, e non fa niente su un file già compresso.
Da ricordare
L’informazione è sorpresa: un esito di probabilità \(p\) vale \(-\log_2 p\) bit; tanto più, quanto più è raro.
L’entropia \(H(p)=-\sum_i p_i \log_2 p_i\) è la sorpresa media: 1 bit per la moneta equa, 0,47 per quella truccata, 2,585 per il dado. Massima sull’uniforme, nulla sul certo.
La cross-entropia \(H(p,q)\) è il costo di usare il «codice» sbagliato; la divergenza KL \(D_{KL}(p\,\|\,q)=H(p,q)-H(p)\ge 0\) è lo spreco puro. Asimmetrica: non è una distanza.
Minimizzare la cross-entropy come loss = minimizzare la KL fra dati e modello = massima verosimiglianza: tre nomi per la stessa operazione.
\(I(X;Y)=H(Y)-H(Y\mid X)=D_{KL}\big(p(x,y)\,\|\,p(x)p(y)\big)\ge 0\): simmetrica, nulla se e solo se \(X\) e \(Y\) sono indipendenti. Condizionare riduce l’entropia in media, non per ogni valore osservato, e lungo una catena \(X\to Y\to Z\) vale \(I(X;Z)\le I(X;Y)\).
La perplessità \(2^{H}\) traduce l’entropia in «facce del dado»; quella di un modello si minimizza, con pavimento \(1\), e la ritroveremo nei modelli di linguaggio.
Il limite della compressione senza perdite è l’entropia per simbolo (entropy rate) \(\lim_n H(X_1,\dots,X_n)/n\), non la \(H\) di ordine zero calcolata sulle frequenze marginali: per una sorgente con memoria la seconda sovrastima largamente, e un compressore generico la scavalca senza contraddire Shannon.
Tutto questo conta in bit. Anche la memoria del calcolatore si conta in bit, cioè in cifre binarie, e lì il numero di cifre è fissato una volta per tutte: un numero reale deve starci dentro comunque. Che cosa si perde nel farcelo entrare, e come si evita che la perdita cresca durante un conto, è l’argomento dell’analisi numerica.