


Generative Adversarial Networks#
L’idea delle GAN nasce in un bar di Montréal, «Les 3 Brasseurs», una sera del 2014, e a raccontarla è stato lo stesso Ian Goodfellow [Gil18]. Dottorando nel laboratorio di Yoshua Bengio, sta festeggiando un collega che ha appena discusso la tesi, e alcuni amici gli chiedono aiuto: vogliono un programma che crei fotografie da sé, e il loro metodo è un’analisi statistica degli elementi che compongono una fotografia (quanto spesso due pixel vicini hanno lo stesso colore, quali sfumature si accompagnano a quali), da cui costruire un’immagine nuova che li rispetti tutti. Sarebbe una mole di calcoli senza fine, e Goodfellow obietta che così non funzionerà; ma intanto gli viene un’idea diversa: e se invece di una rete sola se ne mettessero due, una a fabbricare immagini e una a smascherarle, e le si facesse combattere? Tornato a casa scrive il codice fino a notte fonda, e funziona al primo colpo. Ne esce l’articolo Generative Adversarial Nets [GPAM+14]: generative adversarial networks, alla lettera reti generative avversarie, cioè reti che fabbricano qualcosa e che imparano a farlo sfidandosi.
Generare, non classificare#
Abbiamo già incontrato reti che producono qualcosa: un modello linguistico scrive la parola dopo, un sintetizzatore legge un testo ad alta voce. Tutte e due, mentre imparavano, avevano accanto la risposta giusta: la parola che veniva davvero dopo, l’onda che quella frase aveva davvero. Nel sintetizzatore vocale, e prima ancora nei codec neurali, c’era già una seconda rete addestrata a riconoscere i falsi, ma lavorava accanto al confronto con l’onda vera, non al suo posto. Chi deve disegnare un gatto mai esistito, invece, una risposta giusta non ce l’ha e non può averla: non c’è nessun originale da mettere accanto al risultato per vedere, punto per punto, di quanto ci si è allontanati. La domanda delle GAN è proprio questa: come si insegna a una rete a fabbricare dati nuovi e plausibili quando non c’è niente con cui confrontarli.
Una risposta l’ha appena data il capitolo sui modelli latenti: si scrive la verosimiglianza \(p_\theta(\mathbf{x})\), cioè quanto il modello trova probabile un dato, e siccome calcolarla esattamente non si può, se ne fa salire un limite inferiore, l’ELBO. Le GAN prendono la strada opposta, ed è la scelta che spiega tutto il resto: qui una verosimiglianza non si scrive affatto, e al suo posto si mette una seconda rete che guarda il risultato e dice se ci crede.
Un classificatore guarda la foto di un gatto e dice «gatto». Un modello generativo, partendo da un pugno di numeri casuali, disegna la foto di un gatto che non è mai esistito: un gatto che nessuna macchina fotografica ha mai ripreso. Non ha imparato a mettere un’etichetta: ha imparato la «ricetta» di che aspetto ha una foto di gatto, e può cucinarne di nuove all’infinito.
I numeri casuali sono la sua materia prima: una manciata (un centinaio, di solito), tirati a sorte, quasi tutti piccoli e vicini allo zero e qualcuno più grosso ogni tanto. Ad addestramento finito la rete non cambia più, e quei numeri sono l’unica cosa che distingue una richiesta dall’altra: numeri diversi in ingresso, gatti diversi in uscita.
E devono essere tirati a sorte nello stesso modo anche dopo. In addestramento alla rete arrivano solo manciate sorteggiate così, e lei impara a cavarsela dove quelle manciate cadono. Una manciata scelta a mano (numeri tutti grandi, o in fila 1, 2, 3…) cade quasi sempre in un territorio dove la rete non è mai stata, e quello che ne esce non ha nessuna ragione di somigliare a un gatto.
Un modello discriminativo apprende la probabilità condizionata \(p(y \mid \mathbf{x})\) di un’etichetta \(y\) dato l’input \(\mathbf{x}\). Un modello generativo apprende, esplicitamente o implicitamente, la distribuzione dei dati \(p_{\text{dati}}(\mathbf{x})\), così da poterne campionare esempi nuovi. Una GAN la apprende in modo implicito: non stima una densità in forma chiusa, ma costruisce un campionatore \(G(\mathbf{z})\) che trasforma un rumore semplice \(\mathbf{z} \sim p_z\) (tipicamente gaussiano) in campioni che l’addestramento spinge a diventare indistinguibili da quelli reali; la distribuzione da cui questi campioni provengono si indica con \(p_G\). In generazione \(\mathbf{z}\) si estrae dallo stesso \(p_z\) dell’addestramento: \(G\) è stato addestrato soltanto dove \(p_z\) ha massa, e quando \(p_z\) è la normale standard in \(L\) dimensioni quella massa sta quasi tutta nel guscio \(\lVert\mathbf{z}\rVert \approx \sqrt{L}\). Un \(\mathbf{z}\) scelto a mano con norma molto diversa (le componenti \(1, 2, \dots, L\), per esempio) cade dove l’uscita non è controllata.
Due reti in competizione#
Le reti sono due e si addestrano l’una contro l’altra: il generatore fabbrica dati, il discriminatore li giudica. Il duello si è già visto al lavoro due volte: nei codec neurali, dove un discriminatore costringe il decoder a produrre audio che suoni vero, e nel vocoder HiFi-GAN della sintesi vocale, dove i discriminatori sono parecchi e ascoltano l’onda ciascuno a modo suo. Smontarlo serve a vedere a quali condizioni un duello del genere sta in piedi.
Un falsario dipinge quadri contraffatti; un esperto d’arte deve dire quali sono autentici e quali falsi. All’inizio il falsario è maldestro e l’esperto lo smaschera senza sforzo. Ma ogni volta che viene scoperto, il falsario impara qualcosa e migliora; e l’esperto, di fronte a falsi sempre più raffinati, affina il proprio occhio. È una corsa agli armamenti: i due si perfezionano a vicenda. Se la corsa arriva in fondo, i falsi sono così buoni che nemmeno l’esperto sa più distinguerli. Il generatore è il falsario, il discriminatore è l’esperto.
Resta una domanda, ed è il cuore di tutto il capitolo: il falsario impara che cosa? Se l’esperto si limitasse a dire «falso», il falsario saprebbe di aver sbagliato ma non saprebbe dove, ed è la stessa differenza che passa fra un professore che scrive «no» in fondo al compito e uno che sottolinea le righe da rifare. L’esperto di questa storia appartiene al secondo tipo: non dice «falso», dice «falso, e soprattutto per via di questo qui», indicando col dito, punto per punto del quadro, da che parte tirare. Come faccia, e perché per riuscirci debba essere una rete e non una persona, lo racconta la sezione sull’addestramento avversario.
Le due reti hanno ruoli antagonisti. Il generatore \(G\) mappa un vettore di rumore \(\mathbf{z}\) in un campione sintetico \(G(\mathbf{z})\). Il discriminatore \(D\) riceve un’immagine e restituisce \(D(\cdot) \in [0,1]\), la probabilità stimata che sia reale. Si addestrano insieme ma con obiettivi opposti: \(D\) vuole assegnare \(1\) ai dati veri e \(0\) ai falsi; \(G\) vuole che \(D\) assegni \(1\) ai propri falsi. Il segnale che smaschera il falso, propagato all’indietro attraverso \(D\), è lo stesso che insegna a \(G\) come migliorarlo: è questa condivisione a saldare l’addestramento delle due reti in un unico ciclo di feedback.
Quel segnale è il perno dell’intero capitolo, e non è il verdetto. Ciò che risale da \(D\) verso \(G\) è il gradiente della loss del generatore rispetto al dato generato \(\tilde{\mathbf{x}} = G(\mathbf{z})\), cioè \(\partial \mathcal{L}_G / \partial \tilde{\mathbf{x}}\): non un numero ma un vettore, con una componente per ogni numero del dato, che dice in che verso spostare ciascuna di quelle componenti perché il verdetto cambi. È una direzione, non un voto, e la sua esistenza richiede che \(D\) sia derivabile rispetto al proprio ingresso: la sezione seguente riprende il punto con la regola della catena.
Lo schema complessivo del gioco è quello di Fig. 26.1.

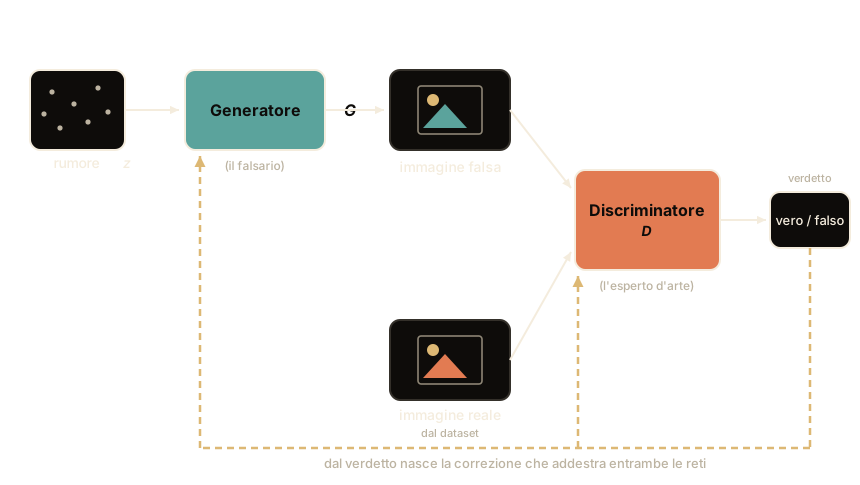
Fig. 26.1 Il gioco avversario. Il generatore trasforma numeri casuali in un’immagine falsa; il discriminatore riceve immagini di tutti e due i tipi, una per volta, e su ciascuna emette un verdetto. Da come è arrivato al verdetto si ricava una correzione, che torna indietro a tutte e due le reti: al discriminatore serve per sbagliare di meno, al generatore per farlo sbagliare di più. La correzione non è il verdetto ed è molto più ricca di quello, ma per capire perché bisogna arrivare alla sezione seguente.#
Il gioco a somma zero#
Generatore e discriminatore giocano l’uno contro l’altro: ciò che guadagna uno lo perde l’altro. In teoria dei giochi si chiama gioco a somma zero, e si descrive con una sola funzione di valore, \(V(D,G)\), che il discriminatore vuole il più alta possibile e il generatore il più bassa possibile.
È un tiro alla fune: il discriminatore tira da una parte (vuole avere sempre ragione), il generatore tira dall’altra (vuole ingannarlo), e la corda è una sola. L’immagine però va fermata qui: in un tiro alla fune, quando nessuno dei due si sposta più non sta succedendo niente, mentre fra falsario ed esperto il pareggio è il traguardo.
Il pareggio arriva quando il falsario è diventato bravissimo. Se i suoi quadri sono indistinguibili da quelli veri, l’esperto non ha più niente su cui appoggiarsi: qualunque cosa gli passi davanti, può solo tirare a indovinare, come a testa o croce, e indovina una volta su due. Quel 50% è il massimo che chiunque possa ottenere quando non c’è più niente da vedere, non un esperto che si è arreso.
Ma perché dovrebbe finire così, e non con l’esperto che vince sempre e il falsario che resta scarso per sempre? Perché l’esperto, quando boccia un quadro, dice anche dove ha visto il falso: finché fra falsi e veri resta una differenza da vedere, il falsario ha una strada per correggersi. E quella strada porta verso i quadri veri, non verso un quadro qualunque, per via di un dettaglio dell’allenamento dell’esperto: ogni volta che tocca a lui guarda anche dei quadri autentici, ed è su quelli che viene corretto. È lui il punto in cui la realtà entra nel gioco. La corsa si ferma solo quando di differenze da vedere non ce ne sono più, cioè al pareggio.
Quel pareggio è delicato, e si rompe in due modi. L’esperto può prendere troppo vantaggio, e allora il falsario non ha più modo di stargli dietro. Oppure il falsario trova un quadro che passa sempre e da lì in poi dipinge quello e basta: l’inganno riesce, ma la varietà sparisce. Sono problemi concreti, e la sezione sull’addestramento avversario li riprende uno per uno.
Goodfellow formula l’addestramento come un problema minimax sulla funzione di valore \(V(D,G)\):
Qui \(\mathbf{x}\sim p_{\text{dati}}\) è un campione reale, \(\mathbf{z}\sim p_z\) è il rumore in ingresso a \(G\), \(D(\mathbf{x})\) è la probabilità stimata che l’input sia autentico. Il primo termine è l’unico in cui compaiono i dati: è attraverso \(D\) che \(p_{\text{dati}}\) entra nel gioco, e \(G\) la vede soltanto di riflesso. Il discriminatore massimizza \(V\) (assegna probabilità alta ai veri, bassa ai falsi \(G(\mathbf{z})\)); il generatore minimizza il secondo termine, cioè spinge \(D(G(\mathbf{z}))\) verso \(1\). All’ottimo teorico si ha \(p_G=p_{\text{dati}}\) e \(D(\mathbf{x})=\tfrac{1}{2}\) sul supporto dei dati: l’esperto non sa più decidere. In pratica l’equilibrio è delicato: instabilità dell’addestramento e mode collapse (il generatore che produce sempre la stessa immagine vincente) sono i due grattacapi ricorrenti, e la sezione sull’addestramento avversario li riprende uno per uno.
Perché ce ne importa#
Le GAN hanno spostato il confine di ciò che una macchina può fabbricare. Da questa idea nascono i volti fotorealistici di persone inesistenti: la famiglia StyleGAN di NVIDIA [KLA19] alimenta siti come This Person Does Not Exist, dove ogni ricarica mostra un volto sintetico che a un primo sguardo non si distingue da una fotografia. Da qui arrivano anche i deepfake (volti sostituiti nei video) con tutto il loro carico di rischi per disinformazione e consenso. E arriva l’arte generata, con un ritratto prodotto da una GAN battuto all’asta da Christie’s nel 2018: l’episodio, e la questione di chi ne sia l’autore, tornano nella sezione sulle applicazioni.
Uno strumento potente e ambivalente, insomma: capace di fabbricare dataset (le raccolte di esempi su cui si addestrano le altre reti), di restaurare immagini e perfino di proporre molecole nuove, descritte come grafi (atomi collegati dai loro legami), ma anche di fabbricare falsi convincenti.
Il duello, e quello che ne è nato#
Dall’intuizione si passa al meccanismo. La sezione sull’addestramento avversario dice che cosa entra e che cosa esce da ciascuna delle due reti, che cosa esattamente l’una restituisce all’altra, e come dalla funzione di valore ciascuna ricavi la propria loss, cioè il conto del proprio errore. Poi il ciclo di addestramento a turni, scritto riga per riga in PyTorch, con le sue insidie: il duello che non si stabilizza, e il mode collapse, il generatore che trova un solo campione capace di ingannare il discriminatore e si limita a rifare quello. Da lì due domande. Come si misura se una GAN sta funzionando, visto che la sua loss non lo dice: con l’Inception Score e soprattutto con il FID, che giudicano un insieme di immagini invece di una sola. E come si stabilizza il duello: cambiando la distanza che il gioco minimizza (la Wasserstein GAN), vincolando il discriminatore (il gradient penalty, la normalizzazione spettrale), oppure le regole dell’addestramento.
La sezione sulle evoluzioni racconta le varianti che hanno fatto la storia, dalla DCGAN alle GAN condizionali fino a StyleGAN e ai suoi successori, e chiude sul passaggio di testimone ai modelli di diffusione. Quelli generano in un altro modo: addestrano una sola rete a togliere il rumore da un’immagine, e ne producono una nuova partendo da rumore puro e ripulendolo un passo alla volta. È la famiglia che dal 2021 ha tolto alle GAN il primato, e ha un capitolo tutto suo.