


Il contesto è l’interfaccia: la finestra di un agente#
Due squadre costruiscono un assistente che risponde ai clienti di un negozio. Si rivolgono allo stesso identico modello, dallo stesso fornitore, con le stesse impostazioni. Una ottiene risposte precise e nel tono giusto; l’altra, risposte vaghe che inventano politiche di rimborso mai esistite. Nessuno ha addestrato niente: la differenza sta tutta in cosa le due squadre scrivono davanti al modello prima di premere invio, cioè quali istruzioni, quali esempi, quali documenti e in quale ordine. Il modello è lo stesso: cambia quello che gli si mette davanti.
Quello che sta «davanti al modello» è il contesto, e il suo contenitore è la finestra di contesto già incontrata nell’anatomia di un agente: il numero massimo di token che il modello elabora in una volta, fissato da chi l’ha costruito (per esempio 128.000).
Ed è lì che sta il mestiere. Per chi usa un modello già addestrato, senza riaddestrarlo, l’unica leva è il testo che gli mette davanti: in questo senso il contesto è l’interfaccia del modello, l’unico punto da cui passa ogni comando. Con un modello di oggi non si programma scrivendo codice, si programma scrivendo il contesto. Nella sezione sui grandi modelli linguistici questa scoperta ha un nome inglese, l’in-context learning, l’imparare dal contesto: gli descrivi il compito lì dentro, magari con due esempi, e lui lo esegue senza che nessuno abbia cambiato una virgola dentro di lui. È un modo di comandare un programma scrivendo in italiano invece che in codice, e come tutti i comandi è potente e fragile insieme: una parola diversa cambia la risposta.
Il mestiere che nasce da lì si chiama context engineering, l’ingegneria del contesto: l’insieme delle strategie con cui si sceglie e si mantiene, a ogni passo, il testo che entra nella finestra (istruzioni, esempi, documenti recuperati, cronologia, risultati degli strumenti) [Anthropic25a]. La sua trattazione completa sta nel capitolo su prompt, contesto e loop, e in particolare nella sezione sul context engineering: come si pensa il contesto, come lo si monta dentro un budget, quali mosse lo governano, in quanti modi si guasta.
E per un agente il problema è ancora più acuto, perché il ciclo osserva → ragiona → agisci riempie il contesto da sé: ogni pensiero, ogni chiamata a uno strumento, ogni osservazione di ritorno è testo che si accumula, la cronologia, cioè l’elenco di tutto quel che si è detto e fatto finora. Con osservazioni di migliaia di token bastano poche decine di passi per occuparne buona parte. E anche prima del limite la qualità cala, perché la capacità del modello di ritrovare un’informazione nel contesto diminuisce al crescere dei token che contiene: Anthropic lo chiama context rot, il contesto che marcisce [Anthropic25a]. Decidere che cosa tenere e che cosa togliere fa quindi parte del progetto dell’agente.
La finestra è piccola e preziosa#
La finestra di contesto ha una misura, e la misura è un numero preciso. Non si conta in parole né in pagine, ma in token: i pezzetti in cui una frase viene tagliata prima di entrare nel modello. Quanto sia grande un pezzetto dipende dalla lingua e dal modello: in inglese vale grosso modo una parola, in italiano vale meno, e una parola sola ne consuma spesso più di uno. Ogni modello dichiara quanti token riesce a leggere in una volta, e oltre quel numero non si va.
Riempirli non è gratis, e il prezzo si conta in token.
Si paga in tre valute. In memoria, perché per non ricalcolare a ogni passo ciò che ha già letto il modello conserva le chiavi e i valori dell’attenzione di tutto il contesto. È il taccuino della sezione sull’attenzione in pratica, e cresce linearmente con i token: per il modello da sette miliardi di quella sezione, nella variante con tutte le teste (MHA), costa 512 KiB a token. A ottomila token sono già 4 GiB contro i 13 GiB dei pesi, e a 128.000 token lo spazio occupa parecchie volte il modello stesso. In secondi di attesa, perché il contesto va elaborato tutto prima che compaia il primo token della risposta. E in denaro, perché i fornitori fanno pagare ogni token che entra e ogni token che esce: quel listino si chiama costo per token, ha uno sconto sulla parte già vista quando si usa la cache dei prefissi, ed è una delle cose che LLMOps tiene d’occhio. Un contesto gonfio è una bolletta più salata e una risposta più lenta, e riempire la finestra fino all’orlo «per sicurezza» è quasi sempre un cattivo affare.
La Fig. 20.11 mostra come la finestra si riempie in una giornata di lavoro vera, e due delle sue voci vanno chiamate per nome. La prima è il system prompt: il foglio di istruzioni di fondo che il programma antepone sempre, uguale a ogni richiesta, e che l’utente non vede né scrive. La seconda sono le definizioni tool, cioè il catalogo degli strumenti del tool use, con nome, descrizione e argomenti di ciascuno: il modello lo legge come legge tutto il resto, e quindi si paga.

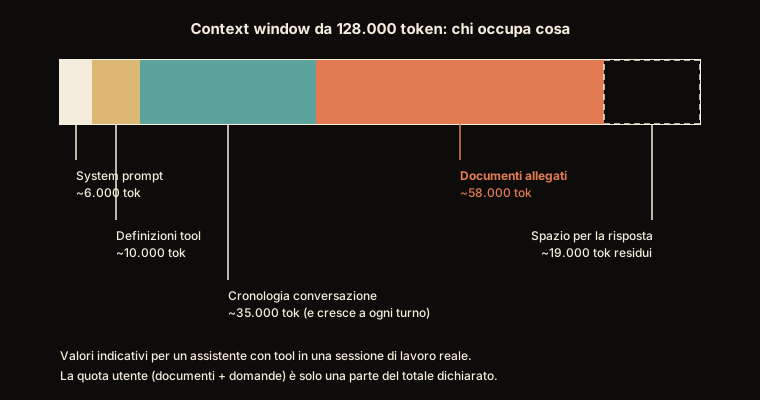
Fig. 20.11 La finestra come budget da ripartire. Ogni segmento toglie spazio agli altri, e l’ultimo (lo spazio per la risposta) è quello che si dimentica di contare finché il modello non la tronca a metà.#
Messa così, la finestra rivela la sua vera natura: un budget. I centoventottomila token del disegno (grosso modo un romanzo) sembrano tantissimi finché non li si vede ripartiti fra cinque voci che competono: ogni token che va a una lo toglie alle altre. E come ogni budget si può spendere bene o male: una descrizione di strumento scritta larga, una cronologia che nessuno accorcia mai, dieci documenti recuperati dove ne bastavano tre. Nessuna di queste è un errore in sé, ma insieme mangiano lo spazio della risposta, che è l’ultimo segmento e l’unico che nessuno pensa a contare.
C’è di peggio, e va contro l’intuizione: anche quando lo spazio ci sarebbe, riempirlo può danneggiare la risposta, perché i modelli usano bene l’informazione che sta all’inizio e alla fine del contesto e trascurano quella sepolta in mezzo: è il lost in the middle, dal titolo dell’articolo in cui Nelson Liu e colleghi l’hanno misurato [LLH+24]. Per un agente la conseguenza è immediata, perché i passi vecchi della traccia finiscono proprio lì, fra le istruzioni in testa e l’ultima osservazione in fondo. Come lo si è misurato, e come se ne tiene conto quando si monta il contesto, lo racconta la sezione sul context engineering.
La memoria: oltre la finestra#
La finestra, allora, è quello che l’agente tiene «in testa» adesso: la sua memoria di lavoro, veloce da consultare, stretta, e che sparisce appena la conversazione finisce. Ma un agente serio deve ricordare anche oltre il singolo scambio: chi è l’utente, cosa si è detto ieri, cosa contengono mille pagine di documentazione che nella finestra non entrerebbero mai tutte insieme. Serve una memoria a lungo termine, e per forza deve stare fuori dal contesto.
A mente tieni giusto le poche cose che ti servono ora: è veloce, ma ci sta poco e svanisce. Su un’agenda invece finisce tutto quello che hai annotato nel tempo: non la leggi tutta insieme, la apri alla pagina giusta quando ti serve.
Un agente fa lo stesso. Nel breve termine usa un foglio di brutta dentro la finestra: ci scrive i risultati intermedi, i conti a metà, gli appunti del compito in corso. Nel lungo termine tiene uno schedario fuori, e la sua bravura sta nel pescarne solo la pagina che serve adesso, invece di tenere tutto aperto sul tavolo (dove non ci starebbe, e dove si perderebbe nel mezzo).
Nello schedario finiscono tre generi di cose, e conviene distinguerle perché si recuperano in modi diversi. I documenti, che si vanno a cercare come abbiamo visto parlando di RAG. I riassunti di quello che si è già detto: quando una conversazione si allunga troppo, invece di portarsela dietro parola per parola se ne tiene un sunto, che costa una frazione dello spazio. E i fatti sull’utente, cioè le poche cose che valgono sempre (come si chiama, che lingua parla, cosa ha già chiesto tre volte), tenute a parte e rimesse davanti al modello quando c’entrano.
E quando un lavoro è troppo grande per un tavolo solo, se ne passa un pezzo a un aiutante, che lo sbriga sul suo tavolo e riporta soltanto il risultato: sul tavolo dell’agente arriva una pagina, non tutte le carte che sono servite a scriverla.
La memoria a breve termine è lo scratchpad: uno spazio nel contesto in cui l’agente scrive i propri stati intermedi (la traccia ReAct del ciclo dell’agente ne è un esempio) e che vive quanto vive la finestra. La memoria a lungo termine è esterna e persistente, e la letteratura la organizza a livelli, come la memoria virtuale di un sistema operativo: in MemGPT [PWL+23] la finestra è la memoria principale, l’archivio esterno la secondaria, e il modello stesso decide che cosa spostare fra le due. Tre forme ricorrono. La prima è il database vettoriale: i ricordi (documenti, scambi passati) vengono codificati in embedding e recuperati per similarità quando servono; è esattamente il RAG dei Transformer, letto qui come un meccanismo di memoria, non solo di recupero. La seconda è il riassunto progressivo: quando la cronologia della conversazione si allunga, la si comprime in un sunto che ne conserva l’essenziale a costo di token molto minore, liberando finestra. La terza sono i fatti strutturati (preferenze, identità, vincoli dell’utente) tenuti a parte e reiniettati quando pertinenti. Nelle pratiche descritte da Anthropic nel 2025 [Anthropic25a] le stesse idee hanno nomi propri: la compattazione (riassumere la conversazione e ripartire con una finestra nuova), gli appunti strutturati tenuti fuori dalla finestra, e i sotto-agenti, ciascuno con una finestra sua, che restituiscono all’agente principale solo un riassunto del proprio lavoro. Il nodo difficile sta a valle dell’archivio, ed è una politica di ammissione: che cosa di tutto quel materiale merita la finestra a questo passo.
La memoria esterna non ha il limite della finestra, ma ogni voce che rientra nel contesto ne consuma lo spazio. Scrivere bene in memoria è già un problema (che cosa conservare, come aggiornare un fatto che cambia, quando dimenticare), e a ogni passo se ne aggiunge un secondo: decidere che cosa di tutto quel materiale merita di occupare la finestra adesso. Ogni riga che ci metti per ricordare è una riga in meno per ragionare, e il conto lo si paga subito: la domanda difficile non è cosa tenere, è cosa lasciare fuori.
Pensare costa token: il ragionamento come context engineering#
Un’ultima osservazione chiude il cerchio. Far «ragionare ad alta voce» l’agente prima di agire, cioè fargli scrivere i passaggi intermedi nel contesto prima della conclusione (la catena di ragionamento, la chain-of-thought [WWS+22]), è anch’essa ingegneria del contesto: si spende deliberatamente una parte del budget in token di «pensiero» per comprare qualità di risposta. Il ragionamento non è gratis, perché occupa finestra e fa aspettare, e il guadagno misurato si concentra sui compiti matematici e simbolici [SYR+25]: altrove spesso non ripaga il costo, e va speso dove serve.
L’idea si può spingere oltre sui problemi che chiedono di pianificare. Invece di seguire un unico filo fino in fondo, si aprono più strade di ragionamento, si valuta dove portano e si torna indietro da quelle che non promettono: è il Tree of Thoughts («albero di pensieri») [YYZ+23]. Il suo banco di prova più citato è il gioco del 24: quattro numeri da combinare con le quattro operazioni, usandoli una volta ciascuno, per ottenere 24.
Con 4, 9, 10 e 13 bisogna arrivare a 24. Chi va a colpo d’occhio scrive un’operazione dopo l’altra e spera; se al terzo passo i conti non tornano, il tentativo è sprecato, e si ricomincia da zero.
Chi va con metodo fa un passo e si ferma a guardare. Prova 13 − 9 = 4, e scrive su un foglietto che cosa gli resta: 4, 4 e 10. Prova anche 10 − 4 = 6, e su un altro foglietto: 6, 9 e 13. Per ogni foglietto si chiede se da lì a 24 ci si arriva: «sicuro», «forse» o «impossibile» (con 1, 1 e 2, per dire, non ci si arriva in nessun modo). Butta gli impossibili, tiene i più promettenti e riparte da quelli, un passo per volta; se una strada si chiude, torna al foglietto di prima e prova un’altra mossa. Da 4, 4 e 10 si arriva a (10 − 4) × 4 = 24: era la strada buona.
Ogni foglietto in più costa carta e tempo, e il confronto onesto va fatto a parità di fatica. Un tentativo solo a colpo d’occhio, sui giochi difficili, va a segno quattro volte su cento; cento tentativi, contando il gioco come risolto se anche uno solo va a segno, circa la metà delle volte; il metodo dei foglietti, tenendone a ogni passo i cinque migliori, tre volte su quattro.
Uno stato è \(s = [x, z_1, \dots, z_i]\), il problema \(x\) con i pensieri \(z_1, \dots, z_i\) prodotti finora, e il metodo ha quattro pezzi [YYZ+23]. La scomposizione decide che cos’è un pensiero: nel gioco del 24 un’operazione con i numeri che restano, tre in tutto. Il generatore propone \(k\) pensieri successivi a partire da \(s\), campionandoli indipendentemente o, quando lo spazio è stretto, chiedendoli tutti in una volta con un prompt di proposta, così che non si ripetano. Il valutatore, lo stesso modello, stima quanto prometta ciascuno stato (nel gioco del 24, tre giudizi «sicuro / forse / impossibile» campionati per ogni stato). La ricerca decide quali stati espandere: in ampiezza (BFS, tenendo i \(b\) stati migliori a ogni livello) o in profondità (DFS, potando lo stato giudicato senza speranza e risalendo al padre). È la cosa che il filo unico non permette: abbandonare uno stato che non promette e riprendere da uno precedente.
I numeri sono di GPT-4 (maggio 2023), su cento giochi difficili di una raccolta di 1.362. Una sola catena di pensiero ne risolve il 4%, l’albero il 45% con \(b = 1\) e il 74% con \(b = 5\). Il guadagno va letto a parità di costo: concedendo alla catena di pensiero cento tentativi e contando il gioco come risolto se almeno uno va a segno, cioè con un oracolo che sa riconoscere quello giusto, si arriva al 49%, ancora sotto l’albero che visita più nodi. Il prezzo è sempre lo stesso: più token, più tempo, più costo.
È il compromesso di fondo del context engineering, in una forma nuova: la finestra è un budget, e ogni cosa che ci metti (istruzioni, esempi, memoria recuperata, o il pensiero stesso del modello) la paghi, e va messa dove rende di più. Ed è, in fondo, quello che separava le due squadre da cui siamo partiti: che cosa mettere davanti al modello, e in che ordine.
Da ricordare
Con un modello istruito, se non lo si riaddestra, non si programma scrivendo codice, ma scrivendo il contesto: quello che gli metti davanti prima di fargli la domanda è l’unico comando che hai. Il mestiere di riempire bene quello spazio vale più di qualunque «frase magica».
La finestra è piccola e costosa: ogni parola che ci metti la paghi in memoria, in attesa e in denaro, e gli strumenti e la traccia di un agente se ne mangiano una parte a ogni passo. E il modello usa bene l’inizio e la fine di quello che legge, e trascura il centro (in inglese lost in the middle [LLH+24]): proprio lì finiscono i passi vecchi della traccia.
Memoria: a breve termine il foglio di brutta dentro la finestra, dove l’agente scrive i conti a metà; a lungo termine uno schedario esterno da cui pescare solo la pagina che serve adesso (i documenti recuperati, i riassunti di quello che si è detto, i fatti sull’utente tenuti a parte), e per i lavori grossi un aiutante che riporta solo il risultato. Il problema difficile è decidere cosa lasciare fuori dalla finestra adesso: ogni riga spesa a ricordare è una riga in meno per ragionare.
Anche pensare costa: far ragionare il modello a voce alta prima di rispondere [WWS+22], o fargli provare più strade e tornare indietro da quelle che non promettono (Tree of Thoughts [YYZ+23]), compra qualità spendendo spazio nella finestra. Come ogni spesa, va fatta dove rende: il ragionamento scritto aiuta soprattutto nei conti e nella logica, e l’albero nei problemi da pianificare, dove batte anche cento tentativi alla cieca.
Da ricordare
Per chi usa un LLM istruito senza riaddestrarlo, ciò che si mette nella finestra prima di chiedere è l’interfaccia. Il context engineering è l’insieme delle strategie per scegliere e mantenere a ogni passo i token del contesto [Anthropic25a]. Per un agente la cronologia cresce a ogni passo, e la qualità cala con i token anche prima del limite (context rot).
La finestra è finita e costosa: ogni token pesa sul taccuino delle chiavi e dei valori (lineare nella lunghezza, 512 KiB per token per un modello da sette miliardi a 16 bit), sull’attesa del primo token e sul costo per token; le definizioni degli strumenti e la cronologia ne occupano una parte che cresce a ogni passo. E c’è il lost in the middle [LLH+24]: i modelli usano bene l’inizio e la fine del contesto, male il centro, dove finiscono i passi vecchi della traccia.
Memoria: a breve termine lo scratchpad nella finestra; a lungo termine una memoria esterna, a livelli come la memoria virtuale (MemGPT [PWL+23]), nelle forme del database vettoriale/RAG, dei riassunti progressivi (la compattazione), dei fatti strutturati e dei sotto-agenti. Il problema difficile sta a valle, nella politica di ammissione: che cosa di quel materiale merita la finestra a questo passo.
Anche il ragionamento è context engineering: chain-of-thought [WWS+22] e la sua estensione ad albero, il Tree of Thoughts [YYZ+23], comprano qualità spendendo token di «pensiero». Il guadagno della prima si concentra su matematica e logica [SYR+25]; il secondo, nel gioco del 24, passa dal 4% al 74%, e resta sopra il 49% di cento catene giudicate da un oracolo.