


Kernel: dare ordini a migliaia di thread#
Scrivi c = a + b su due tensori PyTorch che vivono sulla GPU, e sembra
l’operazione più banale del mondo: la stessa somma che faresti su due numeri.
Ma se a e b hanno un milione di elementi ciascuno, dietro quella riga
innocua è appena partito un piccolo programma, lanciato in un colpo solo su un
milione di minuscoli esecutori che sommano ognuno la propria coppia di numeri,
tutti insieme. Quel programma ha un nome: kernel.
Il kernel è l’unità di lavoro che gira davvero sulla GPU, e finora l’abbiamo solo nominata. La parola ha già fatto un altro mestiere: il kernel del kernel trick era una regola che dà un numero per ogni coppia di punti, e con questo ha in comune soltanto il nome, che in inglese vuol dire nocciolo. Nella sezione sull’architettura abbiamo visto chi esegue (gli Streaming Multiprocessor, i warp da 32 thread); in quella sulla memoria, da dove arrivano i dati. Qui vediamo cosa eseguono: il kernel, appunto, e come lo si scrive.
Un programma solo, un milione di esecutori#
La cosa spiazzante, la prima volta, è che un kernel non descrive il lavoro intero. Descrive quello di un solo esecutore, un thread, su un pezzetto di dato, e la GPU lo replica su tutti i thread della griglia in una volta sola.
Per semplicità il kernel lavora su un array a una dimensione (in PyTorch, un tensore a una dimensione): il thread numero 7 si occupa dell’elemento in posizione 7, e così via.
Il kernel, dunque, si scrive per uno e si lancia su tutti. «Lanciare», qui, è il verbo tecnico: si passa alla GPU il programmino e le si dice su quanti esecutori farlo partire. Quell’insieme di esecutori è la griglia (in inglese grid) vista nell’architettura, cioè tutti i blocchi messi insieme. Ognuno esegue lo stesso codice su dati diversi, e per sapere su quali, comincia col ricavare il proprio numero.
Un milione di volantini da consegnare a mano, uno per cassetta della posta, e un esercito a disposizione. Non scrivi un milione di ordini diversi. Ne scrivi uno solo, che vale per tutti: «guarda il numero cucito sulla tua divisa, va’ alla cassetta con quel numero, infila il volantino». Poi lo leggi ad alta voce una volta, e l’intero esercito parte. Il soldato numero 0 va alla cassetta 0, il soldato numero 999.999 alla cassetta 999.999, tutti insieme. L’ordine è identico per ognuno; l’unica cosa che cambia è quel numero, che ciascuno ricava da sé per capire di quale cassetta occuparsi.
E lo ricava come farebbe un esercito vero. Sulla divisa non c’è scritto «999.999»: c’è scritto a quale squadra appartiene e che posto occupa in fila. Le squadre sono tutte della stessa misura, e quanto siano grandi lo sa ognuno. Da queste tre cose il conto viene da sé: quante squadre ho davanti, moltiplicato per quante persone stanno in una squadra, più il posto che occupo io. Squadre da quattro, e si conta partendo da zero: chi sta al posto 2 della squadra 1 ha davanti una squadra intera, cioè quattro cassette, e da lì conta altri due posti, quindi la sua è la cassetta 6. È quello che disegna la Fig. 8.9.
Un kernel è esattamente quell’ordine unico: una manciata di righe, scritte pensando a un esecutore, che la GPU fa eseguire in parallelo a un’intera folla. La riga «calcola il tuo numero» è la più importante di tutte: senza, i soldati si accalcherebbero tutti sulla stessa cassetta.
All’ordine manca ancora una riga, e serve perché le squadre sono tutte uguali mentre il numero delle cassette non si lascia dividere così docilmente. Dieci cassette e squadre da quattro: due squadre ne coprono otto, per le ultime due ne serve una terza, e così partono dodici persone per dieci cassette. Le due che avanzano andrebbero a cercare la cassetta 10 e la cassetta 11, che nel palazzo non ci sono; e chi non trova la propria cassetta lascia comunque il volantino da qualche parte, sotto una porta o nella buca del vicino, cioè dove non andava. Perciò l’ordine finisce così: «se il tuo numero supera l’ultima cassetta, fermati e non consegnare».
Questo stile si chiama SPMD, Single Program, Multiple Data: un unico
programma, tante copie in esecuzione su porzioni diverse dei dati.
Sull’hardware NVIDIA si concretizza nel modello SIMT già visto
nell’architettura: i 32 thread di un warp ricevono la stessa istruzione nello
stesso momento, ed è l’hardware a raggruppare per l’emissione quelli che si
trovano allo stesso punto del programma (dal 2017, come si è visto, ciascuno ha
il proprio program counter, quindi non è più un avanzamento in blocco per
costruzione). Nel modello CUDA [NBGS08] il kernel è una
funzione (marcata __global__ nel C per GPU) che riceve implicitamente le
coordinate del thread che la sta eseguendo, dentro la gerarchia griglia →
blocco → thread già introdotta. Tre variabili predefinite bastano a
orientarsi:
threadIdx, la posizione del thread dentro il suo blocco;blockIdx, la posizione del blocco dentro la griglia;blockDim: quanti thread ha ogni blocco.
Da queste, la prima riga di quasi ogni kernel ricostruisce l’indice globale del thread, la sua identità univoca nell’intera griglia:
dove \(i\) è l’indice dell’elemento di cui questo thread si occupa
(Fig. 8.9). Le tre variabili sono in realtà terne, con le
componenti .x, .y e .z: griglia e blocchi si possono disporre su una, due
o tre dimensioni, e su un array a una dimensione si usa la sola x, cioè
blockIdx.x * blockDim.x + threadIdx.x. Con blocchi da 4 thread, il thread
threadIdx=2 del blocco blockIdx=1 lavora sull’elemento
\(1 \cdot 4 + 2 = 6\). Da lì in poi il kernel è codice ordinario (legge x[i],
calcola, scrive y[i]) con la sola avvertenza che l’ultimo blocco può sforare
la fine dell’array (se la lunghezza non è un multiplo esatto della dimensione
del blocco), e allora serve un controllo i < n per non scrivere fuori dai
bordi.
In C per GPU un kernel completo sta in poche righe. Questo calcola \(\mathbf{y} = \max(0,\, a\mathbf{x} + b)\), lo stesso conto che fra poco si scrive in Triton:
__global__ void fused_kernel(const float* x, float* out, float a, float b,
                             int n) {
    int i = blockIdx.x * blockDim.x + threadIdx.x;  // indice globale
    if (i < n) out[i] = fmaxf(a * x[i] + b, 0.0f);  // un elemento per thread
}

// lancio: blocchi da 256 thread, tanti quanti ne servono per n elementi
fused_kernel<<<(n + 255) / 256, 256>>>(x, out, a, b, n);
Fra le parentesi angolari stanno il numero di blocchi della griglia e il
numero di thread per blocco. L’espressione \((n + 255)/256\) è la divisione
arrotondata per eccesso, perché la divisione fra interi del C tronca: lancia
un blocco in più quando \(n\) non è un multiplo di 256, ed è per gli ultimi
thread di quel blocco che serve la guardia i < n.

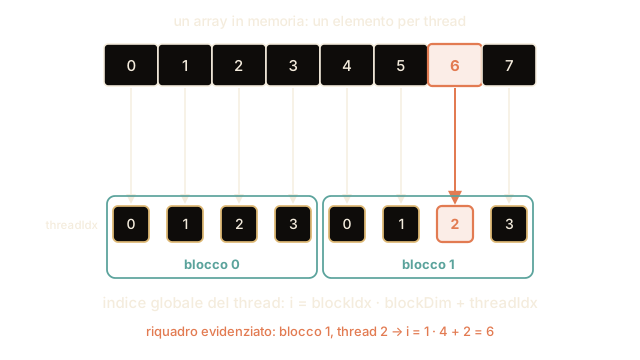
Fig. 8.9 L’indice globale, disegnato. Ogni thread sa due cose, il blocco a cui appartiene e il posto che occupa dentro il blocco, e da quelle due ricava il proprio numero unico in tutta la griglia: qui il terzo thread del secondo blocco (i blocchi sono da quattro, e si conta da zero) trova \(1 \cdot 4 + 2 = 6\), e va a occuparsi dell’elemento numero 6. È l’unica riga che distingue un esecutore dall’altro: il resto del kernel è identico per tutti.#
Un kernel in Python: Triton#
Un kernel, storicamente, si scrive in C, che è il linguaggio di programmazione con cui si parla alle macchine quando si vuole controllare tutto: potente, e faticoso. Chi lo usa deve calcolarsi gli indici a mano, decidere in quale memoria mettere ogni numero, tenere a mente i dettagli della scheda che ha davanti. Nel 2019 Philippe Tillet ha proposto un’alternativa che ha cambiato il modo di scriverlo, Triton [TKC19]: un linguaggio che ragiona a tessere, cioè a riquadri di dati di forma fissa, invece che al singolo esecutore. Quella prima versione era ancora un dialetto del C, e la riscrittura dentro Python, quella con cui i kernel Triton si scrivono oggi, arriva nel 2021, quando Tillet la pubblica da OpenAI [Til21].
Il motivo per cui ci riguarda da vicino è che Triton non serve solo a chi
scrive kernel a mano. Quando la sezione «Prestazioni e scala» chiedeva a PyTorch di riscriversi il programma in forma
più efficiente, con la riga torch.compile, la lingua in cui PyTorch se lo
riscrive è proprio questa: guardare un kernel Triton significa vedere che cosa
fabbrica quella riga.
Ecco un kernel che calcola in un colpo solo \(\mathbf{y} = \max(0,\; a \mathbf{x} + b)\). In parole povere: prendi ogni numero della lista, moltiplicalo per \(a\), aggiungi \(b\) e, se il risultato viene negativo, sostituiscilo con uno zero. Con \(a = 2\) e \(b = 1\): da \(3\) esce \(7\); da \(-4\) uscirebbe \(-7\), che diventa \(0\). Quell’ultima mossa («se è sotto zero, metti zero») è la ReLU incontrata fra le funzioni di attivazione delle reti neurali, e la catena moltiplica-somma-ReLU ricorre ovunque nelle reti. Che cosa calcola il kernel, insomma, lo abbiamo appena detto senza simboli; nel codice il kernel vero e proprio sono le sette righe di conti in alto, il resto è il modo di lanciarlo.
import os
import torch
if not torch.cuda.is_available():
    os.environ["TRITON_INTERPRET"] = "1"   # senza GPU, Triton interpreta il kernel sulla CPU
import triton
import triton.language as tl

dispositivo = "cuda" if torch.cuda.is_available() else "cpu"

@triton.jit
def fused_kernel(x_ptr, out_ptr, a, b,
                 n_elementi, BLOCK_SIZE: tl.constexpr):
    pid = tl.program_id(axis=0)                    # indice del blocco di programma
    inizio = pid * BLOCK_SIZE
    offsets = inizio + tl.arange(0, BLOCK_SIZE)    # gli indici che questo blocco elabora
    mask = offsets < n_elementi                    # non uscire dal bordo dell'array
    x = tl.load(x_ptr + offsets, mask=mask)        # UNA lettura dalla memoria
    y = tl.maximum(a * x + b, 0.0)                  # a*x + b e poi ReLU, tutto insieme
    tl.store(out_ptr + offsets, y, mask=mask)      # UNA scrittura in memoria


def fused_relu(x, a, b):
    out = torch.empty_like(x)
    n = out.numel()
    # quanti blocchi di programma servono per coprire tutti gli elementi
    grid = lambda meta: (triton.cdiv(n, meta["BLOCK_SIZE"]),)
    fused_kernel[grid](x, out, a, b, n, BLOCK_SIZE=1024)
    return out


x = torch.tensor([3.0, -4.0], device=dispositivo)  # sulla GPU, se c'è
print(fused_relu(x, a=2.0, b=1.0).cpu())
tensor([7., 0.])
C’è una differenza di taglia rispetto all’esercito di prima. Con CUDA (il
modo di programmare le GPU aperto da NVIDIA) l’ordine si dà al singolo soldato,
che si occupa di una cassetta sola. In Triton lo si dà a un’intera squadra:
«voi della seconda squadra, occupatevi delle cassette dalla 1024 alla 2047».
Il lotto che tocca a ogni squadra è di 1024 cassette, molto più delle quattro
di poco fa, ed è la riga BLOCK_SIZE=1024 del codice. Quante persone abbia la
squadra, invece, in quell’ordine non c’è scritto: se non lo dici lo decide
Triton, e le cassette restano comunque più delle persone, perché ognuna ne
lavora parecchie.
La misura del lotto non si sceglie a piacere: dev’essere una potenza di due, 256, 512, 1024. Le ragioni sono due. La prima riguarda chi lavora: i lavoratori marciano in plotoni da 32, e un lotto che non fosse un multiplo di 32 lascerebbe l’ultimo plotone con delle corsie vuote. La seconda riguarda chi traduce l’ordine in istruzioni per la macchina, il programma che si chiama compilatore: sa spezzare in parti uguali soltanto le taglie che si dimezzano fino in fondo, e davanti a una taglia come 96, che pure è un multiplo di 32, si ferma e protesta invece di provarci. Quale potenza di due, invece, non si sa a tavolino: dipende dalla scheda che si ha davanti e dal conto che le si sta chiedendo, e il modo di trovarlo è provarne qualcuna e cronometrare. Quel numero però va scritto nell’ordine prima che l’ordine parta: il compilatore vuole saperlo in anticipo, così prepara istruzioni tagliate apposta per squadre di quella taglia.
Poi si conta quanti lotti servono, e come sempre qualcosa avanza. Un milione
di cassette in lotti da 1024 fa 976 lotti pieni e un resto di 576 cassette:
di squadre ne partono 977, e l’ultima ha in mano un lotto in cui 448 cassette
non esistono. Per quelle vale la riga di prima, chi supera l’ultima cassetta si
ferma, ed è la riga mask del codice, quella che marca quali indici sono
buoni.
Come le persone della squadra si spartiscano poi il lotto non è più affar tuo: lo decide Triton, che tiene occupati i lavoratori della GPU quasi sempre come farebbe a mano un esperto. Tu ragioni a lotti; il compilatore scende ai dettagli. È per questo che un kernel Triton si scrive in Python leggibile, senza toccare né l’indice del singolo esecutore né la memoria in cui appoggiare i numeri.
Non tutti gli ordini, però, si sbrigano ciascuno per conto suo. Se alla squadra si chiede quanti volantini restano in tutto, i numeri vanno messi insieme, e passarli di mano in mano uno dopo l’altro vorrebbe dire trentuno passaggi per un plotone. Si sommano invece a coppie, poi le coppie a coppie: in cinque turni il plotone ha il suo totale, e lo stesso gioco si ripete fra i plotoni della squadra. Con i numeri con la virgola, però, l’ordine delle somme si sente nell’ultima cifra, perché ogni somma arrotonda: due squadre organizzate in modo diverso possono dare totali che differiscono lì.
Riga per riga: il decoratore @triton.jit dice a Triton di compilare la
funzione in un kernel per GPU. tl.program_id(axis=0) è l’analogo del
blockIdx di prima: l’identità di questa istanza del programma. Da lì
offsets costruisce, con tl.arange, l’elenco degli indici di cui l’istanza
si occupa; mask marca quelli validi (gli altri, oltre la fine dell’array,
verranno ignorati); tl.load legge dalla memoria solo le posizioni valide,
tl.maximum(a * x + b, 0.0) fa tutti i conti sui dati appena caricati, e
tl.store scrive il risultato. La funzione fused_relu sotto è il
lancio: alloca l’uscita, calcola quante istanze servono (triton.cdiv, la
divisione arrotondata per eccesso) e invoca il kernel con la sintassi
fused_kernel[grid](...).
Il salto di astrazione è netto: un program instance di Triton (un pid)
non è un thread, ma elabora un intero blocco di BLOCK_SIZE elementi. Il
programmatore lavora su vettori e tessere (offsets è un vettore di indici,
x un vettore di valori); il compilatore Triton mappa da sé quel lavoro sui
thread e sui warp dell’SM, sceglie il layout dei dati e sintetizza gli accessi
coalescenti visti nella sezione sulla memoria. È un livello sopra
CUDA (dove invece scriveresti esplicitamente cosa fa un thread) e un livello
sotto PyTorch. BLOCK_SIZE è un tl.constexpr, cioè una costante nota a
tempo di compilazione: Triton la usa per generare codice specializzato
(srotolare cicli, dimensionare i registri), ed è uno dei pomelli su cui
l’autotuning cerca il valore migliore, provandone diversi al primo lancio e
tenendo il più veloce.
E quel kernel non è illustrativo: gira. Non serve nemmeno una GPU per
guardarlo lavorare, perché con la variabile d’ambiente TRITON_INTERPRET=1
Triton esegue il kernel in un interprete sulla CPU, un’istanza di programma
per volta: con \(a = 2\) e \(b = 1\) da \(3\) esce \(7\) e da \(-4\) esce \(0\), cioè
esattamente i numeri promessi. E se si vuole vedere che cosa il compilatore ne
fa, triton.compile lo traduce nel PTX (la lingua intermedia in cui NVIDIA
descrive un programma per GPU, che il driver traduce poi nelle istruzioni della
scheda che si ha davanti) per un’architettura scelta a tavolino, sm_90 per
esempio, senza che quell’architettura sia presente. Lì dentro la
moltiplicazione e la somma non compaiono come istruzioni separate: al posto
delle due c’è una fma.rn.f32 (fused multiply-add). È una fusione di un
altro genere, dentro una singola istruzione invece che fra kernel: non
risparmia né un lancio né un viaggio in memoria, e in cambio arrotonda una
volta sola invece di due, quindi il numero che esce non è bit per bit quello
di una moltiplicazione seguita da una somma. Quello per cui una GPU vera serve
davvero è misurare quanto va veloce, non sapere che cosa calcola.
Non tutte le operazioni sono elemento per elemento. Una riduzione (una
somma, un massimo) di \(K\) valori non si fa con una catena di \(K-1\) somme ma ad
albero, in \(\lceil\log_2 K\rceil\) passi: dentro un warp i 32 valori si
combinano con le istruzioni che scambiano registri fra i thread
(__shfl_down_sync in CUDA), fra i warp di un blocco si passa dalla shared
memory, e in Triton basta tl.sum su una tessera, perché l’albero lo
costruisce il compilatore. È il mattone della softmax e delle normalizzazioni.
Siccome la somma in virgola mobile non è associativa, l’ordine dell’albero
cambia l’ultima cifra: due esecuzioni che spartiscono la somma in un numero
diverso di blocchi possono differire lì.
Ogni lancio si paga: perché fondere#
Perché prendersi la briga di scrivere un kernel fuso come quello, che fa tre
operazioni in un passaggio solo, invece della riga PyTorch pulita y = torch.relu(a * x + b)? Perché quella riga contiene tre operazioni (moltiplica,
somma, azzera i negativi) e nel modo di eseguire di partenza sono tre kernel
distinti e non una cosa sola, lanciati uno dopo l’altro, e ogni lancio ha un
prezzo. Quel modo si chiama eager, «impaziente», perché esegue ogni
operazione appena la incontra, senza aspettare di aver letto il resto del
programma.
Ogni volta che lanci un kernel è come fare una telefonata per piazzare un
ordine: c’è un costo fisso di «comporre il numero e spiegarsi» che paghi
uguale, che l’ordine sia grande o minuscolo. Scrivere relu(a * x + b) in
modo ingenuo sono tre telefonate: una per la moltiplicazione, una per la
somma, una per la ReLU. E c’è di peggio del costo delle chiamate, perché a
ogni telefonata parte anche un camion, e quello si paga a merce trasportata.
L’intero array viene tirato su dalla memoria, gli si fa un solo, misero
conticino, e lo si rispedisce indietro, per poi ritirarlo su di nuovo alla
telefonata dopo. Tre viaggi di andata e ritorno per un milione di numeri,
per fare un lavoro che si poteva fare in un viaggio solo. Fondere i kernel
vuol dire proprio questo: una telefonata sola, i dati salgono una volta, si
fanno tutti e tre i conti mentre sono lì a portata di mano, e si riscrive una
volta.
Quanto si guadagni dipende dal rapporto fra il trasporto e il lavoro, e qui il rapporto è impietoso: su ogni numero c’è da fare una moltiplicazione, una somma e un confronto con lo zero, tre gesti che durano molto meno del viaggio che li ha portati a destinazione. Con i viaggi che scendono da tre a uno, il tempo scende quasi nella stessa proporzione. Se invece su ogni numero ci fosse mezz’ora di conti da fare, le telefonate e i viaggi sarebbero un rumore di fondo, e fondere non cambierebbe niente di misurabile. Si guadagna dove il trasporto pesa più del conto, ed è il caso di quasi tutto quello che una rete fa sui numeri uno per uno. Portata all’estremo, poi, la cura si esaurisce da sé: a forza di togliere viaggi si arriva al punto in cui il trasporto smette di essere il freno e a comandare il tempo comincia a essere il conto, e da lì in poi fondere ancora non rende più niente.
Ci sono due costi sovrapposti. Il primo è il launch overhead: ogni
invocazione di kernel richiede alla CPU di preparare e inviare il lancio alla
GPU, un costo dell’ordine dei microsecondi che, moltiplicato per una catena di
molte operazioni leggere, diventa visibile. Il secondo, più pesante, è il
traffico di memoria. Le operazioni elemento-per-elemento hanno intensità
aritmetica bassissima: come calcolato nel roofline della sezione sulla memoria,
una somma vettoriale fa circa \(1\) FLOP ogni \(12\) byte spostati (profondamente
memory-bound). Tre op separate leggono e riscrivono l’array tre volte; il
kernel fuso una sola. A parità di FLOP, tagliare i byte alza l’intensità
aritmetica e sposta l’operazione verso destra sul roofline, dal tetto di banda
verso quello di calcolo. È esattamente ciò che fa la kernel fusion di
torch.compile, descritta in «Prestazioni e scala»: TorchInductor riconosce le
catene di operazioni fondibili e ne sintetizza un unico kernel Triton, così che
la memoria venga letta e scritta una volta invece di \(k\). Il guadagno è tanto
maggiore quanto più il calcolo è memory-bound: per gran parte delle operazioni
non-matmul, parecchio.
Da PyTorch al kernel: eager contro compile#
Con questo in mente, si capisce cosa succede davvero sotto ogni riga di
PyTorch, e perché torch.compile sposti il cronometro. Sono due strade
diverse dal codice ai kernel.
Le telefonate di poco fa erano il modo di partenza, quello eager: PyTorch esegue il programma un’operazione alla volta, e ognuna è una telefonata. È comodissimo, perché vedi il risultato di ogni passo appena lo scrivi e, se qualcosa va storto, capisci subito quale riga è stata. Ma paghi il conto appena visto: una telefonata e un viaggio in memoria per ogni riga.
La seconda strada è quella che si accende con la riga torch.compile: invece
di telefonare un ordine alla volta, consegni la lista intera. PyTorch se la
legge tutta prima di cominciare, riconosce le voci che si possono chiedere in
un colpo solo e le riscrive da sé come un ordine unico: fonde le telefonate al
posto tuo, senza che tu debba scrivere niente. Le richieste davvero
impegnative restano affidate agli specialisti (kernel scritti a mano dal
costruttore della GPU); tutto il contorno di operazioni piccole viene
accorpato. Meno telefonate, meno viaggi, e lo stesso risultato salvo
l’ultima cifra: facendo i conti tutti di fila si arrotonda meno volte, e in
virgola mobile ogni arrotondamento si sente.
In modalità eager, quella di default, ogni operazione tensoriale viene smistata (dispatch) al proprio kernel già compilato, uno per uno, nell’ordine in cui la scrivi. Le moltiplicazioni fra matrici e le convoluzioni PyTorch le delega a librerie specializzate di NVIDIA, cuBLAS e cuDNN, i cui kernel sono scritti e ottimizzati a mano dal produttore dell’hardware (il GEMM a tessere che ci sta dentro è il tema della sezione sul GEMM). Tutto il resto (somme, ReLU, softmax, normalizzazioni) lo esegue con kernel CUDA propri, uno per operazione. È flessibile e immediato da debuggare, ma paga i lanci e i viaggi in memoria appena visti, uno per ogni riga.
In modalità compile, la catena cambia forma. Come descritto in «Prestazioni
e scala», TorchDynamo cattura la sequenza di operazioni in un grafo e
TorchInductor la ricompila: le operazioni pesanti restano affidate a cuBLAS e
cuDNN, ma le lunghe catene elementwise che le circondano (quelle che in eager
sarebbero state dieci kernel e dieci viaggi in memoria) vengono fuse in
pochi kernel Triton generati al volo. Meno lanci, meno traffico sulla HBM, la
GPU meglio sfamata. Dietro la riga model = torch.compile(model) c’è questa
fabbrica di kernel fusi che si mette in moto, e i kernel che sforna sono
scritti nel linguaggio che abbiamo appena letto.
La fusione accorpa le operazioni che si lasciano accorpare, ma molte restano kernel a sé (le moltiplicazioni fra matrici affidate alle librerie del costruttore, l’attenzione, le normalizzazioni fra l’una e l’altra), e ciascuna è ancora un lancio. Quando i kernel rimasti sono tanti e ciascuno fa poco lavoro, è il lancio a comandare il tempo, e ha una cura sua, i CUDA Graphs: graph qui è il grafo, la rete delle operazioni con i loro collegamenti, e non un grafico. È il caso tipico di un modello linguistico non troppo grande che genera una parola alla volta per poche persone insieme, un tema che la sezione sui grandi modelli linguistici e quella su LLMOps, il mestiere di far girare i modelli linguistici in produzione, raccontano per esteso.
Con un fornitore da cui si compra ogni giorno la stessa lista, telefonare una voce alla volta, come nella scena di prima, è tempo buttato. Si fa una cosa più furba: la si detta una volta, per intero, e il fornitore la registra come ordine ricorrente. Da lì in poi basta una telefonata di tre secondi, «il solito», e parte tutto. Registrare la lista si chiama catturare il grafo, e «il solito» è il CUDA Graph.
Quanto si guadagna dipende da quanto pesa la telefonata rispetto alla merce. Se ogni voce è un camion di mattoni, il tempo dei camion è molto più lungo di quello del telefono, e l’ordine ricorrente fa risparmiare poco. Se la lista è fatta di trecento voci da una scatoletta ciascuna, chi deve lavorare la merce resta con le mani in mano fra una scatoletta e l’altra ad aspettare la telefonata dopo: lì «il solito» cambia tutto. Un modello non troppo grande che genera una parola alla volta per poche persone è una lista del secondo tipo, centinaia di operazioni piccole per ogni parola, e la scheda passa il tempo ad aspettare il processore che gliele detta.
L’ordine ricorrente ha però una regola ferrea: il solito è sempre lo stesso. Le quantità sono quelle registrate, e anche il magazzino dove scaricare (nella scheda, i posti della memoria dove stanno i dati), quindi la merce nuova va portata lì prima di dire «il solito». Se un giorno di ogni voce servono nove pezzi invece di otto (con un modello, nove persone da servire insieme invece di otto), «il solito» non va bene. Allora si registrano alcuni ordini ricorrenti di taglie diverse, per quattro, per otto, per sedici, e ogni volta si chiede quello appena più grande di quanto serve, accettando di ricevere qualche pezzo in più. Una lista che cambia a ogni giro, come la lettura di testi sempre di lunghezza diversa, si continua a dettare.
E i camion restano. L’ordine ricorrente toglie le telefonate che la fusione ha lasciato, non i viaggi in memoria: per quelli serve fondere, e le due cure si sommano.
Il costo di lancio si vede in un profilo temporale (torch.profiler, o Nsight
Systems di NVIDIA) come spazi vuoti fra un kernel e l’altro sulla linea della
GPU: il carico è launch-bound quando la CPU impiega a preparare e accodare
i lanci più tempo di quanto la GPU impieghi a eseguirli. È il regime della
generazione autoregressiva a mazzo piccolo. Un passo di un Transformer da
\(n_\ell\) strati esegue almeno una decina di kernel per strato con i kernel fusi
di un motore di serving, e alcune decine eseguito operazione per operazione.
Con qualche microsecondo di preparazione per lancio (un ordine di grandezza,
che dipende dal framework, dalla CPU e dal driver), un modello da un miliardo
di parametri con \(n_\ell = 16\) costa alla sola CPU circa mezzo millisecondo per
passo con i kernel fusi, e da uno a due millisecondi eseguito operazione per
operazione. Lo stesso modello in 16 bit legge 2 GB di pesi a passo, circa 0,6
ms su una scheda da 3,35 TB/s: con i kernel fusi i due tempi si equivalgono,
operazione per operazione il collo di bottiglia è la CPU. Con otto miliardi di
parametri e \(n_\ell = 32\), invece, i lanci restano intorno al millisecondo ma i
pesi da leggere diventano 16 GB, quasi 5 ms, e torna a comandare la memoria.
Un CUDA Graph registra una volta (cattura) la sequenza di kernel con i
loro argomenti e gli indirizzi di memoria, e la riesegue (replay) con un solo
lancio dalla CPU: le dipendenze fra i nodi del grafo sono note in anticipo, e
il driver le soddisfa senza tornare alla CPU fra un kernel e l’altro. Il prezzo
è la staticità. Il grafo fissa le forme dei tensori, gli indirizzi e il flusso
di controllo, quindi un ramo che dipende dai dati o una dimensione che cambia
richiedono un grafo diverso, e i dati nuovi vanno copiati nei tensori su cui il
grafo è stato catturato prima di ogni replay. Ogni grafo tiene inoltre
riservata la memoria dei tensori su cui è stato catturato, e dentro la cattura
non possono esserci sincronizzazioni con la CPU (un .item(), per esempio).
torch.compile(mode="reduce-overhead") fa la cattura e il replay, e registra un
grafo nuovo per ogni forma nuova che incontra. I motori di serving vanno oltre:
catturano un grafo per ciascuna di una serie di taglie di mazzo, fino a qualche
centinaio di sequenze, ed eseguono ogni passo di generazione con il grafo della
taglia immediatamente superiore, riempiendo i posti vuoti; la lettura iniziale
di un prompt lungo resta fuori, o vi entra a pezzi con l’attenzione eseguita
fuori dal grafo. Il meccanismo è indipendente dalla fusione: il grafo toglie i
lanci, la fusione i viaggi in memoria.
Con questo il quadro è completo: l’architettura dice chi esegue (gli SM, i warp da 32 thread), la memoria da dove arrivano i dati, il kernel che cosa si esegue. Resta il kernel su cui una rete spende la maggior parte del tempo, il prodotto fra matrici, e gli è dedicata la sezione sul GEMM.
Da ricordare
Il rilevatore del censimento, il soldato con il numero sulla divisa e il lavoratore alla scrivania erano sempre la stessa cosa, un thread; la dispensa e il magazzino sempre la stessa, la memoria grande della scheda.
Un kernel è il programmino che gira sulla GPU. La cosa spiazzante è che non descrive il lavoro intero: descrive quello di un solo esecutore su un pezzetto di dato, e la GPU lo fa eseguire identico a un’intera folla.
La riga più importante di un kernel è quella in cui ogni esecutore legge il proprio numero e capisce di quale pezzetto occuparsi: è il numero cucito sulla divisa dei soldati che consegnano i volantini. Senza, si accalcherebbero tutti sulla stessa cassetta.
Triton [TKC19], dal 2021 scrivibile dentro Python, dà l’ordine a una squadra invece che al singolo esecutore. È anche la lingua in cui PyTorch, quando gli si chiede di ottimizzare, si scrive da sé i propri kernel.
Ogni volta che si lancia un kernel si paga una telefonata: un costo fisso che c’è sia per un ordine grande sia per uno minuscolo. E a ogni telefonata i dati fanno un viaggio di andata e ritorno dalla memoria.
Fondere più operazioni in un kernel solo vuol dire fare una telefonata al posto di tre e un viaggio al posto di tre, e molto meno tempo. Si guadagna però solo dove il trasporto pesa più del conto: se su ogni numero ci fosse molto da calcolare, fondere non cambierebbe niente. È il grosso di quello che fa quella riga di
torch.compilevista nella sezione «Prestazioni e scala».Le telefonate che la fusione lascia si tolgono con l’ordine ricorrente, «il solito»: si registra una volta la lista dei lanci e la si fa ripartire con una chiamata sola. Vale solo per liste sempre uguali, e per questo si registra in poche taglie; toglie le telefonate, non i viaggi.
Da ricordare
Un kernel è il programma che gira sulla GPU: descrive cosa fa un thread su un pezzo di dato, e la GPU lo replica su tutta una griglia di thread (stile SPMD/SIMT). Ogni thread calcola il proprio indice globale \(i = \text{blockIdx} \cdot \text{blockDim} + \text{threadIdx}\) per scegliere il dato su cui lavorare, e la guardia \(i < n\) ferma i thread in eccesso dell’ultimo blocco [NBGS08]. In CUDA il kernel è una funzione
__global__, lanciata con<<<blocchi, thread>>>.Triton [TKC19], dal 2021 scrivibile in Python, permette di ragionare a tessere di dati invece che a singoli thread: è il linguaggio in cui
torch.compile(via TorchInductor) genera i suoi kernel fusi su GPU, mentre su CPU Inductor emette C++.Ogni lancio di kernel ha un costo fisso, e ogni operazione elemento-per-elemento rilegge e riscrive l’intero array: una catena di op è tanti kernel e tanti viaggi in memoria (memory-bound).
La kernel fusion unisce più operazioni in un kernel solo (una lettura, una scrittura): alza l’intensità aritmetica e sposta l’operazione verso il tetto di calcolo del roofline.
In eager ogni op è un kernel a sé (cuBLAS/cuDNN per matmul e convoluzioni, kernel CUDA propri di PyTorch per il resto, softmax e normalizzazioni comprese); con
torch.compilele catene elementwise vengono fuse in kernel Triton, riducendo lanci e traffico di memoria.Le riduzioni (somme, massimi) si fanno ad albero, in \(\lceil\log_2 K\rceil\) passi: dentro il warp con gli scambi fra registri, fra i warp passando dalla shared memory. La somma in virgola mobile non è associativa, quindi l’ordine dell’albero cambia l’ultima cifra.
Un carico è launch-bound quando la CPU impiega più a preparare i lanci che la GPU a eseguirli (il decode a mazzo piccolo: su un modello da un miliardo di parametri i lanci costano quanto la lettura dei pesi, su uno da otto miliardi no). Un CUDA Graph cattura la sequenza di kernel una volta e la riesegue con un lancio solo, a forme, indirizzi e flusso di controllo fissati.
mode="reduce-overhead"registra un grafo per ogni forma nuova; i motori di serving catturano una serie di taglie di mazzo e riempiono i posti vuoti.