


Classificare descrivendo: analisi discriminante e naive Bayes#
Chiedi a un ornitologo come distingua una cornacchia da una gazza e non ti risponderà con un confine. Ti dirà com’è fatta una cornacchia: grigia e nera, tozza, coda corta, becco robusto. E com’è fatta una gazza: bianca e nera, più snella, con quella coda lunghissima che non si può sbagliare. Il confine fra le due specie non lo ha mai tracciato; ce l’ha in testa come conseguenza di due descrizioni.
I classificatori visti finora, a parte il Bayes ingenuo incontrato fra gli ensemble, fanno il contrario, e si chiamano discriminativi: modellano la probabilità della classe dato l’esempio, \(p(y \mid \mathbf{x})\), come la regressione logistica e l’albero, oppure soltanto il confine, come la SVM. Sanno dove finisce una classe e comincia l’altra, non com’è fatta ciascuna.
L’altra strada è descrivere ciascuna classe: stimare la distribuzione degli esempi dentro la classe, \(p(\mathbf{x} \mid y)\), e la frequenza delle classi, \(p(y)\), e ricavare il confine dopo, con il teorema di Bayes. I modelli che lo fanno si chiamano generativi, e i tre membri classici della famiglia (analisi discriminante lineare, analisi discriminante quadratica e naive Bayes) hanno tutti più di cinquant’anni e sono tutti ancora in uso. Il nome dei primi due inganna: l’analisi discriminante sta dalla parte dei generativi.
Due modi di rispondere alla stessa domanda#
Alla fine ogni classificatore assegna una classe a un esempio, e molti lo fanno stimando quanto è probabile ciascuna classe. Cambia da dove ci si arriva.
Una moneta raccolta per terra, da uno o da due euro? A occhio lo dice il colore, ma facciamo come la macchinetta del caffè, che il colore non lo guarda. Sul tavolo ci sono una bilancia, un calibro e un barattolo di mille monete già riconosciute.
Versi il barattolo sul foglio e segni ogni moneta come un punto, il peso in orizzontale e il diametro in verticale. Poi tiri la riga che tiene i due mucchi più separati. Adesso pesi la moneta nuova, la misuri, guardi da che parte cade. Della moneta da un euro non hai imparato niente in particolare. Hai imparato dove finisce.
Oppure il barattolo lo dividi in due mucchi, uno per taglio (il valore della moneta). Delle monete da un euro calcoli peso medio, diametro medio, e di quanto le singole se ne scostano di solito; poi rifai tutto sul mucchio da due. Adesso hai due descrizioni, e alla moneta nuova fai due domande: quanto sarebbe strana fra quelle da un euro, e quanto fra quelle da due? Strana vuol dire lontana dal centro, contata in scostamenti: se le monete da un euro pesano in media 7,5 grammi e se ne scostano di solito di un decimo, una da 8 grammi è cinque scostamenti più in là. Vince il mucchio che la trova meno strana, con una correzione che nel barattolo si legge: settecento delle mille erano da un euro e trecento da due, quindi a parità di stranezza la dai da un euro.
Con una descrizione in mano fai anche una cosa che la riga non sa fare: sorteggi un peso e un diametro che le stiano dentro, ed ecco sul foglietto una moneta da un euro credibile che nel barattolo non c’era. Il nome generativo viene da qui, e i programmi che inventano immagini e frasi fanno lo stesso, con descrizioni molto più ricche.
Il giorno che nel barattolo finiscono i cinquanta centesimi, ne calcoli media e scostamenti e la terza descrizione è pronta; le prime due restano quelle di ieri, mentre la riga andrebbe ritracciata da capo. La moneta col bordo ammaccato, che nel calibro non entra dritta, la giudichi col solo peso: ogni descrizione sa dire quanto pesano le monete del suo taglio, mentre la riga, senza il diametro, non sa dove metterla.
Togli dal barattolo tutto tranne venti monete, e di ognuna misura anche spessore, colore del bordo e usura: poche monete, tante misure. Medie e scostamenti di ciascun mucchio escono comunque, perché li calcoli su quel mucchio e basta, e nella media ogni moneta pesa poco. La riga invece la decidono soprattutto le poche monete vicine al confine: con cinque misure non la disegni più su un foglio, ma resta un confine netto, e con venti monete basta spostarne una perché giri.
Poi sul tavolo arriva un gettone del luna park, o una moneta straniera, o un falso fatto male. Sta lontano da tutti e due i centri, e le due descrizioni lo trovano stranissimo tutte e due. La riga quella parola non ce l’ha: qualunque cosa le metti sopra cade a destra o a sinistra, e il gettone esce come una moneta da due euro con la stessa disinvoltura di una vera.
Le due descrizioni, in fondo, colorano il foglio: scuro dove le monete sono fitte, chiaro dove sono rade, e il gettone cade nel bianco. Colorare così si chiama stima di densità, e «densità» vuol dire proprio quanto sono fitte, come gli abitanti di una città. L’inchiostro però sta in una boccetta sola: chi annerisce un posto deve lasciarne chiaro un altro. Se no basterebbe annerire tutto, e ogni moneta, gettone compreso, sembrerebbe normale.
Con la boccetta che è quella, una descrizione è tanto migliore quanto più inchiostro mette sotto le monete vere del barattolo, purché resti semplice: un centro per mucchio, e quanto e in che direzione il mucchio si allarga, cioè la sua forma. Una che versasse una goccia sotto ciascuna delle mille monete le troverebbe normalissime, e troverebbe strana qualunque moneta nuova.
E se il barattolo arrivasse senza cartellini? Il foglio si colora lo stesso, col barattolo intero: si cercano due macchie invece di una, e si indovina da sé quale moneta sta in quale. Il gettone resta nel bianco, lontano da tutte le monete di qualunque taglio.
Con due misure tutto questo regge. Con migliaia, come i puntini di una fotografia, può ingannare, e una delle ragioni è questa: ogni foto vera si scosta dalla foto media in mille piccoli modi, uno per puntino, così nessuna sta proprio al centro, dove l’inchiostro è più scuro. Stanno tutte in un anello tutt’intorno, e una foto di tutt’altro genere può cadere più vicino di loro alla macchia più scura. Programmi che avevano studiato fotografie di animali e di camion hanno trovato le fotografie di numeri civici, mai viste, più normali di quelle su cui avevano studiato.
Il conto si paga quando la descrizione che ti sei dato è sbagliata. Hai dato per buono che ogni taglio faccia un mucchio solo, tondo e compatto, e invece, mettiamo, le monete da due euro sono di due serie, una più pesante e una più leggera: due mucchietti staccati. La tua descrizione ne fa la media e mette il centro a metà strada, dove monete da due euro non ce ne sono, e da lì sbagli anche pezzi che una riga tirata a occhio avrebbe messo dalla parte giusta. Raccontare com’è fatto ogni taglio vuol dire pagare ogni dettaglio raccontato male, compresi quelli che alla domanda non servivano.
La distinzione è quella fra classificatori discriminativi e generativi.
Un classificatore discriminativo modella direttamente la posteriore \(p(y \mid \mathbf{x})\) (regressione logistica, alberi, reti) o addirittura solo il confine di decisione senza probabilità (SVM, percettrone). Un classificatore generativo modella la congiunta \(p(\mathbf{x}, y) = p(\mathbf{x} \mid y)\,p(y)\), cioè la distribuzione dei dati dentro ciascuna classe più la frequenza delle classi, e ricava la posteriore con il teorema di Bayes:
Il nome «generativo» viene da una proprietà che il discriminativo non ha: avendo \(p(\mathbf{x} \mid y)\) si possono campionare esempi nuovi di una classe. Il modello non riassume i dati, li sa rifare, ed è la stessa parola dei modelli che generano immagini e testo, che pure apprendono una distribuzione dei dati da cui si può campionare (spesso condizionata a un’etichetta o a un testo), ma non tutti ne danno una densità calcolabile.
Le conseguenze pratiche di modellare \(p(\mathbf{x}\mid y)\) invece di \(p(y \mid \mathbf{x})\) sono quattro, e tornano tutte più avanti nel libro:
si ottiene una densità, quindi il rilevamento di anomalie e degli input fuori distribuzione ha un punteggio naturale, affidabile in poche dimensioni;
i parametri si stimano in forma chiusa, ciascuno da tutti i dati della sua classe e non tutti insieme dentro un’unica ottimizzazione, e questo si sente quando gli esempi sono pochi rispetto alle feature;
le classi si stimano una alla volta e indipendentemente: aggiungere una classe non richiede di riaddestrare le altre, e i dati mancanti si trattano marginalizzando invece che imputando;
se il modello di \(p(\mathbf{x}\mid y)\) è sbagliato, l’errore si paga anche dove non serviva: il generativo spende capacità a descrivere aspetti dei dati che non contano per la decisione.
La stima di densità è il compito su cui poggia quel punteggio: dato un campione \(\mathbf{x}_1,\dots,\mathbf{x}_m\) estratto i.i.d. da una distribuzione ignota \(p\) sullo spazio dei dati \(\mathcal{X}\), trovare in una famiglia \(\mathcal{P}\) una densità vicina a \(p\). La vicinanza si misura di solito con la divergenza di Kullback-Leibler. Poiché
dove \(H(p)\) è l’entropia di \(p\) (differenziale, se \(p\) è una densità) e non dipende da \(q\), la migliore approssimazione nella famiglia, \(p^\star = \arg\min_{q \in \mathcal{P}} \mathrm{KL}(p\,\|\,q)\), è la \(q\) che rende massimo \(\mathbb{E}_p[\log q]\). Quel valore atteso non si conosce, ma il campione lo stima, e la stima di densità per massima verosimiglianza
è la minimizzazione empirica della KL. Conta anche la famiglia: su una troppo ricca il massimo degenera, e una componente di mistura che si stringe su un punto solo manda la verosimiglianza all’infinito, come mostra la sezione su riduzione e clustering. Senza etichette è un compito non supervisionato (misture gaussiane, flussi, modelli generativi profondi); con le etichette, un classificatore generativo ne risolve uno per classe, e la \(p(\mathbf{x}) = \sum_k \pi_k\, p(\mathbf{x}\mid y=k)\) che ne risulta è una densità a sua volta. In alta dimensione, però, il punteggio può ingannare: flussi, VAE e PixelCNN addestrati su fotografie di oggetti comuni danno una verosimiglianza più alta a fotografie di numeri civici mai viste [NMT+19]. Le spiegazioni proposte sono due: la regione di densità più alta non coincide con quella in cui cadono i campioni tipici [NMTL19], e la semplicità di un’immagine alza da sola la sua verosimiglianza [SerraAlvarezGomez+20]. La sezione sugli usi della verosimiglianza esatta le mette a confronto.
Resta da dire quale descrizione si usa. Il caso classico è il più semplice: dentro ogni classe gli esempi seguono una gaussiana multivariata, \(p(\mathbf{x}\mid y = k) = \mathcal{N}(\mathbf{x}\mid\boldsymbol{\mu}_k, \boldsymbol{\Sigma}_k)\), con una media \(\boldsymbol{\mu}_k\) (il centro della classe, dove sta l’esemplare tipico) e una matrice di covarianza \(\boldsymbol{\Sigma}_k\) (la forma: quanto e in quali direzioni gli esempi si allontanano dal centro). Con le etichette le due si stimano con due medie: la media degli esempi della classe, e la media dei prodotti dei loro scarti dal centro presi a due a due (peso per peso, peso per diametro, diametro per diametro).
Senza etichette gli stessi due ingredienti vanno indovinati insieme all’appartenenza di ciascun punto, con una procedura iterativa: è quello che la sezione su riduzione e clustering farà con le misture gaussiane e l’algoritmo EM. Qui le etichette ci sono, e non c’è niente da indovinare.
Analisi discriminante: lineare o quadratica#
Ronald Fisher affronta il problema nel 1936, su dei fiori
[Fis36]. Il botanico Edgar Anderson aveva misurato lunghezza e
larghezza di petali e sepali di centocinquanta iris, cinquanta per ciascuna di
tre specie; la domanda era se quelle quattro misure bastassero a distinguerle.
Nel suo stesso articolo Fisher mette un’avvertenza che vale per chiunque riusi
quei dati: la terza specie, Iris virginica, «differisce dagli altri due
campioni per non essere stata raccolta nella stessa colonia naturale», il che
«potrebbe alterare parecchio sia le medie sia le loro variabilità». Poiché le
altre due, secondo Anderson, vengono dalla penisola di Gaspé in Québec, una
parte di quello che distingue virginica può venire dal posto e non dalla
specie. Fisher cercava la combinazione delle quattro misure che separasse al
meglio le specie, e il metodo che ne uscì porta il suo nome. È lo stesso iris
che il capitolo sull’interpretabilità farà
classificare a un albero, ed è probabilmente il dataset più riusato della
storia della statistica.[1]
Torniamo alle monete, e mettiamo che i due tagli abbiano la stessa forma: variano allo stesso modo (chi è più pesante è anche un po’ più largo, nella stessa misura per tutte e due), e a distinguerli è solo dove sta il centro.
Allora, per dire da quale taglio viene una moneta nuova, guardi a quale dei due centri è più vicina. La distanza però la misuri nella forma del mucchio, non in grammi e millimetri: se il peso di solito si scosta di un decimo di grammo e il diametro di un centesimo di millimetro, un decimo di grammo di scarto è normale e un decimo di millimetro no. E la solita correzione per quanto sono comuni i due tagli resta anche qui. Con la distanza misurata così, le monete ugualmente lontane dai due centri stanno sull’asse del segmento che li unisce, come a geometria: il confine è una retta, e la correzione la sposta soltanto, parallela a sé stessa. Il metodo porta il nome di Fisher: è l’analisi discriminante lineare, o LDA.
Fisher ci arrivava da un’altra parte, senza le due descrizioni. Cercava una ricetta che mescolasse le misure in un numero solo, per esempio due volte il peso in grammi più tre volte il diametro in millimetri: per una moneta da un euro (7,5 grammi, 23,25 millimetri) fa \(84{,}75\), per una da due (8,5 e 25,75) \(94{,}25\). Messo come un punto su una linea, quel numero doveva tenere i due tagli lontani fra loro e ciascuno ben raccolto. I due centri distano nove e mezzo, e ciascun mucchio si allarga di circa due decimi attorno al suo: nove e mezzo diviso due decimi fa circa \(47\), e la ricetta migliore è quella che rende più grande questo rapporto fra la distanza dei centri e la larghezza dei mucchi.
Poi sulla linea scegli una soglia, sopra da due euro e sotto da uno. Una moneta da \(7{,}5\) grammi e \(25\) millimetri e una da \(9\) grammi e \(24\) millimetri fanno tutte e due \(90\): ogni grammo in più si compensa con due terzi di millimetro in meno, sempre nello stesso rapporto. Sul foglio, quindi, le monete che cadono proprio sulla soglia stanno su una retta, inclinata come il confine trovato con i due centri: le due strade arrivano allo stesso confine. Ed è una retta come quella tirata sul barattolo all’inizio. Cambia come la trovi (là guardando dove cadono le monete, qui calcolandola dalle due descrizioni), e finché le descrizioni sono giuste le due finiscono quasi nello stesso posto.
Dove mettere la soglia, però, la ricetta di Fisher non lo dice. A metà strada fra i due centri va bene solo se i due tagli sono ugualmente comuni. Con settecento monete da un euro e trecento da due, la solita correzione sposta la soglia verso il mucchio da due e lascia più spazio alle monete da uno; a metà strada avresti una retta parallela a quella giusta, ma troppo vicina al mucchio da un euro.
Con tre tagli (uno, due euro e cinquanta centesimi) un numero solo di solito non basta, ma ne bastano due, perché tre centri stanno sempre su un foglio piano. Serve quando le misure sono tante. Con cinque misure ogni moneta è un punto in uno spazio che non si disegna, ma i tre centri fissano comunque un foglio, come tre puntine. Accendi una lampada sopra il foglio e guarda dove cade l’ombra della moneta: con le distanze misurate nella forma del mucchio, per dire a quale centro è più vicina conta solo l’ombra, perché quanto la moneta sta sollevata dal foglio pesa allo stesso modo su tutte e tre le distanze. L’ombra si dice con due numeri; con peso e diametro soltanto, il foglio lo hai già.
Se invece i due tagli hanno forme diverse (uno varia tanto in peso, l’altro tanto in diametro), la vicinanza al centro da sola inganna. Un taglio molto variabile trova poco strano qualunque valore, e a lasciarlo fare si prenderebbe tutte le monete dubbie; quindi alla stranezza che trova si aggiunge una tassa, tanto più alta quanto più quel taglio è sparpagliato. Con una forma sola quella tassa era uguale per i due tagli e non spostava il confine di un millimetro; con due forme diverse decide. Impari una forma per ciascuno, e il confine si incurva. È l’analisi discriminante quadratica, QDA.
La seconda sembra sempre meglio, visto che può fare tutto quello che fa la prima. Ma imparare una forma per taglio vuol dire stimare il doppio dei numeri con le stesse monete, quindi stimarli peggio. Con tagli che hanno davvero la stessa forma, la QDA spende numeri per scoprire una cosa già vera e ci rimette; con tagli di forma diversa, la LDA non ha modo di accorgersene. È il compromesso bias-varianza: una descrizione troppo rigida contro una troppo libera per le monete che ha.
Quando le monete sono poche c’è una via di mezzo: stimi le due forme separate e poi le tiri verso la forma unica, tenendo un po’ di ciascuna. Quanto tirare è una manopola, e la fermi dove le monete tenute da parte per la prova vengono riconosciute meglio.
Si assume \(p(\mathbf{x} \mid y = k) = \mathcal{N}(\mathbf{x} \mid \boldsymbol{\mu}_k, \boldsymbol{\Sigma}_k)\). Sostituendo in Bayes e prendendo il logaritmo, la regola di decisione confronta le funzioni discriminanti
e assegna \(\mathbf{x}\) alla classe con \(\delta_k\) massima. Il primo termine è \(-\tfrac12 D_k^2(\mathbf{x})\), dove \(D_k^2(\mathbf{x}) = (\mathbf{x}-\boldsymbol{\mu}_k)^{\top}\boldsymbol{\Sigma}_k^{-1}(\mathbf{x}-\boldsymbol{\mu}_k)\) è la distanza di Mahalanobis al quadrato dal centro della classe, cioè la distanza euclidea dopo aver trasformato i dati con \(\boldsymbol{\Sigma}_k^{-1/2}\): è la formalizzazione di «misurare la distanza nella forma giusta».
I parametri si stimano classe per classe: \(\hat\pi_k = m_k/m\), \(\hat{\boldsymbol\mu}_k = \frac{1}{m_k}\sum_{y_i = k}\mathbf{x}_i\). Per la QDA la covarianza è \(\hat{\boldsymbol\Sigma}_k = \frac{1}{m_k - 1}\sum_{y_i = k}(\mathbf{x}_i - \hat{\boldsymbol\mu}_k)(\mathbf{x}_i - \hat{\boldsymbol\mu}_k)^\top\); per la LDA, la covarianza comune è \(\hat{\boldsymbol\Sigma} = \frac{1}{m - K}\sum_k \sum_{y_i = k}(\mathbf{x}_i - \hat{\boldsymbol\mu}_k)(\mathbf{x}_i - \hat{\boldsymbol\mu}_k)^\top\) [HTF09], dove \(m_k\) è il numero di esempi della classe \(k\) e \(K\) il numero delle classi. Le inverse esistono solo se le classi hanno abbastanza esempi in posizione generale: con colonne ridondanti, combinazioni lineari di altre, \(\hat{\boldsymbol\Sigma}_k\) è singolare con qualunque numero di esempi, e serve una regolarizzazione.
Il confine fra due classi è \(\delta_k(\mathbf{x}) = \delta_\ell(\mathbf{x})\), e la sua forma dipende da una sola ipotesi.
Con covarianze diverse (QDA) i termini \(\mathbf{x}^{\!\top}\boldsymbol{\Sigma}_k^{-1}\mathbf{x}\) non si cancellano, e il confine è una quadrica (iperbole, ellisse, parabola secondo il caso).
Con covarianze uguali (LDA), cioè \(\boldsymbol{\Sigma}_k = \boldsymbol{\Sigma}\) per ogni \(k\), il termine quadratico è lo stesso nelle due funzioni discriminanti e sparisce nella differenza. Sviluppando:
dove il termine raccolto dalla graffa non è costante in \(\mathbf{x}\) (è proprio
quello quadratico), ma è lo stesso per tutte le classi, quindi sparisce nella
differenza \(\delta_k - \delta_\ell\), che è ciò da cui il confine dipende.
Tolto quello, quel che resta è affine in \(\mathbf{x}\): il confine è un
iperpiano. È anche l’enunciato che il collaudo numerico verifica, dato che
decision_function restituisce proprio quella differenza.
Il nome ha una storia più lunga di questa derivazione. Fisher nel 1936 non suppone classi gaussiane: cerca la direzione \(\mathbf{a}\) che massimizza il rapporto fra la dispersione delle medie di classe e quella dentro le classi,
dove \(\mathbf{S}_B\) è la covarianza delle medie di classe e \(\mathbf{S}_W\) la covarianza comune dentro le classi; per due classi il massimo è in \(\mathbf{a} \propto \mathbf{S}_W^{-1}(\boldsymbol{\mu}_1 - \boldsymbol{\mu}_0)\), la stessa direzione che la regola bayesiana dà con \(\boldsymbol{\Sigma} = \mathbf{S}_W\). La soglia invece nel quoziente non compare. La regola bayesiana taglia in
con \(\mathbf{a} = \mathbf{S}_W^{-1}(\boldsymbol{\mu}_1 - \boldsymbol{\mu}_0)\) senza riscalarlo, e tagliare nel punto medio delle medie proiettate dà la stessa regola solo con classi equiprobabili. Per Fisher la linearità era dunque un’ipotesi, perché la regola è una combinazione lineare per costruzione; la lettura gaussiana, venuta dopo, la trasforma in una conseguenza dell’aver condiviso la covarianza. Con \(K\) classi \(\mathbf{S}_B\) ha rango al più \(K-1\), quindi il problema agli autovalori generalizzati \(\mathbf{S}_B\mathbf{a} = \lambda\,\mathbf{S}_W\mathbf{a}\), i cui autovettori sono i punti stazionari di \(J\), ha al più \(\min(K-1, d)\) autovalori non nulli. Proiettare su quelle direzioni non perde niente per la regola LDA: nelle coordinate sbiancate da \(\mathbf{S}_W\) i \(K\) centri stanno in un sottospazio affine di dimensione al più \(K-1\), e le componenti ortogonali a quel sottospazio pesano allo stesso modo su tutte le distanze dai centri [HTF09]. È da qui che viene la riduzione a \(K-1\) dimensioni.
Il conto dei parametri spiega il compromesso. Con \(d\) feature e \(K\) classi, la
LDA stima \(K\) medie più una covarianza, cioè \(Kd + d(d+1)/2\) numeri; la QDA
ne stima \(K\), cioè \(Kd + K\,d(d+1)/2\). Per \(d = 20\) e \(K = 2\) sono \(250\) contro
\(460\): quasi il doppio, e la parte che raddoppia è quella difficile, perché
stimare una covarianza è stimare circa \(d^2/2\) numeri da dati che ne
informano poco.
Da qui la regularized discriminant analysis di Friedman
[Fri89], che interpola fra le due mescolando
\(\boldsymbol{\Sigma}_k\) con la covarianza comune. In scikit-learn quella
interpolazione non c’è (QuadraticDiscriminantAnalysis(reg_param=...) fa solo
l’altra metà, cioè tira ciascuna \(\boldsymbol{\Sigma}_k\) verso l’identità), e
c’è invece un rimedio diverso e complementare,
LinearDiscriminantAnalysis(shrinkage=...), che tira la covarianza comune
verso un multiplo dell’identità:
\((1-\alpha)\hat{\boldsymbol{\Sigma}} +
\alpha\,\frac{\operatorname{tr}\hat{\boldsymbol{\Sigma}}}{d}\mathbf{I}\).
Cura cioè il rumore della stima, non la differenza fra le classi (e vuole
solver="lsqr" o "eigen": con il solver predefinito il parametro solleva un
errore invece di essere ignorato, che è il modo giusto di comportarsi).
Due parentele, con la regressione logistica e con le misture gaussiane. La LDA produce una posteriore che, per due classi, è esattamente una sigmoide di una funzione affine, cioè la stessa forma funzionale della regressione logistica; e il legame con le misture gaussiane è ancora più stretto, perché la LDA è una mistura gaussiana a covarianza condivisa in cui le variabili latenti sono osservate. All’EM della sezione sul clustering la seconda parentela si legge al contrario: il passo E, che là dovrà stimare le responsabilità, qui è dato (valgono \(0\) e \(1\), e le sanno tutti), e resta il solo passo M, che sono le due medie e la covarianza comune, eseguito una volta.
Le due situazioni, misurate: due classi con la stessa forma e due classi con forme diverse, gli stessi \(200\) esempi di addestramento, la stessa prova su ventimila esempi mai visti.
import numpy as np
from sklearn.discriminant_analysis import (LinearDiscriminantAnalysis,
                                           QuadraticDiscriminantAnalysis)
from sklearn.linear_model import LogisticRegression

def genera(n, forma_uguale, seme):
    """Due classi gaussiane, con la stessa forma oppure con forme diverse."""
    r = np.random.default_rng(seme)
    C0 = np.array([[2.0, 1.2], [1.2, 1.0]])
    C1 = C0 if forma_uguale else np.array([[0.6, -0.5], [-0.5, 2.2]])
    y = r.integers(0, 2, n)
    return (np.where(y[:, None] == 0,
                     r.multivariate_normal([0, 0], C0, n),
                     r.multivariate_normal([1.6, 1.2], C1, n)), y)

print(f"{'':30} {'LDA':>13} {'QDA':>13} {'logistica':>13}")
for uguale in (True, False):
    Xte, yte = genera(20_000, uguale, 999)
    col = []
    for M in (LinearDiscriminantAnalysis, QuadraticDiscriminantAnalysis,
              LogisticRegression):
        # venti addestramenti da 200 esempi: la deviazione dice quanto ballano
        s = [M().fit(*genera(200, uguale, 10 + k)).score(Xte, yte) for k in range(20)]
        col.append(f"{np.mean(s):.3f} ±{np.std(s):.3f}")
    etichetta = "stessa forma, due classi" if uguale else "forme diverse"
    print(f"{etichetta:30} {col[0]:>13} {col[1]:>13} {col[2]:>13}")
                                         LDA           QDA     logistica
stessa forma, due classi        0.728 ±0.003  0.726 ±0.003  0.728 ±0.003
forme diverse                   0.813 ±0.005  0.855 ±0.002  0.810 ±0.007
La colonna del \(\pm\) è la deviazione standard fra venti addestramenti, cioè quanto quel numero balla se si ripete tutto: senza di lei il resto della tabella non si legge. Nella prima riga i tre valori stanno dentro un \(\pm 0{,}003\) l’uno dall’altro, cioè dentro la dispersione di un singolo addestramento: quando le classi hanno la stessa forma non c’è niente da guadagnare a imparare due forme (né a passare a un discriminativo), e la QDA, che stima il doppio dei numeri, resta due millesimi sotto. Nella seconda riga la QDA sta quattro punti sopra le altre due, con la deviazione più piccola di tutte: lì la differenza è reale.
Notare anche chi resta indietro insieme a chi: LDA e regressione logistica si muovono appaiate in tutte e due le righe, perché tracciano lo stesso tipo di confine e differiscono solo su come ne stimano la posizione.
E che il confine della LDA sia davvero una retta non è una cosa da credere sulla parola. Il collaudo è questo: si prende il punteggio con cui il modello decide, si cerca la retta che meglio lo imita, e si guarda di quanto i due si scostano nel punto peggiore. Se il punteggio è una retta lo scarto deve venire zero.
X, y = genera(4000, True, 1)
lda = LinearDiscriminantAnalysis().fit(X, y)
qda = QuadraticDiscriminantAnalysis().fit(X, y)

r = np.random.default_rng(0)
P = r.normal(0, 3, (500, 2))          # cinquecento punti a caso nel piano
base = np.c_[P, np.ones(len(P))]      # la piu' generale funzione affine del piano

def scarto_dall_affine(decisione):
    """Quanto la funzione di decisione si scosta dalla piu' vicina retta."""
    coef = np.linalg.lstsq(base, decisione(P), rcond=None)[0]
    return np.abs(decisione(P) - base @ coef).max()

print(f"LDA, scarto dall'affine: {scarto_dall_affine(lda.decision_function):.2e}")
print(f"QDA, scarto dall'affine: {scarto_dall_affine(qda.decision_function):.2e}")
LDA, scarto dall'affine: 8.88e-15
QDA, scarto dall'affine: 7.21e+00
Lo scarto della LDA è dell’ordine di \(10^{-14}\), cioè degli arrotondamenti in doppia precisione (l’epsilon di macchina è \(2{,}2\cdot10^{-16}\), e i valori della funzione di decisione sono dell’ordine delle unità): zero. Il punteggio della LDA è una retta, non le somiglia. La QDA se ne scosta di \(7{,}2\): i suoi termini quadratici, stimati separatamente per classe, non si cancellano, e sui punti lontani dai dati pesano. È la stessa cosa che si ottiene con l’algebra, dove per la LDA i termini al quadrato si cancellano fra le due classi perché sono identici.

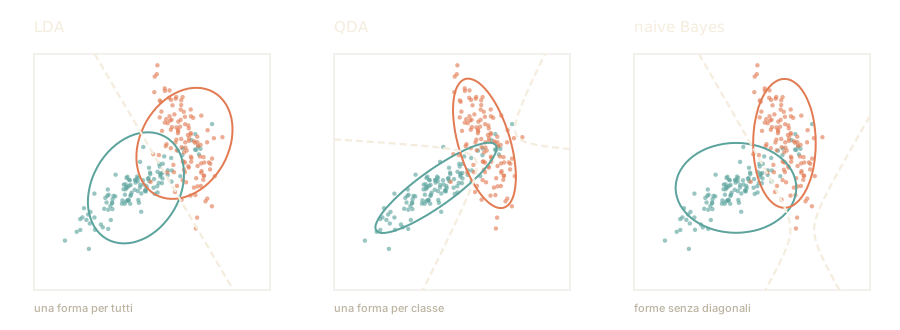
Fig. 4.32 Le tre ipotesi, disegnate. L’ovale che circonda ciascun gruppo (un’ellisse) è la forma che quel metodo si concede per descrivere la classe, e da sola decide la forma del confine: una sola forma, la stessa per le due classi in due posizioni diverse, dà una retta; due forme diverse danno una curva. Nessuno dei confini è stato disegnato: sono tutti conseguenze delle ellissi. Il terzo pannello anticipa il naive Bayes gaussiano, che le ellissi le obbliga a stare dritte, con gli assi paralleli a quelli del grafico.#
La LDA come regressione, e che cosa ne nasce#
Con più di due classi alla LDA si arriva anche per un’altra strada, la regressione, e da quella strada nascono due sue estensioni: la flexible discriminant analysis (FDA), che incurva il confine, e la penalized discriminant analysis (PDA), che regge quando le misure sono centinaia e ordinate, come i valori di uno spettro di frequenze [HBT95, HTB94]. Il punto di partenza è un modo di sbagliare: dare a ogni esempio un voto per classe, uno alla propria e zero alle altre (le indicatrici), e cercare per regressione lineare una formula che indovini ciascun voto; con tre classi in fila, quella di mezzo resta mascherata.
Con tre tagli viene in mente una scorciatoia. A ogni moneta si danno tre voti, uno per taglio: uno al taglio che è, zero agli altri due. Per ciascun voto si cerca una ricetta alla Fisher, tanto peso più tanto diametro, che lo indovini il meglio possibile, e alla moneta nuova si dà il taglio che prende il voto più alto.
Con le monete da un euro, da cinquanta centesimi e da due, però, i cinquanta centesimi stanno in mezzo: più larghi di quelle da un euro (24,25 millimetri contro 23,25) e più stretti di quelle da due (25,75). La ricetta del voto «due euro» sale andando verso le monete larghe, quella del voto «un euro» scende, e quella del voto «cinquanta centesimi» dovrebbe salire in mezzo e scendere ai due lati. Una somma di tanto peso e tanto diametro questo non lo sa fare: resta quasi piatta, e vicino al centro le altre due la superano. Molti cinquanta centesimi finiscono sotto un altro nome, e il taglio di mezzo resta mascherato.
Il rimedio è non fissare i voti a uno e zero, ma sceglierli, e il nome dice proprio questo: optimal scoring, i voti scelti al meglio. Per ogni taglio si cerca il numero che una ricetta sola indovina meglio, e i numeri che escono mettono l’euro a un capo, i due euro all’altro e i cinquanta centesimi in mezzo, dove stanno davvero. Con i voti scelti così la regressione ritrova esattamente la ricetta di Fisher, e il taglio di mezzo non si perde più.
Da lì si può allargare in due direzioni. La ricetta può smettere di essere una somma e diventare una curva qualunque, e allora il confine fra i tagli si piega dove serve: non solo nei modi della QDA, che ammette soltanto le curve che nascono da due forme diverse, ma in tutti quelli che la curva scelta permette. È la FDA. Oppure le misure sono centinaia e in fila, come il suono della moneta che cade sul tavolo registrato a duecentocinquantasei altezze diverse. Una ricetta libera darebbe a ogni altezza un peso tutto suo, alto e basso a caso, e imparerebbe il rumore di quelle poche monete. Si chiede allora che due altezze vicine abbiano pesi simili, con una manopola che dice quanto chiederlo, e la ricetta viene liscia: è la PDA.
Sia \(\mathbf{Y} \in \{0,1\}^{m \times K}\) la matrice indicatrice delle classi. La regressione lineare di \(\mathbf{Y}\) sulla matrice dei dati \(\mathbf{X}\), con intercetta, seguita dalla regola \(\hat{y} = \arg\max_k \hat{Y}_k(\mathbf{x})\), è un classificatore lineare, e per \(K = 2\) la sua direzione è quella di Fisher. Per \(K \ge 3\) no: le \(\hat{Y}_k\) sommano a uno in ogni punto, e con i centroidi quasi allineati la funzione della classe centrale resta quasi costante e viene superata dalle due esterne. È il masking, tanto più probabile quanto più \(K\) è grande rispetto alla dimensione \(d\) [HTF09].
L’optimal scoring sostituisce le indicatrici con punteggi \(\theta_\ell : \{1, \dots, K\} \to \mathbb{R}\) (qui \(\theta_\ell\) è un punteggio delle classi, non un parametro del modello: è la notazione di Hastie, Tibshirani e Buja), scelti insieme ai coefficienti per minimizzare
con i punteggi a media nulla, varianza unitaria e ortogonali fra loro sui dati. I \(\boldsymbol{\beta}_\ell\) coincidono, a meno di una costante, con le direzioni discriminanti di Fisher, e la LDA si ottiene assegnando la classe del centroide più vicino nello spazio delle \(\hat{\eta}_\ell(\mathbf{x}) = \mathbf{x}^{\!\top}\boldsymbol{\beta}_\ell\), con pesi \(w_\ell = 1/\big(r_\ell^2(1 - r_\ell^2)\big)\), dove \(r_\ell^2\) è il residuo quadratico medio del punteggio \(\ell\) [HTB94]. Il calcolo è una regressione multipla di \(\mathbf{Y}\) seguita da un problema agli autovalori di dimensione \(K\), \(\mathbf{Y}^{\!\top}\hat{\mathbf{Y}}\boldsymbol{\theta} = \lambda\,\mathbf{Y}^{\!\top}\mathbf{Y}\boldsymbol{\theta}\), da cui si scarta il punteggio costante (\(\lambda = 1\)); per gli altri \(r_\ell^2 = 1 - \lambda_\ell\).
La FDA sostituisce \(\mathbf{x}^{\!\top}\boldsymbol{\beta}_\ell\) con una regressione non parametrica \(\eta_\ell(\mathbf{x})\) (spline additive, MARS, nuclei) e minimizza \(\mathrm{ASR} + \gamma \sum_\ell \mathcal{R}(\eta_\ell)\), con \(\mathcal{R}\) il regolarizzatore di quella famiglia. Con un polinomio di secondo grado i confini sono quadriche, le stesse che darebbe una LDA sulle feature aumentate dei quadrati e dei prodotti incrociati. Quando la regressione è lineare su un’espansione \(h(\mathbf{x})\) con penalità \(\gamma\,\boldsymbol{\beta}^{\!\top}\boldsymbol{\Omega}\,\boldsymbol{\beta}\), la FDA diventa la PDA [HBT95], cioè una LDA nello spazio espanso con la covarianza interna sostituita da \(\mathbf{S}_W + \gamma\boldsymbol{\Omega}\): le direzioni massimizzano \(\mathbf{a}^{\!\top}\mathbf{S}_B\,\mathbf{a}\) sotto \(\mathbf{a}^{\!\top}(\mathbf{S}_W + \gamma\boldsymbol{\Omega})\mathbf{a} = 1\), e la distanza è quella di Mahalanobis nella stessa metrica. Serve anche senza espansione, quando i predittori sono già troppi e correlati (i 256 valori di un log-periodogramma, i pixel di una cifra scritta a mano): con \(\boldsymbol{\Omega}\) che penalizza le differenze fra coefficienti adiacenti, la metrica pesa meno le combinazioni ruvide, e la direzione discriminante esce liscia. È parente dello shrinkage di scikit-learn, che tira la covarianza verso un multiplo dell’identità invece che verso la levigatezza.
Le tre regole si mettono alla prova sulle monete: un euro, cinquanta centesimi e due euro, trecento per taglio, con peso e diametro veri e uno scarto di un decimo su tutte e due le misure (sul diametro, dieci volte quello delle monete di Fisher). L’optimal scoring è scritto a mano, perché scikit-learn ha la LDA e la QDA ma non la FDA né la PDA.
import numpy as np
from scipy.linalg import eigh
from sklearn.discriminant_analysis import LinearDiscriminantAnalysis

rng = np.random.default_rng(0)
# peso in grammi e diametro in millimetri: un euro, 50 centesimi, due euro
centri = np.array([[7.5, 23.25], [7.8, 24.25], [8.5, 25.75]])
y = np.repeat([0, 1, 2], 300)
X = centri[y] + rng.normal(0, 0.1, (900, 2))       # un decimo di scarto

A = np.column_stack([np.ones(len(y)), X])          # con l'intercetta
Y = np.eye(3)[y]                                   # uno al proprio taglio
Y_hat = A @ np.linalg.lstsq(A, Y, rcond=None)[0]   # una regressione per taglio
voto = Y_hat.argmax(1)

# optimal scoring: i punteggi dei tagli che la regressione indovina meglio
N = len(y)
lam, Theta = eigh(Y.T @ Y_hat / N, Y.T @ Y / N)    # autovalori crescenti
# via il punteggio costante (lambda = 1); il segno è arbitrario, un euro in basso
lam, Theta = lam[::-1][1:], Theta[:, ::-1][:, 1:]
Theta *= -np.sign(Theta[0])
eta = Y_hat @ Theta                                # le regressioni sui punteggi
w = 1 / ((1 - lam) * lam)                          # con r^2 = 1 - lambda
centroidi = np.array([eta[y == k].mean(0) for k in range(3)])
distanze = (((eta[:, None, :] - centroidi) ** 2) * w).sum(-1)
punteggio = distanze.argmin(1)
lda = LinearDiscriminantAnalysis().fit(X, y).predict(X)

for nome, pred in [("regressione sulle indicatrici", voto),
                   ("optimal scoring", punteggio), ("LDA", lda)]:
    print(f"{nome:30} sbaglia {np.sum(pred != y):3d} monete su {N},"
          f" di cui {np.sum((pred != y) & (y == 1)):3d} da cinquanta centesimi")
solo_primo = (((eta[:, None, :1] - centroidi[:, :1]) ** 2) * w[:1]).sum(-1).argmin(1)
print(f"con il solo primo punteggio sbaglia {np.sum(solo_primo != y)} monete")
print("primo punteggio (un euro, 50 cent, due euro):", np.round(Theta[:, 0], 2))
print(f"optimal scoring e LDA concordano su {np.sum(punteggio == lda)}"
      f" monete su {N}")
regressione sulle indicatrici  sbaglia 117 monete su 900, di cui  97 da cinquanta centesimi
optimal scoring                sbaglia   0 monete su 900, di cui   0 da cinquanta centesimi
LDA                            sbaglia   0 monete su 900, di cui   0 da cinquanta centesimi
con il solo primo punteggio sbaglia 0 monete
primo punteggio (un euro, 50 cent, due euro): [-1.12 -0.19  1.31]
optimal scoring e LDA concordano su 900 monete su 900
La regressione sulle indicatrici sbaglia 117 monete su 900, e 97 sono da cinquanta centesimi: il taglio di mezzo ne perde quasi un terzo. L’optimal scoring e la LDA non ne sbagliano nessuna e concordano su tutte e 900, perché sono la stessa regola scritta in due modi. Il primo punteggio mette l’euro a \(-1{,}12\), i due euro a \(1{,}31\) e i cinquanta centesimi in mezzo, a \(-0{,}19\): più vicini all’euro, perché nel diametro gli sono più vicini, un millimetro contro uno e mezzo. E quel primo punteggio da solo basta già a non sbagliarne nessuna: nelle monete da euro peso e diametro crescono quasi in proporzione, i tre centri stanno quasi su una retta, ed è proprio il caso in cui la regressione sulle indicatrici maschera di più e un numero solo, scelto bene, separa tutto.
Naive Bayes: l’indipendenza che non c’è#
Il terzo membro della famiglia, il naive Bayes (il Bayes ingenuo dell’esperimento sugli ensemble), assume che dentro ogni classe le caratteristiche siano indipendenti, \(p(\mathbf{x}\mid y) = \prod_j p(x_j \mid y)\). L’ipotesi è quasi sempre falsa, eppure per classificare spesso costa poco, per una ragione che si può dire con precisione.
Descrivere una classe con centro e forma costa: la forma dice anche come le caratteristiche vanno insieme (se le monete più pesanti sono anche più larghe), e con venti caratteristiche le coppie da guardare sono \(20 \times 19 / 2\), cioè centonovanta. Tante da imparare.
Il naive Bayes taglia corto e dichiara che quelle relazioni non esistono: dentro una classe, ogni caratteristica va per conto suo. Peso e diametro non si sanno l’uno dell’altro. Così di ogni classe basta imparare, una caratteristica per volta, una media e una dispersione. Poi la moneta nuova si giudica su ogni caratteristica separatamente, e i giudizi che ne escono si moltiplicano fra loro.
L’ipotesi è quasi sempre falsa, e non un po’: in un’email le parole «offerta» e «gratis» si tirano dietro a vicenda, in una moneta peso e diametro pure. Il nome lo ammette: naive vuol dire ingenuo.
Il fatto strano è che funziona lo stesso, e la ragione è che al classificatore non serve avere ragione sulle probabilità, gli serve mettere in classifica le classi nel giusto ordine. Può sbagliare di brutto sul «quanto» (dirà \(0{,}999\) dove il vero è \(0{,}7\), perché contando due volte prove che erano la stessa prova si convince troppo) e azzeccare comunque il «quale». Domingos e Pazzani hanno studiato proprio questo nel 1997 [DP97], mostrando che l’insieme dei casi in cui il naive Bayes è ottimo è molto più grande di quello in cui la sua ipotesi è vera.
Il corollario pratico tocca chi usa questi modelli. Le probabilità del naive Bayes non si usano come probabilità. Come classifica sono buone, come numeri no. Se servono probabilità di cui fidarsi (una soglia da tarare, un costo da calcolare) vanno ricalibrate.
L’ipotesi è l’indipendenza condizionata delle feature data la classe:
Nel caso gaussiano equivale a imporre \(\boldsymbol{\Sigma}_k\) diagonale, e i parametri di covarianza crollano da \(K\,d(d+1)/2\) a \(Kd\): per \(d = 20\) e \(K = 2\), da \(420\) a \(40\). Geometricamente, le ellissi di livello hanno gli assi paralleli agli assi coordinati (nessuna rotazione), che è ciò che mostra il terzo pannello di Fig. 4.32.
Il risultato di Domingos e Pazzani [DP97] è che la regione di ottimalità del naive Bayes sotto perdita \(0\)–\(1\) è strettamente più ampia di quella in cui vale l’indipendenza condizionata: l’errore sull’ordinamento delle posteriori è un evento più raro dell’errore sulle posteriori stesse, perché la funzione \(\arg\max\) è invariante a un’ampia classe di distorsioni monotone. Le stime restano però mal calibrate, tipicamente sovrasicure, perché feature correlate contribuiscono evidenza ripetuta al prodotto: chi ha bisogno delle probabilità e non solo dell’etichetta ricalibri con lo scaling di Platt o con l’isotonica, che la sezione sulle metriche mette alla prova.
Nel caso discreto (conteggi di parole) il modello prende il nome di naive Bayes multinomiale, e con lo smoothing di Laplace è la base storica della classificazione dei testi. La sezione Classificare il testo lo tratta in quella veste, con il conto dello smoothing: qui interessa come membro della famiglia generativa, non come classificatore di documenti.
Quando il generativo vince: pochi dati#
Resta la domanda che decide se questa famiglia serve ancora: con pochi dati, chi descrive le classi batte chi cerca il confine? Andrew Ng e Michael Jordan la formulano nel 2001 [NJ01], e la risposta ha la forma di una gara con due tempi. Il generativo parte meglio: si avvicina al meglio che sa fare con un numero di esempi che cresce come \(\log d\) nel numero \(d\) di caratteristiche, contro l’ordine di \(d\) della logistica. Il discriminativo parte peggio, ma il meglio che sa fare non è mai peggiore, ed è più alto quando l’ipotesi del generativo è falsa. Su pochi dati vince il primo; su tanti, il secondo, se l’ipotesi del primo è sbagliata.
Il confronto che scelgono è il più pulito possibile: naive Bayes gaussiano
contro regressione logistica. Nel loro naive Bayes ogni caratteristica ha una
media per classe e una varianza sola, comune alle due classi, e con questa
scelta la posteriore, cioè la probabilità della classe dato l’esempio, è
esattamente una sigmoide di una funzione affine (una somma pesata delle
caratteristiche più una costante): i due modelli arrivano alla stessa formula
per decidere, e differiscono solo su come ne ricavano i numeri dai dati.
GaussianNB di scikit-learn stima invece una varianza per classe, e il suo
confine è una quadrica; per rifare il confronto di Ng e Jordan la varianza va
messa in comune.
Rifacendo quel confronto con una colonna in più, la logistica come la si usa oggi, si vede quanto ne resta.
import numpy as np
from sklearn.linear_model import LogisticRegression
from sklearn.naive_bayes import GaussianNB
from scipy.stats import norm

D = 40
rng = np.random.default_rng(0)
MU = rng.choice([-1, 1], D) * 0.35     # le due classi differiscono in ogni feature

def dati(m, r):
    """Due classi gaussiane a feature indipendenti: l'ipotesi naive qui e' VERA."""
    y = r.integers(0, 2, m)
    return r.normal(0, 1, (m, D)) + np.outer(y, MU), y

def nb_condiviso(X, y):
    """Il naive Bayes di Ng e Jordan: una varianza per colonna, comune alle classi."""
    nb = GaussianNB().fit(X, y)
    nb.var_[:] = (X - nb.theta_[y]).var(axis=0)
    return nb

X_test, y_test = dati(20_000, np.random.default_rng(999))

print(f"{'m':>6} {'naive Bayes':>12} {'logistica (default)':>21} {'logistica nuda':>16}")
for m in (20, 40, 80, 200, 600, 2000):
    a, b, c = [], [], []
    for s in range(15):
        r = np.random.default_rng(100 + s)
        X, y = dati(m, r)
        if len(np.unique(y)) < 2:
            continue
        a.append(nb_condiviso(X, y).score(X_test, y_test))
        b.append(LogisticRegression(max_iter=5000).fit(X, y).score(X_test, y_test))
        c.append(LogisticRegression(C=1e6, max_iter=5000).fit(X, y).score(X_test, y_test))
    print(f"{m:6d} {np.mean(a):12.3f} {np.mean(b):21.3f} {np.mean(c):16.3f}")

# il tetto di tutti: la regola di Bayes con le due gaussiane vere, che per
# classi equiprobabili a covarianza identita' indovina Phi(|MU| / 2)
print(f"massimo teorico: {norm.cdf(np.linalg.norm(MU) / 2):.3f}")
     m  naive Bayes   logistica (default)   logistica nuda
    20        0.714                 0.708            0.663
    40        0.762                 0.746            0.693
    80        0.811                 0.771            0.722
   200        0.843                 0.817            0.796
   600        0.857                 0.847            0.846
  2000        0.862                 0.859            0.859
massimo teorico: 0.866
La terza colonna è la logistica senza regolarizzazione, che è quella del confronto originale, e su di lei il fenomeno si vede per intero: a \(m = 80\) il naive Bayes sta a \(0{,}811\) e lei a \(0{,}722\), quasi nove punti sotto; a \(m = 200\) sono ancora quasi cinque; da \(m = 600\) in poi si avvicinano fino quasi a toccarsi. Con quaranta caratteristiche e ottanta esempi la logistica ha due esempi per parametro, e con così poco non impara; il naive Bayes ne stima anche di più (centoventi: una media per classe e per colonna, e una varianza per colonna), ma li stima uno alla volta, ciascuno con tutti i dati della sua classe, e se la cava.
La seconda colonna è la logistica come la si usa oggi, cioè col
penalty="l2" che scikit-learn applica per default, ed è il motivo per cui
questo esperimento conviene rifarlo invece di citarlo. Quel freno accorcia il
divario senza chiuderlo: a \(m = 80\) il naive Bayes resta quattro punti sopra
(\(0{,}811\) contro \(0{,}771\)), a \(m = 200\) due e mezzo, a \(m = 600\) uno, e a
\(m = 2000\) ancora tre millesimi. Il fenomeno del 2001 sopravvive ai
default di oggi; la regolarizzazione ne cambia la misura, e il verso resta
quello.
Una precisazione su questa tabella, che ne dichiara il limite. I dati qui sono stati fabbricati a feature indipendenti, cioè nel mondo in cui l’ipotesi del naive Bayes è vera. Questo rende visibile il primo tempo della gara, la partenza rapida del generativo, e rende invisibile il secondo: se il modello del naive Bayes è quello giusto, i due metodi hanno lo stesso tetto, e quel tetto è il massimo teorico del problema (\(0{,}866\) di accuratezza, stampato in fondo all’uscita). Infatti la riga di \(m = 2000\) li dà a \(0{,}862\) e \(0{,}859\), tutti e due a pochi millesimi da quel tetto: il generativo ci arriva prima, il discriminativo lo insegue, e il suo asintoto più alto si vede solo quando l’ipotesi naive è falsa. Con feature correlate l’asintoto del naive Bayes scende sotto il massimo teorico, e con abbastanza esempi la logistica lo supera: al vantaggio di stimare poco si somma il costo di un’ipotesi falsa. Il vantaggio dei pochi dati è reale; non è un salvacondotto.
Le stesse due classi con le colonne vicine correlate, \(\operatorname{corr}(x_i, x_j) = 0{,}3^{\lvert i-j\rvert}\), mettono l’ipotesi naive dalla parte del torto, e fanno vedere il secondo tempo della gara:
RHO = 0.3                                    # colonne vicine correlate
COV = RHO ** np.abs(np.subtract.outer(np.arange(D), np.arange(D)))
radice = np.linalg.cholesky(COV)

def dati_correlati(m, r):
    """Le stesse due classi, ma l'ipotesi naive qui e' FALSA."""
    y = r.integers(0, 2, m)
    return r.normal(0, 1, (m, D)) @ radice.T + np.outer(y, MU), y

X_test, y_test = dati_correlati(20_000, np.random.default_rng(999))
print(f"{'m':>6} {'naive Bayes':>12} {'logistica nuda':>16}")
for m in (20, 80, 200, 600, 2000):
    a, c = [], []
    for s in range(10):
        X, y = dati_correlati(m, np.random.default_rng(100 + s))
        a.append(nb_condiviso(X, y).score(X_test, y_test))
        c.append(LogisticRegression(C=1e6, max_iter=5000)
                 .fit(X, y).score(X_test, y_test))
    print(f"{m:6d} {np.mean(a):12.3f} {np.mean(c):16.3f}")

# i due tetti: la regola di Bayes vera, e il meglio che il naive Bayes puo' fare
print(f"massimo teorico: {norm.cdf(np.sqrt(MU @ np.linalg.solve(COV, MU)) / 2):.3f}")
print(f"tetto del naive Bayes: {norm.cdf(MU @ MU / (2 * np.sqrt(MU @ COV @ MU))):.3f}")
     m  naive Bayes   logistica nuda
    20        0.696            0.653
    80        0.783            0.724
   200        0.819            0.790
   600        0.832            0.846
  2000        0.837            0.858
massimo teorico: 0.863
tetto del naive Bayes: 0.841
Il naive Bayes resta avanti finché gli esempi sono pochi (\(0{,}819\) contro \(0{,}790\) a \(m = 200\)), poi si ferma sotto il proprio tetto, \(0{,}841\): con le colonne correlate conta più volte la stessa prova, e la sua frontiera resta storta anche con infiniti dati. La logistica lo supera fra \(200\) e \(600\) esempi, e a \(m = 2000\) arriva a \(0{,}858\), vicino al massimo teorico \(0{,}863\).
In pratica#
from scipy.special import logsumexp

X, y = genera(2000, True, 0)
lda = LinearDiscriminantAnalysis(store_covariance=True).fit(X, y)
print("accuratezza LDA:", round(lda.score(*genera(20_000, True, 999)), 3))

# la LDA ha imparato due gaussiane: da quelle si ricava anche p(x), non solo la
# classe. E' l'unica cosa che un discriminativo non puo' dare.
inversa = np.linalg.inv(lda.covariance_)
_, logdet = np.linalg.slogdet(lda.covariance_)

def log_densita(P):
    """log p(x): quanto e' verosimile un punto, per il modello gia' addestrato."""
    per_classe = [-0.5*np.einsum("ij,jk,ik->i", P - m, inversa, P - m)
                  - 0.5*logdet - np.log(2*np.pi) + np.log(q)
                  for m, q in zip(lda.means_, lda.priors_)]
    return logsumexp(per_classe, axis=0)

fuori = np.array([[14.0, -11.0]])          # un punto che non c'entra niente
print(f"log p(x) di un punto in mezzo ai dati: {log_densita(X[:1])[0]:9.2f}")
print(f"log p(x) di un punto lontanissimo    : {log_densita(fuori)[0]:9.2f}")
print(f"e sullo stesso punto lontano si dichiara sicuro al "
      f"{lda.predict_proba(fuori).max():.2%}")
accuratezza LDA: 0.731
log p(x) di un punto in mezzo ai dati:     -2.36
log p(x) di un punto lontanissimo    :   -711.59
e sullo stesso punto lontano si dichiara sicuro al 99.99%
Le ultime tre righe sono il gettone fra le monete, misurato. Il punto \((14, -11)\) non ha niente a che vedere con questi dati, e la densità lo dice senza esitazioni. I due numeri stampati sono logaritmi, e la differenza fra loro è di settecentonove: non «settecento volte meno probabile», ma un rapporto di \(10^{308}\), cioè un \(1\) seguito da trecentotto zeri. Quel punto, per il modello, semplicemente non capita. La classificazione dello stesso punto, invece, esce al \(99{,}99\%\) di sicurezza, perché una volta scelto da che parte della retta si trova non c’è altro da dire.
I due numeri vengono dallo stesso modello, addestrato una volta sola, e sono la ragione per cui conviene avere in casa un generativo: la sicurezza di un classificatore è sempre relativa alle classi che conosce, e da sola non distingue «è certamente una gazza» da «non ho idea di cosa sia, ma se devo scegliere dico gazza». La densità quella distinzione la fa.
Quando conviene prenderli in considerazione, in concreto:
come riferimento di partenza: la LDA non ha iperparametri da tarare, si addestra in fretta, e dà un numero contro cui misurare tutto il resto. Se il modello elaborato non la batte, o il confine vero è quasi lineare e la LDA era già la risposta, o al modello elaborato mancano dati, caratteristiche o messa a punto. In tutti e due i casi la complessità in più non ha ripagato il proprio costo;
con pochi esempi e molte colonne, che è la situazione tipica dei dati clinici e sperimentali: è la riga \(m = 80\) della tabella;
quando serve una densità, cioè quando bisogna accorgersi degli esempi che non somigliano a niente di visto: è quello che la mistura gaussiana della sezione su riduzione e clustering farà per segnalare i punti improbabili;
per schiacciare i dati in poche dimensioni senza perdere le classi: la LDA li proietta su al più \(K-1\) direzioni, con \(K\) il numero delle classi, scelte apposta perché su quelle le classi si distinguano. È la cugina supervisionata dell’analisi delle componenti principali, che la stessa sezione costruirà: quella cerca le direzioni in cui i dati variano di più, questa quelle in cui le classi si distinguono di più, e le due possono benissimo non coincidere.
Da ricordare
Ci sono due modi di classificare. Imparare dove passa il confine (i discriminativi: la logistica, gli alberi, le SVM) e imparare com’è fatta ogni classe, per poi ricavarne il confine. Il secondo è quello dell’ornitologo, e si chiama generativo.
Chi sa com’è fatta ogni classe sa anche dire dove i casi sono fitti e dove sono radi, la stima di densità, e quindi riconoscere quello che non somiglia a nessuna: un gettone fra le monete. Chi ha imparato solo il confine no. Con migliaia di misure, come i puntini di una foto, quel conto può ingannarsi.
LDA: una sola forma condivisa dalle due classi, e il confine viene una retta. QDA: una forma per classe, e il confine si incurva. La ricetta di Fisher, un numero solo mescolando le misure, dà l’inclinazione della retta; dove tagliare dipende anche da quanto è comune ciascuna classe.
Non conviene sempre la più flessibile: con classi che hanno davvero la stessa forma i tre metodi stanno a pochi millesimi (\(0{,}728\), \(0{,}726\), \(0{,}728\), e ballano di \(\pm 0{,}003\)), e la più flessibile è un filo sotto; con forme diverse la QDA sta quattro punti sopra.
Il naive Bayes dichiara che dentro una classe le caratteristiche non si parlano fra loro. È quasi sempre falso, e funziona lo stesso, perché per scegliere la classe basta l’ordine, non il valore esatto. Le sue probabilità però non vanno usate come probabilità: sono troppo sicure di sé.
Il generativo dà il meglio con pochi dati: a ottanta esempi e quaranta colonne il naive Bayes sta quasi nove punti sopra la logistica non regolarizzata, e quattro sopra quella con i freni di oggi. A seicento esempi il vantaggio è quasi finito; e se le caratteristiche sono legate fra loro, con abbastanza esempi la logistica passa davanti.
Con tre tagli in fila, dare a ogni moneta voti di uno e zero e indovinarli con una ricetta dritta fa perdere il taglio di mezzo; scegliere i voti al meglio ritrova la ricetta di Fisher. Da lì la FDA piega il confine come serve, e la PDA tiene lisce le ricette quando le misure sono centinaia e in fila.
Da ricordare
Discriminativo: si modella \(p(y \mid \mathbf{x})\). Generativo: si modella \(p(\mathbf{x} \mid y)\,p(y)\) e si applica Bayes. Il secondo dà in più una densità (anomalie, con un punteggio che in alta dimensione inganna), la stima classe per classe e un migliore comportamento a pochi dati.
La regola di decisione confronta \(\delta_k(\mathbf{x}) = -\frac{1}{2}(\mathbf{x}-\boldsymbol{\mu}_k)^\top \boldsymbol{\Sigma}_k^{-1}(\mathbf{x}-\boldsymbol{\mu}_k) -\frac{1}{2}\log\lvert\boldsymbol{\Sigma}_k\rvert + \log\pi_k\): meno metà della distanza di Mahalanobis al quadrato, più il termine di volume e la priore.
Con \(\boldsymbol{\Sigma}_k = \boldsymbol{\Sigma}\) il termine quadratico si cancella nella differenza e \(\delta_k\) diventa affine: è la LDA, e la linearità è una conseguenza, non un’ipotesi. Lo scarto dalla più vicina funzione affine è \(8{,}9 \cdot 10^{-15}\) per la LDA, cioè arrotondamento, contro \(7{,}2\) per la QDA.
Parametri (medie più covarianze): LDA \(Kd + d(d+1)/2\), QDA \(Kd + K\,d(d+1)/2\), naive Bayes gaussiano \(2Kd\) (una media e una varianza per classe e per feature, niente termini incrociati). È il compromesso bias-varianza sul modello di \(p(\mathbf{x}\mid y)\); la regularized discriminant analysis e lo
shrinkageinterpolano.Naive Bayes: \(p(\mathbf{x}\mid y) = \prod_j p(x_j \mid y)\). La regione di ottimalità sotto perdita \(0\)–\(1\) è più ampia di quella in cui l’ipotesi vale [DP97], perché conta l’\(\arg\max\) e non il valore; le posteriori restano sovrasicure e vanno ricalibrate.
Ng e Jordan [NJ01], con un naive Bayes a varianza comune fra le classi (la coppia esatta della logistica): il generativo si avvicina al proprio asintoto con un numero di esempi che cresce come \(O(\log d)\) nel numero di feature, il discriminativo ne chiede \(O(d)\); in cambio l’asintoto del discriminativo ha errore più basso quando l’ipotesi del generativo è falsa. A feature indipendenti i due asintoti coincidono (accuratezza di Bayes \(0{,}866\)) e si vede solo la prima metà. L’\(\ell_2\) di default riduce il divario senza annullarlo: \(0{,}811\) contro \(0{,}771\) a \(m = 80\). Con colonne correlate (\(0{,}3^{\lvert i-j\rvert}\)) il naive Bayes si ferma al proprio tetto, \(0{,}841\), e la logistica lo supera fra \(200\) e \(600\) esempi (\(0{,}858\) a \(m = 2000\), contro un massimo di \(0{,}863\)).
Il quoziente di Fisher dà la direzione \(\mathbf{S}_W^{-1}(\boldsymbol{\mu}_1 - \boldsymbol{\mu}_0)\), non la soglia, che dipende dalle priori. La LDA è anche una riduzione di dimensionalità supervisionata su al più \(\min(K-1, d)\) direzioni, senza perdita per la regola LDA, ed è la mistura gaussiana della sezione sul clustering con le variabili latenti osservate: resta il solo passo M, eseguito una volta.
Con \(K \ge 3\) la regressione sulle indicatrici maschera le classi centrali; l’optimal scoring [HTB94] sceglie i punteggi delle classi e ritrova la LDA con una regressione multipla e un autoproblema di dimensione \(K\). Sostituendo la regressione con una non parametrica si ha la FDA; con una penalità \(\gamma\boldsymbol{\Omega}\) sui coefficienti la PDA [HBT95], cioè la LDA con \(\mathbf{S}_W + \gamma\boldsymbol{\Omega}\).
Il giro dei classificatori classici si chiude tornando al punto di partenza da dietro: la regressione logistica con cui tutto era cominciato e la LDA di Fisher tracciano lo stesso tipo di confine e non sono lo stesso metodo, perché una guarda il confine e l’altra guarda le classi. La sezione su riduzione e clustering toglie le etichette: chiede ai dati quante dimensioni servano davvero a descriverli e quali gruppi contengano, e ritrova le gaussiane della LDA nella mistura gaussiana, dove l’appartenenza di ogni punto va indovinata invece che letta sull’etichetta.