


Processi decisionali di Markov e funzioni valore#
La sezione sui bandit ha lavorato su un mondo che non si muove: davanti all’agente c’era una fila di leve sempre uguale, e tirarne una non cambiava in nulla quello che si sarebbe trovato davanti al tiro dopo. Il mondo vero non è così. Il bambino della panoramica, quando dalla camminata passa alla bicicletta, se ne accorge alla prima pedalata storta: non gli costa soltanto un punto in meno, gli sposta la bicicletta, e quello che potrà fare fra un istante dipende da quello che ha fatto ora. Si ritrova in una situazione che si è creato da sé.
Rimettere al suo posto la situazione che cambia è il passo che resta da fare. Costa qualche simbolo in più, e in cambio restituisce il problema per intero.
L’impalcatura che serve è il processo decisionale di Markov, in inglese Markov Decision Process, che tutti abbreviano in MDP. Lo ha formalizzato Richard Bellman nel 1957 [Bel57], ed è l’impianto su cui è costruito il manuale di Sutton e Barto [SB18].
Il ciclo: stati, azioni, ricompense#
A ogni istante l’agente si trova in uno stato, sceglie un’azione, l’ambiente lo trasporta in un nuovo stato e gli consegna una ricompensa numerica. Poi il ciclo riparte.
Un piccolo robot si muove in un labirinto a caselle. Lo stato è la casella in cui si trova; le azioni sono i movimenti possibili (su, giù, destra, sinistra); la transizione è dove finisce dopo la mossa; la ricompensa è il punteggio che riceve: diciamo \(+10\) quando raggiunge l’uscita e \(-1\) per ogni passo, così impara a uscire in fretta. Il robot non conosce la mappa: la scopre muovendosi.
Quei due numeri, il \(+10\) dell’uscita e il \(-1\) del passo, li scegliamo noi: sono il modo di dire al robot che cosa vogliamo. Cambiandoli si cambia il problema, quindi ogni volta che comparirà un labirinto nuovo diremo che regole ha.
Una mossa, poi, non sempre fa quello che promette. Su un pavimento scivoloso il comando «avanti» porta avanti nove volte su dieci e di traverso una volta su dieci: dove si finisce è un elenco di caselle con accanto quanto spesso capita ciascuna, e non una casella sola. Lo stesso per il punteggio: se una casella bagnata certe volte costa un punto e certe altre tre, il numero che conta è quanto costa in media. Nel mondo su cui faremo i conti, tre caselle in fila, niente slitta e niente varia: ogni mossa porta sempre nella stessa casella e paga sempre lo stesso. È il caso facile, quello in cui l’elenco ha una riga sola.
Un MDP è la quintupla
\(\mathcal{S}\) è l’insieme degli stati, \(\mathcal{A}\) quello delle azioni. La dinamica dell’ambiente è la funzione di transizione
cioè la probabilità di finire in \(s'\) eseguendo l’azione \(a\) nello stato \(s\). La ricompensa attesa è
minuscola perché, a differenza della ricompensa aleatoria \(R_{t+1}\) che l’ambiente estrae a ogni passo, è una funzione deterministica di stato e azione. Attenzione al doppio uso, che è una trappola vera: \(r(s,a)\) con i suoi argomenti è sempre la ricompensa attesa, mentre la \(r\) nuda che comparirà nelle regole di aggiornamento di Monte Carlo e del Q-learning è la ricompensa osservata in una singola transizione, cioè una realizzazione di \(R_{t+1}\). Confondere le due vuol dire credere che l’agente conosca una media che invece deve stimare.
Infine \(\gamma \in [0,1]\) è il fattore di sconto, che il paragrafo sul ritorno scontato riprende per esteso. Le transizioni possono essere stocastiche, cioè la stessa azione può condurre in stati diversi; il caso deterministico, come l’MDP in miniatura della Fig. 13.2, è il caso particolare in cui \(P(s'\mid s,a)\) vale \(1\) su un solo stato. Né \(P\) né \(r\) dipendono dal tempo \(t\): l’MDP è stazionario, ed è l’ipotesi che cade quando nell’ambiente ci sono altri agenti che a loro volta imparano.
La proprietà di Markov#
La proprietà prende il nome da Andrej Markov, il matematico russo che fra Otto e Novecento studiò le sequenze di eventi in cui ciò che viene dopo dipende soltanto da ciò che c’è adesso. Chiede che lo stato riassuma tutto ciò che serve a prevedere il seguito: noti lo stato e l’azione di adesso, la storia precedente non aggiunge niente alla previsione dello stato successivo e della ricompensa.
Fotografa una partita a scacchi a metà. A un bravo giocatore, per capire come può andare avanti la partita, e quindi per decidere la prossima mossa, basta la foto: non gli serve sapere in che ordine i pezzi sono arrivati lì. La posizione attuale racconta già tutto ciò che conta. Uno stato fatto così si dice markoviano. E se la foto non bastasse? Si allarga l’inquadratura finché basta: negli scacchi veri, per esempio, alla foto va aggiunta una nota («il re non ha ancora mosso»), perché da essa dipende una mossa speciale, l’arrocco, in cui il re e la torre si scambiano di posto e che è permessa solo se nessuno dei due si è mai mosso prima. L’importante è che tutto il necessario stia nella foto, e niente resti nascosto nella storia.
Allargare l’inquadratura, però, non sempre si può. A carte le mani degli altri sono coperte, e nessuna fotografia del tavolo dirà mai che cosa tengono: guardando solo il tavolo, la mossa migliore non si decide. Chi gioca bene fa allora l’unica cosa che resta, e cioè si ricorda le carte già passate e da lì si fa un’idea di quello che può esserci sotto («con quelle uscite, un asso ce l’ha una volta su tre»). Non una situazione sola, quindi, ma tutte quelle possibili con accanto quanto sono probabili: si gioca lo stesso, il conto è molto più lungo, e la certezza non arriva mai. Dove invece a mancare è solo il movimento, un rimedio economico c’è, e non chiede tutto questo: si guarda non l’ultimo istante ma gli ultimi cinque o sei, perché da una fotografia sola non si capisce dove stia andando una palla, da sei fotogrammi di fila sì.
Formalmente si richiede che
La distribuzione congiunta dello stato successivo e della ricompensa, condizionata a stato e azione correnti, non cambia aggiungendo l’intera traiettoria passata, ricompense comprese: è quello che serve perché \(r(s,a)\) sia ben definita, e perché il valore di uno stato dipenda soltanto dallo stato. Se l’osservazione disponibile non soddisfa questa proprietà, si arricchisce lo stato (aggiungendo variabili, o una finestra di osservazioni recenti), finché la proprietà vale: è esattamente ciò che farà il DQN impilando quattro frame consecutivi di un videogioco per catturare le velocità.
Quel caso ha un nome, perché è la regola e non l’eccezione. Quando l’agente non osserva lo stato ma solo una sua funzione parziale e rumorosa, il modello si chiama POMDP (Partially Observable MDP): oltre a stati, azioni e ricompense c’è un insieme di osservazioni e una distribuzione \(\Pr(o \mid s)\) che dice cosa si riesce a vedere. Un robot con sensori limitati, un sistema di raccomandazione che non conosce l’umore dell’utente, un giocatore di poker che non vede le carte altrui: tutti POMDP.
La difficoltà è che in un POMDP la policy ottima non può dipendere solo dall’osservazione corrente. La soluzione teorica è ragionare su una distribuzione di probabilità sugli stati possibili, il belief state \(\beta(s)\), aggiornata a ogni passo con il filtro bayesiano
dove \(a\) è l’azione eseguita, \(o\) l’osservazione ricevuta subito dopo e la costante di proporzionalità normalizza la somma a \(1\). Il belief riassume tutta la storia senza perdere niente che serva a decidere, quindi il POMDP diventa un MDP sui belief; ma quello spazio è continuo anche quando gli stati sono pochi (un simplesso di dimensione \(|\mathcal{S}|-1\)), e il problema diventa molto più duro. In pratica si fa una di due cose: si impila una finestra di osservazioni recenti, come il DQN con i quattro fotogrammi, oppure si dà all’agente una memoria, cioè una rete ricorrente il cui stato nascosto fa da riassunto approssimato di tutto ciò che si è visto finora. È la ragione per cui, nel capitolo sui world model, l’agente sceglie l’azione leggendo due cose e non una: ciò che vede in questo istante, e lo stato nascosto di una rete ricorrente che ha visto tutto il resto.
La policy: la strategia dell’agente#
Sapere in quali stati ci si può trovare non dice ancora cosa fare. La regola di comportamento dell’agente si chiama policy, che è la parola inglese per «politica»; e con «strategia» fanno tre parole per la stessa cosa.
La policy è l’abitudine dell’agente: per ogni stato, quale azione scegliere. «In questa stanza vado sempre a destra» è una policy. Può anche assomigliare a un dado truccato: «qui vado a destra 8 volte su 10». Sembra uno spreco lasciare due volte su dieci alla sorte, ma è il dilemma del ristorante della panoramica: se vado sempre a destra, che cosa ci fosse a sinistra non lo scoprirò mai, e la mia abitudine potrebbe essere sbagliata senza che io possa accorgermene. Imparare, nel reinforcement learning, significa migliorare la policy.
Una policy \(\pi\) è una distribuzione sulle azioni condizionata allo stato:
È deterministica se concentra tutta la probabilità su una sola azione, \(a = \pi(s)\); stocastica altrimenti. L’obiettivo dell’apprendimento è trovare la policy che massimizza la ricompensa accumulata nel tempo.
Quanto vale il futuro: il ritorno scontato#
Una ricompensa da sola dice poco: conta la somma delle ricompense lungo tutto il percorso. Quella somma è il ritorno: non quanto si incassa adesso, ma quanto si incasserà in tutto da qui alla fine. Un premio subito, però, vale più dello stesso premio fra dieci mosse, e quindi nella somma i premi lontani entrano ridotti: da qui il nome ritorno scontato, che è il numero che l’agente cerca di rendere più grande possibile.
Dieci euro oggi valgono più di dieci euro l’anno prossimo. Il fattore di sconto \(\gamma\) (gamma), un numero tra 0 e 1, misura questa impazienza. Con \(\gamma = 0{,}9\) un \(+10\) che arriva alla prossima mossa conta per intero, \(10\); se arriva una mossa dopo vale \(0{,}9 \times 10 = 9\), due mosse dopo \(0{,}9^2 \times 10 = 8{,}1\). Più è lontano, meno pesa. Con \(\gamma\) vicino a 0 l’agente è miope (guarda solo al premio immediato), vicino a 1 è lungimirante.
Lo sconto fa anche un secondo mestiere, meno visibile del primo. Una partita che non finisce mai regala premi per sempre, e a sommarli tutti interi viene un totale infinito: due strategie che incassano senza fine varrebbero infinito tutte e due, e col totale non ci sarebbe modo di dire quale sia la migliore. Scontando, invece, il totale resta un numero: \(+10\) a ogni passo per sempre, con \(\gamma = 0{,}9\), fa in tutto \(100\). Il perché sta in un conto di due righe. Il totale da adesso in poi è il \(10\) di adesso più nove decimi del totale che comincia al passo dopo; ma dal passo dopo la partita è identica, e il suo totale è lo stesso numero. Un numero che vale \(10\) più nove decimi di sé stesso è \(100\), perché il decimo che avanza deve valere \(10\). Nelle partite senza fine c’è anche un’altra strada, che lascia stare il totale e chiede quanto si incassa in media a ogni passo: con \(+10\) per sempre fa \(10\), e resta un numero anche senza sconto. Nelle partite che a un certo punto finiscono il problema non si pone, perché i premi da sommare finiscono anche loro: lì lo sconto si può lasciare da parte.
Oltre allo sconto conta un’altra cosa, quando la partita dura un numero fisso di turni: la mossa giusta può dipendere anche da quanti ne restano. Al minuto 89, in vantaggio di un gol, una squadra butta la palla in tribuna; al minuto 10, dallo stesso punto del campo, non lo farebbe mai. Stessa posizione, mossa diversa, perché è cambiato il tempo che resta sull’orologio. Una policy, cioè un’abitudine, che guarda solo dove ci si trova e non l’orologio basta in due casi. Il primo sono le partite senza fine: dopo ogni passo il futuro che resta è lungo quanto prima, e la stessa posizione chiede sempre la stessa mossa. Il secondo sono le partite che finiscono all’arrivo a un traguardo, senza scadenza, come il labirinto del robot: quanto manca all’uscita dipende da dove ci si trova, non da quanti turni sono passati. Se i punti lontani contano per intero, senza sconto, serve una precauzione in più, che girare a vuoto non convenga mai: nel labirinto ci pensa il \(-1\) di ogni passo, perché un robot che gironzola per sempre perde punti senza fine. Nelle partite a durata fissa, invece, l’orologio conta, e il rimedio è quello degli scacchi: nella foto si scrive anche quanti turni mancano.
Il ritorno al tempo \(t\) è la somma scontata delle ricompense future:
Con \(0 \le \gamma < 1\), e se le ricompense sono limitate, la serie converge anche su orizzonti infiniti, il che rende il problema ben posto. È il motivo per cui nei compiti continui, quelli che non finiscono mai, si sconta di norma. L’alternativa è non scontare e misurare la ricompensa per unità di tempo, il criterio della ricompensa media,
che Sutton e Barto adottano per i compiti continui quando i valori si approssimano con una funzione, perché lì lo sconto crea problemi [SB18]. Nei compiti episodici la somma ha invece un numero finito di termini, perché l’episodio termina, e \(\gamma = 1\) è ammesso: è il caso di molti esempi classici, compreso il cliff walking che incontreremo nella sezione sul Q-learning. Nell’uno e nell’altro caso \(\gamma\) non è un semplice trucco matematico: codifica quanto lontano nel futuro all’agente conviene guardare.
La lunghezza dell’orizzonte decide anche la forma della policy ottima. Una policy \(\pi(a\mid s)\) che non dipende dal tempo, ma solo dallo stato in cui ci si trova, si dice stazionaria. A orizzonte finito \(H\), cioè con episodi che durano esattamente \(H\) passi, la policy ottima in generale non lo è: il miglior ritorno atteso da \(s\) dipende anche dai passi che mancano, \(h = H - t\), e la policy ottima è una successione \(\pi^*_h(a\mid s)\), indicizzata anch’essa da \(h\), che nello stesso stato può scegliere azioni diverse con \(h = 2\) e con \(h = 100\) [RN20]. Equivalentemente, è stazionaria sullo stato allargato \((s, h)\). A orizzonte infinito scontato, con stati e azioni finiti, esiste sempre una policy ottima stazionaria e deterministica, perché dopo ogni passo il problema che resta è identico a quello di partenza. Gli episodi che finiscono in uno stato terminale senza una scadenza fissata, come il labirinto e il cliff walking, stanno da questa parte: quanto resta da giocare dipende dallo stato in cui ci si trova, non dall’orologio. Con \(\gamma < 1\) basta il risultato scontato, perché lo stato terminale è uno stato da cui non si esce e che non paga più niente; con \(\gamma = 1\), come nel cliff walking, servono le ipotesi dei problemi di cammino minimo stocastico, che tornano con la convergenza della value iteration. È la ragione per cui la policy si scrive di solito \(\pi(a\mid s)\), senza indice di tempo, e per cui i risultati sugli equilibri fra più agenti parlano di policy stazionarie.
Un MDP in miniatura#
Conviene vedere tutti i pezzi in un solo disegno. La Fig. 13.2 ritrae un mondo minuscolo con tre stati, che chiamiamo \(s_0\), \(s_1\) e \(s_2\) (sono soltanto nomi di caselle, e il disegno le mostra). Da \(s_0\) l’agente può salire verso \(s_1\) oppure restare fermo; da \(s_1\) può scendere verso l’obiettivo \(s_2\) o tornare indietro. L’obiettivo si dice terminale, a indicare che lì la partita finisce: arrivati, non si fa più niente e non si incassa più niente. Ogni freccia è un’azione ed è annotata con la ricompensa che paga: salire non costa nulla, restare o tornare fanno perdere un punto (nel disegno, \(r = -1\)), raggiungere l’obiettivo ne fa guadagnare dieci (\(r = +10\)). Con \(\gamma\) vicino a 1 la strategia migliore è intuibile a colpo d’occhio (\(s_0 \to s_1 \to s_2\)) ed è proprio quel «colpo d’occhio» che le funzioni valore rendono calcolabile in modo sistematico.

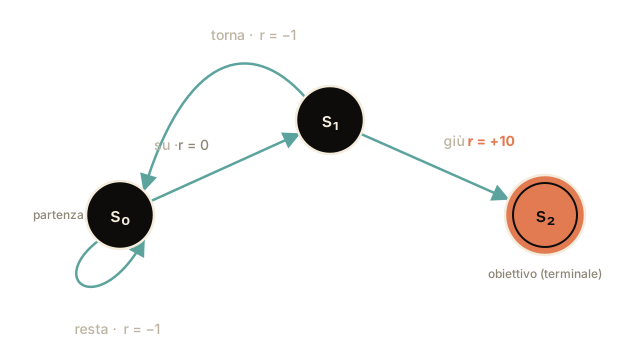
Fig. 13.2 Un MDP in miniatura: gli stati sono cerchi, le azioni frecce, e ogni freccia riporta il nome della mossa e la ricompensa che si incassa facendola (la \(r\) del disegno sta per ricompensa). L’obiettivo \(s_2\) è terminale: arrivati lì la partita finisce.#
Le funzioni valore: quanto vale trovarsi qui#
Una partita sola dice poco. Il ritorno raccolto in un singolo episodio, cioè in una partita giocata dall’inizio alla fine, dipende da come è andata quella volta: dalle mosse scelte, che possono essere state tirate a sorte, e dal mondo, che alla stessa mossa può rispondere in modi diversi (una pedalata non fa sempre lo stesso effetto). Rigiocando viene un numero diverso. Quello che serve è il ritorno medio: quanto promette, in media, trovarsi in una certa situazione e comportarsi in un certo modo. È il mestiere delle funzioni valore.
Due domande, due funzioni. Quanto è buono trovarsi qui? è il valore di stato \(V\): la ricompensa totale che mi aspetto di raccogliere partendo da questo stato. Quanto è buono fare questa mossa qui? è il valore di stato-azione \(Q\): come sopra, ma fissando anche l’azione. \(Q\) è spesso più utile in pratica, perché confrontando le azioni in uno stato mi dice direttamente quale conviene.
Una precisazione che serve subito, perché altrimenti le due ricette che vengono adesso sembrano tirare fuori un’idea dal nulla. «Quanto mi aspetto di raccogliere» dipende da come gioco: la stessa casella vale poco per chi si muove a caso e molto per chi si muove bene, quindi non c’è un valore solo, ce n’è uno per ogni strategia. Nelle due ricette che vengono adesso, quando non si dice niente, si intende il valore giocando al meglio; dove invece interessa il valore di una strategia particolare, lo diremo.
I due numeri, del resto, sono legati proprio dalla strategia: quanto vale una casella è la media di quanto valgono le mosse che partono da lì, pesata per quanto spesso la strategia sceglie ciascuna. Chi tira a sorte metà e metà fra una mossa che vale \(10\) e una che vale \(4\) si ritrova una casella che vale \(0{,}5 \times 10 + 0{,}5 \times 4 = 7\); per chi gioca sempre la migliore delle due, la stessa casella vale \(10\).
I conti che vengono adesso li faremo tutti sul primo dei due, il valore di una casella, che è il più corto da scrivere. Il secondo, il valore di una mossa, torna nell’ultima sezione del capitolo, tanto centrale da dare il nome all’algoritmo che se ne occupa: il Q-learning, che è appunto imparare quella \(Q\) lì.
Data una policy \(\pi\), la funzione valore di stato e la funzione valore di stato-azione sono
\(V^\pi(s)\) è il ritorno atteso partendo da \(s\) e seguendo poi \(\pi\); \(Q^\pi(s,a)\) fissa la prima azione ad \(a\) e da lì prosegue con \(\pi\). Le due sono legate da \(V^\pi(s) = \sum_a \pi(a\mid s)\, Q^\pi(s,a)\).
L’equazione di Bellman: ogni valore si appoggia al successivo#
L’equazione di Bellman lega il valore di uno stato a quello degli stati che lo seguono. Il ritorno si spezza in due pezzi, la ricompensa del passo successivo e il ritorno scontato che viene dopo, e di questo secondo pezzo basta il valore atteso: non serve sommare da capo infinite ricompense.
Il valore di dove sei = la ricompensa che incassi al prossimo passo più il valore (scontato) di dove finisci. È una scala a pioli: ogni gradino è definito in funzione del successivo. Vale per qualunque strategia, con i valori di quella strategia: chi gioca a caso ha la sua scala, chi gioca bene un’altra. Per chi gioca al meglio, la ricompensa e la casella d’arrivo sono quelle della mossa migliore.
Quando la strategia lascia qualcosa al caso, o quando il mondo alla stessa mossa risponde in modi diversi, «la ricompensa che incassi» e «dove finisci» sono più possibilità, ciascuna con la sua probabilità, invece di un numero e una casella. Il gradino allora si calcola in media, pesando ogni possibilità per quanto spesso capita. Una mossa che sette volte su dieci porta in una casella che vale \(10\), e tre volte su dieci scivola in una che vale \(0\), in media porta \(0{,}7 \times 10 + 0{,}3 \times 0 = 7\).
Nel labirinto, il valore della casella accanto all’uscita è alto perché l’uscita vale molto; e poi quel valore fa un passo all’indietro, dalla casella accanto all’uscita a quella prima ancora, e poi a quella prima ancora, gradino dopo gradino, fino alla partenza. Il premio non si sposta: si sposta la notizia che esiste.
Spezzando il ritorno come \(G_t = R_{t+1} + \gamma\, G_{t+1}\) e prendendo l’attesa condizionata a \(S_t = s\) si ha
Nell’ultimo termine si condiziona prima anche a \(S_{t+1}\) (legge delle attese iterate): per la proprietà di Markov, e perché né \(\pi\) né \(P\) dipendono dal tempo, noto \(S_{t+1} = s'\) il futuro non dipende più da \(S_t\), quindi \(\mathbb{E}_\pi[G_{t+1} \mid S_{t+1} = s',\, S_t = s] = V^\pi(s')\). Si ottiene l’equazione di Bellman per \(V^\pi\):
che, esplicitando policy e transizioni, diventa
La gemella per \(Q^\pi\) si ottiene con la stessa spezzatura, fissando la prima azione:
Dentro le parentesi quadre c’è il gradino successivo, pesato con le probabilità con cui \(\pi\) sceglie: campionare quel gradino invece di sommarlo (uno stato \(s'\) consegnato dall’ambiente, un’azione \(a'\) pescata da \(\pi\)) è esattamente l’aggiornamento di SARSA, che arriva nella pagina su Q-learning e differenze temporali.
Sono sistemi di equazioni lineari: relazioni di consistenza fra il valore di uno stato (o di una coppia stato-azione) e quello dei successori. Da qui partono la programmazione dinamica e le differenze temporali, dalla value iteration e dalla policy iteration che vengono adesso fino al Q-learning; i metodi Monte Carlo stimano gli stessi valori senza usare la ricorsione.
Value iteration: l’equazione diventa algoritmo#
L’equazione di Bellman dice come devono stare i valori quando sono giusti, ma non come trovarli, e all’inizio non li conosciamo. Il primo modo di trovarli la usa come regola di aggiornamento: su ogni casella si scrive il valore richiesto dall’equazione, calcolato usando i numeri presenti in quel momento sulle caselle d’arrivo, e si ripete finché le stime non si assestano. In inglese si chiama value iteration, «iterazione dei valori», ed è il nome con cui si incontra ovunque.
È anche l’idea con cui Bellman inaugurò la programmazione dinamica [Bel57]: due parole che non spiegano niente (e lo sapeva lui per primo, che le scelse anche perché suonavano innocue a chi doveva finanziarlo), ma che ancora oggi indicano questo: risolvere un problema grande riusando le risposte già trovate ai suoi pezzi piccoli.
La ricetta, nel labirinto: scrivi \(0\) su ogni casella. Poi, casella per casella, guarda tutte le mosse possibili e chiediti: «quanto rende ciascuna, contando la ricompensa immediata più il valore (scontato) della casella dove finirei?». Scrivi sulla casella il risultato della mossa migliore, perché il valore che stiamo calcolando è quello di chi gioca al meglio. Finito il giro, ricomincia da capo con i numeri nuovi, e poi ancora, finché i numeri smettono di muoversi. A quel punto ogni casella dice quanto vale davvero, e la strategia migliore è in omaggio: da ogni casella, scegli la mossa che rende di più. Da quali numeri si sia cominciato non conta: partendo da cento dappertutto invece che da zero i giri sono molti di più, ma i numeri su cui ci si ferma sono gli stessi. Sulle leve il numero di partenza cambiava parecchio, perché decideva quali leve l’agente avrebbe provato; qui nessuno sceglie che cosa guardare, a ogni giro si ricalcolano tutte le caselle, e il punto di partenza sbiadisce da sé.
Un dettaglio del «giro» va fissato adesso, perché senza di quello i conti che seguono sembrano sbagliati. Si scrive su un foglio nuovo guardando il vecchio, e non si corregge il vecchio mentre lo si legge. Quindi, dentro un giro, i numeri che si leggono sono sempre quelli con cui il giro è cominciato: anche quelli di una casella che nel frattempo si è già riscritta.
Partendo da una stima arbitraria \(V_0\) (tipicamente nulla), si itera
dove \(V_k\) è la stima dei valori al passo \(k\): è l’equazione di Bellman con un \(\max\) sulle azioni al posto della media pesata dalla policy. Il punto fisso è l’equazione di ottimalità di Bellman, \(V^*(s) = \max_a \sum_{s'} P(s'\mid s,a)\big[r(s,a) + \gamma\, V^*(s')\big]\), dove \(V^*\) è il valore della migliore policy possibile. Con \(\gamma < 1\), stati e azioni finiti e ricompense limitate, la convergenza è garantita. Chiamato \(\mathcal{B}\) l’operatore che porta \(V_k\) in \(V_{k+1}\), per due funzioni qualsiasi \(U\) e \(W\) vale
basta la disuguaglianza \(|\max_a x_a - \max_a y_a| \le \max_a |x_a - y_a|\), insieme al fatto che le \(P(s'\mid s,a)\) sommano a \(1\). \(\mathcal{B}\) è quindi una contrazione di fattore \(\gamma\) nella norma del massimo, e per il teorema di punto fisso di Banach ha un punto fisso unico, \(V^*\), a cui l’iterazione arriva da qualunque inizializzazione con \(\|V_k - V^*\|_\infty \le \gamma^k \|V_0 - V^*\|_\infty\) [Bel57] [SB18]. La stessa disuguaglianza dà il criterio d’arresto: se \(\|V_{k+1} - V_k\|_\infty < \kappa(1-\gamma)/(2\gamma)\), la policy greedy rispetto a \(V_{k+1}\) perde al più \(\kappa\) rispetto all’ottima. Ogni passata costa \(O(|\mathcal{S}|^2 |\mathcal{A}|)\). Nei compiti episodici con \(\gamma = 1\) il fattore di contrazione sparisce, e la garanzia va ricomprata altrove: basta che ogni policy raggiunga con probabilità \(1\) uno stato terminale, e la condizione si allenta fino a chiedere che almeno una ci arrivi e che ogni policy che non ci arriva accumuli, da qualche stato, ricompensa \(-\infty\) (è il quadro dei problemi di cammino minimo stocastico). Estratto \(V^*\), la policy ottima è quella greedy: in ogni stato, l’azione che realizza il massimo di \(\sum_{s'} P(s'\mid s,a)\,[\,r(s,a) + \gamma\, V^*(s')\,]\), e per calcolarlo serve il modello. Con i valori delle azioni non serve: \(\pi^*(s) = \arg\max_a Q^*(s,a)\) si legge dalla tabella. Per questo, quando il modello manca, si stimano i valori delle azioni.
La value iteration all’opera#
Facciamo davvero i conti, sull’MDP in miniatura della Fig. 13.2 e con uno sconto di \(0{,}9\). Le transizioni sono deterministiche: la stessa mossa porta sempre nella stessa casella, e non c’è nessuna media da fare fra esiti diversi. La ricetta si legge allora senza complicazioni: «quanto paga la mossa, più \(0{,}9\) volte il valore della casella dove si finisce», e si tiene la mossa che rende di più. L’obiettivo \(s_2\) vale sempre \(0\), perché lì la partita è finita e non c’è più niente da raccogliere; e si comincia scrivendo \(0\) anche sulle altre due caselle, tanto per avere un punto di partenza.
Vale la regola di prima: dentro un giro si leggono i numeri con cui il giro è cominciato, e quindi l’ordine in cui si visitano le caselle non conta.
Primo giro. Cominciamo da \(s_1\), la casella accanto all’obiettivo. Scendere paga \(10\) subito e porta nell’obiettivo, che vale \(0\): in tutto \(10 + 0{,}9 \times 0 = 10\). Tornare indietro costa \(1\) e porta in \(s_0\), che per adesso vale \(0\): in tutto \(-1 + 0{,}9 \times 0 = -1\). Vince scendere, e su \(s_1\) scriviamo \(10\). Passiamo a \(s_0\): salire non costa nulla e porta in \(s_1\), che sul foglio vecchio vale ancora \(0\) (il \(10\) l’abbiamo appena scritto su quello nuovo, e in questo giro non si legge), quindi rende \(0\); restare fermi costa \(1\) e lascia dove si è, cioè in \(s_0\), che vale \(0\), quindi rende \(-1\). Vince salire, e su \(s_0\) scriviamo \(0\). Il premio è entrato in \(s_1\), ma in \(s_0\) non è ancora arrivato.
Secondo giro. Su \(s_1\) non cambia niente, resta \(10\). Su \(s_0\) invece salire adesso porta in una casella che vale \(10\), quindi rende \(0 + 0{,}9 \times 10 = 9\), contro il \(-1\) di restare fermi: scriviamo \(9\). Il premio ha fatto un altro passo all’indietro.
Terzo giro. Rifacendo gli stessi conti non si muove più niente. Da \(s_0\) salire rende ancora \(9\), mentre restare fermi adesso costa \(1\) e lascia in una casella che vale \(9\), cioè \(-1 + 0{,}9 \times 9 = 7{,}1\): meno di \(9\), quindi si sale ancora. Da \(s_1\) scendere rende ancora \(10\), mentre tornare costa \(1\) e porta in \(s_0\), che vale \(9\): \(-1 + 0{,}9 \times 9 = 7{,}1\) di nuovo. Che venga lo stesso numero non è un mistero: le due mosse costano tutte e due \(1\) punto e finiscono tutte e due in una casella che vale \(9\), quindi il conto è letteralmente lo stesso. I numeri si sono fermati, e allora abbiamo finito: è questo che si intende con «finché non si assestano», e infatti nella tabella le ultime due righe sono uguali.
dopo il giro |
\(s_0\) vale |
\(s_1\) vale |
\(s_2\) vale |
|---|---|---|---|
all’inizio |
\(0\) |
\(0\) |
\(0\) |
primo |
\(0\) |
\(10\) |
\(0\) |
secondo |
\(9\) |
\(10\) |
\(0\) |
terzo |
\(9\) |
\(10\) |
\(0\) |
Prima iterazione. In \(s_1\): scendere rende \(10 + 0{,}9 \times 0 = 10\), tornare rende \(-1 + 0{,}9 \times 0 = -1\); vince scendere, quindi \(V_1(s_1) = 10\). In \(s_0\): salire rende \(0 + 0{,}9 \times 0 = 0\), restare \(-1 + 0{,}9 \times 0 = -1\); quindi \(V_1(s_0) = 0\). Il \(+10\) dell’obiettivo è «entrato» in \(s_1\), ma non ha ancora raggiunto \(s_0\).
Seconda iterazione. In \(s_1\) non cambia nulla: \(V_2(s_1) = 10\). In \(s_0\), però, salire ora rende \(0 + 0{,}9 \times 10 = 9\) contro il \(-1\) di restare: quindi \(V_2(s_0) = 9\). Il valore dell’obiettivo è retrocesso di un altro passo verso l’inizio.
Terza iterazione. Rifacendo i conti non si muove più niente: salire da \(s_0\) rende ancora \(9\), restare renderebbe \(-1 + 0{,}9 \times 9 = 7{,}1\); scendere da \(s_1\) rende ancora \(10\), tornare \(-1 + 0{,}9 \times 9 = 7{,}1\). Quindi \(V_3(s_0) = 9\) e \(V_3(s_1) = 10\): l’algoritmo si è fermato, e quel punto fisso è \(V^*\), il valore della policy ottima.
\(V(s_0)\) |
\(V(s_1)\) |
\(V(s_2)\) |
|
|---|---|---|---|
\(k=0\) |
\(0\) |
\(0\) |
\(0\) |
\(k=1\) |
\(0\) |
\(10\) |
\(0\) |
\(k=2\) |
\(9\) |
\(10\) |
\(0\) |
\(k=3\) |
\(9\) |
\(10\) |
\(0\) |
I numeri hanno smesso di muoversi, e quelli sono i valori veri: dicono, da ogni casella, quanto ci si può aspettare di raccogliere da lì in avanti giocando al meglio. La strategia migliore arriva in omaggio, leggendo le mosse che hanno vinto (da \(s_0\) salire, da \(s_1\) scendere): è lo stesso «colpo d’occhio» di prima, solo che adesso è un calcolo che un computer ripete identico su un milione di caselle.
Un milione, però, è un tetto e non un vanto, ed è la ragione per cui esiste il deep reinforcement learning. La tabella si può scrivere finché le situazioni si possono elencare, e ci sono giochi comunissimi in cui non si possono.
Gli scacchi hanno circa \(4{,}8 \times 10^{44}\) posizioni legali, dove \(10^{44}\) è la scrittura breve di «uno seguito da quarantaquattro zeri». Il Go, che si gioca sugli incroci di una griglia di diciannove righe per diciannove, ne ha circa \(2{,}08 \times 10^{170}\). Sono due conti fatti sul serio dal matematico John Tromp e dai suoi collaboratori: il Go nel 2016, dove il numero è esatto e ha tutte e centosettantuno le sue cifre, e gli scacchi nel 2021, dove è una stima.
E poi c’è il caso che chiude il discorso. Prendiamo un solo fotogramma di un videogioco Atari, ridotto come lo riducevano gli agenti che imparavano a giocare guardando lo schermo: niente colori, solo sfumature di grigio, e una griglia di \(84\) pixel per \(84\), i puntini di cui è fatta l’immagine (una misura scelta da loro, abbastanza piccola da essere maneggiabile e abbastanza grande da vederci ancora qualcosa). Sono \(7056\) pixel, e ognuno può essere in uno di \(256\) grigi, dal nero al bianco. Le combinazioni si contano moltiplicando: due pixel da \(256\) grigi danno \(256 \times 256\) immagini diverse, tre pixel \(256 \times 256 \times 256\), e settemila pixel danno \(256\) moltiplicato per sé stesso settemila volte, che si scrive \(256^{7056}\). È un numero di quasi diciassettemila cifre; per contare tutti gli atomi dell’universo osservabile ne bastano un’ottantina. Non è che su quei mondi la tabella sia lenta: non c’è nessun universo in cui la si possa scrivere. Un milione di stati è poco.
Il premio, si è visto, non resta fermo dov’è: risale il mondo una casella per giro, come un’onda che parte dal traguardo e va all’indietro. Su tre stati quell’onda si esaurisce in due passi, e non c’è granché da guardare. Su una griglia si vede meglio, ed è quello che mostra la Fig. 13.3.
Attenzione, è un labirinto diverso da quello a tre caselle di prima: qui l’obiettivo (la stella) paga \(+1\), i passi non costano nulla, le due caselle scure sono muri, e lo sconto vale sempre \(0{,}9\). Con queste regole i numeri dentro le caselle si leggono da soli: la casella da cui basta una mossa per arrivare vale \(1{,}00\), cioè il premio pieno, e ogni passo indietro lo moltiplica per \(0{,}9\), perché lo stesso premio arriva più tardi: \(0{,}90\), poi \(0{,}81\), e così via. Dopo sei giri i numeri si fermano, e sei sono esattamente i passi che separano dall’obiettivo le due caselle più lontane: quella in basso a sinistra e quella subito sotto il muro più in alto. Si contino sul disegno, aggirando i muri, e tornano.

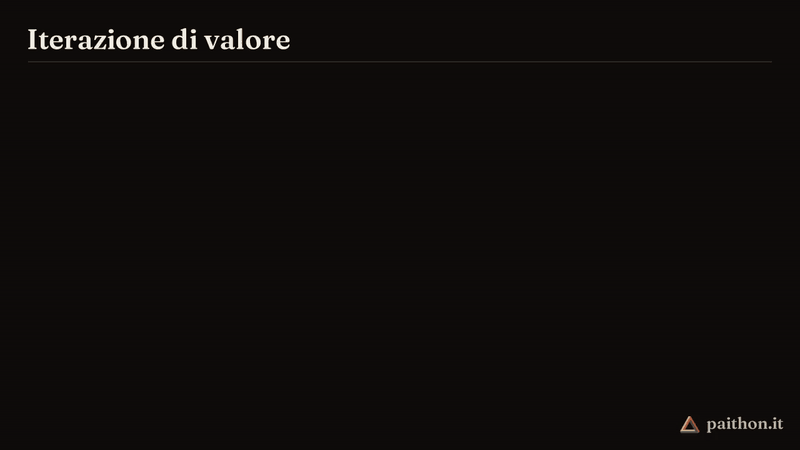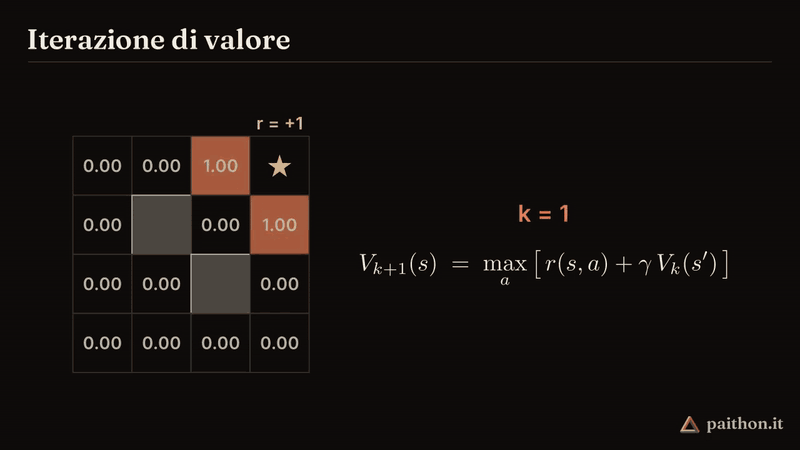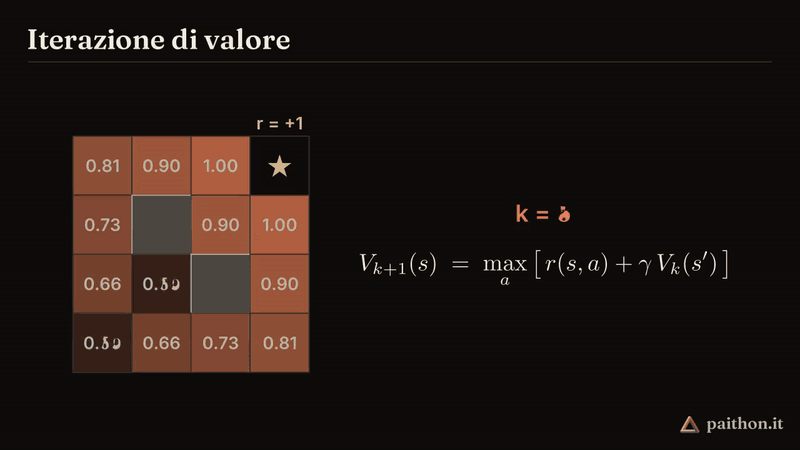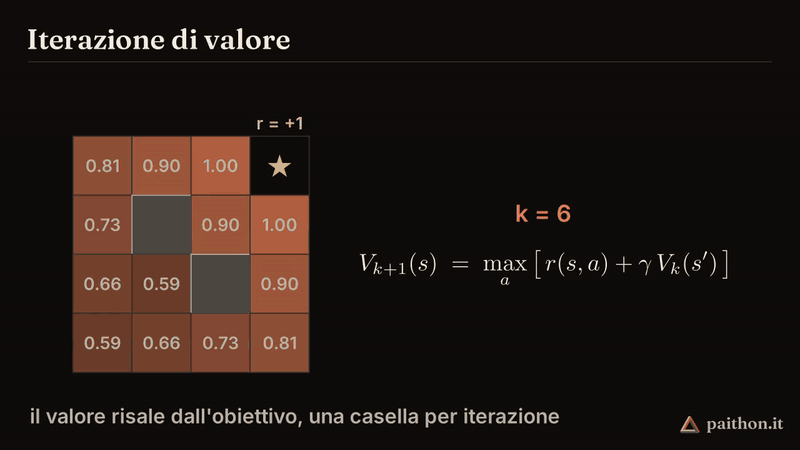
Fig. 13.3 La stessa ricetta su un mondo a griglia \(4\times4\). Il valore parte dall’obiettivo e risale la griglia di una casella per giro, aggirando i muri, finché i numeri smettono di muoversi; la casella dell’obiettivo non porta numeri perché lì la partita è finita. A destra, il contatore dei giri e la stessa ricetta scritta in simboli: il valore nuovo di una casella è, fra tutte le mosse possibili, la migliore fra «quanto paga la mossa, più lo sconto per il valore vecchio della casella dove si finisce».#
Che i giri siano esattamente sei vale però solo in un mondo come questo, dove ogni mossa porta sempre nella stessa casella e il premio sta tutto sul traguardo. Quando le mosse hanno esito incerto, cioè quando la stessa mossa a volte riesce e a volte no, di regola il calcolo non si ferma da sé: si avvicina ai numeri veri senza mai toccarli. Chiamiamo errore di una casella la distanza fra il numero che porta e il suo valore vero. Il numero nuovo di una casella si fa con quelli delle caselle d’arrivo moltiplicati per lo sconto, e con loro arrivano moltiplicati per lo sconto anche i loro errori: a ogni giro l’errore più grande della griglia scende almeno a nove decimi di quello che era. Dopo dieci giri ne resta al più il 35% (\(0{,}9\) moltiplicato per sé stesso dieci volte), dopo venti al più il 12%, e ci si ferma quando è più piccolo di una soglia fissata in anticipo. In tutti e due i casi resta vero il punto: il valore non arriva dappertutto insieme, cammina, una casella per giro.
Policy iteration: valutare e migliorare, a turni#
La value iteration fonde due gesti in un unico aggiornamento: stimare quanto rendono gli stati e scegliere le azioni migliori. La policy iteration, che si deve a Ronald Howard [How60], li separa e li alterna: prima valuta fino in fondo la policy corrente, poi la migliora, e ricomincia.
Restiamo nel labirinto, che è più concreto. Una strategia in mano c’è già, anche stupida: in ogni casella una freccia che dice dove andare. Primo tempo, la pagella: tenendo quelle frecce ferme, si calcola con pazienza quanto rende partire da ogni casella, e si ricalcola finché i numeri non si assestano. Secondo tempo, la correzione: con la pagella davanti si scorrono le caselle una per una, e dove un’altra freccia rende di più, contando insieme quello che paga la mossa e il valore scontato della casella in cui manda, si gira la freccia. Poi si rifà la pagella per le frecce nuove, si corregge ancora, e avanti così. Quando un giro di correzioni non gira più nessuna freccia, quella è la strategia migliore possibile.
Detta così sembra troppo bella: e se mi fossi incastrato in una strategia mediocre che da sola non riesce a migliorarsi? Non succede, ed è un teorema: in questo tipo di problema, se in nessuna casella una freccia diversa rende di più, allora non esiste nemmeno un cambio di molte frecce insieme che renda di più. Il controllo casella per casella, che sembra miope, basta. E non si va avanti all’infinito: i modi di disporre le frecce sono tanti ma finiti, ogni giro ne consegna uno migliore del precedente, e una lista finita non si può risalire per sempre.
La differenza con il metodo di prima è il ritmo. Là ogni giro era leggero (un’occhiata sola per casella) e i giri erano tanti; qui i giri sono pochi, spesso una manciata, ma ognuno contiene una pagella completa, che è un lavoro lungo.
Si alternano due passi. Valutazione: data la policy \(\pi\), si calcola \(V^\pi\) risolvendo il sistema lineare dell’equazione di Bellman. In forma vettoriale è \(\mathbf{v}^\pi = \mathbf{r}^\pi + \gamma\, \mathbf{P}^\pi \mathbf{v}^\pi\), dove \(\mathbf{v}^\pi\) è il vettore dei valori, \(\mathbf{r}^\pi\) quello delle ricompense attese sotto \(\pi\) e \(\mathbf{P}^\pi\) la matrice di transizione fra stati indotta da \(\pi\); quindi \(\mathbf{v}^\pi = (\mathbf{I} - \gamma\, \mathbf{P}^\pi)^{-1} \mathbf{r}^\pi\), e l’inversa esiste perché \(\mathbf{P}^\pi\) è stocastica e il raggio spettrale di \(\gamma\, \mathbf{P}^\pi\) non supera \(\gamma < 1\). Per eliminazione costa \(O(|\mathcal{S}|^3)\), e per questo con molti stati la si itera, stavolta senza \(\max\), fino a convergenza: l’operatore \(\mathcal{B}^\pi\) della valutazione, la stessa iterazione senza \(\max\), è anch’esso una contrazione di fattore \(\gamma\) nella norma del massimo, e per questo converge a \(V^\pi\). Si può anche aggiornare sul posto, usando subito i valori già ricalcolati nello stesso giro: converge lo stesso, e di solito più in fretta [SB18]. Miglioramento: si rende la policy greedy rispetto ai valori appena calcolati,
Il policy improvement theorem dice che, se \(Q^\pi(s,\pi'(s)) \ge V^\pi(s)\) in ogni stato, allora \(V^{\pi'}(s) \ge V^\pi(s)\) in ogni stato. La dimostrazione è un’espansione ripetuta,
in cui sul secondo termine si riapplica la stessa disuguaglianza, passo dopo passo, finché resta l’attesa del ritorno sotto \(\pi'\). La policy greedy soddisfa la condizione per costruzione, con miglioramento stretto da qualche parte finché \(\pi\) non è ottima; e poiché in un MDP finito le policy deterministiche sono in numero finito, l’alternanza termina sulla policy ottima in un numero finito di iterazioni, al più \(|\mathcal{A}|^{|\mathcal{S}|}\) e in pratica pochissime [SB18]. La terminazione vuole però una cautela: se il \(\arg\max\) ha azioni pari merito e le sceglie ogni volta in modo diverso, l’algoritmo può rimbalzare per sempre fra policy ugualmente buone; si cambia azione solo quando la nuova è strettamente migliore, oppure ci si ferma quando \(V^\pi\) smette di cambiare. Il confronto con la value iteration è un compromesso classico: la policy iteration converge in meno iterazioni, ma ciascuna contiene una valutazione completa (costosa: un sistema di \(|\mathcal{S}|\) equazioni, o molte passate); la value iteration fa iterazioni molto più economiche (una sola passata con il \(\max\)) ma ne richiede di più. Si può anzi leggere la value iteration come una policy iteration impaziente, che tronca la valutazione dopo un solo passo. L’alternanza fra valutare e migliorare, completa o troncata, sincrona o sul posto, ha un nome, generalized policy iteration, ed è lo schema in cui Sutton e Barto riconoscono quasi tutti i metodi di reinforcement learning [SB18].
Le due strade portano alla stessa policy ottima: la policy iteration con poche iterazioni, ciascuna con una valutazione completa; la value iteration con molte iterazioni leggere. Nella pratica si usano anche le vie di mezzo, in cui la valutazione si ferma dopo poche passate invece di arrivare fino in fondo (modified policy iteration).
In codice le due ricette stanno in poche righe, sul mondo a tre caselle della Fig. 13.2: la value iteration ripete il massimo su tutte le caselle, la policy iteration parte dalla strategia peggiore, quella che resta ferma e torna indietro, e alterna valutazione e correzione.
import numpy as np

gamma = 0.9
# Il mondo della figura: s0, s1 e l'obiettivo s2, che chiude la partita.
# In ogni casella la mossa 0 va verso l'obiettivo, la mossa 1 no.
P = np.zeros((2, 3, 3))                 # P[a, s, s'] = P(s' | s, a)
r = np.zeros((3, 2))                    # r[s, a] = ricompensa attesa r(s, a)
P[0, 0, 1], r[0, 0] = 1, 0              # s0, su:    si va in s1, r = 0
P[1, 0, 0], r[0, 1] = 1, -1             # s0, resta: si resta in s0, r = -1
P[0, 1, 2], r[1, 0] = 1, 10             # s1, giù:   si arriva in s2, r = +10
P[1, 1, 0], r[1, 1] = 1, -1             # s1, torna: si torna in s0, r = -1
P[:, 2, 2] = 1                          # da s2 non si esce e non si incassa
NOMI = [["su", "resta"], ["giù", "torna"]]

def valori_mosse(V):
    """Q(s, a) = r(s, a) + gamma * somma su s' di P(s' | s, a) V(s')."""
    return r + gamma * np.einsum("ast,t->sa", P, V)

print("value iteration       V(s0)  V(s1)  V(s2)")
V = np.zeros(3)
for giro in range(1, 4):
    V = valori_mosse(V).max(axis=1)     # in ogni casella, la mossa migliore
    print(f"  giro {giro}            " + "".join(f"{v:7.2f}" for v in V))

print("policy iteration")
pi = np.array([1, 1, 0])                # si parte da "resta" e "torna"
caselle = np.arange(3)
while True:
    # valutazione: si risolve (I - gamma P_pi) v = r_pi
    V = np.linalg.solve(np.eye(3) - gamma * P[pi, caselle], r[caselle, pi])
    print(f"  {NOMI[0][pi[0]]:5} {NOMI[1][pi[1]]:5}       "
          + "".join(f"{v:7.2f}" for v in V))
    nuova = valori_mosse(V).argmax(axis=1)       # correzione: greedy su V
    if (nuova == pi).all():
        break
    pi = nuova
value iteration       V(s0)  V(s1)  V(s2)
  giro 1               0.00  10.00   0.00
  giro 2               9.00  10.00   0.00
  giro 3               9.00  10.00   0.00
policy iteration
  resta torna        -10.00 -10.00   0.00
  su    giù            9.00  10.00   0.00
La value iteration si ferma al terzo giro sui numeri della tabella. La policy iteration parte da una strategia che perde un punto a ogni passo per sempre, e che scontato fa \(-10\) da tutte e due le caselle; alla prima correzione arriva sulla strategia giusta e sugli stessi valori, e lì si ferma.
Quando manca il modello dell’ambiente#
C’è però un dettaglio che finora abbiamo dato per scontato, ed è enorme. Per fare quei conti («ricompensa della mossa più valore della casella d’arrivo») bisogna sapere in anticipo dove porta ogni mossa e quanto paga. Le due ricette appena viste richiedono cioè di avere in mano la mappa: per ogni mossa, dove si finisce (e con quali probabilità, quando l’esito è incerto) e quanto si incassa a farla. È pianificare un viaggio con la cartina già aperta sul tavolo, e quella cartina sono le regole che, nel capitolo sulla ricerca, si potevano interrogare a volontà.
Quella mappa ha un nome tecnico, modello dell’ambiente: le probabilità di transizione \(P(s'\mid s,a)\) e le ricompense attese \(r(s,a)\). Attenzione a non confonderlo con il «modello» di cui si parla altrove, la rete neurale addestrata: qui modello vuol dire una descrizione di come funziona il mondo, niente di più. Il robot del nostro labirinto quella descrizione non ce l’ha, e il mondo reale quasi mai la consegna: nessuno può dire a un agente, per ogni mossa e in anticipo, con che probabilità troverà traffico o come risponderà l’avversario a Go.
Quando la mappa manca, i valori si ricavano dall’esperienza, cioè giocando, e le strade sono due. La prima usa le partite per stimare la mappa stessa, le probabilità \(P(s'\mid s,a)\) e le ricompense \(r(s,a)\), e poi su quella stima rifà i conti delle due ricette di prima, come fa la sezione sull’RL basato su modello. La seconda stima i valori direttamente, senza passare dalla mappa, e lo si può fare in due modi.
Il primo è il più diretto che si possa immaginare. Si gioca una partita intera, si guarda quanti punti si sono fatti, e si usa quel totale per dare un voto a tutte le caselle attraversate. Poi un’altra partita, e un’altra ancora, e si fa la media. Sono i metodi Monte Carlo, dal nome del casinò, perché tutto si regge sul ripetere molte volte una cosa che ogni volta va a finire diversamente.
Il secondo non aspetta nemmeno la fine della partita. Dopo ogni singola mossa guarda dov’è finito, legge il numero che era già scritto su quella casella (un numero provvisorio, magari sbagliato, ma è quello che si ha) e con quello corregge subito il numero della casella da cui era partito. Correggere una stima con un’altra stima, ancora imperfetta, è l’idea dell’apprendimento per differenze temporali, che prende il nome dalla correzione: la differenza fra quello che si credeva un istante fa e quello che si crede adesso. Che funzioni, e a quali condizioni, lo mostra la sezione sul Q-learning e le differenze temporali, il suo esemplare più famoso.
Da ricordare
Il reinforcement learning si descrive con un giro solo: l’agente si trova in una situazione (il robot in una casella del labirinto), sceglie una mossa, finisce da qualche parte e incassa un punteggio. Poi si ricomincia.
La situazione deve bastare da sola: come la foto di una partita a scacchi, deve dire tutto ciò che serve per prevedere come va avanti, e quindi per decidere, senza che occorra sapere come ci si è arrivati. Se non basta, si allarga l’inquadratura; e dove non si può, come con le carte coperte degli altri, ci si fa un’idea di quello che c’è sotto e si gioca lo stesso.
La strategia è l’abitudine dell’agente (in questa casella vado a destra), eventualmente truccata come un dado quando conviene provare altro. E il futuro pesa meno del presente: dieci euro oggi valgono più di dieci euro l’anno prossimo, e il fattore di sconto misura questa impazienza.
Il valore di una casella è il punteggio che ci si aspetta di raccogliere da lì in avanti; il valore di una mossa fa lo stesso fissando anche la prima mossa. Ogni valore si appoggia al successivo come i pioli di una scala: è così che il premio dell’uscita risale il labirinto, una casella per volta.
Se la mappa è nota (dove porta ogni mossa e quanto paga), ci sono due ricette: aggiornare i numeri di tutte le caselle finché smettono di muoversi, oppure alternare pagella e correzione come un allenatore. Quando la mappa manca si impara giocando: o ci si ricostruisce la mappa e si rifanno i conti, oppure si stimano direttamente i valori, con partite intere (Monte Carlo) o con correzioni a ogni passo (differenze temporali).
Tutto questo si tiene in una tabella con una casella per situazione, e la tabella si scrive finché le situazioni si possono elencare: un milione va benissimo, ma gli scacchi ne hanno uno seguito da quarantaquattro zeri e il Go uno seguito da centosettanta zeri. È il muro che il deep reinforcement learning esiste per aggirare.
Da ricordare
Un MDP \((\mathcal{S},\mathcal{A},P,r,\gamma)\) formalizza un agente che sceglie azioni, transita fra stati e raccoglie ricompense.
La proprietà di Markov: noti lo stato e l’azione presenti, lo stato successivo e la ricompensa non dipendono dal resto della storia.
La policy \(\pi(a\mid s)\) è la strategia, e senza indice di tempo basta a orizzonte infinito o senza scadenza (a orizzonte finito \(H\) la policy ottima dipende dai passi che mancano); il ritorno scontato \(G_t\) pesa il futuro con \(\gamma\), e nei compiti continui l’alternativa allo sconto è la ricompensa media.
\(V^\pi\) e \(Q^\pi\) misurano il ritorno atteso; l’equazione di Bellman li definisce in modo ricorsivo, ed è la base degli algoritmi che stimano le funzioni valore.
Con il modello (\(P\) e \(r\)) noto, value iteration e policy iteration calcolano valori e policy ottimi iterando Bellman. Quando il modello manca lo si può stimare dall’esperienza e pianificarci dentro, oppure imparare i valori direttamente, coi metodi Monte Carlo o con le differenze temporali; e senza modello la policy greedy si legge dai valori delle azioni, non da quelli degli stati.
Tutto l’impianto presuppone \(\mathcal{S}\) enumerabile, una casella di tabella per stato: \(10^6\) stati si trattano, \(10^{44}\) (scacchi) o \(10^{170}\) (Go) no. È l’ipotesi che il deep reinforcement learning dovrà abbandonare.