


Ridurre le dimensioni e trovare gruppi: l’apprendimento non supervisionato#
Fino a qui abbiamo sempre avuto un maestro alle spalle. La regressione, la classificazione, gli alberi e gli ensemble: ogni esempio arrivava con la sua risposta giusta accanto (il prezzo della casa, l’etichetta «spam» o «non spam»). Era l’apprendimento supervisionato, il primo dei «tre modi di imparare» che abbiamo distinto all’inizio del capitolo. Quelle etichette, però, sono un lusso: qualcuno le ha dovute scrivere, una per una. La stragrande maggioranza dei dati che il mondo produce (foto, transazioni, segnali di sensori, log di navigazione) arriva muta, senza nessuna risposta allegata.
Questo è il territorio dell’apprendimento non supervisionato: si danno al modello solo gli input, e gli si chiede di scoprire da sé una struttura nascosta. Due domande, soprattutto, si possono porre a dati senza etichette. La prima: questi dati hanno davvero bisogno di tutte queste dimensioni, o si possono comprimere senza perdere l’essenziale? È la riduzione della dimensionalità. La seconda: ci sono gruppi naturali là dentro, famiglie di esempi che si somigliano tra loro? È il clustering. Una terza, quanto è probabile questo dato?, è la stima della densità: le misture gaussiane rispondono a questa e alla seconda insieme.
Quando avere troppe dimensioni è un problema#
Si penserebbe che più informazioni su ogni esempio (più colonne, più misure, più caratteristiche) siano sempre meglio. A parità di esempi non è così: in uno spazio ad alta dimensione il volume da coprire cresce più in fretta dei dati, e la geometria cambia in modi che l’intuizione, formata su due o tre dimensioni, non prevede. Il fenomeno si chiama maledizione della dimensionalità (curse of dimensionality), con il nome che gli diede Richard Bellman studiando la programmazione dinamica [Bel57].
Il primo effetto riguarda il volume. La sfera inscritta in un cubo si prende il \(78{,}5\%\) del quadrato in due dimensioni, il \(52{,}4\%\) del cubo in tre e lo \(0{,}25\%\) in dieci, e la quota tende a zero al crescere della dimensione: quasi tutto il volume del cubo sta fuori dalla sfera, dalle parti dei vertici.

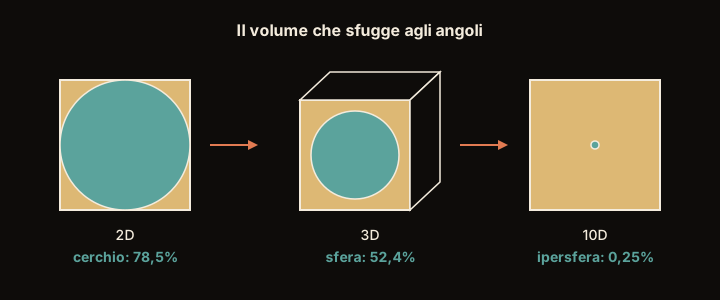
Fig. 4.33 La palla inscritta nel cubo, in due, tre e dieci dimensioni, con la quota di spazio che si prende. Dove sta la palla è il centro; il resto del cubo, in ocra, sono gli angoli. In dieci dimensioni del centro non resta praticamente niente.#
Il conto di Fig. 4.33 mostra che in tante dimensioni il volume sta lontano dal centro. Il secondo effetto riguarda le distanze. Con \(d\) dimensioni, il quadrato della distanza fra due punti è una somma di \(d\) termini, uno per coordinata; se le coordinate sono indipendenti, la somma ha media proporzionale a \(d\) e deviazione standard proporzionale a \(\sqrt{d}\), quindi lo scarto relativo cala come \(1/\sqrt{d}\): al crescere di \(d\) le distanze fra le coppie diventano quasi uguali in proporzione.
Quando l’effetto c’è, ne risente ogni algoritmo basato sulle distanze: «il vicino più vicino» smette di voler dire qualcosa, perché la differenza fra il primo e il centesimo vicino, in proporzione alla loro distanza, si assottiglia fino a sparire.
Prima di tutto, di quali dimensioni stiamo parlando? Delle colonne della tabella: in Apprendimento supervisionato ogni colonna è una direzione dello spazio e ogni riga un punto. Se di ogni cliente registriamo età, reddito, spese mensili e altre novantasette misure, quel cliente è un punto in uno spazio a cento dimensioni. Non lo possiamo disegnare, ma i conti (distanze comprese) si fanno identici a quelli su un foglio.
Immagina allora di cercare un amico, sapendo che le persone sono sempre mille: cambia solo il posto in cui stanno. In una strada (una dimensione) è facile: mille persone in una strada sono una folla, il tuo amico ti è addosso. In una piazza (due dimensioni) le stesse mille persone sono sparpagliate, e devi guardarti attorno. In un grattacielo (tre dimensioni) mille persone sono quasi nessuno: due o tre per piano. Aggiungi una dimensione, cioè una colonna, e il posto disponibile si gonfia ancora, mentre le persone restano mille: in dieci, cento, mille dimensioni lo spazio è così vasto che tutti sono lontanissimi da tutti, e la parola «vicino» perde senso. Il tuo amico è lontano, e lo sono anche tutti gli altri in modo così simile che sapere chi è il più vicino non ti aiuta a trovarlo.
L’altro effetto, ancora più controintuitivo, è quello della figura: in tante dimensioni quasi tutto lo spazio si accalca sui bordi. Il conto si può rifare a mano su una scatola. Prendi una scatola di lato \(1\) e stacca da ogni parete un guscio spesso un decimo. Quello che resta dentro è una scatola più piccola, di lato \(0{,}8\) (un decimo tolto da un lato e uno dall’altro), e quanto spazio occupa lo dice una potenza: in una dimensione \(0{,}8\); in due \(0{,}8 \times 0{,}8 = 0{,}64\); in dieci \(0{,}8\) moltiplicato per sé stesso dieci volte, cioè \(0{,}11\).
Il guscio è tutto il resto: il \(20\%\) in una dimensione, il \(36\%\) in due, e già l’\(89\%\) in dieci. In cento dimensioni il cuore è praticamente zero: nessun punto sta «nel mezzo», stanno tutti appiccicati alle pareti. In un mondo così svuotato e spinto ai margini, gli algoritmi che si fidano delle distanze («chi è vicino a chi») vanno in crisi. Da qui l’idea di ridurre le dimensioni: togliere direzioni tenendo solo ciò che conta davvero.
La sfera inscritta nell’ipercubo unitario \([0,1]^d\) ha raggio \(1/2\) e volume \(V_d\,2^{-d}\), con \(V_d = \pi^{d/2}/\Gamma(d/2+1)\) il volume della sfera di raggio \(1\): la frazione del cubo che occupa vale \(\pi/4 \approx 0{,}785\) per \(d=2\), \(\pi/6 \approx 0{,}524\) per \(d=3\), \(\pi^5/(120\cdot 2^{10}) \approx 0{,}0025\) per \(d=10\), e tende a zero. Un conto più elementare porta alla stessa conclusione. Consideriamo l’ipercubo unitario \([0,1]^d\) e il guscio dei punti che distano meno di \(\varepsilon = 0{,}1\) da almeno una faccia. Il «cuore» interno è un cubo di lato \(1 - 2\varepsilon = 0{,}8\), di volume \(0{,}8^{\,d}\); la frazione di volume nel guscio è quindi
Per \(d=1\) vale \(0{,}2\); per \(d=10\) vale \(1 - 0{,}8^{10} \approx 0{,}89\); per \(d=100\) vale \(1 - 0{,}8^{100} \approx 1 - 2\cdot 10^{-10}\), ossia praticamente \(1\). All’aumentare di \(d\) il volume fugge verso la superficie.
Parallelamente le distanze si concentrano. Si fissino \(m\) punti e un punto di interrogazione (quello di cui si cercano i vicini) indipendente da loro: se la varianza relativa della distanza, \(\operatorname{Var}(\operatorname{dist}) / \mathbb{E}[\operatorname{dist}]^2\), tende a zero con \(d\) (è il caso di coordinate indipendenti e identicamente distribuite con momenti finiti), allora per ogni \(\varepsilon > 0\) la probabilità che \(\operatorname{dist}_{\max} \le (1+\varepsilon)\operatorname{dist}_{\min}\) tende a \(1\) [BGRS99], cioè
Se le coordinate sono tutte copie l’una dell’altra i punti stanno su una retta e l’effetto non c’è: conta la dimensione intrinseca dei dati, che per dati reali è spesso molto minore di \(d\), e lì \(k\)-NN e il clustering per distanza funzionano. Dove l’effetto c’è, il punto più vicino e il più lontano sono quasi equidistanti, la nozione di «vicinanza» perde contrasto, e con essa vacillano \(k\)-NN, il clustering per distanza e la stima di densità [Geron22]. La risposta è cercare un sottospazio di dimensione \(q \ll d\) che conservi l’informazione utile: è la riduzione della dimensionalità.
PCA: le direzioni in cui i dati si muovono di più#
Il metodo più antico e più usato per ridurre le dimensioni è l’analisi delle componenti principali (Principal Component Analysis, PCA), le cui radici risalgono a Karl Pearson [Pea01] nel 1901 e a Harold Hotelling [Hot33] nel 1933. L’idea è semplice: tra tutte le direzioni possibili nello spazio dei dati, lungo alcune i punti si sparpagliano molto, cioè hanno varianza grande, lungo altre restano quasi fermi. La PCA assume che la varianza sia il segnale: tiene le direzioni a varianza grande, perpendicolari fra loro, e proietta i dati su quelle, cioè di ogni punto conserva soltanto le coordinate lungo quelle direzioni. L’assunzione regge quando il segnale ha varianza maggiore del rumore; non è una garanzia, perché la PCA non guarda le etichette, e una direzione a varianza piccola può essere proprio quella che separa le classi.
Uno stormo di uccelli, fotografato da lontano. Se lo stormo è disteso in lunghezza, la fotografia più informativa la scatti di lato, cogliendo la direzione in cui gli uccelli sono più sparpagliati: da quella prospettiva distingui bene chi è avanti e chi è indietro. Fotografarlo di punta, invece, li schiaccerebbe tutti in un mucchietto indistinto.
La PCA fa esattamente questo con i dati. Cerca la direzione lungo cui i punti sono più dispersi (la chiama prima componente principale), perché è lì che si nasconde la maggior parte delle differenze tra un esempio e l’altro.
Prima di scattare, però, ci si mette d’accordo sul metro. Se dello stormo misuri la lunghezza in metri e l’altezza in centimetri, i numeri diranno che gli uccelli sono sparpagliatissimi in altezza, e sarà soltanto colpa delle unità: due direzioni si possono confrontare quando le misure stanno sulla stessa scala. E lo sparpagliamento si conta a partire dal centro dello stormo, non da un punto qualsiasi del cielo.
Trovata la prima direzione, ne cerca una seconda, e qui c’è un vincolo: dev’essere perpendicolare alla prima. La ragione è che due direzioni non perpendicolari raccontano in parte la stessa cosa, e quel pezzo lo si conterebbe due volte; perpendicolari, invece, non si sovrappongono affatto, e quello che la seconda aggiunge è tutta roba nuova. Poi la terza, perpendicolare alle prime due, e così via. (Di direzioni perpendicolari alla prima ce ne sono infinite: la seconda componente è quella, fra tutte, lungo cui i punti restano più dispersi.)
C’è un caso in cui la domanda non ha una risposta sola: uno stormo a palla, sparpagliato uguale in tutte le direzioni. Lì nessuna direzione batte le altre, e una coppia di direzioni perpendicolari vale quanto un’altra.
Se le prime due o tre direzioni catturano quasi tutta la dispersione, possiamo buttare le altre e rappresentare ogni dato con due o tre numeri soltanto, quasi senza perdite.
La «dispersione» è la varianza, la stessa parola usata parlando del compromesso bias-varianza. Ma non indica la stessa cosa, e tenere separati i due usi evita un equivoco. Là la varianza era l’irrequietezza di un modello: quanto cambiano le sue risposte se lo riaddestriamo su un campione diverso. Qui è una proprietà dei dati, e non c’è nessun modello in giro: quanto sono sparpagliati i punti lungo una direzione. Stessa parola perché il conto che si fa è lo stesso (quanto le cose si scostano dalla loro media).
Sia \(\mathbf{X} \in \mathbb{R}^{m \times d}\) la matrice dei dati, con le feature già centrate (media di colonna nulla) e, di norma, standardizzate (varianza unitaria, così che una feature misurata in metri non domini una misurata in chilometri). La dispersione dei dati è riassunta dalla matrice di covarianza
dove \(C_{jl}\) è la covarianza tra la feature \(j\) e la feature \(l\). La PCA cerca il versore \(\mathbf{u}\) che massimizza la varianza dei dati proiettati, \(\operatorname{Var}(\mathbf{X}\mathbf{u}) = \mathbf{u}^{\top}\mathbf{C}\,\mathbf{u}\), con il vincolo \(\lVert \mathbf{u} \rVert = 1\). Con i moltiplicatori di Lagrange il problema diventa
cioè le direzioni cercate sono gli autovettori di \(\mathbf{C}\), e la varianza catturata da ciascuna è il corrispondente autovalore \(\lambda\). Ordinando gli autovalori \(\lambda_1 \ge \lambda_2 \ge \dots \ge \lambda_d \ge 0\), la prima componente principale è l’autovettore di \(\lambda_1\), la seconda quello di \(\lambda_2\), e così via; e si possono sempre scegliere ortogonali fra loro, perché \(\mathbf{C}\) è simmetrica (con autovalori distinti lo sono per forza; se un autovalore è ripetuto, il teorema spettrale garantisce che una base ortonormale del suo autospazio esiste, ed è quella che ogni implementazione restituisce). Ogni \(\mathbf{u}_j\) relativo a un autovalore semplice resta però definito a meno del segno, perché \(-\mathbf{u}_j\) ha lo stesso autovalore: due implementazioni possono restituire la stessa componente ribaltata, e con lei tutte le proiezioni su quell’asse. Proiettare su \(\mathbf{u}_1, \dots, \mathbf{u}_q\) (con \(q \ll d\)) dà la rappresentazione ridotta \(\mathbf{Z} = \mathbf{X}\,\mathbf{U}_q\), dove \(\mathbf{U}_q\) raccoglie i primi \(q\) autovettori in colonna. Tornare indietro costa una moltiplicazione, \(\hat{\mathbf{X}} = \mathbf{Z}\,\mathbf{U}_q^{\!\top}\), e l’errore medio di ricostruzione è la somma degli autovalori scartati, \(\tfrac{1}{m}\lVert\mathbf{X} - \hat{\mathbf{X}}\rVert_F^2 = \sum_{j>q}\lambda_j\). Massimizzare la varianza proiettata (la domanda di Hotelling) e minimizzare l’errore di ricostruzione (quella di Pearson) danno quindi le stesse direzioni, e per il teorema di Eckart e Young nessun’altra approssimazione di rango \(q\) fa meglio. In pratica la matrice di covarianza non si forma: si calcola la decomposizione a valori singolari \(\mathbf{X} = \mathbf{P}\,\mathbf{S}\,\mathbf{U}^{\!\top}\), in cui le colonne di \(\mathbf{U}\) sono proprio gli \(\mathbf{u}_j\) e \(\lambda_j = s_j^2/m\), al costo di \(O(m\,d\,\min(m,d))\), o molto meno con le versioni randomizzate quando servono poche componenti.
Lo stesso meccanismo si vede su un esempio minuscolo: quattro punti in due dimensioni, da proiettare su una sola.
Disegna quattro punti su un foglio a quadretti: \((2,2)\) e \((-2,-2)\) sulla diagonale che sale, \((1,-1)\) e \((-1,1)\) su quella che scende. Lo «stormo» è chiaramente più allungato lungo la diagonale che sale: i due punti che ci stanno sopra sono i più lontani dal centro.
Misurare la dispersione lungo una direzione vuol dire fare l’ombra di ogni punto su quella direzione (come nel corridoio delle SVM) e guardare quanto le quattro ombre si allontanano dal centro. Attenzione: non la distanza del punto dal centro, la distanza della sua ombra.
Cominciamo dalla diagonale che sale. I due punti che ci stanno sopra, \((2,2)\) e \((-2,-2)\), hanno l’ombra su sé stessi, e distano dal centro \(\sqrt{2^2+2^2} = \sqrt{8}\) per Pitagora. Gli altri due, \((1,-1)\) e \((-1,1)\), stanno di traverso a quella diagonale, e la loro ombra cade esattamente al centro: la loro ombra dista \(0\), anche se il punto è lontano. La dispersione è la media dei quadrati di quelle quattro distanze, e vale \((8 + 0 + 8 + 0)/4 = 4\). (Si contano i quadrati, come per la retta di best fit: le posizioni delle ombre prese con il segno, da una parte e dall’altra del centro, si cancellerebbero; e con i quadrati le direzioni perpendicolari si sommano, per Pitagora.)
Lungo la diagonale che scende succede l’esatto contrario. Adesso sono \((1,-1)\) e \((-1,1)\) a starci sopra, con distanza \(\sqrt{1^2+1^2} = \sqrt2\), e \((2,2)\) e \((-2,-2)\) a cadere sul centro: \((0+2+0+2)/4 = 1\).
Le due direzioni sono perpendicolari, quindi per Pitagora il quadrato della distanza di ogni punto dal centro è la somma dei quadrati delle sue due ombre, e la dispersione totale è la somma delle due: \(4 + 1 = 5\). Lo conferma il conto diretto con le distanze dei quattro punti dal centro, \((8 + 2 + 8 + 2)/4 = 5\). La prima direzione, da sola, ne cattura \(4\): l’\(80\%\).
Proiettare significa allora tenere solo le ombre sulla diagonale che sale, e buttare via il resto. Ogni punto diventa un numero solo: \((2,2)\) diventa \(+2{,}83\) (cioè \(\sqrt8\)), \((-2,-2)\) diventa \(-2{,}83\), e gli altri due diventano entrambi \(0\). Quei due, che sul foglio erano distinti, ora sono indistinguibili: è il \(20\%\) che abbiamo deciso di perdere per passare da due numeri a uno.
Prendiamo quattro punti già centrati (media nulla), così da saltare la sottrazione della media:
La matrice di covarianza, dividendo per \(m = 4\), ha elementi
quindi
Gli autovalori risolvono \(\det(\mathbf{C} - \lambda \mathbf{I}) = 0\), cioè \((2{,}5-\lambda)^2 - 1{,}5^2 = 0\), da cui \(2{,}5 - \lambda = \pm 1{,}5\) e
La loro somma è la traccia di \(\mathbf{C}\), \(2{,}5 + 2{,}5 = 5\): la dispersione totale si ripartisce fra le due direzioni, senza perdite e senza doppi conteggi. Gli autovettori corrispondenti sono \(\mathbf{u}_1 = \tfrac{1}{\sqrt2}(1, 1)\) (la diagonale che sale) e \(\mathbf{u}_2 = \tfrac{1}{\sqrt2}(1, -1)\). La varianza spiegata dalla prima componente è
l’80%: proiettando su \(\mathbf{u}_1\) soltanto, buttiamo via una dimensione ma conserviamo i quattro quinti della dispersione. La proiezione di ogni punto è il prodotto scalare con \(\mathbf{u}_1\):
I due punti «fuori diagonale» collassano a \(0\) (stavano interamente lungo la direzione scartata \(\mathbf{u}_2\)), mentre i due «in diagonale» conservano tutta la loro distanza.
La Fig. 4.34 mostra la stessa idea su una nuvola più fitta: l’asse lungo è la prima componente, quello corto la seconda, e proiettare significa lasciar cadere ogni punto perpendicolarmente sull’asse lungo.

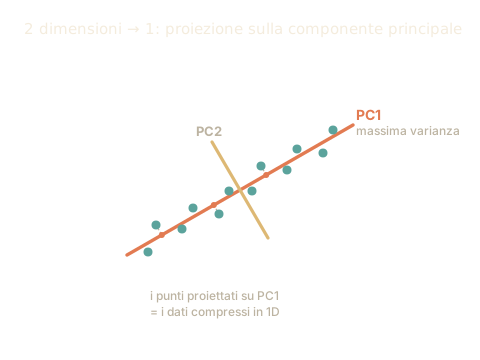
Fig. 4.34 La prima componente principale (PC1) segue la direzione di massima varianza; la seconda (PC2), ortogonale, ne raccoglie molta meno. Proiettare i punti su PC1 comprime i dati da due dimensioni a una, perdendo poco.#
In concreto, la PCA serve a comprimere i dati (meno numeri da salvare e da passare ai modelli); a visualizzare in due o tre dimensioni dataset con centinaia di feature; a ripulirli dal rumore (denoising), se il segnale ha varianza maggiore del rumore: proiettando sulle prime componenti si scarta il rumore che cade nelle altre, ma quello che cade nelle prime resta, perché la PCA non lo distingue dal segnale. Il limite di fondo è che la PCA è lineare: ruota e proietta lungo assi dritti. Se i dati stanno vicino a una superficie curva di dimensione più bassa, una varietà (l’esempio classico è lo Swiss roll, un foglio avvolto a spirale in tre dimensioni, come un rotolo di pasta), la proiezione sovrappone punti che sulla superficie sono lontani. Per questi casi servono metodi non lineari: t-SNE e UMAP per la visualizzazione, il kernel PCA [ScholkopfSMuller98] e Isomap [TdSL00] per la riduzione, e gli autoencoder, che Comprimere e ricostruire mostra coincidere con la PCA quando sono lineari.
ICA: separare le voci che si sono mescolate#
La PCA ha un secondo limite, che con la curvatura non ha niente a che fare. Cerca le direzioni in cui i dati variano di più, e le coordinate dei punti lungo quelle direzioni sono incorrelate: quando una sale, l’altra non tende né a salire né a scendere. Ma incorrelato non vuol dire indipendente: un numero preso a caso fra \(-1\) e \(1\) e il suo quadrato sono incorrelati, eppure conoscere il primo dice tutto del secondo. Sono incorrelati perché un numero e il suo opposto hanno lo stesso quadrato: mentre il numero sale da \(-1\) a \(1\), il quadrato prima scende e poi risale, e nel complesso non tende a salire con lui né a scendere. E quando i dati nascono mescolando segnali indipendenti fra loro, le sorgenti, la PCA restituisce altre miscele. Colin Cherry chiamò problema del cocktail party la capacità di isolare la voce di una persona mentre altre parlano insieme [Che53]; nella versione per le macchine due persone parlano nella stessa stanza, due microfoni in punti diversi registrano ciascuno un miscuglio delle due voci, e si vogliono riavere le voci separate senza sapere come i microfoni le hanno mescolate. L’analisi delle componenti indipendenti (Independent Component Analysis, ICA) risolve questo problema sotto ipotesi precise. È nata a metà degli anni Ottanta con la separazione cieca delle sorgenti di Hérault, Jutten e Ans, pubblicata per esteso da Jutten e Hérault [JHerault91], e l’ha messa in forma Comon [Com94].
Due microfoni in una stanza, e ognuno sente le due voci insieme, in proporzioni diverse. Anna e Bruno parlano allo stesso volume; il primo microfono sente Anna intera e metà di Bruno, il secondo metà di Anna e Bruno intero. Al mixer puoi alzare o abbassare ciascuna registrazione e sommarle, anche col segno meno, e la combinazione giusta cancella una voce. Il primo meno metà del secondo fa (Anna più metà di Bruno) meno (un quarto di Anna più metà di Bruno), cioè tre quarti di Anna e niente Bruno. Ma quanto ogni microfono sente dell’altra voce (qui la metà) nessuno te lo dice. La PCA sceglie la combinazione in cui il suono è più forte, cioè più sparpagliato, che qui è la somma dei due microfoni: una volta e mezza Anna più una volta e mezza Bruno, un altro miscuglio.
Per riconoscere una voce sola, l’ICA prende in prestito i dadi del teorema del limite centrale, dove si conta quante volte esce ogni totale. Un dado dà una forma piatta, la somma di due dadi un triangolo (il 7 esce sei volte più spesso del 2), quella di dieci già una campana. Sommare cose indipendenti, di norma, porta verso la campana, che è anche la forma del rumore di fondo, somma di mille piccoli suoni. Con una registrazione si fa lo stesso conto: è una linea che sale e scende attorno allo zero, come in un messaggio vocale, e si conta quante volte sta a ciascun livello, senza guardare in che ordine ci arriva. Una voce sta quasi sempre vicino allo zero, nelle pause, e ogni tanto schizza lontano, nei picchi: il disegno è una punta stretta con le code lunghe. Dalla campana ci si può allontanare anche dall’altra parte: un fischio che oscilla regolare, o un segnale che salta fra due soli valori, sta più spesso vicino ai suoi due estremi che vicino allo zero, e il suo disegno è largo e senza punta, con il grosso del conto ai due bordi. Da una parte o dall’altra, due segnali mescolati somigliano già di più alla campana. Allora, fra tutte le combinazioni del mixer, si cerca quella che le somiglia di meno, ed è quella in cui è rimasta una voce sola.
La ricerca si fa in due tempi. Nel primo la PCA prende la somma e la differenza dei due microfoni, che non salgono e scendono insieme, e le porta allo stesso volume. Con i numeri di prima:
Anna |
Bruno |
|
|---|---|---|
primo microfono |
\(1\) |
\(0{,}5\) |
secondo microfono |
\(0{,}5\) |
\(1\) |
somma |
\(1{,}5\) |
\(1{,}5\) |
differenza |
\(0{,}5\) |
\(-0{,}5\) |
e dividendo la somma per \(1{,}5\) e la differenza per \(0{,}5\) restano Anna più Bruno e Anna meno Bruno, allo stesso volume. Nel secondo tempo, sul mixer resta una manopola sola, quella che dice in che proporzione mescolare queste due: girata tutta da una parte dà la prima, tutta dall’altra la seconda, e a metà corsa le due insieme fanno due volte Anna. L’ICA gira la manopola finché la forma è la più lontana dalla campana.
Lo stesso conto dice che cosa l’ICA non può sapere. Esce due volte Anna, e non Anna, perché chi parla forte lontano dal microfono e chi parla piano da vicino lasciano la stessa registrazione. Girando ancora, la differenza meno la somma fa meno due volte Bruno, cioè Bruno capovolto, che scende dove saliva e all’orecchio suona identico. E quale voce sia la prima nessuno lo dice.
Il trucco si rompe in tre casi. Se le voci fossero due soffi di rumore a forma di campana, a ogni posizione della manopola uscirebbe la stessa campana, e l’ICA ne sceglierebbe una a caso. Se nella stanza entra Carla e i microfoni restano due, una combinazione cancella una voce sola: con due microfoni e tre voci ne restano due mescolate. E il conto suppone che ogni microfono senta le voci nello stesso istante; nella stanza vera il suono arriva un po” prima al microfono più vicino, con l’eco ogni microfono sente anche le voci di un attimo prima, e allora il miscuglio non è più una semplice somma.
Il modello è \(\mathbf{x} = \mathbf{A}\mathbf{s}\): \(n\) sorgenti \(\mathbf{s} \in \mathbb{R}^n\) a componenti indipendenti, altrettanti sensori, e \(\mathbf{A}\) quadrata e invertibile, la matrice di miscelazione. Gli \(m\) campioni di \(\mathbf{x}\) si trattano come estrazioni indipendenti: l’ordine nel tempo non conta, e di ogni sorgente conta soltanto la distribuzione dei valori. Con più sensori che sorgenti basta che \(\mathbf{A}\) abbia rango pieno di colonna, e la PCA riduce prima a \(n\) dimensioni; con meno sensori che sorgenti nessuna matrice le ricostruisce tutte. Comon ha dimostrato che, se al più una delle componenti di \(\mathbf{s}\) è gaussiana, \(\mathbf{A}\) è identificabile a meno di una permutazione e di una scala delle sue colonne [Com94]: ordine, ampiezza e segno delle sorgenti restano indeterminati, il resto no.
Il primo passo è lo sbiancamento, la PCA con le componenti riscalate a varianza unitaria: \(\mathbf{z} = \boldsymbol{\Lambda}^{-1/2}\mathbf{U}^\top(\mathbf{x} - \boldsymbol{\mu})\), con \(\boldsymbol{\mu} = \mathbb{E}[\mathbf{x}]\) e \(\mathbf{U}\boldsymbol{\Lambda}\mathbf{U}^\top\) la decomposizione della covarianza. Dopo, \(\mathbb{E}[\mathbf{z}\mathbf{z}^\top] = \mathbf{I}\), e se le sorgenti hanno varianza unitaria (lo si può sempre supporre, perché la loro scala è comunque indeterminata e finisce nelle colonne di \(\mathbf{A}\)) la miscela residua \(\mathbf{z} = \tilde{\mathbf{A}}\mathbf{s}\) ha \(\tilde{\mathbf{A}}\tilde{\mathbf{A}}^\top = \mathbf{I}\): resta da trovare una rotazione, cioè \(n(n-1)/2\) angoli invece degli \(n^2\) numeri di una matrice qualunque (le riflessioni le assorbe l’indeterminazione di segno). È qui che la gaussiana fa eccezione: una gaussiana sbiancata è isotropa, ogni rotazione la lascia identica, e nessun criterio che guardi la distribuzione dei valori può sceglierne una. Con una sola sorgente gaussiana la rotazione è fissata lo stesso, dalle altre \(n-1\) direzioni per ortogonalità; con due o più resta libera la rotazione nel loro sottospazio. Se invece le sorgenti hanno spettri diversi, l’ordine nel tempo basta a separarle anche gaussiane, con le sole covarianze a ritardo [BAMCM97]: è un altro modello, che l’ICA non usa.
La rotazione si trova massimizzando la non gaussianità delle proiezioni \(y = \mathbf{w}^\top\mathbf{z}\) con \(\|\mathbf{w}\| = 1\), che hanno media nulla e varianza unitaria. L’intuizione viene dal teorema del limite centrale: una combinazione di sorgenti indipendenti è di solito più vicina a una gaussiana delle sorgenti che mescola [HyvarinenO00]. Le misure usuali sono il valore assoluto (o il quadrato) della curtosi, \(|\mathbb{E}[y^4] - 3|\), perché una sorgente può stare dall’una o dall’altra parte della gaussiana (una sinusoide ha curtosi \(-1{,}5\), un segnale che salta fra \(\pm 1\) ha \(-2\), una laplaciana \(+3\)), e la negentropia \(J(y) = h(y_{\mathcal{N}}) - h(y)\), dove \(h\) è l’entropia differenziale e \(y_{\mathcal{N}}\) una gaussiana con la stessa varianza di \(y\). La negentropia è la divergenza KL fra \(y\) e quella gaussiana, quindi mai negativa e nulla solo per la gaussiana, e rende esatta l’intuizione. Per la disuguaglianza della potenza entropica, se \(y = \sum_i q_i s_i\) con \(\sum_i q_i^2 = 1\), vale \(J(y) \le \sum_i q_i^2 J(s_i) \le \max_i J(s_i)\): una miscela non supera mai la sorgente più lontana dalla gaussiana, e può invece superare una sorgente quasi gaussiana, che è la ragione del «di solito». In pratica la negentropia si approssima, a meno di una costante positiva, con \(\big(\mathbb{E}[G(y)] - \mathbb{E}[G(y_{\mathcal{N}})]\big)^2\) e \(G(u) = \log\cosh u\), che cresce più piano della quarta potenza e risente meno di una manciata di campioni nelle code. L’algoritmo FastICA aggiorna
con \(g = G'\) (qui \(g = \tanh\)), e per più componenti decorrela i vettori fra un passo e l’altro. È un passo di Newton approssimato sulla condizione di ottimo vincolato \(\mathbb{E}[\mathbf{z}\,g(\mathbf{w}^\top\mathbf{z})] = \beta\,\mathbf{w}\), in cui lo jacobiano \(\mathbb{E}[\mathbf{z}\mathbf{z}^\top g'(\mathbf{w}^\top\mathbf{z})]\) si approssima con \(\mathbb{E}[g'(\mathbf{w}^\top\mathbf{z})]\,\mathbf{I}\) perché i dati sono sbiancati; sotto il modello converge in modo cubico, o almeno quadratico [HyvarinenO00], e ogni passo costa \(O(mn)\) per componente. Lo stesso problema scritto come massima verosimiglianza, o come massimo passaggio di informazione in una rete (l’infomax di Bell e Sejnowski [BS95]), porta alla stessa famiglia di soluzioni, a una condizione: la non linearità della rete dev’essere la funzione di ripartizione della densità supposta per le sorgenti, e basta indovinarne il tipo, sub o super gaussiano. La sigmoide logistica di Bell e Sejnowski le suppone super gaussiane, e su una sinusoide e un’onda quadra, che sono sub gaussiane, la separazione fallisce; la ripara l’infomax esteso di Lee, Girolami e Sejnowski, che stima il tipo di ciascuna sorgente [LGS99]. Il modello chiede miscele istantanee: con ritardi ed eco la miscela diventa una convoluzione, e servono varianti convolutive.
Il blocco mescola due segnali, uno che oscilla e uno che salta fra due valori, come farebbero due microfoni, e misura quanto la PCA e l’ICA li ritrovano con la correlazione, in valore assoluto, fra ogni voce vera e la stima che le somiglia di più: \(1\) vuol dire ritrovata, a meno di volume e segno. Poi ripete venti volte la separazione con voci diverse, e venti volte con due voci gaussiane, cioè due soffi di rumore a forma di campana.
import warnings
import numpy as np
from sklearn.decomposition import PCA, FastICA

A = np.array([[1.0, 0.6],                      # come i due microfoni
              [0.5, 1.0]])                     # mescolano le due voci
t = np.linspace(0, 8, 2000)

def voci_e_microfoni(rng, gaussiane=False):
    if gaussiane:
        voci = rng.standard_normal((2000, 2))
    else:
        voci = np.column_stack([                   # una voce che oscilla
            np.sin(3 * t + rng.uniform(0, 6)),     # e una che salta fra
            np.sign(np.sin(5 * t + rng.uniform(0, 6)))])        # due valori
    return voci, voci @ A.T + 0.02 * rng.standard_normal((2000, 2))

def somiglianza(stime, voci):
    """Per ogni voce vera, la correlazione (in valore assoluto) con la stima che
    le somiglia di più: 1 vuol dire ritrovata, a meno di scala e segno."""
    return np.abs(np.corrcoef(stime.T, voci.T)[:2, 2:]).max(axis=0)

def ica(x, seme):
    with warnings.catch_warnings():            # sui dati gaussiani FastICA
        warnings.simplefilter("ignore")        # a volte non converge
        return FastICA(2, whiten="unit-variance", algorithm="parallel",
                       random_state=seme).fit_transform(x)

voci, microfoni = voci_e_microfoni(np.random.default_rng(0))
print("PCA:", np.round(somiglianza(PCA(2).fit_transform(microfoni), voci), 2))
print("ICA:", np.round(somiglianza(ica(microfoni, 0), voci), 2))

for gaussiane in (False, True):
    peggiore = []
    for k in range(20):                        # venti miscele diverse
        voci, microfoni = voci_e_microfoni(np.random.default_rng(k), gaussiane)
        peggiore.append(somiglianza(ica(microfoni, k), voci).min())
    nome = "voci gaussiane" if gaussiane else "voci non gaussiane"
    print(f"{nome}: separate tutte e venti? {min(peggiore) > 0.98};",
          f"la peggiore: {min(peggiore):.2f}")
PCA: [0.81 0.85]
ICA: [1. 1.]
voci non gaussiane: separate tutte e venti? True; la peggiore: 1.00
voci gaussiane: separate tutte e venti? False; la peggiore: 0.72
La PCA restituisce due miscugli, con una correlazione di 0,81 e 0,85 con le voci vere; l’ICA le ritrova intere in tutte e venti le miscele. Con due voci gaussiane, invece, la peggiore delle venti scende a 0,72. Il valore più basso che quella misura può dare è \(1/\sqrt{2} \approx 0{,}71\), ed è quello di stime ruotate di 45°, che prendono le due voci in parti uguali: 0,72 è a un passo da lì. L’algoritmo si ferma su una rotazione qualunque, perché non ce n’è una migliore delle altre.
Resta il limite da cui si era partiti. PCA e ICA sanno soltanto ruotare, riscalare e proiettare: se la struttura interessante dei dati è curva, nessuna delle due la stende.
t-SNE e UMAP: vedere in due dimensioni ciò che vive in mille#
Quando lo scopo è guardare dati ad alta dimensione (non passarli a un altro modello, ma disegnarli su uno schermo), la PCA può non bastare: una proiezione lineare in due dimensioni sovrappone punti che in origine sono lontani. t-SNE (t-distributed Stochastic Neighbor Embedding, van der Maaten e Hinton, 2008) [vdMH08] e UMAP (Uniform Manifold Approximation and Projection, McInnes, Healy e Melville, 2018) [MHM18] sono trasformazioni non lineari pensate per la visualizzazione: scelgono la posizione dei punti nel piano in modo da conservare i vicinati, non le distanze.

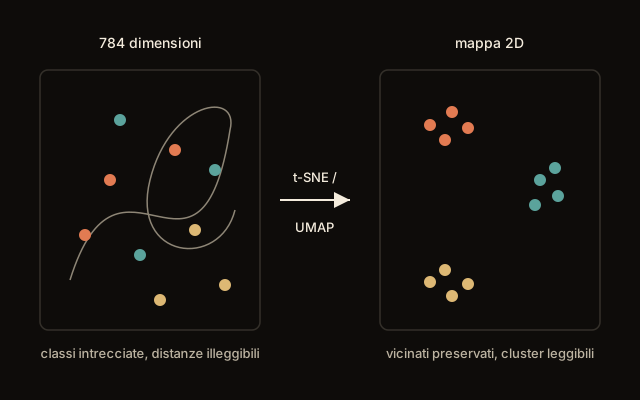
Fig. 4.35 Da un groviglio a una mappa. Ciò che queste tecniche promettono di conservare sono i vicinati, cioè chi sta vicino a chi, non le distanze assolute né la posizione dei gruppi fra loro.#
La promessa di Fig. 4.35 è limitata, e il limite è anche l’avvertenza d’uso: sulla mappa la grandezza di un gruppo e la distanza fra due gruppi non sono misure.
Su un foglio, la mappa delle amicizie di una scuola non si disegna con il righello. Non ti interessa la distanza reale tra le case: ti interessa che chi è amico finisca vicino sul foglio, e chi non si conosce finisca lontano. t-SNE e UMAP fanno questo con i dati: prendono punti che vivono in uno spazio con tante dimensioni e li dispongono in due, cercando di mettere accanto i punti che erano vicini in origine. Il risultato sono mappe bellissime, dove categorie diverse (cifre scritte a mano, tipi di cellule, generi musicali) si separano in isole ben distinte.
Chi sia «amico» non lo decide una soglia uguale per tutti: c’è il ragazzino che frequenta trenta persone e quello che ne frequenta tre. Si stabilisce in partenza quanti compagni stretti contare, all’incirca, e attorno a ciascuno si allarga o si stringe il cerchio finché ne stanno dentro quel tanto. Poi si mettono d’accordo le due versioni: se lui la considera un’amica e lei lo considera un conoscente, sul foglio finisce una via di mezzo fra le due.
Il foglio, poi, è piccolo, e tutte le distanze insieme non possono tornare. Pretendere che anche le lontananze siano fedeli vorrebbe dire stringere tutti verso il centro, e gli amici finirebbero ammucchiati. Con i lontani, invece, si può essere di manica larga: basta che stiano lontani, quanto esattamente non importa. Anche gli sbagli, del resto, non pesano uguale: separare due amici costa carissimo e il disegno lo evita in ogni modo, mentre mettere due sconosciuti un po’ più in qua o un po’ più in là non costa quasi niente, e il disegno li sistema come gli torna comodo.
Ma qui serve un’avvertenza onesta, perché è la causa di molti errori. Su queste mappe non fidarti delle distanze grandi: due isole lontane sul foglio non sono necessariamente più diverse di due isole vicine, l’algoritmo non lo garantisce. E non fidarti della grandezza delle isole né di quanto sono fitte: un gruppo disegnato grande e sparso può in realtà essere compatto quanto uno disegnato piccolo. Sono strumenti per vedere se esistono dei gruppi, non per misurare quanto distano o quanto sono grandi. Ottimi per l’occhio, pessimi per il righello.
t-SNE modella le vicinanze come probabilità. Nello spazio originale la somiglianza tra i punti \(i\) e \(j\) è una gaussiana sulla loro distanza, \(p_{j\mid i} \propto \exp(-\lVert \mathbf{x}_i - \mathbf{x}_j\rVert^2 / 2\sigma_i^2)\), con \(\sigma_i\) tarato localmente da un iperparametro, la perplexity: \(\sigma_i\) si cerca per bisezione finché \(2^{H(P_i)}\), con \(H(P_i)\) l’entropia in bit della distribuzione \(p_{\cdot\mid i}\) dei vicini di \(i\), vale la perplexity scelta, che fa quindi da numero efficace di vicini. Queste condizionate non sono simmetriche (\(p_{j\mid i} \neq p_{i\mid j}\), perché \(\sigma_i\) e \(\sigma_j\) differiscono) e vengono simmetrizzate in una congiunta, \(p_{ij} = (p_{j\mid i} + p_{i\mid j})/2m\), dove \(m\) è il numero di esempi. Quella simmetrizzazione, da sola, dà il symmetric SNE, cioè una variante del SNE originale di Hinton e Roweis; la \(t\) del nome viene dopo, ed è la vera differenza: nello spazio ridotto, al posto di un’altra gaussiana, t-SNE usa una \(t\) di Student a un grado di libertà (con code pesanti, che evitano l’affollamento al centro), \(q_{ij} \propto (1 + \lVert \mathbf{z}_i - \mathbf{z}_j\rVert^2)^{-1}\), e dispone i punti \(\mathbf{z}_i\) minimizzando la divergenza di Kullback–Leibler \(\mathrm{KL}(P \Vert Q)\) tra le due distribuzioni congiunte. Poiché la KL pesa molto le vicinanze e poco le lontananze, t-SNE preserva la struttura locale ma distorce quella globale: distanze tra cluster, densità e dimensioni apparenti sui grafici non sono quantitativamente affidabili. Il calcolo esatto costa \(O(m^2)\) per iterazione; scikit-learn usa di default l’approssimazione di Barnes e Hut, che scende a \(O(m\log m)\).
UMAP parte da fondamenta diverse (una costruzione su grafi e topologia) ma
persegue un obiettivo simile; in pratica è più veloce, scala meglio a
milioni di punti e tende a preservare meglio la struttura globale. Su
quest’ultimo punto vale però una precisazione che ridimensiona il confronto:
Kobak e Linderman [KL21] hanno mostrato che il divario
si annulla inizializzando t-SNE con la PCA invece che a caso, ed è quindi
l’inizializzazione, più dell’algoritmo, a decidere quanto sopravvive della
struttura globale. In scikit-learn init="pca" è il default dalla versione
1.2, quindi il rimedio è già acceso. Resta comunque lo stesso
monito per entrambi: sono strumenti di visualizzazione, non di
analisi metrica. Entrambi vanno usati per esplorare, mai per concludere che
«questo gruppo è il doppio più lontano di quell’altro».
Quando usarli, e quando no
Sì: guardare se un mucchio di dati ha una struttura a gruppi prima di metterci un modello; guardare le rappresentazioni interne di una rete neurale, cioè gli elenchi di numeri con cui la rete descrive ogni esempio dentro di sé (si chiamano embedding), per capire cosa ha imparato; presentare a un pubblico la forma di dati che nessuno può visualizzare, come le immagini di cifre scritte a mano di \(28 \times 28\) pixel: sono \(784\) pixel per immagine, e quindi \(784\) colonne, cioè \(784\) dimensioni.
No: come passaggio preparatorio prima di un classificatore. Per quello serve la PCA, per due ragioni. Si applica a dati nuovi ripetendo la stessa identica trasformazione, una proiezione lineare; t-SNE non ha una trasformazione da applicare (i punti nuovi chiedono un nuovo calcolo su tutto l’insieme, che restituirebbe un’altra mappa), e UMAP ne ha una approssimata, che colloca i punti nuovi in una mappa già fissata. E la PCA sa anche tornare indietro, ricostruendo i dati di partenza dalle poche direzioni tenute: una ricostruzione approssimata, perché quello che si è buttato via è perso (nell’esempio dei quattro punti era il \(20\%\)), ma nella stessa forma di prima e con un errore che si conosce in anticipo, la varianza delle direzioni scartate. In t-SNE l’inversa non c’è, in UMAP è approssimata.
Mai: fare clustering sulle coordinate 2D prodotte da t-SNE. I gruppi che vedi possono essere prodotti dalla proiezione stessa, e la loro separazione apparente non corrisponde a una separazione reale. Il clustering si fa nello spazio originale; la mappa serve solo a guardarne il risultato.
Clustering con k-means: assegna, ricalcola, ripeti#
Cambiamo domanda. Non più «come comprimo i dati» ma «ci sono gruppi naturali là dentro». Il clustering cerca di dividere gli esempi in famiglie di simili (clienti simili, documenti sullo stesso tema, pixel dello stesso oggetto) senza che nessuno abbia mai detto quali famiglie esistano. È il gemello non supervisionato della classificazione: anche qui, alla fine, ogni esempio esce con un’etichetta attaccata; ma nella classificazione le etichette gliele avevamo insegnate noi, e qui invece se le inventa l’algoritmo, che può solo dire «questo sta con quest’altro», non come si chiami il gruppo.
Il metodo più celebre è k-means, il cui algoritmo, che ripete due mosse finché nulla cambia, è dovuto a Stuart Lloyd (formulato ai Bell Labs nel 1957, pubblicato nel 1982) [Llo82]; il nome «\(k\)-means» compare in James MacQueen nel 1967 [Mac67].
Il centroide di un gruppo è la media dei suoi punti, coordinata per coordinata: in generale un punto dello spazio che non coincide con nessun dato. Nei disegni si segna con una x.

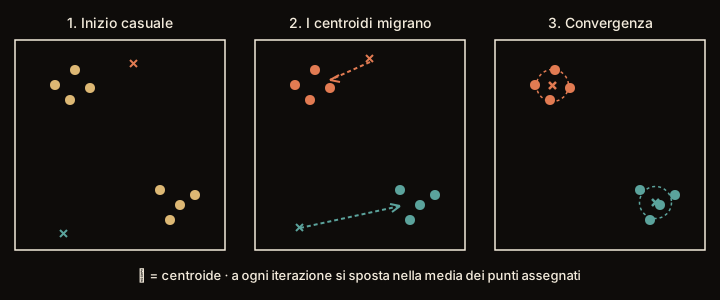
Fig. 4.36 Le due mosse di k-means, ripetute. Ogni punto va al centroide più vicino, poi ogni centroide va nel mezzo dei punti che gli sono toccati: da un inizio a caso si arriva ai gruppi in poche iterazioni.#
Il primo pannello di Fig. 4.36 mostra dove sta la fragilità dell’algoritmo: le due x di partenza sono scelte a caso, e partenze diverse possono portare a gruppi diversi.
Devi sistemare un mucchio di persone sparse in un parco attorno a due punti di ritrovo, in modo che ciascuno vada al ritrovo più vicino. Ma non sai ancora dove mettere i due punti di ritrovo. k-means risolve il dilemma con un tira-e-molla, ripetuto finché tutto si stabilizza:
Piazza a caso i due punti di ritrovo (il numero di ritrovi si chiama \(k\), e qui vale due).
Assegna ogni persona al ritrovo più vicino: si formano due gruppi.
Sposta ogni ritrovo esattamente al centro del suo gruppo (la media delle posizioni).
Ricomincia dall’assegnazione. Con i ritrovi spostati, qualcuno cambierà gruppo; si ricalcolano i centri; e si continua.
Perché il tira-e-molla finisca, e non giri all’infinito, c’è una ragione precisa. Tieni il conto della scomodità: per ogni persona la distanza dal suo ritrovo moltiplicata per sé stessa, e poi tutte sommate; così una persona lasciata lontanissima conta più di dieci lasciate un po’ scomode. L’assegnazione non può farlo salire: ognuno passa al ritrovo più vicino, quindi cammina meno di prima, o uguale. Nemmeno lo spostamento lo fa salire, perché fra tutti i punti in cui potresti piantare un ritrovo quello che rende minimo il conto del suo gruppo è proprio il centro: il conto da un punto qualsiasi è il conto dal centro più un pezzo in più, che vale il numero di persone del gruppo moltiplicato per il quadrato della distanza dal centro, ed è zero solo nel centro. E ogni volta che qualcuno cambia ritrovo il totale scende davvero, quindi una sistemazione già vista non può tornare; le sistemazioni possibili, per quante siano, sono in numero finito, e prima o poi nessuno cambia più gruppo e i centri si fermano.
Fermarsi, però, non vuol dire aver trovato la sistemazione più comoda che c’era: vuol dire che nessuno guadagna a cambiare ritrovo per conto suo, e che ogni ritrovo sta già in mezzo ai suoi. Un giro, in compenso, costa poco: ogni persona confrontata con ogni ritrovo, e basta, anche quando le persone sono milioni. E il numero di ritrovi, \(k\), lo devi decidere tu in anticipo.
Dato un numero \(k\) di cluster, k-means cerca i centroidi \(\boldsymbol{\mu}_1,
\dots, \boldsymbol{\mu}_k\) e l’assegnazione dei punti che minimizzano
l’inerzia, la somma (non la media) delle distanze quadrate dai rispettivi
centroidi, che in scikit-learn è inertia_:
dove \(c_i \in \{1, \dots, k\}\) è il cluster assegnato al punto \(\mathbf{x}_i\) e \(C_j = \{i : c_i = j\}\) l’insieme dei punti finiti nel cluster \(j\) (niente a che vedere con la matrice di covarianza \(\mathbf{C}\) della PCA: qui la lettera fa un altro mestiere). L’algoritmo di Lloyd minimizza \(\mathcal{L}\) alternando due passi di coordinate:
Ciascun passo non aumenta \(\mathcal{L}\): l’assegnazione per costruzione, l’aggiornamento perché per ogni punto \(\mathbf{p}\) vale \(\sum_{i\in C_j}\lVert\mathbf{x}_i-\mathbf{p}\rVert^2 = \sum_{i\in C_j}\lVert\mathbf{x}_i-\boldsymbol{\mu}_j\rVert^2 + |C_j|\,\lVert\boldsymbol{\mu}_j-\mathbf{p}\rVert^2\), minimo in \(\mathbf{p}=\boldsymbol{\mu}_j\). Le assegnazioni possibili sono in numero finito (al più \(k^m\)) e, se a parità di distanza un punto resta dov’è, nessuna si ripresenta: la procedura si ferma in un numero finito di passi, in un minimo locale che dipende dall’inizializzazione. Il costo è \(O(m\,k\,d)\) per iterazione; le iterazioni sono poche in pratica, ma nel caso peggiore crescono in modo esponenziale con \(m\) anche nel piano [Vat11]. Il minimo globale non si sa trovare in tempo polinomiale: il problema è NP-difficile già con due gruppi, in dimensione arbitraria [ADHP09]. k-means++ ha una garanzia sulla sola inizializzazione: l’inerzia attesa è al più \(8(\ln k+2)\) volte quella ottima [AV07].
Seguiamo una manciata di iterazioni a mano. Sei punti in due dimensioni, \(k = 2\):
Nelle formule il centroide si scrive con la lettera greca mi in grassetto, \(\boldsymbol{\mu}\): in statistica quella lettera indica da sempre una media, e il grassetto ricorda che non è un numero solo, ma un punto con tutte le sue coordinate. Le distanze fra due punti le calcoliamo con Pitagora, come sul foglio a quadretti: differenza delle ascisse e delle ordinate, ciascuna al quadrato, sommate, e radice.
Partiamo (di proposito male) con i centroidi \(\boldsymbol{\mu}_1 = (1,1)\) e \(\boldsymbol{\mu}_2 = (2,1)\), entrambi in mezzo al gruppo di sinistra.
Nella prima assegnazione ogni punto va al centroide più vicino. \(A\) e \(B\) finiscono in \(\boldsymbol{\mu}_1\). \(C\) finisce in \(\boldsymbol{\mu}_2\) perché ci coincide, distanza zero. E anche \(D\), \(E\) ed \(F\), che sono lontanissimi da tutti e due, finiscono in \(\boldsymbol{\mu}_2\): per un soffio, ma ci finiscono. Il conto per \(D(8,8)\), con Pitagora, è \(\sqrt{(8-2)^2+(8-1)^2} = \sqrt{85} \approx 9{,}2\) da \(\boldsymbol{\mu}_2 = (2,1)\), contro \(\sqrt{(8-1)^2+(8-1)^2} = \sqrt{98} \approx 9{,}9\) da \(\boldsymbol{\mu}_1 = (1,1)\); per \(E\) ed \(F\) i due numeri sono \(9{,}9\) contro \(10{,}6\) e \(10{,}0\) contro \(10{,}6\). Gruppi: \(\{A, B\}\) attorno a \(\boldsymbol{\mu}_1\), \(\{C, D, E, F\}\) attorno a \(\boldsymbol{\mu}_2\).
Nel primo aggiornamento ricalcoliamo i centri come media:
Alla seconda assegnazione \(C(2,1)\) dista \(\sqrt{1{,}25} \approx 1{,}12\) da \(\boldsymbol{\mu}_1 = (1;\,1{,}5)\) ma ben \(\approx 7{,}3\) da \(\boldsymbol{\mu}_2 = (6{,}75;\,6{,}5)\): cambia gruppo e passa con \(A\) e \(B\). I punti \(D, E, F\) restano con \(\boldsymbol{\mu}_2\). Adesso i gruppi sono \(\{A, B, C\}\) e \(\{D, E, F\}\): i due gruppi «veri».
Il secondo aggiornamento dà \(\boldsymbol{\mu}_1 = (\tfrac{4}{3}; \tfrac{4}{3}) \approx (1{,}33; 1{,}33)\) e \(\boldsymbol{\mu}_2 = (\tfrac{25}{3}; \tfrac{25}{3}) \approx (8{,}33; 8{,}33)\). Alla terza iterazione nessun punto cambia più gruppo: l’algoritmo è a convergenza. Nota come una partenza sbagliata si sia corretta da sola in due passi (Fig. 4.37): l’unico momento in cui succede qualcosa di non ovvio è quando \(C\) cambia gruppo, e da lì in poi non si muove più niente.

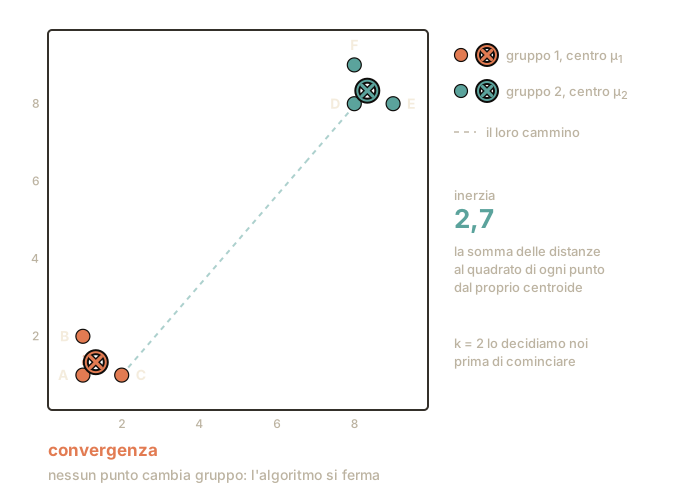
Fig. 4.37 Le due mosse sui sei punti dell’esempio: ogni punto prende il colore del centroide più vicino, poi ogni centroide si sposta nella media dei suoi punti. Al secondo giro \(C\) cambia gruppo, e da lì non si muove più niente.#
Quante famiglie? Scegliere k#
Il tallone d’Achille di k-means è che \(k\) va deciso prima. Due strumenti aiutano a sceglierlo.
Il metodo del gomito (elbow). Provi diversi valori di \(k\) e, per ciascuno, misuri quanto sono «larghe» le famiglie che ne escono: è lo stesso conto della scomodità di poco fa, le distanze dal proprio centro moltiplicate ciascuna per sé stessa e poi sommate. Poi metti quei risultati su un grafico: \(k\) in orizzontale, la larghezza in verticale. La curva scende sempre, perché più centri ci sono e più ognuno è vicino ai suoi, e al limite con un centro per punto la somma è zero; ma a un certo punto smette di scendere ripida e prosegue quasi piatta. Il grafico fa una piega, come un braccio piegato, ed è quello il gomito. Il \(k\) del gomito è di solito una buona scelta: da lì in poi aggiungere gruppi non compra quasi più niente. Il guaio è che la piega la devi riconoscere tu: certe curve scendono lisce, senza nessun angolo, e davanti allo stesso grafico due persone scelgono due \(k\) diversi.
La silhouette (si legge siluèt, e in francese vuol dire «profilo», perché misura quanto un gruppo è ben ritagliato). Per ogni punto si misurano due distanze medie: quanto dista, in media, dai compagni del suo gruppo, e quanto dista, in media, dai membri del gruppo estraneo più vicino. Poi si fa la differenza fra la seconda e la prima e la si divide per la più grande delle due, così il risultato sta sempre fra \(-1\) e \(+1\). Vicino a \(+1\) vuol dire che il punto è molto più vicino ai suoi che agli altri, cioè è ben piazzato; attorno a zero che sta sul confine; negativo che in media è più vicino al gruppo accanto che al proprio, cioè che probabilmente è nel gruppo sbagliato. La media su tutti i punti dice quanto è «pulita» la partizione: si sceglie il \(k\) che la rende più alta. I due grafici si leggono in versi opposti: la larghezza del gomito scende sempre, e si cerca la piega; la silhouette si cerca al massimo.
Il metodo del gomito osserva l’inerzia \(\mathcal{L}(k)\) in funzione di \(k\) e cerca il punto di rendimento decrescente (la curvatura massima), un criterio utile ma soggettivo. La silhouette lo rende quantitativo: per il punto \(i\), detta \(a_i\) la distanza media dai punti del suo cluster e \(b_i\) la distanza media minima verso un altro cluster,
dove \(s_i \to 1\) indica un punto ben separato, \(s_i \approx 0\) un punto al confine, \(s_i < 0\) un punto probabilmente mal assegnato. Il coefficiente medio \(\bar{s}\) si massimizza su \(k\) per una scelta più oggettiva.
I limiti di \(k\)-means non si esauriscono nella scelta di \(k\). L’algoritmo
minimizza distanze quadrate da un centro, e questo gli fa assumere gruppi
compatti, di forma sferica e di dimensione simile: le zone che i centroidi si
spartiscono sono poliedri convessi separati da iperpiani (in due dimensioni, gli
assi dei segmenti che uniscono due centroidi), e le forme allungate o
concentriche vengono tagliate di traverso. L’obiettivo inoltre non è convesso:
l’algoritmo si ferma in un minimo locale, un assetto che nessuna mossa piccola
migliora pur non essendo il migliore possibile, e quale minimo trovi dipende
dall’inizializzazione. Il rimedio standard è k-means++
[AV07], che i centroidi iniziali li sorteggia ancora, ma con
probabilità proporzionale al quadrato della distanza dal centroide già scelto
più vicino, così che partano lontani tra loro: è l’inizializzazione predefinita
di scikit-learn. Il secondo rimedio è ripetere l’algoritmo da più partenze e
tenere la soluzione con la somma delle distanze quadrate più bassa, e va chiesto
esplicitamente (in scikit-learn con n_init), perché con k-means++ il valore
predefinito fa una partenza sola.
DBSCAN: seguire la densità, non i centri#
Quando i gruppi non sono pallini tondi ma serpenti, anelli o spirali, serve un’idea diversa da «un centro e tutto ciò che gli sta attorno». DBSCAN (Ester, Kriegel, Sander e Xu, 1996) [EKSX96] cambia prospettiva: un cluster è una regione densa di punti, e le regioni dense sono separate da zone quasi vuote.
Guarda le luci di una città dall’aereo di notte. Non ti servono dei «centri» per riconoscere i quartieri: li vedi come zone fitte di luci, separate da buio. Un lampione isolato in campagna resta un puntino sperduto. DBSCAN ragiona così. Ha due manopole: un raggio di vicinato (quanto vicini devono stare due punti per dirsi «vicini») e un numero minimo di vicini perché una zona conti come densa. Con queste, parte da un punto in una zona affollata e «cresce» il cluster contagiando i vicini, e i vicini dei vicini, finché la densità regge. Quando i punti si diradano, il cluster finisce. Proprio sull’orlo c’è un caso a metà: il lampione che di vicini ne ha pochi, troppo pochi perché da lui il quartiere continui a crescere, ma che sta a un passo da uno che ne ha tanti. Quello nel quartiere entra lo stesso, e ne segna il bordo.
Due regali rispetto a k-means. Primo: non devi dire quanti gruppi cerchi (li scopre lui, contando le zone dense). Secondo: i punti isolati, quelli in mezzo al buio, non vengono forzati dentro a nessun gruppo: DBSCAN li marca come rumore. E poiché segue la forma della densità, riconosce famiglie di qualunque sagoma: anche due lune intrecciate, dove k-means fallisce miseramente (Fig. 4.39).
Il prezzo si paga tutto sulle manopole. Il raggio lo scegli una volta e vale per l’intera foto: se nello stesso scatto ci sono una metropoli fittissima e un paese di poche case, un valore buono per tutti e due non c’è. Stretto abbastanza da tenere distinti i quartieri della metropoli, il paese non risulta mai abbastanza fitto e finisce tutto nel rumore; largo abbastanza da vedere il paese, la metropoli diventa una macchia sola. Per orientarsi si sceglie prima il numero minimo di vicini, per esempio cinque, e poi si guarda, lampione per lampione, quanto dista il suo quinto vicino. Messe in fila dalla più piccola alla più grande, quelle distanze a un certo punto fanno un salto: lì passa il confine fra il fitto e il rado, ed è lì che conviene mettere il raggio.
DBSCAN è governato da due parametri: il raggio \(\varepsilon\) e la soglia \(\mathrm{minPts}\). Un punto è core se nel suo intorno di raggio \(\varepsilon\) cadono almeno \(\mathrm{minPts}\) punti (sé stesso incluso). Un cluster è un insieme massimale di punti connessi per densità: due punti core appartengono allo stesso cluster se raggiungibili tramite una catena di punti core a distanza \(\le \varepsilon\); i punti non-core nell’intorno di un core sono di bordo e vi si aggregano; tutti gli altri sono rumore, e non appartengono ad alcun cluster. Il numero di cluster \(k\) non è un parametro: emerge dai dati. In compenso la scelta di \(\varepsilon\) è delicata (una regola pratica è ispezionare il grafico delle distanze al \(\mathrm{minPts}\)-esimo vicino, ordinate, e cercarne il gomito), e DBSCAN soffre quando i cluster hanno densità molto diverse tra loro: un \(\varepsilon\) unico non può adattarsi a tutte. La risposta standard è HDBSCAN [CMS13], che considera tutti i raggi insieme, costruisce la gerarchia dei cluster al variare della densità e tiene i più persistenti (in scikit-learn dalla versione 1.3). E un dettaglio rende l’esito dipendente dall’ordine dei dati: un punto di bordo raggiungibile da due cluster finisce in quello visitato per primo.

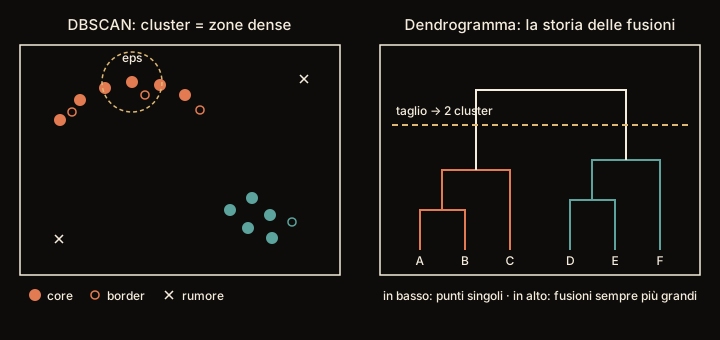
Fig. 4.38 Due modi di non dover dire quanti gruppi cercare. A sinistra DBSCAN: i punti nel folto del gruppo (core), quelli sul bordo (border) e quelli che restano fuori da tutto, il rumore. A destra l’albero di parentele del metodo gerarchico: lì il numero di gruppi lo decide l’altezza a cui si taglia.#
La categoria «rumore» in Fig. 4.38 è la differenza pratica più importante rispetto a k-means. Là ogni punto finisce per forza in un gruppo, anche quello isolato in mezzo al nulla, che trascina il centroide; qui un punto può restare fuori, e i cluster non vengono deformati da chi non c’entra.

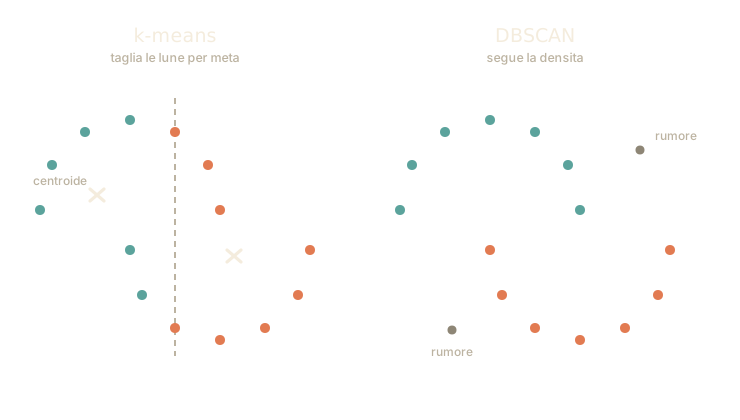
Fig. 4.39 Due lune intrecciate. A sinistra k-means, che cerca cluster sferici attorno a due centroidi, taglia le lune con un confine rettilineo e sbaglia. A destra DBSCAN segue la densità, ricostruisce le due forme curve e isola il rumore.#
Il confronto di Fig. 4.39 non premia un metodo in assoluto: k-means è veloce, regge bene anche milioni di punti e va bene quando i gruppi sono compatti e tondeggianti; DBSCAN brilla su forme irregolari e in presenza di rumore, ma teme le densità disomogenee.
C’è poi un’asimmetria che si sente il giorno dopo, quando il raggruppamento va
usato. k-means lascia in mano i suoi \(k\) centroidi, e un punto che arriva domani
si colloca confrontandolo con quelli; DBSCAN non lascia niente di simile, perché
l’appartenenza dipende da quanti vicini ha il punto, e per contarli servono i
dati di partenza. In scikit-learn la differenza si vede nell’interfaccia:
KMeans ha un metodo predict, DBSCAN ha soltanto fit_predict, e per
collocare un punto nuovo si addestra un classificatore per vicinanza (un \(k\)-NN)
sui soli punti core, quelli nel folto di un gruppo, con l’etichetta che hanno
ricevuto [Geron22].
Una terza via, utile quando si vuole esplorare la struttura a diversi livelli di dettaglio, è il clustering gerarchico: invece di fissare i gruppi in un colpo solo, costruisce un albero di fusioni progressive; si parte da ogni punto come cluster a sé e si fondono via via i più vicini. L’albero risultante si chiama dendrogramma ed è quello di destra in Fig. 4.38: in basso i punti presi uno per uno, e salendo le fusioni via via più grandi. L’altezza a cui due rami si uniscono dice quanto erano distanti i due gruppi al momento di fondersi: le fusioni facili stanno in basso, quelle forzate in alto.
Ecco perché si può «tagliare» l’albero a un’altezza qualunque: tagliare basso vuol dire tenere solo le parentele strette, e i gruppi vengono tanti e piccoli; tagliare alto vuol dire accettare anche le parentele alla lontana, e i gruppi diventano pochi e grandi. Il numero di gruppi si decide così dopo aver visto la struttura, invece che prima, e nessun livello è giusto in assoluto: dipende dalla domanda.
Per fondere due gruppi bisogna dire quanto distano, e quando contengono molti punti la risposta non è unica: la fissa il criterio di collegamento (linkage), e i più usati sono quattro, single, complete, average e Ward.
Il dendrogramma è un albero genealogico letto al contrario: dai singoli individui alle famiglie, ai ceppi, alle popolazioni. Per costruirlo bisogna decidere, a ogni passo, quali due famiglie sono le più vicine, e quando le famiglie contano molte persone la domanda ha più di una risposta. Due comitive in gita: quanto distano fra loro? Dipende da chi guardi.
single («legame singolo»): conta la distanza fra i due membri più vicini, uno per comitiva. Due gruppi sono vicini se anche solo due persone si sfiorano. Segue bene le forme allungate (un serpente di persone resta un serpente), ma soffre di concatenamento: basta una fila di passanti sparsi a fare da ponte perché due comitive lontanissime vengano dichiarate una sola;
complete («legame completo»): conta la distanza fra i due membri più lontani. Due gruppi si fondono solo se stanno stretti tutti quanti: ne escono gruppi compatti e di dimensioni simili, al prezzo di spezzare le forme allungate;
average: la media delle distanze fra tutte le coppie, una persona per comitiva, che è un compromesso fra i due;
Ward: fonde le due comitive che, una volta unite, restano le più raccolte, cioè quelle che fanno crescere di meno lo sparpagliamento attorno al proprio centro. È parente stretto di k-means, che misura la stessa cosa, e come lui preferisce gruppi tondi e della stessa taglia.
Il prezzo è che, per sapere chi è vicino a chi, servono le distanze fra tutte le coppie di persone: con mille persone sono circa mezzo milione, con un milione circa cinquecento miliardi. Per questo, con tanti dati, si torna a k-means.
Detti \(A\) e \(B\) due gruppi e \(d\) la distanza fra due punti, i quattro criteri sono:
single: \(d(A,B) = \min_{\mathbf{a}\in A,\,\mathbf{b}\in B} d(\mathbf{a},\mathbf{b})\), la coppia più vicina. Segue le forme allungate, ma soffre di concatenamento: una catena di punti, ciascuno vicino al successivo, basta a fondere due gruppi lontani;
complete: \(d(A,B) = \max_{\mathbf{a}\in A,\,\mathbf{b}\in B} d(\mathbf{a},\mathbf{b})\), la coppia più lontana. Produce gruppi compatti e di diametro simile, e spezza le forme allungate;
average: la media di \(d(\mathbf{a},\mathbf{b})\) sulle \(|A|\,|B|\) coppie, un compromesso fra i due;
Ward: fonde la coppia che fa crescere di meno la somma dei quadrati delle distanze dai centroidi, cioè l’inerzia di \(k\)-means; l’aumento vale \(\frac{|A|\,|B|}{|A|+|B|}\lVert\boldsymbol{\mu}_A-\boldsymbol{\mu}_B\rVert^2\), con \(\boldsymbol{\mu}_A\) e \(\boldsymbol{\mu}_B\) i centroidi. È il default di scikit-learn e, come \(k\)-means, preferisce gruppi sferici e di taglia simile.
Il costo è almeno quadratico nel numero di punti, perché servono le distanze fra tutte le \(m(m-1)/2\) coppie; la versione ingenua, che a ogni fusione cerca la coppia più vicina fra tutte, è cubica, e il legame singolo si calcola in tempo quadratico e memoria lineare [Sib73].
In pratica: single se ti aspetti strutture allungate, a filo, Ward come
punto di partenza ragionevole in tutti gli altri casi.
Misture gaussiane: dal gruppo alla distribuzione#
I tre metodi di raggruppamento visti finora assegnano ogni punto a un gruppo, senza dire con quanta sicurezza. Una mistura gaussiana gli assegna una probabilità per ciascun gruppo, e di ogni gruppo impara, oltre al centro, la forma: la sua matrice di covarianza.
Due comitive fanno merenda nello stesso prato, una in fila lungo la riva sotto i pioppi, l’altra stretta in cerchio attorno alla griglia. Un metodo che dei gruppi conosce soltanto il centro, come k-means, li vuole tondi e della stessa taglia, e manda l’ultimo della fila alla griglia, che gli è più vicina.
Sopra ogni comitiva si può disegnare una campana, alta dove la gente è fitta e bassa dove si dirada: lunga lungo la riva, tonda attorno alla griglia. È la curva di Carl Friedrich Gauss, quella dell’altezza delle persone e degli errori di misura, e due campane, una per comitiva, sono una mistura gaussiana. Di ogni gruppo si impara il centro e anche la forma, quanto si allarga e in che direzione. Così l’ultimo della fila resta dei suoi.
Chi siede a metà strada riceve una risposta divisa invece di un nome secco, nove decimi della fila e un decimo della griglia; nel folto di una comitiva sarebbe quasi tutta da una parte. Lì in mezzo l’incertezza c’è davvero, e chi conta le porzioni preferisce quel dubbio a un’etichetta che finge una sicurezza inesistente.
Sotto c’è un racconto di come il prato si è riempito, e chi si limita a raggruppare non ce l’ha. Ognuno è arrivato in due mosse: ha scelto la comitiva, e quella che ne raccoglie sette su dieci esce sette volte su dieci; poi si è seduto, vicino ai suoi il più delle volte, in disparte di rado. Imparare vuol dire trovare le campane, e la frequenza del sorteggio, che rendono più plausibile il prato che hai davanti. E chi sta disteso in mezzo al campo da calcio, dove nessuna campana aspettava nessuno, è un’anomalia.
Come si trovano le campane? Girando un ragionamento circolare. Sapendo di chi è ogni persona, centro e forma di una comitiva sono una media; sapendo centro e forma, dire di chi è una persona è un confronto. Non sai né l’una né l’altra, quindi tiri a indovinare e alterni. Nessuno conta per intero da una parte sola: chi è nove decimi della fila pesa nove volte tanto nel centro della fila che in quello del cerchio.
Ogni giro spiega il prato non peggio del giro prima, e quasi sempre un po’ meglio; quando la spiegazione smette di crescere, ci si ferma. Dove ci si ferma dipende da dove si è partiti, quindi si riprova da più partenze. Il giro si chiama algoritmo EM, dalle iniziali inglesi delle sue due mosse: la prima (expectation) decide di chi è ognuno, viste le forme; la seconda (maximization) ricalcola centri e forme, viste le attribuzioni.
Niente vieta a una campana di stringersi su una persona sola, seduta in disparte, e capita davvero. Quella la descrivi alla perfezione, il racconto sembra il migliore di tutti, e di una comitiva non hai imparato niente. Per questo alle campane si impone una larghezza minima.
Un modello di mistura gaussiana (Gaussian Mixture Model, GMM) è un modello generativo: assume che ogni punto sia stato prodotto scegliendo prima una componente e poi campionando dalla sua gaussiana. La densità è
con \(\pi_k\) i pesi di mistura, \(\boldsymbol{\mu}_k\) le medie e \(\boldsymbol{\Sigma}_k\) le covarianze, che sono ciò che k-means non ha. Il parametro da stimare è \(\theta = \{\pi_k, \boldsymbol{\mu}_k, \boldsymbol{\Sigma}_k\}\), per massima verosimiglianza:
Il logaritmo di una somma non si separa, e annullando il gradiente non si ottiene una forma chiusa. Il rimedio è introdurre una variabile latente \(z^{(i)} \in \{1,\dots,K\}\), l’identità della componente che ha generato il punto: se le \(z^{(i)}\) fossero note, la stima sarebbe immediata.
L’algoritmo EM, formalizzato da Dempster, Laird e Rubin nel 1977 [DLR77], alterna due passi.
Passo E (expectation): a parametri fissi, calcola le responsabilità, cioè la posteriore di ogni componente su ogni punto,
Passo M (maximization): a responsabilità fisse, ristima i parametri con medie pesate, dove il peso è la responsabilità e \(m_k = \sum_i \gamma_{ik}\) è la massa della componente:
La proprietà che rende EM un algoritmo e non un’euristica è la monotonia, e la prova sta in una riga. Per qualunque distribuzione \(q\) sulle \(z^{(i)}\),
e siccome la KL non è mai negativa, \(\mathcal{E}\) sta sotto la
log-verosimiglianza. Il passo E prende come \(q\) la posteriore, cioè le
responsabilità \(\gamma_{ik}\): la KL si annulla e il limite tocca la
verosimiglianza nel \(\theta\) corrente. Il passo M massimizza \(\mathcal{E}\) in
\(\theta\), e allora \(\log p(\mathbf{X}\mid\theta_{\text{nuovo}}) \ge
\mathcal{E}(q,\theta_{\text{nuovo}}) \ge \mathcal{E}(q,\theta_{\text{vecchio}})
= \log p(\mathbf{X}\mid\theta_{\text{vecchio}})\). La monotonia non garantisce
l’ottimo globale e nemmeno un massimo locale: il punto a cui si arriva è in
generale un punto stazionario (la verosimiglianza è multimodale, e da
inizializzazioni diverse si arriva a soluzioni diverse: per questo si
inizializza tipicamente con k-means e si riparte più volte, cosa che in
scikit-learn va chiesta con n_init, che di suo vale \(1\)).
Con una covarianza propria per ogni componente (piena, diagonale o sferica),
però, quell’ottimo globale non è nemmeno una cosa da cercare: la verosimiglianza
è illimitata superiormente. Basta una componente che si stringe attorno a un
singolo punto, con la sua covarianza che tende a zero, mentre le altre
continuano a spiegare tutti gli altri punti: la densità in quel punto tende a
\(+\infty\), e con lei la verosimiglianza, mentre il modello non ha imparato
assolutamente niente. Con una covarianza condivisa fra le componenti
(covariance_type="tied") non succede, perché stringerla penalizzerebbe tutti i
punti. Quel massimo è una degenerazione, e va impedita: le implementazioni
aggiungono una piccola quantità sulla diagonale delle covarianze, che tiene le
componenti larghe abbastanza da non collassare (in scikit-learn è reg_covar,
di default \(10^{-6}\)).
Due letture che pagano nel resto del libro. La prima: k-means è il caso limite di EM su una mistura con covarianze \(\sigma^2\mathbf{I}\) e \(\sigma^2 \to 0\), dove le responsabilità collassano su 0 e 1. L’assegnazione dura è la versione degenere di quella morbida, e la preferenza di k-means per gruppi sferici è scritta in quella \(\mathbf{I}\). La seconda: essendo generativo, un GMM restituisce una densità, quindi serve anche a quello che il clustering non fa, cioè segnalare i punti improbabili. È uno dei rilevatori di anomalie di riferimento, e riaggancia Quando i dati cambiano.
Poiché il modello ha una verosimiglianza, il numero di componenti si sceglie con
un criterio di informazione invece che a occhio. BIC e AIC sommano a
\(-2\) volte la log-verosimiglianza una penalità sul numero di parametri
(\(\lvert\theta\rvert\log m\) per il BIC, \(2\lvert\theta\rvert\) per l’AIC, con
\(\lvert\theta\rvert\) il numero di parametri liberi), e si prende il \(K\) che li
minimizza: il primo termine premia chi spiega bene i dati (cambiato di segno,
quindi minimizzarlo vuol dire massimizzare la verosimiglianza), il secondo fa
pagare i parametri usati per farlo. È la convenzione di GaussianMixture.bic, e
una risposta più difendibile del gomito o della silhouette, che sono
diagnostiche geometriche senza un modello sotto.
L’algoritmo EM ricompare in altri punti del libro, e lo schema è sempre lo stesso: quando la variabile che renderebbe facile la stima non si osserva, la si stima a parametri fissi, si riaggiornano i parametri a stima fissa, e si alterna.
Tre posti in cui lo si ritrova. Il primo è Speech Recognition: i sistemi che per trent’anni hanno trascritto il parlato usavano proprio misture gaussiane come queste, e le addestravano con EM. Il secondo è Oltre il BPE: la tokenizzazione unigram sceglie i pezzi in cui tagliare le parole senza sapere in anticipo come vadano tagliate, e il motore è di nuovo EM. Il terzo sono i modelli latenti: il capitolo che li tratta riprende la mistura gaussiana come il caso più semplice di un modello che spiega i dati con una causa che non si osserva, e la sezione su ELBO e riparametrizzazione sostituisce il passo che stima la variabile nascosta con una rete che impara a farlo.
In pratica, con scikit-learn#
Come per l’apprendimento supervisionato, in scikit-learn ogni tecnica è poche
righe, con la solita interfaccia fit (qui spesso fit_transform per chi
trasforma i dati, o fit_predict per chi assegna etichette di cluster):
from sklearn.cluster import KMeans, DBSCAN
from sklearn.datasets import make_blobs
from sklearn.decomposition import PCA
from sklearn.manifold import TSNE
from sklearn.preprocessing import StandardScaler

# Tre gruppi in cinque dimensioni, i dati su cui gira tutto il blocco
X, _ = make_blobs(n_samples=300, n_features=5, centers=3, random_state=0)

# Standardizzare prima: PCA e le distanze sono sensibili alla scala
X_std = StandardScaler().fit_transform(X)

# --- Riduzione della dimensionalità ---
pca = PCA(n_components=2)          # tieni le prime 2 componenti
Z = pca.fit_transform(X_std)      # dati proiettati: (m, 2)
print(pca.explained_variance_ratio_)  # varianza spiegata da ogni componente

# Visualizzazione non lineare (solo per guardare, non per misurare)
Z_tsne = TSNE(n_components=2, perplexity=30).fit_transform(X_std)

# --- Clustering ---
km = KMeans(n_clusters=3, init="k-means++", n_init=10)
etichette_km = km.fit_predict(X_std)   # un intero per punto: 0, 1, 2

db = DBSCAN(eps=0.5, min_samples=5)
etichette_db = db.fit_predict(X_std)   # -1 marca il rumore
[0.55173949 0.37539761]
Le prime due componenti si prendono il \(55\%\) e il \(38\%\) della dispersione, il
\(93\%\) in tutto. Tre punti stanno sempre su un piano, quindi due direzioni
bastano a contenere i tre centri, e le altre tre dimensioni portano soltanto la
dispersione interna ai gruppi. Quante componenti tenere, in generale, si decide
fissando la quota di varianza da conservare (PCA(n_components=0.95) sceglie da
sé quante ne servono per il \(95\%\)) o cercando il gomito nella curva delle
quote.
Due dettagli che fanno la differenza in pratica. La standardizzazione prima di una PCA o di un clustering per distanza va fatta quando le feature hanno unità o scale diverse (è lo stormo misurato in metri e in centimetri): senza, quella con la scala numerica più ampia domina il conto. Quando le feature sono omogenee, come i pixel di un’immagine, la varianza relativa è già informazione, e standardizzare la cancella. E le etichette restituite dal clustering sono arbitrarie: il «cluster 0» di k-means non ha alcun significato intrinseco, è solo un nome; due esecuzioni possono scambiare i numeri senza che nulla sia cambiato.
La differenza fra la risposta secca di k-means («sei del gruppo 1») e quella sfumata della mistura («sei del gruppo 1 al \(70\%\)») non è teorica: si vede su due gruppi allungati e vicini, esattamente il caso in cui il centro da solo non basta.
Nell’esperimento che segue le due nuvole sono generate da noi, quindi conosciamo il gruppo di ogni punto. L’algoritmo non vede queste etichette: servono dopo, come le soluzioni in fondo a un eserciziario, per contare quanti punti ha assegnato al gruppo giusto. È un indice esterno, e Valutare un raggruppamento ne dice il perché e i limiti: con due gruppi basta l’accordo a meno di uno scambio dei nomi, con più gruppi si usa l’ARI.
import numpy as np
from sklearn.cluster import KMeans
from sklearn.mixture import GaussianMixture

rng = np.random.default_rng(1)
# due nuvole allungate nella stessa direzione, vicine fra loro
forma = [[4.0, 0.0], [0.0, 0.15]]
X = np.vstack([rng.multivariate_normal([0.0, 0.0], forma, 300),
               rng.multivariate_normal([1.0, 2.2], forma, 300)])
vero = np.r_[np.zeros(300), np.ones(300)]

def concordanza(a, b):
    """Quota di punti d'accordo, a meno di uno scambio dei nomi dei cluster."""
    return max((a == b).mean(), (a != b).mean())

km = KMeans(n_clusters=2, n_init=10, random_state=0).fit_predict(X)
gm = GaussianMixture(n_components=2, covariance_type="full",
                     random_state=0).fit(X)

print(f"k-means           : {concordanza(km, vero):.3f}")
print(f"mistura gaussiana : {concordanza(gm.predict(X), vero):.3f}")

# l'assegnazione morbida: quanto ogni punto appartiene a ciascun gruppo
incerti = (gm.predict_proba(X).max(axis=1) < 0.9).sum()
print(f"punti su cui il modello resta incerto: {incerti} su {len(X)}")

# quanti gruppi? con una verosimiglianza sotto, lo dice il BIC
for k in range(1, 6):
    bic = GaussianMixture(n_components=k, covariance_type="full",
                          random_state=0).fit(X).bic(X)
    print(f"  k={k}  BIC={bic:9.1f}")
k-means           : 0.663
mistura gaussiana : 0.997
punti su cui il modello resta incerto: 5 su 600
  k=1  BIC=   4431.2
  k=2  BIC=   3971.9
  k=3  BIC=   4008.9
  k=4  BIC=   4039.6
  k=5  BIC=   4078.2
I numeri stampati sono la quota di punti finiti nel gruppo giusto: \(1\) sarebbe perfetto, e \(0{,}5\) è quanto prende chi tira a caso, perché con due gruppi indovinare a caso ne azzecca metà.
k-means si ferma a \(0{,}663\), cioè poco sopra il tirare a caso: le due nuvole sono allungate, e la frontiera a metà strada fra i due centri le taglia di traverso. La mistura arriva a \(0{,}997\), perché ha imparato che i gruppi sono larghi in una direzione e stretti nell’altra. Restano cinque punti su seicento su cui il modello non si sbilancia oltre il 90%, e sono quelli in mezzo: l’unica risposta onesta, lì.
Resta l’ultima stampa, il BIC (Bayesian Information Criterion): \(-2\log L + \lvert\theta\rvert\log m\), con \(L\) la verosimiglianza dei dati, \(\lvert\theta\rvert\) il numero di parametri e \(m\) quello degli esempi. Il primo termine scende quando la mistura spiega meglio i dati, il secondo sale con i parametri, che per \(k\) gaussiane in due dimensioni sono \(\lvert\theta\rvert = 6k-1\) (per ognuna due coordinate del centro e tre numeri della forma, più i \(k-1\) pesi liberi): oltre il numero giusto di gruppi, un gruppo in più costa più di quanto rende. È il rasoio di Occam scritto come penalità. Il BIC si minimizza, e qui tocca il minimo esattamente a \(k=2\): con un modello probabilistico sotto, il numero dei gruppi si sceglie con un criterio invece che con un giudizio a occhio su un grafico.
Da ricordare
Qui i dati arrivano muti, senza risposta giusta accanto, ed è il caso della stragrande maggioranza dei dati del mondo. Si può chiedere loro due cose: se si possono descrivere con meno colonne, e se contengono gruppi naturali.
A parità di esempi, troppe colonne sono un problema: in uno spazio con tante direzioni il volume scappa verso i bordi e le distanze fra i punti diventano quasi uguali in proporzione, e «chi somiglia a chi» perde senso. È la maledizione della dimensionalità.
La PCA cerca le direzioni lungo cui i punti sono più sparpagliati e butta le altre, scommettendo che lo sparpagliamento sia il segnale: è la fotografia dello stormo scattata dal lato giusto. Serve a comprimere, a disegnare in due dimensioni ciò che ne ha cento, e a ripulire dal rumore.
Quando i dati sono voci mescolate, la PCA restituisce altri miscugli; l’ICA cerca la combinazione che somiglia di meno alla campana del rumore di fondo, ed è quella con dentro una voce sola. Non sa l’ordine, il volume, né se una voce va presa dritta o capovolta; con voci che sono già rumore a forma di campana non separa niente, e servono almeno tanti microfoni quante voci.
t-SNE e UMAP disegnano mappe bellissime, dove chi si somigliava finisce vicino. Ma sono ottime per l’occhio e pessime per il righello: la distanza fra due isole, la loro grandezza e quanto sono fitte non vogliono dire quasi niente.
k-means raggruppa alternando due mosse: ognuno va al punto di ritrovo più vicino, poi ogni ritrovo si sposta in mezzo ai suoi. Bisogna dirgli quanti gruppi cercare (il gomito e la silhouette aiutano a sceglierlo), e preferisce i gruppi tondi e della stessa taglia.
DBSCAN guarda invece le zone fitte, come le luci di una città viste dall’aereo: scopre da solo quanti gruppi ci sono, riconosce forme di qualunque sagoma, e ha il buon senso di lasciare fuori i puntini isolati. In cambio non lascia una regola per collocare un punto che arriva dopo: per dire di chi è servono di nuovo tutti gli altri.
Il clustering gerarchico costruisce un albero di fusioni, il dendrogramma, e il numero di gruppi si sceglie dopo, decidendo a che altezza tagliarlo; quando due gruppi sono «vicini» lo decide il criterio di collegamento.
Le misture gaussiane imparano di ogni gruppo anche la forma, non solo il centro, e invece di un’etichetta secca rispondono «al 90% di qua e al 10% di là»: sul confine l’incertezza c’è davvero, ed è onesto dirlo. Si trovano con l’algoritmo EM, che tira a indovinare e poi alterna fra «di chi è ognuno» e «com’è fatto ogni gruppo».
Da ricordare
L’apprendimento non supervisionato lavora su dati senza etichette (la maggioranza dei dati reali) per scoprire una struttura nascosta.
In alte dimensioni, a parità di esempi, scatta la maledizione della dimensionalità: i volumi si concentrano sui bordi e le distanze si concentrano (con coordinate indipendenti, il rapporto fra distanza massima e minima tende a uno), e i metodi basati sulla vicinanza entrano in crisi quando la dimensione intrinseca dei dati è alta.
La PCA trova le direzioni di massima varianza (autovettori della matrice di covarianza) e vi proietta i dati; è lineare, ottima fra le proiezioni lineari per l’errore di ricostruzione (Eckart e Young); per la visualizzazione e il denoising vale se la varianza è il segnale.
L’ICA stima \(\mathbf{x} = \mathbf{A}\mathbf{s}\) con sorgenti indipendenti: sbianca con la PCA, poi cerca la rotazione che massimizza la non gaussianità (valore assoluto della curtosi, negentropia; FastICA). Identifica \(\mathbf{A}\) a meno di ordine e scala (segno compreso) se al più una sorgente è gaussiana, tratta i campioni come indipendenti, ignorandone l’ordine nel tempo, e chiede miscele istantanee.
t-SNE e UMAP visualizzano dati ad alta dimensione preservando la vicinanza locale: sulle loro mappe distanze globali, densità e dimensioni dei cluster non sono affidabili.
k-means alterna assegnazione ai centroidi e ricalcolo delle medie (algoritmo di Lloyd); richiede \(k\) a priori (gomito, silhouette), assume cluster convessi e sferici, si ferma in un numero finito di passi in un minimo locale (quello globale è NP-difficile) ed è sensibile all’inizializzazione (k-means++, con la sua garanzia \(O(\log k)\)).
DBSCAN raggruppa per densità (\(\varepsilon\), \(\mathrm{minPts}\)): trova cluster di forma arbitraria, marca il rumore e non richiede \(k\), ma non restituisce un modello con cui assegnare un punto nuovo, perché l’appartenenza è una proprietà del vicinato; il clustering gerarchico offre un dendrogramma da tagliare a piacere, con il criterio di collegamento (single, complete, average, Ward) che decide quanto distano due gruppi, a un costo almeno quadratico nel numero di punti.
Le misture gaussiane imparano di ogni gruppo non solo il centro ma la forma (la covarianza), e assegnano una probabilità invece di un’etichetta secca. Si stimano con l’algoritmo EM, che alterna il calcolo delle responsabilità (passo E) e la ristima dei parametri (passo M) e garantisce che la verosimiglianza non decresca. k-means è il caso limite di questo schema con covarianze sferiche che tendono a zero.
Avendo un modello probabilistico sotto, una mistura dà una densità (quindi serve anche per le anomalie) e permette di scegliere il numero di componenti con BIC o AIC invece che a occhio: penalità \(\lvert\theta\rvert\log m\) o \(2\lvert\theta\rvert\) sommata a \(-2\log L\), e si minimizza.