


La dualità: Mamba-2 e Mamba-3#
Lo scan di Mamba (che da qui in avanti chiameremo Mamba-1, per
distinguerlo dai successori) ha un limite di hardware. Sulla GPU le
moltiplicazioni fra matrici girano sui tensor core, le unità dedicate
descritte nella sezione sul GEMM, dove sta
quasi tutta la potenza di calcolo: su una A100, 312 mila miliardi di operazioni
al secondo in mezza precisione, contro 19,5 mila miliardi delle unità generiche
in float32. Le operazioni elemento per elemento e le somme girano invece sulle
unità generiche, e lo scan di Mamba-1 è fatto proprio di operazioni di questo
tipo: i tensor core restano inutilizzati.
Mamba-2, di Tri Dao e Albert Gu [DG24], risponde con un risultato teorico e uno pratico. Il primo: per una classe precisa di SSM, quelli in cui la transizione è uno scalare per l’identità, la ricorrenza e un’attenzione lineare mascherata (la formula dei Transformer senza la softmax) calcolano la stessa funzione; le due famiglie si incontrano su quel gradino, e fuori da lì restano parenti. Il secondo: da quella equivalenza discende un algoritmo fatto quasi tutto di moltiplicazioni di matrici, che riporta il calcolo sui tensor core.
State Space Duality: dove un SSM è un’attenzione#
Il risultato, detto in una riga, è questo: un SSM la cui transizione è uno scalare per l’identità calcola la stessa funzione di un’attenzione lineare mascherata, cioè di un’attenzione senza softmax a cui è vietato guardare avanti, che confronta ogni parola solo con quelle che l’hanno preceduta e pesa ogni confronto con il decadimento accumulato nel frattempo. Gli autori chiamano questo fatto State Space Duality (SSD), la dualità fra spazio degli stati e attenzione.
Il titolo del loro articolo, Transformers are SSMs, è programmatico e più largo del teorema che contiene, ed è il rovescio della medaglia di quello che avevamo incontrato nel capitolo sull’attenzione lineare, Transformers are RNNs [KVPF20]. Lì avevamo tolto dall’attenzione il pezzo che costava di più e trovato sotto una rete ricorrente a stato fisso; qui si parte dall’altro capo, da un sistema dinamico misurato a intervalli, e si arriva a un’attenzione lineare.
Una dualità l’abbiamo già incontrata: la stessa funzione calcolata «passo dopo passo» (ricorrente) oppure «tutta insieme» (convoluzione o attenzione). Quella che arriva adesso riguarda due oggetti che avevamo trattato come parenti lontani.
In due valli vicine si parlano due dialetti che tutti considerano diversi. Di qua si dice «uno stato che evolve nel tempo», ed è la lingua degli State Space Model, venuta dalla teoria del controllo: la lingua della vasca, con il suo rubinetto, i suoi scarichi e il suo ago. Di là si dice «una tabella che confronta ogni parola con ogni altra», ed è la lingua dell’attenzione, venuta dalla traduzione automatica, con le sue chiavi, i suoi valori e le sue query. Mamba-2 mette i due vocabolari uno accanto all’altro, e per ogni parola dell’uno trova quella dell’altro:
nella vasca |
nell’attenzione |
|---|---|
come il rubinetto spartisce l’acqua fra le vasche |
la chiave, l’etichetta sotto cui la parola si archivia |
l’acqua che entra, cioè il numero che la parola porta |
il valore, l’informazione archiviata |
come l’ago legge le vasche |
la query, la domanda con cui la si va a ripescare |
lo scarico, che fa calare quello che c’è |
quanto una parola vecchia conta ancora adesso |
Il vocabolario combacia a una condizione, ed è la rinuncia che Mamba-2 accetta: si prende la versione più semplice della vasca, quella in cui tutti gli scarichi tirano alla stessa velocità invece che ognuno alla propria. Con una velocità diversa per ogni vasca una tabella dei confronti esiste ancora, ma non si scrive più come quella dell’attenzione, un confronto per ogni coppia di parole moltiplicato per un unico sbiadimento: di là mancherebbe la parola per dirla in una tabella sola. Con tutti gli scarichi uguali, invece, i due dialetti dicono la stessa cosa con due alfabeti.
Tradotta la frase, lo stesso conto si fa in due modi: passo dopo passo, aggiornando la memoria una parola per volta, oppure tutto insieme, formando la grande tabella dei confronti. La tabella non si riempie tutta, però. La metà che confronterebbe una parola con quelle che vengono dopo di lei resta a zero, perché nessuno può leggere il futuro; e ogni confronto che resta viene moltiplicato per quanto del ricordo è sopravvissuto da lì fin qui, così le parole lontane pesano meno di quelle vicine. Il secondo modo è quello che le GPU adorano.
Riprendiamo la convenzione del capitolo: lo stato \(\mathbf{S}_t\) è una memoria chiave→valore, aggiornata per prodotto esterno e letta con la query. Nella sezione sulla scrittura in memoria del capitolo precedente avevamo messo in fila lo «zoo» delle ricorrenze, e la riga di Mamba-2 era il decadimento scalare
con transizione \(\alpha_t \mathbf{I}\) (uno scalare per l’identità). (Uno scalare commuta, quindi qui il lato da cui la transizione moltiplica lo stato non conta.) La SSD mostra che questa è precisamente la forma cui si riduce un SSM quando si impone \(\mathbf{A} = a\mathbf{I}\), con \(a\) scalare fisso (uno per testa): la discretizzazione fa il resto, perché la transizione discreta diventa \(\bar{\mathbf{A}}_t = a_t \mathbf{I}\) con \(a_t = e^{\Delta_t a}\), data-dipendente attraverso \(\Delta_t\). Basta identificare i ruoli. Lo stato dell’SSM per una testa a dimensione \(P\) è la matrice \(\mathbf{S}_t \in \mathbb{R}^{P\times N}\); la matrice d’ingresso \(\mathbf{B}_t\in\mathbb{R}^{N}\) fa da chiave \(\mathbf{k}_t\), l’ingresso \(\mathbf{x}_t\in\mathbb{R}^{P}\) fa da valore \(\mathbf{v}_t\), la matrice d’uscita \(\mathbf{C}_t\in\mathbb{R}^{N}\) fa da query \(\mathbf{q}_t\), e lo scalare \(a_t\) è il gate \(\alpha_t\). La ricorrenza dell’SSM,
è la stessa riga della tabella. Un avvertimento sulla scrittura, perché altrimenti stona con il resto del capitolo: qui \(\mathbf{B}_t\) è già la matrice discretizzata, quella che altrove scriviamo \(\bar{\mathbf{B}}_t\), e il passo \(\Delta_t\) sta dentro, non davanti. È la convenzione del paper SSD, che dichiara in una nota di aver dato ai parametri discreti le lettere dei continui per alleggerire la notazione; più avanti, quando ricomparirà \(\bar{\mathbf{B}}_t = \Delta_t \mathbf{B}_t\), saremo tornati alle lettere del capitolo.
Srotolando la ricorrenza dallo stato iniziale nullo, l’uscita al passo \(i\) è
dove il fattore \(\prod_{k} a_k\) è quanto è sopravvissuto, dal passo \(j\) al passo \(i\), di ciò che era stato scritto. Raccogliamo tutti i passi in una sola matrice. Impilando le query \(\mathbf{C}_i\), le chiavi \(\mathbf{B}_j\) e i valori \(\mathbf{x}_j\) nelle righe di \(\mathbf{C}\), \(\mathbf{B}\), \(\mathbf{X}\), l’intera sequenza di uscite si scrive
dove \(\mathbf{C} \mathbf{B}^\top\) è la matrice \(L\times L\) (lunghezza per lunghezza) di tutte le affinità tra query e chiave, esattamente \(\mathbf{Q}\mathbf{K}^\top\) dell’attenzione; \(\odot\) è il prodotto elemento per elemento; e \(\mathbf{M}\) è una maschera causale con decadimento: azzera il futuro (triangolo superiore) e pesa il passato con i prodotti degli scalari \(a_t\). Il paper di Mamba-2 chiama \(\mathbf{L}\) questa maschera; qui la chiamiamo \(\mathbf{M}\) perché in questo capitolo \(L\) è la lunghezza della sequenza (il numero di posizioni, come nell’attenzione), e le due cose comparirebbero nella stessa formula. Questa è un’attenzione lineare mascherata. Dell’attenzione dei Transformer, \(\mathrm{softmax}(\mathbf{Q}\mathbf{K}^\top/\sqrt{d_k})\mathbf{V}\) [VSP+17], tiene i punteggi \(\mathbf{Q}\mathbf{K}^\top\) (qui \(\mathbf{C}\mathbf{B}^\top\)) e toglie la softmax. La maschera \(\mathbf{M}\) non la rimpiazza: si moltiplica ai punteggi elemento per elemento e, oltre a vietare il futuro, pesa il passato con il decadimento. La softmax non ha un equivalente fra gli SSM, perché \(\exp(\mathbf{q}^\top\mathbf{k})\) richiede una mappa di feature di dimensione infinita, cioè uno stato infinito: in pratica, la cache che cresce con la sequenza. La matrice \(\mathbf{M}\) ha una struttura particolare, detta 1-semiseparabile: ogni sua sottomatrice interamente contenuta nel triangolo inferiore ha rango al più uno, perché ogni elemento si fattorizza nei prodotti cumulati degli \(a_t\). È questa struttura a fare da ponte, e il paper la dimostra in forma più generale: qualunque SSM con stato di dimensione \(N\), anche con \(\bar{\mathbf{A}}_t\) diagonale o piena, calcola \(\mathbf{Y} = \mathbf{T}\mathbf{X}\) con \(T_{ij} = \mathbf{C}_i^\top \bar{\mathbf{A}}_i \cdots \bar{\mathbf{A}}_{j+1}\mathbf{B}_j\) per \(i \ge j\), e \(\mathbf{T}\) è \(N\)-semiseparabile (ogni sottomatrice del triangolo inferiore ha rango al più \(N\)). La transizione scalare è il caso in cui \(\mathbf{T}\) si spezza nel prodotto elemento per elemento di una maschera \(1\)-semiseparabile per \(\mathbf{C}\mathbf{B}^\top\), cioè in un’attenzione lineare mascherata che si calcola a prodotti di matrici: i sistemi a spazio di stati con transizione scalare sono le attenzioni lineari con maschera 1-semiseparabile. Il rovescio non vale in generale: con una maschera semiseparabile di rango più alto l’attenzione strutturata è strettamente più espressiva, e non si descrive più con un SSM standard (Remark 7 del paper). Con un decadimento che varia per canale e per dimensione dello stato, come in Mamba-1, la matrice resta semiseparabile, ma quella fattorizzazione si perde, e con lei i tensor core. Le due famiglie, dunque, si intersecano, ed è l’immagine che usa il paper stesso: due insiemi che si sovrappongono sui modelli duali, la classe scalare, e fuori da lì restano distinti.
Nella sezione sulla scrittura in memoria del capitolo precedente avevamo messo in fila una piccola collezione di architetture (uno «zoo», lo avevamo chiamato) con lo stesso corpo, una memoria di taglia fissa addestrata in parallelo e usata passo dopo passo, e una sola differenza: come il passato sbiadisce quando arriva il presente. C’era chi non dimenticava niente, chi sbiadiva tutta la memoria della stessa quantità, chi ne sbiadiva ogni colonna al suo ritmo, e chi cancellava in modo mirato la vecchia voce che stava per essere riscritta. Mamba-2 stava sul secondo gradino, quello della transizione \(\alpha_t\mathbf{I}\), il decadimento scalare ricalcolato a ogni parola. Arrivando dai sistemi dinamici invece che dall’attenzione, con la transizione scalare ci si ritrova su quello stesso gradino. Lì la stessa funzione ha una forma ricorrente, che costa quanto la lunghezza del testo (la vista «SSM»), e una forma a tabella, la griglia \(L \times L\) dei confronti fra tutte le coppie di parole, mascherata perché ciascuna guardi solo all’indietro (la vista «attenzione»). Su quel gradino non è un’analogia: è un’uguaglianza. Sugli altri, le due famiglie restano parenti.
Perché conviene: i tensor core#
La dualità sarebbe solo un’eleganza teorica se non pagasse in velocità. Paga, e la chiave è una rinuncia. In Mamba-1 ogni casella della memoria sbiadiva a velocità propria; Mamba-2 impone che sbiadiscano tutte alla stessa. È una perdita di espressività, cioè di cose che il modello sa distinguere, e i due paper la riconoscono: gli autori di Mamba-2 la giudicano piccola e la pagano volentieri, perché in cambio l’algoritmo si scrive quasi tutto come prodotto di matrici [DG24]; quelli di Mamba-3 osservano che, a parità di costo in generazione, la restrizione si sente [LLC+26].
Un’officina ha un attrezzo formidabile e specializzato: una pressa che stampa una lastra intera in un colpo solo, purché il pezzo abbia una certa forma. Finché lavori a mano, pezzo per pezzo, la pressa resta ferma e tu vai lentissimo. Se accetti di dare ai pezzi quella forma standard, puoi usarla, e vai molto più veloce.
I tensor core della GPU sono quella pressa: sanno fare una cosa sola, moltiplicare tabelle di numeri, e la fanno a velocità impressionante. Lo scan di Mamba-1, fatto di operazioni una-alla-volta, li teneva spenti. La rinuncia di Mamba-2 dà ai conti la «forma standard» che la pressa accetta. Il modello lavora per canali, i numeri in fila con cui è scritta ogni parola, e ogni canale ha il suo pezzo di memoria, la sua schiera di vasche; invece di lasciare che ogni canale dimentichi a modo suo, si chiede a un intero gruppo di canali di dimenticare tutti alla stessa velocità. Basta questo, e il calcolo di tutto il gruppo diventa un prodotto fra tabelle: la pressa si accende.
La pressa, intanto, non toglie lavoro: batte tutta la lastra in una volta, comprese le zone dove non c’era niente da stampare, e di colpi ne dà anche più di quanti ne avresti dati tu andando a mano. Va più veloce lo stesso, perché li dà tutti insieme e tutti uguali, senza fermarsi a cercare il pezzo dopo. Quello che cambia è la forma del lavoro, ed è la forma che la macchina digerisce.
In più, potendo permettersi una memoria più capiente senza pagarla in velocità, Mamba-2 allarga il pezzo di memoria di ogni canale (da una manciata di caselle a diverse decine o centinaia) e organizza i canali in gruppi, che chiama teste, come l’attenzione. Con più caselle la memoria tiene separate più voci: se ne scrivono tante senza che si pestino i piedi, e a rileggerle si ripesca quella giusta invece di una via di mezzo fra due.
Un’avvertenza, la stessa del capitolo precedente: la grande tabella dei confronti non si forma mai per intero, perché su un testo lungo sarebbe di nuovo la tabella da cui eravamo scappati. Si lavora a blocchi: dentro un blocco di poche centinaia di parole la tabella è piccola e si fa tutta insieme, e da un blocco al successivo passa soltanto il riassunto. Tabella dentro il blocco, riassunto da un blocco all’altro: è così che il lavoro resta proporzionale alla lunghezza e la pressa lavora lo stesso.
La rinuncia, in formule: la matrice di stato \(\mathbf{A}\), diagonale, non ha più \(N\) valori distinti per canale ma un solo scalare ripetuto, \(\mathbf{A} = a\mathbf{I}\), da cui una transizione discreta \(\bar{\mathbf{A}}_t = a_t \mathbf{I}\).
Il motivo per cui il matmul batte lo scan è nell’hardware. Un tensor core esegue un piccolo prodotto di matrici per ciclo: su una GPU moderna è lì che risiede la stragrande maggioranza dei FLOP disponibili. Un selective scan come quello di Mamba-1 è invece una ricorrenza associativa fatta di moltiplicazioni elemento per elemento e somme: parallelizzabile in \(O(\log L)\) passi, ma su unità generiche, molto meno dense di FLOP. Sta usando la frazione lenta della GPU.
Con la transizione \(\bar{\mathbf{A}}_t = a_t \mathbf{I}\) l’algoritmo pratico non forma davvero l’intera matrice lunghezza per lunghezza (sarebbe \(O(L^2)\) in memoria). Si adotta una decomposizione a blocchi (chunked scan): la sequenza si spezza in blocchi di lunghezza \(Q\) (la lettera è quella del paper, e non c’entra con le query \(\mathbf{Q}\), che essendo una matrice restano in grassetto); dentro ciascun blocco si calcola la forma quadratica, attention-like, come un prodotto di matrici sui tensor core; tra un blocco e il successivo si passa solo lo stato riassuntivo, con un termine di rango basso, in forma ricorrente. Si interpola così tra le due viste della dualità: quadratica dentro il blocco, lineare tra i blocchi.
In formule, con \(L/Q\) blocchi l’uscita del blocco \(c\) si compone di quattro pezzi. (i) Il blocco diagonale, \((\mathbf{M}_{cc} \odot \mathbf{C}_c\mathbf{B}_c^\top)\,\mathbf{X}_c\), cioè la forma attention-like ristretta al blocco: due prodotti di matrici. (ii) Lo stato che il blocco scriverebbe partendo da zero, \(\mathbf{H}^{0}_c = \sum_{j \in c} \big(\prod_{k=j+1}^{\text{fine}(c)} a_k\big)\, \mathbf{x}_j \mathbf{B}_j^\top\), ancora un prodotto di matrici. (iii) La ricorrenza fra i blocchi, \(\mathbf{H}_c = \big(\prod_{k \in c} a_k\big)\, \mathbf{H}_{c-1} + \mathbf{H}^{0}_c\), lunga soltanto \(L/Q\) passi, che dà lo stato vero alla fine di ogni blocco. (iv) Il contributo dello stato precedente a ogni posizione \(i\) del blocco, \(\big(\prod_{k=\text{inizio}(c)}^{i} a_k\big)\, \mathbf{H}_{c-1}\mathbf{C}_i\), di nuovo un prodotto di matrici. L’uscita è la somma di (i) e (iv). I blocchi fuori diagonale di \(\mathbf{M} \odot \mathbf{C}\mathbf{B}^\top\) hanno rango al più \(N\), ed è per questo che si riducono agli stati di fine blocco [DG24].
Sul costo conviene essere precisi, perché è qui che si annida il malinteso. Il conto torna lineare nella lunghezza: \(O\big(L\,Q\,(N+P) + L\,N\,P\big)\) con blocchi di lunghezza \(Q\), stato \(N\) e dimensione di testa \(P\), che nel caso del Teorema 6.1 del paper (\(P = N\), blocchi dell’ordine di \(N\)) diventa \(O(L\,N^2)\). Rispetto alla forma quadratica, che di operazioni ne fa \(O\big(L^2 (N+P)\big)\), è un guadagno enorme; rispetto alla ricorrenza pura non si risparmia nulla, anzi con blocchi lunghi si fanno più operazioni. Il punto sta nel farne di un tipo diverso, non nel farne meno: tutte moltiplicazioni di matrici, cioè lavoro che la pressa accetta. Ne seguono due conseguenze di progetto: la struttura è multi-head come l’attenzione (dimensione di testa \(P\) tipicamente \(64\) o \(128\)), e lo stato può crescere di un ordine di grandezza (da \(N=16\) in Mamba-1 a \(N\) dell’ordine di \(64\)–\(256\) e oltre in Mamba-2), perché una memoria più grande, ora, non costa in velocità. Uno stato più capiente è direttamente più memoria associativa: meno crosstalk, richiamo più preciso.
Mamba-1 aveva reso l’SSM selettivo pagando con lo scan. Mamba-2 recupera il parallelismo pieno delle matrici accettando una transizione di stato (il modo in cui lo stato sbiadisce) più semplice, e può permetterselo proprio perché la dualità gli garantisce che quella forma più semplice è un’attenzione lineare mascherata, e come tale si calcola a prodotti di matrici. È il compromesso tipico di questa famiglia: qualche grado di libertà in meno sulla transizione, cioè meno modi di sbiadire, in cambio di forme parallele che sfruttano le GPU.
Mamba-3#
L’ultimo anello di questa catena è Mamba-3, di Lahoti, Li e colleghi con Dao e Gu, comparso su arXiv a marzo 2026 e presentato a ICLR 2026 [LLC+26]. Il paper valuta modelli da 180 milioni a 1,5 miliardi di parametri, addestrati su 100 miliardi di token, con una cifra per ogni configurazione e senza barre d’errore; i vantaggi sulle medie dei compiti vanno da mezzo punto a circa due, e contano i meccanismi più delle cifre. Le novità rispetto a Mamba-2 sono tre, e tutte lavorano su come lo stato evolve, lasciando com’era la struttura generale.
La prima riguarda la discretizzazione, cioè il modo di trasformare il sistema continuo in una ricorrenza, introdotta nella sezione sui sistemi dinamici.
Ricordiamo il problema: un sistema che scorre nel tempo va «campionato» a intervalli, e bisogna indovinare cosa succede tra un campione e l’altro. Il punto delicato è quanta parte di ciò che entra in quel tratto finisce nella memoria. Torniamo al rubinetto: più a lungo lo tieni aperto e più forte lo apri, più acqua entra, e la quantità è la superficie della figura che ha per base la durata del tratto e per altezza l’apertura. Mamba-1 e Mamba-2 usano una sola altezza, l’apertura del campione che stanno leggendo: quella figura è un rettangolo, ed è il conto sbrigativo, il valore di adesso moltiplicato per la durata, come se fosse stato quello per tutto il tratto. Rapido, ma con un errore che a ogni passo si accumula.
Mamba-3 rifà lo stesso conto a trapezi, cioè guardando tutte e due le aperture, quella di adesso e quella del campione precedente: si tira un segmento fra i due valori e si misura la superficie che gli sta sotto. È un altro trapezio rispetto a quello di S4: là stimava quanta acqua la vasca perde dallo scarico, qui quanta ne entra dal rubinetto. Con una correzione che la vasca impone da sé: l’acqua entrata all’inizio del tratto ha avuto tutto il tratto per defluire dallo scarico, quindi di quella si conta soltanto la parte ancora dentro. E c’è una furbizia in più, la mossa di sempre di Mamba: quanto contano i due estremi non è deciso una volta per tutte a metà e metà, lo decide il modello a ogni passo, in base a ciò che legge, con un peso che va da zero a uno (il trapezio della geometria, quello che fa la media, è il caso particolare in cui i due estremi pesano uguale). Il conto è il più preciso quando i due estremi pesano quasi uguale, e lontano da lì torna grossolano quanto i rettangoli. Gli autori hanno provato a inchiodare il peso a metà: il conto a metà e metà fa già meglio di quello a rettangoli, e lasciare libero il peso guadagna ancora qualcosa. Le differenze sono piccole, e il paper non dice di quanto cambierebbero rifacendo la prova. C’è poi una conseguenza pratica, che viene dalla forma della regola più che dalla sua precisione. Mamba-1 e Mamba-2 avevano bisogno, prima del cuore selettivo, di una piccola convoluzione causale (un mini-filtro che mescola qualche parola vicina) per funzionare bene. Ma il conto a due estremi guarda già due campioni vicini, quello di adesso e quello di prima, cioè fa da sé una parte del mescolamento che il filtro forniva: con quello, e con un ritocco in più (un numero fisso aggiunto ai due pezzi che scrivono nella memoria e la rileggono), il filtro diventa opzionale e il modello lavora bene anche senza. Una regola migliore per fare i conti, e una stampella in meno.
Mamba e Mamba-2 discretizzano la transizione con lo zero-order hold, che per la parte di stato è esatto (\(\bar{\mathbf{A}}_t = \exp(\Delta_t \mathbf{A})\), come nella sezione sui sistemi dinamici); il termine d’ingresso, però, viene semplificato al prim’ordine (Eulero): \(\bar{\mathbf{B}}_t = \Delta_t \mathbf{B}_t\), con un errore locale dell’ordine di \(O(\Delta_t^2)\) sul passo. È su questo termine che interviene Mamba-3, con una discretizzazione esponenziale-trapezoidale: un’integrazione del second’ordine che stima il contributo dell’ingresso con una combinazione convessa dei valori agli estremi dell’intervallo,
dove il peso \(\lambda_t \in [0,1]\) è uno scalare deciso dai dati, token per token, esattamente come \(\Delta_t\) (e \(A_t\) è lo scalare negativo che moltiplica l’identità nella transizione al passo \(t\): in Mamba-2 era fisso, e la dipendenza dal token passava tutta per \(\Delta_t\); in Mamba-3 anche \(A_t\) è prodotto dall’ingresso, per uniformità, e il paper riporta prestazioni simili alla versione fissa). La regola classica del trapezio (la media dei due estremi) è il caso \(\lambda_t = 1/2\) e la regola di Eulero di Mamba-2 è il caso \(\lambda_t = 1\): sono due casi particolari di una famiglia di regole. Sotto le ipotesi di regolarità che il paper enuncia (ingresso, \(A_t\) e \(\mathbf{B}_t\) di classe \(C^3\) sul passo, e \(\lambda_t\) dentro un intervallo limitato) l’errore locale scende a \(O(\Delta_t^3)\) a condizione che \(\lambda_t\) resti vicino a \(1/2\) (precisamente \(\lambda_t = 1/2 + O(\Delta_t)\)); fuori da quella condizione il metodo resta del prim’ordine, con una costante che cresce come \(\lvert 1/2 - \lambda_t \rvert\) e che ai due estremi \(\lambda_t \in \{0, 1\}\) vale quanto quella di Eulero. Il paper riporta che imporre quella condizione peggiora i risultati: a 440 milioni di parametri la perplessità è 15,72 con il peso appreso, 15,76 con il peso fisso a \(1/2\) e 15,81 con la regola di Eulero (una cifra per riga, senza barre d’errore). Il second’ordine quindi paga, ma meno del peso che il modello sceglie da solo. La trasformazione bilineare di S4 approssima l’esponenziale di \(\mathbf{A}\); qui il trapezio agisce sul termine d’ingresso data-dipendente, e la transizione resta esponenziale. Resta esatta, però, finché \(A_t\) non dipende dal token: in Mamba-3, dove dipende, il paper approssima separatamente i due integrali, e il second’ordine riguarda il solo termine d’ingresso. La conseguenza riportata nel paper è che la short causal convolution posta prima dell’SSM (presente in tutti i blocchi Mamba precedenti come stabilizzatore) diventa opzionale: insieme a un termine di bias esplicito su \(\mathbf{B}\) e \(\mathbf{C}\), la discretizzazione più fine recupera l’effetto di mescolamento locale che quel filtro forniva; il paper avverte che i due oggetti restano distinti, perché la convoluzione corta agisce su \(x_t\) fuori dalla ricorrenza e questa sul prodotto \(\mathbf{B}_t x_t\) dentro. Vanno insieme, i due ingredienti, e il paper li toglie uno per volta: con la discretizzazione nuova ma senza i bias la qualità cala, e senza nessuno dei due cala ancora.
Il peso \(\lambda_t\), un numero fra zero e uno, decide quanto contano i due estremi dell’intervallo. Fig. 18.5 confronta tre pesi su un solo passo di una curva di prova: non misura Mamba-3, misura la regola di quadratura che Mamba-3 usa. Allontanarsi dalla metà costa quasi uguale dalle due parti: il peso zero, che guarda soltanto il campione precedente, sbaglia quanto il peso uno di Mamba-2 a meno di un decimo, e il minimo cade quasi a metà.
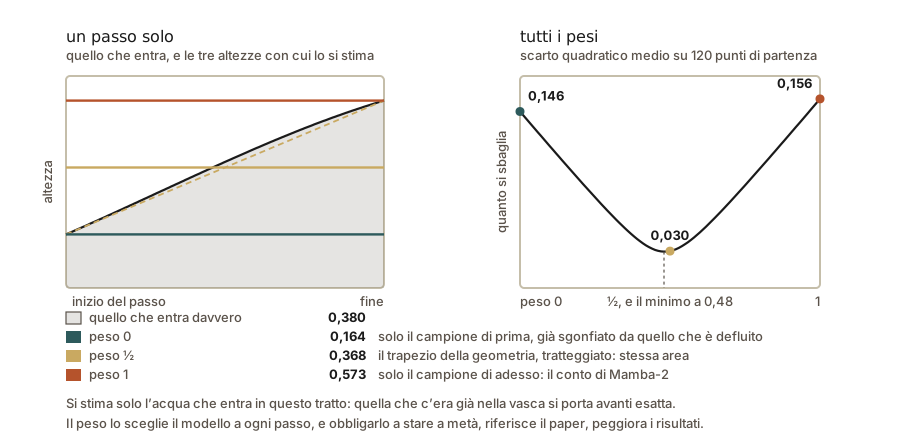
Fig. 18.5 Su una curva di prova, inventata apposta, con un passo tenuto largo perché il gesto si veda. A sinistra quanto entra in un passo, e le tre altezze con cui tre pesi diversi lo stimano; a destra, per ogni peso fra zero e uno, lo scarto medio su 120 punti di partenza. È una conca con il fondo quasi a metà, e i due estremi sbagliano quasi uguale. Il fondo, però, non è dove Mamba-3 tiene il peso: inchiodarlo lì, dice il paper, peggiora i risultati, sia pure di poco. E il vantaggio del fondo dipende dal passo: qui è di quasi cinque volte, e cresce al ridursi del passo, che il modello sceglie da sé, token per token.#
La seconda novità è la più concettuale, ed è quella che riaggancia gli SSM ai Transformer.
Nei modelli selettivi visti finora, Mamba e Mamba-2, lo stato è una collezione di numeri che possono solo crescere o sbiadire: salire di volume e poi spegnersi, come l’eco nella valle. La vasca di S4 sapeva anche ondeggiare, perché i suoi numeri di partenza lo permettevano, ma i modelli selettivi quell’ondeggiare l’avevano lasciato da parte per semplicità. Mamba-3 lo riporta: lo stato può ruotare, oltre che affievolirsi. È come passare da una manopola del volume a una lancetta che può girare su un quadrante: oltre a «quanto forte», ora c’è un «dove sto puntando».
Perché serve? Ci sono compiti in cui la risposta dipende dal contare o dal tenere il segno: capire se il numero di parentesi aperte è pari o dispari, tenere il conto di qualcosa che si ripete a cicli (come le ore su un quadrante, dove dopo il dodici si ricomincia), seguire uno stato che si alterna. Una memoria che sa solo sbiadire fatica; una che sa ruotare può, letteralmente, «girare la lancetta» a ogni passo e ricordare a che punto del ciclo si trova. Sulle parentesi si vede bene: basta che a ogni parentesi la lancetta faccia mezzo giro, e dopo un numero pari di parentesi è tornata esattamente al punto di partenza, dopo un numero dispari è dalla parte opposta del quadrante. Le due situazioni si distinguono a colpo d’occhio, mentre una memoria che può solo affievolirsi non ha modo di tenerle separate. Gli ingegneri lo chiamano state tracking, tenere traccia dello stato, ed è storicamente un punto debole delle ricorrenze lineari.
E qui torna il filo con i Transformer, che è la ragione per cui questa è la più concettuale delle tre novità. Dentro un modello ogni parola è una fila di numeri, che si può guardare come una freccia; e anche i Transformer, per dire a che punto della frase sta una parola, fanno ruotare la sua freccia di un angolo che cresce con la posizione. La differenza è che lì la rotazione viene aggiunta apposta da fuori, mentre qui nasce da sola dal modo in cui la memoria evolve; e l’angolo, invece di dipendere solo da quanto si è andati avanti, dipende da ciò che si sta leggendo.
Mamba-3 riporta nel modello selettivo le transizioni a valori complessi, che S4 aveva (nella sua forma normale più basso rango) e che Mamba e Mamba-2 avevano abbandonato per il caso reale [LLC+26]. La dinamica dello stato diventa una moltiplicazione per un numero complesso, che ha un modulo (il decadimento, come prima) e una fase (una rotazione). Nel piano complesso, moltiplicare per \(e^{i\theta}\) è ruotare di un angolo \(\theta\); ripetendo il passo, lo stato percorre un cerchio. Per la parità basterebbe un autovalore reale negativo, \(-1\), che rovescia il segno a ogni passo: Grazzi e colleghi [GSZ+25] dimostrano che una ricorrenza lineare a precisione finita con autovalori della transizione tutti positivi, come l’\(e^{\Delta_t a} \in (0,1)\) di Mamba-2, la parità non la risolve, e che per contare modulo \(3\) serve che una transizione, o un prodotto di transizioni, abbia un autovalore non reale: una triangolare a elementi reali non basta. La rotazione è proprio questo: con angolo \(2\pi/m\) lo stato torna al punto di partenza ogni \(m\) passi e conta modulo \(m\), cosa che un fattore reale, anche negativo, sa fare solo per \(m = 2\). Il paper documenta un netto miglioramento sui compiti di state tracking.
Il legame con i Transformer è preciso. Il paper mostra che l’SSM complesso equivale a un RoPE data-dipendente applicato alle matrici \(\mathbf{B}\) e \(\mathbf{C}\): l’equivalenza vale già con la discretizzazione di Eulero, per cui un SSM complesso di stato \(N/2\) è un SSM reale di stato \(N\) con transizione a blocchi di rotazioni \(2\times 2\), scalate dal decadimento. RoPE (la Rotary Position Embedding [SAL+24] della struttura del Transformer) inietta la posizione ruotando query e key di un angolo proporzionale all’indice del token, e nel prodotto scalare le due rotazioni si compongono, così che ai punteggi arrivi solo la distanza fra le posizioni. Qui accade lo stesso, con due differenze: le rotazioni si applicano alle controparti SSM di key e query (\(\mathbf{B}\) e \(\mathbf{C}\)), e l’angolo dipende dai dati oltre che dalla posizione, perché il passo \(\Delta\) è selettivo. È l’ennesimo ponte tra le due famiglie: la codifica posizionale rotazionale dei Transformer riemerge, spontaneamente, come la fase di una dinamica di stato complessa.
Il paper verifica che conti proprio la dipendenza dai dati, con un controllo. Misurando un’accuratezza riscalata (100 la risposta sempre giusta, 0 il tirare a indovinare), sulla parità e sull’aritmetica modulare senza parentesi Mamba-3 arriva a 100 e a 98,5; con un RoPE standard, ad angoli fissi, scende a 1,6 e a 20,7, e Mamba-2 si ferma a 0,9 e a 47,8 [LLC+26]. La rotazione da sola non basta: serve che l’angolo lo scelga la parola.
La terza novità è più ingegneristica.
Ogni canale tiene il suo pezzo di memoria e, a ogni parola, ci scrive una voce e ne rilegge una. Mamba-3 gli fa scrivere e rileggere più voci per parola (nel paper, quattro) sullo stesso pezzo di memoria, che non diventa più grande. Il vantaggio sta nel modo di lavorare delle schede grafiche: andare a prendere i dati in memoria costa più che farci i conti sopra, quindi conviene, a ogni viaggio, portare a casa più lavoro utile. Il risultato pratico è una qualità un po’ migliore senza rallentare la generazione: l’attesa tra una parola prodotta e la successiva resta quasi la stessa.
Mamba-2 e i suoi predecessori sono, nella loro forma base, sistemi a singolo ingresso e singola uscita (SISO): ogni canale evolve con un proprio stato, indipendente, e \(\mathbf{B}_t\) e \(\mathbf{C}_t\) sono vettori. Mamba-3 propone una formulazione MIMO (multi-input multi-output, come per S5), in cui più ingressi e più uscite condividono lo stesso stato attraverso matrici \(\mathbf{B}\) e \(\mathbf{C}\) non più vettoriali ma di rango maggiore. In formule, con lo stato scritto come nella dualità e la discretizzazione di Eulero per brevità, la ricorrenza SISO di una testa è \(\mathbf{S}_t = a_t\, \mathbf{S}_{t-1} + \Delta_t\, \mathbf{x}_t \mathbf{B}_t^\top\), con \(\mathbf{S}_t \in \mathbb{R}^{P\times N}\), \(\mathbf{x}_t \in \mathbb{R}^{P}\) e \(\mathbf{B}_t \in \mathbb{R}^{N}\). Nel MIMO di rango \(R\), \(\mathbf{x}_t \in \mathbb{R}^{P\times R}\) e \(\mathbf{B}_t \in \mathbb{R}^{N\times R}\) (e così \(\mathbf{C}_t\)): la scrittura \(\mathbf{x}_t\mathbf{B}_t^\top\) diventa una somma di \(R\) prodotti esterni, cioè un prodotto fra matrici; lo stato resta \(P \times N\), le operazioni del passo crescono di un fattore \(R\) e la quantità di byte letti, dominata dallo stato, resta quasi invariata. L’effetto tecnico è aumentare l’intensità aritmetica (il numero di operazioni per ogni byte letto dalla memoria), che è proprio ciò che tiene occupati i tensor core. Per un passo di decodifica SISO questa intensità vale circa 2,5 operazioni per byte, contro le circa 295 che servono a saturare i tensor core di una H100 in mezza precisione, e il MIMO la fa crescere linearmente con \(R\) (nel paper, \(R = 4\)). Il guadagno pratico riportato è qualità migliore senza aumentare apprezzabilmente la latenza di decodifica, cioè senza rallentare la generazione token per token [LLC+26].
Da S4 a Mamba-3: cosa è cambiato#
S4 è un SSM invariante nel tempo, con \(\mathbf{A}\) inizializzata da HiPPO perché lo stato ricordi a lungo e con una struttura (normale più basso rango) che rende il filtro \(\bar{\mathbf{K}}\) calcolabile in tempo quasi lineare. Poiché i parametri non dipendono dall’ingresso, la stessa funzione si calcola come ricorrenza o come convoluzione, ma il modello non può scegliere che cosa ricordare.
Mamba-1 rende \(\Delta_t\), \(\mathbf{B}_t\) e \(\mathbf{C}_t\) funzioni dell’ingresso. Il sistema diventa selettivo, perde il filtro unico e si addestra con uno scan parallelo eseguito nella memoria veloce della GPU, che non usa i tensor core.
Mamba-2 restringe la transizione a uno scalare per l’identità, \(\bar{\mathbf{A}}_t = a_t\mathbf{I}\). A questa condizione l’SSM calcola la stessa funzione di un’attenzione lineare mascherata (la dualità SSD): si scrive a blocchi come prodotto di matrici sui tensor core, e può avere uno stato molto più grande, organizzato in teste. È il gradino su cui le due strade, dall’attenzione e dai sistemi dinamici, si incontrano.
Mamba-3 lascia l’impianto e cambia tre cose dentro la ricorrenza: una discretizzazione esponenziale-trapezoidale con peso \(\lambda_t\) appreso (che rende opzionale la convoluzione corta), transizioni a valori complessi, equivalenti a un RoPE dipendente dai dati su \(\mathbf{B}\) e \(\mathbf{C}\), che permettono di tenere il conto, e la formulazione MIMO, che a parità di stato fa più calcolo per byte letto. Il filo è sempre lo stesso, comprimere il passato in uno stato di dimensione fissa, e ogni versione sposta qualcosa: su che cosa vi si scrive, su come lo si calcola, su che cosa lo stato può rappresentare.
Da ricordare
Mamba-2 nasce da un problema pratico: dentro la scheda grafica c’è una pressa specializzata che sa fare una cosa sola, moltiplicare matrici, ed è lì che sta quasi tutta la potenza disponibile. Lo scan di Mamba-1, fatto di operazioni minute, la lasciava spenta.
La dualità stato-attenzione (Dao e Gu, 2024) è il ponte esplicito con il capitolo sull’attenzione: appena si sceglie la versione più semplice dello stato (tutti i canali di una testa sbiadiscono allo stesso ritmo), un SSM fa lo stesso conto di un’attenzione senza softmax che guarda solo all’indietro, dove ogni confronto fra due parole è pesato da quanto è sopravvissuto nel frattempo. Le due famiglie si incontrano su quel gradino, e fuori da lì restano parenti; sul gradino, lo stesso conto si fa passo dopo passo oppure formando la grande tabella dei confronti.
È lo stesso gradino che nello «zoo» delle ricorrenze del capitolo precedente portava già il nome di Mamba-2: le due strade, dall’attenzione e dai sistemi dinamici, si incontrano lì.
Quella rinuncia (i canali di uno stesso gruppo dimenticano tutti alla stessa velocità), una perdita vera ma piccola, dà ai conti la forma che la pressa accetta: tutto diventa moltiplicazione di tabelle. Non si fanno meno operazioni, se ne fanno di un tipo che la macchina digerisce meglio. In più la memoria si organizza a gruppi (le teste, come nell’attenzione) e il pezzo di memoria di ogni canale può diventare molto più capiente.
Mamba-3 (Lahoti et al., 2026) non cambia l’impianto, ne raffina la dinamica con tre mosse. I conti sull’intervallo si rifanno guardando tutti e due gli estremi invece del solo valore di adesso, con il peso dei due deciso volta per volta dal modello: a metà e metà il conto è il più preciso, inchiodarlo lì fa già meglio dei rettangoli, e lasciarlo libero guadagna ancora un poco. Il mini-filtro che stava prima del cuore selettivo diventa così opzionale, perché il conto a due estremi mescola già i campioni vicini, purché si aggiunga il numero fisso che l’accompagna. Lo stato, oltre a sbiadire, sa ruotare come una lancetta su un quadrante, ed è utile per contare e tenere il segno. E ogni canale scrive e rilegge più voci a ogni parola sullo stesso pezzo di memoria, il che dà più qualità senza rallentare la generazione. Le differenze misurate sono piccole.
L’arco S4 → Mamba → Mamba-2 → Mamba-3: da un sistema che tratta ogni token con la stessa regola e ricorda a lungo, a uno che sceglie cosa ricordare, a uno riconciliato con l’attenzione e veloce, a uno raffinato nel modo in cui la memoria evolve (sempre la stessa idea: comprimere il passato in un riassunto che non cresce mai).
Da ricordare
Mamba-2 nasce da un problema pratico: lo scan di Mamba-1 non usa i tensor core della GPU, l’hardware dedicato a moltiplicare matrici, e lascia gran parte della potenza inutilizzata.
La State Space Duality (Dao e Gu, ICML 2024) è il ponte esplicito con il capitolo sull’attenzione: un SSM con \(\mathbf{A} = a\mathbf{I}\), cioè con transizione discreta \(\bar{\mathbf{A}}_t = a_t \mathbf{I}\) (uno scalare per l’identità), calcola la stessa funzione di un’attenzione lineare mascherata, \(\mathbf{Y} = (\mathbf{M} \odot \mathbf{C}\mathbf{B}^\top)\mathbf{X}\) con maschera causale \(\mathbf{M}\) \(1\)-semiseparabile (il paper la chiama \(\mathbf{L}\); qui \(L\) è la lunghezza). La stessa funzione ha una forma lineare/ricorrente \(O(L)\) e una quadratica/attention-like. Fuori da questa classe le due famiglie si intersecano soltanto: un SSM generale ha una matrice \(N\)-semiseparabile che non si fattorizza così, e la softmax non ha un SSM equivalente.
È lo stesso gradino (il decadimento scalare \(\alpha_t \mathbf{I}\)) che occupava la riga «Mamba-2» nello «zoo» delle ricorrenze lineari: le due strade, dall’attenzione e dai sistemi dinamici, si incontrano su quella riga.
La restrizione \(\mathbf{A} = a\mathbf{I}\) (diagonale tutta uguale, mentre Mamba-1 aveva valori distinti) è una perdita di espressività che gli autori giudicano piccola, e rende il calcolo quasi tutto moltiplicazione di matrici, con costo \(O(L\,Q\,(N+P) + L\,N\,P)\) a blocchi di lunghezza \(Q\): non meno operazioni della ricorrenza pura, ma operazioni che stanno sui tensor core. Ne seguono la struttura multi-head e uno stato molto più grande (da \(N=16\) a \(64\)–\(256\) e oltre).
Mamba-3 (Lahoti et al., ICLR 2026, Oral) raffina la dinamica con tre mosse: discretizzazione esponenziale-trapezoidale (combinazione convessa degli estremi con peso \(\lambda_t\) data-dipendente; il trapezio classico è \(\lambda_t=1/2\), Eulero è \(\lambda_t=1\)), che è una famiglia e non un metodo: il second’ordine vale solo se \(\lambda_t\) resta vicino a \(1/2\), e fuori di lì si torna al prim’ordine con la costante di Eulero ai due estremi; a 440 milioni di parametri la perplessità è 15,72 con il peso appreso, 15,76 a \(1/2\) e 15,81 con Eulero. Insieme a un bias esplicito su \(\mathbf{B}\) e \(\mathbf{C}\) rende opzionale la convoluzione causale corta; stato complesso con aggiornamenti rotazionali, che S4 aveva e i modelli selettivi avevano abbandonato (migliore state tracking, con un legame formale al RoPE data-dipendente su \(\mathbf{B}\) e \(\mathbf{C}\)); e formulazione MIMO (più qualità senza aumentare la latenza di decodifica). Modelli fino a 1,5 miliardi di parametri, una cifra per configurazione, senza barre d’errore.
L’arco S4 → Mamba → Mamba-2 → Mamba-3: da tempo-invariante a lungo raggio, a selettivo, a riconciliato con l’attenzione e veloce, a raffinato nella dinamica (sempre la stessa idea di comprimere il passato in uno stato di dimensione fissa).