


Scrivere meglio nella memoria: gate e delta rule#
L’attenzione lineare causale è una rete ricorrente: al posto della KV cache, che cresce a ogni token, ha un’unica memoria \(\mathbf{S}_t\) di dimensione fissa. Ogni token vi scrive un’associazione chiave → valore, sommandola a quelle già presenti, e una query la legge moltiplicandola per \(\mathbf{S}_t\), invece di scorrere tutto il contesto.
Il registro della sala si usa come una rubrica: alla voce di un’etichetta si legge l’informazione che le corrisponde. È una rubrica particolare, che non ha una riga per contatto: ha un numero fisso di caselle, e ogni voce nuova si somma a quello che c’è già scritto. Quando le chiedi «che cosa corrisponde a questa etichetta?», lei non pesca una riga: risponde con un miscuglio, in cui pesa soprattutto l’informazione scritta sotto l’etichetta più somigliante, più un po’ di tutte le altre. Finché le etichette sono ben diverse fra loro quel «po’ di tutte le altre» è trascurabile, ed è per questo che il trucco funziona.
In formule, con la scrittura snella delle architetture moderne (la feature map è assorbita nelle proiezioni che producono \(\mathbf{k}_t\) e \(\mathbf{q}_t\), come in GLA che non ne usa nessuna o in DeltaNet che vi mette una SiLU seguita dalla normalizzazione \(L_2\), e il normalizzatore \(\mathbf{z}_t\) non compare),
letta applicando lo stato alla query, \(\mathbf{o}_t = \mathbf{S}_t\, \mathbf{q}_t\). Qui \(\mathbf{k}_t\), \(\mathbf{v}_t\) e \(\mathbf{q}_t\) sono le chiavi, i valori e le query che conosciamo dall’attenzione dei Transformer, \(\mathbf{v}_t \mathbf{k}_t^\top\) è il prodotto esterno che scrive il valore sotto la sua chiave, e \(\mathbf{S}_t\) è la memoria dopo aver letto i primi \(t\) token.
I due difetti dell’accumulo, che non dimentica e non corregge, hanno due rimedi: il gate, che fa decadere ciò che è scritto, e la delta rule, che scrive soltanto la differenza fra il valore giusto e quello che la memoria già restituisce. Su questi due meccanismi e sulle loro combinazioni si costruiscono le ricorrenze lineari, le memorie di taglia fissa riscritte a ogni token che tengono insieme l’attenzione lineare e gli State Space Model.
Dimenticare: i gate#
La prima idea è lasciare che le voci vecchie sbiadiscano da sole. Invece di tramandare la memoria intatta, la si moltiplica a ogni passo per un fattore di decadimento minore di uno: ciò che è stato scritto tempo fa pesa sempre meno, finché svanisce. È il gate di dimenticanza, il cancello che nelle LSTM dei modelli di sequenza decideva che cosa lasciar andare: lo stesso forget gate che Gers, Schmidhuber e Cummins aggiunsero alle LSTM nel 2000 [GSC00]. Qui torna nella sua forma più spoglia, un numero fra zero e uno che moltiplica la memoria.
Sul registro l’inchiostro sbiadisce, come su una lavagna (sono lo stesso foglio, raccontato con un’altra immagine). A ogni passo tutte le voci si affievoliscono un po’: quelle appena scritte sono nitide, quelle vecchie quasi invisibili. Se il fattore di sbiadimento è \(0{,}9\), dopo dieci passi una voce vale \(0{,}9^{10} \approx 0{,}35\) di quanto valeva: circa un terzo. La lavagna così non si satura mai, perché fa spazio da sola buttando via il passato lontano.
Quel numero, lo \(0{,}9\), non lo sceglie nessuno a mano parola per parola. Ci sono tre modi di deciderlo, ed è la scala su cui si dispongono i modelli di questa famiglia. Nel primo è fissato una volta per tutte quando il modello viene progettato, e non cambia mai (è la strada di RetNet, che si incontra con le architetture lineari). Nel secondo il modello lo calcola parola per parola a partire da ciò che sta leggendo: davanti a una cosa importante sbiadisce poco, davanti a un intercalare, un «cioè» o un «insomma», sbiadisce molto (è la strada di Mamba-2, un modello degli State Space Model che, da questo lato, si comporta esattamente così). Nel secondo caso non c’è nessun valore da tenere, perché a essere stato appreso durante l’addestramento è il modo di ricalcolarlo a ogni parola.
E c’è un terzo modo, il più fine. Sbiadire tutta la lavagna allo stesso ritmo è grossolano: magari in una parte della lavagna c’è un dettaglio che servirà ancora fra mille parole, in un’altra solo appunti usa-e-getta. Meglio poter sbiadire una zona della lavagna alla volta: tenere nitida quella con le cose che contano (fattore \(0{,}99\), quasi non svanisce) e cancellare in fretta quella degli appunti di servizio (fattore \(0{,}5\), dimezza a ogni passo). È la differenza tra abbassare le luci di tutta la stanza e regolare ogni lampada singolarmente.
Le zone, poi, non sono zone a caso. Dentro il modello l’etichetta di una voce è una fila di numeri, e le posizioni di quella fila si chiamano canali. La lavagna è divisa in colonne, una per canale, e sono quelle le zone. Ogni voce nuova si spalma su tutte, e ogni colonna ha il suo fattore di sbiadimento, il suo cancello, che sbiadisce quella e nessun’altra. Neanche questi fattori li sceglie una persona: il modello li ricalcola a ogni parola, come faceva col fattore unico buono per tutta la lavagna, solo che adesso ne ricalcola una fila intera invece di uno solo. Il modello che lo fa si chiama GLA, cioè attenzione lineare con i cancelli (in inglese gated linear attention).
La forma più semplice è il decadimento scalare: un unico numero \(\alpha_t \in (0,1)\) moltiplica l’intera memoria,
dove \(\alpha_t\) è il gate di dimenticanza al passo \(t\) e \(\mathbf{v}_t \mathbf{k}_t^\top\) è la nuova voce scritta. È la ricorrenza di RetNet [SDH+23], dove \(\alpha_t = \gamma\) è una costante fissata a priori (data-indipendente), diversa per ciascuna testa così da coprire orizzonti temporali diversi; ed è anche quella di Mamba-2 [DG24], dove invece \(\alpha_t\) è prodotto dall’input, quindi data-dipendente (Mamba-2 è un modello a spazio degli stati, e lo presenta per intero il capitolo sugli State Space Model). Srotolando la ricorrenza si vede cosa fa il gate: il contributo scritto al passo \(j\) arriva al passo \(t\) pesato per \(\prod_{i=j+1}^{t}\alpha_i\), cioè decade in modo (quasi) esponenziale con la distanza.
Uno scalare, però, applica la stessa dimenticanza a tutte le dimensioni della memoria. La Gated Linear Attention (GLA) di Yang e colleghi, presentata all’ICML 2024 [YWS+24], la rende molto più fine sostituendo lo scalare con un gate diagonale:
dove ora \(\boldsymbol{\alpha}_t \in (0,1)^d\) è un vettore di gate, uno per canale di chiave (il grassetto lo distingue dallo scalare \(\alpha_t\) della formula precedente: stesso ruolo, una componente sola contro \(d\)), e \(\operatorname{Diag}(\boldsymbol{\alpha}_t)\) è la matrice diagonale che ne fa i coefficienti. Il lato da cui moltiplica cambia il risultato: con la convenzione \(\mathbf{S} = \sum_i \mathbf{v}_i \mathbf{k}_i^\top\) e la lettura \(\mathbf{o} = \mathbf{S}\mathbf{q}\), le colonne di \(\mathbf{S}\) sono indicizzate dai canali della chiave e le righe da quelli del valore, quindi moltiplicando da destra ogni colonna decade al proprio ritmo, che è quel che si vuole; da sinistra sbiadirebbero i canali del valore, che è un’altra cosa. (Anche la transizione della delta rule, fra poco, sta da quel lato e per la stessa ragione.) Così \(\alpha_{t,i}\to 1\) conserva il canale \(i\) (nel limite si torna all’accumulo puro), \(\alpha_{t,i}\to 0\) lo azzera. Il vettore è ricavato dall’input con una proiezione a basso rango (un collo di bottiglia di dimensione 16) seguita da una sigmoide, per generare \(d\) gate distinti senza far esplodere il numero di parametri. La sigmoide è poi elevata a \(1/\tau\) con \(\tau = 16\), un esponente che gli autori chiamano temperatura e che spinge i gate verso 1, rallentando l’oblio. In formule \(\boldsymbol{\alpha}_t = \sigma\big(\mathbf{W}^2_\alpha \mathbf{W}^1_\alpha \mathbf{x}_t + \mathbf{b}_\alpha\big)^{1/\tau}\), dove \(\mathbf{W}^1_\alpha\) porta l’ingresso \(\mathbf{x}_t\) da \(d_{\text{model}}\) a 16, e \(\mathbf{W}^2_\alpha\) lo porta da 16 alla dimensione \(d\) delle chiavi (in GLA le chiavi hanno, in tutto, metà della dimensione del modello). La gerarchia è chiara: scalare fisso (RetNet) \(\to\) scalare data-dipendente (Mamba-2) \(\to\) diagonale data-dipendente (GLA), dal più grossolano al più selettivo.
Il gate attenua il primo difetto, la saturazione, al prezzo di dimenticare anche ciò che servirebbe: nei test in cui bisogna ritrovare un dato nascosto in un testo lungo, Mamba-2, che decade troppo in fretta, peggiora molto oltre i 2000 token [YKH25]. Il secondo difetto non lo tocca: per quanto si sbiadisca, ogni scrittura resta un’aggiunta cieca, e nessuno controlla se quella voce contraddice ciò che c’è già.
Correggere: la delta rule#
La seconda idea si dice in una riga: prima di scrivere, guardare che cosa c’è già scritto. Ha radici lontane, e per vederle si passa da una scoperta del 2021 sulla regola con cui la memoria si riscrive.
In quell’anno Schlag, Irie e Schmidhuber si accorgono che l’attenzione lineare (nei paper la chiamano anche Transformer lineare) è a tutti gli effetti una rete che Schmidhuber aveva progettato negli anni Novanta, il fast weight programmer, il «programmatore di pesi veloci» [SIS21]. Il nome dice che in queste reti convivono due memorie con due velocità: i pesi lenti, cioè i parametri della rete, appresi durante l’addestramento e poi fissi mentre il modello si usa, e i pesi veloci, la matrice \(\mathbf{S}_t\), che cambia a ogni token. La rete lenta non contiene le risposte: contiene le istruzioni con cui, mentre legge, riscrive la memoria veloce. E se la rete riscrive da sé la propria memoria, la regola con cui lo fa si può scegliere: l’attenzione lineare somma prodotti esterni e basta (è la regola di covarianza delle memorie associative), la delta rule prima guarda che cosa la memoria contiene già.
Una cifra nuova da annotare, e due modi di farlo. Il primo è sommarla a quella che c’era senza nemmeno guardare. Se alla voce di quel nome c’era già una cifra, magari sbagliata, le due scritte si sommano, e chi consulta la rubrica si sente rispondere un miscuglio in cui non si riconosce più né la cifra vecchia né quella nuova.
Il secondo modo è quello di chi prima cerca la voce e legge quello che c’è. Alla voce «Mario» la rubrica oggi risponde che mi deve \(7\) euro, e il conto giusto è \(10\). La differenza è \(10 - 7 = 3\), e si annota soltanto quella. Quanta annotarne lo decide una dose, un numero fra zero e uno che nelle formule si chiama beta e si scrive \(\beta\). A metà dose scrivo \(0{,}5 \times 3 = 1{,}5\), e da lì in avanti alla voce «Mario» la rubrica risponde \(8{,}5\), più vicina alla verità senza aver cancellato niente di colpo. A dose piena, con \(\beta = 1\), la cifra vecchia sparisce e resta il \(10\). A dose zero resta il \(7\). Annotare soltanto la differenza si chiama delta rule, ed è il gesto di chi corregge un tiro, spostandosi di quanto ha sbagliato invece di ripartire da capo.
Lo stesso gesto si può fare in un altro ordine, e il numero che ne esce è identico. Invece di annotare la differenza, cancello metà del \(7\) e ci scrivo metà del \(10\), e resta \(3{,}5 + 5 = 8{,}5\), lo stesso di prima. Quanto cancellare e quanto riscrivere lo decide la stessa dose. Ecco perché a dose zero la voce resta com’era: quello che si scrive è la correzione, e a dose zero non si cancella niente e non si scrive niente.
La dose piena, però, fa sparire la cifra vecchia solo se tutte le etichette sono scritte con la stessa forza. Se «Mario» fosse scritto col pennarello, e pesasse quindi il doppio nel conto, la dose piena correggerebbe il doppio dell’errore. Dal \(7\) arriverei a \(13\), e da lì sbaglierei di \(3\) dall’altra parte, quindi al giro dopo tornerei a \(7\), avanti e indietro per sempre senza fermarmi mai sul \(10\), come il tiratore che esagera ogni correzione e la manda ogni volta dall’altra parte del bersaglio. Per questo chi tiene una rubrica così riporta prima tutte le etichette alla stessa misura.
La dose non la sceglie una persona. Il modello la calcola da sé a ogni parola, in base a quello che sta leggendo, e come per il fattore di sbiadimento a essere stato appreso durante l’addestramento è il modo di ricalcolarla. Correggere in proporzione all’errore è una vecchia idea dell’ingegneria, e la misero in formula Widrow e Hoff nel 1960, per una macchina che imparava aggiustandosi da sé.
Al passo \(t\), prima di scrivere, si interroga la memoria con la chiave corrente e si ottiene il valore che essa già predice per quella chiave,
Qui \(\bar{\mathbf{v}}_t\) è la «vecchia risposta»: ciò che la memoria restituisce oggi alla chiave \(\mathbf{k}_t\). La delta rule scrive allora soltanto l’errore \(\mathbf{v}_t - \bar{\mathbf{v}}_t\), scalato da un learning-rate \(\beta_t \in (0,1)\) appreso dinamicamente (\(\beta_t = \sigma(\mathbf{w}_\beta^\top \mathbf{x}_t)\), dove \(\mathbf{x}_t\) è il vettore in ingresso al passo \(t\), \(\mathbf{w}_\beta\) un vettore di pesi appresi e \(\sigma\) la sigmoide, che tiene \(\beta_t\) fra \(0\) e \(1\)):
È la regola di Widrow–Hoff (o LMS) [WH60], il mattone dell’apprendimento adattivo. Raccogliendo i termini si ottiene la forma di Householder generalizzata, che mette in evidenza la transizione di stato:
dove \(\mathbf{I}\) è l’identità e \(\mathbf{k}_t \mathbf{k}_t^\top\) è il prodotto esterno della chiave con se stessa. Il fattore \((\mathbf{I} - \beta_t \mathbf{k}_t \mathbf{k}_t^\top)\) agisce come una transizione di stato che cancella la vecchia traccia lungo la direzione \(\mathbf{k}_t\) appena prima di scriverci quella nuova: per \(\beta_t \to 1\) e chiave di norma unitaria la voce di \(\mathbf{k}_t\) viene sovrascritta del tutto (\(\mathbf{S}_t\mathbf{k}_t = \mathbf{v}_t\)), per \(\beta_t \to 0\) la memoria resta intatta (i due estremi sono limiti, perché la sigmoide non li raggiunge). I suoi autovalori valgono tutti \(1\) tranne uno, che vale \(1 - \beta_t \lVert \mathbf{k}_t \rVert^2\), e perché cadano tutti in \([0,1]\) basta che \(\beta_t \lVert \mathbf{k}_t \rVert^2 \le 1\): a garantirlo si normalizzano le chiavi, in norma \(L_1\) in Schlag e colleghi e in norma \(L_2\) in DeltaNet [YWZ+24], dove con \(\beta_t = 1\) il fattore diventa un proiettore. La sua norma spettrale, però, resta esattamente \(1\), quindi il fattore non è una contrazione: restringe una direzione sola e lascia intatte le altre.
Senza il normalizzatore \(\mathbf{z}_t\), abbandonato già da Schlag e colleghi, GLA e DeltaNet stabilizzano la lettura con una normalizzazione sull’uscita (una LayerNorm in GLA, una RMSNorm in DeltaNet), e lo stato lo tengono limitato in due modi diversi: in DeltaNet la normalizzazione delle chiavi tiene gli autovalori della transizione dentro \([0,1]\); in GLA le chiavi sono una proiezione lineare secca, e a tenere limitato lo stato è il gate \(\boldsymbol{\alpha}_t \in (0,1)^d\), che sbiadisce la memoria a ogni passo.
Resta un problema pratico. Il gate si può anticipare: \(\alpha_t\) dipende solo dall’ingresso, quindi i prodotti \(\prod_i \alpha_i\), che dicono quanto resterà fra dieci token di ciò che si scrive adesso, si calcolano per tutti i passi insieme, distribuiti su molte unità di calcolo. La correzione no: \(\mathbf{v}_t - \mathbf{S}_{t-1}\mathbf{k}_t\) dipende dallo stato precedente. Per sapere che cosa scrivere al token numero cento bisogna prima sapere che cosa la memoria risponde al token numero cento, e quello dipende da tutte le novantanove correzioni precedenti: in questa forma, la ricorrenza impone di completare ogni passo prima di calcolare il successivo.
Il modello con la delta rule è dunque nato subito, ma nato lento. Lo propongono nel 2021 gli stessi Schlag, Irie e Schmidhuber, che lo addestrano davvero come modello linguistico e lo battezzano Delta Network, nome che la letteratura successiva scriverà tutto attaccato, DeltaNet. L’algoritmo che avevano, però, procede in fila lungo la sequenza: sfrutta male l’hardware parallelo e non regge oltre le taglie piccole. Nel 2024, alla conferenza NeurIPS, Yang e colleghi lo sbloccano con un algoritmo chunk-parallel, che spezza la sequenza in blocchi e dentro ogni blocco fa i conti tutti insieme [YWZ+24]. Il trucco è che le correzioni non hanno bisogno delle memorie intermedie. Lo stato si riscrive come una somma di prodotti esterni, \(\mathbf{S}_t = \sum_{i\le t}\mathbf{u}_i\mathbf{k}_i^\top\), in cui al posto del valore c’è uno pseudo-valore, \(\mathbf{u}_t = \beta_t\big(\mathbf{v}_t - \sum_{i<t}\mathbf{u}_i\,(\mathbf{k}_i^\top\mathbf{k}_t)\big)\), che dipende soltanto dalle chiavi e dagli pseudo-valori precedenti. Dentro un blocco di \(B\) token gli pseudo-valori si ricavano tutti insieme risolvendo un sistema triangolare (ogni equazione usa soltanto le soluzioni delle precedenti), a costo \(O(B^2 d)\) e senza toccare le memorie di mezzo; nei paper è la rappresentazione WY. Al blocco successivo passa solo la memoria di fine blocco, e da lì in avanti la delta rule è addestrabile alla scala dei modelli linguistici.
Il guadagno si vede sui compiti di richiamo, quelli in cui bisogna ritrovare il valore legato a una chiave incontrata prima. A 340 milioni di parametri e a parità di dimensione dello stato, DeltaNet supera GLA su tre compiti di richiamo presi da testi veri, SWDE, SQuAD e FDA [YWZ+24]. Rispetto alla somma pura il vantaggio della correzione si vedeva già nel modello di Schlag e colleghi, che su WikiText-103, nella configurazione piccola, porta la perplessità di validazione da \(37{,}1\) a \(34{,}1\) (più è bassa, meglio è) [SIS21]. A 1,3 miliardi di parametri, invece, la parità di memoria non si riesce a tenere: lì DeltaNet ha uno stato più piccolo di quello di GLA, e sui compiti di richiamo GLA lo supera.
La prova dell’errore di richiamo, rifatta con la delta rule al posto della somma, mostra il guadagno in piccolo: stesse chiavi di norma unitaria, stessa memoria \(32\times 32\), e in più una chiave già usata a cui si riscrive un valore nuovo.
import numpy as np

def scrivi(K, V, regola):
    """Memoria d x d dopo aver scritto le coppie (k, v) in ordine."""
    S = np.zeros((K.shape[1], K.shape[1]))
    for k, v in zip(K, V):
        scritto = v - S @ k if regola == "delta" else v   # delta: l'errore
        S += np.outer(scritto, k)
    return S

def prova(N, d=32, prove=2000, seme=0):
    rng = np.random.default_rng(seme)
    err = {"somma": [], "delta": []}     # richiamo delle N associazioni
    nuovo = {"somma": [], "delta": []}   # valore riscritto sotto la chiave 0
    for _ in range(prove):
        K = rng.standard_normal((N, d))
        K /= np.linalg.norm(K, axis=1, keepdims=True)   # chiavi di norma 1
        V = rng.standard_normal((N, d))
        v_nuovo = rng.standard_normal(d)
        for regola in err:
            S = scrivi(K, V, regola)
            letto = (S @ K.T).T
            err[regola].append((np.linalg.norm(letto - V, axis=1)
                                / np.linalg.norm(V, axis=1)).mean())
            k0 = K[0]
            scritto = v_nuovo - S @ k0 if regola == "delta" else v_nuovo
            S += np.outer(scritto, k0)
            nuovo[regola].append(np.linalg.norm(S @ k0 - v_nuovo)
                                 / np.linalg.norm(v_nuovo))
    return {r: (np.mean(err[r]), np.mean(nuovo[r])) for r in err}

for N in (8, 16, 32):
    r = prova(N)
    print(f"N={N:2d}  richiamo: somma {r['somma'][0]:.2f}, "
          f"delta {r['delta'][0]:.2f}  | riscrittura: "
          f"somma {r['somma'][1]:.2f}, delta {r['delta'][1]:.2f}")
N= 8  richiamo: somma 0.46, delta 0.30  | riscrittura: somma 1.12, delta 0.00
N=16  richiamo: somma 0.68, delta 0.49  | riscrittura: somma 1.22, delta 0.00
N=32  richiamo: somma 0.99, delta 0.72  | riscrittura: somma 1.43, delta 0.00
La delta rule riduce il limite di capacità senza toglierlo: a \(N = d\) l’errore resta \(0{,}72\), contro \(0{,}99\) della somma. Sul valore riscritto la somma sbaglia di più del valore stesso, perché restituisce il vecchio sommato al nuovo; la delta rule lo restituisce esatto, perché le chiavi hanno norma uno e \(\beta_t = 1\).
Unire oblio e correzione: Gated DeltaNet#
Dal momento che gate e delta rule curano difetti diversi, si possono combinare. Il gate scalare, che sbiadisce tutta la memoria con lo stesso fattore, svuota in fretta, ma in modo uniforme e indiscriminato: non sa cosa sta buttando via. La delta rule fa correzioni mirate su singole chiavi, ma da sola non svuota: tende a lasciare la memoria piena di tracce, sia pure aggiustate. Le due mosse sono dunque complementari, e le tiene insieme Gated DeltaNet, di Yang (MIT) con Kautz e Hatamizadeh (NVIDIA), presentato alla conferenza ICLR nel 2025 [YKH25].
Torniamo alla lavagna e alla rubrica, che sono lo stesso oggetto con due nomi. Ogni volta che arriva una parola nuova si fanno due gesti, in quest’ordine. Primo: si passa uno straccio su tutta la lavagna, che sbiadisce quello che c’era senza guardare cosa fosse. Secondo: si cerca la voce che riguarda la parola appena letta, si legge cosa dice adesso e si scrive sopra soltanto la correzione, come faceva la rubrica di Mario.
I due gesti si occupano di due problemi diversi e non si pestano i piedi. Lo straccio fa spazio, e serve perché la lavagna non arrivi mai piena; la correzione tiene in ordine le voci che restano, e serve perché quello che c’è scritto sia giusto. Se si smette di passare lo straccio, resta la sola correzione: le voci sono precise, ma la lavagna a un certo punto si riempie. Se si smette di correggere, resta il solo straccio, e questa è la parte sorprendente: non si ottiene la lavagna che sbiadisce e ci somma sopra le voci nuove, si ottiene una lavagna che sbiadisce e non scrive più niente. È la conseguenza vista con Mario: la dose a zero spegneva la correzione e con lei la scrittura, perché quel che si scrive è la correzione. Per questo Gated DeltaNet senza correzione è un’altra cosa da RetNet e da Mamba-2, che sbiadiscono e poi sommano la voce nuova a piena forza. Insieme, invece, i due gesti fanno il mestiere per intero: buttare via in fretta ciò che non serve e tenere in ordine ciò che si conserva.
La ricorrenza combina i due fattori di transizione:
dove i due parametri hanno ruoli distinti e leggibili a colpo d’occhio:
\(\alpha_t \in (0,1)\) è un gate scalare (nella parametrizzazione di Mamba-2): il decadimento globale, che alleggerisce l’intera memoria a ogni passo;
\(\beta_t \in (0,1)\) è la forza di scrittura della delta rule: quanto correggere la chiave corrente, esattamente come in DeltaNet.
Con \(\alpha_t \to 1\) si ritrova la pura delta rule (nessun oblio, sole correzioni). Il limite \(\beta_t \to 0\) va invece letto con attenzione, perché \(\beta_t\) compare anche nel termine di scrittura: la transizione si riduce sì al puro gate scalare \(\alpha_t \mathbf{I}\), ma con la correzione si spegne anche la scrittura, e quel che resta è \(\mathbf{S}_t = \alpha_t \mathbf{S}_{t-1}\), una memoria che decade a zero senza registrare più nulla. Il decadimento scalare puro di RetNet e Mamba-2, invece, non si ritrova come caso particolare: là il gate scalare accompagna una scrittura a piena forza, mentre qui la forza di scrittura è lo stesso \(\beta_t\) che comanda la correzione. Gated DeltaNet contiene la delta rule pura, non il decadimento scalare puro, e vive nel mezzo: dimentica in fretta ciò che non serve più e aggiusta con precisione ciò che tiene. La parallelizzazione lungo la sequenza si ottiene estendendo la stessa rappresentazione WY di DeltaNet, così che anche questa forma più ricca resti addestrabile su contesti lunghi.
Le ricorrenze come regressione online#
Accumulo, gate, delta rule e la loro combinazione sembrano trucchi diversi, e si leggono tutti come passi di ottimizzazione online sullo stesso problema, con obiettivi e decadimenti diversi. Il problema è una regressione lineare con bersaglio vettoriale, della stessa famiglia della retta di best fit: si cerca una matrice \(\mathbf{S}\) tale che \(\mathbf{S}\mathbf{k}_t \approx \mathbf{v}_t\) per ogni coppia letta. È online perché le coppie arrivano una alla volta, e ciascuna si usa una volta sola, senza poter rileggere le precedenti.
Ricordi la retta di best fit? Data una nuvola di punti, cercavamo la retta che minimizza l’errore quadratico: la somma dei quadrati degli scarti tra valori veri e previsti. Facevamo tutto in una volta, con l’intero dataset sotto gli occhi. Indovinare un numero a partire da un altro, come fa la retta, si chiama regressione.
La nostra rubrica fa la stessa cosa, ma un dato alla volta, mentre scorre: è una regressione online, dove «online» non ha niente a che fare con internet e vuol dire «mentre i dati arrivano, senza poterli rileggere». Il suo compito è imparare a rispondere bene: data un’etichetta, restituire l’informazione giusta. A ogni parola arriva una nuova coppia (etichetta, informazione) e la rubrica fa un piccolo passo per rispondere meglio. È la versione «in tempo reale» della retta di best fit: non risolvi il problema in blocco, lo aggiusti in continuazione a ogni esempio che passa. Il passo lo abbiamo già visto in numeri: la rubrica che rispondeva \(7\), dopo la correzione risponde \(8{,}5\), e si avvicina al \(10\) senza arrivarci in un colpo solo. Ecco perché correggere un tiro era l’immagine giusta: la delta rule non assomiglia a imparare, è imparare, come imparano le reti neurali: guardare di quanto si è sbagliato e spostarsi un po’ in quella direzione.
Anche le altre due mosse stanno in questo racconto. Sommare alla cieca è lo stesso passo fatto con meno cura, quello di chi non guarda l’errore: scrive l’informazione nuova come se sotto quell’etichetta non ci fosse ancora niente. Dà lo stesso risultato del passo fatto bene soltanto quando valgono insieme due condizioni: l’etichetta di adesso non somiglia a nessuna di quelle già in rubrica, e la dose è piena. Basta che ne manchi una perché i due modi si separino subito: a metà dose, alla prima parola la rubrica scrive la metà di quello che avrebbe scritto la somma alla cieca. Sbiadire, poi, è la cautela di chi impara di continuo e non si ferma mai: a ogni passo tira un po’ verso lo zero tutto quello che ha imparato finora, così che i conti vecchi non si accumulino senza fine, e di quanto tirare decide parola per parola.
Sommare e correggere sono lo stesso passo, con più o meno cura; sbiadire è la cautela che gli sta accanto.
Fissiamo, a ogni passo, l’obiettivo di regressione online
cioè «mappare la chiave \(\mathbf{k}_t\) nel valore \(\mathbf{v}_t\)», con \(\mathbf{S}\) la memoria da addestrare. Il suo gradiente rispetto a \(\mathbf{S}\) è
e un singolo passo di discesa del gradiente con learning-rate \(\beta_t\), partendo da \(\mathbf{S}_{t-1}\), dà
È esattamente la delta rule di DeltaNet: il passo di gradiente esatto su \(\ell_t\), nella lettura che Yang e colleghi fanno esplicita [YWZ+24] e che risale a Widrow e Hoff [WH60]. Le altre ricorrenze sono parenti meno fedeli dello stesso passo. L’accumulo puro dell’attenzione lineare scrive \(\mathbf{v}_t \mathbf{k}_t^\top\) senza sottrarre ciò che la memoria già predice: equivale a trascurare il termine \(\mathbf{S}_{t-1} \mathbf{k}_t\) nel gradiente, cioè a fare il passo esatto (a learning rate unitario) sull’obiettivo linearizzato \(-\mathbf{v}_t^\top \mathbf{S}\, \mathbf{k}_t\). Con \(\ell_t\) coincide solo se valgono due condizioni: che la memoria non abbia ancora nulla da dire sulla chiave corrente (\(\mathbf{S}_{t-1} \mathbf{k}_t = \mathbf{0}\), per esempio con chiavi mutuamente ortogonali) e che la scrittura sia a piena forza, \(\beta_t = 1\). La prima da sola non basta, e si vede subito: con chiavi ortonormali la delta rule scrive \(\beta_t\, \mathbf{v}_t \mathbf{k}_t^\top\) dove l’accumulo scrive \(\mathbf{v}_t \mathbf{k}_t^\top\), quindi a \(\beta_t = 0{,}5\) le due memorie si separano già al primo token, di un fattore due. E il gate \(\alpha_t\) è, in questa lettura, un weight decay adattivo: la contrazione \(\mathbf{S} \leftarrow \alpha_t \mathbf{S}\) che l’ottimizzazione applica per non lasciare che i vecchi coefficienti si accumulino all’infinito, regolata token per token. Accumulo, gate e delta rule si leggono dunque tutti come un passo di ottimizzazione online sul compito di associare chiavi a valori: cambiano l’obiettivo, quadratico per la delta rule e lineare per l’accumulo, e il decadimento dei pesi, che è il gate. Nel quadro di Liu e colleghi ogni aggiornamento è la soluzione in forma chiusa di un obiettivo online, e l’articolo su Gated DeltaNet ne fa una tabella, dall’attenzione lineare a Mamba-2 e a DeltaNet [LWW+25, YKH25]. Il quadro non comprende tutto: ne restano fuori RWKV-4, il cui stato è un vettore per canale senza associazioni chiave → valore, e la cella sLSTM di xLSTM, la cui ricorrenza non è lineare.
La Fig. 17.4 mette in fila lo «zoo» delle memorie dell’attenzione lineare e degli State Space Model: si parte da quella che tiene tutto e si sale un gradino alla volta, fino all’ultima, che tiene insieme le due mosse. (Nella figura compaiono due nomi che appartengono al seguito: RWKV-6, la sesta versione di un’architettura descritta con le architetture lineari, che sbiadisce zona per zona come GLA, e Mamba-2, che si vede da vicino con gli State Space Model.)

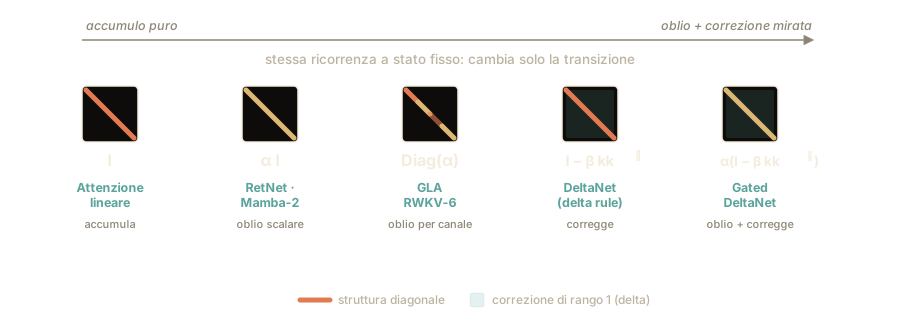
Fig. 17.4 Lo «zoo» delle memorie, in fila da quella che sa fare meno a quella che sa fare di più. Ogni quadrato dice che cosa resta della memoria di ieri, colonna per colonna: sulla diagonale quanto ciascuna conserva di sé, fuori dalla diagonale quanto prende dalle altre. Diagonale piena vuol dire tenere tutto; diagonale scolorita, sbiadire tutto allo stesso modo; diagonale a segmenti, sbiadire zona per zona; fondo velato, cancellare la voce che si sta per riscrivere. L’ultimo riquadro tiene insieme la diagonale scolorita del secondo e il fondo velato del quarto. Il resto del meccanismo cambia poco.#
La stessa storia, messa in tabella: cinque modi di far sopravvivere la memoria di ieri, dal più semplice al più raffinato.
Modello |
Che cosa fa della memoria di ieri |
|---|---|
Attenzione lineare |
La tiene tutta, intatta, e ci somma sopra la voce nuova. |
Mamba-2 / RetNet |
La sbiadisce tutta allo stesso ritmo, poi ci somma sopra la voce nuova. I due si dividono proprio sul ritmo: RetNet lo fissa una volta per tutte, Mamba-2 lo ricalcola a ogni parola. |
GLA |
La sbiadisce zona per zona, ogni zona al suo ritmo, poi ci somma sopra la voce nuova. |
DeltaNet |
Non la sbiadisce, ma prima di scrivere sbianchetta la vecchia voce proprio dell’etichetta che sta per riscrivere, tanto quanto dice la dose, e al suo posto scrive la nuova, nella stessa misura. |
Gated DeltaNet |
Le due cose insieme: sbiadisce tutto, e in più cancella e riscrive la voce di turno. |
Cinque righe, una storia sola: a cambiare è soprattutto la prima mossa, quella che decide che cosa resta di ciò che si era scritto prima. Il resto (la memoria che non cresce mai, la voce che si somma sotto la sua etichetta, il fatto che il modello si alleni tutto in una volta e poi scriva una parola alla volta) è comune a tutte e cinque, con due differenze di contorno. Nelle due righe che correggono, anche quel che si scrive lo decide la dose. E allenarsi tutto in una volta costa a ciascuna un trucco di calcolo diverso, che per chi corregge è stato il più difficile da trovare.
Metodo |
Aggiornamento di \(\mathbf{S}_t\) |
Transizione di stato |
|---|---|---|
Attenzione lineare |
\(\mathbf{S}_t = \mathbf{S}_{t-1} + \mathbf{v}_t\, \mathbf{k}_t^\top\) |
\(\mathbf{I}\) (identità) |
Mamba-2 / RetNet |
\(\mathbf{S}_t = \alpha_t\, \mathbf{S}_{t-1} + \mathbf{v}_t\, \mathbf{k}_t^\top\) |
\(\alpha_t \mathbf{I}\) (decadimento scalare, fisso in RetNet e ricalcolato a ogni passo in Mamba-2; commuta con lo stato) |
GLA |
\(\mathbf{S}_t = \mathbf{S}_{t-1}\operatorname{Diag}(\boldsymbol{\alpha}_t) + \mathbf{v}_t\, \mathbf{k}_t^\top\) |
\(\operatorname{Diag}(\boldsymbol{\alpha}_t)\) (decadimento diagonale, un gate per canale) |
DeltaNet |
\(\mathbf{S}_t = \mathbf{S}_{t-1}(\mathbf{I} - \beta_t\, \mathbf{k}_t \mathbf{k}_t^\top) + \beta_t\, \mathbf{v}_t\, \mathbf{k}_t^\top\) |
\(\mathbf{I} - \beta_t\, \mathbf{k}_t \mathbf{k}_t^\top\) (Householder generalizzata) |
Gated DeltaNet |
\(\mathbf{S}_t = \mathbf{S}_{t-1}\big[\alpha_t(\mathbf{I} - \beta_t\, \mathbf{k}_t \mathbf{k}_t^\top)\big] + \beta_t\, \mathbf{v}_t\, \mathbf{k}_t^\top\) |
\(\alpha_t(\mathbf{I} - \beta_t\, \mathbf{k}_t \mathbf{k}_t^\top)\) (gated-delta) |
Letta dall’alto in basso, la tabella mostra che le ricorrenze si distinguono soprattutto per la transizione di stato, il fattore che moltiplica \(\mathbf{S}_{t-1}\). Restano comuni lo stato di dimensione fissa, la scrittura per prodotto esterno e la doppia forma, parallela per addestrare e ricorrente per generare. Cambiano invece l’algoritmo che rende efficiente la forma parallela (per la delta rule serve la rappresentazione WY, e GLA ha bisogno di un secondo livello di blocchi per la stabilità numerica [YWS+24]) e, nelle due righe con la delta rule, il fattore \(\beta_t\) nel termine di scrittura.
Questa è la struttura comune alle ricorrenze lineari, e gli State Space Model (in sigla SSM) la raggiungono da un’altra strada, quella dei sistemi dinamici. Mamba-2, il modello che sbiadisce tutta la memoria allo stesso ritmo ma decide il ritmo parola per parola, compare due volte, qui fra le attenzioni lineari e là fra gli SSM: è il ponte fra le due famiglie. I suoi autori lo scrivono infatti in due modi, una volta come memoria che si aggiorna e una volta come attenzione, e chiamano dualità quella doppia scrittura.
Da ricordare
Il registro che somma e basta ha due difetti: non dimentica (la pagina si satura di tracce sovrapposte) e non corregge (una voce sbagliata resta scritta). Sono mali diversi, e si curano con due mosse diverse.
Dimenticare: si lascia sbiadire l’inchiostro a ogni passo, così la lavagna fa spazio da sola (con un fattore di \(0{,}9\), dopo dieci passi una voce vale circa un terzo), al prezzo di perdere anche qualcosa che sarebbe servito. Il ritmo si può fissare una volta per tutte, ricalcolare parola per parola, o ricalcolare zona per zona della lavagna: tre gradini dal più grossolano al più selettivo, come abbassare le luci di tutta la stanza o regolare ogni lampada.
Correggere: prima di scrivere si consulta la rubrica e si annota soltanto la differenza fra la risposta che dà e quella giusta, in una dose fra zero e uno. A dose piena la voce viene sovrascritta, purché l’etichetta non sia scritta più marcata del dovuto; a dose zero resta com’era. È la regola di Widrow e Hoff, e per anni è rimasta lenta sui testi lunghi perché va fatta in fila, finché si è trovato il modo di farla a blocchi, in parallelo.
Gated DeltaNet mette insieme i due gesti, che sono complementari: sbiadire alleggerisce tutto ma non sa che cosa butta, correggere aggiusta una voce per volta ma non svuota nulla.
Il filo che unisce tutto: ogni ricorrenza è un piccolo passo di apprendimento fatto al volo, una parola alla volta, sullo stesso compito, «data questa etichetta, rispondi con questa informazione»: la retta di best fit aggiustata di continuo. Correggere è il passo fatto bene; sommare alla cieca dà lo stesso risultato solo se l’etichetta nuova non somiglia a nessuna già scritta e la dose è piena; sbiadire impedisce alla memoria di gonfiarsi.
A cambiare, da un’architettura all’altra, è soprattutto il modo in cui la memoria di ieri sopravvive a oggi; quel che si scrive cambia poco, al più nella dose.
Da ricordare
L’accumulo puro dell’attenzione lineare ha due difetti: non dimentica (la memoria si satura) e non corregge (le voci sbagliate restano). Gate e delta rule li curano separatamente: il gate libera memoria al prezzo di dimenticare anche ciò che serve, la delta rule corregge ma non svuota.
Il gate di dimenticanza moltiplica la memoria per un fattore in \((0,1)\): scalare e fisso in RetNet, scalare e data-dipendente in Mamba-2, diagonale e data-dipendente in GLA; dal più grossolano al più selettivo, canale per canale.
La delta rule (Widrow–Hoff, ritrovata dentro i fast weight programmer di Schmidhuber da Schlag e colleghi, che nel 2021 la portano nel modello che battezzano Delta Network) scrive solo l’errore \(\mathbf{v}_t - \mathbf{S}_{t-1}\mathbf{k}_t\) scalato da \(\beta_t \in (0,1)\): per \(\beta_t \to 1\) e chiave di norma unitaria sovrascrive la voce, per \(\beta_t \to 0\) la lascia com’è. Yang e colleghi (2024) l’hanno resa parallelizzabile con la rappresentazione WY, \(\mathbf{S}_t = \sum_{i\le t}\mathbf{u}_i\mathbf{k}_i^\top\), con pseudo-valori che in ogni blocco si ricavano da un sistema triangolare.
Gated DeltaNet combina i due gesti complementari: \(\alpha_t\) decade in modo globale, \(\beta_t\) corregge in modo mirato (dimentica in fretta e aggiusta con precisione).
Il filo: accumulo, gate e delta rule sono passi di ottimizzazione online sullo stesso problema di regressione, \(\mathbf{S}\mathbf{k}_t \approx \mathbf{v}_t\). La delta rule è il passo di gradiente su \(\ell_t = \tfrac12\lVert\mathbf{S}\mathbf{k}_t - \mathbf{v}_t\rVert^2\); l’accumulo è il passo su un obiettivo lineare, e coincide col precedente solo se \(\mathbf{S}_{t-1}\mathbf{k}_t = \mathbf{0}\) e \(\beta_t = 1\); il gate è un decadimento dei pesi [LWW+25, YKH25]. Ne restano fuori RWKV-4 e la sLSTM.
A cambiare, da un’architettura all’altra, è soprattutto la transizione di stato (\(\mathbf{I} \to \alpha_t \mathbf{I} \to \operatorname{Diag}(\boldsymbol{\alpha}_t) \to \mathbf{I}-\beta_t \mathbf{k}_t \mathbf{k}_t^\top \to \alpha_t(\mathbf{I}-\beta_t \mathbf{k}_t \mathbf{k}_t^\top)\)). Restano comuni lo stato fisso, la scrittura per prodotto esterno e la doppia forma; cambiano il fattore \(\beta_t\) nella scrittura delle righe con la delta rule e l’algoritmo che rende efficiente la forma parallela.