


Un pixel alla volta#
Generare una cosa alla volta si è già visto. Il capitolo sui Transformer scrive testo una parola alla volta; quello sull’audio produce suono un simbolo alla volta, e prima ancora, con WaveNet, un campione d’onda alla volta. La ricetta è sempre la stessa: si mette il dato in fila, si insegna alla rete a indovinare il pezzo successivo dati i precedenti, e la probabilità dell’intero è il prodotto delle probabilità dei pezzi, ciascuna presa sapendo i pezzi che vengono prima. È la regola della catena della probabilità: se la prima parola di una frase ha probabilità un decimo e la seconda, sapendo la prima, un mezzo, la coppia ha probabilità un ventesimo. Nessuna approssimazione: quel prodotto è la probabilità, non una sua stima, e ogni fattore è una probabilità vera perché è una scelta fra un numero finito di possibilità, con i pesi che sommano a uno.
Chiediamoci allora la cosa ovvia: e un’immagine? La domanda ha una storia più lunga dei modelli che l’hanno resa celebre. Le reti che scrivono la probabilità di un dato a molte dimensioni come prodotto di condizionali risalgono almeno ai primi anni Novanta; nel 2011 il NADE di Hugo Larochelle e Iain Murray ne fa un modello neurale che si addestra e si valuta senza approssimazioni [LM11], e nel 2015 Lucas Theis e Matthias Bethge modellano immagini con LSTM che scorrono sulle due dimensioni [TB15]. Nel gennaio del 2016 Aäron van den Oord, Nal Kalchbrenner e Koray Kavukcuoglu [vdOKK16] portano l’idea a scala con una rete che «predice in sequenza i pixel di un’immagine lungo le due dimensioni spaziali»; WaveNet, che la sezione sul generare suono racconta come la pietra miliare del suono generato, è la sorella minore di questo lavoro, stesso laboratorio e stesso anno, con l’onda al posto della griglia.
Servono due cose, e la seconda è tutto il mestiere.
Primo: un ordine#
Una frase un ordine ce l’ha, un’immagine no. Bisogna sceglierne uno e non cambiarlo più: si va riga per riga, da sinistra a destra, come quando si legge, e dentro un pixel a colori si mette anche un ordine fra i tre canali, cioè fra il rosso, il verde e il blu. La scelta è arbitraria e nessuno pretende che sia la migliore: pretende solo di essere fissa, perché è rispetto a essa che «prima» e «dopo» vogliono dire qualcosa.
Fatto questo, la probabilità di un’immagine è il prodotto delle probabilità dei suoi pixel, ciascuna presa sapendo tutti i pixel che nella lettura vengono prima, cioè condizionata a quelli. Per una figurina di \(32 \times 32\) in bianco e nero sono 1.024 fattori, uno per pixel, e ciascuno è una distribuzione su 256 livelli di grigio: una probabilità vera, che somma a uno, e non un punteggio da normalizzare in un secondo tempo.
Secondo: una convoluzione che guarda solo indietro#
Qui arriva l’ostacolo, e ha una forma precisa. Il capitolo sul deep learning ha spiegato perché su un’immagine si usa una convoluzione e non uno strato denso: la convoluzione calcola l’uscita in un punto con un filtro, un quadratino di pesi che guarda un intorno del pixel, cioè i vicini in tutte le direzioni. Ma «tutte le direzioni» qui è esattamente ciò che non si può fare. L’intorno comprende anche pixel che nell’ordine di lettura vengono dopo, e se nel prevedere un pixel la rete li vede, il prodotto dei condizionali non è più una probabilità.
Il vincolo si impone sui pesi, ed è la convoluzione mascherata: il filtro si moltiplica, elemento per elemento, per una maschera di zeri e di uni che azzera i pesi sulle posizioni successive nell’ordine di lettura. Su un filtro \(3 \times 3\) restano accese le tre caselle della riga di sopra e quella a sinistra del centro; si spengono la casella a destra e le tre della riga di sotto, e resta da decidere che cosa fare del centro.
Al primo strato la casella centrale contiene il pixel vero, cioè proprio il valore da indovinare: se restasse accesa, la rete imparerebbe in pochi passi di addestramento a copiare la risposta dalla domanda, e avremmo un modello con verosimiglianza perfetta e utilità nulla. Il primo strato usa quindi la maschera di tipo A, che spegne anche il centro, cinque caselle su nove. Dal secondo strato in poi la casella centrale contiene quello che lo strato precedente ha calcolato lì a partire dai soli pixel già letti, perché il pixel vero la maschera di tipo A gliel’aveva tolto. Spegnerla sarebbe uno spreco, e si lascia accesa: è la maschera di tipo B, che di caselle ne spegne quattro.
Il codice, e una sorpresa#
La causalità non si dichiara, si verifica, e il modo più diretto è chiederla al gradiente: se muovendo un pixel l’uscita in una certa posizione non cambia, quel pixel non è entrato nel conto.
import torch
import torch.nn as nn
import torch.nn.functional as F

torch.manual_seed(0)


class ConvMascherata(nn.Conv2d):
    """Convoluzione che puo' guardare solo i pixel gia' visitati.

    Ordine di scansione: riga per riga, da sinistra a destra. Il tipo 'A'
    esclude anche il pixel centrale (serve al primo strato: se lo vedesse, il
    modello imparerebbe a copiarlo); il tipo 'B' lo include, perche' da li' in
    poi il centro non e' piu' il pixel vero ma un riassunto legittimo.
    """

    def __init__(self, tipo, *a, **kw):
        super().__init__(*a, **kw)
        _, _, kh, kw_ = self.weight.shape
        m = torch.ones(kh, kw_)
        m[kh // 2, kw_ // 2 + (1 if tipo == "B" else 0):] = 0   # resto della riga
        m[kh // 2 + 1:] = 0                                      # tutte le righe sotto
        self.register_buffer("maschera", m)

    def forward(self, x):
        return F.conv2d(x, self.weight * self.maschera, self.bias,
                        self.stride, self.padding, self.dilation, self.groups)


def campo_visivo(n_strati, rif=(8, 4), n=9):
    """Quali pixel entrano DAVVERO nel conto per il pixel `rif`?

    Non lo deduciamo dalle maschere: lo chiediamo al gradiente. Se muovendo un
    pixel l'uscita in `rif` non cambia, quel pixel non e' stato guardato.

    L'attivazione e' una LeakyReLU e non una ReLU: l'ingresso e' tutto zeri,
    quindi ogni pre-attivazione vale il proprio bias, e una ReLU con bias
    negativo ha derivata nulla su tutta la mappa. Quel canale spegnerebbe un
    cammino del gradiente, e la sonda direbbe "mai guardato" di un pixel che
    la maschera lascia passare: falsi negativi che dipendono dal seme.
    """
    strati = [ConvMascherata("A", 1, 8, 3, padding=1), nn.LeakyReLU(0.1)]
    for _ in range(n_strati - 2):
        strati += [ConvMascherata("B", 8, 8, 3, padding=1), nn.LeakyReLU(0.1)]
    strati.append(ConvMascherata("B", 8, 1, 3, padding=1))
    x = torch.zeros(1, 1, n, n, requires_grad=True)
    nn.Sequential(*strati)(x)[0, 0, rif[0], rif[1]].backward()
    return x.grad[0, 0].abs() > 0


N, RIF = 9, (8, 4)
prima = torch.tensor([[(r * N + c) < (RIF[0] * N + RIF[1]) for c in range(N)]
                      for r in range(N)])

for L in (6, 12, 24):
    visto = campo_visivo(L, RIF, N)
    print(f"{L:2d} strati | pixel del futuro guardati: {int((visto & ~prima).sum())}"
          f" | pixel del passato mai guardati: {int((prima & ~visto).sum())}")

print("\ncampo visivo con 24 strati ('#' visto, '.' passato mai visto, "
      "' ' futuro):")
visto = campo_visivo(24, RIF, N)
for r in range(N):
    print("   " + " ".join("#" if visto[r, c] else ("." if prima[r, c] else " ")
                           for c in range(N)))
 6 strati | pixel del futuro guardati: 0 | pixel del passato mai guardati: 24
12 strati | pixel del futuro guardati: 0 | pixel del passato mai guardati: 6
24 strati | pixel del futuro guardati: 0 | pixel del passato mai guardati: 6

campo visivo con 24 strati ('#' visto, '.' passato mai visto, ' ' futuro):
   # # # # # # # # #
   # # # # # # # # #
   # # # # # # # # #
   # # # # # # # # #
   # # # # # # # # #
   # # # # # # # # .
   # # # # # # # . .
   # # # # # # . . .
   # # # #
La prima colonna dei numeri è la buona notizia, e va letta come una prova: a qualunque profondità, zero pixel del futuro entrano nel conto. Le maschere fanno il loro mestiere.
La seconda colonna è la sorpresa. Con sei strati ventiquattro pixel del passato restano fuori, ed è atteso: la rete non arriva così lontano, basta farla più profonda. Con dodici ne restano fuori sei. Con ventiquattro ne restano fuori ancora sei, e sono una zona che quelle maschere non raggiungono a nessuna profondità: il triangolo che nella mappa sale a destra del pixel da indovinare. Si chiama punto cieco (blind spot), e il lavoro che l’ha diagnosticato lo dice in una riga: le PixelCNN «hanno un punto cieco nel campo recettivo che non può essere usato per fare predizioni» [vdOKV+16]. Il disegno lo mostra strato per strato (Fig. 28.1): il cono si allarga fin dove arriva, e i sei quadretti tratteggiati che salgono a destra del pixel da indovinare restano dove sono anche quando tutto il resto si è acceso.

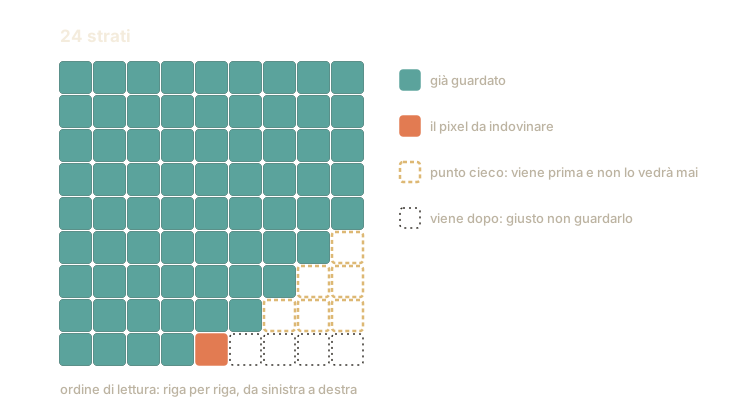
Fig. 28.1 Il campo visivo cresce con la profondità, il punto cieco no. In terracotta il pixel da indovinare, in teal (il verde-azzurro scuro) quello che la rete arriva a guardare; i quadretti tratteggiati in ocra vengono prima nell’ordine di lettura, quindi la rete avrebbe tutto il diritto di guardarli, e non li guarderà mai. Quelli grigi vengono dopo, e restano spenti giustamente.#
Il perché è geometrico, e sulla figura si vede. I filtri sono \(3 \times 3\), quindi ogni strato allarga la vista di una casella per lato. Verso sinistra e verso l’alto quella casella si guadagna subito; verso destra no, perché sulla riga corrente la maschera si ferma al centro, e l’unico modo di spostarsi a destra è passare per la riga di sopra: una colonna guadagnata a destra costa una riga guadagnata in alto. Il risultato è un cono che verso sinistra si apre in fretta e verso destra sale in diagonale, mentre il passato vero, quello dell’ordine di lettura, comprende tutta la riga di sopra fino in fondo.
La riparazione, nello stesso lavoro, divide la convoluzione in due pile che lavorano in parallelo: una verticale, che guarda tutte le righe di sopra senza maschera e quindi cresce a rettangolo, e una orizzontale, che guarda solo la riga corrente fino al pixel. La verticale passa la sua uscita all’orizzontale e mai il contrario, perché il ritorno porterebbe nella verticale pixel che nell’ordine vengono dopo; la predizione esce dall’orizzontale. Il campo resta finito e cresce con la profondità come prima, ma senza più buchi. La verosimiglianza migliora, e il merito va diviso: lo stesso lavoro cambia anche le funzioni di attivazione.
Una parola coperta in mezzo a una pagina, e il permesso di leggere tutto quello che viene prima: il gioco è indovinarla, e poi la seguente, fino in fondo. Il voto della pagina intera è il prodotto dei voti delle singole parole: se la prima la indovini con probabilità un mezzo e la seconda, sapendo la prima, con probabilità un terzo, le due insieme valgono un sesto. Per dare il voto a una pagina già scritta basta un giro, perché le parole ci sono tutte e si possono coprire e indovinare insieme; per scriverne una nuova bisogna indovinare una parola, scriverla, e solo dopo passare alla seguente.
Perché nessuno bari, gli occhiali che ti danno guardano soltanto all’indietro. La prima lente copre anche la parola da indovinare, com’è ovvio; le lenti successive leggono gli appunti della prima, e al centro di quegli appunti c’è soltanto ciò che la prima ha scritto senza vedere la risposta, quindi possono guardarlo. Il guaio è che gli occhiali hanno una fessura storta. Sulla riga che stai leggendo vedi indietro fin dove arriva la lente; sulle righe di sopra ti fermi prima verso destra, e il pezzo che ti sfugge è più lungo proprio sulla riga appena sopra la tua, quella che ti servirebbe di più. Lenti più spesse allungano la portata; la forma della fessura resta quella, e quelle parole nessuno te le aveva vietate.
Sono due difetti diversi. Con sei strati la rete non arriva lontano abbastanza: è miopia, e si cura con la profondità. Con ventiquattro la portata basta e restano fuori sempre gli stessi pixel: sei, su questa griglietta di prova, e su un’immagine vera il triangolo cieco è molto più largo. È il punto cieco, e lì la profondità non serve più a niente, perché il limite sta nella forma dello strumento e si sposta soltanto cambiando quella. La riparazione del 2016 è mettere due finestre al posto di una: una guarda tutte le righe di sopra per intero, l’altra la riga corrente da sinistra. Quello che vede la prima lo si passa alla seconda, e mai al rovescio: al rovescio la prima si ritroverebbe davanti pezzi che non ha il diritto di vedere, e il gioco tornerebbe truccato.
Conta anche il modo di rispondere. Nel gioco la risposta è una parola, e al momento di sceglierne una le parole non stanno su una scala: non ce n’è una che sia in mezzo fra due altre. La rete invece sceglie fra 256 gradazioni di grigio, che stanno su una scala: il 128 e il 129 sono vicini di casa. Chi le tratta come 256 nomi di un elenco butta via quello che sa già; chi risponde con una curva sulla scala impara prima e indovina meglio.
Vale ben oltre le immagini: quando un modello non arriva a un risultato, prima di ingrandirlo si guarda se quell’architettura possa arrivarci in linea di principio. Ingrandire un modello miope serve; ingrandire un’architettura che ha un punto cieco è calcolo buttato.
La fattorizzazione è la regola della catena applicata a un ordinamento totale dei pixel:
con \(x_i\) l’\(i\)-esimo valore in ordine di scansione, il condizionamento su tutto ciò che precede che si abbrevia \(\mathbf{x}_{<i}\), e \(D\) il numero di valori che compongono il dato: \(n^2\) per un’immagine \(n \times n\) in scala di grigi, \(3n^2\) a colori quando, come in PixelRNN e PixelCNN, i tre canali stanno ordinati dentro ciascun pixel. Ogni fattore è una categorica su 256 livelli, quindi normalizzata per costruzione: \(\log p(\mathbf{x})\) è esatta e si ottiene in un solo passaggio in avanti, perché durante l’addestramento tutti i contesti sono disponibili insieme (teacher forcing). È l’asimmetria caratteristica della famiglia: valutare costa un passaggio, campionare ne costa \(D\). I \(D\) passaggi sono \(D\) valutazioni complete della rete solo se a ogni passo si ricalcola tutto: conservando le attivazioni già calcolate, ogni passo aggiorna soltanto ciò che il valore nuovo cambia, e su PixelCNN++ la generazione accelera fino a 183 volte [RPK+17]. Il numero di passi in sequenza resta \(D\).
L’ordine di scansione è una scelta che conta. Per un modello perfetto ogni ordine dà la stessa \(p(\mathbf{x})\), perché la regola della catena vale in qualunque ordine; per un modello addestrato no, e DeepNADE [UML14] addestra con parametri condivisi un modello per ogni ordine delle variabili, osservando che le stime dei diversi ordini non coincidono.
Le maschere realizzano il vincolo di causalità a livello di pesi: \(\mathbf{W} \leftarrow \mathbf{W} \odot \mathbf{M}\) con \(\mathbf{M}\) binaria (che qui moltiplica i pesi, mentre la \(\mathbf{M}\) dell’attenzione si somma ai punteggi), tipo A al primo strato e tipo B dopo. È la stessa idea con cui MADE [GGML15] maschera i pesi di un autoencoder densamente connesso, mentre NADE ottiene la causalità condividendo i pesi fra i fattori. In scala di grigi il tipo A azzera il centro. A colori, del pixel centrale, azzera il canale che si sta predicendo e quelli che nell’ordine vengono dopo, e lascia passare quelli già predetti (il rosso per il verde, il rosso e il verde per il blu); il tipo B aggiunge la sola connessione di ciascun canale a sé stesso [vdOKK16]. La composizione resta causale grazie al primo strato: il tipo B conserva la dipendenza dal centro, il tipo A la toglie, e toglierla una volta sola, all’ingresso, basta per tutta la pila. È ciò che il test sul gradiente verifica: detta \(\mathbf{o}_i\) l’uscita della rete in posizione \(i\) (il vettore dei 256 punteggi da cui la softmax ricava la distribuzione di \(x_i\)), si ha \(\partial \mathbf{o}_i / \partial x_j = \mathbf{0}\) per ogni \(j \geq i\) nell’ordine di scansione, a qualunque profondità.
Il punto cieco è il prezzo della realizzazione, non del vincolo. Detto in termini di campo recettivo: la maschera tronca la riga corrente al centro, quindi l’espansione verso destra guadagna al più una colonna per ogni riga guadagnata in alto. Il bordo destro del campo sale quindi a \(45^\circ\) invece di coprire tutto il semipiano che l’ordinamento consentirebbe, e ciò che resta fra quella retta e il bordo dell’immagine non è raggiungibile a nessuna profondità: con filtri \(3 \times 3\) il punto cieco arriva a coprire, dicono gli autori, «fino a un quarto del campo recettivo potenziale». La riparazione di [vdOKV+16] fattorizza il filtro in due pile: la verticale, non mascherata, sulle righe strettamente superiori (campo rettangolare, nessun punto cieco), e l’orizzontale, mascherata, sulla riga corrente. L’uscita della verticale entra nell’orizzontale con una \(1\times1\), e non nell’altro verso: il ritorno darebbe alla verticale i pixel sotto e a destra, e romperebbe la fattorizzazione. La predizione esce dall’orizzontale. Lo stesso lavoro sostituisce la ReLU con un’unità gated in stile LSTM, e aggiunge il condizionamento su un vettore esterno, che è il motivo per cui il titolo parla di generazione condizionale. Le due pile e le unità gated insieme portano il PixelCNN, su CIFAR-10, da \(3{,}14\) a \(3{,}03\) bit per dimensione (quanti bit costa in media ogni numero dell’immagine: più basso è meglio), a un soffio dal \(3{,}00\) del PixelRNN. Quest’ultimo, però, è molto più lento da addestrare, perché una ricorrenza sui pixel non si parallelizza come una convoluzione. Il PixelRNN usa due LSTM bidimensionali: la Row LSTM elabora una riga alla volta con una convoluzione \(k \times 1\) sullo stato della riga precedente, e ha un campo recettivo triangolare; la Diagonal BiLSTM scorre lungo le diagonali dell’immagine inclinata e copre tutto il contesto passato, ed è lei a dare il \(3{,}00\). WaveNet risolve in una dimensione un problema diverso, un campo recettivo troppo corto: con filtri causali di lunghezza \(k\) ogni strato allunga il campo di \(k - 1\) posizioni, mentre con convoluzioni causali dilatate, raddoppiando la dilatazione a ogni strato, il campo di \(L\) strati con \(k = 2\) arriva a \(2^L\) invece che a \(L + 1\).
Fra i successori, PixelCNN++ [SKCK17] sostituisce la categorica su 256 livelli con una miscela di logistiche discretizzate: per una categorica il livello 128 e il 129 sono due simboli senza alcuna relazione, mentre una miscela continua e poi discretizzata recupera l’ordinamento dei valori; gli autori riportano che così l’addestramento accelera. Questa e altre quattro modifiche insieme portano il conto su CIFAR-10 a \(2{,}92\). Una delle quattro cambia anche il costo del campionamento: PixelCNN++ condiziona su pixel interi invece che sui singoli canali, predice i tre canali di un pixel insieme (la dipendenza del verde dal rosso, e del blu da entrambi, passa per le medie della miscela) e scende da \(3n^2\) a \(n^2\) passaggi sequenziali.
Perché non ha vinto sulle immagini, e dove è tornata#
Il costo sta tutto nel campionamento. Valutare la probabilità di un’immagine costa un passaggio della rete; generarne una ne costa uno per valore, in fila, perché il valore numero mille si può estrarre solo dopo che il novecentonovantanovesimo è stato fissato. Su una fotografia a colori di \(256 \times 256\) sono \(256 \times 256 \times 3 = 196.608\) passaggi sequenziali per una sola immagine, contro l’unico passaggio di una GAN o del flusso della prossima sezione: più di cinque ordini di grandezza nel numero di passi in fila, che un’implementazione più furba rende più leggeri ma non riduce, perché la sequenza la impone la fattorizzazione stessa.
Per questo l’idea, sulle immagini, è tornata spostandosi di un piano. Niente obbliga i pezzi da mettere in fila a essere pixel. Se prima si comprime l’immagine in una griglia piccola di simboli presi da un catalogo, i passaggi sequenziali crollano. Ne è un esempio il VQ-VAE dei modelli latenti, o il suo successore con perdita avversaria, il VQ-GAN della sezione sulle evoluzioni delle GAN, che riduce \(256 \times 256\) pixel a \(16 \times 16\) caselle, cioè 256 posizioni: i passaggi scendono da 196.608 a 256, settecentosessantotto volte meno, e a metterli in fila può pensare un Transformer. È la forma in cui l’autoregressione sulle immagini vive nei modelli che trattano testo e immagini come un’unica sequenza di simboli, come Chameleon nella sezione sulla fusione precoce.
Resta però una cosa che si perde in quel trasloco, e riguarda proprio questo capitolo: la verosimiglianza che si calcola sui token è quella dei token, non quella dell’immagine. Il passaggio dal catalogo ai pixel è una perdita, e oltre quella perdita il numero non parla più. Chi vuole \(\log p\) dell’immagine vera deve restare sui pixel, o cambiare famiglia: ed è la strada dei flussi normalizzanti.
Da ricordare
È la ricetta con cui si scrive un testo, applicata a una griglia. Si sceglie un ordine (riga per riga, come si legge), e la probabilità di un’immagine è il prodotto di quella di ogni pixel dato tutto quello che viene prima. Nessuna approssimazione, e per misurarla basta un passaggio solo.
Il costo è bendare in parte la convoluzione: si spengono le caselle del filtro che guardano nel futuro. Al primo strato si spegne anche quella centrale, perché lì c’è il pixel che stiamo cercando di indovinare, e vederlo sarebbe copiare la risposta dalla domanda; dal secondo in poi la si lascia accesa, perché al centro c’è solo ciò che lo strato prima ha calcolato senza vederla.
La benda si porta dietro un guasto suo: un triangolo di pixel che vengono prima e che la rete non guarderà mai, per quanto la si faccia profonda. Si chiama punto cieco, e non si cura con la profondità: si cura cambiando la forma della finestra, cioè mettendone due.
Generare costa carissimo, perché va fatto un pixel alla volta e in fila: su una fotografia sono quasi duecentomila passaggi, contro l’unico di una GAN. Per questo oggi la stessa idea si applica a pezzi più grossi dei pixel (i simboli di catalogo del VQ-GAN), dove i passaggi diventano poche centinaia. Il prezzo del trasloco è che il numero esatto vale allora per i simboli, e non più per l’immagine.
Da ricordare
\(\log p(\mathbf{x}) = \sum_i \log p(x_i \mid \mathbf{x}_{<i})\) su un ordinamento totale dei pixel, ogni fattore una categorica su 256 livelli: normalizzazione per costruzione, verosimiglianza esatta, valutazione in un passaggio (teacher forcing), campionamento in \(D\) passaggi sequenziali, uno per valore del dato.
Causalità imposta sui pesi: \(\mathbf{W} \leftarrow \mathbf{W} \odot \mathbf{M}\), maschera di tipo A al primo strato (azzera il centro) e di tipo B dopo. La causalità è chiusa per composizione, e il test sul gradiente la verifica invece di darla per buona.
Il punto cieco [vdOKV+16] è un artefatto della realizzazione, non del vincolo: il bordo destro del campo recettivo sale a \(45^\circ\) invece di coprire il semipiano che l’ordinamento consentirebbe, e con filtri \(3 \times 3\) arriva a un quarto del campo potenziale. Riparazione: fattorizzare in pila verticale (non mascherata) e orizzontale (mascherata), con la verticale che alimenta l’orizzontale e non viceversa; su CIFAR-10, con le unità gated, da \(3{,}14\) a \(3{,}03\) bit per dimensione.
PixelCNN++ [SKCK17] sostituisce la softmax a 256 vie con una miscela di logistiche discretizzate, che recupera l’ordinamento fra livelli adiacenti perso dalla categorica. Quella e altre quattro modifiche insieme portano CIFAR-10 a \(2{,}92\); una di queste, il condizionamento su pixel interi, porta il campionamento a \(n^2\) passaggi.
Il collo di bottiglia è il campionamento sequenziale (\(D\) passaggi, che la memorizzazione delle attivazioni rende più leggeri ma non riduce). Spostando l’autoregressione dai pixel a token discreti (VQ-GAN) si passa da \(196.608\) a \(256\) passaggi, al prezzo di una verosimiglianza che è quella dei token e non dell’immagine.