


Servire un modello: dal file all’API#
Alla fine di tutto, un modello addestrato è un file. Qualche centinaio di megabyte di numeri su un disco (i pesi che Dal notebook alla produzione ha insegnato a versionare e archiviare) e nient’altro. Da solo non fa niente: è inerte come uno spartito senza orchestra. Metterlo in produzione vuol dire costruirgli intorno un servizio che riceve richieste dal mondo, esegue il modello e risponde, in fretta e in modo affidabile, migliaia di volte al minuto.
Con dati, codice e pesi tracciabili e riproducibili (è il punto a cui sono arrivate Dal notebook alla produzione e Dati e pipeline), il passo successivo, il quarto nodo dell’anello, è consegnare il modello al mondo, cioè metterlo in un posto dove chi ne ha il diritto possa interrogarlo. In inglese consegnarlo si dice deployment; tenere acceso quel posto, giorno dopo giorno, si dice serving. Sono le due parole che nel gergo del mestiere coprono tutto quello che segue.
È una questione tanto ingegneristica quanto di aspettative, perché metà del lavoro è decidere che cosa promettere a chi userà il servizio. E per una volta il grosso non riguarda la rete neurale, ma tutto ciò che le sta attorno [KKuhlH23].
Batch, online, streaming#
Prima di scrivere una riga di codice va scelto il regime di inferenza. Inferenza è il momento in cui il modello non impara più ma risponde: gli si dà un caso, restituisce la sua previsione; il regime è il modo in cui quel momento è organizzato, cioè come il modello incontra le richieste. La scelta cambia l’architettura, le priorità, perfino il conto della bolletta. I regimi fondamentali sono tre.
Il forno di un panificio li fa tutti e tre.
C’è il pane in blocco: di notte, quando il negozio è chiuso, il fornaio prepara in un colpo solo tutto il pane che servirà l’indomani. Nessuno aspetta al bancone, quindi non importa se ci mette due ore: conta solo sfornarne tanto. Questo è il regime batch: si accumula un mucchio di richieste e le si smaltisce tutte insieme, quando fa comodo (di notte, offline).
C’è poi il panino al momento: un cliente entra, ordina, e vuole il suo panino adesso, non domani. Qui conta la fretta: ogni singola richiesta deve avere risposta in pochi secondi, mentre la persona aspetta. E se la fila si allunga il fornaio non fa un panino più grande: chiama qualcuno al banco. Questo è il regime online: una richiesta, una risposta, subito.
E c’è il nastro trasportatore del sushi: i piatti scorrono senza sosta e tu prendi al volo quello che passa. Nessuno «ordina» e nessuno «finisce»: è un flusso continuo che non si ferma mai. Questo è lo streaming: eventi che arrivano ininterrottamente (clic, transazioni, sensori) e il modello li lavora al volo, mentre passano.
Fra il pane e il panino non si sceglie a caso. Il pane si fa la notte prima perché domani si vende comunque; il panino no, perché finché il cliente non parla non si sa che cosa metterci dentro. Quando la risposta si può preparare prima che serva conviene prepararla prima, e costa anche meno; se dipende da chi arriva, si fa sul momento.
I tre regimi si distinguono lungo due assi: latenza (quanto tempo passa tra una richiesta e la sua risposta) e throughput (quante richieste al secondo il sistema smaltisce). Sono in tensione, e ogni regime ottimizza uno sacrificando l’altro.
Batch (offline): si accumula un grande insieme di input e li si elabora in un’unica passata pianificata (tipicamente notturna). La latenza per singolo esempio è irrilevante (ore vanno benissimo), mentre il throughput si massimizza sfruttando batch enormi. Caso d’uso: assegnare un punteggio a tutti i clienti di un database per una campagna, o pre-calcolare le raccomandazioni della home page.
Online (sincrono): la richiesta arriva e attende la risposta in linea, con un budget di latenza stretto (spesso decine di millisecondi). Il throughput si ottiene con la concorrenza, non con batch grandi. Caso d’uso: la raccomandazione calcolata al clic dell’utente.
Streaming (event-driven): il modello consuma un flusso continuo di eventi, spesso su finestre temporali scorrevoli, e produce output man mano. Caso d’uso: rilevare frodi su transazioni mentre avvengono.
La scelta la detta il prodotto [Huy22], non il gusto. Se la previsione può essere pronta prima che serva, il batch è più semplice ed economico; se dipende da un input che esiste solo al momento della richiesta, serve l’online.
Batch e online sono i due estremi che si incontrano più spesso, ed è utile vederli affiancati (Fig. 36.5): stessa scatola «modello» al centro, priorità opposte ai due lati. Le due priorità hanno un nome. La latenza è il tempo che passa fra la domanda e la risposta; il throughput è quante risposte il sistema riesce a sfornare in un secondo.

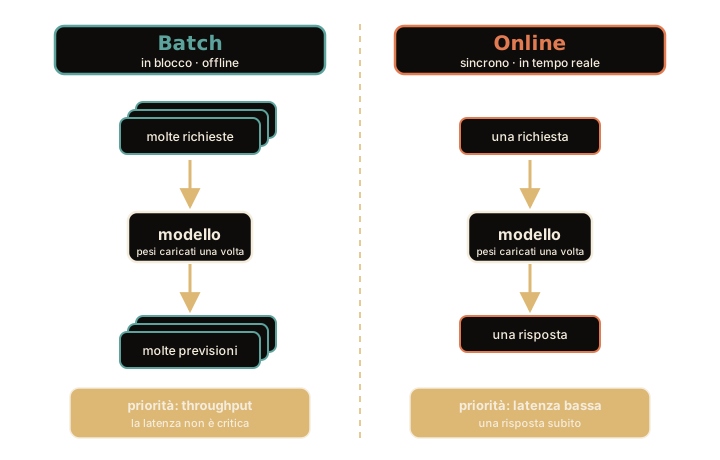
Fig. 36.5 Batch contro online: lo stesso modello, priorità opposte. A sinistra si smaltisce un mucchio di richieste in blocco e conta quante se ne servono al secondo; a destra si risponde a una richiesta per volta, subito, e conta quanto si aspetta.#
Il modello dietro un’API#
Nel regime online (il più comune e il più esigente) il modello vive dietro l’API di cui parlava Dal notebook alla produzione: lo sportello elettronico a cui un altro programma manda la domanda e da cui riceve la risposta, senza sapere né dover sapere che cosa c’è dietro.
Serve una parola in più, perché uno sportello ha un indirizzo. L’indirizzo preciso a cui si bussa si chiama endpoint, che alla lettera è «il capo della linea»: l’API è lo sportello, l’endpoint è la targa con il numero civico.
Solo che l’indirizzo, da solo, non basta: dietro ci dev’essere una macchina su cui il modello gira, e il software di quella macchina deve essere lo stesso ovunque, altrimenti si torna al «sul mio computer funzionava». La risposta del mestiere è chiudere il modello dentro una scatola che contiene anche tutto ciò che gli serve per funzionare: il sistema, l’interprete Python, la versione esatta di ogni libreria, e spesso i pesi. Sigillata la scatola, il software dentro è lo stesso su qualunque computer. Restano fuori due cose, che la scatola prende in prestito dal computer che la ospita: il nucleo del sistema operativo e l’hardware. Un’immagine costruita per un tipo di processore non gira su un altro senza un emulatore, e una scheda grafica la si usa con il driver installato sulla macchina, non con uno portato da casa.
Le tre parole che servono per parlarne sono in Fig. 36.6. La scatola sigillata, che nessuno modifica più, si chiama immagine. Una sua copia in funzione si chiama container, ed è usa e getta: per averne un’altra basta riaprire l’immagine. E siccome tutto ciò che il container scrive muore con lui, quello che deve sopravvivere (i dati, i risultati) si tiene fuori, in uno spazio agganciato dall’esterno che si chiama volume.

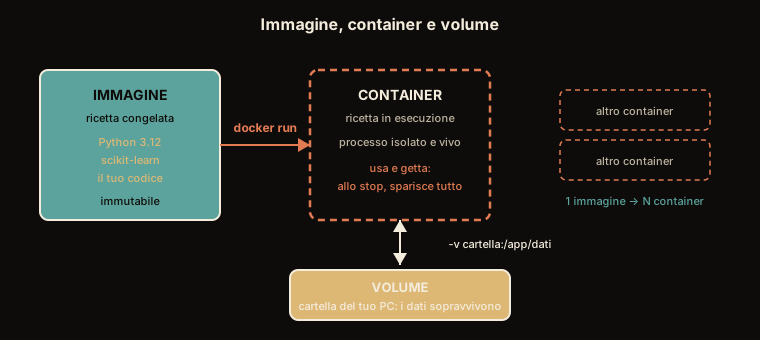
Fig. 36.6 Tre cose che si confondono di continuo. L’immagine non cambia, il container è usa e getta, e tutto ciò che deve sopravvivere sta nel volume.#
Questa distinzione è ciò che rende un servizio riproducibile: se l’immagine contiene l’ambiente per intero, la stessa identica versione del modello gira sul portatile di chi sviluppa e sul server di produzione, cioè sul computer sempre acceso che risponde alle richieste del mondo. E il container si può buttare e ricreare senza pensarci, il che torna utile quando si sostituisce un modello con uno nuovo: è quello che permette di tenere in piedi due versioni del modello nello stesso momento, o di spegnere in un istante quella nuova se si comporta male.
Chi chiama non sa e non deve sapere che dentro c’è una rete neurale: vede solo un servizio che, dati certi ingressi, restituisce una previsione. Dietro lo sportello c’è un programma che tiene il modello acceso in memoria e gli passa le domande man mano che arrivano: si chiama model server.
È lo sportello di un ufficio. Dietro il vetro c’è l’impiegato (il modello) che sa fare una cosa sola ma la sa fare bene. Tu non entri nel retro a rovistare tra le pratiche: passi il tuo modulo dalla fessura e ti torna indietro la risposta compilata. Lo sportello (l’API) nasconde tutto il resto, e il numero appeso sopra la fessura, quello che serve per trovarlo, è l’endpoint. E c’è una regola di buon senso che vale oro: l’impiegato arriva la mattina, si siede una volta sola e resta lì tutto il giorno. Sarebbe assurdo se andasse a casa e tornasse a ogni singolo cliente. Con i modelli è identico: i pesi si caricano in memoria una volta all’avvio del servizio, non a ogni richiesta; caricarli costa secondi, e a ogni richiesta li si pagherebbe di nuovo.
Il model server carica i pesi una volta all’avvio e li tiene in memoria; a ogni richiesta esegue solo il forward, in modalità inferenza. Sopra questa logica si appoggia un livello di trasporto (REST/JSON per semplicità, o gRPC per la bassa latenza e i payload binari) che però è, in sostanza, contorno.
Il problema serio sta nel renderlo riproducibile, più che nell’esporlo. Un modello dipende da una versione precisa di PyTorch, delle librerie di pre-processing, perfino di CUDA: la stessa trappola del «sul mio computer funzionava» vista in Dal notebook alla produzione, spostata dall’addestramento al servizio. La risposta standard è la containerizzazione: un’immagine Docker che congela sistema, interprete Python, dipendenze e, se si vuole, i pesi (che spesso stanno invece in un archivio a parte e si scaricano all’avvio) in un artefatto unico, avviabile allo stesso modo su qualunque host con la stessa architettura di CPU. Il container condivide però il kernel dell’host, e per la GPU usa il driver dell’host: l’immagine contiene le librerie CUDA, non il driver, che deve essere compatibile con loro. Il container è ciò che si versiona e si distribuisce; l’orchestrazione di più container (scalare le repliche sotto carico) è il livello successivo, di competenza dell’infrastruttura.
Lo scheletro di un servizio d’inferenza, tolto tutto ciò che riguarda il traffico in arrivo, sta in poche righe. La sostanza è tutta in tre gesti: caricare i pesi una volta sola, dire alla rete che ha finito di studiare, e spegnere il meccanismo che le serviva solo per imparare. La rete è piccola e i suoi pesi sono quelli iniziali, salvati in un file tenuto in memoria al posto di quello che l’addestramento lascerebbe su disco: la risposta non vuol dire niente, conta il percorso che la produce.
import io

import torch
import torch.nn as nn


class MiaRete(nn.Module):  # la stessa classe usata in addestramento
    def __init__(self):
        super().__init__()
        self.strati = nn.Sequential(
            nn.Linear(4, 16), nn.BatchNorm1d(16), nn.ReLU(), nn.Dropout(0.2),
            nn.Linear(16, 3),
        )

    def forward(self, x):
        return self.strati(x)


def preprocessa(richiesta: dict) -> torch.Tensor:
    """Dal JSON al tensore d'ingresso: un batch di una riga sola."""
    return torch.tensor([richiesta["x"]], dtype=torch.float32)


# al posto del file "pesi.pt" lasciato dall'addestramento, un file in memoria
torch.manual_seed(0)
file_pesi = io.BytesIO()
torch.save(MiaRete().state_dict(), file_pesi)
file_pesi.seek(0)

# Caricamento UNA VOLTA all'avvio del servizio, non a ogni richiesta
modello = MiaRete()
modello.load_state_dict(torch.load(file_pesi, map_location="cpu"))
modello.eval()             # inferenza: niente dropout, BatchNorm congelata


@torch.no_grad()           # niente autograd: meno memoria, più veloce
def predici(richiesta: dict) -> dict:
    x = preprocessa(richiesta)
    logit = modello(x)     # forward: logit grezzi, come in PyTorch
    prob = torch.softmax(logit, dim=1)
    return {
        "classe": int(prob.argmax(dim=1).item()),
        "confidenza": round(float(prob.max().item()), 3),
    }


print(predici({"x": [0.1, 0.2, 0.3, 0.4]}))
{'classe': 0, 'confidenza': 0.356}
Il primo gesto, caricare i pesi all’avvio, è quello del model server appena descritto. Gli altri due sono una riga di codice ciascuno, e sono i due che si dimenticano più spesso.
Il secondo gesto è dire alla rete che ha finito di studiare. Sembra strano doverglielo dire, e invece serve, perché alcuni suoi pezzi si comportano in due modi diversi a seconda che stiano imparando o rispondendo.
Il primo di questi pezzi, mentre la rete studia, spegne a caso una parte dei suoi neuroni a ogni ripetizione: è un trucco d’allenamento, il dropout, e serve a non farle imparare le risposte a memoria, come un insegnante che copre a caso qualche riga del testo. Quando la rete risponde, invece, deve usarli tutti.
Il secondo, la BatchNorm, riporta su una scala comune i numeri che lo attraversano, e per farlo guarda il gruppo di esempi che ha davanti: ne calcola la media e di quanto si sparpagliano. Studiando, intanto, tiene da parte una media di quelle medie, raccolta su tutto l’allenamento. Quando risponde ha davanti un esempio solo, di cui non ha senso fare la media, e deve usare quella messa da parte. Se nessuno gli dice che l’allenamento è finito, fa due danni: calcola la scala su un gruppo che non c’è, e continua ad aggiornare la sua media con le domande che arrivano, così che il modello cambia un po” a ogni richiesta. Le risposte escono sbagliate senza che niente segnali l’errore.
Il terzo gesto è spegnere il taccuino. Mentre impara, la rete annota ogni singola operazione che fa, perché le servirà per tornare indietro e correggersi. Quando risponde non si corregge più niente, e continuare a prendere appunti costa memoria e tempo a ogni richiesta. Si spegne, e si va più veloci.
La prima riga, modello.eval(), commuta i moduli che hanno un comportamento
distinto fra addestramento e inferenza: il dropout, che in addestramento
azzera a caso una frazione delle attivazioni e in inferenza deve lasciarle
passare tutte, e la BatchNorm, che in addestramento normalizza sulle
statistiche del batch corrente e in inferenza deve usare le medie mobili
accumulate. Dimenticarla, quasi sempre, non solleva nessuna eccezione: produce
solo predizioni sbagliate. L’errore si fa sentire solo quando per canale resta
un valore solo (una BatchNorm1d su un batch di uno, o una BatchNorm2d su
mappe \(1\times1\) con un batch di uno): lì la statistica del batch non descrive
più niente e il modulo si rifiuta di calcolarla; il dropout invece tace sempre.
E in modalità di addestramento la BatchNorm aggiorna anche running_mean e
running_var con i dati di produzione, perfino dentro torch.no_grad(), che
spegne i gradienti e non le statistiche: il modello in memoria si sposta a ogni
richiesta, e smette di essere quello che è stato validato.
La seconda, torch.no_grad(), disattiva la costruzione del grafo delle
operazioni che l’autograd userebbe per la retropropagazione. In inferenza
quel grafo non serve, e costruirlo costa memoria e tempo a ogni richiesta;
torch.inference_mode() è la variante più aggressiva della stessa rinuncia, che
disattiva anche il version counter dei tensori.
Il resto è il modello del capitolo PyTorch chiamato a rispondere invece che a
imparare: i logit grezzi in uscita dal forward e la softmax che li porta
su una distribuzione di probabilità.
Ottimizzare l’inferenza#
Un servizio corretto può ancora essere troppo lento o troppo costoso. Le leve per accelerare l’inferenza sono diverse da quelle dell’addestramento, ma una radice è comune con le prestazioni in PyTorch: meno numeri da spostare, più velocità.
La prima leva è il batching dinamico, e qui la parola batch torna con un significato diverso da quello di poco fa: qui è il mazzetto di richieste che il server mette insieme prima di passarle al modello. Il motivo è che la scheda grafica che fa i conti (la GPU) è costruita per eseguire migliaia di operazioni identiche nello stesso istante, e a servirle una richiesta per volta la si tiene quasi ferma: è il punto su cui è costruito il capitolo sulle GPU. Il server allora accumula per qualche millisecondo le richieste che arrivano, ne fa un mazzetto e lo passa al modello in un colpo solo. Chi era arrivato per primo aspetta quei pochi millisecondi in più; in cambio, nello stesso secondo, il sistema ne serve molte di più.
Il batching dinamico ha anche un prezzo che non si vede nei tempi. Il modo in cui una libreria somma i numeri dipende dalla forma dei dati che le arrivano, e la forma qui la decide quante richieste capitano nello stesso mazzetto: due chiamate identiche, finite in mazzetti diversi, possono differire nelle ultime cifre [He25]. È la ripetibilità bit a bit alla quale il servizio rinuncia, come avvertiva Dal notebook alla produzione. Per i modelli che generano testo, poi, il mazzetto non si chiude e si riapre a ogni richiesta, ma si ricompone a ogni token: è il continuous batching di LLMOps.
La seconda leva è ridurre la precisione dei numeri, cioè scriverli con meno
cifre. Dentro un calcolatore ogni informazione è fatta di cifre binarie, i
bit, che valgono zero o uno, e un numero con la virgola di solito ne occupa
trentadue. Scendendo a sedici (è la scrittura che il capitolo PyTorch chiamava
float16, e usarla per una parte dei conti e non per tutti è la precisione
mista che là serviva ad addestrare più in fretta) si dimezza lo spazio
occupato, e con esso la quantità di byte da far scorrere fra memoria e
processore: i numeri restano tanti quanti erano, sono più corti. Con mazzetti
piccoli è proprio lo scorrere dei byte il collo di bottiglia, e dimezzarli
dimezza quasi il tempo; con mazzetti grandi il limite diventa il calcolo, e il
guadagno si riduce. Il prezzo è qualche cifra dopo la virgola, e con float16
anche un pezzo di intervallo: il numero più grande che si scrive è \(65\,504\), e
dove i valori lo superano si usa il bfloat16 del capitolo PyTorch, che tiene
l’intervallo dei trentadue bit e rinuncia a qualche cifra in più.
La terza leva spinge oltre, fino agli interi: la quantizzazione a
int8 [JKC+18]. I suoi guadagni non si sommano a quelli
della seconda leva, perché è la stessa leva spinta più in là: in tutte e due si
decide quanti bit dare a ogni numero, e il conto si fa sempre rispetto ai
trentadue di partenza, sedici bit due volte più leggeri, otto bit quattro
volte. Con quelli del batching, invece, si combinano, perché mazzetti più
grandi e numeri più corti sono due guadagni indipendenti.
È il trucco delle immagini GIF, quelle delle animazioni che girano nelle chat. Una foto normale può usare milioni di sfumature; una GIF ne sceglie soltanto 256, e a ogni pixel dà quella più vicina. I pixel restano tutti al loro posto: sono i colori a diventare più grossolani, e a occhio quasi non si vede. In cambio il file pesa molto meno.
Quantizzare un modello è la stessa idea applicata ai suoi numeri: restano tutti, ma ciascuno è scritto peggio. Un peso può valere qualunque numero, con tante cifre dopo la virgola. Quantizzare vuol dire tenerne pronti soltanto 256, come i gradini di una scala. Il 256 non è scelto a caso: le macchine maneggiano i bit a gruppi di otto, e con otto bit si scrivono \(2^8 = 256\) valori diversi. Ogni peso sale sul gradino più vicino, e al suo posto si scrive il numero del gradino, che è un intero piccolo. Della scala vanno segnate due cose, o non la si sa più rileggere: quanto è alto un gradino, e quale gradino corrisponde allo zero. Per i pesi, che sono numeri positivi e negativi, lo zero si mette a metà scala; per numeri che stanno tutti da una parte dello zero lo si sposta in fondo, così nessun gradino resta inutilizzato. Nessun peso si sposta più di mezzo gradino: quello è tutto l’errore che si fa.
Ogni numero passa da trentadue bit a otto: quattro volte più leggero, spesso molto più veloce, un pizzico meno preciso.
Il guaio è un peso enorme in mezzo agli altri: i gradini devono arrivare fino a lui, quindi si alzano tutti, e i pesi normali, ammucchiati in basso, si ritrovano su una manciata di gradini. La cura costa poco: gruppetti piccoli, ognuno con i suoi gradini, invece di una scala sola per tutti.
Il patto conviene quasi sempre: l’accuratezza cala di una frazione di punto e il modello gira anche su un telefono. Ma «quasi sempre» non è «sempre», e di quanto cali si scopre soltanto misurandolo su quel modello lì.
La forma più economica è la quantizzazione post-training (PTQ): si prende
un modello già addestrato in float32 e se ne convertono i pesi in interi,
senza riaddestrare. Il meccanismo è costruito per esteso in Meno bit [JKC+18]. Quella sezione definisce
la mappa affine \(\hat{w} = s\,(q - z)\) fra l’intero \(q\) e il valore reale
ricostruito \(\hat{w}\) (con \(s\) la larghezza di un gradino e \(z\), lo
zero-point, il livello che rappresenta lo zero), calcola l’errore limitato a
mezzo gradino, e spiega perché la larghezza del gradino la dettino gli elementi
più estremi fra quelli che condividono la scala. Da lì si danno per acquisite
due conseguenze: che la granularità della scala sia la leva più economica, e
che nei modelli linguistici poche componenti anomale la dettino per tutte le
altre. Qui interessa la parte di servizio, cioè che cosa si scrive e che cosa
si misura.
In PyTorch la quantizzazione dinamica post-training è una riga, e l’esportazione verso un runtime dedicato (indipendente da Python) è un’altra:
import torch
import torch.nn as nn

# Pesi in int8, attivazioni quantizzate al volo (dynamic quantization).
# API storica, oggi in via di sostituzione: avvisa che si migri a torchao.
modello_int8 = torch.quantization.quantize_dynamic(
    modello, {nn.Linear}, dtype=torch.qint8,
)

esempio = torch.randn(1, 784)
programma = torch.export.export(modello, (esempio,))    # il grafo, catturato
torch.onnx.export(modello, (esempio,), "modello.onnx")  # lo stesso, in ONNX
La quantize_dynamic è la variante più indolore (nessun dato di calibrazione
richiesto, adatta agli strati lineari), e va usata sapendo due cose. La prima è
che usa le due forme della mappa insieme. I pesi, in int8 con segno, hanno
\(z = 0\): è la forma simmetrica, il caso particolare in cui la scala basta da
sola e che Meno bit sviluppa per il resto del suo
percorso. Le attivazioni invece si quantizzano al volo in interi senza segno,
con \(s\) e \(z\) ricalcolati su ogni batch dal suo minimo e dal suo massimo: è la
forma asimmetrica, che non spreca livelli quando i valori stanno quasi tutti
da una parte dello zero. La seconda è che quell’API è dichiarata in uscita (il
messaggio di deprecazione rimanda a torchao e alla sua quantize_), quindi è
materia da ricontrollare a ogni aggiornamento invece che da imparare a memoria.
Sull’esportazione, invece, è cambiato il rapporto fra i due strumenti.
torch.export cattura il grafo del modello staccandolo dal codice Python che
l’ha addestrato; ONNX è un formato aperto con cui quel grafo si consegna a un
motore d’inferenza di terzi. Non sono due strade alternative, e chi le ha
imparate ai tempi di PyTorch 1.x se lo ricorda al contrario: da PyTorch 2.9
l’esportatore ONNX passa per torch.export (il parametro dynamo vale
True di serie) e delega a lui la cattura del grafo. Ne discende una
conseguenza pratica immediata: la traduzione in ONNX vive in
un pacchetto a parte, onnxscript, che non viene più installato insieme a
torch. Su un ambiente appena preparato quella riga solleva un
ModuleNotFoundError, e la cura è installarlo (pip install onnxscript), non
tornare all’esportatore vecchio.
Vale infine la stessa disciplina della precisione mista: la quantizzazione va sempre misurata su un insieme di validazione, perché il calo di accuratezza dipende dal modello e non è mai garantito trascurabile a priori.
Latenza e throughput: cosa promettere#
Ottimizzato il servizio, resta la domanda più scomoda: che cosa promettere a chi lo userà? Le due grandezze in ballo sono sempre latenza e throughput, e tirano in direzioni opposte: per questo vanno promesse insieme. Ma prima di promettere qualcosa bisogna decidere quale numero guardare, e qui il gergo confonde tre cose diverse.
Le tre cose sono quelle di qualunque promessa: che cosa si guarda, che cosa ci si impegna a fare e che cosa succede se non lo si fa. Un treno le ha tutte e tre: si guarda il ritardo all’arrivo, ci si impegna a stare sotto i cinque minuti, e se si sfora il biglietto viene rimborsato.
La prima è la grandezza che si misura, e in gergo si chiama SLI, Service Level Indicator. Sceglierla è già una decisione: la latenza media è un indicatore legittimo e di solito quello sbagliato, perché nasconde la coda, cioè i pochi casi lenti, che sono proprio quelli che l’utente nota. Al suo posto si prende un percentile alto, il tempo entro cui risponde la stragrande maggioranza delle richieste, per esempio il 99%.
La seconda è il bersaglio che i tecnici si danno da soli su quella grandezza: «il tempo entro cui risponde il 99% delle richieste sta sotto i 200 millisecondi». È lo SLO, Service Level Objective.
La terza è il contratto firmato con il cliente, che su quel bersaglio si appoggia e stabilisce il rimborso se la promessa salta: lo SLA, Service Level Agreement.
Fra le tre, quella su cui il team lavora ogni giorno è lo SLO, e un buon SLO tiene insieme le due grandezze, quanto si fa aspettare chi chiede e quanti se ne servono (Fig. 36.7).

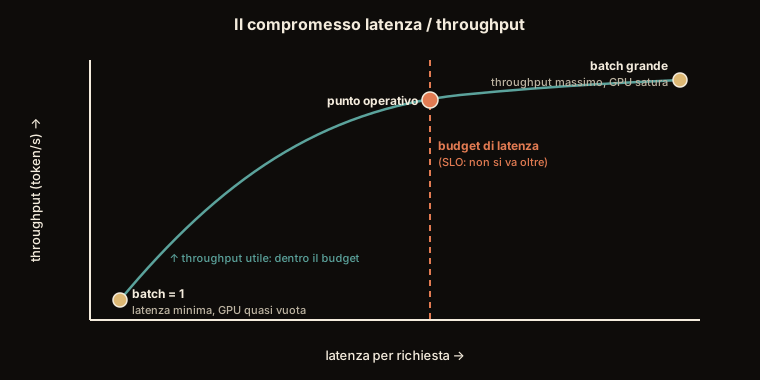
Fig. 36.7 Le due grandezze tirano in direzioni opposte, a una condizione: che il sistema stia già smaltendo le richieste alla velocità con cui arrivano. Batch grandi servono più utenti al secondo, e ciascuno di loro aspetta di più. (Sull’asse verticale il throughput è contato in token al secondo invece che in risposte al secondo, perché la curva è disegnata su un modello che genera testo: la forma della curva è la stessa in tutti e due i casi.)#
Il tratto piatto a destra in Fig. 36.7 è quello da riconoscere: oltre quel punto si continua a pagare in attesa senza più guadagnare in capacità. Dove fermarsi non lo decide la curva ma il bersaglio che il team si è dato (lo SLO), ed è questo il senso di sceglierlo prima.
Quel vincolo, che il sistema stia già smaltendo le richieste alla velocità con cui arrivano, merita il suo paragrafo, perché la curva da sola inganna. Il tempo segnato sull’asse orizzontale è la latenza di servizio: quanto ci mette il modello a rispondere una volta che alla richiesta è arrivato il turno. Ma ciò che l’utente vive è l’attesa in fila sommata al servizio, e la fila non compare nella curva.
Con la fila nel conto le situazioni sono tre. Finché la capacità del servizio non copre il carico, cioè finché le richieste arrivano più in fretta di quanto escano, la fila cresce senza limite, e ingrandire il mazzetto migliora tutte e due le grandezze: alza il throughput e accorcia l’attesa. Quando la capacità ha superato il carico comincia il compromesso vero: un mazzetto più grande serve qualcosa in più e fa aspettare qualcosa in più. Nel tratto piatto della curva, infine, la capacità non cresce più e si allunga soltanto l’attesa. È anche la ragione per cui in un servizio molto sollecitato il batching dinamico non è un lusso: spesso è l’unica configurazione stabile.
Prendiamo il forno del panificio, stavolta di giorno, col negozio aperto e la gente in fila davanti al bancone: il pane della notte serve apposta a non far aspettare nessuno, qui invece l’attesa è tutto il problema. Un’infornata da una pagnotta sola richiede mezz’ora, quindi il forno ne sforna due all’ora; una da cento richiede quaranta minuti, un po’ di più, ma di pagnotte ne consegna centocinquanta all’ora. I clienti che entrano nel negozio sono sessanta all’ora.
Con il forno da una pagnotta la fila non smette mai di allungarsi: entrano sessanta persone e ne escono due, quindi ogni ora ne restano dentro cinquantotto in più, e chi arriva alle undici aspetta più di chi è arrivato alle dieci, per sempre. Con il forno da cento, che ne fa centocinquanta contro sessanta, la fila si smaltisce e nessuno aspetta più di due infornate. La singola infornata è più lenta, e ciononostante tutti aspettano meno. Finché il forno non sta dietro ai clienti, insomma, ingrandire l’infornata migliora tutto; quando ci sta dietro, allargarla ancora fa sfornare qualcosa in più e aspettare qualcosa in più, e sta al fornaio decidere se lo scambio conviene; e oltre una certa misura il forno non sforna più niente in più, e si aspetta e basta.
Alla posta, su cento clienti, ottanta escono dall’ufficio due minuti dopo esserci entrati, quindici ci mettono dieci minuti e cinque restano impantanati quaranta minuti: sono tempi porta a porta, fila compresa, che è quello che vive chi aspetta. L’attesa media è \((80 \times 2 + 15 \times 10 + 5 \times 40)/100 = 5{,}1\) minuti. Ma cinque minuti non li aspetta nessuno: chi entra alla posta aspetta due minuti, o dieci, o quaranta. La media è un numero che non descrive l’esperienza di nessuno dei presenti.
Quello che conta davvero è la promessa sul caso quasi peggiore. Con questi stessi numeri si può dire: «novantacinque clienti su cento sono serviti entro dieci minuti», ed è una frase verificabile, perché gli ottanta in due minuti più i quindici in dieci fanno novantacinque. Restano fuori i cinque sfortunati, e sono loro il problema del direttore dell’ufficio: potrebbe aprire dieci sportelli e far uscire tutti in due minuti, e non lo fa perché dieci impiegati costano. Quei cinque su cento sono anche il suo margine: finché la settimana ne lascia fuori meno, può permettersi di provare una novità allo sportello; quando li ha già spesi tutti, smette di provare e sistema quello che c’è.
Quei cinque pesano più di quanto sembri, perché una pratica raramente si sbriga a uno sportello solo. Se per finirla ne servono tre, basta che uno sia di quelli lenti: con cinque lenti su cento per sportello, che vadano bene tutti e tre capita a ottantasei persone su cento (\(0{,}95\) moltiplicato per sé stesso tre volte), e le altre quattordici ne incontrano almeno uno. Con i modelli succede lo stesso, perché una richiesta passa quasi sempre per più servizi (chi legge i dati, chi calcola le feature, chi fa la predizione), e i tre sportelli sono loro.
Per questo, con i modelli, si promette non il tempo medio ma il tempo entro cui risponde la stragrande maggioranza, e quel «novantacinque su cento entro dieci minuti» ha un nome: si chiama percentile. La p95 è il tempo entro cui è servito il 95% delle richieste: su venti richieste, una sola ci mette di più. La p99 lascia fuori una richiesta su cento. Quale dei due mettere nel mirino è una scelta di severità: la p99 è più difficile da rispettare, perché lascia fuori cinque volte meno gente della p95.
Si descrive la latenza con i suoi percentili, non con la media. La p50 (mediana) è il tempo entro cui risponde metà delle richieste; la p95 e la p99 i tempi entro cui ne risponde il 95% e il 99%. La coda della distribuzione, la p99, la p99.9: è ciò che governa l’esperienza reale sotto carico, perché in un sistema che compone più servizi anche una piccola frazione di richieste lente si propaga e degrada l’insieme. Se una richiesta attraversa \(k\) chiamate indipendenti, ciascuna lenta con probabilità \(p\), è lenta con probabilità \(1-(1-p)^k\): con \(p = 0{,}05\) e \(k = 3\) è il 14%, con \(p = 0{,}01\) e \(k = 100\) chiamate in parallelo il 63% [DB13]. Uno SLO serio si scrive sui percentili alti: «p99 sotto i 200 ms», non «latenza media 80 ms», che nasconde la coda. Uno SLO del \(99{,}9\%\) definisce anche il suo complemento, il budget d’errore: \(1 - 0{,}999\) degli eventi della finestra può violare la soglia, cioè una richiesta su mille, o \(43{,}2\) minuti di indisponibilità su trenta giorni. Il budget si spende: il rapporto fra il tasso di violazioni osservato e \(1-\text{SLO}\) (il burn rate) dice a che velocità, e un burn rate di 10 esaurisce il mese in tre giorni. La politica che ne discende è la ragione per cui lo SLO si scrive: finché resta budget si rilascia, a budget finito si congelano i rilasci e si lavora sull’affidabilità.
Il secondo numero da promettere è il throughput sostenibile (richieste al secondo), e lo lega alla latenza la legge di Little, \(L = \lambda W\): il numero medio di richieste nel sistema è il tasso d’arrivo per il tempo medio di permanenza, qualunque sia la distribuzione (è la stessa legge del capitolo sulle GPU), purché il sistema sia stabile. Con arrivi poissoniani, un servente solo esponenziale di tasso \(\mu\) e la fila servita in ordine d’arrivo (la coda M/M/1 FIFO) il tempo di permanenza è esponenziale di parametro \(\mu-\lambda\), quindi \(W = 1/(\mu-\lambda)\) e \(p_{99} = \ln(100)\,W \approx 4{,}6\,W\), che vale solo se \(\rho = \lambda/\mu < 1\). A \(\mu = 100\) richieste al secondo, \(W\) passa da 20 ms a \(\lambda=50\), a 100 ms a \(\lambda=90\), a un secondo a \(\lambda=99\): la latenza cresce piano finché il carico è basso, esplode vicino a \(\rho=1\), e oltre non esiste più. Il batching cambia modello, perché il servente lavora a mazzi (è una coda a servizio di gruppo), e tira in due versi: alza la capacità, cioè \(\mu\), che allontana il muro, e fa aspettare ogni richiesta finché il suo mazzo non è pieno e poi per tutta la sua durata. Finché la capacità non copre il carico vince il primo effetto, e un mazzo più grande migliora tutte e due le grandezze; oltre quel punto vince il secondo, ed è lì che batch più grandi alzano il throughput ma allungano la p99 (sono le tre situazioni della curva). Il terzo numero è economico, il costo per richiesta, che spesso è il vero vincolo di progetto. Con il batching una richiesta non occupa l’hardware da sola, quindi il suo costo è il prezzo orario diviso per le richieste servite in un’ora, \(c = \text{prezzo orario}/(3600\,X)\) con \(X\) il throughput in richieste al secondo; moltiplicare il prezzo per il tempo di calcolo della singola richiesta lo sovrastimerebbe di un fattore pari alla taglia del mazzo. È per questo che il batching lo abbassa. Un modello che rispetta lo SLO ma costa dieci volte troppo per richiesta non si può mettere in produzione [Huy22].
C’è infine una cautela che riguarda come si sostituisce un modello con uno nuovo, senza rompere niente. Non si spegne la versione vecchia e si accende la nuova sperando bene: si procede per passi, prima due gradi di esposizione del pubblico e poi un confronto.
Il primo grado non espone nessuno. In modalità shadow, cioè «in ombra», la nuova versione riceve una copia delle richieste vere e produce le sue risposte, ma quelle risposte non vengono date a nessuno: si mettono da parte e si confrontano con quelle della vecchia.
Il secondo grado espone pochi. In un rilascio canary la nuova versione risponde davvero, ma solo a una piccola frazione delle richieste, e la quota si allarga solo se i numeri tengono; il nome viene dal canarino che i minatori portavano sottoterra per accorgersi del gas prima degli uomini.
Il terzo passo è un esperimento. Un test A/B assegna gli utenti a caso alle due versioni, nelle proporzioni scelte, e confronta una metrica fissata in anticipo. Shadow e canary dicono se la versione nuova si può servire senza danni; l’A/B dice se è migliore.
Le tre tornano in Sorvegliare un modello vivo, dove si vede a quale domanda risponde ciascuna. È il lato «serving» della stessa prudenza che l’anello MLOps chiede a ogni tappa: misurare prima di fidarsi.
Da ricordare
Inferenza è il modello che risponde, non che impara, e ci sono tre modi di organizzarla: tutto insieme quando fa comodo (il pane sfornato di notte), una richiesta per volta mentre qualcuno aspetta (il panino al momento), o su un flusso che non si ferma mai (il nastro del sushi).
Il modello sta dietro uno sportello: chi lo interroga non sa e non deve sapere che cosa c’è dietro. E l’impiegato allo sportello si siede una volta sola la mattina: i pesi si caricano all’avvio del servizio, non a ogni richiesta.
Perché dietro lo sportello giri lo stesso software su ogni macchina, il modello si chiude in una scatola sigillata con dentro tutto quello che gli serve (l’immagine), tranne il nucleo del sistema operativo e l’hardware; una sua copia in funzione (il container) è usa e getta, e ciò che deve sopravvivere si tiene fuori.
Per andare più veloci: servire più richieste in un colpo solo, scrivere i numeri con meno cifre, e al limite arrotondarli ai 256 gradini di una scala (la quantizzazione, come una GIF che usa 256 colori invece di milioni senza togliere un pixel). Quattro volte più leggero, un pizzico meno preciso, da misurare ogni volta.
Servire a mazzi fa aspettare di più ogni singola richiesta, ma finché il servizio non sta dietro alle richieste fa aspettare tutti di meno, come il forno che con l’infornata grande smaltisce la fila.
Non si promette il tempo medio di risposta, che non lo vive quasi nessuno: si promette il caso quasi peggiore, «il 95% entro dieci minuti». Quel numero si chiama percentile, e il cliente scontento è quello del gruppetto lento, non quello medio.
Una versione nuova non si accende di colpo per tutti, ma per gradi: prima la si fa girare in ombra, senza servirne le risposte a nessuno; poi la si fa provare a pochi. E per sapere se è davvero migliore si tirano a sorte gli utenti, si dà a ciascun gruppo una versione diversa, e si guarda quale va meglio.
Da ricordare
Un modello in produzione va scelto per regime di inferenza: batch (in blocco, offline, massimizza il throughput), online (sincrono, budget di latenza stretto), streaming (flusso continuo di eventi) [Huy22].
Nel serving online il modello vive dietro un endpoint gestito da un model server che carica i pesi una volta sola; il container Docker congela l’ambiente e lo rende riproducibile [KKuhlH23] sugli host con la stessa architettura di CPU, mentre kernel e driver della GPU restano quelli dell’host.
Lo scheletro d’inferenza corretto in PyTorch è:
load_state_dictall’avvio,model.eval()(per dropout e BatchNorm, che in modo train aggiornerebbe le sue medie con i dati di produzione),torch.no_grad()per non costruire il grafo del backward.Le leve per accelerare sono il batching dinamico, la riduzione di precisione (
float16, come nel capitolo PyTorch) e la quantizzazione aint8con la mappa affine \(\hat{w} = s\,(q - z)\), cioè scala e livello dello zero [JKC+18] (inquantize_dynamic, \(z = 0\) sui pesi e \(z\) ricalcolato a ogni batch sulle attivazioni): circa 4× di memoria in meno sui pesi che si quantizzano (con i solinn.Linear, su una rete mista il guadagno complessivo è molto minore), al prezzo di un piccolo calo di accuratezza, da misurare sempre. La scala per canale costa una manciata di scalari per strato ed evita che un solo canale anomalo allarghi il gradino di tutti.L’esportazione stacca il modello dal codice che l’ha addestrato:
torch.exportcattura il grafo, e da PyTorch 2.9 l’esportatore ONNX passa di lì invece di essere la sua alternativa (serveonnxscript, che non è più una dipendenza ditorch).I termini sono tre: l’SLI è ciò che si misura (la p99 della latenza), lo SLO la soglia che il team si impone su quell’indicatore, lo SLA il contratto con le penali. Uno SLO serio si scrive sui percentili alti (p95, p99), non sulla media, e va bilanciato con throughput e costo per richiesta.
Il compromesso fra latenza e throughput vale oltre il punto in cui la capacità copre il carico: sotto quel punto la coda è instabile, e batch più grandi migliorano tutte e due le grandezze insieme.
Le nuove versioni si rilasciano per gradi di esposizione (shadow, che non serve nessuno; canary, che serve pochi) per non rompere niente in produzione; l’A/B, che confronta due versioni su gruppi di utenti assegnati a caso, risponde a un’altra domanda, cioè quale delle due sia migliore.