


I tre errori più comuni#
Esiste un rito d’iniziazione che accomuna chiunque abbia scritto codice
PyTorch, dal primo esercizio al laboratorio di ricerca: un RuntimeError
lungo venti righe, la sensazione che il messaggio sia scritto in una lingua
straniera, e mezz’ora persa a spostare .to(device) da una riga all’altra
sperando che smetta. La buona notizia è che quel messaggio quasi mai è davvero
nuovo. Sotto la varietà apparente, gran parte dei messaggi riguarda tre cose:
la forma dei dati, il loro tipo, il dispositivo su cui stanno.
La ragione è che, quando due tensori si incontrano, PyTorch controlla tre loro
attributi: la forma (shape), il tipo dei numeri (dtype) e il dispositivo
(device). Dove una regola lo permette li adatta da sé (allarga una forma col
broadcasting, porta due tipi a uno comune), e dove non può si ferma, e quasi
sempre perché una di queste tre regole non è rispettata: chi impara a
riconoscerle a colpo d’occhio smette di cercare l’errore per tentativi. Restano
fuori i guasti sui valori, come un’etichetta che indica una classe che non
esiste (IndexError: Target 10 is out of bounds), e quelli di risorse, come la
memoria della scheda grafica che finisce (CUDA out of memory).
import torch

x = torch.randn(32, 3, 224, 224)
print(x.shape)    # torch.Size([32, 3, 224, 224])  -> la forma
print(x.dtype)    # torch.float32                   -> il tipo
print(x.device)   # cpu                             -> dove abita
Questa terna è la prima cosa da stampare quando qualcosa non va.
1. La forma non torna#
RuntimeError: mat1 and mat2 shapes cannot be multiplied (32x784 and 128x10)
Lo si incontra presto, e il messaggio (una volta imparato a leggerlo) dice già tutto: PyTorch ha provato a moltiplicare una tabella \(32 \times 784\) per una \(128 \times 10\), e non si può, perché il numero di colonne della prima (\(784\)) non coincide con il numero di righe della seconda (\(128\)). È la regola del prodotto fra matrici vista nella sezione di algebra lineare, e il motivo per cui esiste è che ogni riga della prima matrice viene accoppiata a una colonna della seconda, numero per numero: se le due file non hanno la stessa lunghezza, gli accoppiamenti non si chiudono.
I numeri dicono anche dove è successo, ed è la parte che si impara a leggere. Il \(32\) è il numero di esempi nel mini-batch (nel codice, batch); il \(784\) sono i pixel di un’immagine MNIST srotolata, \(28 \times 28\). Il \(128\) e il \(10\) sono la seconda tabella, cioè lo strato d’uscita del nostro percettrone: prende 128 numeri e ne produce 10, uno per cifra. Traduzione del messaggio: sono arrivate 32 immagini appiattite direttamente allo strato finale, perché fra i due manca lo strato nascosto, quello che avrebbe dovuto portarle da \(784\) a \(128\).
Un tensore porta scritte addosso le sue dimensioni, che dicono quante cose contiene e come sono disposte. \((3, 224, 224)\) è un’immagine: tre tavole di \(224 \times 224\) numeri, una per colore, rosso verde e blu. Ogni numero è un lato del blocco, e due pezzi si agganciano quando le dimensioni combaciano sul lato giusto, come due tubi che si avvitano quando hanno lo stesso diametro. Con una differenza che conta, e che torna più avanti: due tubi sbagliati non si avvitano e basta, mentre due dimensioni sbagliate a volte si agganciano lo stesso, in silenzio, e danno un numero che non vuol dire niente. Le cause ricorrenti hanno un nome ciascuna.
Manca l’appiattimento. Uno strato nn.Linear legge un numero solo delle
dimensioni, l’ultimo, e degli altri non si occupa. Davanti a
\((3, 224, 224)\) guarda il \(224\) finale: se ne aspettava un altro si ferma, e se
per caso aspettava proprio \(224\) va perfino peggio, perché il conto lo fa e
nessuno protesta: lo strato tratta ogni riga di pixel di ogni colore come se
fosse un esempio a sé, e di un’immagine sola ne fa \(3 \times 224 = 672\)
risposte scollegate invece di una. Serve un
nn.Flatten() in mezzo, che srotola ogni immagine in un’unica fila di
\(3 \times 224 \times 224 = 150\,528\) numeri e lascia stare il mazzetto,
perché srotola le immagini una per una senza impastarle fra loro. Lo strato che
viene dopo va allora costruito per accettarne \(150\,528\).
Due strati non si parlano. L’uscita di uno strato deve essere l’ingresso
del successivo: se il primo produce \(128\) numeri, il secondo deve aspettarsene
\(128\), non \(256\). Quando quel numero l’abbiamo scritto noi si tratta di un
refuso, e si corregge guardando la riga sopra. Spesso però non lo si conosce
affatto, perché esce da una catena di passaggi che lo cambiano ognuno un po’:
in quel caso c’è nn.LazyLinear, che il diametro del tubo se lo misura da sé
la prima volta che gli passa qualcosa, e su quella misura si costruisce
addosso il pezzo. Comodo mentre si prova; nella versione definitiva quel numero
è meglio scriverlo.
Manca il lato del mazzetto. Il modello si aspetta un mazzetto di esempi, anche
quando l’esempio è uno solo. Un’immagine singola va da
\((3, 224, 224)\) a \((1, 3, 224, 224)\), con x.unsqueeze(dim=0), cioè «un
mazzetto che contiene un’immagine». È l’inciampo classico del momento in cui
si prova il modello su una foto scaricata al volo. Il gesto contrario ha una
trappola: x.squeeze(), senza dire quale lato, toglie tutti i lati che valgono
uno, e su un mazzetto da un esempio solo porta via anche quello, riportando
l’immagine com’era prima. Il lato si indica sempre, con x.squeeze(dim=...),
così quello del mazzetto resta dov’è.
Per trovare il punto in cui la fila si spezza non serve indovinare: si fanno stampare le dimensioni a ogni passaggio, e la prima coppia che non combacia è quella da riparare.
Il conto da tenere è quello delle dimensioni lungo la rete, e le tre cause si formalizzano così.
Appiattimento. nn.Linear(d_in, d_out) opera sull’ultima dimensione e
lascia intatte le precedenti: applicato a \((B, C, H, W)\) fallisce a meno che
\(W = d_{\text{in}}\). Per un MLP su immagini serve nn.Flatten() (che per
default appiattisce da start_dim=1, preservando il batch) e
\(d_{\text{in}} = C \cdot H \cdot W\).
Composizione. In una nn.Sequential, out_features di uno strato deve
uguagliare in_features del successivo. La dimensione, però, a volte dipende
da calcoli: succede con gli strati che fanno scorrere un filtro sull’immagine,
dove ogni stride e ogni padding cambiano la forma di quello che esce (li
monta pezzo per pezzo la sezione sulle reti convoluzionali). Per un filtro di lato \(k\)
(kernel_size), con passo \(s\) (stride) e riempimento \(p\) (padding), la
lunghezza d’uscita lungo un asse di lunghezza \(n\) è
\(\lfloor (n + 2p - k)/s \rfloor + 1\), con la dilatazione di default
(dilation=1): con \(n = 10\), \(k = 3\), \(s = 2\), \(p = 1\) viene \(5\). Il conto si
può fare a mano, oppure si lascia fare: nn.LazyLinear(d_out) deduce la
dimensione dal primo tensore che riceve, materializzando i pesi alla prima
chiamata. È comodo in fase esplorativa; nel codice definitivo, meglio fissare
il numero.
Dimensione di batch. Quasi tutti i moduli assumono la convenzione
batch-first \((B, \dots)\), con un’eccezione che costa cara perché non solleva
eccezioni: nn.RNN, nn.LSTM, nn.GRU, nn.MultiheadAttention e i moduli
nn.Transformer* hanno batch_first=False di default, cioè si aspettano
\((L, B, \dots)\), con \(L\) la lunghezza della sequenza. Per aggiungere la
dimensione di batch a un esempio singolo si usa unsqueeze(0) nel caso comune
e unsqueeze(1) in quei moduli, che però accettano anche l’ingresso senza
batch, \((L, d_{\text{in}})\). Attenzione all’inverso: squeeze() senza
argomento elimina tutte le dimensioni unitarie, e su un batch da un elemento
cancella anche quella del batch; si passi sempre dim esplicito.
Lo strumento di diagnosi è il pacchetto torchinfo, da installare a parte
(pip install torchinfo): dopo from torchinfo import summary,
summary(modello, input_size=(32, 3, 224, 224), col_names=("input_size", "output_size", "num_params")) stampa forma in ingresso, forma in uscita e
parametri di ogni strato (senza col_names la forma in ingresso non c’è), ed
è il modo più rapido per vedere dove la catena si spezza. Senza dipendenze, la
catena delle forme si prova sul dispositivo meta, dove i tensori hanno forma
e tipo ma nessun numero, e quindi non occupano memoria:
from torch import nn

with torch.device("meta"):                   # forme e tipi, nessun numero
    rete = nn.Sequential(nn.Flatten(), nn.Linear(28 * 28, 128), nn.ReLU(),
                         nn.Linear(128, 10))
    print(rete(torch.empty(32, 1, 28, 28)).shape)
torch.Size([32, 10])
In alternativa, un print(x.shape) in ogni riga del forward: poco elegante,
sempre efficace.
2. Il tipo non torna#
RuntimeError: mat1 and mat2 must have the same dtype, but got Byte and Float
RuntimeError: expected target dtype to be Long or Byte, but got Float
Il secondo errore riguarda il dtype, cioè il tipo di numero con cui il
tensore è scritto: interi (il \(3\)) oppure decimali (il \(3{,}0\)). Quando somma o
moltiplica due tensori numero per numero, PyTorch li porta da sé a un tipo
comune che li contenga tutti e due (un intero e un decimale, per esempio,
diventano due decimali); ma nel prodotto fra matrici e dentro gli strati nn
(i casi dei due messaggi) la libreria richiede un tipo preciso, e preferisce
fermarsi piuttosto che indovinare quale volevamo.
I due messaggi vanno letti in modi diversi. Nel primo i due tipi sono i
due operandi, il tensore che abbiamo passato e i pesi del modello,
nell’ordine, e non «atteso» e «trovato». Byte è il nome interno di uint8,
cioè interi da \(0\) a \(255\), il tipo di un’immagine appena letta da un file, e
Float è il tipo dei pesi: la frase dice che una cosa a interi e una a
decimali si sono incontrate in una moltiplicazione fra matrici. Il secondo
riguarda le etichette, e lì i nomi sono quelli dei tipi ammessi (Long, cioè
int64, interi lunghi) contro quello ricevuto.
Una nota sulla varietà: la stessa situazione produce frasi diverse a seconda
dell’operazione. Uno strato lineare dice mat1 and mat2 must have the same dtype. Uno strato convoluzionale, quello che fa scorrere un piccolo filtro
sull’immagine (lo costruisce la sezione sulle reti convoluzionali), dice Input type (unsigned char) and bias type (float) should be the same se ha il bias, e expected scalar type Byte but found Float se non ce l’ha. Sono tre modi di dire la stessa cosa, e
riconoscerne il tema è più utile che impararli a memoria.
Un’immagine appena letta da un file è fatta di numeri interi da \(0\) a \(255\): è
il tipo uint8, il «Byte» del messaggio. Una rete neurale lavora invece con
numeri decimali, e li vuole in una scala piccola, di solito fra \(0\) e \(1\) in
ingresso. In una somma PyTorch la conversione la fa da
sé, ma la rete no: dentro uno strato il tipo se lo aspetta preciso, e la
conversione è a carico nostro. La fa la trasformazione ToTensor(), che
converte e divide per \(255\) portando i valori nell’intervallo giusto; a mano
servono tutti e due i gesti, .float() / 255, e il secondo si dimentica
spesso, con l’effetto di dare alla rete numeri esattamente \(255\) volte più
grandi di quelli che si aspetta.
C’è una seconda coppia che non si incontra, e stavolta sono due decimali. I
numeri con la virgola si scrivono in due misure, una lunga e una corta, cioè
con più cifre dopo la virgola o con meno, e strumenti diversi non scelgono la
stessa: un foglio di dati letto con NumPy, la libreria con cui in Python si
fanno i conti, arriva nella misura lunga, mentre i pesi della rete sono scritti
in quella corta. Dentro uno strato le due misure non si incontrano e la
libreria si ferma, anche se i numeri sono giusti e sono decimali tutti e due.
Il messaggio nomina le due misure con i nomi che hanno in inglese, Double per
la lunga e Float per la corta. È il caso che fa perdere più tempo, perché la
riga da guardare sta fuori da PyTorch, molte righe più su, dove i dati sono
stati letti. Il rimedio è lo stesso gesto di prima, .float(), scritto subito
dopo la lettura.
Il secondo messaggio è il caso opposto e riguarda le etichette. Alla
CrossEntropyLoss le classi vere si danno come numeri interi (la classe \(3\),
non \(3{,}0\)), perché sono nomi, non quantità. Passare \(3{,}0\) produce
quell’errore. Alla BCEWithLogitsLoss, invece, servono proprio decimali,
perché lì l’etichetta è un numero fra zero e uno: quasi sempre è uno dei due
estremi, «no» oppure «sì», ma la porta è aperta anche ai valori in mezzo, che
servono quando l’etichetta è incerta.
La regola pratica: una sola conversione, il più presto possibile. Si converte quando i dati entrano, non a metà del training loop.
Il default di PyTorch è float32; il default di NumPy è float64. Un
torch.from_numpy(array) conserva il float64 e produce un tensore che non
può essere moltiplicato per i pesi float32 del modello (mat1 and mat2 must have the same dtype, but got Double and Float, dove Double è float64): è
la sorgente più insidiosa di errori di tipo, perché nasce fuori da PyTorch. La
conversione esplicita torch.from_numpy(a).float() (o .to(torch.float32)) va
fatta al confine.
Sul type promotion elemento per elemento la formula che si legge di solito
(«le stesse regole di NumPy») è vera solo in parte. Le due librerie hanno in
comune otto tipi numerici di uso quotidiano (uint8, i quattro interi con
segno e i tre decimali, escluso il bfloat16 che in NumPy non esiste), per un
totale di \(8^2 = 64\) coppie possibili. Confrontando torch.result_type con
np.result_type su ciascuna di esse, dieci divergono, e sono tutte del tipo
intero per decimale: a differenza di NumPy, in PyTorch un intero non spinge mai
un decimale a una precisione più alta. int64 + float32 dà float32 in torch
e float64 in NumPy; torch.tensor([1,2,3]) * 2.5 dà float32, mentre
np.array([1,2,3]) * 2.5 dà float64. Il che rende il float64 in arrivo da
NumPy ancora più insidioso, perché le due librerie non la pensano allo stesso
modo.
Il quadro completo dei tipi che si incontrano:
Contenuto |
dtype atteso |
Note |
|---|---|---|
Immagini, feature, attivazioni |
|
il default dei pesi |
Etichette per |
|
indici di classe, shape \((B,)\); oppure |
Etichette per |
|
shape uguale ai logit |
Maschere booleane |
|
per |
Immagini appena lette |
|
da convertire, e da scalare in \([0,1]\) |
La riga della CrossEntropyLoss spiega anche perché il suo messaggio parla di
«target dtype» e non di «scalar type»: da PyTorch 1.10 quella loss accetta
anche target float, ma solo con la stessa shape dei logit, interpretandoli
come probabilità di classe (è la forma che serve per il mixup e per
la distillazione). Un target float di shape \((B,)\) è quindi un tipo
sbagliato e non una forma sbagliata, ed è per questo che l’errore parla di tipi.
Nota che float16 e bfloat16 non fanno eccezione a queste regole: la
precisione mista, trattata in prestazioni, non si ottiene
convertendo i tensori a mano ma lasciando gestire le conversioni a
torch.autocast, che sa quali operazioni si possono degradare e quali no.
3. Il dispositivo non torna#
RuntimeError: Expected all tensors to be on the same device,
but found at least two devices, cuda:0 and cpu!
Il terzo errore è il più banale nella diagnosi e il più fastidioso da prevenire: due tensori che devono incontrarsi abitano in due memorie diverse.
Sono due stanze separate, e da una non si vede che cosa c’è nell’altra: la CPU
ha la sua memoria, la GPU la sua. Un’operazione richiede che entrambi i pezzi
siano nella stessa stanza, e il trasloco va chiesto esplicitamente con
.to(device).
Il caso classico è aver spostato il modello e dimenticato i dati:
device = "cuda" if torch.cuda.is_available() else "cpu"
modello = modello.to(device)               # il modello trasloca...

for X, y in loader:
    X, y = X.to(device), y.to(device)      # ...e i dati devono seguirlo
    ...
Attenzione a una differenza sottile, che sta nel segno = delle due righe.
Nella prima, quella del modello, il = si potrebbe anche togliere:
modello.to(device) scritto da solo sposta il modello davvero, sul posto, e
dopo quella riga il modello sta di là. Nella seconda no. X.to(device) non
tocca X: fabbrica una copia di X che sta di là e la restituisce (a meno
che X non sia già di là, e allora restituisce proprio X), e se quella
copia non la si mette da nessuna parte va persa. Ecco perché nella riga dei
dati c’è X = X.to(device): senza il =, X.to(device) scritto da solo è
una riga che sembra funzionare e non fa nulla, e non dà nessun errore finché il
tensore non arriva al modello.
L’altro caso, quello che sfugge quasi sempre, riguarda un pezzo che nasce
dentro il modello mentre lavora. Una riga come torch.ones(...) lo fabbrica
nella stanza della CPU, perché nessuno le ha detto dove farlo, e il modello che
sta di là se lo trova davanti come qualcuno entrato dalla porta sbagliata. Il
rimedio è guardare dove sta un dato che si ha già in mano, invece di scrivere
il nome della stanza dentro il modello: torch.ones(..., device=x.device)
fabbrica il pezzo dove serve, qualunque stanza sia.
E le cose che appartengono al modello (una tabella di riferimento, una media da
sottrarre) vanno dichiarate sue con self.register_buffer("nome", tensore).
Così traslocano insieme a lui e, quando il modello si salva su disco, partono
con lui. Un tensore lasciato lì come una variabile qualsiasi resta indietro in
tutti e due i casi, e il guasto salta fuori il giorno in cui si passa alla GPU.
Anche il viaggio di ritorno vuole il suo trasloco. Un risultato calcolato di là
si porta dietro la catena dei conti che l’hanno prodotto, che la libreria tiene
da parte perché le servirà per correggere i pesi, e così com’è non lo si
consegna agli attrezzi che fanno i grafici. Prima lo si stacca da quella
catena, poi lo si riporta nella stanza della CPU, e a quel punto è un numero
come gli altri. In codice sono i tre gesti di
tensore.detach().cpu().numpy().
nn.Module.to() opera in-place su parametri e buffer registrati e
restituisce self; Tensor.to() è una funzione pura che restituisce un nuovo
tensore (o lo stesso oggetto, se è già sul dispositivo giusto). Da qui la
diversa disciplina d’uso.
Il caso che sfugge quasi sempre è un tensore creato dentro il forward:
def forward(self, x):
    maschera = torch.ones(x.shape[-1])            # nasce su CPU: errore
    maschera = torch.ones(x.shape[-1], device=x.device)   # corretto
La regola generale è non leggere mai una variabile globale device dentro un
modulo, ma dedurlo da un tensore che si ha già in mano (x.device) o dai
propri parametri (next(self.parameters()).device). Per le costanti che
appartengono al modello (una tabella di codifiche posizionali, una media di
normalizzazione), la soluzione corretta è
self.register_buffer("nome", tensore): i buffer non sono parametri (non
ricevono gradiente) ma seguono il modulo in .to(), finiscono nello
state_dict e si salvano con lui.
Ultimo dettaglio: un tensore ancora agganciato al grafo autograd non si passa
a NumPy. tensore.detach().cpu().numpy() è la sequenza completa: detach
stacca dal grafo, cpu fa il trasloco, numpy converte.
Un metodo, non un rimedio#
I tre errori si risolvono in trenta secondi se si legge il messaggio. Il metodo con cui li si risolve va reso esplicito, perché funziona anche sugli errori che nessun elenco contiene, compresi quelli che nasceranno il mese prossimo.
Leggi il traceback dal basso verso l’alto. Quando un programma Python si ferma non stampa una frase, stampa un elenco: è il traceback, la catena di chiamate che ha portato all’errore, dalla prima riga lanciata (in cima) fino al punto esatto in cui è esploso (in fondo). L’ultima riga dice che cosa è successo; risalendo si trova la prima riga di codice tuo: quella è il punto da guardare, non le venti righe interne di PyTorch che stanno sotto.
Stampa la terna.
print(x.shape, x.dtype, x.device)prima della riga che esplode, e la stessa cosa per l’altro operando. Quasi sempre l’errore diventa evidente.Riduci il problema. Un batch solo, un esempio solo, un modello di due strati. Un errore che sopravvive alla riduzione si trova in un minuto.
Fai un giro a vuoto prima di addestrare. Un
forwardsu un tensore finto della forma giusta (torch.randn(2, 3, 224, 224)) verifica in un istante tutta la catena, senza aspettare che ilDataLoaderscaldi i motori.
Gli altri classici#
I tre grandi errori si annunciano con un messaggio. I prossimi sono peggiori, perché non danno nessun errore: il codice gira, le curve della loss dicono poco o dicono il falso, e non c’è niente di rosso da leggere.

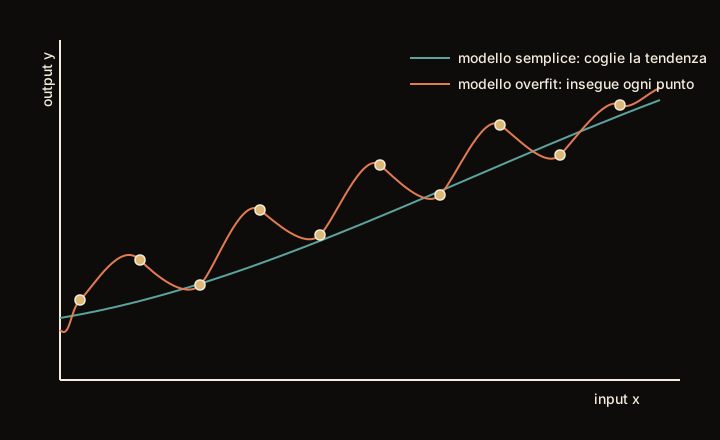
Fig. 7.12 La curva che passa per tutti i punti non ha capito meglio: ha memorizzato. Sul training set il suo errore è zero, ed è proprio questo a doverci insospettire.#
Fig. 7.12 ritrae un errore silenzioso frequente, e ne fa vedere la causa più che il sintomo: una curva che passa per ogni punto invece di seguire la tendenza. Il sintomo, sulle due loss, è che quella di addestramento scende benissimo mentre quella di validazione risale. Il codice funziona, non c’è niente da correggere in PyTorch, e proprio per questo lo si scopre tardi. È l’overfitting, già descritto nella sezione su overfitting e validazione, e come ci si ferma in tempo, con l’arresto anticipato, lo mostra il paragrafo «Quando fermarsi» della sezione sul training loop.
optimizer.zero_grad()dimenticato. Senza quella riga i gradienti si sommano invece di sostituirsi: al giro \(t\) l’aggiornamento usa la somma dei \(t\) gradienti calcolati fin lì, circa \(t\) volte la correzione media. Che cosa si vede dipende dall’ottimizzatore e dal passo, e non nel verso che ci si aspetta: con SGD a passo corto la loss all’inizio può perfino scendere più in fretta, a passo lungo esplode, e con Adam al passo di default l’esito dipende dal problema. In nessun caso arriva un messaggio: la curva della loss, da sola, non denuncia il bug.La predizione e il target non hanno la stessa forma. Se le predizioni sono una colonna di otto numeri e le etichette una riga di otto,
nn.MSELossenn.L1Lossnon si fermano: allineano le due forme allargandole (è il broadcasting già visto sui tensori) e finiscono per confrontare ogni predizione con ogni etichetta, sessantaquattro coppie invece di otto. Il numero che esce è quindi una media di errori incrociati che non significa niente, e non ha nemmeno un verso: secondo gli esempi che capitano può uscire più basso di quello giusto o più alto, quindi da quel numero non ci si accorge di nulla. Un avviso arriva e nomina il guasto («Using a target size that is different to the input size»), ma è unUserWarning, esce alla prima chiamata della loss e poi tace, perché Python lo stampa una volta per messaggio distinto: se l’ultimo batch è più corto, di messaggi ne escono due, ed è tutto. Il modello passa la notte a ottimizzare la cosa sbagliata mentre l’unica traccia è scorsa via un’ora prima. LaBCEWithLogitsLossè l’eccezione gentile, perché si rifiuta e lo dice, con unValueErrorinvece del solitoRuntimeError(Target size must be the same as input size). Il rimedio è una riga sola, da scrivere prima delle loss che confrontano due tensori della stessa forma (MSELoss,L1Loss,BCEWithLogitsLoss):assert pred.shape == target.shape. ConCrossEntropyLosse le classi date come numeri interi le forme sono diverse per costruzione, un punteggio per classe contro una classe per esempio, e l’asserzione fallirebbe sempre.optimizer.step()dimenticato. I gradienti si calcolano ma nessuno aggiorna i pesi: la loss resta piatta, identica, epoca dopo epoca.Softmax applicata due volte. Se l’ultimo strato del modello ha già una
nn.Softmaxe si usann.CrossEntropyLoss, la trasformazione avviene due volte: il modello impara comunque qualcosa, ma molto peggio. La loss vuole i logit, e il perché lo mostra il paragrafo sulle funzioni di perdita della sezione sui moduli, insieme al pavimento sotto cui, con una softmax di troppo, la loss non scende.model.eval()dimenticato in valutazione. Il modello resta in modalità studio, cioè si comporta come quando impara: il dropout continua a spegnere neuroni a caso, e la batch norm continua a normalizzare con le statistiche del batch che ha davanti invece che con quelle raccolte durante l’addestramento (sono gli strati a doppia personalità della sezione su studiare e dare l’esame). Le metriche ne escono diverse a ogni esecuzione, e non per forza peggiori: con la sola batch norm possono perfino uscire migliori, che è il modo peggiore in cui un errore silenzioso può presentarsi. E c’è un danno che resta: in modalità studio la batch norm aggiorna le proprie statistiche sui dati di validazione, quindi il modello esce cambiato dall’essere stato valutato male.Memoria che cresce a ogni epoca.
perditaè un numero più la catena di operazioni che l’ha prodotto, e accumularetotale += perditatiene in vita la catena di ogni batch, una sopra l’altra. In addestramento labackward()ha già liberato i valori intermedi, e restano soltanto i nodi della catena: la memoria cresce piano, ma senza fermarsi. In valutazione senzatorch.no_grad(), invece, nessunabackward()libera niente, e per ogni batch restano anche i valori intermedi: dopo qualche centinaio di iterazioni la memoria finisce (out of memory). In tutti e due i casiperdita.item()estrae il numero e lascia andare la catena.shuffle=TruesulDataLoaderdi test. Non è un errore di per sé, ma rende impossibile confrontare le predizioni con le etichette in un ordine stabile. Quello che invece non cambia è il voto: conmodel.eval()l’accuratezza misurata è identica cifra per cifra con il mescolamento acceso e con quello spento, perché sono gli stessi esempi in un altro ordine. L’unico numero che cambia è la media delle medie per batch, che però è un errore numerico a sé, spiegato in dal notebook agli script, e si sistema lì.La loss diventa
nan.nansta per not a number ed è il valore che i computer usano per dire «questo conto non ha un risultato»: lo si ottiene dividendo zero per zero, o sottraendo fra loro due infiniti (il valore assunto da un numero cresciuto oltre il limite rappresentabile). Quando compare al posto della loss, il primo sospettato è un learning rate troppo alto, con i pesi schizzati via; altrimenti c’è un denominatore che si annulla da qualche parte, e il posto dove si nasconde più spesso è la divisione per una deviazione standard nulla, cioè per un gruppo di numeri tutti uguali. Il secondo sospettato è il logaritmo di una probabilità esatta \(0\), che non è una divisione per zero: vale meno infinito, e diventa unnanappena quell’infinito incontra uno zero o un altro infinito. I rimedi sono altrettanto meccanici: dividere il learning rate per tre o per dieci, e sommare al denominatore un numero minuscolo (si scrive \(\varepsilon\), epsilon, e vale \(10^{-5}\) negli strati che normalizzano, \(10^{-8}\) dentro Adam) perché non possa mai essere zero esatto.
Per sapere dove nasce un nan c’è il rilevatore di anomalie di autograd,
torch.autograd.set_detect_anomaly(True): acceso, fa fermare la backward()
sulla prima operazione che restituisce un nan, e stampa la riga della
passata in avanti che l’ha creata. Rallenta molto, quindi si accende solo per
cercare. Su un logaritmo di zero moltiplicato per zero:
w = torch.zeros(3, requires_grad=True)
with torch.autograd.set_detect_anomaly(True):
    try:
        (torch.log(w) * 0).sum().backward()   # log(0) = -inf; -inf * 0 = nan
    except RuntimeError as e:
        print(e)
Function 'LogBackward0' returned nan values in its 0th output.
Se invece i gradienti esplodono prima di arrivare al nan,
torch.nn.utils.clip_grad_norm_(modello.parameters(), 1.0), scritta fra
backward() e step(), ne limita la norma.
Il primo della lista, lo zero_grad dimenticato, ha dietro un meccanismo
preciso, ed è quello che spiega perché la diagnosi cambia con l’ottimizzatore.
È il foglio delle correzioni che non si toglie mai dal tavolo. Al primo giro c’è scritta una correzione, al secondo due, al decimo dieci, e ogni volta ci si corregge con tutto quello che c’è sul foglio. All’inizio sembra andare meglio: le correzioni spingono tutte dalla stessa parte, e si corre verso la risposta giusta più in fretta di chi il foglio lo cambia. Quando ci si arriva, però, non ci si ferma, perché sul foglio c’è ancora la spinta di tutti i giri prima: si scavalca la risposta, si torna indietro, la si riscavalca. Con passi piccoli si oscilla attorno a lei per sempre; con passi grandi le oscillazioni crescono a ogni giro, e l’errore esplode.
Adam, l’ottimizzatore che si prova per primo, ogni volta divide la spinta per quanto è grande di solito: l’esplosione al passo normale la evita, ma la spinta dei giri prima resta, e secondo il problema arriva lo stesso alla risposta giusta, o si pianta a metà strada. È il caso peggiore, perché la curva dell’errore non mostra niente di strano; e se il passo è grande, esplode anche lui.
Con SGD il bug ha un nome esatto. Se p.grad non si svuota, l’aggiornamento
diventa \(\theta_{t+1} = \theta_t - \eta \sum_{s \le t} \mathbf{g}_s\), cioè la
discesa col momento della sezione sull’ottimizzazione con coefficiente \(1\) e nessuno
smorzamento: cifra per cifra lo stesso cammino di
optim.SGD(params, lr=eta, momentum=1.0) con il ciclo corretto. Un momento
senza attrito all’inizio accelera, e per qualche centinaio di passi la loss può
stare perfino sotto quella del ciclo corretto; ma non si ferma mai. Su una
conca quadratica di curvatura \(\lambda\) l’iterazione diventa
\(\theta_{t+1} = (2 - \eta\lambda)\,\theta_t - \theta_{t-1}\), le cui radici
hanno modulo \(1\) per \(0 < \eta\lambda < 4\): il parametro oscilla attorno al
minimo con ampiezza costante, e oltre quella soglia l’ampiezza cresce a ogni
giro e la loss esplode.
Con Adam, al passo che si usa di default, la loss non esplode, e la ragione è strutturale: Adam non usa il gradiente così com’è, lo divide per una misura di quanto quel gradiente è grande di solito, quindi moltiplicare il gradiente per un fattore costante si semplifica e il passo resta lungo come sempre. Qui però il fattore non è costante, cresce con \(t\): le due medie di Adam (quella dei gradienti, al numeratore, e quella dei loro quadrati, al denominatore, come le scrive la sezione sul training loop) hanno memorie diverse, la prima corta e pronta a inseguire, la seconda lunga e in ritardo, e il passo effettivo cresce lentamente. A passo grande quella crescita basta a far divergere anche Adam. Al passo di default l’esito dipende dal problema, ed è proprio questo il pericolo. La normalizzazione toglie la scala ma non la memoria: la direzione del passo resta quella della somma di tutti i gradienti visti, cioè un momento senza attrito, che vicino al minimo lo scavalca invece di fermarcisi. Su un batch fatto apposta per essere mandato a memoria la loss col bug può arrivare a zero come quella del ciclo corretto; su una regressione con una rete piccola può restare piantata molto più in alto. In nessuno dei due casi arriva una divergenza o un messaggio: la curva, da sola, non denuncia il bug, e il caso peggiore è quindi l’ottimizzatore che si prova per primo.
Il grafico è il messaggio d’errore#
Per gli errori rumorosi c’è il traceback. Per quelli silenziosi c’è un grafico, ed è lo strumento diagnostico che si usa più spesso: le due curve della loss, addestramento e validazione, epoca per epoca.
Una premessa: quel grafico va guardato dall’epoca uno, non alla fine. Aspettare il termine dell’addestramento per tracciare le curve significa, su un modello serio, scoprire dopo sei ore una cosa che era leggibile dopo due epoche. Il costo di stampare due numeri a fine epoca e disegnarli è nullo; il costo di non farlo è una notte di GPU.

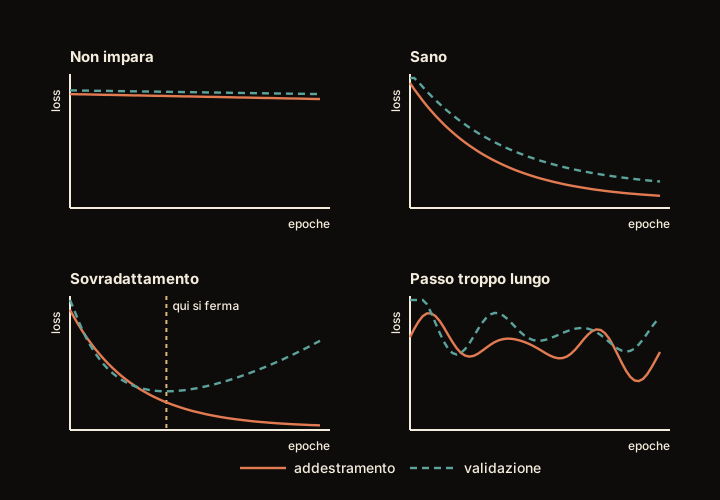
Fig. 7.13 Quattro forme e quattro diagnosi. La forma della coppia di curve dice più del valore finale della loss, ed è il motivo per cui va disegnata mentre l’addestramento gira.#
Le quattro forme di Fig. 7.13 coprono i casi più frequenti.
Non impara. Le curve restano alte e piatte. Qui conviene guardare da
vicino quanto piatte, perché la distinzione è diagnostica. Se la loss è
esattamente identica epoca dopo epoca, il problema non è di apprendimento
ma un bug, e i sospetti sono pochi (manca optimizer.step(),
il learning rate è zero, i parametri sono congelati da un
requires_grad=False di troppo, oppure la loss che si retropropaga non è
collegata all’uscita del modello). Se invece scende pochissimo ma scende, è
underfitting: il modello non ha abbastanza capacità, o il passo è troppo
corto, o le feature non contengono l’informazione richiesta.
Sano. Entrambe scendono, la validazione sta un po’ sopra, e il divario fra le due resta più o meno costante. Un divario c’è quasi sempre e non è una malattia: quello che si sorveglia è se si allarga.
Overfitting. L’addestramento continua a scendere, la validazione tocca un minimo e risale. Il rimedio, l’arresto anticipato, lo racconta per esteso quando fermarsi. Vale però un’avvertenza, che riguarda soprattutto i modelli con molti più parametri che esempi da imparare: lì la risalita può non essere la fine della storia, e continuando ad addestrare la validazione può tornare a scendere una seconda volta. È il fenomeno della doppia discesa, che la sezione su overfitting e validazione racconta in tutte e due le forme, quella che dipende dai parametri e quella che dipende dalle epoche. In pratica l’arresto anticipato resta la regola; chi ha tempo da spendere può continuare oltre il primo minimo, tenendo da parte la copia migliore, e guardare se la seconda discesa arriva.
Passo troppo lungo. Le curve oscillano vistosamente, magari con una tendenza generale al ribasso ma con salti che la coprono. L’ottimizzatore sta scavalcando il minimo a ogni passo, oppure il gradiente è talmente rumoroso da non indicare più una direzione stabile.
La regoletta operativa, una forma di curva alla volta.
Curva piatta come un tavolo: c’è un errore nel codice, e va cercato nel ciclo di addestramento prima di toccare qualunque manopola. Se scende appena, allunga il passo (moltiplicandolo per tre, non alzandolo del dieci per cento, perché la misura giusta può stare mille volte più in là) e, quando non basta, ingrandisci il modello. Se cala in fretta all’inizio e poi si pianta su un valore mediocre, il passo resta troppo lungo per infilarsi nel punto più basso, e va accorciato. Se il divario fra le due si allarga servono i freni, cioè qualcosa che renda la vita più difficile al modello mentre studia (deformare un po’ gli esempi a ogni giro, spegnergli a caso qualche neurone) oppure, più semplicemente, fermarsi prima.
La curva che salta, invece, ha due cause che si somigliano e non si curano allo stesso modo. O il passo è troppo lungo e il modello scavalca il punto più basso a ogni giro, oppure i mazzetti sono troppo piccoli, e con pochi esempi alla volta la direzione che il modello ricava è una media presa male, che traballa da un giro all’altro. Distinguerle costa una prova sola: quadruplica il mazzetto, lasciando il passo com’è, e riguarda le curve. Se il tremolio si calma era la media presa male. Il tremolio si dimezza ogni volta che gli esempi a giro si quadruplicano, ed è per questo che la prova si fa quadruplicando: raddoppiando si toglie meno di un terzo, e a occhio non si vede. Se invece le curve saltano identiche la colpa è del passo, e allora ingrandire i mazzetti non serve a niente, perché si paga il conto senza vedere niente in cambio.
E il collaudo dei dieci esempi, quello del flusso di lavoro, si fa prima di lanciare l’addestramento vero: un solo mazzetto di esempi, una decina, nessun freno, un passo normale, e si addestra finché la loss non arriva quasi a zero. Se la rete, che ha più pesi che esempi, non ci riesce, quasi sempre si è rotto qualcosa lungo la catena, e i posti dove guardare sono pochi. Le etichette non corrispondono più agli esempi a cui erano attaccate; una trasformazione ha rovinato i dati per strada; il conto dell’errore si fa sulla cosa sbagliata; oppure la correzione non arriva fino a tutti i pesi.
Il learning rate lascia una firma riconoscibile, e conviene imparare a
leggerla perché è l’iperparametro a cui l’addestramento è più sensibile
[GBC16]. Troppo alto: la loss esplode o resta alta e
irregolare (nel caso estremo diventa nan). Alto: cala in fretta nelle prime
iterazioni e poi si assesta su un valore mediocre, perché il passo è troppo
lungo per entrare nella conca. Troppo basso: scende in modo quasi lineare e
lentissimo, senza mai piegare. Giusto: cala rapidamente e continua a
migliorare. Poiché la scala giusta cambia di ordini di grandezza fra un
problema e l’altro, la si esplora moltiplicando o dividendo per tre, non
aggiustandola di percentuali.
Il rumore delle curve ha due sorgenti diverse, che si riconoscono da come si comporta l’oscillazione. Il passo troppo lungo produce oscillazioni che non si riducono aumentando la dimensione del batch; il rumore del gradiente scala invece come \(1/\sqrt{B}\) con la dimensione \(B\) del batch, quindi quadruplicare il batch dimezza l’ampiezza. La prova va fatta quadruplicando, non raddoppiando: raddoppiare toglie solo il 29%, che su curve rumorose a occhio non si distingue. Se quadruplicare \(B\) calma visibilmente le curve, era rumore di campionamento; se non cambia nulla, è il passo. La prova si fa a learning rate invariato: così il passo medio resta lo stesso, e cambia soltanto il rumore.
Il collaudo canonico prima di ogni addestramento serio è sovradattare di proposito un batch solo: si prendono otto o dieci esempi, si disattiva ogni regolarizzazione e si addestra su quelli per qualche centinaio di iterazioni. Un modello sano arriva a una loss praticamente nulla, perché memorizzare dieci esempi è alla portata di qualunque rete con più parametri che esempi (una regressione lineare con sei parametri no, e lì il fallimento è atteso). Se non ci riesce con un learning rate ordinario (per Adam, \(10^{-3}\)) e senza regolarizzazione, il difetto è quasi sempre nella catena: etichette disallineate rispetto agli ingressi, una trasformazione che distrugge il segnale, una loss calcolata sulla cosa sbagliata, un gradiente che non arriva a tutti i parametri. È il test più economico del mestiere e quasi nessuno lo fa.
Quando la validazione va meglio dell’addestramento#
C’è una forma che confonde chiunque la incontri la prima volta: la curva di validazione sta sotto quella di addestramento. Sembra impossibile, perché il modello i dati di addestramento li ha visti e quelli di validazione no. Quasi sempre non c’è nulla di rotto, e le spiegazioni sono quattro.
Si stanno confrontando due misure prese in momenti diversi. La loss di addestramento che si stampa è di solito la media su tutti i batch dell’epoca, calcolata mentre i pesi cambiavano, e quindi include anche i pesi peggiori di inizio epoca. Quella di validazione è calcolata alla fine, con i pesi migliori. Nelle prime epoche, quando il miglioramento dentro una singola epoca è grande, questo basta da solo a invertire l’ordine.
La regolarizzazione è attiva solo in addestramento. Il dropout spegne neuroni e la data augmentation deforma gli esempi durante il training e non in valutazione: la rete che produce la loss di addestramento è una rete azzoppata, quella che produce la validazione no.
Il set di validazione è più facile. Può capitare per caso con split piccoli, o sistematicamente se la separazione non è stata casuale (i casi difficili concentrati da una parte sola).
Si è addestrato poco. Nelle prime epoche il modello non ha ancora memorizzato niente, quindi non ha alcun vantaggio sui dati visti.
Le prime due si verificano in un minuto: si ricalcola la loss di addestramento
a fine epoca con model.eval(), sugli stessi pesi con cui si misura la
validazione. Se il paradosso sparisce, non c’era.
# Registrare la storia costa due liste, e senza storia non c'è diagnosi.
storia = {"train": [], "val": []}

for epoca in range(n_epoche):
    modello.train()
    somma, n = 0.0, 0
    for X, y in loader_train:
        ...                                   # i cinque passi soliti
        somma += perdita.item() * X.size(0)   # .item(): niente grafo in memoria
        n += X.size(0)
    storia["train"].append(somma / n)

    modello.eval()                            # niente dropout, niente augmentation
    with torch.no_grad():
        somma, n = 0.0, 0
        for X, y in loader_val:
            somma += loss_fn(modello(X), y).item() * X.size(0)
            n += X.size(0)
    storia["val"].append(somma / n)

    # stampare a ogni epoca, non alla fine: è tutto il punto
    print(f"epoca {epoca:3d}  train {storia['train'][-1]:.4f}  val {storia['val'][-1]:.4f}")

import matplotlib.pyplot as plt
plt.plot(storia["train"], label="addestramento")
plt.plot(storia["val"], label="validazione", linestyle="--")
plt.xlabel("epoche"); plt.ylabel("loss"); plt.legend()
Tre errori che si annunciano, otto che tacciono, più l’overfitting che si legge nelle curve. Il metodo vale per tutti e dodici: leggere il messaggio dal basso, stampare la terna, ridurre il problema, fare un giro a vuoto, e per gli errori silenziosi disegnare le due curve dalla prima epoca.
Da ricordare
Un tensore ha forma, tipo e dispositivo: quasi ogni errore rosso di PyTorch riguarda uno di questi tre, e la prima cosa da fare è stamparli tutti e tre, per il tuo dato e per quello che gli sta di fronte.
Forma: manca lo strato che srotola l’immagine, due strati non combaciano, oppure manca il mazzetto attorno all’esempio singolo.
Tipo: numeri decimali per i dati, numeri interi per le etichette quando la risposta è una categoria fra tante. Le immagini appena lette sono fatte di interi da 0 a 255 e vanno convertite una volta sola, appena entrano.
Dispositivo: spostare il modello lo sposta davvero; spostare un dato restituisce una copia, e se non la riassegni non hai fatto niente.
Il metodo vale più dei rimedi: leggi l’errore dall’ultima riga in su, stampa forma-tipo-dispositivo, riduci il problema a un esempio solo, e prova la catena con un dato finto prima di lanciare l’addestramento vero.
Gli errori peggiori sono quelli silenziosi, quelli senza niente di rosso: le correzioni del giro prima non azzerate, la softmax applicata due volte, la modalità studio lasciata accesa durante l’esame, la perdita accumulata intera invece che ridotta al suo numero, e la predizione confrontata con un’etichetta di forma diversa, che si aggancia lo stesso e dà un numero senza senso.
Per gli errori silenziosi il messaggio d’errore è la coppia di curve, e va disegnata dalla prima epoca. Piatta come un tavolo: è un errore nel codice. Scende appena: passo corto o modello piccolo. Salta: passo lungo o mazzetti troppo piccoli. Distanza fra le due che si allarga: servono i freni.
Far imparare a memoria dieci esempi, con un passo normale e senza freni, è il collaudo più economico che esista: se il modello non ci riesce, quasi sempre il difetto è nel codice.
La validazione sotto l’addestramento di solito non è un guasto: il numero dell’addestramento è una media presa mentre il modello stava ancora cambiando, e i trucchi che si usano solo mentre si studia penalizzano soltanto lui.
Da ricordare
Un tensore ha forma, tipo e dispositivo: quasi ogni
RuntimeErrordi PyTorch riguarda uno di questi tre.Forma: manca
nn.Flatten(), due strati non combaciano, o manca la dimensione del batch (unsqueeze(0)).torchinfo.summaryla mostra strato per strato.Tipo:
float32per i dati,int64per le etichette dellaCrossEntropyLoss,float32per quelle dellaBCEWithLogitsLoss. NumPy producefloat64: convertire al confine.Dispositivo:
modello.to(device)modifica sul posto,x.to(device)restituisce una copia da riassegnare. I tensori creati nelforwardvanno creati condevice=x.device; le costanti del modello conregister_buffer.Il metodo vale più dei rimedi: traceback dal basso, stampa della terna, problema ridotto, giro a vuoto con un tensore finto.
Gli errori peggiori sono quelli silenziosi:
zero_gradmancante (con SGD e passo corto la loss all’inizio può perfino scendere più in fretta, con passo lungo esplode; con Adam al passo di default l’esito dipende dal problema e la curva da sola non denuncia il bug, ed è il caso peggiore; a passo grande diverge anche Adam), softmax doppia,eval()dimenticato,.item()dimenticato nell’accumulo (e in valutazione senzatorch.no_grad()la memoria finisce), e forme di predizione e target che si allineano per broadcasting (assert pred.shape == target.shapeprima delle loss che confrontano forme uguali: MSE, L1, BCE).Per gli errori silenziosi il messaggio d’errore è la coppia di curve, e va disegnata dall’epoca uno. Piatta come un tavolo: è un bug. Scende appena: passo corto o modello piccolo. Salta: passo lungo o batch piccolo. Divario che si allarga: servono i freni.
Sovradattare di proposito un batch da dieci esempi è il collaudo più economico che esista: se il modello non ci riesce con un learning rate ordinario e senza regolarizzazione, il difetto è quasi sempre nella catena.
La validazione sotto l’addestramento di solito non è un guasto: la loss di training è una media presa mentre i pesi cambiavano, e dropout e augmentation penalizzano solo il training.
Il codice visto finora è codice da notebook, che per esplorare è lo strumento giusto. Quando lo stesso codice deve sopravvivere più di un pomeriggio, ed essere rilanciato da altri o da sé stessi fra un mese, la forma cambia: è il passaggio dal notebook agli script.