



L’attenzione in pratica#
Nel novembre del 2019 esce un articolo di nove pagine, firmato da una persona sola, che si intitola Fast Transformer Decoding: One Write-Head is All You Need [Sha19]. Il gioco di parole è deliberato: l’autore è Noam Shazeer, secondo firmatario dell’articolo del 2017. Due anni dopo aver scritto che serviva l’attenzione, torna sulla stessa formula per dire che, al momento di generare, basta una sola testa per le chiavi. La formula resta quella; cambiano la memoria occupata e il modo di eseguirla.
Lo stesso strato di attenzione gira in due modalità: con tutta la sequenza insieme in addestramento, o un token alla volta in generazione. I costi delle due sono molto diversi, ed è per questo che separarle serve a leggere con precisione ciò che si dice sui costi dell’attenzione (che sia quadratica, che richieda molta memoria, che le teste condivise facciano risparmiare).
Addestrare e generare: due regimi della stessa formula#
Un modello che scrive lo fa in modo autoregressivo: produce un token, se lo rimette in ingresso, produce il successivo. La sezione sulla struttura del Transformer ha montato la maschera causale che lo rende possibile, e da lì discendono i costi dei due regimi.
Un correttore di bozze e uno scrittore lavorano sullo stesso testo con due ritmi opposti. Il correttore ha davanti il testo finito: può guardare la pagina tutta insieme, e su ogni parola fare il suo lavoro nello stesso momento in cui lo fa su tutte le altre. Lo scrittore no: la parola numero venti non esiste finché non ha scritto la diciannovesima, quindi procede per forza una parola alla volta.
L’addestramento assomiglia al correttore. Il testo c’è già tutto, il modello lo elabora in un colpo solo, e il divieto di sbirciare avanti glielo impone la maschera invece del tempo. La generazione assomiglia allo scrittore, e non c’è nessun trucco che la renda parallela: le parole che non ha ancora prodotto non esistono da nessuna parte.
Da qui nasce lo spreco che spiega tutto il resto. Rifare tutto il lavoro a ogni parola vorrebbe dire, per una risposta di mille parole, rileggere da capo il testo mille volte: alla parola numero mille si ricalcolerebbero per la millesima volta risultati già ottenuti quando la prima parola era appena uscita. I risultati, però, non sono cambiati. Poiché nessuna parola può guardare avanti, il contenuto che il modello ricava dalla parola numero tre è lo stesso quando la frase finisce lì e quando è lunga mille.
Non si conserva la domanda che una parola ha posto: serviva a quella parola e a quel momento, dà il suo risultato e si butta. Si tengono invece l’etichetta con cui la parola si fa trovare e l’informazione che consegna, perché vi attingeranno tutte le parole successive.
Il riuso vale finché vale il divieto di guardare avanti. Se ogni parola potesse tener conto anche di quelle che verranno, aggiungerne una in fondo cambierebbe l’etichetta di tutte le altre, e il lavoro andrebbe rifatto da capo a ogni parola nuova. Le macchine a cui il divieto non si applica, cioè quelle che leggono un testo già scritto per capirlo e non per continuarlo, sono fatte proprio così: ogni parola tiene conto anche di quelle dopo. La traduzione è un caso a parte: il modello legge la frase da tradurre una volta sola, e le sue rappresentazioni restano valide per tutta la traduzione.
Sia \(T\) la lunghezza del prefisso già elaborato. Le due modalità in cui lo stesso strato viene chiamato hanno forme diverse.
Nell’elaborazione a prefisso pieno (addestramento, oppure il prefill di un prompt) molte posizioni di query vengono trattate insieme: \(L = S = T\), la matrice dei punteggi è \(T \times T\), e il calcolo è un prodotto fra matrici denso, ideale per l’hardware parallelo. La maschera causale garantisce che il risultato coincida con quello ottenuto elaborando le posizioni una per una.
Nella decodifica incrementale arriva un token per volta: \(L = 1\) (o poche righe, con la decodifica speculativa) e \(S = T + 1\). La matrice dei punteggi ha una riga sola, e il collo di bottiglia si sposta dal calcolo alla banda di memoria.
La ragione per cui la seconda modalità può riusare il lavoro della prima discende dalla struttura della maschera, non da un’euristica. Con attenzione causale, la rappresentazione della posizione \(j\) a ogni strato dipende solo dalle posizioni \(\le j\); quindi \(\mathbf{k}_j\) e \(\mathbf{v}_j\), che sono proiezioni lineari di quella rappresentazione, sono determinati appena il token \(j\) è stato elaborato, e non cambiano quando la sequenza si allunga. Formalmente, \(\mathbf{k}_j = \mathbf{W}^{K\top} \mathbf{h}_j^{(\ell)}\) con \(\mathbf{h}_j^{(\ell)} = f^{(\ell)}(\mathbf{x}_{1:j})\), indipendente da \(\mathbf{x}_{>j}\).
Anche la query \(\mathbf{q}_t\) è determinata appena il token \(t\) è elaborato, ma non si conserva: serve a calcolare la riga \(t\) della matrice dei pesi, viene consumata in quel prodotto e nessuna query successiva la rilegge. Chiavi e valori si distinguono dalla query per il riuso, non per la stabilità: tutte le query che verranno li rileggeranno. Conservare \(\mathbf{Q}\) sarebbe occupare memoria per un oggetto che nessuno consulterà più.
Si noti che la garanzia vale per l’attenzione causale. In un encoder bidirezionale la rappresentazione di ogni posizione, dal secondo strato in su, dipende anche da ciò che viene dopo, quindi aggiungere un token invalida le chiavi e i valori già calcolati a quei livelli (al primo strato dipendono soltanto dall’embedding del loro token). Un caso a parte è la cross-attention di un modello encoder-decoder: chiavi e valori vengono dall’uscita dell’encoder, che si calcola una volta sola, e restano fissi per tutta la generazione, una cache che non cresce.
La cache KV, come struttura dati#
Da questa osservazione nasce la KV cache, già incontrata nella sezione sulla FlashAttention: la memoria di chiavi (K) e valori (V) già calcolati, che ogni sistema di inferenza usa per generare. Per ogni strato e per ogni testa di chiave e valore, è una coppia di matrici che cresce di una riga per ogni token elaborato.
Un taccuino, uno per ogni piano del palazzo e per ogni lettore. Ogni volta che il modello elabora una parola nuova ci scrive due righe: l’etichetta con cui quella parola si farà trovare, e l’informazione che consegnerà a chi la sceglie. Le righe già scritte non si correggono mai, si aggiungono soltanto. È l’opposto del taccuino della LSTM, che aveva una pagina sola e per fare posto cancellava: questo si allunga di due righe a ogni parola. Per la parola nuova bastano le righe che ci sono: la domanda che quella parola pone si confronta con tutte le etichette del taccuino, e il miscuglio si fa con le informazioni che ci stanno accanto.
Il risparmio si vede contando che cosa si evita. Senza taccuino, ogni parola nuova costringe a ricavare etichetta e informazione per tutte le parole già scritte; con il taccuino, se ne ricavano due sole, quelle della parola nuova. Il resto è già scritto.
Il taccuino non elimina il confronto. La parola nuova guarda comunque tutte le righe scritte finora, quindi il lavoro per ogni parola cresce con il testo: la millesima si confronta con mille righe, la duemillesima con duemila. Dire che il taccuino rende la scrittura gratuita significa guardare solo la metà che si risparmia.
Resta lo spazio, che si vede subito sul taccuino di una conversazione lunga. Ad esempio, un palazzo moderno, molto più alto di quello del 2017, ha trentadue piani con trentadue lettori per piano: circa mille taccuini, ciascuno con due righe per ogni parola scritta, e ogni riga è fatta di centoventotto numeri da due byte. Mille per due per centoventotto per due fa circa mezzo megabyte a parola, e una conversazione da ottomila parole ne occupa più di quattro gigabyte.
A ogni parola nuova quel materiale va riletto tutto, insieme ai numeri del modello. A questo punto la domanda diventa dove tenere i taccuini.
Per ogni strato \(\ell\) e ogni testa di chiave-valore, la cache tiene due matrici che crescono per righe:
Al passo \(t\) lo strato calcola \(\mathbf{q}_t, \mathbf{k}_t, \mathbf{v}_t\) per il solo token nuovo, aggiunge in coda \(\mathbf{k}_t\) e \(\mathbf{v}_t\) alle rispettive matrici e valuta l’attenzione di \(\mathbf{q}_t\) (una riga) contro le \(t\) righe accumulate. È il caso \(L \neq S\) per eccellenza: \(1 \times t\) invece di \(t \times t\).
Il numero di elementi conservati per token, sommando su tutti gli strati, è
dove il \(2\) conta chiavi e valori, \(n_{\text{strati}}\) è il numero degli strati (da non confondere con l’indice \(\ell\) che ne individua uno), \(h_{kv}\) è il numero di teste di chiave-valore e \(d_k\) la dimensione per testa (qui e nel seguito \(d_v = d_k\), come in quasi tutte le implementazioni). In byte si moltiplica per la dimensione del tipo numerico. Il numero non dipende dalle teste di query, e MQA, GQA e MLA sfruttano questa indipendenza.
Il costo in calcolo, per token e per strato, si divide in due termini di natura diversa: \(O(t\, d)\) per l’attenzione contro il prefisso, e \(O(d^2)\) per le proiezioni e la rete feed-forward, con \(d = d_{\text{model}}\). Il secondo non dipende dalla lunghezza; il primo invece cresce linearmente con il numero di token già elaborati. La generazione di \(n\) token ha quindi costo \(O(n^2 d + n\, d^2)\) per strato, contro l’\(O(n^3 d + n^2 d^2)\) di un forward rifatto da capo a ogni passo.
La cache riusa le proiezioni passate e non abolisce l’interazione con il prefisso; di conseguenza l’affermazione «la cache rende la decodifica a costo costante» è falsa per l’attenzione densa.
In decodifica domina la lettura della memoria, non il calcolo. Con una richiesta per volta, ogni token generato rilegge dalla memoria tutti i pesi del modello e tutta la cache, quindi il tempo per token è almeno
con \(b_{\text{pesi}}\) i byte dei pesi, \(b_{\text{KV}}\) i byte di cache per token (\(2\,n_{\text{strati}}\,h_{kv}\,d_k\) elementi, per la dimensione del tipo numerico), \(T\) il contesto e \(B\) la banda della memoria: è il collo di bottiglia sulla banda della decodifica incrementale, e il contributo della cache in quella somma cresce con \(T\). Con \(R\) richieste servite insieme, ciascuna con contesto \(T\), la cache occupa \(R\,T\,b_{\text{KV}}\) byte, mentre i pesi, condivisi, restano gli stessi.
Il modo più rapido di convincersi che le due strade danno la stessa cosa è
eseguirle entrambe: si costruisce uno strato di attenzione causale con pesi
casuali, lo si esegue prima sulla sequenza intera e poi un token alla
volta con la cache, confrontando le due uscite. La funzione attenzione è
una sola, chiamata con forme diverse.
import torch

torch.manual_seed(0)
d_model, d_k, T = 16, 4, 6
W_Q, W_K, W_V = (torch.randn(d_model, d_k) / d_k**0.5 for _ in range(3))
X = torch.randn(T, d_model)          # i sei token del prefisso

def attenzione(Q, K, V):
    """Attenzione causale con L query e S chiavi, allineate a destra:
    l'ultima query vede tutte le S chiavi."""
    L, S = Q.shape[0], K.shape[0]
    punteggi = Q @ K.T / Q.shape[-1] ** 0.5
    vietato = torch.triu(torch.ones(L, S, dtype=torch.bool), diagonal=S - L + 1)
    return torch.softmax(punteggi.masked_fill(vietato, float("-inf")), -1) @ V

# 1) tutto il prefisso in un colpo: L = S = 6, matrice quadrata
O_pieno = attenzione(X @ W_Q, X @ W_K, X @ W_V)

# 2) un token per volta, con la cache: L = 1, S che cresce
K_cache, V_cache, uscite = torch.empty(0, d_k), torch.empty(0, d_k), []
for t in range(T):
    x_t = X[t:t+1]                                # il solo token nuovo
    K_cache = torch.cat([K_cache, x_t @ W_K])     # la cache cresce di una riga
    V_cache = torch.cat([V_cache, x_t @ W_V])     # la query non si conserva
    uscite.append(attenzione(x_t @ W_Q, K_cache, V_cache))
O_cache = torch.cat(uscite)

print("cache dopo sei token:", tuple(K_cache.shape), tuple(V_cache.shape))
print("le due strade coincidono:", torch.allclose(O_pieno, O_cache, atol=1e-5))
cache dopo sei token: (6, 4) (6, 4)
le due strade coincidono: True
Si noti che la maschera dipende dalle due lunghezze, \(L\) query e \(S\) chiavi:
nel caso quadrato dà il solito triangolo, con una query sola non vieta niente.
Questo allineamento a destra, necessario per generare (nel codice
diagonal=S - L + 1), permette alla stessa funzione di servire entrambi i
regimi. Le uniche righe che scrivono nella cache sono le due che la allungano;
della query \(\mathbf{q}_t\) non resta traccia.
Quante teste per le chiavi: da MHA a MLA#
La cache dipende dal numero di teste di chiave e valore, non da quello delle teste di query. Su questa osservazione si fondano, dal 2019, tre varianti della multi-head attention originale (MHA) che ne riducono la cache in modi diversi: la multi-query attention (MQA), la grouped-query attention (GQA) e la multi-head latent attention (MLA). Fig. 16.7 le mette una accanto all’altra.
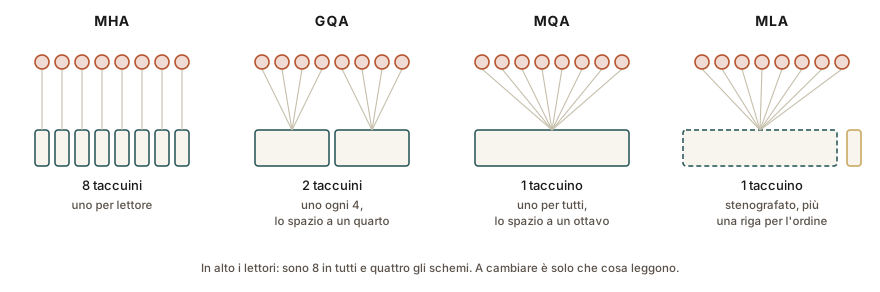
Fig. 16.7 Le quattro formulazioni, una accanto all’altra. In alto, in tutte e quattro, la stessa fila di otto teste di query, i lettori; sotto, i taccuini, cioè le cache di chiave e valore che ciascuna testa consulta. MHA ne dà uno a testa, GQA uno per gruppo, MQA uno per tutti; MLA ne tiene uno solo come MQA, ma dentro ci scrive un riassunto compresso, e lascia fuori il segnale dell’ordine delle parole, su una striscia a parte. La larghezza di un taccuino dice a quante teste serve, non quanto occupa.#
Torniamo al palazzo del 2017, con otto lettori per piano: con numeri piccoli il filo si segue meglio. Finora ognuno teneva il proprio taccuino: otto etichette e otto informazioni per ogni parola, per ogni piano. È la formulazione che i testi chiamano MHA. Eppure i lettori si distinguono per le domande che pongono, non per il materiale che consultano: perché non farli leggere dallo stesso taccuino?
La versione estrema, MQA, lo fa: un taccuino solo per piano, otto lettori che vi attingono tutti, ciascuno con le sue domande. Lo spazio si divide per il numero dei lettori, la scrittura diventa molto più svelta e si perde qualcosa in qualità, perché otto punti di vista che consultavano appunti diversi adesso consultano gli stessi.
La versione di mezzo, GQA, divide i lettori in gruppi: due gruppi da quattro, e un taccuino per gruppo. Il numero dei gruppi è la manopola che decide dove stare fra i due estremi. L’hanno adottata quasi tutti, perché nelle prove di chi l’ha proposta, con pochi gruppi, la perdita resta piccola. La seconda ragione pesa quanto la prima: un palazzo già costruito, con il suo taccuino per ogni lettore, si converte ai gruppi senza tirarlo giù. Si fondono gli appunti dei lettori di uno stesso gruppo facendone la media, si rimette a punto il tutto per un ventesimo del tempo impiegato a costruirlo, e il palazzo riapre.
MLA segue un’altra strada. Invece di far leggere a più lettori lo stesso taccuino, riscrive che cosa ci si annota: al posto delle etichette e delle informazioni per esteso, un riassunto compatto da cui le une e le altre si ricostruiscono al momento del bisogno. È un taccuino di appunti stenografati che occupa una frazione dello spazio e che, nelle prove di chi l’ha inventato, non fa leggere peggio dei taccuini separati. Un punto resta scomodo, l’ordine delle parole: quel segnale va tenuto fuori dal riassunto, su una riga a parte, altrimenti il risparmio svanisce.
Nessuna di queste strade riduce il numero di lettori, come invece si sente dire. Le domande restano otto e i punti di vista restano otto; si condivide o si comprime il materiale su cui si legge.
MHA, MQA e GQA si distinguono per come trattano \(h_{kv}\) rispetto a \(h_q\); MLA cambia invece l’oggetto conservato.
Multi-head attention (MHA), la formulazione originale: \(h_{kv} = h_q\), una proiezione di chiave e una di valore per ogni testa di query. Cache per token \(2\,n_{\text{strati}}\,h_q\,d_k\).
Multi-query attention (MQA) [Sha19]: \(h_{kv} = 1\). Tutte le teste di query condividono un’unica testa di chiave e un’unica testa di valore. La cache si riduce di un fattore \(h_q\), e con essa la banda di memoria richiesta a ogni passo di decodifica, con una perdita di qualità rispetto a MHA.
Grouped-query attention (GQA) [ALTdJ+23]: \(1 < h_{kv} < h_q\). Le teste di query sono partizionate in \(h_{kv}\) gruppi, e ogni gruppo condivide una testa di chiave-valore. Il numero di gruppi è l’iperparametro che sposta il modello fra i due estremi, e gli autori mostrano che con pochi gruppi si ottiene quasi la velocità di MQA restando vicini alla qualità di MHA. Lo stesso lavoro contiene il risultato che ne ha favorito l’adozione: un modello già addestrato con MHA si converte con un uptraining pari al 5% del calcolo del preaddestramento originale. Prima si sostituiscono le proiezioni di chiave e valore di ciascun gruppo con la loro media, una scelta che negli esperimenti degli autori funziona meglio che tenere una testa sola o ripartire da pesi casuali.
Multi-head latent attention (MLA), introdotta con DeepSeek-V2 [DeepSeekAI24a]: cambia la rappresentazione conservata invece del numero di teste. Una compressione congiunta a rango basso produce un latente \(\mathbf{c}^{KV}_t = \mathbf{W}^{DKV}\mathbf{h}_t \in \mathbb{R}^{d_c}\) con \(d_c \ll h_q d_k\), e da lì due proiezioni apprese ricostruiscono chiavi e valori. In decodifica si conserva il solo latente, e le matrici di ricostruzione si assorbono in \(\mathbf{W}^Q\) e \(\mathbf{W}^O\), quindi chiavi e valori per esteso non vengono nemmeno materializzati.
La RoPE è però incompatibile con questa compressione: applicandola alle chiavi ricostruite, la matrice di ricostruzione resterebbe incastrata fra \(\mathbf{W}^Q\) e una matrice di rotazione che dipende dalla posizione corrente, e l’assorbimento non sarebbe più possibile. DeepSeek-V2 risolve con una RoPE disaccoppiata: una componente di chiave a parte, condivisa fra le teste, che porta il segnale posizionale. La cache contiene quindi il latente più quella componente, \((d_c + d_k^R)\,n_{\text{strati}}\) elementi per token.
formulazione |
elementi in cache per token |
teste di chiave-valore |
|---|---|---|
MHA |
\(2\,n_{\text{strati}}\,h_q\,d_k\) |
quante quelle di query |
GQA |
\(2\,n_{\text{strati}}\,h_{kv}\,d_k\) |
un numero intermedio |
MQA |
\(2\,n_{\text{strati}}\,d_k\) |
una |
MLA |
\((d_c + d_k^R)\,n_{\text{strati}}\) |
altra formulazione |
In particolare, con i valori di DeepSeek-V2 (\(d_c = 4 d_k\), \(d_k^R = d_k/2\)) la cache di MLA equivale a quella di un GQA con 2,25 gruppi. MLA non è riducibile a un GQA con meno teste, perché cambia l’oggetto conservato e l’algebra delle proiezioni usata in inferenza. Gli stessi autori misurano che, con modelli densi da circa 7 miliardi di parametri, su BBH, MMLU, C-Eval e CMMLU MHA supera GQA con otto gruppi e MQA (su MMLU 45,2 contro 41,2 e 37,9): condividere le teste ha un costo in qualità, che i benchmark difficili mostrano. Sulla qualità di MLA riportano che, con una cache pari al 14% (scala piccola) e al 4% (scala grande) di quella di MHA, l’architettura supera MHA su quattro benchmark e due scale di modelli a esperti (con la sola eccezione di C-Eval sulla scala piccola). È un risultato di chi ha progettato il modello, e l’implementazione è più complessa, fra RoPE disaccoppiata e assorbimento delle matrici.
Si noti che nessuna delle tre varianti tocca il numero di teste di query, e con esso la molteplicità dei sottospazi in cui il modello calcola le compatibilità: si condivide o si comprime la rappresentazione conservata.
Per un modello di taglia ordinaria (trentadue strati, trentadue teste di query, \(d_k = 128\), quindi \(d_{\text{model}} = 4096\)) con chiavi e valori a 16 bit, si calcola quanta memoria richiede la cache per ogni token e su una finestra di ottomila, e quale frazione dei byte da rileggere a ogni token generato è dovuta alla cache, a finestra piena.
strati, teste_q, d_k, byte, contesto = 32, 32, 128, 2, 8192
pesi = 7e9 * byte                    # sette miliardi di parametri, a 16 bit

varianti = [
    (f"MHA   (h_kv = {teste_q})",       2 * strati * teste_q * d_k),
    ("GQA   (h_kv = 8)",                2 * strati * 8 * d_k),
    ("MQA   (h_kv = 1)",                2 * strati * 1 * d_k),
    ("MLA   (d_c = 4 d_k, d_R = d_k/2)", strati * (4 * d_k + d_k // 2)),
]

# per ogni token generato si rileggono i pesi e tutta la cache
print(f"{'variante':34}{'KiB/token':>11}{'GiB a 8192':>12}{'cache/letti':>13}")
for nome, elementi in varianti:
    per_token = elementi * byte
    cache = per_token * contesto
    print(f"{nome:34}{per_token/1024:11.0f}{cache/1024**3:12.2f}"
          f"{cache/(cache + pesi):13.1%}")
print(f"\npesi del modello: {pesi/1024**3:.1f} GiB")
variante                            KiB/token  GiB a 8192  cache/letti
MHA   (h_kv = 32)                         512        4.00        23.5%
GQA   (h_kv = 8)                          128        1.00         7.1%
MQA   (h_kv = 1)                           16        0.12         0.9%
MLA   (d_c = 4 d_k, d_R = d_k/2)           36        0.28         2.1%

pesi del modello: 13.0 GiB
In concreto, una sola conversazione da ottomila token occupa 4 GiB, contro i 13 dei pesi: con quattro richieste servite insieme la cache supera il modello, e già con una, a finestra piena, quasi un quarto dei byte da rileggere a ogni token generato è cache. Il caso GQA spiega perché questa variante si trovi in quasi tutti i modelli recenti, il caso MLA perché si sia cambiata la formulazione dell’attenzione per un problema di memoria. Il caso MHA, in cui ogni testa di query tiene le sue chiavi, viene ripreso nella sezione sui grandi modelli linguistici per analizzare un modello da sette miliardi di parametri: mezzo megabyte a token.
Che cosa è quadratico, e di quale risorsa si parla#
Il confronto coi modelli precedenti ha separato il tempo dalla memoria. La distinzione va portata più in là, perché sotto la parola «quadratico» stanno grandezze diverse, che i discorsi sui costi trattano spesso come una sola.
Il lavoro aritmetico dell’attenzione densa su una sequenza di lunghezza \(n\), cioè quante moltiplicazioni e somme richiede, ha un termine \(O(n^2 d)\) per strato, che cresce come il quadrato della lunghezza: è una proprietà dell’operazione, perché le coppie query-chiave sono \(n^2\) e vanno calcolate tutte.
La memoria intermedia materializzata, cioè quanti numeri si tengono scritti tutti insieme a metà del calcolo, è una proprietà dell’implementazione: un’implementazione ingenua scrive la matrice \(n \times n\) dei punteggi, e allora anche lo spazio è quadratico; una che non la scrive tutta insieme non lo è.
Il traffico di memoria, cioè quanti byte si spostano fra la memoria grande e lenta della scheda grafica e quella piccola e veloce dove si eseguono i calcoli, è una terza grandezza ancora, e sulle schede di oggi decide spesso il tempo di esecuzione, a parità di operazioni da compiere.
Tenerle distinte permette di dire due cose insieme senza contraddirsi: l’attenzione densa fa un numero quadratico di interazioni, e un’implementazione esatta può evitare di scrivere in memoria l’intera matrice quadratica e girare molto più in fretta. Quest’ultima è la strada della FlashAttention, che esegue l’attenzione esatta un pezzo alla volta: a parità di risultato cambia solo l’esecuzione, come mostra in dettaglio la sezione sulla FlashAttention. Una famiglia diversa di rimedi cambia invece quali coppie si calcolano, con finestre locali o schemi sparsi, e allora l’attenzione non è più densa; un’altra ancora riscrive la softmax per non formare mai le coppie, come nel capitolo sull’attenzione lineare.
Mentre il modello genera, un token alla volta, il quadro cambia forma. Per ogni token generato, con la cache, il lavoro dell’attenzione cresce linearmente con la lunghezza già letta, non quadraticamente; il quadrato ricompare quando si somma su tutti i token generati. La cache, invece, occupa una memoria che cresce linearmente con la lunghezza per tutta la durata della richiesta: moltiplicata per le richieste servite insieme, è la voce che per prima limita il contesto e le conversazioni aperte. A ogni passo, inoltre, va riletta per intero, e quando il contesto è lungo questa lettura fissa il tempo per token.
Gli errori che si fanno davvero#
Chi scrive da zero uno strato di attenzione sbaglia più spesso le forme, gli assi e le convenzioni che la formula, e molti errori non fanno rumore: il codice gira, le matrici hanno la forma giusta e il modello impara, un po’ peggio di quanto potrebbe. Il più facile da diagnosticare è la softmax sull’asse sbagliato, che definisce un’altra operazione e ha un sintomo netto: le righe non sommano più a uno.
import torch

punteggi = torch.tensor([[2., 0., 1.],
                         [0., 3., 1.],
                         [1., 1., 4.]])
print("somma per riga, normalizzando sulle chiavi:",
      torch.softmax(punteggi, dim=-1).sum(dim=-1))
print("somma per riga, normalizzando sulle query: ",
      torch.softmax(punteggi, dim=0).sum(dim=-1).round(decimals=4))
somma per riga, normalizzando sulle chiavi: tensor([1.0000, 1.0000, 1.0000])
somma per riga, normalizzando sulle query:  tensor([0.7525, 0.9791, 1.2684])
Quattro di questi errori riguardano il tabellone, e la sezione sull’attenzione li ha già mostrati uno per uno: colorare per colonna invece che per riga, e le righe smettono di sommare a uno; dimenticare la divisione prima di colorare, e il modello impara un po’ peggio, tanto più quanto più le liste sono lunghe, senza che niente si rompa; cancellare dopo aver colorato, e il miscuglio esce sbiadito; dare il tabellone per quadrato quando chi chiede e chi risponde sono due liste di lunghezza diversa, e il divieto di guardare avanti si allinea dalla parte sbagliata.
Gli altri tre riguardano i taccuini e la stima dello spazio. Il primo è contare i lettori al posto dei taccuini: da quando i lettori condividono gli appunti i due numeri sono diversi, e una stima fatta sui lettori sbaglia in eccesso, cioè nella direzione che non fa mai suonare nessun allarme. Il secondo è consegnare al piano dopo le intensità del colore invece del miscuglio: le intensità servono a decidere le proporzioni e poi escono di scena, mentre va consegnata la miscela delle informazioni, che ha tutt’altra forma e tutt’altro significato. Il terzo è confrontare due misure di memoria senza dire che cosa comprendono: i numeri del modello, il tabellone di passaggio, i taccuini e tutto ciò che il computer tiene aperto per lavorare sono voci distinte, e due conti che non dichiarano quali voci includono non si possono paragonare.
La softmax lungo la dimensione sbagliata. L’attenzione normalizza sulle
chiavi, per ogni query: dim=-1 su un tensore (..., L, S). Normalizzare
lungo le query definisce un’altra operazione, e le righe di \(\mathbf{A}\) non
sommano più a 1.
La scala dimenticata. Senza il fattore \(1/\sqrt{d_k}\) il modello si addestra lo stesso e degrada al crescere di \(d_k\), in un modo che nessun controllo segnala.
La maschera applicata dopo la softmax. Azzerare i pesi vietati a valle lascia righe che non sommano a 1, e con un logit vietato abbastanza grande manda in underflow quelli permessi. Il divieto va sommato ai punteggi prima della normalizzazione.
La maschera quadrata dove \(L \neq S\). Un triangolo costruito sul presupposto che righe e colonne siano in corrispondenza uno a uno risulta errato non appena le due lunghezze differiscono, cioè nell’attenzione incrociata e nella decodifica con la cache. L’allineamento va dichiarato, e va fatto combaciare con la convenzione della libreria.
Le teste di query confuse con quelle di chiave-valore. In GQA i due numeri differiscono, e ogni conto sulla cache va fatto con \(h_{kv}\). Usare \(h_q\) sovrastima la memoria di un fattore \(h_q/h_{kv}\), pari al numero di teste di query che condividono la stessa testa di chiave-valore: con trentadue teste di query e otto di chiave-valore il fattore è quattro, non otto come i gruppi. La stima è in eccesso, e non produce errori di esecuzione immediati.
I pesi di attenzione presi per l’uscita dello strato. \(\mathbf{A}\) è un intermedio \(L \times S\); l’uscita è data da \(\mathbf{A}\mathbf{V}\), a cui seguono la concatenazione delle teste, la proiezione \(\mathbf{W}^O\) e il resto del blocco. Restituire i pesi da una funzione che deve restituire l’uscita produce tensori di forma plausibile e risultati senza senso.
La memoria dell’attenzione confrontata senza dichiarare che cosa si conta. Pesi, matrice temporanea dei punteggi, cache, attivazioni e spreco dell’allocatore sono grandezze distinte, e due misure che non dicono quali voci includono non sono confrontabili.
Le frasi che si sentono dire#
Attorno all’attenzione circolano alcune frasi fatte che sopravvivono perché sono quasi vere, e che si smontano una per una.
«L’attenzione è la memoria del modello.» L’attenzione è un’operazione di mescolamento, e non conserva niente da una chiamata all’altra. Durante la generazione persiste soltanto la cache, che appartiene al sistema di inferenza e viene scartata a fine risposta. Fra una conversazione e l’altra il modello non ricorda nulla: ciò che sembra memoria è testo che qualcuno gli rimette davanti, e la sezione sul context engineering racconta come lo si sceglie.
«Più teste è meglio.» A \(d_{\text{model}}\) fisso, cioè a parità di dimensione complessiva, aumentare le teste le rende più strette: con \(d_{\text{model}} = 512\), otto teste lavorano in dimensione 64 e trentadue in dimensione 16. Oltre una certa soglia lo spazio di ciascuna testa diventa troppo ristretto per rappresentare una compatibilità utile, e il guadagno di varietà viene superato dalla perdita di risoluzione. Il numero di teste è un compromesso da calibrare sul modello, non una quantità da massimizzare. L’articolo del 2017 lo misura a calcolo costante (Tabella 3, righe A): con una testa sola il BLEU scende da 25,8 a 24,9, con sedici resta 25,8, con trentadue ridiscende a 25,4. Su un modello già addestrato molte teste si tolgono con perdite trascurabili [MLN19].
«I pesi di attenzione sono la spiegazione.» È la frase più diffusa e la più delicata, perché quei pesi sono facili da visualizzare: sono distribuzioni sulle posizioni d’ingresso, e la tentazione di leggere un peso alto come «il modello ha usato questo token perché contava» è forte. Il dibattito ha due voci. Jain e Wallace [JW19] hanno mostrato casi in cui i pesi appresi si legano debolmente alle misure di importanza basate sul gradiente, e in cui distribuzioni di attenzione molto diverse davano previsioni quasi identiche. Wiegreffe e Pinter [WP19] hanno contestato il rifiuto categorico, sostenendo che la risposta dipende da che cosa si chiama spiegazione e da quali termini di paragone si adottano. La posizione difendibile sta in mezzo, più stretta di tutti e due gli slogan: un peso alto dice dove è andata l’aggregazione, e non dice perché il modello abbia risposto così. Leggerlo come una spiegazione richiede un metodo e una validazione, di cui si occupa la sezione su attribuzione e interpretabilità meccanicistica.
L’attenzione che si usa davvero#
Scrivere l’attenzione a mano serve a capirla; chi la deve far girare chiama una
funzione di libreria, che seleziona l’implementazione adatta all’hardware
disponibile. In PyTorch è scaled_dot_product_attention, e la sua firma
raccoglie quasi tutti gli oggetti discussi: maschera, scala, teste di
chiave-valore.
import torch.nn.functional as F

# query: (batch, teste_q, L, d_k)    chiave e valore: (batch, teste_kv, S, d_k)
uscita = F.scaled_dot_product_attention(
    query, chiave, valore,
    attn_mask=None,     # maschera booleana o additiva; alternativa a is_causal
    dropout_p=0.0,      # da azzerare in valutazione
    is_causal=True,     # la maschera causale, senza materializzarla
    scale=None,         # None significa 1/sqrt(d_k)
    enable_gqa=True,    # teste_kv < teste_q: la condivisione la fa la funzione
)
L’interfaccia nasconde due trappole di convenzione. La prima riguarda la
maschera booleana: in questa funzione True indica che la posizione partecipa
all’attenzione, all’opposto di key_padding_mask in nn.MultiheadAttention
dove True marca ciò che va escluso. Scambiare le convenzioni non solleva
nessun errore, ma porta il modello a guardare le posizioni sbagliate. La
seconda riguarda is_causal=True, che non produce la maschera della
funzione attenzione costruita a mano: l’argomento la allinea in alto
a sinistra, cosicché con una sola query e un prefisso lungo quella query vede
soltanto la posizione iniziale; la generazione richiede invece l’allineamento a
destra, che la libreria espone a parte. In decodifica con la cache la maschera
non serve comunque, perché con una query sola non c’è niente da vietare. I
vincoli di divisibilità di enable_gqa, invece, dipendono dalla versione e
vanno letti in quella installata.
Da ricordare
La stessa formula gira in due regimi opposti. Con il testo già scritto davanti, il modello lavora su tutte le parole insieme; mentre scrive, va per forza una parola alla volta, perché quella dopo non esiste ancora.
Il lavoro svolto su una parola quando la frase finiva lì resta valido quando la frase si allunga, perché nessuno può guardare avanti. Da qui il taccuino, che a differenza di quello della LSTM non cancella mai e si allunga a ogni parola: si conservano l’etichetta e l’informazione di ogni parola, e la domanda no, perché serviva una volta sola.
Il taccuino toglie la fatica di ricalcolare, non quella di confrontare: ogni parola nuova guarda comunque tutte quelle di prima, quindi il costo di scrivere cresce insieme al testo.
Il taccuino occupa molto spazio: per un modello di taglia ordinaria mezzo megabyte per ogni parola, e già quattro conversazioni lunghe servite insieme occupano più memoria del modello stesso.
Di lì le varianti: far leggere più lettori dallo stesso taccuino, tutti (MQA) o a gruppi (GQA), oppure annotare un riassunto stenografato da cui etichette e informazioni si ricostruiscono (MLA). Nessuna di queste tocca il numero di lettori, cioè i punti di vista restano quanti erano.
Sotto la parola «quadratico» stanno cose diverse: quanti conti si fanno, quanta memoria si occupa di passaggio, e quanti byte si spostano. Tenerle insieme è la fonte di quasi tutti gli equivoci sui costi.
Gli errori che si fanno montando questa macchina riguardano più spesso le righe, le colonne e le convenzioni che la formula. Il più delle volte niente si rompe: il modello impara un po’ peggio.
L’attenzione non è la memoria del modello: mescola, e non conserva niente da una volta all’altra. Fra una conversazione e l’altra il modello non ricorda nulla, e la sua apparente memoria è testo che qualcuno gli rimette davanti.
Da ricordare
Prefisso pieno e decodifica incrementale sono due regimi della stessa operazione: nel primo \(L = S = T\) e il calcolo è denso e parallelo, nel secondo \(L = 1\) e \(S = T + 1\), con il collo di bottiglia sulla banda di memoria.
Con attenzione causale \(\mathbf{k}_j\) e \(\mathbf{v}_j\) dipendono solo dalle posizioni \(\le j\), quindi non cambiano quando la sequenza si allunga: è la garanzia su cui poggia la cache. \(\mathbf{q}_t\) viene consumata nel prodotto e non si conserva, perché nessuna query successiva la rilegge. In un encoder bidirezionale la garanzia cade dal secondo strato in su; nella cross-attention di un encoder-decoder chiavi e valori si calcolano una volta sola.
La cache tiene \(2\,n_{\text{strati}}\,h_{kv}\,d_k\) elementi per token: la dimensione non dipende da \(h_q\). Per trentadue strati, \(h_{kv} = 32\) e \(d_k = 128\) a 16 bit sono 512 KiB per token, cioè 4 GiB per una finestra di 8192.
MQA porta \(h_{kv}\) a 1, GQA a un valore intermedio con le teste di query raggruppate, MLA conserva un latente compresso più una componente di RoPE disaccoppiata. Tutte riducono o comprimono le teste di chiave-valore, nessuna tocca \(h_q\).
Per token generato, con la cache, l’attenzione ha costo \(O(t\,d)\), lineare nel prefisso; il quadrato riappare sommando sui token generati. Lavoro aritmetico, memoria intermedia materializzata e traffico fra i livelli di memoria sono grandezze distinte, e «quadratico» da solo non dice quale.
Gli errori ricorrenti sono di asse e di convenzione: softmax sulla dimensione sbagliata, scala omessa, maschera applicata dopo la normalizzazione, maschera causale quadrata con \(L \neq S\), \(h_q\) usato al posto di \(h_{kv}\), pesi restituiti al posto di \(\mathbf{A}\mathbf{V}\).
Un peso di attenzione alto localizza l’aggregazione e non la spiega: trattarlo come spiegazione richiede un metodo e una validazione. L’attenzione non conserva niente fra una chiamata e l’altra: persiste la cache, che appartiene al sistema di inferenza e viene scartata al termine della risposta.
La formula del 2017 è rimasta quella, e attorno a lei è cambiato il modo di eseguirla: dove si conservano i suoi risultati intermedi, quante teste di chiave e valore li condividono, in che ordine si toccano i livelli di memoria. Le librerie degli esempi pratici la fanno girare così.