


Il bootstrap: quanto ci credo a questo numero#
Il nome più famoso della statistica al calcolatore è stato dato in una riga sola, e con la più svagata delle motivazioni. Bradley Efron, nel 1979, annuncia un metodo che chiama più primitivo del jackknife (l’attrezzo che allora si usava, e che l’articolo mostra esserne un’approssimazione lineare), e lo battezza bootstrap «for reasons which will become obvious», per ragioni che diventeranno ovvie [Efr79]. Le venticinque pagine che seguono su quelle ragioni non ci tornano più sopra: il lettore se le deve dedurre da solo.
Il senso però si indovina, ed è una vanteria: to pull oneself up by one’s bootstraps, tirarsi su per i tiranti degli stivali (gli anelli di cuoio cuciti in cima, che servono a infilarli), in inglese vuol dire cavarsela da soli in una situazione da cui non si potrebbe uscire senza aiuto. È un’immagine di impossibilità fisica, e infatti il metodo di Efron sembra fare qualcosa di impossibile: dire quanto è affidabile una stima senza raccogliere un solo dato in più.[1]
Un numero da solo non dice quanto balla#
Ogni accuratezza stampata fin qui, dall’\(89\%\) della foresta al \(91\%\) dello stacking, ne ha nascosta un’altra: quanto quel numero cambierebbe su un altro test. Una stima calcolata su un campione ha una distribuzione campionaria: con un altro campione verrebbe un altro numero, e la dispersione di quei numeri, misurata dalla loro deviazione standard, è l’errore standard della stima. La cifra stampata da sola non lo mostra. Un modello dà l’\(87\%\) di accuratezza: sì, ma su questo test. Rifacendo la prova con altri trecento esempi, quanto verrebbe? \(86\%\)? \(91\%\)? La differenza fra i due casi decide se conviene mettere il modello in produzione, e il numero da solo non la dice.
Per alcune quantità la risposta esiste da due secoli. Se la stima è una media, la statistica ha una formula che dice di quanto ci si può aspettare che balli: si prende quanto sono sparpagliati i dati e si divide per la radice di quanti sono. È il motivo per cui un sondaggio su mille persone dichiara un margine di poco più di tre punti, e il giornalista può scriverlo senza rifare il sondaggio.
Il problema è che quella formula vale per la media e per poco altro. Restano scoperte quasi tutte le quantità che si vogliono misurare davvero: la mediana degli stipendi (che è più onesta della media, perché non si fa trascinare da tre amministratori delegati), l’AUC di un modello, il rapporto fra due grandezze, la differenza fra le prestazioni di due modelli messi a confronto. Per tutte queste, la formula o non esiste, o esiste sotto ipotesi che i dati veri non rispettano.
Un attrezzo prima del 1979 c’era, e si chiama jackknife: togli un dato dal mucchio, rifai il conto senza di lui, rimettilo a posto e passa al successivo, fino all’ultimo. Quanto i risultati si allontanano fra loro dice quanto la stima balla, e sulla media va bene. Sulla mediana no, e la ragione si vede a occhio: sessanta stipendi in fila sono un numero pari, quindi al centro non ce n’è uno ma due, e la mediana sta fra loro; togliendone uno il centro scivola di un posto e mai di più, così il risultato è sempre uno di quei due numeri. Sessanta prove che ridanno due soli valori fanno sembrare la mediana molto più ferma di quanto sia, ed è proprio la mediana quella su cui si voleva una risposta.
Per lei, e per le altre quantità scoperte, la risposta onesta era: se vuoi sapere quanto balla, rifai l’indagine venti volte e guarda. Cioè, quasi sempre: non lo saprai.
Il problema è quello classico dell’inferenza. Si osserva un campione \(\mathbf{x} = (x_1, \dots, x_m)\) estratto da una distribuzione ignota \(F\). Si calcola una statistica \(\hat{\theta} = s(\mathbf{x})\) e se ne cerca la distribuzione campionaria, cioè come varierebbe \(\hat{\theta}\) ripetendo l’estrazione da \(F\). Nella notazione consolidata del bootstrap due simboli cambiano mestiere: \(\mathbf{x}\) è l’intero campione e non le caratteristiche di un singolo esempio, mentre \(\theta\) è la quantità da stimare e non i parametri di un modello. Da lì si ricavano errore standard, intervalli di confidenza e test.
Per \(\hat\theta = \bar{x}\) il teorema del limite centrale dà la risposta asintotica, \(\operatorname{se}(\bar{x}) = \sigma/\sqrt{m}\) stimabile con \(s/\sqrt{m}\). Per statistiche non lineari o non regolari (mediana, quantili, rapporti, coefficienti di correlazione, AUC, differenza fra due metriche) la distribuzione campionaria dipende da \(F\) in modo che non si scrive in forma chiusa; le approssimazioni con il metodo delta richiedono derivabilità e danno comunque solo il primo ordine. Il jackknife di Quenouille e Tukey, la soluzione precedente, ricalcola la statistica togliendo un dato per volta, \(\hat\theta_{(i)}\), e stima \(\widehat{\operatorname{se}}_{\text{jack}} = \sqrt{\tfrac{m-1}{m}\sum_i(\hat\theta_{(i)} - \hat\theta_{(\cdot)})^2}\), con \(\hat\theta_{(\cdot)}\) la media delle \(m\) repliche. Sulla media ritrova esattamente \(s/\sqrt m\); sulla mediana fallisce, perché le repliche prendono due soli valori e la stima dipende da un unico scarto fra due dati: sui sessanta stipendi dell’esempio che segue vale \(549\), contro i \(2061\) del bootstrap. E non migliora con più dati: il rapporto fra la stima e l’errore standard vero non converge a \(1\) ma a una variabile casuale esponenziale di media \(1\) [Efr82]. Era già noto quando Efron scrive; quello che lui mostra, nel paragrafo 3 dell’articolo, è che sulla stessa mediana il bootstrap invece funziona, e quel confronto è una delle ragioni per cui il metodo nasce.
Il campione come mondo in miniatura#
L’idea di Efron è sostituire la distribuzione ignota \(F\), da cui il campione viene, con la distribuzione empirica \(\hat F_m\) del campione stesso, che dà probabilità \(1/m\) a ciascuno degli \(m\) dati, e simulare da quella: ogni campione simulato è un’estrazione di \(m\) dati con reimmissione dai dati osservati. È più audace di quanto sembri, perché usa il campione due volte: come stima, e come mondo da cui ricampionare.
Quello che vorresti fare è chiaro: rifare l’indagine mille volte, ottenere mille mediane, e guardare quanto quelle mille sono sparpagliate. Ecco quanto balla la tua mediana. Non puoi: hai un campione solo, e raccoglierne altri novecento novantanove costa quanto i primi.
Efron fa questo ragionamento. Il campione che hai in mano è la miglior fotografia che esista del mondo da cui viene: sessanta stipendi presi a caso somigliano al paese più di qualunque altra cosa tu abbia. E allora, invece di pescare mille campioni nuovi dal mondo (impossibile), peschiamo mille campioni nuovi dalla fotografia.
Come si pesca da una fotografia di sessanta numeri un campione nuovo di sessanta numeri? Rimettendo dentro. Si estrae un numero a caso, lo si segna, lo si rimette nell’urna, e si ripete sessanta volte. Il campione che ne esce ha sessanta numeri come l’originale, ma non è l’originale: qualcuno è uscito due o tre volte, qualcun altro non è uscito affatto. Poi se ne calcola la mediana. Poi si ricomincia: mille volte, o diecimila, che costano solo tempo di calcolatore.
Alla fine hai un mucchio di mediane. Non vengono da indagini vere, ma il modo in cui si sparpagliano è una stima onesta di come si sparpaglierebbero quelle vere. Dal mucchio esce anche l’intervallo, cioè i due estremi da scrivere accanto alla stima: metti le mediane in fila dalla più piccola alla più grande, scarta il due e mezzo per cento più basso e il due e mezzo per cento più alto (su mille, sono venticinque per parte), e i due valori rimasti ai bordi sono l’intervallo che promette di contenere la mediana vera novantacinque volte su cento. Siccome i due estremi sono due percentili del mucchio, si chiama intervallo percentile. E questo lo puoi fare stasera, con i dati che hai già.
L’analogia si rompe nello stesso punto in cui si rompe il metodo: la fotografia non può mostrare quello che non inquadra. Se il campione è piccolo, o storto (solo stipendi del Nord, solo clienti soddisfatti), il bootstrap ricampiona quella stortura con la stessa diligenza con cui ricampiona il resto, e restituisce un intervallo stretto e sbagliato. Il bootstrap misura la variabilità del campionamento, non i peccati del campione. E c’è un caso in cui la fotografia è buona e il metodo si rompe lo stesso, quando la stima dipende dal bordo del campione: è il massimo, e lo si vede più avanti.
Si sostituisce la distribuzione ignota \(F\) con la distribuzione empirica \(\hat{F}_m\), che mette massa \(1/m\) su ciascun dato osservato. Un campione bootstrap \(\mathbf{x}^*\) è un campione di taglia \(m\) estratto da \(\hat{F}_m\), cioè estratto con reimmissione dai dati, e la distribuzione bootstrap è quella di \(\hat\theta^* = s(\mathbf{x}^*)\) al variare del sorteggio.
Il principio è la sostituzione
giustificata dal fatto che \(\hat{F}_m \to F\) (Glivenko–Cantelli) e che, per statistiche abbastanza regolari, la legge della radice normalizzata \(\sqrt m\,(\hat\theta - \theta(F))\) dipende con continuità da \(F\): allora la sua copia bootstrap \(\sqrt m\,(\hat\theta^* - \hat\theta)\), calcolata sotto \(\hat F_m\), ha la stessa legge limite [BF81]. Basta che \(\theta\) sia differenziabile secondo Hadamard in \(F\), come la media, le funzioni lisce di medie e i quantili interni dove \(F\) ha densità positiva; il massimo non lo è. L’errore standard si stima con la deviazione standard delle \(B\) repliche,
e presa alla lettera, la sostituzione dà l’intervallo basic. Con probabilità \(1-2\alpha\) lo scarto simulato \(\hat\theta^* - \hat\theta\) cade fra \(\hat\theta^{*}_{(\alpha)} - \hat\theta\) e \(\hat\theta^{*}_{(1-\alpha)} - \hat\theta\); la sostituzione dice che lo stesso vale per lo scarto ignoto \(\hat\theta - \theta\), e allora \(\theta\) cade in \([\,2\hat\theta - \hat\theta^{*}_{(1-\alpha)},\ 2\hat\theta - \hat\theta^{*}_{(\alpha)}\,]\), con i quantili ribaltati attorno alla stima. L’intervallo percentile al livello \(1-2\alpha\) prende invece i quantili così come sono, \([\hat\theta^{*}_{(\alpha)},\, \hat\theta^{*}_{(1-\alpha)}]\): coincide col basic quando la distribuzione bootstrap è simmetrica attorno a \(\hat\theta\), e si giustifica con un altro argomento, l’esistenza di una trasformazione monotona che renda simmetrica la statistica. Sui sessanta stipendi dell’esempio che segue i due danno, per la mediana, \([25\,678;\ 32\,844]\) e \([25\,720;\ 32\,885]\).
Due avvertenze. La prima: \(B\) conta le simulazioni, non gli esempi del campione, e l’unico costo è di calcolo; \(B = 200\) basta per un errore standard, per i quantili di un intervallo ne servono almeno \(1000\) e \(10\,000\) non fanno male. La seconda: l’intervallo percentile è il più semplice, e non sempre il migliore. Per le statistiche che sono funzioni lisce di medie (la media stessa, un rapporto, una correlazione) ciascuno dei suoi estremi ha un errore di copertura di ordine \(m^{-1/2}\), e con statistiche distorte o asimmetriche sotto-copre. Il \(\mathrm{BCa}\) (bias-corrected and accelerated) [Efr87] tiene gli stessi quantili bootstrap e ne sposta i livelli:
dove \(\Phi\) è la ripartizione della normale standard, \(z_\alpha = \Phi^{-1}(\alpha)\), \(\hat z_0 = \Phi^{-1}\bigl(\#\{b : \hat\theta^*_b < \hat\theta\}/B\bigr)\) misura la distorsione mediana e l’accelerazione \(\hat a\) si stima col jackknife; con \(\hat z_0 = \hat a = 0\) si torna al percentile. Sempre per le statistiche lisce, l’errore di ciascun estremo scende all’ordine \(m^{-1}\), e lo stesso ordine lo dà il \(t\)-bootstrap, al prezzo di una stima dell’errore standard dentro ogni replica [DE96]. La mediana non è liscia in \(F\) (e il jackknife con cui si stima \(\hat a\), su di lei, sbaglia), e la prova di copertura più avanti mostra che lì la correzione non serve: il \(\mathrm{BCa}\) copre come il percentile, e l’intervallo basic copre molto meno. Sul massimo, invece, non c’è correzione che tenga: la distribuzione bootstrap non converge a quella vera [BF81], e il rimedio è ricampionare \(r\) punti invece di \(m\), con \(r \to \infty\) e \(r/m \to 0\). Su dati simulati, dove il valore vero si conosce, la sotto-copertura si può misurare.
Tutto questo presuppone che il campione sia estratto i.i.d. dalla \(F\) di cui si vuole parlare: se è stato raccolto da un’altra popolazione, \(\hat F_m\) stima quella, e il bootstrap ne misura la variabilità con precisione, attorno al bersaglio sbagliato.
Il ricampionamento con reimmissione è esattamente la mossa con cui il bagging costruisce dataset diversi avendone uno solo, e il conto di quanti esempi restano fuori (poco più di un terzo) è già stato fatto lì. Quello che cambia è cosa se ne fa: il bagging usa i campioni per addestrare modelli diversi da far votare, qui li si usa per guardare quanto balla una stima. Stesso attrezzo, due mestieri; e fra poco quel terzo tornerà, a rovescio, a dire dove il bootstrap non arriva.
Il conto, su sessanta stipendi#
Su sessanta stipendi fabbricati apposta (con la coda a destra che hanno i redditi veri), ricampionati diecimila volte, quelle diecimila mediane danno due numeri: l’errore standard, cioè la deviazione standard delle diecimila mediane, e l’intervallo, i due estremi che promettono di contenere la mediana vera nel \(95\%\) dei casi. Il programma poi rifà lo stesso lavoro sulla media, dove esiste anche la formula di due secoli fa, per avere un riferimento noto con cui confrontare i risultati, e in fondo stampa due termini di paragone: l’intervallo basic e il jackknife.
import numpy as np

rng = np.random.default_rng(0)
# sessanta stipendi, con la coda a destra che hanno i redditi veri
campione = np.round(np.exp(rng.normal(np.log(28_000), 0.45, 60)))

def bootstrap(dati, stima, giri=10_000, seme=0):
    """La stima calcolata su `giri` ricampionamenti con reimmissione."""
    r = np.random.default_rng(seme)
    idx = r.integers(0, len(dati), (giri, len(dati)))
    return stima(dati[idx], axis=1)

for nome, f in (("mediana", np.median), ("media", np.mean)):
    d = bootstrap(campione, f)
    lo, hi = np.percentile(d, [2.5, 97.5])
    print(f"{nome:8s} = {f(campione):9.0f}   intervallo 95%: [{lo:.0f}, {hi:.0f}]"
          f"   errore standard {d.std():.0f}")

# l'intervallo basic per la mediana, e il bersaglio del bootstrap della media
med = np.median(campione)
d = bootstrap(campione, np.median)
lo, hi = np.percentile(d, [2.5, 97.5])
print(f"\nintervallo basic per la mediana: [{2*med-hi:.0f}, {2*med-lo:.0f}]")
print(f"errore standard della media con divisore m: "
      f"{campione.std() / np.sqrt(len(campione)):.0f}")

# per la media la formula esiste: errore standard = s / radice di m
s = campione.std(ddof=1) / np.sqrt(len(campione))
print(f"\nformula per la media: errore standard {s:.0f}, "
      f"intervallo [{campione.mean()-1.96*s:.0f}, {campione.mean()+1.96*s:.0f}]")

# il jackknife: la statistica ricalcolata togliendo un dato per volta
for nome, f in (("mediana", np.median), ("media", np.mean)):
    rep = np.array([f(np.delete(campione, i)) for i in range(len(campione))])
    se = np.sqrt((len(rep) - 1) / len(rep) * np.sum((rep - rep.mean()) ** 2))
    print(f"jackknife, {nome:8s}: errore standard {se:.0f}, "
          f"{len(np.unique(rep))} valori distinti fra le {len(rep)} repliche")
mediana  =     29282   intervallo 95%: [25720, 32885]   errore standard 2061
media    =     31425   intervallo 95%: [28219, 34806]   errore standard 1675

intervallo basic per la mediana: [25678, 32844]
errore standard della media con divisore m: 1652

formula per la media: errore standard 1666, intervallo [28159, 34691]
jackknife, mediana : errore standard 549, 2 valori distinti fra le 60 repliche
jackknife, media   : errore standard 1666, 60 valori distinti fra le 60 repliche
Conviene leggere prima la riga della media e quella della formula, che controllano il programma. Sulla media la risposta si sa da due secoli, e il bootstrap dice \(1675\) contro i \(1666\) della formula: mezzo punto percentuale di differenza. Che i due vadano d’accordo, però, è garantito in partenza: sulla media il bootstrap rifà la formula per costruzione (punta alla deviazione standard con divisore \(m\), la riga che stampa \(1652\), mentre la formula usa \(m-1\); il resto è il sorteggio delle diecimila simulazioni, che con un altro seme sposta la cifra di qualche decina). Che funzioni anche sulla mediana, dove una formula non c’è e il bootstrap risponde \(2061\), non lo dice questo confronto: lo dicono la teoria [Efr79] e la prova di copertura che segue. Le ultime due righe mostrano perché ci voleva: il jackknife ritrova la formula della media alla lettera (\(1666\)), e sulla mediana si ferma a \(549\), un quarto del bootstrap, perché fra le sue sessanta repliche ci sono due soli valori.
Da notare, per inciso, che la mediana (\(29\,282\)) sta ben sotto la media (\(31\,425\)), che è quello che succede sempre agli stipendi e alle case: pochi valori altissimi tirano su la media e lasciano stare la mediana.

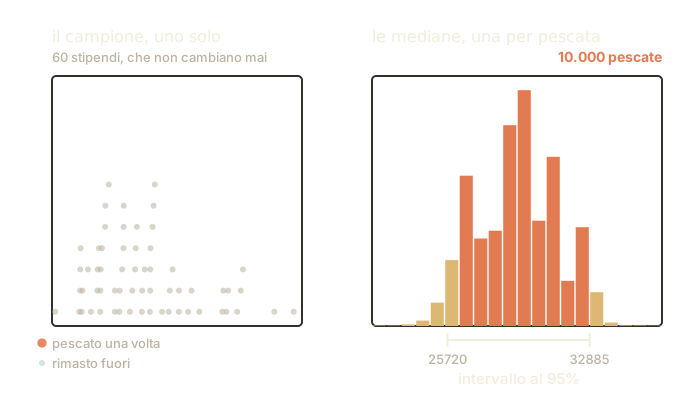
Fig. 4.27 Il gesto, in movimento. A sinistra il campione, che non cambia mai: a ogni giro alcuni dei suoi punti vengono pescati (in terracotta, più grossi se pescati più volte) e altri restano fuori. A destra la mediana di ciascuna pescata si aggiunge alle precedenti, e la pila che ne viene fuori è la risposta: da un campione solo, una distribuzione.#
Quello che Fig. 4.27 fa vedere e le righe stampate no è che il campione non si tocca: la variabilità che si vede a destra non viene da dati nuovi, viene tutta dal sorteggio di quali dei sessanta guardare. È il punto in cui il metodo sembra un imbroglio, e a togliere il sospetto è il collaudo dell’intervallo.
Ma quell’intervallo è davvero al 95%?#
Un intervallo di confidenza al \(95\%\) promette una cosa precisa e verificabile: ripetendo tutto l’esperimento tante volte, il valore vero deve cadere dentro l’intervallo nel \(95\%\) dei casi. Qui i dati li fabbrichiamo noi, quindi il valore vero si conosce e la promessa si può controllare.
import numpy as np

MU, SIGMA, M, PROVE = np.log(28_000), 0.45, 60, 20_000
VERA = np.exp(MU)          # per una distribuzione log-normale la mediana e' exp(mu)

rng = np.random.default_rng(0)
dentro = 0
for k in range(PROVE):
    c = np.exp(rng.normal(MU, SIGMA, M))          # un'indagine nuova, da capo
    d = bootstrap(c, np.median, giri=1000, seme=k)
    lo, hi = np.percentile(d, [2.5, 97.5])
    dentro += lo <= VERA <= hi

quota = dentro / PROVE
# anche questa percentuale e' una stima, e balla: ecco entro quali estremi
margine = 1.96 * np.sqrt(quota * (1 - quota) / PROVE)
print(f"mediana vera: {VERA:.0f}")
print(f"l'intervallo la contiene {dentro} volte su {PROVE}: {quota:.2%}")
print(f"margine di queste {PROVE} prove: da {quota-margine:.2%} "
      f"a {quota+margine:.2%}")
mediana vera: 28000
l'intervallo la contiene 18906 volte su 20000: 94.53%
margine di queste 20000 prove: da 94.21% a 94.85%
Il \(94{,}53\%\) contro il \(95\%\) promesso è la risposta giusta a due domande diverse. Alla prima («funziona?») risponde di sì, almeno in questo caso: un metodo che non funzionasse darebbe \(70\%\) o \(99\%\), non un numero a mezzo punto dal bersaglio.
Alla seconda («è esatto?») risponde di no, ma la risposta va letta con la terza riga in mano. Anche il \(94{,}53\%\) è una stima, ottenuta da ventimila prove e non da infinite, quindi balla pure lui, fra \(94{,}21\%\) e \(94{,}85\%\): è l’intervallo di Wald (la stima, più o meno \(1{,}96\) errori standard) della sezione sugli intervalli di confidenza, applicato a \(18\,906\) successi su \(20\,000\). Il \(95\%\) promesso resta fuori da quell’intervallo: l’esperimento rileva la sotto-copertura.
Le prove devono essere tante perché lo scarto da misurare è piccolo. Con quattromila il margine sarebbe di circa sette decimi di punto per parte, più largo dello scarto stesso, e il verdetto cambierebbe da un seme all’altro: quando un confronto si gioca su pochi decimi di punto, prima ancora delle cifre da stampare conta che il margine sia più stretto di quei decimi.
La sotto-copertura è un fatto documentato dell’intervallo percentile: con
campioni piccoli e distribuzioni storte sotto-copre di poco e sistematicamente.
Le sue varianti (l’intervallo basic, che ribalta i quantili attorno alla
stima, e il \(\mathrm{BCa}\), che ne corregge i livelli) si possono mettere alla
prova sullo stesso esperimento, con meno prove per metodo perché le differenze
da vedere sono più grandi: scipy.stats.bootstrap le calcola tutte e tre.
from scipy.stats import bootstrap as boot_scipy

PROVE = 2000
rng = np.random.default_rng(1)
dentro = {"percentile": 0, "basic": 0, "BCa": 0}
for k in range(PROVE):
    c = np.exp(rng.normal(MU, SIGMA, M))
    for metodo in dentro:
        ci = boot_scipy((c,), np.median, n_resamples=1000, method=metodo,
                        random_state=k).confidence_interval
        dentro[metodo] += ci.low <= VERA <= ci.high

for metodo, n in dentro.items():
    q = n / PROVE
    print(f"{metodo:10s}: {n} su {PROVE}, {q:.1%} "
          f"(±{1.96 * np.sqrt(q * (1 - q) / PROVE):.1%})")
percentile: 1880 su 2000, 94.0% (±1.0%)
basic     : 1745 su 2000, 87.2% (±1.5%)
BCa       : 1878 su 2000, 93.9% (±1.0%)
Il \(\mathrm{BCa}\) copre come il percentile, e l’intervallo basic resta sotto di sette punti. Sulla mediana la correzione non serve: i suoi ordini d’errore valgono per le statistiche lisce, come la media o un coefficiente di regressione, ed è lì che ripaga il costo. Chi deve sapere se una differenza è solida usa il percentile, che costa quattro righe.
La prudenza ci ha portati in un posto preciso: per giudicare una percentuale misurata abbiamo dovuto chiederci di quanto ballasse, e la risposta ha deciso il verdetto. È la domanda da cui siamo partiti, applicata a noi stessi.
Dove si rompe, e perché è lo stesso conto del bagging#
Un metodo che sembra dare qualcosa in cambio di niente va provato dove non funziona, altrimenti non si sa fin dove fidarsene. Il caso da manuale è il massimo.
import numpy as np

rng = np.random.default_rng(7)
c = np.exp(rng.normal(np.log(28_000), 0.45, 60))

for nome, f in (("massimo", np.max), ("mediana", np.median)):
    d = bootstrap(c, f, giri=10_000)
    print(f"{nome:8s}: {len(np.unique(d)):4d} valori distinti su 10000 ricampionamenti")

d = bootstrap(c, np.max, giri=10_000)
print(f"\nil massimo del campione vale {c.max():.0f}")
print(f"quota di ricampionamenti che ridanno esattamente quel valore: {(d == c.max()).mean():.3f}")
print(f"1 - (1 - 1/m)^m con m=60 vale                               : {1-(1-1/60)**60:.3f}")
massimo :    9 valori distinti su 10000 ricampionamenti
mediana :  160 valori distinti su 10000 ricampionamenti

il massimo del campione vale 68882
quota di ricampionamenti che ridanno esattamente quel valore: 0.631
1 - (1 - 1/m)^m con m=60 vale                               : 0.635
Diecimila ricampionamenti e nove risposte diverse: la distribuzione bootstrap del massimo si riduce a un mucchietto di nove valori, e in poco meno di due casi su tre è sempre lo stesso. La ragione è ovvia una volta detta: il massimo di un ricampionamento non può superare il massimo del campione, quindi da quel lato l’intervallo è murato, e dall’altro può solo saltare al secondo, al terzo, al quarto valore più grande. Non c’è niente da guardare, perché il massimo sta sul bordo: nessun ricampionamento può andare oltre, e quasi due su tre lo contengono.
E le ultime due righe sono il pezzo che conviene portarsi via. Il \(0{,}631\) contato sui diecimila ricampionamenti e il \(0{,}635\) che la formula dà per \(m = 60\) sono lo stesso numero, ed è il conto di Alberi e metodi ensemble letto al contrario. Là si contavano gli esempi che restano fuori da un campione bootstrap, poco più di un terzo, e la notizia era buona: su quel terzo si misura l’errore gratis. Qui si contano gli altri, i quasi due terzi che restano dentro, e la stessa notizia diventa la condanna del metodo, perché in poco meno di due ricampionamenti su tre il massimo c’è, e quindi ridanno la stessa identica risposta. È la stessa proprietà, letta dai due lati: un numero non è mai buono o cattivo per conto suo, dipende da che cosa gli si chiede di reggere.
Da qui la regola pratica: il bootstrap funziona per le statistiche che cambiano poco quando cambia un po’ la distribuzione dei dati (medie, mediane e altri quantili interni, coefficienti di un modello, metriche) e fallisce per quelle che stanno sul bordo dei dati: il massimo, il minimo, i quantili estremi. La mediana di sessanta valori dipende da due soli dati, eppure funziona: conta dove stanno.
Ci sono altri due modi di rompersi, e sono più insidiosi perché il conto esce lo stesso e sembra buono.
Dati che non sono indipendenti. Il ricampionamento tratta i dati come palline in un’urna, quindi intercambiabili. In una serie temporale non lo sono: la temperatura di oggi somiglia a quella di ieri, e mescolando le palline si distrugge proprio la struttura che rende la serie una serie. Il risultato è un intervallo troppo stretto, cioè una fiducia che non c’è. Il rimedio si chiama block bootstrap, e ricampiona pezzi di serie interi invece che singoli valori; il capitolo sulle serie temporali torna sul perché quei dati vadano trattati a parte.
Il campione stesso, raccolto male: il bootstrap ne misura la variabilità e non la distorsione, e dà un intervallo stretto attorno al numero sbagliato.
A che serve, quando si valuta un modello#
Il posto in cui questo attrezzo torna utile subito è la valutazione dei modelli. Un’accuratezza dell’\(87\%\) misurata su duecento esempi di test e una misurata su ventimila sono due numeri scritti uguale che valgono in modo diverso. Per un’accuratezza, che è una proporzione, il margine lo dà già la formula delle proporzioni; per l’AUC, l’F1 o qualunque metrica che non sia una media di zeri e uno lo dà il bootstrap sul test set: si ricampionano gli esempi di test con reimmissione, si ricalcola la metrica ogni volta, e si guardano i percentili. Per confrontare due modelli, però, i due intervalli separati non bastano, e la sezione sugli intervalli di confidenza lo dice già: due margini messi a fianco sono prudenti per costruzione e nascondono differenze vere. La mossa che decide costa una riga in più, ed è ricampionare gli stessi esempi per tutti e due i modelli e guardare la distribuzione della differenza: se lo zero sta fuori, la differenza c’è. Ecco la foresta della sezione sugli ensemble contro una regressione logistica, sullo stesso test:
import numpy as np
from sklearn.datasets import make_classification
from sklearn.ensemble import RandomForestClassifier
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split

X, y = make_classification(n_samples=3000, n_features=20, n_informative=8,
                           class_sep=0.7, random_state=0)
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=0)
foresta = RandomForestClassifier(n_estimators=200, random_state=0)
foresta.fit(X_tr, y_tr)
logistica = LogisticRegression().fit(X_tr, y_tr)
giusto_a = foresta.predict(X_te) == y_te
giusto_b = logistica.predict(X_te) == y_te

# gli STESSI indici ricampionati per tutti e due i modelli
idx = np.random.default_rng(0).integers(0, len(y_te), (10_000, len(y_te)))
acc_a, acc_b = giusto_a[idx].mean(1), giusto_b[idx].mean(1)
for nome, d in (("foresta", acc_a), ("logistica", acc_b),
                ("differenza", acc_a - acc_b)):
    lo, hi = np.percentile(d, [2.5, 97.5])
    print(f"{nome:10s}: [{lo:.3f}, {hi:.3f}]")
foresta   : [0.873, 0.913]
logistica : [0.831, 0.877]
differenza: [0.019, 0.059]
I due intervalli separati si sovrappongono, e messi a fianco non deciderebbero; quello della differenza, calcolato sugli stessi esempi, sta tutto sopra lo zero: la foresta è davvero migliore, di una quantità fra due e sei punti. Con l’accuratezza i conti si leggono a occhio; per un’altra metrica cambia solo la riga che la calcola sugli esempi sorteggiati.
Vale anche per le classifiche pubblicate: due sistemi separati da mezzo punto su un test da mille esempi, quasi sempre, non si distinguono, che non vuol dire che siano uguali: vuol dire che quel test non basta a separarli.
Da ricordare
Una stima è un numero, e un numero da solo non dice quanto balla. Per la media una formula esiste da due secoli (e per un’accuratezza, che è una media di zeri e uno, basta la sua versione per le proporzioni); per la mediana, per l’AUC di un modello, per un rapporto, no.
Il bootstrap ricampiona i dati che hai, con reimmissione e nella stessa quantità, mille volte, e guarda quanto la stima si sparpaglia fra i mille. Dei modi di rispondere senza raccogliere altri dati è quello che funziona anche dove il jackknife si arrende.
Sulla media il bootstrap dà \(1675\) e la formula \(1666\): il confronto controlla il programma. Sulla mediana, dove la formula non c’è, il bootstrap si controlla contando quante volte il suo intervallo contiene il valore vero.
La promessa di un intervallo al \(95\%\) si può misurare, e su ventimila prove esce \(94{,}53\%\). Anche quel numero ha il suo margine (da \(94{,}21\) a \(94{,}85\)), e il \(95\%\) resta fuori: il metodo funziona, e copre un filo meno di quanto promette. Con poche prove il margine sarebbe largo quanto lo scarto, e il verdetto lo deciderebbe il caso.
Non funziona per il massimo: diecimila ricampionamenti danno nove risposte distinte, perché il massimo di un ricampionamento non può superare quello del campione, e lo ritrova in circa due casi su tre. Vale per il minimo e per le altre statistiche di bordo.
Il campione è una fotografia, e una fotografia non mostra quello che non inquadra: su dati raccolti male il bootstrap dà un intervallo stretto attorno al numero sbagliato, e la strettezza è la parte pericolosa.
Per dire se un modello batte un altro si ricampionano gli stessi esempi di test per tutti e due e si guarda la differenza: se lo zero ne resta fuori, la differenza c’è.
Da ricordare
Il bootstrap stima la distribuzione campionaria di \(\hat\theta = s(\mathbf{x})\) sostituendo a \(F\) la distribuzione empirica \(\hat{F}_m\) e simulando: campioni di taglia \(m\) con reimmissione, la statistica ricalcolata su ciascuno [Efr79].
Errore standard = deviazione standard delle \(B\) repliche; intervallo percentile = quantili empirici. \(B \approx 200\) per un errore standard, \(\ge 1000\) per i quantili.
Il jackknife ricalcola la statistica togliendo un dato per volta: sulla media ritrova \(s/\sqrt m\), sulla mediana è inconsistente (\(549\) contro i \(2061\) del bootstrap, con due soli valori fra le sessanta repliche).
Il percentile sotto-copre con statistiche distorte o asimmetriche: \(94{,}53\%\) contro il \(95\%\) nominale su \(20\,000\) prove, con intervallo Monte Carlo \([94{,}21;\ 94{,}85]\); con un quinto delle prove il margine è largo quanto lo scarto da misurare, e il verdetto dipende dal seme. Gli ordini d’errore (\(m^{-1/2}\) per il percentile, \(m^{-1}\) per \(\mathrm{BCa}\) e \(t\)-bootstrap) valgono per funzioni lisce di medie: sulla mediana il \(\mathrm{BCa}\) copre come il percentile (\(93{,}9\%\) contro \(94{,}0\%\)), l’intervallo basic molto meno (\(87{,}2\%\)).
Condizioni di validità: statistica regolare in \(F\) (differenziabile secondo Hadamard: medie, funzioni lisce di medie, quantili interni) e dati i.i.d. dalla \(F\) che interessa. Cade per statistiche di bordo (massimo, minimo: distribuzione bootstrap degenere, \(9\) valori distinti su \(10^4\) repliche) e per dati dipendenti (serie temporali: intervalli troppo stretti; serve il block bootstrap).
La probabilità che un dato compaia in un campione bootstrap è \(1 - (1-1/m)^m \to 1 - e^{-1} \approx 0{,}632\): è lo stesso conto che nel bagging produce il terzo di esempi out-of-bag, e qui è la ragione per cui il bootstrap del massimo non funziona.
Uso in ML: intervalli attorno a una metrica misurata su un test set finito, e confronto fra due modelli. Il confronto si fa sul bootstrap appaiato della differenza (stessi indici per i due modelli), non accostando due intervalli marginali, che è prudente per costruzione.
Il bootstrap dà a ogni metrica la sua incertezza e, nella forma appaiata, il confronto fra due modelli: servirà ogni volta che due modelli si mettono uno accanto all’altro. Le macchine a vettori di supporto cambiano domanda: invece di misurare un confine già tracciato, cercano quello che lascia il margine più largo fra le classi, e la risposta viene da un ragionamento di geometria.