


Meno pesi: la promessa che si riscuote male#
Novanta pesi su cento si possono buttare via e la rete continua a rispondere quasi come prima. Non è un modo di dire: più sotto un programma lo fa su una rete piccola che legge cifre scritte a mano, e ne stampa i numeri; sulle reti grandi lo hanno mostrato Han e colleghi, che hanno ridotto i parametri di nove volte su AlexNet e di tredici su VGG-16 senza perdere accuratezza [HPTD15].
È la promessa più grande delle tre, ma sul calcolatore si riscuote male: una rete alleggerita del novanta per cento non è più veloce in proporzione, perché la moltiplicazione fra matrici che si esegue di solito, quella densa, moltiplica anche gli zeri. Per guadagnare tempo bisogna cambiare il modo di moltiplicare, e conviene solo a certe condizioni.
Quali pesi si tolgono#
La domanda è quale peso togliere, e la risposta che si usa quasi sempre è la più sbrigativa che ci sia.
Un club deve tagliare il budget e a giugno il presidente deve mandare via nove giocatori su dieci, anche se la squadra ha appena vinto il campionato. Chiunque mandi via, la squadra ci rimette, e la domanda è solo chi costa meno perdere. Quanto valga davvero ciascuno non lo sa nessuno, e allora si guardano i minuti giocati e si manda via chi ne ha di meno.
In una rete quella cifra c’è già, e sono i pesi. Il peso di un collegamento dice quanto quel collegamento conta, e uno vicino a zero non sposta quasi niente: tagliarlo sembra gratis. Si ordinano tutti per grandezza, si tiene una percentuale dei più grandi, il resto va a zero. Che lavoro faccia ciascun collegamento non lo guarda nessuno.
Il presidente scommette quattro volte, e perde tutte e quattro. Scommette che la squadra fosse già sistemata al meglio, così che nessun piccolo cambio di ruolo potesse migliorarla, mentre a giugno sta dove il campionato l’ha lasciata, a metà di un aggiustamento. Che due giocatori con gli stessi minuti lascino lo stesso buco: il portiere gioca quanto un difensore e non si rimpiazza con la stessa facilità. Che i buchi si sommino: due che si intendevano bene, tolti insieme, si sentono più della somma dei due presi uno per uno. E che quel criterio regga anche a tagliare in blocco: vale per un giocatore alla volta, e di pesi se ne azzerano nove su dieci in un pomeriggio. La cosa curiosa è che il criterio funzioni lo stesso, e nessuno sa dire bene perché.
La prima domenica dice come è andata. Tolti nove pesi su dieci, l’accuratezza passa da novantotto a trentanove per cento, cioè da «sbaglia una volta su cinquanta» a «sbaglia tre volte su cinque».
Quello che salva la squadra è il ritiro. Dopo aver tagliato si riaddestra, tenendo però i tagli dove sono: i giocatori rimasti si allenano nei ruoli lasciati vuoti, e dopo qualche settimana si gioca di nuovo bene. Chi è stato mandato via non rientra: dopo ogni seduta i pesi tagliati vengono rimessi a zero, così nessuno di loro può riprendersi il posto.
Il ritiro riesce meglio a scaglioni. Mandarne via nove su dieci in un pomeriggio e poi allenare quel che resta funziona peggio che tagliarne pochi, allenare, tagliarne altri pochi: ogni volta si chiede alla squadra un aggiustamento piccolo, e lo regge.
E a un certo punto nemmeno il ritiro basta. Con la metà dei pesi tolti la rete non perde niente; con nove su dieci resta indietro di circa un punto; con diciannove su venti di quasi cinque. Il ritiro insegna a coprire i buchi, non a essere in due dove ne servono undici, e sotto un certo numero di giocatori non c’è allenamento che tenga.
La potatura per grandezza azzera i pesi il cui valore assoluto sta sotto una soglia, tipicamente scelta per percentile all’interno di ciascuna matrice. È il criterio di [HPTD15], e Optimal Brain Damage [LDS90], di venticinque anni prima, non ne è la giustificazione: è il lavoro scritto per scavalcarlo, che si propone di «andare oltre l’approssimazione che grandezza uguale importanza» e misura che ordinare per grandezza costa più che ordinare per l’importanza stimata. Ricostruire il criterio dentro quel quadro serve proprio a vedere quante approssimazioni nasconde. Spostando i pesi di \(\delta\boldsymbol{\theta}\),
con \(\mathbf{g}\) il gradiente e \(\mathbf{H}\) l’Hessiana. Di qui in poi OBD butta via tre pezzi, e li nomina: si ferma al secondo ordine (quadratica), pota ad addestramento finito, dove il gradiente è nullo e il primo termine sparisce (estremale), e trascura i termini fuori diagonale, così il costo si spezza in un addendo per peso (diagonale), \(\tfrac{1}{2}h_{ii}\,\delta \theta_i^2\); azzerare il peso \(i\)-esimo vuol dire \(\delta\theta_i = -w_i\) (con \(w_i\) il valore di \(\theta_i\) a fine addestramento), cioè un costo \(s_i = \tfrac{1}{2}h_{ii}w_i^2\), che OBD chiama salienza. Le \(h_{ii}\) si calcolano con una ricorsione simile alla retropropagazione, allo stesso costo del gradiente, e trascurando il termine con la derivata seconda dell’attivazione (l’approssimazione di Levenberg-Marquardt) escono sicuramente positive: l’Hessiana intera non si costruisce mai. L’ordinamento che ne esce non è ancora quello per \(|w_i|\): lo diventa con una quarta ipotesi, che la diagonale sia uniforme, e quella OBD non la fa.
Sono quattro approssimazioni, non una, e si sanno false tutte e quattro: il costo non è quadratico, una rete fermata da Adam non sta in un minimo, l’Hessiana non è diagonale, e la sua diagonale non è uniforme. Gli autori di OBD misurano dove si rompono le loro tre: l’accordo con la previsione regge fino a circa il trenta per cento dei pesi tolti, e potare al novanta è tre volte oltre. La cosa notevole è che il criterio regga lo stesso.
Il taglio da solo non basta perché la rete rimasta è fuori dal minimo in cui era stata portata: i pesi superstiti sono ottimi rispetto a una funzione che comprendeva anche quelli azzerati. Il riaddestramento con maschera fissa (la maschera dei pesi sopravvissuti si applica dopo ogni passo dell’ottimizzatore, così i pesi tagliati non tornano mai) riporta i superstiti in un minimo della funzione ristretta.
Nella pratica il ciclo si itera: si pota una frazione, si riaddestra, si pota ancora [HPTD15]. Lo faceva già OBD, che teneva fissi a zero i parametri tolti, riaddestrava e ripeteva. A parità di accuratezza la potatura iterativa toglie più pesi di quella in un colpo solo (su AlexNet, senza perdita di accuratezza, nove volte meno parametri invece di cinque), e la ragione è la stessa che limita lo sviluppo di Taylor: vale per spostamenti piccoli, e ogni giro chiede alla rete un adattamento piccolo invece che uno enorme.
La prova si fa su una rete piccola e su dati piccoli, così sta in una pagina e gira in mezzo minuto. Il compito è riconoscere cifre scritte a mano: si dà alla rete un quadratino di otto pixel per otto e lei deve dire quale delle dieci cifre sia.
import torch
from torch import nn
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split

torch.manual_seed(0)
# un thread solo: due esecuzioni di fila danno lo stesso numero. Su un'altra
# macchina le ultime cifre ballano, perche' cambia l'ordine delle somme
torch.set_num_threads(1)

dati = load_digits()
Xtr, Xte, ytr, yte = train_test_split(dati.data / 16.0, dati.target,
                                      test_size=0.3, random_state=0)
Xtr = torch.tensor(Xtr, dtype=torch.float32)
Xte = torch.tensor(Xte, dtype=torch.float32)
ytr, yte = torch.tensor(ytr), torch.tensor(yte)


def costruisci(seme=0):
    torch.manual_seed(seme)
    return nn.Sequential(nn.Linear(64, 256), nn.ReLU(),
                         nn.Linear(256, 256), nn.ReLU(), nn.Linear(256, 10))


def addestra(rete, passi, maschere=None):
    """Se ci sono le maschere, i pesi tagliati vengono rimessi a zero
    dopo ogni passo: l'ottimizzatore non puo' farli risorgere."""
    opt = torch.optim.Adam(rete.parameters(), lr=1e-3)
    matrici = [p for p in rete.parameters() if p.dim() == 2]
    for _ in range(passi):
        nn.functional.cross_entropy(rete(Xtr), ytr).backward()
        opt.step()
        opt.zero_grad()
        if maschere:
            with torch.no_grad():
                for p, m in zip(matrici, maschere):
                    p *= m
    return rete


def accuratezza(rete):
    with torch.no_grad():
        return (rete(Xte).argmax(1) == yte).float().mean().item() * 100


rete = addestra(costruisci(), 600)
pieni = [p.detach().clone() for p in rete.parameters()]
print(f"rete intera: {accuratezza(rete):.1f}%")
print()
print(f"{'tolti':>7} {'subito dopo':>13} {'dopo il riaddestramento':>25}")
for frazione in (.5, .8, .9, .95):
    with torch.no_grad():
        for p, originale in zip(rete.parameters(), pieni):
            p.copy_(originale)                 # si riparte sempre dalla rete intera
        maschere = []
        for p in [q for q in rete.parameters() if q.dim() == 2]:
            soglia = p.abs().flatten().kthvalue(int(frazione * p.numel())).values
            m = (p.abs() >= soglia).float()
            p *= m
            maschere.append(m)
    subito = accuratezza(rete)
    dopo = accuratezza(addestra(rete, 300, maschere))
    print(f"{frazione*100:>6.0f}% {subito:>12.1f}% {dopo:>24.1f}%")

# il controllo: stessi trecento passi con un Adam nuovo, ma senza potare
with torch.no_grad():
    for p, originale in zip(rete.parameters(), pieni):
        p.copy_(originale)
print()
print(f"controllo, rete intera con altri 300 passi: "
      f"{accuratezza(addestra(rete, 300)):.1f}%")
rete intera: 97.8%

  tolti   subito dopo   dopo il riaddestramento
    50%         95.9%                     98.0%
    80%         66.5%                     97.6%
    90%         39.3%                     96.9%
    95%         30.4%                     93.0%

controllo, rete intera con altri 300 passi: 98.0%
La colonna di mezzo e quella di destra dicono due cose diverse, e la seconda è quella che conta. Tolti nove pesi su dieci la rete non sa più leggere una cifra, e dopo trecento passi di riaddestramento è tornata a 96,9 contro il 97,8 di partenza: ha perso circa un punto avendo dentro un decimo dei collegamenti. Il decimale va preso con le molle: su un altro processore la stessa esecuzione, con lo stesso seme, si sposta di qualche decimo, perché la macchina somma in un altro ordine, l’ultima cifra dei conti cambia e trecento passi di addestramento la ingrandiscono. A metà strada, con la metà dei pesi, è perfino salita di due decimi, e qui bisogna resistere alla tentazione di dedurne qualcosa. Il riaddestramento dà alla rete potata trecento passi in più e un ottimizzatore nuovo, che la rete intera non riceve; dati alla rete intera, senza potare niente, la portano allo stesso 98,0%, ed è la riga del controllo. Quei due decimi non li ha regalati la potatura, li ha regalati il riavvio dell’ottimizzatore.
Quella prova pota in un colpo solo, perché sta in venti righe. Chi pota sul serio lo fa a giri: toglie una fetta, riaddestra, toglie un’altra fetta, e così via. Fig. 9.2 fa proprio questo, tredici giri di fila più lo stato di partenza, ed è una figura che si muove: se la si guarda online i pesi si spengono giro dopo giro e la curva si allunga da sinistra a destra. La rete lì dentro ha un solo strato nascosto invece di due, quindi i numeri non combaciano con quelli della tabella e non devono: la cosa da guardare è la forma della curva, non il valore.

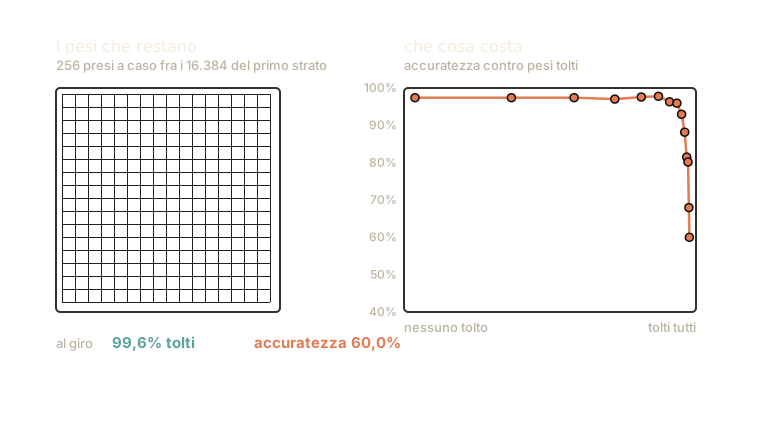
Fig. 9.2 Tredici giri di potatura iterativa su una rete piccola, più lo stato di partenza. A sinistra i pesi che restano, a destra quello che costa toglierli. La curva non scende piano: resta piatta finché si tolgono i primi nove pesi su dieci, e poi cade. Il punto in cui cade non si sa prima, e per questo si pota misurando a ogni giro invece che scegliendo una percentuale all’inizio.#
Perché la moltiplicazione non si accorge degli zeri#
E adesso la parte che rovina la festa. Una matrice con il novantacinque per cento di zeri (una matrice sparsa, per distinguerla da una piena) viene moltiplicata esattamente come una piena.
torch.manual_seed(0)
# nomi tutti nuovi: nel notebook compagno le pagine si susseguono nello stesso
# spazio dei nomi, e riusare `W` costringerebbe a rieseguirle sempre in ordine
piena = torch.randn(1024, 1024)
soglia = piena.abs().flatten().kthvalue(int(0.95 * piena.numel())).values
sparsa = piena * (piena.abs() >= soglia)
ingressi = torch.randn(1024, 256)

zeri = (sparsa == 0).float().mean().item()
fatte = piena.numel() * ingressi.shape[1]
print(f"zeri nella matrice sparsa: {zeri * 100:.0f}%")
print(f"moltiplicazioni che servirebbero: una su {1 / (1 - zeri):.0f}")
print(f"moltiplicazioni che il calcolatore fa, in tutti e due i casi: "
      f"{fatte / 1e6:.0f} milioni")
print(f"  di cui per zero: {fatte * zeri / 1e6:.0f} milioni")
zeri nella matrice sparsa: 95%
moltiplicazioni che servirebbero: una su 20
moltiplicazioni che il calcolatore fa, in tutti e due i casi: 268 milioni
  di cui per zero: 255 milioni
Venti volte meno lavoro utile, e zero lavoro risparmiato: il calcolatore fa gli stessi duecentosessantotto milioni di moltiplicazioni in tutti e due i casi, e duecentocinquantacinque milioni di quelle (il novantacinque per cento) sono moltiplicazioni per zero.
Cronometrandolo si vede lo stesso: la matrice sparsa non va venti volte più veloce, va uguale. Un cronometro dipende dalla macchina e da quanto è occupata; il conto delle moltiplicazioni no, e dice la stessa cosa.
La ragione è semplice e un po’ deludente: un calcolatore che moltiplica due matrici non guarda i numeri, li macina. Fa la stessa identica sequenza di moltiplicazioni comunque siano fatti, e moltiplicare per zero costa quanto moltiplicare per qualunque altra cosa.
Per guadagnarci bisognerebbe saltare gli zeri, e per saltarli bisogna sapere dove sono, cioè tenere in memoria un elenco delle loro posizioni. Quel libretto costa a sua volta memoria da leggere, e i salti costano tempo perché mandano all’aria l’ordine con cui i numeri arrivano dalla memoria.
A volte quel patto conviene e a volte no, e dipende da due cose: da quanto è vuota la matrice, e da che macchina la moltiplica. Su un processore normale, con novantacinque zeri su cento, l’elenco conviene e si guadagna davvero; con la metà degli zeri no, perché tenere il conto delle posizioni costa più di quanto fa risparmiare. Su una scheda grafica non conviene quasi mai, perché lì la moltiplicazione ordinata va così veloce che saltare gli zeri costa più di farli. Ed è per questo che, in pratica, si sente dire che la potatura non fa guadagnare tempo: è vero dove i modelli grandi girano davvero.
Quello che invece si guadagna è lo spazio, purché gli zeri siano tanti. Per non scriverli bisogna mettere accanto a ogni numero tenuto l’indirizzo della sua casella, che pesa più o meno quanto lui: con novanta zeri su cento la matrice si salva in circa un quinto dello spazio, con metà zeri non si risparmia niente. Per chi deve distribuire un modello questo conta. Ma spazio su disco e velocità di risposta sono due cose diverse.
C’è un modo di riscuotere anche la seconda, ed è togliere i pesi a blocchi invece che uno per uno: non il singolo collegamento più debole, ma un neurone intero con tutti i collegamenti che vi arrivano, cioè una riga intera della griglia. Una rete a cui si toglie un neurone intero è letteralmente una rete più piccola: la griglia ha una riga in meno, e moltiplicare una griglia più piccola costa meno, senza trucchi. Si paga in accuratezza, perché scegliendo a blocchi si è costretti a buttare via anche i pesi utili che stavano nella riga sbagliata.
Una via di mezzo esiste, e taglia a gruppi minuscoli invece che a righe intere. Non la sceglie chi addestra: la decide chi disegna le macchine. Certe schede grafiche sanno saltare gli zeri, a una condizione: che stiano al loro posto. Di ogni quattro pesi in fila almeno due devono essere zero, sempre, in tutta la griglia. La moltiplicazione resta ordinata abbastanza da correre veloce, e chi taglia resta libero abbastanza da non dover buttare via righe intere. Il vincolo però non si tratta: dove di pesi utili ce ne sono tre di fila, uno dei tre va a zero lo stesso.
Un prodotto matriciale denso è eseguito da un kernel GEMM che opera su piastrelle regolari, con accessi alla memoria contigui e prevedibili: è il regime per cui l’hardware è costruito, e la sezione su GEMM e tensor core spiega perché uscirne costi caro. La sparsità non strutturata distrugge esattamente le due proprietà che rendono quel kernel veloce, la regolarità dell’accesso e la possibilità di riempire le unità vettoriali. Passare a un formato sparso (CSR e simili, cioè la matrice scritta come l’elenco delle sole posizioni non nulle, riga per riga) vuol dire quindi cambiare kernel, non aggiustare quello di prima, e se convenga è una domanda empirica, non di principio. Sulla matrice sparsa dell’esperimento precedente, su CPU e a tempo di processore: il CSR pareggia il denso intorno al venti per cento di densità, e al cinque per cento (cioè con i novantacinque zeri su cento di quell’esperimento) va dalle cinque alle sette volte più veloce, a seconda della macchina. Su GPU la soglia si sposta molto più in basso, perché il kernel denso lavora vicino al picco e gli accessi irregolari costano di più: è la ragione per cui in pratica la sparsità non strutturata si usa poco, e sta nell’hardware, non nell’aritmetica.
Da qui la distinzione operativa:
la sparsità non strutturata riduce i parametri e non tocca il tempo del kernel denso, che è quello che quasi tutti eseguono. È utile per la dimensione del file, se la densità è abbastanza bassa da pagare gli indici (in CSR, con valori e indici a 32 bit, un elemento non nullo costa il doppio di uno denso, e il pareggio cade al cinquanta per cento di densità), e come strumento di indagine (è quella che serve nel paragrafo sul biglietto della lotteria);
la sparsità strutturata rimuove unità intere (righe e colonne di una matrice, canali di una convoluzione, teste di attenzione [MLN19, VTM+19], strati). Il risultato è un tensore più piccolo e denso, quindi lo stesso kernel di prima su una forma minore: il guadagno è reale e proporzionale. Il costo è che il vincolo strutturale esclude molte configurazioni buone, e a parità di parametri rimossi l’accuratezza è peggiore;
una via di mezzo esiste ed è imposta dall’hardware: alcuni acceleratori supportano schemi a densità fissa locale (per esempio due valori non nulli ogni quattro consecutivi), che sono abbastanza regolari da essere eseguiti in fretta e abbastanza liberi da non essere una potatura a blocchi. È il compromesso che decide chi progetta il silicio, non chi addestra.
Due su quattro#
Fra gli schemi a densità fissa, quelli con lo stesso numero massimo di pesi non nulli in ogni gruppetto, il più diffuso è il 2:4: in ogni gruppo di quattro pesi consecutivi, almeno due sono zero. È abbastanza regolare perché i tensor core della sezione su GEMM e tensor core lo eseguano con poco circuito in più, e abbastanza libero perché dentro ogni gruppo la potatura scelga quali pesi tenere.
Si prende la griglia dei pesi e la si divide, riga per riga, in gruppetti di quattro caselle. La regola è una sola, e vale dappertutto: in ogni gruppetto sopravvivono al più due numeri, di solito i due più grandi, e gli altri diventano zero. Scriverla costa poco più della metà, perché di ogni gruppetto si tengono solo i due sopravvissuti, ciascuno con un’etichetta minuscola che dice in quale delle quattro caselle stava: bastano due cifre binarie, perché le caselle sono quattro.
Poi il chip moltiplica. Di ogni gruppetto legge i due numeri rimasti, guarda le etichette, e fra i numeri d’ingresso prende soltanto i due che andrebbero moltiplicati proprio con quelle caselle; gli altri due non li tocca, perché andrebbero moltiplicati per zero. Due moltiplicazioni invece di quattro, in ogni gruppetto, e quindi metà del lavoro. E siccome la regola è la stessa per tutti i gruppetti, ogni pezzo del chip ha esattamente lo stesso lavoro degli altri, e nessuno resta ad aspettare.
Il prezzo è quello del vincolo, già detto: il gruppetto con tre pesi utili ne perde uno, e la rete ci rimette. Per questo, dopo aver azzerato, la si fa studiare di nuovo, per tutto il tempo che era servito la prima volta, e i pesi rimasti imparano a coprire quelli tolti: così torna quasi dov’era. Con i modelli linguistici grandi, però, ripetere l’addestramento costerebbe troppo, e si pota senza rifarlo. Lì la regola dei due su quattro fa perdere più punti rispetto a togliere la stessa metà dei pesi dove si vuole, e un ripasso breve recupera buona parte della differenza, senza colmarla. E la velocità doppia vale per le moltiplicazioni: i numeri da portare dalla memoria non si dimezzano, e l’intero calcolo accelera meno di due volte, in un modello grande una volta e mezza per le moltiplicazioni di uno strato e un quarto in più per la risposta intera.
Lo schema delle Sparse Tensor Core di NVIDIA [MLP+21] impone che in ogni gruppo di quattro pesi consecutivi lungo la dimensione di riduzione almeno due siano nulli. Una matrice \(R \times C\) si memorizza compressa come \(R \times C/2\) valori e, per ciascuno, un indice di 2 bit con la sua posizione nel gruppo: il sovraccarico dei metadati è del 12,5% sui valori a 16 bit e del 25% su quelli a 8. Il tensor core usa gli indici per prelevare dall’altra matrice i soli due elementi corrispondenti di ogni gruppo, ed esegue metà delle moltiplicazioni: il picco aritmetico è il doppio di quello denso. L’accelerazione di un GEMM intero resta sotto il doppio e dipende dalla forma e dall’intensità aritmetica: si dimezzano i prodotti, non i byte da muovere, e i pesi compressi con i loro indici pesano più della metà. Nelle misure di Wanda su A6000, simulate con i kernel GEMM di CUTLASS, i prodotti degli strati lineari di LLaMA-65B a batch 1 guadagnano da 1,54 a 1,63 volte, e il tempo di risposta intero di LLaMA-7B 1,24 volte [SLBK24]. Il vincolo è locale e uniforme, quindi conserva le due proprietà che la sparsità non strutturata distrugge, la regolarità dell’accesso e il riempimento delle unità di calcolo, e in più bilancia il carico per costruzione.
La ricetta degli autori è addestrare il modello denso, potarlo a 2:4 per modulo (in ogni gruppo si tengono i due pesi più grandi) e riaddestrarlo con lo stesso ottimizzatore e lo stesso calendario, per lo stesso numero di epoche, cioè con un secondo addestramento intero. Su un’ampia gamma di reti di visione e di linguaggio questo recupera l’accuratezza del denso, con eccezioni che gli autori riportano: le reti già snelle, come MobileNet, vogliono prima una permutazione dei canali, e alcune reti generative perdono qualcosa. Sui modelli linguistici grandi, dove un secondo addestramento costa troppo, si pota dopo: Wanda [SLBK24] toglie i pesi con il prodotto \(|W_{ij}|\,\lVert\mathbf{X}_j\rVert_2\) più piccolo senza aggiornare gli altri, SparseGPT [FA23] aggiorna i superstiti strato per strato con la stessa ricostruzione del secondo ordine di GPTQ. Nelle tabelle di Wanda, su LLaMA e LLaMA-2, l’accuratezza media su sette compiti affrontati senza esempi scende con il vincolo 2:4 di qualche punto in più che con il 50% libero, sia con Wanda sia con SparseGPT, perché il vincolo esclude configurazioni buone; un fine-tuning breve con LoRA ne recupera buona parte, senza colmare il divario con il 50% libero sottoposto allo stesso fine-tuning.
Un chip che guarda i numeri#
La via di mezzo a densità fissa è un compromesso per chi moltiplica griglie piene. Un acceleratore costruito solo per far rispondere un modello già addestrato può spingersi oltre, e saltare gli zeri dovunque stiano: nei pesi, che la potatura ha azzerato, e negli ingressi di ogni strato, che dopo una ReLU (la funzione che lascia passare i positivi e azzera i negativi) sono zero spesso per metà o più. EIE di Han e colleghi [HLM+16] lo fa per il prodotto fra una griglia di pesi e un vettore, SCNN di Parashar e colleghi [PRM+17] per le convoluzioni, lo strato delle reti per immagini che la sezione sulle reti convoluzionali racconta per esteso.
Il calcolatore che moltiplica griglie piene non guarda i numeri, e anche quello dei due su quattro guarda solo le etichette. Un chip fatto apposta, come EIE, li guarda, e prima di cominciare riscrive la griglia dei pesi colonna per colonna, tenendo solo i numeri diversi da zero, ciascuno con un’etichetta che dice quante caselle vuote lo precedono: una colonna con un 3 nella seconda casella e un 5 nella settima diventa «una vuota, poi 3; quattro vuote, poi 5». L’etichetta è corta, quattro cifre binarie, cioè sedici combinazioni, da zero a quindici: se le caselle vuote di fila sono di più, si scrive uno zero finto che fa da segnaposto, e si ricomincia a contare. Nemmeno i pesi sono scritti per intero: la rete ne usa soltanto sedici valori diversi, raccolti in una tavola comune a tutta la griglia, e al posto di ciascun peso c’è il suo numero di posto nella tavola, altre quattro cifre binarie.
Poi arriva la fila di numeri da moltiplicare per la griglia, il vettore d’ingresso. I suoi zeri non partono nemmeno; ogni numero diverso da zero va a tutti i banchi del chip insieme (i banchi sono i piccoli moltiplicatori di cui il chip è fatto, e ciascuno tiene una parte delle righe della griglia), e ogni banco lo moltiplica soltanto per i pesi non nulli della colonna corrispondente. Zero per qualcosa, qui, non si calcola mai, tranne gli zeri finti dei segnaposto.
Tutte queste etichette hanno un prezzo: stanno in memoria e vanno lette anche loro, così il risparmio vero resta molto sotto quello che il conto delle sole moltiplicazioni prometterebbe. E i banchi non finiscono insieme: a uno toccano più pesi non nulli che a un altro, e chi è in anticipo resterebbe ad aspettare gli altri se una coda di lavoro non lo tenesse occupato.
Per le reti che guardano le immagini c’è una variante, ed è SCNN. Lì ogni peso incontra quasi ogni numero dell’ingresso, e allora si moltiplicano a blocchi tutte le coppie di numeri non nulli, e poi si spedisce ogni prodotto nella casella giusta del risultato. Lo smistamento diventa la parte costosa: due prodotti che vogliono la stessa casella nello stesso istante fanno la fila, e per ridurre gli ingorghi le caselle si raddoppiano. E qui il bilancio si rovescia quando gli zeri sono pochi: davanti a un’immagine quasi piena, o con troppo pochi pesi non nulli per riempire un blocco, lo smistamento costa più di quanto fa risparmiare, e un chip che moltiplica tutto va più veloce.
EIE [HLM+16] esegue \(\mathbf{o} = \mathbf{W}\mathbf{a}\) per uno strato completamente connesso potato. I pesi stanno in formato per colonne (CSC): per ogni colonna \(\mathbf{W}_{:,j}\) un vettore dei valori non nulli e uno di indici relativi a 4 bit, il numero di zeri che precede ogni voce, con uno zero esplicito inserito dopo quindici zeri consecutivi; il valore stesso è un indice a 4 bit in un dizionario di sedici pesi condivisi. Le attivazioni restano in formato denso: una rete di rilevamento degli elementi non nulli (leading non-zero detection) trova gli \(a_j \neq 0\) e li trasmette in broadcast ai 64 elementi di calcolo, a cui le righe di \(\mathbf{W}\) sono assegnate a turno (riga \(i\) all’elemento \(i \bmod 64\)); ciascuno scorre la propria parte della colonna \(j\) e accumula. Il lavoro è proporzionale al numero di pesi non nulli nelle colonne con \(a_j \neq 0\) invece che a tutta la griglia: con pesi al 10% e attivazioni al 30% di densità si fanno circa tre moltiplicazioni su cento. I costi sono gli indici (il lavoro attribuisce anche a loro un risparmio energetico reale circa dieci volte sotto quello teorico) e lo sbilanciamento del carico fra elementi, assorbito da code di profondità otto.
SCNN [PRM+17] porta l’idea alle convoluzioni, con pesi e attivazioni compressi entrambi. Il flusso planar-tiled, input-stationary, Cartesian product sfrutta il fatto che, a passo unitario, ogni peso di un filtro si moltiplica per ogni attivazione di una tessera del piano d’ingresso (ai bordi della tessera servono anche valori delle tessere vicine, che il lavoro scambia a parte): ogni elemento prende un vettore di \(F = 4\) pesi non nulli e uno di \(I = 4\) attivazioni non nulle, ne calcola tutti i sedici prodotti e li disperde, attraverso una crossbar, verso banchi di accumulatori scelti dalle coordinate d’uscita, che si ricavano dagli indici dei due fattori. I banchi sono il doppio dei prodotti (\(A = 2FI\)) per contenere le collisioni. Il punto di rottura è la densità: a parità di moltiplicatori con un acceleratore denso, e con più area per crossbar e accumulatori, SCNN è più veloce solo quando pesi e attivazioni sono ciascuno sotto l’85% circa di densità, e più efficiente in energia sotto l’83% contro il denso semplice e sotto il 60% contro uno che spegne già le moltiplicazioni per zero e comprime il traffico verso la memoria. Rende poco anche quando i fattori non nulli sono troppo pochi per riempire l’array \(4 \times 4\) (i filtri \(1 \times 1\)) e sugli strati d’ingresso, densi al 100%.
Il blocco scrive una griglia potata al 90% nel formato per colonne con le etichette a 4 bit, la moltiplica per un vettore passato da una ReLU saltando gli zeri, e conta.
import numpy as np

rng = np.random.default_rng(0)
n = 512
W = rng.normal(size=(n, n)) * (rng.random((n, n)) < 0.1)   # potata: nove pesi su dieci a zero
a = np.maximum(rng.normal(size=n), 0)                      # dopo una ReLU: circa metà a zero

# per ogni colonna i soli pesi non nulli, ciascuno con quante righe vuote lo
# precedono scritto in 4 bit: più di 15 righe vuote di fila vogliono uno zero di riempimento
colonne = []
for j in range(n):
    voci, ultima = [], -1
    for i in np.flatnonzero(W[:, j]):
        while i - ultima > 16:
            ultima += 16
            voci.append((ultima, 0.0))
        voci.append((i, W[i, j]))
        ultima = i
    colonne.append(voci)

o, moltiplicazioni, a_vuoto = np.zeros(n), 0, 0
for j in np.flatnonzero(a):                  # gli zeri dell'ingresso non partono nemmeno
    for i, w in colonne[j]:
        o[i] += w * a[j]
        moltiplicazioni += 1
        a_vuoto += w == 0                    # un riempimento si moltiplica come gli altri
print("uguale al prodotto denso:", np.allclose(o, W @ a))
print(f"pesi nulli: {np.mean(W == 0):.0%}, ingressi nulli: {np.mean(a == 0):.0%}")
print(f"moltiplicazioni: {n * n} nel prodotto denso, {moltiplicazioni} saltando gli zeri"
      f" ({moltiplicazioni / (n * n):.1%}), {a_vuoto} delle quali sugli zeri di riempimento")
voci = sum(len(c) for c in colonne)
riempimento = sum(1 for c in colonne for _, w in c if w == 0)
print(f"voci del formato compresso: {voci}, di cui {riempimento} zeri di riempimento")
uguale al prodotto denso: True
pesi nulli: 90%, ingressi nulli: 49%
moltiplicazioni: 262144 nel prodotto denso, 16407 saltando gli zeri (6.3%), 3009 delle quali sugli zeri di riempimento
voci del formato compresso: 31964, di cui 5797 zeri di riempimento
Il risultato è quello del prodotto denso, con il 6,3% delle moltiplicazioni. Un peso su dieci per un ingresso su due ne farebbe sperare il 5%, e la differenza sono gli zeri di riempimento, che si moltiplicano come gli altri: quasi seimila voci su trentaduemila, il prezzo delle etichette corte, pagato in memoria e in conti.
Spegnere invece di saltare#
Saltare gli zeri fa risparmiare tempo ed energia insieme, e costa etichette, code e smistamento. Una strada più economica rinuncia al tempo e tiene l’energia: il ciclo passa lo stesso, ma la parte di circuito che non ha niente da fare non si muove. È il gating (da gate, cancello: se ne chiude uno davanti a un pezzo di circuito), e ha tre gradi: fermare i dati che entrano in un moltiplicatore quando uno dei due numeri da moltiplicare è zero (data gating), fermare il clock di un blocco inattivo (clock gating), staccargli la corrente (power gating). Quanto rende ciascuno dipende da dove se ne va l’energia di un circuito digitale: una parte a ogni filo che cambia valore, una parte sempre, anche a circuito fermo. È la stessa ragione che sta dietro il power wall del capitolo sulle GPU.
Dentro un chip l’energia se ne va quasi tutta in un gesto: un filo che cambia valore. Ogni filo è un secchiello, che per passare da zero a uno va riempito fino all’orlo e per tornare a zero si svuota, e quell’acqua è persa. Un secchiello più grande costa di più; alzare l’orlo costa due volte, perché ci vuole più acqua e la si deve portare più in alto, così a orlo doppio la fatica è quattro volte tanto. Il metronomo del chip batte il tempo, e a ogni battito si riempiono i secchielli dei fili che cambiano, e solo quelli: un filo che resta com’era non costa niente. Più battiti al secondo, più secchielli. E c’è un’acqua che se ne va sempre, anche a chip fermo: i rubinetti gocciolano, ed è la dispersione.
A un banco, uno dei piccoli moltiplicatori del chip, arriva uno zero. Il risultato si sa già, zero per qualunque peso fa zero, e al totale non si aggiunge niente. Il banco allora non tira fuori il peso dal cassetto e non tocca la calcolatrice: i suoi fili restano come stavano e nessun secchiello si riempie. Su un chip per le reti che guardano le immagini questo solo accorgimento ha tolto quasi metà dell’energia spesa nei banchi. Il battito però passa lo stesso, e il banco lo passa fermo: si risparmia acqua, non tempo. Per risparmiare anche il battito bisogna sapere prima dove stanno gli zeri, ed è il mestiere delle etichette di EIE.
Un banco che per un intero strato non ha niente da fare smette di sentire il metronomo. Non si muove più niente, nemmeno i fili che portano il battito, che cambiano a ogni battito senza eccezioni e sono fra i più cari del chip. Anche questo ha un prezzo: il battito arriva al banco passando per un cancello in più, cioè un filo in ritardo rispetto agli altri banchi, e chi progetta il chip deve rimettere tutti a tempo. E i rubinetti gocciolano ancora.
Per fermare anche le gocce si chiude la valvola del banco, e chiuderla ha tre prezzi. Quello che il banco aveva sul tavolo si perde, a meno di metterlo prima in un cassetto che resta collegato. Riaprire vuol dire riempire di nuovo i secchielli del banco, cioè acqua, e un po’ di attesa prima di ripartire. E se tutti i banchi riaprissero insieme la pressione cadrebbe per tutti, così le valvole si riaprono una alla volta. Chiudere conviene solo se la pausa è lunga: se il banco perde una goccia a battito e riaprire costa quanto trenta gocce, una pausa di meno di trenta battiti costa più di quanto fa risparmiare. Per questo le due cose si fanno insieme: orecchie tappate per le pause brevi, dove non si perde niente e si riparte subito, e valvola chiusa per quelle lunghe.
Quanto durerà una pausa, però, non lo sa nessuno, e la regola pratica è aspettare qualche battito prima di chiudere. Se le pause sono di due specie, tante brevissime e poche lunghe, un banco fermo da quindici battiti è molto probabilmente in una pausa lunga, e chiuderlo conviene. Se invece a ogni battito il lavoro ha la stessa probabilità di tornare, aspettare non insegna niente. È come tirare un dado a ogni battito e far tornare il lavoro quando esce il sei: dopo dieci tiri senza sei, il sei non è più vicino di prima, perché il dado non si ricorda i tiri passati. Una pausa che dura da quindici battiti ha allora davanti a sé, in media, la stessa strada di una appena cominciata, e o conviene chiudere subito, o non conviene mai.
La potenza media di un circuito CMOS si scompone così [Cha94]:
dove \(C_L\) è la capacità caricata, \(V_{dd}\) la tensione di alimentazione, \(f_{clk}\) la frequenza del clock e \(p_{01}\) il fattore di attività (in letteratura spesso \(\alpha\)), la probabilità che il nodo compia in un ciclo una transizione \(0 \to 1\), che preleva \(C_L V_{dd}^2\) dall’alimentazione quando l’escursione del nodo è piena, pari a \(V_{dd}\), come nella logica CMOS ordinaria. \(I_{sc}\) è la corrente di cortocircuito, che scorre solo durante le commutazioni, quando i due transistor del nodo conducono insieme, e quindi segue l’attività come il primo termine, di cui di norma è una frazione piccola; \(I_{leak}\) è la dispersione, che scorre anche a circuito fermo. Le correnti statiche dei circuiti polarizzati, assenti nella logica CMOS ordinaria, si trascurano. Lo scaling di Dennard abbassava \(C_L\) e \(V_{dd}\) a ogni generazione, e \(f_{clk}\) poteva salire a densità di potenza costante: il muro è arrivato quando \(V_{dd}\) ha smesso di scendere.
Data gating. Se un operando è zero il prodotto è noto, e basta non propagare niente. Eyeriss [CKES17], l’acceleratore del flusso row stationary che la sezione sulle reti convoluzionali descrive, tiene in ogni elemento di calcolo un zero buffer di 12 bit con le posizioni degli zeri fra le attivazioni d’ingresso; su uno zero, la logica di gating disabilita la lettura del peso dalla memoria locale e impedisce al datapath della moltiplicazione-accumulo di commutare, cioè azzera il \(p_{01}\) di quel pezzo di circuito per quel ciclo. Rispetto allo stesso elemento senza gating la potenza scende del 45%, e su AlexNet la potenza del chip cala strato dopo strato, man mano che le attivazioni si riempiono di zeri. Il ciclo però si consuma e il throughput non cambia: recuperarlo vuol dire sapere in anticipo dove stanno i non nulli, cioè i formati compressi di EIE e SCNN con il loro costo in indici.
Clock gating. Il clock di un blocco passa per una porta comandata da un segnale di abilitazione: a blocco disabilitato i registri non caricano, la logica a valle vede ingressi fermi, e si ferma anche il ramo dell’albero di clock, che commuta a ogni ciclo (\(p_{01} = 1\)) e ha una capacità grande. Toglie il termine dinamico del blocco, non la dispersione; il prezzo è nel progetto dell’albero, dove la porta aggiunge ritardo e sfasamento fra i rami [Cha94]. Eyeriss spegne così, strato per strato, gli elementi che la mappatura lascia senza lavoro, e nella ripartizione della potenza del chip la rete del clock sta, con le memorie locali, fra le voci che dominano.
Power gating. Un transistor di sospensione, un PMOS verso l’alimentazione (header) o un NMOS verso massa (footer), stacca il blocco su un’alimentazione virtuale, e la sua dispersione crolla. I prezzi sono tre: lo stato si perde, salvo tenerlo in registri di ritenzione alimentati a parte; il risveglio costa tempo ed energia, perché le capacità del blocco vanno ricaricate; e chiudere tutti gli interruttori insieme richiama una corrente di spunto (in-rush) che disturba l’alimentazione, per cui li si chiude in sequenza. Per questo i due si usano insieme: il clock gating, che non perde lo stato e riparte subito, sulle pause brevi, e il power gating su quelle lunghe.
Quanto lunghe lo dice un bilancio. Se \(E_{ov}\) è l’energia di uno spegnimento con il suo risveglio ed \(E_{leak} = I_{leak}V_{dd}/f_{clk}\) la dispersione in un ciclo, staccare una pausa di \(D\) cicli rende \(E_{leak}\,D - E_{ov}\), positivo solo sopra il pareggio \(D^* = E_{ov}/E_{leak}\). È un modello lineare: Hu e colleghi ricavano il pareggio da un modello fisico della scarica dell’alimentazione virtuale, più fine di questa divisione, e con quello confrontano le politiche che decidono quando staccare [HBS+04]. Quella a tempo, che stacca dopo \(\tau\) cicli di inattività, tiene spente le unità in virgola mobile di un processore superscalare fuori ordine fino al 28% dei cicli, con il 2% di prestazioni perse nei risvegli. Quale \(\tau\) scegliere lo dice il bilancio stesso: arrivati a \(\tau\) cicli di pausa, staccare rende in media \(E_{leak}\,\mathbb{E}[D - \tau \mid D > \tau] - E_{ov}\), quindi conviene se la vita residua media \(\mathbb{E}[D - \tau \mid D > \tau]\) supera \(D^*\). Se questa cresce con \(\tau\), come quando le pause sono di due specie, l’attesa filtra le brevi; se \(D\) è geometrica non dipende da \(\tau\), e conviene staccare sempre o mai.
Il blocco mette alla prova la politica a tempo su pause di forma nota, nove su dieci brevi (quattro cicli in media) e una su dieci lunga (quattrocento), con il pareggio a trenta cicli; e poi su pause con la stessa media, ma senza memoria.
import numpy as np

rng = np.random.default_rng(0)
n = 100_000
# le pause di un'unità di calcolo, in cicli: nove su dieci brevi, una lunga
lunga = rng.random(n) < 0.1
due_specie = np.where(lunga, rng.geometric(1 / 400, n), rng.geometric(1 / 4, n))
# stessa media, ma ogni ciclo fermo ha la stessa probabilità di essere l'ultimo
senza_memoria = rng.geometric(1 / due_specie.mean(), n)

fuga = 1.0       # dispersione in un ciclo passato acceso e fermo
costo = 30.0     # energia per staccare l'unità e riattaccarla
print(f"pausa media {due_specie.mean():.2f} cicli,"
      f" pareggio {costo / fuga:.0f} cicli")

def risparmio(pause, attesa):
    """Stacca dopo `attesa` cicli fermi: dispersione risparmiata, al netto."""
    staccate = pause > attesa
    netto = fuga * (pause[staccate] - attesa).sum() - costo * staccate.sum()
    return netto / (fuga * pause.sum()), staccate.mean()

for nome, pause in [("due specie", due_specie),
                    ("senza memoria", senza_memoria)]:
    print(nome)
    for attesa in [0, 10, 30, 100]:
        r, quota = risparmio(pause, attesa)
        print(f"  attesa {attesa:3d}: risparmiato {r:6.1%} della dispersione,"
              f" staccate {quota:6.1%} delle pause")
    migliore = max(range(301), key=lambda a: risparmio(pause, a)[0])
    print(f"  attesa migliore fra 0 e 300 cicli: {migliore}")
pausa media 44.47 cicli, pareggio 30 cicli
due specie
  attesa   0: risparmiato  32.5% della dispersione, staccate 100.0% delle pause
  attesa  10: risparmiato  79.9% della dispersione, staccate  15.2% delle pause
  attesa  30: risparmiato  78.9% della dispersione, staccate   9.5% delle pause
  attesa 100: risparmiato  66.3% della dispersione, staccate   7.9% delle pause
  attesa migliore fra 0 e 300 cicli: 15
senza memoria
  attesa   0: risparmiato  32.5% della dispersione, staccate 100.0% delle pause
  attesa  10: risparmiato  26.0% della dispersione, staccate  79.5% delle pause
  attesa  30: risparmiato  16.6% della dispersione, staccate  50.5% delle pause
  attesa 100: risparmiato   3.4% della dispersione, staccate  10.2% delle pause
  attesa migliore fra 0 e 300 cicli: 0
Staccare subito rende il 32,5% in tutti e due i casi, perché dipende soltanto dalla media: ogni pausa paga trenta cicli e ne risparmia in media 44,47. Con le pause di due specie, aspettare dieci cicli porta il risparmio al 79,9% staccando il 15,2% delle pause, cioè con un risveglio ogni sette pause circa invece che a ogni pausa. L’attesa migliore è di quindici cicli; oltre si ricomincia a perdere, perché anche le pause lunghe vengono staccate tardi. Senza memoria, invece, aspettare peggiora soltanto, e l’attesa migliore è zero.
Il biglietto della lotteria, e perché non ci salva#
C’è una domanda che a questo punto viene naturale: se alla fine mi resta una rete con un decimo dei pesi che funziona, perché ho dovuto addestrare quella grande? Perché non parto da quella piccola?
La risposta sta nella sezione su overfitting e validazione, proprio dove mostra quanto male il numero di parametri misuri la complessità di un modello: quella sottorete funziona se la si riaddestra con i numeri di partenza che aveva (sulle reti grandi, con quelli di poche iterazioni dopo l’inizio), e reinizializzandola a caso non impara altrettanto bene. Non era il collegamento a essere buono, era il collegamento con quella partenza lì, e da qui il nome che l’idea porta: fra i milioni di collegamenti di una rete grande, inizializzati a caso, qualcuno è già disposto bene per il compito, e addestrare la rete grande è comprare tutti i biglietti insieme per ritrovarsi in mano quello vincente.
Qui interessa una conseguenza sola, ed è quella che riguarda l’efficienza: il risparmio che si vorrebbe non è disponibile. Per sapere quali sono i biglietti vincenti bisogna prima fare l’estrazione, cioè addestrare la rete grande, e per giunta più volte se si pota a giri. Tutto quello che si è visto finora (novanta pesi su cento tolti, un punto di accuratezza perso) si paga dopo un addestramento intero, non al posto suo. La potatura comprime un modello che esiste già; non insegna a farne uno piccolo.
Con due riserve, che stringono la frase senza ribaltarla. Quando si potano unità intere, l’architettura che ne esce, addestrata da zero con un calendario abbastanza lungo, spesso fa quanto il modello potato e rifinito [LSZ+19]: lì la potatura ha trovato una forma più che dei pesi, e la forma si può addestrare da sola. E una maschera si può cercare senza addestrare prima la rete densa, potando all’inizializzazione oppure cambiando la maschera durante l’addestramento, a numero di pesi fisso [EGM+20]. I metodi del primo tipo restano sotto la potatura fatta dopo l’addestramento [FDRC21], e il risparmio di conti dei secondi si incassa solo con un modo di moltiplicare che salti gli zeri, cioè alle condizioni già viste.
Le due leve insieme#
Le tre leve si compongono, e quello che costano insieme non è la somma di quello che costano da sole, né sta da una parte prevedibile. I pezzi per vederlo ci sono: si prende la rete, la si pota al novanta per cento riaddestrandola, e poi si arrotondano a quattro bit i pesi rimasti con la funzione della sezione precedente.
def stato_pieno():
    """Rimette la rete com'era dopo il primo addestramento."""
    with torch.no_grad():
        for p, originale in zip(rete.parameters(), pieni):
            p.copy_(originale)


def arrotonda(bit=4, gruppo=64):
    with torch.no_grad():
        for p in rete.parameters():
            if p.dim() == 2:
                p.copy_(quantizza(p, bit, gruppo))     # dalla sezione di prima


def pota_e_riaddestra(frazione=0.9):
    """Azzera in ogni matrice la frazione dei pesi piu' piccoli, e riaddestra
    tenendo i tagli."""
    maschere = []
    with torch.no_grad():
        for p in [q for q in rete.parameters() if q.dim() == 2]:
            k = int(frazione * p.numel())
            soglia = p.abs().flatten().kthvalue(k).values
            m = (p.abs() >= soglia).float()
            p *= m
            maschere.append(m)
    addestra(rete, 300, maschere)


stato_pieno()
print(f"rete intera:                {accuratezza(rete):.1f}%")
stato_pieno()
arrotonda()
print(f"solo quattro bit:           {accuratezza(rete):.1f}%")
stato_pieno()
pota_e_riaddestra()
print(f"solo potata al 90%:         {accuratezza(rete):.1f}%")
potata = [p.detach().clone() for p in rete.parameters()]
arrotonda()
print(f"potata e poi a quattro bit: {accuratezza(rete):.1f}%")
rete intera:                97.8%
solo quattro bit:           98.0%
solo potata al 90%:         96.9%
potata e poi a quattro bit: 96.7%
Arrotondare da solo non costa niente, anzi guadagna due decimi, che sono rumore. Potare da solo costa 0,9 punti. Fare tutte e due costa 1,1, più della somma dei due costi presi separatamente, che è 0,7: su un campione di prova di cinquecentoquaranta cifre, quello scarto in più sono due cifre. Ripartendo da un’altra inizializzazione, però, lo scarto cambia anche di verso, e lo si vede rifacendo le stesse quattro prove su cinque reti addestrate da partenze diverse (i costi sono in punti di accuratezza, rispetto alla rete intera di ciascuna):
print(f"{'partenza':>8} {'solo 4 bit':>11} {'solo potata':>12} "
      f"{'tutte e due':>12} {'somma':>6}")
for seme in range(5):
    rete = addestra(costruisci(seme), 600)
    pieni = [p.detach().clone() for p in rete.parameters()]
    intera = accuratezza(rete)
    arrotonda()
    solo_bit = intera - accuratezza(rete)
    stato_pieno()
    pota_e_riaddestra()
    solo_potata = intera - accuratezza(rete)
    arrotonda()
    tutte = intera - accuratezza(rete)
    print(f"{seme:>8} {solo_bit:>+11.1f} {solo_potata:>+12.1f} "
          f"{tutte:>+12.1f} {solo_bit + solo_potata:>+6.1f}")
partenza  solo 4 bit  solo potata  tutte e due  somma
       0        -0.2         +0.9         +1.1   +0.7
       1        +0.0         +1.7         +1.3   +1.7
       2        -0.2         +1.1         +1.5   +0.9
       3        +0.0         +0.2         +0.9   +0.2
       4        +0.6         +1.5         +1.7   +2.0
Su cinque partenze, comporre costa più della somma in tre e meno in due. Che sia più o meno non si sa prima: quello che ci si può permettere di perdere in tutto, il budget di errore, non si spartisce a tavolino fra le leve. Resta comunque un ottimo affare: un decimo dei pesi diversi da zero e un ottavo dei bit per ciascuno, per poco più di un punto di accuratezza. Quanto valga in byte dipende dal formato in cui si salva la rete, perché ogni peso tenuto si porta dietro il suo indirizzo.
Componendo le due leve salta fuori anche un guasto che nessuna delle due
mostrava da sola, e che non dà nessun errore. Dopo la potatura interi gruppi di
sessantaquattro pesi sono tutti zeri: senza la riga di protezione di
quantizza la scala di quei gruppi vale zero, dividere per zero riempie la
rete di valori non numerici, e da lì argmax sceglie sempre la stessa cifra.
Lo si vede rifacendo l’arrotondamento della rete potata di prima, ma senza la
protezione.
# un gruppo tutto di zeri ha massimo zero, e 0 / 0 da' `nan`
livello = 2 ** (4 - 1) - 1                     # quattro bit
vuoti = 0
with torch.no_grad():
    for p, salvato in zip(rete.parameters(), potata):
        p.copy_(salvato)
        if p.dim() == 2:
            f = p.reshape(p.shape[0], -1, 64)
            massimo = f.abs().amax(-1, keepdim=True)     # senza `clamp`
            vuoti += int((massimo == 0).sum())
            q = torch.round(f / massimo * livello).clamp(-livello - 1, livello)
            p.copy_((q * massimo / livello).reshape(p.shape))
zero = (yte == 0).float().mean() * 100
print(f"gruppi da 64 tutti a zero:       {vuoti}")
print(f"accuratezza senza protezione:    {accuratezza(rete):.1f}%")
print(f"cifra 0 fra gli esempi di prova: {zero:.1f}%")
gruppi da 64 tutti a zero:       201
accuratezza senza protezione:    8.3%
cifra 0 fra gli esempi di prova: 8.3%
Duecentouno gruppi sono tutti zeri, e l’accuratezza si ferma all’8,3%, che non
è il caso (il caso sarebbe il dieci per cento) ma la frequenza dello zero fra
gli esempi di prova: la rete risponde «zero» a tutto. Senza un avviso e senza
un errore. È il motivo della riga di protezione nella funzione quantizza
della sezione precedente, ed è il genere di guasto che si trova solo componendo
le cose e provandole.
Di tutte e tre le leve, la potatura non strutturata è quella con il divario più grande fra il risparmio sulla carta e quello sul calcolatore: la promessa è enorme, il costo in accuratezza è basso, e in mezzo c’è una moltiplicazione, quella densa, che quella promessa non la sa incassare.
Da ricordare
Potare vuol dire mettere a zero i pesi più piccoli. Da solo distrugge la rete; quello che la salva è riaddestrare tenendo i tagli: togliendo nove pesi su dieci si passa da 97,8% a 39,3%, e dopo trecento passi di riaddestramento si è a 96,9%.
La promessa però si riscuote male: con il novantacinque per cento di zeri le moltiplicazioni utili sono una su venti, e il calcolatore le fa tutte e venti lo stesso: 268 milioni in tutti e due i casi, di cui 255 milioni per zero. Non guarda i numeri, li macina.
Lo spazio su disco si guadagna se gli zeri sono tanti: ogni numero tenuto si porta dietro il suo indirizzo, e con metà zeri il risparmio sparisce. Per guadagnare anche tempo bisogna togliere i pesi a blocchi (un neurone intero, cioè una riga intera della griglia): allora la rete è davvero più piccola, ma si buttano via anche pesi utili che stavano nella riga sbagliata.
Un chip fatto apposta può invece saltare gli zeri, nei pesi e negli ingressi, se li tiene in un formato con le etichette delle posizioni. Paga in etichette, zeri di riempimento, code e smistamento, e quando gli zeri sono pochi un chip che moltiplica tutto va più veloce.
Lo zero si può anche solo spegnere: il banco che lo riceve non si muove, e si risparmia energia ma non tempo. Un banco senza lavoro può smettere di sentire il battito, o farsi chiudere anche l’acqua, che ferma le gocce ma conviene solo per pause più lunghe del pareggio.
Il biglietto della lotteria, che la sezione su overfitting e validazione ha già raccontato, dice qui una cosa sola: per sapere quali collegamenti tenere bisogna prima addestrare la rete grande. La potatura comprime un modello che esiste già; al più, quando toglie neuroni interi, insegna la forma di uno più piccolo.
Potare e poi arrotondare costa più della somma dei due costi in tre partenze su cinque, e meno nelle altre due: quanto si perde mettendo insieme le leve non si sa prima, si misura.
Da ricordare
La potatura per grandezza ordina i pesi per \(|w_i|\) e azzera sotto una soglia percentile. Poggia su quattro approssimazioni, tutte e quattro note come false: sviluppo fermo al secondo ordine, rete supposta a un minimo, Hessiana supposta diagonale (le tre di Optimal Brain Damage, che le nomina per scavalcare proprio l’ordinamento per grandezza) e diagonale supposta uniforme, che è la quarta e serve solo a riportarsi a \(|w_i|\).
Il riaddestramento con maschera fissa è la parte non opzionale: la rete potata è fuori dal minimo in cui stava, e i superstiti vanno riportati in un minimo della funzione ristretta. A sparsità 0,9: 39,3% subito, 96,9% dopo.
Sparsità non strutturata: riduce i parametri, non il tempo, perché un kernel GEMM denso esegue lo stesso numero di prodotti indipendentemente da quanti operandi siano nulli: a sparsità 0,95 il lavoro utile è un ventesimo e quello eseguito è identico. Passare a un formato sparso è cambiare kernel, e conviene o no a seconda della densità e dell’hardware (su CPU il pareggio di velocità è intorno al venti per cento di densità); anche lo spazio si risparmia solo sotto il pareggio degli indici, il cinquanta per cento di densità in CSR con valori e indici a 32 bit. Strutturata: rimuove unità intere e dà un guadagno reale su qualunque macchina, a un costo maggiore in accuratezza. Gli schemi a densità fissa locale, come il 2:4 [MLP+21], sono il compromesso imposto dall’hardware: raddoppiano il picco delle moltiplicazioni ma accelerano un GEMM intero meno di due volte, e senza riaddestramento costano più del 50% non strutturato.
Gli acceleratori sparsi saltano gli zeri in hardware: EIE [HLM+16] con i pesi in CSC a indici relativi di 4 bit e le attivazioni non nulle in broadcast, SCNN [PRM+17] con il prodotto cartesiano dei non nulli e una crossbar verso gli accumulatori. Il prezzo è negli indici e nella dispersione, e a densità alta (per SCNN, pesi e attivazioni ciascuno sopra l’85% circa) un acceleratore denso con gli stessi moltiplicatori vince.
Il gating risparmia energia, non cicli: data gating sugli operandi nulli (Eyeriss, potenza dell’elemento di calcolo giù del 45%), clock gating sul termine \(p_{01} C_L V_{dd}^2 f_{clk}\) dei blocchi fermi, power gating sulla dispersione, conveniente solo oltre il pareggio \(D^* = E_{ov}/E_{leak}\); la politica a tempo rende se la vita residua delle pause cresce con l’attesa.
L’ipotesi del biglietto della lotteria [FC19] sta nel capitolo sul machine learning, con i suoi due limiti: sulle reti grandi si riavvolge ai pesi di poche iterazioni dopo l’inizio [FDRC20], e la maschera si ottiene addestrando la rete densa. Il secondo è quello che conta qui: il costo è pagato prima e non al posto. Lo attenuano la potatura strutturata, la cui architettura si può addestrare da zero [LSZ+19], e l’addestramento sparso dinamico [EGM+20]; la potatura all’inizializzazione resta sotto quella fatta dopo l’addestramento [FDRC21].
Le leve si compongono, i costi no: potare al 90% e arrotondare a quattro bit costa più della somma dei due costi in tre partenze su cinque e meno nelle altre due. Il budget di errore si misura sul modello composto.
Le prime due leve hanno in comune una cosa che finora è passata sotto silenzio: partono da un modello già addestrato e ne cambiano l’interno, la quantizzazione arrotondandone i numeri, la potatura azzerandone una parte e riaddestrando il resto. La terza rovescia il tavolo. Non stringe il modello grande: ne costruisce un altro, piccolo, e gli affianca il grande come maestro. E la cosa da capire è che cosa passi fra i due, perché non è la risposta giusta: quella ce l’avevano già i dati.