


Mamba: selezione e scan#
S4 e i suoi successori diagonali discretizzano un sistema continuo in una ricorrenza lineare a stato fisso, \(\mathbf{h}_t = \bar{\mathbf{A}}\,\mathbf{h}_{t-1} + \bar{\mathbf{B}}\,x_t\) con uscita \(y_t = \mathbf{C}\,\mathbf{h}_t\), che si calcola come ricorrenza per generare e come convoluzione per addestrare. È una macchina potente e a lungo raggio, con un limite di fondo: è invariante nel tempo.
Un SSM lineare e tempo-invariante (LTI) usa le stesse tre regole a ogni passo: la stessa \(\bar{\mathbf{A}}\) per il decadimento dello stato, la stessa \(\bar{\mathbf{B}}\) per l’ingresso, la stessa \(\mathbf{C}\) per l’uscita. È questa invarianza a dare a S4 la forma convoluzionale, con un unico filtro \(\bar{\mathbf{K}}\) valido per tutta la sequenza, e ne è anche il limite: l’aggiornamento dello stato non dipende da ciò che entra, quindi il modello non può decidere, in base al contenuto, che cosa trattenere e che cosa lasciar cadere. Tratta allo stesso modo la parola importante e quella di riempimento.
L’idea di Mamba, proposta da Albert Gu e Tri Dao alla fine del 2023 [GD24], è rendere l’SSM selettivo: le regole della ricorrenza diventano funzioni di ciò che entra, così che il modello possa decidere, parola per parola, che cosa propagare e che cosa dimenticare. È lo stesso passaggio che, nella sezione sulla scrittura in memoria del capitolo precedente, separava il decadimento fissato una volta per tutte (RetNet) da quello che la parola in arrivo ricalcola a ogni passo (Mamba-2): là si partiva dall’attenzione, qui dai sistemi dinamici.
La selettività (S6)#
Il cuore di Mamba è un SSM di tipo S4 in cui le regole non sono più decise una volta per tutte: le sceglie, parola per parola, ciò che sta entrando. Gli autori lo chiamano S6, per brevità: la sigla sta per «S4 con un meccanismo di selezione, calcolato con uno scan», e non indica il successore di S5, che è il modello di un altro gruppo.
Se le regole cambiano a ogni parola, il sistema non è più invariante nel tempo e non ha più un filtro unico: la forma «tutto insieme», che rendeva veloce l’addestramento di S4, non si può più usare. Per lavorare in parallelo servirà un’altra strada, lo scan. Ma prima il guadagno, che ripaga il sacrificio.
All’ingresso di un locale ci sono due modi di far entrare la gente. Uno è il tornello: chiunque arrivi, stesso trattamento, stessa spinta in avanti. L’altro è un buttafuori che guarda in faccia chi ha davanti e decide sul momento. Un SSM invariante nel tempo è il tornello; Mamba è il buttafuori. Tre cose cambiano da una faccia all’altra: quanto di una persona gli resta in testa, quanto di ciò che ha in testa tira fuori al momento giusto, e il tempo che le dedica.
Una cosa invece il buttafuori non la cambia mai: il ritmo a cui i ricordi gli sbiadiscono col passare del tempo. Ed è proprio per questo che il tempo dedicato a ciascuno decide quanto dimentica a ogni faccia. Quando se la prende comoda, chi ha davanti gli si stampa bene in testa, e intanto le facce di prima gli sbiadiscono parecchio; se fa passare qualcuno in un lampo, quello non lascia traccia e la sua testa resta com’era. Con il solo intervallo ottiene tutte e due le cose che gli servono: «di questo mi ricorderò» e «questo non l’ho nemmeno visto». È l’intervallo \(\Delta\) della vasca, e Mamba lo sceglie a ogni parola.
Questo meccanismo apre la porta a un tipo di ragionamento che un tornello non potrà mai fare: quello che dipende dal contenuto. Prendi il gioco del «copia solo le parole in maiuscolo» in mezzo a un fiume di parole minuscole: serve decidere, parola per parola, se questa va tenuta o buttata. Un sistema che tratta tutti i token allo stesso modo fallisce; uno che sa scegliere, no.
Il prezzo si vede sulla fila fuori. Un tornello lo si regola la mattina, a locale vuoto: una regolazione sola, buona per tutti quelli che arriveranno, tanto che la fila si potrebbe smaltire a blocchi. Le decisioni del buttafuori non esistono prima che la persona gli sia arrivata davanti: non c’è nessuna regolazione da preparare in anticipo. Ogni decisione dipende solo dalla faccia che ha davanti, ma i ricordi si accumulano nell’ordine in cui le facce si presentano, e per smaltire la fila in parallelo serve un trucco diverso, lo scan.
In un SSM LTI i parametri \((\bar{\mathbf{A}}, \bar{\mathbf{B}}, \mathbf{C}, \Delta)\) sono costanti lungo la sequenza. Mamba li rende funzioni dell’input. Detta \(\mathbf{x}_t\) l’attivazione al passo \(t\) e \(N\) la dimensione dello stato dell’SSM (per canale):
dove \(\mathrm{Linear}_N\) proietta \(\mathbf{x}_t\) in un vettore di dimensione \(N\) (\(\mathbf{B}_t\) e \(\mathbf{C}_t\) sono vettori, ma conservano la maiuscola delle matrici \(\mathbf{B}\) e \(\mathbf{C}\) da cui discendono, come in tutta la letteratura), \(p\) è il bias appreso del canale (uno per canale, un vettore di dimensione \(D\) in tutto) e \(\mathrm{softplus}(z) = \log(1 + e^z)\) garantisce un passo \(\Delta_t > 0\). Nell’implementazione \(\mathrm{Linear}_1\) è una proiezione di rango basso verso tutti i \(D\) canali, così che ogni canale abbia il suo passo; la formula ne scrive la componente di un canale. La matrice \(\mathbf{A}\), diagonale, resta un parametro fisso: non dipende dal token. Ma la discretizzazione (lo zero-order hold, che nella sezione sui sistemi dinamici ha dato \(\bar{\mathbf{A}} = \exp(\Delta \mathbf{A})\)) fa passare \(\Delta_t\) dentro la transizione:
dove \(\bar{\mathbf{A}}_t\) è la transizione discreta al passo \(t\) e \(\bar{\mathbf{B}}_t = \Delta_t \mathbf{B}_t\) è il termine di ingresso, entrambi ottenuti da \(\Delta_t\) (la ricorrenza è scritta per un canale: \(x_t\) è la componente dell’attivazione \(\mathbf{x}_t\) su quel canale, ed è un numero). Poiché \(\Delta_t\) dipende da \(\mathbf{x}_t\), anche \(\bar{\mathbf{A}}_t\) diventa di fatto data-dipendente, pur partendo da una \(\mathbf{A}\) fissa: un \(\Delta_t\) grande azzera quasi del tutto lo stato (\(\bar{\mathbf{A}}_t \to \mathbf{0}\)) e fa entrare con forza il token corrente; un \(\Delta_t\) vicino a zero lascia lo stato quasi immutato (\(\bar{\mathbf{A}}_t \to \mathbf{I}\)) e ignora il token (\(\bar{\mathbf{B}}_t \to \mathbf{0}\)) [GD24].
Il ruolo di \(\Delta_t\) si vede nel caso più piccolo. Con \(N = 1\), \(A = -1\), \(B = 1\) e \(\Delta_t = \mathrm{softplus}(s_t)\), dove \(s_t\) è la proiezione del token, la discretizzazione ZOH dà \(\bar{A}_t = e^{-\Delta_t} = 1 - \sigma(s_t)\) e \(\bar{B}_t = 1 - e^{-\Delta_t} = \sigma(s_t)\), con \(\sigma\) la sigmoide, quindi
cioè un cancello di interpolazione come nelle RNN a cancelli (è il Teorema 1 del paper): con \(g_t \to 1\) lo stato si azzera e vi si scrive \(x_t\), con \(g_t \to 0\) lo stato resta e \(x_t\) è ignorato. L’identità richiede lo ZOH esatto anche per \(B\); con la semplificazione di Eulero dell’implementazione, \(\bar{B}_t = \Delta_t\), i due coefficienti non sommano più a uno.
Il prezzo è la perdita dell’invarianza temporale: non esiste più un unico kernel \(\bar{\mathbf{K}} = (\mathbf{C}\bar{\mathbf{B}},\, \mathbf{C}\bar{\mathbf{A}}\bar{\mathbf{B}},\, \dots)\), perché \(\bar{\mathbf{A}}_t, \bar{\mathbf{B}}_t, \mathbf{C}_t\) cambiano a ogni passo. La forma convoluzionale svanisce; resta la forma ricorrente, e con essa il problema di come addestrarla in parallelo.
Il guadagno concettuale è quello che gli autori chiamano ragionamento basato sul contenuto. Il gioco delle parole da copiare e di quelle da lasciar cadere è il compito di selective copying. Nella sua versione classica, con le parole da copiare a distanze fisse, un SSM invariante nel tempo se la cava contando il tempo, con un filtro della lunghezza giusta; il selective copying rende casuali le distanze e toglie la scorciatoia. Lì il nucleo di S4 da solo si ferma al 18 per cento di risposte esatte, e dentro i blocchi di H3 o di Mamba a circa il 57; il nucleo selettivo arriva al 97 da solo e sopra il 99 dentro un blocco [GD24]. Lo stesso vale per le induction heads [OEN+22], le teste di induzione incontrate fra i grandi modelli linguistici: il meccanismo con cui un modello, visto una volta lo schema «A è seguito da B», lo completa la volta successiva. Richiedono di agganciare il presente a un preciso episodio passato, cioè di scegliere cosa propagare; addestrato su sequenze di 256 token, Mamba le risolve senza errori fino a un milione, circa quattromila volte più lunghe, dove nessuno degli altri modelli provati va oltre il doppio.
La selettività ha lo stesso compito che nella sezione sulla scrittura in memoria avevano i gate di dimenticanza calcolati dai dati, e il legame è preciso: nel caso più piccolo la ricorrenza di Mamba è proprio una cella a cancello, come quelle delle RNN (Teorema 1 del paper).
Lo scan hardware-aware#
Rinunciare alla convoluzione sembra un disastro per l’efficienza: la forma «tutto insieme» era ciò che rendeva S4 addestrabile in fretta. La ricorrenza lineare, però, ha una proprietà che le ricorrenze non lineari non hanno, come anticipava la sezione sui modelli di sequenza: comporre due passi dà ancora un passo dello stesso tipo, descritto dagli stessi numeri. Applicare \(h \mapsto a_1 h + b_1\) e poi \(h \mapsto a_2 h + b_2\) equivale ad applicare \(h \mapsto (a_2 a_1)\,h + (a_2 b_1 + b_2)\), quindi fondere due passi costa una moltiplicazione e una somma. In una ricorrenza non lineare, come \(h \mapsto \tanh(w\,h + u_t)\), la composta di due passi non ha una forma così compatta, e fonderli non fa risparmiare niente. A questa proprietà, la chiusura, si aggiunge da sé l’associatività, che vale per ogni composizione di funzioni: raggruppare i passi in un modo o nell’altro dà lo stesso risultato. Insieme autorizzano a fondere i passi a coppie, poi a gruppi di quattro, di otto, invece di percorrerli in fila da sinistra a destra.
Questo è il parallel scan, dove «scan» è la passata che percorre la sequenza accumulando i risultati parziali. In fila, \(L\) passi chiedono \(L\) turni uno dopo l’altro; a raddoppio ne bastano circa \(\log_2 L\), una decina per mille passi, e raddoppiando la lunghezza si aggiunge un turno soltanto. Il prezzo è il lavoro totale, che nella versione più semplice cresce di un fattore \(\log_2 L\) e in quella più efficiente resta dell’ordine di \(L\), come in fila: è il compromesso tipico del calcolo parallelo, più conti (o almeno non meno) in cambio di meno attesa.
Ogni turno tiene occupati migliaia di core della GPU: quelli generici, però, non le sue unità dedicate a moltiplicare matrici, i tensor core, ed è il problema da cui partirà Mamba-2. La convoluzione se n’è andata, ma il parallelismo resta.
La Fig. 18.3 mette le due strade sullo stesso orologio.

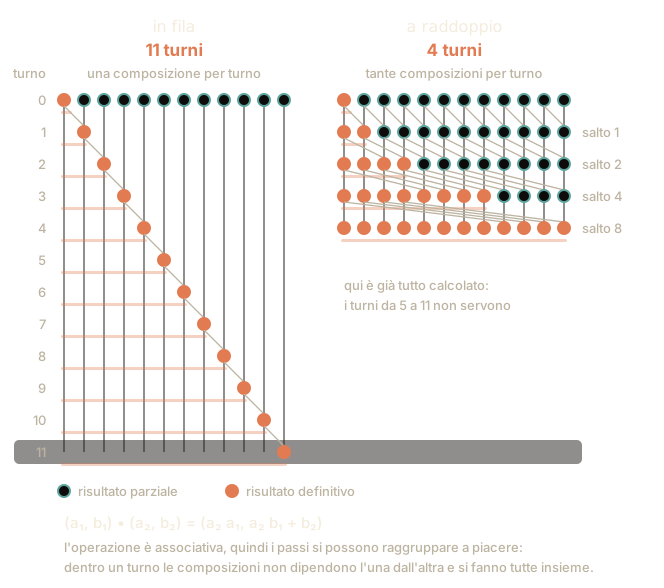
Fig. 18.3 Le due strade per svolgere la stessa ricorrenza su dodici passi, messe sullo stesso orologio: in verticale i turni, in orizzontale le posizioni della sequenza. A sinistra si va in fila, una composizione per turno, e il risultato definitivo (il pallino pieno) avanza di una posizione alla volta: servono undici turni. A destra si compongono le posizioni distanti prima 1, poi 2, poi 4, poi 8, e siccome a ogni turno raddoppia il tratto di sequenza già riassunto, dopo quattro turni ogni posizione ha il suo risultato. Le due strade danno gli stessi numeri, e non con la stessa fatica: a sinistra di composizioni se ne contano undici, a destra trentatré, in cambio di quattro turni invece di undici.#
Non basta però l’algoritmo. Mamba deve fare i conti anche con il modo in cui una scheda grafica tiene i dati, la sua gerarchia di memoria, ed è qui che sta la parte «hardware-aware», cioè attenta a come è fatta la macchina.
Mille numeri alla lavagna, e una classe che deve sommarli. Un ragazzo solo parte dal primo e va avanti, quasi mille addizioni una dopo l’altra, e nessuno può aiutarlo, perché per fare la somma di adesso deve aspettare quella di prima. La classe invece lavora tutta insieme: al primo giro ognuno somma al proprio numero quello del compagno che lo precede, al secondo quello di due posti prima, al terzo quello di quattro, e a ogni giro raddoppia il tratto di lavagna che ciascuno si è già messo dentro. Dopo dieci giri si è in fondo, perché raddoppiando dieci volte si passa il mille. Di addizioni se ne fanno parecchie più di prima, perché a ogni giro lavorano quasi tutti; a crollare è l’attesa, che da mille passi in fila scende a dieci giri.
Alla lavagna, al posto dei numeri, la catena dei passi di Mamba mette istruzioni, e ognuna dice due cose, «del totale che hai, tieni questa parte» e «aggiungici questo». Due istruzioni una dietro l’altra si fondono in una sola, dello stesso identico tipo. «Tieni metà e aggiungi 4», poi «tieni un decimo e aggiungi 1», è come dire in un colpo solo «tieni un ventesimo e aggiungi 1,4», perché metà di un decimo è un ventesimo, e del 4 aggiunto prima sopravvive un decimo, cioè 0,4, che sommato a 1 fa 1,4. Tanto basta per mettersi a coppie come la classe. Due istruzioni diventano una, quella si accoppia con la vicina, e dopo una decina di giri il conto è fatto.
C’è però una libertà che i ragazzi si prendono e le istruzioni no. Sommando, l’ordine non conta, 3 più 5 fa quanto 5 più 3. Le due istruzioni di prima, scambiate, danno un altro risultato, perché «tieni un decimo e aggiungi 1» seguito da «tieni metà e aggiungi 4» porta, partendo da zero, a 4,5 invece che a 1,4. Raggruppare quanto si vuole, scambiare mai, perché l’ordine delle istruzioni è l’ordine delle parole della frase. E non serve solo il totale finale, serve la somma fino a ciascun numero della lavagna, e quelle escono per strada, un giro dopo l’altro.
Un contabile tiene la somma corrente di una lunghissima lista di movimenti. Ha un foglietto sulla scrivania, piccolo ma a portata di mano, e un archivio in cantina, enorme ma lontano, e ogni discesa costa tempo. Scendere in archivio a ogni riga, per depositare e riprendere il totale, è il modo stupido. Il modo furbo è tenere la somma sul foglietto, aggiornarla movimento dopo movimento senza mai alzarsi, e scendere in cantina una volta sola alla fine.
Mamba fa esattamente questo. Il foglietto veloce è la memoria interna della scheda grafica, l’archivio lontano è la sua memoria principale, e sul foglietto ci stanno i conti della scheda, non il riassunto che il modello si fa del testo. I parametri li carica una volta, svolge tutta la catena sul foglietto e riporta in archivio soltanto il risultato, mentre i totali intermedi, che sono migliaia e ingombranti, in cantina non ci scendono mai. Quando poi servono di nuovo, per correggere i conti (è la backpropagation, il passaggio all’indietro dell’addestramento), il contabile non li ripesca, li rifà, perché rifare una somma costa meno che tenere in archivio migliaia di fogli.
L’operatore dello scan si scrive in una riga. Posto \(h_t = a_t\,h_{t-1} + b_t\) (una singola componente dello stato: nel caso diagonale \(a_t\) e \(b_t\) sono le componenti corrispondenti di \(\bar{\mathbf{A}}_t\) e di \(\bar{\mathbf{B}}_t x_t\), e sono numeri), ogni passo è la coppia \((a_t, b_t)\) e comporne due dà
dove il fattore di sinistra è il passo che viene prima. La famiglia è dunque chiusa (il risultato è ancora una coppia dello stesso tipo), ed è la chiusura a rendere lo scan conveniente: ogni nodo dell’albero costa una moltiplicazione e una somma. L’operatore è anche associativo, perché lo è la composizione di funzioni, e l’associatività permette di riassociare l’albero a piacere; ma vale per qualunque ricorrenza, anche non lineare, dove però la composta di due passi non ha una forma chiusa e riassociare non fa risparmiare niente. L’operatore non è invece commutativo, e non potrebbe esserlo: l’ordine dei fattori è l’ordine della sequenza.
Le versioni classiche dello scan sono due, e differiscono nel lavoro, non nella profondità. Detta \(L\) la lunghezza della sequenza, quella a raddoppio compone a ogni turno le posizioni distanti prima 1, poi 2, poi 4: raggiunge la profondità \(O(\log L)\), ma con un lavoro \(O(L\log L)\), cioè tante volte il necessario quanti sono i turni. Quella di Blelloch, con una passata che sale e una che scende, ha la stessa profondità \(O(\log L)\) e lavoro \(O(L)\), come la versione sequenziale. In entrambe il numero di turni crolla da \(L\) al suo logaritmo, ed è il numero di turni ciò che si paga in attesa.
Fin qui si contano composizioni. Una composizione costa \(O(N)\) per uno stato diagonale, dove si combinano elemento per elemento le coppie \((\mathbf{a}, \mathbf{b}) \in \mathbb{R}^N \times \mathbb{R}^N\), e \(O(N^3)\) per una \(\mathbf{A}\) piena, che chiede un prodotto di matrici: è per questo che S5 e Mamba prendono la transizione diagonale. Il lavoro totale è allora \(O(LN)\) con Blelloch e \(O(LN \log L)\) a raddoppio. La versione a raddoppio è quella descritta da Hillis e Steele [HS86], quella a due passate è di Blelloch [Ble90]; applicarle alle ricorrenze lineari delle reti neurali è un’idea di Martin e Cundy [MC18], e da lì la riprendono S5 e Mamba.
La GPU, dal canto suo, ha una memoria ad alta capacità ma lenta, la HBM, e una memoria molto più piccola e veloce, la SRAM on-chip. Il collo di bottiglia di una ricorrenza selettiva è che lo stato espanso ha forma \((\texttt{batch}, L, D, N)\) (batch per lunghezza per canali per dimensione dello stato) e materializzarlo tutto in HBM sarebbe proibitivo in memoria e in banda. Mamba lo evita con la fusione dei kernel (kernel fusion): carica i parametri \((\Delta, \mathbf{A}, \mathbf{B}, \mathbf{C})\) dalla HBM alla SRAM, esegue in SRAM la discretizzazione e la ricorrenza tramite il parallel scan, e riporta in HBM soltanto l’output \(\mathbf{y}\) di dimensione \((\texttt{batch}, L, D)\). Lo stato espanso non viene mai scritto nella memoria lenta: nasce e muore in SRAM.
Quanto pesi lo stato espanso lo dice un conto. In Mamba-130M (\(D = 768\), fattore di espansione \(E = 2\), quindi 1536 canali interni, e \(N = 16\)), per una sola sequenza e un solo strato:
# lo stato espanso di uno strato di Mamba-130M: D = 768, E = 2, N = 16
canali, stato = 2 * 768, 16   # canali interni (E per D) e stato per canale
for lunghezza in (2048, 2**20):
    elementi = lunghezza * canali * stato
    print(f"L = {lunghezza:>7}: stato espanso {4 * elementi / 1e6:>7.0f} MB, "
          f"ingresso {4 * lunghezza * canali / 1e6:>5.0f} MB (float32)")
L =    2048: stato espanso     201 MB, ingresso    13 MB (float32)
L = 1048576: stato espanso  103079 MB, ingresso  6442 MB (float32)
Lo stato espanso è \(N = 16\) volte l’ingresso: duecento megabyte a 2048 token, più di cento gigabyte a un milione. In operazioni, invece, la ricorrenza ne fa \(O(LDN)\) e la convoluzione \(O(LD \log L)\), quindi per \(N\) piccolo e sequenze lunghe la ricorrenza può costare perfino meno [GD24]: rinunciando alla convoluzione si perde il parallelismo, non il lavoro.
A questo si aggiunge la ricomputazione (recomputation). Nell’addestramento, il passo all’indietro (backward) ha bisogno degli stati intermedi \(\mathbf{h}_t\) per calcolare i gradienti; salvarli tutti costerebbe memoria quanto materializzare lo stato espanso. Mamba non li salva: li ricalcola durante il backward, rifacendo la ricorrenza. È lo stesso baratto di FlashAttention e del gradient checkpointing (si spende un po’ di calcolo in più per risparmiare molta memoria), e permette al selective scan di avere lo stesso profilo di memoria di un’implementazione ottimizzata dell’attenzione, senza mai pagare il costo dello stato espanso in HBM.
La funzione ssm_selettivo scrive la ricorrenza selettiva di un canale con un
ciclo sulla posizione \(t\):
\(\mathbf{h}_t = \bar{\mathbf{A}}_t\,\mathbf{h}_{t-1} + \bar{\mathbf{B}}_t\,x_t\)
e \(y_t = \mathbf{C}_t^{\top}\mathbf{h}_t\). Poi lo stesso \(\mathbf{y}\) si calcola
in due modi senza il ciclo.
import torch

# SSM selettivo, un canale: stato h di dimensione N.
# I parametri B, C, delta dipendono dal token (indice t); A e' fisso.
def ssm_selettivo(x, A, B, C, delta):
    # x: (L,)   input del canale
    # A: (N,)   diagonale fissa (valori negativi, per stabilita')
    # B, C: (L, N)  generati da x, cambiano a ogni passo
    # delta: (L,)   passo di discretizzazione, generato da x
    L, N = B.shape
    h = torch.zeros(N, dtype=x.dtype, device=x.device)
    y = torch.empty_like(x)
    for t in range(L):
        A_bar = torch.exp(delta[t] * A)   # A-bar_t = exp(delta_t A), diagonale
        B_bar = delta[t] * B[t]           # discretizzazione semplificata di B
        h = A_bar * h + B_bar * x[t]      # h_t = A-bar_t h_{t-1} + B-bar_t x_t
        y[t] = torch.dot(C[t], h)         # y_t = C_t . h_t
    return y
Il ciclo for è la forma ricorrente, quella dell’inferenza: costo e memoria
costanti per token, un aggiornamento dopo l’altro. Quel ciclo però si può evitare in due modi, e li proviamo tutti e due.
Il primo riprende la discretizzazione: se le regole non cambiano da un passo all’altro, lo stesso risultato si ottiene con un filtro unico che scorre sulla sequenza. Congeliamo allora i tre parametri che dipendevano dal token (\(\mathbf{B}_t\), \(\mathbf{C}_t\) e \(\Delta_t\)), costruiamo quel filtro e confrontiamo.
torch.manual_seed(0)
L, N = 12, 4
x = torch.randn(L, dtype=torch.float64)
A = -torch.rand(N, dtype=torch.float64) - 0.5      # autovalori negativi
B_fisso = torch.randn(N, dtype=torch.float64)
C_fisso = torch.randn(N, dtype=torch.float64)
delta = torch.full((L,), 0.4, dtype=torch.float64)

# stessi parametri a ogni passo: il sistema e' invariante nel tempo (LTI)
y_ric = ssm_selettivo(x, A, B_fisso.repeat(L, 1), C_fisso.repeat(L, 1), delta)

# il kernel K_j = C A-bar^j B-bar: quanto pesa ancora un ingresso di j passi fa
A_bar = torch.exp(0.4 * A)
B_bar = 0.4 * B_fisso
K = torch.stack([(C_fisso * A_bar**j * B_bar).sum() for j in range(L)])

# la convoluzione causale con quel kernel, scritta a mano
y_conv = torch.stack([(K[: t + 1] * torch.flip(x[: t + 1], (0,))).sum()
                      for t in range(L)])

print("ricorrenza vs convoluzione, scarto massimo sotto 1e-12:",
      (y_ric - y_conv).abs().max().item() < 1e-12)
ricorrenza vs convoluzione, scarto massimo sotto 1e-12: True
Il secondo è il parallel scan: anche quando le regole cambiano a ogni passo,
e il filtro unico non esiste più, calcola esattamente lo stesso vettore y
del ciclo, raggruppando i passi invece di percorrerli in fila.
def scan_parallelo(a, b):
    """Ricorrenza h_t = a_t h_{t-1} + b_t svolta a raddoppio.

    Ogni passo e' la coppia (a_t, b_t), e comporne due da'
    (a1, b1) . (a2, b2) = (a2 a1, a2 b1 + b2): ancora una coppia (la
    famiglia e' chiusa), e l'operazione e' associativa, quindi i passi si
    possono fondere e raggruppare a piacere.
    """
    a, b = a.clone(), b.clone()
    salto = 1
    while salto < a.shape[0]:
        a_prec, b_prec = a[:-salto].clone(), b[:-salto].clone()
        b[salto:] = a[salto:] * b_prec + b[salto:]
        a[salto:] = a[salto:] * a_prec
        salto *= 2          # 1, 2, 4, 8, ...: log L giri invece di L
    return b                # b_t contiene ora h_t

# parametri che cambiano a ogni passo: il sistema e' selettivo
B = torch.randn(L, N, dtype=torch.float64)
C = torch.randn(L, N, dtype=torch.float64)
delta = torch.rand(L, dtype=torch.float64) * 0.5 + 0.1
y_ciclo = ssm_selettivo(x, A, B, C, delta)

A_bar = torch.exp(delta[:, None] * A)          # (L, N)
B_bar = delta[:, None] * B * x[:, None]        # (L, N)
H = scan_parallelo(A_bar, B_bar)               # tutti gli stati in una volta
y_scan = (C * H).sum(dim=1)

print("ciclo vs scan parallelo, scarto massimo sotto 1e-12:",
      (y_ciclo - y_scan).abs().max().item() < 1e-12)
ciclo vs scan parallelo, scarto massimo sotto 1e-12: True
In tutti e due i confronti lo scarto resta al livello degli arrotondamenti della doppia precisione, ben sotto \(10^{-12}\): le forme messe a paragone calcolano la stessa funzione. È, ancora una volta, la doppia natura che accomuna tutta questa famiglia di modelli: una forma parallela per addestrare in fretta, una forma ricorrente a costo costante per generare.
Il blocco Mamba#
Attorno al nucleo selettivo sta il blocco Mamba, che nasce dalla fusione di due pezzi già noti. Il primo è il blocco H3 [FDS+23], che aveva adattato gli SSM al linguaggio mettendo attorno al nucleo ricorrente un cancello d’uscita: due rami che si moltiplicano elemento per elemento, e uno regola quanto dell’altro passa, lo stesso schema del gate d’uscita della cella mLSTM nella sezione sulle architetture lineari. Il secondo è il gated MLP, la variante con cancello dello strato che nei Transformer segue l’attenzione. Il cancello del blocco agisce posizione per posizione; la selezione, che agisce lungo la sequenza, sta dentro l’SSM, in \(\Delta_t\), \(\mathbf{B}_t\) e \(\mathbf{C}_t\). Il blocco è l’unico tipo della rete, ripetuto decine di volte con una normalizzazione e una connessione residua, dove i Transformer alternano attenzione e MLP.

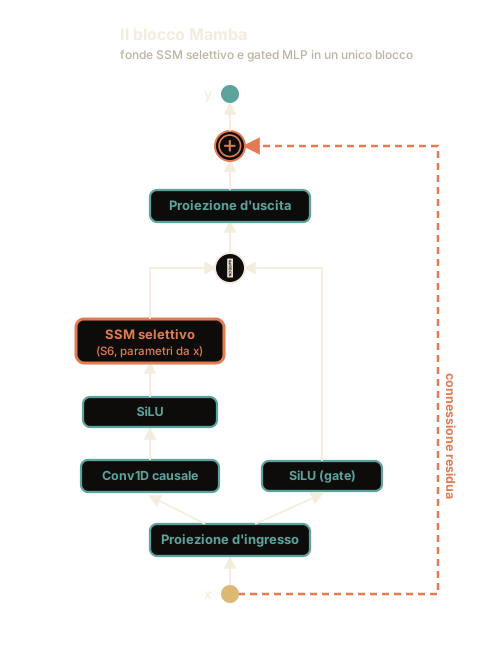
Fig. 18.4 Il blocco Mamba, ripetuto uguale decine di volte. Dopo una proiezione lineare l’ingresso si divide in due rami: quello principale (a sinistra) passa per una convoluzione causale corta (Conv1D), una SiLU e l’SSM selettivo; quello parallelo (a destra) per una sola SiLU, e fa da cancello. I due rami si moltiplicano elemento per elemento (\(\odot\)) e una proiezione di uscita riporta il risultato alla dimensione di partenza. Il tratteggio è la connessione residua: l’ingresso del blocco, che il disegno chiama \(x\), viene sommato (\(\oplus\)) alla sua uscita.#
Seguiamo il percorso di Fig. 18.4 dal basso verso l’alto.
Il blocco è una piccola catena di montaggio. Il pezzo grezzo (il token) entra e viene subito sdoppiato in due copie che seguono strade diverse. La copia principale passa per tre stazioni: prima una che le fa dare un’occhiata ai quattro pezzi appena passati, mai a quelli che devono ancora arrivare (una convoluzione corta, una finestrella che non ha niente a che vedere col filtro lungo quanto il testo a cui Mamba ha rinunciato), poi un ammorbidimento (l’attivazione), poi il cuore selettivo che decide cosa ricordare del lungo passato. La seconda copia prende una scorciatoia con un solo ammorbidimento e diventa un cancello: alla fine i due rami si reincontrano e il cancello regola quanto del ramo principale lasciar passare, moltiplicandoli insieme. Un’ultima proiezione rimette il pezzo nella forma di partenza, e il pezzo originale, portato in cima da un passaggio a parte, ci si somma: le lavorazioni aggiungono al pezzo invece di sostituirlo. Un solo tipo di stazione, ripetuto in verticale decine di volte: niente attenzione, niente strati aggiuntivi, la stessa macchina dall’inizio alla fine.
Detta \(\mathbf{u} \in \mathbb{R}^{D}\) l’attivazione in ingresso al blocco, il flusso è:
Proiezione in ingresso: una proiezione lineare porta \(\mathbf{u}\) a dimensione \(2ED\) (fattore di espansione \(E = 2\)) e la divide in due rami da \(ED\) canali, quello principale e \(\mathbf{z}\) (di gating).
Convoluzione causale 1D: una
Conv1ddepthwise (un filtro per canale) a finestra di 4 passi scorre sul ramo principale lungo la dimensione temporale. È «causale» perché ogni posizione vede solo il proprio passato immediato (nessuna fuga di informazione dal futuro) ed è la stessa idea di filtro che scorre vista per le reti convoluzionali, qui ridotta a una dimensione e a una manciata di passi. Fornisce un contesto locale a basso costo prima dell’SSM.Attivazione SiLU: si applica \(\mathrm{SiLU}(x) = x\,\sigma(x)\) (nota anche come Swish), la parente liscia della ReLU delle funzioni di attivazione, dove \(\sigma\) è la sigmoide. Il risultato è l’ingresso \(\mathbf{x}_t\) dell’SSM, da cui si ricavano \(\mathbf{B}_t\), \(\mathbf{C}_t\) e \(\Delta_t\).
SSM selettivo (S6): il ramo attraversa il nucleo selettivo, con stato \(N = 16\) per canale, \(\mathbf{B}_t, \mathbf{C}_t, \Delta_t\) generati dall’input e calcolo via parallel scan.
Gating moltiplicativo: l’uscita dell’SSM viene moltiplicata elemento per elemento dal ramo parallelo passato per SiLU, \(\mathbf{y} \odot \mathrm{SiLU}(\mathbf{z})\). È il gate che regola, canale per canale, quanto dell’uscita ricorrente lasciar passare.
Proiezione in uscita: una proiezione lineare riporta il risultato alla dimensione del modello.
Il blocco è avvolto da una normalizzazione (LayerNorm o RMSNorm) e da una connessione residua, come in un Transformer, e si impila sempre lo stesso, senza alternare attenzione e feed-forward. Quasi tutti i parametri stanno nelle proiezioni, \(3ED^2\) per blocco (\(2ED^2\) in ingresso, \(ED^2\) in uscita), e due blocchi Mamba pareggiano i \(12D^2\) di uno strato di Transformer con attenzione e MLP [GD24].
Cosa ottiene Mamba#
Messi insieme i pezzi, la scelta di che cosa ricordare, il modo di farla in fretta sulla scheda grafica e il blocco che li ospita, che cosa se ne ricava?
Due cose, soprattutto. La prima è il costo lineare: testo doppio, lavoro doppio. Nella generazione parola per parola il vantaggio si sente, perché a ogni parola nuova il modello non deve rileggersi tutto quello che ha scritto finora: gli basta il suo riassunto, che è sempre della stessa misura.
La seconda è la portata, ed è il punto in cui conviene essere precisi su dove è stata misurata. Le sequenze da un milione di passi su cui Mamba continua a migliorare non sono testo, ma suono grezzo (dove un passo è un campione sonoro: in un secondo di registrazione ce ne stanno circa sedicimila, quindi un milione di campioni è poco più di un minuto) e sequenze di DNA (dove un passo è una lettera del genoma). Sul linguaggio i contesti provati nell’articolo restano molto più corti, dell’ordine delle migliaia di parole. Che la stessa ricetta funzioni su tre materiali così diversi è comunque il segno che il meccanismo non ha niente di specificamente linguistico.
Gli autori, poi, hanno misurato quale dei gesti del buttafuori pesi di più. Il tempo dedicato a ciascuno, da solo, vale più di ognuno degli altri due preso da solo, e tutti e tre insieme fanno meglio ancora. E una testa più capiente serve solo a chi sceglie: data a un tornello, non cambia niente.
Il bilancio, sui meccanismi:
Tempo lineare nella lunghezza della sequenza, contro il tempo quadratico dell’attenzione piena.
Inferenza a memoria costante: lo stato ricorrente sostituisce la cache chiave-valore, che in un Transformer cresce con il contesto e va riletta a ogni token generato. È da qui che viene il vantaggio di throughput in generazione.
Scaling verificato fino a sequenze dell’ordine di \(10^6\) passi, cioè su ordini di grandezza dove l’attenzione piena non è praticabile. Le misure a quella lunghezza sono su audio grezzo e genomica; sul linguaggio i contesti dell’articolo restano di qualche migliaio di token.
Quali parametri contano: se è selettivo il solo \(\Delta\) la perplessità passa da 10,93 a 9,81, con il solo \(\mathbf{B}\) a 10,15, con il solo \(\mathbf{C}\) a 9,98, e con i tre insieme a 8,71 (tabella 7 del paper).
Perché uno stato grande conviene solo con la selezione: portare \(N\) da 1 a 16 migliora la perplessità di circa un punto (da 9,73 a 8,71) con poco più dell’1% di parametri in più, ma solo se \(\mathbf{B}\) e \(\mathbf{C}\) sono selettivi; con \(\mathbf{B}\) e \(\mathbf{C}\) costanti resta ferma intorno a 9,8 (tabella 10). È l’argomento che rende interessante lo stato molto più grande di Mamba-2.
Il meccanismo non è specifico del testo: gli stessi blocchi si addestrano su audio e su DNA. Il DNA è una sequenza di simboli discreti (le quattro basi), senza un lessico di parole e con dipendenze lunghissime; l’audio è un segnale continuo campionato, nel paper a sedicimila valori al secondo.
Restano due limiti. Lo scan selettivo non usa i tensor core della GPU, le unità fatte per le moltiplicazioni di matrici, dove sta quasi tutta la sua potenza. E lo stato di dimensione fissa, che è la forza di Mamba in efficienza, resta il suo limite quando serve ritrovare un dettaglio preciso in un contesto molto lungo. Il primo lo scioglie Mamba-2, che riscrive lo scan come una moltiplicazione di matrici; il secondo lo allenta soltanto, perché con i tensor core uno stato più grande costa poco, ma nessuno stato di taglia fissa lo toglie, come dice Panorama e limiti. Riscrivendo lo scan, Mamba-2 trova anche una parentela precisa con l’attenzione: un SSM a transizione scalare calcola la stessa funzione di un’attenzione lineare mascherata, e su quel gradino le due famiglie si incontrano.
Da ricordare
S4 tratta ogni parola con la stessa regola: è un tornello. Ha memoria lunga, ma non sa scegliere. Mamba [GD24] mette al suo posto un buttafuori, che guarda in faccia chi passa e decide sul momento quanto scriverne nel riassunto e quanto lasciar cadere. È questa la selettività.
Si paga un prezzo: se la regola cambia a ogni parola, non esiste più un filtro unico, e il modo «tutto insieme» di fare i conti se ne va. La ricorrenza resta, e va resa parallela in un altro modo.
Il prezzo si recupera con lo scan: due passi si fondono in un passo dello stesso tipo, e la catena si svolge a gruppi invece che in fila (a coppie, poi a quattro, poi a otto). Di operazioni se ne fanno di più, ma i turni di attesa crollano. In più Mamba tiene i conti nella memoria piccola e vicina della scheda grafica, come il contabile che non scende in cantina a ogni riga, e i risultati intermedi che gli serviranno dopo li rifà invece di conservarli.
Il blocco Mamba è un’unica stazione, ripetuta decine di volte: il pezzo si sdoppia, una copia passa per la lavorazione lunga (uno sguardo ai pezzi appena passati, mai a quelli che devono ancora arrivare; un ammorbidimento; il cuore selettivo), l’altra fa da cancello, e alla fine le due si moltiplicano. Niente attenzione, nessun altro tipo di stazione.
Cosa se ne ricava: il lavoro cresce di pari passo con la lunghezza (testo doppio, lavoro doppio, non quadruplo), la memoria durante la generazione non cresce mai, e si reggono sequenze dell’ordine del milione di passi, misurate però fuori dal linguaggio (un minuto di suono grezzo, un tratto di genoma). Restano due limiti: lo scan non usa le parti più veloci della scheda grafica (lo risolverà Mamba-2), e una memoria di taglia fissa fatica a ricordare parola per parola (Mamba-2 lo allenta soltanto).
Da ricordare
S4 è tempo-invariante (LTI): stessi parametri a ogni passo, quindi un kernel di convoluzione fisso, ma nessuna capacità di scegliere in base al contenuto. Mamba [GD24] rende l’SSM selettivo (S6).
Nella selettività \(\mathbf{B}_t, \mathbf{C}_t, \Delta_t\) diventano funzione dell’input; \(\mathbf{A}\) resta fissa, ma poiché \(\bar{\mathbf{A}}_t = \exp(\Delta_t \mathbf{A})\) e \(\Delta_t\) dipende da \(\mathbf{x}_t\), anche la transizione è di fatto data-dipendente. Si rompe l’invarianza temporale: niente più convoluzione, serve uno scan.
Il guadagno è il ragionamento basato sul contenuto (selective copying, induction heads) che un SSM LTI non sa fare: sul selective copying il nucleo S4 si ferma al 18%, quello selettivo arriva al 97%. Nel caso scalare la ricorrenza selettiva è una cella a cancello (Teorema 1 del paper): è lo stesso salto dei gate data-dipendenti delle attenzioni lineari, raggiunto dal versante dei sistemi dinamici.
Comporre due passi della ricorrenza dà un passo dello stesso tipo (la famiglia è chiusa) e la composizione è associativa: da qui il parallel scan, con profondità \(O(\log L)\) e lavoro \(O(L)\) nella versione di Blelloch (\(O(L\log L)\) in quella a raddoppio), su unità generiche e non sui tensor core. Le ottimizzazioni hardware-aware (kernel fusion in SRAM e ricomputazione nel backward) evitano di materializzare lo stato espanso in HBM.
Il blocco Mamba fonde il blocco H3 [FDS+23] con un gated MLP (\(E=2\)): proiezione in ingresso → Conv1d causale → SiLU → SSM selettivo → gating moltiplicativo con ramo parallelo (SiLU) → proiezione in uscita, con normalizzazione e residui. Un solo tipo di blocco, senza attenzione né MLP a parte.
Cosa ottiene: tempo lineare nella lunghezza, inferenza a memoria costante (nessuna KV cache che cresce), scaling verificato fino a \(\sim 10^6\) passi su audio grezzo e genomica (sul linguaggio, contesti molto più corti), e lo stesso impianto valido per tutte e tre le modalità. Resta aperto quello che Mamba-2 affronterà: lo scan non usa i tensor core, e lo stato fisso limita il richiamo esatto.