


Tendenze e limiti#
Prevedere l’evoluzione dei Transformer è rischioso, perché in questo campo le previsioni invecchiano in pochi mesi. È più utile descrivere le direzioni di lavoro visibili oggi e i problemi aperti che le motivano. Il paradosso è che l’architettura funziona su una gamma larghissima di compiti, dal testo alle immagini al suono, e che farla funzionare costa sempre di più, in calcolo e in memoria, man mano che cresce.
Dove punta la ricerca#
I cantieri aperti sono questi. Fare di più con meno: i grandi modelli consumano molto calcolo e molta memoria, e buona parte della ricerca punta a ridurli, fino a farli stare in un telefono invece che in un centro di calcolo. Unire i sensi: modelli che leggono, guardano e ascoltano insieme, come l’assistente a cui mostri una foto e fai una domanda a voce. Superare i limiti dell’architettura stessa: nell’attenzione piena ogni token si confronta con ogni altro, e su una sequenza di \(n\) token il costo cresce come \(n^2\), quindi raddoppiando la lunghezza i confronti quadruplicano; questo spinge a cercare modi più economici di far comunicare le parti di un testo. Accanto a questi, due filoni li attraversano tutti: il post-training, che è diventato una fase standard dell’addestramento, e il calcolo che si adatta alla difficoltà della domanda, a cui è dedicata la sezione sul pensare più a lungo.
Fra i modi di fare di più con meno c’è la distillazione [HVD15], che invece di alleggerire un modello ne addestra uno nuovo, piccolo: l’allievo impara a riprodurre l’intera distribuzione di probabilità di un maestro grande, e non soltanto la risposta giusta, perché le probabilità piccole dicono quali alternative erano quasi ragionevoli (Fig. 16.27). Il meccanismo, con la temperatura che rende visibili le probabilità piccole, sta nella sezione sul modello piccolo che imita.

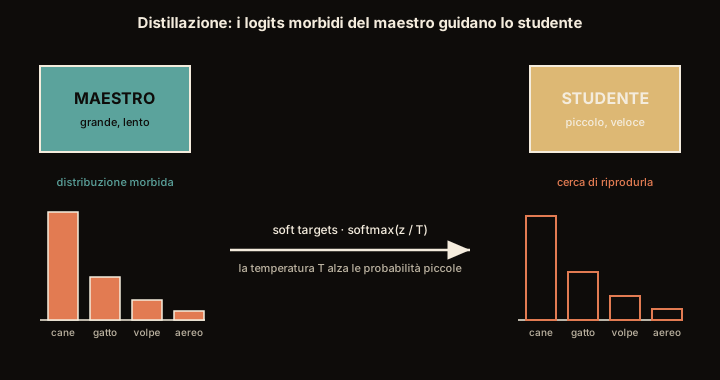
Fig. 16.27 Il maestro passa all’allievo l’intera distribuzione, e non la sola risposta: la risposta giusta dice soltanto qual è, la distribuzione dice anche quali errori erano quasi ragionevoli. La temperatura \(T\) del disegno è la manopola che rende visibili le probabilità piccole.#
Gli altri modi di rimpicciolire un modello sono due, e il capitolo sull’efficienza dedica a ciascuno una sezione: scrivere ogni numero con meno cifre, e togliere di mezzo i numeri che contano poco. Detti così sembrano gratis, e non lo sono. Là il prezzo è contato: arrotondare ogni numero a quattro bit, cioè a soli sedici valori possibili, senza altri accorgimenti, sposta di quasi un quinto quello che esce da uno strato, e una rete a cui si tolgono nove pesi su dieci smette di funzionare finché non la si riaddestra.
C’è poi una strada che non rimpicciolisce niente. Il modello resta grosso, ma per ogni parola ne accende un pezzo solo, come una redazione che manda l’articolo di sport a chi si occupa di sport invece di farlo rileggere a tutti quanti. Sa quello che sanno tutti i suoi redattori, e su ogni articolo spende quanto ne spende uno.
Sul contesto lungo la ricerca prova invece a far comunicare le parole senza convocarle tutte insieme, e le due strade più promettenti sono l’attenzione lineare e i modelli a spazio di stato, che hanno un capitolo ciascuna. Una terza, FlashAttention, non tocca il meccanismo e cambia il modo di eseguirlo, tenendo in memoria meno roba per volta. Sul fronte dei sensi si costruiscono mappe del significato condivise, dove una foto di gatto e la parola «gatto» cadono nello stesso punto. Ci si arriva mostrando al modello milioni di immagini con la didascalia che le accompagna, e chiedendogli di tenere vicine le coppie giuste e lontane quelle sbagliate. E c’è un cantiere in più, che dieci anni fa stava ai margini delle ricerche sui modelli di linguaggio: renderli utili e non dannosi, cioè il post-training, che nel frattempo è diventato una fase standard dell’addestramento.
Sul fronte dell’efficienza: la distillazione, la quantizzazione (pesi a 8 o 4 bit invece che a 32, dove a quattro bit la perdita smette di essere trascurabile e servono metodi che facciano più che arrotondare), la potatura, e le architetture mixture of experts, che attivano solo una frazione dei parametri per ogni token. Sul fronte del contesto lungo: le attenzioni sparse e lineari, le ottimizzazioni di memoria come FlashAttention, e gli state space model (Mamba); a questi ultimi, e alle attenzioni lineari, sono dedicati i due capitoli che seguono. Sul fronte multimodale: spazi di rappresentazione condivisi tra testo, immagini e audio, con l’addestramento contrastivo su coppie immagine-didascalia sul modello di CLIP come collante, che la sezione su un solo spazio per immagini e parole costruisce per esteso. A cui si aggiunge l’allineamento, di cui parla il post-training.
Pensare più a lungo sulle cose difficili#
Un Transformer standard spende lo stesso calcolo su ogni token, facile o difficile che sia: sessanta strati, sessanta passaggi. Togliere quel vincolo è un’idea del 2018 che per anni non ha preso piede, ed è tornata da una strada diversa.
Sessanta piani, e l’ascensore ferma a tutti. La domanda sale in un vassoio, un bigliettino per parola, a ogni piano qualcuno ci mette mano, e dal tetto esce la risposta. «Quanto fa due più due» fa il viaggio intero, e un rompicapo da dieci mosse pure. Noi no: sulle cose facili rispondiamo di getto, sulle difficili ci fermiamo a pensare.
Nel 2018 Mostafa Dehghani e colleghi provarono a rifare il palazzo, e lo chiamarono Universal Transformer. Le sessanta stanze sono tutte diverse, e un paio in più non si aggiungono: quel numero è murato. E se la stanza fosse una sola, e ci si rientrasse? I giri li deciderebbe la domanda: due per «due più due», venti per il rompicapo. A ogni giro un bigliettino può dire «io ho finito», e resta lì com’è mentre gli altri continuano.
Nei muri della stanza non è scritto nessun massimo: il numero di giri lo decide la domanda e non l’edificio. Per questo la stanza sola promette di reggere anche compiti più lunghi di tutti quelli visti in addestramento, quelli che chiedono più passaggi di lavoro di quanti piani abbia il palazzo.
Manca un pezzo. Un bigliettino che può fermarsi non ha motivo di farlo, girare è gratis e un giro in più non fa danno. Perciò all’ingresso si paga un pedaggio, piccolo, a ogni giro: si paga finché la domanda lo merita, poi si smette.
Sulla porta c’è una promessa più grossa: con questa stanza si può calcolare tutto quello che un computer saprebbe calcolare, dati tempo e carta a volontà. È vera, e sotto ha una riga che quasi nessuno legge: giri quanti ne servono, senza tetto. A quella condizione mantiene la stessa promessa anche il palazzo di sessanta piani, se la risposta che esce dal tetto la si rimette al pianterreno quante volte si vuole (è quello che fa un modello che scrive una parola alla volta) e se i conti si fanno senza mai arrotondare. Con i conti arrotondati, come sono quelli veri, il palazzo che risponde al primo passaggio sa fare poco; ogni giro in più gli fa guadagnare un po’ di potenza, e con abbastanza giri arriva a tutto quello che si risolve in un tempo ragionevole. A decidere è quanti giri si concedono, più della forma dell’edificio.
La stanza sola non prese piede: farci sessanta giri costa le stesse ore di sessanta stanze, perché il lavoro è lo stesso, ma i mobili da scegliere sono quelli di una stanza sola, e con la stessa spesa si impara meno. Intanto tirare su palazzi più alti funzionava benissimo.
È tornata da una strada inattesa. Anche i modelli che «ragionano» prima di rispondere spendono di più sulle domande difficili, solo che invece di girare in silenzio a porta chiusa scrivono i passaggi su un foglio, una riga alla volta. Ogni riga va prodotta e poi riletta, quindi costa; in compenso si insegna meglio, perché di quaderni con i passaggi svolti ne esistono a montagne. E dal 2024 è tornata anche la porta chiusa: c’è chi addestra i modelli a fare i loro giri in silenzio, senza scrivere niente. Quale strada convenga resta aperto: la porta chiusa non riempie fogli, il foglio lascia una traccia da leggere. Che la traccia racconti quello che è successo davvero nella stanza, però, non è detto, e quando lo si è misurato spesso non lo racconta.
L’Universal Transformer [DGV+19] (l’articolo è del luglio 2018, presentato a ICLR l’anno successivo, che è la data della voce in bibliografia) sostituisce gli \(n_{\text{strati}}\) strati distinti con un solo blocco applicato ricorrentemente in profondità, cioè con i pesi legati fra le iterazioni. La motivazione dichiarata è recuperare il bias induttivo ricorrente che il Transformer aveva abbandonato insieme alla ricorrenza temporale, e che serve sui compiti a struttura gerarchica e sulla generalizzazione a lunghezze non viste in addestramento.
A questo aggiungono l’Adaptive Computation Time di Graves [Gra16]: a ogni iterazione, per ogni posizione, una piccola unità emette una probabilità di arresto; le posizioni che si fermano vengono copiate invariate mentre le altre continuano a essere aggiornate, e una penalità sul numero di passi (il ponder cost) impedisce di pensare all’infinito. Il calcolo diventa così condizionato all’ingresso invece che fissato dall’architettura.
C’è un punto che il titolo lascia intuire, e va detto con precisione, insieme a quanto sia solido. Gli autori dimostrano che legare i pesi e iterare rende il modello Turing-completo, ma la loro stessa formulazione lo dice sotto certe ipotesi, e l’ipotesi cruciale è la solita: un numero di passi non limitato a priori. Il ragionamento è che un Transformer standard esegue un numero di passi sequenziali fissato dall’architettura, mentre una ricorrenza in profondità lo fa dipendere dai dati.
Sarebbe però scorretto presentare la Turing-incompletezza del Transformer standard come un fatto assodato, perché la letteratura contiene anche il risultato opposto: Pérez, Barceló e Marinković [PerezBarceloM21] dimostrano che il Transformer encoder-decoder è Turing-completo, con precisione aritmetica arbitraria e un numero illimitato di passi di decodifica. E quell’ultima ipotesi è esattamente la generazione autoregressiva, cioè la strada che percorrono oggi i modelli lasciati scrivere finché serve. Le due prove non si contraddicono, cambiano le ipotesi; ma la morale da trarre è che «quanti passi può fare» conta più di «come sono legati i pesi», e che una frase secca sull’espressività di un’architettura, senza le sue ipotesi accanto, è quasi sempre una frase sbagliata.
La teoria successiva dà a quella morale una forma quantitativa. Con una precisione aritmetica finita un Transformer di profondità costante è molto più debole: con una precisione logaritmica nel numero di token si simula con circuiti a soglia di profondità costante, la classe \(\mathsf{TC}^0\), e se \(\mathsf{L} \neq \mathsf{P}\) non sa nemmeno risolvere con esattezza equazioni lineari [MS23]. La catena di pensiero allarga l’espressività in proporzione ai passi: con \(T\) passi, un Transformer di profondità costante, precisione costante e dimensione d’embedding \(O(\log n)\) risolve ogni problema calcolabile da circuiti booleani di dimensione \(T\) [LLZM24], e con un numero polinomiale di passi di decodifica, sotto una lieve generalizzazione della pre-normalizzazione, riconosce esattamente i problemi risolvibili in tempo polinomiale [MS24]. Il calcolo al momento della risposta acquista espressività, e la paga a tanti token quanti passi.
L’idea del calcolo condizionato è rimasta a lungo ai margini, ed è tornata da più parti. Dal lato dei token, i modelli «ragionanti» della sezione sul post-training (o1, settembre 2024; DeepSeek-R1, gennaio 2025) allocano più calcolo in inferenza generando una catena di passi intermedi, e di solito ne generano di più sui problemi difficili. Dal lato latente, Coconut [HSS+25] (dicembre 2024) rimette in ingresso l’ultimo stato nascosto invece di decodificarlo in una parola, e il modello a profondità ricorrente di Geiping e colleghi [GMJ+25] (febbraio 2025), da 3,5 miliardi di parametri, itera un blocco al momento dell’inferenza senza dati speciali di catene. E dentro i Transformer è tornato anche per un’altra via: Mixture-of-Depths [RRR+24] (aprile 2024) decide con un top-\(k\) per strato, come il router della sezione sui modelli a esperti, quali token lo attraversino, così che la spesa totale resti fissata e quella per token no. Fra la via latente e quella in token il compromesso è diverso e non risolto: il calcolo latente non produce token da scrivere e rileggere, e le iterazioni possono condividere la KV cache, ma non è ispezionabile; quello in token costa di più, si addestra con la supervisione esistente e lascia una traccia che si può leggere, il che nel capitolo sull’interpretabilità è tutt’altro che un dettaglio.
Che la traccia sia poi una descrizione fedele del calcolo svolto è una domanda a sé, e le misure dicono: non necessariamente. Le spiegazioni a catena di pensiero possono travisare la ragione vera di una previsione, fino a far scendere l’accuratezza del 36% quando il prompt contiene un indizio fuorviante che la catena non nomina [TMPB23]; quanto il modello si appoggi alla catena varia molto con il compito, e i modelli più grandi tendono a produrne di meno fedeli [LCR+23]; e nei modelli che ragionano, nel 2025, gli indizi usati compaiono nella catena spesso in meno del 20% dei casi [CBR+25].
I limiti che restano#
Accanto agli entusiasmi va tenuto il conto dei limiti, e i limiti si tengono l’un l’altro. Il primo è il costo: addestramento e inferenza dei modelli maggiori richiedono risorse (economiche, energetiche, di hardware) concentrate in poche aziende, e la ricerca indipendente lavora per necessità su scala ridotta.
Quel costo cresce con i dati, e i dati sono il secondo limite. Le grandi raccolte di testo prese dal web (i corpora) potrebbero esaurirsi come fonte di materiale di qualità: secondo una stima del 2022, rivista nel 2024, se le tendenze restano quelle i modelli saranno addestrati su raccolte grandi quanto tutto il testo umano pubblico, fra il 2026 e il 2032, e le vie d’uscita indicate sono i dati sintetici e un uso più efficiente dei dati [VHS+24]. E i corpora portano con sé le distorsioni sistematiche di ciò che è stato scritto online, i bias, che i modelli assorbono insieme al resto.
Da quei dati il modello impara a stimare la probabilità di un testo, e qui sta il terzo limite, l’affidabilità. Le allucinazioni (risposte fluenti ma false) hanno una causa nell’obiettivo stesso: il pre-addestramento premia la verosimiglianza, e un’affermazione falsa e fluente non si distingue da un fatto se i dati non offrono un modo di farlo. Probabile non vuol dire vero. La valutazione fa il resto, perché la maggior parte dei benchmark dà zero punti a un «non lo so» e premia così chi tira a indovinare [KNVZ25]. Mitigarle (con il recupero di fonti esterne, la verifica, la calibrazione, cioè l’accordo fra la sicurezza che il modello dichiara e quanto spesso ha ragione) è un problema aperto.
E resta aperta la domanda più grande, su che cosa i modelli capiscano davvero: il dibattito scientifico è tutt’altro che chiuso, e attribuire loro intenzioni o ragionamento senza prove è un errore. Prudenza, qui, è il modo in cui si tratta un’affermazione che non si sa ancora come verificare.
Niente di nuovo, tutto in un ordine nuovo#
Ogni pezzo del Transformer viene da prima: l’attenzione con le sue query, key e value, la codifica posizionale, la rete feed-forward, gli embedding, la discesa del gradiente che sistema i parametri un passo alla volta. Su larga scala quei pezzi hanno chiesto il resto, dalla KV cache alla mixture of experts, dal post-training al retrieval, e i salti sono venuti più dal modo in cui si combinano, e da quanto calcolo e quanti dati si sono potuti spendere, che da pezzi nuovi. Chi conosce i pezzi riconosce le novità per quello che sono: combinazioni nuove di idee note.
Da ricordare
La ricerca punta su efficienza (la distillazione, cioè l’apprendista che impara dal maestro; la quantizzazione, cioè scrivere ogni numero con meno cifre per farlo stare in un telefono; e i modelli che tengono acceso solo un pezzo di sé per ogni parola), contesto lungo (modi più economici di far parlare fra loro le parti di un testo, fino ai modelli a spazio di stato) e multimodalità (leggere, guardare e ascoltare con lo stesso meccanismo).
Un Transformer standard spende lo stesso calcolo su ogni ingresso, facile o difficile che sia. Nel 2018 si provò a togliere quel vincolo con un piano solo riapplicato più volte, lasciando a ogni parola il diritto di dire «io ho finito» e fermarsi. Allora non prese piede, e l’idea è tornata attuale dalla parte opposta: i modelli che ragionano spendono più calcolo sulle difficili scrivendo i passi invece di girare in silenzio. La prima strada non riempie fogli, la seconda lascia una traccia da leggere, che però spesso non racconta quello che è successo davvero.
I limiti sono strutturali: costi concentrati, dati di qualità che potrebbero finire, bias dei dati, e il fatto che un modello addestrato a stimare il probabile non ha, di per sé, un modo di distinguere il probabile dal vero. Su che cosa questi modelli «capiscano» davvero il dibattito è tutt’altro che chiuso.
Tutti gli ingredienti dei Transformer vengono dai capitoli precedenti: ciò che è nuovo è la composizione, non i mattoni.
Da ricordare
Le direzioni di frontiera: efficienza (distillazione, quantizzazione a 8 o 4 bit, pruning, architetture mixture-of-experts che attivano solo una frazione dei parametri per token), contesto lungo (attenzioni sparse e lineari, ottimizzazioni di memoria come FlashAttention, state space model) e multimodalità (spazi di rappresentazione condivisi fra testo, immagini e audio). A cui si aggiunge l’allineamento (RLHF, DPO).
Il calcolo condizionato all’ingresso: l’Universal Transformer [DGV+19] lega i pesi fra le iterazioni, e sopra ci mette l’Adaptive Computation Time [Gra16], che a ogni giro dà a ogni posizione una probabilità di arresto. La Turing-completezza che ne segue vale sotto ipotesi, e quella che pesa è il numero di passi non limitato a priori.
Lo stesso filone è tornato da due parti: i modelli che ragionano allungano la generazione e scrivono i passi, e la teoria lega l’espressività al numero di passi [MS24]; il ragionamento latente [HSS+25] itera in silenzio. Si paga in token prodotti, si guadagna una traccia leggibile, che però non è necessariamente fedele al calcolo svolto [TMPB23].
Limiti aperti: il costo quadratico \(O(n^2)\) dell’attenzione piena e la KV cache, che cresce linearmente con i token generati; costi concentrati, dati che potrebbero esaurirsi e bias dei dati; e lo scarto fra massimizzare la verosimiglianza di una continuazione e stabilire che sia vera, che la valutazione aggrava premiando chi tira a indovinare [KNVZ25].
Resta aperto il conto del cantiere sui limiti dell’architettura: l’attenzione si paga con il quadrato della lunghezza del testo, e durante la generazione con una KV cache, il taccuino delle chiavi e dei valori, che non smette di crescere. Il capitolo sull’attenzione lineare riapre quel conto da un pezzo che fin qui si è sempre dato per fisso: la softmax, che spartisce l’attenzione fra le parole.