


Un solo spazio per le immagini e le parole#
Le mille categorie di ImageNet, il dataset su cui si è addestrata mezza storia della visione artificiale, contengono circa centoventi razze di cane e nessuna classe «persona» (ci sono uno «sposo», un «giocatore di baseball» e un «sommozzatore», ma l’essere umano in quanto tale non è una categoria). Quell’assenza è la conseguenza di come nasce un classificatore: qualcuno decide una lista, qualcun altro etichetta milioni di immagini secondo quella lista, e il modello impara a rispondere sempre alla stessa domanda, quale delle mille. Fuori da quell’elenco non esiste niente. Un tram non esiste, una radiografia non esiste, e «un gatto nero che salta sul muro» non esiste nemmeno come domanda: è una frase, non una classe.
La via d’uscita standard è il transfer learning, costruito nella sezione sulla classificazione: si prende una rete pre-addestrata, si toglie la testa (l’ultimo strato, quello che sceglie fra le classi), se ne monta una nuova con tante uscite quante sono le proprie classi e la si addestra su esempi etichettati a mano. Funziona, e resta il modo normale di costruire un classificatore quando le classi sono poche e stabili. Ma il conto si paga ogni volta che l’elenco cambia: una classe in più vuole immagini nuove, etichette nuove, un addestramento nuovo e un modello nuovo da mettere in servizio. Quello che il sistema sa dire viene deciso una volta per tutte, prima di partire.
La domanda, allora, è se si possa costruire un modello a cui le classi si dicano a parole, nel momento in cui servono. La risposta comincia da un cambio di domanda.
Non «che cosa è», ma «quale di queste»#
Lo strumento è lo spazio degli embedding già incontrato per le parole, la mappa del significato in cui gatto finisce vicino a felino e la vicinanza si misura con la similarità del coseno, un numero fra \(-1\) e \(+1\): più è alto, più i due vettori puntano nella stessa direzione. Qui lo spazio deve contenere anche le fotografie, non soltanto le parole: la foto di un gatto nero su un muro deve avere con la frase «un gatto nero su un muro» un coseno più alto che con «una scodella di minestra». Non serve che i due vettori coincidano, e la distanza che resta fra le foto e le frasi è il modality gap del paragrafo «Un solo spazio, due quartieri».
L’idea, resa celebre da CLIP [RKH+21] nel 2021, è di addestrare due reti separate, un encoder di immagini e un encoder di testo, a portare le loro uscite nello stesso spazio vettoriale; l’articolo stesso indica come antenati della sua perdita la multi-class N-pair loss di Sohn, la InfoNCE e ConVIRT, che l’aveva già adattata a radiografie e referti medici. Il compito diventa l’appaiamento: dato un batch di \(B\) immagini e le loro \(B\) didascalie in ordine mescolato, il modello deve ritrovare per ciascuna immagine la didascalia che le appartiene.

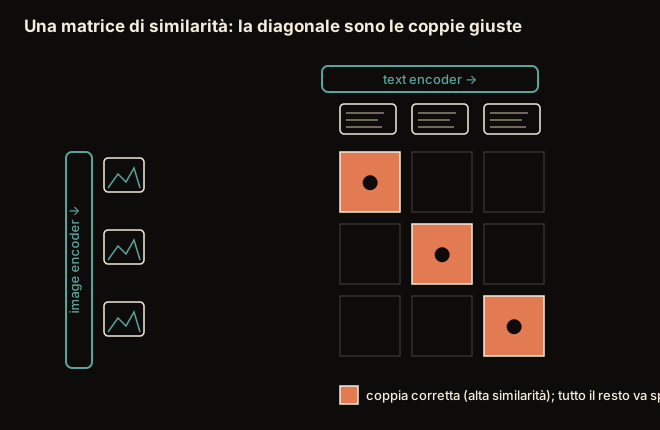
Fig. 19.2 La matrice è il compito. Ogni riga porta con sé una risposta giusta e tante sbagliate, e sono queste ultime, gratuite e numerose, a fare il grosso del lavoro.#
Su un tavolo ci sono quattro fotografie e, in disordine, quattro didascalie ritagliate dal giornale. Nessuno ti dice che cosa raffigurano le foto: ti si chiede solo di appaiarle. Il gioco sembra più povero di «riconosci il soggetto», e invece chiede la stessa cosa per vie traverse, perché per appaiare bene devi comunque aver capito che nella prima foto c’è un gatto su un muro e che quella didascalia parla di un gatto su un muro.
Il vantaggio è che questo gioco non ha bisogno di nessuno che prepari le risposte. Le didascalie esistono già: ogni immagine pubblicata sul web arriva con del testo attaccato, la frase sotto la foto, la descrizione alternativa che serve a chi non vede, il titolo del prodotto in un catalogo. Sono coppie già appaiate, gratis, a milioni: per addestrare CLIP ne sono state raccolte quattrocento milioni. Nessuno le ha etichettate, e nessuno ha deciso un elenco di classi da riconoscere: per raccoglierle gli autori hanno cercato sul web le coppie in cui compariva una fra mezzo milione di parole e frasi diverse, tenendone al più ventimila per ciascuna, perché non ci fossero mille gatti per ogni tram. È supervisione, ma naturale: viene dal fatto che gli esseri umani, quando pubblicano un’immagine, ci scrivono accanto che cosa c’è.
Formalmente si apprendono due funzioni, \(f_{\text{img}}\) e \(f_{\text{txt}}\), che portano rispettivamente un’immagine e una sequenza di token in un unico spazio di rappresentazione \(\mathbb{R}^d\) (in CLIP, tramite una proiezione lineare posta in cima a ciascun encoder). L’encoder visivo è una CNN o un Vision Transformer [DBK+21]; quello testuale è un Transformer con maschera causale, da cui si preleva la rappresentazione dell’ultimo token. Le uscite vengono normalizzate,
dove \(\tilde{\mathbf{I}}_i\) è l’immagine \(i\)-esima del batch (il tensore grezzo, quello che l’overview chiamava \(\mathbf{I}\)), \(\tilde{\mathbf{T}}_j\) la sequenza di token della didascalia \(j\)-esima e \(\mathbf{I}_i, \mathbf{T}_j \in \mathbb{R}^d\) i due embedding. La notazione \(\mathbf{I}_i\), \(\mathbf{T}_j\) è quella della Figura 1 del lavoro su CLIP, dove indicano gli embedding normalizzati e non i dati grezzi (lo pseudocodice della Figura 3 li chiama invece \(I_e\) e \(T_e\), e riserva \(I\) e \(T\) ai dati): qui \(\mathbf{I}_i\) è un vettore, non un reticolo di pixel. È una deroga dichiarata alla convenzione del libro, che riserva il maiuscolo grassetto alle matrici: il maiuscolo qui viene dal paper, e a fare il lavoro resta il grassetto, che dice che l’oggetto ha più di una componente. Il \(T\) tondo che si incontra altrove nel capitolo (il numero di token di un prompt) è invece un conteggio. I due embedding vivono così sulla sfera unitaria: il loro prodotto scalare \(\langle \mathbf{I}_i, \mathbf{T}_j \rangle\) è esattamente il coseno dell’angolo fra i due, un numero in \([-1, 1]\).
Il compito di pretesto è una classificazione a \(B\) vie definita dal batch stesso: data l’immagine \(i\), indovinare quale delle \(B\) didascalie presenti sia la sua. Non c’è alcuna ontologia fissata a priori, e il «vocabolario» delle descrizioni è aperto quanto la lingua. Il lavoro originale chiama questo tipo di apprendimento supervisione dal linguaggio naturale (natural language supervision), e nota che la letteratura lo descrive di volta in volta come non supervisionato, auto-supervisionato, debolmente supervisionato o supervisionato: l’etichetta è la didascalia che accompagna l’immagine. La perdita è di famiglia contrastiva, quella che la sezione su JEPA metterà accanto alla generativa e alla predittiva nello spazio latente: si impara una geometria, avvicinando ciò che va insieme e allontanando ciò che non va insieme.
La matrice di Fig. 19.2 mostra perché conti la dimensione del batch \(B\). Ogni riga ha una coppia giusta, il positivo, e \(B - 1\) sbagliate, i negativi, cioè gli abbinamenti che il caso ha messo insieme nello stesso batch. Passando da \(B\) a \(2B\) i negativi diventano \(2B - 1\), e riconoscere il positivo si fa più difficile. Quanto costi un \(B\) grande lo dice il paragrafo «La temperatura e il batch»: è il vincolo da cui nascerà SigLIP.

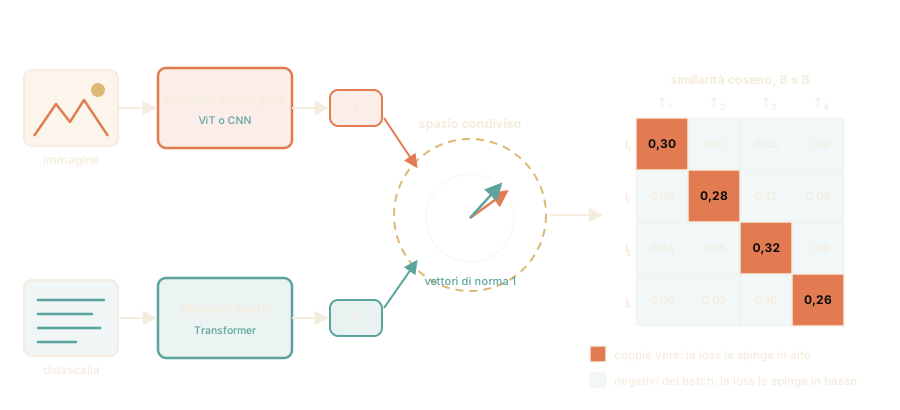
Fig. 19.3 Due encoder, una mappa sola. Le somiglianze di un gruppo di \(B\) coppie formano una tabella \(B \times B\): sulla diagonale gli abbinamenti giusti, in tutte le altre caselle quelli sbagliati. Il disegno a sinistra è uno schema: quanto le due frecce siano davvero vicine lo misureremo più avanti, ed è meno di quel che sembra.#
La Fig. 19.3 mostra la struttura che ne esce: il bi-encoder (detto anche dual encoder, o a due torri) già incontrato nella ricerca per rispondere. Le due reti non si scambiano niente durante il calcolo e si incontrano solo alla fine, nel prodotto scalare fra i due embedding, la somma dei prodotti delle loro componenti, che per vettori di lunghezza uno coincide con il coseno dell’angolo fra loro.
L’esame si fa in due sensi#
La loss deve alzare i numeri sulla diagonale e abbassare tutti gli altri. Si ottiene con la cross-entropy, cioè meno il logaritmo della probabilità che il modello assegna alla risposta giusta: le probabilità di una riga si ricavano dalle sue somiglianze con la softmax, la stessa che nell’attenzione trasforma i punteggi in pesi, e la classificazione a risposta multipla la definisce il batch stesso, con le \(B\) didascalie presenti nel ruolo delle classi.
Guarda la griglia della figura una riga alla volta. La prima riga è un’interrogazione a risposta multipla: «ecco l’immagine numero uno, quale delle quattro didascalie è la sua?». Il modello risponde con quattro numeri, e la risposta giusta è sempre la prima cella, quella sulla diagonale. Il costo misura quanto la risposta giusta è stata considerata probabile: se il modello le dà il 90% di fiducia paga pochissimo, se le dà il 25% (come tirando a caso fra quattro) paga parecchio.
I quattro numeri della riga partono come somiglianze fra \(-1\) e \(+1\) e diventano percentuali di fiducia che insieme fanno cento con la stessa ricetta che nell’attenzione decide quanto guardare ogni parola, la softmax. Siccome fanno cento, quello che manca alla didascalia giusta se l’è preso qualcun altro, e quasi sempre è la didascalia sbagliata che le somiglia di più. È su quella che il modello lavora, mentre le due che non c’entravano niente le lascia stare.
Poi si rifà lo stesso identico esame guardando le colonne: «ecco la didascalia numero uno, quale delle quattro immagini descrive?». Le due interrogazioni non sono la stessa cosa, perché una didascalia potrebbe essere la più adatta a una foto senza che quella foto sia la più adatta a lei. Si fanno entrambe e si fa la media: da qui l’aggettivo simmetrica che si attacca a questa loss.
La forma generale è la InfoNCE [vdOLV18], già incontrata per SimCLR nella sezione sull’imparare senza etichette e per gli embedding di frasi nella sezione sulla rappresentazione del testo; qui le lettere sono \(\mathbf{u}\) per l’ancora e \(\mathbf{v}^{+}\) per il positivo:
dove \(\mathbf{u}\) è l’ancora (\(\mathbf{z}_i\) in SimCLR, \(\mathbf{a}\) negli embedding di frasi), \(\mathbf{v}^{+}\) il suo positivo, \(\mathbf{v}_1, \dots, \mathbf{v}_B\) l’insieme dei candidati (il positivo più \(B-1\) negativi), \(s(\cdot, \cdot)\) una misura di compatibilità e \(\tau > 0\) la temperatura. È, letteralmente, una cross-entropy su un problema di classificazione a \(B\) vie in cui la classe corretta è «il positivo». (Nel testo originale la compatibilità è una funzione di punteggio qualsiasi; la \(\tau\) esplicita è della variante su similarità coseno, quella che CLIP adotta, e che qui useremo sempre.)
In CLIP l’ancora è un embedding di immagine, i candidati sono le \(B\) didascalie del batch e la compatibilità è il coseno. Per la direzione immagine → testo:
e simmetricamente, scorrendo la colonna \(i\) invece della riga \(i\), per la direzione testo → immagine:
La loss finale è la media delle due:
Qui \(B\) è la dimensione del batch (la lettera \(N\) è già impegnata a contare le tessere di un’immagine), \(\mathbf{I}_i\) e \(\mathbf{T}_j\) gli embedding normalizzati, \(\langle \mathbf{I}_i, \mathbf{T}_j \rangle\) la loro similarità coseno e \(\tau\) la temperatura. Si noti che il numeratore è lo stesso nelle due direzioni (la coppia vera \((i,i)\)) e a cambiare è solo l’insieme rispetto a cui si normalizza: le didascalie a parità di immagine, oppure le immagini a parità di didascalia. I gradienti alzano il coseno della diagonale e abbassano quelli fuori diagonale, con un’intensità che dipende da quanto ciascun negativo è già vicino: detto \(s_{ij} = \langle \mathbf{I}_i, \mathbf{T}_j \rangle\) e \(p_{ij}\) la probabilità che la softmax della riga \(i\) dà alla didascalia \(j\), vale \(\partial \ell^{\,\mathrm{I}\to\mathrm{T}}_i / \partial s_{ij} = (p_{ij} - \mathbb{1}_{[j = i]})/\tau\), come per SimCLR. È la proprietà, tipica della softmax, di occuparsi soprattutto dei concorrenti credibili.
Quattro coppie, fatte a mano#
Nella ricetta c’è un ingrediente in più, la temperatura \(\tau\): ogni somiglianza viene divisa per \(\tau\) prima della softmax, e quindi le differenze fra le somiglianze si amplificano tanto più quanto più \(\tau\) è piccola. Il suo effetto si vede solo con i numeri. Prendiamo un batch minuscolo, \(B = 4\): quattro immagini e le loro quattro didascalie. Nella tabella delle somiglianze le righe \(\mathbf{I}_1 \dots \mathbf{I}_4\) sono le quattro immagini, le colonne \(\mathbf{T}_1 \dots \mathbf{T}_4\) le quattro didascalie, e ogni cella dice quanto quell’immagine e quella didascalia si somigliano, su una scala che va da \(-1\) (agli antipodi) a \(+1\) (nello stesso punto esatto); in grassetto le quattro coppie vere. I valori sono plausibili per un modello a metà addestramento (le coppie vere intorno a \(0{,}3\), le altre fra \(0\) e \(0{,}15\)):
somiglianza |
\(\mathbf{T}_1\) |
\(\mathbf{T}_2\) |
\(\mathbf{T}_3\) |
\(\mathbf{T}_4\) |
|---|---|---|---|---|
\(\mathbf{I}_1\) |
0,30 |
0,10 |
0,05 |
0,02 |
\(\mathbf{I}_2\) |
0,08 |
0,28 |
0,12 |
0,04 |
\(\mathbf{I}_3\) |
0,04 |
0,15 |
0,32 |
0,09 |
\(\mathbf{I}_4\) |
0,06 |
0,03 |
0,10 |
0,26 |
Nella prima riga la coppia giusta somiglia \(0{,}30\), la migliore delle sbagliate \(0{,}10\). Differenze piccole, e il mestiere della temperatura è decidere quanto pesano. La temperatura amplifica le differenze fra i punteggi prima di trasformarli in percentuali di fiducia, e lo fa tanto più quanto più il suo numero è basso, perché è un divisore, e dividere per un numero piccolo ingrandisce.
Con la temperatura di partenza di CLIP, che è bassa (\(0{,}07\)), quel piccolo vantaggio viene ingigantito, e i passaggi si possono rifare con una calcolatrice: sono i tre passi della softmax. Primo: si divide ogni somiglianza per la temperatura, cioè per \(0{,}07\), che è come moltiplicarla per quattordici e rotti: la riga diventa \(4{,}29\), poi \(1{,}43\), \(0{,}71\) e \(0{,}29\). Secondo: quei numeri si trasformano in fiducia con l’esponenziale, il tasto \(e^x\), che gonfia i grandi molto più dei piccoli: \(4{,}29\) diventa \(73\), mentre \(1{,}43\) diventa appena \(4{,}2\) e gli altri due ancora meno. Terzo: si guarda che fetta è ciascuno del totale, che è poco più di \(80\): alla coppia giusta ne vanno \(73\), cioè il 91% della fiducia.
Il costo della riga si ricava da quella fetta con il logaritmo naturale (il tasto \(\ln\), che disfa quello che fa l’esponenziale), cambiato di segno perché venga un numero positivo: più alta è la fetta, più basso è il costo. Al 91% vale circa \(0{,}1\); se il modello tirasse a caso, dando il 25% a ciascuna delle quattro, varrebbe \(1{,}386\). Facendo la media sulle quattro righe, e poi anche sulle colonne, il costo complessivo è \(0{,}148\).
Ora portiamo la temperatura da \(0{,}07\) a \(0{,}5\), senza toccare una sola somiglianza. Alzarne il numero riduce l’amplificazione, che infatti quasi sparisce: alla coppia giusta va il 35% della fiducia e alle tre sbagliate poco meno, fra il 20 e il 24. Il costo sale a \(1{,}082\); per confronto, tirare a caso fra quattro didascalie costerebbe \(1{,}386\). Stessa tabella, stesso ordine corretto: con la temperatura alta si pagano quasi quattro quinti di quanto costerebbe tirare a caso, con quella bassa un decimo.
Con la temperatura di partenza di CLIP, \(\tau = 0{,}07\), le similarità coseno della prima riga diventano logit dividendo per \(\tau\): \(0{,}30/0{,}07 = 4{,}29\), poi \(1{,}43\), \(0{,}71\) e \(0{,}29\). Esponenziando si ottengono \(72{,}7\), \(4{,}17\), \(2{,}04\) e \(1{,}33\), la cui somma è \(80{,}2\); le probabilità sono quindi \(0{,}906\), \(0{,}052\), \(0{,}025\) e \(0{,}017\), e il costo della riga è \(-\log 0{,}906 = 0{,}099\) (i logaritmi qui sono naturali, come vuole la forma esponenziale della softmax). Ripetendo per le altre tre righe e mediando, la loss in direzione immagine → testo vale \(0{,}147\); quella sulle colonne \(0{,}148\); la loss simmetrica \(0{,}148\).
Ora rifacciamo il conto senza cambiare una sola similarità, solo alzando la temperatura a \(\tau = 0{,}5\). Dividendo per \(0{,}5\) ed esponenziando come prima, la prima riga diventa \(0{,}351\), \(0{,}235\), \(0{,}213\), \(0{,}201\) di probabilità: la coppia giusta è ancora in testa, ma di un soffio, e la loss simmetrica sale a \(1{,}082\). Per confronto, un modello che tirasse a caso fra quattro didascalie pagherebbe \(\log 4 = 1{,}386\). Con \(\tau = 0{,}5\) questa matrice, che pure è ordinata correttamente, costa il \(78\%\) di quanto costerebbe tirare a caso (\(1{,}082\) contro \(1{,}386\)); con \(\tau = 0{,}07\) ne costa l’\(11\%\).
La temperatura e il batch#
Quel confronto dimostra che la temperatura non è un parametro cosmetico: decide quanto piccole differenze di somiglianza diventino grandi differenze di fiducia, e quindi che cosa il modello si sforzi di correggere.
La temperatura decide quanto l’esaminatore distingue. Un esaminatore mite (temperatura alta) dà a tutti voti quasi uguali: che la risposta giusta fosse nettamente davanti alle altre o appena appaiata, il voto cambia pochissimo, e allora non hai nessun motivo di allargare quel vantaggio. Un esaminatore severo (temperatura bassa) amplifica ogni differenza: essere appena davanti vale molto, essere appena dietro costa moltissimo, e il modello viene spinto ad allargare il margine. Nei conti di prima il modello era davanti in tutte e quattro le righe, quindi l’esaminatore severo, che quel piccolo vantaggio l’ha visto e premiato, gli è costato \(0{,}15\), e quello mite, che non se n’è nemmeno accorto, \(1{,}08\). Con un modello in svantaggio sarebbe andata al contrario: il severo l’avrebbe fatto pagare carissimo.
Questa severità non la sceglie chi progetta: è un numero che il modello impara insieme a tutto il resto, come i pesi. E siccome, sulle coppie già messe in ordine giusto, abbassarla fa scendere il costo da sola, senza che il modello abbia imparato niente, le si mette un fondo sotto il quale non può andare. CLIP parte da \(0{,}07\) e finisce l’addestramento appoggiato a quel fondo, a \(0{,}01\), sette volte più severo di come era partito. Lasciato libero, l’esaminatore diventa il più duro che il regolamento gli consente.
C’è poi un secondo ingrediente altrettanto poco appariscente: quante didascalie sbagliate ci sono nel mucchio. Indovinare fra quattro è facile, e un modello che sbaglia poco impara poco. Indovinare fra trentamila è tutta un’altra cosa, e trentamila è esattamente l’ordine di grandezza che CLIP usa: quanto è grande il mucchio decide la difficoltà dell’esame.
Il mucchio grande, però, costa, e costa in un modo storto. Le caselle da riempire sono \(B\) righe per \(B\) colonne: se le coppie raddoppiano, le caselle diventano quattro volte tante, e vanno tenute tutte insieme sotto gli occhi, perché per dare le percentuali di una riga bisogna avere davanti la riga intera. Trentamila coppie in memoria a una macchina sola non ci stanno: il lavoro si spezza fra centinaia di schede grafiche, e a ogni passo i pezzi vanno radunati e poi ridistribuiti. E la forbice è brutta: raddoppiando il mucchio l’ingombro per prepararlo diventa quattro volte tanto, mentre la difficoltà dell’esame cresce pianissimo, come il logaritmo. È per questo che i mucchi molto grandi costano tanto e rendono poco.
In CLIP \(\tau\) è appresa. In pratica il parametro ottimizzato è il logaritmo del fattore di scala \(1/\tau\), così che la scala resti positiva senza vincoli espliciti; lo si inizializza al valore corrispondente a \(\tau = 0{,}07\) e si impedisce alla scala di superare \(100\), perché l’ottimizzazione tenderebbe altrimenti a farla crescere senza freno (una temperatura che tende a zero rende la loss arbitrariamente piccola sulle coppie già ordinate bene, e instabile il gradiente: nel lavoro originale il tetto è motivato proprio dall’instabilità osservata in addestramento). L’effetto di \(\tau\) sulla distribuzione dei pesi è quello visto nei conti: al calare della temperatura la softmax si fa più piccata e la penalità si concentra sui negativi difficili, quelli con coseno vicino a quello del positivo. Il \(0{,}07\) è un punto di partenza e non un regime di esercizio: nel modello pubblicato la scala appresa sta appoggiata al tetto, cioè \(\tau = 1/100 = 0{,}01\), sette volte più piccata di come è partita. L’ottimizzazione, lasciata libera, raggiunge il vincolo e vi si ferma; ci servirà fra poco, quando si tratterà di capire perché due nuvole di punti non si avvicinano mai.
Il secondo parametro strutturale è \(B\). Il denominatore della InfoNCE somma sui candidati del batch: i negativi sono il batch, non un insieme costruito a parte. Con \(B\) piccolo il compito è banale (la baseline casuale è \(\log B\), e con \(B = 4\) vale \(1{,}39\)) e il segnale di apprendimento è povero; al crescere di \(B\) il compito diventa un ago in un pagliaio. Come per SimCLR, la InfoNCE limita dal basso l’informazione mutua fra immagine e didascalia, \(\mathcal{I}(\mathbf{u}; \mathbf{v}) \ge \log B - \mathcal{L}_{\text{InfoNCE}}\) [vdOLV18], a condizione che i negativi siano campioni indipendenti; e quel limite non può superare \(\log B\). Con \(B = 4\) il tetto è \(1{,}39\) nat, con \(B = 32\,768\) è circa \(10{,}4\): il batch fissa quanta informazione la perdita può certificare, e raddoppiarlo alza quel tetto di appena \(\log 2 \approx 0{,}69\) nat. CLIP addestra con batch da \(32\,768\) coppie, distribuiti su centinaia di GPU. Il prezzo è la struttura stessa della loss: la matrice di similarità è \(B \times B\), e la sua memoria cresce con il quadrato del batch (per \(B = 32\,768\) sono \(1{,}07 \cdot 10^{9}\) elementi, \(4{,}3\) GB in precisione singola), mentre il calcolo, \(2B^2 d\) operazioni, accanto alle due torri è trascurabile (circa lo \(0{,}2\%\) per CLIP con un ViT-B/32 ed embedding da \(d = 512\)). CLIP la calcola a blocchi, ogni GPU per la propria parte; la normalizzazione della softmax richiede comunque che ogni riga veda tutte le colonne, quindi che gli embedding di tutti i dispositivi vengano radunati a ogni passo. È il vincolo che SigLIP, più avanti, scioglie.
La loss in dieci righe#
In PyTorch la perdita sta in una funzione. Gli embedding arrivano dai due encoder come due matrici \((B, d)\), una riga per elemento del batch; il resto è una normalizzazione, un prodotto fra matrici e due cross-entropy.
import torch
from torch import nn
import torch.nn.functional as F

# la temperatura si impara: il parametro e' log(1/tau), cosi' la scala,
# che si ottiene esponenziando, e' positiva per costruzione
logit_scale = nn.Parameter(torch.tensor(1 / 0.07).log())


def loss_contrastiva(emb_img, emb_txt, logit_scale):
    """emb_img, emb_txt: due tensori (B, d), una riga per elemento del batch."""
    # 1. sulla sfera unitaria: il prodotto scalare diventa un coseno
    I = F.normalize(emb_img, dim=-1)
    T = F.normalize(emb_txt, dim=-1)

    # 2. matrice B x B dei coseni, riscalata dalla temperatura (con il tetto)
    scala = logit_scale.exp().clamp(max=100.0)
    logits = scala * (I @ T.t())

    # 3. la risposta giusta e' sempre sulla diagonale: 0, 1, 2, ... B-1
    bersagli = torch.arange(len(I), device=I.device)

    # 4. una cross-entropy sulle righe, una sulle colonne, e si media
    perdita_i2t = F.cross_entropy(logits, bersagli)
    perdita_t2i = F.cross_entropy(logits.t(), bersagli)
    return (perdita_i2t + perdita_t2i) / 2


# La funzione alla prova: otto embedding ortogonali, prima con le coppie giuste
# sulla diagonale, poi con le didascalie spostate di un posto
base = torch.eye(8)
print(f"coppie giuste: {loss_contrastiva(base, base, logit_scale):.2f}")
print(f"didascalie spostate di un posto: "
      f"{loss_contrastiva(base, base.roll(1, dims=0), logit_scale):.2f}")

# Gli stessi conti fatti a mano poco fa: si parte direttamente dalla tabella
# delle somiglianze, saltando i due encoder.
somiglianze = torch.tensor([[0.30, 0.10, 0.05, 0.02],
                            [0.08, 0.28, 0.12, 0.04],
                            [0.04, 0.15, 0.32, 0.09],
                            [0.06, 0.03, 0.10, 0.26]])
bersagli = torch.arange(4)
for tau in (0.07, 0.5):
    logits = somiglianze / tau
    perdita = (F.cross_entropy(logits, bersagli)
               + F.cross_entropy(logits.t(), bersagli)) / 2
    print(f"tau = {tau}: loss simmetrica = {perdita:.3f}")
coppie giuste: 0.00
didascalie spostate di un posto: 14.29
tau = 0.07: loss simmetrica = 0.148
tau = 0.5: loss simmetrica = 1.082
Le prime due righe mettono alla prova la funzione sui due casi estremi. Con le coppie giuste sulla diagonale e nessuna somiglianza fra le altre la perdita è praticamente zero; con ogni didascalia spostata sull’immagine accanto ogni riga mette tutto il punteggio, \(1/0{,}07 = 14{,}29\), sulla coppia sbagliata, e la perdita vale praticamente quel numero. Le ultime due rifanno i conti della tabella delle somiglianze: la stessa matrice, la stessa loss, solo la temperatura cambiata, e i due numeri, \(0{,}148\) e \(1{,}082\), sono quelli dei conti a mano.
Cosa non c’è: nessuna etichetta, nessun numero di classi, nessuna testa di classificazione. L’unica informazione supervisionata è l’ordine delle righe, cioè il fatto che la didascalia \(i\) stava sotto l’immagine \(i\).
Un solo spazio, due quartieri#
Una foto e la sua didascalia finiscono vicine nello spazio comune, ma «vicine» va preso con cautela: su un modello CLIP pubblico la distanza fra le due non è quella che ci si aspetta.
Prendiamo ottanta fotografie, otto per ciascuno di dieci soggetti (aerei, gatti, cavalli, navi e così via), più quaranta didascalie, diamole a un modello CLIP pubblico e misuriamo tutte le vicinanze. Una fotografia somiglia alla didascalia che il modello stesso sceglie per lei circa \(0{,}3\), e a un’altra fotografia del mucchio circa \(0{,}76\). Ogni foto è molto più vicina a una foto qualunque che alla frase che la descrive.
Non è un guasto, e il meccanismo funziona lo stesso: sulle stesse ottanta immagini il classificatore scritto a parole (le dieci categorie diventano dieci frasi, e si tiene la più vicina) indovina nove volte su dieci. Funziona perché il confronto che conta è sempre «questa foto, con quale delle dieci frasi va meglio?», e mai «foto contro frase, in assoluto». Fra le frasi la graduatoria è giusta, ed è tutto quello che serve.
La mappa, insomma, è una sola, ma ci sono due quartieri: le fotografie da una parte, le frasi dall’altra, e i due gruppi non si toccano mai. Basta una riga tracciata una volta sola per dire di ogni punto, senza sbagliarne nemmeno uno su centoventi, se è una foto o una frase. L’addestramento non ha mai chiesto ai due quartieri di mescolarsi: ha chiesto che, nel quartiere delle frasi e soltanto lì, quella giusta stesse davanti a tutte le altre. E quello lo ottiene benissimo.
I due quartieri, per giunta, erano separati fin dal primo giorno. Due reti appena costruite scrivono già in angoli diversi della mappa, prima ancora di essere addestrate, e niente le obbliga poi a traslocare. Anzi, con l’esaminatore severo di CLIP e con le tante coppie del web in cui foto e frase c’entrano poco, spostare a mano un quartiere sopra l’altro fa salire il costo; con un esaminatore mite, invece, avvicinarli conviene.
Ne segue una regola pratica: il numero di somiglianza fra una foto e una frase non si confronta con quello fra due foto. Sono due righelli con lo zero in posti diversi, e chi fissa una soglia guardando i secondi e la applica ai primi sbaglia tutte le volte.
Il fenomeno ha un nome, modality gap, e una descrizione sistematica in Liang
e colleghi [LZK+22], che trovano le due modalità immerse «a
distanza di braccio» nello spazio che condividono. I numeri che seguono vengono
da clip-vit-base-patch32, da ottanta fotografie di CIFAR-10 (otto per
ciascuna delle dieci classi, scelte con un seme fisso) e da quaranta
didascalie, quattro stampi per classe (del tipo a photo of a {classe}), più
dieci didascalie in italiano, una per classe.
# pt-lento non per il tempo, ma per i circa 600 MB di pesi e i 170 MB di
# CIFAR-10 da scaricare la prima volta: dopo, restano nella cache locale.
import numpy as np
import torch
import torchvision
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import cross_val_score
from transformers import CLIPModel, CLIPProcessor

nome = "openai/clip-vit-base-patch32"
modello = CLIPModel.from_pretrained(nome).eval()
processore = CLIPProcessor.from_pretrained(nome)
cifar = torchvision.datasets.CIFAR10(root="data", train=False, download=True)

# ottanta immagini, otto per classe, scelte con un seme fisso
rng = np.random.default_rng(4)
etichette = np.array(cifar.targets)
indici = np.concatenate([rng.choice(np.where(etichette == k)[0], 8,
                                      replace=False) for k in range(10)])
y = etichette[indici]

# quaranta didascalie, quattro stampi per classe (la classe k sta in 4k..4k+3),
# e dieci didascalie in italiano, una per classe
stampi = ["a photo of a {}", "a picture of a {}", "an image of a {}",
          "a low resolution photo of a {}"]
frasi = [s.format(c) for c in cifar.classes for s in stampi]
italiano = ["una foto di un aereo", "una foto di un'automobile",
            "una foto di un uccello", "una foto di un gatto",
            "una foto di un cervo", "una foto di un cane",
            "una foto di una rana", "una foto di un cavallo",
            "una foto di una nave", "una foto di un camion"]

with torch.no_grad():
    entrata = processore(text=frasi + italiano,
                         images=[cifar[i][0] for i in indici],
                         return_tensors="pt", padding=True)
    uscita = modello(**entrata)
I = uscita.image_embeds.numpy()            # (80, 512), gia' normalizzati
T = uscita.text_embeds.numpy()[:40]        # le quaranta in inglese
T_it = uscita.text_embeds.numpy()[40:]     # le dieci in italiano

S = I @ T.T                                # coseni immagine-didascalia
print(f"distanza fra i centroidi: {np.linalg.norm(I.mean(0) - T.mean(0)):.2f}")
print(f"coseno medio con la didascalia migliore: {S.max(axis=1).mean():.2f}")
print(f"coseno medio fra due immagini: "
      f"{(I @ I.T)[np.triu_indices(80, 1)].mean():.2f}")

X = np.vstack([I, T])
modalita = np.array([0] * 80 + [1] * 40)   # 0 = immagine, 1 = testo
acc = cross_val_score(LogisticRegression(max_iter=1000), X, modalita, cv=5)
print(f"immagine o testo? accuratezza in validazione incrociata: "
      f"{acc.mean():.2f}")

# un solo prompt per classe, il primo dei quattro stampi
zero_shot = ((I @ T[0::4].T).argmax(axis=1) == y).mean()
print(f"zero-shot, un prompt per classe in inglese: {zero_shot:.2f}")
zero_shot_it = ((I @ T_it.T).argmax(axis=1) == y).mean()
print(f"zero-shot, un prompt per classe in italiano: {zero_shot_it:.2f}")
distanza fra i centroidi: 1.08
coseno medio con la didascalia migliore: 0.30
coseno medio fra due immagini: 0.76
immagine o testo? accuratezza in validazione incrociata: 1.00
zero-shot, un prompt per classe in inglese: 0.90
zero-shot, un prompt per classe in italiano: 0.70
La distanza fra i due centroidi vale \(1{,}08\) (gli embedding stanno sulla sfera unitaria, dove il massimo possibile è \(2\)); il coseno medio con la didascalia migliore è \(0{,}30\), contro \(0{,}76\) fra due immagini qualunque; e le due nuvole non si sovrappongono per niente, tanto che una regressione logistica risponde «immagine o testo?» senza un errore in validazione incrociata. Con un solo prompt per classe, in inglese, la classificazione zero-shot a dieci vie arriva al 90%: il divario non le impedisce di funzionare, ed è il punto. Cambiando il seme, cioè le otto immagini per classe, le prime quattro righe dell’uscita non si spostano più di un centesimo, mentre lo zero-shot si muove fino a una decina di punti; e quel \(0{,}76\) è alto perché le immagini di CIFAR-10 sono \(32 \times 32\) e si somigliano fra loro più di quanto si somiglino fotografie a piena risoluzione: su queste il valore scende, senza che la forbice si chiuda. L’ampiezza del divario dipende dal modello, dai dati e dalla temperatura: con \(\tau\) bassa, come in CLIP, la perdita lo mantiene; con \(\tau\) alta, nelle prove di Liang e colleghi, un fine-tuning lo riduce fino a chiuderlo.
Il divario non è un difetto dell’ottimizzazione. La InfoNCE non contiene nessun termine che premi la vicinanza fra le due modalità in assoluto: vincola l’ordine e i margini dentro ogni riga e dentro ogni colonna. Liang e colleghi trovano tre ingredienti. Il primo è l’inizializzazione, l’effetto cono: una rete profonda non addestrata concentra le proprie uscite in un cono stretto, e due reti diverse danno due coni diversi. Il secondo è la temperatura bassa: a \(\tau = 0{,}01\), il valore finale di CLIP, avvicinare a mano le due nuvole fa aumentare la perdita (nella loro prova il divario di partenza è il minimo globale), mentre con \(\tau\) più alta il minimo si sposta verso la sovrapposizione. Il terzo sono le coppie mal appaiate, frequenti nei dati del web, che a temperatura bassa creano proprio la struttura che respinge la sovrapposizione.
Due conseguenze per chi costruisce. La prima: coseni cross-modali e coseni intra-modali vivono su scale diverse, non si confrontano fra loro e non si mescolano in un’unica soglia. La seconda: le operazioni che presuppongono uno spazio omogeneo (il centroide fra un’immagine e un testo, un \(k\)-means su vettori misti, una soglia assoluta di appartenenza) non hanno la garanzia che il coseno dà dentro una modalità, e vanno verificate caso per caso. Quel che è sempre lecito, ed è quanto basta a tutto il resto della sezione, è l’\(\arg\max\) dentro una modalità sola.
Il classificatore che si scrive a parole#
Finito l’addestramento, il modello sa fare una cosa sola: dire quanto un’immagine e un testo si somigliano. Usata bene, quella cosa sola produce un classificatore senza nessun addestramento supplementare.
Vuoi distinguere gatti, cani e tram? Non serve raccogliere foto né riaddestrare niente. Scrivi tre frasi: «una foto di un gatto», «una foto di un cane», «una foto di un tram» (in inglese, a dire il vero: il CLIP originale ha imparato su didascalie inglesi, e in italiano funziona, ma molto peggio). Le passi all’encoder di testo, che ti dà tre liste di numeri. Passi la tua immagine all’encoder di immagini, che te ne dà una. Guardi a quale delle tre è più vicina, cioè calcoli quel numero fra \(-1\) e \(+1\) tre volte e tieni il più alto. Se domani ti serve anche «una foto di un vaporetto», aggiungi una riga di testo: il classificatore è cresciuto di una classe in un secondo, senza una sola immagine di vaporetto.
Questo si chiama zero-shot, «a zero esempi», ed è la stessa identica operazione di prima, l’abbinare, usata con didascalie che ti sei scritto da solo. Le tre liste di numeri sono i pesi del classificatore, e di solito i pesi si stimano a poco a poco su migliaia di foto etichettate; qui li scrive l’encoder di testo, leggendo una frase. Il fenomeno che ha colpito tutti nel 2021 è che il classificatore scritto a parole, senza aver visto nemmeno una delle immagini etichettate di ImageNet (sono 1,28 milioni), ci prendeva quanto la ResNet-50 che su quelle immagini si era addestrata.
C’è però una stranezza: il risultato cambia a seconda di come scrivi la frase. «Una foto di un gatto» funziona meglio della sola parola «gatto», perché il modello ha imparato dalle didascalie del web, che sono frasi: una parola secca gli arriva in una lingua un po’ diversa da quella su cui si è allenato. E poi c’è l’ambiguità. «Gru» da sola può essere l’uccello o la macchina da cantiere, mentre «una foto di una gru, l’uccello» chiude la questione. Sistemare la frase vale, su ImageNet, poco più di un punto di risposte giuste in più.
L’altro accorgimento sta nel non fidarsi di una formulazione sola. Della stessa classe si scrivono ottanta frasi diverse («una foto di un gatto», «un primo piano di un gatto», «una foto sfocata di un gatto»), si fa la media delle ottanta liste di numeri e si usa quella: le stranezze di ciascuna si annullano a vicenda e resta quello che le ottanta hanno in comune, il concetto. Vale altri tre punti e mezzo, e non costa niente, perché la media si fa una volta sola e prima di guardare qualunque fotografia.
Il trucco ha però i suoi confini. Dove le foto somigliano poco a quelle che si trovano sul web con una didascalia accanto (le immagini da satellite, i vetrini di un laboratorio di analisi, i segnali stradali) o dove bisogna contare gli oggetti, il classificatore scritto a parole perde nettamente contro uno addestrato su foto etichettate.
Dato un insieme di classi candidate \(\{c_1, \dots, c_K\}\), si costruisce per
ciascuna un prompt (per esempio a photo of a {c_k}), lo si passa nell’encoder
di testo e si normalizza, ottenendo \(\mathbf{T}_1, \dots, \mathbf{T}_K\). La
lingua conta: il CLIP originale è addestrato e valutato su testo inglese, e con
prompt in italiano rende molto meno, come mostra l’ultima riga del blocco di
«Un solo spazio, due quartieri» (\(0{,}70\) contro \(0{,}90\) sulle stesse ottanta
immagini); per altre lingue serve un modello multilingue, o la traduzione delle
etichette. La predizione per un’immagine con embedding \(\mathbf{I}\) è
L’osservazione strutturale, fatta nel paper originale [RKH+21], è che questa è una regressione logistica multinomiale con ingressi e pesi normalizzati in norma \(\ell_2\), senza bias e con temperatura: la matrice \([\mathbf{T}_1; \dots; \mathbf{T}_K] \in \mathbb{R}^{K \times d}\) è la matrice dei pesi, e l’encoder di testo è una hypernetwork, una rete che genera i pesi del classificatore a partire da una descrizione delle classi, invece di stimarli per discesa del gradiente su esempi etichettati. Cambiare l’insieme delle classi significa rigenerare quella matrice, con una passata dell’encoder di testo per classe e per prompt, da fare una volta sola; se i prompt sono più d’uno, la media dei loro embedding si normalizza di nuovo.
Due fenomeni rendono la scelta del prompt non neutrale. Il primo è la
polisemia: un’etichetta isolata non disambigua i suoi sensi (l’italiano
«gru» copre l’uccello e la macchina da cantiere, e nei dataset di visione casi
simili sono la norma), mentre un contesto testuale lo fa. Il secondo è uno
scarto di distribuzione: nel corpus di pre-addestramento il testo appaiato
a un’immagine è quasi sempre una frase, quindi un input costituito da una sola
parola cade in una regione poco frequentata dello spazio testuale. Il rimedio,
un template fisso come A photo of a {label}., vale nel paper originale un
guadagno di \(1{,}3\) punti su ImageNet, e mediare gli embedding di ottanta
template diversi (una forma di ensembling che, essendo fatta sui vettori e non
sulle predizioni, non costa nulla in inferenza) ne aggiunge altri \(3{,}5\).
Lo zero-shot ha però punti di rottura chiari. Nel confronto del lavoro originale con una regressione logistica addestrata sulle feature di una ResNet-50, su 27 insiemi di dati, CLIP vince su 16, ma perde di 37 punti su EuroSAT (immagini satellitari), di 34 su KITTI Distance, di 19 su PatchCamelyon (patologia), di 18 su GTSRB (segnali stradali) e su CLEVRCounts (conteggio): sono i compiti specialistici, astratti o lontani dalla distribuzione delle immagini del web.
La stessa geometria dà il recupero cross-modale: si indicizzano gli embedding di un archivio di immagini e si interroga l’indice con l’embedding di una frase, prendendo i \(k\) più vicini; oppure il contrario, cercando la didascalia più adatta a un’immagine. Ricerca semantica di immagini, deduplicazione, filtraggio di corpora enormi: sono tutti lo stesso prodotto scalare. E il text encoder così addestrato è riusabile altrove: è lui, congelato, a tradurre il prompt in vettori dentro Stable Diffusion v1 (le versioni successive ne usano altri, o più d’uno), come descrive la sezione su Stable Diffusion.
Sì o no, una casella alla volta#
Il vincolo del batch grande viene dalla softmax, che per normalizzare una riga ha bisogno degli embedding di tutte le didascalie del batch: il costo di radunarli a ogni passo cresce con il batch, proprio mentre il metodo chiede batch grandi.
SigLIP [ZMKB23] sostituisce la softmax di riga con una sigmoide per coppia: ogni casella della matrice diventa una classificazione binaria, coppia giusta o sbagliata, indipendente dalle altre.
Invece di «ecco l’immagine numero uno, quale delle quattro didascalie è la sua?», a ogni casella della tabella si fa una domanda indipendente: «voi due andate insieme, sì o no?». Sedici domandine al posto delle otto interrogazioni di prima, quattro sulle righe e quattro sulle colonne.
Il guadagno è che per rispondere a una non serve sapere niente delle altre. Nessuno deve più radunare la riga intera, il lavoro si può spezzare in pezzi che viaggiano per conto proprio, e soprattutto cade l’obbligo del mucchio enorme: l’esame a scelta multipla, per essere difficile, il mucchio grande lo pretendeva; una domanda sì-o-no si regge da sé. Il mucchio grande serve ancora fino a un certo punto (oltre, anzi, peggiora le cose), ma non è più obbligatorio.
Un guaio però c’è, ed è di proporzioni. In una tabella di quattro per quattro le caselle da «sì» sono quattro e quelle da «no» dodici; con un mucchio da quattromila coppie diventano quattromila «sì» contro quasi sedici milioni di «no». Chi rispondesse «no» a tutto avrebbe quasi sempre ragione senza aver imparato niente, e le prime ore di addestramento se ne andrebbero tutte a scoprire questa sciocchezza. Il rimedio è dirgliela in partenza: si regala al modello la conoscenza che «no» è la risposta di gran lunga più frequente, così il tempo lo può spendere sul resto.
«Questa immagine e questa didascalia vanno insieme?» è un problema di classificazione binaria, e la funzione che gli corrisponde non è la softmax ma la sigmoide:
dove \(\sigma\) è la funzione logistica, \(t\) il fattore di scala appreso (lo stesso ruolo di \(1/\tau\), parametrizzato anche qui come esponenziale di un parametro libero), \(b\) un bias appreso e \(z_{ij}\) l’etichetta binaria della cella. Si noti la normalizzazione: la somma corre su tutte le \(B^2\) celle, ma il divisore è \(B\), così che la loss conti il costo per elemento del batch e non per cella. Il bias serve a un problema che la softmax non aveva: in un batch le celle negative sono \(B^2 - B\) contro \(B\) positive, un forte sbilanciamento, e senza un \(b\) inizializzato molto negativo (nel lavoro originale a \(-10\)) le prime iterazioni si consumerebbero tutte a correggerlo, invece che a imparare.[1]
La conseguenza pratica è che ogni casella dipende da una coppia sola, e non c’è più niente da normalizzare su tutto il batch. Con il batch distribuito su \(D\) dispositivi, ciascuno calcola la perdita dei propri \(B/D\) esempi contro un blocco di embedding di testo alla volta, e i blocchi passano al dispositivo vicino con \(D\) permutazioni collettive, senza radunare tutto su ciascuno: la memoria della matrice scende da \(B^2\) a \((B/D)^2\) per dispositivo, mentre il calcolo totale resta \(O(B^2 d)\). E la qualità dipende molto meno dalla dimensione del batch. Nelle prove degli autori con l’encoder visivo bloccato (SigLiT) la sigmoide batte di parecchio la softmax sotto le sedicimila coppie per batch, e oltre le trentaduemila nessuna delle due guadagna più molto; addestrando tutto da zero (SigLIP) il vantaggio sotto le trentaduemila coppie è più piccolo, di uno o due punti, il massimo della sigmoide sta a trentaduemila e quello della softmax a novantottomila, e un batch di trecentomila peggiora entrambe. Sono i numeri di quelle prove, non costanti di natura; quello che non dipende dai numeri è la direzione, cioè che alla dimensione del batch viene tolto il ruolo di prerequisito. È lo stesso allineamento, ottenuto togliendo un vincolo invece di aggiungere un pezzo.
ALIGN [JYX+21], uscito negli stessi mesi di CLIP, addestra lo stesso schema a due torri (EfficientNet per le immagini, BERT per il testo, entrambi da zero) su 1,8 miliardi di coppie di immagine e testo alternativo prese dal web con un filtro minimo, basato sulle sole frequenze, senza i costosi passaggi di pulizia con cui di solito si prepara un archivio di immagini. Molte di quelle didascalie c’entrano poco con la loro fotografia; la tesi degli autori è che la scala compensa il rumore. Ripulire l’archivio non è un prerequisito del metodo.
Uno spazio allineato non è uno spazio che capisce#
Fin qui l’allineamento funziona: ricerca per descrizione, classificazione senza esempi, addestramento su dati senza etichette. Restano due limiti.
Torniamo alla frase che apriva la sezione: «un gatto nero che salta sul muro». Un modello contrastivo la riconosce benissimo se nella foto ci sono un gatto, qualcosa di nero e un muro. Ma proviamo a chiedergli di distinguere «il gatto sotto il tappeto» da «il tappeto sotto il gatto», o «il gatto insegue il cane» da «il cane insegue il gatto»: le due frasi contengono le stesse identiche parole, e le due immagini gli stessi oggetti. È qui che il meccanismo mostra il fondo.
Il fenomeno è stato reso visibile da Winoground [TJB+22], un insieme di quattrocento esempi costruiti a mano apposta: due immagini e due didascalie fatte esattamente delle stesse parole in ordine diverso, con il compito di appaiarle correttamente. Si misura in tre modi: scegliere la didascalia giusta per ciascuna delle due immagini, scegliere l’immagine giusta per ciascuna delle due didascalie, e riuscire in tutte e quattro le scelte insieme. Le prime due misure chiedono di indovinare entrambe le volte fra due possibilità, quindi tirando a caso si prende il 25%, un mezzo per un mezzo. La terza, a caso, non vale un sedicesimo, come verrebbe moltiplicando le prime due, perché le quattro scelte leggono gli stessi quattro punteggi (uno per ciascuna coppia di immagine e didascalia) e non sono indipendenti. Il conto si fa sugli ordinamenti: quattro punteggi diversi si mettono in fila in \(4! = 24\) modi, e le quattro scelte riescono solo se le due coppie giuste occupano i primi due posti, in uno dei due ordini possibili, con le sbagliate dietro, anche loro in uno dei due ordini: \(2 \times 2 = 4\) ordinamenti su \(24\), un sesto, il \(16{,}7\%\). Il risultato, enunciato dagli autori nel 2022, è che nessuno dei modelli provati fa molto meglio del caso; sulle due misure più difficili, cioè scegliere l’immagine giusta e riuscire in tutte e quattro le scelte insieme, sono tutti sotto il livello del caso, il che non è sfortuna: vuol dire che qualcosa li spinge sistematicamente verso la risposta sbagliata.[2] È la misura di un limite che riguardava le famiglie di modelli di allora, non una classifica fra prodotti. Nel 2024, usando come giudici sì o no i modelli con un decoder che legge l’immagine, quelli delle sezioni che seguono [LPL+24], il punteggio di gruppo sale dal \(7{,}8\%\) di un CLIP più grande (il caso vale \(16{,}7\%\)) al \(29{,}8\%\) di LLaVA-1.5 e al \(46{,}0\%\) del modello degli autori, contro l’\(85{,}5\%\) delle persone.
Per CLIP e per i modelli addestrati con lo stesso gioco la spiegazione più diretta sta nel gioco stesso: il modello impara a distinguere la sua didascalia dalle altre del gruppo (didascalie di immagini prese a caso), e non a descrivere quello che vede. Winoground, da solo, non basta a provarlo, perché mette in difficoltà anche modelli addestrati in altro modo, con l’appaiamento e il mascheramento delle parole. Per vincere al gioco, quasi sempre, basta indovinare quali oggetti compaiono nella foto: se le altre didascalie parlano di un tramonto, di una bicicletta e di una scodella di minestra, riconoscere «gatto» e «muro» è più che sufficiente, e capire chi sta sopra chi non porta nessun vantaggio. La soluzione che costa meno per abbassare la loss è trattare la didascalia come un sacchetto di parole (bag-of-words), e l’ottimizzazione la trova, perché nulla nella loss la penalizza. La sintassi, le relazioni spaziali, il conteggio, la negazione (togliere un «senza» da una didascalia le rovescia il significato e non la sposta quasi per niente nello spazio) sono i primi a rimanere fuori.
Che il gioco contrastivo sia una causa di questo comportamento è l’ipotesi di Yuksekgonul e colleghi [YBK+23], sostenuta da un esperimento chiarissimo: si prendono le didascalie di un archivio, se ne mescolano le parole, si rifà la ricerca per immagini, e il risultato quasi non peggiora. Se l’ordine si può buttare via senza pagare pegno, l’ordine il compito non lo chiedeva. Lo stesso lavoro propone anche una riparazione, che è la parte utile: fra i negativi del batch si aggiungono didascalie ottenute scambiando fra loro sintagmi, nomi, aggettivi o verbi della didascalia giusta, e immagini molto simili a quelle del batch. Con questo fine-tuning di CLIP su COCO la stessa rete migliora nettamente sui test di ordine e di relazione (su COCO Order, per esempio, da 46% a 86%): una buona parte del limite stava in quello che le si chiedeva di distinguere. Solo una parte, però: quelle didascalie con le parti scambiate sono spesso frasi sgrammaticate, che un modello di solo testo riconosce senza guardare l’immagine, e rifatta la prova con negativi scritti bene il guadagno si ridimensiona di molto [HZM+23].
Due precisazioni, per onestà. La prima è che quegli esempi, scelti a mano perché siano difficili, lo sono anche per altre ragioni (alcuni chiedono conoscenza del mondo, altri sono visivamente ostici [DBC+22]), e quindi quel che misurano è il saper mettere insieme i pezzi di una frase (la composizionalità) più qualcos’altro. Il fenomeno è solido, la sua quantificazione esatta lo è meno. La seconda è che un limite parallelo viene dalla forma della rappresentazione: un’intera immagine finisce in un solo vettore, addestrato a distinguere una didascalia dalle altre, che tiene soprattutto ciò che serve a quel compito. Il testo scritto nell’immagine ci arriva solo in parte: CLIP lo legge bene quando è testo digitale, frequente nei dati di addestramento, e male quando non lo è (l’88% sulle cifre scritte a mano di MNIST, meno di una regressione logistica sui pixel [RKH+21]). La posizione precisa di ogni oggetto e il dettaglio fine sono quello che l’obiettivo non chiede, e a \(224\) pixel spesso non ci sono nemmeno: il dettaglio e i documenti sono un problema a parte, e li affronta la sezione Il costo del dettaglio.
La risposta ai due limiti è mettere al posto del prodotto scalare un modello di linguaggio che legge l’immagine token per token: per la composizione, perché la relazione fra le parole e le regioni dell’immagine non è più schiacciata in un coseno; per il dettaglio, perché i token possono essere molti, a un costo che quella sezione calcola. Come si innesta un occhio su un modello che sa solo leggere lo mostra la sezione Innestare gli occhi.
Da ricordare
Un classificatore a elenco chiuso sa dire soltanto le voci del suo elenco, e aggiungerne una costa foto nuove, etichette nuove e un addestramento nuovo. Il gioco delle quattro foto e delle quattro didascalie da appaiare sostituisce la domanda «che cosa è questo?» con «quale di queste didascalie è la sua?».
Nessuno prepara le risposte: le didascalie sono già attaccate alle immagini del web, e per addestrare CLIP ne sono state raccolte quattrocento milioni.
Il gioco si fa in due sensi, per righe e per colonne, e si fa la media. Due numeri decidono quanto è severo: la temperatura, che amplifica le differenze fra le somiglianze prima di trasformarle in percentuali, e tanto più quanto più è piccola, e quante didascalie sbagliate ci sono nel mucchio, perché indovinare fra quattro è facile e indovinare fra trentamila no.
Il regalo che ne esce: per costruire un classificatore bastano tre frasi scritte a mano, e domani la quarta si aggiunge in un secondo, senza una sola fotografia. Conta però come si scrive la frase: meglio in inglese, la lingua su cui CLIP ha imparato, e meglio ottanta frasi mediate che una sola. E dove le foto non somigliano a quelle del web, o bisogna contare, perde contro un classificatore addestrato.
Nella variante «sì o no» si smette di chiedere «quale di queste quattro» e si chiede a ogni casella «voi due andate insieme?»: nessuno deve più radunare tutta la riga, e il mucchio enorme smette di essere obbligatorio.
Immagini e parole finiscono sulla stessa mappa, ma in due quartieri separati: per una foto la didascalia giusta è la più vicina fra tutte le frasi, e questo basta a farla vincere, ma nessuna frase le è mai vicina quanto le è vicina una fotografia qualunque. Con un esaminatore severo come quello di CLIP i quartieri restano separati, e i numeri si confrontano fra pari, mai una foto con una frase in assoluto.
Appaiare non è capire: al gioco si vince riconoscendo gli oggetti, quindi «il gatto sotto il tappeto» e «il tappeto sotto il gatto» restano indistinguibili. È il motivo per cui esistono le sezioni che seguono.
Da ricordare
Un classificatore chiuso sa dire solo le classi su cui è stato addestrato, e aggiungerne una costa rietichettatura e riaddestramento. L’addestramento contrastivo immagine-testo [RKH+21] sostituisce la domanda «che cosa è» con «quale di queste didascalie è la sua».
La supervisione è naturale: le coppie immagine-didascalia esistono già sul web (quattrocento milioni per CLIP, raccolte con circa mezzo milione di interrogazioni), nessuno le etichetta e non c’è un elenco di classi da riconoscere.
La loss è una InfoNCE simmetrica [vdOLV18]: embedding normalizzati, matrice \(B \times B\) di coseni divisi per la temperatura \(\tau\), cross-entropy sulle righe e sulle colonne con la diagonale come risposta corretta.
\(\tau\) e \(B\) sono parte del metodo, non dell’implementazione: la temperatura è appresa, e a fine addestramento la scala \(1/\tau\) sta appoggiata al suo tetto, cioè \(\tau\) al suo valore minimo, \(0{,}01\). Decide quanto la distribuzione è piccata, e i negativi vengono dal batch, quindi un batch piccolo rende il compito troppo facile. A crescere con \(B^2\) non è il calcolo, che accanto ai due encoder è trascurabile, ma la memoria della matrice. E la normalizzazione di riga obbliga a un all-gather degli embedding fra i dispositivi a ogni passo.
Le due modalità restano in due regioni disgiunte dello spazio condiviso, il modality gap [LZK+22]: il contrastivo ottimizza un ordinamento dentro il batch, e di quell’ordinamento la sovrapposizione delle due nuvole non fa parte; a temperatura bassa, come in CLIP, forzarla a mano fa salire la perdita invece di abbassarla. Conseguenza operativa: un coseno cross-modale non si confronta con un coseno intra-modale.
La classificazione zero-shot è una conseguenza, non una funzione in più: una regressione logistica i cui pesi li genera l’encoder di testo, una didascalia per classe. La forma del prompt conta, perché il modello ha imparato su frasi e non su parole isolate, e conta la lingua (il CLIP originale è inglese). Cade sui compiti specialistici, astratti o di conteggio. La stessa geometria dà il recupero di immagini per descrizione.
SigLIP [ZMKB23] sostituisce la softmax di riga con una sigmoide per coppia: niente normalizzazione globale, niente raduno degli embedding fra le GPU, buon addestramento anche con batch piccoli. ALIGN [JYX+21] mostra che il metodo regge 1,8 miliardi di coppie raccolte dal web con un filtro minimo.
Allineare non è capire: la loss premia il riconoscimento degli oggetti e non le relazioni fra loro, e il modello si comporta in buona parte come un sacchetto di parole. Winoground [TJB+22] rende visibile il fallimento (nel 2022 nessuno dei modelli provati faceva molto meglio del caso); l’esperimento delle didascalie con le parole mescolate [YBK+23] mostra che la ricerca di immagini non richiede l’ordine, e con negativi costruiti scambiando le parti della didascalia la stessa rete migliora su quei test, in parte per scorciatoie del benchmark [HZM+23]. Da qui le architetture che seguono.