


Molti semplici invece di pochi intelligenti#
Gli storni con cui si è aperto il capitolo non stanno risolvendo niente: volano. La loro regola dei sei o sette vicini serve a restare insieme sopra il posatoio, non a calcolare qualcosa. Ma la domanda che quello spettacolo mette in testa a un informatico è vecchia e precisa: se una regola locale elementare basta a tenere in aria migliaia di uccelli, può bastare anche a risolvere un problema?
Per una trentina d’anni la risposta a questa domanda ha occupato una parte rilevante della ricerca multi-agente: prima che «agente» significasse un modello di linguaggio con un foglio di istruzioni, in buona parte di quella letteratura un agente era una particella con tre righe di aritmetica dentro. Le sezioni precedenti hanno contato quanto testo si fanno rileggere gli agenti, e hanno messo ordine nei loro messaggi, perché erano partecipanti costosi e chiacchieroni; qui la situazione si ribalta. Nelle formiche, nelle particelle e negli algoritmi genetici i partecipanti sono centinaia, non costano quasi niente, non ragionano e non si scrivono messaggi; nelle società simulate che chiudono il capitolo tornano agenti linguistici, e l’oggetto di studio diventa la società che formano. L’idea comune resta però quella dell’apertura: molte unità quasi banali, nessun controllore centrale, e una soluzione che emerge dall’interazione invece di essere calcolata da qualcuno.
Le formiche del Politecnico#
L’idea nasce da una domanda di etologia: come fanno animali quasi ciechi come le formiche a trovare il cammino più breve fra il formicaio e una fonte di cibo, senza vederlo e senza che nessuna di loro lo sappia? La prima risposta esce nel 1991 a Parigi, in un articolo di convegno di Alberto Colorni, Marco Dorigo e Vittorio Maniezzo; diventa nel 1992 la tesi di dottorato di Dorigo al Politecnico di Milano, e nel 1996 l’articolo di rivista che tutti citano [DMC96]. È il capostipite di una famiglia di algoritmi (la ant colony optimization) nata in un’università italiana, e il problema su cui viene provato è il commesso viaggiatore: date certe città e le distanze fra loro, trovare il giro più corto che le tocchi tutte una volta sola e torni al punto di partenza. È facile da enunciare e difficilissimo da risolvere: il problema è NP-difficile, e i giri possibili con \(n\) città sono \((n-1)!/2\), cioè 181.440 con dieci città e circa sessanta milioni di miliardi con venti. È per questo uno dei problemi più studiati che esistano.
Il meccanismo biologico è questo. Una formica che cammina deposita per terra una sostanza, il feromone; una formica che incontra una traccia già depositata tende a seguirla, e seguendola la rinforza con il proprio feromone. Il modello matematico lo traduce in due regole, una per scegliere la strada e una per rinforzarla.
Mettiamo due strade che portano allo stesso cibo, una lunga il doppio dell’altra, e formiche che vanno tutte alla stessa velocità. All’inizio nessuna sa niente e si dividono a caso, metà di qua e metà di là.
Adesso guarda l’orologio. Se il giro breve si fa in dieci minuti e quello lungo in venti, in un’ora una formica sulla strada corta la percorre sei volte e una sulla strada lunga tre. Stesso numero di formiche, stessa quantità di feromone lasciata a ogni passaggio, e sulla strada corta se ne accumula il doppio. Le formiche che arrivano dopo trovano una traccia doppia da una parte, la seguono con probabilità maggiore, e depositano altro feromone proprio lì.
Nessuno ha misurato le due strade. Nessuno le ha confrontate. La strada corta vince perché la si percorre più spesso, e la si percorre più spesso perché è corta: è il tempo a fare la misura al posto di un cervello.
Le formiche del computer fanno la stessa cosa con una scorciatoia. Invece di lasciare sempre la stessa quantità e aspettare che sia il tempo a contare i passaggi, fanno un giro per volta e alla fine lasciano traccia tanto maggiore quanto più corto è stato il giro: chi ha fatto il giro lungo il doppio ne lascia la metà. Il doppio di traccia sulla strada corta arriva così in un colpo, invece che a forza di passaggi.
E la formica del computer non è cieca del tutto. Fra due strade che spariscono dietro l’angolo non c’è niente da vedere, ma quando il giro è fra molte città, a ogni tappa guarda anche quale città è più vicina, e pesa quello che vede contro quello che le altre hanno lasciato per terra: col solo naso andrebbe sempre dalla più vicina, senza ascoltare nessuno; con la sola traccia saprebbe tutto delle altre e niente del terreno.
La colonia costruisce soluzioni un pezzo alla volta. Una formica \(k\) che si trova sul nodo \(i\) sceglie il nodo successivo \(j\) con probabilità
dove \(\tau_{ij}\) è la quantità di feromone sull’arco \((i,j)\) ed \(\eta_{ij}\) è la visibilità, cioè l’inverso della lunghezza dell’arco (\(\eta_{ij} = 1/d_{ij}\) nel commesso viaggiatore, e niente a che vedere con il tasso di apprendimento \(\eta\) del resto del libro). L’insieme \(\mathcal{A}_k\) contiene i nodi che la formica \(k\) non ha ancora visitato: una lista di nodi proibiti le vieta di tornare dove è già passata, ed è ciò che rende legale il giro. Infine, gli esponenti \(\alpha, \beta \ge 0\) pesano i due termini l’uno contro l’altro. La formula è un compromesso fra esperienza collettiva (\(\tau\): quante formiche sono passate di qui e quanto bene è andata) ed euristica locale (\(\eta\): quanto è vicino il prossimo nodo). I due casi limite lo chiariscono: con \(\alpha = 0\) il feromone sparisce dal conto e resta un algoritmo goloso stocastico, cioè una colonia di formiche che non comunicano; con \(\beta = 0\) resta solo il passaparola, senza nessuna informazione sul problema.
Il rinforzo arriva a giro finito, ed è proporzionale alla qualità della soluzione costruita:
dove \(m\) è il numero di formiche della colonia, \(L_k\) è la lunghezza del giro completo costruito dalla formica \(k\) e \(Q\) è una costante di scala dell’algoritmo (nessun rapporto con il valore-azione \(Q\) del Reinforcement Learning; nel lavoro originale la sua influenza risulta trascurabile). Il quoziente \(Q/L_k\) è la differenza che conta fra questa versione (ant-cycle) e le due che gli autori provano e scartano, dove la formica deposita a ogni passo, senza aspettare la fine del giro, una quantità fissa (ant-density) o inversamente proporzionale alla lunghezza del singolo arco (ant-quantity). Sono due usi di informazione locale, e infatti vanno peggio: chi ha fatto un giro corto deve lasciare più feromone di chi ne ha fatto uno lungo, e per saperlo bisogna che il giro sia finito. Così la traccia non registra il traffico, registra il merito.
Nell’articolo del 1996 i valori risultati migliori per questa versione sono \(\alpha = 1\), \(\beta = 5\), \(Q = 100\) e una persistenza di \(0{,}5\) (la frazione di traccia che resta da un giro all’altro), con tante formiche quante città, \(m = n\). Un giro della colonia costa \(O(m\,n^2)\) operazioni, perché ciascuna delle \(m\) formiche fa \(n\) scelte fra al più \(n\) candidati. Le varianti venute dopo lasciano depositare soltanto la formica migliore e tengono le tracce dentro un intervallo \([\tau_{\min}, \tau_{\max}]\), come il MAX-MIN Ant System [StutzleH00]; per questa famiglia si dimostra che la probabilità di trovare almeno una volta il giro ottimo tende a uno, ma senza alcun limite sul tempo che serve [StutzleD02].
L’accumulo si vede solo nel tempo: in un fotogramma solo non c’è niente da guardare, perché è proprio l’accumularsi a decidere. In Fig. 22.6 ci sono sei giri della colonia sulle due strade, che cambiano spessore man mano che il feromone si deposita.

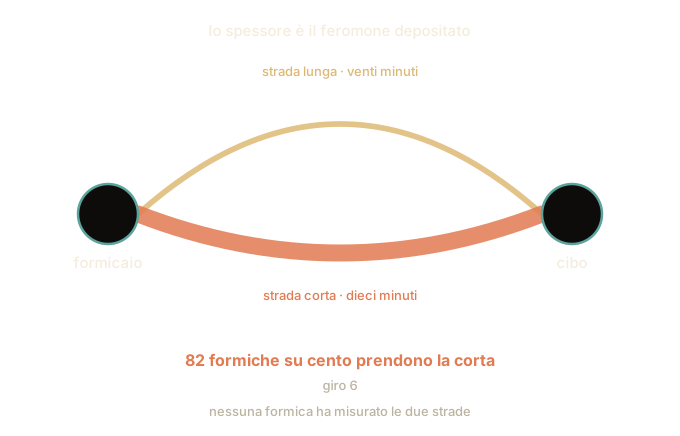
Fig. 22.6 Sei giri della colonia sulle due strade: lo spessore di ciascuna è il feromone che ci si è accumulato sopra. Si parte in parità, cinquanta e cinquanta, e si finisce con l’ottantadue per cento delle formiche sulla strada corta. I numeri non sono disegnati a occhio, li calcola la figura applicando le due sole regole viste finora: si sceglie la strada in proporzione al feromone che ci si trova sopra, e si lascia feromone in proporzione a quanto è stato buono il giro. Il modello della figura non ha evaporazione: il feromone si accumula e non svanisce.#
Nella figura contano due cose, e la seconda più della prima.
La prima è dove si muove di più. La quota di formiche sulla strada corta parte da cinquanta su cento e diventa, giro dopo giro, sessantasei, settantatré, settantasette, ottanta, ottantadue: il salto grosso è il primo, sedici punti, contro i sette del secondo e i quattro del terzo. Ed è il salto che avviene quando le due strade sono ancora percorse dallo stesso numero di formiche: lì a fare la differenza è soltanto quanto ciascuna lascia alla fine del giro, e siccome un giro è lungo la metà dell’altro, chi lo fa lascia il doppio di chi fa l’altro. Da lì in poi il vantaggio si rinforza da sé.
La seconda è che anche la strada lunga si ispessisce. Il difetto sta nel meccanismo, non nel disegno. Finché le formiche passano, il feromone si accumula dappertutto e non se ne va più; quello che cresce è il divario, non la differenza fra una traccia e nessuna traccia. Un sistema fatto così sa premiare, ma non sa dimenticare, ed è esattamente il buco che le prossime pagine vanno a tappare.
L’evaporazione è l’esplorazione#
Fin qui il meccanismo ha un difetto grosso, e conviene vederlo prima della cura, perché è lo stesso di molti sistemi che si alimentano da soli. Il feromone attira formiche, le formiche depositano feromone, il feromone attira altre formiche: è una retroazione positiva, e senza un freno la traccia cresce senza limite proprio dove è già più forte. La prima strada trovata per caso diventa la più battuta, la più battuta diventa l’unica, e la colonia si fossilizza su una soluzione che non ha nessun motivo di essere buona: nel gergo dell’articolo è il comportamento di stagnazione, la situazione in cui tutte le formiche fanno lo stesso giro e nessuna cerca più niente.
La cura è una sola parola: il feromone evapora.
Ogni sera metà del feromone se ne va da solo. Una strada che continua a essere usata non se ne accorge, perché ogni giorno riceve un deposito nuovo. Una strada che è stata la migliore per un po’ e poi non lo è più si sbiadisce in fretta: partendo da cento, in cinque sere passa a cinquanta, venticinque, dodici e mezzo, poco più di sei, poco più di tre. Dopo una settimana è sotto l’uno per cento, come se non fosse mai esistita, e le formiche tornano a provarci altrove.
Metà per sera fissa anche la taglia della memoria. Una strada battuta tutti i giorni non cresce all’infinito: si assesta sul doppio di quello che ci si lascia in una giornata, e lì quel che arriva la sera pareggia quel che se n’è andato. E il gruppo si ricorda in pratica gli ultimi due giorni: il deposito di ieri pesa la metà di quello di oggi, quello di tre sere fa un ottavo.
Detta così sembra una perdita, ed è invece la cosa più preziosa dell’algoritmo. Senza evaporazione la memoria del gruppo è definitiva: la prima strada scoperta per caso resta la più marcata per sempre, e nessuna formica avrà mai occasione di scoprire quella dietro l’angolo. All’estremo opposto, se ogni sera sparisse tutto quello che c’era prima, la mattina resterebbe soltanto il segno del giorno appena finito: niente si accumula più, e la colonia ricomincia ogni volta quasi da capo. A metà per sera la memoria è un ricordo che va tenuto vivo per restare. Il gruppo dimentica, e dimenticando continua a guardarsi attorno.
L’aggiornamento della traccia, nella convenzione oggi standard, è
dove \(\rho\) è il tasso di evaporazione: la frazione di feromone che sparisce a ogni ciclo, indipendentemente da quello che le formiche stanno facendo. (Due avvertenze di notazione. Nell’articolo del 1996 la stessa lettera indica la persistenza, e l’aggiornamento compare come \(\tau \leftarrow \rho\,\tau + \Delta\tau\), con \(1-\rho\) a fare l’evaporazione: è la stessa legge scritta dall’altro verso, e la letteratura successiva ha invertito la convenzione. Inoltre \(\rho\) è la terza cosa che questa lettera indica nel capitolo, dopo la densità dello stormo e la correlazione fra votanti: sono notazioni consolidate nei rispettivi campi, e qui vale quella locale.)
Srotolando la ricorsione si vede che cosa sia davvero la traccia:
cioè una somma della qualità recente di quell’arco con pesi che decadono esponenzialmente (una media mobile esponenziale moltiplicata per \(1/\rho\), che è la somma dei pesi: per questo il punto fisso vale \(\Delta/\rho\) e non \(\Delta\)); il primo addendo è la traccia iniziale, una costante piccola e positiva uguale su tutti gli archi, che si spegne da sé nei primi cicli. Due conseguenze quantitative. La prima: la traccia non diverge. Se un arco riceve un deposito costante \(\Delta\) a ogni ciclo, la serie geometrica converge al punto fisso \(\tau^{\ast} = \Delta/\rho\), che con \(\rho = 0{,}5\) vale il doppio di un singolo deposito. La seconda: la somma dei pesi è \(1/\rho\), quindi \(1/\rho\) è l’orizzonte di memoria in cicli. Con \(\rho\) vicino a zero la colonia ricorda tutto e si fossilizza sul primo ottimo locale; con \(\rho\) vicino a uno dimentica a ogni giro e le formiche tornano a essere golose e scorrelate. Il valore che gli autori trovano migliore per questa variante sta esattamente in mezzo, \(\rho = 0{,}5\) (l’unico numero che vale lo stesso nelle due convenzioni, appunto perché sta in mezzo), cioè un orizzonte di due cicli; e la ragione che ne danno è la migliore descrizione in una riga del compromesso esplorazione-sfruttamento: l’algoritmo ha bisogno di poter dimenticare parte dell’esperienza passata per sfruttare l’informazione globale che sta arrivando adesso.
La memoria non sta negli individui#
Adesso il punto che fa di uno sciame un sistema multi-agente, e non soltanto un metodo di ottimizzazione. Le formiche artificiali non si scambiano un solo messaggio. Non si conoscono, non si nominano, non sanno nemmeno in quante sono. Tutto quello che una formica sa delle altre lo legge per terra: la loro esperienza è diventata una proprietà fisica dell’ambiente, e la traccia sopravvive alle singole formiche che l’hanno lasciata.
Gli autori lo dicono in una frase che potrebbe stare in un manuale di sistemi distribuiti: nell’Ant System le formiche comunicano modificando una struttura dati globale. È la forma della lavagna condivisa di Hearsay-II, incontrata nella sezione sulle topologie, ed è la stigmergia: il coordinamento attraverso le tracce lasciate in uno spazio comune invece che attraverso messaggi diretti. E della lavagna tornano i pregi e i difetti. Aggiungere una formica non obbliga a modificare nessun’altra, perché nessuna sa dell’esistenza delle altre. Al centro c’è qualcosa che conserva e non qualcuno che decide. E si perde per strada chi ha fatto che cosa, perché il feromone su una strada è un numero, e un numero non dice chi ce l’ha messo.
La conseguenza fino a oggi è meno metaforica di quanto sembri. Una squadra di agenti che si coordina lasciando file in una cartella condivisa, o note in un documento che tutti possono leggere e riscrivere, sta facendo esattamente questo: non si scrivono messaggi, si modifica uno spazio comune e si reagisce a come lo si trova. Cambia la taglia (il feromone è un numero, una nota è un paragrafo) ma i problemi da risolvere sono gli stessi: che cosa succede se due scrivono insieme, come si tiene traccia di chi ha scritto che cosa, e che cosa fa dimenticare allo spazio comune ciò che non serve più. Le formiche quest’ultima cosa ce l’hanno per costruzione; una cartella di file cresce e basta.
Lo sciame di particelle#
Il secondo classico del filone nasce da tutt’altra parte, e la sua origine riporta dritti allo stormo dell’apertura. Nel 1995, alla International Conference on Neural Networks di Perth, James Kennedy e Russell Eberhart presentano la particle swarm optimization [KE95]. Chi sono i due autori spiega già mezza storia: uno psicologo sociale e un ingegnere elettrotecnico. Erano partiti provando a simulare uno stormo, ispirandosi ai boids di Reynolds [Rey87] e ai modelli di volo coordinato di Heppner e Grenander, e hanno scoperto che quel giocattolo, tolti i pezzi giusti, risolveva problemi.
Il racconto delle amputazioni è la parte istruttiva. Via la «pazzia», cioè il rumore aggiunto a mano per rendere il volo credibile: non serviva. Via l’allineamento con il vicino più prossimo (ogni agente copiava la velocità del compagno più vicino, che è l’allineamento dei boids ridotto a un solo vicino): senza, riportano gli autori, l’ottimizzazione va perfino un po’ più in fretta, e quello che resta è uno sciame, non più uno stormo. Restano due sole attrazioni: verso il punto migliore che quella particella ha trovato finora, e verso il punto migliore che ha trovato il gruppo.
Un gruppo di persone cerca il punto più basso di una valle nella nebbia. Ognuno vede solo dove mette i piedi, e può misurare la quota lì dove si trova. Nessuno ha la mappa.
Ciascuno si ricorda una cosa sola: il punto più basso in cui lui è passato. E ne sente una sola: il punto più basso in cui è passato qualcuno, gridato a tutti. (Se invece ciascuno sentisse soltanto i due compagni che gli stanno accanto, la notizia passerebbe di bocca in bocca e arriverebbe più tardi.) A ogni passo tira un po’ verso il proprio ricordo e un po’ verso quello del gruppo, e quanto sia quel «po’» lo decide il caso: certe volte il richiamo lo porta appena oltre il punto, certe volte lo lascia a mezza strada, e in media lo porta proprio lì. E un po’ tira dritto per dove stava già andando, perché ha una sua velocità e non si ferma di colpo.
Quest’ultima cosa sembra un dettaglio ed è quella che fa funzionare tutto. Se uno andasse solo dove è tirato, si poserebbe sul punto migliore conosciuto insieme a tutti gli altri: più gli si avvicina, più corto diventa il richiamo, finché non lo muove più. Ma siccome arriva lanciato, lo supera, va a guardare un po’ più in là, e ogni tanto scopre che più in là si scende ancora. Gli autori hanno provato a togliere questa inerzia e il metodo ha smesso di trovare i punti più bassi: quelli buoni non stanno dove il gruppo sta già puntando, stanno appena oltre.
Ogni particella \(i\) è una coppia posizione-velocità \((\mathbf{x}_i, \mathbf{v}_i)\) nello spazio delle soluzioni, e sono vettori: il grassetto qui non è decorazione, perché tutto ciò che segue si applica componente per componente. L’aggiornamento è di due righe, ripetute:
dove \(\mathbf{p}_i\) è la posizione migliore visitata dalla particella \(i\) (il termine cognitivo), \(\mathbf{g}\) la migliore visitata dall’intero sciame (il termine sociale), \(\mathbf{r}_1\) e \(\mathbf{r}_2\) sono vettori di numeri casuali uniformi in \([0,1]\) estratti daccapo a ogni passo, \(\odot\) è il prodotto componente per componente, mentre \(c_1\), \(c_2\) e l’inerzia \(w\) sono scalari che dosano le tre spinte. I tre addendi sono, nell’ordine, dove stavo andando, dove sono stato meglio io, dove è stato meglio il gruppo.
Due precisazioni storiche. Nella formulazione del 1995 il peso \(w\) non c’è: la velocità precedente entra con coefficiente unitario, e l’inerzia come parametro regolabile la introducono Shi ed Eberhart nel 1998 [SE98], perché \(w\) grande favorisce l’esplorazione e \(w\) piccolo la convergenza. E il valore originale \(c_1 = c_2 = 2\) non è arbitrario: moltiplicando per \(2\) un numero uniforme in \([0,1]\) si ottiene un fattore di media \(1\), così che ciascuna delle due spinte, in media, porti la particella esattamente sul proprio attrattore, e quindi la faccia sorpassare circa una volta su due. Il sorpasso è deliberato: gli autori riportano che togliendo il termine di velocità precedente, che nel 1995 chiamano momentum (cioè sostituendo la velocità invece di correggerla), l’algoritmo diventa inefficace nel trovare gli ottimi globali. È la stessa ragione dell’evaporazione delle formiche, in veste meccanica: un sistema che va solo dove è già andato bene smette di cercare.
La stabilità ha una risposta chiusa [CK02]. Con \(\varphi = c_1 + c_2 > 4\) e il fattore di costrizione
l’aggiornamento \(\mathbf{v}_i \leftarrow \chi\,[\mathbf{v}_i + c_1\mathbf{r}_1 \odot (\mathbf{p}_i - \mathbf{x}_i) + c_2\mathbf{r}_2 \odot (\mathbf{g} - \mathbf{x}_i)]\) tiene le traiettorie limitate e le fa convergere, nel modello semplificato che l’analisi studia (attrattori fermi, niente sorteggio), a un punto fra \(\mathbf{p}_i\) e \(\mathbf{g}\), che non è per forza un ottimo. Con \(\varphi = 4{,}1\) si ha \(\chi \approx 0{,}7298\), cioè \(w \approx 0{,}73\) e \(c_1 = c_2 = 2{,}05\,\chi \approx 1{,}50\); con \(w = 1\) e senza costrizione le velocità crescono invece senza limite.
Il termine sociale, infine, dipende da chi ascolta chi. Con \(\mathbf{g}\) unico per tutto lo sciame ogni particella legge la stessa memoria, come attorno a una lavagna; con il migliore \(\mathbf{l}_i\) del solo vicinato di \(i\) (per esempio le due particelle adiacenti su un anello) l’informazione si propaga a velocità finita. Più collegamenti fanno convergere prima, senza per questo trovare ottimi migliori [KM02]: la topologia del vicinato è un parametro di progetto, ed è la tesi del capitolo dentro un algoritmo.
Rimescolare invece di muoversi: gli algoritmi genetici#
Formiche e particelle si spostano: c’è uno spazio, e ogni individuo ha una posizione che aggiorna. La terza famiglia di questa cassetta degli attrezzi rinuncia anche a quello, e cambia il verbo. Gli individui non si muovono: si riproducono.
Devi riempire uno zaino scegliendo fra venti oggetti, ognuno con un peso e un valore, senza superare il limite di carico. Qui non c’è nessuna pendenza da seguire: una soluzione è un elenco di sì e no, e un elenco non ha un «poco più a destra».
Un algoritmo genetico parte da una popolazione di zaini riempiti a caso, quasi tutti mediocri, e ripete tre gesti che vengono dalla biologia.
Selezione. Chi vale di più ha più probabilità di fare figli. Il modo più semplice è il torneo: si pescano due individui a caso e passa il migliore.
Incrocio. Da due genitori si fa un figlio prendendo il primo pezzo dell’elenco dall’uno e il resto dall’altro. È il gesto che le formiche e le particelle non hanno: loro si spostano, questi si mescolano.
Mutazione. Ogni tanto, a caso, si ribalta una scelta: un oggetto che c’era esce, uno che non c’era entra. Serve a non restare prigionieri del materiale genetico di partenza, ed è la stessa funzione dell’evaporazione nelle formiche e dell’inerzia nelle particelle.
Più una cautela che dalla biologia non viene: il migliore di ogni generazione passa alla successiva così com’è. Senza, la generazione nuova può venire peggiore della vecchia, perché incrocio e mutazione rompono anche quello che funzionava.
Una popolazione, poi, permette di chiedere un’altra cosa ancora: non un solo zaino migliore, ma tutta la fila dei compromessi, il più prezioso per ogni peso che sei disposto a portare.
L’incrocio nasconde una scommessa, ed è il punto in cui questi algoritmi funzionano o falliscono: si assume che una buona soluzione sia fatta di buoni pezzi, e che i pezzi di due soluzioni decenti, mescolati, possano darne una migliore. Sullo zaino regge (un buon gruppo di oggetti resta buono accanto a un altro). Dove il valore dipende da tutte le scelte insieme, e spezzare l’elenco distrugge il senso di tutte e due le metà, l’incrocio è solo rumore costoso.
Il quadro lo fissa John Holland [Hol75] nel 1975. Una soluzione candidata è codificata come una stringa (il genotipo, nel caso più semplice binaria) e la funzione obiettivo diventa la fitness. A ogni generazione si applicano tre operatori:
selezione, che campiona i genitori con probabilità crescente nella fitness (proporzionale alla fitness, cioè la «roulette», oppure per torneo, che è più robusto perché dipende solo dall’ordine e non dalla scala dei valori);
crossover, che ricombina due genotipi (a un punto, a due punti, uniforme);
mutazione, che perturba ogni gene con probabilità piccola.
Si aggiunge quasi sempre l’elitismo, cioè il trasferimento diretto del migliore alla generazione successiva, senza il quale la ricerca può peggiorare da una generazione all’altra.
La giustificazione classica dell’incrocio è l’ipotesi dei building block: schemi parziali corti e buoni verrebbero propagati e combinati. Il teorema su cui poggia è quello degli schemi di Holland. Uno schema \(H\) è un insieme di genotipi che coincidono in alcune posizioni fissate (per esempio \(1{*}{*}0{*}\)). Siano \(m(H,t)\) il numero di individui della generazione \(t\) che vi appartengono, \(f(H)\) la loro fitness media, \(\bar{f}\) quella della popolazione, \(\delta(H)\) la distanza fra la prima e l’ultima posizione fissata, \(o(H)\) il numero di posizioni fissate, \(\ell\) la lunghezza del genotipo, e infine \(p_c\) e \(p_m\) le probabilità di incrocio e di mutazione. Allora vale la disuguaglianza:
Gli schemi corti, di ordine basso e sopra la media crescono di generazione in generazione. Ma è una disuguaglianza sul valore atteso del singolo schema, e non dice niente su come i pezzi si combinino fra loro: per questo i building block restano un’argomentazione euristica più che un teorema, e il loro limite ha un nome preciso, epistasi: quando il contributo di un gene dipende fortemente dagli altri, spezzare il genotipo distrugge proprio l’informazione che si voleva trasmettere, e il crossover degrada a mutazione macroscopica. La codifica fa quindi parte del progetto dell’algoritmo, perché decide quali pezzi sono separabili.
Rispetto alle altre due famiglie della sezione, la differenza operativa è che lo spazio non deve avere una metrica. PSO ha bisogno di sommare posizioni e velocità, quindi di uno spazio vettoriale; un algoritmo genetico ha bisogno solo di saper ricombinare e perturbare, e questo lo rende applicabile a permutazioni, alberi, grafi e programmi. Il caso in cui l’individuo è un programma si chiama programmazione genetica.
Un secondo vantaggio distintivo, che né il gradiente né le altre metaeuristiche danno gratis, è l’ottimizzazione multi-obiettivo. Poiché la popolazione è un insieme e non un punto, la si può far convergere non su un ottimo ma sull’intero fronte di Pareto dei compromessi fra obiettivi in conflitto (accuratezza contro latenza, prestazione contro consumo): è ciò che fa NSGA-II [DPAM02], ordinando la popolazione per dominanza invece che per un punteggio scalare. Con un metodo a singolo punto bisognerebbe fissare i pesi degli obiettivi in anticipo e rilanciare la ricerca per ogni compromesso.
Lo zaino è il tipo di problema su cui il metodo solito, quello che cerca il punto più basso sentendo da che parte scende il terreno (la discesa del gradiente della matematica, con cui si addestrano le reti), non ha proprio dove appoggiarsi. Nel codice che segue i venti oggetti, con i loro pesi e i loro valori, sono sorteggiati una volta sola e poi restano quelli; e siccome sono soltanto venti possiamo permetterci il lusso di conoscere la risposta vera, provando tutte le combinazioni una per una. Così l’algoritmo si può giudicare invece che ammirare.
import numpy as np
from itertools import product

# --- l'istanza: 20 oggetti, uno zaino che regge 60 kg (fissata una volta) ---
istanza = np.random.default_rng(7)
N, CAPIENZA = 20, 60
peso   = istanza.integers(4, 20, N)
valore = istanza.integers(5, 40, N)

def bonta(pop):                      # quanto vale uno zaino; 0 se sfonda il limite
    return np.where(pop @ peso <= CAPIENZA, pop @ valore, 0)

def genetico(seme, POP=60, GEN=80, P_MUT=0.03):
    rng = np.random.default_rng(seme)
    pop = rng.integers(0, 2, size=(POP, N))          # una popolazione di zaini a caso
    for _ in range(GEN):
        f = bonta(pop)
        elite = pop[f.argmax()].copy()               # il migliore non si perde mai
        s = rng.integers(0, POP, size=(POP, 2))      # selezione: torneo a due
        genitori = np.where((f[s[:, 0]] >= f[s[:, 1]])[:, None], pop[s[:, 0]], pop[s[:, 1]])
        taglio = rng.integers(1, N, size=(POP, 1))   # incrocio a un punto:
        maschera = np.arange(N)[None, :] < taglio    # meta' da un genitore, meta' dall'altro
        figli = np.where(maschera, genitori, genitori[rng.permutation(POP)])
        figli ^= (rng.random((POP, N)) < P_MUT)      # mutazione: qualche bit ribaltato
        figli[0] = elite
        pop = figli
    return int(bonta(pop).max())

esiti = [genetico(s) for s in range(10)]
ottimo = max(sum(v for v, b in zip(valore, c) if b)
             for c in product([0, 1], repeat=N)
             if sum(p for p, b in zip(peso, c) if b) <= CAPIENZA)

# La stessa risposta con la programmazione dinamica: migliore[c] e' il valore
# piu' alto che si ottiene con capienza c usando gli oggetti visti finora.
migliore = [0] * (CAPIENZA + 1)
for p, v in zip(peso, valore):
    for c in range(CAPIENZA, p - 1, -1):
        migliore[c] = max(migliore[c], migliore[c - p] + v)

print("dieci esecuzioni:", esiti)
print("ottimo vero (forza bruta su 2^20 = 1 048 576 combinazioni):", ottimo)
print("ottimo con la programmazione dinamica:", migliore[CAPIENZA])
print(f"quante volte lo trova: {esiti.count(ottimo)}/10, con 4800 zaini provati su un milione")
dieci esecuzioni: [228, 228, 228, 228, 224, 228, 228, 228, 228, 224]
ottimo vero (forza bruta su 2^20 = 1 048 576 combinazioni): 228
ottimo con la programmazione dinamica: 228
quante volte lo trova: 8/10, con 4800 zaini provati su un milione
Il risultato dice due cose insieme, e vanno tenute insieme. La prima è che l’algoritmo prova quattromilaottocento zaini (sessanta per generazione, per ottanta generazioni) su un milione e passa di combinazioni possibili, cioè meno di mezzo per cento; e con quelli arriva otto volte su dieci alla risposta esatta, mentre le altre due volte si ferma a duecentoventiquattro contro duecentoventotto, cioè meno del due per cento sotto. Per un problema in cui non esiste alcuna pendenza da seguire, è molto. La seconda è che quel «otto volte su dieci» non si può eliminare. Un algoritmo genetico non dà garanzie, e soprattutto non dice quanto gli è mancato: qui lo sappiamo perché lo zaino ha anche un algoritmo esatto e rapido, la programmazione dinamica, che con pesi interi costa dell’ordine di \(n \cdot W\) operazioni (\(n\) oggetti, \(W\) la capienza: qui \(20 \cdot 60 = 1200\)) e arriva anch’essa a 228. Lo zaino serve qui proprio da banco di prova con la risposta nota; un algoritmo genetico si usa dove una scorciatoia del genere non c’è, e lì la risposta trovata ha esattamente lo stesso aspetto, giusta o sbagliata che sia.
Nel machine learning questa famiglia compare in due punti. Il primo è la ricerca di architetture, dove le due strade possibili si confondono spesso. La rete base di EfficientNet, ricordata fra le architetture storiche del deep learning, viene da una ricerca automatica multi-obiettivo guidata dal reinforcement learning, non dall’evoluzione. L’evoluzione è l’altra strada principale, e il suo esemplare è AmoebaNet [RAHL19], dove le architetture mutano e le migliori sopravvivono, con una selezione a torneo che scarta anche le più vecchie. Quell’algoritmo l’incrocio non ce l’ha, ed è coerente con la scommessa dichiarata poche righe fa: in un’architettura i pezzi non sono separabili, perché un blocco che funziona bene in una rete può essere pessimo in un’altra, quindi la scommessa non reggerebbe e l’algoritmo si limita a non farla. Il secondo punto è ovunque l’obiettivo non sia derivabile: scegliere iperparametri discreti, potare una rete decidendo quali pezzi togliere, ottimizzare una pipeline di preelaborazione.
Perché non usare il gradiente#
Sia le formiche sia le particelle hanno una proprietà che va guardata in faccia: non usano mai la derivata della funzione da minimizzare, cioè la sua pendenza. Vedono solo il suo valore, in un punto alla volta. La sezione di matematica su analisi e ottimizzazione ha spiegato la discesa del gradiente (scendere seguendo quella pendenza), che è il metodo con cui si addestrano le reti neurali; qui abbiamo un’altra famiglia, e il confronto va fatto con cura, perché è il punto in cui questi metodi vengono spesso presentati senza il loro costo.
La differenza è quella fra sentire la pendenza sotto i piedi e doverla scoprire provando. Chi sente la pendenza sa subito da che parte si scende, e fa un passo nella direzione giusta. Chi non la sente deve fare un passo a caso, misurare la quota dove è arrivato, e capire dopo se era la direzione giusta.
Su una collina liscia il primo arriva in fondo in una manciata di passi e il secondo in moltissimi: non c’è partita. Il secondo vince in due situazioni, però. La prima è un terreno pieno di buche: chi segue la pendenza finisce nella buca più vicina e lì resta, convinto di essere in fondo, mentre di un gruppo sparso per la valle è probabile che qualcuno sia partito vicino a quella giusta. La seconda è quando la pendenza non si può proprio sentire: se il «terreno» è l’ordine in cui visitare venti città, o quale macchinario assegnare a quale lavorazione, non esiste nessuna direzione in cui muoversi di un millimetro, ed esiste solo provare.
C’è però una ragione per cui quel «moltissimi» diventa «impossibile» appena le cose da decidere sono tante. Chi sente la pendenza la sente in tutte le direzioni insieme: che siano due o un milione, un piede appoggiato gli dice per ognuna se si sale o se si scende. Chi non la sente le deve provare a una a una, e con un milione di direzioni gli servono almeno un milione di passi solo per sapere da che parte andare: la giornata finisce prima.
E dove vince non promette niente. Quando si ferma, non sa dire se quello è il punto più basso della valle o soltanto il più basso che ha visto.
Formiche, sciami e algoritmi genetici sono metodi senza derivate: interrogano la funzione obiettivo come una scatola nera e non ne richiedono né differenziabilità né continuità. Il loro dominio proprio è dove il gradiente non c’è, non si calcola o non informa: funzioni non differenziabili, spazi combinatori (il commesso viaggiatore non ha un gradiente: ha permutazioni), valutazioni rumorose o prodotte da una simulazione, e paesaggi molto multimodali dove il gradiente è informativo solo dentro il bacino in cui si nasce.
Il prezzo si paga in valutazioni della funzione obiettivo, e in alta dimensione diventa proibitivo, per una ragione precisa. Con la retropropagazione una sola passata all’indietro produce tutte le \(d\) derivate parziali di \(\mathcal{L}\) rispetto ai parametri \(\theta\), a un costo dell’ordine di una passata in avanti: l’informazione per passo cresce con \(d\) mentre il costo no. Un metodo senza derivate deve invece stimare una direzione utile a partire da valori scalari: con le differenze finite servono \(d+1\) valutazioni per ogni passo, e per i metodi che esplorano direzioni casuali Nesterov e Spokoiny dimostrano, su funzioni convesse, un numero di iterazioni fino a \(d\) volte quello del metodo del gradiente [NS17]. È il motivo per cui nessuno addestra con uno sciame una rete da centinaia di milioni di parametri, e insieme il motivo per cui gli sciami restano vivi dove \(d\) è piccolo e ogni valutazione è cara (taratura di iperparametri, progettazione ingegneristica, instradamento, schedulazione). Di questi metodi, poi, non esiste una garanzia di convergenza all’ottimo globale in tempo utile: per alcune varianti delle formiche si dimostra che l’ottimo prima o poi viene trovato, ma senza un limite sul tempo [StutzleD02]. Sono euristiche, funzionano bene su molte istanze e nessuno può promettere che funzionino sulla prossima, e presentarli come un’alternativa generale alla discesa del gradiente non è giustificato.
Uno sciame in venti righe#
Il modo più rapido di crederci è farlo girare. La funzione di prova è la Rastrigin, \(f(\mathbf{x}) = 10\,d + \sum_{i=1}^{d}\big(x_i^2 - 10\cos 2\pi x_i\big)\) sul quadrato di lato da \(-5{,}12\) a \(5{,}12\), qui con \(d = 2\): una conca larghissima e regolare, che scende dolcemente verso il centro, sulla quale qualcuno ha passato una grattugia, cioè un’ondulazione fitta e ordinata che scava una fossetta attorno a ogni coppia di numeri interi. Il fondo vero è nell’origine e vale zero; di fossette ce ne sono \(11^2 = 121\), e dal fondo di ognuna tutte le direzioni salgono. È il paesaggio fatto apposta per mettere in crisi chi segue la pendenza.
import numpy as np


# Rastrigin in due dimensioni: minimo globale in (0, 0), dove vale 0.
# Tutt'attorno un reticolo di conche locali, attorno a ogni coppia di interi.
def rastrigin(X):
    return 10 * X.shape[1] + np.sum(X**2 - 10 * np.cos(2 * np.pi * X), axis=1)


rng = np.random.default_rng(7)     # seme fisso: il risultato e' riproducibile
n, d = 30, 2                       # trenta particelle in due dimensioni
w, c1, c2 = 0.73, 1.50, 1.50       # inerzia, spinta personale, spinta sociale

X = rng.uniform(-5.12, 5.12, (n, d))       # posizioni iniziali, sparse a caso
V = rng.uniform(-1.0, 1.0, (n, d))         # velocita' iniziali
P, fP = X.copy(), rastrigin(X)             # miglior punto di ogni particella
g = int(np.argmin(fP))                     # indice del migliore del gruppo

for t in range(1, 61):
    r1, r2 = rng.random((n, d)), rng.random((n, d))
    V = w * V + c1 * r1 * (P - X) + c2 * r2 * (P[g] - X)
    X = np.clip(X + V, -5.12, 5.12)        # nessuno esce dal dominio
    f = rastrigin(X)
    meglio = f < fP                        # chi ha battuto il proprio record
    P[meglio], fP[meglio] = X[meglio], f[meglio]
    g = int(np.argmin(fP))
    if t % 10 == 0:
        print(f"iterazione {t:3d}   f = {fP[g]:.6f}   "
              f"x = ({P[g][0]:+.4f}, {P[g][1]:+.4f})")
iterazione  10   f = 1.948778   x = (-0.9332, +0.0325)
iterazione  20   f = 0.000262   x = (+0.0008, -0.0008)
iterazione  30   f = 0.000262   x = (+0.0008, -0.0008)
iterazione  40   f = 0.000262   x = (+0.0008, -0.0008)
iterazione  50   f = 0.000213   x = (+0.0010, -0.0004)
iterazione  60   f = 0.000168   x = (+0.0009, +0.0000)
La riga da guardare è la prima. Alla decima iterazione il punto migliore che lo sciame conosce sta dentro la fossetta accanto, quella scavata attorno al punto di coordinate meno uno e zero, il cui fondo vale uno invece di zero (e nel punto trovato la funzione vale poco meno di due, perché lo sciame in fondo a quella fossetta non c’è nemmeno arrivato). Un metodo che segue la pendenza, partito da lì, scivolerebbe in fondo a quella fossetta e ci resterebbe per sempre, perché dal fondo tutte le direzioni salgono. Lo sciame ne esce entro la ventesima, e ne esce senza alcuna informazione sulla pendenza: una particella era semplicemente arrivata più in là del punto migliore conosciuto, e più in là si scendeva. Dalla ventesima in poi il gruppo si limita a rifinire un valore già piccolissimo.
Quanto costa? Ogni giro lo sciame misura la quota nei trenta punti in cui si trovano le sue particelle; i giri sono sessanta, più la misura iniziale, quindi in tutto milleottocentotrenta misure. In due dimensioni sono niente. In mille dimensioni sarebbero ancora milleottocentotrenta, e non basterebbero: per capire da che parte si scende servirebbero almeno mille misure a ogni passo, cioè più di metà del bilancio per un passo solo.
E il risultato non è garantito. Il programma dello sciame parte da posizioni sorteggiate, e ripetendolo con sorteggi diversi le cose vanno diversamente. Se lo si rifà trecento volte, cambiando ogni volta soltanto il sorteggio, lo sciame arriva al fondo vero in duecentosettantasette casi su trecento: poco più di nove volte su dieci, non sempre.
Il confronto che si legge in giro, e quello onesto#
Adesso il paragone con il metodo che segue la pendenza. Qui il confronto si fa spesso senza contare la spesa: fatta partire da un solo punto preso a caso, una discesa lungo la pendenza arriva al fondo vero due volte su trecento; nelle altre duecentonovantotto si ferma ordinatamente nella fossetta in cui è nata. Duecentosettantasette contro due: un confronto splendido e scorretto, perché schiera trenta esploratori contro uno solo, e milleottocentotrenta misure contro sessanta passi.
Rifacciamolo a parità di esploratori e di spesa, come chiede la regola prudente della sezione sul costo del coordinamento. Alla discesa si danno gli stessi trenta punti iniziali dello sciame, da ciascuno si fanno sessanta passi, e si tiene il migliore dei trenta risultati: sono milleottocento calcoli della pendenza, quante le misure dello sciame. Il passo è \(0{,}0025\), metà del limite oltre il quale la discesa diverge (in fondo a una fossetta la curvatura vale \(2 + 40\pi^2 \approx 397\), e il limite è \(2\) diviso la curvatura, poco più di cinque millesimi), e con quel passo bastano poche decine di passi per arrivare in fondo alla fossetta in cui si è nati. Allora la discesa arriva al fondo vero sessantasette volte su trecento, cioè poco più di una su cinque, contro le nove su dieci dello sciame. Lo sciame vince ancora, e vince nettamente, ma vince circa quattro volte tanto e non centoquaranta.
Il confronto è perfino generoso verso la discesa, perché le regala la pendenza. In un problema in cui la funzione è una scatola nera la pendenza va stimata provando, e in due dimensioni costa tre misure per passo: con la stessa spesa dello sciame la discesa può fare venti passi da ciascun punto, e il risultato resta sessantasette su trecento. Finché la discesa arriva in fondo alla fossetta in cui è nata, il numero e la lunghezza dei passi non cambiano il numero di prove riuscite; cambiano soltanto quanto si spende.
E si può capire da dove venga quel sessantasette, il che è più interessante del numero. Le partenze singole in tutto sono novemila, cioè trecento prove per trenta punti ciascuna, e ne riescono settantadue: otto su mille, che è la misura della fossetta centrale. È larga circa uno per uno dentro un quadrato di lato dieci e un quarto, quindi occupa poco meno dell’uno per cento dell’area, e nascere lì dentro è appunto un tiro di dado che va bene una volta ogni cento e rotti.
Ogni punto iniziale, insomma, è un biglietto della lotteria che vince otto volte su mille, e ogni prova ne compra trenta. Attenzione a non sommarli: trenta per otto farebbe ventiquattro su cento, ma una prova in cui due biglietti vincono resta una prova riuscita, e nel conto va contata una volta sola. La domanda giusta è al contrario: quante prove perdono tutti e trenta i biglietti? Un biglietto perde novecentonovantadue volte su mille, e perché perdano tutti e trenta bisogna moltiplicare quel numero per sé stesso trenta volte: viene poco meno di ottanta su cento. Le prove che vanno a segno sono il resto, poco più di una su cinque, cioè sessantaquattro su trecento. In formula, con \(p = 0{,}008\) la probabilità che una partenza riesca, una prova da trenta partenze riesce con probabilità \(1 - (1-p)^{30} \approx 0{,}214\). Ne escono sessantasette.
Il conto si controlla sui dati, per escludere un’altra storia che dia per caso lo stesso numero. Contiamo i sorteggi che avevano almeno un punto di partenza dentro la fossetta centrale: sono sessantasei, e riescono tutti e sessantasei. Le prove riuscite in tutto sono sessantasette, quindi una sola ce l’ha fatta partendo interamente da fuori. Nascere nel posto giusto, qui, è sempre bastato e quasi sempre è servito. La discesa con trenta ripartenze non ha imparato niente in più di quella a partenza singola: ha soltanto avuto trenta biglietti invece di uno.
Tutti questi numeri escono da un programma solo, che rifà le trecento prove per intero, con gli stessi sorteggi e la stessa soglia, che qui smette di essere sottintesa: «arrivare al fondo vero» vuol dire scendere sotto un centesimo.
# Le trecento prove del confronto: semi 0..299. Ogni prova usa gli STESSI
# trenta punti iniziali per lo sciame e per le trenta ripartenze della
# discesa; la rastrigin e' quella definita sopra.
def sciame(X0, rng, anello=False):
    n, d = X0.shape
    w, c1, c2 = 0.73, 1.50, 1.50
    X = X0.copy()
    V = rng.uniform(-1.0, 1.0, (n, d))
    P, fP = X.copy(), rastrigin(X)
    for t in range(1, 61):
        if anello:   # sente soltanto i due vicini di posto, e se stesso
            terne = np.stack([np.roll(fP, 1), fP, np.roll(fP, -1)])
            guida = P[(np.arange(n) + np.argmin(terne, axis=0) - 1) % n]
        else:        # tutti sentono il migliore dell'intero gruppo
            guida = P[int(np.argmin(fP))]
        r1, r2 = rng.random((n, d)), rng.random((n, d))
        V = w * V + c1 * r1 * (P - X) + c2 * r2 * (guida - X)
        X = np.clip(X + V, -5.12, 5.12)
        f = rastrigin(X)
        meglio = f < fP
        P[meglio], fP[meglio] = X[meglio], f[meglio]
    return fP.min()


def discese(X0, passo=0.0025, passi=60):
    X = X0.copy()
    for _ in range(passi):
        G = 2 * X + 20 * np.pi * np.sin(2 * np.pi * X)   # gradiente esatto
        X = np.clip(X - passo * G, -5.12, 5.12)
    return rastrigin(X)


s_ok = a_ok = d1_ok = d30_ok = d20_ok = singole_ok = conca = conca_ok = 0
for seme in range(300):
    rng = np.random.default_rng(seme)
    X0 = rng.uniform(-5.12, 5.12, (30, 2))
    stato = rng.bit_generator.state   # l'anello avra' gli stessi sorteggi
    s_ok += sciame(X0, rng) < 1e-2            # la soglia del «fondo vero»
    rng.bit_generator.state = stato
    a_ok += sciame(X0, rng, anello=True) < 1e-2
    f_disc = discese(X0)                      # 30 partenze x 60 passi
    d1_ok += f_disc[0] < 1e-2                 # partenza singola: il primo punto
    d30_ok += f_disc.min() < 1e-2             # il migliore delle trenta
    d20_ok += discese(X0, passi=20).min() < 1e-2
    singole_ok += int((f_disc < 1e-2).sum())  # tutte le 9000 partenze singole
    in_conca = np.all(np.abs(X0) < 0.5, axis=1).any()
    conca += in_conca
    conca_ok += in_conca and (f_disc.min() < 1e-2)

p = singole_ok / 9000
print(f"sciame, migliore del gruppo:    {s_ok} su 300")
print(f"sciame, vicini sull'anello:     {a_ok} su 300")
print(f"discesa, partenza singola:      {d1_ok} su 300")
print(f"discesa, trenta ripartenze:     {d30_ok} su 300")
print(f"  con venti passi invece di 60: {d20_ok} su 300")
print(f"partenze singole riuscite:      {singole_ok} su 9000")
print(f"prove nate in conca centrale:   {conca} (riuscite: {conca_ok})")
print(f"atteso dal conto dei biglietti: {round((1 - (1 - p) ** 30) * 300)} su 300")
sciame, migliore del gruppo:    277 su 300
sciame, vicini sull'anello:     191 su 300
discesa, partenza singola:      2 su 300
discesa, trenta ripartenze:     67 su 300
  con venti passi invece di 60: 67 su 300
partenze singole riuscite:      72 su 9000
prove nate in conca centrale:   66 (riuscite: 66)
atteso dal conto dei biglietti: 64 su 300
Il programma confronta anche due modi di far circolare, dentro lo sciame, la notizia del punto migliore. In quello usato fin qui ogni particella sente il migliore dell’intero gruppo, gridato a tutti; nell’altro le trenta particelle stanno in cerchio, e ciascuna sente soltanto le due che le stanno accanto. Con gli stessi sorteggi e gli stessi sessanta giri, lo sciame ad anello arriva al fondo vero 191 volte su 300 invece di 277: la notizia viaggia di vicino in vicino, e in sessanta giri non fa in tempo ad arrivare a tutti. Gli individui sono identici, cambia soltanto chi ascolta chi, e cambia quello che il gruppo trova: è la tesi degli storni, dentro un algoritmo. Più lento non vuol dire peggiore in assoluto, perché un collegamento più fitto fa convergere prima senza per questo trovare ottimi migliori [KM02]; a parità di giri, qui, si misura la velocità.
Un’ultima nota sui tre numeri in cima al programma, quelli che pesano le tre
spinte (tirare dritto per dove stavo andando, tornare dove sono stato meglio io,
andare dove è stato meglio il gruppo). Non sono i valori del 1995 ma quelli oggi
standard, e non sono stati trovati provando: vengono da un conto di Clerc e
Kennedy del 2002, il fattore di costrizione, che dice per quali valori la
velocità delle particelle non esplode. Il conto dà due numeri, uno per
l’inerzia e uno per le altre due spinte, che sono uguali fra loro: arrotondati,
sono lo 0.73 e i due 1.50 del programma. Con spinte troppo forti lo sciame si
sparpaglia e non torna più; con questi valori sta insieme da sé, e nessuno deve
tarare a mano l’ampiezza dei passi.
Venticinque agenti in un paese#
Gli sciami mettono molte unità stupide a risolvere un problema. Con i modelli di linguaggio si può fare una cosa che prima non si poteva: mettere molte unità non stupide a fare qualcosa che un problema di ottimizzazione non è, cioè comportarsi. Il lavoro di riferimento è quello di Park e colleghi del 2023 [POBrienC+23], che la sezione sulle architetture degli agenti ha già presentato parlando della memoria che dura: venticinque agenti in un paese simulato, ciascuno con un archivio di ricordi in linguaggio naturale. Il risultato più citato è un comportamento emerso, e conviene dire dove comincia l’emergenza: agli sperimentatori tocca una riga sola, mettere in testa a un agente l’intenzione di dare una festa di San Valentino, e da lì in poi nessuno instrada più niente. L’invito si propaga di bocca in bocca, e alla fine tredici agenti su venticinque ne sanno qualcosa e cinque si presentano.
Non ripetiamo l’architettura, che è già stata descritta lì: flusso di osservazioni, recupero, riflessione, pianificazione. La riflessione è il momento in cui l’agente si ferma, rilegge quello che gli è appena successo e ne ricava una conclusione più generale, che riscrive fra i propri ricordi. Il pezzo che regge tutto, e che è anche il più imitato senza capirlo, è la funzione di recupero a tre termini. Risponde alla domanda di qualunque memoria grande: fra diecimila ricordi, quali sono i pochi che vanno messi nel contesto adesso?
Sono i tre voti del bibliotecario che, nella sezione sulle architetture degli agenti, pescava dal diario le pagine giuste: quanto è recente il ricordo, quanto è importante, e quanto c’entra con quello che sto facendo. Nessuno dei tre basta da solo. Chi guarda solo l’orologio si ricorda l’ultima cosa successa; chi guarda solo l’importanza si ripete addosso sempre lo stesso trauma; chi guarda solo l’attinenza pesca frasi che somigliano alla domanda ma sono di sei mesi fa.
Prima di sommarli bisogna però saperli misurare, e la freschezza si misura così: ogni ora che passa il ricordo perde mezzo punto percentuale di freschezza, sempre lo stesso mezzo punto su quello che gli era rimasto (quindi cala in fretta all’inizio e poi sempre più piano). L’orologio, però, non parte da quando il ricordo è nato: parte dall’ultima volta che è stato ripescato, e così un fatto di sei mesi fa a cui hai ripensato ieri è fresco. Partendo da uno, dopo cinquanta ore resta 0,78 e dopo duecento 0,37.
Il guaio è sommare i tre criteri, perché sono misurati in unità diverse. L’importanza è un voto da 1 a 10 che l’agente si dà da sé; gli altri due sono numeri fra zero e uno. Facciamo il conto su tre ricordi in gara:
ricordo |
freschezza |
importanza |
pertinenza |
somma diretta |
|---|---|---|---|---|
A: di un’ora fa, molto attinente |
0,995 |
3 |
0,82 |
4,82 |
B: di duecento ore fa, drammatico |
0,367 |
8 |
0,44 |
8,81 |
C: di cinquanta ore fa, così così |
0,778 |
5 |
0,60 |
6,38 |
Sommandoli così vince B, poi C, poi A: esattamente l’ordine dell’importanza, e gli altri due criteri non hanno contato niente. Un voto da 1 a 10 schiaccia due numeri fra 0 e 1.
La cura è mettere le tre colonne sulla stessa scala prima di sommarle. In ogni colonna, il migliore dei tre prende 1, il peggiore prende 0, e quello di mezzo prende la frazione che gli spetta: sulla freschezza, per esempio, il migliore è A con 0,995 e il peggiore B con 0,367, quindi C, che sta a 0,778, ha percorso due terzi scarsi della distanza fra i due e prende 0,65.
ricordo |
freschezza |
importanza |
pertinenza |
somma |
|---|---|---|---|---|
A |
1 |
0 |
1 |
2,00 |
B |
0 |
1 |
0 |
1,00 |
C |
0,65 |
0,40 |
0,42 |
1,47 |
La classifica si è rovesciata: adesso vince A, il ricordo appena successo e attinente, e il drammatico e vecchio finisce ultimo. È la differenza fra un agente che ragiona su quello che sta succedendo e uno ossessionato dal proprio passato più intenso.
E questi voti dipendono dai concorrenti. Chi prende 1 lo prende perché è il migliore dei tre in gara, non perché valga 1 in assoluto: lo stesso ricordo, in un’altra terna, ne uscirebbe con un punteggio diverso.
Il punteggio di recupero è la somma di tre segnali,
dove \(e\) è un ricordo, \(q\) la situazione corrente e la tilde indica che ogni termine è stato riscalato con un min-max nell’intervallo \([0,1]\) prima della somma. Nel lavoro originale i tre pesi valgono tutti \(1\), il che rende la normalizzazione l’unico meccanismo che impedisce al termine con l’escursione più ampia di dominare: sommando direttamente un voto in \([1,10]\) e due grandezze in \([0,1]\), il voto decide da solo l’ordine di due ricordi ogni volta che le loro importanze distano più di due punti, perché le altre due grandezze insieme non arrivano a recuperarli. E poiché il riscalamento è relativo all’insieme dei candidati, il punteggio non è assoluto: lo stesso ricordo vale diversamente a seconda della compagnia.
I tre segnali. La recenza decade esponenzialmente nel tempo simulato trascorso dall’ultimo recupero di quella memoria, con fattore \(0{,}995\) per ora: l’emivita è \(\ln 0{,}5 / \ln 0{,}995 \approx 138\) ore, poco meno di sei giorni simulati, e il tempo caratteristico è all’incirca \(1/0{,}005 = 200\) ore (il valore esatto, \(-1/\ln 0{,}995\), è \(199{,}5\)). È la stessa forma dell’evaporazione del feromone, con un \(\rho\) molto più piccolo, e il paragone è istruttivo: la colonia dimentica in due cicli perché deve continuare a esplorare, un agente in duecento ore perché deve restare la stessa persona. La pertinenza (relevance) è la similarità del coseno fra l’embedding del ricordo e quello della query, cioè il recupero denso già visto nel RAG. L’importanza è l’unica anomala: non si calcola, si chiede al modello, che assegna alla memoria un voto di salienza da 1 a 10 nel momento in cui la scrive, con tutti i pregiudizi che ha su che cosa conti in una vita.
Sopra i tre segnali sta un quarto meccanismo, la riflessione, che non scatta a orario fisso, ma quando la somma delle importanze degli eventi recenti supera una soglia (150 nella loro implementazione, che nei loro esperimenti si traduce in due o tre riflessioni al giorno). La cadenza è quindi guidata dagli eventi e non dall’orologio: una giornata piatta non produce riflessioni, una densa ne produce diverse. L’agente si pone allora le domande più salienti sul proprio periodo recente, risponde con proposizioni astratte e le riscrive nel flusso come ricordi nuovi, con la loro importanza e la loro recenza. È una retroazione: le sintesi competono con le osservazioni grezze nel recupero successivo, e sopra le prime riflessioni se ne formano altre. Ne esce un albero di astrazioni costruito dal basso, ed è anche il punto delicato dell’architettura, perché un’inferenza sbagliata in basso diventa una premessa a tutti i livelli sopra.
Ciò che fa di Smallville un esperimento multi-agente, e non venticinque esperimenti su un agente, sono le tre misure di emergenza sociale del lavoro. La diffusione dell’informazione: quanti agenti conoscono un fatto seminato in uno solo (la festa passa da \(1\) a \(13\) agenti su \(25\) in due giorni simulati, una candidatura da \(1\) a \(8\)). La formazione di relazioni, sul grafo non orientato in cui un arco unisce due agenti che si conoscono a vicenda, con densità \(\operatorname{dens}(G) = 2|E| / \bigl(|V|(|V|-1)\bigr)\), che sale da \(0{,}167\) a \(0{,}74\). Il coordinamento: dei dodici invitati alla festa se ne presentano cinque. Le prime due misure si leggono intervistando gli agenti, e per questo gli autori riscontrano ogni risposta affermativa nell’archivio di ricordi dell’agente: su festa e candidatura nessuna era inventata, sulle conoscenze reciproche sei su 453 (l’1,3%).
Che cosa dimostra una simulazione di persone#
Le trascrizioni di questi esperimenti sono convincenti. Gli agenti si invitano, si ricordano di essersi conosciuti, si giustificano se arrivano tardi. Ma la tentazione di usare simulazioni del genere come evidenza sul comportamento umano è forte e, senza dati veri alle spalle, il salto non è consentito.
Il punto sta in una parola che gli autori usano con cura e che chi li cita spesso lascia cadere: gli agenti producono comportamenti credibili (believable), che non vuol dire fedeli. La valutazione di Park e colleghi misura proprio la credibilità, giudicata da persone che leggono le risposte degli agenti, e mostra che l’architettura completa batte le versioni a cui manca la memoria, la riflessione o la pianificazione, e perfino le risposte scritte da persone reclutate per immedesimarsi negli agenti; non misura quanto quei comportamenti somiglino a quelli di una popolazione reale. E una parte della credibilità viene dal modello di linguaggio stesso. Un modello addestrato su enormi quantità di testo umano è, per costruzione, una macchina per produrre continuazioni verosimili di testo umano; quando gli si chiede di comportarsi come una persona, il fatto che il risultato somigli a una persona è in buona parte la specifica, non una scoperta. Peggio: la nostra sensazione di aver visto qualcosa di vero cresce con la qualità del modello, cioè con la sua abilità a produrre testo convincente, che di per sé non dice nulla sulla verità. Le mani avanti se le mettono gli autori stessi, in una nota a piè di pagina: i loro agenti, scrivono, come i personaggi animati della Disney puntano a dare un senso di credibilità, ma non implicano una vera capacità di agire per conto proprio.
Credibile non vuol dire predittivo, ed è la solita distinzione fra somigliare e prevedere. Perché una simulazione dicesse qualcosa sulle società reali dovrebbe riprodurre non i singoli comportamenti verosimili, ma le distribuzioni di quei comportamenti: quante persone su venticinque davvero verrebbero alla festa, e in quali condizioni nessuna. Su questo non c’è nessuna garanzia, e ce ne sono anzi di contrarie: un modello di linguaggio riflette le proporzioni del proprio corpus di addestramento, non quelle della popolazione che si vorrebbe studiare, e le opinioni che esprime si discostano in modo sostanziale da quelle di molti gruppi della popolazione, anche quando gli si chiede di parlare a nome di uno di quei gruppi [SDL+23]. Che tredici agenti su venticinque abbiano saputo della festa è un fatto sulla simulazione, non una stima sulla diffusione di un invito in un paese.
Ne discende una regola d’uso netta. Come generatore di ipotesi queste simulazioni sono legittime e utili: fanno emergere dinamiche a cui non si era pensato, permettono di provare a costo quasi nullo interfacce e scenari prima di metterci delle persone, e sono un banco di prova per architetture di agenti (il loro contributo principale). Come prova sul comportamento di una popolazione non bastano, e nessuna quantità di trascrizioni convincenti le avvicina a una prova, perché ciò che le rende convincenti non è ciò che le renderebbe affidabili. Il caso in cui un agente simulato ha un valore predittivo è un altro, e si misura: quando è costruito a partire dai dati di persone reali e confrontato con risposte che non ha visto. Lo stesso gruppo di ricerca ha costruito agenti a partire da interviste di due ore a 1.052 persone; nella versione più recente del lavoro (2026), sulle domande di una grande indagine sociale statunitense gli agenti riproducono le risposte delle persone con un’accuratezza pari all’83-86% della coerenza che le persone stesse mostrano ripetendo l’indagine due settimane dopo, contro il 74% di agenti costruiti sui soli dati demografici [PZK+26]. Anche lì il valore predittivo vale per quelle persone e per quel tipo di domande, non per una popolazione qualunque. Chi presenta l’esito di una simulazione senza dati come un risultato sulle persone fa con il testo quello che nessuno accetterebbe con i numeri: chiamare dato ciò che è un’uscita del proprio modello.
La regola di interazione come variabile di progetto#
Dagli storni alle formiche, passando per agenti che si scrivono, votano, dibattono e imparano, è cambiato quasi tutto: la taglia dei partecipanti, il loro costo, perfino se si parlino o no. Non è cambiata la variabile di progetto, che è sempre la regola di interazione. I sei o sette vicini che lo storno tiene d’occhio, i collegamenti che il progettista concede o nega, il tipo di messaggio scritto in cima al biglietto, il premio dato alla squadra o al singolo, la velocità con cui il feromone svanisce, il vicinato che una particella ascolta: sono la stessa variabile, regolata su sistemi diversi.
È la tesi dell’apertura, arrivata in fondo intatta: a parità di individui, il comportamento di un gruppo lo decide la regola di interazione. Vale per gli storni sopra Termini, che contando i vicini restano uniti e che, nelle simulazioni, misurandoli in metri si spezzerebbero molto più spesso [BCC+08]; vale per una colonia di formiche artificiali, che con la stessa formula e un parametro di evaporazione diverso o esplora per sempre o si fossilizza sul primo tentativo. E vale per una squadra di agenti da costruire: accanto alla domanda su quale modello mettere dentro ciascuno, che conta, c’è quella che si dimentica, cioè che cosa può scrivere ciascuno, a chi, quando, e chi decide dopo.
Da ricordare
Prima dei modelli di linguaggio il multi-agente era soprattutto ottimizzazione: tante unità quasi banali, nessuno che comanda, e una soluzione che emerge dall’interazione. Il capostipite è l’ottimizzazione a colonia di formiche [DMC96], nata al Politecnico di Milano fra il 1991 e il 1992 (un articolo di convegno e la tesi di dottorato di Marco Dorigo). Fra due strade verso lo stesso cibo, quella corta si percorre più spesso e accumula più traccia: è il tempo a fare la misura, senza che nessuna formica confronti niente. E si lascia traccia in quantità proporzionale a quanto è buono il giro appena finito, così la traccia registra il merito e non il traffico.
L’evaporazione è l’esplorazione. Se ogni sera metà della traccia se ne va da sola, una strada che continua a essere usata non se ne accorge e una strada abbandonata sparisce in una settimana; quanto lentamente evapora dice per quanti giri il gruppo ricorda. Senza evaporazione la prima strada trovata per caso resta la più marcata per sempre e la colonia si fossilizza.
La memoria del gruppo non sta negli individui, sta nell’ambiente: è la stigmergia, cioè la lavagna condivisa della sezione sulle topologie. Una squadra di agenti che si coordina lasciando file in una cartella comune fa esattamente questo, con gli stessi problemi (chi scrive mentre un altro scrive, chi ha messo lì una certa cosa, e che cosa fa dimenticare allo stato comune ciò che non serve più).
Nello sciame di particelle [KE95], nato togliendo pezzi a una simulazione di stormo [Rey87], ognuno cerca il punto più basso della valle nella nebbia tirando un po’ verso il proprio ricordo, un po’ verso il punto migliore che ha trovato il gruppo, e un po’ dritto per dove stava già andando. È quest’ultima spinta a far superare il punto migliore conosciuto e a guardare appena più in là: senza, il metodo smette di trovare i minimi buoni.
Gli algoritmi genetici [Hol75] cambiano verbo: gli individui non si spostano, si riproducono (selezione, incrocio, mutazione, più il migliore che passa sempre alla generazione dopo). L’incrocio è una scommessa dichiarata, che una buona soluzione sia fatta di buoni pezzi staccabili, e cade quando ogni scelta dipende troppo da tutte le altre: come si scrive la soluzione è il progetto dell’algoritmo. In cambio a questi algoritmi non serve nessuna pendenza da seguire: basta saper mescolare due soluzioni e cambiarne un pezzo a caso. Va bene quindi anche una soluzione che è un elenco di sì e no, come gli oggetti da mettere nello zaino, o un ordine, come la sequenza in cui visitare venti città. E siccome in gara non c’è un candidato solo ma una popolazione intera, sparsa, è più probabile che qualcuno sia partito vicino alla risposta giusta. Sullo zaino a venti oggetti trova la risposta esatta otto volte su dieci provando meno di mezzo per cento delle combinazioni, e non dice mai quanto gli è mancato.
Questi metodi non sentono la pendenza: provano un punto e misurano la quota. Servono dove la pendenza non c’è, non si calcola o non informa (terreni pieni di buche, misure rumorose, scelte in cui non ci si può spostare di un millimetro, come l’ordine in cui visitare venti città), e si pagano in tentativi: sulla valle piena di fossette dell’esempio lo sciame trova il fondo vero in 277 prove su 300. Il confronto va però fatto a parità di esploratori e di spesa, altrimenti si bara: una discesa del gradiente lanciata da un punto solo ci arriva due volte su trecento, ma lanciata dagli stessi trenta punti dello sciame, con la stessa spesa, ci arriva poco più di una volta su cinque. Lo sciame vince circa quattro volte, non centoquaranta. Se poi ogni particella sente solo i due vicini invece del migliore di tutti, in sessanta giri lo sciame ci arriva 191 volte su 300: anche qui conta chi ascolta chi. E quando le variabili sono tantissime il rapporto si rovescia: non sono un’alternativa generale.
Nelle società simulate [POBrienC+23] il pezzo da capire è come si scelgono i ricordi da rimettere davanti all’agente: quanto è recente, quanto è importante, quanto c’entra con quello che sta facendo, e i tre criteri vanno messi sulla stessa scala prima di sommarli, altrimenti decide quasi da solo quello con i numeri più grandi. Le riflessioni scattano per accumulo di cose importanti, non a orologio, e rientrano in memoria. Ma quegli agenti producono comportamenti credibili (believable), che è in buona parte ciò che un modello di linguaggio sa fare per costruzione e non una scoperta sul comportamento umano: valgono come generatore di ipotesi, e come prova sulle persone non bastano, perché sono convincenti proprio in quanto il modello è addestrato a convincere. Un valore predittivo lo hanno soltanto agenti costruiti sui dati di persone vere e controllati su risposte che non hanno visto.
Da ricordare
Prima degli LLM il multi-agente era soprattutto ottimizzazione: molte unità quasi banali, nessun controllore centrale, e una soluzione che emerge dall’interazione. Il capostipite è l’ottimizzazione a colonia di formiche [DMC96], nata al Politecnico di Milano fra il 1991 e il 1992 (un articolo di convegno e la tesi di dottorato di Marco Dorigo). Una formica sceglie l’arco con probabilità \(p_{ij} \propto \tau_{ij}^{\alpha}\eta_{ij}^{\beta}\) (feromone contro visibilità) e deposita \(Q/L_k\), tanto più quanto è buono il giro che ha costruito: la traccia registra il merito, non il traffico.
L’evaporazione è l’esplorazione. Con \(\tau_{ij} \leftarrow (1-\rho)\tau_{ij} + \Delta\tau_{ij}\) la traccia è una somma a pesi esponenzialmente decrescenti, con orizzonte \(1/\rho\) cicli; senza evaporazione il rinforzo positivo fossilizza la colonia sul primo cammino trovato per caso (comportamento di stagnazione).
La memoria del gruppo non sta negli individui, sta nell’ambiente: è la stigmergia, cioè la lavagna condivisa della sezione sulle topologie. Una squadra di agenti che si coordina lasciando file in una cartella condivisa fa esattamente questo, con gli stessi problemi (contesa, provenienza, e che cosa fa dimenticare allo stato comune ciò che non serve più).
Nella particle swarm optimization [KE95], nata togliendo pezzi a una simulazione di stormo alla Reynolds [Rey87], ogni particella combina inerzia, attrazione verso il proprio miglior punto e verso il miglior punto del gruppo. Il sorpasso è voluto: senza inerzia il metodo smette di trovare gli ottimi buoni.
Gli algoritmi genetici [Hol75] cambiano verbo: gli individui non si spostano, si ricombinano (selezione, incrocio, mutazione, più l’elitismo). L’incrocio è una scommessa esplicita, che una buona soluzione sia fatta di buoni pezzi separabili, e cade quando i geni interagiscono troppo (epistasi): la codifica è il progetto dell’algoritmo. In cambio non serve una metrica sullo spazio, quindi si applica a permutazioni, alberi e programmi, e la popolazione permette di inseguire un intero fronte di Pareto invece di un punto solo [DPAM02]. Sullo zaino a venti oggetti trova l’ottimo esatto otto volte su dieci provando meno di mezzo per cento delle combinazioni, e non dice mai quanto gli è mancato.
Questi metodi non usano il gradiente, quindi servono dove il gradiente non esiste, non si calcola o non informa (funzioni non differenziabili, valutazioni rumorose, spazi combinatori), e pagano in valutazioni della funzione obiettivo: sulla Rastrigin in due dimensioni lo sciame trova il minimo globale in 277 prove su 300 con 1830 valutazioni. Il termine di paragone va preso a parità di budget, come impone la regola prudente della sezione sul costo del coordinamento: la discesa del gradiente a partenza singola chiude 2 prove su 300, ma con trenta ripartenze, cioè con gli stessi trenta punti iniziali dello sciame e la stessa spesa (60 passi a passo \(0{,}0025\), 1800 gradienti; o 20 passi con il gradiente stimato per differenze, 1800 valutazioni), ne chiude 67: 66 sono i semi che avevano un punto nato nella conca giusta, e riescono tutti, uno solo ce la fa da fuori. Con il vicinato ad anello invece del migliore globale lo sciame scende a 191 su 300 nello stesso numero di giri. In alta dimensione il rapporto si rovescia: per i metodi senza derivate il costo cresce con \(d\) [NS17], e non sono un’alternativa generale.
Nelle società simulate [POBrienC+23] il pezzo da capire è il recupero a tre termini (recenza, importanza, pertinenza) normalizzati e sommati con pesi uguali: senza normalizzazione il termine con l’escursione più ampia decide l’ordine ogni volta che le differenze superano l’escursione degli altri due. Le riflessioni scattano per accumulo di importanza, non a orologio, e rientrano in memoria. Ma gli agenti producono comportamenti credibili (believable), una qualità che la loro valutazione misura e che viene in buona parte dal modello di linguaggio, non una scoperta sul comportamento umano: legittime come generatore di ipotesi, insufficienti come prova sul comportamento di una popolazione. Il valore predittivo si misura solo su agenti costruiti dai dati di persone reali e convalidati su risposte non viste (83-86% della coerenza test-retest delle persone stesse [PZK+26]), e le opinioni dei modelli restano disallineate da quelle di molti gruppi demografici [SDL+23].
Chi progetta un sistema con più di una parte che parla ha una domanda da farsi prima di tutte le altre, e non riguarda soltanto gli agenti software: chi può scrivere a chi, quando, e chi decide dopo. Audio oltre la voce lascia i modelli linguistici e riparte da un segnale grezzo, l’onda che esce da un microfono; gli attrezzi però restano, e il Transformer riappare presto, con al posto delle parole dei simboli che descrivono un suono.