


Probabilità e statistica: convivere con l’incertezza#
Nell’estate del 1654 due matematici francesi, Blaise Pascal e Pierre de Fermat, si scambiano alcune lettere su un problema apparentemente frivolo: come dividere la posta di un gioco d’azzardo interrotto prima della fine. Da quella corrispondenza nasce, di fatto, la teoria della probabilità: la disciplina che insegna a ragionare quando non sappiamo con certezza cosa accadrà. È la stessa situazione del machine learning. Un modello non «sa» se un’email è spam: stima quanto è probabile che lo sia. Misurare l’incertezza, e aggiornarla quando arrivano nuovi dati, è ciò di cui si occupano la probabilità e la statistica.
Lo spazio delle possibilità#
Ogni volta che c’è del caso in gioco, si parte elencando cosa può succedere.
Lancia un dado. I risultati possibili sono \(\{1,2,3,4,5,6\}\): è lo spazio campionario. Un evento è un gruppo di questi risultati, per esempio «esce un numero pari» \(=\{2,4,6\}\). Se il dado è onesto, la probabilità di un evento è semplicemente casi favorevoli su casi possibili: \(P(\text{pari}) = 3/6 = 0{,}5\).
Tre regole di buon senso governano tutto: una probabilità sta sempre fra \(0\) (impossibile) e \(1\) (certo); l’evento «esce qualcosa» ha probabilità \(1\); e se due eventi non possono capitare insieme, la probabilità che ne capiti uno o l’altro è la somma delle due.
Formalizziamo con lo spazio campionario \(\Omega\) e gli eventi come suoi sottoinsiemi \(A\subseteq\Omega\), presi in una famiglia \(\mathcal{F}\) chiusa per complementare e unione numerabile (una \(\sigma\)-algebra): quando \(\Omega\) non è numerabile non tutti i sottoinsiemi si possono misurare, e la restrizione serve appena si passa alle variabili continue. Una misura di probabilità soddisfa gli assiomi di Kolmogorov (1933):
dove l’ultima uguaglianza vale per eventi \(A_i\) a due a due disgiunti. Da questi tre assiomi discende tutto il resto: \(P(\varnothing)=0\), la probabilità del complementare \(P(A^c)=1-P(A)\), e la regola di inclusione-esclusione \(P(A\cup B)=P(A)+P(B)-P(A\cap B)\).
Contare i casi#
«Casi favorevoli su casi possibili» funziona finché i casi si lasciano contare, e contarli è meno ovvio di quanto sembri. Il problema della posta interrotta, da cui era partita la corrispondenza fra Pascal e Fermat, si risolve così. Fermat contò tutti i modi in cui sarebbero potuti andare i turni rimasti, giocandoli fino in fondo anche quando la partita sarebbe già stata decisa, e Pascal ne scrisse la soluzione generale con il triangolo aritmetico, quello che in Italia si chiama di Tartaglia. Le regole per contare formano il calcolo combinatorio, e il numero che ne esce più spesso ha un simbolo suo, il coefficiente binomiale \(\binom{n}{k}\): quanti gruppi diversi di \(k\) oggetti si formano da \(n\), senza badare all’ordine. Serve ogni volta che si contano coppie, squadre o gruppi: quante coppie si formano con mille esempi, in quanti modi una giuria di sette può trovarsi in maggioranza dalla parte giusta, che è il conto dietro il teorema della giuria di Condorcet.
Dieci amici devono scegliere un capitano e un vice. Per il capitano ci sono dieci possibilità, e per ciascuna ne restano nove per il vice: \(10\cdot 9 = 90\) coppie capitano-vice. È la regola che regge tutto il resto: quando si sceglie una cosa dopo l’altra, le possibilità si moltiplicano.
Se invece devono formare una coppia per il doppio a ping-pong, dove nessuno comanda, il conto di prima conta ogni coppia due volte. Anna capitano con Bruno vice e Bruno capitano con Anna vice, al tavolo, sono la stessa coppia. Le coppie sono quindi \(90/2 = 45\).
Con una squadra di tre i doppioni sono di più. Scegliendoli in fila si hanno \(10\cdot 9\cdot 8 = 720\) terne ordinate, ma ogni squadra compare tante volte quanti sono i modi di mettere in fila i suoi tre membri: tre per il primo posto, due per il secondo, uno per l’ultimo, \(3\cdot 2\cdot 1 = 6\) (Anna, Bruno, Carlo è la stessa squadra di Anna, Carlo, Bruno, di Bruno, Anna, Carlo, e così via). Le squadre sono \(720/6 = 120\). Il prodotto \(3\cdot 2\cdot 1\) si scrive \(3!\) e si legge «tre fattoriale»; il numero delle squadre si scrive \(\binom{10}{3}\) e si legge «dieci su tre», anche se non è una divisione. (Scegliere i tre che giocano è come scegliere i sette che restano in panchina, e infatti anche le panchine da sette sono \(120\).)
Si può contare anche in un altro modo, ed è un buon controllo. Anna o è nella squadra, o non c’è. Se c’è, restano da scegliere due compagni fra gli altri nove, \(9\cdot 8/2 = 36\) squadre; se non c’è, servono tre persone fra quei nove, \(9\cdot 8\cdot 7/6 = 84\). E \(36 + 84 = 120\).
Adesso ciascuno lancia una moneta. Le file possibili di testa e croce sono \(2^{10} = 1024\) (due possibilità per ciascuno, moltiplicate dieci volte), tutte ugualmente probabili se le monete sono oneste. Quante hanno esattamente tre teste? Tante quante i modi di scegliere chi fa testa, cioè ancora \(120\). La probabilità è \(120/1024\), circa l’\(11{,}7\%\): il conto delle squadre e quello delle monete sono lo stesso conto.
La ricetta però vale solo se i casi contati sono ugualmente probabili, e sbagliare è facile. Nel 1754 Jean-Baptiste Le Rond d’Alembert, uno dei matematici più celebri del suo secolo, sostenne che lanciando due volte una moneta la probabilità di vedere almeno una testa fosse \(2/3\). Pensava al gioco che si ferma appena esce testa: i casi, diceva, sono tre (testa al primo lancio, e il secondo non serve; croce e poi testa; due croci), e due su tre vanno bene. Ma quei tre casi non si equivalgono, perché «testa subito» raccoglie due file, testa-testa e testa-croce: il secondo lancio, anche se non lo si fa, sarebbe potuto andare in due modi. Contando le file, che sono quattro e ugualmente probabili, quelle con almeno una testa sono tre, e la probabilità è \(3/4\). Pascal e Fermat, un secolo prima, avevano evitato proprio questo errore: per dividere la posta giocavano sulla carta anche i turni che non servivano più.
E i casi crescono in fretta. I modi di mettere in fila i dieci amici sono già \(10! = 3\,628\,800\), e quelli di mescolare un mazzo da 52 carte formano un numero di sessantotto cifre. Quando i casi sono troppi per elencarli, se ne guarda una parte estratta a caso, un campione, e si stima: lo si vedrà fare, per esempio, per dividere il merito di una previsione fra le informazioni su cui si è basata, nelle spiegazioni locali.
Il principio del prodotto dice che se una prima scelta si fa in \(a\) modi e, per ciascuno, una seconda in \(b\) modi, le coppie sono \(ab\) anche quando le seconde scelte possibili dipendono dalla prima: se \(A\) è l’insieme delle prime e \(B_x\) quello delle seconde dopo la scelta \(x\), con \(|A| = a\) e \(|B_x| = b\), le coppie sono \(\sum_{x\in A}|B_x| = ab\); quando \(B_x = B\) per ogni \(x\) è la cardinalità del prodotto cartesiano, \(|A\times B| = |A|\,|B|\). Iterandolo, le sequenze di \(k\) elementi distinti presi da \(n\) (le disposizioni semplici, per \(0\le k\le n\)) sono
con \(n! = n(n-1)\cdots 1\) e \(0! = 1\) (un solo modo di mettere in fila zero oggetti, ed è la scelta che fa valere la formula anche per \(k = n\)); per \(k = n\) sono le \(n!\) permutazioni. Se invece lo stesso elemento si può riprendere, le sequenze sono \(n^k\), le disposizioni con ripetizione: le file di \(n\) lanci di una moneta sono \(2^n\). Ogni sottoinsieme di taglia \(k\) corrisponde a esattamente \(k!\) disposizioni, i suoi ordinamenti, quindi i sottoinsiemi sono
simmetrico per \(k \leftrightarrow n-k\) (scegliere chi entra è scegliere chi resta fuori). Vale la regola di Pascal, quella del triangolo (ogni numero è la somma dei due che gli stanno sopra),
valida per \(n\ge 1\) con la convenzione \(\binom{n}{k} = 0\) fuori da \(0\le k\le n\), e con una dimostrazione biiettiva che non chiede conti: fissato un elemento, i sottoinsiemi di taglia \(k\) si dividono in quelli che lo contengono (e scelgono gli altri \(k-1\) fra i restanti \(n-1\)) e quelli che non lo contengono (e li scelgono tutti e \(k\) fra i restanti). Il nome viene dal teorema del binomio, \((x+y)^n = \sum_{k=0}^{n}\binom{n}{k}x^k y^{n-k}\), dove il coefficiente di \(x^k y^{n-k}\) conta da quali \(k\) degli \(n\) fattori si prende la \(x\); con \(x = y = 1\) dà \(\sum_k \binom{n}{k} = 2^n\), il numero dei sottoinsiemi. Le scelte in cui conta solo quante volte compare ciascun elemento, le combinazioni con ripetizione, sono \(\binom{n+k-1}{k}\) (\(k\) segni e \(n-1\) separatori messi in fila, e si sceglie dove stanno i segni): tanti quanti i monomi di grado \(k\) in \(n\) variabili, cioè le coordinate di grado \(k\) dello spazio che il kernel polinomiale usa senza calcolarle.
Per \(n\) lanci indipendenti di una moneta onesta le \(2^n\) sequenze sono equiprobabili, e quelle con \(k\) teste corrispondono una a una ai sottoinsiemi di \(k\) lanci, quelli che fanno testa: \(P(k \text{ teste}) = \binom{n}{k}/2^n\). Con una moneta che dà testa con probabilità \(p\) e lanci indipendenti, ogni sequenza con \(k\) teste ha probabilità \(p^k(1-p)^{n-k}\), e sommando sulle \(\binom{n}{k}\) sequenze il numero \(X\) di teste ha
che è la distribuzione binomiale: il teorema del binomio con \(x = p\) e \(y = 1-p\) la normalizza a uno. È la distribuzione del conteggio di successi su cui poggiano il test binomiale esatto e l’intervallo di Clopper-Pearson.
Il punto debole della definizione classica, \(P(A) = |A|/|\Omega|\), è l’ipotesi che gli esiti elementari siano equiprobabili, e da come si sceglie lo spazio dipende il risultato. D’Alembert, nella voce «Croix ou pile» dell’Encyclopédie (1754), diede \(2/3\) alla probabilità di almeno una testa in due lanci perché prese come equiprobabili gli esiti del gioco che si ferma alla prima testa (\(T\), \(CT\), \(CC\)) invece delle quattro sequenze complete; la risposta è \(3/4\). È l’obiezione che Roberval aveva mosso al metodo di Fermat, e che Pascal riferisce nella lettera del 24 agosto 1654: la partita vera si ferma appena qualcuno ha vinto. Giocare anche i turni che non servono non cambia il vincitore, e rende equiprobabili le sequenze. Si conta su uno spazio in cui la simmetria del meccanismo rende gli esiti equiprobabili, e solo dopo si passa alle probabilità.
Resta la crescita. La formula di Stirling, \(n! \sim \sqrt{2\pi n}\,(n/e)^n\) (il rapporto fra i due lati tende a \(1\), e a \(n = 52\) la sottostima è appena dello \(0{,}16\%\)), dà per il coefficiente centrale \(\binom{2m}{m} \sim 4^m/\sqrt{\pi m}\): con \(n = 2m\), i soli sottoinsiemi di taglia \(n/2\) sono \(2^n\) diviso appena \(\sqrt{\pi n/2}\). Enumerare i sottoinsiemi di \(n\) elementi costa dunque \(2^n\) anche fermandosi a una taglia sola, e smette di essere praticabile già per qualche decina di elementi. Le grandezze definite come somme su tutti i sottoinsiemi o su tutti gli ordinamenti, come i valori di Shapley delle spiegazioni locali, si calcolano quindi esatte solo per \(n\) piccolo, e altrimenti si stimano campionando sottoinsiemi o ordinamenti.
I conti delle squadre, delle monete e di d’Alembert si possono rifare senza formule, elencando i casi uno per uno. L’elenco però non sceglie lo spazio: a partire dai tre casi di d’Alembert restituisce di nuovo \(2/3\). A dire quali casi si equivalgono è il gioco stesso, e lo si interroga giocandolo: su centomila partite simulate, fermandosi alla prima testa, almeno una testa esce tre volte su quattro. Il blocco confronta anche \(52!\) con la formula approssimata di Stirling, che lo stima senza fare tutte le moltiplicazioni.
import random
from itertools import combinations, permutations, product
from math import comb, e, factorial, pi, sqrt

amici = "ABCDEFGHIL"                      # dieci amici, "A" è Anna
print("capitano e vice:", len(list(permutations(amici, 2))))
print("coppie per il doppio:", len(list(combinations(amici, 2))))
print("terne ordinate:", len(list(permutations(amici, 3))),
      "| squadre da tre:", len(list(combinations(amici, 3))), "=", comb(10, 3),
      "| panchine da sette:", len(list(combinations(amici, 7))))
con_anna = sum("A" in s for s in combinations(amici, 3))
senza_anna = sum("A" not in s for s in combinations(amici, 3))
print("squadre con Anna:", con_anna, "=", comb(9, 2),
      "| senza Anna:", senza_anna, "=", comb(9, 3))

file = list(product("TC", repeat=10))    # tutte le file di dieci lanci
tre_teste = sum(f.count("T") == 3 for f in file)
print(f"file di dieci lanci: {len(file)}, con tre teste: {tre_teste}"
      f" ({tre_teste / len(file):.1%})")

# d'Alembert: l'elenco restituisce la risposta dello spazio che riceve
due = list(product("TC", repeat=2))
print("almeno una testa, file complete:",
      sum("T" in f for f in due), "su", len(due))
print("almeno una testa, casi di d'Alembert:",
      sum("T" in c for c in ("T", "CT", "CC")), "su 3")
# il gioco vero: si lancia finché esce testa, al più due volte
sorte = random.Random(0)
partite = 100_000
vinte = sum(sorte.random() < 0.5 or sorte.random() < 0.5
            for _ in range(partite))
print(f"in {partite} partite, almeno una testa nel {vinte / partite:.0%}")

print("10! =", factorial(10))
n = 52
stirling = sqrt(2 * pi * n) * (n / e)**n
print(f"52! ha {len(str(factorial(n)))} cifre;"
      f" Stirling la sottostima dello {1 - stirling / factorial(n):.2%}")
capitano e vice: 90
coppie per il doppio: 45
terne ordinate: 720 | squadre da tre: 120 = 120 | panchine da sette: 120
squadre con Anna: 36 = 36 | senza Anna: 84 = 84
file di dieci lanci: 1024, con tre teste: 120 (11.7%)
almeno una testa, file complete: 3 su 4
almeno una testa, casi di d'Alembert: 2 su 3
in 100000 partite, almeno una testa nel 75%
10! = 3628800
52! ha 68 cifre; Stirling la sottostima dello 0.16%
Variabili aleatorie#
Lanciare dieci monete e guardare come sono venute è una cosa; contare quante teste sono uscite è un’altra, ed è quasi sempre quella che interessa. Il salto è piccolo e cambia tutto: da un elenco di casi si passa a un numero, e sui numeri si possono fare medie, grafici, confronti.
Una variabile aleatoria è un numero il cui valore dipende dal caso. Se lancio dieci monete e conto le teste, quel conteggio è una variabile aleatoria. Ne esistono due specie. Quelle discrete contano cose separate (\(0, 1, 2, \dots\) teste): a ciascun valore assegniamo una probabilità, e la somma fa \(1\). Quelle continue misurano grandezze che scorrono senza salti (un’altezza, un tempo di attesa): qui la probabilità non si concentra in un singolo punto ma si spalma su una curva, la densità, e le probabilità diventano aree sotto quella curva.
Una variabile aleatoria è una funzione \(X:\Omega\to\mathbb{R}\). Se è discreta la descrive la funzione di massa \(p(x)=P(X=x)\), con \(\sum_x p(x)=1\). Se è continua la descrive la densità \(f(x)\ge 0\) con \(\int_{-\infty}^{+\infty} f(x)\,dx=1\), e
In entrambi i casi la funzione di ripartizione \(F(x)=P(X\le x)\) raccoglie l’informazione cumulata fino a \(x\).
La stessa curva si può disegnare in due modi, e conviene saperli riconoscere tutti e due.

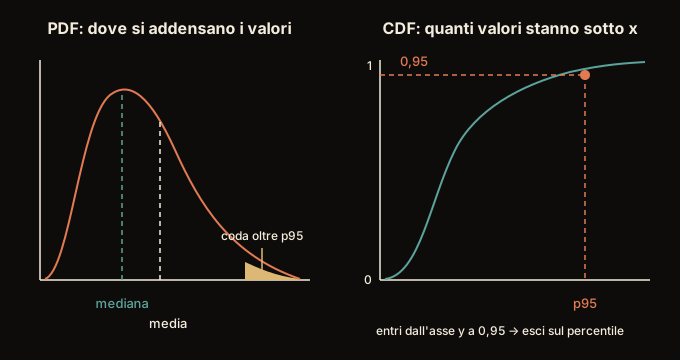
Fig. 3.14 La stessa variabile, due modi di guardarla. A sinistra la densità appena descritta, che disegna quali valori escono spesso e quali di rado: lì la probabilità è l’area sotto la curva, e infatti la zona colorata è il cinque per cento dei casi che cadono oltre il valore segnato. A destra una seconda curva, che per ogni valore risponde alla domanda «quanta parte dei casi sta sotto questo numero?» e perciò sale da \(0\) a \(1\): lì la stessa probabilità è l’altezza della curva, cioè un punto da leggere invece di un’area da calcolare. Il nome tecnico della seconda è funzione di ripartizione. (Le due sigle in cima ai grafici sono le abbreviazioni inglesi con cui si trovano ovunque: PDF per la densità, CDF per la ripartizione.)#
I due grafici di Fig. 3.14 descrivono la stessa variabile: la ripartizione è l’area della densità fino a \(x\), \(F(x)=\int_{-\infty}^{x}f(t)\,dt\), e la densità è la pendenza della ripartizione, \(f=F'\). La seconda curva serve a rispondere alla domanda che si fa più spesso su una misura: «sotto quale valore cade il novantacinque per cento dei casi?». Quel valore si chiama novantacinquesimo percentile, \(F^{-1}(0{,}95)\), e sul grafico di destra si legge partendo dall’altezza \(0{,}95\) e scendendo al numero corrispondente; su quello di sinistra vorrebbe un’area da calcolare. È l’abitudine dei tecnici che sorvegliano un servizio online: invece di dire «in media il sito risponde in mezzo secondo» dicono «il novantacinquesimo percentile del tempo di risposta è due secondi», che è un modo di parlare non della giornata tipica, ma di quanto vanno male le giornate storte.
Il centro e la larghezza#
Il quadro completo di come si comporta una grandezza casuale (quali valori escono, e con che frequenza ciascuno) si chiama la sua distribuzione: è la parola che d’ora in poi useremo per la curva o per l’elenco di probabilità appena visti. Quasi sempre non serve tutto il quadro: bastano due numeri, dove sta il centro della distribuzione e quanto è dispersa attorno a esso.

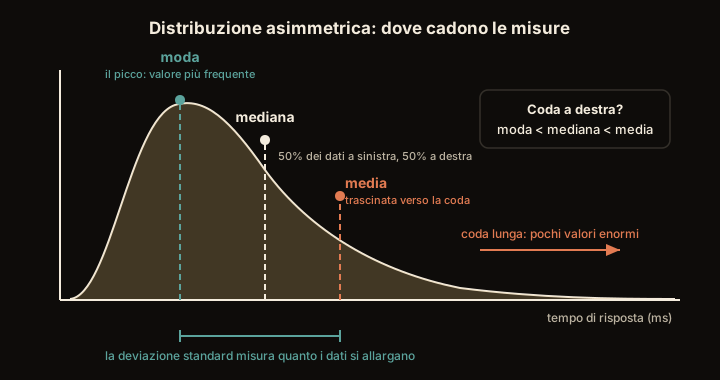
Fig. 3.15 Tre centri per la stessa distribuzione. La moda sta sul picco (il valore più frequente), la mediana taglia i casi a metà, la media è quella scolastica. Su una curva simmetrica coinciderebbero; qui no, perché la curva ha una coda, cioè si allunga da un lato con valori rari ma molto grandi, e la media è quella che la coda sposta di più: pochi stipendi altissimi alzano lo stipendio medio senza spostare quello di mezzo.#
L’ordine in cui i tre indicatori compaiono in Fig. 3.15 è un buon promemoria pratico: quando media e mediana si allontanano molto, la distribuzione ha una coda, e riassumerla con la sola media descrive un valore tipico che quasi nessuno osserva.
Il valore atteso è la media dei valori possibili, ciascuno pesato dalla sua probabilità: è il risultato medio che ci aspettiamo «a lungo andare». Si scrive \(\mathbb{E}[X]\), e si legge «valore atteso di X» (la E doppia sta per expected, atteso, e \(X\) è il nome della grandezza che stiamo guardando). Per un dado onesto vale \(\tfrac{1+2+3+4+5+6}{6}=3{,}5\): un numero che non uscirà mai in un singolo lancio, ma attorno al quale si assesta la media di tanti lanci.
La varianza, che si scrive \(\mathrm{Var}(X)\) e si legge «varianza di X», misura invece quanto tipicamente ci si allontana da quel centro: piccola se i valori sono raccolti, grande se sono sparpagliati. Il conto è meno spaventoso del nome, e sul dado si fa a mano in un minuto. Si guarda di quanto ciascuna faccia dista dal centro \(3{,}5\) (sono \(-2{,}5\), \(-1{,}5\), \(-0{,}5\), \(0{,}5\), \(1{,}5\), \(2{,}5\)), si eleva ogni scarto al quadrato (per togliere di mezzo i segni: \(6{,}25\), \(2{,}25\), \(0{,}25\), \(0{,}25\), \(2{,}25\), \(6{,}25\)) e si fa la media: \(17{,}5\) diviso \(6\) fa circa \(2{,}92\). Quella è la varianza.
Il quadrato però ha gonfiato tutto, e per tornare a parlare in punti di dado si fa la radice: \(\sqrt{2{,}92} \approx 1{,}7\). Questa è la deviazione standard, ed è la forma leggibile delle due: dice che rispetto al centro \(3{,}5\) i risultati si sparpagliano tipicamente di un punto e mezzo o due, che guardando le facce di un dado è proprio quello che ci si aspetta.
Sul dado il conto fila liscio perché le facce e le loro probabilità si conoscono in partenza, centro compreso. Sui dati veri il centro non lo conosce nessuno: lo si ricava dagli stessi numeri di cui poi si misura lo sparpagliamento, e così la misura esce un po’ più piccola del giusto. Tre freccette su un bersaglio: se come centro prendi il punto di mezzo dei tuoi tre tiri, quel punto insegue i tiri, e gli scarti misurati da lì vengono, nel complesso, più corti di quelli dal centro vero del bersaglio. Il rimedio è dividere la somma degli scarti al quadrato per uno in meno, per due invece che per tre: con pochi dati la differenza si sente, con migliaia sparisce.
Per una variabile discreta, con \(\mu=\mathbb{E}[X]\):
per una continua le somme diventano integrali. La deviazione standard \(\sigma=\sqrt{\mathrm{Var}(X)}\) riporta la dispersione nelle stesse unità di \(X\). Il valore atteso è lineare, \(\mathbb{E}[aX+cY+d]=a\,\mathbb{E}[X]+c\,\mathbb{E}[Y]+d\), anche quando \(X\) e \(Y\) dipendono l’una dall’altra, proprietà che useremo di continuo. Per la varianza valgono \(\mathrm{Var}(aX+d)=a^2\mathrm{Var}(X)\) e, per variabili indipendenti, \(\mathrm{Var}(X+Y)=\mathrm{Var}(X)+\mathrm{Var}(Y)\) (in generale c’è il termine \(2\,\mathrm{Cov}(X,Y)\)). Per il dado: \(\mathbb{E}[X^2]=\tfrac{91}{6}\approx 15{,}17\), quindi \(\mathrm{Var}(X)=15{,}17-3{,}5^2\approx 2{,}92\) e \(\sigma\approx 1{,}71\).
Una distinzione che d’ora in poi è data per fatta. \(\mathrm{Var}(X)\) è una proprietà della distribuzione, e nei conti di sopra la si calcola perché la distribuzione è nota. Sui dati veri non lo è: la si stima da un campione \(x_1,\dots,x_n\), ed è un’altra cosa, che si scrive \(s^2\) e non \(\mathrm{Var}(X)\). La media degli scarti quadratici \(\frac{1}{n}\sum_i (x_i-\bar x)^2\) sottostima sistematicamente \(\sigma^2\), perché \(\bar x\) è stata calcolata sugli stessi dati e si adagia su di essi; dividere per \(n-1\) (correzione di Bessel) rende lo stimatore non distorto:
Il linguaggio è quello degli stimatori: una funzione \(\hat\theta\) del campione che serve a indovinare un parametro \(\theta\) della distribuzione. La sua distorsione è \(\operatorname{bias}(\hat\theta)=\mathbb{E}[\hat\theta]-\theta\), la sua varianza dice quanto cambia da un campione all’altro, e l’errore quadratico medio si spezza nelle due, \(\mathbb{E}[(\hat\theta-\theta)^2]=\operatorname{bias}(\hat\theta)^2+\mathrm{Var}(\hat\theta)\). Per campioni i.i.d. il conto di Bessel sta in una riga, una volta noto che \(\mathrm{Var}(\bar x)=\sigma^2/n\) (per le due regole sulla varianza appena viste): da \(\sum_i(x_i-\bar x)^2=\sum_i(x_i-\mu)^2-n(\bar x-\mu)^2\) segue \(\mathbb{E}\big[\sum_i(x_i-\bar x)^2\big]=n\sigma^2-n\,\mathrm{Var}(\bar x)=(n-1)\sigma^2\). Due avvertenze. Non distorto non vuol dire migliore: su dati gaussiani il divisore \(n\) ha errore quadratico medio più piccolo di \(n-1\), e \(n+1\) più piccolo ancora. E la non distorsione non attraversa le funzioni non lineari: \(s=\sqrt{s^2}\) sottostima \(\sigma\), per la disuguaglianza di Jensen.
Il divisore \(n\) è quello della massima verosimiglianza gaussiana (il criterio
che sceglie i parametri che rendono i dati più probabili): annullando le
derivate di
\(-\frac{n}{2}\log(2\pi\sigma^2)-\frac{1}{2\sigma^2}\sum_i(x_i-\mu)^2\) si trovano
\(\hat\mu=\bar x\) e \(\hat\sigma^2=\frac1n\sum_i(x_i-\bar x)^2\). La massima
verosimiglianza, dunque, non promette stimatori non distorti. Le librerie
scelgono default diversi, e conviene saperlo prima di confrontare due numeri:
np.var e StandardScaler di scikit-learn dividono per \(n\) (ddof=0),
torch.var divide per \(n-1\) (correction=1). Su otto osservazioni la varianza
calcolata con \(n-1\) supera del \(14\%\) quella calcolata con \(n\) (la deviazione
standard del \(7\%\)); su diecimila la differenza è invisibile.
Due distribuzioni che tornano spesso#
Di distribuzioni ne esistono molte, ma due tornano spesso. La Bernoulli descrive ogni singola prova «sì/no»; la normale (o gaussiana) descrive le grandezze che sono somme di tanti piccoli contributi indipendenti.

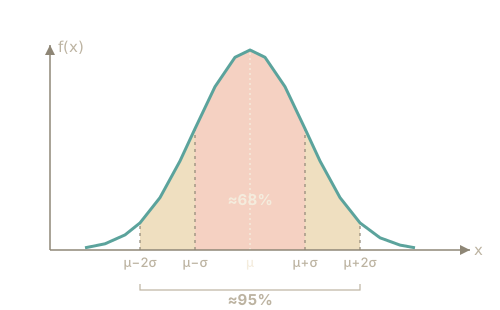
Fig. 3.16 La distribuzione normale, che si abbrevia \(\mathcal{N}(\mu,\sigma^2)\): le due lettere greche sono il centro della campana (\(\mu\), «mu») e il suo scarto tipico (\(\sigma\), «sigma»), cioè di quanto in genere i valori si allontanano dal centro. Nella sigla il secondo numero è scritto al quadrato perché per tradizione si elenca la varianza e non lo scarto; la larghezza che si vede nel disegno resta \(\sigma\). Circa il \(68\%\) della probabilità cade entro \(\mu\pm\sigma\) e circa il \(95\%\) entro \(\mu\pm 2\sigma\).#
Una Bernoulli è una moneta, magari truccata: esce \(1\) (successo) con probabilità \(p\) e \(0\) con probabilità \(1-p\). Serve a modellare qualunque esito binario: click/non click, spam/non spam.
La normale, che prende anche il nome di gaussiana dal matematico Carl Friedrich Gauss, è la celebre curva a campana (Fig. 3.16): simmetrica, con la maggior parte dei valori stretti attorno alla media \(\mu\) e code che si assottigliano ai lati. Vale una regola pratica utilissima, la «68–95»: circa il \(68\%\) dei casi cade entro una deviazione standard dalla media (\(\mu\pm\sigma\)), circa il \(95\%\) entro due (\(\mu\pm 2\sigma\)). Altezze, errori di misura, rumore: in natura la campana è dappertutto.
Perché dappertutto? C’è un risultato che lo spiega, e ha un nome importante: il teorema del limite centrale. Dice una cosa sorprendente: ogni volta che una grandezza è la somma di tanti contributi casuali e indipendenti fra loro, nessuno dei quali possa da solo essere enormemente più grande di tutti gli altri messi insieme, il risultato assomiglia a una campana, e questo succede qualunque sia la forma dei singoli contributi. L’altezza di una persona è la somma di centinaia di piccoli effetti (geni, alimentazione, salute da bambino): campana. L’errore di uno strumento è la somma di tante imprecisioni minuscole: campana. Il totale di tre dadi è la somma di tre numeri che, presi da soli, non hanno niente di campanulare (in un dado tutte le facce sono ugualmente probabili, il disegno sarebbe piatto): eppure il totale, sì.
Attenzione a cosa il teorema promette e cosa no. Promette che, sommando abbastanza pezzi, la campana arriva. Non promette quanto in fretta: con i dadi bastano tre addendi, ma con ingredienti molto storti (per esempio un evento che capita una volta su cento) nemmeno trenta bastano, e la campana non si vede ancora.
La Bernoulli\((p)\) ha \(P(X{=}1)=p\), valore atteso \(\mathbb{E}[X]=p\) e varianza \(\mathrm{Var}(X)=p(1-p)\). La normale \(\mathcal{N}(\mu,\sigma^2)\) ha densità
dove \(\mu\) è la media (il centro della campana) e \(\sigma\) la deviazione standard (la sua larghezza). Perché è così onnipresente? Per il teorema del limite centrale (de Moivre, Laplace, poi Lyapunov): se \(X_1,\dots,X_n\) sono i.i.d. con media \(\mu\) e varianza \(\sigma^2\) finita e non nulla, posto \(S_n = X_1 + \dots + X_n\), la somma standardizzata \((S_n - n\mu)/(\sigma\sqrt{n})\) converge in distribuzione a \(\mathcal{N}(0,1)\), quale che sia la distribuzione di partenza; in pratica, per \(n\) grande, \(S_n\) si approssima bene con \(\mathcal{N}(n\mu,\,n\sigma^2)\). (Per variabili indipendenti ma non identicamente distribuite servono condizioni in più, come quella di Lindeberg o di Lyapunov.) È il motivo per cui gli errori di misura si modellano gaussiani, e per cui in una rete neurale larga, all’inizializzazione, le pre-attivazioni di uno strato, che sono somme di molti contributi indipendenti, tendono a essere gaussiane qualunque sia la distribuzione dei pesi, purché abbia media nulla e varianza finita. Non è invece il motivo per cui si inizializzano i pesi in un modo o nell’altro: gli schemi standard derivano la varianza dell’inizializzazione, per conservare la scala delle attivazioni fra uno strato e l’altro, e non la famiglia, tanto che il default di PyTorch campiona da un’uniforme e non da una normale.
Il teorema dice che si converge, non quanto in fretta, e la seconda domanda ha una risposta separata. Una garanzia grossolana la dà la disuguaglianza di Berry–Esseen, \(\sup_z |F_n(z)-\Phi(z)| \le C\,\rho_3 / (\sigma^3\sqrt{n})\), dove \(F_n\) è la funzione di ripartizione della somma standardizzata, \(\Phi\) quella della normale standard, \(C\) una costante universale minore di mezzo che non dipende dalla distribuzione di partenza, e \(\rho_3 = \mathbb{E}|X-\mu|^3\). La distanza cala dunque come \(1/\sqrt{n}\). Davanti, però, c’è un momento terzo assoluto, che non distingue una sola coda lunga da due code lunghe simmetriche. A separarle è lo sviluppo di Edgeworth, il cui primo termine correttivo è proporzionale all’asimmetria e si annulla quando la distribuzione di partenza è simmetrica: è lei, a parità di tutto il resto, a governare il termine dominante.
La distanza fra due distribuzioni si misura con la statistica di Kolmogorov–Smirnov (KS), cioè il massimo scarto fra le due funzioni di ripartizione, applicata qui alla somma standardizzata contro la normale. Per la somma di tre dadi (asimmetria nulla) vale \(0{,}069\), ma quasi tutto è discretezza: la somma è intera, il salto massimo della sua ripartizione è \(27/216=0{,}125\), e metà di quel salto, \(0{,}0625\), è il minimo a cui la KS può scendere contro una normale continua; con la correzione di continuità la distanza è \(0{,}010\). Per una lognormale con \(\mu=0\) e \(\sigma=2\), asimmetrica e continua, a \(n=30\) resta \(0{,}27\), su quattrocentomila somme simulate. Per una Bernoulli\((0{,}01)\), a \(n=30\) vale \(0{,}449\), e qui la discretezza è tutto il numero: la somma mette il \(74\%\) della massa su un valore solo, e quel salto, da solo, vale \(0{,}449\). Il caso del dado resta il più gentile, non il più ostile.
import numpy as np
from itertools import product
from scipy.stats import binom, norm

def ks_interi(k, p, media, sd, continuita=False):
    """Distanza di Kolmogorov-Smirnov fra la ripartizione di una variabile a
    valori interi e la normale con la stessa media e varianza (con
    continuita=True si confronta con la normale spostata di mezza unità)."""
    F = np.cumsum(p)
    if continuita:
        return np.abs(F - norm.cdf((k + 0.5 - media) / sd)).max()
    Phi = norm.cdf((k - media) / sd)
    return max(np.abs(F - Phi).max(), np.abs(F - p - Phi).max())

# tre dadi: i 216 esiti si enumerano tutti
somme = np.array([sum(t) for t in product(range(1, 7), repeat=3)])
k, c = np.unique(somme, return_counts=True)
p, sd = c / c.sum(), np.sqrt(3 * 35 / 12)
print("tre dadi:", round(ks_interi(k, p, 10.5, sd), 3),
      "| mezzo salto massimo:", round(p.max() / 2, 4),
      "| con la continuità:", round(ks_interi(k, p, 10.5, sd, True), 3))

# trenta Bernoulli(0,01): la somma è binomiale, e si calcola esatta
k = np.arange(31)
p = binom.pmf(k, 30, 0.01)
print("trenta Bernoulli(0,01):",
      round(ks_interi(k, p, 0.3, np.sqrt(30 * 0.01 * 0.99)), 3),
      "| P(somma = 0):", round(p[0], 3))

# trenta lognormali, il cui logaritmo è N(0, 2^2): 400 000 somme simulate
rng = np.random.default_rng(0)
media, var = np.exp(2.0), (np.exp(4.0) - 1) * np.exp(4.0)
S = sum(rng.lognormal(0.0, 2.0, size=400_000) for _ in range(30))
z = np.sort((S - 30 * media) / np.sqrt(30 * var))
F = np.arange(1, z.size + 1) / z.size
print("trenta lognormali:", round(max((F - norm.cdf(z)).max(),
                                      (norm.cdf(z) - F + 1 / z.size).max()), 2))
tre dadi: 0.069 | mezzo salto massimo: 0.0625 | con la continuità: 0.01
trenta Bernoulli(0,01): 0.449 | P(somma = 0): 0.74
trenta lognormali: 0.27
Conviene vedere il teorema del limite centrale succedere, perché detto a parole sembra una promessa e guardato sembra un trucco.

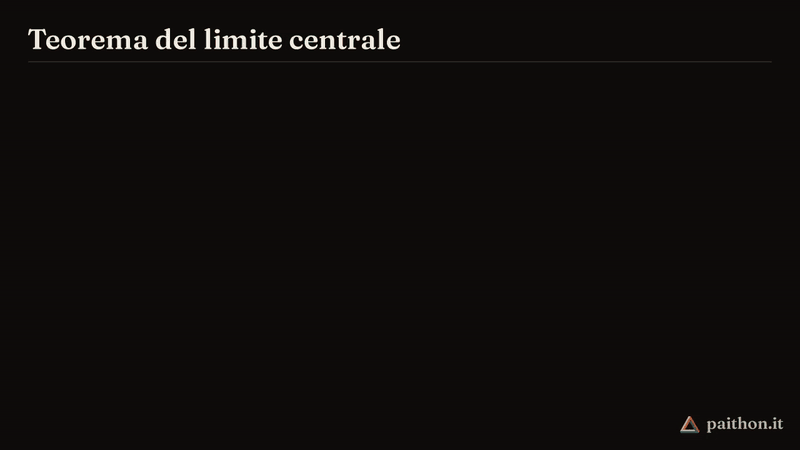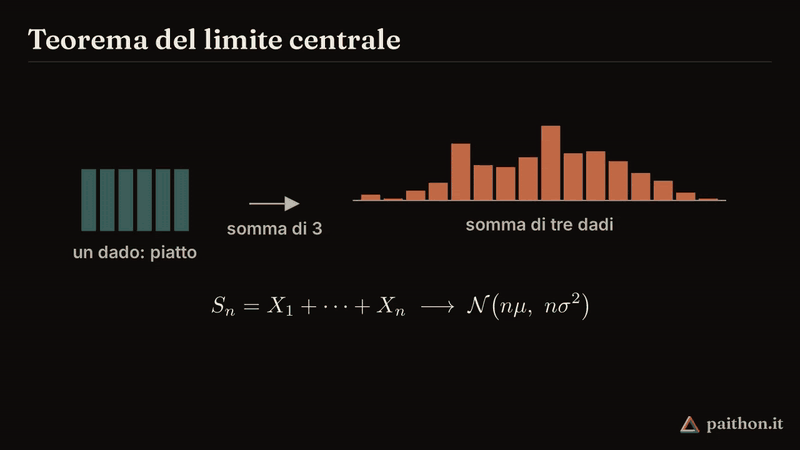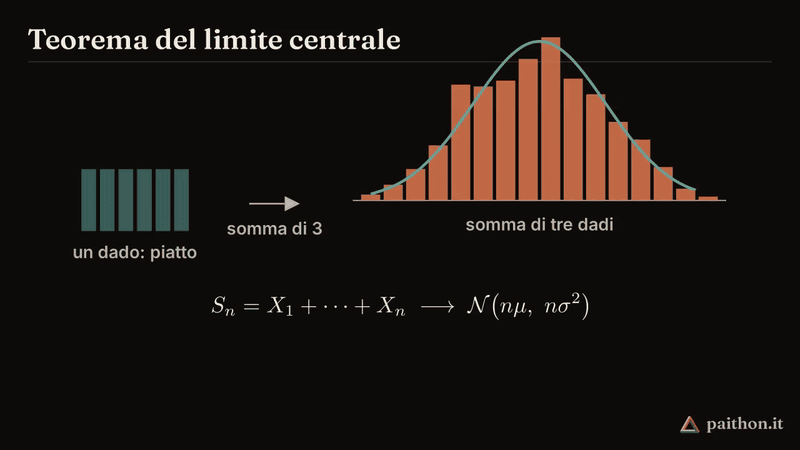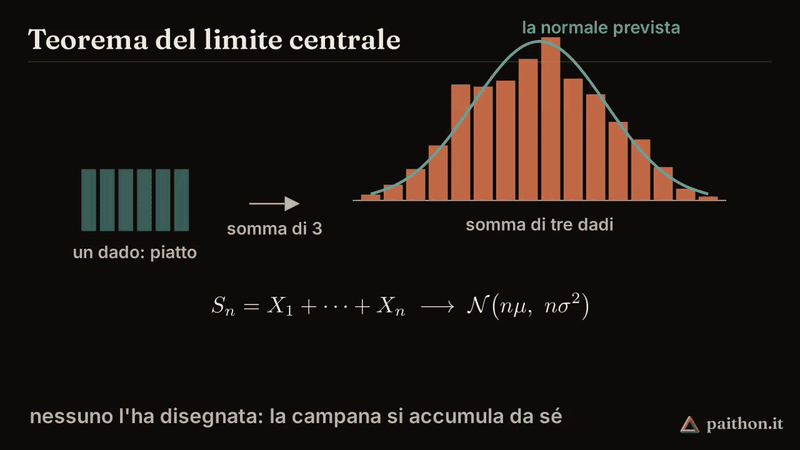
Fig. 3.17 Un dado è piatto: nessuna faccia è più probabile di un’altra. Eppure la somma di tre dadi, ripetuta seicento volte, si dispone da sé lungo la campana. La curva sovrapposta è la campana che il teorema prevede prima ancora di tirare i dadi, e non un disegno fatto sopra le barre a cose fatte: è centrata sulla somma media dei tre e larga di conseguenza, e i dadi le danno ragione.#
Due cose valgono più della formula, nella Fig. 3.17. La prima è che la distribuzione di partenza non ha niente della campana: nessuna faccia è privilegiata, il disegno di un dado singolo sarebbe una fila di barre tutte uguali, e la campana arriva lo stesso. È questo il senso di «qualunque sia la forma dei singoli contributi».
La seconda va detta con più cautela di quanto si faccia di solito. Qui bastano tre addendi, ma il merito è del dado più che del teorema: è simmetrico, cioè non ha una coda più lunga dell’altra. È proprio la simmetria a far arrivare in fretta la campana, ed è per questo che il caso più «piatto» è anche il più facile.
Lo stesso fenomeno si vede con le monete, ed è il caso che ricorre più spesso nel machine learning: contare i successi in una serie di prove «sì/no» indipendenti.

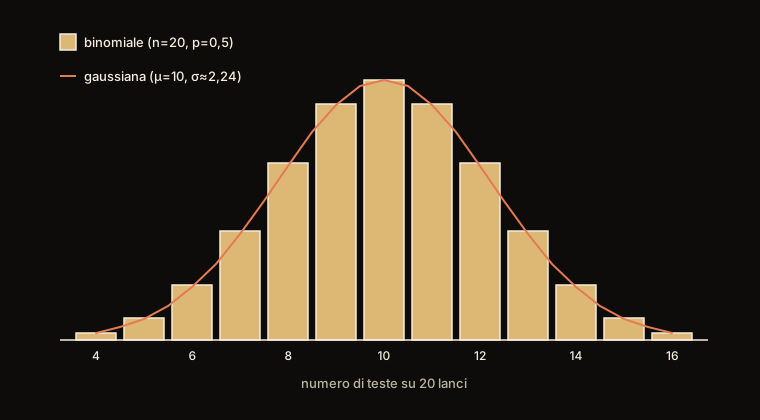
Fig. 3.18 Barre discrete, curva continua. Il conteggio dei successi può valere solo numeri interi, eppure la campana continua lo approssima già bene con venti prove.#
L’accordo mostrato in Fig. 3.18 è ciò che autorizza un’abitudine diffusa. Per sapere quanto vale un modello lo si prova su un gruppo di esempi tenuti da parte, mai visti durante l’addestramento (il test set), e si conta la percentuale di risposte esatte: quella percentuale si chiama accuratezza. Ma un conteggio di risposte esatte su prove indipendenti è una somma di Bernoulli, come il conteggio di teste appena disegnato, quindi lo si può trattare come una campana, purché le prove siano abbastanza numerose e la quota di risposte esatte non sia troppo vicina a zero o a uno (una regola pratica: \(n\,p(1-p)\) almeno una decina, con \(n\) le prove e \(p\) quella quota). È l’approssimazione su cui poggiano gli intervalli di confidenza, e cede proprio dove il modello è molto buono: con cento esempi e il \(98\%\) di risposte esatte, il margine calcolato con la campana arriva oltre il \(100\%\).
Aggiornare le credenze: il teorema di Bayes#
Fin qui abbiamo calcolato probabilità «in avanti». Ma spesso il problema è rovesciato: osserviamo un effetto e vogliamo risalire alla causa. È il regno di Thomas Bayes, il cui saggio fu pubblicato postumo nel 1763.
Un test cerca una malattia rara, che colpisce \(1\) persona su \(100\). Il test è buono: individua il \(99\%\) dei malati e sbaglia solo nel \(5\%\) dei sani. Ti arriva un risultato positivo: quanto devi preoccuparti? L’istinto dice «molto», ma i conti dicono altro. Su \(10\,000\) persone, \(100\) sono malate (e \(99\) risultano positive); ma dei \(9\,900\) sani ben \(495\) risultano positivi per errore. I positivi totali sono \(99+495=594\), e solo \(99\) sono davvero malati: circa il 17%. Con una malattia rara, la maggior parte dei positivi sono falsi allarmi.
Per \(P(B)>0\) la probabilità di \(A\) dato \(B\) è \(P(A\mid B)=P(A\cap B)/P(B)\), la probabilità ricalcolata dentro il mondo ristretto a \(B\). Due eventi sono indipendenti se \(P(A\cap B)=P(A)\,P(B)\), cioè se sapere che \(B\) è successo non sposta \(A\); per le variabili aleatorie si chiede la stessa fattorizzazione per ogni coppia di valori, e «i.i.d.» vuol dire indipendenti e con la stessa distribuzione. Se \(B_1,\dots,B_k\) partizionano lo spazio degli esiti, vale la legge della probabilità totale \(P(A)=\sum_j P(A\mid B_j)\,P(B_j)\). Scrivendo \(P(A\cap B)\) nei due modi si ottiene il teorema di Bayes, che lega la probabilità condizionata nei due versi:
Con \(A\) = «malato» e \(B\) = «positivo», prevalenza \(P(A)=0{,}01\), sensibilità \(P(B\mid A)=0{,}99\) e tasso di falsi positivi \(P(B\mid A^c)=0{,}05\), il denominatore è \(P(B)=0{,}99\cdot 0{,}01+0{,}05\cdot 0{,}99=0{,}0594\), da cui
La prevalenza \(P(A)\) (il prior) domina il risultato: nessun classificatore va giudicato dalla sola accuratezza quando le classi sono fortemente sbilanciate.
Che a comandare sia quanto la malattia è diffusa, e non quanto il test è buono, si vede meglio spostando proprio quel dato. Teniamo lo stesso test (individua il \(99\%\) dei malati e sbaglia sul \(5\%\) dei sani) e rendiamo la malattia dieci volte più rara, una persona su mille invece di una su cento.

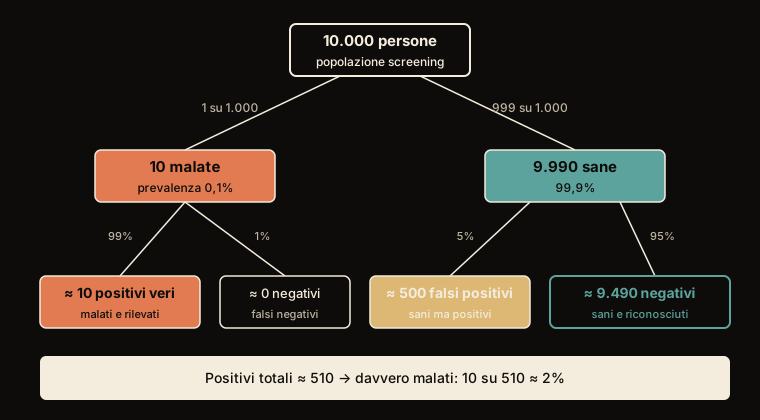
Fig. 3.19 Lo stesso test su una malattia dieci volte più rara. I falsi positivi non cambiano di molto (vengono dai sani, che sono tanti); i positivi veri sì, e la probabilità di essere davvero malati crolla dal \(17\%\) al \(2\%\). Nel disegno compaiono due termini del mestiere: prevalenza è quanto la malattia è diffusa nella popolazione (qui una persona su mille, cioè lo \(0{,}1\%\)), e falso negativo è il caso opposto del falso allarme, cioè un malato a cui il test dice che sta bene.#
Il test non è peggiorato di una virgola fra Fig. 3.19 e l’esempio di prima: a cambiare sono stati i malati. È la ragione per cui la stessa identica prova diagnostica va interpretata diversamente in uno screening di massa e in un reparto, dove chi arriva è già stato selezionato dai sintomi.
La legge dei grandi numeri: perché servono tanti dati#
Un casinò perde in continuazione. A ogni tavolo di roulette qualcuno vince, e il banco paga. Eppure la roulette non manda in rovina un casinò: su una singola puntata il margine è minuscolo e il caso domina, su milioni di puntate il guadagno medio per puntata si avvicina al margine, e le oscillazioni relative si restringono.

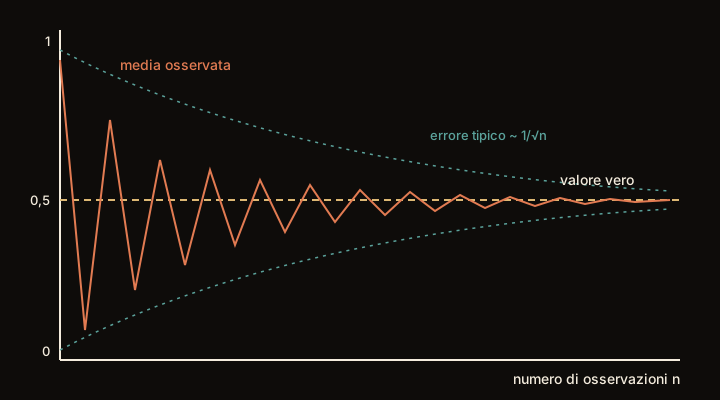
Fig. 3.20 Le oscillazioni non spariscono: si restringono. È una differenza che conta, perché nessun numero di prove rende la media uguale al valore vero.#
La forma a imbuto di Fig. 3.20 è quella che governa quanti esempi servono per valutare un modello, e l’imbuto si stringe più lentamente di quanto verrebbe da sperare: non in proporzione al numero di prove, ma alla sua radice quadrata. Il conto è quello: con cento prove l’incertezza vale un certo tanto, e per dimezzarla non basta arrivare a duecento, bisogna arrivare a quattrocento, perché quello che deve raddoppiare è la radice, e la radice di quattrocento è il doppio della radice di cento (\(20\) contro \(10\)). Quattro volte i dati per metà dell’errore, e la tassa si paga ogni volta che si misura qualcosa su un campione.
Se ripeti tante volte lo stesso esperimento casuale, la media delle osservazioni si avvicina sempre di più al valore atteso. Su \(10\) lanci di una moneta equa, \(7\) teste non stupiscono nessuno. Su \(10\,000\) lanci, il \(70\%\) di teste è talmente improbabile che concluderesti (ragionevolmente) che la moneta è truccata.
Attenzione a un equivoco diffuso: il caso non si corregge, si diluisce. Dopo dieci teste di fila la moneta non «deve» croce, il lancio successivo resta 50 e 50. Quello che succede è che le dieci teste iniziali pesano sempre meno man mano che i lanci si accumulano, finché diventano irrilevanti nella media.
Due condizioni reggono la garanzia, e conviene tenerle distinte perché si rompono in modi diversi. La prima è che le osservazioni siano indipendenti, cioè che nessuna influenzi le altre: se le prime recensioni di un ristorante sono entusiaste, chi scrive dopo le ha lette e si adegua, e mille voti così non valgono mille pareri raccolti separatamente. La seconda è che vengano tutte dalla stessa distribuzione, cioè che si stia misurando sempre la stessa cosa: mille recensioni scritte dagli amici del ristoratore misurano l’amicizia, non la cucina, e sommarle a quelle dei clienti fa una media di due cose diverse. Se salta l’una o l’altra, la garanzia nella sua forma semplice non vale più (ne esistono versioni per dati dipendenti, ma chiedono condizioni che una raccolta fatta male non soddisfa), ed è la ragione per cui una raccolta di dati fatta male non migliora aggiungendone altra raccolta allo stesso modo.
Siano \(X_1,\dots,X_n\) variabili i.i.d. con media \(\mu=\mathbb{E}[X]\) finita. La media campionaria \(\bar{X}_n=\frac{1}{n}\sum_i X_i\) converge a \(\mu\): in probabilità (legge debole) e quasi certamente (legge forte).
La velocità è il punto che interessa il machine learning. Se \(\mathrm{Var}(X)=\sigma^2\), allora
L’errore cala come \(1/\sqrt{n}\), non come \(1/n\): per dimezzare l’incertezza servono quattro volte i dati. Vale per qualunque grandezza che si stimi come media di osservazioni indipendenti, e quindi per ogni metrica che sia una media sugli esempi di un test set, come l’accuratezza. L’errore di un modello addestrato segue invece curve di apprendimento proprie, con esponenti che dipendono dal compito e in genere sono più piccoli di \(1/2\) [KMH+20], anche se la tendenza ai rendimenti decrescenti è la stessa.
L’ipotesi i.i.d. è quella che si rompe più spesso nella pratica: dati correlati nel tempo, esempi duplicati, campioni raccolti da una sola fonte. Quando salta, \(n\) conta molto meno di quanto dica il conteggio delle righe.
Quanto fidarsi di una stima: gli intervalli di confidenza#
Un modello nuovo raggiunge l’\(87{,}2\%\) di accuratezza sul test set, il vecchio si fermava all’\(86{,}8\%\). Il team festeggia. Ma se il test set ha \(500\) esempi, quattro decimi di punto sono due risposte esatte in più. Due.

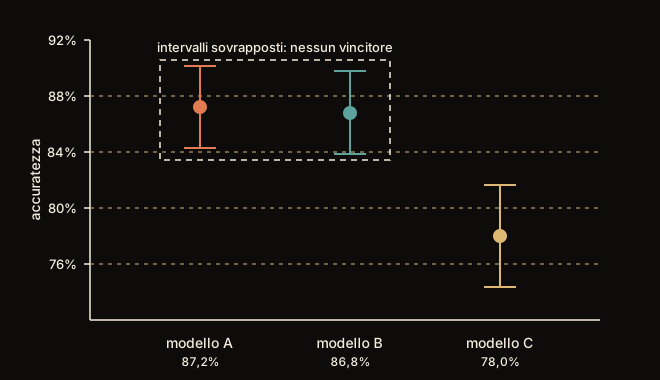
Fig. 3.21 Le stesse tre misure, con l’incertezza disegnata. A e B non sono distinguibili: la differenza fra loro è più piccola di quanto la misura possa risolvere. C invece è davvero peggiore.#
Fig. 3.21 mostra cosa si compra con una barra d’errore: la capacità di dire «non lo so». Senza, una classifica si può sempre stilare, e sembrerà informativa anche quando ordina rumore; con la barra, alcune coppie restano semplicemente a pari merito, che è la risposta corretta.
Un istituto intervista mille persone e trova il candidato A al \(47{,}2\%\). Nessun giornale serio pubblica quel numero da solo: accanto ci va il margine d’errore, e con mille intervistati quel \(47{,}2\%\) vuol dire «da qualche parte fra il \(44\%\) e il \(50\%\)». L’istituto non ha contato i voti di tutti. Ne ha presi mille a caso, un campione, e da quelli stima il numero vero, che si saprà solo la sera dello spoglio.
Provare un modello su \(500\) esempi è sondare \(500\) elettori. L’\(87\%\) di risposte esatte del modello nuovo è il suo sondaggio; l’elezione, cioè come se la caverebbe su tutti i casi possibili, nessuno la vedrà mai.
Il sondaggista il margine se lo fa a mente. Parte da un candidato al \(50\%\), dove gli intervistati sono più divisi e la stima balla di più: lì il margine è circa \(100/\sqrt{n}\) punti con \(n\) intervistati, perché l’incertezza di una media cala come uno diviso la radice del numero di prove (è la legge dei grandi numeri). Con \(500\) intervistati, \(\sqrt{500}\) è poco più di \(22\), quindi circa \(4{,}5\) punti. Poi accorcia, perché lontano dal \(50\%\) la stima balla meno: quando quasi tutti la pensano allo stesso modo, due campioni diversi si somigliano. Con la quota dell’\(87\%\) fa tre passi. Moltiplica la quota per la quota opposta, \(0{,}87 \times 0{,}13 = 0{,}113\), che è quanto balla una singola risposta (al massimo quando le due risposte sono alla pari, zero quando tutti rispondono uguale). Ne fa la radice, \(0{,}34\). La divide per \(0{,}5\), che è quanto lo stesso conto dà al \(50\%\): \(0{,}34\) diviso \(0{,}5\) fa circa due terzi (all’\(80\%\) verrebbe \(0{,}8\), al \(93\%\) circa la metà). I \(4{,}5\) punti per due terzi fanno un margine di tre punti.
La stima onesta del modello nuovo sta quindi fra l’\(84\%\) e il \(90\%\), quella del vecchio fra l’\(83{,}8\%\) e l’\(89{,}8\%\). I due intervalli si sovrappongono quasi per intero, e i quattro decimi di punto di vantaggio sono compatibili con il rumore, il nome che si dà alla parte di un risultato che viene dal caso e non dal merito.
Per stringere il margine l’istituto deve sentire più gente, e molta, perché sotto c’è una radice quadrata: un test set di \(5\,000\) esempi porta a circa \(\pm 1\) punto, uno di \(50\,000\) a \(\pm 0{,}3\). E il conto con la radice vale per i sondaggi normali: in un paesino di poche decine di elettori, o con un candidato dato al \(99\%\) o all’\(1\%\), sbaglia, e chi fa sondaggi passa a formule fatte apposta.
Il \(95\%\) stampato accanto al margine parla dell’istituto, non della singola tornata di telefonate. Il risultato dell’urna è già deciso, e o sta dentro il margine o non ci sta. Il \(95\%\) conta quante volte l’istituto ci prende lavorando così: di venti sondaggi, in media diciannove contengono il valore vero e uno lo manca, e quale sia lo sbagliato non lo dice nessuno.
Quando due candidati restano a pari merito, l’istituto torna dalle stesse persone e chiede a ciascuna quale dei due preferisce. Chi li apprezza entrambi, o non sopporta né l’uno né l’altro, non sposta niente: la partita si gioca su chi li divide. Due modelli provati sugli stessi \(500\) esempi rispondono uguale quasi ovunque, e a dividerli sono gli esempi in cui uno risponde giusto e l’altro no. Se quei casi si spartiscono quasi a metà, il pari merito è confermato. Se uno la spunta quasi sempre, il vantaggio è reale anche con i margini sovrapposti: due margini messi a confronto sono prudenti per costruzione, e qualche differenza vera la lasciano in ombra.
Per una proporzione \(\hat{p}\) stimata su \(n\) prove indipendenti, l’errore standard è \(\sqrt{\hat{p}(1-\hat{p})/n}\) e l’intervallo di Wald al livello \(95\%\) è
Con \(\hat{p}=0{,}872\) e \(n=500\): errore standard \(\approx 1{,}49\) punti, margine \(\approx 2{,}93\) punti, intervallo \([84{,}2\%,\ 90{,}2\%]\).
Cosa significa davvero «95%». Non che il valore vero abbia il \(95\%\) di probabilità di stare in questo intervallo: il valore vero è un numero fisso, o ci sta o non ci sta. Significa che la procedura, ripetuta su molti campioni, produce intervalli che contengono il valore vero nel \(95\%\) dei casi. È una proprietà del metodo, non di questo singolo risultato.
Due avvertenze pratiche. L’intervallo di Wald è inaffidabile con \(n\) piccolo o \(\hat p\) vicino a \(0\) o \(1\): con \(\hat p=0{,}98\) e \(n=100\) va da \(95{,}2\%\) a \(100{,}8\%\). Al suo posto si usa l’intervallo di Wilson, \(\dfrac{\hat p+z^2/2n\pm z\sqrt{\hat p(1-\hat p)/n+z^2/4n^2}}{1+z^2/n}\) (qui da \(92{,}9\%\) a \(99{,}5\%\)), oppure quello esatto di Clopper-Pearson. E quando si confrontano due modelli sullo stesso test set gli errori sono appaiati: il confronto fra due intervalli è conservativo e può nascondere differenze reali (\(90\%\) contro \(86\%\) su \(500\) esempi dà intervalli che si sovrappongono). Il test adatto è quello di McNemar [McN47] sui soli esempi in cui i due modelli dissentono: con \(b\) esempi giusti solo per il primo e \(c\) solo per il secondo, sotto \(H_0\) la statistica \((b-c)^2/(b+c)\) è approssimativamente \(\chi^2_1\), oppure si usa il test binomiale esatto su \(b\) con \(b+c\) prove e probabilità \(1/2\). Con \(b=30\) e \(c=10\) il \(p\) esatto è \(0{,}002\).
Escludere il caso: l’ipotesi nulla e il p-value#
Un intervallo di confidenza sa dire «non lo so», ed è già molto. Ma prima o poi qualcuno chiede una risposta secca: questo modello è meglio dell’altro, sì o no? Questa serie di dati è cambiata rispetto al mese scorso, sì o no? Una risposta secca si può dare, a patto di dichiarare quanto spesso si è disposti a sbagliarla.
Cento lanci di una moneta, sessanta teste. È truccata?
La statistica comincia, e la prima volta sorprende, dalla risposta che vorrebbe scartare: suppone la moneta onesta, e guarda quanto sarebbe strano un sessanta contro quaranta se lo fosse davvero. Quella supposizione si chiama ipotesi nulla. Non si scrive perché ci si creda: si scrive perché è l’unica su cui si sappiano fare i conti. «Onesta» dice esattamente che numeri aspettarsi; «truccata» non dice niente, perché truccata al cinquantacinque per cento e truccata al novanta sono due mondi diversi.
Il conto a mente si fa con la regola 68–95, che entro due larghezze dal centro di una campana mette circa il \(95\%\) dei casi. Su cento lanci di una moneta onesta le teste si accumulano attorno a cinquanta, e la campana è larga la radice di un quarto dei lanci (un quarto perché ogni lancio contribuisce con la quota per la quota opposta, un mezzo per un mezzo): un quarto di cento fa venticinque, la cui radice è cinque teste. Sessanta sta dunque due larghezze sopra il centro, e fuori da due larghezze si finisce circa cinque volte su cento.
«Circa» però non basta, perché la soglia è proprio cinque su cento, e la campana approssima un conto che si può fare esatto, contando quante file di cento testa-o-croce hanno sessanta teste o più. Uno sbilanciamento di sessanta e più (o di quaranta e meno) capita a una moneta onesta \(57\) volte su mille, cioè \(0{,}057\): la regola a mente dava l’ordine di grandezza giusto, la decisione la prende la cifra. Quel numero, quanto spesso il caso da solo produrrebbe una stranezza almeno pari a quella vista, si chiama \(p\), o \(p\)-value. Ed è un’altra \(p\) rispetto a quella che indicava la probabilità che esca testa: quella era una proprietà della moneta, questa della prova appena fatta.
Si contano anche i quaranta e meno perché la domanda era «è truccata», e non «è truccata a favore di testa». Chi sceglie il verso dopo aver visto il risultato si dà due occasioni di gridare al trucco invece di una, e quella in più se la prende anche quando il trucco non c’è.
Chi fa la prova sul serio decide prima di lanciare quanto piccolo debba essere \(p\) perché si smetta di credere all’ipotesi nulla. Per convenzione cinque su cento, e quel numero non dice quanto è forte la prova: dice quanto spesso si accetta di accusare una moneta onesta. Qui \(p\) vale \(0{,}057\), appena sopra la soglia, e la moneta non viene accusata: ci sarebbero volute sessantuno teste.
Il verdetto può sbagliare in due modi. Si può accusare una moneta onesta, e quanto spesso capita lo si è deciso a tavolino. Oppure si può lasciar passare una moneta truccata, e capita tanto più spesso quanto meno si è lanciato: con venti lanci e dodici teste \(p\) vale \(0{,}503\), e con una prova così corta la stessa proporzione di teste non dice più niente. Non accusare non è assolvere. E i due errori si scambiano: alzare l’asticella per accusare lascia passare più monete truccate, e viceversa. Con la stessa prova in mano, l’unico modo di stringerli tutti e due è lanciare di più.
C’è poi un modo di leggere \(p\) che è sbagliato, ed è il primo che viene in mente: \(p\) non è la probabilità che la moneta sia onesta. Per dire quella servirebbe sapere quante monete truccate girano, che è il passaggio del teorema di Bayes visto prima. \(p\) risponde a una domanda sola: se fosse onesta, quanto spesso vedrei una cosa così?
Si fissa un’ipotesi nulla \(H_0\) (la moneta è onesta, \(\theta = 1/2\)), un’alternativa \(H_1\), e una statistica \(T\) calcolata sui dati. Il \(p\)-value è
dove \(T_{\text{oss}}\) è il valore osservato e «almeno estrema» va nel verso dell’alternativa (bilaterale, se conta lo sbilanciamento in entrambi i sensi). Con \(n = 100\) e \(60\) successi, la binomiale esatta dà \(p = 0{,}057\) (bilaterale come raddoppio della coda minore, la convenzione più diffusa; la variante che somma tutte le probabilità non superiori a quella osservata qui coincide, perché la binomiale con \(\theta = 1/2\) è simmetrica).
La discretezza costa qualcosa, e va detto perché si vede nei conti. I valori ottenibili di \(p\) sono un insieme finito, quindi il livello nominale \(\alpha\) non è quasi mai raggiunto: con \(n = 100\) il più piccolo rifiuto ammesso è a \(61\) successi, e la taglia effettiva del test è \(0{,}035\) invece di \(0{,}05\). Un test esatto su una statistica discreta è conservativo, e un conto di falsi positivi fatto con \(\alpha\) nominale ne prevede più di quanti ne arrivino.
Il livello \(\alpha\) si fissa prima, e Neyman e Pearson [NP33] gli danno il significato che ancora si usa: è la frequenza con cui la procedura rifiuta \(H_0\) quando \(H_0\) è vera, cioè l’errore di prima specie. L’errore di seconda specie \(\beta\) è non rifiutare quando \(H_1\) è vera, e \(1-\beta\) è la potenza. A test fissato i due si scambiano; per stringerli insieme serve \(n\).
La dualità con gli intervalli di confidenza vale a parità di famiglia: rifiutare \(H_0: \theta = \theta_0\) al livello \(\alpha\) equivale a non trovare \(\theta_0\) dentro l’intervallo di confidenza al \(1-\alpha\) costruito con lo stesso metodo. L’intervallo di Wald e il test binomiale esatto non sono duali fra loro, e chi li mescola trova casi in cui uno rifiuta e l’altro contiene, e con \(n = 100\) succede proprio alle sessanta teste da cui questo conto è partito. Le coppie giuste: Clopper-Pearson con il test binomiale esatto, Wald con il test \(z\) che stima l’errore standard dalla proporzione osservata, Wilson con il test \(z\) che lo calcola sotto \(H_0\). Test e intervallo dicono la stessa cosa in due modi, e l’intervallo dice in più quali valori restano compatibili.
Sull’interpretazione l’American Statistical Association ha ritenuto necessario un comunicato [WL16], sei principi. Il primo dice che cosa il \(p\)-value fa: indica quanto i dati siano incompatibili con un modello statistico specificato. Un altro dice che cosa non fa: non misura la probabilità che l’ipotesi studiata sia vera, né la probabilità che i dati siano stati prodotti dal solo caso. Un terzo non parla del \(p\)-value ma di chi lo legge: nessuna conclusione dovrebbe reggersi soltanto sul fatto che un \(p\)-value superi o non superi una soglia. Il divieto del secondo è il passaggio da \(\Pr(\text{dati} \mid H_0)\) a \(\Pr(H_0 \mid \text{dati})\), che senza una probabilità a priori non si fa.
Il punto di rottura è a monte del conto. Il \(p\)-value ha il significato dichiarato solo se la statistica, il verso e la soglia sono stati scelti prima di guardare i dati. Chi prova più definizioni di errore, più finestre temporali, più sottogruppi e riporta la migliore ha misurato la propria ostinazione, ed è la stessa porta da cui entra il guaio della molteplicità.
Mille domande insieme: Bonferroni e le false scoperte#
Il guaio comincia quando la domanda non è una sola. Un programma che sorveglia un modello al lavoro tiene d’occhio trecento grandezze e per ciascuna chiede «è cambiata?»; uno studio di genetica misura ventimila geni; un banco di prova confronta sessanta modi di regolare la stessa rete. La soglia che regge una domanda non regge trecento.
Un ispettore riceve una scatola con mille monete, novecento oneste e cento truccate, e da fuori non si vede quali. Le truccate escono testa il sessantacinque per cento delle volte: al sessanta, come si è appena visto, in cento lanci non si distinguerebbero. L’ispettore lancia ogni moneta cento volte e accusa quella che sbilancia troppo da una parte o dall’altra, con la solita soglia di cinque su cento: da sessantuno teste in su, o da trentanove in giù.
Il guaio si vede prima ancora di aprire la scatola. La soglia prometteva cinque accuse ingiuste ogni cento monete oneste, che con novecento farebbero quarantacinque; saranno una trentina, perché le teste sono un numero intero e la soglia non si può centrare esattamente, ma trenta o quarantacinque il punto non cambia. Nell’elenco delle accusate, lungo un centinaio, decine di monete sono lì per caso, e chi lo legge non ha modo di sapere quali.
La prima riparazione alza l’asticella in proporzione al numero delle domande: con mille monete l’ispettore chiede \(0{,}05\) diviso mille, cioè cinque su centomila. Il conto che la giustifica sta in una riga: ogni moneta onesta viene accusata cinque volte su centomila, le oneste sono novecento, e novecento per cinque su centomila fa al più cinque centesimi di accusa ingiusta a scatola, cioè un innocente accusato al più in una scatola su venti. Di nuovo cinque su cento, ma riferito all’intera scatola invece che alla singola moneta. È la correzione di Bonferroni, prudentissima, e il prezzo si vede subito: con l’asticella così in alto smettono di essere accusate anche quasi tutte le monete davvero truccate.
La seconda riparazione cambia la promessa, e si chiama Benjamini-Hochberg. Invece di «quasi certamente non accuso nemmeno una moneta onesta», l’ispettore promette «fra le monete che accuso, in media non più del cinque per cento sono oneste», e anzi qualcosa meno, tanto meno quante più truccate ci sono nella scatola. In media su tante scatole, perché su una scatola sola nessuno può garantire niente; ed è una promessa più debole, che proprio per questo permette di accusarne molte di più.
L’ispettore mette in fila le mille monete, dalla più sbilanciata alla meno, e alla moneta che sta al posto numero \(k\) chiede una soglia di \(k\) volte il cinque per cento diviso mille: alla prima cinque su centomila, come Bonferroni; alla seconda il doppio; alla decima dieci volte tanto; alla centesima cento volte tanto, cioè il cinque per cento diviso dieci. Scende fino all’ultima che ce la fa, segna quel posto, e accusa tutte le monete da lì in su. Nel gruppo finisce anche qualcuna che da sola non ce l’avrebbe fatta, ed è voluto. Bonferroni giudica ogni moneta da sola, come se fosse l’unica; qui una moneta un po’ sospetta viene creduta anche per la compagnia in cui si trova, perché sopra di lei nella fila ce ne sono decine ancora più sbilanciate, e decine di monete sbilanciate tutte insieme il caso da solo non le produce. La cosa che si tiene sotto controllo si chiama tasso di false scoperte, e «scoperta» è il nome che si dà a un’accusa quando il colpevole non è una moneta ma un gene o un guasto.
Quale delle due serva dipende da che cosa succede dopo l’accusa. Se ogni segnalazione fa scattare qualcosa di costoso, e una segnalazione sbagliata si paga cara, la prudenza di Bonferroni è quella giusta. Se invece la segnalazione apre soltanto un controllo, e di controlli se ne possono fare a decine, tenere bassa la quota di controlli inutili serve molto più che evitarne uno a tutti i costi.
Con \(m\) test simultanei, sia \(V\) il numero di ipotesi nulle vere rifiutate (falsi positivi) e \(R\) il numero totale di rifiuti. Le due grandezze da controllare sono
(con \(V/R\) posto a \(0\) quando \(R = 0\)). La prima è la probabilità di sbagliare almeno una volta in tutta la famiglia; la seconda è la quota attesa di errori fra le scoperte annunciate.
La correzione di Bonferroni confronta ogni \(p\)-value con \(\alpha/m\) [Dun61]. Che controlli la FWER segue dalla disuguaglianza di Boole, \(\Pr(\bigcup_i A_i) \le \sum_i \Pr(A_i)\), e quindi non chiede indipendenza: è la sua forza e la ragione della sua prudenza. Una cosa la chiede, e va detta perché è quella che si rompe più spesso: che ogni \(p\)-value sia valido di per sé, cioè \(\Pr(p_i \le t \mid H_0) \le t\). Con \(p\)-value ottimisti Bonferroni fallisce anche senza nessuna dipendenza. Un’alternativa gratuita e mai peggiore esiste: la procedura di Holm ordina i \(p\)-value e allenta la soglia man mano, controlla la stessa FWER sotto le stesse ipotesi e rifiuta sempre almeno quanto Bonferroni.
La procedura di Benjamini e Hochberg [BH95] controlla invece la FDR a un livello \(q\): si ordinano i \(p\)-value \(p_{(1)} \le \dots \le p_{(m)}\), si cerca il più grande \(k\) tale che
e si rifiutano le prime \(k\) ipotesi. Sotto indipendenza, e sotto la dipendenza positiva che Benjamini e Yekutieli chiamano PRDS [BY01], la garanzia è \(\mathrm{FDR} \le q\,m_0/m\), dove \(m_0\) è il numero di ipotesi nulle vere: con il \(90\%\) di nulle vere e \(q = 0{,}05\), il limite effettivo è \(4{,}5\%\). Fuori di lì la garanzia cade e serve la versione conservativa \(q/\sum_{j \le m} 1/j\). E come Bonferroni, anche questa presuppone \(p\)-value validi: se sotto \(H_0\) sono conservativi, come lo sono i \(p\)-value binomiali delle monete, la FDR misurata resta sotto il limite per quella ragione e non per merito della procedura.
Il punto di rottura sta nella parola attesa. La FDR è una media su ripetizioni: sul singolo insieme di dati la quota di falsi fra le scoperte può essere ben più alta di \(q\), e nessuna procedura può garantire il contrario. La scelta fra le due grandezze è quindi una scelta di mestiere: confermare una singola affermazione chiede la FWER, esplorare ventimila geni chiede la FDR.
I due \(p\) delle monete singole e la differenza fra le tre strade si misurano nello stesso blocco. Per la scatola: mille monete, cento delle quali escono testa il \(65\%\) delle volte e le altre novecento oneste, cento lanci a testa, e il \(p\) calcolato contando le combinazioni; il tutto ripetuto trecento volte con scatole sorteggiate in modo diverso, perché una quota media si guarda su molte prove.
import numpy as np
from math import comb

M, TRUCCATE, LANCI = 1000, 100, 100
SBILANCIO, ALFA, PROVE = 0.65, 0.05, 300

def massa_binomiale(n):
    return [comb(n, i) / 2**n for i in range(n + 1)]

def tabella_p(n):
    """Quanto spesso una moneta onesta sbilancia almeno quanto k teste,
    contando tutti e due i versi."""
    massa = massa_binomiale(n)
    return [min(1.0, 2 * min(sum(massa[:k+1]), sum(massa[k:]))) for k in range(n + 1)]

tavola = tabella_p(LANCI)
massa = massa_binomiale(LANCI)
prima = next(k for k in range(LANCI // 2 + 1, LANCI + 1) if tavola[k] <= ALFA)
taglia = sum(massa[k] for k in range(LANCI + 1) if tavola[k] <= ALFA)
print(f"larghezza tipica della campana dei {LANCI} lanci: {(LANCI * 0.25)**0.5:.1f} teste")
print(f"p di 60 teste su 100 lanci: {tavola[60]:.3f}")
print(f"p di 12 teste su  20 lanci: {tabella_p(20)[12]:.3f}")
print(f"prima accusata a {prima} teste; soglia dichiarata {ALFA}, "
      f"quota vera di oneste accusate {taglia:.3f}")
print()

truccata = np.zeros(M, dtype=bool)
truccata[M - TRUCCATE:] = True

def una_scatola(seme):
    rng = np.random.default_rng(seme)
    teste = rng.binomial(LANCI, np.where(truccata, SBILANCIO, 0.5))
    p = np.array([tavola[k] for k in teste])
    ordine = np.argsort(p)                       # Benjamini-Hochberg
    sotto = np.nonzero(p[ordine] <= ALFA * np.arange(1, M + 1) / M)[0]
    bh = np.zeros(M, dtype=bool)
    if len(sotto):
        bh[ordine[:sotto[-1] + 1]] = True
    return {"nessuna correzione": p < ALFA, "Bonferroni": p < ALFA / M, "Benjamini-Hochberg": bh}

conti = {nome: [] for nome in ("nessuna correzione", "Bonferroni", "Benjamini-Hochberg")}
for seme in range(PROVE):
    for nome, accusate in una_scatola(seme).items():
        n = accusate.sum()
        conti[nome].append((n, (accusate & ~truccata).sum() / n if n else 0.0,
                            (accusate & truccata).sum()))

for nome, righe in conti.items():
    n, quota, trovate = (np.mean([r[i] for r in righe]) for i in range(3))
    print(f"{nome:20} accusate {n:6.1f}   oneste fra le accusate {100*quota:5.1f}%"
          f"   truccate trovate {trovate:5.1f} su {TRUCCATE}")
larghezza tipica della campana dei 100 lanci: 5.0 teste
p di 60 teste su 100 lanci: 0.057
p di 12 teste su  20 lanci: 0.503
prima accusata a 61 teste; soglia dichiarata 0.05, quota vera di oneste accusate 0.035

nessuna correzione   accusate  115.3   oneste fra le accusate  27.9%   truccate trovate  83.0 su 100
Bonferroni           accusate   12.7   oneste fra le accusate   0.2%   truccate trovate  12.7 su 100
Benjamini-Hochberg   accusate   48.6   oneste fra le accusate   3.5%   truccate trovate  46.9 su 100
I numeri delle ultime tre righe sono medie su trecento scatole, ed è per questo che hanno la virgola. Senza correzione si annunciano centoquindici scoperte e più di una su quattro è rumore: la soglia del cinque per cento sta facendo il suo mestiere una domanda alla volta, e chi legge l’elenco intero non ha nessuna delle garanzie che crede di avere. Bonferroni porta i falsi quasi a zero e trova tredici monete truccate su cento; Benjamini-Hochberg ne trova quarantasette, e la quota di oneste fra le accusate resta al \(3{,}5\%\), sotto il \(4{,}5\%\) promesso (che è il cinque per cento moltiplicato per la quota di monete oneste nella scatola). L’ultima colonna, quante truccate si trovano su cento, ha un nome: è la potenza della procedura. Le tre righe descrivono tre promesse diverse, non una classifica, e la domanda giusta è quale delle tre serva a chi legge il risultato.
Un conto va rifatto, perché non torna, e la ragione è istruttiva. Senza correzione le accusate sono \(115\) e le truccate trovate \(83\): le oneste accusate sono quindi una trentina, mentre il cinque per cento di novecento ne farebbe prevedere quarantacinque. La spiegazione sta nella riga che stampa la quota vera di oneste accusate, \(0{,}035\) invece di \(0{,}05\). Le teste sono un numero intero, e fra sessanta e sessantuno non c’è niente: a sessanta \(p\) vale \(0{,}057\) e non basta, a sessantuno vale \(0{,}035\) e basta. La soglia dichiarata è cinque su cento, quella che si ottiene davvero è tre e mezzo su cento, e il test è più prudente di quanto prometta. Da lì viene anche il margine fra il \(3{,}5\%\) misurato e il \(4{,}5\%\) promesso: con \(p\)-value continui quel margine sparirebbe. È il primo posto in cui guardare quando un conto sui \(p\)-value non torna.
Correlazione non è causalità#
Nei mesi estivi aumentano le vendite di gelato. Negli stessi mesi aumentano gli annegamenti. Le due curve salgono e scendono insieme con regolarità quasi imbarazzante, e un modello addestrato su questi dati imparerebbe la relazione senza esitare. Nessuno però propone di vietare il gelato: dietro entrambe le curve c’è una terza cosa, il caldo.

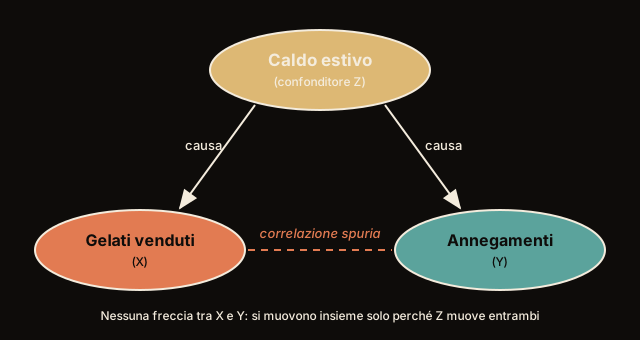
Fig. 3.22 Il confondente, disegnato (nel disegno è etichettato «confonditore Z»: i due nomi indicano la stessa cosa, e qui si usa il primo). Fra gelati e annegamenti non passa nessuna freccia: il legame che si misura nei dati è tutto riflesso di quello che ciascuno dei due ha con il caldo.#
In Fig. 3.22 conta soprattutto ciò che non c’è: la freccia fra \(X\) e \(Y\), cioè fra i gelati e gli annegamenti (nel disegno le due lettere stanno per le due grandezze che si misurano, e \(Z\) per la causa comune). I dati da soli non la disegnano né la cancellano: fra due sole variabili correlazione e causalità lasciano sui numeri la stessa traccia. A distinguerle serve qualcosa che nei dati non c’è: un intervento (cambiare \(X\) e guardare \(Y\)) oppure una conoscenza del dominio che dica quale freccia è plausibile.
La correlazione misura il co-movimento: quanto due grandezze tendono a salire e scendere insieme. Ed è simmetrica e cieca.
Simmetrica: la correlazione fra gelati e annegamenti è identica a quella fra annegamenti e gelati (il numero non contiene alcuna informazione su chi influenzi chi).
Cieca: non distingue fra una relazione diretta, una mediata da altro e una pura coincidenza. È come notare che due colleghi arrivano sempre insieme in ufficio: potrebbero viaggiare insieme, o semplicemente prendere lo stesso treno perché abitano nello stesso quartiere.
Il caldo dell’esempio si chiama confondente: una causa comune che spiega entrambi gli effetti. Accanto alla causa comune vivono altre due strutture. La catena è un legame vero che fa scalo: il caldo fa venire sete, la sete fa vendere bibite; la causalità c’è, ma passa per un anello intermedio. Il collider nasce quando si sceglie chi guardare: fra i ristoranti che sopravvivono, quelli nei vicoli senza passaggio cucinano meglio della media, perché lì resta aperto solo chi cucina davvero bene. Fra tutti i ristoranti quel legame non esiste; lo ha creato la selezione dei sopravvissuti.
Il guaio è che noi il caldo lo sospettiamo per buon senso; un modello no. Impara la scorciatoia che funziona sui dati che ha visto e la usa finché il mondo non cambia: poi sbaglia, e sbaglia in modo inspiegabile.
Il coefficiente di Pearson fra \(X\) e \(Y\) è
dove \(\mathrm{Cov}(X,Y)=\mathbb{E}\big[(X-\mu_X)(Y-\mu_Y)\big]\) è la covarianza, cioè la media del prodotto dei due scarti dalla propria media (positiva se le due grandezze stanno di solito dalla stessa parte del proprio centro, negativa se da parti opposte), e \(\sigma_X,\sigma_Y\) sono le due deviazioni standard, che servono a togliere di mezzo le unità di misura.
Con più variabili le covarianze si raccolgono in una matrice. Per un vettore aleatorio \(\mathbf{x}\in\mathbb{R}^d\) con media \(\boldsymbol{\mu}=\mathbb{E}[\mathbf{x}]\), la matrice di covarianza è \(\boldsymbol{\Sigma}=\mathbb{E}\big[(\mathbf{x}-\boldsymbol{\mu})(\mathbf{x}-\boldsymbol{\mu})^\top\big]\in\mathbb{R}^{d\times d}\), con \(\Sigma_{ij}=\mathrm{Cov}(x_i,x_j)\) e le varianze sulla diagonale. È simmetrica e semidefinita positiva, perché \(\mathbf{v}^\top\boldsymbol{\Sigma}\mathbf{v}=\mathrm{Var}(\mathbf{v}^\top\mathbf{x})\ge 0\) per ogni \(\mathbf{v}\): la varianza lungo una direzione unitaria è una forma quadratica, e massimizzarla porta all’autovettore dominante di \(\boldsymbol{\Sigma}\), cioè alla PCA della sezione sull’algebra lineare. Se \(\boldsymbol{\Sigma}\) è definita positiva, la normale multivariata ha densità
e il suo \((\det\boldsymbol{\Sigma})^{1/2}\) è proporzionale al volume dell’ellissoide di covarianza della sezione sul determinante.
Il coefficiente misura la sola dipendenza lineare: \(\rho=0\) non implica indipendenza; se \(X\) è distribuita in modo simmetrico attorno allo zero, \(Y=X^2\) ha correlazione nulla con \(X\) e dipendenza perfetta. (La simmetria è essenziale: per \(X\) uniforme su \([0,1]\) la stessa parabola dà una correlazione vicina a \(0{,}97\).)
Le strutture da tenere distinte:
confondente: \(Z \to X\) e \(Z \to Y\) producono correlazione fra \(X\) e \(Y\) senza alcun legame causale diretto (il caldo);
catena: \(X \to Z \to Y\), causalità reale ma mediata;
collider: \(X \to Z \leftarrow Y\), dove condizionare su \(Z\) crea correlazione fra \(X\) e \(Y\) che non esisteva. È il meccanismo dietro molti paradossi di selezione del campione.
Dai soli dati osservativi la catena e il confondente sono indistinguibili: tutti e due rendono \(X\) e \(Y\) dipendenti, e tutti e due le rendono indipendenti dato \(Z\). Il collider lascia invece un’impronta propria, \(X\) e \(Y\) indipendenti finché non si condiziona su \(Z\), ed è questa struttura a v che gli algoritmi di scoperta causale riescono a orientare dai dati, sotto l’ipotesi che ogni indipendenza osservata venga dal grafo (fedeltà). Il verso di una catena e un confondente non osservato chiedono invece un intervento (esperimento randomizzato) o assunzioni causali esplicite. Nel machine learning la conseguenza ha un nome, shortcut learning: il modello aggancia la correlazione più comoda del dataset (lo sfondo invece dell’animale, il marcatore dell’ospedale invece della patologia) e crolla appena la distribuzione cambia. La correlazione basta per predire dentro la stessa distribuzione; non basta per decidere un intervento.
Tre gradini: vedere, fare, immaginare#
Le tre strutture appena elencate si sistemano dentro una cornice più larga, da avere in testa perché rimette in fila cose che tornano in capitoli lontanissimi fra loro. La propone Judea Pearl, e la chiama scala della causalità [PM18].
I gradini sono tre, e ognuno risponde a un tipo di domanda che il gradino sotto non sa nemmeno formulare.
Vedere. «Fra chi compra il gelato, quanti annegano?» È una domanda che si risolve guardando i dati e contando. Tutto ciò che si fa con una tabella, un grafico o un modello che prevede sta qui: si osserva quello che è successo e si cercano le regolarità.
Fare. «Se vietassi il gelato, gli annegamenti calerebbero?» Non è la stessa domanda, e non si risponde con gli stessi dati. Osservare chi compra il gelato non è come far comprare il gelato a qualcuno scelto a caso: nel secondo caso si è tagliata la freccia che va dal caldo alla decisione d’acquisto. È il motivo per cui esistono gli esperimenti randomizzati.
Immaginare. «Quel bagnante che è annegato, si sarebbe salvato se non fosse uscito quel giorno?» Riguarda un caso singolo e un mondo che non è accaduto. Non basta nemmeno l’esperimento, perché l’esperimento dice cosa succede in media, non cosa sarebbe successo a lui.
I modelli addestrati sui dati stanno quasi tutti sul primo gradino, e ci stanno benissimo. Pearl lo dice con un’immagine: la civetta può essere un buon cacciatore senza capire perché il topo vada sempre da A a B [PM18]. La civetta ha visto migliaia di topi e sa dove sarà questo fra un secondo, il che le basta per prenderlo; delle ragioni per cui il topo si sposta non sa niente, e non le servono. Predire, insomma, non richiede capire. Il punto è sapere quale domanda si sta facendo, perché salire un gradino richiede sempre qualcosa che nei dati non c’è.
I tre livelli si distinguono formalmente dall’oggetto probabilistico che sanno esprimere.
Associazione: \(P(y \mid x)\), cioè condizionare. È tutto ciò che si ottiene osservando, e include correlazione, regressione e ogni modello puramente predittivo.
Intervento: \(P(y \mid do(x))\), dove l’operatore \(do\) denota l’imposizione di \(X = x\) dall’esterno, che nel grafo causale corrisponde a recidere tutti gli archi entranti in \(X\). In generale \(P(y \mid do(x)) \neq P(y \mid x)\), e la differenza è esattamente il contributo dei confondenti.
Controfattuale: \(P(y_x \mid x', y')\), la probabilità che \(Y\) sarebbe stato \(y\) sotto \(X = x\), dato che in realtà si è osservato \(x'\) e \(y'\). Richiede un modello strutturale completo, non solo il grafo.
Il risultato che rende la scala operativa e non solo tassonomica è che condizioni grafiche esplicite (il criterio di backdoor, il do-calculus) dicono quando una quantità di livello 2 è calcolabile a partire da soli dati osservativi di livello 1, e con quale aggiustamento. Se un insieme \(Z\) di variabili osservate soddisfa il criterio di backdoor, \(P(y\mid do(x))=\sum_z P(y\mid x,z)\,P(z)\), mentre la semplice associazione è \(P(y\mid x)=\sum_z P(y\mid x,z)\,P(z\mid x)\): la differenza sta nel peso, \(P(z)\) al posto di \(P(z\mid x)\). Non sempre la quantità è calcolabile: se i confondenti rilevanti non sono osservati, nessuna quantità di dati basta, ed è un’impossibilità di principio, non un limite di campione.
La conseguenza per chi costruisce sistemi è che il gradino di una domanda determina che dati servono. Chiedere «quali clienti abbandoneranno» è livello 1 e un classificatore basta; chiedere «quali clienti abbandoneranno se non li chiamiamo» è livello 2, e un classificatore addestrato su dati in cui le chiamate erano decise da qualcuno risponde alla domanda sbagliata con grande sicurezza.
I tre gradini si distinguono per che cosa serve avere prima di poter rispondere, non per quanto siano nobili le domande. Sul primo gradino, quello di chi guarda i dati e conta, sta la gran parte di quello che leggeremo. Sul secondo, quello di chi il mondo lo tocca invece di limitarsi a guardarlo, stanno i test A/B (si mostrano due versioni di un prodotto a due gruppi di utenti scelti a caso e si confrontano i risultati) e l’apprendimento per rinforzo, dove un programma i dati non li riceve, se li produce agendo. Sul terzo stanno le domande su ciò che non è successo, tipo «a questo cliente il prestito è stato negato; glielo avrebbero dato con mille euro di reddito in più?»: si chiamano spiegazioni controfattuali. Il secondo gradino non ha un capitolo proprio: lo abita l’apprendimento per rinforzo, dove l’agente produce i propri dati agendo, come racconta il capitolo sul reinforcement learning; le spiegazioni controfattuali stanno nel capitolo sull’interpretabilità.
Dalla probabilità all’apprendimento#
Resta un’ultima domanda: cosa c’entra tutto questo con l’addestrare un modello? Il ponte si chiama massima verosimiglianza (maximum likelihood estimation, MLE).

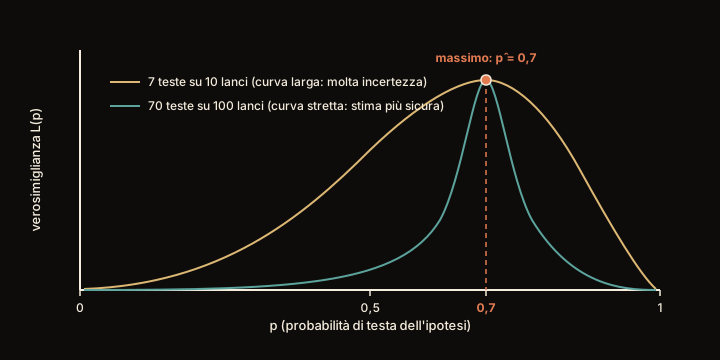
Fig. 3.23 Stessa proporzione, due quantità di prove. Il punto più alto non si sposta; a cambiare è quanto la curva sia stretta, cioè quanto ci si può contare. Il cappello su \(\hat p\), nel disegno, vuol dire «ricavato dai dati», e serve a tenerlo distinto dal valore vero, che nessuno conosce.#
Le due curve di Fig. 3.23 dicono ciò che la sola stima non dice. Con dieci lanci molti valori di \(p\) spiegano l’osservazione quasi altrettanto bene; con cento, no. La stima puntuale è identica, ma la seconda è un’affermazione molto più forte, e a misurare la differenza è la larghezza della curva.
Abbiamo dei dati e vogliamo scegliere i parametri che li rendono meno sorprendenti possibile. Lancio una moneta 10 volte e vedo 7 teste: quale valore di \(p\) (la probabilità che esca testa) spiega meglio quel che ho osservato?
Il modo di rispondere è provarli tutti e tenere il migliore. Per ogni valore di \(p\) si calcola quanto sarebbe probabile vedere proprio 7 teste su 10. Il conto ha due pezzi. Il primo: una sequenza precisa, per dire TTTTTTTCCC, ha probabilità \(p^7(1-p)^3\), cioè sette volte \(p\) per tre volte \(1-p\). Il secondo: di sequenze con sette teste ce ne sono \(120\), tutte ugualmente probabili, quindi si moltiplica per \(120\). Con \(p=0{,}5\) viene \(120 \cdot 0{,}5^{10} \approx 0{,}12\), cioè il \(12\%\): possibile, non entusiasmante. Se fosse \(p=0{,}6\) si salirebbe al \(21\%\), con \(p=0{,}7\) si arriverebbe al \(27\%\), con \(p=0{,}8\) si ridiscenderebbe al \(20\%\). Il massimo cade a \(0{,}7\), cioè esattamente sulla proporzione osservata, ed è questo che si intende quando si dice che \(0{,}7\) è il valore «che rende l’osservazione più probabile».
Quel «quanto è probabile l’osservazione, se il parametro valesse così» ha un nome: si chiama verosimiglianza. La curva della figura è proprio questa: per ogni valore di \(p\) sull’asse orizzontale, quanto sarebbe verosimile ciò che ho visto.
«Imparare», per un modello, è spesso esattamente questo: girare le manopole dei parametri finché i dati osservati diventano i più plausibili.
Dati esempi indipendenti \(x^{(1)},\dots,x^{(m)}\), la verosimiglianza dei parametri \(\theta\) è
e la stima di massima verosimiglianza è
Il passaggio dal prodotto alla somma dei logaritmi è lecito perché il logaritmo è strettamente crescente: applicarlo non sposta il punto di massimo, e i due problemi hanno lo stesso \(\arg\max\). Che poi sommare sia anche numericamente più stabile che moltiplicare mille numeri piccoli è un secondo vantaggio, non la giustificazione.
(Scriviamo \(L\) e non \(\mathcal{L}\): la \(\mathcal{L}\) calligrafica indica la loss, che si minimizza; la verosimiglianza si massimizza, e le due si incontrano nella log-verosimiglianza negativa, \(\mathcal{L}(\theta)=-\log L(\theta)\) a meno di costanti.) Il punto cruciale: per un modello di regressione che descrive \(y\) dato \(x\) come una gaussiana centrata sulla predizione, \(y \mid x \sim \mathcal{N}(\hat{y},\sigma^2)\) con varianza fissa, massimizzare la log-verosimiglianza equivale a minimizzare l’errore quadratico medio; sotto ipotesi di Bernoulli/categoriche equivale a minimizzare la cross-entropy. Le loss di regressione e di classificazione più usate sono verosimiglianze travestite, non scelte arbitrarie: a svestirle una per una, e a farne una procedura applicabile a una distribuzione qualsiasi, è Da dove viene la loss.
Con un’opinione di partenza: la stima bayesiana#
La massima verosimiglianza tratta il parametro come un numero da trovare e basta. Il teorema di Bayes, visto sopra, permette di fare di più: dare al parametro \(\theta\) (per la moneta, la probabilità di testa) una distribuzione a priori \(p(\theta)\), in breve la priore, che dice che cosa se ne pensa prima dei dati, e ottenere con i dati \(\mathcal{D}\) la distribuzione a posteriori \(p(\theta \mid \mathcal{D})\), la posteriore, dove la barra si legge «sapendo che». Da lì escono la stima MAP (maximum a posteriori, il punto più alto della posteriore) e, quando la priore è coniugata alla verosimiglianza, cioè scelta in modo che la posteriore abbia la stessa forma della priore, un aggiornamento che si riduce a sommare dei conteggi. Fig. 3.24 mostra l’aggiornamento sulla moneta, un lancio dopo l’altro.
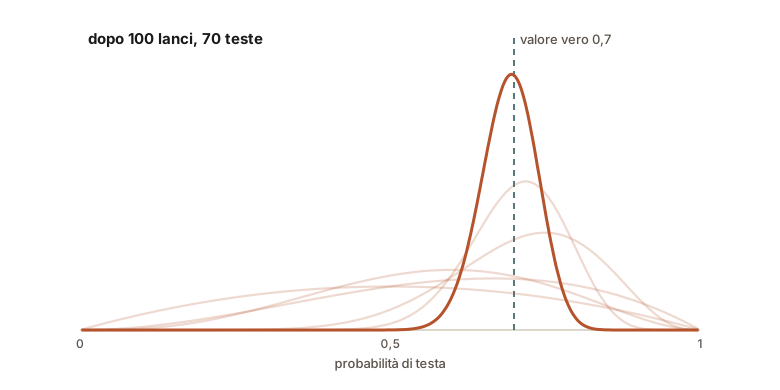
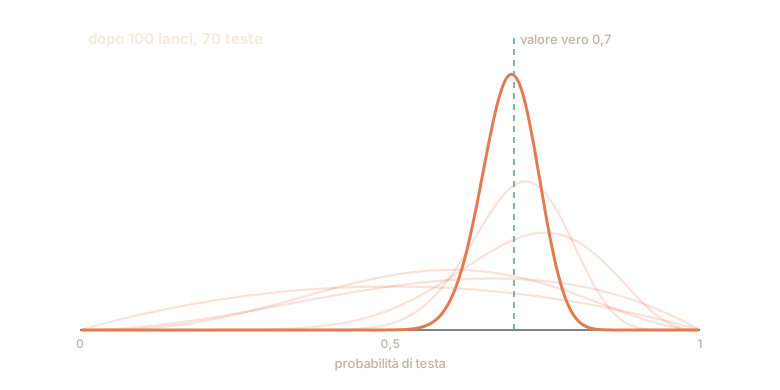
Fig. 3.24 La credenza sulla probabilità di testa, prima dei lanci e dopo 1, 3, 10, 30 e 100 lanci di una moneta che fa testa il 70% delle volte: a ogni tappa la curva si alza e si stringe, e alla fine sta attorno al valore vero.#
Chi prende in mano una moneta qualunque, prima di lanciarla, un’idea ce l’ha: non sa se fa testa esattamente metà delle volte, ma non scommetterebbe che la faccia nove volte su dieci. Quell’idea si può scrivere come lanci immaginati, per esempio come se si fossero già viste due teste e due croci. Poi arrivano i lanci veri, e si sommano a quelli immaginati: dopo 7 teste su 10, la stima (il baricentro della curva di cui si dice subito sotto) diventa \((2 + 7)/(4 + 10) = 9/14 \approx 0{,}64\), un po” più vicina a metà del \(0{,}7\) dei soli lanci veri, perché i quattro immaginati tirano verso il centro.
Il risultato non è un numero ma una curva, che dice quanto è credibile ogni valore della moneta. All’inizio è bassa e larga; con i lanci si alza e si stringe, e i lanci immaginati pesano sempre meno: dopo 70 teste su 100 la stima è \((2 + 70)/(4 + 100) = 72/104 \approx 0{,}69\), quasi la proporzione osservata. Una curva si può riassumere in due modi, con il suo punto più alto o con il suo baricentro, e con pochi lanci i due differiscono un poco; con tanti coincidono. E il punto più alto è la massima verosimiglianza con in più una spinta verso l’opinione di partenza: la regolarizzazione, nel capitolo sul Machine Learning, userà proprio questo gesto per trattenere un modello che esagera.
Il prezzo è l’opinione di partenza, che bisogna scegliere. Con quattro lanci immaginati conta poco e presto; con mille lanci immaginati tutti a metà, cento teste di fila sposterebbero la stima soltanto da \(0{,}50\) a \(0{,}55\) (cioè \(600/1100\)), e sarebbe la testardaggine di chi l’ha scelta, non la prudenza.
Per il teorema di Bayes, \(p(\theta \mid \mathcal{D}) \propto p(\mathcal{D} \mid \theta)\, p(\theta)\), e la stima MAP è
la massima verosimiglianza più un termine che dipende solo dal parametro. Con una priore gaussiana \(\theta_j \sim \mathcal{N}(0, \tau^2)\) quel termine è \(-\sum_j \theta_j^2 / (2\tau^2)\), che corrisponde, a meno di un fattore positivo, alla penalità \(\ell_2\) del Ridge della regolarizzazione; con una priore di Laplace è la \(\ell_1\) del Lasso. La stima bayesiana completa, invece, tiene tutta la posteriore: ne ricava la media, un intervallo di credibilità, la predittiva \(p(x \mid \mathcal{D}) = \int p(x \mid \theta)\, p(\theta \mid \mathcal{D})\, d\theta\).
Una priore è coniugata a una verosimiglianza quando la posteriore sta nella sua stessa famiglia. Per \(k\) teste su \(n\) lanci di Bernoulli la coniugata è la Beta: da \(\mathrm{Beta}(a, b)\) si passa a \(\mathrm{Beta}(a + k,\, b + n - k)\), con moda \((a + k - 1)/(a + b + n - 2)\) e media \((a + k)/(a + b + n)\), e \(a\), \(b\) si leggono come conteggi fittizi per la media (per la moda i conteggi sono \(a - 1\) e \(b - 1\)). Per la media \(\mu\) di una gaussiana con varianza \(\sigma^2\) nota, la coniugata è gaussiana: con priore \(\mathcal{N}(\mu_0, \tau_0^2)\) e \(n\) osservazioni di media \(\bar{x}\),
una media pesata con le precisioni, in cui il peso della priore resta fisso e quello dei dati cresce con \(n\): per \(n \to \infty\) la media tende a \(\bar{x}\) e la varianza a posteriori scende come \(\sigma^2/n\). I limiti: la coniugazione esiste per le famiglie esponenziali con priori scelte apposta, e altrove la posteriore si approssima, campionando con le catene di Markov della sezione sul MCMC o con metodi variazionali; con pochi dati la priore pesa, e va giustificata; e la MAP, a differenza della massima verosimiglianza, dipende da come si parametrizza \(\theta\), perché una densità cambia forma sotto un cambio di variabile e il suo massimo si sposta.
Il blocco calcola sulla moneta, con la priore \(\mathrm{Beta}(2, 2)\), la massima verosimiglianza, la MAP, la media a posteriori e l’intervallo al 95% (la fascia centrale che contiene il 95% della credenza, detto intervallo di credibilità) dopo 7 teste su 10 e dopo 70 su 100; poi ricostruisce la prima posteriore su una griglia, moltiplicando verosimiglianza e priore, e la confronta con la formula della coniugata.
import numpy as np
from scipy.stats import beta

a0, b0 = 2, 2                                   # la credenza di partenza: Beta(2, 2)
for teste, lanci in [(7, 10), (70, 100)]:
    a, b = a0 + teste, b0 + lanci - teste       # la coniugata: ai parametri si sommano i conteggi
    mle = teste / lanci
    map_ = (a - 1) / (a + b - 2)                # il punto più alto della posteriore
    media = a / (a + b)                         # il suo baricentro
    basso, alto = beta.ppf([0.025, 0.975], a, b)
    print(f"{teste:2}/{lanci:3}: massima verosimiglianza {mle:.3f}, MAP {map_:.3f}, "
          f"media {media:.3f}, intervallo al 95% da {basso:.3f} a {alto:.3f}")

# la stessa posteriore senza la formula: verosimiglianza per prior, su una griglia
p = np.linspace(0.0005, 0.9995, 1000)
posteriore = p**7 * (1 - p)**3 * beta.pdf(p, a0, b0)
posteriore /= posteriore.sum() * (p[1] - p[0])
print("coincide con la Beta(9, 5):", np.allclose(posteriore, beta.pdf(p, 9, 5), rtol=1e-3))
 7/ 10: massima verosimiglianza 0.700, MAP 0.667, media 0.643, intervallo al 95% da 0.386 a 0.861
70/100: massima verosimiglianza 0.700, MAP 0.696, media 0.692, intervallo al 95% da 0.601 a 0.777
coincide con la Beta(9, 5): True
Con dieci lanci la priore si sente: la MAP scende da \(0{,}700\) a \(0{,}667\) e la media a \(0{,}643\), e l’intervallo va da \(0{,}386\) a \(0{,}861\), largo quasi metà dell’asse. Con cento lanci le tre stime stanno fra \(0{,}692\) e \(0{,}700\) e l’intervallo si è ristretto a poco più di un sesto dell’asse, da \(0{,}601\) a \(0{,}777\). La griglia, che non sa niente di coniugate, dà la stessa \(\mathrm{Beta}(9, 5)\) della formula.
In pratica, con NumPy#
Poche righe traducono in codice tutto ciò che abbiamo visto: media e varianza di una distribuzione discreta, e l’aggiornamento bayesiano del test diagnostico.
import numpy as np

# Valore atteso e varianza di un dado onesto
valori = np.arange(1, 7)
p = np.full(6, 1/6)
mu  = (valori * p).sum()                # 3.5
var = ((valori - mu)**2 * p).sum()      # ~2.9167
print(mu, var, np.sqrt(var))            # 3.5  ~2.9167  ~1.7078

# Teorema di Bayes: test per una malattia rara
prevalenza  = 0.01     # P(malato)
sensibilita = 0.99     # P(positivo | malato)
falsi_pos   = 0.05     # P(positivo | sano)

p_pos     = sensibilita * prevalenza + falsi_pos * (1 - prevalenza)
posterior = sensibilita * prevalenza / p_pos
print(posterior)       # ~0.167: solo il 17% dei positivi è davvero malato
Da ricordare
La probabilità misura l’incertezza; una variabile aleatoria le dà un numero (le teste su dieci lanci), e per riassumerla bastano quasi sempre due cose: il risultato medio che ci si aspetta a lungo andare e quanto tipicamente ci si allontana da quel centro.
Contare i casi vuol dire moltiplicare le scelte e dividere per i modi di mettere in fila che non contano: dieci amici formano \(\binom{10}{3} = 120\) squadre da tre. Il conto diventa una probabilità solo se i casi contati sono ugualmente probabili, ed è lì che sbagliò d’Alembert.
La curva a campana compare ovunque perché tante piccole cause casuali che si sommano la producono da sé, anche partendo da dadi in cui nessuna faccia è favorita. Regola pratica: circa il \(68\%\) dei casi cade entro uno scarto tipico dalla media, circa il \(95\%\) entro due.
Un risultato positivo va sempre letto insieme a quanto la cosa cercata è rara: con una malattia che colpisce una persona su cento, anche un test molto buono produce più falsi allarmi che malati veri (solo il \(17\%\) circa dei positivi è davvero malato). È il teorema di Bayes al lavoro.
La media di tante osservazioni si assesta sul valore vero, ma le oscillazioni si stringono con calma: per dimezzare l’incertezza non basta il doppio dei dati, ne servono quattro volte tanti.
Un’accuratezza è una stima, come un sondaggio elettorale: su \(500\) esempi vale circa \(3\) punti in più o in meno, e fra due modelli una differenza più piccola di così può essere rumore: per deciderlo si guardano gli esempi su cui i due dissentono.
Per una risposta secca («è cambiato qualcosa, sì o no?») si parte dalla risposta che si vuole scartare: si suppone che sia stato il caso e si guarda quanto spesso il caso, da solo, produrrebbe una stranezza come quella vista. Quel «quanto spesso» è il \(p\), e la soglia sotto cui lo si accetta (per convenzione cinque su cento) dice quante volte si è disposti ad accusare un innocente, non quanto è forte la prova. Non accusare non è assolvere: con pochi dati non si distingue una moneta truccata da una onesta.
E \(p\) non è la probabilità che l’ipotesi sia vera: per quella servirebbe anche sapere quanto la cosa cercata è rara, cioè di nuovo Bayes.
Facendo mille domande insieme con la solita soglia, decine di risposte positive arriverebbero per puro caso anche se non ci fosse assolutamente niente da trovare. Bonferroni stringe la soglia dividendola per il numero di domande, così è improbabile sbagliarne anche una sola, e in cambio quasi non trova più niente; Benjamini-Hochberg promette invece che fra le scoperte annunciate la quota di errori resti bassa in media, e ne trova molte di più. La scelta dipende da quanto costa una segnalazione sbagliata.
Due grandezze che salgono e scendono insieme (i gelati e gli annegamenti) bastano a prevedere finché il mondo resta com’è, non a decidere un intervento: dietro le due curve c’è una causa comune, il caldo, e vietare il gelato non salverebbe nessuno.
Le domande sulle cause stanno su tre gradini: vedere (che cosa va insieme a che cosa), fare (che cosa succede se intervengo), immaginare (che cosa sarebbe successo se). I dati osservati da soli rispondono al primo; per salire serve qualcosa che nei dati non c’è.
Un’opinione di partenza si può scrivere come lanci immaginati, e i lanci veri la aggiornano sommandosi a quelli: più dati arrivano, meno conta l’opinione.
Imparare, per un modello, è girare le manopole dei parametri finché i dati osservati diventano i meno sorprendenti possibile: le funzioni di costo più usate sono questa stessa idea, scritta in un altro modo.
Da ricordare
La probabilità misura l’incertezza; una variabile aleatoria le dà un numero, e \(\mathbb{E}[X]\) e \(\mathrm{Var}(X)\) ne riassumono centro e dispersione. Attenzione a non confondere la varianza della distribuzione con la sua stima dal campione: quest’ultima è non distorta solo dividendo per \(n-1\) (correzione di Bessel), e le librerie scelgono default diversi.
\(\binom{n}{k} = n!/(k!\,(n-k)!)\) conta i sottoinsiemi di taglia \(k\), e \(\binom{n}{k}p^k(1-p)^{n-k}\), la binomiale, è la probabilità di \(k\) successi in \(n\) prove indipendenti con la stessa probabilità \(p\); la probabilità classica «favorevoli su possibili» vale solo su uno spazio di esiti equiprobabili.
La normale compare ovunque per il teorema del limite centrale; la regola 68–95 lega la deviazione standard \(\sigma\) alle probabilità.
Il teorema di Bayes aggiorna le credenze alla luce dei dati: con classi rare, occhio ai falsi positivi.
La legge dei grandi numeri garantisce la convergenza della media, ma solo come \(1/\sqrt{n}\): dimezzare l’incertezza costa quattro volte i dati.
Un’accuratezza è una stima: su \(500\) esempi il margine al \(95\%\) è di circa \(\pm 3\) punti. Due modelli sullo stesso test set si confrontano con McNemar sui disaccordi, non con due intervalli sovrapposti.
Il \(p\)-value è \(\Pr(T \text{ almeno estrema} \mid H_0)\), e il livello \(\alpha\) (errore di prima specie) si fissa prima: rifiutare a livello \(\alpha\) equivale a non trovare il valore nullo nell’intervallo di confidenza al \(1-\alpha\) costruito con lo stesso metodo (Wald con il test \(z\), Clopper-Pearson con il binomiale esatto). Su una statistica discreta il livello nominale non è raggiunto e il test è conservativo: con \(n=100\) e \(\alpha = 0{,}05\) la taglia vera è \(0{,}035\). Non misura \(\Pr(H_0 \mid \text{dati})\), e perde ogni significato se statistica e soglia sono scelte dopo aver visto i dati.
Con \(m\) test simultanei si controlla la FWER \(= \Pr(V \ge 1)\) con Bonferroni (\(\alpha/m\), valida senza ipotesi di indipendenza per la disuguaglianza di Boole) oppure la FDR \(= \mathbb{E}[V/R]\) con Benjamini-Hochberg (il più grande \(k\) con \(p_{(k)} \le kq/m\)), che sotto indipendenza o dipendenza positiva (PRDS) garantisce \(\mathrm{FDR} \le q\,m_0/m\). Entrambe presuppongono \(p\)-value validi, e la FDR è una media su ripetizioni, non una promessa su questo insieme di dati.
La correlazione basta per predire dentro la stessa distribuzione, non per decidere un intervento: confondenti e collider producono correlazioni senza causalità.
La massima verosimiglianza è il ponte fra probabilità e apprendimento: minimizzare MSE o cross-entropy è massimizzare una verosimiglianza.
Il limite centrale dice come si distribuisce l’errore di una media quando gli esempi sono tanti, ma solo al limite: con un numero finito di esempi non dice quanto si può sbagliare. Le disuguaglianze della sezione sulla concentrazione mettono un limite esplicito alla probabilità che una media si discosti dal valore vero di una quantità fissata, per ogni numero di esempi.