


Algebra lineare: vettori, matrici, prodotti#
Prima di arrivare a un modello, un dato diventa una fila ordinata di numeri. Un cliente diventa la lista dei suoi attributi numerici (età, acquisti, anni di iscrizione). Una foto è una griglia di intensità dei pixel, che si legge riga per riga come una fila sola. Un’email, contate le parole che contiene, diventa un elenco di conteggi. Quella fila si chiama vettore, e più vettori impilati formano una matrice. L’algebra lineare studia i vettori e le trasformazioni lineari che li mandano in altri vettori, di cui le matrici sono la scrittura.
Vettori: dati e direzioni#

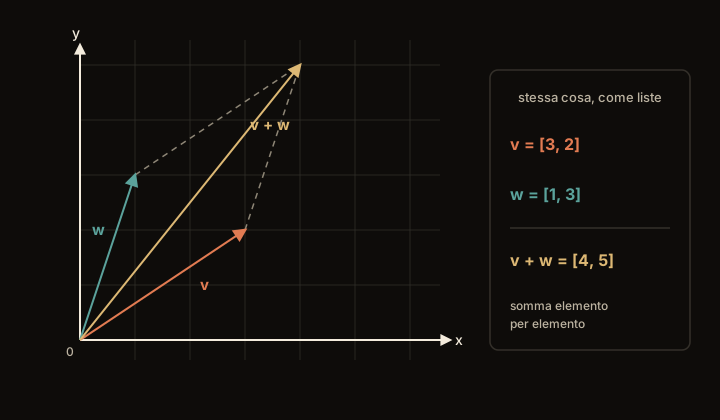
Fig. 3.1 Il vettore ha due letture, e la figura le tiene insieme: una coppia di numeri e una freccia. Sommare due liste di numeri voce per voce (\([3,2]\) più \([1,3]\) fa \([4,5]\)) e fare prima uno spostamento e poi l’altro sono la stessa operazione: si arriva nello stesso punto.#
La doppia lettura di Fig. 3.1 è il primo motivo per cui l’algebra lineare serve al machine learning. I dati arrivano come liste di numeri, e appena li si guarda come frecce diventano disponibili parole che sui numeri non avevano senso: direzione, distanza, angolo.
Un vettore è una lista ordinata di numeri. Se descrivo un appartamento con tre numeri (metri quadri, numero di stanze, piano), ho già un vettore:
L’ordine conta: il primo posto è sempre «metri quadri», il secondo «stanze», e così via. Possiamo immaginare un vettore di due o tre numeri come una freccia che parte dall’origine e punta verso quel punto: ci dice una direzione e una lunghezza.
Con i vettori si fanno tre gesti, e sono tutti conti che sapresti fare a mente.
Sommarli: si sommano i numeri che occupano lo stesso posto. Se \(\mathbf{x} = (75, 3, 2)\) e \(\mathbf{y} = (10, 1, 0)\), allora \(\mathbf{x} + \mathbf{y} = (85, 4, 2)\). Sulla freccia vuol dire fare prima uno spostamento e poi l’altro.
Sottrarli: si sottraggono voce per voce, \(\mathbf{y} - \mathbf{x} = (-65, -2, -2)\). È l’operazione che serve per misurare uno scarto, e quindi un errore: la differenza fra quello che il modello ha previsto e quello che è successo davvero.
Moltiplicarli per un numero: si moltiplica ogni voce per quel numero, \(2\mathbf{x} = (150, 6, 4)\). La freccia resta sulla stessa retta e cambia solo lunghezza (e se il numero è negativo, si volta dall’altra parte).
Quanti numeri contiene la lista si chiama la sua dimensione: l’appartamento di sopra è un vettore di dimensione tre. Non ha niente a che vedere con le dimensioni di un mobile, è solo un conteggio di caselle.
Con più di tre numeri la freccia non la disegniamo più, ma i tre gesti restano identici, perché sono conti sulle liste e non sul disegno: si sommano mille numeri con mille numeri esattamente come se ne sommavano tre con tre. Prendi una fotografia in bianco e nero di ventotto puntini per ventotto: ogni pixel, per il calcolatore, è un numero, e dice quanto quel punto è chiaro o scuro. Mettendoli in fila una riga dopo l’altra viene una lista di \(28 \times 28 = 784\) numeri. Quando si dirà «direzione» in uno spazio a 784 dimensioni, la cosa da tenere in mente non è un’immagine ma questa: le operazioni sono le stesse, e le parole «vicino», «lontano», «dalla stessa parte» continuano a voler dire qualcosa perché si calcolano, non perché si vedono.
Un vettore è un elemento di uno spazio vettoriale, tipicamente \(\mathbb{R}^n\). Lo scriviamo come colonna di \(n\) componenti reali:
Le due operazioni fondanti sono la somma componente per componente e la moltiplicazione per uno scalare \(\alpha \in \mathbb{R}\):
In machine learning \(\mathbf{x}\) è tipicamente il vettore delle caratteristiche (feature) di un singolo esempio, e \(n\) è la dimensionalità dello spazio delle feature. Un’immagine \(28\times 28\) in scala di grigi, «srotolata», è un vettore di \(\mathbb{R}^{784}\).
Il prodotto scalare: quanto due vettori «vanno d’accordo»#
È l’operazione che ritorna più spesso nel machine learning: un neurone artificiale, il mattone di cui una rete è fatta, calcola il prodotto scalare fra i propri pesi e i numeri che riceve, vi somma un termine costante e applica una funzione non lineare, come spiega la sezione sul percettrone.
Per produrre un solo token un modello linguistico da sette miliardi di parametri esegue circa sette miliardi di moltiplicazioni con somma, raccolte in oltre un milione di prodotti scalari fra vettori di migliaia di componenti. Due vettori entrano, un numero esce: il calcolo occupa mezza riga in un libro di matematica ed è fra i più eseguiti del mondo.

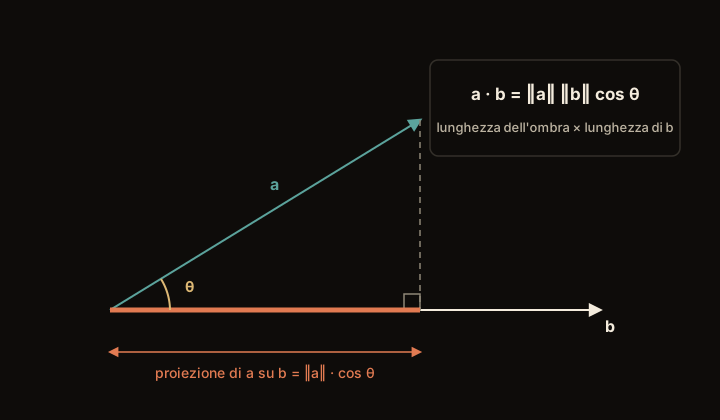
Fig. 3.2 La proiezione di \(\mathbf{a}\) su \(\mathbf{b}\) è l’«ombra» che \(\mathbf{a}\) getta sulla direzione di \(\mathbf{b}\). Il prodotto scalare è la lunghezza di quest’ombra moltiplicata per la lunghezza di \(\mathbf{b}\), e l’angolo fra le due frecce (nel disegno la lettera greca \(\theta\), si legge «theta») decide se il risultato è grande, nullo o negativo. Nella formula del disegno, le doppie stanghette \(\lVert\mathbf{a}\rVert\) vogliono dire «lunghezza di \(\mathbf{a}\)» (la norma, che si incontra fra poco) e \(\cos\theta\), il coseno dell’angolo, è semplicemente un numero fra \(-1\) e \(1\) che misura l’accordo fra le due direzioni: vale \(1\) se puntano dalla stessa parte, \(0\) se sono perpendicolari, \(-1\) se sono opposte. Non serve saperlo calcolare per leggere il resto: qui il coseno è solo il nome di quel numero.#
Alla cassa del supermercato si incontrano due liste. Nel carrello ci sono 4 chili di patate e 2 vaschette di fragole; le patate stanno a 1 euro al chilo e le fragole a 3 euro l’una. La cassa moltiplica ogni quantità per il suo prezzo e somma, \(4\cdot 1 + 2\cdot 3 = 4 + 6 = 10\) euro. Quel conto è il prodotto scalare delle due liste \(\mathbf{a}=(4,2)\) e \(\mathbf{b}=(1,3)\), e in generale si scrive
I numerini in basso dicono il posto nella fila. \(a_1\) è la prima voce dello scontrino, \(a_2\) la seconda, \(n\) quante sono in tutto. Letta a voce, la riga dice primo per primo, più secondo per secondo, e così via fino alla fine. Con mille voci nel carrello le moltiplicazioni da sommare diventano mille, e qualsiasi totale pesato che tu abbia mai fatto era uno di questi. Mille quantità e mille prezzi entrano, e ne esce un numero solo, che in matematica si chiama scalare e dà il nome all’operazione: la spesa intera in una cifra, confrontabile con quella di domenica scorsa.
Le stesse due liste, disegnate come frecce, rispondono a un’altra domanda. Puntano dalla stessa parte? La strada dritta davanti a te è \(\mathbf{b}\); il bastone piantato obliquo all’inizio della strada è \(\mathbf{a}\), e il sole è a picco (Fig. 3.2). L’ombra sull’asfalto è la parte di bastone che va dove va la strada, e il prodotto scalare è la sua lunghezza moltiplicata per quella della strada. Se il bastone pende anche di lato l’ombra cade di sbieco, e nel conto entra soltanto quanto ne avanza lungo la carreggiata. Ed è lo stesso numero dello scontrino, fatto in un altro modo: con il bastone \((4,2)\) e la strada \((1,3)\) l’ombra è lunga circa \(3{,}16\), la strada pure, e \(3{,}16\cdot3{,}16\) fa di nuovo \(10\).
Bastone quasi sdraiato sulla strada, ombra lunga, numero grande e positivo. Dritto in piedi, ombra ridotta a un punto, zero. Inclinato all’indietro, ombra dall’altra parte, e allora la sua lunghezza la contiamo col segno meno, perché il segno dice da che lato l’ombra è caduta. Tre pendenze, tre verdetti: concordi, indifferenti, opposti.
Allunga la strada di un chilometro e il totale cresce, senza che il bastone si sia mosso di un grado, perché quel numero mescola le due lunghezze con l’accordo. Il segno invece non si muove, comunque si allunghino strada e bastone.
Per confrontare le sole pendenze si divide il prodotto scalare per le due lunghezze, cioè per il massimo che potrebbe raggiungere, quello che si tocca col bastone sdraiato esattamente lungo la strada. La lunghezza di una freccia la dà il teorema di Pitagora. Le nostre due frecce misurano \(\sqrt{4^2+2^2}=\sqrt{20}\approx 4{,}47\) e \(\sqrt{1^2+3^2}=\sqrt{10}\approx 3{,}16\); il prodotto scalare faceva \(10\), e \(10 / (4{,}47 \cdot 3{,}16) \approx 0{,}71\). Quel numero sta fra \(-1\) e \(1\), non cambia se allunghi bastone e strada, ed è il coseno dell’angolo fra le due frecce, l’accordo puro fra le direzioni, la similarità del coseno.
Per \(\mathbf{a},\mathbf{b}\in\mathbb{R}^n\) il prodotto scalare (o interno) è
dove \(\theta\) è l’angolo tra i due vettori e l’apice \(\top\) si legge «trasposto»: \(\mathbf{a}^\top\) è la colonna \(\mathbf{a}\) scritta in riga, e il prodotto di una riga per una colonna è la somma dei prodotti delle componenti corrispondenti (la trasposta di una matrice qualsiasi sta nel paragrafo sulle matrici). La seconda uguaglianza è la chiave: il prodotto scalare misura l’allineamento. Da qui la similarità del coseno, onnipresente nel NLP per confrontare embedding:
La formula vale per \(\mathbf{a},\mathbf{b}\neq\mathbf{0}\). In \(\mathbb{R}^2\) e \(\mathbb{R}^3\) la seconda uguaglianza è un teorema; per \(n>3\) è la definizione di \(\theta\), lecita perché la disuguaglianza di Cauchy-Schwarz, che si ricava parlando di norme, garantisce \(|\mathbf{a}^\top\mathbf{b}|\le\lVert\mathbf{a}\rVert\lVert\mathbf{b}\rVert\), cioè \(\cos\theta\in[-1,1]\). Due vettori sono ortogonali quando \(\mathbf{a}^\top\mathbf{b}=0\). Un singolo neurone artificiale calcola \(\sigma(\mathbf{w}^\top\mathbf{x}+b)\): il prodotto scalare fra i pesi \(\mathbf{w}\) e l’input \(\mathbf{x}\), più un termine di bias \(b\), a cui si applica una funzione non lineare \(\sigma\) (la funzione di attivazione).
Matrici: trasformazioni di interi insiemi di dati#
Un vettore descrive un esempio, ma gli esempi sono cento, o un milione. Impilati uno sotto l’altro formano la matrice dei dati \(\mathbf{X}\), con una riga per esempio e una colonna per caratteristica: \(m\) esempi descritti da \(d\) numeri ciascuno danno una matrice \(m \times d\). Da lì nasce la seconda cosa che si fa con una matrice, meno ovvia della prima e molto più importante: non solo tenere fermi i dati, ma trasformarli.
Una matrice è una tabella di numeri: righe e colonne. Ci serve per due cose. Primo, impilare tanti esempi: se ho 100 appartamenti descritti da 3 numeri ciascuno, ottengo una tabella \(100\times 3\). Secondo, trasformare i dati, ed è qui che serve rallentare, perché «moltiplicare una lista di numeri per una tabella di numeri» sembra un’operazione misteriosa e non lo è: è il prodotto scalare di poco fa, ripetuto una volta per ogni riga della tabella.
Torniamo all’appartamento, \(\mathbf{x} = (75,\ 3,\ 2)\): metri quadri, stanze, piano. Voglio ricavarne due numeri nuovi, un punteggio di «ampiezza» e uno di «comodità». Scrivo due liste di pesi, una per punteggio, e le impilo:
Ogni riga si combina con l’appartamento come uno scontrino: quantità per prezzi, e si somma.
ampiezza: \(2\cdot 75 + 10\cdot 3 + 0\cdot 2 = 150 + 30 + 0 = 180\);
comodità: \(0\cdot 75 + 1\cdot 3 + 5\cdot 2 = 0 + 3 + 10 = 13\).
Il risultato è la lista \((180,\ 13)\). Tre numeri sono entrati, due ne sono usciti, e ciascuno è una mistura nuova, decisa da una riga della tabella. Questo è tutto ciò che significa moltiplicare i dati per una matrice, e lo si può ripetere: la lista che esce può entrare in un’altra tabella. È così che ogni strato di una rete neurale «riscrive» ciò che riceve prima di passarlo allo strato dopo, e i pesi delle righe sono esattamente ciò che l’addestramento va a regolare.
Il conto appena fatto porta con sé due avvertenze. Ogni riga di pesi deve avere un numero per ciascuna voce dell’appartamento, né uno di più né uno di meno: una riga scritta per quattro voci non si combina con una lista di tre, come una spina a tre poli in una presa da due: il polo in più non ha dove attaccarsi. E quando le tabelle si mettono in fila, l’ordine conta. Passare i dati prima in una tabella e poi nell’altra, o al contrario, dà quasi sempre risultati diversi, e spesso al contrario non si può nemmeno, perché le misure non combaciano: come vestirsi, dove le calze prima delle scarpe funziona e nell’ordine inverso no.
Una tabella, poi, non ha un verso di lettura obbligato. Letta per colonne, la colonna «mq» dice quanto pesano i metri quadri in ciascuno dei due punteggi: 2 nell’ampiezza, 0 nella comodità. Riscriverla scambiando righe e colonne si chiama trasporre: la tabella da due righe e tre colonne diventa una da tre righe e due colonne, e la riga «ampiezza», \((2,\ 10,\ 0)\), diventa la sua prima colonna:
I numeri restano gli stessi, cambia solo il verso in cui si leggono.
A che cosa serve girarla? I programmi tengono gli esempi uno per riga, come nella tabella dei 100 appartamenti, e allora il conto va fatto partendo dalla riga dei dati: ogni appartamento deve incontrare le liste di pesi messe per colonna, cioè la tabella girata. Prima la tabella stava davanti e ogni sua riga incontrava l’appartamento; adesso davanti c’è l’appartamento, \((75,\ 3,\ 2)\), e incontra ciascuna colonna. La prima colonna è \((2,\ 10,\ 0)\), e \(2\cdot 75 + 10\cdot 3 + 0\cdot 2\) fa di nuovo \(180\); la seconda, \((0,\ 1,\ 5)\), dà di nuovo \(13\). Senza girare la tabella non si potrebbe fare, perché le sue colonne hanno due numeri e l’appartamento tre: è la spina che non entra nella presa. Con cento appartamenti è lo stesso conto ripetuto per ogni riga dei dati, e ne esce una tabella di cento righe e due colonne, i due punteggi di ciascuno. Lo scontrino era già questo conto in piccolo: una riga sola di quantità, \((4,\ 2)\), contro una colonna sola di prezzi, \((1,\ 3)\), e ne esce un numero solo, i 10 euro del totale.
Una matrice \(\mathbf{A}\in\mathbb{R}^{m\times n}\) ha \(m\) righe e \(n\) colonne. Il prodotto matrice-vettore \(\mathbf{A}\mathbf{x}\) produce un vettore di \(\mathbb{R}^m\) le cui componenti sono i prodotti scalari tra le righe di \(\mathbf{A}\) e \(\mathbf{x}\):
(Il grassetto distingue l’oggetto intero dai suoi elementi: \(\mathbf{A}\) è la matrice, \(A_{ij}\) il numero che sta all’incrocio fra riga \(i\) e colonna \(j\); maiuscolo grassetto per le matrici, minuscolo grassetto per i vettori, tondo per i numeri singoli.)
Il prodotto tra matrici \(\mathbf{C} = \mathbf{A}\mathbf{B}\), con \(\mathbf{A}\in\mathbb{R}^{m\times k}\) e \(\mathbf{B}\in\mathbb{R}^{k\times n}\), dà \(\mathbf{C}\in\mathbb{R}^{m\times n}\) con
È associativo e distributivo rispetto alla somma, e costa \(mkn\) moltiplicazioni per \(\mathbf{A}\in\mathbb{R}^{m\times k}\) e \(\mathbf{B}\in\mathbb{R}^{k\times n}\); l’associatività non cambia il risultato ma cambia il costo, e con un vettore in fondo conviene \(\mathbf{A}(\mathbf{B}\mathbf{x})\), che costa \(kn+mk\), invece di \((\mathbf{A}\mathbf{B})\mathbf{x}\), che costa \(mkn+mn\). Non è commutativo (\(\mathbf{A}\mathbf{B}\neq\mathbf{B}\mathbf{A}\) in generale) e le dimensioni «interne» devono combaciare. Uno strato fully-connected di una rete non è altro che \(\mathbf{h} = \sigma(\mathbf{W}\mathbf{x}+\mathbf{b})\): una moltiplicazione per la matrice dei pesi \(\mathbf{W}\), seguita da una non linearità \(\sigma\). Il fatto che tante operazioni si riducano a prodotti tra matrici è ciò che rende le GPU (nate per fare in parallelo lo stesso conto su milioni di pixel) così efficaci nel deep learning.
La trasposta di \(\mathbf{A}\in\mathbb{R}^{m\times n}\) è \(\mathbf{A}^\top\in\mathbb{R}^{n\times m}\), che scambia righe e colonne: \((\mathbf{A}^\top)_{ij}=A_{ji}\). Un vettore di \(\mathbb{R}^n\) è una matrice \(n\times 1\) e la sua trasposta una riga \(1\times n\), quindi il prodotto scalare \(\mathbf{a}^\top\mathbf{b}\) è il prodotto di una matrice \(1\times n\) per una \(n\times 1\): una matrice \(1\times 1\), cioè un numero. Nell’ordine opposto, \(\mathbf{a}\mathbf{b}^\top\) è una matrice \(n\times n\) con elementi \(a_i b_j\), il prodotto esterno, che si definisce allo stesso modo fra vettori di lunghezze diverse: \(\mathbf{u}\in\mathbb{R}^m\) e \(\mathbf{v}\in\mathbb{R}^n\) danno una matrice \(m\times n\). Con il prodotto, la trasposta inverte l’ordine dei fattori: per \(\mathbf{A}\in\mathbb{R}^{m\times k}\) e \(\mathbf{B}\in\mathbb{R}^{k\times n}\) come nel prodotto fra matrici,
perché l’elemento \((i,j)\) di tutti e due i lati vale \(\sum_{r=1}^{k} A_{jr}B_{ri}\). Le dimensioni lo confermano, dato che \(\mathbf{B}^\top\) è \(n\times k\) e \(\mathbf{A}^\top\) è \(k\times m\), mentre nell’ordine \(\mathbf{A}^\top\mathbf{B}^\top\) combaciano solo se \(m = n\), e anche allora, in generale, il prodotto è un altro. E siccome un numero coincide con il proprio trasposto, \(\mathbf{a}^\top\mathbf{b} = \mathbf{b}^\top\mathbf{a}\).
Il caso più frequente è \((\mathbf{W}\mathbf{x})^\top = \mathbf{x}^\top\mathbf{W}^\top\): con gli esempi impilati uno per riga in una matrice \(\mathbf{X}\), come lavorano le librerie, lo strato \(\mathbf{W}\mathbf{x}\) applicato a tutti insieme si scrive \(\mathbf{X}\mathbf{W}^\top\). E \(\mathbf{W}^\top\) torna nel passo all’indietro: se \(\boldsymbol{\delta}\) è il gradiente della loss rispetto all’uscita \(\mathbf{W}\mathbf{x}+\mathbf{b}\), quello rispetto all’ingresso è \(\mathbf{W}^\top\boldsymbol{\delta}\) e quello rispetto ai pesi è il prodotto esterno \(\boldsymbol{\delta}\mathbf{x}^\top\), come ricava la sezione sulla backpropagation.
Il caso più semplice da disegnare è quello di una matrice quadrata \(2\times 2\): manda ogni freccia del piano in un’altra freccia dello stesso piano, \(\mathbf{x}\mapsto\mathbf{A}\mathbf{x}\). Applicata a molte frecce insieme, di solito le gira e le stira: ne allunga alcune, ne accorcia altre.
Ma non tutte le direzioni vengono girate: alcune resistono.

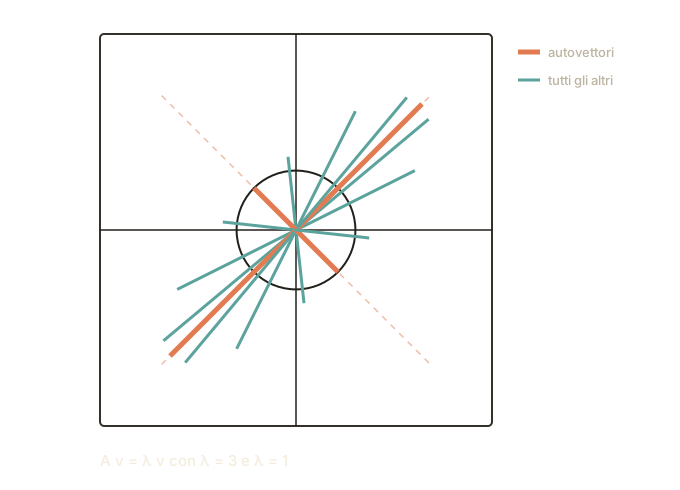
Fig. 3.3 La matrice \(\mathbf{A}=\begin{pmatrix}2&1\\1&2\end{pmatrix}\) applicata a sedici frecce tutte lunghe uno (si dicono vettori unitari: puntano in direzioni diverse ma hanno tutte la stessa lunghezza, così l’unica cosa che cambia fra loro è la direzione). Quasi tutte ruotano; le due sulle diagonali (in terracotta) restano sulla propria retta: una si allunga di \(3\) volte, l’altra non si muove affatto. La riga scritta nel disegno, \(\mathbf{A}\mathbf{v} = \lambda\mathbf{v}\), si legge: «applicare la matrice a quella freccia dà la stessa freccia moltiplicata per un numero», e quel numero è il \(3\) o l’\(1\).#
I valori della figura si verificano con due prodotti scalari, uno per riga di \(\mathbf{A}\). Per la diagonale che sale, \(\mathbf{v}=(1,1)\): \(\mathbf{A}\mathbf{v}=(2\cdot1+1\cdot1,\ 1\cdot1+2\cdot1)=(3,3)=3\mathbf{v}\). Per quella che scende, \(\mathbf{w}=(1,-1)\): \(\mathbf{A}\mathbf{w}=(2-1,\ 1-2)=(1,-1)=\mathbf{w}\). Una freccia qualsiasi, come \((1,0)\), va in \((2,1)\) e punta da un’altra parte.
Autovalori e autovettori: le direzioni che resistono#
Quelle due direzioni sono gli autovettori di \(\mathbf{A}\), e i fattori \(3\) e \(1\) i suoi autovalori.
Una tavola di legno si spacca con niente lungo la venatura, e resiste di traverso. Le venature stanno nella tavola, decise dall’albero molto prima che qualcuno la segasse, e non si spostano a seconda di dove batti. A cambiare è soltanto come la tavola risponde.
La matrice è la tavola, e la freccia a cui la applichiamo è la direzione del colpo. Le venature di una matrice si chiamano autovettori e stanno nella tabella di numeri una volta per tutte. Lungo una venatura la trasformazione si riduce a moltiplicare la freccia per un numero, e lo stirare di qua e il comprimere di là spariscono. La freccia può allungarsi, accorciarsi, perfino ribaltarsi, ma dalla sua retta non esce.
Quel fattore di allungamento si chiama autovalore e si scrive con la lettera greca \(\lambda\) (si legge «lambda»). Un \(\lambda\) sopra \(1\) allunga tutto ciò che punta di lì, e in Fig. 3.3 una venatura ha \(\lambda = 3\) e triplica, mentre l’altra ha \(\lambda = 1\) e lascia le frecce come le trova. Fra \(0\) e \(1\) le accorcia. Sotto zero le volta dall’altra parte, tanto più lunghe quanto più grande è quel numero preso senza il segno.
Certe tavole una venatura non ce l’hanno. Una tabella può far girare tutte le frecce dello stesso angolo, come le lancette di un orologio, e allora nessuna resta sulla propria retta e sul foglio non c’è niente da indicare. I conti una risposta la danno lo stesso, con numeri di un’altra specie che qui non servono. Le tabelle che il machine learning incontra più spesso sono venate, e con le venature perpendicolari fra loro.
Il guaio, cioè la ragione per cui questo interessa chi addestra reti, arriva con cento tavole tagliate dallo stesso tronco, venate tutte uguali, che il colpo attraversa una dopo l’altra, come un segnale che ripassa cento volte per lo stesso strato. Gli allungamenti si moltiplicano fra loro. Un \(1{,}1\) ripetuto cento volte fa \(13\,781\), un \(0{,}9\) fa \(0{,}000027\), numeri enormi da un capo e indistinguibili da zero dall’altro.
Una rete profonda è una pila di cento tavole incollate una sull’altra. All’andata il colpo entra dalla prima e attraversa tutta la pila, in fondo si confronta il pezzo finito con quello che si voleva ottenere, e la correzione di quello scarto risale tavola per tavola dicendo a ognuna come dovrà essere fatta la prossima volta. Quel messaggio di ritorno si chiama gradiente, ed è l’argomento della sezione su analisi e ottimizzazione. Moltiplicato a ogni tavola per poco più di uno, alla prima arriva gonfiato a dismisura; per poco meno di uno non ci arriva affatto. In gergo i gradienti esplodono o svaniscono, ed è fra le prime cose che si guardano quando un addestramento smette di migliorare.
Le cento tavole, però, non hanno la stessa venatura, ed è qui che l’immagine viene usata a sproposito più spesso. È anche il modo in cui si fa il compensato vero, girando la venatura di uno strato rispetto al successivo, e in una rete succede lo stesso: ogni strato ha la sua matrice, e quello che si accumula non è un solo \(\lambda\) elevato a cento ma il prodotto di cento allungamenti diversi. Resta vera l’idea generale, che in una catena lunga basta poco perché cento moltiplicazioni portino lontanissimo; il numero da guardare è quanto allunga il prodotto delle cento matrici, non l’autovalore di una singola, ed è un conto che la sezione sulla backpropagation rifà per esteso.
Dato \(\mathbf{A}\in\mathbb{R}^{n\times n}\), un vettore non nullo \(\mathbf{v}\) è un autovettore con autovalore \(\lambda\) se
Riscrivendo come \((\mathbf{A}-\lambda \mathbf{I})\mathbf{v}=\mathbf{0}\), dove \(\mathbf{I}\) è la matrice identità (uno sulla diagonale e zero altrove), la soluzione non banale esiste solo se \(\mathbf{A}-\lambda \mathbf{I}\) è singolare, cioè non invertibile, cioè se il suo determinante (definito nella sezione sul determinante) si annulla:
È l’equazione caratteristica, un polinomio di grado \(n\) in \(\lambda\): una matrice \(n\times n\) ha quindi \(n\) autovalori nel campo complesso, contati con molteplicità. Per la matrice della figura, \(\det\!\begin{pmatrix}2-\lambda&1\\1&2-\lambda\end{pmatrix} =(2-\lambda)^2-1=0\) dà \(\lambda_1=3\) e \(\lambda_2=1\).
Il caso che ricorre di più nel machine learning è quello simmetrico (\(\mathbf{A}=\mathbf{A}^\top\)): il teorema spettrale garantisce che gli autovalori siano reali e che esista una base ortonormale di autovettori, cioè \(\mathbf{A} = \mathbf{Q}\boldsymbol{\Lambda}\mathbf{Q}^\top\) con \(\mathbf{Q}\) ortogonale e \(\boldsymbol{\Lambda}\) diagonale. Le matrici di covarianza sono simmetriche, ed è precisamente questa decomposizione che la PCA calcola: gli autovettori danno le direzioni di massima varianza, gli autovalori quanta varianza c’è lungo ciascuna.

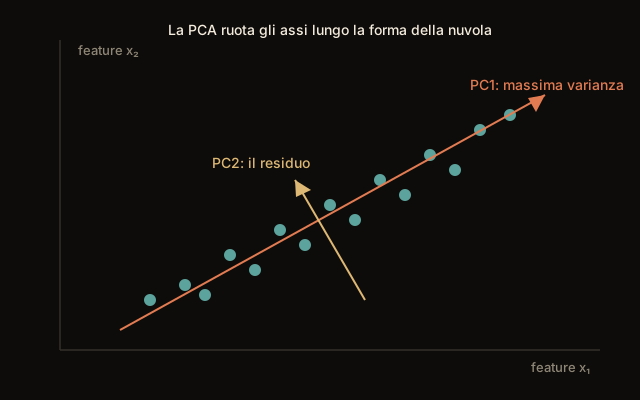
Fig. 3.4 Gli autovettori della covarianza, disegnati. Il primo asse è la direzione che i dati stessi indicano, e non l’orizzontale né la verticale.#
Fig. 3.4 mostra perché la PCA sia una faccenda di autovettori e non di scelta fra le colonne originali. Le direzioni buone quasi mai coincidono con gli assi in cui i dati sono stati registrati; il teorema spettrale garantisce che esistano, siano ortogonali fra loro, e si possano ordinare per quanta varianza catturano.
La decomposizione ai valori singolari. Il teorema spettrale chiede la simmetria, e quindi anche la quadratura. Esiste una decomposizione che non chiede niente, e che servirà più spesso: ogni matrice \(\mathbf{A}\in\mathbb{R}^{m\times n}\), rettangolare o quadrata, singolare o no, si scrive come
con \(\mathbf{U}\in\mathbb{R}^{m\times m}\) e \(\mathbf{V}\in\mathbb{R}^{n\times n}\) ortogonali e \(\boldsymbol{\Sigma}\) «diagonale» con elementi \(\sigma_1\ge\sigma_2\ge\dots\ge 0\), i valori singolari. È la decomposizione ai valori singolari (singular value decomposition, SVD). Letta a destra-verso-sinistra dice che ogni trasformazione lineare è una trasformazione ortogonale (una rotazione, eventualmente con una riflessione), seguita da una dilatazione lungo assi ortogonali, seguita da un’altra trasformazione ortogonale. I due valori estremi hanno un significato immediato: \(\sigma_1 = \max_{\lVert\mathbf{x}\rVert=1}\lVert\mathbf{A}\mathbf{x}\rVert\) è di quanto al massimo la matrice allunga un vettore, \(\sigma_{\min}\) di quanto al minimo (per una matrice con almeno tante righe quante colonne: altrimenti c’è sempre una direzione che viene annullata), e il rango è il numero dei \(\sigma_i\) non nulli (la sezione sui sistemi lineari lo definisce da capo, e mostra le altre tre facce equivalenti dello stesso conteggio). Per una matrice simmetrica i valori singolari sono i moduli degli autovalori; per una matrice quadrata qualsiasi le due famiglie non coincidono, ma non sono nemmeno estranee: il prodotto dei moduli è lo stesso (entrambe le famiglie danno \(|\det\mathbf{A}|\)) e soprattutto \(\sigma_{\max}\ge|\lambda|_{\max}\), cioè l’allungamento massimo non è mai inferiore al modulo dell’autovalore più grande. È una disuguaglianza che può essere larghissima, e proprio in quella distanza sta il fenomeno più interessante. Il rapporto \(\sigma_{\max}/\sigma_{\min}\) è il numero di condizionamento della sezione di analisi numerica; i valori singolari tornano nella sezione sulla backpropagation, dove misurano la «grandezza» di una jacobiana, e in quella sul filtraggio collaborativo, dove il teorema di Eckart e Young regge l’approssimazione di rango basso di una matrice di valutazioni.
Il legame fra valori singolari e autovalori è diretto: \(\mathbf{A}^\top\mathbf{A}=\mathbf{V}\boldsymbol{\Sigma}^\top\boldsymbol{\Sigma}\mathbf{V}^\top\) e \(\mathbf{A}\mathbf{A}^\top=\mathbf{U}\boldsymbol{\Sigma}\boldsymbol{\Sigma}^\top\mathbf{U}^\top\), quindi le colonne di \(\mathbf{V}\) sono autovettori di \(\mathbf{A}^\top\mathbf{A}\), quelle di \(\mathbf{U}\) di \(\mathbf{A}\mathbf{A}^\top\), e \(\sigma_i=\sqrt{\lambda_i(\mathbf{A}^\top\mathbf{A})}\). È anche lo schizzo dell’esistenza. \(\mathbf{A}^\top\mathbf{A}\) è simmetrica e semidefinita positiva, cioè \(\mathbf{x}^\top\mathbf{A}^\top\mathbf{A}\mathbf{x} = \lVert\mathbf{A}\mathbf{x}\rVert^2\ge 0\) per ogni \(\mathbf{x}\), e per il teorema spettrale ha una base ortonormale di autovettori \(\mathbf{v}_i\) con autovalori \(\ge 0\); per \(\sigma_i>0\) si pone \(\mathbf{u}_i=\mathbf{A}\mathbf{v}_i/\sigma_i\), e si verifica che questi vettori sono ortonormali. Una matrice simmetrica è semidefinita positiva se e solo se i suoi autovalori sono \(\ge 0\), e definita positiva se sono \(>0\): le matrici di covarianza sono della prima specie, e un’hessiana definita positiva in un punto stazionario garantisce un minimo locale stretto.
L’iterazione chiarisce il resto: su un autovettore \(\mathbf{A}^k\mathbf{v} = \lambda^k\mathbf{v}\), quindi il comportamento asintotico di un sistema che applica sempre la stessa matrice è governato dall’autovalore di modulo massimo (il raggio spettrale \(\rho(\mathbf{A})\)). Se \(\rho(\mathbf{A})<1\) ogni vettore collassa a zero; se \(\rho(\mathbf{A})>1\) diverge ogni vettore generico, cioè con componente non nulla lungo l’autodirezione dominante. Lo stesso argomento, applicato alla matrice dei link del web (resa stocastica per colonne e corretta con il teletrasporto del fattore di smorzamento), è il PageRank: sotto quelle ipotesi il teorema di Perron–Frobenius garantisce che l’autovalore \(1\) sia semplice e dominante, e l’ordinamento delle pagine è il suo autovettore, l’unica direzione che la trasformazione lascia esattamente com’è. La sezione sulle catene di Markov riprende il conto per esteso, compresa la velocità con cui converge.
Diciamo subito dove questo argomento non arriva, perché è il punto in cui viene applicato più spesso a sproposito. Il gradiente che attraversa una rete profonda è un prodotto di matrici diverse (le Jacobiane dei singoli strati) e non \(\mathbf{A}^k\), e gli autovalori di un prodotto non si ricavano dagli autovalori dei fattori. Di più: anche con una sola matrice, \(\rho(\mathbf{A})<1\) garantisce soltanto il comportamento asintotico. Per \(\mathbf{A} = \begin{pmatrix}0{,}9 & 100\\ 0 & 0{,}9\end{pmatrix}\), che ha \(\rho = 0{,}9\), un vettore unitario arriva a norma \(387\) dopo dieci applicazioni prima di cominciare a scendere: le matrici non normali (\(\mathbf{A}\mathbf{A}^\top \neq \mathbf{A}^\top\mathbf{A}\)) hanno un transitorio che il raggio spettrale non vede, e una rete di qualche decina di strati vive tutta lì dentro. La grandezza giusta per i gradienti che esplodono o svaniscono è quindi la norma del prodotto, cioè i valori singolari, ed è il conto che rifà il capitolo sulle reti neurali.
Ricorrenze lineari: i conigli di Leonardo Pisano#
Nel Liber abaci, scritto nel 1202 e arrivato fino a noi nella redazione del 1228, Leonardo Pisano, il Fibonacci, propone un problema di allevamento. Una coppia di conigli è chiusa in un recinto; ogni coppia ne genera una nuova ogni mese, e le coppie nuove cominciano a generare dal secondo mese, mentre quella di partenza genera già nel primo. Quante coppie ci sono dopo un anno? Leonardo fa il conto mese per mese sommando ogni volta i due numeri precedenti, scrive in margine la fila 1, 2, 3, 5, 8, 13, 21, 34, 55, 89, 144, 233, 377, e avverte che così si può andare avanti per quanti mesi si vuole [LeonardoPisano57].
Una regola in cui ogni termine è una combinazione fissa dei precedenti si chiama ricorrenza lineare, e si risolve con gli autovalori: gli ultimi termini si mettono in un vettore, il passo da un mese al successivo diventa una matrice, e il mese \(n\) è quella matrice applicata \(n\) volte.
Il recinto, mese per mese, si descrive con due numeri: le coppie che ci sono adesso e quelle che c’erano un mese fa. Il mese dopo, le coppie sono quelle di adesso più una nuova per ogni coppia che c’era già un mese fa, che ormai ha l’età per generare; e le coppie «di un mese fa» diventano quelle di adesso. Scritta come tabella, la regola ha due righe: 1 e 1, che somma i due numeri, e 1 e 0, che copia il primo. È una tabella due per due come quelle delle sezioni sulle matrici, e il recinto dopo un anno è quella tabella applicata mese dopo mese.
Anche questa tabella ha le sue venature. Una è la proporzione fra le coppie di adesso e quelle di un mese fa che il mese dopo si ritrova identica, soltanto ingrandita. Se un mese fa c’era 1 e adesso c’è \(f\), il mese dopo, per restare in proporzione, ci deve essere \(f\) per \(f\); ma per la regola ci sono \(f\) più 1. Il fattore giusto è quello per cui \(f\) per \(f\) fa \(f\) più 1, e vale 1,618: 1,618 per 1,618 fa 2,618. Un recinto nella proporzione di 1,618 a 1, un mese dopo, è lo stesso recinto ingrandito di 1,618 volte, e nient’altro.
C’è un secondo numero con la stessa proprietà, \(-0{,}618\) (\(-0{,}618\) per \(-0{,}618\) fa 0,382, cioè \(-0{,}618\) più 1), ed è la seconda venatura. Non è un recinto vero, perché ha un numero negativo: è un correttivo, che serve a scrivere qualunque recinto vero come somma di due pezzi, e che ogni mese si accorcia e cambia segno.
Il recinto alla fine del primo mese, 2 coppie e 1 il mese prima, è 1,17 volte la prima venatura e \(-0{,}17\) volte la seconda: i due pesi si trovano come in un sistema di due equazioni, chiedendo che i due pezzi sommati diano 2 coppie adesso e 1 un mese fa. Mese dopo mese la prima parte cresce di 1,618 volte e la seconda si riduce, fino a non contare più niente: il recinto si mette da solo nella proporzione giusta, e da lì cresce di 1,618 volte al mese. Nel conto di Leonardo si vede già: 377 diviso 233 fa 1,61803.
Ne esce anche una scorciatoia, perché i due pezzi si sanno calcolare per qualunque mese senza passare per quelli intermedi: il numero di coppie al mese \(n\) è 1,17 per 1,618 moltiplicato per sé stesso \(n\) volte (come l’1,1 delle cento tavole), più il pezzo della seconda venatura, che al dodicesimo mese vale poco più di mezzo millesimo e si arrotonda via.
Due cose possono guastare il quadro. La prima è che le due venature abbiano lo stesso fattore. La regola «il numero nuovo è due volte il precedente meno quello prima» ha un fattore solo, 1, che direbbe «resta com’è»; eppure, partendo da 1 e 2, dà 3, 4, 5, 6: una crescita di uno a ogni passo che il fattore da solo non vede. La seconda è che le venature non ci siano, come nella tabella che fa girare tutte le frecce: allora i numeri non crescono in proporzione ma oscillano, positivi e negativi a turno. La regola «il numero nuovo è il precedente meno metà di quello prima» è di queste: a ogni passo la coppia di numeri (quello nuovo e quello prima), vista come una freccia, gira di un ottavo di giro e si accorcia a sette decimi circa, e infatti, partendo da 1 e 1, passa per zero ogni quattro passi, e ogni otto, un giro intero, l’ampiezza si divide per sedici.
Una ricorrenza lineare omogenea a coefficienti costanti, di ordine \(p\), è
con i valori iniziali \(z_0, \dots, z_{p-1}\) assegnati. Con il vettore di stato \(\mathbf{s}_n = (z_n, z_{n-1}, \dots, z_{n-p+1})^\top\) il passo diventa \(\mathbf{s}_{n+1} = \mathbf{M}\mathbf{s}_n\), dove \(\mathbf{M}\) è la matrice compagna
e quindi \(\mathbf{s}_n = \mathbf{M}^{\,n-p+1}\mathbf{s}_{p-1}\). Il polinomio caratteristico di \(\mathbf{M}\), con la convenzione \(\det(\mathbf{M} - \lambda\mathbf{I})\) di prima, è \((-1)^p\,(\lambda^p - c_1\lambda^{p-1} - \dots - c_p)\), e le sue radici sono quelle che si trovano cercando soluzioni della forma \(z_n = \lambda^n\). Se le sue \(p\) radici \(\lambda_1, \dots, \lambda_p\) sono distinte, \(\mathbf{M}\) è diagonalizzabile e
con i coefficienti \(\alpha_i\) fissati dai \(p\) valori iniziali attraverso un sistema di Vandermonde, invertibile proprio perché le radici sono distinte. Per i conigli \(p = 2\) e \(c_1 = c_2 = 1\): l’equazione \(\lambda^2 - \lambda - 1 = 0\) dà \(\varphi = (1+\sqrt5)/2 \approx 1{,}618\) e \(\psi = (1-\sqrt5)/2 \approx -0{,}618\), e con \(F_0 = 0\), \(F_1 = 1\) si ottiene la formula di Binet \(F_n = (\varphi^n - \psi^n)/\sqrt5\). Siccome \(|\psi^n|/\sqrt5 < 1/2\) per ogni \(n \ge 0\), \(F_n\) è l’intero più vicino a \(\varphi^n/\sqrt5\). (La fila di Leonardo, che parte da 1 e 2, è \(F_{n+2}\).)
Se una radice ha modulo strettamente maggiore delle altre (con coefficienti reali è necessariamente reale, perché le complesse vanno in coppie coniugate di pari modulo) e il suo coefficiente non è nullo, \(z_n \sim \alpha_1\lambda_1^n\) e \(z_{n+1}/z_n \to \lambda_1\), con velocità \(|\lambda_2/\lambda_1|^n\): è \(\mathbf{A}^k\mathbf{v} = \lambda^k\mathbf{v}\) letto su una successione, e il raggio spettrale di \(\mathbf{M}\) è il tasso di crescita.
I due casi che sfuggono a questo schema semplice sono le radici multiple e le radici complesse. La matrice compagna ha un solo autovettore per ogni autovalore distinto, quindi una radice di molteplicità \(m\) le dà un blocco di Jordan di taglia \(m\) e contribuisce con i termini \(\lambda^n, n\lambda^n, \dots, n^{m-1}\lambda^n\): un fattore polinomiale che il modulo della radice non vede, parente del transitorio delle matrici non normali. E con coefficienti reali le radici complesse vanno in coppie coniugate \(\rho\, e^{\pm i\theta}\), la cui somma nella formula chiusa è il termine reale \(\rho^n (a \cos n\theta + b \sin n\theta)\): un’oscillazione di periodo \(2\pi/\theta\) dentro un inviluppo \(\rho^n\). Per \(z_n = z_{n-1} - z_{n-2}/2\) le radici sono \((1 \pm i)/2\), con \(\rho = 1/\sqrt2\) e \(\theta = \pi/4\): periodo otto, e in otto passi l’inviluppo si riduce di \(\rho^8 = 1/16\). È la forma della discesa con il momento: sulle quadratiche, lungo ogni autodirezione dell’hessiana, è una ricorrenza del secondo ordine, e la sezione di analisi e ottimizzazione ne ricava così la velocità.
Il conto rifà il recinto con la matrice, ne prende gli autovalori, ricostruisce tutti i mesi con la formula chiusa, e poi fa girare in frazioni esatte la regola che oscilla.
from fractions import Fraction

import numpy as np

# il recinto di Leonardo: lo stato di un mese è (coppie ora, coppie un mese fa)
M = np.array([[1, 1],
              [1, 0]])
s = np.array([2, 1])                    # fine del primo mese: 2 coppie, e 1 prima
coppie = [1, 2]
for mese in range(2, 13):
    s = M @ s
    coppie.append(int(s[0]))
print("coppie, dall'inizio al dodicesimo mese:", coppie)

lam, _ = np.linalg.eig(M)
lam = lam[np.argsort(-np.abs(lam))]     # la radice dominante per prima
print(f"autovalori della matrice: {lam[0]:.4f} e {lam[1]:.4f}")

# formula chiusa: coppie al mese n = a1 * lam1^n + a2 * lam2^n,
# con a1 e a2 fissati dai primi due mesi
V = np.array([[1.0, 1.0], lam])
a = np.linalg.solve(V, np.array(coppie[:2], dtype=float))
print(f"coefficienti delle due radici: {a[0]:.4f} e {a[1]:.4f}")
chiusa = [a[0] * lam[0] ** n + a[1] * lam[1] ** n for n in range(13)]
print("la formula chiusa rifà tutti i mesi:", np.allclose(chiusa, coppie))
print(f"377 / 233 = {coppie[12] / coppie[11]:.5f}; "
      f"parte della seconda radice al mese 12: {a[1] * lam[1] ** 12:+.5f}")

# radici complesse: z_n = z_(n-1) - z_(n-2) / 2, fatta con le frazioni esatte
r = np.roots([1, -1, 0.5])[0]
print(f"radici di r^2 - r + 1/2: modulo {abs(r):.4f}, "
      f"angolo {abs(np.angle(r)) / np.pi:.2f} pi greco")
z = [Fraction(1), Fraction(1)]
for n in range(2, 17):
    z.append(z[-1] - z[-2] / 2)
print("z_0 ... z_16:", " ".join(str(v) for v in z))
coppie, dall'inizio al dodicesimo mese: [1, 2, 3, 5, 8, 13, 21, 34, 55, 89, 144, 233, 377]
autovalori della matrice: 1.6180 e -0.6180
coefficienti delle due radici: 1.1708 e -0.1708
la formula chiusa rifà tutti i mesi: True
377 / 233 = 1.61803; parte della seconda radice al mese 12: -0.00053
radici di r^2 - r + 1/2: modulo 0.7071, angolo 0.25 pi greco
z_0 ... z_16: 1 1 1/2 0 -1/4 -1/4 -1/8 0 1/16 1/16 1/32 0 -1/64 -1/64 -1/128 0 1/256
La matrice rifà la fila di Leonardo fino alle 377 coppie, e i suoi due autovalori sono \(1{,}618\) e \(-0{,}618\), con coefficienti \(1{,}1708\) e \(-0{,}1708\) per il recinto di partenza. La formula chiusa ricostruisce ogni mese senza passare per i precedenti; al dodicesimo mese la seconda radice pesa poco più di cinque decimillesimi, e il rapporto fra due mesi di fila coincide già con il fattore dominante fino alla quarta cifra decimale. La regola che oscilla fa quello che promettono le sue due radici, lunghe \(0{,}7071\) e girate di un quarto di \(\pi\), cioè di un ottavo di giro: torna a zero ogni quattro passi, cambia segno ogni quattro, e fra \(z_0 = 1\) e \(z_8 = 1/16\), come fra \(z_8\) e \(z_{16} = 1/256\), l’ampiezza si divide per sedici.
Norme: misurare lunghezze ed errori#
La lunghezza di un vettore, già comparsa nel prodotto scalare, si chiama norma e si scrive \(\lVert\mathbf{x}\rVert\). Serve a misurare l’errore di un modello che risponde con più numeri insieme (tre prezzi, per esempio): se \(\hat{\mathbf{y}}\) è la risposta del modello e \(\mathbf{y}\) quella giusta, la norma della differenza, \(\lVert\hat{\mathbf{y}}-\mathbf{y}\rVert\), dice di quanto ha sbagliato.
La norma di un vettore è la sua «lunghezza». Per una freccia nel piano è il buon vecchio teorema di Pitagora: radice quadrata della somma dei quadrati delle componenti. La freccia \((3, 4)\), per esempio, è lunga \(\sqrt{3^2 + 4^2} = \sqrt{25} = 5\). Ci serve soprattutto per misurare quanto un modello sbaglia: se la risposta giusta è un vettore e la previsione è un altro vettore, si fa la loro differenza (quella voce per voce di poco fa) e se ne misura la lunghezza. Quel numero è l’errore.
La stessa mossa dà anche la distanza fra due vettori qualsiasi: quanto sono lontani due punti è la lunghezza della freccia che va dall’uno all’altro, cioè la norma della loro differenza. È il conto che si fa ogni volta che si dice che due parole, due canzoni o due clienti «si somigliano».
Un’ultima avvertenza sui conti veri. Al posto della lunghezza si usa quasi sempre il suo quadrato, cioè la lunghezza moltiplicata per sé stessa, perché toglie la radice di mezzo e i conti vengono più comodi. Il quadrato però cambia la scala: un errore lungo \(5\) pesa \(25\), uno lungo \(10\) pesa \(100\), quindi un errore doppio pesa quattro volte tanto. Comodo, finché lo si tiene a mente: quel numero non è più una distanza, e gli errori grandi contano molto più che in proporzione.
La norma euclidea (o \(\ell_2\)) di \(\mathbf{x}\in\mathbb{R}^n\) è
Accanto a essa usiamo spesso la norma \(\ell_1\) (somma dei valori assoluti, \(\lVert\mathbf{x}\rVert_1=\sum_i |x_i|\)), che nella regolarizzazione promuove soluzioni sparse.
Da una norma si ricava una distanza:
È ciò che si misura quando si dice che due embedding sono vicini, ed è una distanza in senso proprio: non negativa, nulla solo se \(\mathbf{x}=\mathbf{y}\), simmetrica, e soggetta alla disuguaglianza triangolare. Il quadrato della norma, comodo perché deriva bene e toglie la radice, distanza non è: raddoppiando lo spostamento quadruplica, e la disuguaglianza triangolare salta.
Proprio il quadrato è però ciò che compare nella celebre loss dell’errore quadratico medio:
Qui \(m\) è il numero di esempi (la stessa lettera che nel prodotto matrice-vettore contava le righe di \(\mathbf{A}\)), \(\mathbf{y}^{(i)}\) è l’uscita vera dell’esempio \(i\)-esimo e \(\hat{\mathbf{y}}^{(i)}\) quella predetta dal modello.
(Scritta così la media è sui soli \(m\) esempi. Con uscite vettoriali le
librerie mediano anche sulle componenti: mean_squared_error di scikit-learn
e nn.MSELoss con reduction='mean' dividono per \(m\) moltiplicato per il
numero di componenti di ciascuna uscita, quindi il loro numero differisce da
questo per quel fattore. Il minimo è lo stesso, il valore stampato no.)
Norme e prodotti scalari sono legati da \(\lVert\mathbf{x}\rVert_2^2 = \mathbf{x}^\top\mathbf{x}\): misurare una lunghezza è fare il prodotto scalare di un vettore con sé stesso. Ne discende la disuguaglianza di Cauchy–Schwarz, \(|\mathbf{x}^\top\mathbf{y}|\le\lVert\mathbf{x}\rVert_2\lVert\mathbf{y}\rVert_2\), con uguaglianza se e solo se i due vettori sono paralleli: è lei a garantire che il coseno stia in \([-1,1]\), e quindi a rendere lecita la definizione di angolo in \(\mathbb{R}^n\). In generale una norma è una funzione nulla solo in \(\mathbf{0}\), omogenea (\(\lVert\alpha\mathbf{x}\rVert=|\alpha|\,\lVert\mathbf{x}\rVert\)) e subadditiva (disuguaglianza triangolare); oltre a \(\ell_1\) e \(\ell_2\) si usa \(\ell_\infty\), il modulo massimo. Le matrici hanno le loro: la norma di Frobenius \(\lVert\mathbf{A}\rVert_F=\big(\sum_{ij}A_{ij}^2\big)^{1/2}\), la \(\ell_2\) della matrice srotolata, e la norma spettrale \(\lVert\mathbf{A}\rVert_2=\max_{\lVert\mathbf{x}\rVert_2=1}\lVert\mathbf{A}\mathbf{x}\rVert_2=\sigma_1\), che soddisfa \(\lVert\mathbf{A}\mathbf{B}\rVert_2\le\lVert\mathbf{A}\rVert_2\lVert\mathbf{B}\rVert_2\) ed è la norma con cui si misura quanto una catena di jacobiane può far esplodere un gradiente.
In pratica, con NumPy#
In Python l’algebra lineare vive in NumPy, la libreria di cui parla il capitolo su Python. Qui basta il richiamo: le operazioni di sopra sono una riga ciascuna, e i commenti dopo il cancelletto dicono in italiano quello che ogni riga fa.
import numpy as np

a = np.array([4, 2])
b = np.array([1, 3])

W = np.array([[0.2, 0.8],
              [-0.5, 0.1]])
x = np.array([75, 3, 2])  # l'appartamento: mq, stanze, piano
pesi = np.array([[2, 10, 0],
                 [0, 1, 5]])

print(a @ b, np.linalg.norm(a))          # prodotto scalare e norma di a
print(W @ a)                             # prodotto matrice-vettore
print(pesi @ x, x @ pesi.T)              # i due punteggi, in due modi
print(np.outer(a, b).tolist())           # la tabella dei prodotti a_i b_j
print(a @ b.T)                           # .T non gira un array 1-D: di nuovo 10
10 4.47213595499958
[ 2.4 -1.8]
[180  13] [180  13]
[[4, 12], [2, 6]]
10
L’operatore @ è il prodotto matriciale: la stessa notazione vale per prodotto
scalare, matrice-vettore e matrice-matrice, perché per NumPy sono tutti casi
della stessa operazione. Un array con un solo asse (forma (n,)), però, non è
né una riga né una colonna, e .T lo lascia com’è: la tabella di tutti i
prodotti \(a_i b_j\) si chiede con np.outer.
Da ricordare
Un vettore è una lista ordinata di numeri che descrive un esempio (l’appartamento: metri quadri, stanze, piano); una matrice è una tabella che impila tanti esempi oppure li trasforma, ed è la mossa che ogni strato di una rete ripete sui dati che riceve.
Tabelle e liste si combinano solo se le misure combaciano (una riga di pesi per tre voci vuole una lista di tre numeri), e quando le tabelle si mettono in fila l’ordine conta. Scambiare righe e colonne di una tabella si chiama trasporre.
Il prodotto scalare moltiplica due liste voce per voce e somma tutto, come lo scontrino della spesa (le quantità per i prezzi, e viene fuori il totale). Il numero che ne esce dice se i due vettori vanno d’accordo: grande se puntano dalla stessa parte, zero se sono perpendicolari, negativo se opposti. È il conto che fa un singolo neurone.
Gli autovettori sono le venature del legno di una matrice: le direzioni che la trasformazione non devia, e lungo cui si limita ad allungare o accorciare di un fattore fisso, l’autovalore \(\lambda\). Applicando cento volte la stessa matrice quel fattore si moltiplica per sé stesso, e basta poco perché il risultato scappi via: un fattore appena sopra l’uno fa esplodere tutto, uno appena sotto lo fa svanire. In una rete vera le matrici sono diverse a ogni strato, quindi va tenuta l’idea (gli effetti si moltiplicano lungo la catena) e non il numero.
Una regola che fa ogni numero dai precedenti con pesi fissi, come i conigli di Leonardo, è una tabella applicata mese dopo mese: le sue venature danno la crescita (1,618 volte al mese per i conigli) e una scorciatoia per qualunque mese. Quando due venature hanno lo stesso fattore compare una crescita in più, e quando mancano i numeri oscillano.
La norma è la lunghezza di una freccia (il teorema di Pitagora sulle sue componenti) e serve soprattutto a misurare l’errore di un modello: quanto è lunga la differenza fra la risposta giusta e la previsione. La stessa lunghezza, applicata alla differenza di due vettori qualsiasi, è la loro distanza: quanto si somigliano.
Da ricordare
Un vettore rappresenta un esempio (le sue feature); una matrice impila esempi oppure trasforma i dati.
Il prodotto scalare misura l’allineamento tra due vettori ed è il cuore del singolo neurone: \(\mathbf{w}^\top\mathbf{x}+b\).
La trasposta scambia righe e colonne e rovescia l’ordine dei prodotti, \((\mathbf{A}\mathbf{B})^\top=\mathbf{B}^\top\mathbf{A}^\top\): \(\mathbf{a}^\top\mathbf{b}\) è il prodotto scalare, \(\mathbf{u}\mathbf{v}^\top\) il prodotto esterno.
Gli autovettori sono le direzioni che una matrice non devia (\(\mathbf{A}\mathbf{v}=\lambda\mathbf{v}\)), e i loro autovalori dicono di quanto le allunga. Iterando la stessa matrice (\(\mathbf{A}^k\mathbf{v}=\lambda^k\mathbf{v}\)) comanda il raggio spettrale; per un prodotto di matrici diverse, come le Jacobiane di una rete, il raggio spettrale non basta e la grandezza da guardare è la norma.
Una ricorrenza lineare di ordine \(p\) è un passo di matrice compagna: con radici distinte \(z_n = \sum_i \alpha_i \lambda_i^n\) (Binet per Fibonacci), la radice dominante dà il tasso di crescita, una radice multipla aggiunge i fattori \(n^k\), una coppia complessa oscilla con inviluppo \(\rho^n\) (è la forma del momento sulle quadratiche).
Ogni matrice, anche rettangolare, si decompone come \(\mathbf{A}=\mathbf{U}\boldsymbol{\Sigma}\mathbf{V}^\top\) (SVD): i valori singolari \(\sigma_i\) dicono di quanto la matrice allunga al massimo e al minimo, e quanti sono i non nulli è il rango.
La norma \(\lVert\mathbf{x}\rVert_2=\sqrt{\mathbf{x}^\top\mathbf{x}}\) misura lunghezze e, soprattutto, l’errore di un modello; la distanza \(\lVert\mathbf{x}-\mathbf{y}\rVert_2\) che ne discende è ciò che si intende quando si dice che due embedding sono vicini.
Vettori, matrici, autovettori e norme sono il vocabolario: dicono di che cosa sono fatti i dati e che cosa una trasformazione fa loro. Resta il problema inverso: dati \(\mathbf{A}\) e \(\mathbf{b}\), trovare i vettori \(\mathbf{x}\) tali che \(\mathbf{A}\mathbf{x}=\mathbf{b}\), e capire che cosa succede quando le condizioni sono troppe, troppo poche o incompatibili. È il mestiere dei sistemi lineari.