


Insegnare a giudicare: classificare il testo#
Tra il 1787 e il 1788, sui giornali di New York, escono ottantacinque saggi firmati con lo pseudonimo Publius: sono i Federalist Papers, la campagna di stampa per convincere lo Stato di New York a ratificare la Costituzione americana. Dietro lo pseudonimo c’erano tre autori (Alexander Hamilton, James Madison e John Jay) ma per dodici di quei saggi l’attribuzione restò contesa per un secolo e mezzo: sia Hamilton (morto nel 1804 in un duello, lasciando una lista dei «suoi» saggi) sia Madison li rivendicavano, e gli storici non riuscivano a decidere. Nei primi anni Sessanta due statistici, Frederick Mosteller e David Wallace, provarono una strada nuova: ignorare del tutto le idee politiche e contare le parole funzione (articoli, preposizioni, congiunzioni, le parole «invisibili» che ognuno usa a modo suo senza accorgersene). Scoprirono, per esempio, che Hamilton scriveva upon più di tre volte ogni mille parole, Madison meno di una; e misero a frutto un indizio che gli storici avevano già notato: Hamilton preferiva while, Madison whilst. Applicando la regola di Bayes a questi conteggi, i dodici saggi contesi risultarono tutti di Madison: un verdetto oggi condiviso dagli storici [MW64].
Quello che è successo ha un nome: un problema da archivisti è stato risolto trasformandolo in un problema di classificazione di testi (assegnare a ogni documento un’etichetta, «Hamilton» o «Madison», sulla base delle parole che contiene). E lo strumento matematico era un teorema del Settecento e non un ritrovato dell’informatica, applicato con più pazienza che potenza di calcolo. Costruiamo proprio quel tipo di giudice automatico, con gli attrezzi di oggi.
Dare un’etichetta a un testo#
La classificazione è il compito più onnipresente del NLP: è spam o no? Questa recensione è positiva o negativa? In che lingua è scritto questo tweet? Questa email va allo sportello «reclami» o «fatturazione»? Chi ha scritto questo saggio? Il formato è sempre lo stesso: in ingresso un documento, in uscita una scelta tra poche etichette prefissate.
Gli ingredienti li abbiamo già. Nella sezione sulla rappresentazione del testo abbiamo imparato a trasformare un documento in un vettore di numeri: il bag-of-words dei conteggi, o la sua versione tarata TF-IDF, costruito sui token che la tokenizzazione ci ha dato. Qui aggiungiamo il pezzo mancante: due modelli che, dato quel vettore, emettono il verdetto. Il primo, Naive Bayes, è il discendente diretto del metodo di Mosteller e Wallace; il secondo, la regressione logistica, l’abbiamo già incontrata nella sezione sull’apprendimento supervisionato e qui la mettiamo al lavoro sul testo. Il confronto tra i due, vedremo, insegna una distinzione che attraversa tutto il machine learning.
Naive Bayes: la regola di Bayes con un’ipotesi ingenua#
Naive Bayes assegna a un documento la classe più probabile applicando la regola di Bayes con un’ipotesi semplificatrice: nessuna parola, da sola, decide che un’email è spam, ma ciascuna sposta un po’ la probabilità a favore o contro.

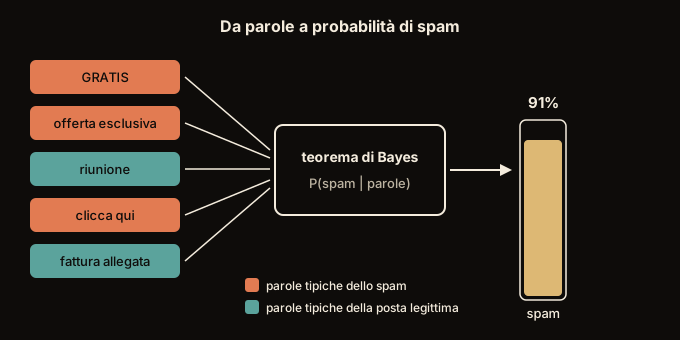
Fig. 15.10 Nessun indizio decide da solo. Ogni parola porta il proprio piccolo peso al calcolo, e il verdetto è la probabilità che ne risulta.#
Nella Fig. 15.10 si vede anche dove sta l’ingenuità che dà il nome al metodo: le frecce entrano nel calcolo ciascuna per conto suo, senza mai incontrarsi. L’aggettivo naive, «ingenuo», è dichiarato nel nome: ogni parola vota come se le altre non esistessero, e se «offerta» e «gratis» compaiono quasi sempre insieme, il modello le conta come due indizi indipendenti e lo stesso sospetto vota due volte. Il modello fa votare tutti gli indizi e sceglie l’etichetta che ne esce meglio.
A questa ipotesi se ne aggiunge un’altra, quella del sacchetto di parole. Il giudice riceve un sacchetto e conta chi c’è dentro; di chi veniva prima e chi dopo non gli arriva niente, e per lui «Il gatto nero salta sul muro» e «Il muro nero salta sul gatto» sono lo stesso identico messaggio. È un’ipotesi diversa dalla prima, e vale per qualunque modello che legga un sacchetto, ingenuo o no. Per decidere se una recensione è entusiasta se ne può fare a meno; per altre cose no, ed è il motivo per cui il NLP non si ferma qui.
Sul tavolo dieci email già lette, in due pile: quattro sono spam, sei legittime. Ne arriva una nuova che dice «gratis» e «offerta», e va messa su una delle due.
L’archivio risponde solo alla domanda rovesciata. Nella pila delle spam «gratis» compare in 3 email su 4 e «offerta» in 2 su 4; fra le legittime, una su sei per ciascuna. Ma serve il contrario: questa email che dice «gratis», quanto rischia di essere spam? A girare la domanda c’è la regola di Bayes, il teorema del Settecento che ha sciolto i Federalist Papers, e in cambio vuole sapere solo quanto sono frequenti le spam in generale (qui 4 su 10).
Ogni pila raccoglie allora i suoi voti e li moltiplica. Due monete sul tavolo danno testa tutte e due le volte una volta su quattro, cioè una su due per una su due; sommando verrebbe la certezza, che è assurda. Due cose che devono capitare insieme si moltiplicano, e qui sono che l’email dica «gratis» e che dica «offerta».
pila delle spam: la quota di spam nell’archivio, per la frequenza di «gratis» fra le spam, per quella di «offerta»: \(0{,}4 \times 0{,}75 \times 0{,}5 = 0{,}15\);
pila delle legittime: 0,6 per 1/6 per 1/6, circa 0,017.
Vince la prima, e di parecchio: 0,15 è nove volte tonde 0,017 (che per esteso è un sessantesimo). I due punteggi diventano probabilità solo quando li si rapporta al totale, come i voti di un’elezione a due candidati: \(0{,}15 \div (0{,}15 + 0{,}017) = 0{,}90\), cioè il 90 per cento di probabilità che sia spam. E l’ingenuità è proprio qui: «gratis» e «offerta» sono due parole che viaggiano insieme, e il conto le fa votare da estranee.
Una parola della nuova email mai vista nella pila delle spam vale zero, e uno zero moltiplicato spegne l’intera pila per colpa di una parola sola. Si regala allora un conteggio a tutte le parole, così nessuna resta a secco; il regalo si paga, perché chi aggiunge 1 sopra la linea di frazione deve aggiungere sotto tanti regali quanti ne ha distribuiti. Contando le email, i regali sono due, uno per «c’è» e uno per «non c’è»: «premio», mai vista fra le 4 spam, passa da 0 su 4 a (0 + 1) su (4 + 2), cioè un sesto, e «gratis» da 3 su 4 a 4 su 6. È la regola del +1 di Laplace.
Le email vere hanno trecento parole, e trecento frazioni moltiplicate una dopo l’altra danno un numero con centinaia di zeri dopo la virgola: sotto una certa piccolezza il calcolatore non ha più modo di scriverlo e lo arrotonda a zero, e allora le due pile valgono zero e non vince nessuno. Si smette dunque di scrivere le frazioni e si segnano i loro zeri: una su mille ne fa tre, una su cento due, e il prodotto (una su centomila) è la somma, tre più due. Le moltiplicazioni diventano addizioni, i numeri restano di taglia normale, e vince la stessa pila di prima, perché chi aveva meno zeri era anche la più grande. Contare gli zeri è il modo casalingo di dire logaritmo.
Sul tavolo si è contato in quante email una parola compare (3 spam su 4); si
può anche contare quante volte compare in tutto, sul totale delle parole della
pila, ed è il modo più diffuso, quello del programma di scikit-learn che
arriva più avanti. L’idea non cambia di una virgola, i decimali sì.
Dato un documento \(d = (w_1, \dots, w_n)\) e un insieme di classi \(\mathcal{C}\), cerchiamo la classe più probabile alla luce del documento. La regola di Bayes ribalta la condizione:
dove \(P(c)\) è la probabilità a priori della classe (quanto è frequente di suo), \(P(d \mid c)\) è la verosimiglianza del documento data la classe e \(P(d)\) (identico per tutte le classi) si può ignorare nell’argmax. Naive Bayes aggiunge due ipotesi semplificatrici: il documento è un bag-of-words (conta solo quali parole compaiono, non dove: per il modello «Il gatto nero salta sul muro» e «Il muro nero salta sul gatto» sono lo stesso documento) e le parole sono condizionatamente indipendenti data la classe. La verosimiglianza si fattorizza allora in un prodotto e la decisione diventa
dove \(\hat{c}\) è la classe predetta e \(P(w_i \mid c)\) la probabilità della parola \(w_i\) nei documenti di classe \(c\). Le stime di massima verosimiglianza sono semplici frequenze relative:
dove \(\mathrm{conta}(w, c)\) è il numero di occorrenze di \(w\) nei documenti di addestramento di classe \(c\) e \(V\) è il vocabolario. Una parola mai vista in una classe darebbe probabilità zero e azzererebbe il prodotto: lo smoothing add-1 di Laplace lo evita sommando 1 a ogni conteggio,
un’idea che ritroveremo, identica, nei modelli n-gram. Infine un accorgimento numerico: un prodotto di centinaia di probabilità minuscole va in underflow, perciò in pratica si lavora nello spazio dei logaritmi, massimizzando \(\log P(c) + \sum_i \log P(w_i \mid c)\); il prodotto diventa una somma e l’argmax non cambia, perché il logaritmo è monotono.
Una precisazione sul modello, perché la stima di \(P(w \mid c)\) per frequenze
relative ne individua uno solo di due. Dividendo le occorrenze di \(w\) per il
totale dei token della classe si ottiene il Naive Bayes multinomiale, quello che
il codice sulle recensioni usa (MultinomialNB) e quello adatto quando conta
quante volte una parola compare. Esiste anche la variante di Bernoulli, in cui
\(P(w \mid c)\) è la frazione di documenti della classe che contengono \(w\), e ogni
parola del vocabolario porta un contributo anche quando è assente. È lo
stimatore che si ottiene contando in quante email della classe una parola
compare («gratis» in 3 spam su 4) e non quante occorrenze ha sul totale dei
token delle spam: due ricette diverse, e i numeri di un conto non si ottengono
con la formula dell’altro. La variante di Bernoulli è preferibile quando
interessa la presenza e non la quantità (testi molto corti, vocabolari piccoli)
e in scikit-learn si chiama BernoulliNB. Anche il lisciamento cambia: si
aggiunge 1 ai documenti che contengono la parola e 1 a quelli che non la
contengono, \(P(w \mid c) = (\mathrm{doc}(w, c) + 1)/(m_c + 2)\), con
\(\mathrm{doc}(w, c)\) il numero di documenti di classe \(c\) che contengono \(w\) e
\(m_c\) il numero di documenti della classe. Nel confronto di McCallum e Nigam
[MN98] il modello di Bernoulli fa a volte meglio con
vocabolari piccoli, ma con vocabolari grandi vince quasi sempre il
multinomiale, che riduce l’errore in media del 27% (in termini relativi).
L’ipotesi di indipendenza è linguisticamente falsa (le parole si tirano a vicenda) eppure Naive Bayes funziona bene, e la ragione si conosce: per classificare basta che la classe giusta abbia il punteggio più alto, non che le probabilità siano esatte, e la distorsione dovuta alle dipendenze può colpire le classi in modo simile senza cambiare la decisione [DP97]. Le probabilità, in compenso, escono troppo estreme. Si addestra con un solo passaggio sui dati (basta contare), regge anche con pochi esempi etichettati, e per decenni è stato il cuore dei filtri antispam reali.
Alla prova: il sentiment delle recensioni#
Il banco di prova classico della classificazione è la sentiment analysis: decidere se un testo esprime un giudizio positivo o negativo.

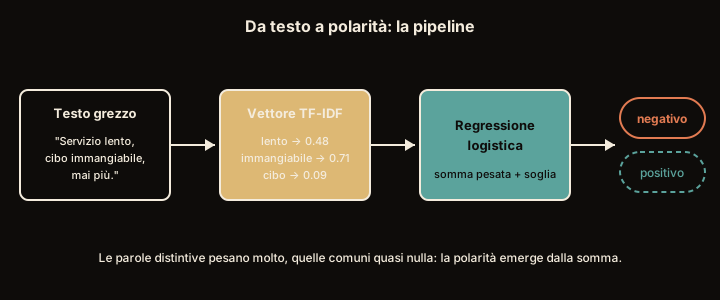
Fig. 15.11 La catena, dal testo alla polarità (positiva o negativa). Ogni stadio è sostituibile: cambiare tokenizzatore o classificatore non cambia la forma della pipeline.#
Gli stadi della catena della Fig. 15.11 sono staccabili: si tiene fisso il resto e si cambia un pezzo solo, e questo permette di confrontare sullo stesso compito metodi lontanissimi fra loro, dal conteggio di parole del 2002 ai modelli di oggi.
Lo studio che aprì il filone è del 2002, e lo firmano Bo Pang, Lillian Lee e Shivakumar Vaithyanathan [PLV02]. Presero 1.400 recensioni di film, 700 entusiaste e 700 stroncature, e ci misero alla prova tre giudici automatici diversi: Naive Bayes; un modello a massima entropia, che è la regressione logistica sotto un altro nome; e le support vector machine, che cercano il confine più largo possibile fra due gruppi di esempi e hanno una sezione tutta loro nel machine learning.
Due risultati restano istruttivi. Il primo: tutti e tre i giudici, che il giudizio se lo erano ricavato dagli esempi, arrivavano intorno all’80 per cento di risposte esatte, cioè nettamente meglio del metodo artigianale con cui si faceva prima, che era compilare a mano una lista di parole belle e una di parole brutte e contare chi vince (le si ritrova con i lessici di sentiment). Il secondo: giudicare il tono si rivelò più difficile che riconoscere di che argomento parla un testo, perché l’argomento sta nelle parole e il giudizio si nasconde nei giri di frase, che i conteggi prendono male.
Con scikit-learn il classificatore diventa poche righe. Costruiamo un
micro-corpus di recensioni in italiano:
from sklearn.feature_extraction.text import CountVectorizer
from sklearn.naive_bayes import MultinomialNB
from sklearn.pipeline import make_pipeline

recensioni = [
    "un capolavoro, attori straordinari e regia impeccabile",
    "film splendido, mi ha emozionato dall'inizio alla fine",
    "divertente e intelligente, lo rivedrei subito",
    "una storia che sorprende, fotografia bellissima",
    "che noia, due ore interminabili e senza idee",
    "recitazione pessima e trama piena di buchi",
    "una delusione totale, soldi buttati",
    "banale e prevedibile, mi sono addormentato",
]
etichette = [1, 1, 1, 1, 0, 0, 0, 0]  # 1 = positiva, 0 = negativa

# CountVectorizer = bag-of-words; alpha=1.0 è lo smoothing di Laplace
modello = make_pipeline(CountVectorizer(), MultinomialNB(alpha=1.0))
modello.fit(recensioni, etichette)

nuove = ["una regia splendida e attori bravissimi",
         "prevedibile e senza emozioni, che delusione"]
print(modello.predict(nuove))                  # la classe di ciascuna
print(modello.predict_proba(nuove).round(3))   # righe: recensioni;
                                               # colonne: classe 0, classe 1
[1 0]
[[0.221 0.779]
 [0.905 0.095]]
Le probabilità si leggono per riga: la prima recensione è positiva al 77,9 per
cento, la seconda negativa al 90,5. Otto esempi sono pochi per qualunque
conclusione seria, ma la meccanica è tutta qui: conteggi in ingresso, regola di
Bayes in mezzo, verdetto in uscita. Al posto di CountVectorizer si può usare
il TfidfVectorizer già visto nella sezione sulla rappresentazione del testo.
La regressione logistica: un peso per parola#
Naive Bayes conta le parole dentro ciascuna delle due etichette possibili («classe» è il nome tecnico per «etichetta», e da qui in avanti si trovano tutti e due) e lascia che la regola di Bayes tiri le somme. C’è un’alternativa più diretta: imparare, per ogni parola, un peso che dica quanto spinge verso un’etichetta o l’altra, e sommare le spinte. È la regressione logistica.
Una bilancia a due piatti, uno «positivo» e uno «negativo»: ogni parola della recensione ci butta sopra un pesetto. I pesetti non li decidiamo noi; li impara il modello dagli esempi etichettati, aggiustandoli un po’ alla volta finché i verdetti tornano. Dopo l’addestramento potremmo trovare, per dire: «splendido» +2,0, «sorprende» +1,5, «noia» −2,2, «delusione» −2,5. La frase «un film splendido, che sorprende» totalizza \(2{,}0 + 1{,}5 = 3{,}5\) sul piatto positivo.
La bilancia non parte sempre in piano. C’è un pesetto fisso, appoggiato su un piatto prima ancora di leggere la recensione. Se nell’archivio le stroncature fossero il doppio delle recensioni entusiaste, l’ago partirebbe già inclinato verso il negativo, e alle parole toccherebbe spingere più forte per raddrizzarlo. Con entusiaste e stroncature in parità l’ago parte in piano, e il totale è la somma dei soli pesetti delle parole, come nel \(3{,}5\) di poco fa.
C’è poi una regola che tiene i pesetti moderati, e serve soprattutto contro le parole rare. Una parola comparsa in una recensione sola, entusiasta, se la lasciassimo fare si prenderebbe un peso enorme, e da quel momento basterebbe lei a decidere il verdetto, sulla fede di un caso solo. La regola le impedisce di crescere troppo, a meno che siano molti esempi a chiederlo.
Resta da tradurre in una probabilità il totale dei pesetti, il 3,5 del nostro esempio, e a farlo è una regola fissa, sempre la stessa, che si chiama sigmoide (la curva a S del capitolo sul machine learning): manda lo zero esattamente a metà, cioè a 0,5, spinge i punteggi positivi verso 1 e quelli negativi verso 0, senza mai arrivare né all’uno né all’altro. Più il punteggio è alto, più il risultato si avvicina a uno: a 3,5 la regola risponde circa 0,97, molto convinta ma non certa. (Quel 0,97 non è a occhio: la sigmoide è una formula sola, \(1/(1 + e^{-z})\), e mettendoci \(z = 3{,}5\) esce \(0{,}9707\). Se il conto non ti dice niente, tieni l’idea: punteggio alto, probabilità vicina a uno.) Se le etichette possibili sono più di due (per esempio lo sportello giusto fra reclami, fatturazione e informazioni) al posto della sigmoide c’è la sua sorella maggiore, la softmax: un punteggio per ogni etichetta, e i punteggi trasformati in probabilità che sommano a uno.
Sul piatto, poi, non finiscono per forza soltanto parole. Ci si può mettere quanto è lunga la recensione, quanti punti esclamativi ha, quante coppie di parole vicine ricorrono, quante parole compaiono in una lista di parole belle e brutte preparata prima. La bilancia non chiede che cosa misuri un pesetto: guarda gli esempi e impara quanto vale.
Il documento è un vettore \(\mathbf{x} \in \mathbb{R}^{|V|}\): conteggi o pesi TF-IDF. Il modello calcola il punteggio lineare e lo schiaccia con la sigmoide:
dove \(\mathbf{w} \in \mathbb{R}^{|V|}\) è il vettore dei pesi (uno per parola: il segno dice la direzione, il modulo la forza dell’indizio), \(b\) il bias, \(z\) e \(\hat{y}\) due scalari, il punteggio e la probabilità della classe positiva. È la stessa formula del percettrone, con la stessa grafia: minuscolo grassetto per i vettori. Per \(K\) classi i pesi diventano una matrice \(\mathbf{W} \in \mathbb{R}^{K \times |V|}\) e la sigmoide lascia il posto alla softmax, \(\hat{\mathbf{y}} = \mathrm{softmax}(\mathbf{W}\mathbf{x} + \mathbf{b})\), con \(\hat{\mathbf{y}} \in \mathbb{R}^{K}\) il vettore delle probabilità. Nel caso a due classi i parametri si stimano minimizzando la cross-entropia media con un termine di regolarizzazione \(L^2\),
dove \(m\) è il numero di documenti di addestramento, \(y_i \in \{0, 1\}\)
l’etichetta del documento \(i\), \(\hat{y}_i\) la probabilità che il modello gli
assegna e \(\lambda \ge 0\) il coefficiente di regolarizzazione (in
scikit-learn si imposta il suo inverso, C). \(\mathcal{L}\) è convessa,
quindi la discesa non resta intrappolata in minimi locali, ma non ha una
soluzione in forma chiusa, e si usano metodi iterativi (la discesa del
gradiente, o L-BFGS in scikit-learn). Senza regolarizzazione, su dati
linearmente separabili il minimo non esiste: la perdita continua a scendere
mentre i pesi crescono senza limite, ed è il caso di una parola rara che
compare in una recensione sola. Con \(\lambda > 0\) i pesi restano finiti. Un
vantaggio pratico: le feature non devono essere solo parole.
Si possono affiancare le coppie di parole adiacenti (i bigrammi), la
lunghezza del documento, il numero di punti esclamativi, i conteggi da un
lessico di sentiment: il modello impara il peso di ciascuna, qualunque cosa
misuri. Con feature dense al posto dei conteggi si ottiene fastText usato come
classificatore [JGBM17]. Il documento è la media degli embedding
delle sue parole e dei suoi bigrammi, questi ultimi mappati per hashing su un
numero fisso di righe, e sopra la media sta la stessa regressione logistica
multinomiale, con una softmax gerarchica quando le classi sono migliaia. È un
solo strato lineare, quindi si addestra su CPU in minuti, e gli autori lo
propongono come linea di base da battere prima di scomodare una rete
profonda.
Generativo contro discriminativo#
Naive Bayes e regressione logistica arrivano alla stessa forma di decisione, una combinazione lineare dei conteggi, per due strade opposte, e la differenza è una delle distinzioni fondamentali del machine learning: un modello generativo impara come sono fatti i documenti di ciascuna classe, un modello discriminativo impara direttamente quale classe ha un documento dato.
Due periti devono attribuire lo stesso quadro a uno di due pittori, e ci arrivano per strade opposte. Il primo studia tutto di ciascun pittore (tavolozza, pennellate, soggetti) fino a saperne quasi imitare lo stile; davanti a un quadro nuovo si chiede: «quale dei due è più capace di aver prodotto proprio questo?». È l’approccio generativo, ed è Naive Bayes: impara com’è fatto un documento tipico di ogni classe. Il secondo perito non sa dipingere e non gli interessa: ha imparato solo i dettagli che distinguono (quella piega del panneggio, quel blu). È l’approccio discriminativo, ed è la regressione logistica: impara direttamente il confine tra le classi. La differenza si vede sugli indizi fotocopia: se «gratis» e «offerta» compaiono quasi sempre insieme, per Naive Bayes sono due voti pieni (conta due volte lo stesso indizio), mentre la bilancia della regressione logistica se ne accorge durante l’addestramento e divide il peso tra le due.
Quel doppio conteggio si sente nel modo in cui il primo perito parla. Si dichiara sicurissimo, «è lui, non c’è dubbio», mentre gli indizi davvero diversi erano meno di quanti ne ha contati. Il nome che tira fuori di solito è ancora quello giusto; la sicurezza con cui lo dice, no. E la differenza conta quando dalla sicurezza dipende che cosa si fa dopo, firmare l’attribuzione o chiamare un terzo perito. In compenso il primo perito impara anche da pochissimi quadri, mentre il secondo ha bisogno di più esempi per capire quali dettagli contano davvero.
Un modello generativo stima la distribuzione congiunta \(P(d, c) = P(d \mid c)\,P(c)\) e classifica passando dalla regola di Bayes: per Naive Bayes, «generare» un documento di classe \(c\) significa estrarre parole da \(P(w \mid c)\). Un modello discriminativo stima direttamente la quantità che serve alla decisione, \(P(c \mid d)\), senza mai modellare come sono fatti i documenti. I due modelli sono una coppia generativa-discriminativa in senso stretto. Con due classi, nello spazio dei logaritmi, il Naive Bayes multinomiale decide con
dove \(x_w\) è il conteggio di \(w\) in \(d\). È una funzione lineare di \(\mathbf{x}\), della stessa forma \(\mathbf{w}^\top\mathbf{x}+b\) della regressione logistica (in grassetto \(\mathbf{w}\) è il vettore dei pesi, in tondo \(w\) è una parola del vocabolario): il peso della parola \(w\) è \(\log\frac{P(w\mid c_1)}{P(w\mid c_0)}\), e \(b\) è il logaritmo del rapporto fra le priori. Cambia come si scelgono i pesi: per conteggio, parola per parola, oppure per massima verosimiglianza condizionata, tutti insieme. Ng e Jordan [NJ01] ne ricavano un compromesso, dimostrato per feature binarie (il Naive Bayes di Bernoulli) e per feature gaussiane: l’errore asintotico del discriminativo non supera mai quello del generativo, e coincide con esso quando l’ipotesi di indipendenza è vera; il generativo, però, può avvicinarsi al proprio asintoto con un numero di esempi che cresce come il logaritmo del numero di feature, dove al discriminativo ne serve, nel caso peggiore, un numero lineare (il confronto è rifatto in Modelli generativi). Le conseguenze pratiche: quando le feature sono correlate (e nel testo lo sono sempre) Naive Bayes moltiplica evidenze non indipendenti e produce probabilità mal calibrate, schiacciate verso 0 o 1 (la decisione spesso resta giusta, la confidenza no); la regressione logistica, ottimizzando i pesi congiuntamente, ripartisce il credito tra feature correlate. In cambio, Naive Bayes ha stime a bassa varianza che convergono con pochi dati e si addestra in un solo passaggio; la regressione logistica tende a vincere quando gli esempi abbondano. Nei confronti di Pang, Lee e Vaithyanathan sulle recensioni di film la regressione logistica (la «massima entropia» del loro articolo) e Naive Bayes stavano vicini, a volte avanti l’una e a volte l’altro: con le sole presenze di parola 80,4 contro 81,0 per cento a favore di Naive Bayes, mentre le SVM guadagnavano un paio di punti (82,9) [PLV02]. Su compiti lessicali, e tanto più con pochi dati, l’ingenuo resta un avversario dignitoso.
Il classificatore in PyTorch#
In PyTorch il modello è un solo strato lineare. nn.Linear calcola il
punteggio \(z = \mathbf{w}^\top\mathbf{x} + b\), un peso per parola più il
bias \(b\), la costante che sposta l’ago; finché non passa dalla curva a S il
punteggio si chiama logit, ed è il 3,5 della bilancia di prima. Il ciclo
for è l’addestramento: trecento passi sugli stessi otto esempi, in ciascuno
dei quali l’ottimizzatore (Adam) sposta i pesi un poco nella direzione che
riduce la perdita. È un neurone artificiale solo, come il
percettrone, con due differenze: la sigmoide
al posto del gradino, e la cross-entropia al posto della regola di
aggiornamento del percettrone. Si riusa il micro-corpus di prima, con vettori
TF-IDF in ingresso:
import torch
from torch import nn
from sklearn.feature_extraction.text import TfidfVectorizer

torch.manual_seed(0)   # senza seme i pesi partono a caso e i numeri cambiano

vec = TfidfVectorizer()
X = torch.tensor(vec.fit_transform(recensioni).toarray(), dtype=torch.float32)
y = torch.tensor(etichette, dtype=torch.float32).unsqueeze(1)

modello = nn.Linear(X.shape[1], 1)      # un peso per parola, più il bias
loss_fn = nn.BCEWithLogitsLoss()        # sigmoide + cross-entropia binaria
ottim = torch.optim.Adam(modello.parameters(), lr=0.05)

for epoca in range(300):
    ottim.zero_grad()
    perdita = loss_fn(modello(X), y)    # logit, non probabilità
    perdita.backward()
    ottim.step()

with torch.no_grad():
    X_nuove = torch.tensor(vec.transform(nuove).toarray(), dtype=torch.float32)
    print(torch.sigmoid(modello(X_nuove)).squeeze())  # probabilità "positiva"
Una nota sul nome più ostico, BCEWithLogitsLoss: fonde in un’unica operazione
la curva a S e la misura dell’errore, e lo fa perché eseguire i due passi
separati, su numeri molto grandi o molto piccoli, perde precisione. È per
questo che il modello restituisce il punteggio grezzo e la sigmoide si applica
solo al momento di leggere le probabilità. E i pesi imparati si possono
interrogare, parola per parola:
pesi = modello.weight.detach().squeeze()
parole = vec.get_feature_names_out()
ordine = pesi.argsort().tolist()
print("più negative:", [parole[i] for i in ordine[:3]])
print("più positive:", [parole[i] for i in ordine[-3:]])
più negative: ['ore', 'soldi', 'senza']
più positive: ['fotografia', 'sorprende', 'che']
Con otto recensioni, però, la lista dice più sul corpus che sulla lingua: in cima finiscono parole che compaiono una volta sola, e perfino una parola vuota come «che» si prende un peso alto pur comparendo una volta per parte, in «una storia che sorprende» e in «che noia». La recensione entusiasta è la più corta delle due, e in un vettore riportato alla stessa misura complessiva la stessa parola pesa di più dove le altre sono meno; basta quel poco perché il suo pesetto finisca sul piatto positivo. Su un corpus vero, dove ogni parola si è vista in contesti diversi, in cima e in fondo compaiono di solito quelle che un lettore umano sottolineerebbe; quando però il corpus è sbilanciato in un modo che non ha a che fare con il giudizio (la fonte, il periodo, il formato dei testi), in cima finisce la parola che tradisce quello sbilanciamento. Il modello resta una bilancia trasparente, i cui pesi si leggono, a patto di non scambiare per una spiegazione quella che può essere una scorciatoia del corpus; e questa leggibilità è uno dei motivi per cui resta un riferimento anche nell’era dei Transformer.
Giudicare il giudice#
Un classificatore di testi si valuta con gli strumenti di Valutare un modello: le metriche: la matrice di confusione, la precision, la recall e la loro sintesi \(F_1\). Le due parole inglesi si ridicono in una riga ciascuna. Di quello che il sistema ha segnalato, quanto era davvero da segnalare (precision)? E di quello che andava segnalato, quanto ne ha trovato (recall)? La prima misura gli abbagli, la seconda le omissioni; \(F_1\) è la loro sintesi in un numero solo.

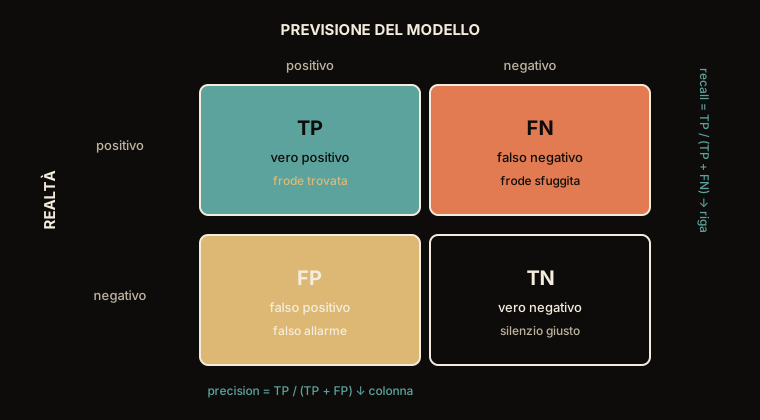
Fig. 15.12 Le stesse quattro caselle, lette in due versi perpendicolari. Della roba segnalata, quanta era giusta: è la precision, e sulla matrice si legge scendendo lungo una colonna. Di quella da segnalare, quanta ne è stata trovata: è la recall, e si legge correndo lungo una riga.#
Il promemoria di Fig. 15.12 serve perché le due domande tirano in direzioni opposte, e la ragione è più semplice di quanto sembri. Il giudice non risponde sì o no: emette un punteggio, e c’è una soglia oltre la quale segnala. Abbassa la soglia e segnalerai di più: la recall non può che salire o restare ferma, perché le segnalazioni giuste di prima restano tutte, mentre la precision di solito scende, perché fra i nuovi segnalati entrano soprattutto falsi allarmi (di solito, non sempre: se il caso che entra è giusto, la precision sale). Alzala e succede il contrario. Un solo cursore, due numeri che tendono a muoversi in senso inverso: per questo non ha senso chiedere «quanto è bravo» in astratto, senza dire quale dei due errori costa di più.
E nei testi il costo è quasi sempre asimmetrico. In un filtro antispam una mail buona cestinata (falso allarme) è molto peggio di uno spam sfuggito, quindi comanda la precision. In un sistema che cerca segnalazioni di un difetto pericoloso è il contrario. La metrica da guardare discende da quel costo, non da una convenzione.
Quando servono tutte e due in un numero solo si usa \(F_1\), la loro media armonica, una media costruita apposta perché un voto basso non si possa nascondere dietro un voto alto. La ricetta: si moltiplicano i due numeri, si raddoppia il prodotto, e lo si divide per la loro somma. In simboli, chiamando \(P\) la precision e \(R\) la recall (lettere scelte per le iniziali: questa \(P\) è un numero fra zero e uno e non una probabilità), \(F_1 = 2PR/(P+R)\).
Prova con precision \(1{,}0\) e recall \(0{,}1\), cioè un sistema che segnala pochissimo e però non sbaglia mai. La media normale, quella di scuola, darebbe un onorevole \((1{,}0 + 0{,}1)/2 = 0{,}55\). Con \(F_1\): il prodotto è \(0{,}10\), raddoppiato fa \(0{,}20\), la somma dei due voti è \(1{,}1\), e \(0{,}20\) diviso \(1{,}1\) fa \(0{,}18\). Il voto basso comanda, ed è giusto così: un sistema che segnala una cosa sola e la azzecca non ha risolto niente.
Con più di due etichette (lo sportello dei reclami, quello della fatturazione, quello delle informazioni) i conti si riassumono in due modi. La media micro somma le caselle di tutte le etichette e calcola un’\(F_1\) sola, e con una sola etichetta per documento coincide con l’accuratezza; la media macro calcola un’\(F_1\) per etichetta e ne fa la media semplice, dando lo stesso peso alle etichette rare, che nei testi sono spesso quelle che contano.
Resta il tranello dell’accuratezza ingannevole, che nei testi è la regola più che l’eccezione, perché le classi sono quasi sempre sbilanciate. Se solo un’email su cento è spam, il filtro pigro che risponde sempre «legittima» sfoggia il 99% di risposte esatte senza aver fermato nulla. Quale metrica privilegiare è la definizione di «successo» per quel particolare giudice.
Il termometro delle parole: i lessici di sentiment#
Prima di chiudere, un attrezzo più artigianale ma tuttora utile: i lessici di sentiment, liste di parole con la loro polarità, cioè il loro segno, positivo o negativo, compilate una volta per tutte.
Un lessico di sentiment è un dizionario dei giudizi: «splendido» +1, «pessimo» −1, migliaia di voci. Per stimare il tono di un testo basta contare: più parole positive che negative, verdetto positivo. Il fascino è che non serve nessun esempio etichettato (niente archivio di recensioni già giudicate) e il verdetto si spiega da solo, parola per parola.
Migliaia di voci, però, nessuno le scrive a una a una. Si parte da una manciata di parole di segno ovvio e si lascia parlare la lingua: chi scrive «elegante e X» quasi sempre sta accostando due parole dello stesso segno, chi scrive «elegante ma X» due parole di segno opposto. Basta leggere abbastanza testo per raccogliere così migliaia di parole nuove con il loro segno, senza che nessuno le abbia giudicate a mano.
Un dizionario del genere, oggi, di rado emette il verdetto per conto suo: quante parole positive e quante negative ha trovato diventano due pesetti che salgono sulla bilancia insieme a tutti gli altri, e sono un aiuto vero quando di recensioni già giudicate ce ne sono poche.
I limiti però sono seri. Il contesto: «imprevedibile» è un complimento per la trama di un film e un’accusa per i freni di un’auto, ma nel dizionario ha un solo segno. L’ironia: «complimenti davvero», scritto sotto il racconto di un disastro, in un elenco di parole conta come una lode. E la negazione: «non è affatto male» è un complimento, eppure è fatto soltanto di parole che un elenco di quel genere marchia come negative o neutre, «non» e «male» in testa. Un conteggio di parole isolate quella frase non la può prendere, per costruzione: presa una per una, nessuna di quelle parole è un elogio, e il senso sta tutto in come stanno insieme. Un modello che legge la frase intera con l’attenzione, come quelli del capitolo sui Transformer, ha davanti anche il «non», e in principio potrebbe farcela. Eppure negli esempi pratici di quel capitolo un modello che dà alle recensioni da una a cinque stelle legge proprio questa frase come scontenta, per un soffio, e le dà due stelle. Leggere tutta la frase è la condizione per capirla, non la garanzia.
I lessici hanno una storia lunga: il General Inquirer di Philip Stone e colleghi [SDSO66] già annotava, a metà degli anni Sessanta, migliaia di parole inglesi con categorie tra cui positivo/negativo. Le voci si costruiscono a mano o in modo semi-supervisionato. Hatzivassiloglou e McKeown [HM97] usano le congiunzioni fra aggettivi («elegante e X» lega X allo stesso orientamento, «elegante ma X» a quello opposto): dai legami dividono gli aggettivi in due gruppi, e chiamano positivo quello delle parole più frequenti. Altri metodi partono da pochi semi di polarità nota e la propagano alle parole che stanno vicine nello spazio dei word embedding, come SentProp di Hamilton e colleghi [HCLJ16]. In un sistema moderno il lessico raramente decide da solo: i suoi conteggi entrano come feature in una regressione logistica, dove convivono con i pesi appresi; un innesto utile soprattutto quando i dati etichettati del dominio sono pochi. Restano i limiti strutturali di ogni approccio a sacchetto di parole: polarità dipendente dal dominio, ironia invisibile, e la negazione, che sposta il segno di intere porzioni di frase e richiede modelli che leggano le sequenze, non i mucchi.
Resta il limite del sacchetto di parole: per il nostro giudice «Il gatto nero salta sul muro» e «Il muro nero salta sul gatto» sono indistinguibili. Per andare oltre serve un modello che prenda sul serio l’ordine delle parole: che sappia dire quanto è plausibile una sequenza, e scommettere sulla parola che viene dopo. È un modello di linguaggio, e il più semplice, l’n-gram, ha con Naive Bayes una parentela stretta: il Naive Bayes multinomiale tiene per ogni classe le frequenze delle parole, cioè un modello di linguaggio che guarda una parola alla volta, e l’n-gram ci aggiunge le parole che vengono prima. Anche il +1 di Laplace ritorna, identico, nei modelli n-gram.
Da ricordare
Classificare un testo vuol dire assegnargli un’etichetta fra poche già decise (spam o no, recensione entusiasta o stroncatura, lingua, autore): un problema risolto già nel 1964 sui Federalist Papers, contando le parole «invisibili» che ognuno usa a modo suo senza accorgersene.
Naive Bayes fa votare le parole: ogni parola porta il suo piccolo indizio, i voti si moltiplicano fra loro e vince l’ipotesi con il punteggio più alto. È ingenuo perché ogni parola vota come se le altre non esistessero, e funziona lo stesso; e come ogni modello a sacchetto non vede l’ordine delle parole. Perché una parola mai vista non azzeri tutto, si regala un conteggio in più a ogni parola: la regola del \(+1\) di Laplace.
La regressione logistica è la bilancia a due piatti: ogni parola butta un pesetto da una parte o dall’altra, i pesetti li impara dagli esempi già etichettati, e la curva a S traduce il totale in una probabilità (con più di due etichette, un punteggio per etichetta).
I due periti davanti ai quadri: il primo (Naive Bayes) studia com’è fatto un quadro tipico di ciascun pittore, il secondo (la regressione logistica) impara solo i dettagli che li distinguono. Il primo se la cava con pochissimi esempi ma conta due volte gli indizi che viaggiano in coppia; il secondo se ne accorge e spartisce il peso, e vince quando gli esempi abbondano.
Per giudicare il giudice servono le misure del capitolo sul machine learning (quante delle segnalazioni sono giuste, quante ne ha trovate) e non la percentuale secca di risposte esatte: se lo spam è una email su cento, chi risponde sempre «legittima» ne azzecca il \(99\%\) senza aver fermato niente.
I lessici di sentiment, dizionari di parole con il loro segno, non chiedono nessun esempio già giudicato, ma sono ciechi al contesto e alla negazione: «non è affatto male» resta il controesempio da ricordare.
Da ricordare
Classificare un testo = assegnargli un’etichetta tra poche prefissate (spam/non spam, positivo/negativo, lingua, autore): un compito risolto con la regola di Bayes già nel 1964, sui Federalist Papers, contando le parole funzione.
Naive Bayes sceglie la classe che massimizza \(P(c)\prod_i P(w_i \mid c)\): le parole votano come indizi indipendenti (ipotesi falsa, ma alla decisione basta che la classe giusta resti in testa; le probabilità escono troppo estreme), e il documento è un sacchetto di parole, che è un’ipotesi distinta. Lo smoothing add-1 di Laplace evita gli zeri; in pratica si calcola tutto in spazio logaritmico.
La regressione logistica impara un peso per parola e passa la somma nella sigmoide (softmax per più classi): stessa ricetta del capitolo sul machine learning, applicata ai vettori bag-of-words o TF-IDF.
Generativo vs discriminativo: Naive Bayes modella \(P(d \mid c)\,P(c)\), la regressione logistica direttamente \(P(c \mid d)\); il primo impara da pochi dati ma conta due volte gli indizi correlati, la seconda ripartisce i pesi e vince quando gli esempi abbondano.
La valutazione usa precision, recall e \(F_1\) (la loro media armonica) del capitolo sul machine learning: con classi sbilanciate (lo spam è raro) l’accuratezza inganna, e con più classi la media macro dà alle classi rare lo stesso peso delle altre.
I lessici di sentiment funzionano senza dati etichettati ma sono ciechi a contesto e negazione: «non è affatto male» resta il controesempio da ricordare.